首页 文章 精选 留言 我的

精选列表

搜索[推荐引擎],共10014篇文章
优秀的个人博客,低调大师

Android学习网站推荐(转)

收集了一些比较好的Android学习网站,希望对大家有所帮助: 1、http://developer.android.com/ Android官方网站,可惜被屏蔽了,需要使用FQ软件 2、http://www.eoeandroid.com/index.php 最大的Android开发社区 3、http://dev.10086.cn/android 中国移动通信开发者社区,丝毫不比eoeandroid差,里面很多源代码 4、http://www.anddev.org/ 刚刚发现的一个外国Android开发者社区 另外,比较有名的社区还有机锋网、安卓网等,但是这几网站商业气息太浓,学习有关的东西占得比例比较小。 转自:链接 本文转自SharkBin博客园博客,原文链接:http://www.cnblogs.com/SharkBin/p/4940300.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark编程模型(博主推荐)

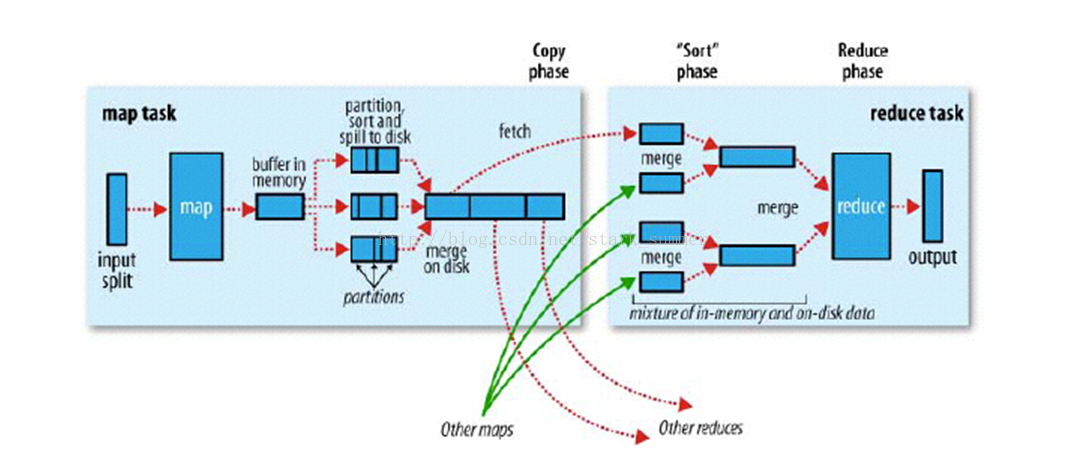
一、Spark编程模型(上) 从Hadoop MR到Spark 回顾hadoop—mapreduce计算过程 MRVS Spark Spark编程模型 核心概念 注意:对比mr里的概念来学习。 这些概念,大家一定要好好理解!!! Spark Application的组成 其中,Driver Program是运行main函数并且新建SparkContext的程序 Cluster Manager是在集群上获取资源的外部服务(例如: standalonde、Mesos、Yarn) Worker Node是集群中任何运行应用代码的节点 Executor是在一个worker node上为某应用启动的一个进程,该进程负责运行任务,并且负责将数据存在内存或磁盘上。每个应用都有各自独立的executors。 Task是被送到某个executor上的工作单元 Spark应用程序的组成 (1)Driver (2)Executor 注意:对照helloworld来思考 Spark Application基本概念 Spark Application编程模型 Spark 应用程序编程模型 – Driver Program ( SparkContext ) – Executor ( RDD 操作) (1)输入Base-> RDD (2)Transformation RDD->RDD (3)Action RDD->driver or Base (4)缓存 Persist or cache() – 共享变量 (1)broadcast variables(广播变量) (2)accumulators(累加器) 回顾Spark Hello World 初识RDD 什么是RDD 定义:Resilient distributed datasets (RDD), an efficient, general-purpose and fault-tolerant abstraction for sharing data in cluster applications. RDD 是只读的。 RDD 是分区记录的集合。 RDD 是容错的。--- lineage RDD 是高效的。 RDD 不需要物化。---物化:进行实际的变换并最终写入稳定的存储器上 RDD 可以缓存的。---课指定缓存级别 RDD是spark的核心,也是整个spark的架构基础,RDD是弹性分布式集合(Resilient Distributed Datasets)的简称,是分布式只读且已分区集合对象。这些集合是弹性的,如果数据集一部分丢失,则可以对它们进行重建。 RDD接口 RDD的本质特征 RDD--partitions Spark中将1~100的数组转换为rdd 通过第15行的size获得rdd的partition的个数,此处创建rdd显式指定定分区个数2,默认数值是这个程序所分配到的资源的cpu核的个数 RDD-preferredLocations 返回此RDD的一个partition的数据块信息,如果一个数据块(block)有多个备份在返回所有备份的location地址信息 主机ip或域名 作用:spark在进行任务调度室尽可能根据block的地址做到本地计算 RDD-dependencies RDD之间的依赖关系分为两类: (1)窄依赖 每个父RDD的分区都至多被一个子RDD的分区使用,即为OneToOneDependecies; (2)宽依赖 多个子RDD的分区依赖一个父RDD的分区,即为ShuffleDependency 。例如,map操作是一种窄依赖,而join操作是一种宽依赖(除非父RDD已经基于Hash策略被划分过了,co-partitioned) (1)窄依赖相比宽依赖更高效资源消耗更少 (2)允许在单个集群节点上流水线式执行,这个节点可以计算所有父级分区。例如,可以逐个元素地依次执行filter操作和map操作。 (3)相反,宽依赖需要所有的父RDD数据可用并且数据已经通过类MapReduce的操作shuffle完成。 (4)在窄依赖中,节点失败后的恢复更加高效。因为只有丢失的父级分区需要重新计算,并且这些丢失的父级分区可以并行地在不同节点上重新计算。 (5)与此相反,在宽依赖的继承关系中,单个失败的节点可能导致一个RDD的所有先祖RDD中的一些分区丢失,导致计算的重新执行。 RDD-compute 分区计算 Spark对RDD的计算是以partition为最小单位的,并且都是对迭代器进行复合,不需要保存每次的计算结果 RDD- partitioner 分区函数:目前spark中提供两种分区函数: (1)HashPatitioner(哈希分区) (2)RangePatitioner(区域分区) 且partitioner只存在于(K,V)类型的RDD中,rdd本身决定了分区的数量。 RDD- lineage val lines = sc.textFile("hdfs://...") // transformed RDDs val errors = lines.filter(_.startsWith("ERROR")) val messages = errors.map(_.split("\t")).map(r => r(1)) messages.cache() // action 1 messages.filter(_.contains("mysql")).count() // action 2 messages.filter(_.contains("php")).count() RDD经过trans或action后产生一个新的RDD,RDD之间的通过lineage来表达依赖关系,lineage是rdd容错的重要机制,rdd转换后的分区可能在转换前分区的节点内存中 典型RDD的特征 不同角度看RDD Scheduler Optimizations Spark编程模型(中) 创建RDD 方式一:从集合创建RDD (1)makeRDD (2)Parallelize 注意:makeRDD可以指定每个分区perferredLocations参数,而parallelize则没有。 方式二:读取外部存储创建RDD Spark与Hadoop完全兼容,所以对Hadoop所支持的文件类型或者数据库类型,Spark同样支持。 (1)多文件格式支持: (2)多文件系统支持: 1)本地文件系统 2)S3 3)HDFS (3)数据库 1)JdbcRDD 2)spark-cassandra-connector(datastax/spark-cassandra-connector) 3)org.apache.hadoop.hbase.mapreduce.TableInputFormat(SparkContext.newAPIHadoopRDD) 4)Elasticsearch-Hadoop transformation操作 惰性求值 (1)RDD 的转化操作都是惰性求值的。这意味着在被调用行动操作之前Spark 不会开始计算 (2)读取数据到RDD的操作也是惰性的 (3)惰性求值的好处: a.Spark 使用惰性求值可以把一些操作合并到一起来减少计算数据的步骤。在类似 Hadoop MapReduce 的系统中,开发者常常花费大量时间考虑如何把操作组合到一起,以减少MapReduce 的周期数。 b.而在Spark 中,写出一个非常复杂的映射并不见得能比使用很多简单的连续操作获得好很多的性能。因此,用户可以用更小的操作来组织他们的程序,这样也使这些操作更容易管理。 转换操作 RDD 的转化操作是返回新RDD 的操作 我们不应该把RDD 看作存放着特定数据的数据集,而最好把每个RDD 当作我们通过转化操作构建出来的、记录如何计算数据的指令列表。 基本转换操作1 基本转换操作2 控制操作 (1)persist操作,可以将RDD持久化到不同层次的存储介质,以便后续操作重复使用。 1)cache:RDD[T] 2)persist:RDD[T] 3)Persist(level:StorageLevel):RDD[T] (2)checkpoint 将RDD持久化到HDFS中,与persist操作不同的是checkpoint会切断此RDD之前的依赖关系,而persist依然保留RDD的依赖关系。 注意:控制操作的细节会在后续博客专门讲解 action操作 Spark编程模型(下) 什么是Pair RDD (1)包含键值对类型的RDD被称作Pair RDD (2)Pair RDD通常用来进行聚合计算 (3)Pair RDD通常由普通RDD做ETL转换而来 创建Pair RDD Python语言 pairs = lines.map(lambda x: (x.split(" ")[0], x)) scala语言 val pairs = lines.map(x => (x.split(" ")(0), x)) Java语言 PairFunction keyData = new PairFunction() { public Tuple2 call(String x) { return new Tuple2(x.split(" ")[0], x); } }; JavaPairRDD pairs = lines.mapToPair(keyData); Pair RDD的transformation操作 Pair RDD转换操作1 Pair RDD 可以使用所有标准RDD 上转化操作,还提供了特有的转换操作。 Pair RDD转换操作2 Pair RDD的action操作 Pair RDD转换操作1 所有基础RDD 支持的行动操作也都在pair RDD 上可用 Pair RDD的分区控制 Pair RDD的分区控制 (1) Spark 中所有的键值对RDD 都可以进行分区控制---自定义分区 (2)自定义分区的好处: 1)避免数据倾斜 2)控制task并行度 自定义分区方式 class DomainNamePartitioner(numParts: Int) extends Partitioner { override def numPartitions: Int = numParts override def getPartition(key: Any): Int = { val domain = new Java.net.URL(key.toString).getHost() val code = (domain.hashCode % numPartitions) if(code < 0) { code + numPartitions // 使其非负 }else{ code } } // 用来让Spark区分分区函数对象的Java equals方法 override def equals(other: Any): Boolean = other match { case dnp: DomainNamePartitioner => dnp.numPartitions == numPartitions case _ => false }

优秀的个人博客,低调大师

推荐5个机器学习API

机器学习作为大数据的前沿无疑是让人生畏的,因为只有技术极客和数据科学领域的专家才能驾驭机器学习算法和技术,对于大部分企业和组织而言,过去这一直都是一个遥不可及的事情。但是现在这种情况正在发生改变,正如标准的API简化了应用程序的开发一样,机器学习API也降低了这一领域的门槛,让越来越多的人和企业能够借助技术底蕴深厚的公司所提供的API试水机器学习。 机器学习API隐藏了创建和部署机器学习模型的复杂性,让开发者能够专注于数据挖掘和用户体验。同时,将机器学习商业化成云服务也是当今的趋势,IBM、Microsoft、Google、Amazon以及BigML等公司都为业务分析师和开发人员提供了自己的机器学习即服务(MLaaS),最近Khushbu Shah在KDnuggets上发表了一篇文章,介绍了这5个公司的机器学习API。 IBM Wat

优秀的个人博客,低调大师

值得推荐的android开源框架

1、volley 项目地址https://github.com/smanikandan14/Volley-demo (1) JSON,图像等的异步下载; (2) 网络请求的排序(scheduling) (3) 网络请求的优先级处理 (4) 缓存 (5) 多级别取消请求 (6) 和Activity和生命周期的联动(Activity结束时同时取消所有网络请求) 2、android-async-http 项目地址:https://github.com/loopj/android-async-http 文档介绍:http://loopj.com/android-async-http/ (1) 在匿名回调中处理请求结果 (2) 在UI线程外进行http请求 (3) 文件断点上传 (4) 智能重试 (5) 默认gzip压缩 (6) 支持解析成Json格式 (7) 可将Cookies持久化到SharedPreferences 3、Afinal框架 项目地址:https://github.com/yangfuhai/afinal 主要有四大模块: (1) 数据库模块:android中的orm框架,使用了线程池对sqlite进行操作。 (2) 注解模块:android中的ioc框架,完全注解方式就可以进行UI绑定和事件绑定。无需findViewById和setClickListener等。 (3) 网络模块:通过httpclient进行封装http数据请求,支持ajax方式加载,支持下载、上传文件功能。 (4) 图片缓存模块:通过FinalBitmap,imageview加载bitmap的时候无需考虑bitmap加载过程中出现的oom和android容器快速滑动时候出现的图片错位等现象。 FinalBitmap可以配置线程加载线程数量,缓存大小,缓存路径,加载显示动画等。FinalBitmap的内存管理使用lru算法, 没有使用弱引用(android2.3以后google已经不建议使用弱引用,android2.3后强行回收软引用和弱引用,详情查看android官方文档), 更好的管理bitmap内存。 FinalBitmap可以自定义下载器,用来扩展其他协议显示网络图片,比如ftp等。同时可以自定义bitmap显示器, 在imageview显示图片的时候播放动画等(默认是渐变动画显示)。 4、xUtils框架 项目地址:https://github.com/wyouflf/xUtils 主要有四大模块: (1) 数据库模块:android中的orm框架,一行代码就可以进行增删改查; 支持事务,默认关闭; 可通过注解自定义表名,列名,外键,唯一性约束,NOT NULL约束,CHECK约束等(需要混淆的时候请注解表名和列名); 支持绑定外键,保存实体时外键关联实体自动保存或更新; 自动加载外键关联实体,支持延时加载; 支持链式表达查询,更直观的查询语义,参考下面的介绍或sample中的例子. (2) 注解模块:android中的ioc框架,完全注解方式就可以进行UI,资源和事件绑定; 新的事件绑定方式,使用混淆工具混淆后仍可正常工作; 目前支持常用的20种事件绑定,参见ViewCommonEventListener类和包com.lidroid.xutils.view.annotation.event。 (3) 网络模块:支持同步,异步方式的请求; 支持大文件上传,上传大文件不会oom; 支持GET,POST,PUT,MOVE,COPY,DELETE,HEAD,OPTIONS,TRACE,CONNECT请求; 下载支持301/302重定向,支持设置是否根据Content-Disposition重命名下载的文件; 返回文本内容的请求(默认只启用了GET请求)支持缓存,可设置默认过期时间和针对当前请求的过期时间。 (4) 图片缓存模块:加载bitmap的时候无需考虑bitmap加载过程中出现的oom和android容器快速滑动时候出现的图片错位等现象; 支持加载网络图片和本地图片; 内存管理使用lru算法,更好的管理bitmap内存; 可配置线程加载线程数量,缓存大小,缓存路径,加载显示动画等… 5、ThinkAndroid 项目地址:https://github.com/white-cat/ThinkAndroid 主要有以下模块: (1) MVC模块:实现视图与模型的分离。 (2) ioc模块:android中的ioc模块,完全注解方式就可以进行UI绑定、res中的资源的读取、以及对象的初始化。 (3) 数据库模块:android中的orm框架,使用了线程池对sqlite进行操作。 (4) http模块:通过httpclient进行封装http数据请求,支持异步及同步方式加载。 (5) 缓存模块:通过简单的配置及设计可以很好的实现缓存,对缓存可以随意的配置 (6) 图片缓存模块:imageview加载图片的时候无需考虑图片加载过程中出现的oom和android容器快速滑动时候出现的图片错位等现象。 (7) 配置器模块:可以对简易的实现配对配置的操作,目前配置文件可以支持Preference、Properties对配置进行存取。 (8) 日志打印模块:可以较快的轻易的是实现日志打印,支持日志打印的扩展,目前支持对sdcard写入本地打印、以及控制台打印 (9) 下载器模块:可以简单的实现多线程下载、后台下载、断点续传、对下载进行控制、如开始、暂停、删除等等。 (10) 网络状态检测模块:当网络状态改变时,对其进行检 6、LoonAndroid 项目地址:https://github.com/gdpancheng/LoonAndroid 主要有以下模块: (1) 自动注入框架(只需要继承框架内的application既可) (2) 图片加载框架(多重缓存,自动回收,最大限度保证内存的安全性) (3) 网络请求模块(继承了基本上现在所有的http请求) (4) eventbus(集成一个开源的框架) (5) 验证框架(集成开源框架) (6) json解析(支持解析成集合或者对象) (7) 数据库(不知道是哪位写的 忘记了) (8) 多线程断点下载(自动判断是否支持多线程,判断是否是重定向) (9) 自动更新模块 (10) 一系列工具类 其中的 volley扩展性非常好,个人比较喜欢的风格。其他如 android-async-http、Afinal 也相当不错。 7、AndroidAnnotations 项目地址: AndroidAnnotations首页 github上的项目地址 主要有以下特点: 使用依赖注入(DI)、控制反转(IOC)来简化开发过程 简化的线程模型(Simplified threading model) 事件绑定(Event binding) REST Client No Magic 类似框架:Bufferknife 8、RoboGuice 项目地址:https://github.com/roboguice/roboguice RoboGuice 使得进行Android开发更加方便,使得开发变得更加简单也更有乐趣。当你调用getIntent().getExtras()是不是经常检查是否为null?RoboGuice可以帮助你。想想调用findViewById()并映射到TextView确实有必要么?RoboGuice也可以帮你。 RoboGuice 可以帮助解决这类的判断工作。你再也不用记住,是通过调用bindService获取一个用户service,调用getSystemService获取一个系统service。注入你的view、service、或者其他对象,然后让RoboGuice来处理剩下的事宜。 RoboGuice 精简了你的应用代码。更少的代码意味着bug也会更少。也使得阅读代码更加容易,不在纠缠于Android平台的各种特性,而是关注于应用实际的业务逻辑。 没什么很难的,你所需要做的仅仅是配置RoboGuice。 ## 9、Dagger ## 项目地址https://github.com/square/dagger android的依赖注入框架(DI框架),感觉跟Spring 的IOC差不多吧。这个框架它的好处是它没有采用反射技术(Spring是用反射的),而是用预编译技术,因为基于反射的DI非常地耗用资源(空间,时间) 10、Fresco 中文文档http://fresco-cn.org/ 项目地址https://github.com/facebook/fresco Fresco 是一个强大的图片加载组件。 Fresco 中设计有一个叫做 image pipeline 的模块。它负责从网络,从本地文件系统,本地资源加载图片。为了最大限度节省空间和CPU时间,它含有3级缓存设计(2级内存,1级文件)。 Fresco 中设计有一个叫做 Drawees 模块,方便地显示loading图,当图片不再显示在屏幕上时,及时地释放内存和空间占用。 特性: 内存管理 图片的渐进式呈现 支持加载Gif图,支持WebP格式 11、ActiveAndroid 项目地址:https://github.com/pardom/ActiveAndroid ActiveAndroid是一个活跃的记录风格的ORM(对象关系映射)库。ActiveAndroid可以让您保存和检索的SQLite数据库记录而没有写一个SQL语句。每个数据库记录被整齐包裹成一个model类,像保存方法()和delete()。 12、Android-Universal-Image-Loader 项目地址:https://github.com/nostra13/Android-Universal-Image-Loader Android-Universal-Image-Loader是一个开源的UI组件程序,该项目的目的是提供一个可重复使用的仪器为异步图像加载,缓存和显示。所以,如果你的程序里需要这个功能的话,那么不妨试试它。因为已经封装好了一些类和方法。我们 可以直接拿来用了。而不用重复去写了。其实,写一个这方面的程序还是比较麻烦的,要考虑多线程,缓存,内存溢出等很多方面。但是,你也可以参考这个例子来自己写出更好的程序。 12、KJFrameForAndroid 项目地址:https://github.com/kymjs/KJFrameForAndroid 一个强大的Android开发库,KJFrameForAndroid的设计思想是通过封装Android原生SDK中复杂的复杂操作而达到简化Android应用级开发,最终实现快速而又安全的开发APP。功能包含 数据库: javabean直接转换为sqlite表存储 Activity继承链:用最快捷的方法实现MVC分层 KJHttp:自带缓存功能的网络请求库,同时可选用HttpurlConnection(默认)或HttpClient实现 KJBitmap:加载网络图片只需要一行代码,使用内存+磁盘双缓存,完美适配任何版本系统不会出现OOM。 13、CJFrameForAndroid 项目地址:https://github.com/kymjs/CJFrameForAndroid 一个完善的Android插件化开发框架的开源实现,只需要一行代码就可以启动一个存在于asset目录或sd卡上的没有安装的apk。 对于插件apk没有任何的编码限制。

优秀的个人博客,低调大师

使用fuel快速安装openstack 推荐

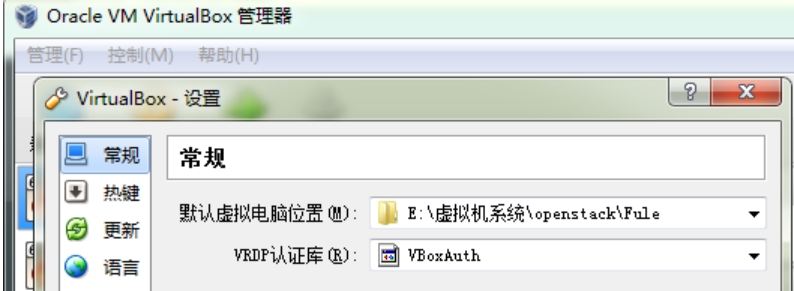
openstack,安装的门槛比较高,而且相当麻烦,很多的安装文档作者省了不少安装步骤。这对初学的人带来了很大的麻烦,也许作者轻易节省一步,就会创成后面的安装失败。而且初学者由于对openstack不是很了解,错误无法排查,因此很多人都在中途放弃对openstack的学习。其实有一个安装工具可以快速的安装openstack,不需要了解openstack各个组件的之间的关系,只需鼠标轻轻一点,就可以完成对openstack的安装;而且还有诸多功能,如对openstack健康检查,查看节点日志等。 首先我们来了解一下fuel,fuel是Mirantis服务集成商开发一套openstack安装工具。Mirantis是一家很NB的openstack服务集成商,在openstack社区贡献排名前5名。下面来说说fuel 是一个为openstack端至端的一健部署工具,其自身包含自动的PXE方式安装操作系统,DHCP服务、业务健康检查以及log查看。底层也是使用puppet对各节点的安装。下面开始干活。 环境: 1、 笔记本:i5cpu,8G内存,空闲100G硬盘。(大家的硬件最好高一点,如果没有8g以上的内存,跑起四个虚拟主机会非常卡) 2、 Oracle VM VirtualBox 3、 MirantisOpenStack-5.1 注意: CPU一定要支持虚拟化、BIOS要开启虚拟化的功能。 软件下载 fuel: http://pan.baidu.com/s/1c0erOjA (大家也可以去官网下载,只需注册一下就可以下载。) VM VirtualBox 大家自行下载吧! 安装Fuel Master: 把默认主机的位置,放在别的盘里,默认是C盘。 管理---全局设置 创建四块网卡 点击加号创建 选择Fuel Master的ISO镜像文件。然后开始安装就可以了。 左边Ctrl+鼠标的右键 移出virtualBOX。这一点做的没有VMware好呀,搞了半天才出来! 同时我们也看到了fuel的访问端口。 因为我的杀毒软件的有隔离,需要建立一个隧道。你们也可以直接使用:http:10.20.0.2:8000进行访问 用户名和密码默认是:admin #选择你要安装的系统环境 部署的模式,刚开始学习建议先部署多节点的环境 虚拟化类型的选择 不需要选择 到这里我们的配置环境已经都配置好了,目前还没有节点加入进来,我们需要有节点服务器。 节点服务: 在虚拟机上创建节点服务,但网卡需要如下设置: 如果电脑配置的好把计算节点把CPU和内存调大一点: 因为我们这里使用网卡启动,所以不需要光盘启动。点取消。在安装的过程中我们不用对安装介质进行选择默认会安装一个非常小的linux系统,等一下会让fuel帮我安装Centos. 等服务都启完之后。fuel这边会有一边提示 在日志那边 第二台机器 NOde节点的分配就完成,下面开始配置网络。 网络验证正确之后在保存设置,其它的配置默认就可以了。下面我们开始部署。 部署变更------部署。 这时我们就可以看到部署的进度条 这个时候我们可以看到正在安装Centos,我在实验环境做的时候,还需要切到openstack的控制节点和计算节点,点一下OK。 安装后Centos 控制节点,开始安装openstack. 安装完成之后,我们应该会在界面上有显示的openstack的登录地址,因为我这里是把机器重启了,这里没有显示,但我们可以去日志里看到。 哈哈 这就看到的了高大山的openstack 用户名密码:admin 创建一个虚拟主机: 将网络拖进去。然后 运行 云主机创建成功。 设置一个浮动的IP地址:从下面下拉的窗口中随意选取一个 由于openstack自身有防火墙的功能我们需要设置一下icmp 和22号端口 虚拟主机的用户名和密码在vm1 日志 里可以看到。 用户:cirros 密码:cubswin:) ssh 连接上去 可以ping通172.16.0.0段的网关 openstack添加云硬盘的功能: 把虚拟机的网卡按照上面的调试方法调试一下,并让他从网络启动: 验证网络之后,我们就开始部署。 创建一块云硬盘: 更多 将云硬盘挂载到那个主机 这个小小kernel 必须使用sudo 命令才能执行操作: OK 看到云硬盘了!测试fuel安装openstack完成,fuel还有很多其他的功能,各位可以去测试。 最后让我们来看一下fuel安装openstack的架构: 感谢各位的观看请不要吝惜你手中的 赞 哦!

优秀的个人博客,低调大师

Docker 引擎概述

Docker Engine 是一个开源的容器技术,被用来对你的应用进行容器化构建。 Docker Engine 实际上是一个客户端服务器(client-server)应用: 一个在服务器上长期运行的被称为 dockerd 的进程。 一个指定结构的 APIs,这个 API 被用来与 Docker 守护进程进行通信。 一个命令行界面(CLI)客户端 docker。 命令行界面(CLI)使用 Docker APIs 来控制和与 Docker 来互相作用。这个使用脚本或者 CLI 命令行来进行控制和执行。 其他 Docker 应用使用下层 API 和 CLI 来对 Docker 来进行控制。 Docker 守护进程创建和管理 Docker 的对象(objects), 例如 镜像(images),容器(containers),网络(networks),卷(volumes)。 更多的信息和内容,请参考: Docker Architecture。 Docker 用户指南 希望了解更多 Docker 的信息和有关使用和实现的问题和回答,请参考 开始使用 页面中的内容。 安装指南 请参考 installation section 页面中的内容来针对不同平台的 Docker 安装指南。 发行日志 针对当前的版本的修改和历史版本的修改日志,请参考 发行日志页面 页面中的内容。 特性丢弃策略 Docker 容器随着版本的改变和新特性的添加可能随着性能的变化和添加而过期而被替代掉。在已经存在的特性被删除之前,这个特性将会在文档中标记为 “deprecated”。 这个标记将会在 Docker 中至少保持 3 个稳定的版本,除非被明确的表示将会被删除掉。 针对需要删除的特性列表,用户将会被建议先记录下来,并且针对一些被删除的特性,用户在进行版本合并的时候尽量先合并这些新的特性,并尽可能的先替换掉。 完整的需要删除的特性列表,请参考页面:https://docker.ossez.com/engine/deprecated/ 中的内容。 https://www.ossez.com/t/docker/729

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册