首页 文章 精选 留言 我的

精选列表

搜索[Python版本],共10000篇文章
优秀的个人博客,低调大师

这些Python实用小工具了解一下,总有一款是你需要的!

云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 1.实现简单探测 使用socket模块,connect()方法建立与指定IP和端口的网络连接;revc(1024)方法将读取套接字中接下来的1024B数据 通过函数实现 通过def()关键字定义,示例中定义扫描FTP banner信息的函数: 迭代实现 OS模块 os.path.isfile()检查该文件是否存在 os.access()判断当前用户是否有权限读取该文件 整合 将上述各个模块整合起来,实现对目标主机的端口及其banner信息的扫描: 运行结果: 第一个程序:Unix口令破解机 这段代码通过分别读取两个文件,一个为加密口令文件,另一个为用于猜测的字典文件。在testPass()函数中读取字典文件,并通过crypt.crypt()进行加密,其中需要一个明文密码以及两个字节的盐,然后再用加密后的信息和加密口令进行比较查看是否相等即可。 第二个程序:一个Zip文件口令破解机 主要使用zipfile库的extractall()方法,其中pwd参数指定密码 代码中导入了optparse库解析命令行参数,调用OptionParser()生成一个参数解析器类的示例,parser.add_option()指定具体解析哪些命令行参数 usage输出的是参数的帮助信息;同时也采用了多线程的方式提高破解速率。 运行结果: 云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 原文发布时间:2020-03-04本文作者:AI派本文来自:“AI派公众号”,了解相关信息可以关注“AI派”

优秀的个人博客,低调大师

19、 Python快速开发分布式搜索引擎Scrapy精讲—css选择器

css选择器 1、 2、 3、 ::attr()获取元素属性,css选择器 ::text获取标签文本 举例: extract_first('')获取过滤后的数据,返回字符串,有一个默认参数,也就是如果没有数据默认是什么,一般我们设置为空字符串 extract()获取过滤后的数据,返回字符串列表 #-*-coding:utf-8-*- importscrapy classPachSpider(scrapy.Spider): name='pach' allowed_domains=['blog.jobbole.com'] start_urls=['http://blog.jobbole.com/all-posts/'] defparse(self,response): asd=response.css('.archive-title::text').extract()#这里也可以用extract_first('')获取返回字符串 #print(asd) foriinasd: print(i) 【转载自:http://www.lqkweb.com】

优秀的个人博客,低调大师

Python爬虫入门教程 42-100 爬取儿歌多多APP数据-手机APP爬虫部分

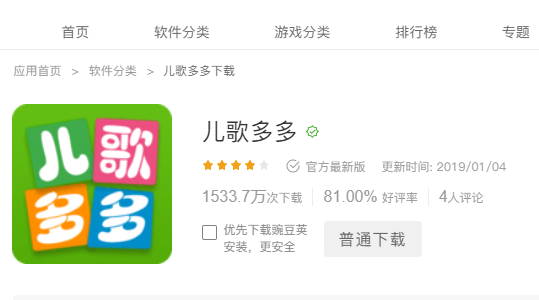
1. 儿歌多多APP简单分析 今天是手机APP数据爬取的第一篇案例博客,我找到了一个儿歌多多APP,没有加固,没有加壳,没有加密参数,对新手来说,比较友好,咱就拿它练练手,熟悉一下Fiddler和夜神模拟器是如何配合着使用的。 儿歌多多APP在豌豆荚的下载量还是可以的,一家做内容的APP。 2. APP安装和使用 APP直接去下载APK包就可以了,拖拽到夜神模拟器就安装成功了。在模拟器打开出现如下界面,表示已经可以开始操作了,非常儿童的APP。 3. 抓包测试 打开APP同时,打开Fiddler,首先测试一下网络是否正常,用模拟器自带的浏览器去访问百度,如果可以访问表示无问题,否则重新设置代理 运行软件过程中,注意观察Fiddler,如果出现JSON类型的API[接口],就要注意了,你想要的数据就在这里 我们点击链接,看Fiddler右侧显示内容

优秀的个人博客,低调大师

Python爬虫入门教程 38-100 教育部高校名单数据爬虫 scrapy

爬前叨叨 今天要爬取一下正规大学名单,这些名单是教育部公布具有招生资格的高校名单,除了这些学校以外,其他招生的单位,其所招学生的学籍、发放的毕业证书国家均不予承认,也就是俗称的野鸡大学! 网址是 https://daxue.eol.cn/mingdan.shtml 爬取完毕之后,我们进行一些基本的数据分析,套路如此类似,哈哈 这个小项目采用的是scrapy,关键代码 import scrapy from scrapy import Request,Selector class SchoolSpider(scrapy.Spider): name = 'School' allowed_domains = ['daxue.eol.cn'] start_urls = ['https://daxue.eol.cn/ming

优秀的个人博客,低调大师

使用python排八字 计算八字的相合相冲五行分值等

简介 八字术是一种古老的算命术。它运用阴阳、五行、干支、八卦等理论,把人的出生年月日时转化为八个字,进而推算人的富贵贫贱、祸福吉凶、穷通寿天、名利地位、家庭六亲等方面的情况 八字源自古代的中国,是一种利用天干和地支来准确记录年、月、日、时的方式,由“年干,年支”、“月干,月支”、“日干,日支”、“时干,时支”,共八个干支所组成(共八个字),年、月、日、时的干支组合称为“柱”,形成“年柱”、“月柱”、“日柱”、“时柱”,故八字又称为“四柱”或“四柱八字”。 这种以干支记录时间的方式从夏朝开始就已经开始使用,但直至宋朝的徐子平才将人们出生时的干支八字用来论断人事祸福,因此命理学中的八字命理又称“子平八字学”,以纪念徐子平对八字命理学的贡献。 公历 2006年1月28日23:50农历 丙戌年正月初一日子时八字 乙酉年己

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册