首页 文章 精选 留言 我的

精选列表

搜索[Python版本],共10000篇文章
优秀的个人博客,低调大师

手把手:AlphaGo有啥了不起,我也能教你做一个(附Python代码)

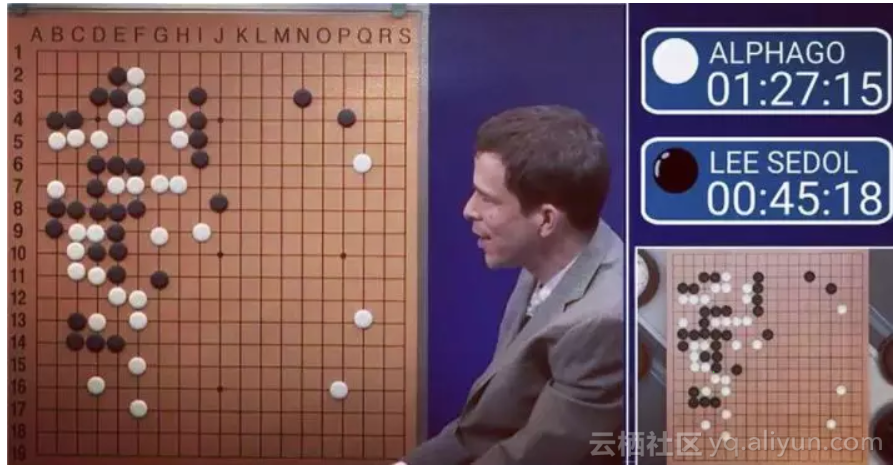
在2016年3月,Deepmind研发的AlphaGo以4:1的成绩,击败了曾荣获18次世界冠军的围棋选手,李世石(Lee Sedol)。超过2亿观众见证了这一历史时刻。一台机器已经学会了一种超越人类的围棋策略。这在以前被认为是一项不可能完成的任务,或者至少需要十年之功。 AlphaGo与李世石的第3场比赛 这已是一项了不起的成就。然而,在2017年10月18日,DeepMind又再次取得了突破。 论文《无需人类知识就能称霸围棋》(Mastering the Game of Go without Human Knowledge),揭示了一种新的算法——AlphaGo Zero,它以100:0的惊人成绩打败了AlphaGo。更令人难以置信的是,它从零开始,通过自我博弈,逐渐学会了能打败自己之前的策略。至此,开发一个超级AI不再需要依赖人类

优秀的个人博客,低调大师

快学学大牛最爱的t-SNE算法吧(附Python/R代码)

假设你有一个包含数百个特征(变量)的数据集,却对数据所属的领域几乎没有什么了解。 你需要去识别数据中的隐藏模式,探索和分析数据集。不仅如此,你还必须找出数据中是否存在模式--用以判定数据是有用信号还是噪音? 这是否让你感到不知所措?当我第一次遇到这种情况,我简直全身发麻。想知道如何挖掘一个多维数据集? 这是许多数据科学家经常问的问题之一。 该篇文章中,我将带你通过一个强有力的方式来实现这一点。用PCA怎么样? 现在,一定会有很多人心里想着“我会使用PCA来降维和可视化”。 好吧,你是对的!PCA绝对是具有大量特征的数据集的降维和可视化的不错选择。 但是,假如你能使用比PCA更先进的东西将会怎样呢? 如果你可以很容易地找出非线性的模式呢? 在本文中,我将告诉你一个比PCA(1933)更有效、被称为t-SNE(2008)的新算法。 首先我

优秀的个人博客,低调大师

全新Linux+Python高端运维班-Linux grep正则表达式练习,及find命令

本周作业内容: 1、显示当前系统上root、fedora或user1用户的默认shell; 1 2 3 4 5 6 7 [root@liuhome] #grep-E"^(root|fedora|user1)\>"/etc/passwd|cut-d:-f1,7 root: /bin/bash user1: /bin/bash fedora: /bin/bash #本题使用扩展的正则表达式 #^:首行|:或者():将一个或者多个字符捆绑在一起当作一个整体来处理\>:表示词尾定锚定 #cut-d:f1,7表示用:号作为分隔符,截取第1字段和第7个字段.分别代表用户名和默认的登陆shell 2、找出/etc/rc.d/init.d/functions文件中某单词后面跟一组小括号的行,形如:hello(); 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 [root@liu/] #grep-E-o"[_[:alpha:]]+\(\)"/etc/rc.d/init.d/functions fstab_decode_str() checkpid() __readlink() __fgrep() __umount_loop() __umount_loopback_loop() __pids_var_run() __pids_pidof() daemon() killproc() pidfileofproc() pidofproc() status() echo_success() echo_failure() echo_passed() echo_warning() update_boot_stage() success() failure() passed() warning() action() strstr() confirm() get_numeric_dev() is_ignored_file() is_true() is_false() apply_sysctl() key_is_random() find_crypto_mount_point() init_crypto() #使用grep-E或者egrep扩展正则表达式,-o表示只匹配到符合的字符 #[_[:alpha:]]表示以_或者大小写字母开头的字符;+表示前面的字符出现一次或多次; #要匹配包含()的行,在过滤时需要对小括号进行转义:\(\) 3、使用echo命令输出一个绝对路径,使用grep取出其基名; 1 2 3 4 [root@liu/] #echo"/tmp/ljohn/useradd.sh"|grep-E-o"[^/]+$" useradd .sh [root@liu~] #echo"/tmp/ljohn/useradd.sh/"|grep-Eo"[^/]+/?$"|cut-d'/'-f1 useradd .sh #基名basename /tmp/ljohn/useradd.sh 1 2 3 4 [root@liu~] #basename/tmp/ljohn/useradd.sh useradd .sh [root@liu~] #basename/tmp/ljohn/useradd.sh/ useradd .sh 1 2 3 #这样可以看出第二种同basename命令。 #行尾的字符串[^/]除了/斜线的任意内容,+代表这个/至少出现1次 #$:表示行尾锚定 扩展:取出其路径名 1 2 3 4 5 6 7 8 9 [root@liu/] #echo"/tmp/ljohn/useradd.sh"|grep-E-o"^/.*/" /tmp/ljohn/ [root@liu~] #echo"/tmp/ljohn/useradd.sh"|grep-Eo"^/.*/"|grep-Eo"^/.*[^/]" /tmp/ljohn #目录名dirname/tmp/ljohn/useradd.sh [root@liu~] #dirname/tmp/ljohn/useradd.sh /tmp/ljohn [root@liu~] #dirname/tmp/ljohn/useradd.sh/ /tmp/ljohn 1 2 3 4 #这样可以看出第二种同dirname命令 #^/.*/表示以/开头,中间任意长度字符,以/结尾。 #.*:任意长度的任意字符 #[^/]:除了斜线的任意内容 4、找出ifconfig命令结果中的1-255之间数字; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 [root@liu/] #ifconfig|grep-E-o"\<([1-9]|[1-9][0-9]|1[0-9][0-9]|2[0-9][0-9])\>"|sort -n-u 5 8 19 20 29 30 31 38 39 41 42 45 64 100 127 128 137 150 164 168 192 255 #[1-9]表示1-9;[1-9][0-9]表示10-99;1[0-9][0-9]表示100-199;2[0-9][0-9])表示200-299 #使用-o参数表示只显示匹配到的字符; #sort-n-u按数字大小排序并去重; 5、挑战题:写一个模式,能匹配合理的IP地址; # A类地址范围:1.0.0.1—126.255.255.254 B类地址范围:128.0.0.1—191.255.255.254 # C类地址范围:192.0.0.1—223.255.255.254 D类地址范围:224.0.0.1—239.255.255.254 # E类地址范围:240.0.0.1—255.255.255.254 127.X.X.X是保留地址,用做循环测试用的 # 匹配范围为 1-255.0-255.0-255.1-254 1 2 3 [root@liu/] #ifconfig|grep-E-o"(2[0-5]{2}|1[0-9]{2}|[1-9][0-9]|[1-9])\.((2[0-5]{2}|1[0-9]{2}|[1-9][0-9]|[0-9])\.){2}\<(2[0-5][0-4]|1[0-9]{2}|[1-9][0-9]|[1-9])\>" 192.168.137.30 127.0.0.1 #此题参考http://ld0381.blog.51cto.com/3318114/1845601; http://2368360.blog.51cto.com/2358360/1846091 #详细解析: ^PATTERN$ 用于模式匹配整行 {2}表示前面字符正好出现两次 | 的意思是或者 ( )上面的括号不能少,是为了匹配括号中整体字符串,表达式中有几个()就表示有几个相应的匹配字符串 [0-4]表示0~4的任何一个数字 [0-9]表示0~9的任何一个数字 [1-9]的意思是1~9之间的任意一个数字 [1-9][0-9]的意思是10~99之间的任意一个数字 1[0-9]{2}的意思就是100~199之间的任意一个数字 2[0-4][0-9]的意思是200~249之间的任意一个数字 25[0-5]的意思是250~255之间的任意一个数字 \.的意思是.点要转义为普通字符 6、挑战题:写一个模式,能匹配出所有的邮件地址; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 [root@liu/] #cat/tmp/mail.txt 184694637@qq.com lshailkj@qq.com ljohnmail@foxmail.com foxmail@_cmd.cn ljohn@163.com lkjdas_ #@123_.com [root@liu/] #grep-E"^[[:alnum:]]+@[[:alnum:]]+\.[[:alnum:]]+$"/tmp/mail.txt 184694637@qq.com lshailkj@qq.com ljohnmail@foxmail.com ljohn@163.com #先创建了一个mail.txt的文件事先编辑了几个邮箱 #首先要了解邮箱的格式:数字字母@数字字母.数字字母 #[[:alnum:]]+表示任意数字或字母 7、查找/var目录下属主为root,且属组为mail的所有文件或目录; 1 2 3 4 5 [root@liu~] #find/var-userroot-groupmail-ls 2622964drwxrwxr-x2rootmail40969月415:35 /var/spool/mail 2620484-rw-------1rootmail23539月317:33 /var/spool/mail/root #find命令格式:find[OPTION]...[查找路径][查找条件][处理动作] #find命令实现对属主,数组的匹配,使用-user和-group来实现。 8、查找当前系统上没有属主或属组的文件; 1 2 3 4 5 6 7 8 9 10 11 [root@liu~] #find/-nouser-o-nogroup /home/mandirva /home/mandirva/ .gnome2 /home/mandirva/ .bashrc /home/mandirva/ .mozilla /home/mandirva/ .mozilla /plugins /home/mandirva/ .mozilla /extensions /home/mandirva/ .bash_logout /home/mandirva/ .bash_profile /var/spool/mail/mandirva #-nouser没有属主;-nogroup没有数组 进一步:查找当前系统上没有属主或属组,且最近3天内曾被访问过的文件或目录; 1 2 3 4 5 6 7 8 9 10 [root@liu~] #find/\(-nouser-o-nogroup\)-atime-3 find :“ /proc/3759/task/3759/fd/5 ”:没有那个文件或目录 find :“ /proc/3759/task/3759/fdinfo/5 ”:没有那个文件或目录 find :“ /proc/3759/fd/5 ”:没有那个文件或目录 find :“ /proc/3759/fdinfo/5 ”:没有那个文件或目录 /home/mandirva /home/mandirva/ .gnome2 /home/mandirva/ .mozilla /home/mandirva/ .mozilla /plugins /home/mandirva/ .mozilla /extensions 9、查找/etc目录下所有用户都有写权限的文件; 1 2 3 4 5 6 7 [root@liu~] #find/etc-perm-222 /etc/rc .d /rc1 .d /K73winbind /etc/rc .d /rc1 .d /K92iptables /etc/rc .d /rc1 .d /K99rngd /etc/rc .d /rc1 .d /K84wpa_supplicant /etc/rc .d /rc1 .d /K89portreserve ... #根据权限查找: -perm [+|-]MODE MODE: 精确权限匹配 +MODE:任何一类(u,g,o)对象的权限中只要能一位匹配即可; -MODE:每一类对象都必须同时拥有为其指定的权限标准; -222:表示每一个用户都有写权限。 10、查找/etc目录下大于1M,且类型为普通文件的所有文件; 1 2 3 4 [root@liu~] #find/etc/-typef-size+1M /etc/selinux/targeted/modules/active/policy .kern /etc/selinux/targeted/policy/policy .24 /etc/gconf/gconf .xml.defaults/%gconf-tree.xml #根据类型查找: -type TYPE: f: 普通文件 d: 目录文件 l: 符号链接文件 s:套接字文件 b: 块设备文件 c: 字符设备文件 p: 管道文件 #根据文件大小查找: -size [+|-]#UNIT 常用单位:k, M, G #UNIT: (#-1, #] -#UNIT:[0,#-1] +#UNIT:(#,oo) 11、查找/etc/init.d/目录下,所有用户都有执行权限,且其它用户有写权限的文件; 1 2 [root@liu~] #find/etc/init.d-perm-113-ls 6529140lrwxrwxrwx1rootroot112月122015 /etc/init .d->rc.d /init .d 12、查找/usr目录下不属于root、bin或hadoop的文件; 1 2 3 4 5 [root@liu~] #find/usr-not\(-userroot-o-userbin-o-userhadoop\)-ls 209568-rwsr-xr-x1abrtabrt670011月232013 /usr/libexec/abrt-action-install-debuginfo-to-abrt-cache 或者: [root@liu~] #find/usr-not-userroot-a-not-userbin-a-not-userhadoop-ls 209568-rwsr-xr-x1abrtabrt670011月232013 /usr/libexec/abrt-action-install-debuginfo-to-abrt-cache 13、查找/etc/目录下至少有一类用户没有写权限的文件; 1 2 3 4 5 [root@liu~] #find/etc-not-perm-222-ls 65280212drwxr-xr-x118rootroot122889月415:35 /etc 6528260-rw-r--r--1rootroot01月122010 /etc/exports 6619614drwxr-xr-x2rootroot40968月3023:52 /etc/glances 6620334-rw-r--r--1rootroot32881月182014 /etc/glances/glances .conf ... 14、查找/etc目录下最近一周内其内容被修改过,且不属于root或hadoop的文件; 创建一个文件并修改权限: 1 2 3 4 5 6 7 8 9 10 [root@liuetc] #cat>findtest.txt<<EOF >123123 >Hello!! >Howareyou! >EOF [root@liuetc] #chownliu.liufindtest.txt [root@liuetc] #ls-lfindtest.txt -rw-r--r--.1liuliu299月505:07findtest.txt [root@liuetc] #find/etc-mtime-7-not-userroot-not-userhadoop /etc/findtest .txt 本文转自 ljohnmail 51CTO博客,原文链接:http://blog.51cto.com/ljohn/1846386,如需转载请自行联系原作者

优秀的个人博客,低调大师

2016全新Linux+Python高端运维班-Linux grep命令及基本正则表达式

本周作业内容: 1、复制/etc/skel目录为/home/tuser1,要求/home/tuser1及其内部文件的属组和其它用户均没有任何访问权限。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 第一种方式: [root@liu/] #chmod-Rgo=---/home/tuser1 [root@liutuser1] #ls-l/home/tuser1/ 总用量4 -rw-------.1rootroot478月2500:01issue 第二种方式: [root@liu/] #rm-rf/home/tuser1/ [root@liu/] #cp-r/etc/skel//home/tuser1 [root@liu/] #chmod-Rg-rwx/home/tuser1/ [root@liu/] #chmod-Ro-rwx/home/tuser1/ [root@liu/] #ls-l/home/tuser1/ 总用量4 -rw-------.1rootroot478月2500:12issue [root@liu/] #ls-ld/home/tuser1/ drwx------.4rootroot40968月2500:12 /home/tuser1/ 2、编辑/etc/group文件,添加组hadoop。 1 2 3 4 5 6 7 第一种方式: [root@liu/] #echo"hadoop:x:3008:">>/etc/group 第二种方式: vim /etc/group 在最下面添加一行: hadoop:x:3009: 保存退出。 3、手动编辑/etc/passwd文件新增一行,添加用户hadoop,其基本组ID为hadoop组的id号;其家目录为/home/hadoop。 1 2 3 4 5 6 vim /etc/passwd 在最下面添加一行: hadoop:x:3008:3008:: /home/hadoop : /bin/bash 保存退出。 [root@liu/] #idhadoop uid=3008(hadoop)gid=3008(hadoop)组=3008(hadoop) 4、复制/etc/skel目录为/home/hadoop,要求修改hadoop目录的属组和其它用户没有任何访问权限。 1 2 3 4 5 6 7 8 9 10 11 12 [root@liu/] #cp-r/etc/skel//home/hadoop [root@liu/] #chmod-Rgo=---/home/hadoop [root@liu/] #ls-la/home/hadoop 总用量32 drwx------.4rootroot40968月2500:33. drwxr-xr-x.19rootroot40968月2500:33.. -rw-------.1rootroot188月2500:33.bash_logout -rw-------.1rootroot1768月2500:33.bash_profile -rw-------.1rootroot1248月2500:33.bashrc drwx------.2rootroot40968月2500:33.gnome2 -rw-------.1rootroot478月2500:33issue drwx------.4rootroot40968月2500:33.mozilla 5、修改/home/hadoop目录及其内部所有文件的属主为hadoop,属组为hadoop。知识点: 修改文件的属主:chown chown [OPTION]... [OWNER][:[GROUP]] FILE... 用法: OWNER OWNER:GROUP :GROUP Note: 命令中的冒号可用.替换; -R: 递归 chown [OPTION]... --reference=RFILE FILE... 1 2 3 [root@liu/] #chown-Rhadoop:hadoop/home/hadoop/ [root@liu/] #idhadoop uid=3008(hadoop)gid=3008(hadoop)组=3008(hadoop) 6、显示/proc/meminfo文件中以大写或小写S开头的行;用两种方式; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@liu/] #grep'^[Ss]'/proc/meminfo SwapCached:0kB SwapTotal:2097144kB SwapFree:2097144kB Shmem:3296kB Slab:46576kB SReclaimable:13148kB SUnreclaim:33428kB [root@liu/] #grep-i"^s"/proc/meminfo SwapCached:0kB SwapTotal:2097144kB SwapFree:2097144kB Shmem:3296kB Slab:46584kB SReclaimable:13160kB SUnreclaim:33424kB 7、显示/etc/passwd文件中其默认shell为非/sbin/nologin的用户;知识点: grep [OPTIONS] PATTERN [FILE...] 选项: --color=auto: 对匹配到的文本着色显示; -v: 显示不能够被pattern匹配到的行; -i: 忽略字符大小写; -o: 仅显示匹配到的字符串; -q: 静默模式,不输出任何信息; -A #:after, 后#行 -B #: before, 前#行 -C #:context, 前后各#行 -E:使用ERE; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 [root@liu/] #grep-v"/sbin/nologin"/etc/passwd|cut-d:-f1 root sync shutdown halt liu bash basher testbash centos useradd1 mageia slackware openstacks user1 user2 user3 hadoop 8、显示/etc/passwd文件中其默认shell为/bin/bash的用户; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 [root@liu/] #grep"/bin/bash"/etc/passwd|cut-d:-f1 root liu bash basher testbash centos useradd1 mageia openstacks user1 user2 user3 hadoop 9、找出/etc/passwd文件中的一位数或两位数;知识点: 基本正则表达式元字符: 字符匹配: .: 匹配任意单个字符; []: 匹配指定范围内的任意单个字符 [^]:匹配指定范围外的任意单个字符 [:digit:]、[:lower:]、[:upper:]、[:alpha:]、[:alnum:]、[:punct:]、[:space:] 匹配次数:用在要指定次数的字符后面,用于指定前面的字符要出现的次数; *:匹配前面的字符任意次; 例如: grep "x*y" abxy xay xxxxxxy 贪婪模式 .*:任意长度的任意字符; \?:匹配其前面的字符0或1次;即前面的可有可无; \+:匹配其前面的字符至少1次; \{m\}:匹配前面的字符m次; \{m,n\}:匹配前面的字符至少m次,至多n次; \{0,n\}:匹配前面的字符至多n次; \{m,\}:匹配前面的字符至少m次; 位置锚定: ^:行首锚定;用于模式的最左侧; $:行尾锚定;用于模式的最右侧; ^PATTERN$: 用于模式匹配整行; ^$: 空行; ^[[:space:]]*$ \< 或 \b:词首锚定;用于单词模式的左侧; \> 或 \b:词尾锚定;用于单词模式的右侧; \<PATTERN\>:匹配整个单词; 分组: \(\):将一个或多个字符捆绑在一起,当作一个整体进行处理; \(xy\)*ab 1 [root@liu/] #grep-E-o"\<[0-9]{1,2}\>"/etc/passwd 10、显示/boot/grub/grub.conf中以至少一个空白字符开头的行; 1 2 3 4 5 6 7 8 [root@liu/] #grep"^[[:space:]]\+"/boot/grub/grub.conf root(hd0,0) kernel /vmlinuz-2 .6.32-431.el6.i686ro root=UUID=3fcabd0f-e9fb-4618-918d-c9e004fe6a59rd_NO_LUKS KEYBOARDTYPE=pcKEYTABLE=usrd_NO_MDcrashkernel=autoLANG=zh_CN.UTF-8 rd_NO_LVMrd_NO_DMrhgbquiet initrd /initramfs-2 .6.32-431.el6.i686.img 11、显示/etc/rc.d/rc.sysinit文件中以#开头,后面跟至少一个空白字符,而后又有至少一个非空白字符的行; 1 2 3 4 5 6 7 8 9 10 11 12 13 [root@liu/] #grep"^#[[:space:]]\+[^[:space:]]\+"/etc/rc.d/rc.sysinit #/etc/rc.d/rc.sysinit-runonceatboottime #TakeninpartfromMiquelvanSmoorenburg'sbcheckrc. #CheckSELinuxstatus #Printatextbanner. #Onlyreadthisonce. #Initializehardware #Setdefaultaffinity #Loadotheruser-definedmodules #Loadmodules(forbackwardcompatibilitywithVARs) #Configurekernelparameters #Setthehostname. ... 12、打出netstat -tan命令执行结果中以‘LISTEN’,后或跟空白字符结尾的行; 1 2 3 4 5 6 7 8 9 10 11 12 13 [root@liu/] #netstat-tan|grep"LISTEN[[:space:]]\+$" tcp000.0.0.0:1110.0.0.0:*LISTEN tcp000.0.0.0:220.0.0.0:*LISTEN tcp00127.0.0.1:6310.0.0.0:*LISTEN tcp00127.0.0.1:250.0.0.0:*LISTEN tcp000.0.0.0:336610.0.0.0:*LISTEN tcp00:::36996:::*LISTEN tcp00:::111:::*LISTEN tcp00:::22:::*LISTEN tcp00::1:631:::*LISTEN tcp00::1:25:::*LISTEN 或者使用 egrep 命令 netstat -tan| egrep "LISTEN[[:space:]]+$" 13、添加用户bash, testbash, basher, nologin (此一个用户的shell为/sbin/nologin),而后找出当前系统上其用户名和默认shell相同的用户的信息; 1 2 3 4 5 6 7 8 9 10 [root@liu/] #useraddbash [root@liu/] #useraddtestbash [root@liu/] #useraddbasher [root@liu/] #useraddnologin-s/sbin/nologin [root@liu/] #grep"^\(\<[[:alpha:]]\+\>\).*\1$"/etc/passwd sync :x:5:0: sync : /sbin : /bin/sync shutdown :x:6:0: shutdown : /sbin : /sbin/shutdown halt:x:7:0:halt: /sbin : /sbin/halt bash :x:501:501:: /home/bash : /bin/bash nologin:x:504:504:: /home/nologin : /sbin/nologin 本文转自 ljohnmail 51CTO博客,原文链接:http://blog.51cto.com/ljohn/1843661,如需转载请自行联系原作者
优秀的个人博客,低调大师

《灯灯》多租户快速开发平台 5.0.8 发布,基于 vben-admin5.x版本的全新前端正式发布

升级内容 feat(lamp-base-server): 在上传文件时选择LOCAL模式,可以通过springboot代理上传的文件,进行文件预览 faet: 适配达梦数据库 feat(lamp-generator): 代码生成器支持生成 lamp-web-max-vben 版前端的Tree页面 refactor(lamp-generator): 优化代码生成器生成 lamp-web-max-vben 版前端的单表页面 feat(lamp-web-max-vben): fast-crud 开发的表格,全局开启 拖拽调整列宽 feat(lamp-web-max-vben): 文件上传时,支持以函数的方式传递自定义参数 feat(lamp-web-max-vben): 配置 plugin-render-antd,使用vxe-table时,可以使用ant-design-vue的组件 fix(lamp-web-max-vben): 设置默认租户异常 feat(lamp-web-max-vben): 接口管理 开发完成 feat(lamp-web-max-vben): 接口日志 开发完成 feat(lamp-web-max-vben): 消息模版 开发完成 feat(lamp-web-max-vben): 我的应用 开发完成 feat(lamp-web-max-vben): 我的消息 开发完成 feat(lamp-web-max-vben): 消息管理 开发完成 feat(lamp-web-max-vben): 个性消息模版 开发完成 feat(lamp-web-max-vben): 员工维护 开发完成 feat(lamp-web-max-vben): 组织机构 开发完成 feat(lamp-web-max-vben): 岗位维护 开发完成 feat(lamp-web-max-vben): 个性字典 开发完成 feat(lamp-web-max-vben): 个性参数 开发完成 feat(lamp-web-max-vben): 角色权限维护 开发完成 feat(lamp-web-max-vben): 操作日志 开发完成 feat(lamp-web-max-vben): 登录日志 开发完成 feat(lamp-web-max-vben): 个人中心 开发完成 体验网址 vben2 版 vben5 版 soybean 版 数据源模式 点我体验 点我体验 点我体验 字段模式 点我体验 点我体验 点我体验 本次升级功能预览 1.接口管理 2.接口日志 3.消息模版 4.我的应用 5.我的消息 6.消息管理 7.个性消息模版 8.员工维护 9.组织机构 10.岗位维护 11.个性字典 12.个性参数 13.角色权限维护 14.操作日志 15.登录日志 16.个人中心 关于 lamp 灯灯(简称灯,英文名:lamp),她是一个项目集,为满足高内聚低耦合设计原则,将一个大项目拆解为以下几个子项目: lamp-util:后端工具集 lamp-cloud:基于 Spring Cloud 实现的后台 lamp-boot:基于 Spring Boot 实现的后台 lamp-job:基于 xxl-job 集成本项目的分布式定时任务 lamp-generator:代码生成器 lamp-web:前端 lamp-cloud简介 lamp-cloud是基于SpringCloudAlibaba、SpringCloud、SpringBoot开发的微服务中后台快速开发平台,支持jdk17、jdk11和jdk8,专注于多租户 (SaaS 架构) 解决方案,亦可作为普通项目(非 SaaS 架构)的基础开发框架使用,目前已实现数据库隔离、字段隔离等租户隔离方案以及非租户隔离的解决方案。 她拥有自研 RBAC(基于租户应用的角色权限控制体系)、网关统一鉴权、数据权限、优雅缓存解决方案、防缓存击穿、前后端统一表单校验、字典数据自动回显、可视化前后端代码生成器、支持多种文件存储、支持多种短信邮件发送接口、灰度发布、防 XSS 攻击、防 SQL 注入、分布式事务、分布式定时任务等功能;支持多业务系统并行开发,支持多服务并行开发,是中后台系统开发脚手架的最佳选择。 lamp-cloud 代码简洁,注释齐全,架构清晰,非常适合个人学习以及中小企业作为基础框架使用。采用 Spring Cloud Alibaba、SpringBoot、Mybatis、Seata、Sentinel、RabbitMQ、FastDFS/MinIO、SkyWalking 等主要框架和中间件。本项目旨在实现基础框架能力,不涉及具体业务。 关注项目 官网:https://tangyh.top 源码:https://github.com/dromara/lamp-cloud 源码:https://gitee.com/dromara/lamp-cloud

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册