首页 文章 精选 留言 我的

精选列表

搜索[Harness工程],共10000篇文章
优秀的个人博客,低调大师

20 年 Java 工程师的经验有什么用

赠书啦,欢迎大家在评论区聊聊「关于 Java 开发的故事」,畅所欲言 我们将在评论区随机选出 3 名 OSCer,赠送《Spring Boot + MVC + Vue3 项目全流程开发指南》一本 活动截止时间:3 月 5 日 18:00 编码规范 1.Java开发规范 Java开发规范主要是为了保证代码的质量和可读性,并提高团队协作的效率,具体做法如下。 1) 使用驼峰式命名法命名Java类、方法和变量。 2) 确保代码格式一致,使用制表符或空格字符进行缩进,其中缩进使用4个空格字符。 3) 不能省略大括号,避免出现错误的复合语句。 4) 避免使用长行代码,在必要时使用换行符。 5) 有效地运用空格来分隔代码。 6) 每个方法只处理一项任务。 7) 不要使用过时的语言特性。 8) 使用final关键字来定义不允许修改的变量。 2.版权规范 版权规范主要是为了保证项目的知识产权,防止代码被恶意复制或盗用,具体做法如下。 1) 在项目中使用合适的授权许可证。 2) 对使用的开源代码进行审查。 3) 声明代码版权信息。 4) 声明禁止将代码用于商业用途。 3.命名规范 命名规范主要是为了增加代码的可读性,降低维护成本,具体做法如下。 1) Java类名采用大驼峰式命名法,命名规则为:名称(如业务名或功能名) + 动词 +层级后缀。例如:在控制层管理员管理模块,那么它的类名是AdminManageController,其中Admin是业务名、Manage是动词、Controller控制层后缀。 2) Java方法名采用小驼峰式命名法,命名规则为:动词 + 名称(如业务名或功能名) + 业务数据结构名(可选),例如:获取管理员列表方法,那么它的方法名是getAdminList,其中get是动词、Admin是业务名、List是业务数据结构名。 3) Java变量名采用小驼峰式命名法。 4) 常量名采用大写字母,多个单词使用下划线进行分隔。 5) 所有名称都尽量采用实际业务名或功能名。 4.注释规范 注释规范主要是为了增加代码的可读性和可维护性,具体做法如下。 1) 对类和方法进行注释,包括功能、输入参数和输出值等。 2) 对复杂代码片段进行注释。 3) 注释应精简、清晰。 4) 注释应该与代码保持一致。 5) 不要编写过多或者毫无意义的注释。 6) 在代码中使用符合标准的单行注释和多行注释。 7)在代码变动时,更新注释的内容。 版本控制 版本控制(Version Control)是一种管理和控制代码或文档的历史版本和变更记录的工具。它可以帮助开发团队在开发过程中管理代码的变更、跟踪项目的历史记录、协作开发,以及解决代码冲突等问题。 1.版本 版本是指软件的不同发布状态。每个版本都代表着软件在某个时间点的特定状态,包括功能、修复和改进。这里的软件是指一组文件或代码,那么软件版本是指一组文件或代码在某一时刻的状态,它记录了文件或代码的修改历史。 每个版本都会有一个编号,这个编号叫版本号。版本号是用来标识和区分不同软件版本的一组数字。通常包括主版本号、次版本号、修订号和构建号,有时也可以有其他标识。以下是一些常见的版本号定义规则。 1)主版本号:表示重大功能改变或架构变化,一般在大幅度重构或设计变更时增加。 2)次版本号:表示较大规模功能添加或修改,一般在添加新功能时增加。 3)修订号:表示小规模的修改或问题修复,一般在bug修复或小功能改进时增加。 4)构建号:表示每次编译生成的唯一标识符,每次构建都会增加。 版本号的定义规则可以根据具体项目和团队的需求进行定制。常见的规则包括“主.次.修订”格式(如1.0.0),也有日期格式(如2022-01-01)等。 版本号具有以下重要意义。 1)识别不同版本:通过不同的版本号,可以清楚地区分和识别不同软件发布状态,帮助用户选择合适的软件版本。 2)管理功能变更:通过对每个版本进行编号,可以追踪和管理软件中引入的新功能、修改和删除旧功能。 3)问题追踪与修复:通过对每个修订号进行编号,可以追踪和管理问题报告,并将问题与特定版本关联起来。 4)兼容性管理:通过比较不同软件版本之间的差异,可以帮助开发人员确保向后兼容性,并确保用户能够平滑升级到新版。 总之,版本和版本号在商业软件项目中起着至关重要的作用,它们能够帮助开发团队更好地管理、追踪和控制软件发布过程中的各种变化。 2.版本分支 版本分支是指在开发软件时,为了同时进行多个开发任务或者为了管理不同版本之间的差异而在主干代码基础上创建的一个独立的代码分支。 版本分支通常是从主干代码中某个时间点创建的,可以在分支上独立地进行开发、测试、修复问题等工作,而不影响主干代码。同时,版本分支也可以合并回主干代码中,将各个分支的修改内容整合在一起。 以下是一些常见的版本分支定义规则。 1)主干代码:通常是指软件的主要代码线,包含稳定的功能和修复过的问题。主干代码不允许直接修改和提交。 2)版本分支:通常是指从主干代码创建出来并用于独立开发或管理不同版本之间差异的独立代码分支。版本分支可以自由修改和提交。 3)特性分支:通常是指用于实现某个特定功能或任务而从版本分支上创建出来的独立代码分支。特性分支可以自由修改和提交。 4)发布标签:通常是指一个标记点,用于标记在特定时间点上,主干或者某个特定版本分支的打包发布。 版本分支具有以下重要意义。 1)同时进行多项开发任务:通过创建不同的版本分支,在不同的开发任务之间切换和管理,使得团队成员可以更高效地同时进行多项开发任务。 2)管理不同软件版本:通过将不同软件版本保存在各自的版本分支上,并合并回主干或其他相应发布时,在保证稳定性和可靠性的同时实现对各种需求变化及时响应。 3)保持发布历史记录:为每次发布的软件版本打标签,非常利于在以后追踪发布历史记录。 4)方便问题追踪与修复:通过对每个特性分支、修订号等进行编号,可以追踪和管理问题报告,并将问题与特定的功能、任务、发布相关联起来。 总之,版本分支是一种重要的软件管理机制,在软件开发过程中可以帮助团队更好地控制软件发布中的各种变化。正确使用版本分支能够有效提高团队协作效率,并确保项目的高质量、可靠。 3.版本合并 版本合并(Merge)是指将两个或多个不同的代码版本合并为一个新的版本。在软件开发过程中,版本合并是一个非常常见的操作,特别是在多人协作开发或者分支开发的情况下。 版本合并有以下一些执行规则和意义。 1) 版本合并必须基于一个共同的祖先版本进行的。即需要先找到两个或多个版本之间的共同祖先,然后将其分别与目标版本进行合并。 2) 版本合并时需要注意代码冲突。如果两个或多个版本中都对同一段代码进行了修改,则需要手动解决代码冲突。 3) 版本合并后必需进行测试和验证。合并后的代码可能会出现新的问题,需要对其进行测试和验证。 4) 版本合并可以使得不同分支之间的代码得以相互融合。这可以提高团队协作开发效率,避免重复工作。 5) 版本合并可以使得不同分支之间相互独立。这可以避免在修改某个功能时影响到其他功能。 6) 版本合并可以保留历史记录。每次合并都会生成一个新的版本,这样就能够保留历史记录,方便以后查看和追溯。 总之,版本合并是非常重要的操作,能够提高团队协作开发效率、避免重复工作、保留历史记录等。同时,在进行版本合并时需要注意遵守一些规则,以保证代码质量和稳定性。 4.版本冲突 版本冲突是指多人同时修改同一个文件的同一部分时会出现不同的版本。当试图将这些不同版本合并时,就会出现冲突。版本冲突是软件开发中非常常见的问题。 版本冲突有以下一些执行规则和注意事项。 1) 当多人修改同一个文件的同一部分时,会自动检测到冲突。 2) 版本冲突需要手动解决。 3) 解决版本冲突需要仔细分析和比较不同版本之间的差异,保留所有有用的修改,并将其合并为一个新的版本。 4) 解决版本冲突需要与其他开发人员协作进行代码审查、讨论、测试等操作。 5) 解决版本冲突可以提高代码质量和稳定性,避免代码错误和漏洞。 总之,在软件开发中,避免或解决版本冲突是非常重要的问题。只有通过合理协作、认真分析、细致比较等方式来解析这个问题,才能保证团队协作开发效率、提高代码质量和稳定性,并且确保软件项目成功完成。 5.中央式版本控制 中央式版本控制是一种常见的软件版本控制方式,也被称为集中式版本控制。 中央式版本控制通常使用客户端-服务器架构。开发者在本地使用客户端工具从中央服务器下载代码,进行开发和修改,再将修改后的代码上传到中央服务器。在上传之前,需要先从中央服务器上获取最新的代码,并进行合并和冲突解决。 现在广泛使用的软件产品是Subversion(SVN)。Subversion是一个流行的中央式版本控制系统,被广泛应用于软件开发和源码管理。它具有稳定性高、可靠性好、易于使用等特点。 虽然中央式版本控制在很长一段时间内是主流版本控制方式,但它也存在一些问题。例如,在分支管理、合并、离线工作等方面存在一些不便之处。因此,在当今软件开发领域也出现了另一种主流的版本控制方式——分布式版本控制系统(例如Git),其具有更加灵活、高效和便利等优点。 6.分布式版本控制 分布式版本控制是一种较新的版本控制方式,其与中央式版本控制的不同点在于,分布式版本控制将代码库完全复制到每个开发者的本地机器上,每个开发者都可以在本地创建、合并分支,并且在不需要连接到中央服务器的情况下进行代码比较和版本历史查看等操作。当然,在需要和其他开发者共享代码时,分布式版本控制系统也提供了一些便利的方式。 当一个开发者需要与其他开发者共享代码时,他可以将自己本地修改后的代码推送到其他人所在机器上,并将自己修改后的代码合并到他人机器上。因此,分布式版本控制系统可以让每个开发者都有完整的代码库备份,避免了单点故障。 Git是最流行和广泛使用的分布式版本控制系统之一,其拥有快速、高效、强大等优点,在大型团队协作和复杂项目管理方面表现出色。 综上所述,版本控制是软件开发中不可或缺的一部分。通过版本控制工具,团队成员可以更好地管理代码和文档,同时也可以提高开发效率和代码质量。本书项目使用Git进行版本控制。 以上内容节选自《Spring Boot + MVC + Vue3 项目全流程开发指南》 作者:花树峰 《Spring Boot + MVC + Vue3 项目全流程开发指南》 花树峰 具有20年以上软件开发经验,技术底蕴深厚、项目管理经验丰富。大学毕业后,历任Java程序员、高级软件开发师、产品经理、客户项目经理、技术经理、技术总监、创业公司合伙人等。精通Java、PHP、Python、Spring、Spring Boot、Spring MVC、MyBatis、Thymeleaf、MySQL、MongoDB等主流技术。曾在惠普、华数集团从事项目开发和产品经理工作,参与研发了“日本电信管理平台”(大型企业应用)、“华数互动电视平台”(大型视频互动平台)、“优猜”(社交类APP)、“木禾建站”(可快速建设在线商城的SaaS平台)等各种大型商业软件应用。 本书全面概述了软件项目开发的全流程,全书共13章,包括项目开发概述、开发规范、开发技术、需求分析、架构与目录结构设计、数据库表结构设计、详细功能设计、技术框架选型、初始化与底层搭建、业务代码开发、单元测试开发、性能测试和部署等内容。书中以实际项目为例,结合理论知识和实践操作,为读者提供了一条清晰、完整的项目开发学习路线。本书不仅详细介绍了各环节的具体操作和技巧,还强调了按照规范进行操作的重要性,以确保项目开发的标准化和高质量。

优秀的个人博客,低调大师

测试工程师在敏捷项目中扮演什么角色

敏捷团队中的测试人员主要负责执行各种测试,以满足“已完成”的定义,从而为团队在重复迭代中努力交付的持续价值创造做出贡献。对于测试人员来说,拥有敏捷的心态是至关重要的,如果没有敏捷的思维方式,他们可能就不能果断地计划、划分优先级并执行他们的任务,因此会无意中影响团队满足迭代目标的能力。敏捷的思维方式是测试人员展示正确行为的先决条件,这些行为能够加速整个团队的性能。 为了在敏捷项目中取得成功,测试人员应该关注以下实践: 1.态度胜过一切 团队中的测试人员可能不具备敏捷背景、自动化技能或丰富的测试经验——只要他们具备成为敏捷团队一员的正确态度,这仍然是可以的。正确的态度会反映在以下行为中,比如:相信敏捷宣言和实践,信任教练并全力以赴地遵循它,对新的学习和变化持开放态度,清晰表达和透明,致力于对团队重要的活动,在这段时间内主动改进和变得更好等等。 敏捷、自动化、测试或其他培训,对于拥有正确态度的人来说,是可以齐头并进的。 根据我的经验,在工作中使用僵化思维的测试人员减慢了迭代的进度。有些行为是——仅在ALM工具中更新状态时才测试缺陷;在测试环境关闭时,闲置而不在本地主机上执行健全性测试;考虑在会议期间单独测试活动;在部署时坚持团队成员的正式沟通,阻止决议和暗示等。 相反,以开放的心态来的测试人员转变了自己,为团队服务,并以各种可能的方式做出贡献,例如,他们中的一些人在空闲时间编写Junit案例来帮助开发人员,学会编写服务来模拟测试环境,在高度动态的环境中灵活调整计划和测试方法。 2.将迭代目标优先于外部分配 在矩阵式组织结构中,测试人员在敏捷团队中与Scrum Master一起工作,但他们向测试实践部门的直线经理或同一项目中的测试经理报告。这些在敏捷团队中驱动整体测试的测试经理,可能会给测试人员分配许多与团队迭代计划不一致的特别任务。 在我与测试人员的多次接触中,我发现他们很难在两方面之间取得平衡——兼顾绩效评估和致力于工作。他们中的大多数人都试图在没有通知敏捷团队的情况下承担外部任务,因为他们不想让直线经理不高兴。一些人知道它会影响正在进行的迭代活动,于是通过延长工作时间即加班来完成这些任务,但也有很多人牺牲了迭代活动。由于这种妥协,他们无法交付迭代目标,这导致了用户故事的常规溢出,也影响了团队的信任和内聚水平。 在这种情况下,测试人员应该怎么做?答案是——迭代活动应该总是优先于任何其他活动。但是,如果他们能够在不影响迭代目标的情况下完成外部任务,那么他们就可以继续!但是,如果外部任务有可能影响迭代目标,那么他们应该咨询团队以获得集体同意或意见分歧,并将决策告知直线经理。 3.跨职能团队中的关系平等 “我不能测试这个用户故事,因为开发人员没有部署它”,一个测试人员在每日站会中说,开发人员回答说:“抱歉,我忘了它,但你也应该联系其他开发人员来完成。”。这个场景突出了团队缺乏协作和所有权。推动一个用户故事的完成并消除间歇的阻碍因素并不是个人的责任,而是团队的努力,作为团队一部分的测试人员也不例外。 测试人员的某些行为有助于加快交付速度——无论是否与测试相关,都需要关注到阻碍因素;经常与开发人员同步,而不是通过电子邮件沟通;积极参加scrum会议以提高团队的决策能力,与团队的计划保持一致,从而使他们的活动保持一致等等。 一些与其他团队过度交往的测试人员更喜欢挑选低优先级的任务。因为他们需要花费数小时来解决其他团队的问题,却以牺牲自己的工作为代价——这种行为超出了在跨职能团队中作为平等伙伴的边缘。团队成员应该优先解决他们的问题,如果需要的话,为其他团队提供帮助应该是次要的目标。 4.假设并不是一种选择 有时,利益相关者的评审意见显示,团队在验收标准方面存在一些不必要的假设。假设不是特定的对测试人员的选择,因为测试是工作流中的最后一个活动,因此也是团队中任何人验证需求的最后机会。此外,测试人员的专长在于发现有问题的可交付成果。 我了解一些让测试人员陷入不合理假设的根本原因。这些原因是:害怕被人评判他们提出正确问题的能力,对他们以前的问题没有得到适当的答复,沟通能力差,使他们无法抓住任何机会,缺乏一个安全的环境来公开挑战接受标准,或者在积压工作改进会议期间无知,不提出问题需要澄清的问题。 在敏捷项目中,假设的成本太高了,因为产品增量很快就会推出给最终客户——交付的任何缺陷都会影响投资回报(ROI),并需要返工,消耗的预算超过了功能的价值。 迭代经理、ScrumMaster或教练使用诸如5个为什么之类的技术对这些根本原因进行彻底的分析,对于设计有效的指导计划和在随后的迭代中控制这些行为非常有益。

优秀的个人博客,低调大师

云原生 AI 工程化实践之 FasterTransformer 加速 LLM 推理

01 背景 OpenAI 在 3 月 15 日发布了备受瞩目的 GPT4,它在司法考试和程序编程领域的惊人表现让大家对大语言模型的热情达到了顶点。人们纷纷议论我们是否已经跨入通用人工智能的时代。与此同时,基于大语言模型的应用也如雨后春笋般出现,为我们带来了协同办公、客服对话、语言翻译、内容生成等方面前所未有的畅快体验。 然而,当我们享受着大语言模型带来的普惠 AI 能力时,它也给开发者们带来了前所未有的挑战。随着模型不断增大,计算量也达到了空前的高度,直接导致推理时间变长。为了解决大语言模型推理的延迟问题,业界已经提供了一些解决方案,比如 Tensorrt、FasterTransformer 和 vllm。为了帮助用户解决云原生系统中的大语言模型推理加速问题,云原生 AI 套件引入了 FasterTransformer 推理加速方案。 本文将在 ACK 容器服务上,以 Bloom7B1 模型为例展示如何使用 FasterTransformer 进行推理加速。本例中会使用以下组件: Arena Arena 是基于 Kubernetes 的机器学习轻量级解决方案,支持数据准备、模型开发,模型训练、模型预测的完整生命周期,提升数据科学家工作效率。同时和阿里云的基础云服务深度集成,支持 GPU 共享、CPFS 等服务,可以运行阿里云优化的深度学习框架,最大化使用阿里云异构设备的性能和成本的效益。更多 arena 信息,可以参考云原生 AI 套件开发者使用指南[1]。 Triton Server Triton Server为Nvidia 提供了机器学习推理引擎,可以支持 Tensorflow、Pytorch、Tensorrt 和 Fastertransformer 多种 backend。云原生 AI 套件已经将 Triton Server 加入到 Arena 中,用户可以通过简单的命令行或 SDK 来在云原生系统中完成 Triton Server 服务的拉起、运维和监控。更多 AI 套件中使用 Triton Server 信息,可以参考部署 PyTorch 模型推理服务[2]。 FasterTransformer FasterTransformer 是真对于 Transofrmer 类型模型(也包括 encoder-only、decoder-only)的推理加速方案,其提供了 Kernel Fuse、Memory reuse、kv cache、量化等多种优化方案,同时也提供了 Tensor Parallel 和 Pipeline Parallel 两种分布式推理方案。本文将介绍如何在云原生 AI 套件中使用 FasterTransformer 进行模型的推理加速。 02 环境准备 环境准备分为两个部分,第一个部分是创建包含 GPU 的 Kubernetes 集群[3]和安装云原生 AI 套件[4],第二个部分是从 huggingface 官网下载 bloom-7b1 模型。 模型的下载命令如下: git lfs install git clone git@hf.co:bigscience/bloom-7b1 通过上面的命令,可以将 huggingface repo 中的文件下载到本地: 下载完成后,我们将 bloom-71 文件夹上传到 OSS 中,作为推理时的共享存储,OSS 的使用可以参考开始使用 OSS[5]。 上传到 OSS 之后,分别创建名称为 bloom7b1-pv 和 bloom7b1-pvc 的 PV 和 PVC,以用于推理服务的容器挂载。具体操作,请参见使用 OSS 静态存储卷[6]。 03 模型转换 FasterTransformer 本质上是对模型的重写,它通过 CUDA、cuDNN 和 cuBLAS 重写了 Transformer 模型结构,因此其具有自己的模型结构和模型参数的描述方式。而我们的模型一般是通过 Pytorch、Tesorflow、Megatron 或 huggingface 这样的训练框架产出,其往往又具有自己单独的一套模型结构和参数的表达,因此在使用FasterTransformer时,就需要将模型原有的 checkpoint 转换为 FasterTransformer 的结构。 FasterTransformer 中已经支持了多种类型的转换脚本,这里我们使用 FasterTransofrmer 提供的 examples/pytorch/gpt/utils/huggingface_bloom_convert.py。 云原生 AI 套件已经接入了上述的转换逻辑,因此,通过如下脚本即可完成一次模型的转换。 arena submit pytorchjob\ --gpus=1\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name convert-bloom\ --workers 1\ --namespace default-group\ --data bloom-pvc:/mnt\ 'python /FasterTransformer/examples/pytorch/gpt/utils/huggingface_bloom_convert.py -i /mnt/model/bloom-7b1 -o /mnt/model/bloom-7b1-ft-fp16 -tp 2 -dt fp16 -p 64 -v' 通过 arena log 来观察转换的日志: $arena logs -n default-group convert-bloom ======================= Arguments ======================= - input_dir...........: /mnt/model/bloom-7b1 - output_dir..........: /mnt/model/bloom-7b1-ft-fp16 - tensor_para_size....: 2 - data_type...........: fp16 - processes...........: 64 - verbose.............: True - by_shard............: False ========================================================= loading from pytorch bin format model file num: 2 - model.pre_decoder_layernorm.bias................: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.pre_decoder_layernorm.bias.bin - model.layers.0.input_layernorm.weight...........: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.input_layernorm.weight.bin - model.layers.0.attention.dense.bias.............: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.dense.bias.bin - model.layers.0.input_layernorm.bias.............: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.input_layernorm.bias.bin - model.layers.0.attention.query_key_value.bias...: shape (3, 2048) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.query_key_value.bias.0.bin (0/2) - model.layers.0.post_attention_layernorm.weight..: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.post_attention_layernorm.weight.bin - model.layers.0.post_attention_layernorm.bias....: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.post_attention_layernorm.bias.bin - model.layers.0.mlp.dense_4h_to_h.bias...........: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.mlp.dense_4h_to_h.bias.bin - model.layers.0.mlp.dense_h_to_4h.bias...........: shape (8192,) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.mlp.dense_h_to_4h.bias.0.bin (0/2) - model.layers.0.attention.query_key_value.bias...: shape (3, 2048) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.query_key_value.bias.1.bin (1/2) 通过 arena list 命令查看转换是否执行结束: NAME STATUS TRAINER DURATION GPU(Requested) GPU(Allocated) NODE convert-bloom SUCCEEDED PYTORCHJOB 3m 1 N/A 192.168.123.35 转换完成后,会在 OSS 上创建一个 model/arena/bloom-7b1-ft-fp16 文件夹,文件中会存储 FasterTransofrmer 所对应的 checkpoint。 04 性能对比 此时,我们的 OSS 上已经有两份 bloom-7b1 checkpoint,一份是 bloom-7b 文件夹存储了 huggingface 原生的 checkpoint,另一份是 bloom-7b-ft-fp16 文件夹存储了转换后的 FasterTransformer 的 checkpoint。我们将使用这两份 checkpoint 进行性能对比,看一下来 FasterTransformer 是否能够带来性能的提升。 性能对比使用 Fastertransformer 提供的 examples/pytorch/gpt/bloom_lambada.py,我们也已经集成到了 AI 套件中。这里我们分别提交两个性能评测命令。对 Huggingface Bloom-7b1 评测的命令: arena submit pytorchjob\ --gpus=2\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name perf-hf-bloom \ --workers 1\ --namespace default-group\ --data bloom7b1-pvc:/mnt\ 'python /FasterTransformer/examples/pytorch/gpt/bloom_lambada.py \ --tokenizer-path /mnt/model/bloom-7b1 \ --dataset-path /mnt/data/lambada/lambada_test.jsonl \ --batch-size 16 \ --test-hf \ --show-progress' 查看 HuggingFace 的结果: $arena -n default-group logs -t 5 perf-hf-bloom Accuracy: 57.5587% (2966/5153) (elapsed time: 173.2149 sec) 对 Fastertransformer Blooom-7b 评测的命令: arena submit pytorchjob\ --gpus=2\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name perf-ft-bloom \ --workers 1\ --namespace default-group\ --data bloom7b1-pvc:/mnt\ 'mpirun --allow-run-as-root -n 2 python /FasterTransformer/examples/pytorch/gpt/bloom_lambada.py \ --lib-path /FasterTransformer/build/lib/libth_transformer.so \ --checkpoint-path /mnt/model/2-gpu \ --batch-size 16 \ --tokenizer-path /mnt/model/bloom-7b1 \ --dataset-path /mnt/data/lambada/lambada_test.jsonl \ --show-progress' 查看 FasterTransformer 的结果,可以看见带来了 2.5 倍的性能提升。 $arena -n default-group logs -t 5 perf-ft-bloom Accuracy: 57.6363% (2970/5153) (elapsed time: 68.7818 sec) 通过结果对比可以看见,Fastertransformer 与原生的 Huggingface 相比有比较明显的性能提升。 05 模型部署 在这一小节,我们使用 Triton Server 对 FasterTransformer 进行部署,Triton Server 中原生并不支持 FasterTransformer 的 backend,需要我们配合 Nvidia 提供的 Fastertransformer backend 来使用。通过使用 FasterTransformer backend,Triton Server 不再进行 GPU 资源的分配,FasterTransformer backend 会根据 CUDA_VISIBLE_DEVICES 判断当前可用 GPU 资源,并分配给对应的 RANK 来执行分布式的推理。 FasterTransformer 对应的模型 Repo 目录如下所示: ├── model_repo │ └── fastertransformer │ ├── 1 │ │ └── config.ini │ └── config.pbtxt 使用功能 Arena 的如下命令来启动 FasterTransformer: arena serve triton \ --namespace=default-group \ --version=1 \ --data=bloom7b1-pvc:/mnt \ --name=ft-triton-bloom \ --allow-metrics \ --gpus=2 \ --replicas=1 \ --image=ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/triton_with_ft:22.03-main-2edb257e-transformers \ --model-repository=/mnt/triton_repo 通过 kubectl logs,我们可以看到 triton server 的部署日志,通过日志可以看到,triton server 启动了两个 gpu 来进行分布式推理。 I0721 08:57:28.116291 1 pinned_memory_manager.cc:240] Pinned memory pool is created at '0x7fd264000000' with size 268435456 I0721 08:57:28.118393 1 cuda_memory_manager.cc:105] CUDA memory pool is created on device 0 with size 67108864 I0721 08:57:28.118403 1 cuda_memory_manager.cc:105] CUDA memory pool is created on device 1 with size 67108864 I0721 08:57:28.443529 1 model_lifecycle.cc:459] loading: fastertransformer:1 I0721 08:57:28.625253 1 libfastertransformer.cc:1828] TRITONBACKEND_Initialize: fastertransformer I0721 08:57:28.625307 1 libfastertransformer.cc:1838] Triton TRITONBACKEND API version: 1.10 I0721 08:57:28.625315 1 libfastertransformer.cc:1844] 'fastertransformer' TRITONBACKEND API version: 1.10 I0721 08:57:28.627137 1 libfastertransformer.cc:1876] TRITONBACKEND_ModelInitialize: fastertransformer (version 1) I0721 08:57:28.628304 1 libfastertransformer.cc:372] Instance group type: KIND_CPU count: 1 I0721 08:57:28.628326 1 libfastertransformer.cc:402] Sequence Batching: disabled I0721 08:57:28.628334 1 libfastertransformer.cc:412] Dynamic Batching: disabled I0721 08:57:28.661657 1 libfastertransformer.cc:438] Before Loading Weights: +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Backend | Path | Config | +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ | fastertransformer | /opt/tritonserver/backends/fastertransformer/libtriton_fastertransformer.so | {"cmdline":{"auto-complete-config":"true","min-compute-capability":"6.000000","backend-directory":"/opt/tritonserver/backends","default-max-batch-size":"4"}} | +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ I0721 09:01:19.653743 1 server.cc:633] +-------------------+---------+--------+ | Model | Version | Status | after allocation : free: 7.47 GB, total: 15.78 GB, used: 8.31 GB +-------------------+---------+--------+ | fastertransformer | 1 | READY | +-------------------+---------+--------+ I0721 09:01:19.668137 1 metrics.cc:864] Collecting metrics for GPU 0: Tesla V100-SXM2-16GB I0721 09:01:19.668167 1 metrics.cc:864] Collecting metrics for GPU 1: Tesla V100-SXM2-16GB I0721 09:01:19.669954 1 metrics.cc:757] Collecting CPU metrics I0721 09:01:19.670150 1 tritonserver.cc:2264] +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Option | Value | +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | server_id | triton | | server_version | 2.29.0 | | server_extensions | classification sequence model_repository model_repository(unload_dependents) schedule_policy model_configuration system_shared_memory cuda_shared_memory binary_tensor_data statistics trace logging | | model_repository_path[0] | /mnt/triton_repo | | model_control_mode | MODE_NONE | | strict_model_config | 0 | | rate_limit | OFF | | pinned_memory_pool_byte_size | 268435456 | | cuda_memory_pool_byte_size{0} | 67108864 | | cuda_memory_pool_byte_size{1} | 67108864 | | response_cache_byte_size | 0 | | min_supported_compute_capability | 6.0 | | strict_readiness | 1 | | exit_timeout | 30 | +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ I0721 09:01:19.672326 1 grpc_server.cc:4819] Started GRPCInferenceService at 0.0.0.0:8001 I0721 09:01:19.672597 1 http_server.cc:3477] Started HTTPService at 0.0.0.0:8000 I0721 09:01:19.714356 1 http_server.cc:184] Started Metrics Service at 0.0.0.0:8002 06 服务请求 启动 forward 进行验证: # 使用 kubectl 启动port-forward kubectl -n default-group port-forward svc/ft-triton-bloom-1-tritoninferenceserver 8001:8001 这里我们使用 Triton Server 提供的 python SDK 所编写的脚本来向 Triton Server 发起请求。脚本中主要完成三件事情: 通过 huggingface 中 bloom-7b1 对应的分词器对 query 进行分词和 token 转换 通过 triton server SDK 向 triton server 发起请求 通过分词器对 output token 进行转换,拿到最终的结果 import os, sys #from tkinter import _Padding import numpy as np import json import torch #import tritongrpcclient import argparse import time from transformers import AutoTokenizer import tritonclient.grpc as grpcclient # create tokenizer tokenizer = AutoTokenizer.from_pretrained('/mnt/model/bloom-7b1', padding_side='right') tokenizer.pad_token_id = tokenizer.eos_token_id def load_image(img_path: str): """ Loads an encoded image as an array of bytes. """ return np.fromfile(img_path, dtype='uint8') def tokeninze(query): # encode encoded_inputs = tokenizer(query, padding=True, return_tensors='pt') input_token_ids = encoded_inputs['input_ids'].int() input_lengths = encoded_inputs['attention_mask'].sum( dim=-1, dtype=torch.int32).view(-1, 1) return input_token_ids.numpy().astype('uint32'), input_lengths.numpy().astype('uint32') if __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument("--model_name", type=str, required=False, default="fastertransformer", help="Model name") parser.add_argument("--url", type=str, required=False, default="localhost:8001", help="Inference server URL. Default is localhost:8001.") parser.add_argument('-v', "--verbose", action="store_true", required=False, default=False, help='Enable verbose output') args = parser.parse_args() # 1.创建client try: triton_client = grpcclient.InferenceServerClient( url=args.url, verbose=args.verbose) except Exception as e: print("channel creation failed: " + str(e)) sys.exit(1) output_name = "OUTPUT" # 2) 设置input inputs = [] ## 2.1) input_ids query="deepspeed is" input_ids, input_lengths = tokeninze(query) inputs.append(grpcclient.InferInput("input_ids", input_ids.shape, "UINT32")) inputs[0].set_data_from_numpy(input_ids) ## 2.2) input_length inputs.append(grpcclient.InferInput("input_lengths", input_lengths.shape, "UINT32")) inputs[1].set_data_from_numpy(input_lengths) ## 2.3) output length output_len=32 output_len_np = np.array([[output_len]], dtype=np.uintc) inputs.append(grpcclient.InferInput("request_output_len", output_len_np.shape, "UINT32")) inputs[2].set_data_from_numpy(output_len_np) # 3) 设置output outputs = [] outputs.append(grpcclient.InferRequestedOutput("output_ids")) # 4) 发起请求 start_time = time.time() results = triton_client.infer(model_name=args.model_name, inputs=inputs, outputs=outputs) latency = time.time() - start_time # 5) 结果处理:转化为numpy 类型,计算max,转化label output0_data = results.as_numpy("output_ids") print(output0_data.shape) result = tokenizer.batch_decode(output0_data[0]) print(result) 发起 client 请求命令如下: $python3 bloom_7b_client.py (1, 1, 36) ['deepspeed is the speed of the ship at the time of the collision, and the\ndeepspeed of the other ship is the speed of the other ship at the time'] 07 总结 本文我们通过 Bloom-7b1 模型展示了如何在云原生 AI 套件中使用 FasterTransformer 对大语言模型进行加速,通过与 HuggingFace 的版本对比可以带来 2.5 倍的性能提升。后续我们会逐步推出更多大模型相关的推理加速方案,以满足不同的业务需求,大家敬请期待。 相关链接: [1] 云原生 AI 套件开发者使用指南 https://help.aliyun.com/zh/ack/cloud-native-ai-suite/getting-started/cloud-native-ai-component-set-user-guide [2] 部署 PyTorch 模型推理服务 https://help.aliyun.com/zh/ack/cloud-native-ai-suite/user-guide/deploy-a-pytorch-model-as-an-inference-service?spm=a2c4g.11186623.0.0.2267225carYzgA [3] 创建包含 GPU 的 Kubernetes 集群 https://help.aliyun.com/zh/ack/ack-managed-and-ack-dedicated/user-guide/use-gpu-scheduling-in-ack-clusters#task-1664343 [4] 安装云原生 AI 套件 https://help.aliyun.com/document_detail/212117.htm#task-1917487 [5] 开始使用 OSS https://help.aliyun.com/zh/oss/getting-started/getting-started-with-oss [6] 使用 OSS 静态存储卷 https://help.aliyun.com/zh/ack/ack-managed-and-ack-dedicated/user-guide/mount-statically-provisioned-oss-volumes 作者:颜廷帅(瀚廷) 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | 基于 Vite3 的 Monorepo 前端工程搭建

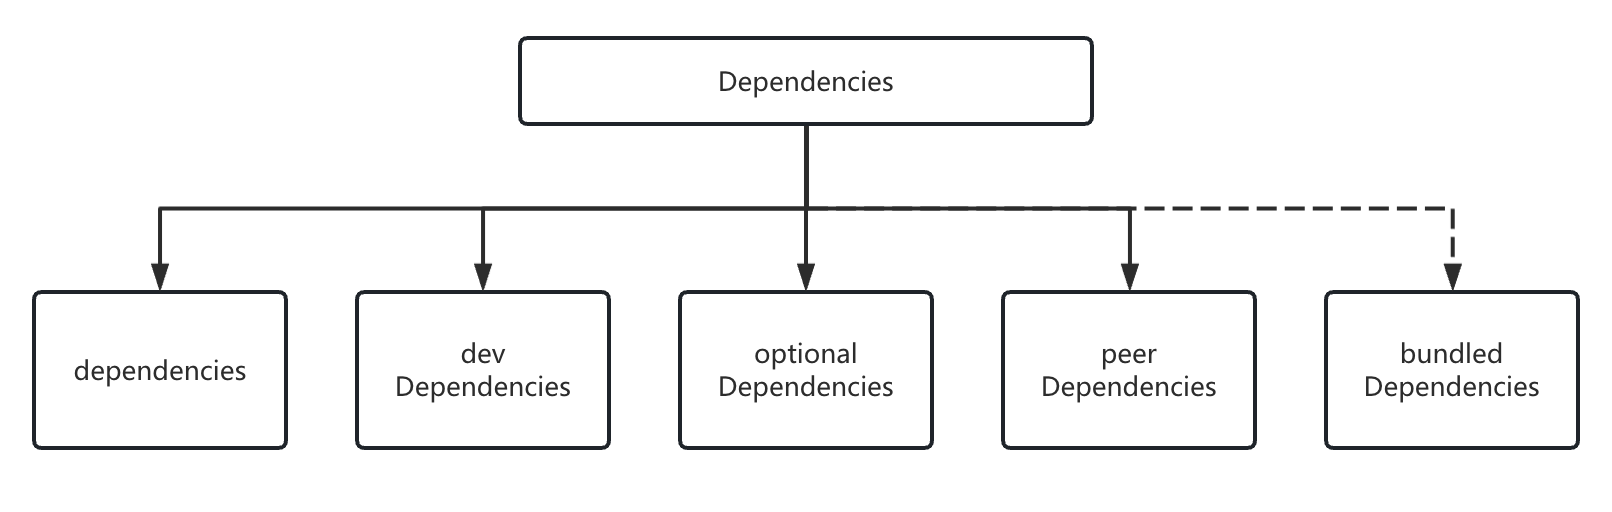
一、技术栈选择 1.代码库管理方式-Monorepo: 将多个项目存放在同一个代码库中 ▪选择理由1:多个应用(可以按业务线产品粒度划分)在同一个repo管理,便于统一管理代码规范、共享工作流 ▪选择理由2:解决跨项目/应用之间物理层面的代码复用,不用通过发布/安装npm包解决共享问题 2.依赖管理-PNPM: 消除依赖提升、规范拓扑结构 ▪选择理由1:通过软/硬链接方式,最大程度节省磁盘空间 ▪选择理由2:解决幽灵依赖问题,管理更清晰 3.构建工具-Vite:基于ESM和Rollup的构建工具 ▪选择理由:省去本地开发时的编译过程,提升本地开发效率 4.前端框架-Vue3:Composition API ▪选择理由:除了组件复用之外,还可以复用一些共同的逻辑状态,比如请求接口loading与结果的逻辑 5.模拟接口返回数据-Mockjs ▪选择理由:前后端统一了数据结构后,即可分离开发,降低前端开发依赖,缩短开发周期 二、目录结构设计:重点关注src部分 1.常规/简单模式:根据文件功能类型集中管理 ``` mesh-fe ├── .husky #git提交代码触发 │ ├── commit-msg │ └── pre-commit ├── mesh-server #依赖的node服务 │ ├── mock │ │ └── data-service #mock接口返回结果 │ └── package.json ├── README.md ├── package.json ├── pnpm-workspace.yaml #PNPM工作空间 ├── .eslintignore #排除eslint检查 ├── .eslintrc.js #eslint配置 ├── .gitignore ├── .stylelintignore #排除stylelint检查 ├── stylelint.config.js #style样式规范 ├── commitlint.config.js #git提交信息规范 ├── prettier.config.js #格式化配置 ├── index.html #入口页面 └── mesh-client #不同的web应用package ├── vite-vue3 ├── src ├── api #api调用接口层 ├── assets #静态资源相关 ├── components #公共组件 ├── config #公共配置,如字典/枚举等 ├── hooks #逻辑复用 ├── layout #router中使用的父布局组件 ├── router #路由配置 ├── stores #pinia全局状态管理 ├── types #ts类型声明 ├── utils │ ├── index.ts │ └── request.js #Axios接口请求封装 ├── views #主要页面 ├── main.ts #js入口 └── App.vue ``` 2.基于domain领域模式:根据业务模块集中管理 ``` mesh-fe ├── .husky #git提交代码触发 │ ├── commit-msg │ └── pre-commit ├── mesh-server #依赖的node服务 │ ├── mock │ │ └── data-service #mock接口返回结果 │ └── package.json ├── README.md ├── package.json ├── pnpm-workspace.yaml #PNPM工作空间 ├── .eslintignore #排除eslint检查 ├── .eslintrc.js #eslint配置 ├── .gitignore ├── .stylelintignore #排除stylelint检查 ├── stylelint.config.js #style样式规范 ├── commitlint.config.js #git提交信息规范 ├── prettier.config.js #格式化配置 ├── index.html #入口页面 └── mesh-client #不同的web应用package ├── vite-vue3 ├── src #按业务领域划分 ├── assets #静态资源相关 ├── components #公共组件 ├── domain #领域 │ ├── config.ts │ ├── service.ts │ ├── store.ts │ ├── type.ts ├── hooks #逻辑复用 ├── layout #router中使用的父布局组件 ├── router #路由配置 ├── utils │ ├── index.ts │ └── request.js #Axios接口请求封装 ├── views #主要页面 ├── main.ts #js入口 └── App.vue ``` 可以根据具体业务场景,选择以上2种方式其中之一。 三、搭建部分细节 1.Monorepo+PNPM集中管理多个应用(workspace) ▪根目录创建pnpm-workspace.yaml,mesh-client文件夹下每个应用都是一个package,之间可以相互添加本地依赖:pnpm install <name> packages: # all packages in direct subdirs of packages/ - 'mesh-client/*' # exclude packages that are inside test directories - '!**/test/**' ▪pnpm install #安装所有package中的依赖 ▪pnpm install -w axios #将axios库安装到根目录 ▪pnpm --filter | -F <name> <command> #执行某个package下的命令 ▪与NPM安装的一些区别: ▪所有依赖都会安装到根目录node_modules/.pnpm下; ▪package中packages.json中下不会显示幽灵依赖(比如tslib@types/webpack-dev),需要显式安装,否则报错 ▪安装的包首先会从当前workspace中查找,如果有存在则node_modules创建软连接指向本地workspace ▪"mock": "workspace:^1.0.0" 2.Vue3请求接口相关封装 ▪request.ts封装:主要是对接口请求和返回做拦截处理,重写get/post方法支持泛型 import axios, { AxiosError } from 'axios' import type { AxiosRequestConfig, AxiosResponse } from 'axios' // 创建 axios 实例 const service = axios.create({ baseURL: import.meta.env.VITE_APP_BASE_URL, timeout: 1000 * 60 * 5, // 请求超时时间 headers: { 'Content-Type': 'application/json;charset=UTF-8' }, }) const toLogin = (sso: string) => { const cur = window.location.href const url = `${sso}${encodeURIComponent(cur)}` window.location.href = url } // 服务器状态码错误处理 const handleError = (error: AxiosError) => { if (error.response) { switch (error.response.status) { case 401: // todo toLogin(import.meta.env.VITE_APP_SSO) break // case 404: // router.push('/404') // break // case 500: // router.push('/500') // break default: break } } return Promise.reject(error) } // request interceptor service.interceptors.request.use((config) => { const token = '' if (token) { config.headers!['Access-Token'] = token // 让每个请求携带自定义 token 请根据实际情况自行修改 } return config }, handleError) // response interceptor service.interceptors.response.use((response: AxiosResponse<ResponseData>) => { const { code } = response.data if (code === '10000') { toLogin(import.meta.env.VITE_APP_SSO) } else if (code !== '00000') { // 抛出错误信息,页面处理 return Promise.reject(response.data) } // 返回正确数据 return Promise.resolve(response) // return response }, handleError) // 后端返回数据结构泛型,根据实际项目调整 interface ResponseData<T = unknown> { code: string message: string result: T } export const httpGet = async <T, D = any>(url: string, config?: AxiosRequestConfig<D>) => { return service.get<ResponseData<T>>(url, config).then((res) => res.data) } export const httpPost = async <T, D = any>( url: string, data?: D, config?: AxiosRequestConfig<D>, ) => { return service.post<ResponseData<T>>(url, data, config).then((res) => res.data) } export { service as axios } export type { ResponseData } ▪useRequest.ts封装:基于vue3 Composition API,将请求参数、状态以及结果等逻辑封装复用 import { ref } from 'vue' import type { Ref } from 'vue' import { ElMessage } from 'element-plus' import type { ResponseData } from '@/utils/request' export const useRequest = <T, P = any>( api: (...args: P[]) => Promise<ResponseData<T>>, defaultParams?: P, ) => { const params = ref<P>() as Ref<P> if (defaultParams) { params.value = { ...defaultParams, } } const loading = ref(false) const result = ref<T>() const fetchResource = async (...args: P[]) => { loading.value = true return api(...args) .then((res) => { if (!res?.result) return result.value = res.result }) .catch((err) => { result.value = undefined ElMessage({ message: typeof err === 'string' ? err : err?.message || 'error', type: 'error', offset: 80, }) }) .finally(() => { loading.value = false }) } return { params, loading, result, fetchResource, } } ▪API接口层 import { httpGet } from '@/utils/request' const API = { getLoginUserInfo: '/userInfo/getLoginUserInfo', } type UserInfo = { userName: string realName: string } export const getLoginUserInfoAPI = () => httpGet<UserInfo>(API.getLoginUserInfo) ▪页面使用:接口返回结果userInfo,可以自动推断出UserInfo类型, // 方式一:推荐 const { loading, result: userInfo, fetchResource: getLoginUserInfo, } = useRequest(getLoginUserInfoAPI) // 方式二:不推荐,每次使用接口时都需要重复定义type type UserInfo = { userName: string realName: string } const { loading, result: userInfo, fetchResource: getLoginUserInfo, } = useRequest<UserInfo>(getLoginUserInfoAPI) onMounted(async () => { await getLoginUserInfo() if (!userInfo.value) return const user = useUserStore() user.$patch({ userName: userInfo.value.userName, realName: userInfo.value.realName, }) }) 3.Mockjs模拟后端接口返回数据 import Mock from 'mockjs' const BASE_URL = '/api' Mock.mock(`${BASE_URL}/user/list`, { code: '00000', message: '成功', 'result|10-20': [ { uuid: '@guid', name: '@name', tag: '@title', age: '@integer(18, 35)', modifiedTime: '@datetime', status: '@cword("01")', }, ], }) 四、统一规范 1.ESLint 注意:不同框架下,所需要的preset或plugin不同,建议将公共部分提取并配置在根目录中,package中的eslint配置设置extends。 /* eslint-env node */ require('@rushstack/eslint-patch/modern-module-resolution') module.exports = { root: true, extends: [ 'plugin:vue/vue3-essential', 'eslint:recommended', '@vue/eslint-config-typescript', '@vue/eslint-config-prettier', ], overrides: [ { files: ['cypress/e2e/**.{cy,spec}.{js,ts,jsx,tsx}'], extends: ['plugin:cypress/recommended'], }, ], parserOptions: { ecmaVersion: 'latest', }, rules: { 'vue/no-deprecated-slot-attribute': 'off', }, } 2.StyleLint module.exports = { extends: ['stylelint-config-standard', 'stylelint-config-prettier'], plugins: ['stylelint-order'], customSyntax: 'postcss-html', rules: { indentation: 2, //4空格 'selector-class-pattern': '^(?:(?:o|c|u|t|s|is|has|_|js|qa)-)?[a-zA-Z0-9]+(?:-[a-zA-Z0-9]+)*(?:__[a-zA-Z0-9]+(?:-[a-zA-Z0-9]+)*)?(?:--[a-zA-Z0-9]+(?:-[a-zA-Z0-9]+)*)?(?:\[.+\])?$', // at-rule-no-unknown: 屏蔽一些scss等语法检查 'at-rule-no-unknown': [true, { ignoreAtRules: ['mixin', 'extend', 'content', 'export'] }], // css-next :global 'selector-pseudo-class-no-unknown': [ true, { ignorePseudoClasses: ['global', 'deep'], }, ], 'order/order': ['custom-properties', 'declarations'], 'order/properties-alphabetical-order': true, }, } 3.Prettier module.exports = { printWidth: 100, singleQuote: true, trailingComma: 'all', bracketSpacing: true, jsxBracketSameLine: false, tabWidth: 2, semi: false, } 4.CommitLint module.exports = { extends: ['@commitlint/config-conventional'], rules: { 'type-enum': [ 2, 'always', ['build', 'feat', 'fix', 'docs', 'style', 'refactor', 'test', 'chore', 'revert'], ], 'subject-full-stop': [0, 'never'], 'subject-case': [0, 'never'], }, } 五、附录:技术栈图谱 作者:京东科技 牛志伟 来源:京东云开发者社区

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册