首页 文章 精选 留言 我的

精选列表

搜索[可灵AI],共10000篇文章
优秀的个人博客,低调大师

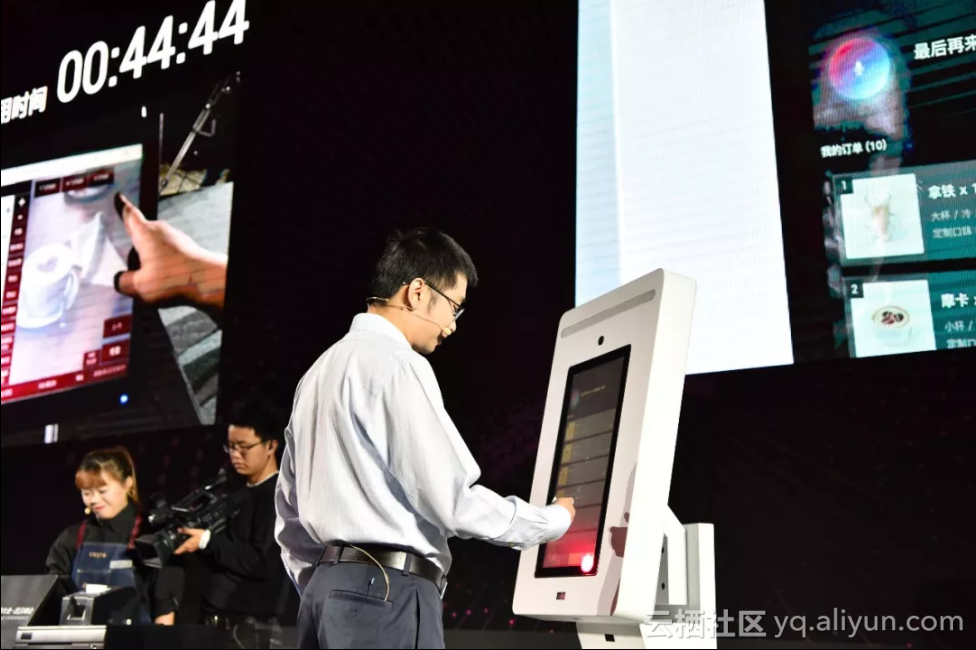
AI收银员来了!用华少的语速点30多杯咖啡,49秒搞定!

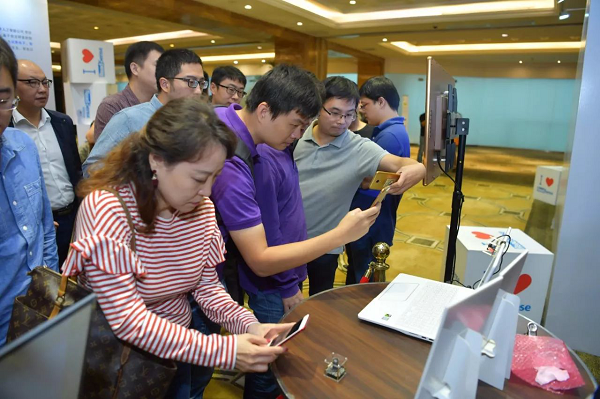
“五个巧克力、两个香草拿铁,巧克力加奶油。” “两个中杯焦糖拿铁,一个热的一个冷的。” ”算了巧克力不要了。” “再要六个小杯少冰摩卡,三杯加焦糖三杯加香草。” “再加一个大的冷的拿铁,去冰半糖加脱脂奶,打包。” 5月23日云栖大会武汉峰会上,阿里巴巴达摩院机器智能技术实验室语音交互首席科学家鄢志杰最快以每秒5个字的语速在一台机器前狂点了30多杯咖啡。 与这台机器一同接受挑战的,是一位资深咖啡师。当咖啡师因“语速太快、记不下来”在中途选择放弃时,这台机器却在每一轮对话中都做出了精准响应,并且在49秒时下单成功。 咖啡师在听了鄢志杰第二次复述后,用了2分37秒完成订单。 “今天,我们将机器对人类口语的理解能力带到了新的高度”,鄢志杰说,这种交互方式完全打破了“语音唤醒+语音指令”的传统命令式交互方式。 上述点单环节包含了修改、删除、加单等多轮对话,在

优秀的个人博客,低调大师

概率计算或成AI突破新爆点,最适合处理不确定性

根据英特尔首席技术官Mike Mayberry的说法,最初的人工智能浪潮是基于逻辑的,这是基于写下规则——即所谓的“经典推理”。在概率计算中,处理单元所消耗的能量降低,从而增加了某些操作出错的可能性。 定义概率计算 根据USFCA的说法,概率计算机将模拟问题(前向)带入一个推理程序(反向)。总部位于加州伯克利的Navia系统公司开发了概率计算机,它将其定义为最适合在不确定的情况下做出判断的技术,就像传统的计算技术是大规模的记录保存一样。这家成立于2007年的创业公司强调,与目前用于逻辑推理和精确计算的计算机不同,在概率计算领域,机器和程序是用来处理不确定性和从经验中进行学习的。 在概率计算下压上重注 英特尔正把赌注押在概率计算上,这是人工智能的一个主要组成部分,它将使未来的系统能够理解和计算自然数据中固有的不确定性,并有助于研究人员能够制

优秀的个人博客,低调大师

DeepLearning.ai学习笔记(五)序列模型 -- week2 自然语言处理与词嵌入

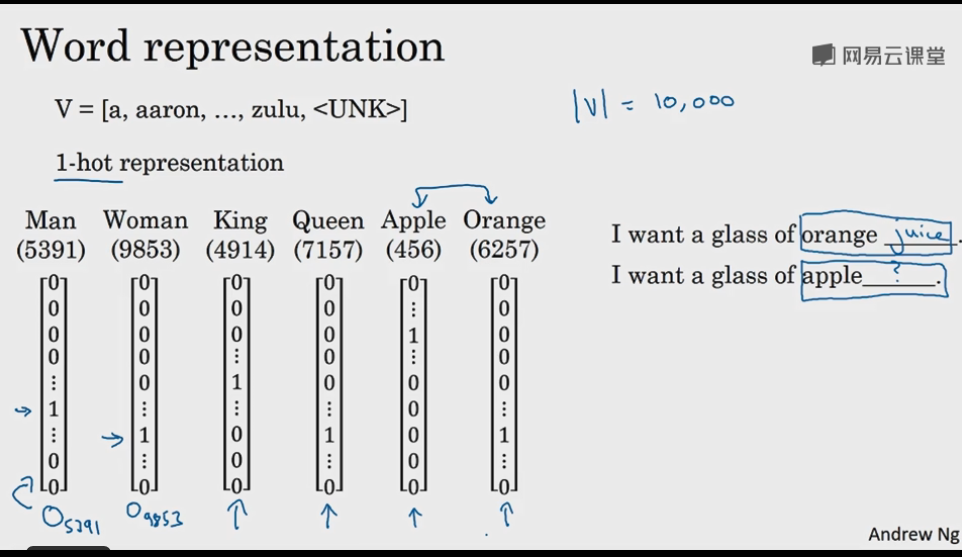
一、词汇表征 首先回顾一下之前介绍的单词表示方法,即one hot表示法。 如下图示,“Man”这个单词可以用 \(O_{5391}\) 表示,其中O表示One_hot。其他单词同理。 但是这样的表示方法有一个缺点,看是看下图中右侧给出的例子,比如给出这么一句不完整的话: **I want a glass of orange __** 假设通过LSTM算法学到了空白处应该填“juice”.但是如果将orange改成apple,即 **I want a glass of apple __** 那么是否也需要从头开始学习“apple juice”吗?能否通过构建“apple” 与 “orange” 的联系让它不需要重学就能进行判断呢?所以下面给出了一种改进的表示方法,称之为“词嵌入(Word Embedding)” 我们知道单词与单词之间是有很多共性的,或在某一特性上相近,比如“苹果”和“橙子”都是水果;或者在某一特性上相反: 比如“父亲”在性别上是男性,“母亲”在性别上是女性,通过构建他们其中的联系可以将在一个单词学习到的内容应用到其他的单词上来提高模型的学习的效率,下面是一个简化的表格用以说明: 原版 汉化版 (上面两个表格分别是课堂上吴大大的讲义和由大数据文摘整理得到的) 简单介绍一下上面的表格的意思: 以“性别(Gender)”这一特征为例,若以-1表示男性,1表示女性,那么显然“Man”在该特征上的值为-1,其他同理,不再赘述。 此时对于单词“orange”和“apple”来说他们会共享很多的特性,比如都是水果,都是圆形,都可以吃,也有些不同的特性比如颜色不同,味道不同,但因为这些特性让RNN模型理解了他们的关系,也就增加了通过学习一个单词去预测另一个的可能性。 假设所用的特征有300个,那么每一个单词就是由这300个特征值组成,因为这个维度是很高的了,所以可以使用$ t-SNE$算法将它们映射到二维空间之后进行可视化聚类,可以得到如下的效果图: 上图通过聚类将词性相类似的单词在二维空间聚为一类,所以这也就可以理解为什么这叫做"词嵌入(Word Embedding)"了,即把原来由多维的特征空间表示单词嵌入到二维空间中去了。 二、使用词嵌入 下面介绍词嵌入的实用场景。 以下图为例,该图表示的是输入一段话,判断出人名。通过学习判断可以知道orange farmer指的应该是人,所以其对应的主语Sally Johnson就应该是人名了,所以其对应位置输出为1。 那如果把orange换成apple呢?通过词嵌入算法可以知道二者词性类似,而且后面跟着farmer,所以也能确认Robert Lin是人名。 我们继续替换,我们将apple farmer替换成不太常见的durian cultivator(榴莲繁殖员)。此时词嵌入中可能并没有durian这个词,cultivator也是不常用的词汇。这个时候怎么办呢?我们可以用到迁移学习。 词嵌入迁移学习步骤如下: 1.学习含有大量文本语料库的词嵌入(一般含有10亿到1000亿单词),或者下载预训练好的词嵌入 2.将学到的词嵌入迁移到相对较小规模的训练集(例如10万词汇),这个时候就能体现出相比于使> 用one hot表示法,使用词嵌入的优势了。如果是使用one hot,那么每个单词是1*100000表> 示,而用词嵌入后,假设特征维度是300,那么只需要使用1*300的向量表示即可。 3.(可选) 这一步骤就是对新的数据进行fine-tune。 词嵌入其实与之前卷积神经网络人脸识别课程中介绍的Siamese网络有类似的地方。 即二者都是使用相同的评价模型对不同对象进行距离运算,距离越近则越相似 例如Siamese网络是将两张人脸图像分别送到相同的CNN模型中计算出特征值并求出差值,来进行判断二者的相似度。词嵌入则是使用两个单词的特征维度进行相似度计算。 但是二者也有差别,以Siamese网络为例,无论输入的人脸图像是什么,其总能计算出二者的相似度。而词嵌入不同,因为有的单词并不出现在某一个词嵌入数据集中,所以此时则无法计算相似度。 三、词嵌入的特性 我们小时候都做过反义词或者近义词的题目吧,那假如告诉机器“Man”↔“Woman”,那么能否退出“King”所对应的单词呢? 这个问题被称作词汇的类比问题(或推理),通过研究词嵌入的特征就可以解决这种问题。 ​如下图示,我们用\(e_{Man}\)来表示“Man”这个单词,其向量为[-1,0.01,0.03,0.09]。“Woman”同理,二者的差异向量为\(e_{Man}-e_{Woman}=[-2,0,0,0]\)(为方便理解,结果做了简化)。 我们可以很容易知道“King”和“Queen”是相对应的,并且它们之间的差异向量也是[-2,0,0,0]。 ​ 大部分时候对于人而言,是很容易找到一对相近的单词的,那么计算机如何找呢?其实按照上面的计算方法已经告诉我们了,即只要满足如下关系式的即可: 已知单词A和单词B是对应的,求与单词C相对应的单词D,则有如下等式: \(e_A - e_B \, \approx \, e_C-e_D\) 其中\(D\)满足\(argmax_w \;\, Similarity(e_D, e_A-e_B+e_C)\) 注意上面的相似度函数为余弦公式,即: \[Similarity(u,v)=\frac{u^Tv}{||u||_2||v||_2}\] 当然也可以用其他距离公式。 如下图用几何方式能够更容易理解,即只要找到与向量\(\vec{AB}\)最接近平行的向量\(\vec{CD}\)即可。 四、嵌入矩阵 如下图示,左边是词嵌入矩阵,每一列表示该单词的特征向量,每一行表示所有单词在某一特征上的值的大小,这个矩阵用\(E\)表示,假设其维度是(300,10000)。 右边矩阵是某一列单词的One hot向量,这里以orange为例,其Onehot向量为\(O_{6257}=[0,…,1,…,0]\)。 那么已知词嵌入矩阵和某一个单词的Onehot向量,那么该单词的特征向量则满足如下等式: \[E*O_j=e_j\] * 表示矩阵乘法 这种获取某个单词特征向量的方法涉及太多运算,所以一般在实际操作中是直接对词嵌入矩阵做列选择即可得到所需单词的特征向量的。 说一下这一小节的感受,虽然最后吴大大也说了在实际操作中只需要做列选择就可以了,但是不明白他为什么还要介绍前面所谓的矩阵相乘运算。。。。 五、学习词嵌入 下图展示了预测单词的方法,即给出缺少一个单词的句子: “**I want a glass of orange ___**” 计算方法是将已知单词的特征向量都作为输入数据送到神经网络中去,然后经过一系列计算到达 Softmax分类层,在该例中输出节点数为10000个。经过计算juice概率最高,所以预测为 “I want a glass of orange juice” 在这个训练模式中,是通过全部的单词去预测最后一个单词然后反向传播更新词嵌表E 假设要预测的单词为W,词嵌表仍然为E,需要注意的是训练词嵌表和预测W是两个不同的任务。 如果任务是预测W,最佳方案是使用W前面n个单词构建语境。 如果任务是训练E,除了使用W前全部单词还可以通过:前后各4个单词、前面单独的一个词、前面语境中随机的一个词(这个方式也叫做 SkipGram 算法),这些方法都能提供很好的结果。 六、Word2Vec 视频中一直没有给 Word2Vec 下一个明确的定义,我们再次下一个非正式定义便于理解: “word2vec” 是指将词语word 变成向量vector 的过程,这一过程通常通过浅层的神经网络完成,例如CBOW或者skip gram,这一过程同样可以视为构建词嵌表E的过程”。 1.Skip-grams ​下图详细的展示了Skip-grams。即先假设Context(上下文)是orange,而Target(预测词)则是通过设置窗口值得到的,例如设置为紧邻的后一个单词,此时Target则为juice,设置其他窗口值可以得到其他预测词。 注意这个过程是用来构建词嵌表的,而不是为了真正的去预测,所以如果预测效果不好并不用担心。 2.Skip-grams公式 Skip-grams模型可用如下表达式表示: \[O_{c}\rightarrow E \rightarrow e_{c} \rightarrow \underset{Softmax}{Output} \rightarrow \hat{y}\] Softmax公式为(假设输出节点数为10000): \[p(t|c)=\frac{e^{θ_t^Te_c}}{\sum_{j=1}^{10000}e^{θ_j^Te_c}}\] \(θ_t\) 表示与t有关的参数。 损失函数: \[l(\hat{y},y)=\sum_{i=1}^{10000}y_ilog\hat{y_i}\] 3.解决计算量大的问题 上面在使用Softmax的时候有一个很明显的问题,那就是计算量过于繁琐,所以为了解决计算量大的问题,提出了如下图所示的方法,即Hierachical Softmax(分层的Softmax) 简单的来说就是通过使用二叉树的形式来减少运算量。 例如一些常见的单词,如the、of等就可以在很浅的层次得到,而像durian这种少用的单词则在较深的层次得到。 七、负采样 对于skip gram model而言,还要解决的一个问题是如何取样(选择)有效的随机词 c 和目标词 t 呢?如果真的按照自然随机分布的方式去选择,可能会大量重复的选择到出现次数频率很高的单词比如说“the, of, a, it, I, ...” 重复的训练这样的单词没有特别大的意义。 如何有效的去训练选定的词如 orange 呢?在设置训练集时可以通过“负取样”的方法, 下表中第一行是通过和上面一 样的窗口法得到的“正”(1)结果,其他三行是从字典中随机得到的词语,结果为“负”(0)。通过这样的负取样法 可以更有效地去训练skip gram model. Context Word Target orange juice 1 orange king 0 orange book 0 orange the 0 orange of 0 负取样的个数k由数据量的大小而定,上述例子中为4. 实际中数据量大则 k = 2 ~ 5,数据量小则可以相对大一些k = 5 ~ 20 通过负取样,我们的神经网络训练从softmax预测每个词出现的频率变成了经典binary logistic regression问题,概率公式用 sigmoid 代替 softmax从而大大提高了速度。 \(x_1=(orange, juice) \rightarrow y_1=1\) \(x_2=(orange, king) \rightarrow y_2=0\) \(...\) \(P(y=1|c,t)=\sigma(\theta_t^Te_c)\) 最后我们通过一个并没有被理论验证但是实际效果很好的方式来确定每个被负选样选中的概率为: \(P(w_i)=\frac{f(w_i^{\frac{3}{4}})} {\sum_{j=1}^{10000}f(w_j^{\frac{3}{4}})}\) 八、GloVe词向量 GloVe(Global vectors for word representation)虽然不想Word2Vec模型那样流行,但是它也有自身的优点,即简单。 下面先介绍该算法定义的变量的含义: 如下图示,\(X_{ij}\)表示单词i在语境j中出现的次数,i就相当于前面内容中提到的t(target),j相当于之前的c(context)。 该算法的主要方法是最小化如下公式(假设共有10000个单词): \[\sum_{i=1}^{10000}\sum_{j=1}^{10000}f(x_{ij})(\theta_i^Te_j+b_i+b_j'-logx_{ij})^2\] 当\(x_{ij}=0\)时,\(f(x_{ij})=0\),并且定义\(0log0=0\)。 所以\(f(x_{ij})\)这么一个加权项就可以避免当\(x_{ij}=0\)时上面的式子是无穷大了。 同时对于像“the、of、a”等这些常用的词,加权项可以给与适当的权重。而对于像“durian”这类不常用到的单词,也可以给到更大但不至于过分的权重。 九、情绪分类 平时上淘宝我们都会对买的东西给出文字评价和对应的星级评价,如下图示。 商家可以通过对这些数据来构建一个情绪分类器,从而可以在一些社交平台上如微博、QQ等大家的文字评论然后对应输出相应的星级等级,这样就可以更容易知道自家店是蒸蒸日上还是日落西山了,2333。 下图展示了情绪分类器的模型。 可以看到下图中的模型先将评语中各个单词通过 词嵌表(数据量一般比较大,例如有100Billion的单词数) 转化成对应的特征向量,然后对所有的单词向量做求和或者做平均,然后构建Softmax分类器,最后输出星级评级。 但是上面的模型存在一个问题,一般而言如果评语中有像"good、excellent"这样的单词,一般都是星级评分较高的评语,但是该模型对下面这句评语就显得无能为力了: “Completely lacking in good taste, good service, and good ambience.” 该评语中出现大量的good,如果直接做求和或者平均运算,经过分类器得到的输出很大概率上是高星级评分的,但这显然与该评语的本意不符。 之所以上面的模型存在那样的缺点,就是因为它没有把单词的时序考虑进去,所以我们可以使用RNN构建模型来解决这种问题。RNN模型如下图示: 另外使用RNN模型还有另一个好处,假设测试集中的评语是这样的 “Completely absent of good taste, good service, and good ambience.” 该评语只是将lacking in替换成了absent of,而且我们即使假设absent并没有出现在训练集中,但是因为词嵌表很庞大,所以词嵌表中包含absent,所以算法依旧可以知道absent和lacking有相似之处,最后输出的结果也依然可以保持正确。 十、词嵌入除偏 现如今机器学习已经被用到了很多领域,例如银行贷款决策,简历筛选。但是因为机器是向人们学习,所以好的坏的都会学到,例如他也会学到一些偏见或者歧视。 如下图示 当说到Man:程序员的时候,算法得出Woman:家庭主妇,这显然存在偏见。 又如Man:Doctor,算法认为Woman:Nurse。这显然也存在其实和偏见。 上面提到的例子都是性别上的歧视,词嵌入也会反映出年龄歧视、性取向歧视以及种族歧视等等。 人类在这方面已经做的不对了,所以机器应当做出相应的调整来减少歧视。 下面将主要从性别歧视上来举例说明如何让机器学习消除偏见。 下图展示了一些单词,你可以在心里先想想你看到这些单词的第一时间认为他们所对应的性别是什么吧~~~ 下面正式介绍算法步骤: 1.识别偏见方向 因为该例子是以消除性别歧视为目的,所以我们需要计算出图中这些单词之间的距离的平均值,进而作为偏见方向(bias direction) \(e_{he}-e_{she}\) \(e_{boy}-e_{girl}\) \(e_{grandmother}-e_{grandfather}\) 将上面所求做平均运算,得到的向量方向即为偏见方向。 为方便理解,已在图中画出偏见方向,其余299D(除gender以外的其他单词特征)向量与偏见方向正交,也在下图中画出。 2.词性中和 像“boy,girl”这类词在性别词性上是很明确的,而且不存在歧视,所以无需中和(Neutralize)。 而图中的babysister、doctor则需要中和,具体方法就是将该词像非偏见方向投影得到一个新的坐标。 3.单词对等距离化 如下图示,虽然babysister中和化,但是它还是离grandmother更近,所以依旧带有偏见 所以我们还需要将grandmother、grandfather这类与性别有关的对应词等距分布在非偏见方向的两侧(红色剪头表示移动方向,红色点表示移动后的新坐标),如下图示。 MARSGGBO原创 2018-3-24
优秀的个人博客,低调大师

AI、新材料、5G、智慧城市,未来的社会场景在高交会提前上演

在高交会上跑断腿的镁客君都看到了什么…… 参与过大大小小的各种展会,除了十分接地气的消费娱乐展,很少有展会能像高交会一样,基本上每个展馆参展的观众都是爆满。 11月16日到21日,第19届中国国际高新技术成果交易会(简称高交会)于深圳会展中心举办,作为目前中国规模最大、最具影响力的科技类展会,有“中国科技第一展”之称的高交会,让镁客君看到不少新鲜亮眼的技术和产品。 一大波身怀绝技的机器人来了!最火的智能家居产品居然是智能门锁 最近,波士顿动力发布了一段视频,展示了他们新版的双足机器人Atlas进行跳跃动作实验,最令人震惊的是Atlas居然会后空翻! 虽然在高交会上没有看到会后空翻的机器人,但是我们看到了会泡咖啡、做饭、甚至是画自画像的机器人。比如下面这个名为“赛大千”的画像机器人,就吸引了不少参展观众。先对人脸进行实时拍照,“赛大千“识别面部轮廓和五官特征,开始自主规划路径,最后就用笔画出一张抽象的手绘画像。 地上的机器人秀出了五花八门的特技,高交会上也有不少天上飞的,光启就展出包括飞行包、GILO转子发动机、Mini云端号、H1、SkyX、动力伞和“旅行者”号在内的科技产品。镁客君还在现场看到一款非常概念性的智能汽车产品:可分离式飞行汽车,它在地面上就是智能无人驾驶电动汽车,当飞行模式开启后,其旋翼展开变形为四旋翼飞行器,然后飞行器脱离汽车底盘,垂直起飞。 除了地上走和天上飞的,高交会期间,水下无人机厂商吉影科技也发布了主打水下拍摄的消费级水下机器人Poseidon I(波塞冬I)。 毫不夸张的说,智能家居产品绝对是这次高交会的大热门之一,现场可以看到非常多的智能门锁厂商,从手势识别、指纹识别、人脸识别到虹膜识别,解锁的方式非常之丰富。就连我们印象中做学习机的小霸王,旗下的一家分公司也展出了他们开发的智能门锁产品。 镁客君在逛展馆的时候,总是会在无意间被一些人脸识别系统捕捉到,其实从最近一段时间计算机视觉公司获得融资的频率和金额来看,它绝对是时下行业内最为关注的技术,高交会上,镁客君也看到了商汤科技的SenseFace人脸布控实战平台,以及深醒科技动态人脸识别实时预警系统等。 物联网、5G,智慧城市已来 物联网方面,三大运营商围绕NB-lOT技术展示了智慧城市的一系列产品,包括智能路灯、智能停车管理等。中国电信网络研究院王庆杨表示,其实NB-IOT简单看是4G的蜂窝互联网技术,但它未来可能会实现5G大规模连接、mMTC的业务场景。 另外,中国电信在现场也展示了5G毫米波AAU,中国联通则演示了他们的5G外场试验。在5G时代真正到来之前,一个万物互联的概念世界正在我们眼前展开。 在智慧城市专馆,华为搭建了近300平方米的“虚拟智慧城市空间”,发布了“打造智慧城市神经系统”。在这个神经系统里面,华为把云计算、大数据、物联网、移动互联网、人工智能等技术与城市场景深度融合,通过数据采集、传输、处理,最终进入智慧城市‘大脑’,并通过对数据进行思考和判断,使更多数据纳入城市日常运行、应急管理和大数据决策支撑中。 VR/AR体验依然很热 虽然今年的VR厂商数量有所减少,并不妨碍各家展区前排成长龙准备体验的用户,不过套用一句业内人士的话,“还是以熟面孔为主。” 大家都在说VR圈的日子不好过,总是有一部分人能坚持下来。如果要给这次VR厂商做个划分的话:大致可以分为三大类:主打体验的线下解决方案商、以VR相机为代表的拍摄解决方案、以及包含人机交互的AR体感体验。 像超级队长就展出了他们的四人对战VR体验新品Super[V],另外镁客君也在现场体验了华捷艾米的滑雪体感游戏,由它们自主研发的深度传感器能够实时捕捉我们的手势动作,和屏幕内的游戏内容产生交互反馈,据华捷艾米的联合创始人沈瑄介绍,他们新一代的3D感知芯片在明年会正式量产。 看前沿技术如何落地 在新材料方面,我们此前报道过的室温液态金属也在高交会上正式亮相,除此之外,石墨烯算得上是绝对的热门,基本上每个展馆都能够看到利用石墨烯传热能力而设计的各种产品,小到发热眼罩,大到石墨烯取暖器,这个目前世界上最轻、最薄、拥有超高导热性的超级纳米材料正在迎来一波产品落地小高潮。 随着苹果打响了手机全面屏概念,关于柔性屏的讨论也甚嚣尘上,这一届高交会上我们看到不少柔性显示屏的产品。 柔宇科技就展示了能够折叠为一支笔大小的柔性键盘,当然他们这次主打的产品是其获得高交会十大人气产品的硬件——3D移动影院Royole Moon。 而在中国科学院展区,我们看到了包括量子通信在内的前沿科学,智能家居产品在内的智能生活,用光控技术明确癫痫治疗新靶点的脑科学、以及以薄膜太阳能电池、全固态柔性锂离子电池为代表的新能源和新材料技术。 结语: 两天的展会逛下来,不得不感慨高交会不愧是“中国科技第一展“,在这里,我们感受到科技技术发展的脉搏,看到技术是如何变革传统的行业,改变我们的生活。毫不夸张地说,未来的社会生活正提前在高交会上上演着。 原文发布时间: 2017-11-18 00:31 本文作者: 巫盼 本文来自云栖社区合作伙伴镁客网,了解相关信息可以关注镁客网。

优秀的个人博客,低调大师

传奇工程师卡马克入坑 AI:徒手一周实现反向传播和 CNN

约翰 · 卡马克是何方神圣? 谁是约翰 · 卡马克? 他是一位集传奇工程师、大神、疯狂程序员、黑客之神、第一人称射击游戏之父、业界活化石、一代玄学码神所有称号为一身的老牌程序员,一举一动都牵动人心。 约翰 ·D· 卡马克二世(John D. Carmack II,出生于 1970 年 8 月 20 日),是美国的电玩游戏程序员、id Software 的创始人之一,id 是一家专门开发电子游戏、电视游戏的公司,成立于 1991 年。 至于 id Software 这家公司都制作过什么游戏呢?说几个你应该就知道了:《CS(反恐精英)》、《半条命》、《毁灭战士》都出自这家公司。 怎么样,对这位卡马克先生多少有些了解了吧? 当然,对技术大牛的一切不提技术水平的吹捧都是耍流氓!——沃茨 · 基硕德,那我们就来说一说这位卡马克大神的技术水平。 卡马克最让

优秀的个人博客,低调大师

李开复万字长文科普人工智能:AI是什么 将带我们去哪儿?

在这篇长达万字的演讲实录里,关于人工智能、深度学习、Google的野心等,首次“科普式”地得以展现。 人工智能正以前所未有的态势汹涌而来,一方面是风投和创业创新,都把人工智能当做了下一个尚未被开垦的宝地;另一方面是应用,比起概念盛行的阶段,现在的无人车、AlphaGo等已经把人工智能技术带到了“看得到摸得着”的境地。 那人工智能到底是什么?这个领域包含哪些要素?它将如何改变当今世界,又面临哪些问题和瓶颈?对于人工智能的应用和商业化,哪些领域会最快显现效果出来? 在清华大学“清华学堂计算机科学实验班”题为《人工智能的黄金时代》的演讲中,创新工场董事长兼CEO李开复对“人工智能”进行了深入浅出的讲解分析。 在讲解中,这位机器学习领域的博士对人工智能追古溯源、引用知名商业案例,并结合Google等巨头的布局和调整,为受众勾勒了人工智能的框架、要素、商用领域和条件,并且强调了人工智能当前的瓶颈和对当前互联网市场的影响。 值得一提的是,这位中国最知名的创业导师还给有志于在人工智能领域进行创业的创业者们提供了建议。 在这篇长达万字的演讲实录里,关于人工智能、深度学习、Google的野心等,首次“科普式”地得以展现。 以下是李开复演讲实录: 谢谢大家!非常高兴有这个机会又一次来到清华,尤其是在我最尊敬的姚期智教授的邀请和介绍之下。姚教授的姚班在全球已经享有盛名,我从Google到创新工场,看到有非常多成功的工程师,都是在姚老师的培养之下成为了计算机界的顶尖人才。 在讲人工智能之前,我想向大家介绍一下我的一些可能不太为人熟知的背景:其实在进入几个国际大公司任职之前,也就是在30多年前,我就进入了人工智能领域。我是在1980年首先做的自然语言处理,1982年做的计算机视觉,1983做的语音识别,1985年做的人机对弈,1996年做的VR/AR……但我们现在知道,那时候我的这些选择基本上都是非常“糟糕错误”的职业选择,因为每一件事情,我都是在它的黄金时代之前、白银时代之前,甚至破铜烂铁都不是的时代就涉足了。从这个事情上,其实我也想说,做计算机研究这个领域,本身的素质能力当然都非常重要,但是还要在正确的时候选择正确的事情。我在错误的时候太过狂热的跳进了人工智能领域,与此同时,过去的三四十年人工智能也是起起伏伏,一下很火,一下又跌入谷底。 但现在是人工智能的黄金时代。可能各位也会问,凭什么这次说是人工智能的黄金时代?为了说明这个问题,这次我肯定不只用一些理论来说服大家,毕竟我过去也做了这么多“错误的选择”——我今天还带一些实际的数据来跟大家分享为什么我对今天的人工智能充满信心。人工智能有很多分支,其中之一是机器学习,机器学习里面还有一个分支是深度学习,今天我更多的会用深度学习作为案例。 人工智能是一种工具 最近人工智能成为全球热门新闻话题,很多是因为大家看到AlphaGo在几个月前击败了李世石,最近在网上还传出年底之前它要挑战柯杰的消息。但在这个新闻的热度之下,有一点让我觉得很可惜:大家对这个话题讨论的重心都放在了人工智能是不是在模仿人脑,“奇点”是否即将来临这样的问题上,却没有真正关注人工智能对我们的现实影响。 “奇点”认为未来机器将有各种的智能、人类必须做一些事情来保护自己。我们在座的没有任何一个人能够证明或否定“奇点”,但就我个人而言,我认为人工智能要取代人还是一个非常遥远的事情。我觉得我们需要更关注的事情是人工智能是今天能够拿来用的工具,它能帮助人类解决问题,能取代重复性的工作,能创造商业价值。正因为这个理由,我认为我们今天进入了人工智能的黄金时代。 随便举几个例子:今天很多的工作以后大部分都会消失,比如说翻译,虽然现在还不是做的那么完美,但是每年进步的都很快,再过几年人工的翻译可能就会非常难找到工作了。记者也同样如此,如今90%美联社的文章都是用机器来写的。几乎所有思考模式可以被理性推算的工作岗位,在有足够数据支撑的时候,都会被取代。有人说十年之内一半的工作会消失,有人说十五年之内一半的工作会消失,我觉得这些都是合理的揣测。 我想在座大部分都会相信这个理论,而如果你对此还有怀疑,你可以想想,为什么AlphaGo这么厉害?就是因为它可以动用到几千台机器每天和自己对弈上万盘的围棋,而这人是做不到的;以后为什么自动驾驶会这么厉害呢?因为它可以用它的各种的sensor在路上搜集数据,这不是任何一个司机可以匹敌的。所以这些都是一些必然的过程。 何为人工智能 到底什么是人工智能呢?我觉得大概来说可能是有几个部分。 首先是感知,感知就是包括视觉、语音、语言;然后是决策,刚刚讲的做一些预测,做一些判断,这些是决策层面的;那当然如果你要做一套完整的系统,就像机器人或是自动驾驶,它会需要一个反馈。 什么是人工智能? 在这些例子上可以看到,感知可能更多的是帮助识别图里面一个婴儿在沙发上抱着泰迪熊这种。在推荐上面,我举的例子是一个用Google now通过你过去做的一些事情推测你下面要做什么,在最下面的例子你会看到有一个无人驾驶的汽车,它有各种的sensor,它捕捉的信息可以用来做最后的决策,比如怎么去操作方向盘、油门、刹车等等的。其实这三件事情的总和就是今天所被归纳为的人工智能。 再从博弈、感知决策以及反馈四个方面回顾一下人工智能的发展历程。博弈今天就不讲太多了,但是基本上我可以看到从我在大学做的Othello到Checkers再到DeepBlue chess,经过很长的一段时间,终于有了今天AlphaGo打败了围棋世界冠军。我们从中可以看到,这是一条长达三十多年的路程。 人工智能的各阶段发展里程碑事件 在感知方面,从我的博士论文发表到Nuance成为一个顶尖的公司,从中国诞生了科大讯飞到美国的Deep Face、中国的Face++等等做得越来越好的企业,这些年也有很多的进步。还有一些很特殊的例子,比如最近看到一些搞笑的比较Microsoft Tay在Twitter上开始跟人家交流一下子就讲了一堆不堪的话,就被Microsoft撤回了,所以这里有很多的成功例子,也有很多有趣的事件。 决策方面,从早期Microsoft Office里的工具到Google广告的推荐,然后到金融行业的很多智能决策公司的出现,进步迅速。Google auto mail可能大家还没有看过,但是如果你现在还在用Gmail的话,会发现你有时候收到email,Google会跳出来问要不要发回复,有时候它连回复都帮你写好了,而且写的很精确。这也是人工智能的体现。可能以后我们讲话都不用,助理能帮我们搞定,人工智能的助理肯定也是一个方向。 最后是反馈,从CMU Boss早期的无人驾驶到Amazon用Kiva推动物流,再到最近的Pepper、Google car,我们可以看到这个领域过去三四年特别的热,有很多看起来商业化已经做的非常好。 科普深度学习 在这里,我要稍微深度讲一下深度学习。 深度学习是一种神经网络,与但与之前的相比,它的特点是使用了多层网络,能够学习抽象概念,同时融入自我学习,而且收敛相对快速。收敛快速可能是一种技巧,不见得是一个理论,但是有一批人通过它解决了很多重要的问题。 简单的来说,如果我们有很多笑脸,然后我们把笑脸的像素输入到一个神经网络里面去,最后你那儿希望让机器能识别这是姚明,那是马云,但是因为你这个深度学习的网络很深,要一次性学会这么多也会比较困难,所以就需要用到一个比较快速收敛的技巧——自我学习。通过自我学习,机器会逐步从大量的样本中逐层抽象出相关的概念,然后做出理解,最终做出判断和决策。 比如它可以有好几层的nodes和connection,经过这些nodes和connection,它在每一个层次会感知到不同的抽象特征,且一层比一层更为高级。这些都是通过自我学习实现的,而不是人教的。经过自我学习,从一个脸输进去再从同样的一个脸输出来,它就从里面抽象的学习到了一个人的脸重要特征。 深度学习的分层无监督训练 经过这个学习之后,我再去做监督训练,看机器是否能够识别他们,如果不能,就在训练之后做微调。例如,如果我输入了马云的脸,出来的却是王宝强,那训练系统就会告诉你的网络说这个是错误的:这不是王宝强,这是马云。那接下来就是要进行微调,以便于下一次机器看到这个脸时,能识别出是马云的概率高一些,出来王宝强的概率低一些。 分层无监督训练 但是这么一调也不能调的太过火了,要不然就会有overtraining的问题,我们就对整个数学公式做一点微调,用大量的数据,不断重复的去教它,经过不断微调,那么它就很可能在多次之后降低识别错误。 其实这一整套理论在二三十年前就已经有了,我在做我博士论文的时候,很多我的同事就在做训练神经网络的工作。 深度学习在最初的时候训练速度特别特别慢,所以比较难进入工业级别或者是应用级别,比如,你的手机是做不来这个的,因为它的速度实在太慢了。但经过这么多年,我们的计算机变的越来越快,另外也有了更多取巧的训练和识别做法,深度学习的应用可能性也发生了变化,它能被应用的领域越来越宽。多年前,我过早的进入了这一领域,但是现在,人工智能大规模应用的时机已经到了。 凭什么这么说?一个很简单的评估标准就是,我们的深度学习或者是任何的机器学习,它是不是超越人类的能力表现,如果超越的话,可能很多应用就会产生。比如在机场,如果机器识别人脸的准确度超过人,那么我们那些边防的人就可能不需要那么多。这并不是说机器不会犯错,而是说既然人不能比机器做的更好,那我不妨就用机器取代。 深度学习的应用领域 在过去的五年,深度学习的准确度从75%多提升到了97%左右,而人的表现准确率大概是95%。从95%到97%听起来只进步了2%,但实际上是把错误率降低了40%,这是很大的进步。如果这种进步持续,未来人工智能必然会超过人类的表现,同时也将可以进入一些可应用的领域。这就是今天我讲人工智能进入黄金时代的证据:在很多领域,也包括我们在face++做的人脸识别,包括了Apple、Google,科大讯飞的语音识别,它们的认知水平将在未来几年的时间内超过人类,而一旦超过人类,应用就会快速的增加。 深度学习的应用领域举例 深度学习首先可以应用于识别,包括人脸识别和语音识别等,这些可以用于安防,安检等。 人脸语音的数据来之不易,但是BI,商业的流程、互联网的数据却非常丰富。Google、百度很早就已经在搜索,在广告以及推荐系统里面充分使用了类机器学习技术,解决该推荐什么商品,一个商品怎么定价,在什么位置会卖的最多,应该把这样的产品卖给谁等问题。这一类的推销可以直接产生经济价值,而社交媒体营销,整个互联网广告,这每一个领域都是几十亿,几百亿甚至更大的市场。 将智能用于炒股其实也是一个不错的选择。在国内在国外,很多人都在做这方面创业的工作。利用智能,我可以随时来算一篮子股票和期货应该如何对冲,以寻求最大的利润。顶尖金融分析师也会做这个,但是他不可能把所有的股票的排列组合都考虑一遍,但是机器可以二十四小时不睡觉,每天都在算怎么能赚最多的钱。除此之外,deep learning深度学习的技术可以把各种的因素都融合进来,比如这个公司的高管有没有变动,今天出了什么新闻,行业里还有没有什么变动……甚至你可以对一个智能系统说如果明天巴西发生了地震,什么股票该被购买,甚至你可以说发生了地震不要问我,你直接去买它就可以了。 银行保险方面,比如说贷款该不该审批,则无论是银行的贷款,还是P2P的贷款,都可以通过机器来判断,而且数据未必要来自银行内部。 医学方面,因为我自己生过病,也深深的受过这方面的痛苦,我也感觉到在今天的医生的判断真的不是最完善的。一方面医生有好有坏,顶尖的医生是非常少的;第二方面比如在癌症方面,它每一年都有新的药出来,那每个医生每天忙着看病人,就不见得有时间去研究这些药物,那些药物也不是每个国家都可以使用的。还有就是每一个人,他的各种特质,不见得就适合用这个药。这些其实都是可以用机器学习来做出来的。 前一阵我在美国碰到了一些科学家,他们正在用机器学习的方法来发明新药。我们的科学研究方面当然要有聪明的头脑和很好的实验,但是其中有一个很关键的部分,就要是一定的程度去排列组合:试很多东西,对小白鼠先试试这个有没有用,再试试看那个有没有用,然后再在猿猴身上实验,再进行人体实验。在以前,这整个过程都是由人脑完成,但是这个交给机器来做也许会更精准。甚至有一家公司它养了非常多的白老鼠,他里面所有的实验都是通过机器学习精准进行:每天白老鼠活了几只,死了几只,什么药可以进到下一步……这些都是靠机器学习加上非常精密的系统来做。 我们发明的很多新的材料,都不是靠纯粹的科学方法推出来的,也是去试一试,把这个碰到那个,就产生了有很特殊效应的材料。这些知识都可以输入我们的信息学习系统,通过它我们可以帮助发明新的事物。 在教育方面也有应用。在学习的过程中,如果基础没有打好,下一个层次根本学不下去。智能化的教育系统会识别你的学习水平,然后根据你的水平确定学习内容。比如,你的乘法没有学好,机器就不可能让你去学除法。 当然学习外语也是很好的例子,我们今天的语音识别做的这么好,为什么我们学外语还是一定要找外教,为什么语音识别不能再上一层楼呢?所以,当你的技术一提高了,语音识别应用就不会只是我的讲话进去然后文字出来,它还有可能用在教育领域。 在这么多机会之下,这个人工智能会重塑亿万级别的领域。当然这个不是明天就会发生,因为我觉得人工智能在很多方面还是相当大的欠缺…… 人工智能将重塑亿万级别的领域 人工智能会重塑很多亿万级别的领域。当然这个不是明天就会发生,因为今天我们在很多相关方面仍存在相当大的欠缺。 比如,在我们的计算架构上面,现在还是需要时间去做算法的改进提升,需要去研究如何部署云端架构,另外深度学习用时仍太长,这些还都是需要探索的内容,而且并没有一个标准化的答案。 另外,算法框架也非常重要。我们可以看到有一些重要技术的推进,实际上是因为有了开源或者API或者标准的出现,但现在仍有很多方面还没有出现相关标准。当然我们知道Google的TensorFlow等提供了一些开源的方法,但是其实他们还没有真正的平台化,比如你把TensorFlow丢给一个没学过机器学习的人,哪怕是清华大学顶尖的计算机系学生,他也很难用其创造价值。如果清华的学生都不能,那它的普及性就有问题了。 为什么iOS、安卓能够做的很好,就是因为它产生了平台化效应,使得很多人能够比较容易的介入。然后我们可以看到像Hadoop这样七八年前很多人觉得很高深的东西现在也慢慢变得平台化了。今天,如何使得整个机器学习的体系平台化,以便于让更多的非专业人士能够使用,这个是目前面临的一个很大的瓶颈,需要一定的发展时间才能得以突破。 在一些领域中,很多技术性问题可以在两三年内得到解决,但是还有很多问题并非如此简单,比如说语义。我们说语音识别是相对简单的:音进来,字出去,这个非常明确,一个API就可以调动。但是音进来,确定是何种情境的语义出去就很难。这些我觉得两三年远远还不够,还需要更多的时间去理解。 传感器一定程度来说是价格的问题、如何普及的问题。现在我们看到Google Car虽然做的很牛,但是正如驭势科技的吴甘沙说的,Google Car实际商业化的一个巨大瓶颈就是价位的问题:传感器实在太贵了。因此要把这件事做下来就是一个鸡和蛋的问题——降低价格就需要量,但量怎么起来?价格不下去量也起不来。要解决这个问题也需要一定的时间。 最后还有很多机械方面的问题。控制机械运动的算法,硬件运动后给出的回馈等等在机械部门也还需要一些开发。 整体来说,虽然我认为机器学习、深度学习在突破人类的精确度方面已经做的非常好,但是以上几个领域还是需要一些时间才能取得突破。但是这一天肯定是会来临的,我们怎么知道会来临呢? Google的野心 我们知道,不久前Google重新组织了公司架构,将搜索业务和其他前沿项目子公司都放进了控股公司Alphabet公司。很多分析师说,Google把搜索和其他的业务分开来做Alphabet,是为了优化它的股价,其实这种说法太表面了,他们没有了解一个真正有野心的公司在做什么。 一定程度上,Google之所以成立了Alphabet,是因为Google经过搜索和广告业务的积累,逐步发展了一套我们可以简称为Google Brain的模式。Google Brain其实就是机器学习的大脑,这个机器包括了平台也包括了专家,如果它用在搜索领域就是一个搜索引擎,如果它能够用在医学领域,那它可能就是一个癌症诊断系统,它也可以用于人类寿命的延续以及智能家电等各种不同领域。所以Google的野心就是把机器学习作为一个核心,然后用它去解决非计算机非互联网领域的各种问题。 当然它现在还不是一个整体平台,但Google 就会找一些极聪明的人来进军这些领域,有平台的用平台,平台未成形的就用聪明才智来想办法。现在看来,Google这种模式也做成了很多有意义的事情。所以,对于Google,我们千万不要低估了它的能力,因为这家公司可能是未来推动人工智能平台化的最大力量。 怎么证明这是真的呢?从最近Jeff Dean演讲的一张图我们就可以看到Google内部有多少项目在用深度学习。 Google内部对深度学习的大量应用 我们可以看到,从2012年到今天,Google对深度学习的利用在快速增长,应用领域也极为广泛。从这张图我们就可以看到Google,也就是现在的 Alphabet在人工智能方面是多么的有野心。 再回到我原来的问题,我们现在是不是生逢其时,可以在正确的时候选择进入人工智能这个领域呢?如果我们相信Google这帮人很聪明,如果我们相信Google对深度学习的使用逻辑,我们也要相信人工智能的应用期即将来临。 深度学习的挑战 深度学习也面临挑战 但是深度学习以及机器学习还面临很多挑战。这里有几个问题。 第一个问题,就是我刚刚提到的:目前仍然没有一个统一的平台。在深度学习方面,现在的人懂就是懂,不懂就是不懂。这就是为什么Google最近花了重金不断在挖业界顶尖的人才,给年轻人开出的年薪甚至超过200万美元。这些人也就是二十来岁,博士刚毕业不久,怎么会这么值钱呢? 其实就是因为两个理由,第一,这些人进入了公司之后,会被投入到健康、医疗、预防等等各个领域的研究。他们虽然每年拿走公司的两百万美金年薪,但是也许两年后他们就能在相关领域创造出两亿美金的价值,所以对Google公司而言,这些人才实际上不贵,是非常划算的。 第二个理由就是Google多雇一个,Facebook就得少雇一个。这不是开玩笑。因为在美国有三个大公司在疯狂挖人工智能的人才——Google、Facebook和Microsoft,他们之间竞争激烈,对人才的吸引力也不相上下。 第二就是深度学习的网络太大,需要海量的数据。 第三,因为数据太多,所以计算特别的慢,所以需要非常大的计算量。 第四点有点奇怪但也合理:机器无法用人的语言告知做事的动机和理由。即便机器训练做了很棒的深度学习,人脸识别、语音识别做的非常棒,但它不能和人一样,它讲不出来这是怎么做到的。虽然有人也在做这方面的研究,但是在今天,如果一个领域是不断需要告诉别人该怎么做,需要向别人去解释为什么的,那这个领域对于深度学习来讲还是比较困难的。比如AlphaGo打败李世石,你要问AlphaGo是为什么走这步棋,它是答不上来的。 即便有如此多的局限,我们还是认为人工智能在很多领域可以迅速应用,并且可以帮助企业打造竞争壁垒。 人工智能如何帮企业打造竞争壁垒?可以从如下四个方面思考: 第一,如果你有垄断性的大数据,你就会有很大的优势。关于数据需要注意的几点是,首先垄断性大数据不是公开的数据,不是剽来的数据,也不是买来的数据,因为这样的事情你能做竞争对手也能做。其次,无标签的数据也不会给你带来优势。再次,如果是人工标签的数据也不行,因为人工标签太慢了。最好的数据是闭环的数据,所谓闭环的数据就是在你应用的时候可以捕捉到数据并且知道最终你根据数据做出的抉择对或不对。我们投资的face++,它有和美图、阿里的合作,就一定程度形成了特别大的数据的优势。 第二,拥有庞大的机群。机群是很重要的,包括需要什么处理系统的支持,怎么去部署,用什么样的计算架构等等。 第三,你要有一批特别懂的人。没有平台的时候,你就只能把一批人丢进去,让他们去解决特别大的问题。 第四,当你没有平台的时候怎么办?我们就可以找一批特别聪明的人,让他们不断的调节算法——当然这构成一个短期的竞争优势,从长期看,一旦大的人工智能平台出来,这种优势就不存在了。所以现在来做人工智能,抓到这个先机是特别特别重要的。 人工智能如何快速商业化? 人工智能如何快速商业化 第一,不要用人工智能去取代人。 机器不一定要取代人,很多情况之下他只要能辅助人就可以了。我谈到了很多工作会消失,但医生会全部失业吗?一定不会,应该是最高明的医生创造很多机器人给他人使用。记者就不再需要了吗?写深度文章还是需要的,但简单拼拼凑凑的文字就不需要了。所以这些工具一定程度上是在辅助人而不是取代人。 第二,要聪明的找到容错的用户界面。 想想搜索引擎,搜索引擎的精确度其实是很低的,你想一想,当你去百度,Google搜索的时候,它们给出的第一条就是你要的答案的情况有多少?我估计不会超过50%,但是为什么我们都说搜索引擎聪明,不说他笨呢?第一个理由当然是因为它博学,第二个则是因为它的界面做的非常的聪明:它给用户提供很多结果,而用户只要能找到他满意的那个,就会认为搜索引擎很棒,因为没有它的话,用户可能什么也找不到。这一类的容错的界面,即便它的识别率很低,给你很多结果,让你在一定时间里得到满足,其实还是达到了一定的可用度。 第三,让用户提供自然的大数据。 当Siri推出的时候很多人都说“这就是个玩具而已”,认为它没有真实的用处,但是苹果靠Siri收集了很多人的真实语音,收集了大量数据。 很多人把Siri当成一个搞笑工具,会问它诸如“你是男是女”这种无聊问题,苹果就把这些无聊的问题深度分析了一下,去了解人们最常问的都是什么问题,然后他们就考虑能不能优化Siri,让它对正常问题的解答能让人们在一定程度上得到满足。人们满足了以后,就会继续的问,如此问题越问越多,苹果也就可以得到更多的数据。 苹果的这种数据收集方法非常聪明,值得借鉴。我们以前在学语音对话的时候,问的都是非常正经的问题,到最后分析来分析去,不过是那固定的几万句,一直没有跳出这个框框,得到的结果也就不会让人满意。但用一种有趣的方式,你就可以像草船借箭一样,去“借”到几亿个数据。这些数据哪怕不精确也无妨,因为整体来说深度学习非常聪明,能把那些不精确不精准的东西忽略掉。 第四,关注局限领域。 Google很伟大,它要做全天候全路况的无人驾驶,它想把全部竞争对手都击败,最后就剩一个Google。这个计划很宏伟,但是是不是一定要这么做呢?我觉得不见得。其实我们完全可以先做一个用于局限领域的无人车,把这样的一个产品先做起来,然后我们通过它获取数据,学习教训,不断改进。 想想无人驾驶叉车。这个叉车是产生价值的,因为它取代了一个叉车工人去开叉车;它技术难度相对低,因为它只要知道从A走到B;它不上路,不用担心政府的法律法规,不需要考虑撞到人怎么办,是不是要停下。 Google Car能在高速公路上比99%以上的人都开的更好,但是它碰到一些极端的情况,比如大风大雨的漆黑天,它就没辙了,因为它不知道该怎么办,从来没看到过这种情况。这种情况下只有把车子停下来,但那一停会发生什么呢?当然就追尾了。 既然这种情况连Google也避免不了,为什么我们不先考虑做一些可控环境下的商业驾驶项目?这也是一个值得思考的问题,不是说Google的路线不对,而是说有两种路线可以走。 总结:人工智能的未来蓝图 李开复:人工智能的未来蓝图 上图是我认为的人工智能的未来蓝图,这是我们创新工场现在对这一领域的理解,以及可能会发生的顺序。 大数据应用方面,现阶段我们已经看到很多互联网应用,BI、商业自动化马上也会使用相关的技术,未来几年,离钱最近、产生用户最多、产生价值最大的领域可能就是金融、医疗、教育,当然也包括任何有大数据的行业。 在感知方面,今天的人脸识别、语音识别已经做的蛮好。对于VR/AR,我们在短期还不是太乐观,但是随着它三五年以后慢慢得到普及,一定需要非常多的新的自然语言的界面。此外,我们大胆预测三到五年之内会有一个人工智能平台出现。 我们并不认可家庭机器人会很快出现,理由是消费者的期望值是最高的,今天机器人的技术还不行,犯错也太多,而且有时候会看起来太傻,另外价格也太贵,感应器不够灵敏。基于这些理由,我们对家用机器人的投资还只限于一些给小朋友的玩具,或者小鱼在家这种用于沟通的工具,这一类的家庭应用我觉得还是合理的,但要一个能够在家里帮你扫地做菜的机器人出现,恐怕还是一个非常长期的事情。任何行业都要有经济理由来投资这个领域,不断迭代优化它的技术,再进入下一个阶段,所以机器人简单来说应该是工业、商业,最后普及到家庭,所以今天很多对家庭机器人过火的观点和做法我们是不认可的。 关于无人驾驶,我们的观点是虽然Google Car很伟大,但是因为它要去适应各种路况,所以要到应用阶段也还需要很长的时间。我们认为可以先在局限环境中慢慢推进无人驾驶。 从长期看,未来人工智能会在所有的领域彻底改变人类,产生更多的价值,取代更多人的工作,也会让很多现在重复性的工作被取代,然后让人去做人真正应该去做的事情。短期来说,人工智能商业价值也很大,短期在很多领域都能产生价值。 李开复和清华大学姚期智院士 演讲后问答实录: 问题一:刚才听到了人工智能的介绍,真的认为人工智能给我们带来了很多的便捷,的确是快要步入到一个黄金时代,很多人可以从劳动密集型的工作中解放出来。我的问题是,如果很多事儿都可以交给机器来完成,那么剩余的劳动力是否会催生另一个黄金产业,比如服务业等等? 李开复:这个问题很好,我曾经写过一篇文章《如果十年之后有一半的人失业了,下面该发生什么》,讲过这个问题。悲观的预测是,因为现在的95后,00后大部分成长在虚拟世界里,现实世界只是他们一个小小的补充,所以他们可能深陷其中而不能自拔了。反正人工智能让他们失业,也找不到工作,同时政府也可以养着他们,他们不需要工作,那么干脆每天带着虚拟眼镜起来就玩游戏,不思进取就好了。这个是我特别担心的,也是可能发生的。 乐观的是上天让我们来到这个世界,本来就不是让我们来做中介、助理这类劳力的工作,我们被生为有感知,有大脑,应该是有更高的目标。那么,是不是上天让人工智能来到我们面前,就是让一批有思考能力的人帮人类找到一条新的出路,让我们每个人能够找到自己的更高目标,让一半失业的人找到他们的归宿,有自我实现的机会呢? 我对年轻人的建议是做最有热情的事情,要不然机器肯定取代你,要做就要做顶尖最棒最有创意的事情,要不然你肯定会被取代。 问题二:您讲了很多前景中的事情,我们都觉得美好,但是在实现前景的道路上,最大的几个技术瓶颈在哪里?在解决瓶颈的过程中,您看到的大公司解决这些瓶颈的方案是什么? 李开复:最大的瓶颈就是人工智能的平台。平台化会带来井喷的效应,但这个平台是什么我今天也无法描述。你可以看到iOS的平台,安卓的平台等等,每一次都造成了井喷式的效应,所以平台化是必然的也是必须的。对于无人驾驶和机器人方面,主要是感应器的价格等问题,一旦问题解决,这些领域也会发生井喷效应。这些都需要聪明的大脑试着去解决。 问题三:第一个问题,您刚才提到人工智能的黄金时代到来了,那么您能举一个到三个导致这种黄金时代到来的创新明星吗?第二个问题,当人工智能呼啸而来的时候,大家很快意识到人工智能第一个急需解决的问题是人,如果人类把持不住,可能人的时代就过去了。 李开复:今天有四位CEO,分别代表了芯片领域、金融领域、视觉识别领域和无人驾驶领域,这四个公司虽然目前领域不同,但在到达下一个阶段后,一定会做平台,一定要扩张。任何一个领域都是先做一个切入的应用,做好了之后再扩大,变成一个平台,最终获利最多的就是那些有上下平台连接的公司。 关于你的第二个问题,即人类将面临的下一个挑战问题,不是机器人占领了世界,我们被机器统治这样的问题。虽然我不排除这些事情发生的可能性,但是我呼吁大家先要应对一个现实问题——下一阶段50%的人可能失业的问题。这可能是一个最大的问题,毕竟在过去的工业时代也好,信息时代也好,失业率从来没有这么高过,今天的政治经济体系也不能承担这么高的失业率。所以我觉得聪明的人应该赶快解决这个问题,这个问题可能十年后就要到来了,当这个问题解决完了之后,我们再去想下一个问题。 问题四:您讲到的人工智能在各个领域都会以极快的速度超过人的领域,但是它是不是只在某些领域做的更好,在某些人类没有开拓的领域,它有没有自我开拓的能力,根据已有的领域和问题,开拓新的领域?“奇点”真的出现,是不是就说明人工智能有跨领域思考学习的能力? 李开复:从过去已经发生的事情来看,还不存在人工智能的自我开创,未来有没有可能,这其实是一个蛮有意思的话题。我想即便是一些人类未曾进入的领域,只要你能把它量化,变成一个input/output,我觉得机器还是可以学成的。但是我也相信大部分人类的伟大创意都不是那么容易量化的。 第二个关于奇点的问题,回到刚才讲的,机器学习并不知道它自己在干什么,它只是一个非常聪明的input/output而已。另外它没有自我意识。科幻小说和现实生活很大的差别是因为科幻小说里面的机器都有自我意识,所以我觉得,由于机器的自我意识和自我创造力,还有自我解释的行动能力,这三者都不存在,奇点来临也就不是那么容易的事情。我相信在未来的一百年,这三点都有可能被克服,也会给人类带来机会和灾难,但是我们现在真正面临的问题还是50%的人可能失业的问题。 原文发布时间: 2016-06-15 12:12 本文作者: 李根 本文来自云栖社区合作伙伴镁客网,了解相关信息可以关注镁客网。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册