首页 文章 精选 留言 我的

精选列表

搜索[微服务框架],共10000篇文章
优秀的个人博客,低调大师

业界 | 英伟达新利剑:发布RTX20系列新显卡,图灵框架铺垫

英伟达在2018科隆国际游戏展宣布,新款高端显卡GeForce RTX 2070,RTX 2080和RTX 2080 Ti正式问世。 这些RTX20系列显卡会接替英伟达目前的顶级GPU,包括GeForce GTX 1070,GTX 1080和GTX 1080 Ti。虽然英伟达通常会发布更强大的Ti版GPU,但这一次,它同时发布了RTX 2080和RTX 2080 Ti两款GPU。 点击观看宣传视频 当然,价格绝对不会便宜。英伟达CEO黄仁勋在演讲中也提到,这几款不同的显卡价格不同。黄仁勋说,RTX 2070的起售价为499美元,RTX 2080的起售价为699美元,RTX 2080 Ti的起售价为999美元。当被问到为何如此定价时,英伟达的一位代表说道,这些价格反映了第三方制造商的零售价。 英伟达还为这三款显卡提供了Founders Ed

优秀的个人博客,低调大师

python+pytest单元测试框架之在Jenkins上生成Allure测试报告

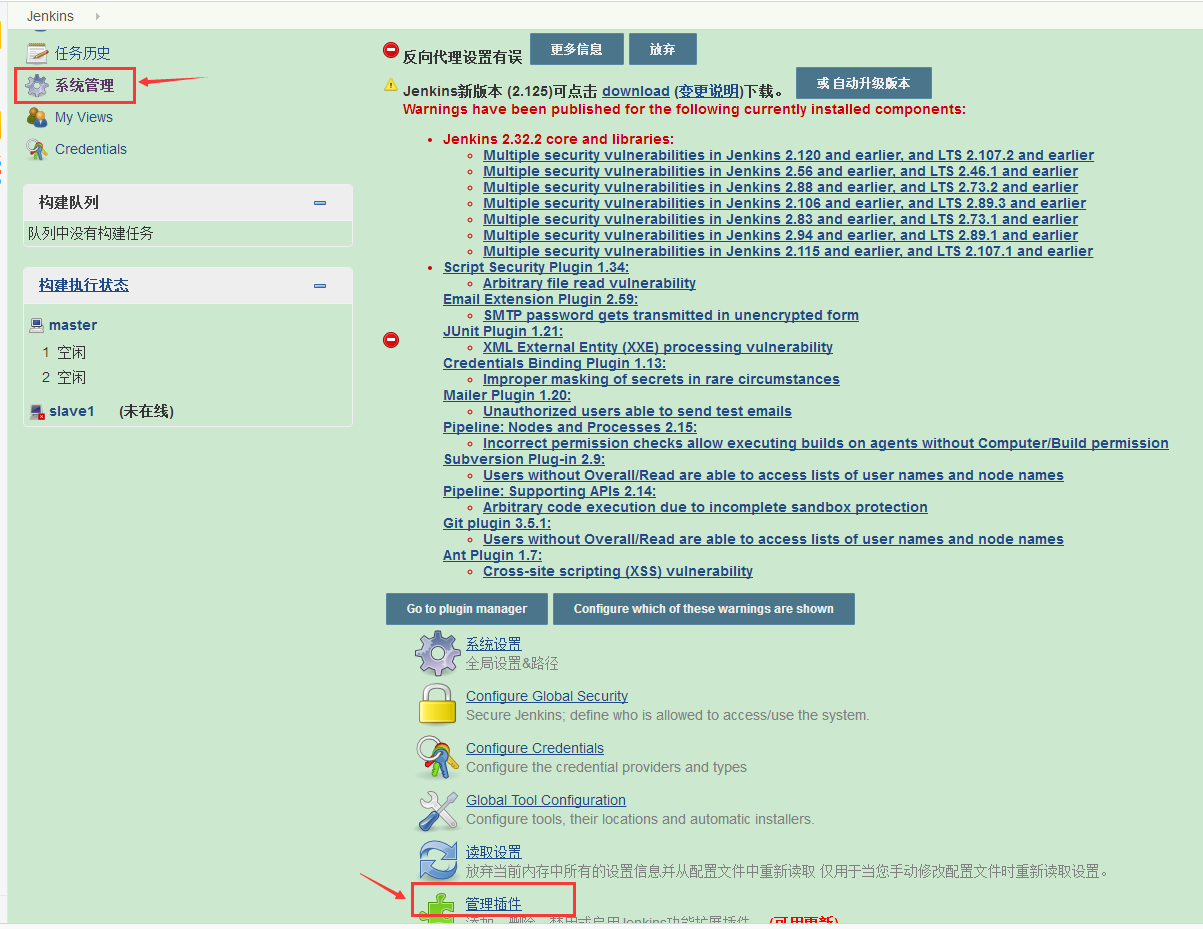
上篇我们通过Allure插件生成了测试report,并通过打开浏览器的方式查看图形化测试report,那要集成都Jenkins中去,并以邮件的方式发送测试report要怎么做呢?请看以下操作 一、搭建环境 1.jenkins环境搭建见《手把手教你搭建Jenkins+Jmeter+Ant自动化集成环境》中的Jenkins部分,这里不做介绍 二、在jenkins中配置插件 1.分别安装插件 Allure Jenkins Plugin 、HTML Publisher plugin a.在Jenkins的页面中点击“系统管理”->"管理插件",搜索“allure”,在搜索结果页,选择“Allure Jenkins Plugin”进行安装。安装完成之后重启一下Jenkins。 Jenkins界面 进入插件管理界面,选择“可选插件”->在右上角过滤编辑框中写入"Allure",按回车键,然后勾选Allure,点击直接安装 安装Allure插件 b.进入插件管理界面,选择“可选插件”->在右上角过滤编辑框中写入"HTML",按回车键,然后勾选HTML Publisher,点击直接安装 安装HTML Publisher 安装过程 安装完成 重启Jenkins 重启后可在“插件管理”界面查看到已安装成功的插件和插件版本 查看安装好的插件1 查看安装好的插件2 2.添加allure执行工具 下载allure压缩文件allure-commandline.zip,解压并添加allure路径至path环境变量 配置path 3.在Jenkins的主界面中找到并进入“(Global Tool Configuration)全局工具管理”页面 Global Tool Configuration管理界面 找到Allure Commandline安装 字样,点击新增Allure Commandline 安装Allure Commandline 点击后,在弹出下面的页面,输入Allure的命令别名和版本(这里我选择最新版本号)后,点击Apply 和Save 保存Allure配置 三、配置Job 1.在Jenkins主界面点击新建,进入如下界面,建立 jenkins 持续集成项目, 这里选择自由风格的项目,按照步骤执行操作后点击OK 输入项目名称 2.点击OK后进入Allure Report界面,如下图所示 进入项目配置界面 3.在Allure Report界面,分别配置“构建”和“构建后操作” a.配置构建步骤:进入Allure Report界面,找到“构建”下方的“增加构建步骤”,下来选择Excute Windows batch command 配置构建步 b.输入如下配置步骤指令: D: cd \work\pytest py.test -s -q --alluredir ${WORKSPACE}/report 配置指令 查看输出的log信息 原因:jenkins执行命令,会把命令生成一个批处理文件执行,而pytest命令对于批处理来说是外部命令,所以要加call表示调用。而jenkins执行windows命令,若退出代码不为0 ,则jenkins会将构建标记为失败,所以需要加上exit 0表示执行完成退出 解决方法:构建命令在py.test前面加上call,最后加上exit 0 重构指令 运行结果打印信息 c.在构建后操作下拉一栏选择“Allure Report”,进入“Allure Report”界面,写入保存报告的路径名称“report”,在“Properties”一栏分别写入Key和Value对应的变量值和存放测试用例文件的路径,如下图所示: 配置report路径 这里需要注意一点就是:执行指令生成测试报告的路径名称和保存测试报告的路径名称必须一致,不然会提示错误。如下图设置 设置测试报告名称 四、查看运行结果 在Jenkins界面点击“立即构建”,会在左下角出现进度条显示,当进度条显示完成后,刷新下当前界面,可以在页面右侧看到运行结果,点击界面的“Allure Report”字样,可查看该测试用例运行的详细情况 运行用例 运行结果1 运行结果2 运行结果3 运行结果4

优秀的个人博客,低调大师

大型分布式C++框架《四:netio之buffer管理器 下》

每周一篇又来了。这次主要介绍netio的buffer管理器。首先buffer管理是每一个网络层不可回避的问题。怎么高效的使用buffer是很关键的问题。这里主要介绍下我们的netio是怎么处理。说实话 这是我见过比较蛋疼buffer管理。 反正我是看了好几天 才看明白的。 最近看了下Qcon2016的视频.里面很多大牛介绍分布式平台。 感觉特别牛逼~~。 感觉我们的分布式相比他们的这些还是简陋了点。感兴趣的同学可以去看看 http://daxue.qq.com/content/special/id/20 1.1 我们先看下 一次系统调用recv就能收到完整包的情况 1)首先通过系统调用函数recv 会每次把从TCP读到的数据放到 m_achRecvBuf[TPT_RECV_BUF_LEN]; 这个buf大小为128*1024 2、判断包头。 先判断是否是0x5a5a 然后解析包头判断 需要发送过来的总长度 如果大于1024*1024就报错。 1024*1024是在初始化的时候申请的大小。 我们的一个最大请求包已经限定为1M 如果发现tcp一次就能收到完整的包。 netio并不会使用我们字节的buf管理器。 m_pSink->OnRecv而是直接丢给netio的app类去处理。 然后等netio中app类对包做了具体的处理后。 网络层 发现处理完以后就会直接 重新跳到while 循环中等待新事件 int CNetHandleMng::_RetrievePkgData(int nHandle,char* pRcvBuf,int nBufLen) { ...... //当前数据包已经读取完成 m_pSink->OnRecv(nHandle,pRcvBuf+TPT_HEAD_LEN,dwPkgLen); return (dwPkgLen + TPT_HEAD_LEN); } int CNetHandleMng::OnRecv(int nHandle,char* pRcvBuf,int nBufLen) { stConn* pConn = _GetConn(nHandle); if( NULL == pConn ) { std::stringstream oss; oss<<"reactor report recv data for connection handle"<<nHandle<<" but we cann't found the connection data"<<std::endl; m_pSink->ReportTptError(__FILE__,__LINE__,__func__,oss.str().c_str()); return 0; } int nReadLen =0; if( 0 == pConn->m_pRcvBuf->m_nDataLen ) { nReadLen = _RetrievePkgsData(nHandle,pRcvBuf,nBufLen); if( nReadLen < 0 ) return nReadLen;//reactor层会自动关闭连接 if( nReadLen >= nBufLen ) return 0;//数据已经处理完毕 ..... } 我们发现在一次recv能收完整个数据包的时候。平台没用字节的buf管理器。而是直接就给netio app类来处理了 1.2 我们先看下 一次系统调用recv收不完包的情况。 5.2.1 我们先分析下一个具体的例子 然后再慢慢的归纳和总结 a)为什么是256个指针? 初始化的时候 CNetioApp::CNetioApp():CNetMsgqSvr(4096*5,1024*1024,4*1024) 规定了一个最大请求包是 1024*1024 buffer管理器中 最小的一个buf大小是4*1024 (1024*1024+4*1024 -1 ) / (1024*4) = 256 然后分配256个大小的二维指针。 所以初始化的时候 会设置一个大小为256的二维指针。注意这里只是创建二维指针。当时并没有给每个指针指向的对象分配空间。 b) 当客户端首次connet的时候。会继续初始化一些信息 当客户端connet请求来临时候。会去buffer管理器取一块buffer。 默认情况下。都是取p[0]里的buffer。 当buffer管理器 发现p[0]为空的时候。 会去创建10个buffer 。这里10是写死的。 由于是p[0]是第一行。那么每个buffer的大小是4096. 这10个buffer 是一个链表。 index=0是最先创建的。index=9是最后创建的。 如上图。 index=9被拿出去了 。但其实这个时候并没有数据过来。 这个不管。被connet信息结构体指向的buffer。我们都认为是在使用中。 这个时候p[0] 就会跳到index=8. 注意 二维指针 永远是指向未被使用的buffer。这很重要。如果没有空间。会继续创建buffer c) 第一次recv 16384数据 这里发现收到的16384个字节 大于4096个字节。 则buffer管理器。会在p[3] 这里申请10个buffer块。 每块 1024*4*4=16384 刚好 放下recv的16384数据 因为不用p[0]的buffer块。 则先回退p[0]的指向。从index=8 到index=9 然后让connet信息块 重新指向p[3]的index=9 前面说了 二维指针一定要指向未被使用的buffer。 所有p[3] 指向index=8 同时在m_nDatalen里面记录 已经保存的字节数 这个时候还没有收完 需要继续收数据 d) 第二次recv 16384数据 注意 第二次也收到了16384. 那么第二次的16384 + 上次的16384 = 32768 这个时候p[3] 这一列的buffer放不下。 需要重新创建buffer 这个时候在p[7] 这一列上创建 4*1024*8 =32768 刚好放下所有数据 这个时候在p[7] 创建10个buffer 。 每个buffer为4*1024*8 接着还是要归还p[3] buffer的使用权。这个时候吧p[3]的指针指向index = 9 同时把 index=9里面的m_nDatalen设置为0. 这样就表示p[3]的index=9被 释放了。 但是其实index=9还是有内容的并没有清除。 接着我们把累加的数据 放到p[7]的index=9里面 e) 后面都是类似的逻辑。 归还空间。然后申请新空间 我看总共131158个字节的内容 recv 6次。 buffer管理器 替换了包括最开始初始化的的buffer总共花了7次 才找到合适的buffer来存放内容 p[32] 的buffer大小 为4*1024*33=135168 1.2.2. 正常情况下的buffer总大小 在netio包了一段时间后。假如各种包的大小都存在。那么最后会怎么样~~。 这256个指针 都会被创建buffer。 没一列的buffer大小是 4*1024*行数。比如第一行就是4*1024*1. 最后一行就是4*1024*256. 而且被创建的buffer不会被释放。我们来计算下这个总的buffer会多大。 4*1024*(1+2+3...+256)=1347420161347420161048576 134742016 / (1024 * 1024) = 128 M 大概128兆。但是 这只是并发请求不高的情况下。我们来看下并发请求高的情况下会怎么样 1.2.3. 高并发场景下 buffer的总大小 我们假设并发来了20个请求。为了使分析简单。我们就认为。每个请求数据都在4*1024以内。 如下图 用户p[0]的10个buffer以后。 p[0] 这个时候是指向了NULL的。 但是这个时候还有请求该怎么帮。 继续分配 这个时候再分配 10个buffer 如下图 又重新分配了10个buffer。 跟在0的后面。 在来的请求就是在后面的10个buffer中分配。 代码中是 每次网络层向buffer管理器申请buffer的时候。 会去查看 二维指针是否为空。不为空则把空间给出来存数据。 如果为空。则会申请10个内存 所有看到这。当并发请求很大的时候。这个buffer会突增大到一个很恐怖的数字。 而且由于 创建后的空间不会被删除。会一直维持一个很高的内存占用 1.2.4 buffer的释放。 我们以下图为例子。 请求 7、4、8 先后是否空间。 那么p[0] 先是指向 index=3 然后指向index=6 最后指向index=2 那么p[0] 指向的其实是 没有被使用的空间的 链表头。 p[0] ->index2->index6->index3 下次又有新请求来的时候。 则把index2分配给新请求使用 总结下: 1)netio的buffer初看还是很麻烦的。看了2、3天才看明白。主要是实现的思想还是有点复杂。但是个人感觉看下来并没有什么特别惊艳的地方。实现上感觉有点像google的tcmall。 2)申请不释放的好处就是不会产生大量内存碎片。 3)但是高并发场景下回内存爆增。且不会下去。 4)还有针对一个大包。需要多次recv。那么buffer管理器会不停的替换buffer来存数据。而不是解析包头。确定包的大小。然后指定一个刚好符合的buffer。然后每次recv数据都放在这个buffer里。而不用不停的替换buffer.

优秀的个人博客,低调大师

iOS: 复选框使用---第三方框架SSCheckBoxView-master

在iOS开发中对应用程序进行设置时一般都用UISwitch,偶尔显得单调,这时候你可以选择使用第三方开源类库SSCheckBoxView。 SSCheckBoxView是一个可用在iOS上一个复选框UI控件,提供选中和不被选中两种情况,和5中风格,如下图 GitHub下载地址:https://github.com/ardalahmet/SSCheckBoxView 原址:http://blog.csdn.net/duxinfeng2010/article/details/9071003 经过封装后的SSCheckBoxView使用起来也很简单,首先初始化它的frame,设置一下显示风格和是否被选中的状态,然后再添加到view上即完成一个复选框的显示 - (void)viewDidLoad { [super viewDidLoad]; SSCheckBoxView *cb = [[SSCheckBoxView alloc] initWithFrame:CGRectMake(50, 50, 30, 30) style:kSSCheckBoxViewStyleMono checked:YES]; [self.view addSubview:cb]; } 五种显示风格,传参的时候也可传0-5之间数设置显示风格 typedef enum SSCheckBoxViewStyle_ { kSSCheckBoxViewStyleBox = 0, kSSCheckBoxViewStyleDark, kSSCheckBoxViewStyleGlossy, kSSCheckBoxViewStyleGreen, kSSCheckBoxViewStyleMono, kSSCheckBoxViewStylesCount } SSCheckBoxViewStyle;如果需要说明复选框干什么用的,设置下text即可,但是需要对SSCheckBoxView对象的宽度进行适配,宽度太短会显示不完全;对复选框观察提供两种方式,一种是使用选择的器,另一种是使用Block; - (void)viewDidLoad { [super viewDidLoad]; SSCheckBoxView *cb = [[SSCheckBoxView alloc] initWithFrame:CGRectMake(50, 50, 300, 30) style:kSSCheckBoxViewStyleMono checked:YES]; [cb setText:@"这个是什么呢"]; [cb setStateChangedTarget:self selector:@selector(checkBoxViewChangedState:)]; [self.view addSubview:cb]; SSCheckBoxView *cb2 = [[SSCheckBoxView alloc] initWithFrame:CGRectMake(50, 80, 300, 30) style:3 checked:YES]; [cb2 setText:@"使用Block观察是否选中"]; [cb2 setStateChangedBlock:^(SSCheckBoxView *cbv) { NSLog(@"复选框状态: %@",cbv.checked ? @"选中" : @"没选中"); }]; [self.view addSubview:cb2]; } -(void)checkBoxViewChangedState:(SSCheckBoxView*)cbv { NSLog(@"复选框状态: %@",cbv.checked ? @"选中" : @"没选中"); } 效果图: 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 本文转自当天真遇到现实博客园博客,原文链接:http://www.cnblogs.com/XYQ-208910/p/5194493.html ,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册