首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

Android插件化——谈谈我理解的坑位

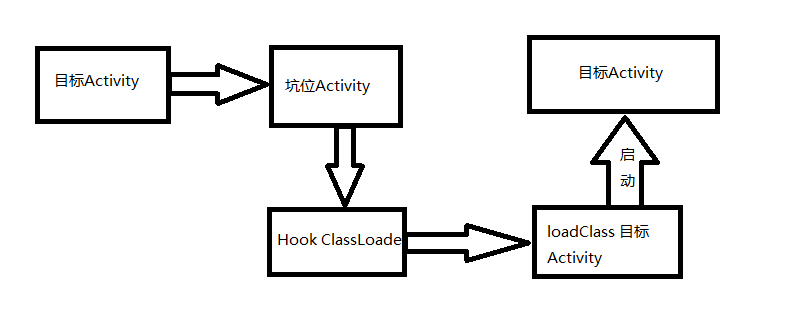
坑位的概念 第一次听说坑位的概念是在360开源插件化框架RePlugin,我印象最深刻的就是在演讲过程中提到的只Hook了一处以及独创坑位概念。虽然下载了源码并且也大致了解了原理,但是自己好像还是有些模糊,感觉抓不到重点。昨天在看Hook AMS来实现启动一个不在AndroidManifest注册的Activity,因为版本问题,网上代码基本上都不行了。突然想起这个坑位法,决定自己尝试一次! 原理 坑位的概念是指在AndroidManifest中注册,但并没有真实的实现类,只作为其他Activity启动的坑位 Hook点为ClassLoader,Android中的ClassLoader有两个,分别为DexClassLoader和PathClassLoader,用于加载APK的是PathClassLoader,也是Android里面默认的类加载器,这个也就是需要Hook的地方。 过程如下: 启动流程 这个原理是真心简单,这里需要有关于ClassLoader和Activity启动流程的知识。 我们知道在启动一个新的Activity时,AMS会对其进行很多检测,例如是否在AndroidManifest中注册,是否有权限启动等等。如果这些都通过,那么需要判断当前的进程是否存在,不存在需要先调用 ActivityThread.main()方法,开启线程循环以及启动Application。最终会通过ActivityThread的Handler发送一条为“BIND_APPLICATION”的消息,通过这个消息,Handler来处理这次 Application的创建过程。这里会创建Application、LoadedApk等。 LoadedApk对象是APK文件在内存中的表示。 Apk文件的相关信息,诸如Apk文件的代码和资源,甚至代码里面的Activity,Service等组件的信息我们都可以通过此对象获取。注意:这里会创建一个ClassLoader作为类加载器,也就是我们需要Hook的。 LoadedApk.java public ClassLoader getClassLoader() { synchronized (this) { if (mClassLoader == null) { createOrUpdateClassLoaderLocked(null /*addedPaths*/); } return mClassLoader; } } Activity的创建是通过反射创建,使用的就是上面提到的ClassLoader,所以我们只需要Hook住这个ClassLoader,通过类的双亲委派机制来实现我们自己的逻辑即可。 源码分析部分省略,位置在ActivityThread处理LAUNCH_ACTIVITY的消息类型处。 代码实现 Hook代码: public static void hookClassLoader(Application context) { try { // 获取Application类的mLoadedApk属性值 Object mLoadedApk = getFieldValue(context.getClass().getSuperclass(), context, "mLoadedApk"); if (mLoadedApk != null) { // 获取其mClassLoader属性值以及属性字段 final ClassLoader mClassLoader = (ClassLoader) getFieldValue(mLoadedApk.getClass(), mLoadedApk, "mClassLoader"); if (mClassLoader != null) { Field mClassLoaderField = getField(mLoadedApk.getClass(), "mClassLoader"); // 替换成自己的ClassLoader mClassLoaderField.set(mLoadedApk, new ClassLoader() { @Override public Class<?> loadClass(String name) throws ClassNotFoundException { // 替换Activity if (name.endsWith("MainActivity2")) { Log.d(TAG, "loadClass: name = " + name); name = name.replace("MainActivity2", "MainActivity3"); Log.d(TAG, "loadClass: 替换后name = " + name); } return mClassLoader.loadClass(name); } }); } } } catch (NoSuchFieldException e) { e.printStackTrace(); } catch (IllegalAccessException e) { e.printStackTrace(); } } /** * 反射获取属性值 * * @param c class * @param o 对象 * @param fieldName 属性名称 * @return 值 * @throws NoSuchFieldException e * @throws IllegalAccessException e */ public static Object getFieldValue(Class c, Object o, String fieldName) throws NoSuchFieldException, IllegalAccessException { Field field = getField(c, fieldName); if (field != null) { return field.get(o); } else { return null; } } /** * 反射获取对象属性 * * @param aClass c * @param fieldName 属性名称 * @return 属性 * @throws NoSuchFieldException e */ private static Field getField(Class<?> aClass, String fieldName) throws NoSuchFieldException { Field field = aClass.getDeclaredField(fieldName); if (field != null) { field.setAccessible(true); } return field; } 注释写的比较清楚,简单说下原理: 获取Application的LoadedApk对象mLoadedApk 获取LoadedApk的属性ClassLoader mClassLoader 通过反射进行替换,这里写死了一些内容,比如遇到名称为MainActivity2的Activity则替换成MainActivity3 测试 Application初始化: public class MyApplication extends Application { @Override public void onCreate() { super.onCreate(); HookUtils.hookClassLoader(this); } } 设置坑位 AndroidManifest注册一个不存在的Activity 坑位 启动Activity override fun onCreate(savedInstanceState: Bundle?) { super.onCreate(savedInstanceState) setContentView(R.layout.activity_main) val listener = object : View.OnClickListener { override fun onClick(v: View?) { val intent = Intent() intent.component = ComponentName("com.example.administrator.test", "com.example.administrator.test.MainActivity2") startActivity(intent) } } // Example of a call to a native method sample_text.text = "MainActivity" bt_test.setOnClickListener(listener) } 结果 结果 结果 可以看到,通过这种方式实现了不在AndroidManifest中注册,但是可以启动Activity的效果。这里可以应用到插件化中,如Replugin,编译时自动注入坑位,运行时进行确定坑位。当然了,这里只是做一些微小的实现,如果想要真正完成完美的插件化,那真是革命尚未成功,同志仍需努力。 总结 当真正读懂摸个框架源码的时候,我常常会想:为什么我没有想到这种方式?可能是缺少经验,也可能是思维固化了吧。保持一颗学习的心,多看看,多想想。

优秀的个人博客,低调大师

深入理解跨域SSO原理与技术

一:SSO体系结构 SSO ​ SSO英文全称Single Sign On,单点登录。SSO是在多个应用系统中,用户只需要登录一次就可以访问所有相互信任的应用系统。它包括可以将这次主要的登录映射到其他应用中用于同一个用户的登录的机制。它是目前比较流行的企业业务整合的解决方案之一。 体系结构 ​ 当用户第一次访问应用系统1的时候,因为还没有登录,会被引导到认证系统中进行登录;根据用户提供的登录信息,认证系统进行身份校验,如果通过校验,应该返回给用户一个认证的凭据--token;用户再访问别的应用的时候就会将这个token带上,作为自己认证的凭据,应用系统接受到请求之后会把token送到认证系统进行校验,检查token的合法性。如果通过校验,用户就可以在不用再次登录的情况下访问应用系统2和应用系统3了 。 Token(令牌) token的意思是“令牌”,是服务端生成的一串字符串,作为客户端进行请求的一个标识。 当用户第一次登录后,服务器生成一个token并将此token返回给客户端,客户端收到token后把它存储起来,可以放在cookie或者Local Storage(本地存储)里。 以后客户端只需带上这个token前来请求数据即可,无需再次带上用户名和密码。 简单token的组成;uid(用户唯一的身份标识)、time(当前时间的时间戳)、sign(签名,token的前几位以哈希算法压缩成的一定长度的十六进制字符串。为防止token泄露)。 设计token的值可以有以下方式 用设备mac地址作为token 用sessionid作为token 同域SSO原理分析 实际上,HTTP协议是无状态的,单个系统的会话由服务端Session进行维持,Session保持会话的原理是通过Cookie把sessionId写入浏览器,每次访问都会自动携带全部Cookie,在服务端读取其中的sessionId进行验证实现会话保持。同域下单点登录其实就是手写token代替sessionId进行会话认证。 token的生成 服务端生成token后,将token与user对象存储在Map结构中,token为Key,user对象为value,response.addCookie()生成新的Cookie,名为token,值为token的值。 token过期移除 将服务端的token从Map中移除,再删除浏览器端的名为token的Cookie。 认证流程 跨域SSO原理分析 当有多个系统时,认证机制的流程如下: 提供用户登录界面,供用户进行身份认证 用户验证通过后,生成新token 将token<->user 对存入全局MAP中供校验 将token写入所有域的Cookie中 页面重定向回原始请求URL 分析 当系统有多个并且在不同域(domain)时,Cookie只会作用在当前域下。 将token写入所有域的Cookie中才是解决跨域SSO的核心。 二:Cookie增删改查 如何读取Cookie? 通过Servlet中的request对象可以读取到Cookie数组,然后foreach遍历读取,一般只是获取到nam和value,其他信息写入到浏览器后,浏览器不主动再发回来,读取并无意义。 Cookie[] cookies = request.getCookies(); if (cookies != null) { for (Cookie cookie : cookies) { System.out.println( cookie.getName() + cookie.getValue() + cookie.getMaxAge() + cookie.getPath() + cookie.getDomain() + cookie.getSecure() + cookie.isHttpOnly()//客户端js是否可以获取 ); } } 如何写入Cookie带浏览器? 新建Cookie对象设置一系列属性,然后添加到response中去。需要注意的是,当设置path为“/”时,表示所有路径都会被该Cookie作用到,如果设置为/path1那么由/path2发起请求就不会携带该Cookie。默认不设置只作用在当前路径下。 Cookie cookie = new Cookie("myCookieName","myCookieValue"); cookie.setHttpOnly(false);//Javascript不能处理 //一个正值表示cookie将在经过许多秒之后过期。注意,值是cookie过期的最大时间,而不是cookie当前的时间。 //负值表示cookie没有持久存储,在Web浏览器退出时将被删除。零值会导致删除cookie。 cookie.setMaxAge(-1000); cookie.setSecure(false);//如果为true,仅支持HTTPS协议 //cookie对指定目录中的所有页面以及该目录子目录中的所有页面都可见。 cookie.setPath("/"); //cookie.setDomain("www.a.com");//默认情况下,cookie只返回给发送cookie的服务器。 response.addCookie(cookie); 修改Cookie 修改更新Cookie时,除了要保证Cookie的name是相同的,也要保证Cookie的一系列属性是相同的,否则浏览器会生成新的Cookie。 删除Cookie 只需要设置Cookie的MaxAge为负值,意味着是过去的Cookie,浏览器就会清除。 三:跨域读写Cookie 1.利用HTML的script标签跨域写Cookie 比如当前域是www.a.com,下面的script标签是跨域写cookie的核心,通过此标签实现了向www.b.com域写入cookie: <script type="text/javascript" src="http://www.b.com/setCookie?cname=token&cval=123456"></script> P3P协议 ​ P3P是一种被称为个人隐私安全平台项目(the Platform for Privacy Preferences)的标准,能够保护在线隐私权,使Internet冲浪者可以选择在浏览网页时,是否被第三方收集并利用自己的个人信息。如果一个站点不遵守P3P标准的话,那么有关它的Cookies将被自动拒绝,并且P3P还能够自动识破多种Cookies的嵌入方式。p3p是由全球资讯联盟网所开发的。 举个例子: ​ 我们在访问A网站时,理论上说,我们只能把Cookie信息保存到A站域名下,而不能写入到B网站下。如果想要跨域读写Cookie,只是通过script标签变相访问B网站在一些浏览器是行不通的,此时B网站的服务器应该告诉浏览器允许A网站写入Cookie,否则浏览器将会拒绝执行,这就是P3P协议。 服务端如何告诉浏览器? ​ P3P提供了一种简单的方式 ,来加载用户隐私策略,只要在http响应的头信息中增加 response.setHeader("P3P","CP=NON DSP COR CURa ADMa DEVa TAIa PSAa PSDa IVAa IVDa CONa HISa TELa OTPa OUR UNRa IND UNI COM NAV INT DEM CNT PRE LOC);而无需指定隐私策略文件也可以达到指定隐私策略的目的。 CP=后面的字符串分别代表不同的策略信息。 总结 因为P3P协议所以不能保证所有浏览器都能通过script标签方式跨域写Cookie,有的浏览器本身就是拒绝跨域的。 显然这种方式是不能保证跨域写cookie的成功性。 2.通过URL参数实现跨域信息传递 我们要在A域实现写入token到B域,需要在A域设计一个servlet接收请求,代码: @WebServlet(name = "tg") public class Servlet extends HttpServlet { protected void doPost(HttpServletRequest request, HttpServletResponse response) throws IOException { //获取请求的目标域 String from = request.getParameter("from"); //生成token, String token = "123456"; //重定向到目标域 response.sendRedirect(from + "?cname=token&cval=" + token); } ... } 由a域发起请求,请求地址:http://www.a.com/tg?from=http://www.b.com/set_cookie, 请求后该Servlet会获取from参数的值并生成token最后让客户端重定向到http://www.b.com/set_cookie?cname=token&cval=123456,然后B域的Servlet("set_cookie")获取Url参数写入Cookie到客户端,代码: //将要写入的cookie项,调用者通过参数传递 String cookieName = request.getParameter("cname"); String cookieValue = request.getParameter("cval"); //生成cookie Cookie cookie = new Cookie(cookieName,cookieValue); cookie.setPath("/"); //一般可以将domain设置到顶级域 //cookie.setDomain("www.b.com"); response.addCookie(cookie); 这时候再查看B域下的Cookie就可以发现(token=123456)已经被写入到浏览器。 3.读取其它域的Cookie 利用script标签 利用script标签执行另一个域实现的读取cookie方法,script标签返回结果将是变量定义形式的JS代码,每一个变量表示一个cookie项,这些代码加载后,此页面后续JS代码可以直接在script脚本中读取已定义的变量值,即各cookie值。 <script type="text/javascript" src="http://www.b.com/reaf_cookies"></script> HTML页面读取 <script> alert(token); </script> B域的url为/read_cookies的Servlet是如何实现的? 如图,首先我们先在request中获取cookie数组,然后for循环遍历拼接为类似var token='test123';的字符串。最重要的是设置ContentType为application/javascript,代码如下: protected void doGet(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException { Cookie[] cookies = request.getCookies(); StringBuilder stringBuilder = new StringBuilder(); //一定要设置响应类型,否则可能导致IE不解析js直接进行下载操作 response.setContentType("application/javascript"); if (cookies != null) { for (Cookie cookie : cookies) { //结果类似于这样 var token='123456'; stringBuilder.append("var ") .append(cookie.getName()) .append("=") .append("'") .append(cookie.getValue()) .append("'") .append(";"); } response.getWriter().append(stringBuilder.toString()); } } 四:跨域Ajax请求 1.Jsonp的方式 跨域Ajax请求在浏览器阶段就会被阻止,我们可以通过script标签返回想要的json数据。如图: <script type="text/javascript" src="http://www.b.com/user_info_2"></script> 后台Servlet代码 //要正确设置响应类型,避免IE出现下载 response.setContentType("application/javascript"); String userInfo = "{\"id\":1,\"name\":\"zhangsan\"}"; //返回拼接的javascript语句字符串,语句本身执行一个调用函数的操作 String ret = "showResult("+userInfo+")"; 在Servlet中设置返回类型为javascript,并正常获取json格式的数据,最关键的是在最后拼接为js语句字符串,语句本身就是执行一个调用函数的操作: showResult({"id":1,"name":"zhangsan"}) 而showResult(ret)回调函数自然需要我们在之前就定义好: <script> function showResult(ret){ console.log(ret) } </script> 优化 这种方式,前端的回调函数和后端耦合度较高。前端可以在调用后端方法时带上回调函数名(?callback=xxxxx),后端优化后的代码: //通过参数传递回调函数名,一定程度降低了前后端代码的耦合度 String callback = request.getParameter("callback"); //返回拼接的javascript语句字符串,语句本身执行一个调用函数的操作 String ret = callback+"("+userInfo+")"; 再优化 HTML页面加载到我们定义的script标签时就会执行我们的回调方法,更多时候我们想要控制回调方法的执行时机。这个问题可以通过前端动态生成节点来解决,当我们执行完之后再移除节点即可: <script> var script = document.createElement("script"); script.src = "http://www.b.com/user_info_2?callback=showResult"; document.body.appendChild(script); script.onload = function () { document.body.removeChild(script); } </script> JQuery 我们可以把这些封装到一个方法里,随时调用。这里可以使用Jquery封装好的API。 $.ajax({ url: "http://localhost:9090/query", type: "GET", dataType: "jsonp", //指定服务器返回的数据类型 jsonpCallback: "showData", //指定回调函数名称 success: function (data) { console.info("调用success"); } }); function showData(data){ var result = JSON.stringify(data); } 2.CORS简介 出于安全原因,浏览器限制从脚本内发起的跨源HTTP请求。 例如,XMLHttpRequest和Fetch API遵循同源策略。 这意味着使用这些API的Web应用程序只能从加载应用程序的同一个域请求HTTP资源,除非使用CORS头文件。 跨域资源共享(CORS)机制允许Web 应用服务器进行跨域访问控制,从而使跨域数据传输得以安全进行。浏览器支持在 API 容器中(例如XMLHttpRequest或Fetch)使用 CORS,以降低跨域 HTTP 请求所带来的风险。 GET跨域请求原理 当客户端浏览器发起一个跨域的HTTP请求,浏览器经过请求响应,如果没有看到Access-Control-Allow-Origin的header头部,会认为你的请求是不合法的。换句话说,我们只要在被请求的服务器上设置这个头部,浏览器就会允许我们进行请求。 解决方法 对于简单的请求,我们直接在服务端 设置就可以了。如图,只要请求的地址是www.a.com就会被浏览器允许跨域。如果想要允许对于多个来源可以用,号进行隔开;如果想要允许所有来源,设置为*就可以,不过建议不要使用,这样会造成安全隐患。 protected void doGet(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException { //简单请求,直接设置Access-Control-Allow-Origin就可以了 response.setHeader("Access-Control-Allow-Origin","*"); //要正确设置响应类型,避免IE出现下载 response.setContentType("application/json"); response.getWriter().write("{\"id\":1,\"name\":\"zhangsan\"}"); } 对于复杂的请求,比如POST,或者加入了自定义header头部,上面的方法就不适用了。下面继续看。 CORS流程 请求发起时,浏览器先判断当前是否是跨域的AJAX; 如果是,判断是否是普通类型请求(GET类型,无自定义头数据); 普通请求,直接发起GET到服务端,在响应头中寻找 Access-Contro-Alow- Origin,如果有且允许,处理响应结果; 不是普通请求(非GET类型,或有自定义头), 先 PreFlight(即发起一个 method= OPTIONS)的请求, 要求返回 Access-Control-Allow- Methods和 Access-Control-Allow- Headers, 内容体为空 PreFlight正确执行后, 再发起GET请求, 获得响应结果, 并处理结果. 实现 归根到我们的代码中的实现,只需要在servlet中定义options请求的处理方法即可。如图 protected void doOptions(HttpServletRequest req, HttpServletResponse response) { response.setHeader("Access-Control-Allow-Origin","*"); response.setHeader("Access-Control-Allow-Methods","GET,POST,OPTIONS,DELETE"); response.setHeader("Access-Control-Allow-Headers","reqid,xxx"); } 注意:Access-Control-Allow-Origin是必需的。 3.两种跨域AJax请求对比 兼容性 Jsonp对所有浏览器兼容,CORS对现代浏览器兼容(IE8之后)。 请求方式 Jsonp只支持GET方式,CORS支持GET,POST等。 调用方式 Jsonp需要服务端封装返回信息,CORS更像原生AJax一样使用。

优秀的个人博客,低调大师

web前端学习:深入理解JS闭包

第一部分:初遇闭包 http://www.runoob.com/js/js-function-closures.html 什么是闭包?闭包有什么作用?这是我遇到闭包时的第一反应。 闭包在JavaScript高级程序设计(第3版)中是这样描述:闭包是指有权访问另一个函数作用域中的变量的函数。 那么闭包的作用也就很明显了。 1. 可以在函数的外部访问到函数内部的局部变量。 2. 让这些变量始终保存在内存中,不会随着函数的结束而自动销毁。 在上面的代码中,闭包指的就是function () {return counter += 1;}这个函数。首先解释一下这段代码,在变量add被赋值之前,第一个function执行了一次(执行且仅会执行一次),因为这是一个函数表达式声明方式并且声明后加上了(),所以会自动执行一次。执行后add被赋值(匿名函数)了,add= function () {return counter += 1;}。然后每次调用add()函数时,返回的都是这个函数,因为这个函数在第一个函数的内部,所以即使第一个函数执行完了,第二个函数依然能访问counter(JS设计的作用域链,当前作用域能访问上级的作用域)。 闭包是可以在另一个函数的外部访问到其作用域中的变量的函数。而被访问的变量可以和函数一同存在。即使另一个函数已经运行结束,导致创建变量的环境销毁,也依然会存在,直到访问变量的那个函数被销毁。当然,如果仅仅是做一个简单的计数器,大可不用这样麻烦。下面这简短的代码就能轻松实现。 var a = 0; function myFunction(){ a++; document.getElementById("demo").innerHTML = a; } 第二部分:牛客翻船 https://www.nowcoder.com/questionTerminal/da4115e308c948169a9a73e50d09a3e7 下面是这个题目的解答: 每个li标签的onclick事件执行时,本身onclick绑定的function的作用域中没有变量i,i为undefined,则解析引擎会寻找父级作用域,发现父级作用域中有i,且for循环绑定事件结束后,i已经赋值为4,所以每个li标签的onclick事件执行时,alert的都是父作用域中的i,也就是4。这是作用域的问题。 闭包只能取得包含函数中任何变量的最后一个值。因为别忘了闭包所保存的是整个变量对象,而不是某个特殊的变量。 这是在循环体中创建闭包的常见错误。https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Closures(一定要看这篇) 这里面给onclick赋值的是闭包。很多人会问为什么是闭包?之前闭包不是函数A里的函数B吗?函数B用来访问函数A的变量,称函数B是闭包,题目中只有一个函数为什么也是闭包。其实,用两个函数形成闭包只是一般形式。闭包真正的含义是,如果一个函数访问了此函数的父级及父级以上的作用域变量,就可以称这个函数是一个闭包。 var a = 1; (function test (){ alert(a); })() 所以上面的function都可以称之为闭包(匿名闭包函数)。 这里还是作用域的问题,那么我们把每次的i都保存到一个变量中,匿名闭包就可以实现想要的效果。 这样就使用了闭包,这里面的闭包指的是function() {alert(num);};第二个function里面弹出的num是第一个function的参数,通过(i)执行了这里面的第一个函数,同时i的值被保存到num中。每个点击事件中都有一个局部变量num,num保存的是相应的i值。 第三部分:let的横空出世 上面的牛客题目只需要将for(var i=0;ihttps://mp.csdn.net/postedit/81065540 let的到来,让令人诟病的JS获得了一丝生机,也补上了JS没有块级作用域的短板。ECMAScript6还有很多新特性,笔者也在不断学习中。 第四部分:闭包的应用 函数工厂和闭包模拟私有方法 https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Closures(这篇讲得很好,希望大家读透) 感谢阅读 喜欢看小编文章的点个订阅或者喜欢!小编每天都会跟大家分享文章,也会给大家提供web前端学习资料。

优秀的个人博客,低调大师

深入理解 Flutter 的编译原理与优化

阿里妹导读:对于开发者而言,Flutter工程和我们的Android/iOS工程有何差别?Flutter的渲染和事件传递机制如何工作?构建缓慢或出错又如何去定位,修改和生效呢?凡此种种,都需要对Flutter从设计,开发构建,到最终运行有一个全局视角的观察。 本文由闲鱼技术团队出品,将以一个简单的hello_flutter为例,介绍下Flutter相关原理及定制与优化。 Flutter简介 Flutter的架构主要分成三层:Framework,Engine和Embedder。 Framework使用dart实现,包括Material Design风格的Widget,Cupertino(针对iOS)风格的Widgets,文本/图片/按钮等基础Widgets、渲染、动画、手势等。此部分的核心代码是:flutter仓库下的flutter pac

优秀的个人博客,低调大师

深入理解flutter的编译原理与优化

闲鱼技术-正物 问题背景 对于开发者而言,什么是Flutter?它是用什么语言编写的,包含哪几部分,是如何被编译,运行到设备上的呢?Flutter如何做到Debug模式Hot Reload快速生效变更,Release模式原生体验的呢?Flutter工程和我们的Android/iOS工程有何差别,关系如何,又是如何嵌入Android/iOS的呢?Flutter的渲染和事件传递机制如何工作?Flutter支持热更新吗?Flutter官方并未提供iOS下的armv7支持,确实如此吗?在使用Flutter的时候,如果发现了engine的bug,如何去修改和生效?构建缓慢或出错又如何去定位,修改和生效呢? 凡此种种,都需要对Flutter从设计,开发构建,到最终运行有一个全局视角的观察。 本文将以一个简单的hello_flutter为例,介绍下Fl

优秀的个人博客,低调大师

谈谈我对Exception和Error的理解(未完)

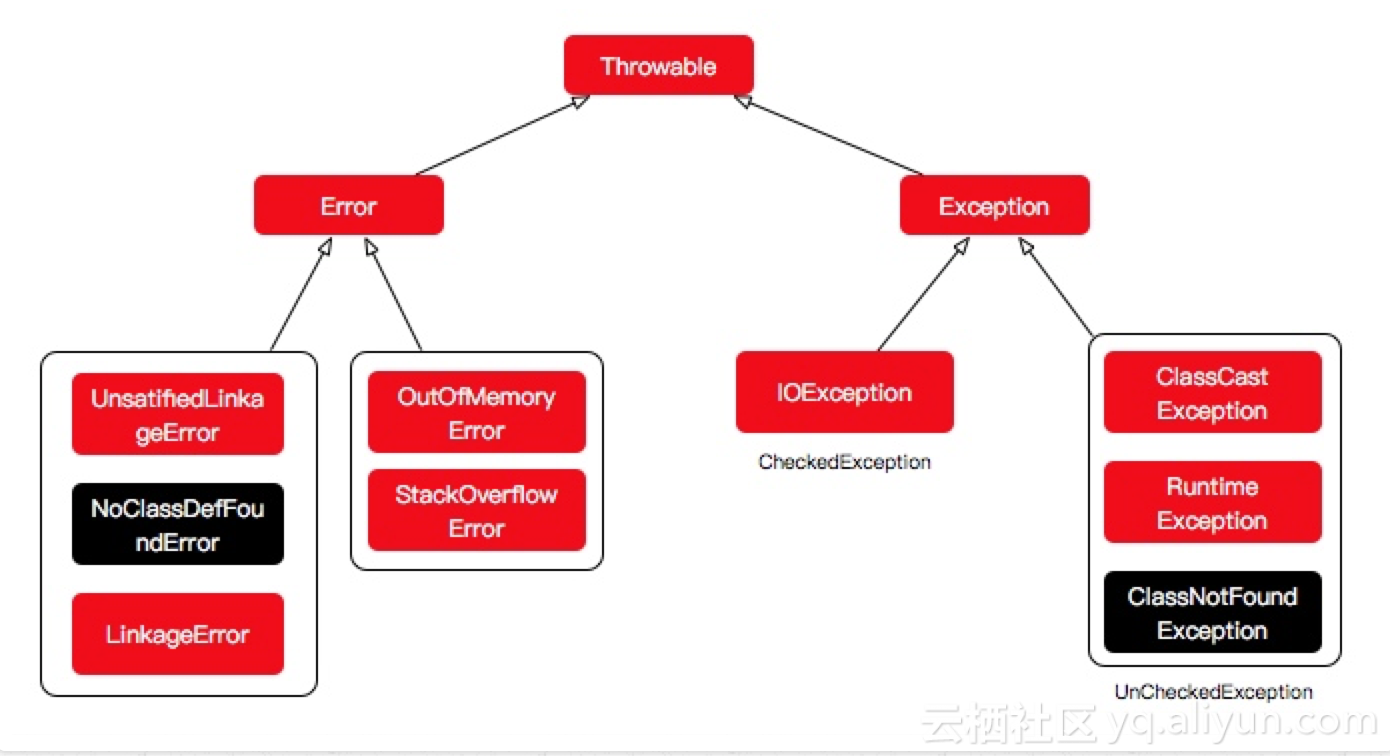
NoClassDefFoundError/ClassNotFoundException NoClassDefFoundError发生在jvm运行时,执行某个方法或者静态成员时,如果jvm加载不到该类时报错的错误。本地编译没报错,但运行时报错,有可能该类对类加载器而言是不可见的。 ClassNotFoundException发生与编译时根据classpath找不到对应类时报的错误。 由于User类为"private"修饰,Test.java里的main无权访问,编译时不会报错到运行时因找到User类NotClassDefFoundError: import java.util.ArrayList; import java.util.List; /** * Created by fujianbo on 2018/5/12. * * @author fujianbo * @date 2018/05/12 */ public class Test { public static void main(String args[]){ List<User> users = new ArrayList<>(2); try { users.add(new User("1234")); } catch (Throwable t) { t.printStackTrace(); } } } class User{ private static String USER_ID = getUserId(); public User(String id){ this.USER_ID = id; } private static String getUserId() { throw new RuntimeException("UserId Not found"); } } 不良案例 捕获时异常要明确异常类型,提高代码可读性 public class Test { public static void main(String args[]){ try { Thread thread = new Thread(); // do something // ... thread.wait(); } catch (InterruptedException e) { } } } 捕获异常范围不宜过大 RuntimeException更应该扩散而不是捕获(很多时候我们并不能处理这类异常),如Throwable或则Error也是如此。 不要使用标准输出打印异常 try { Thread thread = new Thread(); // do something // ... thread.wait(); } catch (InterruptedException e) { e.printStackTrace(); } 使用e.printStackTrace将导致异常堆栈输出到标准异常流,这很难判断日志最终被输出都哪里而丧失监控的意义。 throw early & catch late原则 public static void main(String args[]){ loadFile(null); } private static void loadFile(String fileName) { try { FileInputStream fileInputStream = new FileInputStream(fileName); func1(fileInputStream); func2(fileInputStream); } catch (FileNotFoundException e) { // take logs here } } private static void func1(FileInputStream fileInputStream) { if (fileInputStream == null) { return; } // do something } private static void func2(FileInputStream fileInputStream) { // do something } throw early可节省查看堆栈排查问题的时间,无论使用断言还是if判断都可以简单做到。 自定义异常 Checked Exception的初衷为从异常中恢复,哪些要恢复以及怎么恢复依赖于精细化的异常分类 异常信息不要包含敏感信息,这是ConnectionException不打印ip和端口信息的原因 Checked Exception Or Unchecked Exception? [引用自某博客,出处后续补上]虽然反对使用Checked Exception的声音不少,但Checked Exception在提示不要忘记处理异常,虽然调用该方法的方法体需要申明外抛异常,但至少可以指导底层会抛哪些异常,在自定义异常时提供了有效信息(异常种类划分&处理) Unchecked Exception使代码更简洁,但容易丢失详细堆栈信息。如调用链路横跨多个流程,每个流程涉及到的方法调用都有上下文,哪一步出错可以依赖不同流程的上下文打印信息,快速定位问题。 try/catch代码块产生额外的性能开销,影响jvm优化(尽量缩小try/catch块的大小) 实例化一个Exception会保留执行时的堆栈快照,该过程为相对较重的操作。 思考 Reactive Stream(异步、基于事件机制),出现异常不能简单外抛。由于代码堆栈不在是同步调用时的垂直结构,我们看到的是特定executor的堆栈。那如何处理这类异常呢?(未完待续...)

优秀的个人博客,低调大师

Scala关键字lazy的理解和使用

Scala中使用关键字lazy来定义惰性变量,实现延迟加载(懒加载)。惰性变量只能是不可变变量,并且只有在调用惰性变量时,才会去实例化这个变量。 在Java中,要实现延迟加载(懒加载),需要自己手动实现。一般的做法是这样的: public class LazyDemo { private String property; public String getProperty() { if (property == null) {//如果没有初始化过,那么进行初始化 property = initProperty(); } return property; } private String initProperty() { return "property"; } } 比如常用的单例模式懒汉式实现时就使用了上面类似的思路实现。 而在Scala中对延迟加载这一特性提供了语法级别的支持: lazy val property = initProperty() 使用lazy关键字修饰变量后,只有在使用该变量时,才会调用其实例化方法。也就是说在定义property=initProperty()时并不会调用initProperty()方法,只有在后面的代码中使用变量property时才会调用initProperty()方法。 如果不使用lazy关键字对变量修饰,那么变量property是立即实例化的: object LazyOps { def init(): String = { println("call init()") return "" } def main(args: Array[String]) { val property = init();//没有使用lazy修饰 println("after init()") println(property) } } 上面的property没有使用lazy关键字进行修饰,所以property是立即实例化的,如果观察程序的输出: call init() after init() 可以发现,property声明时,立即进行实例化,调用了init()`实例化方法 而如果使用lazy关键字进行修饰: object LazyOps { def init(): String = { println("call init()") return "" } def main(args: Array[String]) { lazy val property = init();//使用lazy修饰 println("after init()") println(property) println(property) } } 观察输出: after init() call init() 在声明property时,并没有立即调用实例化方法intit(),而是在使用property时,才会调用实例化方法,并且无论缩少次调用,实例化方法只会执行一次。 与Java相比起来,实现懒加载确实比较方便了。那么Scala是如何实现这个语法糖的呢?反编译看下Scala生成的class: private final String property$lzycompute$1(ObjectRef property$lzy$1, VolatileByteRef bitmap$0$1) { synchronized (this)//加锁 { if ((byte)(bitmap$0$1.elem & 0x1) == 0)//如果属性不为null {//那么进行初始化 property$lzy$1.elem = init();bitmap$0$1.elem = ((byte)(bitmap$0$1.elem | 0x1)); } return (String)property$lzy$1.elem; } } Scala同样使用了Java中常用的懒加载的方式自动帮助我们实现了延迟加载,并且还加锁避免多个线程同时调用初始化方法可能导致的不一致问题。 借鉴崔鹏飞的小结 对于这样一个表达式: lazy val t:T = expr 无论expr是什么东西,字面量也好,方法调用也好。Scala的编译器都会把这个expr包在一个方法中,并且生成一个flag来决定只在t第一次被访问时才调用该方法。 本文的编写借鉴了剥开Scala的糖衣(5) -- Lazy

优秀的个人博客,低调大师

深入理解JVM(八)——类加载的时机

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612705 类的生命周期 一个类从加载进内存到卸载出内存为止,一共经历7个阶段:加载——>验证——>准备——>解析——>初始化——>使用——>卸载 其中,类加载包括5个阶段:加载——>验证——>准备——>解析——>初始化 在类加载的过程中,以下3个过程称为连接:验证——>准备——>解析 因此,JVM的类加载过程也可以概括为3个过程:加载——>连接——>初始化 C/C++在运行前需要完成预处理、编译、汇编、链接;而在Java中,类加载(加载、连接、初始化)是在程序运行期间完成的。在程序运行期间进行类加载会稍微增加程序的开销,但随之会带来更大的好处——提高程序的灵活性。Java语言的灵活性体现在它可以在运行期间动态扩展,所谓动态扩展就是在运行期间动态加载和动态连接。 类加载的时机 1. 类加载过程中每个步骤的顺序 我们已经知道,类加载的过程包括:加载、连接、初始化,连接又分为:验证、准备、解析,所以说类加载一共分为5步:加载、验证、准备、解析、初始化。 其中加载、验证、准备、初始化的开始顺序是依次进行的,这些步骤开始之后的过程可能会有重叠。而解析过程会发生在初始化过程中。 2. 类加载过程中“初始化”开始的时机 JVM规范中只定义了类加载过程中初始化过程开始的时机,加载、连接过程都应该在初始化之前开始(解析除外),这些过程具体在何时开始,JVM规范并没有定义,不同的虚拟机可以根据具体的需求自定义。 初始化开始的时机: 在运行过程中遇到如下字节码指令时,如果类尚未初始化,那就要进行初始化:new、getstatic、putstatic、invokestatic。这四个指令对应的Java代码场景是: 通过new创建对象; 读取、设置一个类的静态成员变量(不包括final修饰的静态变量); 调用一个类的静态成员函数。 使用java.lang.reflect进行反射调用的时候,如果类没有初始化,那就需要初始化; 当初始化一个类的时候,若其父类尚未初始化,那就先要让其父类初始化,然后再初始化本类; 当虚拟机启动时,虚拟机会首先初始化带有main方法的类,即主类; 3. 主动引用 与 被动引用 JVM规范中要求在程序运行过程中,“当且仅当”出现上述4个条件之一的情况才会初始化一个类。如果间接满足上述初始化条件是不会初始化类的。其中,直接满足上述初始化条件的情况叫做主动引用;间接满足上述初始化过程的情况叫做被动引用。那么,只有当程序在运行过程中满足主动引用的时候才会初始化一个类,若满足被动引用就不会初始化一个类。 4. 被动引用的场景示例 示例一 public class Fu{ public static String name = "柴毛毛"; static{ System.out.println("父类被初始化!"); } } public class Zi{ static{ System.out.println("子类被初始化!"); } } public static void main(String[] args){ System.out.println(Zi.name); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 输出结果:父类被初始化!柴毛毛原因分析:本示例看似满足初始化时机的第一条:当要获取某一个类的静态成员变量的时候如果该类尚未初始化,则对该类进行初始化。但由于这个静态成员变量属于Fu类,Zi类只是间接调用Fu类中的静态成员变量,因此Zi类调用name属性属于间接引用,而Fu类调用name属性属于直接引用,由于JVM只初始化直接引用的类,因此只有Fu类被初始化。 示例二 public class A{ public static void main(String[] args){ Fu[] arr = new Fu[10]; } } 1 2 3 4 5 输出结果:并没有输出“父类被初始化!”原因分析:这个过程看似满足初始化时机的第一条:遇到new创建对象时若类没被初始化,则初始化该类。但现在通过new要创建的是一个数组对象,而非Fu类对象,因此也属于间接引用,不会初始化Fu类。 示例三 public class Fu{ public static final String name = "柴毛毛"; static{ System.out.println("父类被初始化!"); } } public class A{ public static void main(String[] args){ System.out.println(Fu.name); } } 1 2 3 4 5 6 7 8 9 10 11 12 输出结果:柴毛毛原因分析:本示例看似满足类初始化时机的第一个条件:获取一个类静态成员变量的时候若类尚未初始化则初始化类。但是,Fu类的静态成员变量被final修饰,它已经是一个常量。被final修饰的常量在Java代码编译的过程中就会被放入它被引用的class文件的常量池中(这里是A的常量池)。所以程序在运行期间如果需要调用这个常量,直接去当前类的常量池中取,而不需要初始化这个类。 5. 接口的初始化 接口和类都需要初始化,接口和类的初始化过程基本一样,不同点在于:类初始化时,如果发现父类尚未被初始化,则先要初始化父类,然后再初始化自己;但接口初始化时,并不要求父接口已经全部初始化,只有程序在运行过程中用到当父接口中的东西时才初始化父接口。

优秀的个人博客,低调大师

深入理解JVM(三)——垃圾收集策略详解

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612610 Java虚拟机的内存模型分为五个部分,分别是:程序计数器、Java虚拟机栈、本地方法栈、堆、方法区。 这五个区域既然是存储空间,那么为了避免Java虚拟机在运行期间内存存满的情况,就必须得有一个垃圾收集者的角色,不定期地回收一些无效内存,以保障Java虚拟机能够健康地持续运行。 这个垃圾收集者就是平常我们所说的“垃圾收集器”,那么垃圾收集器在何时清扫内存?清扫哪些数据?这就是接下来我们要解决的问题。 程序计数器、Java虚拟机栈、本地方法栈都是线程私有的,也就是每条线程都拥有这三块区域,而且会随着线程的创建而创建,线程的结束而销毁。那么,垃圾收集器在何时清扫这三块区域的问题就解决了。 此外,Java虚拟机栈、本地方法栈中的栈帧会随着方法的开始而入栈,方法的结束而出栈,并且每个栈帧中的本地变量表都是在类被加载的时候就确定的。因此以上三个区域的垃圾收集工作具有确定性,垃圾收集器能够清楚地知道何时清扫这三块区域中的哪些数据。 然而,堆和方法区中的内存清理工作就没那么容易了。堆和方法区所有线程共享,并且都在JVM启动时创建,一直得运行到JVM停止时。因此它们没办法根据线程的创建而创建、线程的结束而释放。 堆中存放JVM运行期间的所有对象,虽然每个对象的内存大小在加载该对象所属类的时候就确定了,但究竟创建多少个对象只有在程序运行期间才能确定。方法区中存放类信息、静态成员变量、常量。类的加载是在程序运行过程中,当需要创建这个类的对象时才会加载这个类。因此,JVM究竟要加载多少个类也需要在程序运行期间确定。因此,堆和方法区的内存回收具有不确定性,因此垃圾收集器在回收堆和方法区内存的时候花了一些心思。 堆内存的回收 1. 如何判定哪些对象需要回收? 在对堆进行对象回收之前,首先要判断哪些是无效对象。我们知道,一个对象不被任何对象或变量引用,那么就是无效对象,需要被回收。一般有两种判别方式: 引用计数法每个对象都有一个计数器,当这个对象被一个变量或另一个对象引用一次,该计数器加一;若该引用失效则计数器减一。当计数器为0时,就认为该对象是无效对象。 可达性分析法所有和GC Roots直接或间接关联的对象都是有效对象,和GC Roots没有关联的对象就是无效对象。GC Roots是指: Java虚拟机栈所引用的对象(栈帧中局部变量表中引用类型的变量所引用的对象) 方法区中静态属性引用的对象 方法区中常量所引用的对象 本地方法栈所引用的对象PS:注意!GC Roots并不包括堆中对象所引用的对象!这样就不会出现循环引用。 两者对比:引用计数法虽然简单,但存在一个严重的问题,它无法解决循环引用的问题。因此,目前主流语言均使用可达性分析方法来判断对象是否有效。 2. 回收无效对象的过程 当JVM筛选出失效的对象之后,并不是立即清除,而是再给对象一次重生的机会,具体过程如下: 判断该对象是否覆盖了finalize()方法 若已覆盖该方法,并该对象的finalize()方法还没有被执行过,那么就会将finalize()扔到F-Queue队列中; 若未覆盖该方法,则直接释放对象内存。 执行F-Queue队列中的finalize()方法虚拟机会以较低的优先级执行这些finalize()方法们,也不会确保所有的finalize()方法都会执行结束。如果finalize()方法中出现耗时操作,虚拟机就直接停止执行,将该对象清除。 对象重生或死亡如果在执行finalize()方法时,将this赋给了某一个引用,那么该对象就重生了。如果没有,那么就会被垃圾收集器清除。 注意:强烈不建议使用finalize()函数进行任何操作!如果需要释放资源,请使用try-finally。因为finalize()不确定性大,开销大,无法保证顺利执行。 方法区的内存回收 我们知道,如果使用复制算法实现堆的内存回收,堆就会被分为新生代和老年代,新生代中的对象“朝生夕死”,每次垃圾回收都会清除掉大量的对象;而老年代中的对象生命较长,每次垃圾回收只有少量的对象被清除掉。 由于方法区中存放生命周期较长的类信息、常量、静态变量,因此方法区就像是堆的老年代,每次垃圾收集的只有少量的垃圾被清除掉。 方法区中主要清除两种垃圾:1. 废弃常量2. 废弃的类 1. 如何判定废弃常量? 清除废弃的常量和清除对象类似,只要常量池中的常量不被任何变量或对象引用,那么这些常量就会被清除掉。 2. 如何废弃废弃的类? 清除废弃类的条件较为苛刻:1. 该类的所有对象都已被清除2. 该类的java.lang.Class对象没有被任何对象或变量引用只要一个类被虚拟机加载进方法区,那么在堆中就会有一个代表该类的对象:java.lang.Class。这个对象在类被加载进方法区的时候创建,在方法区中该类被删除时清除。3. 加载该类的ClassLoader已经被回收 垃圾收集算法 现在我们知道了判定一个对象是无效对象、判定一个类是废弃类、判定一个常量是废弃常量的方法,也就是知道了垃圾收集器会清除哪些数据,那么接下来介绍如何清除这些数据。 1. 标记-清除算法 首先利用刚才介绍的方法判断需要清除哪些数据,并给它们做上标记;然后清除被标记的数据。 分析:这种算法标记和清除过程效率都很低,而且清除完后存在大量碎片空间,导致无法存储大对象,降低了空间利用率。 2. 复制算法 将内存分成两份,只将数据存储在其中一块上。当需要回收垃圾时,也是首先标记出废弃的数据,然后将有用的数据复制到另一块内存上,最后将第一块内存全部清除。 分析:这种算法避免了碎片空间,但内存被缩小了一半。而且每次都需要将有用的数据全部复制到另一片内存上去,效率不高。 解决空间利用率问题:在新生代中,由于大量的对象都是“朝生夕死”,也就是一次垃圾收集后只有少量对象存活,因此我们可以将内存划分成三块:Eden、Survior1、Survior2,内存大小分别是8:1:1。分配内存时,只使用Eden和一块Survior1。当发现Eden+Survior1的内存即将满时,JVM会发起一次MinorGC,清除掉废弃的对象,并将所有存活下来的对象复制到另一块Survior2中。那么,接下来就使用Survior2+Eden进行内存分配。 通过这种方式,只需要浪费10%的内存空间即可实现带有压缩功能的垃圾收集方法,避免了内存碎片的问题。 但是,当一个对象要申请内存空间时,发现Eden+Survior中剩下的空间无法放置该对象,此时需要进行Minor GC,如果MinorGC过后空闲出来的内存空间仍然无法放置该对象,那么此时就需要将对象转移到老年代中,这种方式叫做“分配担保”。 什么是分配担保?当JVM准备为一个对象分配内存空间时,发现此时Eden+Survior中空闲的区域无法装下该对象,那么就会触发MinorGC,对该区域的废弃对象进行回收。但如果MinorGC过后只有少量对象被回收,仍然无法装下新对象,那么此时需要将Eden+Survior中的所有对象都转移到老年代中,然后再将新对象存入Eden区。这个过程就是“分配担保”。 3. 标记-整理算法 在回收垃圾前,首先将所有废弃的对象做上标记,然后将所有未被标记的对象移到一边,最后清空另一边区域即可。 分析:它是一种老年代的垃圾收集算法。老年代中的对象一般寿命比较长,因此每次垃圾回收会有大量对象存活,因此如果选用“复制”算法,每次需要复制大量存活的对象,会导致效率很低。而且,在新生代中使用“复制”算法,当Eden+Survior中都装不下某个对象时,可以使用老年代的内存进行“分配担保”,而如果在老年代使用该算法,那么在老年代中如果出现Eden+Survior装不下某个对象时,没有其他区域给他作分配担保。因此,老年代中一般使用“标记-整理”算法。 4. 分代收集算法 将内存划分为老年代和新生代。老年代中存放寿命较长的对象,新生代中存放“朝生夕死”的对象。然后在不同的区域使用不同的垃圾收集算法。 Java中引用的种类 Java中根据生命周期的长短,将引用分为4类。 1. 强引用 我们平时所使用的引用就是强引用。A a = new A();也就是通过关键字new创建的对象所关联的引用就是强引用。只要强引用存在,该对象永远也不会被回收。 2. 软引用 只有当堆即将发生OOM异常时,JVM才会回收软引用所指向的对象。软引用通过SoftReference类实现。软引用的生命周期比强引用短一些。 3. 弱引用 只要垃圾收集器运行,软引用所指向的对象就会被回收。弱引用通过WeakReference类实现。弱引用的生命周期比软引用短。 4. 虚引用 虚引用也叫幽灵引用,它和没有引用没有区别,无法通过虚引用访问对象的任何属性或函数。一个对象关联虚引用唯一的作用就是在该对象被垃圾收集器回收之前会受到一条系统通知。虚引用通过PhantomReference类来实现。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册