首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

深入理解Android NDK日志符号化

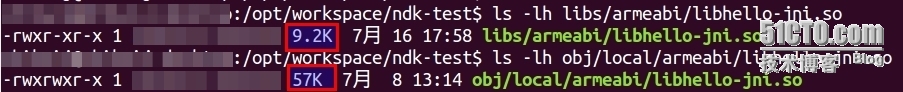
为了进行代码及产品保护,几乎所有的非开源App都会进行代码混淆,这样当收集到崩溃信息后,就需 要进行符号化来还原代码信息,以便开发者可以定位Bug。基于使用SDK和NDK的不同,Android的崩溃分为两类:Java崩溃和C/C++崩溃。Java崩溃通过mapping.txt文件进行符号化,比较简单直观,而C/C++崩溃的符号化则需要使用Google自带的一些NDK工具,比如ndk-stack、addr2line、objdump等。本文不去讨论如何使用这些工具,有兴趣的朋友可以参考同事写的另一篇文章《如何定位Android NDK开发中遇到的错误》,里面做了详细的描述。 基于NDK的Android的开发都会生成一个动态链接库(so),它是基于C/C++编译生成的。动态链接库在Linux系统下广泛使用,而Android系统底层是基于Linux的,所以NDK so库的编译生成遵循相同的规则,只不过Google NDK把相关的交叉编译工具都封装了。 Ndk-build编译时会生成的两个同名的so库,位于不同的目录/projectpath/libs/armeabi/xxx.so和/project path/obj/local/armeabi/xxx.so,比较两个so文件会发现体积相差很大。前者会跟随App一起发布,所以尽可能的小,而后者包含了很多调试信息,主要为了gdb调试的时候使用,当然NDK的日志符号化信息也包含其中。 本文主要分析这个包含调试信息的so动态库,深入分析它的组成结构。在开始之前,先来说说这样做的目的或者好处。现在的App基本都会采集上报崩溃时的日志信息,无论是采用第三方云平台(如Testin崩溃分析+),还是自己搭建云服务,都要将含调试信息的so动态库上传,实现云端日志符号化以及云端可视化管理。移动App的快速迭代,使得我们必须存储管理每一个版本的debugso库,而其包含了很多与符号化无关的信息。如果我们只提取出符号化需要的信息,那么符号化文件的体积将会呈现数量级的减少。同时可以在自定义的符号化文件中添加App的版本号等信息,实现符号化提取、上传到云端、云端解析及可视化等自动化部署。另外,从技术角度讲,你将不在害怕看到“unresolvedsymbol” linking errors,更从容地debugging C/C++ crash或者hacking一些so文件。 首先通过readelf来看看两个不同目录下的so库有什么不同 从中可以清楚看到,包含调试信息的so库多了8个.debug_开头的条目以及.symtab和.strtab条目。符号化的本质,是通过堆栈中的地址信息,还原代码本来的语句以及相应的行号,所以这里只需解析.debug_line和.symtab,最终获取到如下的信息就可以实现符号化了。 1 2 3 4 5 c85c8bwillCrashjni /hello-jni .c:27-29 c8bc8dwillCrashjni /hello-jni .c:32 c8dc8fJNI_OnLoadjni /hello-jni .c:34 c8fc93JNI_OnLoadjni /hello-jni .c:35 c93c9dJNI_OnLoadjni /hello-jni .c:37 通常,目标文件分为三类:relocatable文件、executable文件和shared object文件,它们格式称为ELF(Executableand Linking Format),so动态库属于第三类shared object,它的整体组织结构如下: ELF Header Program header tableoptional Section 1 ... Section n ... Section header tablerequired ELF Header ELF Header文件头的结构如下,记录了文件其他内容在文件中的偏移以及大小信息。这里以32bit为例。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 typedef struct { unsigned char e_ident[EI_NIDENT]; Elf32_Halfe_type; //目标文件类型,如relocatable、executable和sharedobject Elf32_Halfe_machine; //指定需要的特定架构,如Intel80386,Motorola68000 Elf32_Worde_version; //目标文件版本,通e_ident中的EI_VERSION Elf32_Addre_entry; //指定入口点地址,如C可执行文件的入口是_start(),而不是main() Elf32_Offe_phoff; //programheadertable的偏移量 Elf32_Offe_shoff; //sectionheadertable的偏移量 Elf32_Worde_flags; //处理器相关的标志 Elf32_Halfe_ehsize; //代表ELFHeader部分的大小 Elf32_Halfe_phentsize; //programheadertable中每一项的大小 Elf32_Halfe_phnum; //programheadertable包含多少项 Elf32_Halfe_shentsize; //sectionheadertable中每一项的大小 Elf32_Halfe_shnum; //sectionheadertable包含多少项 Elf32_Halfe_shstrndx; //sectionheadertable中某一子项的index,该子项包含了所有section的字符串名称 }Elf32_Ehdr; 其中e_ident为固定16个字节大小的数组,称为ELF Identification,包含了处理器类型、文件编码格式、机器类型等,具体结构如下: Name Value Purpose EI_MAG0 0 前四个字节称为magic number,分别为0x7f、’E’、’L’、’F’,表明文件类型为ELF。 EI_MAG1 1 EI_MAG2 2 EI_MAG3 3 EI_CLASS 4 表明文件是基于32-bit还是64-bit,不同的方式,对齐方式不同,读取某些内容的大小不同。 EI_DATA 5 表明文件数据结构的编码方式,主要分为大端和小端两种 EI_VERSION 6 指定了ELF文件头的版本号 EI_OSABI 7 指定使用了哪种OS-或者ABI-的ELF扩展 EI_ABIVERSION 8 指定该ELF目标文件的目标ABI版本 EI_PAD 9 保留字段起始处,直到第16个字节 EI_NIDENT 16 代表了e_ident数组的大小,固定为16 Sections 该部分包含了除ELF Header、program header table以及section header table之外的所有信息。通过section header table可以找到每一个section的基本信息,如名称、类型、偏移量等。 先来看看Section Header的内容,仍以32-bit为例: 1 2 3 4 5 6 7 8 9 10 11 12 typedefstruct{ Elf32_Word sh_name;//指定section的名称,该值为StringTable字符串表中的索引 Elf32_Word sh_type;//指定section的分类 Elf32_Word sh_flags;//该字段的bit代表不同的section属性 Elf32_Addr sh_addr;//如果section出现在内存镜像中,该字段表示section第一个字节的地址 Elf32_Off sh_offset;//指定section在文件中的偏移量 Elf32_Word sh_size;//指定section占用的字节大小 Elf32_Word sh_link;//相关联的sectionheadertable的index Elf32_Word sh_info;//附加信息,意义依赖于section的类型 Elf32_Word sh_addralign;//指定地址对其约束 Elf32_Word sh_entsize;//如果section包含一个table,该值指定table中每一个子项的大小 }Elf32_Shdr; 通过Section Header的sh_name可以找到指定的section,比如.debug_line、.symbol、.strtab。 String Table String Table包含一系列以\0结束的字符序列,最后一个字节设置为\0,表明所有字符序列的结束,比如: String Table也属于section,只不过它的偏移量直接在ELF Header中的e_shstrndx字段指定。String Table的读取方法是,从指定的index开始,直到遇到休止符。比如要section header中sh_name获取section的名称,比如sh_name = 7, 则从string table字节流的第7个index开始(注意这里从0开始),一直读到第一个休止符(index=18),读取到的名称为.debug_line Symbol Table 该部分包含了程序符号化的定义相关信息,比如函数定义、变量定义等,每一项的定义如下: 1 2 3 4 5 6 7 8 9 10 #SymbolTableEntry typedef struct { Elf32_Word st_name; //symbol字符串表的索引 Elf32_Addr st_value; //symbol相关的值,依赖于symbol的类型 Elf32_Word st_size; //symbol内容的大小 unsigned char st_info; //symbol的类型及其属性 unsigned char st_other; //symbol的可见性,比如类的public等属性 Elf32_Half st_shndx; //与此symbol相关的sectionheader的索引 }Elf32_Sym; Symbol的类型包含一下几种 Name Value STT_NOTYPE 0 STT_OBJECT 1 STT_FUNC 2 STT_SECTION 3 STT_FILE 4 STT_COMMO 5 STT_TLS 6 STT_LOOS 10 STT_HIOS 12 STT_LOPRO 13 STT_HIPROC 15 其中STT_FUNC就是我们要找的函数symbol。然后通过st_name从symbol字符串表中获取到相应的函数名(如JNI_OnLoad)。当symbol类型为STT_FUNC时,st_value代表该symbol的起始地址,而(st_value+st_size)代表该symbol的结束地址。 回顾之前的提到的.symtab和.strtab两个部分,对应的便是Symbol Section和Symbol String Section。 DWARF(Debugging With Attributed Record Formats) DWARF是一种调试文件格式,很多编译器和调试器都通过它进行源码调试(gdb等)。尽管它是一种独立 的目标文件格式,但往往嵌入在ELF文件中。前面通过readelf看到的8个.debug_* Section全部都属于DWARF格式。本文将只讨论与符号化相关的.debug_line部分,更多的DWARF信息请查看参考文献的内容。 .debug_line部分包含了行号信息,通过它可以将代码语句和机器指令地址对应,从而进行源码调试。.debug_line有很多子项组成,每个子项都包含类似数据块头的描述,称为Statement Program Prologue。Prologue提供了解码程序指令和跳转到其他语句的信息,它包含如下字段,这些字段是以二进制格式顺序存在的: total_length uword 整个子项占用的字节大小,注意并不包括该字段本身 versio uhalf 该子项格式的版本号,其实也是整个DWARF格式的版本号,目前总共有四个版本。 prologue_length uword prologue的长度,不包括该字段及前面的两个字段占用的字节数,即相对于本字段,程序语句本身的第一个字节的偏移量 minimum_instruction_length ubyte 最小的目标机器指令 default_is_stmt ubyte is_stmt寄存器的初始值 line_base sbyte 不同的操作码,代表不同的含义,只影响special opcodes line_range ubyte 不同的操作码,代表不同的含义,只影响special opcodes opcode_base ubyte 第一个操作码的数值 standard_opcode_lengths array of ubyte 标准操作码的LEB128操作数的数值 include_directories sequence 目录名字符序列 file_names sequence 源代码所在文件名字符序列 这里用到的机器指令可以分为三类: special opcodes 单字节操作码,不含参数,大多数指令属于此类 standard opcodes 单字节操作码,可以包含0个或者多个LEB128参数 extended opcodes 多字节操作码 这里不做机器指令的解析说明,感兴趣的,可以查看参考文献的内容。 通过.debug_line,我们最终可以获得如下信息:文件路径、文件名、行号以及起始地址。 最后我们汇总一下整个符号化提取的过程: 1、从ELF Header中获知32bit或者64bit,以及大端还是小端,基于此读取后面的内容 2、从ELF Header中获得Section Header Table在文件中的位置 3、读取Section Header Table,从中获得.debug_line、.symtab以及.strtab三个section在文中的位置 4、读取.symtab和.strtab两个section,最后获得所有function symbol的名称、起始地址以及结束地址 5、读取.debug_line,按照DWARF格式解析获取文件名称、路径、行号以及起始地址 6、对比步骤4和5中获取的结果,进行对比合并,形成最终的结果 本文转自jazka 51CTO博客,原文链接:http://blog.51cto.com/jazka/1675766,如需转载请自行联系原作者

优秀的个人博客,低调大师

android 中关于 activity 的一些理解

android活动程序——Activity,承载着View,很类似于MVC中的Controller。 不得不说,使用Intent(意图)来实现Activity与其他组件(包括其他Activity、Service。Broadcast等)进行交互。是Google的一大创新,也是android的一个亮点,这很好地减少了开发的复杂性。就像一个统一的交互接口一样,或者简单的说,Intent就是一个定义各个组件之间通信的标准。说实话,在学Android的时候我总是喜欢将它与.net的win form开发进行对比学习,并且他们之间也确实存在着诸多共性。但是在各个组件之间的交互上,显然还是android的这种机制来得直观和方便。但是,也许因为开发出的程序的运行模式有所区别,所以才导致了这样的局面。 这里就谈谈在应用程序的两个Intent之间采用Intent进行交互,如果你熟悉activity的生命周期,会知道,从一个activity切换到另一个activity(暂且我们将前一个称之为父activity,后一个称之为子activity)。父activity会执行OnPause()->OnStop(),之后会执行子activity的OnCreate()->OnStart()等等。但是当你按“返回”的时候,你会发现子activity执行了Ondestory()方法,而不是只执行到OnStop(),也就是子activity此时已经被销毁,而下一次你在切换到该类型的activity的时候,又会产生一个新的实例。而返回之后,父activity会执行OnRestart()等。也就是说,父activity的实例一直存在,在返回的时候也不需要再调用OnCreate()。 当你再做一个实验,在上面的子activity里,再切换到一个新的activity。你会发现此时,子activity像上面的父activity一样未被destory。也就是如果一个activity作为另一个activity“源”,那么它的生命周期肯定比它跳转到的activity的生命周期长。那么android到底是怎么做的呢。我们很容易联想到一种数据结构——栈。其实,每次startActivity()都只是把“意图”希望启动的一个activity压入栈顶。这样,就可以实现,栈顶的activity先消亡,其下面的activity在它Pop()之后才会再次Restart。这也很符合程序逻辑。 PS:要想测试activity的lifecycle,只需要重新activity的生命周期会尽量的那些方法(API中有介绍),在方法中启用日志记录功能(Log.i();),记录相关日志即可。 java与.net: 看代码的时候发现java中有这样的语法:类命.this、类名.class。一个是引用类的一个实例,一个是引用该类的Class类型的对象(在.net中应该对应的是类型的定义,也就是元数据)。类名.class都是Class类型,class与Class不是同一个类型,这种用法通常在反射中。好吧,这和.net中的Type很相似。可能是先入为主吧,我始终还是觉得称为Type更为合理,一个类型的“原型”本来在英文中用“Type”来表示。并且Class给人的感觉,总是和class相混淆。 上次看到一个面试题:.net中class是什么类型?坑爹啊!是类类型吗?引用类型吗?尼玛就是C#的关键字!这题考Java程序员,是什么效果?应该会比.net程序员好~ 原文发布时间为:2011-07-16 本文作者:vinoYang 本文来自云栖社区合作伙伴CSDN博客,了解相关信息可以关注CSDN博客。

优秀的个人博客,低调大师

深入理解Linux用户空间的锁机制

1.缘起 随着SMP(Symmetrical Multi-Processing)架构的流行和epoll类系统调用对非阻塞fd监视的支持,高性能服务器端的开发已经能够实现CPU计算和IO的分离。为了充分发挥CPU的计算能力,服务器端的设计必须要尽量减少线程切换。引起线程切换最重要的原因之一就是对mutex和semaphor等锁的使用。本文从计算机体系架构、操作系统的支持和mutex的实现彻底分析Linux用户空间mutex的实现,分析的源码版本是glib-2.3.4和kernel-2.6.8。 2. 体系结构和指令的支持 在UP(uni processor)架构下,从用户空间的角度看,中断打断了程序的正常执行。操作系统在处理完中断之后,返回用户空间的之前,重新调度系统中的线程执行。由于CPU是在执行汇编指令结束后响应中断,那么单条汇编指令的执行就是原子的。 在SMP下,由于存在CPU Local Cache和每个CPU的指令周期不同,单条汇编指令的执行不会是原子的。X86 SMP提供了一个lock指令前缀,使得某些汇编指令的执行是原子的。看如下x86_64体系结构的汇编代码,来自glibc。 Intel® 64 and IA-32 Architectures Software Developer’s Manual Volume 2中对cmpxchg指令的解释如下: This instruction can be used with a LOCK prefix to allow the instruction to be executed atomically. 所有以lock为前缀的指令都起内存栅栏的作用。内存栅栏使编译器确保对RAM中数据的改变对所有CPU都是可见的。 上述汇编对应的伪代码: Intel® 64 and IA-32 Architectures Software Developer’s Manual Volume 2中对cmpxchg指令的解释如下: This instruction can be used with a LOCK prefix to allow the instruction to be executed atomically. by gaolingfei 所有以lock为前缀的指令都起内存栅栏的作用。内存栅栏使编译器确保对RAM中数据的改变对所有CPU都是可见的。 上述汇编对应的伪代码: 3. 操作系统支持 按照操作系统的经典定义,进程是资源分配的最小单位,线程是调度的最小单位。 Linux操作系统提供了 futex系统调用以支持 mutex等锁的实现。 futex的主要功能是使得线程以 TASK_INTERRUPTIBLE状态等待处于进程空间的某变量的改变,或者使得某线程可以唤醒等待该变量的其他线程。 2.6.8版的 Kernel中, futex的实现使用一个 futex_hash_bucket。操作系统用户空间任何线程如果在等待mutex或者semaphore的up操作,都是以每个锁的address等为key,将自身线程挂到该futex_hash_bucket等待被唤醒。 实现 wait的步骤如下: A. down_read得到当前线程整个地址空间的读锁,从该步起到 up_read,与线程同一个进程的其他线程mmap()和brk()系统调用都会挂起,mmap()和brk()是malloc()和free()的基础。()(& current->mm->mmap_sem); B.调用 find_extend_vma以确认用户空间锁的地址是否是shared or private mapping. shared mapping一般是进程有多个线程引起的。 find_extend_vma会搜索整个进程地址空间段组成红黑树,以确定该地址空间的类型。()(), C.计算 key。如果是单进程单线程, Key为用户空间地址。如果为单进程多线程,需要执行 spin_lock得到用户地址对应的page,然后 spin_unlock。page_table_lock会影响相应进程的page fault的处理。(& current->mm->page_table_lock)(& current->mm->page_table_lock); D.将自身线程加入到 futex_hash_bucket, futex_hash_bucket的每个桶有一个spin lock保护。 E. up_read(& current->mm->mmap_sem); F. __set_current_state( TASK_INTERRUPTIBLE); G. __set_current_state此时线程已经被其他线程唤醒。( TASK_RUNNING); H.将自身从 futex_hash_bucket移除。 实现 wake up的步骤如下: A.执行 wait的 A到 C。 B. spin_lock给相应桶加锁。(&bh-> lock); C.唤醒在锁上的一个等待线程。 D. spin_unlock(&bh-> lock); E. up_read(& current->mm->mmap_sem); 4. pthread_mutex 实现分析 pthread_mutex_lock()实现在 glibc-2.3.4 pthread_mutex_lock.c文件的 33行,该函数会根据 mutex在 init的时候设置的属性,选择不同的执行路径。 mutex的属性有四种: A. PTHREAD_MUTEX_TIMED_NP:默认属性。 pthread_mutex_lock()直接调用 lll_mutex_lock()。 B. PTHREAD_MUTEX_RECURSIVE_NP:检查 mutex owner是否为当前线程。该属性允许线程多次获取该锁。 C. PTHREAD_MUTEX_ERRORCHECK_NP:如果同一线程两次 lock,会返回错误。 D. PTHREAD_MUTEX_ADAPTIVE_NP:该锁会先 n次调用 lll_mutex_trylock(), n为用户定义和 100的最小值。如果仍然失败,则调用 lll_mutex_lock()。 lll_mutex_trylock()不会调用 futex。 5. spin lock 实现 nginx实现了 spin lock以保护多进程对 listen port的互斥 accept。 spinlock的实现如下: Spinlock本质上是一个“忙等”锁,由于其不存在下节中总结的 mutex的缺点,其对于小资源是最高效的锁。相比上节中 mutex的 PTHREAD_MUTEX_ADAPTIVE_NP属性, nginx的 spinlock是一个更完美的实现方案。 6. 总结 在设置 PTHREAD_MUTEX_TIMED_NP属性和单进程多线程模型下, pthread_mutex_lock()对同进程的其他线程的影响如下: A. pthread_mutex_lock()占用的大部分 CPU时间当中,直接影响其他线程调用 mmap(), brk(), malloc和 free()。 B.对进程处理 page fault也会有影响。 C.如果整个操作系统的用户进程使用了过多的 mutex之类的锁,那么所有锁共享的 futex_hash_bucket将是一个瓶颈。 D.最重要的是,锁的使用会引起线程的频繁切换,导致 cpu cache miss和 TLB miss。 对于系统中,需要互斥访问的资源,如下建议: A.内核中对于小资源如链表的增删,多是使用 spin lock保护。 B.在设置 PTHREAD_MUTEX_ADAPTIVE_NP属性下, mutex既可以是 spin lock,也可以是阻塞锁。 C.使用 atomic_add_return(i, v),原子对变量 i增加 v值,并且返回操作后的值。相反操作: atomic_sub_return(i, v)。 D.使用 Per-CPU variables,例如多线程程序中要每隔 1秒,统计某项操作的值。该变量最好是 cache alignment。 E.对于如数据库频繁更新的操作,可以使用数据库的多版本并发控制方法减少对 mutex的 lock。 本文转自百度技术51CTO博客,原文链接:http://blog.51cto.com/baidutech/1033629 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

如何理解Hadoop-Hbase原理与应用小结

1 我们常说HBase是“数据即日志”的数据库,它是怎样修改和删除数据的?和Oracle这类传统的RDBMS有什么区别? 答:首先Hbase中的一个“元素”是由行键、列族名、限定符、时间戳唯一标识的并且行键作为数据行在表里的唯一标识,我们只有通过行键来访问列族别无他法。 修改数据:我们先找到要修改的行键把新的数据记录追加到对应的列族中并打上一个新时间戳代表最新版本。 删除数据:插入带有删除标记的行进入,相当于把整个行键所在的行删了。 小结:hbase中所有修改和删除都是用insert方式来完成的,这是由底层HDFS文件系统特性决定的,HDFS中的文件只能一次性写入不能修改可以删除在写回。因此hbase是天生面向时间查询的数据库。例如 查询最近一段时间一个人发布的博客、发布签名、发布照片so on。 hbase特点 (1)适合大量插入同时key-value查询,例如可以输入一个key查询一个value,还可以输入一组key查询一组value。 (2)瓶颈是硬盘的传输速度,因为有大量的插入操作和读出操作,使用SSD SCSI IDE不同的硬盘效率是不同的。 (3)适合数据分析。 (4)列式数据库会把相同列的数据都放在一块即列为单位存储。当我们查询某一列的时候只需要调出相应的块即可,这样还可以减少很多I/O。 (5)如果数据元素间的相似性很高的话可以进行大幅度的压缩,相似度越高压缩比越大,甚至可以压缩到原来十几分之一、上百分之一。即节约了空间又减少了I/O,从而提高性能。 (6)hbase只有主键索引,它使用的是LSM(Log Structure Merge)索引,因为hbase所有的修改都是使用追加方式完成的,从数据流上看按照顺序方式写入与日志写入的方式相同,我们又可以认为数据和日志一体化,这又节约了很多空间。 oracle特点 (1)适合小事务短时间片密集型OLTP系统,例如在线交易系统。 (2)瓶颈是硬盘的寻道时间(磁头移动时间),因为oracle随机写随机修改块,首先要找到块这个过程就是寻道时间,而寻道时间又由硬盘转速决定的,5400 7200 15000转/秒 不同的转速效率也是不同的。 (3)适合做SQL统计。 (4)行式数据库会按照数据行顺序集中存放即行为单位存储。当我们查询某一列的时候必须把表里所有的行读完才能抽取我们所要的行,这样很不划算,还要付出很大的I/O资源。 (5)那么从结构上讲oracle的压缩性能就要略逊一筹。 (6)oracle常用的是B+树索引,比较大小来查找记录,小的走左边大的走右边,如果列中的相似度较高的话性能较差。 2 HBase合并storefile的原因是什么?在合并的过程中会做什么操作?如果在合并过程中恰好有涉及到有关storefile的查询发生,会发生什么情况! 答:首先我们介绍一下Hbase数据存储的物理结构 一个物理节点只能跑一个HRegionserver 一个HRegionServer可以包括很多个Region实例,可以是不同表Region 一个Region包含一个hlog和多个store(一个store就是一个列族,因为同列族元素在物理上存放在同一个地方,不同列族在物理上是分离的) 一个store包含一个memstore和多个storefile 当我们在处理数据的时候,首先把数据加载到memstore,数据越来越多直到memstore占满,再写入硬盘storefile中,每次写入形成一个单独storefile,当storefile达到一定的数量后,就会开始把小storefile合并成大storefile,因为hadoop不擅长处理小文件,文件越大性能越好。 在合并的过程中会抛弃删除标识的行和版本过旧的行(hbase版本抛弃方式(1)我们可以预先定义版本的个数,超过这个值就抛弃(2)还可以预先定义版本的时间长短,超过这个时间就抛弃),合并完后形成更大的storefile,当达到数量再次合并,直到storefile容量超过一定阀值后会把当前的Region进行分裂为2个并由Hmaster(hbase数据库主控节点)分配到不同的HRegionServer服务器处理实现负载均衡。 如果在合并过程中恰好有涉及到有关storefile的查询发生的话,我们先是把小storefile加载到内存中进行合并此时如有用户访问可以在内存中检索相关数据返回给用户,我们可以想象在内存中做一个独立镜像备份专门提供被查询需求,另一个主体在另一块内存空间里进行合并,当合并完成后释放备份的内存空间,返回到原来的状态。 3 Hbase具有怎么样的一致性水平 答:hbase是最终一致性的系统,因为hbase是架构在hadoop之上的数据库,“错误是常态”是hadoop座右铭,在cap理论中hbase为了满足可用性和分区容错性牺牲了一部分的数据一致性。 举例:我们要进行电信的指标汇总,并且把汇总结果冗余三份分布在3个datanode中,我们可以设置阀值只要有2份结果保存了我们就可以继续做下面的操作,在一定时间范围内允许第3份结果稍后一致性同步,这就是最终一致性。所以说hbase是适用于AP理论的系统,最终一致性也满足分布式集群的特点。 本文转自 leonarding151CTO博客,原文链接:http://blog.51cto.com/leonarding/1049404,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux之理解内核、内核模块、编译内核

内核组成: uname命令 内核:uname,mkinitrd,dracut 模块: lsmod,modinfo,depmod,modprobe,insmod,rmmod /proc,sysctl,/sys,/dev,udevadm,hotplug命令 内核编译 Linux内核组成 内核文件 bzImage 位置: /boot/vmlinuz-VERSION-RELEASE 内核模块 .ko 位置: /lib/modules/VERSION-RELEASE 辅助文件 initramfs(CentOS 6,7) , initrd (CentOS5) 查看内核相关的信息 uname显示系统(kernel)信息 -s 显示操作系统名称 -n 显示当前主机名称: 显示节点名称 -r 显示VERSION及RELEASE号 -v 显示内核制作信息号 SMP 对称多处理器 -m 当前硬件平台 x86_64 -p 显示处理器类型或架构 x86_64 -i 硬件架构 x86_64 -o 操作系统(GNU/Linux) 使用示例 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 1 、系统信息 #uname Linux #uname-o GNU/Linux 2 、显示节点名称 #uname-n localhost.localdomain #cat/proc/sys/kernel/hostname localhost.localdomain #hostname localhost.localdomain 3 、显示version-release号 #uname-r 2.6 . 32 - 696 .el6.i686 4 、内核制作版本号 #uname-v # 1 SMPTueMar 21 18 : 53 : 30 UTC 2017 5 、当前硬件平台 #uname-m i686 6 、处理器架构 #uname-p i686 7 、硬件架构 #uname-i i386 8 、操作系统 #uname-o GNU/Linux 辅助文件: initramfs,initrd 生成 1 2 3 mv/boot/initramfs-VERSION-RELEASE.img/root mkinitrd/boot/initramfs-$(uname-r).img$(uname-r) dracut/boot/initramfs-$(uname-r).img$(uname-r) 展开 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 1 、查看文件的类型 file 2 、改名.gzip结尾 mv 3 、解压 gzip-d 4 、查看文件类型 file 5 、展开 install-dinitrd cdinitrd cpio-id<../ Linux内核模块 吸收微内核设计:支持模块化设计: 内核中模块 .ko (kernel object) 程序调用的库 .so (share object) 内核模块相当于程序的库的概念,只是模块只能被kernel调用。库只能被程序调用 编译成模块: [M] 编译进内核: [*] 不编译此功能: [ ] 查看所有已经装载的模块lsmod 1 2 3 #lsmod ModuleSizeUsedby 模块大小使用次数 查看模块信息modinfo 模块路径 -n 显示指定内核的模块信息 -k kernel 显示模块的描述 -d 模块的参数 -p License -l Author -a 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 1 、显示所有信息 #modinfoext4 filename:/lib/modules/ 2.6 . 32 - 696 .el6.i686/kernel/fs/ext4/ext4.ko license:GPL description:FourthExtendedFilesystem author:RemyCard,StephenTweedie,AndrewMorton,AndreasDilger,TheodoreTs'oandothers srcversion:74AEE2BDA63AC8482A78F4D depends:mbcache,jbd2 vermagic: 2.6 . 32 - 696 .el6.i686SMPmod_unloadmodversions 686 2 、仅显示filename #modinfo-next4 /lib/modules/ 2.6 . 32 - 696 .el6.i686/kernel/fs/ext4/ext4.ko 3 、仅显示License #modinfo-lext4 GPL 4 、仅显示description #modinfo-dext4 FourthExtendedFilesystem 5 、仅显示作者 #modinfo-aext4 RemyCard,StephenTweedie,AndrewMorton,AndreasDilger,TheodoreTs'oandothers 6 、显示模块参数 #modinfo-pext4 生成模块的依赖关系depmod 为指定内核生成依赖 -b /boot/system.map-VERSION-RELEASE 内核依赖的模块及库 /lib/modules/VERSION-RELEASE/modules.dep.bin 模块的依赖关系 装载模块modprobe MODULE 或 insmod $(modinfo -n MODULE) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 #modprobepcnet32 #lsmod|fgreppcnet32 pcnet32291070 mii44761pcnet32 安装pcnet32模块 #insmod$(modinfo-npcnet32) insmod:errorinserting '/lib/modules/2.6.32-696.el6.i686/kernel/drivers/net/pcnet32.ko' :-1Unknownsymbol in module 查看依赖 #modinfopcnet32 depends:mii 依据路径安装被依赖的模块 #insmod$(modinfo-nmii) 查看是否安装 #lsmod|fgrepmii mii44760 安装Pcnet32 #insmod$(modinfo-npcnet32) 查看是否安装 #lsmod|fgreppcnet32 pcnet32291070 mii44761pcnet32 # 拆除模块modprobe -r MODULE 或 rmmod MODULE 1 2 3 4 5 6 7 #modprobe-rpcnet32 #lsmod|fgreppcnet32 # #rmmodpcnet32 #lsmod|fgreppcnet32 # /proc目录 只读 内核内部统计、状态信息 可写 可配置参数,/proc/sys目录中,由sysctl命令控制,内核性能调整 临时生效:echo 'STRING' > /proc/sys/kernel/hostname , sysctl -w kernel.hostname='STRING' 永久有效:/etc/sysctl.conf sysctl命令 -p CONFIG_FILE 读取文件设定参数 -w PARAMETER='VALUE' 设定内核参数 # echo 'VALUE' > /proc/sys/kernel/hostname # sysctl -w kernel.hostname='VALUE' 主机名: /proc/sys/kernel/hostname 路由转发: /proc/sys/net/ipv4/ip_forward 1:开启; 0:关闭 cache/buffer回收: /proc/sys/vm/drop_caches 1: dropcache -a 显示所有内核参数 -p 重读配置文件 配置文件: /etc/sysctl.conf 路由转发: 打开路由转发时,一个网卡的用户能够ping通另一个网卡所在网络的主机 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 临时生效 1、查看主机名 #cat/proc/sys/kernel/hostname localhost.localdomain 2、设置主机名 #echo"Lcc.org">/proc/sys/kernel/hostname #cat/proc/sys/kernel/hostname Lcc.org #hostname Lcc.org 3、设定主机名 #sysctl-wkernel.hostname="lcc.org" kernel. hostname =lcc.org 4、查看主机名 #hostname lcc.org #cat/proc/sys/kernel/hostname lcc.org 永久有效 #cp/etc/sysctl.conf{,.bak} #echo"kernel.hostname=magedu.com">>/etc/sysctl.conf #hostname lcc.org #sysctl-p net.ipv4.ip_forward=0 net.ipv4.conf.default.rp_filter=1 net.ipv4.conf.default.accept_source_route=0 kernel.sysrq=0 kernel.core_uses_pid=1 net.ipv4.tcp_syncookies=1 kernel.msgmnb=65536 kernel.msgmax=65536 kernel.shmmax=4294967295 kernel.shmall=268435456 kernel. hostname =magedu.com #hostname magedu.com /sys目录 内核探测的硬件信息 kernel 2.4- /dev/目录下事先创建所有设备文件,/dev/目录文件多,造成大量空间浪费 kernel 2.4+ /dev/目录下按需生成设备文件,kernel临时探测,按需创建,节约空间 udev工具: udevadmin,hotplug 简易编译内核 1)获取源码 2)开发环境 3)查看目标主机的硬件设备信息 4)目标实际需要 1、获取源码 https://www.kernel.org/ **小于3.10版本 2、展开至/usr/local/目录 3、创建符号链接 5、编译 1、设置release号 2、设置主机名 3、设置支持NTFS文件系统 4、设置支持的网络驱动 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 generalsetup Localversion-appendtokernelrelease - 1 .os.cpu ((none))Defaulthostname默认主机名 Filesystems JFS GFS2 Btrfs DOS/FAT NTFS Devicedrivers Netowrkdevicesupport Enternetdriversupport 打开一个虚拟的屏幕: 退出: ctrl + a 松开a后按d 列出: screen -ls 连接回: screen -r ID 5、编译 make -j # # lscpu 中 cpu(s) 后的数字为cpu核心数 6、安装 本文转自 lccnx 51CTO博客,原文链接:http://blog.51cto.com/sonlich/1961362,如需转载请自行联系原作者


优秀的个人博客,低调大师

android clipRect Op.xxx各个参数理解

有点小啰嗦的一篇学习笔记,可以直接看最后得出的结论:前面的各种图片和说明都是为最后的结论服务的 1)剪切:和平常画图工具剪切的作用一样,在画布上剪切一个区域,比如剪切一个Rect区域,画布canvas其余的部分都丢掉,之后所有的画图都在这个Rect区域内进行(如果不涉及save和restore方法)。 2)clip进行剪切的时候,不会影响之前已经画好的图形。 3)剪切是对canvas的操作,而不是在canvas上的图进行操作。 为了说明这几点,下面进行一下说明。 步骤1) 在剪切之前绘制一个全屏的蓝色的矩形。 2)定义剪切的矩形Rect区域,并进行剪切 3)设置剪切过后画布颜色为红色 运行的效果如下图所示:此时剪切过后画布的区域就是剪切的Rect区域,虽然剪切掉了canvas上面和下面的一部分,但是仍然会把途中所示的蓝色部分显示出来而不会剪切掉:也就是如上所说不会影响之前已经画好的图形。 代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 protected void onDraw(Canvas canvas) { int width = getMeasuredWidth(); int height = getMeasuredHeight(); Paint paint = new Paint(); paint.setColor(Color.BLUE); //全屏绘制一个蓝色的矩形画面 canvas.drawRect( 0 , 0 ,width,height,paint); //定义剪切的Rect区域 Rect rect = new Rect(); rect.left = 0 ; rect.top = 300 ; //左上角(0,300) rect.right = width; rect.bottom = height/ 2 ; //右下角(width,height) //进行剪切 canvas.clipRect(rect) canvas.drawColor(Color.RED); } 上面的clipRect是只有一个参数的(默认为INTERSECT,下面看看它的重载方法Cliprect(rect,OP.xx)第二个参数以及各个参数的含义和运行效果: 开始之前做些准备工作: 区域A:剪切之前的画布区域 区域B:当前要剪切的区域,也就是clipRect的第一个参数所表示的区域 在没有直接写代码测试之前对这些字段的翻译和查阅写数学资料并对Op.xxx的各种字段在心里做了如下假设: XOR:异或运算,相同为0(false),不用为1(true),也就是两个区域重叠的地方为0,不同的地方为1,剪切过后的画布的区域就是两个区域不重叠的部分。 INTERSECT:交集运算,剪切过后的画布区域就是两个区域的交集区域。 REPLACE:这个有待验证,不明所以,从字面意思来说是代替的意思,应该就是用B的区域代替A的区域,所以剪切过后的画布区域可能就是只剩下B的区域,当然这个只是假设,有待下面的验证过。 DIFFERENCE:差集运算,剪切过后的画布的区域就是A-B REVERSE_DIFFERENCE:差集运算,REVERSE为反向,逆向的意思,不难猜出剪切过后的画布区域是B-A的区域 UNION:并集运算,剪切过后的画布区域就是A和B的区域相加,当然重叠的地方只计算一次 下面就写程序注意验证上面的结果和得出相应的结论 先是全集和子集的情况:此时A为全集区域,B为A的子集 a) Op.DIFFERENCE:即将剪切的区域(设置B)与当前canvas(设置A)之间的差集,剪切过后还剩下的画布canvas区域就是A-B的区域,看看运行结果 步骤还是之前的步骤,只是把canvas.clipRect(rect)改成canvas.clipRect(rect,Op.DIFFERENCE);运行结果如下:<喎�"/kf/ware/vc/" target="_blank" class="keylink">vcD4KPHA+PGltZyBzcmM9"/uploadfile/Collfiles/20150212/2015021208423342.png" alt="\"> b) Op.REVERSE_DIFFERENCE:对比DIFFERENCE取A-B,REVERSE是相反的意思,所以为B-A,因为B为A的子集,所以该差集不存在,所以运行结果为下: c) Op.XOR:两个区域进行异或运算,异或运算的规则是:“相同为0(false),不同为1(true)”,当两个区域进行异或的时候,很显然“区域重叠的地方为0,不重叠的地方为1”,剪切过后剩下的画布canvas的区域就是不重叠的地方所在的区域,看看运行结果 d) Op.UNION 取A和B的并集,所以运行结果为下图: e) Op.INTERSECT 取A和B的交集,因为上面的程序中A是全屏的画布范围,而B在A里面,所以剪切的结果为下图所示,所以说交集为B的范围 f) Op.REPLACE,运行效果如下 通过全集和子集的运行效果来看,REPLACE应该就是跟上面设想的一样,其余的倒是跟设想的结论一样。 所以我就测试了非全集和子集的情况 此时A区域和B区域的关系如图,C为A和B的交集区域: 测试画图步骤: 1)绘制一个蓝色的矩形面 2)定义A的Rect对象(第一次要剪切的区域),并开始剪切 3)定义B的rect对象并开始剪切,并且调用clipRect(rect,Op.xxx)来看不用xxx下剪切的效果 4)把剪切过后的画布设置为红色 上面步骤的代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 int width = 1000 ; int height = 1000 ; Paint paint = new Paint(); paint.setColor(Color.BLUE); //全屏绘制一个蓝色的矩形画面 canvas.drawRect( 0 , 0 ,width,height,paint); //定义区域A的rect对象 Rect rect = new Rect(); rect.left = 100 ; rect.top = 100 ; //左上角(0,300) rect.right = 300 ; rect.bottom = 300 ; //右下角(width,hei //剪切为A区域 canvas.clipRect(rect); //同clipRect //设置b的rect对象 rect.left = 200 ; rect.top = 200 ; //左上角(0,300) rect.right = 400 ; rect.bottom = 400 ; //右下角(width,height) canvas.clipRect(rect,Op.xxxx); //把剪切过后的画布设置红色 canvas.drawColor(Color.RED); a) DIFFERENCE的情况下的运行效果(A-B的差集):也就是A区域去掉C区域 b) REVERSE_DIFFERENCE的运行效果如下图(B-A的差集):也就是B区域去掉C区域 c) UNION 的运行结果 (A和B的并集) d) INTERSECT (交集运算)此时画布只剩下C区域可以显示,所以运行结果如下 e)XOR 异或运算,剪切过后的结果为A和B区域不重叠的区域 f)REPLACE 这个运算结果是什么呢?就是B区域,也就是剪切过后的结果只保留B区域,这也就是REPLACE代替或者替换的含义:当前还没被剪切的区域A被即将要剪切的区域B来代替。 结论: XOR:异或运算,相同为0(false),不用为1(true),也就是两个区域重叠的地方为0,不同的地方为1,剪切过后的画布的区域就是两个区域不重叠的部分。 INTERSECT:交集运算,剪切过后的画布区域就是两个区域的交集区域。 DIFFERENCE:差集运算,剪切过后的画布的区域就是A-B REVERSE_DIFFERENCE:差集运算,REVERSE为反向,逆向的意思,不难猜出剪切过后的画布区域是B-A的区域 UNION:并集运算,剪切过后的画布的区域为A+B的区域 REPLACE:也就是剪切过后的结果只保留B区域,这也就是REPLACE代替或者替换的含义:当前还没被剪切的区域A被即将要剪切的区域B来代替。 本文转自 一点点征服 博客园博客,原文链接:http://www.cnblogs.com/ldq2016/p/6665033.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MaxCompute SQL原理解析及性能调优

分享内容 介绍了MaxCompute(原ODPS) SQL的基于mapreduce是如何实现的及一些使用小技巧,回顾了mapreduce各个阶段可能产生的问题及相应的处理方法,同时介绍了一些应对数据倾斜的处理方法,最后介绍了一些关于数据集构造、特征选择的技巧帮助减少资源利用。 分享嘉宾 顾茂杰 阿里云天池竞赛选手DesTiny 在天池参加过阿里移动推荐算法、新浪微博互动预测大赛、IJCAI 16,并在新浪微博互动预测大赛中获得冠军。现就职于蚂蚁金服,担任推荐平台算法工程师。 分享视频https://v.qq.com/iframe/player.html?vid=l0552ocwlax&width=670&height=376.875&auto=0 分享重点 阿里巴巴大数据-玩家社区https://yq.aliyun.

优秀的个人博客,低调大师

如何才能加深对Linux概念架构的理解

一、Linux内核在整个计算机系统中的位置 Fig 1 - 计算机系统分层结构 分层结构的原则:the dependencies between subsystems are from the top down: layers pictured near the top depend on lower layers, but subsystems nearer the bottom do not depend on higher layers. 这种子系统之间的依赖性只能是从上到下,也就是图中顶部的子系统依赖底部的子系统,反之则不行。 二、内核的作用 1.虚拟化(抽象),将计算机硬件抽象为一台虚拟机,供用户进程process使用;进程运行时完全不需要知道硬件是如何工作的,只要调用 Linux kernel 提供的虚拟接口virtual interface即可。 2.多任务处理,实际上是多个任务在并行使用计算机硬件资源,内核的任务是仲裁对资源的使用,制造每个进程都以为自己是独占系统的错觉。 PS:进程上下文切换就是要换掉程序状态字、换掉页表基地址寄存器的内容、换掉 current 指向的 task_struct 实例、换掉 PC ——>也就换掉了进程打开的文件(通过 task_struct 的 files 可以找到)、换掉了进程内存的执行空间(通过 task_struct 的 mem 可以找到)。 三、Linux内核的整体架构 Linux内核的整体架构 中心系统是进程调度器Process Scheduler,SCHED:所有其余的子系统都依赖于进程调度器,因为其余子系统都需要阻塞和恢复进程。当一个进程需要等待一个硬件动作完成时,相应子系统会阻塞这个进程;当这个硬件动作完成时,子系统会将这个进程恢复:这个阻塞和恢复动作都要依赖于进程调度器完成。 上图中的每一个依赖箭头都有原因: ◆进程调度器依赖内存管理器Memory manager:进程恢复执行时,需要依靠内存管理器分配供它运行的内存。 ◆IPC 子系统依赖于内存管理器:共享内存机制是进程间通信的一种方法,运行两个进程利用同一块共享的内存空间进行信息传递。 ◆VFS 依赖于网络接口Network Interface:支持 NFS 网络文件系统; ◆VFS 依赖于内存管理器:支持 ramdisk 设备 ◆内存管理器依赖于 VFS,因为要支持交换swapping,可以将暂时不运行的进程换出到磁盘上的交换分区swap,进入挂起状态。 四、高度模块化设计的系统,利于分工合作 只有极少数的程序员需要横跨多个模块开展工作,这种情况确实会发生,仅发生在当前系统需要依赖另一个子系统时。 硬件设备驱动hardware device drivers、文件系统模块logical filesystem modules、网络设备驱动network device drivers和网络协议模块network protocol modules这四个模块的可扩展性最高。 五、系统中的数据结构 1.任务列表Task List 进程调度器针对每个进程维护一个数据结构 task_struct;所有的进程用链表管理,形成 task list;进程调度器还维护一个 current 指针指向当前正在占用 CPU 的进程。 2.内存映射Memory Map 内存管理器存储每个进程的虚拟地址到物理地址的映射;并且也提供了如何换出特定的页,或者是如何进行缺页处理。这些信息存放在数据结构 mm_struct 中。每个进程都有一个 mm_struct 结构,在进程的 task_struct 结构中有一个指针 mm 指向次进程的 mm_struct 结构。 在 mm_struct 中有一个指针 pgd,指向该进程的页目录表(即存放页目录首地址)——>当该进程被调度时,此指针被换成物理地址,写入控制寄存器 CR3(x86体系结构下的页基址寄存器)。 3.I-nodes VFS 通过 inodes 节点表示磁盘上的文件镜像,inodes 用于记录文件的物理属性。每个进程都有一个 files_struct 结构,用于表示该进程打开的文件,在 task_struct 中有个 files 指针。使用 inodes 节点可以实现文件共享。文件共享有两种方式:(1)通过同一个系统打开文件 file 指向同一个 inodes 节点,这种情况发生于父子进程间;(2)通过不同系统打开文件指向同一个 inode 节点,举例有硬链接;或者是两个不相关的指针打开同一个文件。 4.数据连接Data Connection 内核中所有的数据结构的根都在进程调度器维护的任务列表链表中。系统中每个进程的的数据结构 task_struct 中有一个指针 mm 指向它的内存映射信息;也有一个指针 files 指向它打开的文件(用户打开文件表);还有一个指针指向该进程打开的网络套接字。 六、子系统架构 1.进程调度器Process Scheduler 架构 (1)目标 进程调度器是 Linux kernel 中最重要的子系统。系统通过它来控制对 CPU 的访问——不仅仅是用户进程对 CPU 的访问,也包括其余子系统对 CPU 的访问。 (2)模块 进程调度器 调度策略模块scheduling policy module:决定哪个进程获得对 CPU 的访问权;调度策略应该让所有进程尽可能公平得共享 CPU。 ◆体系结构相关模块architecture-specific module设计一组统一的抽象接口来屏蔽特定体系接口芯片的硬件细节。这个模块与 CPU 交互以阻塞和恢复进程。这些操作包括获取每个进程需要保存的寄存器和状态信息、执行汇编代码来完成阻塞或者恢复操作。 ◆体系结构无关模块architecture-independent module与调度策略模块交互将决定下一个执行的进程,然后调用体系结构相关的代码去恢复那个进程的执行。不仅如此,这个模块还会调用内存管理器的接口来确保被阻塞的进程的内存映射信息被正确得保存起来。 ◆系统调用接口模块system call interface允许用户进程访问 Linux Kernel 明确暴露给用户进程的资源。通过一组定义合适的基本上不变的接口(POSIX 标准),将用户应用程序和 Linux 内核解耦,使得用户进程不会受到内核变化的影响。 (3)数据表示 调度器维护一个数据结构——task list,其中的元素是每个活动的进程 task_struct 实例;这个数据结构不仅仅包含用来阻塞和恢复进程的信息,也包含额外的计数和状态信息。这个数据结构在整个 kernel 层都可以公共访问。 (4)依赖关系、数据流、控制流 正如前面提到过的,调度器需要调用内存管理器提供的功能,去为需要恢复执行的进程选择合适的物理地址,正因为如此,所以进程调度器子系统依赖于内存管理子系统。当其他内核子系统需要等待硬件请求完成时,它们都依赖于进程调度子系统进行进程的阻塞和恢复。这种依赖性通过函数调用和访问共享的 task list 数据结构来体现。所有的内核子系统都要读或者写代表当前正在运行进程的数据结构,因此形成了贯穿整个系统的双向数据流。 除了内核层的数据流和控制流,OS 服务层还给用户进程提供注册定时器的接口。这形成了由调度器对用户进程的控制流。通常唤醒睡眠进程的用例不在正常的控制流范围,因为用户进程无法预知何时被唤醒。最后,调度器与 CPU 交互来阻塞和恢复进程,这又形成它们之间的数据流和控制流——CPU 负责打断当前正在运行的进程,并允许内核调度其他的进程运行。 2.内存管理器Memory Manager 架构 (1)目标 内存管理模块负责控制进程如何访问物理内存资源。通过硬件内存管理系统(MMU)管理进程虚拟内存和机器物理内存之间的映射。每一个进程都有自己独立的虚拟内存空间,所以两个进程可能有相同的虚拟地址,但是它们实际上在不同的物理内存区域运行。MMU 提供内存保护,让两个进程的物理内存空间不互相干扰。内存管理模块还支持交换——将暂时不用的内存页换出到磁盘上的交换分区,这种技术让进程的虚拟地址空间大于物理内存的大小。虚拟地址空间的大小由机器字长决定。 (2)模块 内存管理子系统 ◆架构相关模块architecture specific module提供访问物理内存的虚拟接口。 ◆架构无关模块architecture independent module负责每个进程的地址映射以及虚拟内存交换。当发生缺页错误时,由该模块负责决定哪个内存页应该被换出内存——因为这个内存页换出选择算法几乎不需要改动,所以这里没有建立一个独立的策略模块。 ◆系统调用接口system call interface为用户进程提供严格的访问接口(malloc 和 free;mmap 和 ummap)。这个模块允许用进程分配和释放内存、执行内存映射文件操作。 (3)数据表示 内存管理存放每个进程的虚拟内存到物理内存的映射信息。这种映射信息存放在 mm_struct 结构实例中,这个实例的指针又存放在每个进程的 task_struct 中。除了存放映射信息,数据块中还应该存放关于内存管理器如何获取和存储页的信息。例如:可执行代码能够将可执行镜像作为备份存储;但是动态申请的数据则必须备份到系统页中。(这个没看懂,请高手解惑?) 最后,内存管理模块还应该存放访问和技术信息,以保证系统的安全。 (4)依赖关系、数据流和控制流 内存管理器控制物理内存,当页面失败 page fault 发生时,接受硬件的通知(缺页中断)—— 这意味着在内存管理模块和内存管理硬件之间存在双向的数据流和控制流。内存管理也依赖文件系统来支持交换和内存映射 I/O——这种需求意味着内存管理器需要调用对文件系统提供的函数接口procedure calls,往磁盘中存放内存页和从磁盘中取内存页。因为文件系统请求非常慢,所以在等待内存页被换入之前,内存管理器要让进程需要进入休眠——这种需求让内存管理器调用进程调度器的接口。由于每个进程的内存映射存放在进程调度器的数据结构中,所以在内存管理器和进程调度器之间也有双向的数据流和控制流。用户进程可以建立新的进程地址空间,并且能够感知缺页错误——这里需要来自内存管理器的控制流。一般来说没有用户进程到内存管理器的数据流,但是用户进程却可以通过 select 系统调用,从内存管理器获取一些信息。 3.虚拟文件系统Virtual File System 架构 (1)目标 虚拟文件系统为存储在硬件设备上数据提供统一的访问接口。可以兼容不同的文件系统(ext2,ext4,ntf等等)。计算机中几乎所有的硬件设备都被表示为一个通用的设备驱动接口。逻辑文件系统促进与其他操作系统标准的兼容性,并且允许开发者以不同的策略实现文件系统。虚拟文件系统更进一步,允许系统管理员在任何设备上挂载任何逻辑文件系统。虚拟文件系统封装物理设备和逻辑文件系统的细节,并且允许用户进程使用统一的接口访问文件。 除了传统的文件系统目标,VFS 也负责装载新的可执行文件。这个任务由逻辑文件系统模块完成,使得 Linux 可以支持多种可执行文件。 (2)模块 虚拟文件系统模块 ◆设备驱动模块device driver module ◆设备独立接口模块Device Independent Interface:提供所有设备的同一视图。 ◆逻辑文件系统logical file system:针对每种支持的文件系统。 ◆系统独立接口system independent interface提供硬件资源和逻辑文件系统都无关的接口,这个模块通过块设备节点或者字符设备节点提供所有的资源。 ◆系统调用模块system call interface提供用户进程对文件系统的统一控制访问。虚拟文件系统为用户进程屏蔽了所有特殊的特性。 (3)数据表示 所有文件使用 inode 表示。每个 inode 都记录一个文件在硬件设备上的位置信息。不仅如此,inode 还存放着指向逻辑文件系统模块和设备驱动的的函数指针,这些指针能够执行具体的读写操作。通过按照这种形式(就是面向对象中的虚函数的思想)存放函数指针,具体的逻辑文件系统和设备驱动可以向内核注册自己而不需要内核依赖具体的模块特性。 (4)依赖关系、数据流和控制流 一个特殊的设备驱动是 ramdisk,这个设备在主存中开辟一片区域,并把它当成持久性存储设备使用。这个设备驱动使用内存管理模块完成任务,所以在 VFS 与对内存管理模块存在依赖关系(图中的依赖关系反了,应该是 VFS 依赖于内存管理模块)、数据流和控制流。 逻辑文件系统支持网络文件系统。这个文件系统像访问本地文件一样,从另一台机器上访问文件。为了实现这个功能,一种逻辑文件系统通过网络子系统完成它的任务——这引入了 VFS 对网络子系统的一个依赖关系以及它们之间的控制流和数据流。 正如前面提到的,内存管理器使用 VFS 完成内存交换功能和内存映射 I/O。另外,当 VFS 等待硬件请求完成时,VFS 需要使用进程调度器阻塞进程;当请求完成时,VFS 需要通过进程调度器唤醒进程。最后,系统调用接口允许用户进程调用来存取数据。不像前面的子系统,VFS 没有提供给用户注册不明确调用的机制,所以没有从VFS到用户进程的控制流。 4.网络接口Network Interface 架构 (1)目标 网络子系统让 Linux 系统能够通过网络与其他系统相连。这个子系统支持很多硬件设备,也支持很多网络协议。网络子系统将硬件和协议的实现细节都屏蔽掉,并抽象出简单易用的接口供用户进程和其他子系统使用——用户进程和其余子系统不需要知道硬件设备和协议的细节。 (2)模块 网络协议层模块图 ◆网络设备驱动模块network device drivers ◆设备独立接口模块device independent interface module提供所有硬件设备的一致访问接口,使得高层子系统不需要知道硬件的细节信息。 ◆网络协议模块network protocol modules负责实现每一个网络传输协议,例如:TCP,UDP,IP,HTTP,ARP等等~ ◆协议无关模块protocol independent interface提供独立于具体协议和具体硬件设备的一致性接口。这使得其余内核子系统无需依赖特定的协议或者设备就能访问网络。 ◆系统调用接口模块system calls interface规定了用户进程可以访问的网络编程API。 (3)数据表示 每个网络对象都被表示为一个套接字socket。套接字与进程关联的方法和 inode 节点相同。通过两个 task_struct 指向同一个套接字,套接字可以被多个进程共享。 (4)数据流,控制流和依赖关系 当网络子系统需要等待硬件请求完成时,它需要通过进程调度系统将进程阻塞和唤醒——这形成了网络子系统和进程调度子系统之间的控制流和数据流。不仅如此,虚拟文件系统通过网络子系统实现网络文件系统(NFS)——这形成了 VFS 和网络子系统指甲的数据流和控制流。 七、结论 1.Linux 内核是整个 Linux 系统中的一层。内核从概念上由五个主要的子系统构成:进程调度器模块、内存管理模块、虚拟文件系统、网络接口模块和进程间通信模块。这些模块之间通过函数调用和共享数据结构进行数据交互。 2.Linux 内核架构促进了他的成功,这种架构使得大量的志愿开发人员可以合适得分工合作,并且使得各个特定的模块便于扩展。 ◆可扩展性一:Linux 架构通过一项数据抽象技术使得这些子系统成为可扩展的——每个具体的硬件设备驱动都实现为单独的模块,该模块支持内核提供的统一的接口。通过这种方式,个人开发者只需要和其他内核开发者做最少的交互,就可以为 Linux 内核添加新的设备驱动。 ◆可扩展性二:Linux 内核支持多种不同的体系结构。在每个子系统中,都将体系结构相关的代码分割出来,形成单独的模块。通过这种方法,一些厂家在推出他们自己的芯片时,他们的内核开发小组只需要重新实现内核中机器相关的代码,就可以讲内核移植到新的芯片上运行。 作者:Ivan Bowman 来源:51CTO

优秀的个人博客,低调大师

深入理解Openstack QoS控制实现与实践

0.什么是QoSFrom Wikipedia: Quality of service (QoS) is the overall performance of a telephony or computer network, particularly the performance seen by the users of the network. To quantitatively measure quality of service, several related aspects of the network service are often considered, such as error rates, bit rate, throughput, transmission delay, availability, jitter, etc. 简单来说,QoS是一种控制机制,提供针对不同用户或者不同数据流采用相应不同的优先级,或者根据应用程序的要求,保证数据流的性能达到一定的水准。QoS的保证对于容量有限的网络来说是十分重要的,特别是对于流媒体应用,例如VoIP和IPTV等,因为这些应用常常需要固定的传输率,对延时也比较敏感。 QoS通常指网络上的数据流控制,本文讨论的QoS则更广泛些,不仅包含了传统的网络数据流控制(即网络IO控制),还包括了本地磁盘的读写控制,比如IOPS等。其中包括两种类型: 质量控制:通过提供不同性能的硬件设备来满足不同应用的性能需求,比如存储设备有SATA、SSD、RAID等。 量化控制:针对应用,对其流量进行严格控制,比如IOPS、网络带宽等。 Openstack同时支持以上两种QoS控制,这些组件包括但不限于计算服务Nova、网络服务Neutron、块存储服务Cinder、对象存储Swift等,Ceph虽然不是Openstack的组件之一,但通常作为Openstack的存储后端,因此本文也会对其进行简单的介绍。 本文旨在归纳总结Openstack如何在应用层实现QoS控制,读者如果对底层实现原理感兴趣,可以查阅相关资料。 1.Ceph Ceph是近年来非常火热的开源统一分布式存储系统,最初是Sage Weil在University of California, Santa Cruz(UCSC)的PhD研究内容,目前由Inktank公司掌控Ceph的开发。Ceph同时支持块存储(LVM、裸硬盘)、对象存储(S3、Swift)、文件系统存储(HDFS、GFS),并且具有高扩展性、高可靠性、高性能的优点。 Ceph其中最广泛的应用之一是作为Openstack的存储后端,为Openstack提供统一分布式存储服务。Openstack组件中Nova、Glance、Cinder都支持直接对接Ceph,云主机的在线迁移、故障转移、镜像存储等功能都依赖于Ceph提供的统一分布式存储服务。 实际在部署时不同的机房或者机架可能配置不同的存储设备,比如SSD固态存储设备、SATA普通硬盘等,rbd image实例使用不同的存储后端,显然能够提供不同的性能。 我们知道ceph是通过crush算法和crush map决定对象如何分布存储的,cursh map描述了存储设备的层级拓扑(可以是物理拓扑,比如机架、机房、区域等,也可以是逻辑拓扑,比如故障域、性能等),整个map图是一个树状结构,如图: ssd /|\ /|\ rack1rack2rack3 /\.../\ host-1host-2host-mhost-n /\....../\ osd1osd2osd-mosd-n 其中中间节点由自定义的bucket type实例构成,通常和物理拓扑名称一致,比如room、rack、host等,叶子节点是真正的存储设备,对应一块硬盘或者分区。根据树的结构,每个存储设备(叶子)有唯一一条路径到root节点,该路径定义为crush location,比如: root=ssdrack=rack1host=host-1 crush map rule能够制定某个pool的数据放置策略,rule的格式如下: rule<rulename>{ ruleset<ruleset> type[replicated|erasure] min_size<min-size> max_size<max-size> steptake<bucket-name> step[choose|chooseleaf][firstn|indep]<N><bucket-type> stepemit } 其中ruleset为rule的id,type用于区分是存储驱动设备(replicated)还是RAID。min_size为最小副本数,如果副本数小于这个数,crush将不会选这个rule,同理max_size为最大副本数。step take开始选择root(注意图上我们只画了一棵树,但crush map可以有多棵树,因此存在多个root type),choose表示从子树种选择对应的bucket type,其中N表示选择的数量: N == 0, 表示设置为pool副本数量; N > 0 && N < replicas,表示真实的数量; N < 0,表示副本数减去该数的绝对值。 比如: stepchoosefirstn1typerack 表示从当前位置向下迭代遍历随机选择一个rack类型。 该step必须位于take或者choose之下。 chooseleaf和choose类似,唯一不同的是在选择的每个bucket中再从中选择一个叶子节点。 以官方例子说明: rulessd-primary{ ruleset5 typereplicated min_size5 max_size10 steptakessd stepchooseleaffirstn1typehost stepemit steptakesata stepchooseleaffirstn-1typehost stepemit } 假设冗余副本数为3,则以上规则会首先从ssd中选择其中一个host,然后在host中选择其中一个osd作为主节点,然后从sata中选择3-1=2个host,分别从当中选择一个osd节点,一共两个osd节点作为副本节点。 注: 主节点负责实际和client通信的节点,而副本节点不会直接和client通信,但会和主节点保持数据同步,当主节点挂了,其中一个副本节点会接管主节点。 在写入数据时,主节点会同步到副本节点,只有当所有的副本节点都写完后,主节点才算写成功,因此ceph采取的是强一致性模型(而Swift是最终一致性模型) 可以通过primary-affinity值设置选择为主节点的概率,值为0表示不会被选择为主节点,值为1表示表示选择为主节点的概率极大(考虑到有多个节点都为1的情况)。 关于crush map 和rule参考官方文档。 ceph中不同的pool可以定义不同的crush以及ruleset,从而可以实现不同的pool,选择不同的osd,比如固定某个pool选择ssd,另一个pool选择sata,其中官方也有个例子: device0osd.0 device1osd.1 device2osd.2 device3osd.3 device4osd.4 device5osd.5 device6osd.6 device7osd.7 hostssd-server-1{ id-1 algstraw hash0 itemosd.0weight1.00 itemosd.1weight1.00 } hostssd-server-2{ id-2 algstraw hash0 itemosd.2weight1.00 itemosd.3weight1.00 } hostsata-server-1{ id-3 algstraw hash0 itemosd.4weight1.00 itemosd.5weight1.00 } hostsata-server-2{ id-4 algstraw hash0 itemosd.6weight1.00 itemosd.7weight1.00 } rootsata{ id-5 algstraw hash0 itemsata-server-1weight2.00 itemsata-server-2weight2.00 } rootssd{ id-6 algstraw hash0 itemssd-server-1weight2.00 itemssd-server-2weight2.00 } rulesata{ ruleset1 typereplicated min_size0 max_size10 steptakeplatter stepchooseleaffirstn0typehost stepemit } rulessd{ ruleset2 typereplicated min_size0 max_size4 steptakessd stepchooseleaffirstn0typehost stepemit } 拓扑图如下: ssd|sata /\|/\ /\|/\ /\|/\ ssd-server-1ssd-server-2|sata-server-1sata-server-2 /\/\|/\/\ /\/\|/\/\ osd0osd1osd2osd3|osd4osd5osd6osd7 我们定义两个rule,假设冗余副本数为3,一个是ssd,它会从ssd中(即左边的树中)中选择osd,另一个是sata,从sata中(即右边的树种)选择osd。 我们创建两个pool,并关联ruleset: cephosdpoolsetsatacrush_ruleset1 cephosdpoolsetssdcrush_ruleset2 通过以上方式我们实现了不同性能的ceph pool,实现QoS质量控制。 那ceph是否支持量化控制呢,rbd目前好像并不支持控制,但可以通过qemu、kvm等控制读写速率。 2.Cinder 介绍完Ceph,接下来终于进入Openstack正题,首先从Cinder谈起。Cinder是Openstack的基础组件之一,提供块存储服务,类似AWS的EBS服务。但是Cinder本身并不提供块服务,而只是一个管理工具,由具体后端实现,后端包括比如LVM、Ceph RBD等,Cinder通过调用对应的驱动来完成volume的生命周期管理。 下面以Ceph RBD作为存储后端为例,首先介绍如何实现volume的QoS质量控制。Cinder支持多后端存储,不同的后端通过不同的配置组区别开,如: [sata-ceph] volume_backend_name=sata rbd_pool=sata volume_driver=cinder.volume.drivers.rbd.RBDDriver rbd_ceph_conf=/etc/ceph/ceph.conf ... [ssd-ceph] volume_backend_name=ssd rbd_pool=ssd volume_driver=cinder.volume.drivers.rbd.RBDDriver rbd_ceph_conf=/etc/ceph/ceph.conf ... 以上有两个配置组,分别为sata-ceph和ssd-ceph,这里我们都使用了ceph rbd作为存储后端,实际部署时可以是完全不同的存储后端,比如混合rbd和LVM。以上我们指定了不同pool以及不同的后端名称,后端名称是为了方便后续创建volume type引用。我们由上面关于Ceph中介绍可知,不同的pool可以定义不同的rule从而选择不同特性的硬件,如果能够绑定Ceph pool和volume问题就解决了,值得庆幸的是,Cinder就是这么实现的。 Cinder自定义volume type,分别创建ssd和sata两个volume type: cindertype-createssd cindertype-createsata 创建完后type后绑定volume_backend_name从而实现与ceph pool关联起来: cindertype-keysatasetvolume_backend_name=sata cindertype-keyssdsetvolume_backend_name=ssd 查看extra-specs: [root@server-39.0.lg.ustack.in~]$cinderextra-specs-list +--------------------------------------+------+-----------------------------------+ |ID|Name|extra_specs| +--------------------------------------+------+-----------------------------------+ |1a0cb988-58a6-43bf-b4ea-199e0e02239b|sata|{u'volume_backend_name':u'sata'}| |38344c5c-b61b-4677-9a48-e70d723b8620|ssd|{u'volume_backend_name':u'ssd'}| +--------------------------------------+------+-----------------------------------+ 此时只需要在创建时指定volume type就可以实现创建不同QoS性能的数据卷,比如: cindercreate--volume-typessd--display-nameint32bit-test-ssd1 以上我们通过自定义volume type并绑定不同的后端实现了对volume访问的QoS质量控制,接下来我们介绍如何通过制定volume type实现不同的QoS量化控制。和前面的步骤类似,首先创建一个high-iops-type volume type: cindertype-createhigh-iops-type cinder通过qos实例对volume进行量化控制,我们需要创建high-iops,设置读最大iops为2000,写最大iopos为1000: cinder qos-create high-iops consumer="front-end" read_iops_sec=2000 write_iops_sec=1000 查看qos列表: $cinderqos-list +--------------------------------------+-----------+-----------+---------------------------------------------------------+ |ID|Name|Consumer|specs| +--------------------------------------+-----------+-----------+---------------------------------------------------------+ |4ba70d30-eb36-4267-8ee5-5c9cc2f8af32|high-iops|front-end|{u'write_iops_sec':u'1000',u'read_iops_sec':u'2000'}| +--------------------------------------+-----------+-----------+---------------------------------------------------------+ 其中consumer的合法值为front-end、back-end、both。front-end表示使用前端控制(hypervisor控制,会在libvirt xml文件中定义), 而back-end表示使用后端控制(cinder drivers,需要driver支持),both表示前后端同时进行QoS控制。 最后绑定qos实例和volume type实例: QOS_SPEC_ID=4ba70d30-eb36-4267-8ee5-5c9cc2f8af32 VOLUME_TYPE_ID=26e33f06-e011-4cf7-a397-91a00ef0a233 cinderqos-associate$QOS_SPEC_ID$VOLUME_TYPE_ID 查看绑定情况: $cinderqos-get-association4ba70d30-eb36-4267-8ee5-5c9cc2f8af32 +------------------+----------------+--------------------------------------+ |Association_Type|Name|ID| +------------------+----------------+--------------------------------------+ |volume_type|high-iops-type|26e33f06-e011-4cf7-a397-91a00ef0a233| +------------------+----------------+--------------------------------------+ 下面我们创建一个volume验证其功能,我们创建时指定volume type为high-iops-type,并挂载到虚拟机中: cindercreate--volume-typehigh-iops-type--display-namehigh-iops-test1 SERVER_ID=1ea33417-b577-45cb-83a0-fc412e421811 VOLUME_ID=bb2ccbfb-654a-473e-9f35-ae548c8e59e1 novavolume-attach$SERVER_ID$VOLUME_ID 查看libvirt xml文件,截取部分disk信息如下: <disktype='network'device='disk'> <drivername='qemu'type='raw'cache='writeback'/> <authusername='admin'> <secrettype='ceph'uuid='bdf77f5d-bf0b-1053-5f56-cd76b32520dc'/> </auth> <sourceprotocol='rbd'name='openstack-00/volume-bb2ccbfb-654a-473e-9f35-ae548c8e59e1'> <hostname='10.0.103.61'port='6789'/> <hostname='10.0.103.62'port='6789'/> <hostname='10.0.103.63'port='6789'/> </source> <backingStore/> <targetdev='vdc'bus='virtio'/> <iotune> <read_iops_sec>2000</read_iops_sec> <write_iops_sec>1000</write_iops_sec> </iotune> <serial>bb2ccbfb-654a-473e-9f35-ae548c8e59e1</serial> <aliasname='virtio-disk2'/> <addresstype='pci'domain='0x0000'bus='0x00'slot='0x08'function='0x0'/> </disk> 由xml文件可见在iotune中对读写IOPS的控制。 以上总结了Openstack Cinder的QoS的控制,接下来将介绍Nova实现机制。 3.Nova Nova是Openstack最核心的服务,提供计算服务,其功能类似AWS EC2。官方描述为: Nova is an OpenStack project designed to provide power massively scalable, on demand, self service access to compute resources. Nova虽然没有直接方式对QoS质量进行控制,但我们可以通过主机集合(Host Aggregate)实现,比如我们有两个计算节点node-1,node-2,配置SSD磁盘,我们创建对应的主机集合并把两个节点加入到该主机集合中: novaaggregate-createssdnova novaaggregate-set-metadatassdssd=true novaaggregate-add-hostssdnode-1 novaaggregate-add-hostssdnode-2 创建一个新的flavor并设置key指定绑定的key-value: novaflavor-createssd.large68192804 novaflavor-keyset_key--name=ssd.large--key=ssd--value=true 查看flavor: $novaflavor-showssd.large +----------------------------+-------------------+ |Property|Value| +----------------------------+-------------------+ |OS-FLV-DISABLED:disabled|False| |OS-FLV-EXT-DATA:ephemeral|0| |disk|80| |extra_specs|{u'ssd':u'true'}| |id|6| |name|ssd.large| |os-flavor-access:is_public|True| |ram|8192| |rxtx_factor|1.0| |swap|| |vcpus|4| +----------------------------+-------------------+ 此时当用户指定ssd.large flavor时,调度器将筛选具有ssd=true标签的计算节点,其余不满足条件的主机将被过滤掉, 最后在node-1和node-2中选取作为虚拟机的宿主机。 同样地,Nova可通过flavor的Extra Specs实现QoS量化控制,以下内容直接参考官方文档-compute flavors: 比如限制IO最大读写速率为10MB/s: openstackflavorsetFLAVOR-NAME\ --propertyquota:read_bytes_sec=10240000\ --propertyquota:write_bytes_sec=10240000 除了IO控制,还支持CPU以及内存限制: CPU openstackflavorsetFLAVOR-NAME\ --propertyquota:cpu_quota=10000\ --propertyquota:cpu_period=20000 内存 openstackflavorsetFLAVOR-NAME\ --propertyquota:memory_shares_level=custom\ --propertyquota:memory_shares_share=15 设置虚拟机最大的disk写入数据为10MB/s: openstackflavorsetFLAVOR-NAME\ --propertyquota:disk_write_bytes_sec=10485760 另外,除了QoS控制,Flavor的强大之处远不止这些,还支持用户自定义CPU拓扑: openstackflavorsetFLAVOR-NAME\ --propertyhw:cpu_sockets=FLAVOR-SOCKETS\ --propertyhw:cpu_cores=FLAVOR-CORES\ --propertyhw:cpu_threads=FLAVOR-THREADS\ --propertyhw:cpu_max_sockets=FLAVOR-SOCKETS\ --propertyhw:cpu_max_cores=FLAVOR-CORES\ --propertyhw:cpu_max_threads=FLAVOR-THREADS 以及NUMA 拓扑: openstackflavorsetFLAVOR-NAME\ --propertyhw:numa_nodes=FLAVOR-NODES\ --propertyhw:numa_cpus.N=FLAVOR-CORES\ --propertyhw:numa_mem.N=FLAVOR-MEMORY 4.Swift Openstack Swift提供对象存储服务,功能类似AWS S3以及Ceph RGW,Swift可以通过配置不同的Storage Policies来实现不同性能的后端存储。具体可参看官方文档Stroage Policie. 5.Neutron Neutron是OpenStack项目中负责提供网络服务的组件,它基于软件定义网络(SDN)的思想,实现了网络虚拟化的资源管理。Neutron支持对虚拟网卡进行带宽流量限制,主要通过QoS Policy实现,需要在neutron server端配置项service_plugins中开启qos插件,参考Neutron QoS。 以下内容主要参考官方文档实例。首先创建一个Qos Policy: neutronqos-policy-createbw-limiter 设置带宽: neutronqos-bandwidth-limit-rule-createbw-limiter--max-kbps3000\ --max-burst-kbps300 通过neutron port-list找到需要限制带宽的端口(虚拟网卡): $neutronport-list +--------------------------------------+----------------------------------+ |id|fixed_ips| +--------------------------------------+----------------------------------+ |0271d1d9-1b16-4410-bd74-82cdf6dcb5b3|{...,"ip_address":"10.0.0.1"}| |88101e57-76fa-4d12-b0e0-4fc7634b874a|{...,"ip_address":"10.0.0.3"}| |e04aab6a-5c6c-4bd9-a600-33333551a668|{...,"ip_address":"10.0.0.2"}| +--------------------------------------+----------------------------------+ 关联port和QoS Policy: neutronport-update88101e57-76fa-4d12-b0e0-4fc7634b874a--qos-policybw-limiter 移除port和Qos Policy的关联: neutronport-update88101e57-76fa-4d12-b0e0-4fc7634b874a--no-qos-policy 创建port时可以指定QoS Policy: neutronport-createprivate--qos-policy-idbw-limiter 总结 本文详细介绍了Openstack基础服务的QoS控制,包括质量控制和量化控制,涉及的内容包括: Ceph通过crush map和ruleset选取不同性能的后端存储设备 Cinder支持多后端存储,Volume type绑定具体的后端从而实现不同性能的后端选择,并且可以自定义QoS实现数据卷的IO读写限制。 Nova可以通过Host Aggregate的Metadata以及Flavor Extra Specs控制调度器选取符合某些特性的(比如SSD)计算节点,通过Flavor Extra Specs实现虚拟机的IO读写限制。 Swift 支持多Policy,通过Storage Policies可以实现不同性能的后端存储设备。 Neutron通过Qos Policy完成对虚拟网卡的带宽限制。 由此可见,Openstack同时支持计算、存储和网络的QoS控制,通过QoS控制可以满足不同应用对不同资源的异构需求。 作者:付广平 来源:51CTO

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册