首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

你都理解创建线程池的参数吗?

微信公众号「后端进阶」,专注后端技术分享:Java、Golang、WEB框架、分布式中间件、服务治理等等。 老司机倾囊相授,带你一路进阶,来不及解释了快上车! 多线程可以说是面试官最喜欢拿来问的题目之一了,可谓是老生之常谈,不管你是新手还是老司机,我相信你一定会在面试过程中遇到过有关多线程的一些问题。那我现在就充当一次面试官,我来问你: 现有一个线程池,参数corePoolSize = 5,maximumPoolSize = 10,BlockingQueue阻塞队列长度为5,此时有4个任务同时进来,问:线程池会创建几条线程? 如果4个任务还没处理完,这时又同时进来2个任务,问:线程池又会创建几条线程还是不会创建? 如果前面6个任务还是没有处理完,这时又同时进来5个任务,问:线程池又会创建几条线程还是不会创建? 如果你此时一脸懵逼,请不要慌,问题不大。 创建线程池的构造方法的参数都有哪些? 要回答这个问题,我们需要从创建线程池的参数去找答案: java.util.concurrent.ThreadPoolExecutor#ThreadPoolExecutor: public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) { if (corePoolSize < 0 || maximumPoolSize <= 0 || maximumPoolSize < corePoolSize || keepAliveTime < 0) throw new IllegalArgumentException(); if (workQueue == null || threadFactory == null || handler == null) throw new NullPointerException(); this.acc = System.getSecurityManager() == null ? null : AccessController.getContext(); this.corePoolSize = corePoolSize; this.maximumPoolSize = maximumPoolSize; this.workQueue = workQueue; this.keepAliveTime = unit.toNanos(keepAliveTime); this.threadFactory = threadFactory; this.handler = handler; } 创建线程池一共有7个参数,从源码可知,corePoolSize和maximumPoolSize都不能小于0,且核心线程数不能大于最大线程数。 下面我来解释一下这7个参数的用途: corePoolSize 线程池核心线程数量,核心线程不会被回收,即使没有任务执行,也会保持空闲状态。 maximumPoolSize 池允许最大的线程数,当线程数量达到corePoolSize,且workQueue队列塞满任务了之后,继续创建线程。 keepAliveTime 超过corePoolSize之后的“临时线程”的存活时间。 unit keepAliveTime的单位。 workQueue 当前线程数超过corePoolSize时,新的任务会处在等待状态,并存在workQueue中,BlockingQueue是一个先进先出的阻塞式队列实现,底层实现会涉及Java并发的AQS机制,有关于AQS的相关知识,我会单独写一篇,敬请期待。 threadFactory 创建线程的工厂类,通常我们会自顶一个threadFactory设置线程的名称,这样我们就可以知道线程是由哪个工厂类创建的,可以快速定位。 handler 线程池执行拒绝策略,当线数量达到maximumPoolSize大小,并且workQueue也已经塞满了任务的情况下,线程池会调用handler拒绝策略来处理请求。 系统默认的拒绝策略有以下几种: AbortPolicy:为线程池默认的拒绝策略,该策略直接抛异常处理。 DiscardPolicy:直接抛弃不处理。 DiscardOldestPolicy:丢弃队列中最老的任务。 CallerRunsPolicy:将任务分配给当前执行execute方法线程来处理。 我们还可以自定义拒绝策略,只需要实现RejectedExecutionHandler接口即可,友好的拒绝策略实现有如下: 将数据保存到数据,待系统空闲时再进行处理 将数据用日志进行记录,后由人工处理 现在我们回到刚开始的问题就很好回答了: 线程池corePoolSize=5,线程初始化时不会自动创建线程,所以当有4个任务同时进来时,执行execute方法会新建【4】条线程来执行任务; 前面的4个任务都没完成,现在又进来2个队列,会新建【1】条线程来执行任务,这时poolSize=corePoolSize,还剩下1个任务,线程池会将剩下这个任务塞进阻塞队列中,等待空闲线程执行; 如果前面6个任务还是没有处理完,这时又同时进来了5个任务,此时还没有空闲线程来执行新来的任务,所以线程池继续将这5个任务塞进阻塞队列,但发现阻塞队列已经满了,核心线程也用完了,还剩下1个任务不知道如何是好,于是线程池只能创建【1】条“临时”线程来执行这个任务了; 这里创建的线程用“临时”来描述还是因为它们不会长期存在于线程池,它们的存活时间为keepAliveTime,此后线程池会维持最少corePoolSize数量的线程。 为什么不建议使用Executors创建线程池? JDK为我们提供了Executors线程池工具类,里面有默认的线程池创建策略,大概有以下几种: FixedThreadPool:线程池线程数量固定,即corePoolSize和maximumPoolSize数量一样。 SingleThreadPool:单个线程的线程池。 CachedThreadPool:初始核心线程数量为0,最大线程数量为Integer.MAX_VALUE,线程空闲时存活时间为60秒,并且它的阻塞队列为SynchronousQueue,它的初始长度为0,这会导致任务每次进来都会创建线程来执行,在线程空闲时,存活时间到了又会释放线程资源。 ScheduledThreadPool:创建一个定长的线程池,而且支持定时的以及周期性的任务执行,类似于Timer。 用Executors工具类虽然很方便,我依然不推荐大家使用以上默认的线程池创建策略,阿里巴巴开发手册也是强制不允许使用Executors来创建线程池,我们从JDK源码中寻找一波答案: java.util.concurrent.Executors: // FixedThreadPool public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } // SingleThreadPool public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); } // CachedThreadPool public static ExecutorService newCachedThreadPool() { // 允许创建线程数为Integer.MAX_VALUE return new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS, new SynchronousQueue<Runnable>()); } // ScheduledThreadPool public ScheduledThreadPoolExecutor(int corePoolSize) { // 允许创建线程数为Integer.MAX_VALUE super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS, new DelayedWorkQueue()); } public LinkedBlockingQueue() { // 允许队列长度最大为Integer.MAX_VALUE this(Integer.MAX_VALUE); } 从JDK源码可看出,Executors工具类无非是把一些特定参数进行了封装,并提供一些方法供我们调用而已,我们并不能灵活地填写参数,策略过于简单,不够友好。 CachedThreadPool和ScheduledThreadPool最大线程数为Integer.MAX_VALUE,如果线程无限地创建,会造成OOM异常。 LinkedBlockingQueue基于链表的FIFO队列,是无界的,默认大小是Integer.MAX_VALUE,因此FixedThreadPool和SingleThreadPool的阻塞队列长度为Integer.MAX_VALUE,如果此时队列被无限地堆积任务,会造成OOM异常。

优秀的个人博客,低调大师

超详细的Guava RateLimiter限流原理解析

限流是保护高并发系统的三把利器之一,另外两个是缓存和降级。限流在很多场景中用来限制并发和请求量,比如说秒杀抢购,保护自身系统和下游系统不被巨型流量冲垮等。 限流的目的是通过对并发访问/请求进行限速或者一个时间窗口内的的请求进行限速来保护系统,一旦达到限制速率则可以拒绝服务或进行流量整形。 常用的限流方式和场景有:限制总并发数(比如数据库连接池、线程池)、限制瞬时并发数(如nginx的limit_conn模块,用来限制瞬时并发连接数,Java的Semaphore也可以实现)、限制时间窗口内的平均速率(如Guava的RateLimiter、nginx的limit_req模块,限制每秒的平均速率);其他还有如限制远程接口调用速率、限制MQ的消费速率。另外还可以根据网络连接数、网络流量、CPU或内存负载等来限流。 比如说,我们需要限制方

优秀的个人博客,低调大师

通过写Babel插件理解抽象语法树(翻译)

原文:https://www.sitepoint.com/understanding-asts-building-babel-plugin/ 每天很多JavaScript开发者使用了浏览器提供商还没有实现的语言版本。很多语言特性都只是草案,将来并不能保证会被写进标准。因为了有了Bable项目,才成为了可能。 众所周知,Babel可以把ES6代码转换为ES5代码,并且可以安全运行;同时,Bable允许开发者编写插件在编译时更改JavaScript程序的结构。 今天,我们将看下如何写Bable插件为JavaScript添加默认的不可变数据。这个教程的代码可以从GitHub仓库下载。 语言概述 我们希望设计允许我们把普通的对象和数组字面量通过使用Mori转换为不可变的数据结构的插件。 我希望这样写代码: varfoo= { a: 1 }; varb

优秀的个人博客,低调大师

深度预警:深入理解HBase的系统架构

HBase的构成 物理上来说,HBase是由三种类型的服务器以主从模式构成的。这三种服务器分别是:Region server,HBase HMaster,ZooKeeper。 其中Region server负责数据的读写服务。用户通过沟通Region server来实现对数据的访问。 HBase HMaster负责Region的分配及数据库的创建和删除等操作。 ZooKeeper作为HDFS的一部分,负责维护集群的状态(某台服务器是否在线,服务器之间数据的同步操作及master的选举等)。 另外,Hadoop DataNode负责存储所有Region Server所管理的数据。HBase中的所有数据都是以HDFS文件的形式存储的。出于使Region server所管理的数据更加本地化的考虑,Region server是根据DataNode分布的。HBase的数据在写入的时候都存储在本地。但当某一个region被移除或被重新分配的时候,就可能产生数据不在本地的情况。这种情况只有在所谓的compaction之后才能解决。 NameNode负责维护构成文件的所有物理数据块的元信息(metadata)。 HBase结构如下图所示: Regions HBase中的表是根据row key的值水平分割成所谓的region的。一个region包含表中所有row key位于region的起始键值和结束键值之间的行。集群中负责管理Region的结点叫做Region server。Region server负责数据的读写。每一个Region server大约可以管理1000个region。Region的结构如下图所示: HBase的HMaster HMaster负责region的分配,数据库的创建和删除操作。 具体来说,HMaster的职责包括: 调控Region server的工作 在集群启动的时候分配region,根据恢复服务或者负载均衡的需要重新分配region。 监控集群中的Region server的工作状态。(通过监听zookeeper对于ephemeral node状态的通知)。 管理数据库 提供创建,删除或者更新表格的接口。 HMaster的工作如下图所示: ZooKeeper HBase利用ZooKeeper维护集群中服务器的状态并协调分布式系统的工作。ZooKeeper维护服务器是否存活,是否可访问的状态并提供服务器故障/宕机的通知。ZooKeeper同时还使用一致性算法来保证服务器之间的同步。同时也负责Master选举的工作。需要注意的是要保证良好的一致性及顺利的Master选举,集群中的服务器数目必须是奇数。例如三台或五台。 ZooKeeper的工作如下图所示: HBase各组成部分之间的合作 ZooKeeper用来协调分布式系统的成员之间共享的状态信息。Region Server及HMaster也与ZooKeeper连接。ZooKeeper通过心跳信息为活跃的连接维持相应的ephemeral node。如下图所示: 每一个Region server都在ZooKeeper中创建相应的ephemeral node。HMaster通过监控这些ephemeral node的状态来发现正常工作的或发生故障下线的Region server。HMaster之间通过互相竞争创建ephemeral node进行Master选举。ZooKeeper会选出区中第一个创建成功的作为唯一一个活跃的HMaster。活跃的HMaster向ZooKeeper发送心跳信息来表明自己在线的状态。不活跃的HMaster则监听活跃HMaster的状态,并在活跃HMaster发生故障下线之后重新选举,从而实现了HBase的高可用性。 如果Region server或者HMaster不能成功向ZooKeeper发送心跳信息,则其与ZooKeeper的连接超时之后与之相应的ephemeral node就会被删除。监听ZooKeeper状态的其他节点就会得到相应node不存在的信息,从而进行相应的处理。活跃的HMaster监听Region Server的信息,并在其下线后重新分配Region server来恢复相应的服务。不活跃的HMaster监听活跃HMaster的信息,并在起下线后重新选出活跃的HMaster进行服务。 HBase的第一次读写 HBase中有一个特殊的起目录作用的表格,称为META table。META table中保存集群region的地址信息。ZooKeeper中会保存META table的位置。 当用户第一次想HBase中进行读或写操作时,以下步骤将被执行: 1.客户从ZooKeeper中得到保存META table的Region server的信息。 2.客户向该Region server查询负责管理自己想要访问的row key的所在的region的Region server的地址。客户会缓存这一信息以及META table所在位置的信息。 3.客户与负责其row所在region的Region Server通信,实现对该行的读写操作。 在未来的读写操作中,客户会根据缓存寻找相应的Region server地址。除非该Region server不再可达。这时客户会重新访问META table并更新缓存。这一过程如下图所示: HBase的META table META table中保存了HBase中所有region的信息。 META table的格式类似于B tree。 META table的结构如下: 键:region的起始键,region id。 值:Region server 如下图所示: Region Server的组成 运行在HDFS DataNode上的Region server包含如下几个部分: WAL:既Write Ahead Log。WAL是HDFS分布式文件系统中的一个文件。WAL用来存储尚未写入永久性存储区中的新数据。WAL也用来在服务器发生故障时进行数据恢复。 Block Cache:Block cache是读缓存。Block cache将经常被读的数据存储在内存中来提高读取数据的效率。当Block cache的空间被占满后,其中被读取频率最低的数据将会被杀出。 MemStore:MemStore是写缓存。其中存储了从WAL中写入但尚未写入硬盘的数据。MemStore中的数据在写入硬盘之前会先进行排序操作。每一个region中的每一个column family对应一个MemStore。 Hfiles:Hfiles存在于硬盘上,根据排序号的键存储数据行。 Region server的结构如下图所示: **HBase的写操作步骤 步骤一 当HBase的用户发出一个PUT请求时(也就是HBase的写请求),HBase进行处理的第一步是将数据写入HBase的write-ahead log(WAL)中。 WAL文件是顺序写入的,也就是所有新添加的数据都被加入WAL文件的末尾。WAL文件存在硬盘上。 当server出现问题之后,WAL可以被用来恢复尚未写入HBase中的数据(因为WAL是保存在硬盘上的)。 如下图所示: 步骤二 当数据被成功写入WAL后,HBase将数据存入MemStore。这时HBase就会通知用户PUT操作已经成功了。 过程如下图所示: HBase的MemStore Memstore存在于内存中,其中存储的是按键排好序的待写入硬盘的数据。数据也是按键排好序写入HFile中的。每一个Region中的每一个Column family对应一个Memstore文件。因此对数据的更新也是对应于每一个Column family。 如下图所示: HBase Region Flush 当MemStore中积累了足够多的数据之后,整个Memcache中的数据会被一次性写入到HDFS里的一个新的HFile中。因此HDFS中一个Column family可能对应多个HFile。这个HFile中包含了相应的cell,或者说键值的实例。这些文件随着MemStore中积累的对数据的操作被flush到硬盘上而创建。 需要注意的是,MemStore存储在内存中,这也是为什么HBase中Column family的数目有限制的原因。每一个Column family对应一个MemStore,当MemStore存满之后,里面所积累的数据就会一次性flush到硬盘上。同时,为了使HDFS能够知道当前哪些数据已经被存储了,MemStore中还保存最后一次写操作的序号。 每个HFile中最大的序号作为meta field存储在其中,这个序号标明了之前的数据向硬盘存储的终止点和接下来继续存储的开始点。当一个region启动的时候,它会读取每一个HFile中的序号来得知当前region中最新的操作序号是什么(最大的序号)。 如下图所示: HFile HBase中的键值数据对存储在HFile中。上面已经说过,当MemStore中积累足够多的数据的时候就会将其中的数据整个写入到HDFS中的一个新的HFile中。因为MemStore中的数据已经按照键排好序,所以这是一个顺序写的过程。由于顺序写操作避免了磁盘大量寻址的过程,所以这一操作非常高效。 如下图所示: HFile的结构 HFile中包含了一个多层索引系统。这个多层索引是的HBase可以在不读取整个文件的情况下查找数据。这一多层索引类似于一个B+树。 键值对根据键大小升序排列。 索引指向64KB大小的数据块。 每一个数据块还有其相应的叶索引(leaf-index)。 每一个数据块的最后一个键作为中间索引(intermediate index)。 根索引(root index)指向中间索引。 文件结尾指向meta block。因为meta block是在数据写入硬盘操作的结尾写入该文件中的。文件的结尾同时还包含一些别的信息。比如bloom filter及时间信息。Bloom filter可以帮助HBase加速数据查询的速度。因为HBase可以利用Bloom filter跳过不包含当前查询的键的文件。时间信息则可以帮助HBase在查询时跳过读操作所期望的时间区域之外的文件。 如下图所示: HFile的索引 HFile的索引在HFile被打开时会被读取到内存中。这样就可以保证数据检索只需一次硬盘查询操作。 如下图所示: HBase的读合并(Read Merge)以及读放大(Read amplification) 通过上面的论述,我们已经知道了HBase中对应于某一行数据的cell可能位于多个不同的文件或存储介质中。比如已经存入硬盘的行位于硬盘上的HFile中,新加入或更新的数据位于内存中的MemStore中,最近读取过的数据则位于内存中的Block cache中。所以当我们读取某一行的时候,为了返回相应的行数据,HBase需要根据Block cache,MemStore以及硬盘上的HFile中的数据进行所谓的读合并操作。 1.HBase会首先从Block cache(HBase的读缓存)中寻找所需的数据。 2.接下来,HBase会从MemStore中寻找数据。因为作为HBase的写缓存,MemStore中包含了最新版本的数据。 3.如果HBase从Block cache和MemStore中没有找到行所对应的cell所有的数据,系统会接着根据索引和bloom filter从相应的HFile中读取目标行的cell的数据。 如下图所示: 这里一个需要注意的地方是所谓的读放大效应(Read amplification)。根据前文所说,一个MemStore对应的数据可能存储于多个不同的HFile中(由于多次的flush),因此在进行读操作的时候,HBase可能需要读取多个HFile来获取想要的数据。这会影响HBase的性能表现。 如下图所示: HBase的Compaction Minor Compaction HBase会自动选取一些较小的HFile进行合并,并将结果写入几个较大的HFile中。这一过程称为Minor compaction。Minor compaction通过Merge sort的形式将较小的文件合并为较大的文件,从而减少了存储的HFile的数量,提升HBase的性能。 这一过程如下图所示: Major Compaction 所谓Major Compaction指的是HBase将对应于某一个Column family的所有HFile重新整理并合并为一个HFile,并在这一过程中删除已经删除或过期的cell,更新现有cell的值。这一操作大大提升读的效率。但是因为Major compaction需要重新整理所有的HFile并写入一个HFile,这一过程包含大量的硬盘I/O操作以及网络数据通信。这一过程也称为写放大(Write amplification)。在Major compaction进行的过程中,当前Region基本是处于不可访问的状态。 Major compaction可以配置在规定的时间自动运行。为避免影响业务,Major compaction一般安排在夜间或周末进行。 需要注意的一点事,Major compaction会将当前Region所服务的所有远程数据下载到本地Region server上。这些远程数据可能由于服务器故障或者负载均衡等原因而存储在于远端服务器上。 这一过程如下图所示: Region的分割(Region split) 首先我们快速复习一下Region: HBase中的表格可以根据行键水平分割为一个或几个region。每个region中包含了一段处于某一起始键值和终止键值之间的连续的行键。 每一个region的默认大小为1GB。 相应的Region server负责向客户提供访问某一region中的数据的服务。 每一个Region server能够管理大约1000个region(这些region可能来自同一个表格,也可能来自不同的表格)。 如下图所示: 每一个表格最初都对应于一个region。随着region中数据量的增加,region会被分割成两个子region。每一个子region中存储原来一半的数据。同时Region server会通知HMaster这一分割。出于负载均衡的原因,HMaster可能会将新产生的region分配给其他的Region server管理(这也就导致了Region server服务远端数据的情况的产生)。 如下图所示: 读操作的负载均衡(Read Load Balancing) Region的分割最初是在Region server本地发生的。但是出于负载均衡的原因,HMaster可能会将新产生的region分配给其他的Region server进行管理。这也就导致了Region server管理存储在远端服务器上的region情况的产生。这一情况会持续至下一次Major compaction之前。如上文所示,Major compaction会将任何不在本地的数据下载至本地。 也就是说,HBase中的数据在写入时总是存储在本地的。但是随着region的重新分配(由于负载均衡或数据恢复),数据相对于Region server不再一定是本地的。这种情况会在Major compaction后得到解决。 如下图所示: HDFS的数据备份(Data Replication) HDFS中所有的数据读写操作都是针对主节点进行的。HDFS会自动备份WAL和HFile。HBase以来HDFS来提供可靠的安全的数据存储。当数据被写入HDFS本地时,另外两份备份数据会分别存储在另外两台服务器上。 如下图所示: HBase的异常恢复(Crash Recovery) WAL文件和HFile都存储于硬盘上且存在备份,因此恢复它们是非常容易的。那么HBase如何恢复位于内存中的MemStore呢? 当Region server宕机的时候,其所管理的region在这一故障被发现并修复之前是不可访问的。ZooKeeper负责根据服务器的心跳信息来监控服务器的工作状态。当某一服务器下线之后,ZooKeeper会发送该服务器下线的通知。HMaster收到这一通知之后会进行恢复操作。 HMaster会首先将宕机的Region server所管理的region分配给其他仍在工作的活跃的Region server。然后HMaster会将该服务器的WAL分割并分别分配给相应的新分配的Region server进行存储。新的Region server会读取并顺序执行WAL中的数据操作,从而重新创建相应的MemStore。 如下图所示: 数据恢复(Data Recovery) WAL文件之中存储了一系列数据操作。每一个操作对应WAL中的一行。新的操作会顺序写在WAL文件的末尾。 那么当MemStore中存储的数据因为某种原因丢失之后应该如何恢复呢?HBase以来WAL对其进行恢复。相应的Region server会顺序读取WAL并执行其中的操作。这些数据被存入内存中当前的MemStore并排序。最终当MemStore存满之后,这些数据被flush到硬盘上。 需要更多大数据开发相关学习资料(Hadoop,spark,kafka,MapReduce,scala,,推荐算法,实时交易监控系统,用户分析行为,推荐系统)加裙免费获取:792133408 点击加入【大数据开发交流圈子】 如下图所示: Apache HBase的优缺点 优点 强一致性模型 当一个写操作得到确认时,所有的用户都将读到同一个值。 可靠的自动扩展 当region中的数据太多时会自动分割。 使用HDFS分布存储并备份数据。 内置的恢复功能 使用WAL进行数据恢复。 与Hadoop集成良好 MapReduce在HBase上非常直观。 缺点 WAL回复较慢。 异常恢复复杂且低效。 需要进行占用大量资源和大量I/O操作的Major compaction https://yq.aliyun.com/articles/601358?spm=a2c4e.11153987.0.0.1d67190akASwj0

优秀的个人博客,低调大师

深入理解Python字符串的用法

0. 拼接字符串 字符串的拼接操作最常用,我专门为这个话题写过一篇《Python拼接字符串的七种方式》,建议你回看。 在此,简单回顾一下:七种拼接方式从实现原理上划分为三类,即格式化类(%占位符、format()、template)、拼接类(+操作符、类元祖方式、join())与插值类(f-string),在使用上,我有如下建议—— 当要处理字符串列表等序列结构时,采用join()方式;拼接长度不超过20时,选用+号操作符方式;长度超过20的情况,高版本选用f-string,低版本时看情况使用format()或join()方式。 不敢说字符串就只有这七种拼接方式,但应该说它们是最常见的了。有小伙伴说,我写漏了一种,即字符串乘法,可以重复拼接自身。没错,从结果上看,这是第八种拼接方式,视为补充吧。 关于字符串拼接,还得补充一个建议,即在复杂场

优秀的个人博客,低调大师

阿里云基础产品基本理解————ECS SLB ESS

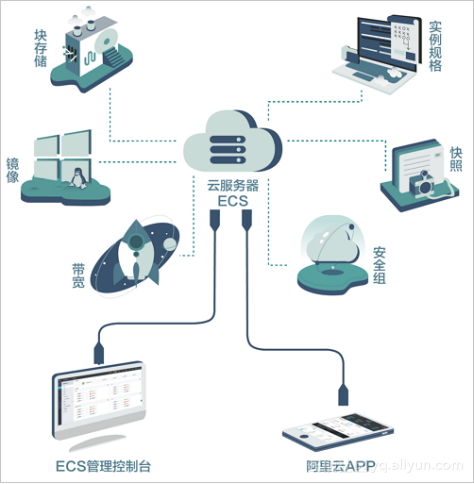
一.ECS # 组成 ECS涉及的所有资源,包括实例规格、块存储、镜像、快照、带宽和安全组。我们可以通过云服务器管理控制台或者阿里云 App及API配置自己的ECS资源。 创建ECS实例过程 **1.首先需要对应客户需求(应用场景)选取最合适的配置2.进行网络规划**(1)Vpc(专用的彻底隔离型的网络)是地域级别的,不能跨地域,但可以通过阿里云骨干网实现多个vpc间的互通。【多地域和多个系统隔离要用多个vpc互联】(2)交换机,一个vpc最好最少两个交换机,放在不同的可用区,实现跨区容灾。(进行优化做到高可用低延迟)(3)根据所需ip数选网段3.配置安全组相当与一个虚拟的防火墙,通过配置其出入ecs规则,来控制ecs出站入站的流量。在同一个vpc里,位于同一个安全组的ecs实例实现私网互通。默认同vpc不同交换机下实例可通过系统路由通信,可通过配置安全组规则进行隔离(私网隔离)。4.制定自动快照规则快照创建频率,保留时间,快照按存储量计费。5.镜像迁移将源系统盘镜像用迁云工具迁移到阿里云,再用文件同步的方式将数据盘数据同步到阿里云数据盘中。(迁云不支持迁移增量数据) ECS实例为什么需要公网和私网 【或者说ECS实例的公网和私网分别在什么样的服务中起到作用】 首先我们知道经典网络的 IP 地址是用户访问 ECS 实例以及 ECS 实例对外提供服务的主要方式。 目前经典网络 IP 地址由阿里云统一分配,分为公网 IP 和私网 IP。 私网 IP 每个实例会分配一块私网网卡,并绑定一个私网 IP。私网 IP 是必选的且无法修改。 如果自行在操作系统内变更私网IP会导致私网通讯中断。 同一地域内实例之间通过私网 IP 进行的通讯流量是免费的。 私网 IP 可以用于以下情况: (1)SLB 的负载均衡 (2)同一局域网内ECS 实例之间内网互访 (3)同一局域网内ECS 实例与其他云服务(如OSS、RDS)之间内网互访 公网 IP 默认情况下,每个实例也会分配一块公网网卡。与私网IP不同,公网 IP 是可选的。 如果在购买实例时选择了大于 0 MB 的公网带宽,实例创建时会被分配一个公网 IP。 公网流量是收费的。 公网 IP 可以用于以下情况: (1)ECS 实例与 Internet 之间互访 (2)不在同一局域网内的ECS 实例与云服务之间互访 二.SLB 什么是SLB 负载均衡(Server Load Balancer)是将访问流量根据转发策略分发到后端多台云服务器(ECS实例)的流量分发控制服务。 SLB通过设置虚拟服务地址(vip),将添加的ECS实例虚拟成一个高性能、高可用的应用服务池,并根据转发规则,将来自客户端的请求分发给云服务器池中的ECS实例。【只做转发,不做具体业务的处理】 SLB还自带健康检查机制,自动隔离异常状态的ECS实例,消除了单台ECS实例的单点故障,提高了应用的整体服务能力。此外,负载均衡还具备抗DDoS攻击的能力,增强了应用服务的防护能力。 组成部分 负载均衡由以下三个部分组成:负载均衡实例 (Server Load Balancer instances)一个负载均衡实例是一个运行的负载均衡服务,用来接收流量并将其分配给后端服务器。一个负载均衡实例最少对应一个监听两个后端服务器(ECS实例)监听 (Listeners)监听用来检查客户端请求并将请求转发给后端服务器。监听也会对后端服务器进行健康检查。后端服务器(Backend Servers)一组接收前端请求的ECS实例 基础架构 阿里云当前提供四层(TCP协议和UDP协议)和七层(HTTP和HTTPS协议)的负载均衡服务。(1)四层采用开源软件LVS(Linux Virtual Server)+ keepalived的方式实现负载均衡(2)七层采用Tengine实现负载均衡。Tengine是由淘宝网发起的Web服务器项目,它在Nginx的基础上,针对有大访问量的网站需求,添加了很多高级功能和特性。 三.ESS 阿里云弹性伸缩服务ESS(Elastic Scaling Service)是根据用户的业务需求和策略,自动调整其弹性计算资源的管理服务。其能够在业务增长时自动增加ECS实例,并在业务下降时自动减少ECS实例。 并提供健康检查机制,自动监控伸缩组内的ECS实例的健康状态,释放不健康的ECS实例后自动添加新的实例,并将其自动添加到负载均衡实例和RDS实例的访问白名单中。

优秀的个人博客,低调大师

一文深入理解 JNI实现机制

写在前面 说到JNI都不陌生,它的全称:Java Native Interface,即Java本地接口。 JNI不仅仅是Android特有的,它是属于Java平台的,它允许在Java虚拟机内运行的java代码与其他编程语言(如c, c++和汇编语言)编写的程序和库进行交互。 JNI调用姿势:Java —> JNI —> C/C++(SO库) 在Android平台中,使用JNI封装了跟硬件相关的操作,从而可以通过Java调用相关JNI模块,以达到对硬件的调用。 下面我们将围绕如下内容进行展开: 1.java代码编译和执行过程 2.jni常规使用姿势 3.so加载流程(jni执行流程、注册方式原理) 4.JNIEnv作用及实现 Java代码编译和执行过程 java代码编译和执行的过程涉及到两个命令:javac和java 1.首先通过javac编译java代码,生成class字节码文件 2.javacTestCode.java --> TestCode.class 3.然后通过java命令来执行class字节码 4.javaTestCode.class java命令执行过程中,会先启动虚拟机,加载TestCode类信息到内存,然后由执行引擎执行其main方法。 JVM的逻辑内存模型如下: JNI常规使用姿势 在java层通过native关键字创建本地方法,如下:(成员方法、static方法) public class JNIMethods { static { System.loadLibrary("test-jni"); } //隐式注册 public native String stringFromJNI(); public static native String testParams(int jint, String jstring, Object jobject, Object[] arrayObject, Listlist); //显式注册 public native String stringFromJNIDis(); public static native String testParamsDis(int jint, String jstring, Object jobject, Object[] arrayObject, Listlist); } 创建c层代码,并注册本地方法 #include #include #include "common.h" jstring stringFromJNIDis(JNIEnv *env, jobject jobj); jstring testParamsDis(JNIEnv *env, jclass type, jint jint_, jstring jstring_, jobject jobject_, jobjectArray objectArray, jobject list); static jmethodID methodID_toString; //显式注册 static JNINativeMethod gMethods[] = { {"stringFromJNIDis", "()Ljava/lang/String;", (void *) stringFromJNIDis}, {"testParamsDis", "(ILjava/lang/String;Ljava/lang/Object;[Ljava/lang/Object;Ljava/util/List;)Ljava/lang/String;", (void *) testParamsDis} }; static int registerNativeMethods(JNIEnv *env, const char *className, JNINativeMethod *methods, int nMethods) { jclass clazz; clazz = env->FindClass(className); if (clazz == NULL) { return JNI_FALSE; } if (env->RegisterNatives(clazz, methods, nMethods) < 0) { return JNI_FALSE; } return JNI_TRUE; } void appendString(JNIEnv *env, char *dest, jstring tmpStr) { if (tmpStr == NULL) { return; } const char *tmpString = env->GetStringUTFChars(tmpStr, 0); strcat(dest, tmpString); env->ReleaseStringUTFChars(tmpStr, tmpString); } //加载so时会执行该方法 JNIEXPORT jint JNICALL JNI_OnLoad(JavaVM *vm, void *reserved) { LOGD("test-jni.cpp JNI_OnLoad"); JNIEnv *env = NULL; if (vm->GetEnv((void **) &env, JNI_VERSION_1_4) != JNI_OK) { return -1; } if (NULL == env) { return -1; } jclass clazz = env->FindClass("java/lang/Object"); methodID_toString = env->GetMethodID(clazz, "toString", "()Ljava/lang/String;"); //显式注册本地方法 if (!registerNativeMethods(env, "com/mob/test/jni/testjni/JNIMethods", gMethods, NELEM(gMethods))) { LOGE("test-jni.cpp JNI_OnLoad register JNIMethods failed"); } return JNI_VERSION_1_4; } //卸载时会执行该方法 JNIEXPORT void JNI_OnUnload(JavaVM *vm, void *reserved) { LOGD("test-jni.cpp JNI_OnUnload"); methodID_toString = NULL; } //隐式注册 extern "C" JNIEXPORT jstring JNICALL Java_com_mob_test_jni_testjni_JNIMethods_stringFromJNI(JNIEnv *env, jobject jobj) { LOGD("test-jni.cpp Java_com_mob_test_jni_testjni_JNIMethods_stringFromJNI"); return stringFromJNIDis(env, jobj); } extern "C" JNIEXPORT jstring JNICALL Java_com_mob_test_jni_testjni_JNIMethods_testParams(JNIEnv *env, jclass type, jint jint_, jstring jstring_, jobject jobject_, jobjectArray arrayObject, jobject list) { LOGD("test-jni.cpp Java_com_mob_test_jni_testjni_JNIMethods_testParams"); return testParamsDis(env, type, jint_, jstring_, jobject_, arrayObject, list); } //显式注册 jstring stringFromJNIDis(JNIEnv *env, jobject jobj) { LOGD("test-jni.cpp stringFromJNIDis"); std::string hello = "Hello from C++"; return env->NewStringUTF(hello.c_str()); } jstring testParamsDis(JNIEnv *env, jclass type, jint jint_, jstring jstring_, jobject jobject_, jobjectArray arrayObject, jobject list) { LOGD("test-jni.cpp testParamsDis"); char returnValue[1024]; int i = jint_; sprintf(returnValue, "%d", i); appendString(env, returnValue, jstring_); jstring returnToString = reinterpret_cast<_jstring *>(env->CallObjectMethod(jobject_, methodID_toString)); appendString(env, returnValue, returnToString); jsize len = env->GetArrayLength(arrayObject); jobject tmpObject; jstring tmpString; for (i = 0; i < len; i++) { tmpObject = env->GetObjectArrayElement(arrayObject, i); tmpString = reinterpret_cast<_jstring *>(env->CallObjectMethod(tmpObject, methodID_toString)); appendString(env, returnValue, tmpString); } env->DeleteLocalRef(tmpObject); jclass clazz_list = env->GetObjectClass(list); jmethodID list_get = env->GetMethodID(clazz_list, "get", "(I)Ljava/lang/Object;"); jmethodID list_size = env->GetMethodID(clazz_list, "size", "()I"); int size = env->CallIntMethod(list, list_size); jstring itemStr; for (i = 0; i < size; i++) { itemStr = reinterpret_cast(env->CallObjectMethod(list, list_get, i)); appendString(env, returnValue, itemStr); } return env->NewStringUTF(returnValue); } 在gradle中配置cmake编译选项,并编写CMakeLists.txt脚本,用于生成so android { externalNativeBuild { cmake { path "CMakeLists.txt" } } } #CMakeList.txt 内容如下: # Sets the minimum version of CMake required to build the native library. cmake_minimum_required(VERSION 3.4.1) set(distribution_DIR ${CMAKE_SOURCE_DIR}/src/main/cpp) add_library( # Sets the name of the library. test-jni # Sets the library as a shared library. SHARED # Provides a relative path to your source file(s). src/main/cpp/test-jni.cpp) find_library( # Sets the name of the path variable. test # Specifies the name of the NDK library that # you want CMake to locate. log) target_link_libraries( # Specifies the target library. test-jni # Links the target library to the log library # included in the NDK. ${log-lib} ) 在java层,加载本地方法前,加载so public class JNIMethods { static { //加载so System.loadLibrary("test-jni"); } //隐式注册 public native String stringFromJNI(); public static native String testParams(int jint, String jstring, Object jobject, Object[] arrayObject, Listlist); //显式注册 public native String stringFromJNIDis(); public static native String testParamsDis(int jint, String jstring, Object jobject, Object[] arrayObject, Listlist); } so加载流程 一般我们是通过 System.loadLibrary("test-jni") 的方式来加载libtest-jni.so库的,一起来跟踪下整个加载过程(此处分析的源码是基于Dalvik的) System.loadLibrary() -> Runtime.loadLibray0() -> Runtime.doLoad() -> Runtime.nativeLoad() //java.lang.System public static void loadLibrary(String libname) { Runtime.getRuntime().loadLibrary0(VMStack.getCallingClassLoader(), libname); } //java.lang.Runtime synchronized void loadLibrary0(ClassLoader loader, String libname) { //...... String error = doLoad(filename, loader); //...... } private String doLoad(String name, ClassLoader loader) { //...... synchronized (this) { return nativeLoad(name, loader, librarySearchPath); } } // TODO: should be synchronized, but dalvik doesn't support synchronized internal natives. private static native String nativeLoad(String filename, ClassLoader loader, String librarySearchPath); 在代码中我们并没有看到相关加载nativeLoad这个本地方法的so,那么它又是用什么方式在什么时候被注册的呢? 很多系统的本地方法都是在应用启动的时候通过显示注册的方式被注册的,下面我们来看下系统启动后会做哪些事情。 启动虚拟机进程app_process首先会执行app_main.cpp中的main方法 /frameworks/base/cmds/app_process/app_main.cpp main() -> AndroidRuntime.start() int main(int argc, char* const argv[]) { //...... if (zygote) { runtime.start("com.android.internal.os.ZygoteInit", startSystemServer ? "start-system-server" : ""); } else if (className) { // Remainder of args get passed to startup class main() runtime.mClassName = className; runtime.mArgC = argc - i; runtime.mArgV = argv + i; runtime.start("com.android.internal.os.RuntimeInit", application ? "application" : "tool"); } //...... } /frameworks/base/core/jni/AndroidRuntime.cpp start()->startVm() void AndroidRuntime::start(const char* className, const char* options) { //...... /* start the virtual machine */ JniInvocation jni_invocation; jni_invocation.Init(NULL); JNIEnv* env; if (startVm(&mJavaVM, &env) != 0) {//启动vm return; } } int AndroidRuntime::startVm(JavaVM** pJavaVM, JNIEnv** pEnv) { //...... if (JNI_CreateJavaVM(pJavaVM, pEnv, &initArgs) < 0) {//创建vm ALOGE("JNI_CreateJavaVM failed\n"); goto bail; } //...... } JNI_CreateJavaVM()在art和dalvik中都有相关实现,这里仅以dalvik为主线跟踪,art的实现在/art/runtime/jni_internal.cc中 /dalvik/vm/Jni.cpp JNI_CreateJavaVM() -> Init.dvmStartUp() jint JNI_CreateJavaVM(JavaVM** p_vm, JNIEnv** p_env, void* vm_args) { //...... JNIEnvExt* pEnv = (JNIEnvExt*) dvmCreateJNIEnv(NULL); /* Initialize VM. */ gDvm.initializing = true; std::string status = dvmStartup(argc, argv.get(), args->ignoreUnrecognized, (JNIEnv*)pEnv);//初始化vm //...... } /dalvik/vm/Init.cpp dvmStartUp()-> InternalNative.dvmInternalNativeStartup() dvmStartUp()-> registerSystemNatives() -> jni.RegisterNatives() std::string dvmStartup(int argc, const char* const argv[], bool ignoreUnrecognized, JNIEnv* pEnv) { //...... if (!dvmNativeStartup()) {//初始化native return "dvmNativeStartup failed"; } if (!dvmInternalNativeStartup()) {//初始化内部native return "dvmInternalNativeStartup failed"; } if (!dvmJniStartup()) {//初始化jni return "dvmJniStartup failed"; } //...... if (!registerSystemNatives(pEnv)) {//注册系统本地方法 return "couldn't register system natives"; } //...... return ""; } static bool registerSystemNatives(JNIEnv* pEnv) { //...... JNIEXPORT jobject JNICALL Java_java_lang_Class_getDex(JNIEnv* env, jclass javaClass); const JNINativeMethod Java_java_lang_Class[] = { { "getDex", "()Lcom/android/dex/Dex;", (void*) Java_java_lang_Class_getDex }, }; //注册Dex的getDex方法 if (pEnv->RegisterNatives(c, Java_java_lang_Class, 1) != JNI_OK) { dvmAbort(); } //加载javacore和nativehelper库 loadJniLibrary("javacore"); loadJniLibrary("nativehelper"); // Back to run mode. self->status = THREAD_RUNNING; return true; } /dalvik/vm/native/InternalNative.cpp dvmInternalNativeStartup() bool dvmInternalNativeStartup() { DalvikNativeClass* classPtr = gDvmNativeMethodSet;//遍历系统类结构体,并保存到gDvm的全局变量userDexFiles中 while (classPtr->classDescriptor != NULL) { classPtr->classDescriptorHash = dvmComputeUtf8Hash(classPtr->classDescriptor); classPtr++; } gDvm.userDexFiles = dvmHashTableCreate(2, dvmFreeDexOrJar); if (gDvm.userDexFiles == NULL) return false; return true; } //系统本地方法都存在这里 static DalvikNativeClass gDvmNativeMethodSet[] = { { "Ljava/lang/Object;", dvm_java_lang_Object, 0 }, { "Ljava/lang/Class;", dvm_java_lang_Class, 0 }, //…… { "Ljava/lang/Runtime;", dvm_java_lang_Runtime, 0 }, { "Ljava/lang/String;", dvm_java_lang_String, 0 }, { "Ljava/lang/System;", dvm_java_lang_System, 0 }, //…… { "Ldalvik/system/DexFile;", dvm_dalvik_system_DexFile, 0 }, { "Ldalvik/system/VMRuntime;", dvm_dalvik_system_VMRuntime, 0 }, //…… }; //调用本地方法会到这里来寻找系统本地方 DalvikNativeFunc dvmLookupInternalNativeMethod(const Method* method) { const char* classDescriptor = method->clazz->descriptor; const DalvikNativeClass* pClass; u4 hash; hash = dvmComputeUtf8Hash(classDescriptor); pClass = gDvmNativeMethodSet;//遍历全局本地方法集合,寻找注册的系统本地方法 while (true) { if (pClass->classDescriptor == NULL) break; if (pClass->classDescriptorHash == hash && strcmp(pClass->classDescriptor, classDescriptor) == 0) { const DalvikNativeMethod* pMeth = pClass->methodInfo; while (true) { if (pMeth->name == NULL) break; if (dvmCompareNameDescriptorAndMethod(pMeth->name, pMeth->signature, method) == 0) { /* match */ return pMeth->fnPtr; } pMeth++; } } pClass++; } return NULL; } 注册本地方法 /dalvik/vm/Jni.cpp RegisterNatives()-> dvmRegisterJNIMethod()-> dvmUseJniBridge() -> Class.dvmSetNativeFunc() static jint RegisterNatives(JNIEnv* env, jclass jclazz, const JNINativeMethod* methods, jint nMethods) { //...... for (int i = 0; i < nMethods; i++) { if (!dvmRegisterJNIMethod(clazz, methods[i].name, methods[i].signature, methods[i].fnPtr)) { return JNI_ERR; } } return JNI_OK; } static bool dvmRegisterJNIMethod(ClassObject* clazz, const char* methodName, const char* signature, void* fnPtr) { //...... if (method->nativeFunc != dvmResolveNativeMethod) { /* this is allowed, but unusual */ ALOGV("Note: %s.%s:%s was already registered", clazz->descriptor, methodName, signature); } method->fastJni = fastJni; dvmUseJNIBridge(method, fnPtr); ALOGV("JNI-registered %s.%s:%s", clazz->descriptor, methodName, signature); return true; } void dvmUseJNIBridge(Method* method, void* func) { //…… DalvikBridgeFunc bridge = gDvmJni.useCheckJni ? dvmCheckCallJNIMethod : dvmCallJNIMethod; dvmSetNativeFunc(method, bridge, (const u2*) func);//将nativeFunc指向dvmCallJNIMethod,并将insns指向func } void dvmCallJNIMethod(const u4* args, JValue* pResult, const Method* method, Thread* self) { //...... JNIEnv* env = self->jniEnv; COMPUTE_STACK_SUM(self); dvmPlatformInvoke(env, (ClassObject*) staticMethodClass, method->jniArgInfo, method->insSize, modArgs, method->shorty, (void*) method->insns, pResult);//调用方法insns,对于不同的cpu架构会有不同的调用方式 //...... } /dalvik/vm/oo/Class.cpp dvmSetNativeFunc() void dvmSetNativeFunc(Method* method, DalvikBridgeFunc func, const u2* insns) { //...... //将nativeFunc指向dvmCallJNIMethod,并将insns指向func if (insns != NULL) { /* update both, ensuring that "insns" is observed first */ method->insns = insns; android_atomic_release_store((int32_t) func, (volatile int32_t*)(void*) &method->nativeFunc); } else { /* only update nativeFunc */ method->nativeFunc = func; } //...... } 至此,我们可以知道调用JNI方法最终会通过 Jni.dvmCallJNIMethod() -> dvmPlatformInvoke() 来根据不同cpu架构实现进行调用。 Class被加载的过程 Android中ClassLoader都是继承自BaseDexClassLoader,加载dex是通过BaseDexClassLoader来加载的,会将dex中的信息都保存到DexPathList中,后面加载类的过程如下: BaseDexClassLoader.findClass() -> DexPathList.findClass() -> 遍历dexElements -> DexFile.loadClassBinaryName() -> DexFile.defineClass() -> DexFile.defineClassNative() /dalvik/vm/native/dalvik_system_DexFile.cpp defineClassNative()-> Class.dvmDefineClass() const DalvikNativeMethod dvm_dalvik_system_DexFile[] = { //…… { "defineClassNative", "(Ljava/lang/String;Ljava/lang/ClassLoader;I)Ljava/lang/Class;", Dalvik_dalvik_system_DexFile_defineClassNative }, { "getClassNameList", "(I)[Ljava/lang/String;", Dalvik_dalvik_system_DexFile_getClassNameList }, //…… }; static void Dalvik_dalvik_system_DexFile_defineClassNative(const u4* args, JValue* pResult) { //...... clazz = dvmDefineClass(pDvmDex, descriptor, loader); Thread* self = dvmThreadSelf(); //...... } /dalvik/vm/oo/Class.cpp dvmDefineClass() -> findClassNoInit() -> dvmLookupClass() -> loadClassFromDex() -> loadClassFromDex0() -> loadMethodFromDex() -> dvmResolveNativeMethod() ClassObject* dvmDefineClass(DvmDex* pDvmDex, const char* descriptor, Object* classLoader) { assert(pDvmDex != NULL); return findClassNoInit(descriptor, classLoader, pDvmDex); } static ClassObject* findClassNoInit(const char* descriptor, Object* loader, DvmDex* pDvmDex) { Thread* self = dvmThreadSelf(); ClassObject* clazz; //...... clazz = dvmLookupClass(descriptor, loader, true);//从gDvm全局变量的loadedClasses中找 if (clazz == NULL) { clazz = loadClassFromDex(pDvmDex, pClassDef, loader);//没找到,则从dex中找 } //...... return clazz; } static ClassObject* loadClassFromDex(DvmDex* pDvmDex, const DexClassDef* pClassDef, Object* classLoader) { ClassObject* result; //...... result = loadClassFromDex0(pDvmDex, pClassDef, &header, pEncodedData, classLoader); //...... return result; } static ClassObject* loadClassFromDex0(DvmDex* pDvmDex, const DexClassDef* pClassDef, const DexClassDataHeader* pHeader, const u1* pEncodedData, Object* classLoader) { ClassObject* newClass = NULL; //...... loadIFieldFromDex(newClass, &field, &newClass->ifields[i]);//遍历加载成员变量 //...... loadMethodFromDex(newClass, &method, &newClass->directMethods[i]);//遍历加载方法 //...... newClass->sourceFile = dexGetSourceFile(pDexFile, pClassDef); return newClass; } static void loadMethodFromDex(ClassObject* clazz, const DexMethod* pDexMethod, Method* meth) { //...... if (dvmIsNativeMethod(meth)) {//如果是本地方法,会将nativeFunc指向dvmResolveNativeMethod,当执行本地方法时就会执行dvmResolveNativeMethod方法 meth->nativeFunc = dvmResolveNativeMethod; meth->jniArgInfo = computeJniArgInfo(&meth->prototype); } //...... } 上面跟踪下来我们知道每个dex中的本地方法都会执行到 dvmResolveNativeMethod(),我们来看看该方法做了哪些事情? /dalvik/vm/Native.cpp dvmResolveNativeMethod() -> InternalNative.dvmLookupInternalNativeMethod() dvmResolveNativeMethod() -> lookupSharedLibMethod() -> findMethodInLib() void dvmResolveNativeMethod(const u4* args, JValue* pResult, const Method* method, Thread* self) { //…… /* start with our internal-native methods */ DalvikNativeFunc infunc = dvmLookupInternalNativeMethod(method);//寻找系统内部本地方法 if (infunc != NULL) { //…… DalvikBridgeFunc dfunc = (DalvikBridgeFunc) infunc; dvmSetNativeFunc((Method*) method, dfunc, NULL); dfunc(args, pResult, method, self);//执行 return; } /* now scan any DLLs we have loaded for JNI signatures */ void* func = lookupSharedLibMethod(method);//在动态加载的so中寻找本地方法 if (func != NULL) { /* found it, point it at the JNI bridge and then call it */ dvmUseJNIBridge((Method*) method, func); (*method->nativeFunc)(args, pResult, method, self);//执行nativeFunc return; } //…… dvmThrowUnsatisfiedLinkError("Native method not found", method);//没找到本地方法,则会报UnsatisfiedLinkError } static void* lookupSharedLibMethod(const Method* method) { if (gDvm.nativeLibs == NULL) { ALOGE("Unexpected init state: nativeLibs not ready"); dvmAbort(); } return (void*) dvmHashForeach(gDvm.nativeLibs, findMethodInLib, (void*) method);//先从gDvm全局变量nativeLibs中寻找,没找到,则通过findMethodInLib在so中寻找,找到则保存到nativeLibs中 } static int findMethodInLib(void* vlib, void* vmethod) { const SharedLib* pLib = (const SharedLib*) vlib; const Method* meth = (const Method*) vmethod; //...... /* * First, we try it without the signature. */ preMangleCM = createJniNameString(meth->clazz->descriptor, meth->name, &len); if (preMangleCM == NULL) goto bail; mangleCM = mangleString(preMangleCM, len); if (mangleCM == NULL) goto bail; //通过createJniNameString和mangleString,得到最终函数的名称路径Java_package_methodName ALOGV("+++ calling dlsym(%s)", mangleCM); func = dlsym(pLib->handle, mangleCM);//根据动态链接库操作句柄与符号,返回符号对应的地址 //...... return (int) func; } 系统内部本地方法通过 dvmLookupInternalNativeMethod()方法来寻找具体实现的 通过System.loadLibrary加载的本地方法,则是通过 lookupSharedLibMethod()方法来寻找的 (方法名称格式:Java_package_methodName) /dalvik/vm/native/InternalNative.cpp dvmLookupInternalNativeMethod() -> java_lang_runtime.Dalvik_java_lang_Runtime_nativeLoad() DalvikNativeFunc dvmLookupInternalNativeMethod(const Method* method) { const char* classDescriptor = method->clazz->descriptor; const DalvikNativeClass* pClass; u4 hash; hash = dvmComputeUtf8Hash(classDescriptor); pClass = gDvmNativeMethodSet;//遍历全局本地方法集合,寻找内部注册的本地方法 while (true) { if (pClass->classDescriptor == NULL) break; if (pClass->classDescriptorHash == hash && strcmp(pClass->classDescriptor, classDescriptor) == 0) { const DalvikNativeMethod* pMeth = pClass->methodInfo; while (true) { if (pMeth->name == NULL) break; if (dvmCompareNameDescriptorAndMethod(pMeth->name, pMeth->signature, method) == 0) { /* match */ //ALOGV("+++ match on %s.%s %s at %p", // className, methodName, methodSignature, pMeth->fnPtr); return pMeth->fnPtr; } pMeth++; } } pClass++; } return NULL; } static DalvikNativeClass gDvmNativeMethodSet[] = { { "Ljava/lang/Object;", dvm_java_lang_Object, 0 }, { "Ljava/lang/Class;", dvm_java_lang_Class, 0 }, //…… { "Ljava/lang/Runtime;", dvm_java_lang_Runtime, 0 }, { "Ljava/lang/String;", dvm_java_lang_String, 0 }, { "Ljava/lang/System;", dvm_java_lang_System, 0 }, { "Ljava/lang/Throwable;", dvm_java_lang_Throwable, 0 }, { "Ljava/lang/VMClassLoader;", dvm_java_lang_VMClassLoader, 0 }, { "Ljava/lang/VMThread;", dvm_java_lang_VMThread, 0 }, //…… { "Ldalvik/system/DexFile;", dvm_dalvik_system_DexFile, 0 }, { "Ldalvik/system/VMRuntime;", dvm_dalvik_system_VMRuntime, 0 }, //…… }; /dalvik/vm/native/java_lang_runtime.cpp java_lang_runtime.Dalvik_java_lang_Runtime_nativeLoad() -> Native.dvmLoadNativeCode() const DalvikNativeMethod dvm_java_lang_Runtime[] = { //…… { "nativeExit", "(I)V", Dalvik_java_lang_Runtime_nativeExit }, { "nativeLoad", "(Ljava/lang/String;Ljava/lang/ClassLoader;Ljava/lang/String;)Ljava/lang/String;", Dalvik_java_lang_Runtime_nativeLoad }, //…… }; static void Dalvik_java_lang_Runtime_nativeLoad(const u4* args, JValue* pResult) { //...... bool success = dvmLoadNativeCode(fileName, classLoader, &reason); //...... } /dalvik/vm/Native.cpp dvmLoadNativeCode() -> JNI_OnLoad() bool dvmLoadNativeCode(const char* pathName, Object* classLoader, char** detail) { SharedLib* pEntry; //...... pEntry = findSharedLibEntry(pathName);//so被加载过一次之后,就会缓存起来 if (pEntry != NULL) { //...... return true; } //…… //so第一次被加载 handle = dlopen(pathName, RTLD_LAZY);//打开so动态链接库,保存句柄到handle //...... /* create a new entry */ SharedLib* pNewEntry; pNewEntry = (SharedLib*) calloc(1, sizeof(SharedLib)); pNewEntry->pathName = strdup(pathName); pNewEntry->handle = handle;//保存handle到pNewEntry //…… SharedLib* pActualEntry = addSharedLibEntry(pNewEntry);//将pNewEntry保存到gDvm全局变量nativeLibs中,下次可以直接通过缓存获取 //...... vonLoad = dlsym(handle, "JNI_OnLoad");//第一次加载so时,调用so中的JNI_OnLoad方法 //...... return result; } } 上面分析总结: 通过System.loadLibrary()加载的库会被保存到全局变量gDvm.nativeLibs中,并执行其JNI_OnLoad方法。 JNI显式注册是直接将本地方法调用地址指向到c层某方法,并将执行方法改成dvmCallJNIMethod(),隐式是通过方法命名规则去寻找方法的调用地址,然后通过dvmCallJNIMethod()来执行类被加载时,所有的本地方法执行地址nativeFunc都被指向了Native.dvmResolveNativeMethod() 通过JNI显式注册会将本地方法调用地址执行C能某实现方法,并将执行地址nativeFunc指向dvmCallJNIMethod(),隐式注册则是在调用的时候才会通过命名规则去寻找方法的调用地址,寻找到之后,再将执行地址nativeFunc指向dvmCallJNIMethod() 所以执行native方法时,nativeFunc未被指向到dvmCallJNIMethod()的方法(包括第一次执行的隐式注册方法和未被注册的系统方法)都会通过 Native.dvmResolveNativeMethod()来处理,针对系统本地方法,会从 InternalNative.gDvmNativeMethodSet 中寻找;针对应用本地方法,则从 gDvm.nativeLibs 中寻找。 当第二次执行同一个方法时,则会直接执行dvmCallJNIMethod(),所以隐式注册相对显示注册来说,第一次调用的时候会慢一点,但是初始化快。 Jni.dvmCallJNIMethod()执行本地方法,是通过调用dvmPlatformInvoke() 来根据不同cpu架构实现方式来执行的。 so加载核心过程: class中本地方法加载过程: 本地方法调用过程: JNIEnv作用及实现 JNIEnv是JNI指针接口,通常我们通过它来调用操作Java对象,它提供了所有的操作java对象的api。 那么JNIEnv又是何时创建,以及如何来操作Java对象的呢?我们一起来看看它的具体实现~ 首先我们来看下线程时如何被创建的: java/lang/Thread.java new Thread().start() -> VMThread.create() public synchronized void start() { checkNotStarted(); hasBeenStarted = true; VMThread.create(this, stackSize);// VMThread创建 } /dalvik/vm/native/java_lang_VMThread.cpp Dalvik_java_lang_VMThread_create() -> Thread.dvmCreateInterpThread() const DalvikNativeMethod dvm_java_lang_VMThread[] = { { "create", "(Ljava/lang/Thread;J)V", Dalvik_java_lang_VMThread_create },//线程创建方法 { "currentThread", "()Ljava/lang/Thread;", Dalvik_java_lang_VMThread_currentThread }, //…… }; static void Dalvik_java_lang_VMThread_create(const u4* args, JValue* pResult) { //…… dvmCreateInterpThread(threadObj, (int) stackSize);//创建线程 RETURN_VOID(); } /dalvik/vm/Thread.cpp dvmCreateInterpThread() -> interpThreadStart() -> jni.dvmCreateJNIEnv() bool dvmCreateInterpThread(Object* threadObj, int reqStackSize) { //...... Thread* newThread = allocThread(stackSize); //...... int cc = pthread_create(&threadHandle, &threadAttr, interpThreadStart, newThread);//创建线程 // ...... } /* * pthread entry function for threads started from interpreted code. */ static void* interpThreadStart(void* arg) { //...... self->jniEnv = dvmCreateJNIEnv(self);//创建jniEnv //...... return NULL; } JNIEnv的创建 /dalvik/vm/jni.cpp dvmCreateJNIEnv() JNIEnv* dvmCreateJNIEnv(Thread* self) { JavaVMExt* vm = (JavaVMExt*) gDvmJni.jniVm; //…… newEnv->funcTable = &gNativeInterface;//接口函数 //...... return (JNIEnv*) newEnv; } static const struct JNINativeInterface gNativeInterface = { DefineClass, FindClass, //...... CallVoidMethod, //... GetFieldID, GetObjectField, //... CallStaticIntMethod, //...... }; //方法具体实现(下面是callVoidMethodA()具体实现) #define CALL_VIRTUAL(_ctype, _jname, _retfail, _retok, _isref) \ static _ctype Call##_jname##Method(JNIEnv* env, jobject jobj, \ jmethodID methodID, ...) \ { \ ScopedJniThreadState ts(env); \ Object* obj = dvmDecodeIndirectRef(ts.self(), jobj); \ const Method* meth; \ va_list args; \ JValue result; \ meth = dvmGetVirtualizedMethod(obj->clazz, (Method*)methodID); \ if (meth == NULL) { \ return _retfail; \ } \ va_start(args, methodID); \ dvmCallMethodV(ts.self(), meth, obj, true, &result, args);//方法调用 \ va_end(args); \ if (_isref && !dvmCheckException(ts.self())) \ result.l = (Object*)addLocalReference(ts.self(), result.l); \ return _retok; \ } \ CALL_VIRTUAL(jobject, Object, NULL, (jobject) result.l, true); //...... /dalvik/vm/interp/Stack.cpp JNIEnv.CallVoidMethodA() -> Stack.dvmCallMethodA() void dvmCallMethodA(Thread* self, const Method* method, Object* obj, bool fromJni, JValue* pResult, const jvalue* args) { //...... if (dvmIsNativeMethod(method)) { TRACE_METHOD_ENTER(self, method); (*method->nativeFunc)((u4*)self->interpSave.curFrame, pResult, method, self);//执行方法 TRACE_METHOD_EXIT(self, method); } //…… } JNIEnv是在Thread创建的时候创建的,因此它是属于线程的,不能线程共享。最终调用方法时通过Stack.dvmCallMethod..相关方法去调用的。至此整个流程就分析完毕了。 结语 通过上面的分析,我们知道了JNI是如何在java和本地代码之间建立桥梁和通讯的。 在使用JNI的时候,需要注意: 1.显式注册和隐式注册的区别 2.JNI_Onload方法的使用 3.JNIEnv的使用 4.JNI方法的命名,以及extern “C"的作用(告诉编译器,这部分代码请使用C来编译)等等 原文发布时间为:2018-11-2 本文作者:MobSDK 本文来自云栖社区合作伙伴“安卓巴士Android开发者门户”,了解相关信息可以关注“安卓巴士Android开发者门户”。

优秀的个人博客,低调大师

简单易懂的 Go 内存分配原理解读

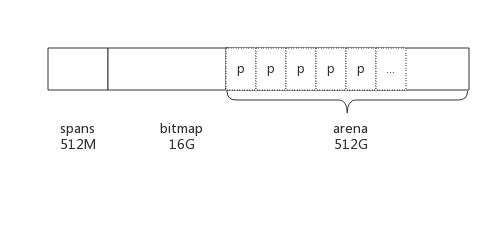
1. 前言 编写过C语言程序的肯定知道通过malloc()方法动态申请内存,其中内存分配器使用的是glibc提供的ptmalloc2。 除了glibc,业界比较出名的内存分配器有Google的tcmalloc和Facebook的jemalloc。二者在避免内存碎片和性能上均比glic有比较大的优势,在多线程环境中效果更明显。 Golang中也实现了内存分配器,原理与tcmalloc类似,简单的说就是维护一块大的全局内存,每个线程(Golang中为P)维护一块小的私有内存,私有内存不足再从全局申请。 另外,内存分配与GC(垃圾回收)关系密切,所以了解GC前有必要了解内存分配的原理。 2. 基础概念 为了方便自主管理内存,做法便是先向系统申请一块内存,然后将内存切割成小块,通过一定的内存分配算法管理内存。 以64位系统为例,Golang程序启动时会向系统申请的内存如下图所示: 预申请的内存划分为spans、bitmap、arena三部分。其中arena即为所谓的堆区,应用中需要的内存从这里分配。其中spans和bitmap是为了管理arena区而存在的。 arena的大小为512G,为了方便管理把arena区域划分成一个个的page,每个page为8KB,一共有512GB/8KB个页; spans区域存放span的指针,每个指针对应一个page,所以span区域的大小为(512GB/8KB)*指针大小8byte = 512M bitmap区域大小也是通过arena计算出来,不过主要用于GC。 2.1 span span是用于管理arena页的关键数据结构,每个span中包含1个或多个连续页,为了满足小对象分配,span中的一页会划分更小的粒度,而对于大对象比如超过页大小,则通过多页实现。 2.1.1 class 跟据对象大小,划分了一系列class,每个class都代表一个固定大小的对象,以及每个span的大小。如下表所示: // class bytes/obj bytes/span objects waste bytes // 1 8 8192 1024 0 // 2 16 8192 512 0 // 3 32 8192 256 0 // 4 48 8192 170 32 // 5 64 8192 128 0 // 6 80 8192 102 32 // 7 96 8192 85 32 // 8 112 8192 73 16 // 9 128 8192 64 0 // 10 144 8192 56 128 // 11 160 8192 51 32 // 12 176 8192 46 96 // 13 192 8192 42 128 // 14 208 8192 39 80 // 15 224 8192 36 128 // 16 240 8192 34 32 // 17 256 8192 32 0 // 18 288 8192 28 128 // 19 320 8192 25 192 // 20 352 8192 23 96 // 21 384 8192 21 128 // 22 416 8192 19 288 // 23 448 8192 18 128 // 24 480 8192 17 32 // 25 512 8192 16 0 // 26 576 8192 14 128 // 27 640 8192 12 512 // 28 704 8192 11 448 // 29 768 8192 10 512 // 30 896 8192 9 128 // 31 1024 8192 8 0 // 32 1152 8192 7 128 // 33 1280 8192 6 512 // 34 1408 16384 11 896 // 35 1536 8192 5 512 // 36 1792 16384 9 256 // 37 2048 8192 4 0 // 38 2304 16384 7 256 // 39 2688 8192 3 128 // 40 3072 24576 8 0 // 41 3200 16384 5 384 // 42 3456 24576 7 384 // 43 4096 8192 2 0 // 44 4864 24576 5 256 // 45 5376 16384 3 256 // 46 6144 24576 4 0 // 47 6528 32768 5 128 // 48 6784 40960 6 256 // 49 6912 49152 7 768 // 50 8192 8192 1 0 // 51 9472 57344 6 512 // 52 9728 49152 5 512 // 53 10240 40960 4 0 // 54 10880 32768 3 128 // 55 12288 24576 2 0 // 56 13568 40960 3 256 // 57 14336 57344 4 0 // 58 16384 16384 1 0 // 59 18432 73728 4 0 // 60 19072 57344 3 128 // 61 20480 40960 2 0 // 62 21760 65536 3 256 // 63 24576 24576 1 0 // 64 27264 81920 3 128 // 65 28672 57344 2 0 // 66 32768 32768 1 0 上表中每列含义如下: class: class ID,每个span结构中都有一个class ID, 表示该span可处理的对象类型 bytes/obj:该class代表对象的字节数 bytes/span:每个span占用堆的字节数,也即页数*页大小 objects: 每个span可分配的对象个数,也即(bytes/spans)/(bytes/obj) waste bytes: 每个span产生的内存碎片,也即(bytes/spans)%(bytes/obj) 上表可见最大的对象是32K大小,超过32K大小的由特殊的class表示,该class ID为0,每个class只包含一个对象。 2.1.2 span数据结构 span是内存管理的基本单位,每个span用于管理特定的class对象, 跟据对象大小,span将一个或多个页拆分成多个块进行管理。 src/runtime/mheap.go:mspan定义了其数据结构: type mspan struct { next *mspan //链表前向指针,用于将span链接起来 prev *mspan //链表前向指针,用于将span链接起来 startAddr uintptr // 起始地址,也即所管理页的地址 npages uintptr // 管理的页数 nelems uintptr // 块个数,也即有多少个块可供分配 allocBits *gcBits //分配位图,每一位代表一个块是否已分配 allocCount uint16 // 已分配块的个数 spanclass spanClass // class表中的class ID elemsize uintptr // class表中的对象大小,也即块大小 } 以class 10为例,span和管理的内存如下图所示: spanclass为10,参照class表可得出npages=1,nelems=56,elemsize为144。其中startAddr是在span初始化时就指定了某个页的地址。allocBits指向一个位图,每位代表一个块是否被分配,本例中有两个块已经被分配,其allocCount也为2。 next和prev用于将多个span链接起来,这有利于管理多个span,接下来会进行说明。 2.2 cache 有了管理内存的基本单位span,还要有个数据结构来管理span,这个数据结构叫mcentral,各线程需要内存时从mcentral管理的span中申请内存,为了避免多线程申请内存时不断的加锁,Golang为每个线程分配了span的缓存,这个缓存即是cache。 src/runtime/mcache.go:mcache定义了cache的数据结构: type mcache struct { alloc [67*2]*mspan // 按class分组的mspan列表 } alloc为mspan的指针数组,数组大小为class总数的2倍。数组中每个元素代表了一种class类型的span列表,每种class类型都有两组span列表,第一组列表中所表示的对象中包含了指针,第二组列表中所表示的对象不含有指针,这么做是为了提高GC扫描性能,对于不包含指针的span列表,没必要去扫描。 根据对象是否包含指针,将对象分为noscan和scan两类,其中noscan代表没有指针,而scan则代表有指针,需要GC进行扫描。 mcache和span的对应关系如下图所示: mchache在初始化时是没有任何span的,在使用过程中会动态的从central中获取并缓存下来,跟据使用情况,每种class的span个数也不相同。上图所示,class 0的span数比class1的要多,说明本线程中分配的小对象要多一些。 2.3 central cache作为线程的私有资源为单个线程服务,而central则是全局资源,为多个线程服务,当某个线程内存不足时会向central申请,当某个线程释放内存时又会回收进central。 src/runtime/mcentral.go:mcentral定义了central数据结构: type mcentral struct { lock mutex //互斥锁 spanclass spanClass // span class ID nonempty mSpanList // non-empty 指还有空闲块的span列表 empty mSpanList // 指没有空闲块的span列表 nmalloc uint64 // 已累计分配的对象个数 } lock: 线程间互斥锁,防止多线程读写冲突 spanclass : 每个mcentral管理着一组有相同class的span列表 nonempty: 指还有内存可用的span列表 empty: 指没有内存可用的span列表 nmalloc: 指累计分配的对象个数 线程从central获取span步骤如下: 加锁 从nonempty列表获取一个可用span,并将其从链表中删除 将取出的span放入empty链表 将span返回给线程 解锁 线程将该span缓存进cache 线程将span归还步骤如下: 加锁 将span从empty列表删除 将span加入noneempty列表 解锁 上述线程从central中获取span和归还span只是简单流程,为简单起见,并未对具体细节展开。 2.4 heap 从mcentral数据结构可见,每个mcentral对象只管理特定的class规格的span。事实上每种class都会对应一个mcentral,这个mcentral的集合存放于mheap数据结构中。 src/runtime/mheap.go:mheap定义了heap的数据结构: type mheap struct { lock mutex spans []*mspan bitmap uintptr //指向bitmap首地址,bitmap是从高地址向低地址增长的 arena_start uintptr //指示arena区首地址 arena_used uintptr //指示arena区已使用地址位置 central [67*2]struct { mcentral mcentral pad [sys.CacheLineSize - unsafe.Sizeof(mcentral{})%sys.CacheLineSize]byte } } lock: 互斥锁 spans: 指向spans区域,用于映射span和page的关系 bitmap:bitmap的起始地址 arena_start: arena区域首地址 arena_used: 当前arena已使用区域的最大地址 central: 每种class对应的两个mcentral 从数据结构可见,mheap管理着全部的内存,事实上Golang就是通过一个mheap类型的全局变量进行内存管理的。 mheap内存管理示意图如下: 系统预分配的内存分为spans、bitmap、arean三个区域,通过mheap管理起来。接下来看内存分配过程。 3. 内存分配过程 针对待分配对象的大小不同有不同的分配逻辑: (0, 16B) 且不包含指针的对象: Tiny分配 (0, 16B) 包含指针的对象:正常分配 [16B, 32KB] : 正常分配 (32KB, -) : 大对象分配 其中Tiny分配和大对象分配都属于内存管理的优化范畴,这里暂时仅关注一般的分配方法。 以申请size为n的内存为例,分配步骤如下: 获取当前线程的私有缓存mcache 跟据size计算出适合的class的ID 从mcache的alloc[class]链表中查询可用的span 如果mcache没有可用的span则从mcentral申请一个新的span加入mcache中 如果mcentral中也没有可用的span则从mheap中申请一个新的span加入mcentral 从该span中获取到空闲对象地址并返回 4. 总结 Golang内存分配是个相当复杂的过程,其中还掺杂了GC的处理,这里仅仅对其关键数据结构进行了说明,了解其原理而又不至于深陷实现细节。 Golang程序启动时申请一大块内存,并划分成spans、bitmap、arena区域 arena区域按页划分成一个个小块 span管理一个或多个页 mcentral管理多个span供线程申请使用 mcache作为线程私有资源,资源来源于mcentral 本文来自云栖社区合作伙伴“开源中国” 本文作者:达尔文 原文链接

优秀的个人博客,低调大师

彻底理解JVM常考题之分级引用模型

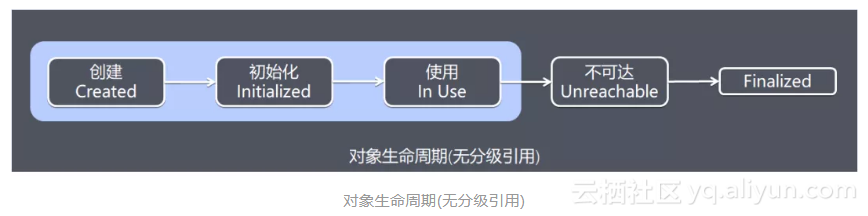
本文通过探析Java中的引用模型,分析比较强引用、软引用、弱引用、虚引用的概念及使用场景,知其然且知其所以然,希望给大家在实际开发实践、学习开源项目提供参考。 Java的引用 对于Java中的垃圾回收机制来说,对象是否被应该回收的取决于该对象是否被引用。因此,引用也是JVM进行内存管理的一个重要概念。Java中是JVM负责内存的分配和回收,这是它的优点(使用方便,程序不用再像使用C语言那样担心内存),但同时也是它的缺点(不够灵活)。由此,Java提供了引用分级模型,可以定义Java对象重要性和优先级,提高JVM内存回收的执行效率。 关于引用的定义,在JDK1.2之前,如果reference类型的数据中存储的数值代表的是另一块内存的起始地址,就称为这块内存代表着一个引用;JDK1.2之后,Java对引用的概念进行了扩充,将引用分为强引用(Strong Reference)、软引用(Soft Reference)、弱引用(Weak Reference)、虚引用(Phantom Reference)四种。 软引用对象和弱应用对象主要用于:当内存空间还足够,则能保存在内存之中;如果内存空间在垃圾收集之后还是非常紧张,则可以抛弃这些对象。很多系统的缓存功能都符合这样的使用场景。 而虚引用对象用于替代不靠谱的finalize方法,可以获取对象的回收事件,来做资源清理工作。 对象生命周期 无分级引用对象生命周期 前面提到,分层引用的模型是用于内存回收,没有分级引用对象下,一个对象从创建到回收的生命周期可以简单地用下图概括:对象被创建,被使用,有资格被收集,最终被收集,阴影区域表示对象“强可达”时间: 有分级引用对象生命周期 JDK1.2引入java.lang.ref程序包之后,对象的生命周期多了3个阶段,软可达,弱可达,虚可达,这些状态仅适用于符合垃圾回收条件的对象,这些对象处于非强引用阶段,而且需要基于java.lang.ref包中的相关的引用对象类来指示标明。 软可达 软可达对象用SoftReference来指示标明,并没有强引用,垃圾回收器会尽可能长时间地保留对象,但是会在抛出OutOfMemoryError异常之前收集它。 弱可达 弱可达对象用WeakReference来指示标明,并没有强引用或软引用,垃圾回收器会随时回收对象,并不会尝试保留它,但是会在抛出OutOfMemoryError异常之前收集它。 在对象回收阶段中,该对象在major collection期间被回收,但是可以在minor collection期间存活 虚可达 虚可达对象用PhantomReference来指示标明,它已经被标记选中进行垃圾回收并且它的finalizer(如果有)已经运行。在这种情况下,术语“可达”实际上是用词不当,因为您无法访问实际对象。 对象生命周期图中添加三个新的可选状态会造成一些困惑。逻辑顺序上是从强可达到软,弱和虚,最终到回收,但实际的情况取决于程序创建的参考对象。但如果创建WeakReference但不创建SoftReference,则对象直接从强可达到弱到达最终到收集。 强引用 强引用就是指在程序代码之中普遍存在的,比如下面这段代码中的obj和str都是强引用: Objectobj=newObject(); Stringstr="helloworld"; 只要强引用还存在,垃圾收集器永远不会回收被引用的对象,即使在内存不足的情况下,JVM即使抛出OutOfMemoryError异常也不会回收这种对象。 实际使用上,可以通过把引用显示赋值为null来中断对象与强引用之前的关联,如果没有任何引用执行对象,垃圾收集器将在合适的时间回收对象。 例如ArrayList类的remove方法中就是通过将引用赋值为null来实现清理工作的: /** *Removestheelementatthespecifiedpositioninthislist. *Shiftsanysubsequentelementstotheleft(subtractsonefromtheir *indices). * *@paramindextheindexoftheelementtoberemoved *@returntheelementthatwasremovedfromthelist *@throwsIndexOutOfBoundsException{@inheritDoc} */ publicEremove(intindex){ rangeCheck(index); modCount++; EoldValue=elementData(index); intnumMoved=size-index-1; if(numMoved>0) System.arraycopy(elementData,index+1,elementData,index, numMoved); elementData[--size]=null;//cleartoletGCdoitswork returnoldValue; } 引用对象 介绍软引用、弱引用和虚引用之前,有必要介绍一下引用对象, 引用对象是程序代码和其他对象之间的间接层,称为引用对象。每个引用对象都围绕对象的引用构造,并且不能更改引用值。 引用对象提供get()来获得其引用值的一个强引用,垃圾收集器可能随时回收引用值所指的对象。 一旦对象被回收,get()方法将返回null,要正确使用引用对象,下面使用SoftReference(软引用对象)作为参考示例: /** *简单使用demo */ privatestaticvoidsimpleUseDemo(){ List<String>myList=newArrayList<>(); SoftReference<List<String>>refObj=newSoftReference<>(myList); List<String>list=refObj.get(); if(null!=list){ list.add("hello"); }else{ //整个列表已经被垃圾回收了,做其他处理 } } 也就是说,使用时: 1、必须经常检查引用值是否为null 垃圾收集器可能随时回收引用对象,如果轻率地使用引用值,迟早会得到一个NullPointerException。 2、必须使用强引用来指向引用对象返回的值 垃圾收集器可能在任何时间回收引用对象,即使在一个表达式中间。 /** *正确使用引用对象demo */ privatestaticvoidtrueUseRefObjDemo(){ List<String>myList=newArrayList<>(); SoftReference<List<String>>refObj=newSoftReference<>(myList); //正确的使用,使用强引用指向对象保证获得对象之后不会被回收 List<String>list=refObj.get(); if(null!=list){ list.add("hello"); }else{ //整个列表已经被垃圾回收了,做其他处理 } } /** *错误使用引用对象demo */ privatestaticvoidfalseUseRefObjDemo(){ List<String>myList=newArrayList<>(); SoftReference<List<String>>refObj=newSoftReference<>(myList); //XXX错误的使用,在检查对象非空到使用对象期间,对象可能已经被回收 //可能出现空指针异常 if(null!=refObj.get()){ refObj.get().add("hello"); } } 3、必须持有引用对象的强引用 如果创建引用对象,没有持有对象的强引用,那么引用对象本身将被垃圾收集器回收。 4、当引用值没有被其他强引用指向时,软引用、弱引用和虚引用才会发挥作用,引用对象的存在就是为了方便追踪并高效垃圾回收。 软引用、弱引用和虚引用 引用对象的3个重要实现类位于java.lang.ref包下,分别是软引用SoftReference、弱引用WeakReference和虚引用PhantomReference。 软引用 软引用用来描述一些还有用但非必需的对象。对于软引用关联着的对象,在系统将要发生抛出OutOfMemoryError异常之前,将会把这些对象列入回收范围之内进行第二次回收。如果这次回收还没有足够的内存,才会抛出OutOfMemoryError异常。在JDK1.2之后,提供了SoftReference类来实现软引用。 下面是一个使用示例: importjava.lang.ref.SoftReference;publicclassSoftRefDemo{ publicstaticvoidmain(String[]args){ SoftReference<String>sr=newSoftReference<>(newString("helloworld")); //helloworld System.out.println(sr.get()); } } JDK文档中提到:软引用适用于对内存敏感的缓存:每个缓存对象都是通过访问的 SoftReference,如果JVM决定需要内存空间,那么它将清除回收部分或全部软引用对应的对象。如果它不需要空间,则SoftReference指示对象保留在堆中,并且可以通过程序代码访问。在这种情况下,当它们被积极使用时,它们被强引用,否则会被软引用。如果清除了软引用,则需要刷新缓存。 实际使用上,要除非缓存的对象非常大,每个数量级为几千字节,才值得考虑使用软引用对象。例如:实现一个文件服务器,它需要定期检索相同的文件,或者需要缓存大型对象图。如果对象很小,必须清除很多对象才能产生影响,那么不建议使用,因为清除软引用对象会增加整个过程的开销。 弱引用 弱引用也是用来描述非必需对象,但是它的强度比软引用更弱一些,被弱引用关联的对象只能生存到下一次垃圾收集发送之前。当垃圾收集器工作时,无论当前内存是否足够,都会回收掉只被弱引用关联的对象。 在JDK1.2之后,提供了WeakReference类来实现弱引用。 /** *简单使用弱引用demo */ privatestaticvoidsimpleUseWeakRefDemo(){ WeakReference<String>sr=newWeakReference<>(newString("helloworld")); //beforegc->helloworld System.out.println("beforegc->"+sr.get()); //通知JVM的gc进行垃圾回收 System.gc(); //aftergc->null System.out.println("aftergc->"+sr.get()); } 可以看到被弱引用关联的对象,在gc之后被回收掉。 有意思的地方是,如果把上面代码中的: WeakReference<String>sr=newWeakReference<>(newString("helloworld")); 改为 WeakReference<String>sr=newWeakReference<>("helloworld"); 程序将输出 beforegc->helloworld aftergc->helloworld 这是因为使用Java的String直接赋值和使用new区别在于: new 会在堆区创建一个可以被正常回收的对象。 String直接赋值,会在Java StringPool(字符串常量池)里创建一个String对象,存于pergmen(永生代区)中,通常不会被gc回收。 WeakHashMap 为了更方便使用弱引用,Java还提供了WeakHashMap,功能类似HashMap,内部实现是用弱引用对key进行包装,当某个key对象没有任何强引用指向,gc会自动回收key和value对象。 /** *weakHashMap使用demo */ privatestaticvoidweakHashMapDemo(){ WeakHashMap<String,String>weakHashMap=newWeakHashMap<>(); Stringkey1=newString("key1"); Stringkey2=newString("key2"); Stringkey3=newString("key3"); weakHashMap.put(key1,"value1"); weakHashMap.put(key2,"value2"); weakHashMap.put(key3,"value3"); //使没有任何强引用指向key1 key1=null; System.out.println("beforegcweakHashMap="+weakHashMap+",size="+weakHashMap.size()); //通知JVM的gc进行垃圾回收 System.gc(); System.out.println("aftergcweakHashMap="+weakHashMap+",size="+weakHashMap.size()); } 程序输出: before:gcweakHashMap={key1=value1,key2=value2,key3=value3},size=3 after:gcweakHashMap={key2=value2,key3=value3},size=2 WeakHashMap比较适用于缓存的场景,例如Tomcat的缓存就用到。 引用队列 介绍虚引用之前,先介绍引用队列: 在使用引用对象时,通过判断get()方法返回的值是否为null来判断对象是否已经被回收,当这样做并不是非常高效,特别是当我们有很多引用对象,如果想找出哪些对象已经被回收,需要遍历所有所有对象。 更好的方案是使用引用队列,在构造引用对象时与队列关联,当gc(垃圾回收线程)准备回收一个对象时,如果发现它还仅有软引用(或弱引用,或虚引用)指向它,就会在回收该对象之前,把这个软引用(或弱引用,或虚引用)加入到与之关联的引用队列(ReferenceQueue)中。 如果一个软引用(或弱引用,或虚引用)对象本身在引用队列中,就说明该引用对象所指向的对象被回收了,所以要找出所有被回收的对象,只需要遍历引用队列。 当软引用(或弱引用,或虚引用)对象所指向的对象被回收了,那么这个引用对象本身就没有价值了,如果程序中存在大量的这类对象(注意,我们创建的软引用、弱引用、虚引用对象本身是个强引用,不会自动被gc回收),就会浪费内存。因此我们这就可以手动回收位于引用队列中的引用对象本身。 /** *引用队列demo */ privatestaticvoidrefQueueDemo(){ ReferenceQueue<String>refQueue=newReferenceQueue<>(); //用于检查引用队列中的引用值被回收 ThreadcheckRefQueueThread=newThread(()->{ while(true){ Reference<?extendsString>clearRef=refQueue.poll(); if(null!=clearRef){ System.out .println("引用对象被回收,ref="+clearRef+",value="+clearRef.get()); } } }); checkRefQueueThread.start(); WeakReference<String>weakRef1=newWeakReference<>(newString("value1"),refQueue); WeakReference<String>weakRef2=newWeakReference<>(newString("value2"),refQueue); WeakReference<String>weakRef3=newWeakReference<>(newString("value3"),refQueue); System.out.println("ref1value="+weakRef1.get()+",ref2value="+weakRef2.get() +",ref3value="+weakRef3.get()); System.out.println("开始通知JVM的gc进行垃圾回收"); //通知JVM的gc进行垃圾回收 System.gc(); } 程序输出: ref1value=value1,ref2value=value2,ref3value=value3 开始通知JVM的gc进行垃圾回收 引用对象被回收,ref=java.lang.ref.WeakReference@48c6cd96,value=null 引用对象被回收,ref=java.lang.ref.WeakReference@46013afe,value=null 引用对象被回收,ref=java.lang.ref.WeakReference@423ea6e6,value=null 虚引用 虚引用也称为幽灵引用或者幻影引用,不同于软引用和弱引用,虚引用不用于访问引用对象所指示的对象,相反,通过不断轮询虚引用对象关联的引用队列,可以得到对象回收事件。一个对象是否有虚引用的存在,完全不会对其生产时间构成影响,也无法通过虚引用来取得一个对象实例。虽然这看起来毫无意义,但它实际上可以用来做对象回收时资源清理、释放,它比finalize更灵活,我们可以基于虚引用做更安全可靠的对象关联的资源回收。 finalize的问题 Java语言规范并不保证finalize方法会被及时地执行、而且根本不会保证它们会被执行 如果可用内存没有被耗尽,垃圾收集器不会运行,finalize方法也不会被执行。 性能问题 JVM通常在单独的低优先级线程中完成finalize的执行。 对象再生问题 finalize方法中,可将待回收对象赋值给GC Roots可达的对象引用,从而达到对象再生的目的。 针对不靠谱finalize方法,完全可以使用虚引用来实现。在JDK1.2之后,提供了PhantomReference类来实现虚引用。 下面是简单的使用例子,通过访问引用队列可以得到对象的回收事件: /** *简单使用虚引用demo *虚引用在实现一个对象被回收之前必须做清理操作是很有用的,比finalize()方法更灵活 */ privatestaticvoidsimpleUsePhantomRefDemo()throwsInterruptedException{ Objectobj=newObject(); ReferenceQueue<Object>refQueue=newReferenceQueue<>(); PhantomReference<Object>phantomRef=newPhantomReference<>(obj,refQueue); //null System.out.println(phantomRef.get()); //null System.out.println(refQueue.poll()); obj=null; //通知JVM的gc进行垃圾回收 System.gc(); //null,调用phantomRef.get()不管在什么情况下会一直返回null System.out.println(phantomRef.get()); //当GC发现了虚引用,GC会将phantomRef插入进我们之前创建时传入的refQueue队列 //注意,此时phantomRef对象,并没有被GC回收,在我们显式地调用refQueue.poll返回phantomRef之后 //当GC第二次发现虚引用,而此时JVM将phantomRef插入到refQueue会插入失败,此时GC才会对phantomRef对象进行回收 Thread.sleep(200); Reference<?>pollObj=refQueue.poll(); //java.lang.ref.PhantomReference@1540e19d System.out.println(pollObj); if(null!=pollObj){ //进行资源回收的操作 } } 比较常见的,可以基于虚引用实现JDBC连接池,锁的释放等场景。 以连接池为例,调用方正常情况下使用完连接,需要把连接释放回池中,但是不可避免有可能程序有bug,造成连接没有正常释放回池中。基于虚引用对Connection对象进行包装,并关联引用队列,就可以通过轮询引用队列检查哪些连接对象已经被GC回收,释放相关连接资源。具体实现已上传github的caison-blog-demo仓库。 总结 对比一下几种引用对象的不同: 引用类型 GC回收时间 常见用途 生存时间 强引用 永不 对象的一般状态 JVM停止运行时 软引用 内存不足时 对象缓存 内存不足时终止 弱引用 GC时 对象缓存 GC后终止 虚引用,配合引用队列使用,通过不断轮询引用队列获取对象回收事件。 虽然引用对象是一个非常有用的工具来管理你的内存消耗,但有时它们是不够的,或者是过度设计的 。例如,使用一个Map来缓存从数据库中读取的数据。虽然可以使用弱引用来作为缓存,但最终程序需要运行一定量的内存。如果不能给它足够实际足够的资源完成任何工作,那么错误恢复机制有多强大也没有用。 当遇到OutOfMemoryError错误,第一反应是要弄清楚它为什么会发生,也许真的是程序有bug,也许是可用内存设置的太低。 在开发过程中,应该制定程序具体的使用内存大小,而已要关注实际使用中用了多少内存。大多数应用程序在实际运行负载下,程序的内存占用会达到稳定状态,可以用此来作为参考来设置合理的堆大小。如果程序的内存使用量随着时间的推移而上升,很有可能是因为当对象不再使用时仍然拥有对对象的强引用。引用对象在这里可能会有所帮助,但更有可能是把它当做一个bug来进行修复。 原文发布时间为:2018-10-12 本文作者:陈彩华 本文来自云栖社区合作伙伴“Hollis”,了解相关信息可以关注“Hollis”。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册