首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

ES7学习笔记(十二)高亮 和 搜索建议

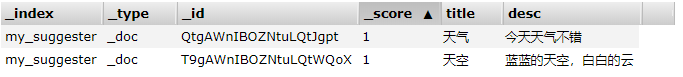
ES当中大部分的内容都已经学习完了,今天呢算是对前面内容的查漏补缺,把ES中非常实用的功能整理一下,在以后的项目开发中,这些功能肯定是对你的项目加分的,我们来看看吧。 高亮 高亮在搜索功能中是十分重要的,我们希望搜索的内容在搜索结果中重点突出,让用户聚焦在搜索的内容上。我们看看在ES当中是怎么实现高亮的,我们还用之前的索引ik_index,前面的章节,我们搜索过香蕉好吃,但是返回的结果中并没有高亮,那么想要在搜索结果中,对香蕉好吃高亮该怎么办呢?我们看看, POST /ik_index/_search { "query": { "bool": { "must": { "match": { "desc": "香蕉好吃" } } } }, "highlight": { "fields": { "desc": {} } } } 我们重点看一下请求体中的highlight部分,这部分就是对返回结果高亮的设置,fields字段中,指定哪些字段需要高亮,我们指定了desc字段,执行一下,看看结果吧。 { "took": 73, "timed_out": false, "_shards": { "total": 1,"successful": 1,"skipped": 0,"failed": 0}, "hits": { "total": { "value": 5, "relation": "eq" }, "max_score": 1.3948275, "hits": [ { "_index": "ik_index", "_type": "_doc", "_id": "2", "_score": 1.3948275, "_source": { "id": 1, "title": "香蕉", "desc": "香蕉真好吃" }, "highlight": { "desc": [ "<em>香蕉</em>真<em>好吃</em>" ] } } …… 我们看到在返回的结果中,增加了highlight,highlight里有我们指定的高亮字段desc,它的值是<em>香蕉</em>真<em>好吃</em>,其中“香蕉”和“好吃”字段在<em>标签中,前端的小伙伴就可以针对这个<em>标签写样式了。我们再看看程序当中怎么设置高亮,继续使用上一节中的搜索的程序, public void searchIndex() throws IOException { SearchRequest searchRequest = new SearchRequest("ik_index"); SearchSourceBuilder ssb = new SearchSourceBuilder(); QueryBuilder qb = new MatchQueryBuilder("desc","香蕉好吃"); ssb.query(qb); HighlightBuilder highlightBuilder = new HighlightBuilder(); highlightBuilder.field("desc"); ssb.highlighter(highlightBuilder); searchRequest.source(ssb); SearchResponse response = client.search(searchRequest, RequestOptions.DEFAULT); SearchHit[] hits = response.getHits().getHits(); for (SearchHit hit : hits) { String record = hit.getSourceAsString(); HighlightField highlightField = hit.getHighlightFields().get("desc"); for (Text fragment : highlightField.getFragments()) { System.out.println(fragment.string()); } } } 我们重点关注一下HighlightBuilder,我们在发送请求前,创建HighlightBuilder,并指定高亮字段为desc。搜索结束后,我们取结果,从hit当中取出高亮字段desc,然后打印出fragment,运行一下,看看结果吧, <em>香蕉</em>真<em>好吃</em> <em>香蕉</em>真<em>好吃</em> 橘子真<em>好吃</em> 桃子真<em>好吃</em> 苹果真<em>好吃</em> 完全符合预期,“香蕉好吃”被分词后,在搜索结果中都增加了<em>标签,我们可不可以自定义高亮标签呢?当然是可以的,我们稍微改一下程序就可以了, HighlightBuilder highlightBuilder = new HighlightBuilder(); highlightBuilder.field("desc"); highlightBuilder.preTags("<b>"); highlightBuilder.postTags("</b>"); ssb.highlighter(highlightBuilder); 在HighlightBuilder中,使用preTags添加起始标签,指定为<b>,用postTags添加闭合标签,指定为</b>,再运行一下,看看结果, <b>香蕉</b>真<b>好吃</b> <b>香蕉</b>真<b>好吃</b> 橘子真<b>好吃</b> 桃子真<b>好吃</b> 苹果真<b>好吃</b> 结果完全正确,用<b>替换了<em>,是不是很灵活。接下来我们再看看搜索建议。 搜索建议 “搜索建议”这个功能也是相当实用的,当我们在搜索框中输入某个字时,与这个字的相关搜索内容就会罗列在下面,我们选择其中一个搜索就可以了,省去了敲其他字的时间。我们看看ES中是怎么实现“搜索建议”的。 如果要在ES中使用“搜索建议”功能,是需要特殊设置的,要设置一个类型为completion的字段,由于之前的索引中已经有了数据,再添加字段是会报错的,索引我们新建一个索引, PUT /my_suggester { "settings":{ "analysis":{ "analyzer":{ "default":{ "type":"ik_max_word" } } } }, "mappings":{ "dynamic_date_formats": [ "MM/dd/yyyy", "yyyy/MM/dd HH:mm:ss", "yyyy-MM-dd", "yyyy-MM-dd HH:mm:ss" ], "properties":{ "suggest":{ "type":"completion" } } } } 这已经成了我们新建索引的一个标配了,指定分词器为ik中文分词,动态字段的时间映射格式,以及搜索建议字段,注意suggest字段的类型为completion。我们再添加字段的时候,就要为suggest字段添加值了,如下: POST /my_suggester/_doc { "title":"天气", "desc":"今天天气不错", "suggest": { "input": "天气" } } POST /my_suggester/_doc { "title":"天空", "desc":"蓝蓝的天空,白白的云", "suggest": { "input": "天空" } } 我们向索引中添加了两条数据,大家需要额外注意的是suggest字段的赋值方法,要使用input,我们看一下数据, suggest字段并没有像其他字段那样展示出来,说明它和其他字段是不一样的。现在我们如果只输入一个“天”字,看看搜索建议能不能给出提示,如下: POST /my_suggester/_search { "suggest": { "s-test": { "prefix": "天", "completion": { "field": "suggest" } } } } 在请求体中,suggest就是“搜索建议”的标识,s-test是自定义的一个名称,prefix是前缀,也就是我们输入的“天”字,completion指定搜索建议的字段,我们看看查询的结果, …… "suggest": { "s-test": [ { "text": "天", "offset": 0, "length": 1, "options": [{ "text": "天气", "_index": "my_suggester", "_type": "_doc", "_id": "QtgAWnIBOZNtuLQtJgpt", "_score": 1, "_source": { "title": "天气","desc": "今天天气不错","suggest": { "input": "天气"}} } , { "text": "天空", "_index": "my_suggester", "_type": "_doc", "_id": "T9gAWnIBOZNtuLQtWQoX", "_score": 1, "_source": { "title": "天空","desc": "蓝蓝的天空,白白的云","suggest": { "input": "天空"}} } ] } ] } 在s-test.options里,包含了两条记录,text字段就是我们写的建议字段,后面_source里还包含对应的数据,下面我们再看看程序里怎么使用“搜索建议”, public void searchSuggest(String prefix) throws IOException { SearchRequest searchRequest = new SearchRequest("my_suggester"); SearchSourceBuilder ssb = new SearchSourceBuilder(); CompletionSuggestionBuilder suggest = SuggestBuilders .completionSuggestion("suggest") .prefix(prefix); SuggestBuilder suggestBuilder = new SuggestBuilder(); suggestBuilder.addSuggestion("s-test",suggest); ssb.suggest(suggestBuilder); searchRequest.source(ssb); SearchResponse response = client.search(searchRequest, RequestOptions.DEFAULT); CompletionSuggestion suggestion = response.getSuggest().getSuggestion("s-test"); for (CompletionSuggestion.Entry.Option option : suggestion.getOptions()) { System.out.println(option.getText().string()); } } @Test public void searchSuggest() throws IOException { eService.searchSuggest("天"); } 我们创建了CompletionSuggestionBuilder,通过方法completionSuggestion指定“搜索建议”字段suggest,并且指定前缀为方法传入的prefix,我们在测试的时候传入"天"字。然后,我们自定义“搜索建议”的名字为s-test,传入前面构造好的suggest。 发送请求后,在响应中获取前面自定义的s-test,然后循环options,取出text字段,这就是搜索建议的字段,我们运行一下,看看结果, 天气 天空 完全符合预期,这样用户在搜索的时候,就会给出提示信息了。 好了,今天这两个ES的知识点就全部OK了~ 大家有问题在评论区留言。

优秀的个人博客,低调大师

ES7学习笔记(八)数据的增删改

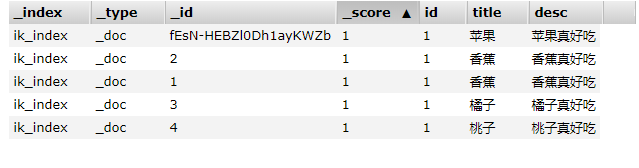
在前面几节的内容中,我们学习索引、字段映射、分析器等,这些都是使用ES的基础,就像在数据库中创建表一样,基础工作做好以后,我们就要真正的使用它了,这一节我们要看看怎么向索引里写入数据、修改数据、删除数据,至于搜索嘛,因为ES的主要功能就是搜索,所以搜索的相关功能我们后面会展开讲。 Document的创建与更新 索引中的数据叫做document,和数据中的一条记录是一样的,而索引就像数据库中的一张表,我们向索引中添加数据,就像在数据库表中添加一条记录一样。下面我们看看怎么向索引中添加数据, PUT /<index>/_doc/<_id> POST /<index>/_doc/ PUT /<index>/_create/<_id> POST /<index>/_create/<_id> 在这个POST请求中,<index>也就是索引的名字是必须的,这就好比我们向数据库中插入记录,要知道往哪张表里插是一样的。<index>后面可以是_doc或者_create,这两个是什么意思呢?咱们慢慢看,除了这两个区别以外,再有就是请求的方法了,分为POST和PUT两种。一般情况下,POST用于数据的插入,PUT用户数据的修改,是不是这样呢?咱们把这4种方式都试一下,首先我们看一下POST /<index>/_doc/这种方式的请求, POST /ik_index/_doc { "id": 1, "title": "苹果", "desc": "苹果真好吃" } 在这里,索引我们使用的是上一节创建的ik_index,执行一下。然后我们再查询一下这个索引, GET /ik_index/_search 返回结果如下: { "took": 1000, "timed_out": false, "_shards": { "total": 1, "successful": 1, "skipped": 0, "failed": 0 }, "hits": { "total": { "value": 2, "relation": "eq" }, "max_score": 1, "hits": [ { "_index": "ik_index", "_type": "_doc", "_id": "1", "_score": 1, "_source": { "id": 1, "title": "大兴庞各庄的西瓜", "desc": "大兴庞各庄的西瓜真是好吃,脆沙瓤,甜掉牙" } }, { "_index": "ik_index", "_type": "_doc", "_id": "fEsN-HEBZl0Dh1ayKWZb", "_score": 1, "_source": { "id": 1, "title": "苹果", "desc": "苹果真好吃" } } ] } } 我们重点看一下hits,这是我们查询出的结果,第一条是我们上一节存入的数据,不用管它。我们看一下第二条记录,注意一下_id这个字段,这个_id是这条记录在索引里的唯一标识,在插入数据的请求中,我们没有指定这个id,ES给我们自动生成了fEsN-HEBZl0Dh1ayKWZb。那么我们可不可以指定呢?试一下, POST /ik_index/_doc/2 { "id": 1, "title": "香蕉", "desc": "香蕉真好吃" } 注意我们发送的请求,_doc后面加了2,这样就指定了id,执行一下。然后再次查询,返回的结果中,我们只截取hits的部分,如下: "hits": [ { "_index": "ik_index", "_type": "_doc", "_id": "1", "_score": 1, "_source": { "id": 1, "title": "大兴庞各庄的西瓜", "desc": "大兴庞各庄的西瓜真是好吃,脆沙瓤,甜掉牙" } }, { "_index": "ik_index", "_type": "_doc", "_id": "fEsN-HEBZl0Dh1ayKWZb", "_score": 1, "_source": { "id": 1, "title": "苹果", "desc": "苹果真好吃" } }, { "_index": "ik_index", "_type": "_doc", "_id": "2", "_score": 1, "_source": { "id": 1, "title": "香蕉", "desc": "香蕉真好吃" } } ] 我们看到插入的香蕉记录,它的_id是2。那么POST请求中指定的id在索引中存在,会是什么情况呢?我们再看一下, POST /ik_index/_doc/1 { "id": 1, "title": "香蕉", "desc": "香蕉真好吃" } 还是香蕉这条数据,我们指定id=1,id=1这条数据在索引中是存在的,我们执行一下,然后查询,返回的结果如下: "hits": [ { "_index": "ik_index", "_type": "_doc", "_id": "fEsN-HEBZl0Dh1ayKWZb", "_score": 1, "_source": { "id": 1, "title": "苹果", "desc": "苹果真好吃" } }, { "_index": "ik_index", "_type": "_doc", "_id": "2", "_score": 1, "_source": { "id": 1, "title": "香蕉", "desc": "香蕉真好吃" } }, { "_index": "ik_index", "_type": "_doc", "_id": "1", "_score": 1, "_source": { "id": 1, "title": "香蕉", "desc": "香蕉真好吃" } } ] 我们看到之前的那条数据被修改了,所以,关于POST /<index>/_doc/<_id>,这种添加数据的方式,我们得出结论如下: <_id>不指定时,ES会为我们自动生成id; 指定<_id>时,且id在索引中不存在,ES将添加一条指定id的数据; 指定<_id>时,但id在索引中存在,ES将会更新这条数据; 接下来我们再看看_doc方式的PUT请求方式,我们先不指定id,看看会是什么情况,请求如下: PUT /ik_index/_doc { "id": 1, "title": "葡萄", "desc": "葡萄真好吃" } 执行一下,返回如下结果: { "error": "Incorrect HTTP method for uri [/ik_index/_doc] and method [PUT], allowed: [POST]", "status": 405 } 错误信息说我们的请求不对,让我们使用POST请求,看来PUT请求不指定id是不行的。我们再看看指定一个不存在的id,是什么情况,如下: PUT /ik_index/_doc/3 { "id": 1, "title": "葡萄", "desc": "葡萄真好吃" } 执行成功,再查询一下, "hits": [ …… { "_index": "ik_index", "_type": "_doc", "_id": "3", "_score": 1, "_source": { "id": 1, "title": "葡萄", "desc": "葡萄真好吃" } } ] 数据添加成功。再看看指定一个存在的id是什么情况,那当然是修改了,我们再试一下, PUT /ik_index/_doc/3 { "id": 1, "title": "橘子", "desc": "橘子真好吃" } 执行成功,再查询一下, "hits": [ …… { "_index": "ik_index", "_type": "_doc", "_id": "3", "_score": 1, "_source": { "id": 1, "title": "橘子", "desc": "橘子真好吃" } } ] 没有问题,修改成功。POST /<index>/_doc/<_id>这种方式的总结如下: <_id>必须指定,不指定会报错; <_id>在索引中不存在,为添加新数据; <_id>在索引中存在,为修改数据; _doc这种请求的POST和PUT都尝试过了,再看看_create这种请求,先看看不指定id是什么情况,如下: POST /ik_index/_create { "id": 1, "title": "桃子", "desc": "桃子真好吃" } 返回错误信息如下: { "error": { "root_cause": [ { "type": "invalid_type_name_exception", "reason": "mapping type name [_create] can't start with '_' unless it is called [_doc]" } ], "type": "invalid_type_name_exception", "reason": "mapping type name [_create] can't start with '_' unless it is called [_doc]" }, "status": 400 } 具体内容我们也不去解读了,总之是不可以,然后加个索引中不存在id试一下, POST /ik_index/_create/4 { "id": 1, "title": "桃子", "desc": "桃子真好吃" } 返回结果创建成功,查询如下: "hits": [ …… { "_index": "ik_index", "_type": "_doc", "_id": "4", "_score": 1, "_source": { "id": 1, "title": "桃子", "desc": "桃子真好吃" } } ] 如果id在索引中存在呢?再试, POST /ik_index/_create/3 { "id": 1, "title": "桃子", "desc": "桃子真好吃" } 返回错误: { "error": { "root_cause": [ { "type": "version_conflict_engine_exception", "reason": "[3]: version conflict, document already exists (current version [2])", "index_uuid": "W2X_riHIT4u678p8HZwnEg", "shard": "0", "index": "ik_index" } ], "type": "version_conflict_engine_exception", "reason": "[3]: version conflict, document already exists (current version [2])", "index_uuid": "W2X_riHIT4u678p8HZwnEg", "shard": "0", "index": "ik_index" }, "status": 409 } 大致的意思是,数据已经存在了,不能再添加新记录,看来_create这种方式还是比较严格的,总结如下: id必须指定; 指定的id如果在索引中存在,报错,添加不成功; 指定的id在索引中不存在,添加成功,符合预期; 再看看_create的PUT,应该和POST正好相反吧?我们试一下,先不指定id,试一下, PUT /ik_index/_create { "id": 1, "title": "火龙果", "desc": "火龙果真好吃" } 返回错误,不指定id肯定是不行的,错误信息就不给大家贴出来了,然后再指定一个不存在的id, PUT /ik_index/_create/5 { "id": 1, "title": "火龙果", "desc": "火龙果真好吃" } 创建成功,查询结果就不给大家展示了,然后再换一个存在的id,如下: PUT /ik_index/_create/4 { "id": 1, "title": "火龙果", "desc": "火龙果真好吃" } 返回了错误的信息,如下,和POST请求是一样的, { "error": { "root_cause": [ { "type": "version_conflict_engine_exception", "reason": "[4]: version conflict, document already exists (current version [1])", "index_uuid": "W2X_riHIT4u678p8HZwnEg", "shard": "0", "index": "ik_index" } ], "type": "version_conflict_engine_exception", "reason": "[4]: version conflict, document already exists (current version [1])", "index_uuid": "W2X_riHIT4u678p8HZwnEg", "shard": "0", "index": "ik_index" }, "status": 409 } 我们得出如下的结论: _create这种形式的POST和PUT是一样的,没有区别; id必须指定; id必须在索引中不存在; Document的删除 有了添加,肯定会有删除,删除的方式很简单,请求格式如下: DELETE /<index>/_doc/<_id> 发送delete请求,指定数据的id,就可以了,我们试一下,删除刚刚添加的火龙果数据,它的id是5,我们发送请求如下: DELETE /ik_index/_doc/5 执行成功,数据被成功的删除。 根据id查询Document 根据id查询数据也很简单,发送如下请求就可以完成查询, GET <index>/_doc/<_id> 我们需要指定索引的名称,以及要查询数据的id,如下: GET ik_index/_doc/3 返回结果如下: { "_index": "ik_index", "_type": "_doc", "_id": "3", "_version": 2, "_seq_no": 5, "_primary_term": 3, "found": true, "_source": { "id": 1, "title": "橘子", "desc": "橘子真好吃" } } 根据id成功的查询出来结果。 好了~ 到这里,ES数据的增删改都介绍了,下节开始,我们看看ES的核心功能——搜索。


优秀的个人博客,低调大师

ES[7.6.x]学习笔记(六)分析器

在前面的章节中,我们给大家介绍了索引中的映射类型,也就是每一个字段都有一个类型,比如:long,text,date等。这和我们的数据库非常的相似,那么它的不同之处是什么呢?对了,就是全文索引,在ES当中,只有text类型的字段才会用的全文索引,那么这里就会引出ES中一个非常重要的概念,文本分析器(Text analysis)。 分析器使ES支持全文索引,搜索的结果是和你搜索的内容相关的,而不是你搜索内容的确切匹配。我们用ES官网中的例子给大家举例,假如你在搜索框中输入的内容是Quick fox jumps,你想得到的结果是A quick brown fox jumps over the lazy dog,或者结果中包含这样的词fast fox或foxes leap。 分析器之所以能够使搜索支持全文索引,都是因为有分词器(tokenization),它可以将一句话、一篇文章切分成不同的词语,每个词语都是独立的。假如你在ES索引中添加了一条记录the quick brown fox jumps,而用户搜索时输入的内容是quick fox,并没有完全匹配的内容,但是因为有了分词器,你索引的内容被切分成了不同的、独立的词,用户搜索的内容也会进行相应的切分,所以用户搜索的内容虽然没有完全匹配,但也能够搜索到想要的内容。 分析器除了要做分词,还要做归一化(Normalization)。分词器能够使搜索内容在每一个词上匹配,但这种匹配也只是在字面上进行的匹配。 比如你搜索Quick,但是不能匹配到quick,它们的大小写不同。 比如你搜索fox,但是不能匹配到foxes,它是复数形式。 比如你搜索jumps,不能匹配到leaps,虽然它们是同义词。 为了解决这些问题,分析器要把这些分词归一化到标准的格式。这样我们在搜索的时候就不用严格的匹配了,相似的词语我们也能够检索出来,上面的3种情况,我们也能够搜索出相应的结果。 分析器的组成 分析器,无论是内置的,还是自定义的,都是由3部分组成:字符过滤器(character filters)、分词器(tokenizers)、分词过滤器(token filters)。 字符过滤器 字符过滤器接收最原始的文档,并且可以改变其内容,比如:可以把中文的一二三四五六七八九,变成阿拉伯数字123456789。它还可以过滤html标签,并对其进行转义。还可以通过正则表达式,把匹配到的内容转化成其他的内容。一个分析器可以有多个字符过滤器,也可以没有字符过滤器。 分词器 一个分析器只能有一个确定的分词器,它可以把一句话分成若干个词,比如:空格分词器。当你输入一句话Quick brown fox!,它将被切分成[Quick, brown, fox!]。 分词过滤器 分词过滤器接收分词并且可以改变分词,比如:小写分词过滤器,它将接收到的分词全部转换成小写。助词过滤器,它将删除掉一些公共的助词,比如英语里的 the,is,are等,中文里的的,得等。同义词过滤器,它将在你的分词中,添加相应的同义词。一个分析器可以有多个分词过滤器,它们将按顺序执行。 我们在建立索引和搜索时,都会用的分析器。 配置文本分析器 前面我们讲了分析器的基本概念,也了解了全文搜索的基本步骤。下面我们看一下如何配置文本分析器,ES默认给我们配置的分析器是标准分析器。如果标准的分析器不适合你,你可以指定其他的分析器,或者自定义一个分析器。 ES有分析器的api,我们指定分析器和文本内容,就可以得到分词的结果。比如: POST _analyze { "analyzer": "whitespace", "text": "The quick brown fox." } 返回的结果如下: { "tokens": [ { "token": "The", "start_offset": 0, "end_offset": 3, "type": "word", "position": 0 }, { "token": "quick", "start_offset": 4, "end_offset": 9, "type": "word", "position": 1 }, { "token": "brown", "start_offset": 10, "end_offset": 15, "type": "word", "position": 2 }, { "token": "fox.", "start_offset": 16, "end_offset": 20, "type": "word", "position": 3 } ] } 我们指定的分析器是空格分析器,输入的文本内容是The quick brown fox.,返回结果是用空格切分的四个词。我们也可以测试分析器的组合,比如: POST _analyze { "tokenizer": "standard", "filter": [ "lowercase", "asciifolding" ], "text": "Is this déja vu?" } 我们指定了标准的分词器,小写过滤器和asciifolding过滤器。输入的内容是Is this déja vu?,我们执行一下,得到如下的结果: { "tokens": [ { "token": "is", "start_offset": 0, "end_offset": 2, "type": "<ALPHANUM>", "position": 0 }, { "token": "this", "start_offset": 3, "end_offset": 7, "type": "<ALPHANUM>", "position": 1 }, { "token": "deja", "start_offset": 8, "end_offset": 12, "type": "<ALPHANUM>", "position": 2 }, { "token": "vu", "start_offset": 13, "end_offset": 15, "type": "<ALPHANUM>", "position": 3 } ] } 我们可以看到结果中,is变成了小写,déja变成了deja,最后的?也过滤掉了。 为指定的字段配置分析器 我们在创建映射时,可以为每一个text类型的字段指定分析器,例如: PUT my_index { "mappings": { "properties": { "title": { "type": "text", "analyzer": "whitespace" } } } } 我们在my_index索引中,创建了title字段,它的类型是text,它的分析器是whitespace空格分析器。 为索引指定默认的分析器 如果我们觉得为每一个字段指定分析器过于麻烦,我们还可以为索引指定一个默认的分词器,如下: PUT my_index { "settings": { "analysis": { "analyzer": { "default": { "type": "whitespace" } } } } } 我们为my_index索引指定了默认的分析器whitespace。这样我们在创建text类型的字段时,就不用为其指定分析器了。 这一节给大家介绍了分析器,我们可以看到例子中都是使用的英文分析器,下一节我们一起看一下强大的中文分析器。

优秀的个人博客,低调大师

ES[7.6.x]学习笔记(四)字段类型(mapping)

在上一节中,我们创建了索引,在创建索引的时候,我们指定了mapping属性,mapping属性中规定索引中有哪些字段,字段的类型是什么。在mapping中,我们可以定义如下内容: 类型为String的字段,将会被全文索引; 其他的字段类型包括:数字、日期和geo(地理坐标); 日期类型的格式; 动态添加字段的映射规则; 字段的可用类型如下: 简单的类型,比如:text,keyword,date,long,double,boolean,ip。我们可以看到,类型当中没有String,字符串的类型是text,所有text类型的字段都会被全文索引。数字类型有两个,long(长整型)和double(浮点型)。 JSON的层级类型:Object(对象)和Nested(数组对象)。Object类型时,该字段可以存储一个JSON对象;Nested类型时,该字段可以存储一个数组对象。 复杂的类型:包括 geo_point、geo_shape和completion。 在索引中创建映射 我们在创建索引的时候可以同时创建映射,就如同上一节的内容。也可以在索引创建好以后,再去创建映射,请求的方式如下: PUT /my-index { "mappings": { "properties": { "age": { "type": "integer" }, "email": { "type": "keyword" }, "name": { "type": "text" } } } } 请求的方法我们要使用PUT,路径是我们的索引名称,请求体当中是我们为索引添加的字段和字段的类型。 在存在的映射中添加字段 正如上面所示,我们在一个索引中添加了字段,但是现在我们要补充额外的字段,这时,我们要怎么做呢? PUT /my-index/_mapping { "properties": { "employee-id": { "type": "keyword", "index": false } } } 我们使用PUT方法,后面跟随我们的索引名称,再接上_mapping,请求体中是我们新添加的映射字段,我们指定了字段的类型为keyword,index索引为false,说明这个字段只用于存储,不会用于搜索,搜索这个字段是搜索不到的。 我们在更新字段时候,是不能修改字段的类型的。如果我们要修改字段的类型,最好是新建一个新的字段,指定正确的类型,然后再更新索引,以后我们只需要查询这个新增的字段就可以了。 查看索引中的字段映射 如果我们要查看已知索引的字段映射,可以向ES发送如下的请求: GET /my-index/_mapping 请求的方法是GET,请求的路径是我们索引的名称my-index,再加上一个_mapping,得到的返回结果如下: { "my-index" : { "mappings" : { "properties" : { "age" : { "type" : "integer" }, "email" : { "type" : "keyword" }, "employee-id" : { "type" : "keyword", "index" : false }, "name" : { "type" : "text" } } } } } 返回的结果中,我们可以看到索引的名称my-index,还有我们添加的字段,也包括后续补充的employee-id字段。 好了,关于索引的字段映射就先给大家介绍到这里。

优秀的个人博客,低调大师

笔记:C#和C++常见容器整合

前言 有一段时间未使用c#/c++,因此写个合集用来回忆常用容器,也方便以后复习记忆 C#常见容器 Array 【数组】 简单的数组集合特点:内存中连续存储,索引快,赋值修改也快。缺点:需要事先声明数组长度,插值复杂。 String[] array = new String[5]; array[0] = '1'; ArrayList 【数组列表】 特点: 无需像Array需要初始长度,可以动态增加。 底层是Array,但继承了List接口 可以存储不同类型数据,所有元素视为object,也因此会出现类型不匹配,即不是类型安全。在拆箱操作时,性能消耗大。 ArrayList Alist = new Arraylist(); Alist.add('there') Alist.add(2333) List< T > 泛型 可以自定义list中元素的结构 public class TeamMate { public string name; public int age; public int groupNum; public override string ToString() { return "name=" + name + ",age=" + age + ",groupNum=" + groupNum; } } static void Main(string[] args) { List<TeamMate> list = new List<TeamMate>(); list.Add(new TeamMate { name = "Tom", age = 20, groupNum = 12 }); list.Add(new TeamMate { name = "Jerry", age = 22, groupNum = 13 }); foreach(Person p in list) { Console.WriteLine(p.ToString()); } } LinkedList< T > 【双向链表】 LinkedList< T >集合类没有非泛型类的版本,相当于C++中的list,内部实现是双链表 优点:如果要插入一个元素到链表的中间位置,会非常的快,原因:如果插入,只需要修改上一个元素的Next与下一个元素的Previous的引用则可。而像ArrayList数组列表中,如果插入,需要移动其后的所有元素。缺点:链表只能是一个接着一个的访问,这样就要用较长的时间来查找定位位于链表中间的元素。 因此从时间复杂度上,要在第K个位置插入一个元素,无论是ArrayList还是LinkedList的时间复杂度都为O(n)+O(1)=O(n)其中数组列表查找时间为O(1),但由于要将后续元素向后移动,则插入时间为O(n);而链表查找时间为O(n),但插入时间为O(1)。 将 List.Add方法和LinkedList的Add方法相比较,真正的性能差别不在于Add操作,而在LinkedList在给GC(垃圾回收机制)的压力上。一个List本质上是将其数据保存在一个堆栈的数组上,而LinkedList是将其所有节点保存在一系列堆栈上。这就使得GC需要更多地管理堆栈上LinkedList的节点对象。 LinkedListNode被LinkedList类包含,用LinkedListNode类,可以获得元素的上一个与下一个元素的引用。 LinkedList<int> list = new LinkedList<int>(); list.AddFirst(2); list.AddFirst(1); list.AddLast(4); list.AddLast(5); 此时链表结构为:1 2 4 5 LinkedListNode<int> NewList = list.Find(4); //4节点的位置 list.AddBefore(NewList, 3); //在4前增加3 此时链表结构为:1 2 3 4 5 HashTable【哈希表】 哈希表是通过key-value形式来存取数据的,相同存储形式的还有字典Dictionary,由于存储对象都是object,因而可以满足任意形式的键值对,但也因此有装箱和拆箱的性能消耗。 特点:当前HashTable中的被占用空间达到一个百分比的时候就将该空间自动扩容,在.net中这个百分比是72%,也叫.net中HashTable的填充因子为0.72。 构造哈希表 Hashtable table = new Hashtable(); table.Add("Name", "Tom"); table.Add("Age", 20); 遍历哈希表 Hashtable table = new Hashtable(); table.Add("Name", "Tom"); table.Add("Age", 20); foreach(DictionaryEntry entry in table) { Console.Write(entry.Key + ":"); Console.WriteLine(entry.Value); } Dictionary< T >【字典】(HashTable的泛型) 相当于C++中的map。只不过map的内部实现是红黑树,Dictionary的内部实现是哈希表,是类型安全的容器。在单线程的时候使用Dictionary更好,多线程的时候使用HashTable更好。 class Person { public string name; public int age; public override string ToString() { return "name=" + name + ",age=" + age; } } class Program { static void Main(string[] args) { Dictionary<string, Person> dictionary = new Dictionary<string, Person>(); Person person1 = new Person() { name = "Tom", age = 20 }; Person person2 = new Person() { name = "Jerry", age = 21}; dictionary.Add("学生1", person1); dictionary.Add("学生2", person2); foreach(KeyValuePair<string, Person> pair in dictionary) { Console.Write(pair.Key + ":"); Console.WriteLine(pair.Value.ToString()); } } } //只取Key值 foreach (string key in dictionary.Keys) { Console.WriteLine(key); } //只取value foreach (Person person in dictionary.Values) { Console.WriteLine(person); } HashSet< T > 特点: 一组不包含重复元素的集合 用O(n)的space来换取O(n)的时间,也就是查找元素的时间是O(1) HashSet<string> set = new HashSet<string>(); set.Add("Tom"); set.Add("Jerry"); set.Add("Tom"); foreach(var n in set) { Console.WriteLine(n); } 上述集合元素中Tom有2个,是重复值,那么输出HashSet结果就只显示一个,这就是不显示重复值的功能。 Queue【队列】 特点:先进先出的对象集合当需要对各项进行先进先出的访问时,则使用队列。当在列表中添加一项,称为入队,当从列表中移除一项时,称为出队。 Queue q = new Queue(); //入队操作 q.Enqueue("A"); q.Enqueue("B"); q.Enqueue("C"); //出队操作 q.Dequeue() Queue< T >【泛型队列】 class Person { public string name; public int age; public override string ToString() { return "name=" + name + ",age=" + age; } } class Program { static void Main(string[] args) { Person person1 = new Person() { name = "Tom", age = 20}; Person person2 = new Person() { name = "Jerry", age = 20 }; Queue<Person> q = new Queue<Person>(); q.Enqueue(person1); q.Enqueue(person2); Console.WriteLine(q.Dequeue()); } } Stack【栈】 特点:后进先出的对象集合。当需要对各项进行后进先出的访问时,则使用栈。当在列表中添加一项,称为推入元素,当从列表中移除一项时,称为弹出元素。 Stack st = new Stack(); //入栈 st.Push("A"); st.Push("B"); //出栈 st.Pop() C++常见容器 转载 C++ STL的实现:1.vector 底层数据结构为数组,支持快速随机访问 2.list 底层数据结构为双向链表,支持快速增删 3.deque 底层数据结构为一个中央控制器和多个缓冲区,支持首尾(中间不能)快速增删,也支持随机访问注:deque是一个双端队列(double-ended queue),也是在堆中保存内容的.它的保存形式如下:[堆1] --> [堆2] -->[堆3] --> ...每个堆保存好几个元素,然后堆和堆之间有指针指向,看起来像是list和vector的结合品4.stack 底层一般用list或deque实现,封闭头部即可,不用vector的原因应该是容量大小有限制,扩容耗时 5.queue 底层一般用list或deque实现,封闭头部即可,不用vector的原因应该是容量大小有限制,扩容耗时(stack和queue其实是适配器,而不叫容器,因为是对容器的再封装) 6.priority_queue 的底层数据结构一般为vector为底层容器,堆heap为处理规则来管理底层容器实现 7.set 底层数据结构为红黑树,有序,不重复 8.multiset 底层数据结构为红黑树,有序,可重复 9.map 底层数据结构为红黑树,有序,不重复 10.multimap 底层数据结构为红黑树,有序,可重复 11.hash_set 底层数据结构为hash表,无序,不重复 12.hash_multiset 底层数据结构为hash表,无序,可重复 13.hash_map 底层数据结构为hash表,无序,不重复 14.hash_multimap 底层数据结构为hash表,无序,可重复 stl容器区别: vector list deque set map-底层实现 在STL中基本容器有: vector、list、deque、set、map set 和map都是无序的保存元素,只能通过它提供的接口对里面的元素进行访问 set:集合, 用来判断某一个元素是不是在一个组里面,使用的比较少map:映射,相当于字典,把一个值映射成另一个值,如果想创建字典的话使用它好了底层采用的是树型结构,多数使用平衡二叉树实现,查找某一值是常数时间,遍历起来效果也不错, 只是每次插入值的时候,会重新构成底层的平衡二叉树,效率有一定影响. vector、list、deque是有序容器 1.vector vector就是动态数组.它也是在堆中分配内存,元素连续存放,有保留内存,如果减少大小后,内存也不会释放.如果新值>当前大小时才会再分配内存. 它拥有一段连续的内存空间,并且起始地址不变,因此它能非常好的支持随即存取,即[]操作符,但由于它的内存空间是连续的,所以在中间进行插入和删除会造成内存块的拷贝,另外,当该数组后的内存空间不够时,需要重新申请一块足够大的内存并进行内存的拷贝。这些都大大影响了vector的效率。 对最后元素操作最快(在后面添加删除最快), 此时一般不需要移动内存,只有保留内存不够时才需要 对中间和开始处进行添加删除元素操作需要移动内存,如果你的元素是结构或是类,那么移动的同时还会进行构造和析构操作,所以性能不高 (最好将结构或类的指针放入vector中,而不是结构或类本身,这样可以避免移动时的构造与析构)。访问方面,对任何元素的访问都是O(1),也就是是常数的,所以vector常用来保存需要经常进行随机访问的内容,并且不需要经常对中间元素进行添加删除操作. 相比较可以看到vector的属性与string差不多,同样可以使用capacity看当前保留的内存,使用swap来减少它使用的内存. capacity()返回vector所能容纳的元素数量(在不重新分配内存的情况下) 总结需要经常随机访问请用vector 2.list list就是双向链表,元素也是在堆中存放,每个元素都是放在一块内存中,它的内存空间可以是不连续的,通过指针来进行数据的访问,这个特点使得它的随机存取变的非常没有效率,因此它没有提供[]操作符的重载。但由于链表的特点,它可以以很好的效率支持任意地方的删除和插入。 list没有空间预留习惯,所以每分配一个元素都会从内存中分配,每删除一个元素都会释放它占用的内存. list在哪里添加删除元素性能都很高,不需要移动内存,当然也不需要对每个元素都进行构造与析构了,所以常用来做随机操作容器.但是访问list里面的元素时就开始和最后访问最快访问其它元素都是O(n) ,所以如果需要经常随机访问的话,还是使用其它的好 总结如果你喜欢经常添加删除大对象的话,那么请使用list要保存的对象不大,构造与析构操作不复杂,那么可以使用vector代替list<指针>完全是性能最低的做法,这种情况下还是使用vector<指针>好,因为指针没有构造与析构,也不占用很大内存 3.deque deque是一个双端队列(double-ended queue),也是在堆中保存内容的.它的保存形式如下:[堆1]...[堆2]...[堆3]每个堆保存好几个元素,然后堆和堆之间有指针指向,看起来像是list和vector的结合品. 它支持[]操作符,也就是支持随即存取,可以让你在前面快速地添加删除元素,或是在后面快速地添加删除元素,然后还可以有比较高的随机访问速度,和vector的效率相差无几,它支持在两端的操作:push_back,push_front,pop_back,pop_front等,并且在两端操作上与list的效率也差不多。在标准库中vector和deque提供几乎相同的接口,在结构上它们的区别主要在于这两种容器在组织内存上不一样,deque是按页或块来分配存储器的,每页包含固定数目的元素.相反vector分配一段连续的内存,vector只是在序列的尾段插入元素时才有效率,而deque的分页组织方式即使在容器的前端也可以提供常数时间的insert和erase操作,而且在体积增长方面也比vector更具有效率 总结:vector是可以快速地在最后添加删除元素,并可以快速地访问任意元素list是可以快速地在所有地方添加删除元素,但是只能快速地访问最开始与最后的元素deque在开始和最后添加元素都一样快,并提供了随机访问方法,像vector一样使用[]访问任意元素,但是随机访问速度比不上vector快,因为它要内部处理堆跳转deque也有保留空间.另外,由于deque不要求连续空间,所以可以保存的元素比vector更大,这点也要注意一下.还有就是在前面和后面添加元素时都不需要移动其它块的元素,所以性能也很高。 因此在实际使用时,如何选择这三个容器中哪一个,应根据你的需要而定,一般应遵循下面的原则:1、如果你需要高效的随即存取,而不在乎插入和删除的效率,使用vector2、如果你需要大量的插入和删除,而不关心随即存取,则应使用list3、如果你需要随即存取,而且关心两端数据的插入和删除,则应使用deque。 c++部分的原文出处

优秀的个人博客,低调大师

go 学习笔记之解读什么是defer延迟函数

Go 语言中有个 defer 关键字,常用于实现延迟函数来保证关键代码的最终执行,常言道: "未雨绸缪方可有备无患". 延迟函数就是这么一种机制,无论程序是正常返回还是异常报错,只要存在延迟函数都能保证这部分关键逻辑最终执行,所以用来做些资源清理等操作再合适不过了. 出入成双有始有终 日常开发编程中,有些操作总是成双成对出现的,有开始就有结束,有打开就要关闭,还有一些连续依赖关系等等. 一般来说,我们需要控制结束语句,在合适的位置和时机控制结束语句,手动保证整个程序有始有终,不遗漏清理收尾操作. 最常见的拷贝文件操作大致流程如下: 打开源文件 srcFile, err := os.Open("fib.txt") if err != nil { t.Error(err) return } 创建目标文件 dstFile, err := os.Create("fib.txt.bak") if err != nil { t.Error(err) return } 拷贝源文件到目标文件 io.Copy(dstFile, srcFile) 关闭目标文件 dstFile.Close() srcFile.Close() 关闭源文件 srcFile.Close() 值得注意的是: 这种拷贝文件的操作需要特别注意操作顺序而且也不要忘记释放资源,比如先打开再关闭等等! func TestCopyFileWithoutDefer(t *testing.T) { srcFile, err := os.Open("fib.txt") if err != nil { t.Error(err) return } dstFile, err := os.Create("fib.txt.bak") if err != nil { t.Error(err) return } io.Copy(dstFile, srcFile) dstFile.Close() srcFile.Close() } > 「雪之梦技术驿站」: 上述代码逻辑还是清晰简单的,可能不会忘记释放资源也能保证操作顺序,但是如果逻辑代码比较复杂的情况,这时候就有一定的实现难度了! 可能是为了简化类似代码的逻辑,Go 语言引入了 defer 关键字,创造了"延迟函数"的概念. 无 defer 的文件拷贝 func TestCopyFileWithoutDefer(t *testing.T) { if srcFile, err := os.Open("fib.txt"); err != nil { t.Error(err) return } else { if dstFile,err := os.Create("fib.txt.bak");err != nil{ t.Error(err) return }else{ io.Copy(dstFile,srcFile) dstFile.Close() srcFile.Close() } } } 有 defer 的文件拷贝 func TestCopyFileWithDefer(t *testing.T) { if srcFile, err := os.Open("fib.txt"); err != nil { t.Error(err) return } else { defer srcFile.Close() if dstFile, err := os.Create("fib.txt.bak"); err != nil { t.Error(err) return } else { defer dstFile.Close() io.Copy(dstFile, srcFile) } } } 上述示例代码简单展示了 defer 关键字的基本使用方式,显著的好处在于 Open/Close 是一对操作,不会因为写到最后而忘记 Close 操作,而且连续依赖时也能正常保证延迟时机. 简而言之,如果函数内部存在连续依赖关系,也就是说创建顺序是 A-&gt;B-&gt;C 而销毁顺序是 C-&gt;B-&gt;A.这时候使用 defer 关键字最合适不过. 懒人福音延迟函数 > 官方文档相关表述见 Defer statements 如果没有 defer 延迟函数前,普通函数正常运行: func TestFuncWithoutDefer(t *testing.T) { // 「雪之梦技术驿站」: 正常顺序 t.Log("「雪之梦技术驿站」: 正常顺序") // 1 2 t.Log(1) t.Log(2) } 当添加 defer 关键字实现延迟后,原来的 1 被推迟到 2 后面而不是之前的 1 2 顺序. func TestFuncWithDefer(t *testing.T) { // 「雪之梦技术驿站」: 正常顺序执行完毕后才执行 defer 代码 t.Log(" 「雪之梦技术驿站」: 正常顺序执行完毕后才执行 defer 代码") // 2 1 defer t.Log(1) t.Log(2) } 如果存在多个 defer 关键字,执行顺序可想而知,越往后的越先执行,这样才能保证按照依赖顺序依次释放资源. func TestFuncWithMultipleDefer(t *testing.T) { // 「雪之梦技术驿站」: 猜测 defer 底层实现数据结构可能是栈,先进后出. t.Log(" 「雪之梦技术驿站」: 猜测 defer 底层实现数据结构可能是栈,先进后出.") // 3 2 1 defer t.Log(1) defer t.Log(2) t.Log(3) } 相信你已经明白了多个 defer 语句的执行顺序,那就测试一下吧! func TestFuncWithMultipleDeferOrder(t *testing.T) { // 「雪之梦技术驿站」: defer 底层实现数据结构类似于栈结构,依次倒叙执行多个 defer 语句 t.Log(" 「雪之梦技术驿站」: defer 底层实现数据结构类似于栈结构,依次倒叙执行多个 defer 语句") // 2 3 1 defer t.Log(1) t.Log(2) defer t.Log(3) } 初步认识了 defer 延迟函数的使用情况后,我们再结合文档详细解读一下相关定义. 英文原版文档 > A "defer" statement invokes a function whose execution is deferred to the moment the surrounding function returns,either because the surrounding function executed a return statement,reached the end of its function body,or because the corresponding goroutine is panicking. 中文翻译文档 > "defer"语句调用一个函数,该函数的执行被推迟到周围函数返回的那一刻,这是因为周围函数执行了一个return语句,到达了函数体的末尾,或者是因为相应的协程正在惊慌. 具体来说,延迟函数的执行时机大概分为三种情况: 周围函数执行return > because the surrounding function executed a return statement return 后面的 t.Log(4) 语句自然是不会运行的,程序最终输出结果为 3 2 1 说明了 defer 语句会在周围函数执行 return 前依次逆序执行. func funcWithMultipleDeferAndReturn() { defer fmt.Println(1) defer fmt.Println(2) fmt.Println(3) return fmt.Println(4) } func TestFuncWithMultipleDeferAndReturn(t *testing.T) { // 「雪之梦技术驿站」: defer 延迟函数会在包围函数正常return之前逆序执行. t.Log(" 「雪之梦技术驿站」: defer 延迟函数会在包围函数正常return之前逆序执行.") // 3 2 1 funcWithMultipleDeferAndReturn() } 周围函数到达函数体 > reached the end of its function body 周围函数的函数体运行到结尾前逆序执行多个 defer 语句,即先输出 3 后依次输出 2 1. 最终函数的输出结果是 3 2 1 ,也就说是没有 return 声明也能保证结束前执行完 defer 延迟函数. func funcWithMultipleDeferAndEnd() { defer fmt.Println(1) defer fmt.Println(2) fmt.Println(3) } func TestFuncWithMultipleDeferAndEnd(t *testing.T) { // 「雪之梦技术驿站」: defer 延迟函数会在包围函数到达函数体结尾之前逆序执行. t.Log(" 「雪之梦技术驿站」: defer 延迟函数会在包围函数到达函数体结尾之前逆序执行.") // 3 2 1 funcWithMultipleDeferAndEnd() } 当前协程正惊慌失措 > because the corresponding goroutine is panicking 周围函数万一发生 panic 时也会先运行前面已经定义好的 defer 语句,而 panic 后续代码因为没有特殊处理,所以程序崩溃了也就无法运行. 函数的最终输出结果是 3 2 1 panic ,如此看来 defer 延迟函数还是非常尽忠职守的,虽然心里很慌但还是能保证老弱病残先行撤退! func funcWithMultipleDeferAndPanic() { defer fmt.Println(1) defer fmt.Println(2) fmt.Println(3) panic("panic") fmt.Println(4) } func TestFuncWithMultipleDeferAndPanic(t *testing.T) { // 「雪之梦技术驿站」: defer 延迟函数会在包围函数panic惊慌失措之前逆序执行. t.Log(" 「雪之梦技术驿站」: defer 延迟函数会在包围函数panic惊慌失措之前逆序执行.") // 3 2 1 funcWithMultipleDeferAndPanic() } 通过解读 defer 延迟函数的定义以及相关示例,相信已经讲清楚什么是 defer 延迟函数了吧? 简单地说,延迟函数就是一种未雨绸缪的规划机制,帮助开发者编程程序时及时做好收尾善后工作,提前做好预案以准备随时应对各种情况. 当周围函数正常执行到到达函数体结尾时,如果发现存在延迟函数自然会逆序执行延迟函数. 当周围函数正常执行遇到return语句准备返回给调用者时,存在延迟函数时也会执行,同样满足善后清理的需求. 当周围函数异常运行不小心 panic 惊慌失措时,程序存在延迟函数也不会忘记执行,提前做好预案发挥了作用. 所以不论是正常运行还是异常运行,提前做好预案总是没错的,基本上可以保证万无一失,所以不妨考虑考虑 defer 延迟函数? 延迟函数应用场景 基本上成双成对的操作都可以使用延迟函数,尤其是申请的资源前后存在依赖关系时更应该使用 defer 关键字来简化处理逻辑. 下面举两个常见例子来说明延迟函数的应用场景. Open/Close 文件操作一般会涉及到打开和开闭操作,尤其是文件之间拷贝操作更是有着严格的顺序,只需要按照申请资源的顺序紧跟着defer 就可以满足资源释放操作. func readFileWithDefer(filename string) ([]byte, error) { f, err := os.Open(filename) if err != nil { return nil, err } defer f.Close() return ioutil.ReadAll(f) } Lock/Unlock 锁的申请和释放是保证同步的一种重要机制,需要申请多个锁资源时可能存在依赖关系,不妨尝试一下延迟函数! var mu sync.Mutex var m = make(map[string]int) func lookupWithDefer(key string) int { mu.Lock() defer mu.Unlock() return m[key] } 总结以及下节预告 defer 延迟函数是保障关键逻辑正常运行的一种机制,如果存在多个延迟函数的话,一般会按照逆序的顺序运行,类似于栈结构. 延迟函数的运行时机一般有三种情况: 周围函数遇到返回时 func funcWithMultipleDeferAndReturn() { defer fmt.Println(1) defer fmt.Println(2) fmt.Println(3) return fmt.Println(4) } 周围函数函数体结尾处 func funcWithMultipleDeferAndEnd() { defer fmt.Println(1) defer fmt.Println(2) fmt.Println(3) } 当前协程惊慌失措中 func funcWithMultipleDeferAndPanic() { defer fmt.Println(1) defer fmt.Println(2) fmt.Println(3) panic("panic") fmt.Println(4) } 本文主要介绍了什么是 defer 延迟函数,通过解读官方文档并配套相关代码认识了延迟函数,但是延迟函数中存在一些可能令人比较迷惑的地方. 读者不妨看一下下面的代码,将心里的猜想和实际运行结果比较一下,我们下次再接着分享,感谢你的阅读. func deferFuncWithAnonymousReturnValue() int { var retVal int defer func() { retVal++ }() return 0 } func deferFuncWithNamedReturnValue() (retVal int) { defer func() { retVal++ }() return 0 } 延伸阅读参考文档 Defer_statements go语言的defer语句 Go defer实现原理剖析 go语言 defer 你不知道的秘密! Go语言中defer的一些坑 go defer (go延迟函数) > 如果本文对你有所帮助,不用赞赏直接点赞就是最大的鼓励,顺便关注下微信公众号「 雪之梦技术驿站 」那就更好啦!

优秀的个人博客,低调大师

AliOS Things 3.0应用笔记:http client简单应用

简介 AliOS Things 3.0版本于9月27日在云栖大会正式发布,在新版本中带来了全新的应用开发框架,帮助用户快速构建自己的应用。使用户可以更专注于自身应用的开发。AliOS Things 3.0版本新增加了httpc组件(http 客户端组件),httpc组件支持多种RESTful的API调用,包括GET、POST、PUT、HEAD等,也支持https安全协议。 本示例是基于AliOS Things 3.0应用开发框架做的一个简单的http client应用,通过http API请求获取当前的天气信息。 准备工作 参考 AliOS Things Environment Setup 和 AliOS Things 3.0 应用开发指南指南 搭建好AliOS Things 3.0的应用开发环境。 创建应用工程 参考AliOS Things 3.0 应用开发指南 > AliOS Studio中创建应用工程创建好你的应用工程。 本示例新建的应用工程名称为httpclient_app,选择的开发板为developerkit。 编写应用代码 新建好的应用工程文件如下面所示: .httpclient_app ├── .aos # AliOS Things 3.0 应用工程描述 ├── .vscode # AliOS Studio 配置文件 ├── Config.in # Menuconfig 配置文件 ├── README.md # 应用说明文档 ├── aos.mk # 编译文件 ├── app_main.c # 应用示例代码 └── k_app_config.h # 内核配置 添加http组件 aos-cube会自动根据include的头文件来自动添加组件。 http组件需要用到全局宏:BUILD_AOS,所以需要在aos.mk中额外增加一个全局宏定义: GLOBAL_DEFINES += BUILD_AOS 天气API说明 本示例使用http组件,发送http get请求获取天气数据,天气的API是中国天气网提供的API:http://www.weather.com.cn/data/sk/101210101.html,其中101210101代表是杭州。 使用curl命令可以测试该API接口: $ curl http://www.weather.com.cn/data/sk/101210101.html {"weatherinfo":{"city":"杭州","cityid":"101210101","temp":"24.8","WD":"东北风","WS":"小于3级","SD":"81%","AP":"1000.3hPa","njd":"暂无实况","WSE":"<3","time":"17:50","sm":"2.1","isRadar":"1","Radar":"JC_RADAR_AZ9571_JB"}}% 或者也可以在浏览器打开该链接测试API接口。 使用http组件 本示例主要使用到了http如下接口,详细的http对外提供的接口和参数说明请参考include/network/http/http.h: /* httpc 初始化 */ int8_t http_client_initialize(void); /* 创建一个httpc实例 */ httpc_handle_t httpc_init(httpc_connection_t *settings); /* 销毁一个httpc实例 */ int8_t httpc_deinit(httpc_handle_t httpc); /* 发送http请求 */ int8_t httpc_send_request(httpc_handle_t httpc, int8_t method, char *uri, const char *hdr, const char *content_type, const char *param, uint16_t param_len); /* 构建http请求header */ int32_t httpc_construct_header(char *buf, uint16_t buf_size, const char *name, const char *data); /* 等待接口http返回 */ int32_t httpc_recv_response(httpc_handle_t httpc, uint8_t *rsp, uint32_t rsp_size, http_rsp_info_t *info, uint32_t timeout); 完整源码 本示例应用的工程源码点击这里下载。 注意:需要更改app_main.c中的WIFI_SSID 和 WIFI_PASSWD 为你的路由器信息。 aos.mk: NAME := httpclient_app $(NAME)_MBINS_TYPE := app $(NAME)_VERSION := 1.0.0 $(NAME)_SUMMARY := httpclient_app $(NAME)_SOURCES += app_main.c GLOBAL_DEFINES += BUILD_AOS GLOBAL_INCLUDES += ./ $(NAME)_COMPONENTS_CUSTOMIZED := http yloop $(NAME)_COMPONENTS += $($(NAME)_COMPONENTS_CUSTOMIZED) app_main.c: /* * Copyright (C) 2015-2017 Alibaba Group Holding Limited */ #include <stdio.h> #include <aos/kernel.h> #include <aos/yloop.h> #include <http.h> #include <network/network.h> #define WIFI_SSID "aiot" #define WIFI_PASSWD "12345678" #define REQ_BUF_SIZE 2048 #define RSP_BUF_SIZE 4096 #define HTTP_UP_HDR_SIZE 128 /* weather api hostname */ #define WEATHER_HOSTNAME "http://www.weather.com.cn/" /* weather api uri */ #define WEATHER_URI "data/sk/101210101.html" static httpc_handle_t httpc_handle = 0; static httpc_connection_t settings; /* buffer for send & receive */ static uint8_t rsp_buf[RSP_BUF_SIZE] = {0}; static uint8_t req_buf[REQ_BUF_SIZE] = {0}; /* send http get request */ char *get_weather(void) { int fd; char hdr[HTTP_UP_HDR_SIZE] = {0}; int32_t ret; http_rsp_info_t rsp_info; http_client_initialize(); /* create socket */ if ((fd = socket(AF_INET, SOCK_STREAM, 0)) < 0) { printf("alloc socket fd fail\n"); goto exit; } memset(&settings, 0, sizeof(settings)); settings.socket = fd; settings.server_name = WEATHER_HOSTNAME; settings.req_buf = req_buf; settings.req_buf_size = REQ_BUF_SIZE; /* httpc initialization */ if ((httpc_handle = httpc_init(&settings)) == 0) { printf("http session init fail\n"); close(fd); goto exit; } /* construct httc header: set accept content type */ if ((httpc_construct_header( hdr, HTTP_UP_HDR_SIZE, "Accept", "text/xml,text/javascript,text/html,application/json")) < 0) { printf("http construct header fail\n"); goto exit; } /* send get request */ if ((httpc_send_request(httpc_handle, HTTP_GET, WEATHER_URI, hdr, "application/json", NULL, 0)) != HTTP_SUCCESS) { printf("httpc_send_request fail\n"); goto exit; } /* get response */ if ((httpc_recv_response(httpc_handle, rsp_buf, RSP_BUF_SIZE, &rsp_info, 10000)) < 0) { printf("httpc_recv_response fail\n"); goto exit; } printf("http session %x, buf size %d bytes, recv %d bytes data", httpc_handle, RSP_BUF_SIZE, rsp_info.rsp_len); // if (rsp_info.rsp_len > 0) { // printf("%s", rsp_buf); // } if (rsp_info.message_complete) { // printf("message_complete"); close(settings.socket); httpc_deinit(httpc_handle); return rsp_info.body_start; } exit: close(settings.socket); httpc_deinit(httpc_handle); return NULL; } /* task for get weather */ static void get_weather_task(void *arg) { char *weather_data = NULL; /* get weather data */ if((weather_data = get_weather()) != NULL){ aos_msleep(200); printf("********************** weather data **********************\r\n"); printf("%s\r\n", weather_data); printf("**********************************************************\r\n"); return; } printf("weather request error\r\n"); } /* wifi event */ static void wifi_service_event(input_event_t *event, void *priv_data) { static char ip[16] = {0}; static int get_weather_started = 0; if (event->type != EV_WIFI && event->code != CODE_WIFI_ON_GOT_IP) { return; } netmgr_wifi_get_ip(ip); /* start up only once */ if (get_weather_started == 1) { return; } /* check if ip is available */ if (0 == strcmp(ip, "0.0.0.0")) { printf("ip invailable\n"); return; } get_weather_started = 1; printf("wifi connected, ip:%s\n", ip); aos_task_new("get_weather", get_weather_task, NULL, 1024 * 4); } /* task for connect wifi */ static void wifi_connect(void *arg) { /* network init */ netmgr_init(); netmgr_start(false); aos_msleep(100); /* connect to wifi */ printf("\r\nConnecting to wifi: ssid:[%s], passwd:[%s]\r\n", WIFI_SSID, WIFI_PASSWD); netmgr_connect(WIFI_SSID, WIFI_PASSWD, 10 * 1000); } /**********************user code*************************/ int application_start(int argc, char *argv[]) { #ifdef WITH_SAL sal_add_dev(NULL, NULL); sal_init(); #endif /* register wifi event */ aos_register_event_filter(EV_WIFI, wifi_service_event, NULL); aos_task_new("wifi_connect", wifi_connect, NULL, 2048); /* loop for schedule */ aos_loop_run(); } 编译运行 点击编译和烧录。运行后,在串口日志最后面就能看的获取到的天气信息。 运行效果: [ 0.050]<A>AOS sensor: drv_acc_st_lsm6dsl_init successfully [ 0.060]<A>AOS sensor: drv_gyro_st_lsm6dsl_init gyro do not need reset [ 0.070]<A>AOS sensor: drv_gyro_st_lsm6dsl_init successfully [ 0.080]<A>AOS sensor: drv_als_liteon_ltr553_init successfully [ 0.090]<A>AOS sensor: drv_ps_liteon_ltr553_init successfully [ 0.100]<A>AOS sensor: drv_baro_bosch_bmp280_init successfully [ 0.110]<A>AOS sensor: drv_mag_memsic_mmc3680kj_init successfully [ 0.120]<A>AOS sensor: drv_humi_sensirion_shtc1_init successfully [ 0.130]<A>AOS sensor: drv_temp_sensirion_shtc1_init successfully Welcome to AliOS Things [ 0.150]<E>sal_wifi Uart dev is not configured, use the default cfg uart 1 enter uart_receive_start_dma instance 0x40004800ip invailable Connecting to wifi: ssid:[aiot], passwd:[12345678] wifi connected, ip:192.168.43.111 [[hhttttppcc]][[000088665500]] hhttttppcc__sseenndd__rreeqquueesstt,, sseenndd rreeqquueesstt hheeaaddeerr vGoErTk s/pdaactea//gsikt/h1u0b1/2A1l0i1O0S1-.Thhtimnlg sH/TbToPa/r1d./1d 2Ulsoepre-rAkgietn/ta:o sA/lbioOaSr-dH_TcTlPi-.Ccl i2e1n6t 1 Cache-Control: no-cache Connection: close Host: www.weather.com.cn Accept: text/xml,text/javascript,text/html,application/json Content-Type: application/json socket 0, len 238 [httpc][009130] httpc_send_request, connect 0 [httpc][009160] httpc_send_request, send 238, ret 0 [httpc][019170] on_message_begin, HTTP response (headers), method GET [httpc][019170] on_status, HTTP response status OK [httpc][019180] print_header_field, len 4, Date [httpc][019190] print_header_field, len 29, Wed, 09 Oct 2019 07:32:13 GMT [httpc][019200] print_header_field, len 12, Content-Type [httpc][019200] print_header_field, len 9, text/html [httpc][019210] print_header_field, len 17, Transfer-Encoding [httpc][019220] print_header_field, len 7, chunked [httpc][019220] print_header_field, len 10, Connection [httpc][019230] print_header_field, len 5, close [httpc][019240] print_header_field, len 6, Server [httpc][019240] print_header_field, len 9, openresty [httpc][019250] print_header_field, len 16, X-Xss-Protection [httpc][019260] print_header_field, len 1, 1 [httpc][019260] print_header_field, len 10, Set-Cookie [httpc][019270] print_header_field, len 8, HttpOnly [httpc][019280] print_header_field, len 3, Age [httpc][019280] print_header_field, len 4, 2068 [httpc][019290] print_header_field, len 5, X-Via [httpc][019300] print_header_field, len 125, 1.1 PSbjsdBGPvu28:10 (Cdn Cache Server V2.0), 1.1 zhdx147:10 (Cdn Cache Server V2.0), 1.1 huadxin69:7 (Cdn Cache Server V2.0) [httpc][019320] on_headers_complete, headers complete [httpc][019320] on_message_complete, HTTP GET response (complete) http session 20002298, buf size 4096 bytes, recv 578 bytes data[ 19.340]<E>sal_wifi HAL_SAL_Close 778 failed ********************** weather data ********************** {"weatherinfo":{"city":"杭州","cityid":"101210101","temp":"24.8","WD":"东北风","WS":"小于3级","SD":"81%","AP":"1000.3hPa","njd":"暂无实况","WSE":"<3","time":"17:50","sm":"2.1","isRadar":"1","Radar":"JC_RADAR_AZ9571_JB"}} ********************************************************** 参考文档 AliOS Things 3.0 应用开发指南 使用AliOS Things3.0 快速构建用户应用BlinkAPP

优秀的个人博客,低调大师

Linux零碎笔记, 及一些命令

001.gui与tui gui, 完全的图形界面. tui, 终端下的图形界面. 002.补全命令 输入前缀, 按一次Tab. 若前缀不唯一, 按2次Tab, 出现相关命令列表. 003.RHEL7.2实现上网功能 1.固定的可用联网IP地址 2.关闭防火墙 3.关闭selinux 4.光盘自动挂载 5.配置好本地yum源 004.linux系统安装分区(标准分区) 1.boot分区:引导分区(启动系统用的), grub(引导器), 内核文件 200M 2.swap分区:内存扩展分区, 一般最多8G或16G 1000M 3./ 根:所有文件的根 10G 4.sda:linux下的第一个磁盘 5.RHEL7使用xfs文件系统, RHEL6使用ext4文件系统, Win7/10使用NTFS文件系统 005.手动配置以太网_IPv4设置 1.ip地址:192.168.0.71(网段192.168一样, 且是没用过的ip) 2.子网掩码:24 3.网关:192.168.0.1 4.DNS服务器:8.8.8.8(或114.114.114.114) 006.ubuntu第一次切换到root用户失败 1.为root设置一个root密码 sudo passwd root // 之后会提示要输入root用户的密码, 连续输入root密码 2.使用 su,并按照提示输入root密码, 就可以在终端中切换成超级管理员用户身份了! 3.设置后,以后就可以直接root登录了 007.ubuntu安装yum 1.安装了build-essential: apt-get install build-essential 2.安装yum: apt-get install yum 008.Xshell由于权限问题无法上传文件到linux 给lunux的文件夹设置权限, 例: 给/usr下的java文件夹添加上传权限 chmod -R 777 /usr/java // -R表示包括子文件夹 添加权限后,在/usr目录下输入: ll // 显示/usr/java这一个文件夹drwxrwxrwx(之前为drwxr-xr-x),并且有绿色阴影 Ubuntu chmod 命令可以用来修改文件或文件夹的读写权限, 命令有两种使用方式: (1)chmod [ u / g / o / a ] [ + / - / = ] [ r / w / x ] file, 其中: u表示User, 是文件的所有者 g表示跟User同Group的用户 o表示Other, 即其他用户 a表示ALL, 所有用户 +表示增加权限 -表示取消权限 =表示取消之前的权限, 并给予唯一的权限 r表示Read, 即读文件 w表示Write, 即写文件 x表示运行文件 file表示文件的路径, 如ubandy-rest/job/views.py For example: chmod u+rw ubandy-rest/job/views.py 2)chmod [xyz] file 其中, x, y, z分别表示数字(最大不超过7), 并分别对应User、Group、Other x, y, z的值由r(r=4), w ( w=2 ), x ( x=1 )来确定 For example:chmod 765 ubandy-rest/authentication/models.py 当然, 你也可以使用通配符 ‘*’, 来设置当前路径下的所有文件的权限 For example: 假如, 当前你的路径下有文件:1.txt, 2.html, 3.py 使用命令:chmod 777 * 可以同时设置上述三个文件的权限为rwx 如果你要修改整个文件夹的权限, 比如你有一个文件夹WhoJoy, 你想修改这个文件夹(包括内部的所有文件)的权限, 那么 可以使用命令:chmod -R 777 WhoJoy/ 其中:-R表示以递归整个文件夹中的子文件 009.ubuntu中apt命令是什么的缩写 the Advanced Packaging Tool 010.Xshell命令行的锁定/解除 Ctrl + q 011.Xshell无法连接到虚拟机,可能原因 1.防火墙未打开22端口 2.未安装openssh-server 3.虚拟机无法联网 012.ubuntu标准磁盘分区:21.5GB primary /boot 2.0GB f ext4 primary swap 2.5GB f swap primary /home 7.0GB f ext4 logical / 10.0GB f ext4 013.ubuntu查看所有组和用户 cat /etc/group sudo cat /etc/shadow 014.查看ip网址 https://ip.cn 或者 https://ipinfo.io 015.ubuntu下载ping和ifconfig命令 apt install iputils-ping apt install net-tools 016.ubuntu16.04关闭/开启mysql开机启动 // 禁止启动 sudo systemctl disable mysql # 开机启动 sudo systemctl enable mysql 017.查看一个目录下所有文件的数量(包括子目录下的文件,只算文件,不算目录) ls -lR|grep "^-"|wc -l 018.ubuntu设置mysql不区分大小写 // 在/etc/mysql/mysql.conf.d/mysqld.cnf文件中加一行代码: lower_case_table_names=1 019.关机 init 0 020.虚拟机切换到主机 Ctrl + Alt 021.清屏 Ctrl + l 022.取消某一操作 Ctrl + c 023.虚拟机BIOS设置 开机按F2(或虚拟机_电源_打开电源进入固件) 024.查看ip ifconfig 025.编辑文件 vim 026.保存退出 :wq 027.不保存退出 :q! 028.撤销 Esc + u 029.进入插入模式 i 030.复制粘贴 插入模式下选中一段文本,按下鼠标滚轮 031.重启 reboot(或者sudo shutdown -r now) 032.查看当前登录用户 whoami 033.切换用户 su - root(用户名) 034.进入全屏 VMware进入全屏Ctrl + Alt + Enter Xshell进入全屏Alt + Enter 035.创建新的文件 touch a.txt 036.复制一个文件夹下所有文件(包括子文件夹)到另一个文件夹下: cp -r /fangjian/tomcat8_new/webapps/ROOT/* /fangjian/bak/oa_20170905_test/ROOT 037.删除一个文件夹下所有文件(包括子文件夹) rm -rf /fangjian/bak/oa_20170905_test/* // 不加/*则删父文件夹 038.查看Linux是32位还是64位 sudo uname -m // i686表示是32位,x86_64表示是64位 039.解压压缩文件 tar -zxvf test.tar.gz 040.创建文件夹 mkdir java 041.为过长的目录建立一个链接 ln -s /usr/java/jdk1.8.0_60/ /usr/jdk 042.查看某进程名的PID ps -ef | grep java 043.根据端口号查看该端口号被谁占用 lsof -i:8080 // 若命令用不了,则需: yum -y install lsof或者: netstat -apn | grep 8080 044.根据进程PID查看该进程占用的端口号 netstat -nap | grep 2703 // 若命令用不了,则需: yum -y install net-tools 045.根据进程PID杀掉该进程 kill -9 2703 046.纯文本形式访问网址 elinks -dump http://www.baidu.com // 若命令用不了,则需: yum -y install elinks 047.RHEL7查看已启动的服务列表 systemctl list-unit-files|grep enabled 048.关闭虚拟机 shutdown -h now 049.Xshell锁屏 Ctrl+s 解锁: Ctrl+q 050.登录mysql mysql -h localhost -u root -proot 051.查看jdk安装路径 which java 或者: echo $JAVA_HOME 052.查看tomcat版本 进入tomcat的bin下执行sh version.sh 053.zip压缩文件 zip -r fileName.zip 文件夹名 解压缩: unzip fileName.zip 054.查看ubuntu版本 sudo lsb_release -a 055.复制一个文件夹下所有文件(包括子文件夹的所有文件但不复制目录,不考虑文件重名)到另一个文件夹下: find /home/dailin/ -type f -exec cp {} /home/c1 ; 056.显示所有ufw应用的配置 sudo ufw app list 057.vim快捷键 01.光标跳转到页面第一行: gg02.光标跳转到页面最后一行: Shift + g03.删除光标所在行: dd04.删除光标所在的向下n行: ndd n表示数字 05.清空文本:先执行:gg 再执行:d + (Shift + g)06.复制光标所在的行: yy07.复制光标所在的向下n行: nyy n表示数字08.将已复制的数据粘贴在光标的下一行: 小p表示09.将已复制的数据粘贴在光标的上一行: 大P10.撤销上一步操作: u (相当于windws的Ctrl + z)11.与u相反, 回到后一步操作: ctrl+r (相当于windws的Ctrl + y)12.重复前一个操作: . 点13.跳转到某一指定行: :12 跳转到第12行14.键入/后, 光标进入VIM底部的命令行, 这时就可以输入以/为开始的/搜索命令,按n搜索下一个,按N搜索上一个 058. 查看文件占用空间大小 du -ah -d 0 -a代表所有文件-h代表加单位-d 0代表: 只深入到第n层目录,若无此属性,则包含所有子目录 059.ubuntu查看磁盘空间 df -h 060.ubuntu永久修改主机名 1、查看主机名在Ubuntu系统中, 快速查看主机名有多种方法:其一, 打开一个GNOME终端窗口, 在命令提示符中可以看到主机名, 主机名通常位于“@”符号后;其二, 在终端窗口中输入命令:hostname或uname –n, 均可以查看到当前主机的主机名. 2、临时修改主机名命令行下运行命令:“hostname 新主机名”其中“新主机名”可以用任何合法字符串来表示. 不过采用这种方式, 新主机名并不保存在系统中, 重启系统后主机名将恢复为原先的主机名称. 例子:hostname ubuntu-temp这样主机名字就临时被修改为ubuntu-temp, 但是终端下不会立即显示生效后的主机名, 重开一个终端窗口(通过ssh连接的终端需要重新连接才可以); 3、永久修改主机名在Ubuntu系统中永久修改主机名也比较简单. 主机名存放在/etc/hostname文件中, 修改主机名时, 编辑hostname文件, 在文件中输入新的主机名并保存该文件即可. 重启系统后, 参照上面介绍的快速查看主机名的办法来确认主机名有没有修改成功. 值得指出的是, 在其它Linux发行版中, 并非都存在/etc/hostname文件. 如Fedora发行版将主机名存放在/etc/sysconfig/network文件中. 所以, 修改主机名时应注意区分是哪种Linux发行版. 4、/etc/hostname与/etc/hosts的区别/etc/hostname中存放的是主机名, hostname文件的一个例子:paulandcode /etc/hosts存放的是域名与ip的对应关系, 域名与主机名没有任何关系, 你可以为任何一个IP指定任意一个或多个名字, hosts文件的一个例子:(IP地址 hostname aliases) aliases可选127.0.0.1 localhost paulandcode127.0.1.1 v-jiwan-ubuntu 061.linux的bash命令一般存放在/sbin, /bin, /usr/bin,这几个目录中 062.ubuntu 显示相对路径 打开 home/paul/.bashrc 找到(可能有多处): PS1='${debian_chroot:+($debian_chroot)}\u@\h:\w\$ ' 修改将小写w改为大写W保存 执行source home/paul/.bashrc 063.Ubuntu的add-apt-repository: command not found sudo apt-get install software-properties-common python-software-properties 064.创建用户 adduser paul 创建用户 passwd paul 给已创建的用户testuser设置密码 userdel paul 用户名删除用户 给paul用户增加所有权限: vim /etc/sudoers 在root ALL=(ALL:ALL) ALL这一行的下面增加如下代码: paul ALL=(ALL:ALL) ALL 065.给用户增加sudu权限 1) 进入到root用户下. 2)添加文件的写权限. 也就是输入命令"chmod u+w /etc/sudoers". 3)编辑该文件,找到这一 行:"root ALL=(ALL) ALL"在起下面添加"yourName ALL=(ALL) ALL" 4)撤销文件的写权限. 也就是输入命令"chmod u-w /etc/sudoers" 066.删除除了某几个文件之外的所有文件 例:删除A文件夹下除了a文件夹和b.txt文件的其他所有文件和文件夹 rm -rf A/!(a|b.txt) 不过一般bash中运行后会提示 “-bash: !: event not found ” 可以通过运行shopt -s extgolb来解决. 如下: [root@localhost abc]# rm -f !(a) -bash: !: event not found [root@localhost abc]# shopt -s extglob [root@localhost abc]# rm -f !(a) [root@localhost abc]# ls a 067.linux脚本加入延时等待 默认以秒为单位,以后接时间的单位, 可以以m表示分钟, h表示小时, d表示天数 sleep 5 sleep 0.005 sleep 3m 068.awk -F ':' '{print $1"\t"$3}', 以冒号为分隔符后把第1,3列,以t分隔输出 例: kill掉第一个java进程id netstat -apn |grep java |awk '{print $7}' |xargs |awk -F '/' '{print $1}' |xargs kill -9 069.查看文件夹的目录结构 sudo tree /etc/nginx 070. Linux上的MySQL设置区分大小写 在/etc/mysql/mysql.conf.d/mysqld.cnf中最后一行加入如下代码: lower_case_table_names=1 071.Ubuntu安装MySQL sudo apt update sudo apt install mysql-server mysql-client 072. Linux下使用命令行导入, 导出MySQL数据库 (1) 导出数据库1> 只导出表结构, 格式: mysqldump -u用户名 -p密码 -d 数据库名 > 文件名.sql /usr/local/mysql/bin/mysqldump -uroot -p -d abc > file.sql 若-p后不加密码, 则敲回车后会提示输入密码 2> 导出表结构和数据, 格式: mysqldump -u用户名 -p密码 数据库名 > 文件名.sql /usr/local/mysql/bin/mysqldump -uroot -p abc > file.sql (2) 导入数据库1> 使用MySQL的Bash命令, 格式: mysql -u用户名 -p密码 数据库名 < 文件名.sql mysql -uroot -p abc < file.sql 2> 进入MySQL执行命令a.进入MySQL mysql -uroot -p b.选择数据库 use abc; c.设置数据库编码, 这个很关键, 否则会乱码 set names utf8; d.导入数据 source /home/abc/file.sql; 073. Linux重启后Tomcat自动启动 只需更改一个文件后重启即可: /etc/rc.local在文件结尾加入如下代码 export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64 export PATH=$JAVA_HOME/bin:$PATH export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export CATALINA_HOME=/home/paul/apache-tomcat-9.0.0.M26 # tomcat自启动 /home/paul/apache-tomcat-9.0.0.M26/bin/startup.sh 074. 虚拟机上的Tomcat无法被主机访问 防火墙原因, 允许访问8080端口: sudo firewall-cmd --zone=public --add-port=8080/tcp --permanent sudo firewall-cmd --reload 如果不使用“--permanent”标记, 把么防火墙规则在重启后会失效. 075. Linux上的MySQL设置区分大小写 在/etc/mysql/mysql.conf.d/mysqld.cnf中最后一行加入如下代码: lower_case_table_names=1 076. Linux虚拟机桥接联网的配置文件 Linux虚拟机桥接联网时需要如下两个配置文件: 1. /etc/resolv.conf nameserver 8.8.8.8 2. /etc/sysconfig/network-scripts/ifcfg-eno16777736 TYPE="Ethernet" BOOTPROTO="static" IPADDR="192.168.0.66" NETWORK="255.255.255.0" GATEWAY="192.168.0.1" DNS1="8.8.8.8" DEFROUTE="yes" PEERDNS="yes" PEERROUTES="yes" IPV4_FAILURE_FATAL="no" IPV6INIT="yes" IPV6_AUTOCONF="yes" IPV6_DEFROUTE="yes" IPV6_PEERDNS="yes" IPV6_PEERROUTES="yes" IPV6_FAILURE_FATAL="no" NAME="eno16777736" UUID="96aa40e3-de9e-4074-b4ad-760d28ae2b66" DEVICE="eno16777736" ONBOOT="yes" 077. 如何Ping固定端口号 1. Windows 需要选择: 控制面板 --> 程序 --> 启动或关闭Windows功能, 在Telnet客户端和Telnet服务端打勾. 被Ping的机器需要服务端, 要Ping的机器需要客户端. 2. Linux若没有自带telnet, 需要安装客户端和服务端 3. 连接命令: telnet 127.0.0.1 8080 注意: IP和端口号之间是空格, 不是冒号.

优秀的个人博客,低调大师

《码出高效》学习笔记与书中错误记录

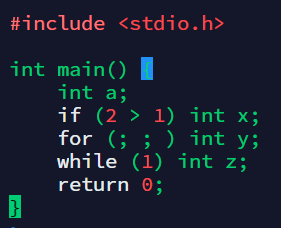
今天在阅读《码出高效》的时候看到了一个问题,我也是第一次知道,而且有点颠覆我的认知。所以做了一些测试,并记录下来。 然而测试的结果发现,好像事实并不如书中说的那么简单。 问题是这样的: if (true) int x; for (; ; ) int y; while (true) int z; 这三句话,能通过编译吗,如果能,会给出 Warning 吗,如果不能,那么错误信息是什么。 书中给出的答案是,不能通过编译,会给出 Declaration not allowed here 编译错误信息,并对此,书中解释为: 单语句在没有加大括号的情况下,声明的变量不可能再被使用,编译器认为没有任何意义。 Every declaration that introduces a name has a scope, in which they can be used. 我做了一些测试,发现事情好像并不是那么简单。 我一开始也是这样认为的。我本来以为,至少应该通过编译,最多是给一个 Warning 说 variable is never used。 我比较好奇,除了 Java,其他语言会不会有同样的编译错误。 首先是是测试 C、C++、Java 是不是都对这句话有相同的结果。 先来看 C,测试环境是 CentOS 7.3 x64,GCC 版本是 gcc version 4.8.5 20150623 (Red Hat 4.8.5-28) (GCC)。 C,不管是 ANSI C 还是 C99,都无法通过编译,直接给出 Error。 error: expected expression before ‘int’ 如果加上大括号,那么能够通过编译,遇到大家常见的 Warning。 warning: unused variable ‘x’ [-Wunused-variable] 同样的结果在环境中(我测试环境是 CodeBlocks,Windows)得到了相同的结果。 我相信,CLion 等 IDE 也有一样的结果,如果没有,那么可能是 IDE 帮忙优化了,毕竟有些时候,写 C 代码漏 include 一些头文件,编译和运行的结果也是正确的(IDE 帮你自动补上了)。 原因稍后分析,下面继续测试。 C++。 结果是,编译通过,给出 Warning。 事实上与代码无关,即使是对刚才的 .c 文件,只要使用 g++ 编译器,也是通过的。 再来看 Java。 public class Main { public static void main(String args[]) { if (true) int jxtxzzw; } } 如果是 Eclipse,直接给出错误。 强行运行,编译失败,无法运行。 Unresolved compilation problem: Syntax error on token “)”, Statement expected after this token at … 如果是 IDEA,会给出编译错误信息。 Declaration not allowed here 至于为什么 C 就不行呢?难道 C 的语法什么地方说了这是不合法的吗?闻所未闻啊? 但是既然 C 的编译器说不行,那肯定是 C 的哪个标准说了这是不合法的,如果这是真的,那么就不是作用域的问题,而是语法、文法的问题。 换句话说,如果 if (true) {int x;} 是合法的,那为什么 if (true) int x; 就不符合语法呢? 我查阅了很多资料(链接见文末),最后找到一个比较信服的答案——确实,根据 C 标准,这就是错的,彻底的语法错误。 首先来澄清一个概念,if 条件句后面,必须跟一个语句。 int x 是一个声明,Declaration。 int x = 10; 是一个定义,Definition。 {int x;} 或者 {int x = 10;} 由于有了 {},是一条语句,Statement。 这是 3 个完全不同的概念,也是绝大多数程序员从一开始就分不清的,而且也始终分不清,从来分不清。 所以,现在的问题的答案就很显然了,C 要求 if 后面是一条语句,然而文章一开始那种写法,是 Declaration,不是 Statement,所以语法就是错的。 这也印证了那句 Error:expected expression,我需要一个表达式。 表达式 Expression,显然是一句语句 Statement。 同时,这与 Eclipse 的报错信息是一致的——if 后面需要一个 Statement。( Statement expected after this token at … ) 如果从这个角度考虑,那么,IDEA 的错误提示,Declaration not allowed 就不应该从变量作用域的角度考虑这里的变量声明不合法,而是应该理解成,这是一个 Declaration,而我需要一个 Statement,所以 Declaration 在这里是不被允许的。 这是一个 Declaration,而我需要一个 Statement,所以 Declaration 在这里是不被允许的 至于为什么 g++ 就可以,我想这个问题,可能和 为什么有些 IDE 这么写就可以通过编译,我猜想的是(是的,只是猜想,没有验证过),恐怕是这个编译器,包括绝大多数的 IDE,都自动优化了这个地方,把所有的 if 等语句后面,默认当作套上了大括号在处理,即使是单语句,也假装有了一个大括号作用域,然后再编译的。 所以,有些 gcc 的编译器,也有可能可以,但是从我的测试情况来看,MinGW、Cygwin、Windows、Window 的 Ubuntu 子系统、CentOS 下,gcc 都会给出 error。 I guess the counter-intuitive part of the question is: if this is correct C:if (a == 1) { int b = 10;}then why is this not also correct C?if (a == 1) int b = 10;I mean, a one-line conditional if statement should be fine either with or without braces, right?The answer lies in the grammar of the if statement, as defined by the C standard. The relevant parts of the grammar I’ve quoted below. > Succinctly: the int b = 10 line is a declaration, not a statement, and the grammar for the if statement requires a statement after the conditional that it’s testing. But if you enclose the declaration in braces, it becomes a statement and everything’s well.见: http://www.open-std.org/jtc1/sc22/wg14/www/docs/n1570.pdf 以及 https://www.quora.com/What-does-error-expected-expression-before-int-mean-in-C

优秀的个人博客,低调大师

Java学习笔记——dubbo服务之底层通讯协议Protocol

我们先来找到通讯协议的入口点吧。通过Protocol接口查找通讯协议入口点,我们根据接口的export方法搜索发现入口了,在ServiceConfig的doExportUrlsFor1Protocol方法,如下图: 然后我们进入 protocol.export(invoker)方法发现有很多实现类,根据spi(不懂的请看之前写的容器篇)查看配置文件能找到如下 registry=com.alibaba.dubbo.registry.integration.RegistryProtocol dubbo=com.alibaba.dubbo.rpc.protocol.dubbo.DubboProtocol//这个是默认的,我们在Protocol接口上可以看到spi的注解 filter=com.alibaba.dubbo.rpc.protocol.ProtocolFilterWrapper listener=com.alibaba.dubbo.rpc.protocol.ProtocolListenerWrapper mock=com.alibaba.dubbo.rpc.support.MockProtocol injvm=com.alibaba.dubbo.rpc.protocol.injvm.InjvmProtocol rmi=com.alibaba.dubbo.rpc.protocol.rmi.RmiProtocol hessian=com.alibaba.dubbo.rpc.protocol.hessian.HessianProtocol com.alibaba.dubbo.rpc.protocol.http.HttpProtocol com.alibaba.dubbo.rpc.protocol.webservice.WebServiceProtocol thrift=com.alibaba.dubbo.rpc.protocol.thrift.ThriftProtocol memcached=com.alibaba.dubbo.rpc.protocol.memcached.MemcachedProtocol redis=com.alibaba.dubbo.rpc.protocol.redis.RedisProtocol rest=com.alibaba.dubbo.rpc.protocol.rest.RestProtocol 进入DubboProtocol.export(Invoker<T> invoker)方法里面有个 openServer(url); 代码: privatevoidopenServer(URLurl){ //findserver. Stringkey=url.getAddress(); //client也可以暴露一个只有server可以调用的服务。 booleanisServer=url.getParameter(Constants.IS_SERVER_KEY,true); if(isServer){ ExchangeServerserver=serverMap.get(key); if(server==null){ serverMap.put(key,createServer(url));//createServer是创建服务 }else{ //server支持reset,配合override功能使用 server.reset(url); } } } 继续进入createServer,上源码 privateExchangeServercreateServer(URLurl){ //默认开启server关闭时发送readonly事件 url=url.addParameterIfAbsent(Constants.CHANNEL_READONLYEVENT_SENT_KEY,Boolean.TRUE.toString()); //默认开启heartbeat url=url.addParameterIfAbsent(Constants.HEARTBEAT_KEY,String.valueOf(Constants.DEFAULT_HEARTBEAT)); Stringstr=url.getParameter(Constants.SERVER_KEY,Constants.DEFAULT_REMOTING_SERVER); if(str!=null&&str.length()>0&&!ExtensionLoader.getExtensionLoader(Transporter.class).hasExtension(str)) thrownewRpcException("Unsupportedservertype:"+str+",url:"+url); url=url.addParameter(Constants.CODEC_KEY,Version.isCompatibleVersion()?COMPATIBLE_CODEC_NAME:DubboCodec.NAME); ExchangeServerserver; try{ server=Exchangers.bind(url,requestHandler); }catch(RemotingExceptione){ thrownewRpcException("Failtostartserver(url:"+url+")"+e.getMessage(),e); } str=url.getParameter(Constants.CLIENT_KEY); if(str!=null&&str.length()>0){ Set<String>supportedTypes=ExtensionLoader.getExtensionLoader(Transporter.class).getSupportedExtensions(); if(!supportedTypes.contains(str)){ thrownewRpcException("Unsupportedclienttype:"+str); } } returnserver; } dubbo从要暴漏的服务的URL中取得相关的配置(host,port等)进行服务端server的创建,同上面的server = Exchangers.bind(url, requestHandler) 正式创建服务。 所以基本的创建步骤是 export() --> openServer() --> createServer() --> server = Exchangers.bind(url, requestHandler); 我们进行来看 Exchangers.bind(url, requestHandler) 源码: publicstaticExchangeServerbind(URLurl,ExchangeHandlerhandler)throwsRemotingException{ if(url==null){ thrownewIllegalArgumentException("url==null"); } if(handler==null){ thrownewIllegalArgumentException("handler==null"); } url=url.addParameterIfAbsent(Constants.CODEC_KEY,"exchange"); returngetExchanger(url).bind(url,handler); } 然后通过getExchanger(url).bind(url, handler)的bing进入 HeaderExchanger类 publicExchangeServerbind(URLurl,ExchangeHandlerhandler)throwsRemotingException{ returnnewHeaderExchangeServer(Transporters.bind(url,newDecodeHandler(newHeaderExchangeHandler(handler)))); } 在进入Transporters类的bing的 publicstaticServerbind(URLurl,ChannelHandler...handlers)throwsRemotingException{ if(url==null){ thrownewIllegalArgumentException("url==null"); } if(handlers==null||handlers.length==0){ thrownewIllegalArgumentException("handlers==null"); } ChannelHandlerhandler; if(handlers.length==1){ handler=handlers[0]; }else{ handler=newChannelHandlerDispatcher(handlers); } returngetTransporter().bind(url,handler); } 通过bing可以知道他讲调用:GrizzlyTransporter,MinaTransporter,NettyTransporter 通过spi默认是调用NettyTransporter 到这里我们基本明白dubbo的通讯默认是交给了netty来处理, 我们在看下doOPen方法 @Override protectedvoiddoOpen()throwsThrowable{ NettyHelper.setNettyLoggerFactory(); ExecutorServiceboss=Executors.newCachedThreadPool(newNamedThreadFactory("NettyServerBoss",true)); ExecutorServiceworker=Executors.newCachedThreadPool(newNamedThreadFactory("NettyServerWorker",true)); ChannelFactorychannelFactory=newNioServerSocketChannelFactory(boss,worker,getUrl().getPositiveParameter(Constants.IO_THREADS_KEY,Constants.DEFAULT_IO_THREADS)); bootstrap=newServerBootstrap(channelFactory); finalNettyHandlernettyHandler=newNettyHandler(getUrl(),this); channels=nettyHandler.getChannels(); //https://issues.jboss.org/browse/NETTY-365 //https://issues.jboss.org/browse/NETTY-379 //finalTimertimer=newHashedWheelTimer(newNamedThreadFactory("NettyIdleTimer",true)); bootstrap.setPipelineFactory(newChannelPipelineFactory(){ publicChannelPipelinegetPipeline(){ NettyCodecAdapteradapter=newNettyCodecAdapter(getCodec(),getUrl(),NettyServer.this); ChannelPipelinepipeline=Channels.pipeline(); /*intidleTimeout=getIdleTimeout(); if(idleTimeout>10000){ pipeline.addLast("timer",newIdleStateHandler(timer,idleTimeout/1000,0,0)); }*/ pipeline.addLast("decoder",adapter.getDecoder());//解码 pipeline.addLast("encoder",adapter.getEncoder());//编码 pipeline.addLast("handler",nettyHandler); returnpipeline; } }); //bind channel=bootstrap.bind(getBindAddress()); } 了解netty的同学,肯定早已习惯这个方法的写法,就是创建了netty的server嘛,到这里dubbo的服务创建完毕了,这个时候控制台见打印: [DUBBO]StartNettyServerbind/0.0.0.0:20880,export/192.168.4.241:20880,dubboversion:2.8.4,currenthost:127.0.0.1

优秀的个人博客,低调大师

jvm 运行时数据区域(读书笔记)

java虚拟机运行是区域主要分为五个 程序计数器 虚拟机栈 本地方法栈 堆 方法区 1.程序计数器 程序计数器是一块比较小的内存空间。可以看作是当前现场所执行的字节码的行号指示器。每条线程都有一个独立的程序计数器,在各线程之间是独立存储的,这类内存区域为“线程私有”内存。如果是一个Native方法这个计数器值为空(Undefined)。 2.java虚拟机栈 虚拟机栈也是线程私有的,它的生命周期和线程相同。每个java方法在执行的时候都会创建一个栈帧。用于储存局部变量表,操作数栈,动态链接,方法出口信息等。 局部变量表存放了编译期可预知的各种基本数据类型,对象引用,returnAddress类型。 局部变量表所需要的内存空间在编译期间完成分配,当进入一个方法时,这个方法需要在帧中分配多大的局部空间是完全确定的,在方法运行期间不会改变局部变量的大小。 3.本地方法栈 本地方法栈和虚拟机栈功能基本相同,只是针对的对象不同。它针对的是虚拟机使用到的Native方法服务。在虚拟机规范中对它没有强制规定,可以把它合并到虚拟机栈中。 4.堆 堆是java虚拟机所管理的最大的一块内存区域。java堆是本所有的线程共享的一块内存区域,在虚拟机启动时创建。这块内存区域唯一目的就是存放对象实例,几乎所有的对象实例都创建在这里。 java堆是垃圾收集器的主要管理区域,从垃圾收集器基本采用分代收集算法来区分堆区域,堆区域还可以细分为:新生代和老年代;再细致一点有分Eden空间、From Survivor空间、To Survivor空间等。从内存分配的角度来看,线程共享的java堆中可能划分出多个线程私有的分配缓冲区(Thread Local Allocation Buffer,TLAB) 5.方法区 方法区也是各个线程共享的区域,它用于储存已经被虚拟机加载的类的信息、常量、静态变量、即时编译器编译后的代码数据等。很多人也把这个区域叫永久代。 6.运行时常量 运行时常量池是方法区的一部分。clas文件中除了有类似的版本、字段、方法、接口等信息描述外,还有一项信息是常量池,用于存放编译期产生的各种字面量和符号引用,这部分在类加载后进入方法区的运行时常量池中存放,还会把翻译出来的直接引用也存储在运行时常量池中。 7.直接内存 直接内存不是虚拟机运行时数据的一部分,也不在java虚拟机规范中定义的内存区域。在JDK1.4中加入了NIO类,引入了基于通道与缓冲区的I/O方式,它可以使用Native函数库直接分配堆外内存,然后通过一个存储在java中的DirectByteBuffer对象作为这块内容的引用操作。

优秀的个人博客,低调大师

Python零基础学习笔记(四十)—— datetime和Calendar

import datetime import time ''' datetime比time高级了不少,可以理解为date time基于time进行了封装, 提供了各种实用的函数,date time模块的接口更为直观,更容易调用 模块中的类: datetime 同时有时间和日期 timedelta 主要用于计算时间跨度 tzinfo 时区相关 time 只关注时间 date 只关注日期 ''' #获取当前时间 d1 = datetime.datetime.now() print(d1) # d2 = datetime.datetime(1995, 4, 28,10,23,34,123355) print(d2) # d3 = datetime.datetime.time(d1) print(d3) #将时间转换为字符串 #d4 = d1.strptime("%Y-%m-%d %X") #print(d4) #时间加减 d5 = d1 - d2 print(d5) #间隔的天数 print(d5.days) #间隔天数除外的秒数 print(d5.seconds) import calendar ''' 日历 ''' #使用 print(calendar.month(2019, 7)) #返回指定年的日历 print(calendar.calendar(2019)) #判断闰年,返回True print(calendar.isleap(2000)) #返回某个月的weekday的第一天和这个月的天数 print(calendar.monthrange(2018, 12)) #返回某个月以每一周为元素的列表 print(calendar.monthcalendar(2017, 12))

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册