首页 文章 精选 留言 我的

精选列表

搜索[虚幻引擎],共10000篇文章
优秀的个人博客,低调大师

云上的Growth hacking之路,打造产品的增长引擎

增长关乎产品的存亡 增长!增长!增长!业务增长是每一个创业者每天面临的最大问题。无论你的产品是APP,还是web,或者是小程序,只能不断的维持用户的增长,才能向资本市场讲出一个好故事,融资活下去。活到最后的产品,才有机会盈利。 为了获取用户的增长,可以投放广告,也可以内容营销、社交传播、销售地推,或者持续的专注于产品优化。无论哪一种方式,我们都面临这几个问题: 运营活动,覆盖了多少用户? 多少用户,开始使用产品? 多少用户付费? 多少用户持续的活跃? 下一步,我们应该把精力放在哪些方面?是持续运营?还是开发新功能? 如果不能回答这些问题,无疑我们的运营活动或者开发就是盲人摸象,完全靠运气。为了解答这些问题,我们不妨关注一下growth hacking这种数据驱动的手段。 Growth Hacker的核心思想 传统的市场营销策略,例如投放电视广告,覆盖

优秀的个人博客,低调大师

基于Unity3d 引擎的Android游戏优化(续)

VSync Count 垂直同步 中新建一个场景空的时候,帧速率(FPS总是很低),大概在60~70之间。一直不太明白是怎么回事,现在基本上明白了。我在这里解释一下原因,如有错误,欢迎指正。在Unity3D中当运行场景打开Profiler的时候,我们会看到VSync 这一项占了很大的比重。这个是什么呢,这个就是垂直同步,稍后再做解释。我们可以关闭VSync来提高帧速率,选择edit->project settings->Quality 在右侧面板中可以找到VSync Count ,把它选成Don't Sync。这就关闭了VSync(垂直同步),现在在运行场景看看,帧速率是不是提高很多。 现在来说说什么是垂直同步,要知道什么是垂直同步,必须要先明白显示器的工作原理,显示器上的所有图像都是一线一线的扫描上去的,无论是隔行扫描还是逐行扫描,显示器都有两种同步参数——水平同步和垂直同步。 什么叫水平同步?什么叫垂直同步? 垂直和水平是CRT中两个基本的同步信号,水平同步信号决定了CRT画出一条横越屏幕线的时间,垂直同步信号决定了CRT从屏幕顶部画到底部,再返回原始位置的时间,而恰恰是垂直同步代表着CRT显示器的刷新率水平。 为什么关闭垂直同步信号会影响游戏中的FPS数值? 道理一点都不复杂,首先我们平时运行操作系统一般屏幕刷新率是多少?大概一般都是在85上下吧,那么显卡就会每按照85的频率时间来发送一个垂直同步信号,信号和信号的时间间隔是上两次屏幕更新的时间间隔。 如果我们选择等待垂直同步信号(也就是我们平时所说的垂直同步打开),那么在游戏中或许强劲的显卡迅速的绘制完一屏的图像,但是没有垂直同步信号的到达,显卡无法绘制下一屏,只有等85单位的信号到达,才可以绘制。这样FPS自然要受到操作系统刷新率运行值的制约。 而如果我们选择不等待垂直同步信号(也就是我们平时所说的关闭垂直同步),那么游戏中作完一屏画面,显卡和显示器无需等待垂直同步信号就可以开始下一屏图像的绘制,自然可以完全发挥显卡的实力。但是不要忘记,正是因为垂直同步的存在,才能使得游戏进程和显示器刷新率同步,使得画面更加平滑和稳定。取消了垂直同步信号,固然可以换来更快的速度,但是在图像的连续性上势必打折扣。这也正是很多朋友抱怨关闭垂直后发现画面不连续的理论原因。 更多unity2018的功能介绍请到paws3d学习中心查找。

优秀的个人博客,低调大师

【Elasticsearch全文搜索引擎实战】之Filebeat快速入门

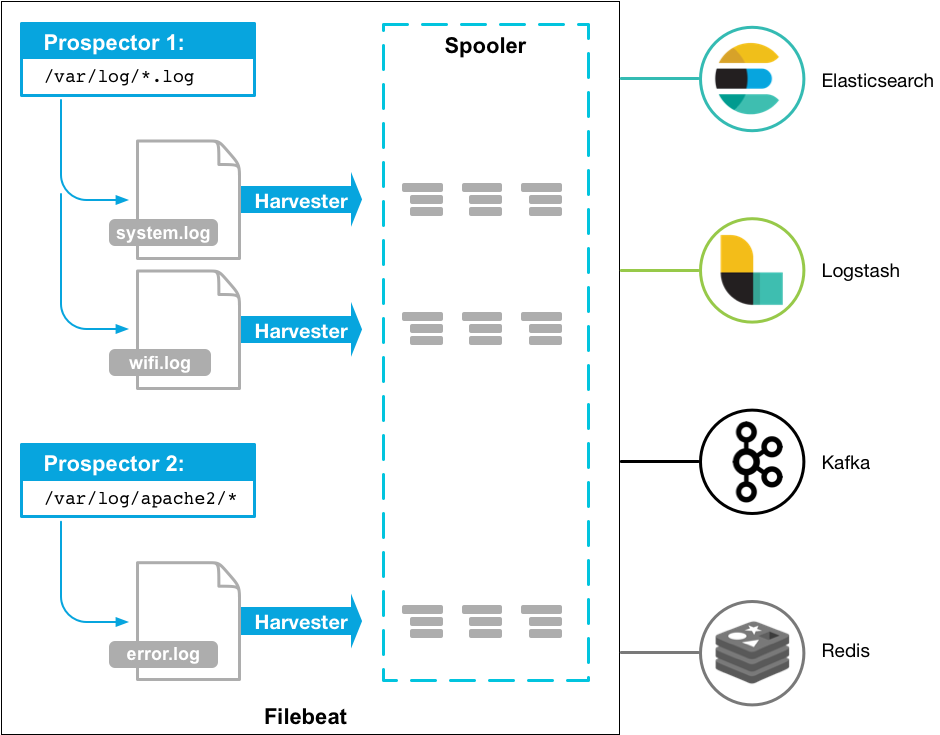
0. 背景 用过ELK(Elasticsearch, Logstash, Kibana)的人应该都面临过同样的问题,Logstash虽然功能强大:支持许多的input/output plugin、强大的filter功能。但是确内存占用会非常大。还有种情况(我就是orz...),在Logstash 5.2+版本中,input plugin使用Log4j,必须使用filebeat,并且只支持log4j 1.x版本。了解到filebeat已经支持filter和不少的output plugin,果断转投fielbeat阵营。 1. 简介 Filebeat官方介绍是这样的: Filebeat is a log data shipper for local files. Installed as an agent on your servers, Filebeat monitors the log directories or specific log files, tails the files, and forwards them either to Elasticsearch or Logstash for indexing. Here’s how Filebeat works: When you start Filebeat, it starts one or more prospectors that look in the local paths you’ve specified for log files. For each log file that the prospector locates, Filebeat starts a harvester. Each harvester reads a single log file for new content and sends the new log data to libbeat, which aggregates the events and sends the aggregated data to the output that you’ve configured for Filebeat. 翻译成中文大意就是: Filebeat是一个日志数据收集工具,在服务器上安装客户端后,filebeat会监控日志目录或者指定的日志文件,追踪读取这些文件(追踪文件的变化,不停的读),并且转发这些信息到elasticsearch或者logstarsh中存放。 以下是filebeat的工作流程:当你开启filebeat程序的时候,它会启动一个或多个探测器(prospectors)去检测你指定的日志目录或文件,对于探测器找出的每一个日志文件,filebeat启动收割进程(harvester),每一个收割进程读取一个日志文件的新内容,并发送这些新的日志数据到处理程序(spooler),处理程序会集合这些事件,最后filebeat会发送集合的数据到你指定的地点。 更关于探测器(prospectors)和收割进程(harvester)信息,请查看官网How Filebeat works. 1.2 核心功能 1.2.1 性能稳健,不错过任何检测信号 无论在任何环境中,随时都潜伏着应用程序中断的风险。Filebeat 能够读取并转发日志行,如果出现中断,还会在一切恢复正常后,从中断前停止的位置继续开始。 1.2.2 Filebeat 不会让通道过载 考虑到数据量较大,Filebeat 使用压力敏感协议向 Logstash 或 Elasticsearch 发送数据。如果 Logstash 正在繁忙地处理数据,它会告知 Filebeat 减慢读取速度。拥塞解决后,Filebeat 将恢复初始速度并继续输送数据。 1.2.3 不需要重载管道 当将数据发送到 Logstash 或 Elasticsearch 时,Filebeat 使用背压敏感协议,以考虑更多的数据量。如果 Logstash 正在忙于处理数据,则可以让 Filebeat 知道减慢读取速度。一旦拥堵得到解决,Filebeat 就会恢复到原来的步伐并继续运行。 1.2.4 输送至 Elasticsearch 或 Logstash。在 Kibana 中实现可视化。 Filebeat 是 Elastic Stack 的一部分,因此能够与 Logstash、Elasticsearch 和 Kibana 无缝协作。无论您要使用 Logstash 转换或充实日志和文件,还是在 Elasticsearch 中随意处理一些数据分析,亦或在 Kibana 中构建和分享仪表板,Filebeat 都能轻松地将您的数据发送至最关键的地方。 2. 性能 运行环境: OS 内存 CPU Filebeat版本 Logstash版本 CentOS 32g 6核Intel(R) Xeon(R) CPU E5-2620 v3 @ 2.40GHz 6.1 5.6.5 Logstash内存占用 [root@dde /]# cat /proc/20085/status /proc/20085/status | grep -i vm VmPeak: 9837428 kB VmSize: 9835376 kB VmLck: 0 kB VmHWM: 798364 kB VmRSS: 798360 kB VmData: 9677292 kB VmStk: 88 kB VmExe: 4 kB VmLib: 16520 kB VmPTE: 2568 kB VmSwap: 0 kB VmPeak: 9837428 kB VmSize: 9835376 kB VmLck: 0 kB VmHWM: 798364 kB VmRSS: 798360 kB VmData: 9677292 kB VmStk: 88 kB VmExe: 4 kB VmLib: 16520 kB VmPTE: 2568 kB VmSwap: 0 kB Filebeat内存占用 [root@dde /]# cat /proc/22207/status /proc/22207/status | grep -i vm VmPeak: 452796 kB VmSize: 410180 kB VmLck: 0 kB VmHWM: 16008 kB VmRSS: 16008 kB VmData: 376332 kB VmStk: 88 kB VmExe: 24764 kB VmLib: 1804 kB VmPTE: 184 kB VmSwap: 0 kB VmPeak: 452796 kB VmSize: 410180 kB VmLck: 0 kB VmHWM: 16008 kB VmRSS: 16008 kB VmData: 376332 kB VmStk: 88 kB VmExe: 24764 kB VmLib: 1804 kB VmPTE: 184 kB VmSwap: 0 kB Logstash因为是运行是JVM中的,可以看到Logstash内存占用比Filebeat大的多。 3. 安装 Filebeat官方提供了以下几种安装方式: (deb for Debian/Ubuntu, rpm for Redhat/Centos/Fedora, mac for OS X, docker for any Docker platform, and win for Windows). deb: curl -L -O https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-6.1.2-amd64.deb sudo dpkg -i filebeat-6.1.2-amd64.deb rpm: curl -L -O https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-6.1.2-x86_64.rpm sudo rpm -vi filebeat-6.1.2-x86_64.rpm mac curl -L -O https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-6.1.2-darwin-x86_64.tar.gz tar xzvf filebeat-6.1.2-darwin-x86_64.tar.gz docker: docker pull docker.elastic.co/beats/filebeat:6.1.2 windows: 1.下载zip包,地址。 2.解压到:C:\Program Files。 3.重命名文件夹为以下格式:filebeat-<version>-windows。 4.以管理员身份运行Shell。 5.使用如下命令,讲Filebeat安装为一个Windows Service: PS > cd 'C:\Program Files\Filebeat' PS C:\Program Files\Filebeat> .\install-service-filebeat.ps1 4. 配置 Elastic提供了一个配合ELK(Elasticsearch + Logstash + Kibana)的快速配置方式,不过我们不需要配合ELK使用Filebeat。直接配置filebeat根目录下filebeat.yml文件: filebeat.prospectors: - type: log enabled: true paths: - /var/log/*.log #- c:\programdata\elasticsearch\logs\* 需要配合elasticsearch使用时,增加以下配置: output.elasticsearch: hosts: ["192.168.1.42:9200"] 需要配合kibana使用时,增加以下配置: setup.kibana: host: "localhost:5601" Output Filebeat现在已经支持丰富的output类型: Elasticsearch Logstash Kafka Redis File Console Output codec Cloud output到kafka的配置类似: output.kafka: # initial brokers for reading cluster metadata hosts: ["kafka1:9092", "kafka2:9092", "kafka3:9092"] # message topic selection + partitioning topic: '%{[fields.log_topic]}' partition.round_robin: reachable_only: false required_acks: 1 compression: gzip max_message_bytes: 1000000 当事件的大小超过max_message_bytes的值的时候,会被直接丢弃不处理,所以要尽量控制filebeat产生的事件小于max_message_bytes的值。 上面示例中字段含义如下:enable: 该output是否生效;hosts:kafka broker集群地址;topic: kafka接收事件的topic;partition: kafka output的partioning 策略,可能值为:random, round_robin, hash。默认为hash;官方关于这几个可选值解释如下: random.group_events: Sets the number of events to be published to the same partition, before the partitioner selects a new partition by random. The default value is 1 meaning after each event a new partition is picked randomly. round_robin.group_events: Sets the number of events to be published to the same partition, before the partitioner selects the next partition. The default value is 1 meaning after each event the next partition will be selected. hash.hash: List of fields used to compute the partitioning hash value from. If no field is configured, the events key value will be used. hash.random: Randomly distribute events if no hash or key value can be computed. required_acks: kafka broker ACK可靠级别: 0=不需要响应, 1=等待本地commit, -1=等待所有的 replicascommit. 默认值为 1. Note: 如果设置为0,kafka将没有ACK返回,也许会有消息丢失或者错误。 5.运行 sudo ./filebeat -e -c filebeat.yml Filebeat目前已经支持Docker和Kubernetes。 5.1 Docker (1)pull image docker pull docker.elastic.co/beats/filebeat:6.1.2 (2) run image docker run \ -v ~/filebeat.yml:/usr/share/filebeat/filebeat.yml \ docker.elastic.co/beats/filebeat:6.1.2 (3) Configuration FROM docker.elastic.co/beats/filebeat:6.1.2 COPY filebeat.yml /usr/share/filebeat/filebeat.yml USER root RUN chown filebeat /usr/share/filebeat/filebeat.yml USER filebeat 5.2 Kubernetes (1)Deploy manifests curl -L -O https://raw.githubusercontent.com/elastic/beats/6.1/deploy/kubernetes/filebeat-kubernetes.yaml (2)Setting - name: ELASTICSEARCH_HOST value: elasticsearch - name: ELASTICSEARCH_PORT value: "9200" - name: ELASTICSEARCH_USERNAME value: elastic - name: ELASTICSEARCH_PASSWORD value: changeme (3)Deploy kubectl create -f filebeat-kubernetes.yaml check status $ kubectl --namespace=kube-system get ds/filebeat NAME DESIRED CURRENT READY UP-TO-DATE AVAILABLE NODE-SELECTOR AGE filebeat 32 32 0 32 0 <none> 1m 6. 参考资料 Elastic Filebeat Reference

优秀的个人博客,低调大师

Elastic Search搜索引擎在SpringBoot中的实践

实验环境 ES版本:5.3.0 spring bt版本:1.5.9 首先当然需要安装好elastic search环境,最好再安装上可视化插件 elasticsearch-head来便于我们直观地查看数据。 当然这部分可以参考本人的帖子:《centos7上elastic search安装填坑记》https://www.jianshu.com/p/04f4d7b4a1d3 我的ES安装在http://113.209.119.170:9200/这个地址(该地址需要配到springboot项目中去) Spring工程创建 这部分没有特殊要交代的,但有几个注意点一定要当心 注意在新建项目时记得勾选web和NoSQL中的Elasticsearch依赖,来张图说明一下吧: 项目自动生成以后pom.xml中会自动添加spring-boot-starter-data-elasticsearch的依赖: <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-elasticsearch</artifactId> </dependency> 本项目中我们使用开源的基于restful的es java客户端jest,所以还需要在pom.xml中添加jest依赖: <dependency> <groupId>io.searchbox</groupId> <artifactId>jest</artifactId> </dependency> 除此之外还必须添加jna的依赖: <dependency> <groupId>net.java.dev.jna</groupId> <artifactId>jna</artifactId> </dependency> 否则启动spring项目的时候会报JNA not found. native methods will be disabled.的错误: 项目的配置文件application.yml中需要把es服务器地址配置对 server: port: 6325 spring: elasticsearch: jest: uris: - http://113.209.119.170:9200 # ES服务器的地址! read-timeout: 5000 代码组织 我的项目代码组织如下: 各部分代码详解如下,注释都有: Entity.java package com.hansonwang99.springboot_es_demo.entity; import java.io.Serializable; import org.springframework.data.elasticsearch.annotations.Document; public class Entity implements Serializable{ private static final long serialVersionUID = -763638353551774166L; public static final String INDEX_NAME = "index_entity"; public static final String TYPE = "tstype"; private Long id; private String name; public Entity() { super(); } public Entity(Long id, String name) { this.id = id; this.name = name; } public Long getId() { return id; } public void setId(Long id) { this.id = id; } public String getName() { return name; } public void setName(String name) { this.name = name; } } TestService.java package com.hansonwang99.springboot_es_demo.service; import com.hansonwang99.springboot_es_demo.entity.Entity; import java.util.List; public interface TestService { void saveEntity(Entity entity); void saveEntity(List<Entity> entityList); List<Entity> searchEntity(String searchContent); } TestServiceImpl.java package com.hansonwang99.springboot_es_demo.service.impl; import java.io.IOException; import java.util.List; import com.hansonwang99.springboot_es_demo.entity.Entity; import com.hansonwang99.springboot_es_demo.service.TestService; import org.elasticsearch.index.query.QueryBuilders; import org.elasticsearch.search.builder.SearchSourceBuilder; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Service; import io.searchbox.client.JestClient; import io.searchbox.client.JestResult; import io.searchbox.core.Bulk; import io.searchbox.core.Index; import io.searchbox.core.Search; @Service public class TestServiceImpl implements TestService { private static final Logger LOGGER = LoggerFactory.getLogger(TestServiceImpl.class); @Autowired private JestClient jestClient; @Override public void saveEntity(Entity entity) { Index index = new Index.Builder(entity).index(Entity.INDEX_NAME).type(Entity.TYPE).build(); try { jestClient.execute(index); LOGGER.info("ES 插入完成"); } catch (IOException e) { e.printStackTrace(); LOGGER.error(e.getMessage()); } } /** * 批量保存内容到ES */ @Override public void saveEntity(List<Entity> entityList) { Bulk.Builder bulk = new Bulk.Builder(); for(Entity entity : entityList) { Index index = new Index.Builder(entity).index(Entity.INDEX_NAME).type(Entity.TYPE).build(); bulk.addAction(index); } try { jestClient.execute(bulk.build()); LOGGER.info("ES 插入完成"); } catch (IOException e) { e.printStackTrace(); LOGGER.error(e.getMessage()); } } /** * 在ES中搜索内容 */ @Override public List<Entity> searchEntity(String searchContent){ SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder(); //searchSourceBuilder.query(QueryBuilders.queryStringQuery(searchContent)); //searchSourceBuilder.field("name"); searchSourceBuilder.query(QueryBuilders.matchQuery("name",searchContent)); Search search = new Search.Builder(searchSourceBuilder.toString()) .addIndex(Entity.INDEX_NAME).addType(Entity.TYPE).build(); try { JestResult result = jestClient.execute(search); return result.getSourceAsObjectList(Entity.class); } catch (IOException e) { LOGGER.error(e.getMessage()); e.printStackTrace(); } return null; } } EntityController.java package com.hansonwang99.springboot_es_demo.controller; import java.util.ArrayList; import java.util.List; import com.hansonwang99.springboot_es_demo.entity.Entity; import com.hansonwang99.springboot_es_demo.service.TestService; import org.apache.commons.lang.StringUtils; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RequestMethod; import org.springframework.web.bind.annotation.RestController; @RestController @RequestMapping("/entityController") public class EntityController { @Autowired TestService cityESService; @RequestMapping(value="/save", method=RequestMethod.GET) public String save(long id, String name) { System.out.println("save 接口"); if(id>0 && StringUtils.isNotEmpty(name)) { Entity newEntity = new Entity(id,name); List<Entity> addList = new ArrayList<Entity>(); addList.add(newEntity); cityESService.saveEntity(addList); return "OK"; }else { return "Bad input value"; } } @RequestMapping(value="/search", method=RequestMethod.GET) public List<Entity> save(String name) { List<Entity> entityList = null; if(StringUtils.isNotEmpty(name)) { entityList = cityESService.searchEntity(name); } return entityList; } } 实际实验 增加几条数据,可以使用postman工具,也可以直接在浏览器中输入,如增加以下5条数据: http://localhost:6325/entityController/save?id=1&name=南京中山陵 http://localhost:6325/entityController/save?id=2&name=中国南京师范大学 http://localhost:6325/entityController/save?id=3&name=南京夫子庙 http://localhost:6325/entityController/save?id=4&name=杭州也非常不错 http://localhost:6325/entityController/save?id=5&name=中国南边好像没有叫带京字的城市了 数据插入效果如下(使用可视化插件elasticsearch-head观看): 我们来做一下搜索的测试:例如我要搜索关键字“南京”我们在浏览器中输入: http://localhost:6325/entityController/search?name=南京 搜索结果如下: 刚才插入的5条记录中包含关键字“南京”的四条记录均被搜索出来了! 当然这里用的是standard分词方式,将每个中文都作为了一个term,凡是包含“南”、“京”关键字的记录都被搜索了出来,只是评分不同而已,当然还有其他的一些分词方式,此时需要其他分词插件的支持,此处暂不涉及,后文中再做探索。

优秀的个人博客,低调大师

音视频引擎/音视频即时通讯

其技术亮点之一“透明通道” “透明通道”顾名思义就是AnyChat SDK为上层应用提供的一个传输数据的通道,由于AnyChat SDK并不关心所传输的内容,即所传输的数据相对于SDK来说是“透明”的,便称为“透明通道”。上层应用可以利用SDK提供的透明通道来扩展业务,传输的内容没有限制,可以为任意数据类型缓冲区,单次传输大小限制为1000字节,如可以利用透明通道传输业务上自定义的指令,接收方收到数据后,会产生透明通道数据回调,在回调函数里面进行指令的解析,并进行对应的业务逻辑处理。V2.8.7之前的版本,只能在当前房间内的任意两个用户间,或是向房间内的所有用户广播数据。自2.8.7版本开始,便可以在两个成功登录的用户之间,用透明通道接口传输自定义的数据,每次传输数据的大小为1000字节,如果自己在房间里面,还可以利用透明通道向房间的所有用户广播数据。如果在房间中任意两个用户间需要传输大量的缓冲区数据,则可使用扩展接口SDK内部会自动完成对大缓冲区的分包、组包、校验工作。 其技术亮点之二“集成第三方编解码器” AnyChat Platform Core SDK支持加载外部音视频的编码、解码模块(简称AnyChat Codec库),增强系统的可扩展性,同时也满足一些特定应用环境的特殊需求,如与特定的硬件平台(android、pad)集成时,可以调用硬件编解码器,实现更高效率的即时通讯应用。AnyChat Platform Core SDK内核已经实现了部分常用的音视频编码、解码模块,如H.264视频编码、解码算法,ARM-WB、AAC、SPEEX、CELT等音频编码、解码算法。上层应用可以自己定义新的音视频编码、解码算法,在AnyChat平台初始化时,通过相关API接口可以加载新的编码、解码模块,同时上层应用也可以重新实现SDK内置的编码、解码算法,在AnyChat平台初始化时,发现加载的音视频编码、解码算法与内置的算法相同,则会采用上层应用提供的相关算法来替代内核的算法。单个音视频编码、解码模块(AnyChat Codec库)最多可以同时包含:一个音频编码器,一个音频解码器,一个视频编码器以及一个视频解码器。当上层应用需要实现多个编码器,或是多个解码器时,可以在多个库中分别实现,然后分别向AnyChat内核进行注册。AnyChat Platform Core SDK根据预先定义的CODEC编号(CodecId)来区分不同的CODEC,当用户需要实现的CODEC不在已定义的CODEC列表中时,可以自行定义新的CODEC编号,当AnyChat内核收到采用新的CODEC编码的数据时,会根据CODEC编号查询已注册的新解码器,然后调用新的CODEC进行解码。当上层应用实现的CODEC编号与AnyChat内核预置的CODEC相同时,且输入(或输出)为标准码流时,可以与AnyChat内置CODEC同步工作(如采用AnyChat Codec库进行编码,用AnyChat内置库进行解码)。当上层应用实现的CODEC编号不存在于AnyChat内置CODEC列表中时,需要在编码端、解码端同时注册新的CODEC,否则将会出现解码失败的情况。 其技术亮点之三“支持Android硬件加速” AnyChat for Android SDK V1.3 正式支持Android硬件加速,启用硬件加速之后,内核将调用Android平台内置的硬件编码、硬件解码模块(CODEC),实现高清晰度的音视频通话。AnyChat for Android SDK内置软件编码、解码库,受限于android平台CPU运算能力,对于高分辨率、高帧率的视频通信效率较低,这时就需要采用硬件加速,通常Android平台的硬件都内置硬件加速芯片,通过硬件加速可以降低对CPU的要求,提高实时性。AnyChat for Android SDK默认采用内置软件编解码库,如需启用硬件加速则需要进行设置,示例代码如下(初始化成功之后调用): 1.// 平台硬件编码设置 2.intuseHardwareCodec = 1; 3.anychat.SetSDKOptionInt(AnyChatDefine.BRAC_SO_CORESDK_USEHWCODEC, useHardwareCodec); AnyChat内核会自动探测当前android平台所支持的硬件加速类型(编码、解码)并自动加载,并在日志中输出相关信息,包括编解码器类型、名称等,如下所示: 1.Load codec libmediahwcodec_2.2.so success 2.Load video encodec success!(id:1,name:OMX.Nvidia.h264.encoder) 3.Load video decodec success!(id:1,name:OMX.Nvidia.h264.decode) Android平台下正常启用硬件加速的条件是:1、硬件平台具备硬件加速芯片;2、硬件厂家提供相关驱动并加载到Android操作系统内核中(符合OMX标准,如不符合,则需要硬件厂家提供相关技术支持)。默认情况下,Android 2.2内核硬件加速不支持设置码率(默认1Mbps),Android 2.3、Android 4.0等平台支持设置硬件加速编码的目标码率、帧率、关键帧间隔等参数,所以在Android 2.3以上的版本上启用硬件加速将会获得理想的效果。如果所使用的Android平台具备硬件加速芯片,但不支持标准的硬件加速接口,则需要硬件厂家提供相关的api接口,然后采用 AnyChat集成第三方编解码器 技术,便可实现非标准的硬件加速功能。 其跨平台特性也是其与众不同的亮点之一,已支持Windows、Unix、Linux(x86、ARM)、Mobile、Android、iPhone平台等,目前正在做WP7平台的移植。利用AnyChat SDK的跨平台特性,可以实现嵌入式硬件设备(ARM平台)与Internet上的Windows平台实现语音、视频的交互。如果企业的平台目前,或是今后需要实现跨平台的特性,则AnyChat SDK将是不二的选择。产品的跨平台特性,操作系统的多重选择,将使企业的应用领域更加的广阔。 本文转自 fanxiaojun 51CTO博客,原文链接:http://blog.51cto.com/2343338/987179,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册