首页 文章 精选 留言 我的

精选列表

搜索[虚幻引擎],共10000篇文章
优秀的个人博客,低调大师

数据源管理 | OLAP查询引擎,ClickHouse集群化管理

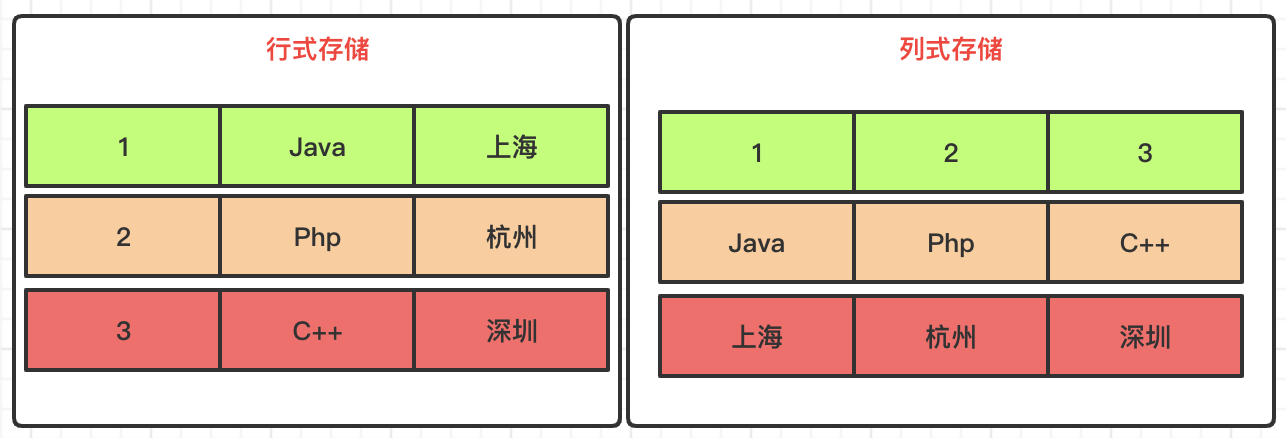
本文源码:GitHub·点这里 || GitEE·点这里 一、列式库简介 ClickHouse是俄罗斯的Yandex公司于2016年开源的列式存储数据库(DBMS),主要用于OLAP在线分析处理查询,能够使用SQL查询实时生成分析数据报告。 列式存储 行式存储和列式存储,数据在磁盘上的组织结构有着根本不同,数据分析计算时,行式存储需要遍历整表,列式存储只需要遍历单个列,所以列式库更适合做大宽表,用来做数据分析计算。 絮叨一句:注意这里比较的场景,是数据分析计算的场景。 二、集群配置 1、基础环境 ClickHouse单服务默认已经安装完毕 Linux下安装ClickHouse单机服务 SpringBoot整合ClickHouse列式数据库 2、取消文件限制 vim /etc/security/limits.conf vim /etc/security/limits.d/90-nproc.conf 文件末尾追加 * soft nofile 65536 * hard nofile 65536 * soft nproc 131072 * hard nproc 131072 3、取消SELINUX 修改/etc/selinux/config中的SELINUX=disabled后重启 4、集群配置文件 服务分别添加集群配置:vim /etc/metrika.xml <yandex> <clickhouse_remote_servers> <clickhouse_cluster> <shard> <internal_replication>true</internal_replication> <replica> <host>192.168.72.133</host> <port>9000</port> </replica> </shard> <shard> <replica> <internal_replication>true</internal_replication> <host>192.168.72.136</host> <port>9000</port> </replica> </shard> <shard> <internal_replication>true</internal_replication> <replica> <host>192.168.72.137</host> <port>9000</port> </replica> </shard> </clickhouse_cluster> </clickhouse_remote_servers> <zookeeper-servers> <node index="1"> <host>192.168.72.133</host> <port>2181</port> </node> <node index="2"> <host>192.168.72.136</host> <port>2181</port> </node> <node index="3"> <host>192.168.72.137</host> <port>2181</port> </node> </zookeeper-servers> <macros> <replica>192.168.72.133</replica> </macros> <networks> <ip>::/0</ip> </networks> <clickhouse_compression> <case> <min_part_size>10000000000</min_part_size> <min_part_size_ratio>0.01</min_part_size_ratio> <method>lz4</method> </case> </clickhouse_compression> </yandex> 注意这里 <macros> <replica>192.168.72.133</replica> </macros> 配置各自服务的IP地址。 5、启动集群 分别启动三台服务 service clickhouse-server start 6、登录客户端查看 这里登录任意一台服务就好 clickhouse-client en-master :) select * from system.clusters 这里这里集群名称:clickhouse_cluster,后续使用。 7、基本环境测试 三台服务上同时创建表结构。 CREATE TABLE ontime_local (FlightDate Date,Year UInt16) ENGINE = MergeTree(FlightDate, (Year, FlightDate), 8192); 133环境创建分布表 CREATE TABLE ontime_all AS ontime_local ENGINE = Distributed(clickhouse_cluster, default, ontime_local, rand()); 随便写入一台服务数据 insert into ontime_local (FlightDate,Year) values ('2020-03-12',2020); 查询总表 select * from ontime_all; 写入总表,数据会分布到各个单表中 insert into ontime_all (FlightDate,Year)values('2001-10-12',2001); insert into ontime_all (FlightDate,Year)values('2002-10-12',2002); insert into ontime_all (FlightDate,Year)values('2003-10-12',2003); 任意关闭一台服务,集群查询直接挂掉 三、集群环境整合 1、基础配置 url:配置全部的服务列表,主要用来管理表结构,批量处理; cluster:集群连接服务,可以基于Nginx代理服务配置; spring: datasource: type: com.alibaba.druid.pool.DruidDataSource click: driverClassName: ru.yandex.clickhouse.ClickHouseDriver url: jdbc:clickhouse://127.0.0.1:8123/default,jdbc:clickhouse://127.0.0.1:8123/default,jdbc:clickhouse://127.0.0.1:8123/default cluster: jdbc:clickhouse://127.0.0.1:8123/default initialSize: 10 maxActive: 100 minIdle: 10 maxWait: 6000 2、管理接口 分别向每个单节点服务创建表和写入数据: data_shard(单节点数据) data_all(分布数据) @RestController public class DataShardWeb { @Resource private JdbcFactory jdbcFactory ; /** * 基础表结构创建 */ @GetMapping("/createTable") public String createTable (){ List<JdbcTemplate> jdbcTemplateList = jdbcFactory.getJdbcList(); for (JdbcTemplate jdbcTemplate:jdbcTemplateList){ jdbcTemplate.execute("CREATE TABLE data_shard (FlightDate Date,Year UInt16) ENGINE = MergeTree(FlightDate, (Year, FlightDate), 8192)"); jdbcTemplate.execute("CREATE TABLE data_all AS data_shard ENGINE = Distributed(clickhouse_cluster, default, data_shard, rand())"); } return "success" ; } /** * 节点表写入数据 */ @GetMapping("/insertData") public String insertData (){ List<JdbcTemplate> jdbcTemplateList = jdbcFactory.getJdbcList(); for (JdbcTemplate jdbcTemplate:jdbcTemplateList){ jdbcTemplate.execute("insert into data_shard (FlightDate,Year) values ('2020-04-12',2020)"); } return "success" ; } } 3、集群查询 上述步骤执行完成后,可以连接集群服务查询分布总表和单表的数据。 基于Druid连接 @Configuration public class DruidConfig { @Resource private JdbcParamConfig jdbcParamConfig ; @Bean public DataSource dataSource() { DruidDataSource datasource = new DruidDataSource(); datasource.setUrl(jdbcParamConfig.getCluster()); datasource.setDriverClassName(jdbcParamConfig.getDriverClassName()); datasource.setInitialSize(jdbcParamConfig.getInitialSize()); datasource.setMinIdle(jdbcParamConfig.getMinIdle()); datasource.setMaxActive(jdbcParamConfig.getMaxActive()); datasource.setMaxWait(jdbcParamConfig.getMaxWait()); return datasource; } } 基于mapper查询 <mapper namespace="com.ckhouse.cluster.mapper.DataAllMapper"> <resultMap id="BaseResultMap" type="com.ckhouse.cluster.entity.DataAllEntity"> <result column="FlightDate" jdbcType="VARCHAR" property="flightDate" /> <result column="Year" jdbcType="INTEGER" property="year" /> </resultMap> <select id="getList" resultMap="BaseResultMap" > select * from data_all where Year=2020 </select> </mapper> 四、源代码地址 GitHub·地址 https://github.com/cicadasmile/data-manage-parent GitEE·地址 https://gitee.com/cicadasmile/data-manage-parent

优秀的个人博客,低调大师

向量搜索引擎 Milvus 发布新版本 0.7.0

版本兼容 新增功能 向量删除 新增了对单条或多条向量的删除功能。如果您对一个集合进行了向量删除操作,后续对这个集合的搜索操作仅支持一部分索引类型,包括在CPU上运行的 Flat、IVFlat、IVFSQ8 等。Milvus 的后续版本将为其他索引类型提供支持。#86 向量读取 新增了通过向量 ID 读取对应的向量值的功能。#861 数据落盘与压缩 新增了数据落盘与压缩功能。您可以设置定时落盘或者手动落盘,从而避免数据丢失。如果一个段中的向量数据被删除,被删除的向量数据占据的空间并不会自动释放。您可以对集合中的段进行压缩操作以释放多余空间。#861#1426 运行时更改 Milvus 服务端参数 新增了运行时更改 Milvus 服务端参数的功能。您可以通过 Milvus 客户端对 Milvus 服务端参数进行更改,部分参数更改后可即时生效,无需重启 Milvus。#665 预写式日志(Write-Ahead Logging, WAL) 新增了 WAL 功能,可以大大提高数据操作的可靠性。您可以在 Milvus 服务端配置文件(server_config.yaml)中对 WAL 进行设置。#830 RESTful API 新增了 RESTful API。详细信息请参考RESTful API Readme。 Go SDK 新增了 Go SDK,详细信息请参考https://github.com/milvus-io/milvus-sdk-go。 HNSW 索引的支持 新增了对 HNSW 索引类型的支持。关于 HNSW 的详细介绍请参考向量索引算法 HNSW 和 NSG 的比较。#853 Jaccard/Hamming/Tanimoto 距离的支持 新增了对 Jaccard、Hamming、Tanimoto 距离的支持。#823 Prometheus 中 Pushgateway 的支持 新增了在 Prometheus 中 Pushgateway 的支持。Pushgateway 使生命周期短、批量的 metric 能够被 Prometheus 提取。#813 AVX 512 指令集的支持 新增了对 AVX 512 指令集的支持。Milvus 理论上可支持所有包含 AVX 512 指令集的 CPU。#1122 变更说明 创建索引与搜索的接口更新 从 Milvus 0.7.0开始,所有客户端创建索引与搜索的接口中的部分参数使用 JSON 字符串进行传值。 Milvus 服务端配置文件更新 从 Milvus 0.7.0开始,Milvus 服务端配置文件(server_config.yaml)版本更新为0.2。配置文件的参数也发生了变化。 术语更新 从0.7.0开始,Milvus 的 Table(表) 正式改名为 Collection(集合)。 Bug 修复 解决了插入向量时使用自动生成的ID 时可能产生重复ID的问题。#1508 对新版本有问题吗?下周二(3.17.2020)晚上八点的线上问答将进行 v.0.7.0 相关专题, 有任何问题或是建议都可以来与我们聊聊!

优秀的个人博客,低调大师

DataGrip 2019.3 EAP 4 发布,多引擎数据库环境

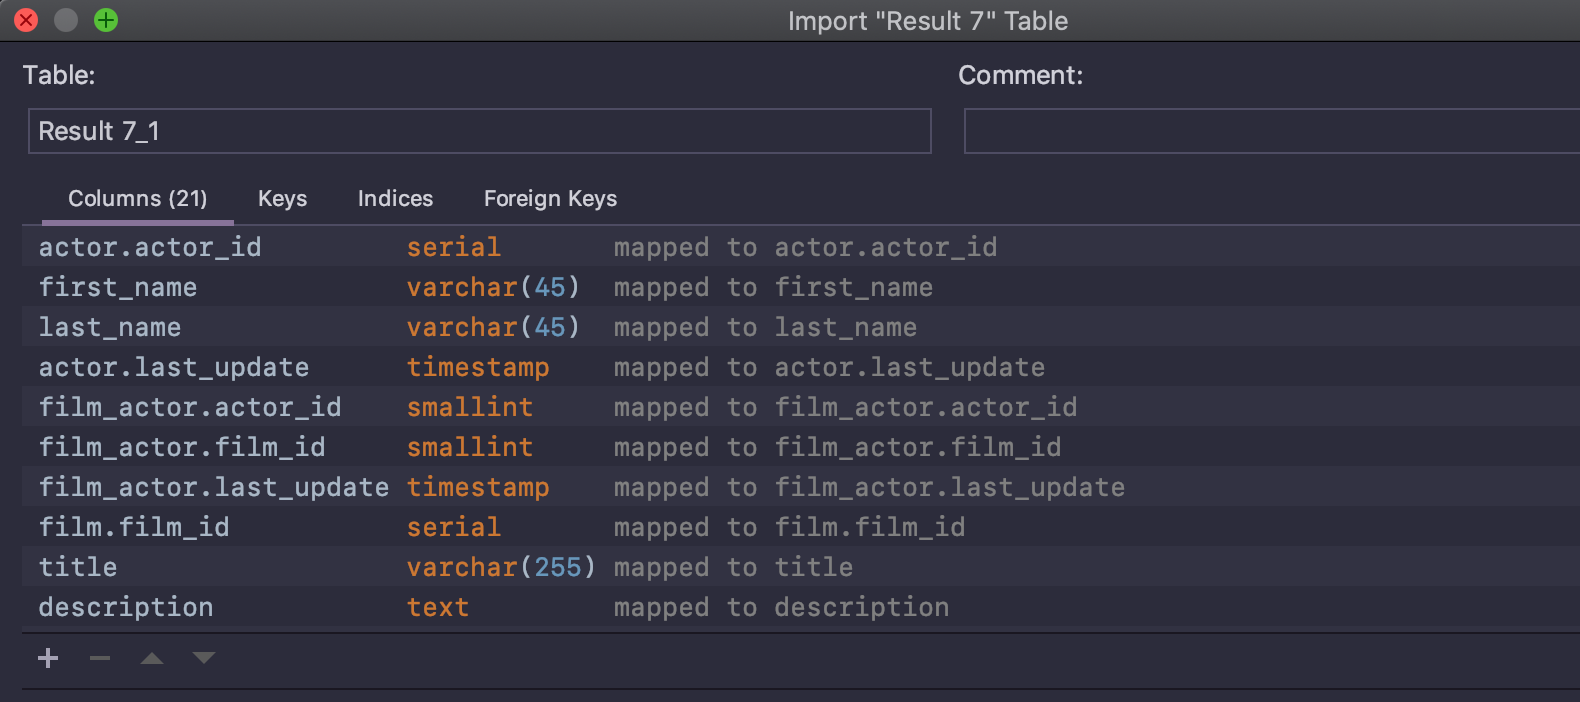
DataGrip 2019.3 的第四个早期访问计划发布了,主要更新内容如下: DBE-7976:现在可以从数据编辑器上下文中使用“修改表”操作,如果要在编辑表数据时添加新列,只需按 Ctr/Cmd+F6 继续。 DBE-9336: Intentions 现在在例程的源代码中起作用。例如,如果要通过星号上的 Alt+Enter 扩展通配符,现在就可以这样做。 DBE-9548:现在,如果结果集包含具有相同名称的多个列,那么从中创建表就不会对歧义名称造成任何问题。 DBE-9428:引入了新的意图,以帮助将 JOIN ON 转换为 JOIN USING,反之亦然。 发布公告: https://blog.jetbrains.com/datagrip/2019/11/15/datagrip-2019-3-eap-4/

优秀的个人博客,低调大师

JavaScript 引擎 V8 Lite Mode 改造 V8

去年年底,V8 团队启动了一个名为 V8 Lite 的项目,旨在大幅降低 V8 的内存使用率。最开始,团队准备把 V8 Lite 作为 V8 的独立模式,专门用于低内存的移动设备与嵌入式设备,因为这些设备更关注的是减少内存使用而不是执行速度。 在这个项目研发的过程中,开发团队发现专门为这个 Lite 模式所做的内存优化其实也可以迁移到原来的V8 上,直接两开花。V8 团队近日发表了一个文章,就详细分享了在构建 V8 Lite 的过程中将一些关键的优化部分带到现有 V8 上的过程,以及在实际工作负载中对 V8 性能表现的影响。下边简要介绍一下。 Lite Mode 分析了 V8 如何使用内存以及哪些对象类型占 V8 堆大小的比例很大之后,V8 团队发现,V8 堆的很大一部分专门用于对 JavaScript 执行来说不必要的对象,比如用于优化 JavaScript 执行和处理异常情况。具体来说比如优化代码;用于确定如何优化代码的类型反馈;用于 C++ 和 JavaScript 对象之间绑定的冗余元数据等。 所以团队从这一点入手,想通过大幅减少这些可选对象的内存分配来提高内存使用。同时团队提出了 V8 的 Lite Mode。 通过配置现有的 V8 设置可以直接应用一些 Lite Mode 的优化,例如禁用 V8 的 TurboFan 优化编译器,但是现有 V8 想支持其它 Lite Mode 优化则需要更多的考虑。 比如在 Ignition 解释器中执行代码时,V8 收集有关传递给各种操作(例如,+和o.foo)的操作数类型的反馈,以便为以后的优化定制这些类型。此信息存储在反馈向量中,这些向量占 V8 堆内存使用量的很大一部分。Lite Mode 不优化代码,所以可以直接不去分配这些反馈向量,但是 V8 的内联缓存基础结构的解释器期望反馈向量可用,因此需要相当多的重构才能支持 Lite Mode 这种无反馈执行。 Lite Mode 在 V8 v7.3 中推出,与 V8 v7.1 相比,通过禁用代码优化、不分配反馈向量并执行很少执行的字节码老化,典型网页堆大小减少 22%。 同时在这个过程中,团队还发现,可以通过使 V8 更加“Lazy”来实现 Lite Mode 的大部分内存节省,而不会影响性能。 Lazy feedback allocation 完全禁用反馈向量分配不仅会阻止 V8 的 TurboFan 编译器优化代码,还会阻止 V8 执行常见操作的内联缓存,例如 Ignition 解释器中的对象属性加载。因此,这样做会导致 V8 的执行时间显著回退,页面加载时间减少 12%,典型交互式网页方案中 V8 使用的 CPU 时间增加 120%。 为了在没有这些回退的情况下将大部分内存节省带到常规 V8 中,开发团队设计了在函数执行了一定量的字节码(目前为 1KB)之后,延迟分配反馈向量。由于大多数函数不经常执行,因此在大多数情况下避免使用反馈向量分配,但会在需要的地方快速分配它们以避免性能回退,并仍然允许优化代码。 使用这种方法,会产生另一个问题。反馈向量会形成树结构,内部函数的反馈向量被保留为外部函数的反馈向量中的条目。这是必要的,以便新创建的函数闭包接收与为同一函数创建的所有其它闭包相同的反馈向量数组。在延迟分配反馈向量的情况下,无法使用反馈向量来形成这棵树,因为无法保证外部函数会在内部函数分配其反馈向量之前就对其进行分配。 如下图,为了解决这个问题,开发团队创建了一个新的 ClosureFeedbackCellArray 来维护这个树,当一个函数的 ClosureFeedbackCellArray 变为Hot 时将其与一个完整的 FeedbackVector 交换掉。 实验显示桌面延迟反馈没有出现性能回退,而在移动端,由于垃圾回收减少,性能有所提升,因此 V8 所有版本中都启用了延迟反馈分配。 Lazy source positions 从 JavaScript 编译字节码时,会生成源位置表,将字节码序列绑定到 JavaScript 源代码中的字符位置。但是,仅在表示异常或执行开发人员任务(如调试)时才需要此信息,因此很少使用。 为了避免这种浪费,现在编译字节码而不收集源位置(假设没有附加调试器或分析器)。仅在实际生成堆栈跟踪时收集源位置,例如在调用 Error.stack 或将异常的堆栈跟踪打印到控制台时。这需要一些成本,因为生成源位置需要重新分析和编译函数,但是大多数网站不会在生产中对堆栈跟踪进行符号化,因此不会看到什么性能影响。 Bytecode flushing 从 JavaScript 源编译的字节码,包括相关的元数据占用了大量的 V8 堆空间,通常约为 15%。但是有许多函数只在初始化期间执行,或者在编译后很少使用。所以,V8 针对最近没有执行的情况,添加了在垃圾回收期间支持从函数中刷新已编译字节码的功能。 具体机制是,跟踪函数字节码的 age,每次主要(mark-compact)垃圾回收 age 都递增,并在执行函数时将其重置为零。任何超过老化阈值的字节码都可以被下一次垃圾回收回收,如果它被回收然后再次执行,则会重新编译。 这么设计的难点在于确保字节码仅在不再需要的情况下才可以被刷新。例如,如果函数 A 调用另一个长时间运行的函数 B,函数 A 可能会在它仍然在堆栈上时老化。这时候我们并不想刷新函数 A 的字节码,即使它达到了老化阈值,因为还需要在长时间运行的函数 B 返回时返回它。 解决这个问题的方法是,当字节码达到其老化阈值时,将字节码视为弱保持状态(weakly held),但是在堆栈或其它地方对字节码的任何引用将强烈保持(strongly held),并且只在没有强链接的情况下才可以刷新代码。 除了刷新字节码,同时还刷新与这些刷新函数相关的反馈向量。但是,无法在与字节码相同的 GC 周期内刷新反馈向量,因为它们不会被同一对象保留。字节码由本地上下文独立的 SharedFunctionInfo 保留,而反馈向量由本地上下文相关的JSFunction 保留。因此,会在随后的 GC 循环中刷新反馈向量。 Additional optimizations 此外开发团队还通过减小 FunctionTemplateInfo 对象的大小和对TurboFan 优化代码进行去优化等方面的优化减少了内存使用。 Results 目前已经在 V8 的最新七个版本中发布了上述优化,通常它们会先应用在 Lite Mode 中,然后再进入 V8 的默认配置。 经过测试,在一系列典型网站上将 V8 堆大小平均减少了 18%,相当于低端 AndroidGo 移动设备平均减少 1.5 MB。 通过禁用功能优化,Lite Mode 可以以一定的开销进一步为 JavaScript 执行吞吐量提供内存节省。平均而言,Lite Mode 可节省 22% 的内存,有些页面可节省高达 32% 的内存。这相当于 AndroidGo 设备上 V8 堆大小减少了 1.8 MB。 具体分析每一种优化技术带来的影响,结果如下: 完整优化介绍查看原博客: https://v8.dev/blog/v8-lite

优秀的个人博客,低调大师

一篇文章带你入门应用容器引擎Docker

什么是 Docker Docker 最初是 dotCloud 公司创始人 Solomon Hykes 在法国期间发起的一个公司内部项目,它是基于 dotCloud 公司多年云服务技术的一次革新,并于 2013 年 3 月以 Apache 2.0 授权协议开源,主要项目代码在 GitHub 上进行维护。Docker 项目后来还加入了 Linux 基金会,并成立推动 开放容器联盟(OCI)。 Docker 自开源后受到广泛的关注和讨论,至今其 GitHub 项目已经超过 4 万 6 千个星标和一万多个 fork。甚至由于 Docker 项目的火爆,在 2013 年底,dotCloud 公司决定改名为 Docker。Docker 最初是在 Ubuntu 12.04 上开发实现的;Red Hat 则从 RHEL 6.5 开始对 Docker 进行支持;Google 也在其 PaaS 产品中广泛应用 Docker。 Docker 使用 Google 公司推出的 Go 语言 进行开发实现,基于 Linux 内核的 cgroup,namespace,以及 AUFS 类的 Union FS 等技术,对进程进行封装隔离,属于 操作系统层面的虚拟化技术。由于隔离的进程独立于宿主和其它的隔离的进程,因此也称其为容器。最初实现是基于 LXC,从 0.7 版本以后开始去除 LXC,转而使用自行开发的 libcontainer,从 1.11 开始,则进一步演进为使用 runC 和 containerd。 Docker 在容器的基础上,进行了进一步的封装,从文件系统、网络互联到进程隔离等等,极大的简化了容器的创建和维护。使得 Docker 技术比虚拟机技术更为轻便、快捷。 下面的图片比较了 Docker 和传统虚拟化方式的不同之处。传统虚拟机技术是虚拟出一套硬件后,在其上运行一个完整操作系统,在该系统上再运行所需应用进程;而容器内的应用进程直接运行于宿主的内核,容器内没有自己的内核,而且也没有进行硬件虚拟。因此容器要比传统虚拟机更为轻便。 为什么要使用 Docker? 作为一种新兴的虚拟化方式,Docker 跟传统的虚拟化方式相比具有众多的优势。 更高效的利用系统资源由于容器不需要进行硬件虚拟以及运行完整操作系统等额外开销,Docker 对系统资源的利用率更高。无论是应用执行速度、内存损耗或者文件存储速度,都要比传统虚拟机技术更高效。因此,相比虚拟机技术,一个相同配置的主机,往往可以运行更多数量的应用。 更快速的启动时间传统的虚拟机技术启动应用服务往往需要数分钟,而 Docker 容器应用,由于直接运行于宿主内核,无需启动完整的操作系统,因此可以做到秒级、甚至毫秒级的启动时间。大大地节约了开发、测试、部署的时间。 一致的运行环境 开发过程中一个常见的问题是环境一致性问题。由于开发环境、测试环境、生产环境不一致,导致有些 bug 并未在开发过程中被发现。而 Docker 的镜像提供了除内核外完整的运行时环境,确保了应用运行环境一致性,从而不会再出现 「这段代码在我机器上没问题啊」 这类问题。 持续交付和部署对开发和运维(DevOps)人员来说,最希望的就是一次创建或配置,可以在任意地方正常运行。 使用 Docker 可以通过定制应用镜像来实现持续集成、持续交付、部署。开发人员可以通过 Dockerfile 来进行镜像构建,并结合 持续集成(Continuous Integration) 系统进行集成测试,而运维人员则可以直接在生产环境中快速部署该镜像,甚至结合 持续部署(Continuous Delivery/Deployment) 系统进行自动部署。 而且使用 Dockerfile 使镜像构建透明化,不仅仅开发团队可以理解应用运行环境,也方便运维团队理解应用运行所需条件,帮助更好的生产环境中部署该镜像。 更轻松的迁移由于 Docker 确保了执行环境的一致性,使得应用的迁移更加容易。Docker 可以在很多平台上运行,无论是物理机、虚拟机、公有云、私有云,甚至是笔记本,其运行结果是一致的。因此用户可以很轻易的将在一个平台上运行的应用,迁移到另一个平台上,而不用担心运行环境的变化导致应用无法正常运行的情况。 更轻松的维护和扩展Docker 使用的分层存储以及镜像的技术,使得应用重复部分的复用更为容易,也使得应用的维护更新更加简单,基于基础镜像进一步扩展镜像也变得非常简单。此外,Docker 团队同各个开源项目团队一起维护了一大批高质量的 官方镜像,既可以直接在生产环境使用,又可以作为基础进一步定制,大大地降低了应用服务的镜像制作成本。 评估 Docker 的安全性时,主要考虑三个方面: 由内核的命名空间和控制组机制提供的容器内在安全Docker 程序(特别是服务端)本身的抗攻击性内核安全性的加强机制对容器安全性的影响 内容参考安全大会ISC关于-云计算虚拟化的一个分享,来源安全牛课堂 。

优秀的个人博客,低调大师

云上的Growth hacking之路,打造产品的增长引擎

增长关乎产品的存亡 增长!增长!增长!业务增长是每一个创业者每天面临的最大问题。无论你的产品是APP,还是web,或者是小程序,只能不断的维持用户的增长,才能向资本市场讲出一个好故事,融资活下去。活到最后的产品,才有机会盈利。 为了获取用户的增长,可以投放广告,也可以内容营销、社交传播、销售地推,或者持续的专注于产品优化。无论哪一种方式,我们都面临这几个问题: 运营活动,覆盖了多少用户? 多少用户,开始使用产品? 多少用户付费? 多少用户持续的活跃? 下一步,我们应该把精力放在哪些方面?是持续运营?还是开发新功能? 如果不能回答这些问题,无疑我们的运营活动或者开发就是盲人摸象,完全靠运气。为了解答这些问题,我们不妨关注一下growth hacking这种数据驱动的手段。 Growth Hacker的核心思想 传统的市场营销策略,例如投放电视广告,覆盖

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册