首页 文章 精选 留言 我的

精选列表

搜索[全模态理解],共10000篇文章
优秀的个人博客,低调大师

Android 启动优化(六)- 深入理解布局优化

前言 说到 Android 启动优化,你一般会想到什么呢? Android 多线程异步加载 Android 首页懒加载 对,这是两种很常见的优化手段,但是如果让你主导这件事情,你会如何开始呢? 梳理现有的业务,哪些是一定要在启动初始化的,哪些是不必要的 需要在启动初始化的,哪些是可以在主线程初始化的,哪些是可以在子线程初始化的 当我们把任务丢到子线程初始化,这时候,我们又会遇到两个问题。 在首页,我们需要用到这个库,如果直接使用,这个库可能还没有初始化,这时候直接调用该库,会发生异常,你要怎么解决 当我们的任务相互依赖时,比如 A 依赖于 B, C 也依赖于 B,要怎么解决这种依赖关系。 这些你有想过嘛。答案都在这几篇文章里面了,这里我就不展开讲了。有疑问的可以一起探讨探讨。 Android 启动优化(一) - 有向无环图 Android 启动优化(二) - 拓扑排序的原理以及解题思路 Android 启动优化(三)- AnchorTask 开源了 Android 启动优化(四)- AnchorTask 是怎么实现的 Android 启动优化(五)- AnchorTask 1.0.0 版本正式发布了 接下来,我们来说一下布局优化相关的。 布局优化的现状与发展趋势 耗时原因 众所周知,布局加载一直是耗时的重灾区。特别是启动阶段,作为第一个 View 加载,更是耗时。 而布局加载之所以耗时,有两个原因。 读取 xml 文件,这是一个 IO 操作。 解析 xml 对象,反射创建 View 一些很常见的做法是 减少布局嵌套层数,减少过度绘制 空界面,错误界面等界面进行懒加载那除了这些做法,我们还有哪些手段可以优化呢? 解决方案 异步加载 采用代码的方式编写布局 异步加载 google 很久之前提供了 AsyncLayoutInflater,异步加载的方案,不过这种方式有蛮多坑的,下文会介绍 采用代码的方式编写布局 代码编写的方式编写布局,我们可能想到使用 java 声明布局,对于稍微复杂一点的布局,这种方式是不可取的,存在维护性查,修改困难等问题。为了解决这个问题,github 上面诞生了一系列优秀的开源库。 litho: https://github.com/facebook/litho X2C: https://github.com/iReaderAndroid/X2C 为了即保留xml的优点,又解决它带来的性能问题,我们开发了X2C方案。即在编译生成APK期间,将需要翻译的layout翻译生成对应的java文件,这样对于开发人员来说写布局还是写原来的xml,但对于程序来说,运行时加载的是对应的java文件.我们采用APT(Annotation Processor Tool)+ JavaPoet技术来完成编译期间【注解】->【解注解】->【翻译xml】->【生成java】整个流程的操作。 这两个开源库在大型的项目基本不会使用,不过他们的价值是值得肯定的,核心思想很有意义。 xml 布局加载耗时的问题, google 也想改善这种现状,最近 Compose beta 发布了,他是采用声明式 UI 的方式来编写布局,避免了 xml 带来的耗时。同时,还支持布局实时预览。这个应该是以后的发展趋势。 compose-samples: https://github.com/android/compose-samples 小结 上面讲了布局优化的现状与发展趋势,接下来我们一起来看一下,有哪些布局优化手段,可以应用到项目中的。 渐进式加载 异步加载 compose 声明式 UI 渐进式加载 什么是渐进式加载 渐进式加载,简单来说,就是一部分一部分加载,当前帧加载完成之后,再去加载下一帧。 一种极致的做法是,加载 xml 文件,就想加载一个空白的 xml,布局全部使用 ViewStub 标签进行懒加载。 这样设计的好处是可以减缓同一时刻,加载 View 带来的压力,通常的做法是我们先加载核心部分的 View,再逐步去加载其他 View。 有人可能会这样问了,这样的设计很鸡肋,有什么用呢? 确实,在高端机上面作用不明显,甚至可能看不出来,但是在中低端机上面,带来的效果还是很明显的。在我们项目当中,复杂的页面首帧耗时约可以减少 30%。 优点:适配成本低,在中低端机上面效果明显。 缺点:还是需要在主线程读取 xml 文件 核心伪代码 1start(){2loadA(){3loadB(){4loadC()5}6}7} 上面的这种写法,是可以的,但是这种做法,有一个很明显的缺点,就是会造成回调嵌套层数过多。当然,我们也可以使用 RxJava 来解决这种问题。但是,如果项目中没用 Rxjava,引用进来,会造成包 size 增加。 一个简单的做法就是使用队列的思想,将所有的 ViewStubTask 添加到队列当中,当当前的 ViewStubTask 加载完成,才加载下一个,这样可以避免回调嵌套层数过多的问题。 改造之后的代码见 1valdecorView=this.window.decorView2ViewStubTaskManager.instance(decorView)3.addTask(ViewStubTaskContent(decorView))4.addTask(ViewStubTaskTitle(decorView))5.addTask(ViewStubTaskBottom(decorView))6.start() 1classViewStubTaskManagerprivateconstructor(valdecorView:View):Runnable{ 2 3privatevariViewStubTask:IViewStubTask?=null 4 5companionobject{ 6 7constvalTAG="ViewStubTaskManager" 8 9@JvmStatic10funinstance(decorView:View):ViewStubTaskManager{11returnViewStubTaskManager(decorView)12}13}1415privatevalqueue:MutableList<ViewStubTask>=CopyOnWriteArrayList()16privatevallist:MutableList<ViewStubTask>=CopyOnWriteArrayList()171819funsetCallBack(iViewStubTask:IViewStubTask?):ViewStubTaskManager{20this.iViewStubTask=iViewStubTask21returnthis22}2324funaddTask(viewStubTasks:List<ViewStubTask>):ViewStubTaskManager{25queue.addAll(viewStubTasks)26list.addAll(viewStubTasks)27returnthis28}2930funaddTask(viewStubTask:ViewStubTask):ViewStubTaskManager{31queue.add(viewStubTask)32list.add(viewStubTask)33returnthis34}353637funstart(){38if(isEmpty()){39return40}41iViewStubTask?.beforeTaskExecute()42//指定decorView绘制下一帧的时候会回调里面的runnable43ViewCompat.postOnAnimation(decorView,this)44}4546funstop(){47queue.clear()48list.clear()49decorView.removeCallbacks(null)50}5152privatefunisEmpty()=queue.isEmpty()||queue.size==05354overridefunrun(){55if(!isEmpty()){56//当队列不为空的时候,先加载当前viewStubTask57valviewStubTask=queue.removeAt(0)58viewStubTask.inflate()59iViewStubTask?.onTaskExecute(viewStubTask)60//加载完成之后,再postOnAnimation加载下一个61ViewCompat.postOnAnimation(decorView,this)62}else{63iViewStubTask?.afterTaskExecute()64}6566}6768funnotifyOnDetach(){69list.forEach{70it.onDetach()71}72list.clear()73}7475funnotifyOnDataReady(){76list.forEach{77it.onDataReady()78}79}8081}8283interfaceIViewStubTask{8485funbeforeTaskExecute()8687funonTaskExecute(viewStubTask:ViewStubTask)8889funafterTaskExecute()909192} 源码地址:https://github.com/gdutxiaoxu/AnchorTask,核心代码主要在ViewStubTask,ViewStubTaskManager, 有兴趣的可以看看 异步加载 异步加载,简单来说,就是在子线程创建 View。在实际应用中,我们通常会先预加载 View,常用的方案有: 在合适的时候,启动子线程 inflate layout。然后取的时候,直接去缓存里面查找 View 是否已经创建好了,是的话,直接使用缓存。否则,等待子线程 inlfate 完成。 AsyncLayoutInflater 官方提供了一个类,可以来进行异步的inflate,但是有两个缺点: 每次都要现场new一个出来 异步加载的view只能通过callback回调才能获得(死穴) 因此,我们可以仿造官方的 AsyncLayoutInflater 进行改造。核心代码在 AsyncInflateManager。主要介绍两个方法。 asyncInflate方法,在子线程 inflateView,并将加载结果存放到 mInflateMap 里面。 1@UiThread 2funasyncInflate( 3context:Context, 4varargitems:AsyncInflateItem? 5){ 6items.forEach{item-> 7if(item==null||item.layoutResId==0||mInflateMap.containsKey(item.inflateKey)||item.isCancelled()||item.isInflating()){ 8return 9}10mInflateMap[item.inflateKey]=item11onAsyncInflateReady(item)12inflateWithThreadPool(context,item)13}1415} getInflatedView方法,用来获得异步inflate出来的view,核心思想如下 先从缓存结果里面拿 View,拿到了view直接返回 没拿到view,但是子线程在inflate中,等待返回 如果还没开始inflate,由UI线程进行inflate 1/** 2*用来获得异步inflate出来的view 3* 4*@paramcontext 5*@paramlayoutResId需要拿的layoutId 6*@paramparentcontainer 7*@paraminflateKey每一个View会对应一个inflateKey,因为可能许多地方用的同一个layout,但是需要inflate多个,用InflateKey进行区分 8*@paraminflater外部传进来的inflater,外面如果有inflater,传进来,用来进行可能的SyncInflate, 9*@return最后inflate出来的view10*/11@UiThread12fungetInflatedView(13context:Context?,14layoutResId:Int,15parent:ViewGroup?,16inflateKey:String?,17inflater:LayoutInflater18):View{19if(!TextUtils.isEmpty(inflateKey)&&mInflateMap.containsKey(inflateKey)){20valitem=mInflateMap[inflateKey]21vallatch=mInflateLatchMap[inflateKey]22if(item!=null){23valresultView=item.inflatedView24if(resultView!=null){25//拿到了view直接返回26removeInflateKey(item)27replaceContextForView(resultView,context)28Log.i(TAG,"getInflatedViewfromcache:inflateKeyis$inflateKey")29returnresultView30}3132if(item.isInflating()&&latch!=null){33//没拿到view,但是在inflate中,等待返回34try{35latch.await()36}catch(e:InterruptedException){37Log.e(TAG,e.message,e)38}39removeInflateKey(item)40if(resultView!=null){41Log.i(TAG,"getInflatedViewfromOtherThread:inflateKeyis$inflateKey")42replaceContextForView(resultView,context)43returnresultView44}45}4647//如果还没开始inflate,则设置为false,UI线程进行inflate48item.setCancelled(true)49}50}51Log.i(TAG,"getInflatedViewfromUI:inflateKeyis$inflateKey")52//拿异步inflate的View失败,UI线程inflate53returninflater.inflate(layoutResId,parent,false)54} 简单 Demo 示范 第一步:选择在合适的时机调用AsyncUtils#asyncInflate方法预加载 View, 1objectAsyncUtils{ 2 3funasyncInflate(context:Context){ 4valasyncInflateItem= 5AsyncInflateItem( 6LAUNCH_FRAGMENT_MAIN, 7R.layout.fragment_asny, 8null, 9null10)11AsyncInflateManager.instance.asyncInflate(context,asyncInflateItem)12}1314funisHomeFragmentOpen()=15getSP("async_config").getBoolean("home_fragment_switch",true)16} 第二步:在获取 View 的时候,先去缓存里面查找 View 1overridefunonCreateView( 2inflater:LayoutInflater,container:ViewGroup?, 3savedInstanceState:Bundle? 4):View?{ 5//Inflatethelayoutforthisfragment 6valstartTime=System.currentTimeMillis() 7valhomeFragmentOpen=AsyncUtils.isHomeFragmentOpen() 8valinflatedView:View 910inflatedView=AsyncInflateManager.instance.getInflatedView(11context,12R.layout.fragment_asny,13container,14LAUNCH_FRAGMENT_MAIN,15inflater16)1718Log.i(19TAG,20"onCreateView:homeFragmentOpenis$homeFragmentOpen,timeInstanceis${System.currentTimeMillis()-startTime},${inflatedView.context}"21)22returninflatedView23//returninflater.inflate(R.layout.fragment_asny,container,false)24} 优缺点 优点: 可以大大减少 View 创建的时间,使用这种方案之后,获取 View 的时候基本在 10ms 之内的。 缺点 由于 View 是提前创建的,并且会存在在一个 map,需要根据自己的业务场景将 View 从 map 中移除,不然会发生内存泄露 View 如果缓存起来,记得在合适的时候重置 view 的状态,不然有时候会发生奇奇怪怪的现象。 总结 参考文章:https://juejin.cn/post/6844903924965572615 View 的渐进式加载,在 JectPack compose 没有推广之后,推荐使用这种方案,适配成本低 View 的异步加载方案,虽然效果显著,但是适配成本也高,没搞好,容易发生内存泄露 JectPack compose 声明式 UI,基本是未来的趋势,有兴趣的可以提前了解一下他。 这篇文章,加上一些 Demo,足足花了我几个晚上的时间,觉得不错的话可以关注一下我的微信公众号程序员徐公,小弟在此感谢各位大佬们。主要分享 Android 开发相关的知识,包括 java,kotlin, Android 技术 面试相关的东西,包括常见的面试题目,面试经验分享 算法相关的知识,比如怎么学习算法,leetcode 常见算法总结 一些时事点评,主要是关于互联网的,比如小米高管屌丝事件,拼多多女员工猝死事件等 源码地址:https://github.com/gdutxiaoxu/AnchorTask Android 启动优化(一) - 有向无环图 Android 启动优化(五)- AnchorTask 1.0.0 版本正式发布了 什么?Android webView 的字体突然变小了 徐公啐啐念 - 蹭热点也要有底线 本文分享自微信公众号 - 徐公码字(stormjun94)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
优秀的个人博客,低调大师

深入理解 relocating 对Elasticsearch集群的影响

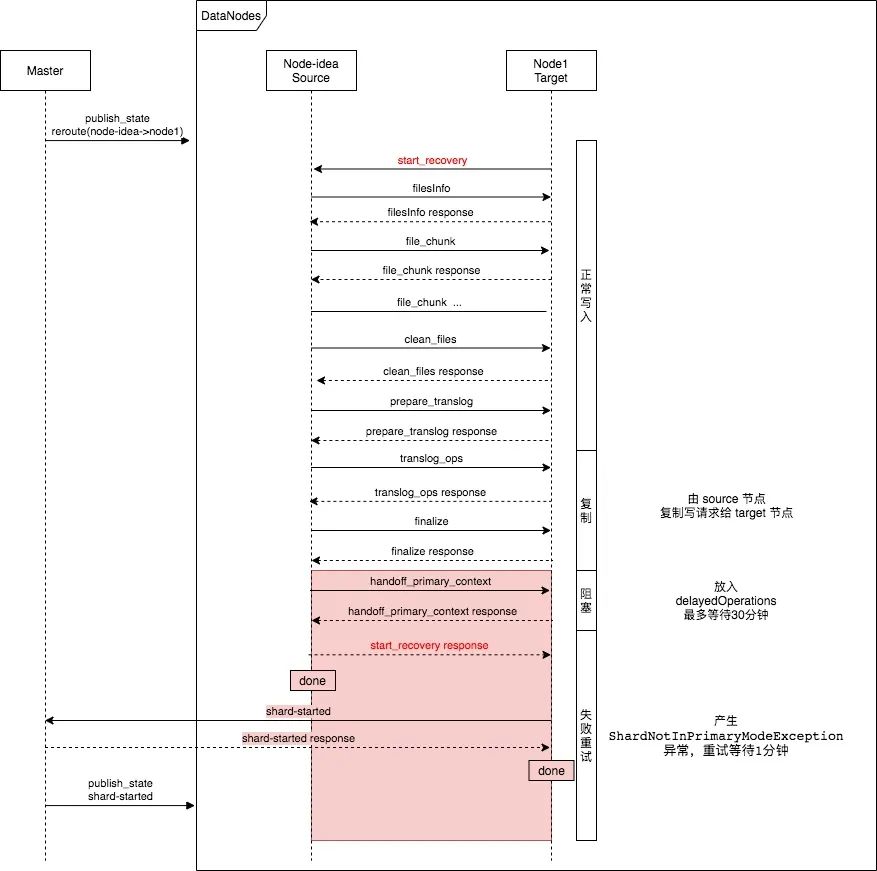
rebalance 用于将集群中的分片进行均衡,保持各个节点的分片数量大致相等,当集群扩容或缩容,掉一个节点的时候,这过程会自动完成。直观的感觉他应该是在后台默默干活的过程,最多占用带宽和磁盘 io 资源,应该感受不到他的存在,但实际情况是,他可能引起一些意想不到的问题。 这篇文章主要思考分片 relocating 对集群会有哪些影响(基于 v7.7),有下面几个。 shard-started RPC 会抢占较多的 master 处理时间 分片移动结束后,target 节点会向 master 发起一个 shard-started PRC,该 RPC 具有次高优先级:URGENT, master 对该 RPC 的处理比较慢,尤其是在集群分片数量到几万的级别,从而可能导致一些较低优先级的 RPC 长时间来不及执行,例如 put-mapping,进而导致对业务的明显影响。 由于 rebalance,allocation filtering,forced awareness等任意原因产生的 shard-started RPC 都会存在这个问题,例如扩容集群的时候,如果把 rebalance 并发开的比较大,对 master 的处理能力造成明显影响。因此对于分片数较多的集群,当你想要加大 rebalance 和 recovery 并发的时候要考虑到对 master 的影响。 move 一个主分片,对写入流程的影响 当一个主分片被 rebalance 或者手工 move 的时候,可以想象必然存在一个时间段该主分片无法写入。 Elasticsearch 对主分片的 relocating 也是直接 move,不会先将主分片资格让给其他副分片,再进行 move,即便如此,也会存在一个时间点进行切换,无法响应写入。 这个时间段从 RPC 的时序来看的话,如下图所示,红色标记的区域为阻塞写入流程的时间段。在该时间段内,客户端的写入请求会被阻塞无返回,直到这部分处理完成。  以手工 move 为例,当一个主分片从 node-idea move 到 node1时,主要有以下几个阶段完成: 首先会通过发布新的集群状态,将该分片标记为 RELOCATING状态,更新 routing_table 和 routing_nodes 数据节点收到集群状态后,开始执行 recovery 流程,该流程自 target 节点发送 start_recovery开始,至 Source 阶段返回 start_recovery response 结束。 recovery 完成后,target发送 shards-started RPC 给 master 节点,master 节点再次下发集群状态,将该分片标记为 STARTED 状态。 阻塞客户端 bulk 写入的阶段,就在 source 节点执行 finalize 阶段时,准备发送 handoff RPC 时开始,直到收到 master 新的集群状态,将该分片标记为 STARTED,每个节点应用集群状态的时间点略有差异,所以每个节点停止阻塞写入的时间点也会有微小差异。 handoff 的 RPC的作用是告知 target 节点该分片可以切换主分片状态,对 handoff RPC 的处理都是一些计算操作,其中涉及到几个锁,一般会很快完成。 整个主分片的 relocating 过程对写入的影响是很复杂的处理过程,我将他们划分为几个阶段,下面是详细过程。 阻塞过程详细原理 在分片的整个 relocating 过程中,对 target 节点的请求都会被转发到 source 节点,直到 target 节点应用了 master 下发的分片变为 STARTED 的集群状态。 正常写入阶段 起初,写入请求到达 source 节点,像往常一样正常写入到主分片中,直到复制阶段。 复制阶段 此阶段将收到的写请求复制给 target 节点。他从收到 prepare_translog 的 response之后开始,直到 handoff 阶段开始之前。 1.将 target 分片加入到 replication group 收到 prepare_translog response之后,recovery 的 phase1阶段已结束,segments 文件发送完毕,target 节点的 engine 已启动。通过 shard.initiateTracking将 target 分片加入到复制组,后续的写入操作都会复制给 target 节点。 prepareEngineStep.whenComplete(prepareEngineTime -> { runUnderPrimaryPermit(() -> shard.initiateTracking(request.targetAllocationId()), shardId + " initiating tracking of " + request.targetAllocationId(), shard, cancellableThreads, logger); final Translog.Snapshot phase2Snapshot = shard.getHistoryOperations("peer-recovery", historySource, startingSeqNo);}); 复制组信息在 ReplicationTracker 的 replicationGroup成员中维护。 2.在写入过程中,将写请求复制给 target 在写入流程的 performOnPrimary#doRun() 函数的 finishRequest方法中,最终调用 ReplicationOperation#handlePrimaryResult函数的 performOnReplicas方法将 index 发送给 target 节点。 handoff阻塞阶段 handoff阶段是为了完成主分片状态的转移,该阶段对收到的写入请求放到队列中,待主分片状态转移完成后继续执行,最多阻塞30分钟。期间对 target 节点的写入也会被转发的 source 节点执行。此阶段从 source 节点收到 finalize 的 response之后开始,直到下一阶段。 1.recovery 过程设置阻塞标记 在 source 节点收到 finalize 的 response之后,通过 handoff RPC 交接主分片状态,这个交接过程通过 indexShardOperationPermits.blockOperations 对此时收到的写入请求进行阻塞,最多30分钟。 public void relocated(final String targetAllocationId, final Consumer<ReplicationTracker.PrimaryContext> consumer){ try { indexShardOperationPermits.blockOperations(30, TimeUnit.MINUTES, () -> {//block 的范围就是这段括号里的代码 final ReplicationTracker.PrimaryContext primaryContext = replicationTracker.startRelocationHandoff(targetAllocationId); try {//下面调用 RemoteRecoveryTargetHandler.handoffPrimaryContext consumer.accept(primaryContext);//执行这里之后发送和响应了 handoff_primary_context RPC } }); } } indexShardOperationPermits.blockOperations 中的阻塞操作只是 queuedBlockOperations 加1,后面写入流程会检查 queuedBlockOperations 的值是否为0 2.写入流程的处理产生在写入链路的 acquire函数: acquire:255, IndexShardOperationPermits (org.elasticsearch.index.shard)acquirePrimaryOperationPermit:2764, IndexShard (org.elasticsearch.index.shard)handlePrimaryRequest:256, TransportReplicationAction 该函数判断 queuedBlockOperations 大于0,于是将他添加到 delayedOperations,写入流程到此结束。delayedOperations中的操作会在本阶段的阻塞过程结束后处理。 失败重试阶段 失败重试阶段自source 节点处理完 handoff response之后开始,直到 master 下发了将分片标记为 STARTED 的集群状态,数据节点应用了集群状态之后结束,在应用这个集群状态之前,分片处于 relocating 状态,期间的写入操作由 source 节点执行,并且会写入失败,抛出 ShardNotInPrimaryModeException 异常,并捕获该异常,等待1分钟后重试写入,再次失败则退出;如果1分钟内收到了新的集群状态,也会重试写入,然后写入成功。 写入流程中,执行 acquire 函数时,发现 queuedBlockOperations为0,执行onAcquired.onResponse(releasable),调用到 wrapPrimaryOperationPermitListener函数时,发现分片已经不是主分片状态,抛出 ShardNotInPrimaryModeException 异常。 if (replicationTracker.isPrimaryMode()) { l.onResponse(r);} else { r.close(); l.onFailure(new ShardNotInPrimaryModeException(shardId, state));} 对于上者返回的异常,写入流程 acquirePrimaryOperationPermit 设置的 Listener会区分异常类型,如果是 ShardNotInPrimaryModeException 异常,则等待1分钟后进行重试。 move 一个副分片,对写入流程的影响 副分片的 move 过程与主分片的 move 过程相似,也是下发两次集群状态,通过 recovery 复制到 target 节点。 需要注意的是,recovery 复制分片到 target 节点,并非从副分片当前所在节点复制到 target,而是从主分片复制到 target。例如,主分片在节点 node-idea 上,副分片在 node-1,当我们从 node-1 move 到 node-2时,recovery 是从 node-idea 复制到 node-2。当 node-1应用主节点发布的分片状态变为 STARTED 的集群状态时,发现分片已经属于自己,于是删除本节点的分片。 与主分片的 relocating 类似的是,在复制阶段,会将正在 recovery 的分片添加到 replication group,这样 replication group 中就有了三个分片,主分片,原副分片,以及 move 到 target 节点的新的副分片。在复制阶段,写入操作会写入到这三个分片。 以手工 move 一个副分片为例,从 node-1 move 到 node-2时,当收到第一个第一个集群状态,分片被标记为 relocating,于是数据从 node-idea recovery 到 node-2。在此期间,新的 index 操作会由主分片节点复制到另外两个节点。如下图所示。 这个过程相当于先增加了一个副分片,执行副分片的 recovery 流程复制到新的 target。 当 recovery 执行完毕,master 下发第二个集群状态,分片被标记为 STARTED,node-1原来持有的分片被删除,如下图所示。 副分片的 relocating 过程不会有 handoff 阶段,整个 relocating 过程如同副分片的 recovery 过程一样,没有对写入进行阻塞的阶段。 (扫码或长按关注本公众号) 本文分享自微信公众号 - Elasticsearch 原理与实践(gh_81a98ec906ca)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
优秀的个人博客,低调大师

从零开始理解HTTP协议及报文分析

前言 从事性能测试必不可绕过的就是协议,对基本知识的了解,还是深入掌握协议的机制,都能让你在从事性能测试实施时显得更加顺手。 下面我们就HTTP协议及性能测试过程必须掌握的一些分析工具来进行分享。 重点分享性能测试实施过程中必须掌握的关键技术、工具。更细节的请参考HTTP相关书籍或RFC文档。 HTTP基本架构 下面我们用一张简单的流程图来展示HTTP协议基本架构,以便大家先有个基本的了解。 Web Client可以是浏览器、搜索引擎、机器人等等一切基于HTTP协议发起http请求的工具。 Web Server可以是任何的能解析HTTP请求,并返回给Web Client可识别的响应的服务,常见的有apache、nginx、IIS等等web服务器。 浓缩就是精华,看下最简洁的HTTP交互图: HTTP报文结构 请求报文 HTTP请求报文由请求行、请求头、空行和请求内容4个部分构成。 如下图所示: 下面对上图进行简单的分析: 请求行 由请求方法字段、URL字段、协议版本字段三部分构成,它们之间由空格隔开。常用的请求方法有:GET、POST、HEAD、PUT、DELETE、OPTIONS、TRACE、CONNECT。 请求头 请求头由key/value对组成,每行为一对,key和value之间通过冒号(:)分割。请求头的作用主要用于通知服务端有关于客户端的请求信息。 典型的请求头有: User-Agent:生成请求的浏览器类型 Accept:客户端可识别的响应内容类型列表;星号*用于按范围将类型分组。*/*表示可接受全部类型,type/*表示可接受type类型的所有子类型。 Accept-Language: 客户端可接受的自然语言 Accept-Encoding: 客户端可接受的编码压缩格式 Accept-Charset:可接受的字符集 Host: 请求的主机名,允许多个域名绑定同一IP地址 connection:连接方式(close或keeplive) Cookie: 存储在客户端的扩展字段 空行 最后一个请求头之后就是空行,用于告诉服务端以下内容不再是请求头的内容了。 请求内容 请求内容主要用于POST请求,与POST请求方法配套的请求头一般有Content-Type(标识请求内容的类型)和Content-Length(标识请求内容的长度) 响应报文 HTTP响应报文由状态行、响应头、空行和响应内容4个部分构成。 如下图所示: 下面对响应报文格式进行简要的分析说明: 状态行 由HTTP协议版本、状态码、状态码描述三部分构成,它们之间由空格隔开。 状态码由3位数字组成,第一位标识响应的类型,常用的5大类状态码如下: 1xx:表示服务器已接收了客户端的请求,客户端可以继续发送请求 2xx:表示服务器已成功接收到请求并进行处理 3xx:表示服务器要求客户端重定向 4xx:表示客户端的请求有非法内容 5xx:标识服务器未能正常处理客户端的请求而出现意外错误 常见状态码说明: 200 OK:表示客户端请求成功 400 Bad Request:表示客户端请求有语法错误,不能被服务器端解析 401 Unauthonzed:表示请求未经授权,该状态码必须与WWW-Authenticate报文头一起使用 404 Not Found:请求的资源不存在,例如输入了错误的url 500 Internal Server Error:表示服务器发生了不可预期的错误,导致无法完成客户端的请求 503 Service Unavailable:表示服务器当前不能处理客户端的请求,在一段时间后服务器可能恢复正常 响应头 一般情况下,响应头会包含以下,甚至更多的信息。 Location:服务器返回给客户端,用于重定向到新的位置 Server:包含服务器用来处理请求的软件信息及版本信息 Vary:标识不可缓存的请求头列表 Connection: 连接方式。 对于请求端来讲:close是告诉服务端,断开连接,不用等待后续的求请了。keeplive则是告诉服务端,在完成本次请求的响应后,保持连接,等待本次连接后的后续请求。 对于响应端来讲:close表示连接已经关闭。keeplive则表示连接保持中,可以继续处理后续请求。Keep-Alive表示如果请求端保持连接,则该请求头部信息表明期望服务端保持连接多长时间(秒),例如300秒,应该这样写Keep-Alive: 300 空行 最后一个响应头之后就是空行,用于告诉请求端以下内容不再是响应头的内容了。 响应内容 服务端返回给请求端的文本信息。 HTTP报文示例 在这里我们在Firefox下用firebug随意抓取一个HTTP包和上文的报文结构做下一一对应关系图,以便大家了解实际的包和标准报文结构的对应关系。 总结 对于HTTP协议的交互过程这里就不再进行说明了,大家可以搜索下相关的资料进行学习,上述的内容请务必熟练掌握、深刻了解。更详细的内容推荐大家学习RFC 2616(http协议1.1版本,有中文版本) 更多精彩: 工具篇 - JMeter之旅01 工具篇 - JMeter目录及关键配置分析02 webdriver介绍&与Selenium RC的比较 Python Selenium Webdriver安装手册 创建你的第一个webdriver python代码 基于Excel参数化你的Selenium2测试 Python Selenium设计模式-POM Python多线程Selenium跨浏览器测试 python selenium2示例 - 生成 HTMLTestRunner 测试报告 随意支持下,一起做好分享 扫一扫或长按关注开源优测公众号,原创文章首发平台 在公众号里回复一下关键字获取对应的系列文章 物联网 appium 大数据测试 RobotFramework Python 自动驾驶 jmeter selenium jenkins 接口测试 顺手点点点右下角的 本文分享自微信公众号 - 开源优测(DeepTest)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

谈谈对于企业级系统架构的理解

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 在我们刚开始学习架构的时候,首先会想到分层的概念,分层架构比较经典的是三层架构,那么,什么是三层架构呢?它包括表现层、业务层、数据访问层;而对于一个新手来说,从抽象意义上的三层架构,逻辑上就划分为三个层。 这个是最基本的三层架构模式。 表现层充当系统的界面呈现以及UI逻辑的角色,也就是说,UI(用户界面)属于表现层; 举一个对于asp.net WebForm来说,人们喜欢把对于UI的控制逻辑(服务器控件的读取、设置、事件等等)写在页面的后置隐藏代码中,并且依赖业务逻辑层。当然,服务器控件支持数据绑定的功能,可以通过数据源进行绑定控件。这样就可以节省在后置隐藏中的代码。 因此,我们就可以把表现层分为UI用户界面以及UI逻辑: UI用户界面的职责只是作为数据输入和输出后的展示工作。 UI逻辑的职责是负责业务逻辑层以及UI用户界面之间的数据交互,并且尽可能地让UI逻辑不依赖于UI技术。 其中UI用户界面的实现方式有很多,包括ASP.NET、WinForm、WPF、Silverlight、移动Web、智能设备等等。 将表现层中UI页面和UI逻辑分离的策略中,当前使用最多的两种模式是MVC模式和MVP模式。 MVC模式,即模型-视图-控制器模式,通过视图触发并执行某个操作,调用控制器,通过控制器去操作业务层,最终返回模型,在视图中进行展示。这里的模型可以是一个领域模型(DM),也可以是一个数据迁移对象(DTO)。 MVP模式,即模型-视图-展示器模式,和MVC模式有点像,不同的是MVP中视图和模型是被完全分离出来的,视图中定义一个接口,而展示器通过调用该接口的方法以控制视图。因此,视图和模型是松散的,展示器也充当了一个控制器的角色,同时它也不依赖于UI技术。 另外再介绍一种模式PM(Preentation Model),它可以说是MVP的变体,在PM中,视图不定义接口,这里的模型只是表示视图状态的类,视图中的元素被直接绑定到模型属性上。例如在WPF中,WPF就先天的具有数据双向绑定机制以及事件通知属性机制。 所以它特别适用于WPF,Sliverlight等等。 在开始业务层之前,不得不说一个前提,在一个小型项目中,直接让表现层调用业务层,足以解决所有问题。但是,当项目大到使用多种表现形式,如使用了各种UI技术、ASP.NET、WPF、移动设备等等,就要考虑在你的表现层和业务层之间增加一个层,以至于让表现层和业务层解耦,因为业务层作为一个业务中间件的平台,最好不要暴露于表现层中,这个层就是传说中的服务层。架构图又演化为: 服务层实际上并不执行任何具体的工作,其功能在于组织各个业务对象,服务层将业务层所有的细节对表现层都隐藏起来,服务器将组织业务逻辑层中的组件,并且通过数据迁移对象(DTO)与表现层交互,因此就产生一个DTO模型。 为了实现服务的可重用性,需要使用服务接口,表现层通过规定的接口访问功能。服务的实现继承服务接口,而服务的实现专注于业务层的调用。 对于服务层,常用的方法包括Web服务、.NET Remoting、Rest以及WCF技术。 本人比较建议使用WCF作为服务,因为可以方便地通过配置达到远程调用服务的目的。 服务层消除了两个表现层和业务层之间的耦合,服务层可以实现一个远程接口,达到多UI技术甚至多平台上的通信。 当然增加服务层也有缺点,假如使用WCF服务,会增加系统的调用开销,进而影响性能。 业务层中包含系统所需要业务过程上的实现,并与下层的数据访问层交互。 我们通常也叫做业务层叫做业务逻辑层,但我认为业务逻辑层是属于业务层的一方面,业务逻辑更专注于业务上逻辑算法的实现。因为业务层还可以包括其他的方面。 业务层必须包括对业务实体尽心建模的对象模型,表达了客户的所有策略和需求的业务规则,因此就产生了领域模型。 (PS:如果这里你不使用领域模型,那么需要采用业务规则层进行业务功能上的业务规则的验证和控制) 领域模型包括对实体的属性定义,方法定义以及实体与实体之间的关系。从这个角度上看,UML建模至关重要,通过对UML动态图和静态图的描述,可以映射到领域模型中。 从服务层刚才讲到了DTO模型,这里需要一个机制将DTO转化为领域模型,所以产生了DTO映射层(DTOMapper)。 另外业务层还包括核心中间件技术,包括第三方组件,以及工作流引擎等等。 业务层需要考虑到一些与数据访问层交互的设计模式,模式中包括事物脚本模式、表模块模式、活动记录模式、领域模型模式。 事物脚本模式是通过方法来执行业务流程,它是一个过程式模型,事物脚本的每个方法都有一个特定的事物脚本,它侧重于业务上一系列流程上的顺序操作,它实现起来很简单,但是它有个致命的缺点就是它会造成很多重复的代码。 表模块模式比起事物脚本模式,具有一定的结构,它的思想也很简单,每个数据表都定义一个业务组件(实体类,实体操作类),在.NET中更多的使用DataSet作为表模型的数据交互。但是它也有一个缺点就是它是从数据库驱动它不适合于大量的数据表以及数据表之间的复杂关系。 活动记录模式中的对象中,可以包含数据和方法。它接近于数据表的结构,它的对象中执行方法中可以包含CRUD操作,验证算法,以及其他的计算功能。一般来说,领域模型不是太复杂,活动记录模式是个好选择。当然他也存在问题,同样地,它对于复杂的业务上,维护的成本也很高,并且如果需求变更导致数据库修改,就需要调整记录对象模型中的相关代码。 经典应用:LINQ-TO-SQL以及Castle ActiveRecord。 领域模型模式是从领域驱动设计中衍生来的,它是以业务为核心的设计模式。它对于复杂的业务逻辑,相当适用。前三种方式使用的是以数据驱动方式,数据驱动方式特点简单,但是当系统到了一定的规模后,就会到难以维护的程度。 数据访问层的目的很明确,主要作为提供数据持久化的功能,包括数据的读取和写入,另外还必须包括事务处理,并发控制等等。 操作数据库的方法可以有两种方式:ORM方式、ADO.NET方式。 ORM可以采用一些第三方的ORM框架来实现,ADO.NET采用ASP.NET自带的数据库操作来实现。 不同的数据库具有不同的持久化实现,因此这里添加一个存储仓库接口层,来适应不同的数据库实现,这里你可以使用IOC依赖注入方式进行数据库选型,可以利用Unity、Spring.NET、Castle的IOC容器等等。 最后各个层中都可以依赖于公共基础设施层。 公共基础设施层可以包括Common通用模块、Logging日志模块、Exception异常模块、Configuration配置模块、DI依赖注入模块、单元测试模块以及第三方组件(例如NHibernate、Sprint.NET、Castle、Quartz计划任务等等) 最终图: 总结:项目类型、项目规模以及业务上的需求,都影响着系统架构的设计,系统架构并不是一层不变的,没有最好的架构,只有更好的架构,并且从项目中多思考系统的扩展性。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-07-31本文作者:CRM咨询本文来自:“51CTO”,了解相关信息可以关注“51CTO”

优秀的个人博客,低调大师

java深入理解浅拷贝和深拷贝

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 简介 拷贝对象是java中经常会遇到的问题。java中存在两种类型,基础类型和引用类型。 java的赋值都是传值的,对于基础类型来说,会拷贝具体的内容,但是对于引用对象来说,存储的这个值只是指向实际对象的地址,拷贝也只会拷贝引用地址。 因为引用对象的存在,所以经常会出现和预期不一样的情况。 本文将会深入的探讨一下在拷贝对象中会出现的浅拷贝和深拷贝的情况。 拷贝接口 java中所有的对象都是继承自java.lang.Object。Object对象中提供了一个clone方法,来供我们对java对象进行拷贝。 这个clone方法是native的,所以不需要我们来实现,但是注意clone方法还是protected,这意味着clone方法只能在java.lang包或者其子类可见。 如果我们想要在一个程序中调用某个对象的clone方法则是不可以的。因为clone方法是定义在Object中的,该对象并没有对外可见的clone方法。 JDK的建议是让我们去实现接口Cloneable,实现了这个接口就表示这个对象可以调用Object的clone方法。 注意,即使你实现了Cloneable接口,还是无法在外部程序中调用该对象的clone方法: 因为Cloneable是空的,明没有强制要你去实现clone方法。 这是JDK在设计上的问题,导致clone方法并不像预期那么好用。 首先clone只是对象的拷贝,它只是简单的拷贝对象,而不会去执行对象的构造函数。 其次clone会导致浅拷贝的问题。 使用clone导致的浅拷贝 我们举个clone产生的浅拷贝的例子,我们定义一个对象中的对象,然后尝试拷贝: 上面的例子中,我们定义了CustUser和Address。 浅拷贝我们只调用了CustUser的clone方法。看下输出结果: 我们可以看到拷贝之后的Address变化会影响到被拷贝的对象。 上面的例子我们还要关注两个点:第一点String是不可变的。不管是拷贝还是赋值,String都是不可变的。 第二点,上面的例子中我们定义了一个数组,可以看到如果只是调用clone的话,数组也是浅拷贝。 使用clone的深拷贝 要使用深拷贝,只需要修改CustUser的构造函数就可以了: 在重写的clone方法中,我们分别调用了CustUser,Address和数组的clone方法来进行拷贝。 再运行一次上面的测试代码: 可以看到address和cars是不同的,这表示我们的深拷贝是成功的。 不要overridden clone 上面的例子我们是通过overridden Object的clone方法来实现的。 但是最佳实践是不要overridden clone。那我们怎么做呢? 使用构造函数来构建新的对象: 据说数组直接用clone来拷贝会更快,也可以使用下面的方式来拷贝数组: 总结 本文讲解了浅拷贝和深拷贝的应用,并对clone方法做了深入的探讨。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-05-11本文作者:flydean本文来自:“掘金”,了解相关信息可以关注“掘金”

优秀的个人博客,低调大师

每日一博 | 深入理解JVM - 方法调用

方法调用并不等同于方法中的代码被执行,方法调用阶段唯一的任务就是确定被调用方法的版本(即调用哪一个方法),暂时还未涉及方法内部的具体运行过程。一切方法调用在Class文件里面存储的都只是符号引用,而不是方法在实际运行时内存布局中的入口地址(也就是之前说的直接引用)。 解析 所有方法调用的目标方法在Class文件里面都是一个常量池中的符号引用,在类加载的解析阶段,会将其中的一部分符号引用转化为直接引用,这种解析能够成立的前提是:方法在程序真正运行之前就有一个可确定的调用版本,并且这个方法的调用版本在运行期是不可改变的。换句话说,调用目标在程序代码写好、编译器进行编译那一刻就已经确定下来。这类方法的调用被称为解析(Resolution),在Java语言中符合这种要求的主要有静态方法和私有方法。 方法调用指令 invokestatic:用于调用静态方法。 invokespecial:用于调用实例构造器<init>()方法、私有方法和父类中的方法。 invokevirtual:用于调用所有的虚方法。 invokeinterface:用于调用接口方法,会在运行时再确定一个实现该接口的对象。 invokedynamic:先在运行时动态解析出调用点限定符所引用的方法,然后再执行该方法。 前面4条调用指令,分派逻辑都固化在Java虚拟机内部,而invokedynamic指令的分派逻辑是由用户设定的引导方法来决定的。 方法分类 在java语言中方法主要分为“虚方法”和“非虚方法”。 非虚方法:在类加载的时候就可以把符号引用解析为该方法的直接引用。比如:静态方法、私有方法、实例构造器、父类方法和被final修饰的方法。 虚方法:需要在运行时才能将符号引用转换成直接引用,如,分派。 分派 分派(Dispatch)它可能是静态的也可能是动态的,按照分派依据的宗量数可分为单分派和多分派。这两类分派方式两两组合就构成了静态单分派、静态多分派、动态单分派、动态多分派4种分派组合情况。 静态分派 依赖静态类型来决定方法执行版本的分派动作,都称为静态分派。静态分派的最典型应用表现就是方法重载,虚拟机(或者准确地说是编译器)在重载时是通过参数的静态类型来作为判定依据的。 public class StaticDispatch { static abstract class Human { } static class Man extends Human { } static class Woman extends Human { } public void sayHello(Human guy) { System.out.println("hello,guy!"); } public void sayHello(Man guy) { System.out.println("hello,gentleman!"); } public void sayHello(Woman guy) { System.out.println("hello,lady!"); } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); StaticDispatch sr = new StaticDispatch(); sr.sayHello(man); sr.sayHello(woman); } } 运行结果: hello,guy! hello,guy! Human man = new Man(); 这里的Human 就是变量的“静态类型”(Static Type),或者叫“外观类型”(Apparent Type);Man就是变量的“实际类型”(Actual Type)或者叫“运行时类型”(Runtime Type)。 动态分派 我们把在运行期根据实际类型确定方法执行版本的分派过程称为动态分派。最典型的表现就是重写。 public class DynamicDispatch { static abstract class Human { abstract void sayHello(); } static class Man extends Human { public void sayHello() { System.out.println("hello,Man!"); } } static class Woman extends Human { public void sayHello() { System.out.println("hello,Woman!"); } } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); man.sayHello(); woman.sayHello(); } } 运行结果: hello,Man! hello,Woman! 我们通过javap命令看下main方法的字节码: ... public static void main(java.lang.String[]); descriptor: ([Ljava/lang/String;)V flags: ACC_PUBLIC, ACC_STATIC Code: stack=2, locals=3, args_size=1 0: new #2 // class com/xiaolyuh/DynamicDispatch$Man 3: dup 4: invokespecial #3 // Method com/xiaolyuh/DynamicDispatch$Man."<init>":()V 7: astore_1 8: new #4 // class com/xiaolyuh/DynamicDispatch$Woman 11: dup 12: invokespecial #5 // Method com/xiaolyuh/DynamicDispatch$Woman."<init>":()V 15: astore_2 16: aload_1 17: invokevirtual #6 // Method com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 20: aload_2 21: invokevirtual #6 // Method com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 24: return LineNumberTable: line 27: 0 line 28: 8 line 29: 16 line 30: 20 line 31: 24 LocalVariableTable: Start Length Slot Name Signature 0 25 0 args [Ljava/lang/String; 8 17 1 man Lcom/xiaolyuh/DynamicDispatch$Human; 16 9 2 woman Lcom/xiaolyuh/DynamicDispatch$Human; } ... 通过字节码我们发现:在main方法中,sayHello()方法的调用对应的符号引用是一样的,com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 。在这里我们可以得出一个结论:在动态分派的情况下,在编译时期我们是无法确定方法的直接引用的,那么它是怎么实现重载方法的调用的呢?问题关键是在invokevirtual指令上,在执行invokevirtual指令时,invokevirtual指令会去确定方法的调用版本。 invokevirtual指令的运行过程 找到操作数栈顶的第一个元素所指向的对象的实际类型,记作C。 如果在类型C中找到与常量中的描述符和简单名称都相符的方法,则进行访问权限校验,如果通过则返回这个方法的直接引用,查找过程结束;不通过则返回java.lang.IllegalAccessError异常。 否则,按照继承关系从下往上依次对C的各个父类进行第二步的搜索和验证过程。4. 如果始终没有找到合适的方法,则抛出java.lang.AbstractMethodError异常。 正是因为invokevirtual指令执行的第一步就是在运行期确定接收者的实际类型,所以两次调用中的invokevirtual指令并不是把常量池中方法的符号引用解析到直接引用上就结束了,还会根据方法接收者的实际类型来选择方法版本,这个过程就是Java语言中方法重写的本质。 当子类声明了与父类同名的字段时,虽然在子类的内存中两个字段都会存在,但是子类的字段会遮蔽父类的同名字段 动态分派的实现 因为动态方法执行非常频繁,并且动态分派的方法版本选择需要在运行时,在实际接受者类型的方法元数据中搜索合适的目标方法,因此,Java虚拟机实现基于执行性能的考虑,虚拟机会为类型在方法区中建立一个虚方法表(Virtual Method Table,也称为vtable,与此对应的,在invokeinterface执行时也会用到接口方法表——Interface Method Table,简称itable),使用虚方法表索引来代替元数据查找以提高性能。 虚方法表中存放着各个方法的实际入口地址。如果某个方法在子类中没有被重写,那子类的虚方法表中的地址入口和父类相同方法的地址入口是一致的,都指向父类的实现入口。如果子类中重写了这个方法,子类虚方法表中的地址也会被替换为指向子类实现版本的入口地址。在图中,Son重写了来自Father的全部方法,因此Son的方法表没有指向Father类型数据的箭头。但是Son和Father都没有重写来自Object的方法,所以它们的方法表中所有从Object继承来的方法都指向了Object的数据类型。 虚方法表一般在类加载的连接阶段进行初始化,准备了类的变量初始值后,虚拟机会把该类的虚方法表也一同初始化完毕。 单分派与多分派 方法的接收者与方法的参数统称为方法的宗量。分派基于多少种宗量,可以将分派划分为单分派和多分派两种。单分派是根据一个宗量对目标方法进行选择,多分派则是根据两个及以上的宗量对目标方法进行选择。 静态分派需要根据静态类型和方法参数两个宗量来确定方法调用,所以属于多分派。 动态分派只需要根据实际类型一个宗量来确定方法的调用,所以属于单分派。 在动态分派的过程中,方法签名是确定的,所以方法参数就不会变,方法调用就取决于参数的实际类型。 总结 解析调用一定是个静态的过程,在编译期间就完全确定,在类加载的解析阶段就会把涉及的符号引用全部转变为明确的直接引用,不必延迟到运行期再去完成。分派(Dispatch)调用则要复杂许多,它可能是静态的也可能是动态的,按照分派依据的宗量数可分为单分派和多分派。这两类分派方式两两组合就构成了静态单分派、静态多分派、动态单分派、动态多分派4种分派组合情况。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册