首页 文章 精选 留言 我的

精选列表

搜索[全模态理解],共10000篇文章
优秀的个人博客,低调大师

Scala关键字lazy的理解和使用

Scala中使用关键字lazy来定义惰性变量,实现延迟加载(懒加载)。惰性变量只能是不可变变量,并且只有在调用惰性变量时,才会去实例化这个变量。 在Java中,要实现延迟加载(懒加载),需要自己手动实现。一般的做法是这样的: public class LazyDemo { private String property; public String getProperty() { if (property == null) {//如果没有初始化过,那么进行初始化 property = initProperty(); } return property; } private String initProperty() { return "property"; } } 比如常用的单例模式懒汉式实现时就使用了上面类似的思路实现。 而在Scala中对延迟加载这一特性提供了语法级别的支持: lazy val property = initProperty() 使用lazy关键字修饰变量后,只有在使用该变量时,才会调用其实例化方法。也就是说在定义property=initProperty()时并不会调用initProperty()方法,只有在后面的代码中使用变量property时才会调用initProperty()方法。 如果不使用lazy关键字对变量修饰,那么变量property是立即实例化的: object LazyOps { def init(): String = { println("call init()") return "" } def main(args: Array[String]) { val property = init();//没有使用lazy修饰 println("after init()") println(property) } } 上面的property没有使用lazy关键字进行修饰,所以property是立即实例化的,如果观察程序的输出: call init() after init() 可以发现,property声明时,立即进行实例化,调用了init()`实例化方法 而如果使用lazy关键字进行修饰: object LazyOps { def init(): String = { println("call init()") return "" } def main(args: Array[String]) { lazy val property = init();//使用lazy修饰 println("after init()") println(property) println(property) } } 观察输出: after init() call init() 在声明property时,并没有立即调用实例化方法intit(),而是在使用property时,才会调用实例化方法,并且无论缩少次调用,实例化方法只会执行一次。 与Java相比起来,实现懒加载确实比较方便了。那么Scala是如何实现这个语法糖的呢?反编译看下Scala生成的class: private final String property$lzycompute$1(ObjectRef property$lzy$1, VolatileByteRef bitmap$0$1) { synchronized (this)//加锁 { if ((byte)(bitmap$0$1.elem & 0x1) == 0)//如果属性不为null {//那么进行初始化 property$lzy$1.elem = init();bitmap$0$1.elem = ((byte)(bitmap$0$1.elem | 0x1)); } return (String)property$lzy$1.elem; } } Scala同样使用了Java中常用的懒加载的方式自动帮助我们实现了延迟加载,并且还加锁避免多个线程同时调用初始化方法可能导致的不一致问题。 借鉴崔鹏飞的小结 对于这样一个表达式: lazy val t:T = expr 无论expr是什么东西,字面量也好,方法调用也好。Scala的编译器都会把这个expr包在一个方法中,并且生成一个flag来决定只在t第一次被访问时才调用该方法。 本文的编写借鉴了剥开Scala的糖衣(5) -- Lazy

优秀的个人博客,低调大师

深入理解JVM(八)——类加载的时机

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612705 类的生命周期 一个类从加载进内存到卸载出内存为止,一共经历7个阶段:加载——>验证——>准备——>解析——>初始化——>使用——>卸载 其中,类加载包括5个阶段:加载——>验证——>准备——>解析——>初始化 在类加载的过程中,以下3个过程称为连接:验证——>准备——>解析 因此,JVM的类加载过程也可以概括为3个过程:加载——>连接——>初始化 C/C++在运行前需要完成预处理、编译、汇编、链接;而在Java中,类加载(加载、连接、初始化)是在程序运行期间完成的。在程序运行期间进行类加载会稍微增加程序的开销,但随之会带来更大的好处——提高程序的灵活性。Java语言的灵活性体现在它可以在运行期间动态扩展,所谓动态扩展就是在运行期间动态加载和动态连接。 类加载的时机 1. 类加载过程中每个步骤的顺序 我们已经知道,类加载的过程包括:加载、连接、初始化,连接又分为:验证、准备、解析,所以说类加载一共分为5步:加载、验证、准备、解析、初始化。 其中加载、验证、准备、初始化的开始顺序是依次进行的,这些步骤开始之后的过程可能会有重叠。而解析过程会发生在初始化过程中。 2. 类加载过程中“初始化”开始的时机 JVM规范中只定义了类加载过程中初始化过程开始的时机,加载、连接过程都应该在初始化之前开始(解析除外),这些过程具体在何时开始,JVM规范并没有定义,不同的虚拟机可以根据具体的需求自定义。 初始化开始的时机: 在运行过程中遇到如下字节码指令时,如果类尚未初始化,那就要进行初始化:new、getstatic、putstatic、invokestatic。这四个指令对应的Java代码场景是: 通过new创建对象; 读取、设置一个类的静态成员变量(不包括final修饰的静态变量); 调用一个类的静态成员函数。 使用java.lang.reflect进行反射调用的时候,如果类没有初始化,那就需要初始化; 当初始化一个类的时候,若其父类尚未初始化,那就先要让其父类初始化,然后再初始化本类; 当虚拟机启动时,虚拟机会首先初始化带有main方法的类,即主类; 3. 主动引用 与 被动引用 JVM规范中要求在程序运行过程中,“当且仅当”出现上述4个条件之一的情况才会初始化一个类。如果间接满足上述初始化条件是不会初始化类的。其中,直接满足上述初始化条件的情况叫做主动引用;间接满足上述初始化过程的情况叫做被动引用。那么,只有当程序在运行过程中满足主动引用的时候才会初始化一个类,若满足被动引用就不会初始化一个类。 4. 被动引用的场景示例 示例一 public class Fu{ public static String name = "柴毛毛"; static{ System.out.println("父类被初始化!"); } } public class Zi{ static{ System.out.println("子类被初始化!"); } } public static void main(String[] args){ System.out.println(Zi.name); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 输出结果:父类被初始化!柴毛毛原因分析:本示例看似满足初始化时机的第一条:当要获取某一个类的静态成员变量的时候如果该类尚未初始化,则对该类进行初始化。但由于这个静态成员变量属于Fu类,Zi类只是间接调用Fu类中的静态成员变量,因此Zi类调用name属性属于间接引用,而Fu类调用name属性属于直接引用,由于JVM只初始化直接引用的类,因此只有Fu类被初始化。 示例二 public class A{ public static void main(String[] args){ Fu[] arr = new Fu[10]; } } 1 2 3 4 5 输出结果:并没有输出“父类被初始化!”原因分析:这个过程看似满足初始化时机的第一条:遇到new创建对象时若类没被初始化,则初始化该类。但现在通过new要创建的是一个数组对象,而非Fu类对象,因此也属于间接引用,不会初始化Fu类。 示例三 public class Fu{ public static final String name = "柴毛毛"; static{ System.out.println("父类被初始化!"); } } public class A{ public static void main(String[] args){ System.out.println(Fu.name); } } 1 2 3 4 5 6 7 8 9 10 11 12 输出结果:柴毛毛原因分析:本示例看似满足类初始化时机的第一个条件:获取一个类静态成员变量的时候若类尚未初始化则初始化类。但是,Fu类的静态成员变量被final修饰,它已经是一个常量。被final修饰的常量在Java代码编译的过程中就会被放入它被引用的class文件的常量池中(这里是A的常量池)。所以程序在运行期间如果需要调用这个常量,直接去当前类的常量池中取,而不需要初始化这个类。 5. 接口的初始化 接口和类都需要初始化,接口和类的初始化过程基本一样,不同点在于:类初始化时,如果发现父类尚未被初始化,则先要初始化父类,然后再初始化自己;但接口初始化时,并不要求父接口已经全部初始化,只有程序在运行过程中用到当父接口中的东西时才初始化父接口。

优秀的个人博客,低调大师

深入理解JVM(三)——垃圾收集策略详解

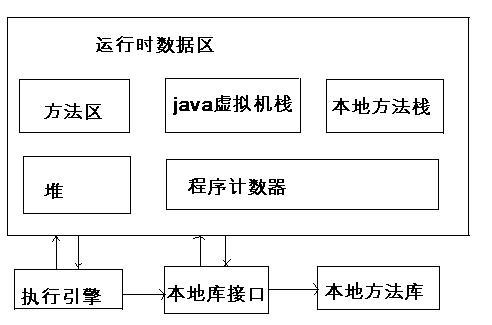
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612610 Java虚拟机的内存模型分为五个部分,分别是:程序计数器、Java虚拟机栈、本地方法栈、堆、方法区。 这五个区域既然是存储空间,那么为了避免Java虚拟机在运行期间内存存满的情况,就必须得有一个垃圾收集者的角色,不定期地回收一些无效内存,以保障Java虚拟机能够健康地持续运行。 这个垃圾收集者就是平常我们所说的“垃圾收集器”,那么垃圾收集器在何时清扫内存?清扫哪些数据?这就是接下来我们要解决的问题。 程序计数器、Java虚拟机栈、本地方法栈都是线程私有的,也就是每条线程都拥有这三块区域,而且会随着线程的创建而创建,线程的结束而销毁。那么,垃圾收集器在何时清扫这三块区域的问题就解决了。 此外,Java虚拟机栈、本地方法栈中的栈帧会随着方法的开始而入栈,方法的结束而出栈,并且每个栈帧中的本地变量表都是在类被加载的时候就确定的。因此以上三个区域的垃圾收集工作具有确定性,垃圾收集器能够清楚地知道何时清扫这三块区域中的哪些数据。 然而,堆和方法区中的内存清理工作就没那么容易了。堆和方法区所有线程共享,并且都在JVM启动时创建,一直得运行到JVM停止时。因此它们没办法根据线程的创建而创建、线程的结束而释放。 堆中存放JVM运行期间的所有对象,虽然每个对象的内存大小在加载该对象所属类的时候就确定了,但究竟创建多少个对象只有在程序运行期间才能确定。方法区中存放类信息、静态成员变量、常量。类的加载是在程序运行过程中,当需要创建这个类的对象时才会加载这个类。因此,JVM究竟要加载多少个类也需要在程序运行期间确定。因此,堆和方法区的内存回收具有不确定性,因此垃圾收集器在回收堆和方法区内存的时候花了一些心思。 堆内存的回收 1. 如何判定哪些对象需要回收? 在对堆进行对象回收之前,首先要判断哪些是无效对象。我们知道,一个对象不被任何对象或变量引用,那么就是无效对象,需要被回收。一般有两种判别方式: 引用计数法每个对象都有一个计数器,当这个对象被一个变量或另一个对象引用一次,该计数器加一;若该引用失效则计数器减一。当计数器为0时,就认为该对象是无效对象。 可达性分析法所有和GC Roots直接或间接关联的对象都是有效对象,和GC Roots没有关联的对象就是无效对象。GC Roots是指: Java虚拟机栈所引用的对象(栈帧中局部变量表中引用类型的变量所引用的对象) 方法区中静态属性引用的对象 方法区中常量所引用的对象 本地方法栈所引用的对象PS:注意!GC Roots并不包括堆中对象所引用的对象!这样就不会出现循环引用。 两者对比:引用计数法虽然简单,但存在一个严重的问题,它无法解决循环引用的问题。因此,目前主流语言均使用可达性分析方法来判断对象是否有效。 2. 回收无效对象的过程 当JVM筛选出失效的对象之后,并不是立即清除,而是再给对象一次重生的机会,具体过程如下: 判断该对象是否覆盖了finalize()方法 若已覆盖该方法,并该对象的finalize()方法还没有被执行过,那么就会将finalize()扔到F-Queue队列中; 若未覆盖该方法,则直接释放对象内存。 执行F-Queue队列中的finalize()方法虚拟机会以较低的优先级执行这些finalize()方法们,也不会确保所有的finalize()方法都会执行结束。如果finalize()方法中出现耗时操作,虚拟机就直接停止执行,将该对象清除。 对象重生或死亡如果在执行finalize()方法时,将this赋给了某一个引用,那么该对象就重生了。如果没有,那么就会被垃圾收集器清除。 注意:强烈不建议使用finalize()函数进行任何操作!如果需要释放资源,请使用try-finally。因为finalize()不确定性大,开销大,无法保证顺利执行。 方法区的内存回收 我们知道,如果使用复制算法实现堆的内存回收,堆就会被分为新生代和老年代,新生代中的对象“朝生夕死”,每次垃圾回收都会清除掉大量的对象;而老年代中的对象生命较长,每次垃圾回收只有少量的对象被清除掉。 由于方法区中存放生命周期较长的类信息、常量、静态变量,因此方法区就像是堆的老年代,每次垃圾收集的只有少量的垃圾被清除掉。 方法区中主要清除两种垃圾:1. 废弃常量2. 废弃的类 1. 如何判定废弃常量? 清除废弃的常量和清除对象类似,只要常量池中的常量不被任何变量或对象引用,那么这些常量就会被清除掉。 2. 如何废弃废弃的类? 清除废弃类的条件较为苛刻:1. 该类的所有对象都已被清除2. 该类的java.lang.Class对象没有被任何对象或变量引用只要一个类被虚拟机加载进方法区,那么在堆中就会有一个代表该类的对象:java.lang.Class。这个对象在类被加载进方法区的时候创建,在方法区中该类被删除时清除。3. 加载该类的ClassLoader已经被回收 垃圾收集算法 现在我们知道了判定一个对象是无效对象、判定一个类是废弃类、判定一个常量是废弃常量的方法,也就是知道了垃圾收集器会清除哪些数据,那么接下来介绍如何清除这些数据。 1. 标记-清除算法 首先利用刚才介绍的方法判断需要清除哪些数据,并给它们做上标记;然后清除被标记的数据。 分析:这种算法标记和清除过程效率都很低,而且清除完后存在大量碎片空间,导致无法存储大对象,降低了空间利用率。 2. 复制算法 将内存分成两份,只将数据存储在其中一块上。当需要回收垃圾时,也是首先标记出废弃的数据,然后将有用的数据复制到另一块内存上,最后将第一块内存全部清除。 分析:这种算法避免了碎片空间,但内存被缩小了一半。而且每次都需要将有用的数据全部复制到另一片内存上去,效率不高。 解决空间利用率问题:在新生代中,由于大量的对象都是“朝生夕死”,也就是一次垃圾收集后只有少量对象存活,因此我们可以将内存划分成三块:Eden、Survior1、Survior2,内存大小分别是8:1:1。分配内存时,只使用Eden和一块Survior1。当发现Eden+Survior1的内存即将满时,JVM会发起一次MinorGC,清除掉废弃的对象,并将所有存活下来的对象复制到另一块Survior2中。那么,接下来就使用Survior2+Eden进行内存分配。 通过这种方式,只需要浪费10%的内存空间即可实现带有压缩功能的垃圾收集方法,避免了内存碎片的问题。 但是,当一个对象要申请内存空间时,发现Eden+Survior中剩下的空间无法放置该对象,此时需要进行Minor GC,如果MinorGC过后空闲出来的内存空间仍然无法放置该对象,那么此时就需要将对象转移到老年代中,这种方式叫做“分配担保”。 什么是分配担保?当JVM准备为一个对象分配内存空间时,发现此时Eden+Survior中空闲的区域无法装下该对象,那么就会触发MinorGC,对该区域的废弃对象进行回收。但如果MinorGC过后只有少量对象被回收,仍然无法装下新对象,那么此时需要将Eden+Survior中的所有对象都转移到老年代中,然后再将新对象存入Eden区。这个过程就是“分配担保”。 3. 标记-整理算法 在回收垃圾前,首先将所有废弃的对象做上标记,然后将所有未被标记的对象移到一边,最后清空另一边区域即可。 分析:它是一种老年代的垃圾收集算法。老年代中的对象一般寿命比较长,因此每次垃圾回收会有大量对象存活,因此如果选用“复制”算法,每次需要复制大量存活的对象,会导致效率很低。而且,在新生代中使用“复制”算法,当Eden+Survior中都装不下某个对象时,可以使用老年代的内存进行“分配担保”,而如果在老年代使用该算法,那么在老年代中如果出现Eden+Survior装不下某个对象时,没有其他区域给他作分配担保。因此,老年代中一般使用“标记-整理”算法。 4. 分代收集算法 将内存划分为老年代和新生代。老年代中存放寿命较长的对象,新生代中存放“朝生夕死”的对象。然后在不同的区域使用不同的垃圾收集算法。 Java中引用的种类 Java中根据生命周期的长短,将引用分为4类。 1. 强引用 我们平时所使用的引用就是强引用。A a = new A();也就是通过关键字new创建的对象所关联的引用就是强引用。只要强引用存在,该对象永远也不会被回收。 2. 软引用 只有当堆即将发生OOM异常时,JVM才会回收软引用所指向的对象。软引用通过SoftReference类实现。软引用的生命周期比强引用短一些。 3. 弱引用 只要垃圾收集器运行,软引用所指向的对象就会被回收。弱引用通过WeakReference类实现。弱引用的生命周期比软引用短。 4. 虚引用 虚引用也叫幽灵引用,它和没有引用没有区别,无法通过虚引用访问对象的任何属性或函数。一个对象关联虚引用唯一的作用就是在该对象被垃圾收集器回收之前会受到一条系统通知。虚引用通过PhantomReference类来实现。

优秀的个人博客,低调大师

深入理解Android NDK日志符号化

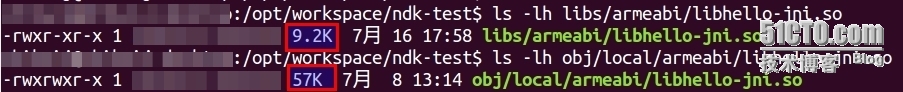
为了进行代码及产品保护,几乎所有的非开源App都会进行代码混淆,这样当收集到崩溃信息后,就需 要进行符号化来还原代码信息,以便开发者可以定位Bug。基于使用SDK和NDK的不同,Android的崩溃分为两类:Java崩溃和C/C++崩溃。Java崩溃通过mapping.txt文件进行符号化,比较简单直观,而C/C++崩溃的符号化则需要使用Google自带的一些NDK工具,比如ndk-stack、addr2line、objdump等。本文不去讨论如何使用这些工具,有兴趣的朋友可以参考同事写的另一篇文章《如何定位Android NDK开发中遇到的错误》,里面做了详细的描述。 基于NDK的Android的开发都会生成一个动态链接库(so),它是基于C/C++编译生成的。动态链接库在Linux系统下广泛使用,而Android系统底层是基于Linux的,所以NDK so库的编译生成遵循相同的规则,只不过Google NDK把相关的交叉编译工具都封装了。 Ndk-build编译时会生成的两个同名的so库,位于不同的目录/projectpath/libs/armeabi/xxx.so和/project path/obj/local/armeabi/xxx.so,比较两个so文件会发现体积相差很大。前者会跟随App一起发布,所以尽可能的小,而后者包含了很多调试信息,主要为了gdb调试的时候使用,当然NDK的日志符号化信息也包含其中。 本文主要分析这个包含调试信息的so动态库,深入分析它的组成结构。在开始之前,先来说说这样做的目的或者好处。现在的App基本都会采集上报崩溃时的日志信息,无论是采用第三方云平台(如Testin崩溃分析+),还是自己搭建云服务,都要将含调试信息的so动态库上传,实现云端日志符号化以及云端可视化管理。移动App的快速迭代,使得我们必须存储管理每一个版本的debugso库,而其包含了很多与符号化无关的信息。如果我们只提取出符号化需要的信息,那么符号化文件的体积将会呈现数量级的减少。同时可以在自定义的符号化文件中添加App的版本号等信息,实现符号化提取、上传到云端、云端解析及可视化等自动化部署。另外,从技术角度讲,你将不在害怕看到“unresolvedsymbol” linking errors,更从容地debugging C/C++ crash或者hacking一些so文件。 首先通过readelf来看看两个不同目录下的so库有什么不同 从中可以清楚看到,包含调试信息的so库多了8个.debug_开头的条目以及.symtab和.strtab条目。符号化的本质,是通过堆栈中的地址信息,还原代码本来的语句以及相应的行号,所以这里只需解析.debug_line和.symtab,最终获取到如下的信息就可以实现符号化了。 1 2 3 4 5 c85c8bwillCrashjni /hello-jni .c:27-29 c8bc8dwillCrashjni /hello-jni .c:32 c8dc8fJNI_OnLoadjni /hello-jni .c:34 c8fc93JNI_OnLoadjni /hello-jni .c:35 c93c9dJNI_OnLoadjni /hello-jni .c:37 通常,目标文件分为三类:relocatable文件、executable文件和shared object文件,它们格式称为ELF(Executableand Linking Format),so动态库属于第三类shared object,它的整体组织结构如下: ELF Header Program header tableoptional Section 1 ... Section n ... Section header tablerequired ELF Header ELF Header文件头的结构如下,记录了文件其他内容在文件中的偏移以及大小信息。这里以32bit为例。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 typedef struct { unsigned char e_ident[EI_NIDENT]; Elf32_Halfe_type; //目标文件类型,如relocatable、executable和sharedobject Elf32_Halfe_machine; //指定需要的特定架构,如Intel80386,Motorola68000 Elf32_Worde_version; //目标文件版本,通e_ident中的EI_VERSION Elf32_Addre_entry; //指定入口点地址,如C可执行文件的入口是_start(),而不是main() Elf32_Offe_phoff; //programheadertable的偏移量 Elf32_Offe_shoff; //sectionheadertable的偏移量 Elf32_Worde_flags; //处理器相关的标志 Elf32_Halfe_ehsize; //代表ELFHeader部分的大小 Elf32_Halfe_phentsize; //programheadertable中每一项的大小 Elf32_Halfe_phnum; //programheadertable包含多少项 Elf32_Halfe_shentsize; //sectionheadertable中每一项的大小 Elf32_Halfe_shnum; //sectionheadertable包含多少项 Elf32_Halfe_shstrndx; //sectionheadertable中某一子项的index,该子项包含了所有section的字符串名称 }Elf32_Ehdr; 其中e_ident为固定16个字节大小的数组,称为ELF Identification,包含了处理器类型、文件编码格式、机器类型等,具体结构如下: Name Value Purpose EI_MAG0 0 前四个字节称为magic number,分别为0x7f、’E’、’L’、’F’,表明文件类型为ELF。 EI_MAG1 1 EI_MAG2 2 EI_MAG3 3 EI_CLASS 4 表明文件是基于32-bit还是64-bit,不同的方式,对齐方式不同,读取某些内容的大小不同。 EI_DATA 5 表明文件数据结构的编码方式,主要分为大端和小端两种 EI_VERSION 6 指定了ELF文件头的版本号 EI_OSABI 7 指定使用了哪种OS-或者ABI-的ELF扩展 EI_ABIVERSION 8 指定该ELF目标文件的目标ABI版本 EI_PAD 9 保留字段起始处,直到第16个字节 EI_NIDENT 16 代表了e_ident数组的大小,固定为16 Sections 该部分包含了除ELF Header、program header table以及section header table之外的所有信息。通过section header table可以找到每一个section的基本信息,如名称、类型、偏移量等。 先来看看Section Header的内容,仍以32-bit为例: 1 2 3 4 5 6 7 8 9 10 11 12 typedefstruct{ Elf32_Word sh_name;//指定section的名称,该值为StringTable字符串表中的索引 Elf32_Word sh_type;//指定section的分类 Elf32_Word sh_flags;//该字段的bit代表不同的section属性 Elf32_Addr sh_addr;//如果section出现在内存镜像中,该字段表示section第一个字节的地址 Elf32_Off sh_offset;//指定section在文件中的偏移量 Elf32_Word sh_size;//指定section占用的字节大小 Elf32_Word sh_link;//相关联的sectionheadertable的index Elf32_Word sh_info;//附加信息,意义依赖于section的类型 Elf32_Word sh_addralign;//指定地址对其约束 Elf32_Word sh_entsize;//如果section包含一个table,该值指定table中每一个子项的大小 }Elf32_Shdr; 通过Section Header的sh_name可以找到指定的section,比如.debug_line、.symbol、.strtab。 String Table String Table包含一系列以\0结束的字符序列,最后一个字节设置为\0,表明所有字符序列的结束,比如: String Table也属于section,只不过它的偏移量直接在ELF Header中的e_shstrndx字段指定。String Table的读取方法是,从指定的index开始,直到遇到休止符。比如要section header中sh_name获取section的名称,比如sh_name = 7, 则从string table字节流的第7个index开始(注意这里从0开始),一直读到第一个休止符(index=18),读取到的名称为.debug_line Symbol Table 该部分包含了程序符号化的定义相关信息,比如函数定义、变量定义等,每一项的定义如下: 1 2 3 4 5 6 7 8 9 10 #SymbolTableEntry typedef struct { Elf32_Word st_name; //symbol字符串表的索引 Elf32_Addr st_value; //symbol相关的值,依赖于symbol的类型 Elf32_Word st_size; //symbol内容的大小 unsigned char st_info; //symbol的类型及其属性 unsigned char st_other; //symbol的可见性,比如类的public等属性 Elf32_Half st_shndx; //与此symbol相关的sectionheader的索引 }Elf32_Sym; Symbol的类型包含一下几种 Name Value STT_NOTYPE 0 STT_OBJECT 1 STT_FUNC 2 STT_SECTION 3 STT_FILE 4 STT_COMMO 5 STT_TLS 6 STT_LOOS 10 STT_HIOS 12 STT_LOPRO 13 STT_HIPROC 15 其中STT_FUNC就是我们要找的函数symbol。然后通过st_name从symbol字符串表中获取到相应的函数名(如JNI_OnLoad)。当symbol类型为STT_FUNC时,st_value代表该symbol的起始地址,而(st_value+st_size)代表该symbol的结束地址。 回顾之前的提到的.symtab和.strtab两个部分,对应的便是Symbol Section和Symbol String Section。 DWARF(Debugging With Attributed Record Formats) DWARF是一种调试文件格式,很多编译器和调试器都通过它进行源码调试(gdb等)。尽管它是一种独立 的目标文件格式,但往往嵌入在ELF文件中。前面通过readelf看到的8个.debug_* Section全部都属于DWARF格式。本文将只讨论与符号化相关的.debug_line部分,更多的DWARF信息请查看参考文献的内容。 .debug_line部分包含了行号信息,通过它可以将代码语句和机器指令地址对应,从而进行源码调试。.debug_line有很多子项组成,每个子项都包含类似数据块头的描述,称为Statement Program Prologue。Prologue提供了解码程序指令和跳转到其他语句的信息,它包含如下字段,这些字段是以二进制格式顺序存在的: total_length uword 整个子项占用的字节大小,注意并不包括该字段本身 versio uhalf 该子项格式的版本号,其实也是整个DWARF格式的版本号,目前总共有四个版本。 prologue_length uword prologue的长度,不包括该字段及前面的两个字段占用的字节数,即相对于本字段,程序语句本身的第一个字节的偏移量 minimum_instruction_length ubyte 最小的目标机器指令 default_is_stmt ubyte is_stmt寄存器的初始值 line_base sbyte 不同的操作码,代表不同的含义,只影响special opcodes line_range ubyte 不同的操作码,代表不同的含义,只影响special opcodes opcode_base ubyte 第一个操作码的数值 standard_opcode_lengths array of ubyte 标准操作码的LEB128操作数的数值 include_directories sequence 目录名字符序列 file_names sequence 源代码所在文件名字符序列 这里用到的机器指令可以分为三类: special opcodes 单字节操作码,不含参数,大多数指令属于此类 standard opcodes 单字节操作码,可以包含0个或者多个LEB128参数 extended opcodes 多字节操作码 这里不做机器指令的解析说明,感兴趣的,可以查看参考文献的内容。 通过.debug_line,我们最终可以获得如下信息:文件路径、文件名、行号以及起始地址。 最后我们汇总一下整个符号化提取的过程: 1、从ELF Header中获知32bit或者64bit,以及大端还是小端,基于此读取后面的内容 2、从ELF Header中获得Section Header Table在文件中的位置 3、读取Section Header Table,从中获得.debug_line、.symtab以及.strtab三个section在文中的位置 4、读取.symtab和.strtab两个section,最后获得所有function symbol的名称、起始地址以及结束地址 5、读取.debug_line,按照DWARF格式解析获取文件名称、路径、行号以及起始地址 6、对比步骤4和5中获取的结果,进行对比合并,形成最终的结果 本文转自jazka 51CTO博客,原文链接:http://blog.51cto.com/jazka/1675766,如需转载请自行联系原作者

优秀的个人博客,低调大师

android 中关于 activity 的一些理解

android活动程序——Activity,承载着View,很类似于MVC中的Controller。 不得不说,使用Intent(意图)来实现Activity与其他组件(包括其他Activity、Service。Broadcast等)进行交互。是Google的一大创新,也是android的一个亮点,这很好地减少了开发的复杂性。就像一个统一的交互接口一样,或者简单的说,Intent就是一个定义各个组件之间通信的标准。说实话,在学Android的时候我总是喜欢将它与.net的win form开发进行对比学习,并且他们之间也确实存在着诸多共性。但是在各个组件之间的交互上,显然还是android的这种机制来得直观和方便。但是,也许因为开发出的程序的运行模式有所区别,所以才导致了这样的局面。 这里就谈谈在应用程序的两个Intent之间采用Intent进行交互,如果你熟悉activity的生命周期,会知道,从一个activity切换到另一个activity(暂且我们将前一个称之为父activity,后一个称之为子activity)。父activity会执行OnPause()->OnStop(),之后会执行子activity的OnCreate()->OnStart()等等。但是当你按“返回”的时候,你会发现子activity执行了Ondestory()方法,而不是只执行到OnStop(),也就是子activity此时已经被销毁,而下一次你在切换到该类型的activity的时候,又会产生一个新的实例。而返回之后,父activity会执行OnRestart()等。也就是说,父activity的实例一直存在,在返回的时候也不需要再调用OnCreate()。 当你再做一个实验,在上面的子activity里,再切换到一个新的activity。你会发现此时,子activity像上面的父activity一样未被destory。也就是如果一个activity作为另一个activity“源”,那么它的生命周期肯定比它跳转到的activity的生命周期长。那么android到底是怎么做的呢。我们很容易联想到一种数据结构——栈。其实,每次startActivity()都只是把“意图”希望启动的一个activity压入栈顶。这样,就可以实现,栈顶的activity先消亡,其下面的activity在它Pop()之后才会再次Restart。这也很符合程序逻辑。 PS:要想测试activity的lifecycle,只需要重新activity的生命周期会尽量的那些方法(API中有介绍),在方法中启用日志记录功能(Log.i();),记录相关日志即可。 java与.net: 看代码的时候发现java中有这样的语法:类命.this、类名.class。一个是引用类的一个实例,一个是引用该类的Class类型的对象(在.net中应该对应的是类型的定义,也就是元数据)。类名.class都是Class类型,class与Class不是同一个类型,这种用法通常在反射中。好吧,这和.net中的Type很相似。可能是先入为主吧,我始终还是觉得称为Type更为合理,一个类型的“原型”本来在英文中用“Type”来表示。并且Class给人的感觉,总是和class相混淆。 上次看到一个面试题:.net中class是什么类型?坑爹啊!是类类型吗?引用类型吗?尼玛就是C#的关键字!这题考Java程序员,是什么效果?应该会比.net程序员好~ 原文发布时间为:2011-07-16 本文作者:vinoYang 本文来自云栖社区合作伙伴CSDN博客,了解相关信息可以关注CSDN博客。

优秀的个人博客,低调大师

深入理解Linux用户空间的锁机制

1.缘起 随着SMP(Symmetrical Multi-Processing)架构的流行和epoll类系统调用对非阻塞fd监视的支持,高性能服务器端的开发已经能够实现CPU计算和IO的分离。为了充分发挥CPU的计算能力,服务器端的设计必须要尽量减少线程切换。引起线程切换最重要的原因之一就是对mutex和semaphor等锁的使用。本文从计算机体系架构、操作系统的支持和mutex的实现彻底分析Linux用户空间mutex的实现,分析的源码版本是glib-2.3.4和kernel-2.6.8。 2. 体系结构和指令的支持 在UP(uni processor)架构下,从用户空间的角度看,中断打断了程序的正常执行。操作系统在处理完中断之后,返回用户空间的之前,重新调度系统中的线程执行。由于CPU是在执行汇编指令结束后响应中断,那么单条汇编指令的执行就是原子的。 在SMP下,由于存在CPU Local Cache和每个CPU的指令周期不同,单条汇编指令的执行不会是原子的。X86 SMP提供了一个lock指令前缀,使得某些汇编指令的执行是原子的。看如下x86_64体系结构的汇编代码,来自glibc。 Intel® 64 and IA-32 Architectures Software Developer’s Manual Volume 2中对cmpxchg指令的解释如下: This instruction can be used with a LOCK prefix to allow the instruction to be executed atomically. 所有以lock为前缀的指令都起内存栅栏的作用。内存栅栏使编译器确保对RAM中数据的改变对所有CPU都是可见的。 上述汇编对应的伪代码: Intel® 64 and IA-32 Architectures Software Developer’s Manual Volume 2中对cmpxchg指令的解释如下: This instruction can be used with a LOCK prefix to allow the instruction to be executed atomically. by gaolingfei 所有以lock为前缀的指令都起内存栅栏的作用。内存栅栏使编译器确保对RAM中数据的改变对所有CPU都是可见的。 上述汇编对应的伪代码: 3. 操作系统支持 按照操作系统的经典定义,进程是资源分配的最小单位,线程是调度的最小单位。 Linux操作系统提供了 futex系统调用以支持 mutex等锁的实现。 futex的主要功能是使得线程以 TASK_INTERRUPTIBLE状态等待处于进程空间的某变量的改变,或者使得某线程可以唤醒等待该变量的其他线程。 2.6.8版的 Kernel中, futex的实现使用一个 futex_hash_bucket。操作系统用户空间任何线程如果在等待mutex或者semaphore的up操作,都是以每个锁的address等为key,将自身线程挂到该futex_hash_bucket等待被唤醒。 实现 wait的步骤如下: A. down_read得到当前线程整个地址空间的读锁,从该步起到 up_read,与线程同一个进程的其他线程mmap()和brk()系统调用都会挂起,mmap()和brk()是malloc()和free()的基础。()(& current->mm->mmap_sem); B.调用 find_extend_vma以确认用户空间锁的地址是否是shared or private mapping. shared mapping一般是进程有多个线程引起的。 find_extend_vma会搜索整个进程地址空间段组成红黑树,以确定该地址空间的类型。()(), C.计算 key。如果是单进程单线程, Key为用户空间地址。如果为单进程多线程,需要执行 spin_lock得到用户地址对应的page,然后 spin_unlock。page_table_lock会影响相应进程的page fault的处理。(& current->mm->page_table_lock)(& current->mm->page_table_lock); D.将自身线程加入到 futex_hash_bucket, futex_hash_bucket的每个桶有一个spin lock保护。 E. up_read(& current->mm->mmap_sem); F. __set_current_state( TASK_INTERRUPTIBLE); G. __set_current_state此时线程已经被其他线程唤醒。( TASK_RUNNING); H.将自身从 futex_hash_bucket移除。 实现 wake up的步骤如下: A.执行 wait的 A到 C。 B. spin_lock给相应桶加锁。(&bh-> lock); C.唤醒在锁上的一个等待线程。 D. spin_unlock(&bh-> lock); E. up_read(& current->mm->mmap_sem); 4. pthread_mutex 实现分析 pthread_mutex_lock()实现在 glibc-2.3.4 pthread_mutex_lock.c文件的 33行,该函数会根据 mutex在 init的时候设置的属性,选择不同的执行路径。 mutex的属性有四种: A. PTHREAD_MUTEX_TIMED_NP:默认属性。 pthread_mutex_lock()直接调用 lll_mutex_lock()。 B. PTHREAD_MUTEX_RECURSIVE_NP:检查 mutex owner是否为当前线程。该属性允许线程多次获取该锁。 C. PTHREAD_MUTEX_ERRORCHECK_NP:如果同一线程两次 lock,会返回错误。 D. PTHREAD_MUTEX_ADAPTIVE_NP:该锁会先 n次调用 lll_mutex_trylock(), n为用户定义和 100的最小值。如果仍然失败,则调用 lll_mutex_lock()。 lll_mutex_trylock()不会调用 futex。 5. spin lock 实现 nginx实现了 spin lock以保护多进程对 listen port的互斥 accept。 spinlock的实现如下: Spinlock本质上是一个“忙等”锁,由于其不存在下节中总结的 mutex的缺点,其对于小资源是最高效的锁。相比上节中 mutex的 PTHREAD_MUTEX_ADAPTIVE_NP属性, nginx的 spinlock是一个更完美的实现方案。 6. 总结 在设置 PTHREAD_MUTEX_TIMED_NP属性和单进程多线程模型下, pthread_mutex_lock()对同进程的其他线程的影响如下: A. pthread_mutex_lock()占用的大部分 CPU时间当中,直接影响其他线程调用 mmap(), brk(), malloc和 free()。 B.对进程处理 page fault也会有影响。 C.如果整个操作系统的用户进程使用了过多的 mutex之类的锁,那么所有锁共享的 futex_hash_bucket将是一个瓶颈。 D.最重要的是,锁的使用会引起线程的频繁切换,导致 cpu cache miss和 TLB miss。 对于系统中,需要互斥访问的资源,如下建议: A.内核中对于小资源如链表的增删,多是使用 spin lock保护。 B.在设置 PTHREAD_MUTEX_ADAPTIVE_NP属性下, mutex既可以是 spin lock,也可以是阻塞锁。 C.使用 atomic_add_return(i, v),原子对变量 i增加 v值,并且返回操作后的值。相反操作: atomic_sub_return(i, v)。 D.使用 Per-CPU variables,例如多线程程序中要每隔 1秒,统计某项操作的值。该变量最好是 cache alignment。 E.对于如数据库频繁更新的操作,可以使用数据库的多版本并发控制方法减少对 mutex的 lock。 本文转自百度技术51CTO博客,原文链接:http://blog.51cto.com/baidutech/1033629 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

如何理解Hadoop-Hbase原理与应用小结

1 我们常说HBase是“数据即日志”的数据库,它是怎样修改和删除数据的?和Oracle这类传统的RDBMS有什么区别? 答:首先Hbase中的一个“元素”是由行键、列族名、限定符、时间戳唯一标识的并且行键作为数据行在表里的唯一标识,我们只有通过行键来访问列族别无他法。 修改数据:我们先找到要修改的行键把新的数据记录追加到对应的列族中并打上一个新时间戳代表最新版本。 删除数据:插入带有删除标记的行进入,相当于把整个行键所在的行删了。 小结:hbase中所有修改和删除都是用insert方式来完成的,这是由底层HDFS文件系统特性决定的,HDFS中的文件只能一次性写入不能修改可以删除在写回。因此hbase是天生面向时间查询的数据库。例如 查询最近一段时间一个人发布的博客、发布签名、发布照片so on。 hbase特点 (1)适合大量插入同时key-value查询,例如可以输入一个key查询一个value,还可以输入一组key查询一组value。 (2)瓶颈是硬盘的传输速度,因为有大量的插入操作和读出操作,使用SSD SCSI IDE不同的硬盘效率是不同的。 (3)适合数据分析。 (4)列式数据库会把相同列的数据都放在一块即列为单位存储。当我们查询某一列的时候只需要调出相应的块即可,这样还可以减少很多I/O。 (5)如果数据元素间的相似性很高的话可以进行大幅度的压缩,相似度越高压缩比越大,甚至可以压缩到原来十几分之一、上百分之一。即节约了空间又减少了I/O,从而提高性能。 (6)hbase只有主键索引,它使用的是LSM(Log Structure Merge)索引,因为hbase所有的修改都是使用追加方式完成的,从数据流上看按照顺序方式写入与日志写入的方式相同,我们又可以认为数据和日志一体化,这又节约了很多空间。 oracle特点 (1)适合小事务短时间片密集型OLTP系统,例如在线交易系统。 (2)瓶颈是硬盘的寻道时间(磁头移动时间),因为oracle随机写随机修改块,首先要找到块这个过程就是寻道时间,而寻道时间又由硬盘转速决定的,5400 7200 15000转/秒 不同的转速效率也是不同的。 (3)适合做SQL统计。 (4)行式数据库会按照数据行顺序集中存放即行为单位存储。当我们查询某一列的时候必须把表里所有的行读完才能抽取我们所要的行,这样很不划算,还要付出很大的I/O资源。 (5)那么从结构上讲oracle的压缩性能就要略逊一筹。 (6)oracle常用的是B+树索引,比较大小来查找记录,小的走左边大的走右边,如果列中的相似度较高的话性能较差。 2 HBase合并storefile的原因是什么?在合并的过程中会做什么操作?如果在合并过程中恰好有涉及到有关storefile的查询发生,会发生什么情况! 答:首先我们介绍一下Hbase数据存储的物理结构 一个物理节点只能跑一个HRegionserver 一个HRegionServer可以包括很多个Region实例,可以是不同表Region 一个Region包含一个hlog和多个store(一个store就是一个列族,因为同列族元素在物理上存放在同一个地方,不同列族在物理上是分离的) 一个store包含一个memstore和多个storefile 当我们在处理数据的时候,首先把数据加载到memstore,数据越来越多直到memstore占满,再写入硬盘storefile中,每次写入形成一个单独storefile,当storefile达到一定的数量后,就会开始把小storefile合并成大storefile,因为hadoop不擅长处理小文件,文件越大性能越好。 在合并的过程中会抛弃删除标识的行和版本过旧的行(hbase版本抛弃方式(1)我们可以预先定义版本的个数,超过这个值就抛弃(2)还可以预先定义版本的时间长短,超过这个时间就抛弃),合并完后形成更大的storefile,当达到数量再次合并,直到storefile容量超过一定阀值后会把当前的Region进行分裂为2个并由Hmaster(hbase数据库主控节点)分配到不同的HRegionServer服务器处理实现负载均衡。 如果在合并过程中恰好有涉及到有关storefile的查询发生的话,我们先是把小storefile加载到内存中进行合并此时如有用户访问可以在内存中检索相关数据返回给用户,我们可以想象在内存中做一个独立镜像备份专门提供被查询需求,另一个主体在另一块内存空间里进行合并,当合并完成后释放备份的内存空间,返回到原来的状态。 3 Hbase具有怎么样的一致性水平 答:hbase是最终一致性的系统,因为hbase是架构在hadoop之上的数据库,“错误是常态”是hadoop座右铭,在cap理论中hbase为了满足可用性和分区容错性牺牲了一部分的数据一致性。 举例:我们要进行电信的指标汇总,并且把汇总结果冗余三份分布在3个datanode中,我们可以设置阀值只要有2份结果保存了我们就可以继续做下面的操作,在一定时间范围内允许第3份结果稍后一致性同步,这就是最终一致性。所以说hbase是适用于AP理论的系统,最终一致性也满足分布式集群的特点。 本文转自 leonarding151CTO博客,原文链接:http://blog.51cto.com/leonarding/1049404,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux之理解内核、内核模块、编译内核

内核组成: uname命令 内核:uname,mkinitrd,dracut 模块: lsmod,modinfo,depmod,modprobe,insmod,rmmod /proc,sysctl,/sys,/dev,udevadm,hotplug命令 内核编译 Linux内核组成 内核文件 bzImage 位置: /boot/vmlinuz-VERSION-RELEASE 内核模块 .ko 位置: /lib/modules/VERSION-RELEASE 辅助文件 initramfs(CentOS 6,7) , initrd (CentOS5) 查看内核相关的信息 uname显示系统(kernel)信息 -s 显示操作系统名称 -n 显示当前主机名称: 显示节点名称 -r 显示VERSION及RELEASE号 -v 显示内核制作信息号 SMP 对称多处理器 -m 当前硬件平台 x86_64 -p 显示处理器类型或架构 x86_64 -i 硬件架构 x86_64 -o 操作系统(GNU/Linux) 使用示例 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 1 、系统信息 #uname Linux #uname-o GNU/Linux 2 、显示节点名称 #uname-n localhost.localdomain #cat/proc/sys/kernel/hostname localhost.localdomain #hostname localhost.localdomain 3 、显示version-release号 #uname-r 2.6 . 32 - 696 .el6.i686 4 、内核制作版本号 #uname-v # 1 SMPTueMar 21 18 : 53 : 30 UTC 2017 5 、当前硬件平台 #uname-m i686 6 、处理器架构 #uname-p i686 7 、硬件架构 #uname-i i386 8 、操作系统 #uname-o GNU/Linux 辅助文件: initramfs,initrd 生成 1 2 3 mv/boot/initramfs-VERSION-RELEASE.img/root mkinitrd/boot/initramfs-$(uname-r).img$(uname-r) dracut/boot/initramfs-$(uname-r).img$(uname-r) 展开 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 1 、查看文件的类型 file 2 、改名.gzip结尾 mv 3 、解压 gzip-d 4 、查看文件类型 file 5 、展开 install-dinitrd cdinitrd cpio-id<../ Linux内核模块 吸收微内核设计:支持模块化设计: 内核中模块 .ko (kernel object) 程序调用的库 .so (share object) 内核模块相当于程序的库的概念,只是模块只能被kernel调用。库只能被程序调用 编译成模块: [M] 编译进内核: [*] 不编译此功能: [ ] 查看所有已经装载的模块lsmod 1 2 3 #lsmod ModuleSizeUsedby 模块大小使用次数 查看模块信息modinfo 模块路径 -n 显示指定内核的模块信息 -k kernel 显示模块的描述 -d 模块的参数 -p License -l Author -a 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 1 、显示所有信息 #modinfoext4 filename:/lib/modules/ 2.6 . 32 - 696 .el6.i686/kernel/fs/ext4/ext4.ko license:GPL description:FourthExtendedFilesystem author:RemyCard,StephenTweedie,AndrewMorton,AndreasDilger,TheodoreTs'oandothers srcversion:74AEE2BDA63AC8482A78F4D depends:mbcache,jbd2 vermagic: 2.6 . 32 - 696 .el6.i686SMPmod_unloadmodversions 686 2 、仅显示filename #modinfo-next4 /lib/modules/ 2.6 . 32 - 696 .el6.i686/kernel/fs/ext4/ext4.ko 3 、仅显示License #modinfo-lext4 GPL 4 、仅显示description #modinfo-dext4 FourthExtendedFilesystem 5 、仅显示作者 #modinfo-aext4 RemyCard,StephenTweedie,AndrewMorton,AndreasDilger,TheodoreTs'oandothers 6 、显示模块参数 #modinfo-pext4 生成模块的依赖关系depmod 为指定内核生成依赖 -b /boot/system.map-VERSION-RELEASE 内核依赖的模块及库 /lib/modules/VERSION-RELEASE/modules.dep.bin 模块的依赖关系 装载模块modprobe MODULE 或 insmod $(modinfo -n MODULE) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 #modprobepcnet32 #lsmod|fgreppcnet32 pcnet32291070 mii44761pcnet32 安装pcnet32模块 #insmod$(modinfo-npcnet32) insmod:errorinserting '/lib/modules/2.6.32-696.el6.i686/kernel/drivers/net/pcnet32.ko' :-1Unknownsymbol in module 查看依赖 #modinfopcnet32 depends:mii 依据路径安装被依赖的模块 #insmod$(modinfo-nmii) 查看是否安装 #lsmod|fgrepmii mii44760 安装Pcnet32 #insmod$(modinfo-npcnet32) 查看是否安装 #lsmod|fgreppcnet32 pcnet32291070 mii44761pcnet32 # 拆除模块modprobe -r MODULE 或 rmmod MODULE 1 2 3 4 5 6 7 #modprobe-rpcnet32 #lsmod|fgreppcnet32 # #rmmodpcnet32 #lsmod|fgreppcnet32 # /proc目录 只读 内核内部统计、状态信息 可写 可配置参数,/proc/sys目录中,由sysctl命令控制,内核性能调整 临时生效:echo 'STRING' > /proc/sys/kernel/hostname , sysctl -w kernel.hostname='STRING' 永久有效:/etc/sysctl.conf sysctl命令 -p CONFIG_FILE 读取文件设定参数 -w PARAMETER='VALUE' 设定内核参数 # echo 'VALUE' > /proc/sys/kernel/hostname # sysctl -w kernel.hostname='VALUE' 主机名: /proc/sys/kernel/hostname 路由转发: /proc/sys/net/ipv4/ip_forward 1:开启; 0:关闭 cache/buffer回收: /proc/sys/vm/drop_caches 1: dropcache -a 显示所有内核参数 -p 重读配置文件 配置文件: /etc/sysctl.conf 路由转发: 打开路由转发时,一个网卡的用户能够ping通另一个网卡所在网络的主机 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 临时生效 1、查看主机名 #cat/proc/sys/kernel/hostname localhost.localdomain 2、设置主机名 #echo"Lcc.org">/proc/sys/kernel/hostname #cat/proc/sys/kernel/hostname Lcc.org #hostname Lcc.org 3、设定主机名 #sysctl-wkernel.hostname="lcc.org" kernel. hostname =lcc.org 4、查看主机名 #hostname lcc.org #cat/proc/sys/kernel/hostname lcc.org 永久有效 #cp/etc/sysctl.conf{,.bak} #echo"kernel.hostname=magedu.com">>/etc/sysctl.conf #hostname lcc.org #sysctl-p net.ipv4.ip_forward=0 net.ipv4.conf.default.rp_filter=1 net.ipv4.conf.default.accept_source_route=0 kernel.sysrq=0 kernel.core_uses_pid=1 net.ipv4.tcp_syncookies=1 kernel.msgmnb=65536 kernel.msgmax=65536 kernel.shmmax=4294967295 kernel.shmall=268435456 kernel. hostname =magedu.com #hostname magedu.com /sys目录 内核探测的硬件信息 kernel 2.4- /dev/目录下事先创建所有设备文件,/dev/目录文件多,造成大量空间浪费 kernel 2.4+ /dev/目录下按需生成设备文件,kernel临时探测,按需创建,节约空间 udev工具: udevadmin,hotplug 简易编译内核 1)获取源码 2)开发环境 3)查看目标主机的硬件设备信息 4)目标实际需要 1、获取源码 https://www.kernel.org/ **小于3.10版本 2、展开至/usr/local/目录 3、创建符号链接 5、编译 1、设置release号 2、设置主机名 3、设置支持NTFS文件系统 4、设置支持的网络驱动 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 generalsetup Localversion-appendtokernelrelease - 1 .os.cpu ((none))Defaulthostname默认主机名 Filesystems JFS GFS2 Btrfs DOS/FAT NTFS Devicedrivers Netowrkdevicesupport Enternetdriversupport 打开一个虚拟的屏幕: 退出: ctrl + a 松开a后按d 列出: screen -ls 连接回: screen -r ID 5、编译 make -j # # lscpu 中 cpu(s) 后的数字为cpu核心数 6、安装 本文转自 lccnx 51CTO博客,原文链接:http://blog.51cto.com/sonlich/1961362,如需转载请自行联系原作者


优秀的个人博客,低调大师

android clipRect Op.xxx各个参数理解

有点小啰嗦的一篇学习笔记,可以直接看最后得出的结论:前面的各种图片和说明都是为最后的结论服务的 1)剪切:和平常画图工具剪切的作用一样,在画布上剪切一个区域,比如剪切一个Rect区域,画布canvas其余的部分都丢掉,之后所有的画图都在这个Rect区域内进行(如果不涉及save和restore方法)。 2)clip进行剪切的时候,不会影响之前已经画好的图形。 3)剪切是对canvas的操作,而不是在canvas上的图进行操作。 为了说明这几点,下面进行一下说明。 步骤1) 在剪切之前绘制一个全屏的蓝色的矩形。 2)定义剪切的矩形Rect区域,并进行剪切 3)设置剪切过后画布颜色为红色 运行的效果如下图所示:此时剪切过后画布的区域就是剪切的Rect区域,虽然剪切掉了canvas上面和下面的一部分,但是仍然会把途中所示的蓝色部分显示出来而不会剪切掉:也就是如上所说不会影响之前已经画好的图形。 代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 protected void onDraw(Canvas canvas) { int width = getMeasuredWidth(); int height = getMeasuredHeight(); Paint paint = new Paint(); paint.setColor(Color.BLUE); //全屏绘制一个蓝色的矩形画面 canvas.drawRect( 0 , 0 ,width,height,paint); //定义剪切的Rect区域 Rect rect = new Rect(); rect.left = 0 ; rect.top = 300 ; //左上角(0,300) rect.right = width; rect.bottom = height/ 2 ; //右下角(width,height) //进行剪切 canvas.clipRect(rect) canvas.drawColor(Color.RED); } 上面的clipRect是只有一个参数的(默认为INTERSECT,下面看看它的重载方法Cliprect(rect,OP.xx)第二个参数以及各个参数的含义和运行效果: 开始之前做些准备工作: 区域A:剪切之前的画布区域 区域B:当前要剪切的区域,也就是clipRect的第一个参数所表示的区域 在没有直接写代码测试之前对这些字段的翻译和查阅写数学资料并对Op.xxx的各种字段在心里做了如下假设: XOR:异或运算,相同为0(false),不用为1(true),也就是两个区域重叠的地方为0,不同的地方为1,剪切过后的画布的区域就是两个区域不重叠的部分。 INTERSECT:交集运算,剪切过后的画布区域就是两个区域的交集区域。 REPLACE:这个有待验证,不明所以,从字面意思来说是代替的意思,应该就是用B的区域代替A的区域,所以剪切过后的画布区域可能就是只剩下B的区域,当然这个只是假设,有待下面的验证过。 DIFFERENCE:差集运算,剪切过后的画布的区域就是A-B REVERSE_DIFFERENCE:差集运算,REVERSE为反向,逆向的意思,不难猜出剪切过后的画布区域是B-A的区域 UNION:并集运算,剪切过后的画布区域就是A和B的区域相加,当然重叠的地方只计算一次 下面就写程序注意验证上面的结果和得出相应的结论 先是全集和子集的情况:此时A为全集区域,B为A的子集 a) Op.DIFFERENCE:即将剪切的区域(设置B)与当前canvas(设置A)之间的差集,剪切过后还剩下的画布canvas区域就是A-B的区域,看看运行结果 步骤还是之前的步骤,只是把canvas.clipRect(rect)改成canvas.clipRect(rect,Op.DIFFERENCE);运行结果如下:<喎�"/kf/ware/vc/" target="_blank" class="keylink">vcD4KPHA+PGltZyBzcmM9"/uploadfile/Collfiles/20150212/2015021208423342.png" alt="\"> b) Op.REVERSE_DIFFERENCE:对比DIFFERENCE取A-B,REVERSE是相反的意思,所以为B-A,因为B为A的子集,所以该差集不存在,所以运行结果为下: c) Op.XOR:两个区域进行异或运算,异或运算的规则是:“相同为0(false),不同为1(true)”,当两个区域进行异或的时候,很显然“区域重叠的地方为0,不重叠的地方为1”,剪切过后剩下的画布canvas的区域就是不重叠的地方所在的区域,看看运行结果 d) Op.UNION 取A和B的并集,所以运行结果为下图: e) Op.INTERSECT 取A和B的交集,因为上面的程序中A是全屏的画布范围,而B在A里面,所以剪切的结果为下图所示,所以说交集为B的范围 f) Op.REPLACE,运行效果如下 通过全集和子集的运行效果来看,REPLACE应该就是跟上面设想的一样,其余的倒是跟设想的结论一样。 所以我就测试了非全集和子集的情况 此时A区域和B区域的关系如图,C为A和B的交集区域: 测试画图步骤: 1)绘制一个蓝色的矩形面 2)定义A的Rect对象(第一次要剪切的区域),并开始剪切 3)定义B的rect对象并开始剪切,并且调用clipRect(rect,Op.xxx)来看不用xxx下剪切的效果 4)把剪切过后的画布设置为红色 上面步骤的代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 int width = 1000 ; int height = 1000 ; Paint paint = new Paint(); paint.setColor(Color.BLUE); //全屏绘制一个蓝色的矩形画面 canvas.drawRect( 0 , 0 ,width,height,paint); //定义区域A的rect对象 Rect rect = new Rect(); rect.left = 100 ; rect.top = 100 ; //左上角(0,300) rect.right = 300 ; rect.bottom = 300 ; //右下角(width,hei //剪切为A区域 canvas.clipRect(rect); //同clipRect //设置b的rect对象 rect.left = 200 ; rect.top = 200 ; //左上角(0,300) rect.right = 400 ; rect.bottom = 400 ; //右下角(width,height) canvas.clipRect(rect,Op.xxxx); //把剪切过后的画布设置红色 canvas.drawColor(Color.RED); a) DIFFERENCE的情况下的运行效果(A-B的差集):也就是A区域去掉C区域 b) REVERSE_DIFFERENCE的运行效果如下图(B-A的差集):也就是B区域去掉C区域 c) UNION 的运行结果 (A和B的并集) d) INTERSECT (交集运算)此时画布只剩下C区域可以显示,所以运行结果如下 e)XOR 异或运算,剪切过后的结果为A和B区域不重叠的区域 f)REPLACE 这个运算结果是什么呢?就是B区域,也就是剪切过后的结果只保留B区域,这也就是REPLACE代替或者替换的含义:当前还没被剪切的区域A被即将要剪切的区域B来代替。 结论: XOR:异或运算,相同为0(false),不用为1(true),也就是两个区域重叠的地方为0,不同的地方为1,剪切过后的画布的区域就是两个区域不重叠的部分。 INTERSECT:交集运算,剪切过后的画布区域就是两个区域的交集区域。 DIFFERENCE:差集运算,剪切过后的画布的区域就是A-B REVERSE_DIFFERENCE:差集运算,REVERSE为反向,逆向的意思,不难猜出剪切过后的画布区域是B-A的区域 UNION:并集运算,剪切过后的画布的区域为A+B的区域 REPLACE:也就是剪切过后的结果只保留B区域,这也就是REPLACE代替或者替换的含义:当前还没被剪切的区域A被即将要剪切的区域B来代替。 本文转自 一点点征服 博客园博客,原文链接:http://www.cnblogs.com/ldq2016/p/6665033.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册