首页 文章 精选 留言 我的

精选列表

搜索[c 14],共10015篇文章
优秀的个人博客,低调大师

阿里云前端周刊 - 第 14 期

推荐 1. JavaScript 在嵌入式设备与物联网中的应用现状 https://auth0.com/blog/javascript-for-microcontrollers-and-iot-part-1/?utm_source=newsjs&utm_medium=sc&utm_campaign=javascript_microcontrollers 随着近年来 Web 的发展与 JavaScript 的崛起,JavaScript 被应用到了许多原本不曾想象到的场景中,从服务端、工作站、数据库、桌面环境到物联网设备中,都可以见到 JavaScript 的身影。而本文则概括了 JavaScript 在不同的嵌入式微型设备中的应用现状,并且选择了具有代表性的设备介绍了具体的使用场景与实践方法。 2. Mikeal Roger

优秀的个人博客,低调大师

开源大数据周刊-第14期

阿里云E-Mapreduce动态 E-Mapreduce团队 1.4版本(正在发布): 作业运行失败报警 作业并行提交 添加sqoop、shell类型的作业 1.4.1版本 集群整体运行情况的仪表盘 集群状态监控报警 资讯 创业公司如何构建数据指标体系?对于庞大的创业群体和数据运营新手来说,这将是一篇非常具有参考价值的干货贴,作者将在文章中深入阐述两套构建指标体系的方法,即关键指标法和海盗指标法。 怎样选择数据平台的建设方案文中对比了MPP、Hadoop传统的数据库等不同方案的优缺点,值得一看。对于一般的中小型企业hadoop还是首选,关键还是得益于hadoop台火爆,一些公司使用impala+hadoop共享mpp+hadoop两者的好处。 全国首份人才大数据报告:大数据行业将面临“全球人才慌"根据数据显示,目前全国的大数据人才只有46万,未来3-5年

优秀的个人博客,低调大师

macOS 14 Sonoma 已发布预览版

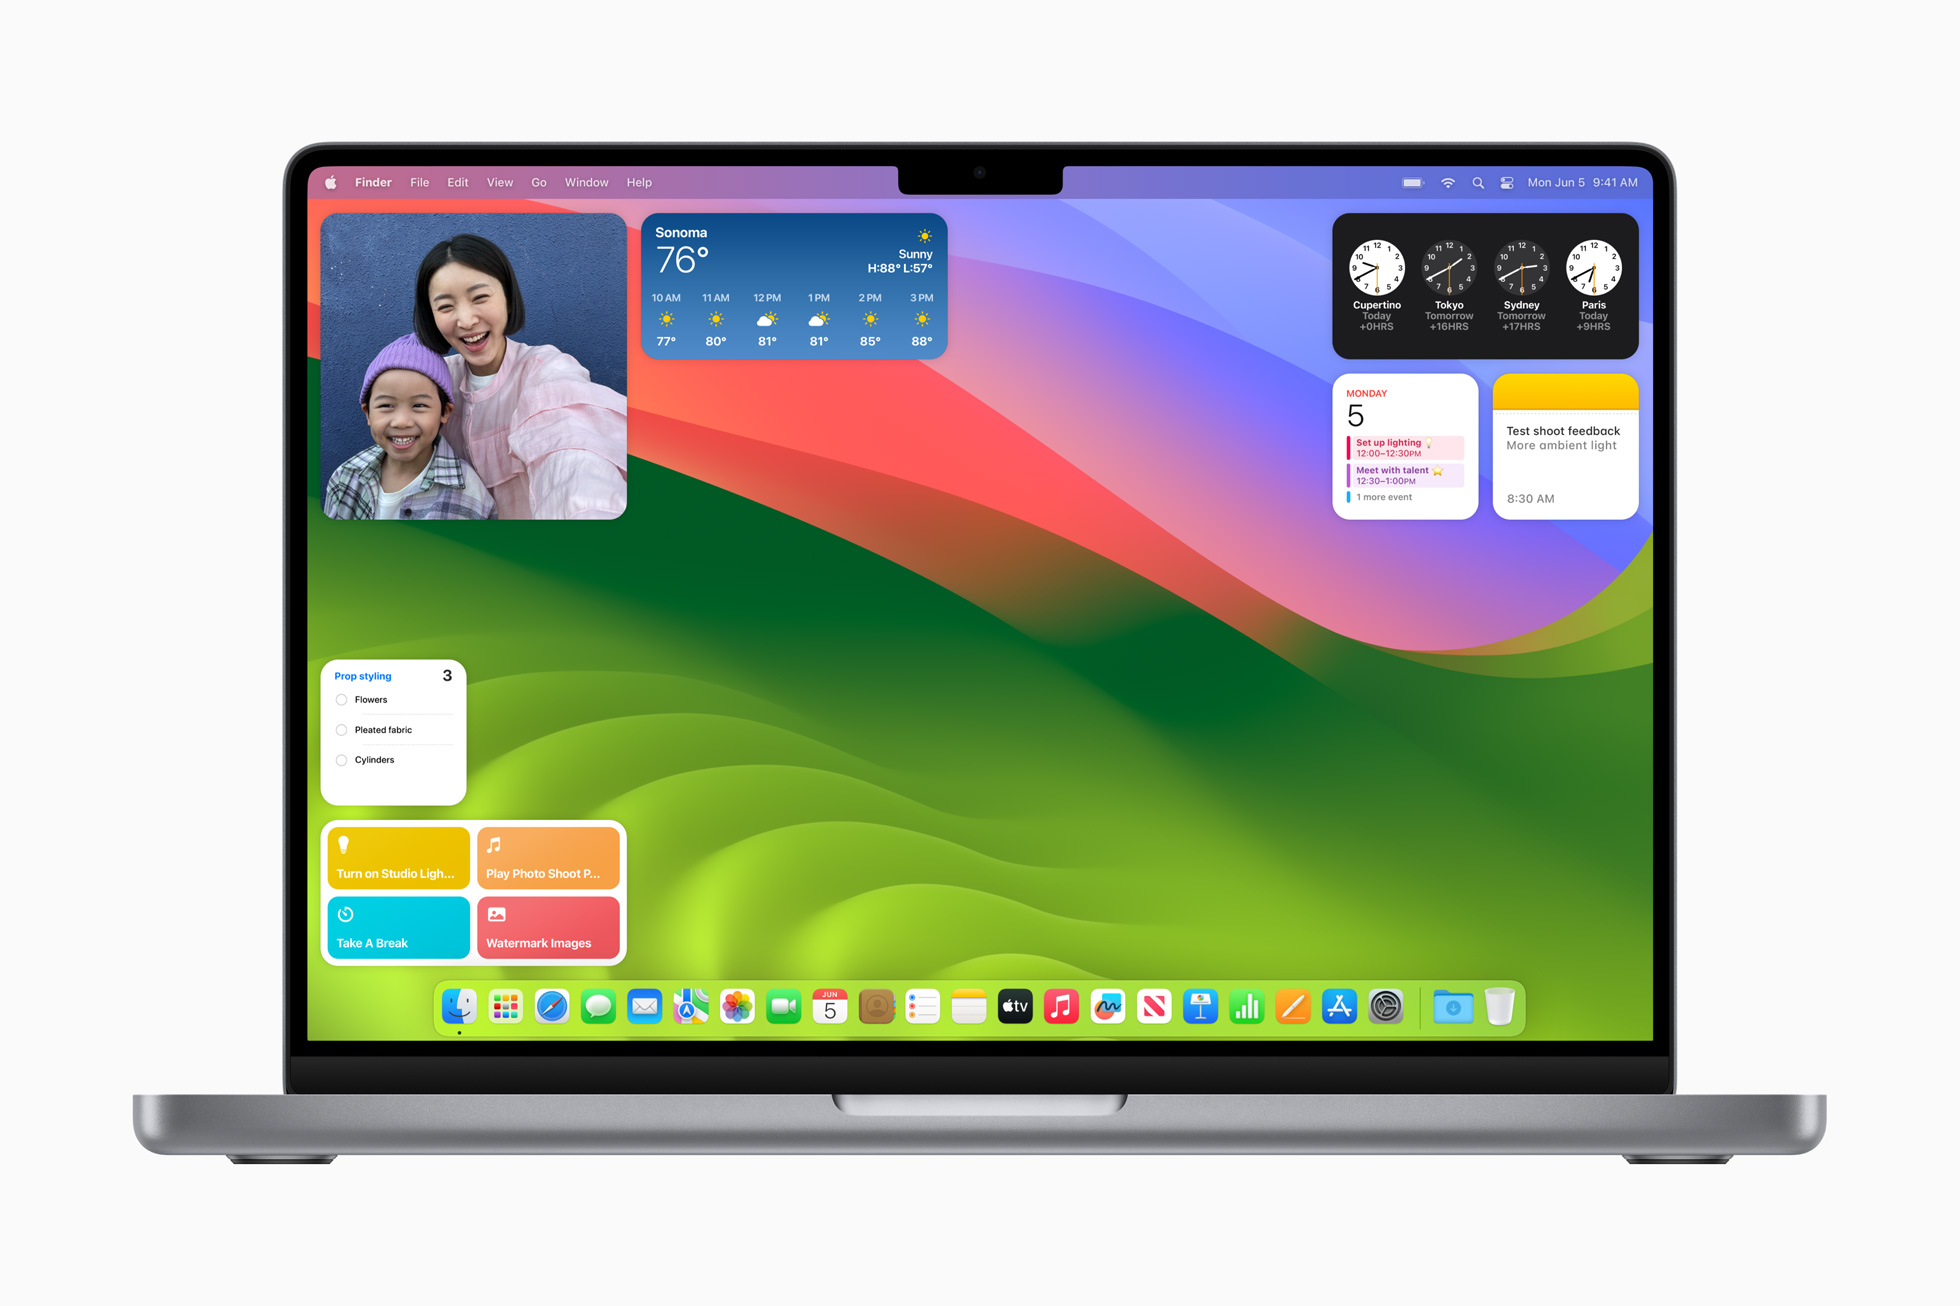
苹果公司在 WWDC 2023 发布了旗下的操作系统更新,比如 macOS Sonoma、 iOS 17 、watchOS 10 和 iPadOS 17 等。 macOS Sonoma 发布的是预览版,并未推送到用户侧。macOS Sonoma 主要带来一些视觉和交互体验,以及隐私功能方面的改进: 交互式小组件 用户可将小组件直接置于桌面之上,并通过访问小组件图库轻松找到工具。 用户在 app 中工作时,小组件会无缝融入墙纸,以便用户全心投入手头任务。 可以从 iPhone 拖到小组件到 MacOS 上。 小组件变得可交互,用户能够直接在 Mac 桌面上执行查看提醒事项、播放或暂停、访问家居控制等各式各样的操作。 智能视频会议 演讲者叠层是一组全新视频特效,可将用户置于共享内容的上方,以便突出演讲者。 此外,利用 Reaction,用户还可通过将气球、五彩纸屑、爱心等元素无缝添加至视频中,或用手势触发这些特效。 改进的屏幕共享选取器,用户可选择在通话中共享 app,从当前开启的窗口中直接共享内容。 Safari 浏览器更新 为无痕浏览推出重要更新,在浏览过程中提供比过去更多的保护,既可拦截跟踪器,亦可防范可访问用户设备的其他人。 无痕浏览模式下的跟踪与指纹保护功能进一步升级,帮助阻止网站跟踪或识别用户。 无痕浏览窗口会在用户未使用时进行锁定。 此外,用户还可使用用户场景功能将浏览按主题分组,从而保持清晰有序,同时亦可区分 Cookie、历史、扩展、标签组和个人收藏。 用户能够同时使用个人帐户和工作帐户登录同一个网站,并快速在二者之间顺滑切换。 Safari 浏览器还支持创建表现类似普通 app 的网页 app,并提供类似 app 体验的简化版工具栏。 其他 macOS Sonoma 更新 包括以下内容 简化的 PDF 体验:有了增强型 PDF 功能,用户可利用自动填写功能快速填写表单,还可获得智能收件人推荐。 在备忘录中实时编辑 PDF:备忘录现可以完整宽度显示 PDF 和文档扫描页面,用户还可在带链接的备忘录中快速访问食谱或作业等相关备忘录。 Siri:用户现在只需说“Siri”即可激活 Siri,无需先 “hey”。 密码:用户现在可以通过创建群组来共享一组密码。群组中的每个成员都可以添加和编辑密码,以确保它们始终处于最新状态;共享通过 iCloud 钥匙串进行,并且获得端到端加密。此外,通过邮件接收到的一次性验证码现可自动填充至 Safari 浏览器中,无需离开浏览器即可轻松实现安全登录。 信息:用户可以使用全新推出的贴纸与自己关系亲密的联系人互动,还可享受经过改进的搜索、回复、群组功能,并可通过 iCloud 同步信息 app。 提醒:提醒中的智能购物清单功能可简化每周的采购任务。此外,用户还可将清单划分为多个板块,并使用新推出的分栏视图横向安排板块布局。 键盘:全新推出自动纠正功能,帮助用户更精准、更轻松地完成修改。实时完句功能可协助用户快速补完整句,而听写功能则借助更上新高的语音识别技术大幅改善精确度。 隐私和安全:通信安全功能延伸至隔空投送、选取照片、来电和 FaceTime 通话留言,进一步扩大对儿童的保护。此外,敏感内容警告功能可防止用户在隔空投送、信息、来电以及 FaceTime 通话留言中意外接触到敏感图像和视频,同时还向用户提供屏蔽该联系人,和寻求进一步帮助资源的选项。 如欲了解所有新功能,可查看sonoma-preview页面。

优秀的个人博客,低调大师

EKS 训练营-日志收集 EFK(14)

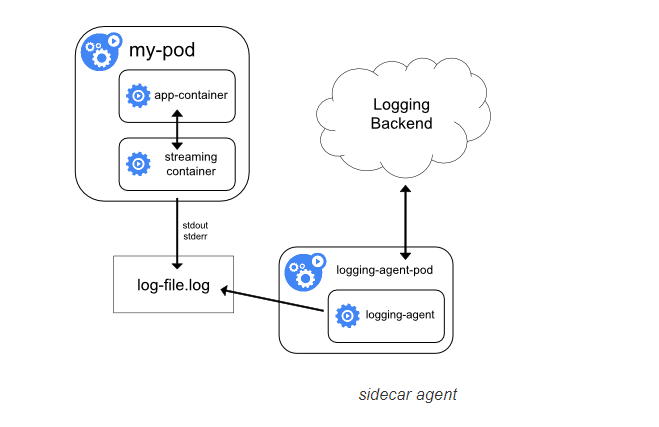
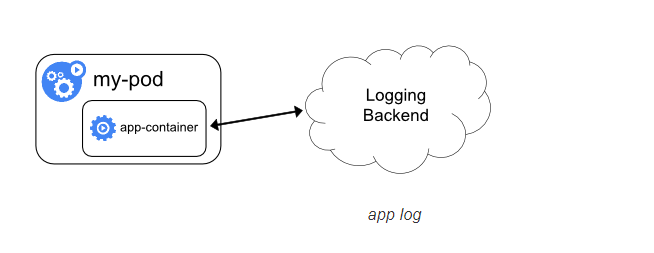
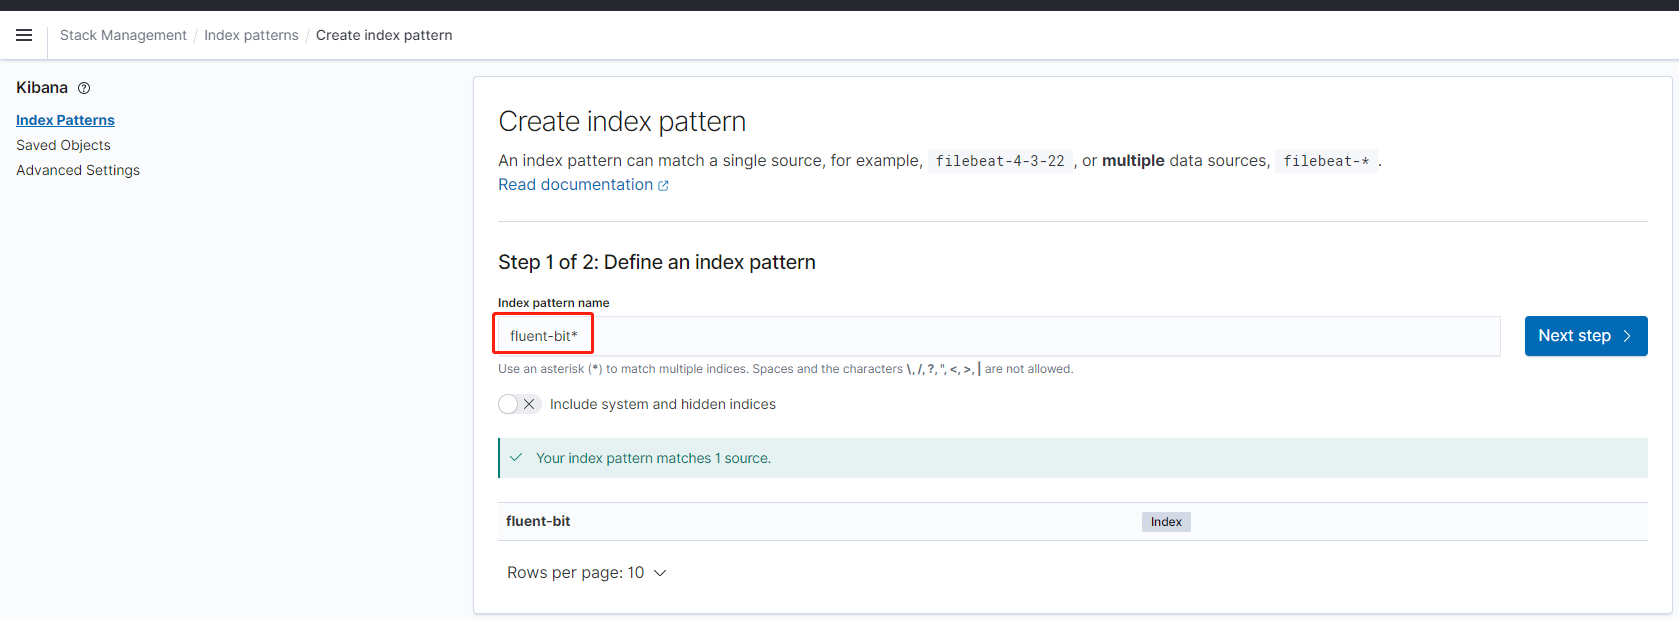
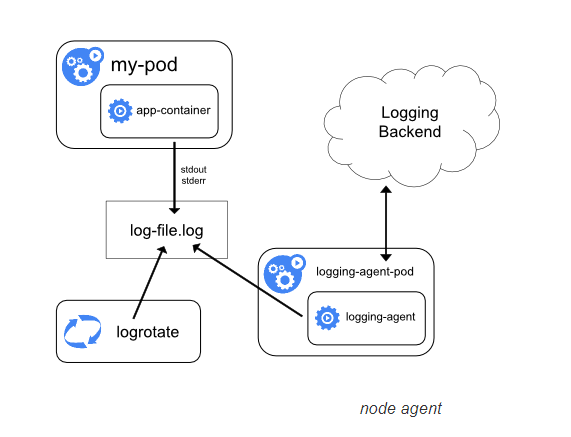
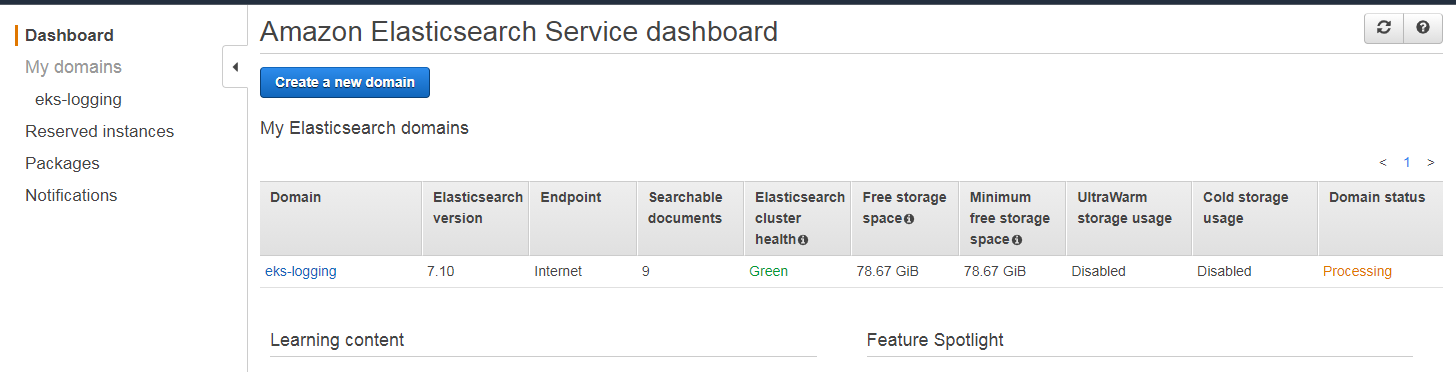
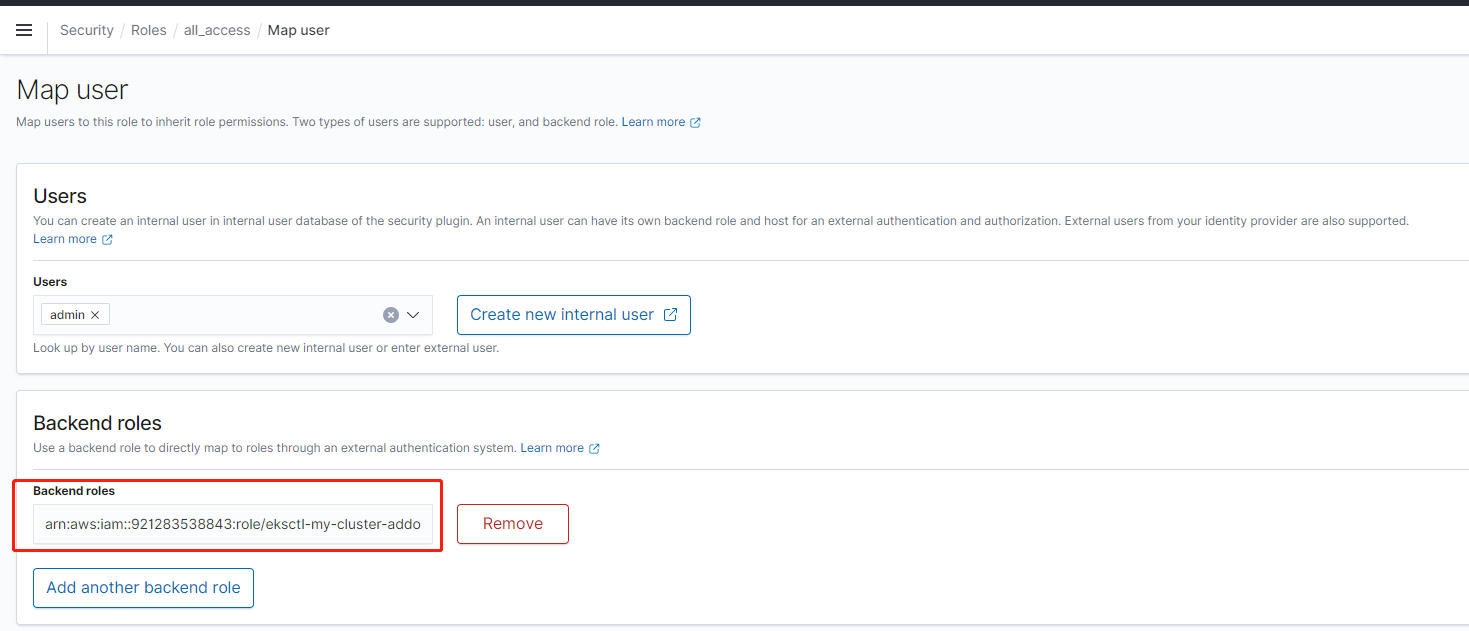
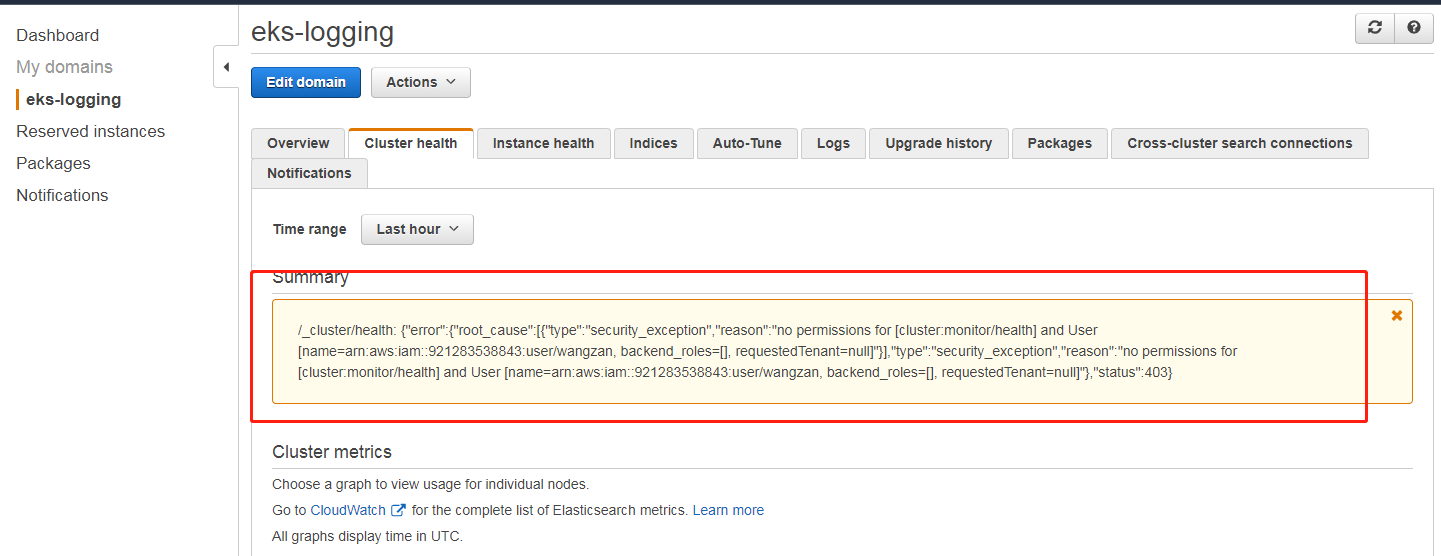
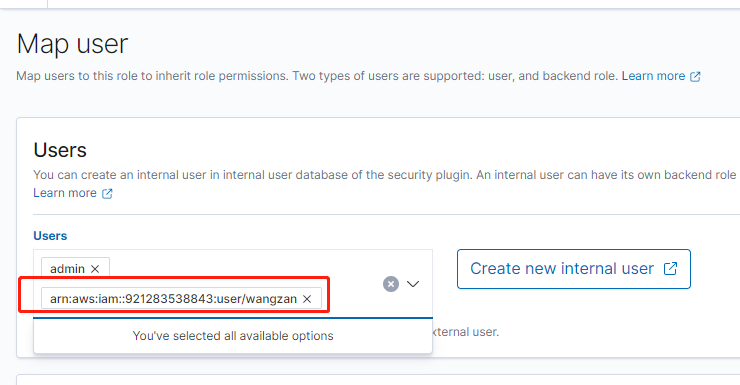
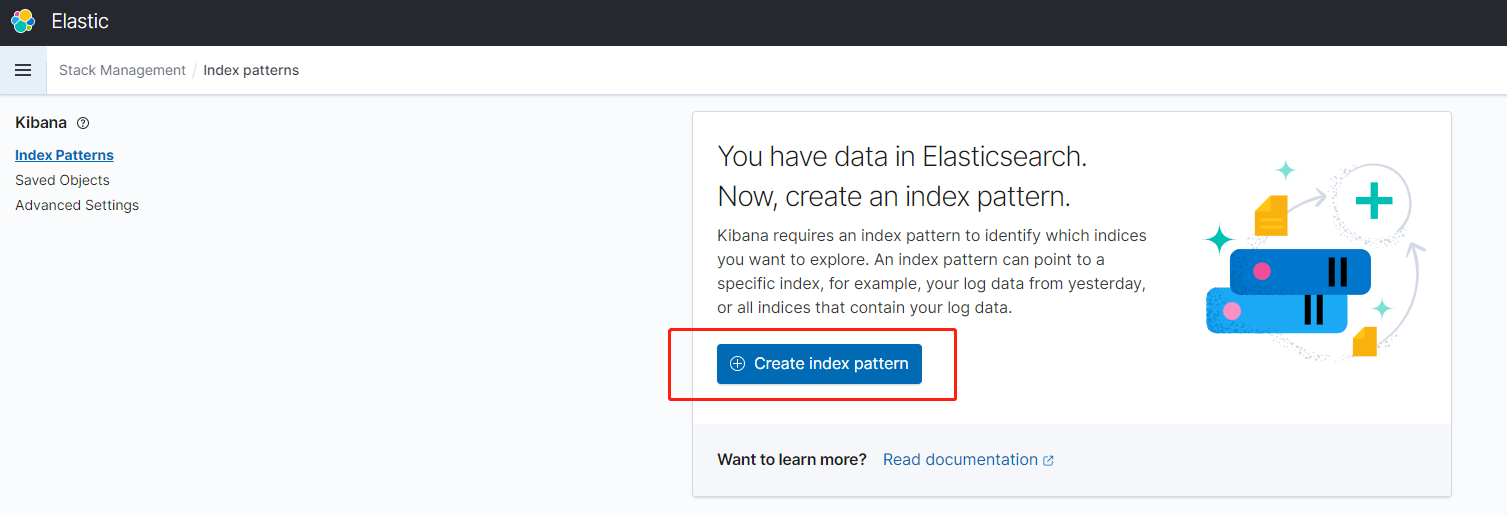
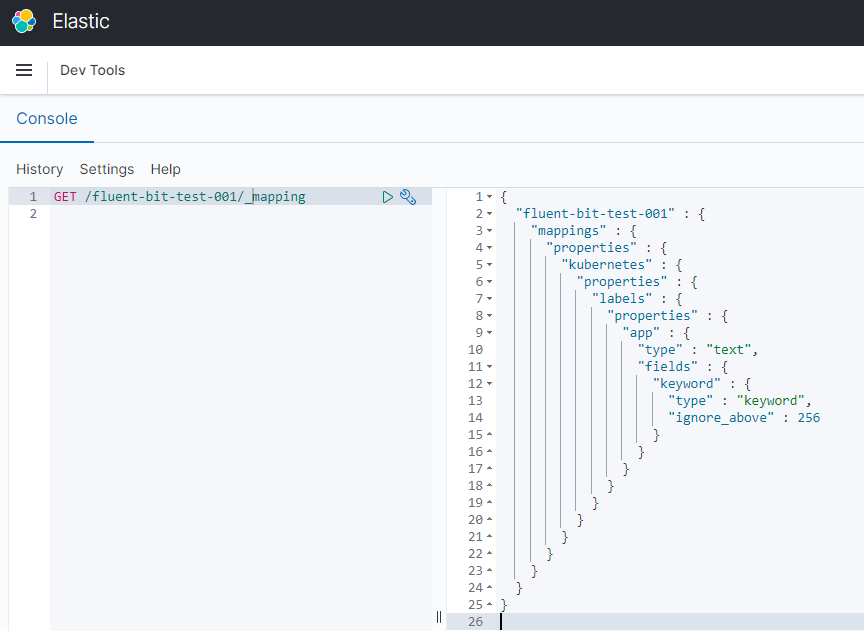
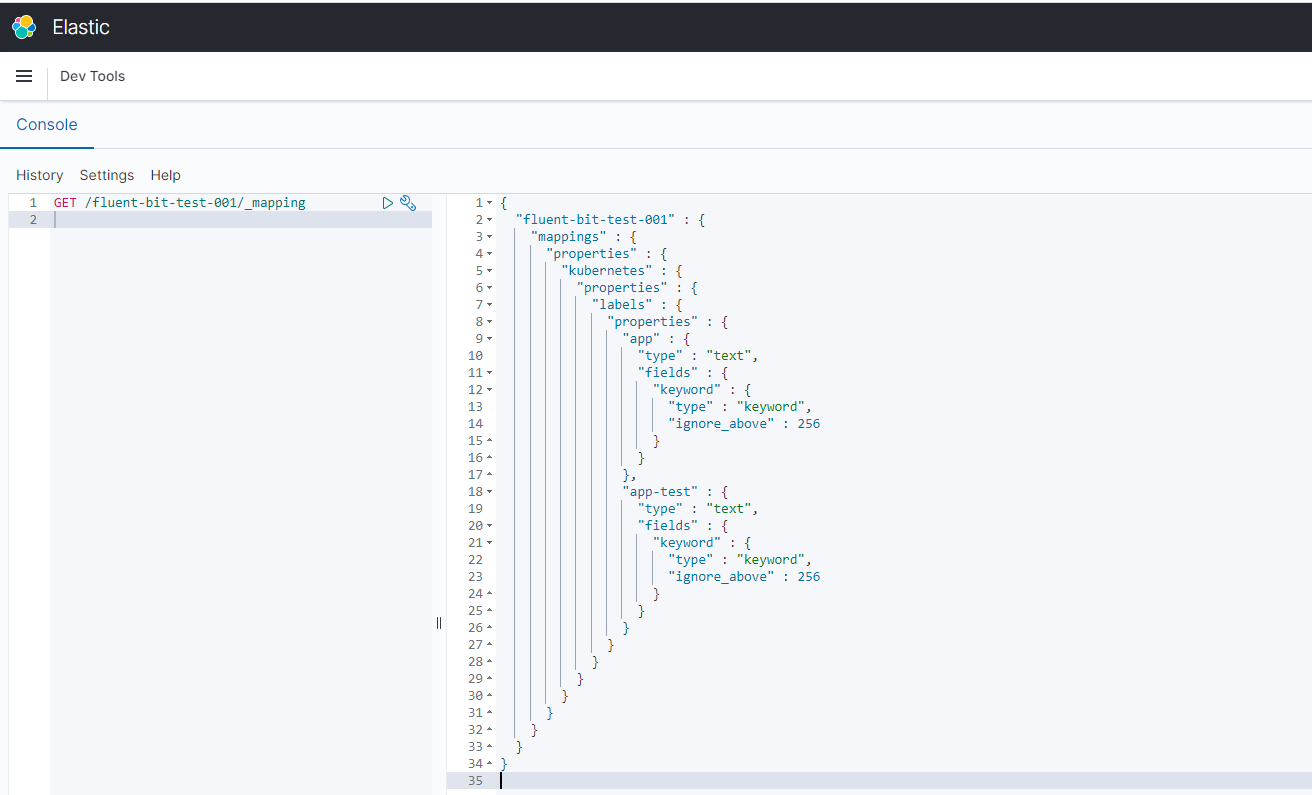
# 介绍 应用程序和系统日志可以帮助我们了解集群内部的运行情况,日志对于我们调试问题和监视集群情况也是非常有用的。而且大部分的应用都会有日志记录,对于传统的应用大部分都会写入到本地的日志文件之中。对于容器化应用程序来说则更简单,只需要将日志信息写入到 stdout 和 stderr 即可,容器默认情况下就会把这些日志输出到宿主机上的一个 JSON 文件之中,同样我们也可以通过 docker logs 或者 kubectl logs 来查看到对应的日志信息。 但是,通常来说容器引擎或运行时提供的功能不足以记录完整的日志信息,比如,如果容器崩溃了、Pod 被驱逐了或者节点挂掉了,我们仍然也希望访问应用程序的日志。所以,日志应该独立于节点、Pod 或容器的生命周期,这种设计方式被称为 cluster-level-logging,即完全独立于 Kubernetes 系统,需要自己提供单独的日志后端存储、分析和查询工具。 ## 日志收集方案 Kubernetes 集群本身不提供日志收集的解决方案,一般来说有主要的 3 种方案来做日志收集: - 在节点上运行一个 agent 来收集日志 ![image-20210607203949035](https://imgs.wzlinux.com/blog/202106/07/203949-774535.png) - 在 Pod 中包含一个 sidecar 容器来收集应用日志 ![image-20210607204001951](https://imgs.wzlinux.com/blog/202106/07/204002-893326.png) - 直接在应用程序中将日志信息推送到采集后端 ![image-20210607204111275](https://imgs.wzlinux.com/blog/202106/07/204111-160445.png) Kubernetes 中比较流行的日志收集解决方案是 Elasticsearch、Fluentd 和 Kibana(EFK)技术栈,也是官方现在比较推荐的一种方案。 `Elasticsearch` 是一个实时的、分布式的可扩展的搜索引擎,允许进行全文、结构化搜索,它通常用于索引和搜索大量日志数据,也可用于搜索许多不同类型的文档。 Elasticsearch 通常与 `Kibana` 一起部署,Kibana 是 Elasticsearch 的一个功能强大的数据可视化 Dashboard,Kibana 允许你通过 web 界面来浏览 Elasticsearch 日志数据。 `Fluentd`是一个流行的开源数据收集器,我们将在 Kubernetes 集群节点上安装 Fluentd,通过获取容器日志文件、过滤和转换日志数据,然后将数据传递到 Elasticsearch 集群,在该集群中对其进行索引和存储。 `Fluentd` 是一个高效的日志聚合器,是用 Ruby 编写的,并且可以很好地扩展。对于大部分企业来说,Fluentd 足够高效并且消耗的资源相对较少,另外一个工具`Fluent-bit`更轻量级,占用资源更少,但是插件相对 Fluentd 来说不够丰富,所以整体来说,Fluentd 更加成熟,使用更加广泛,所以我们这里也同样使用 Fluentd 来作为日志收集工具。 我们先来配置启动一个可扩展的 Elasticsearch 集群,然后在 Kubernetes 集群中创建一个 Kibana 应用,最后通过 DaemonSet 来运行 Fluentd,以便它在每个 Kubernetes 工作节点上都可以运行一个 Pod。 # 创建 ES 集群 为了简便,我们这里使用 AWS 全托管的 ES 服务,服务将会开启精细访问服务,先设定几个环境变量: ```bash # name of our elasticsearch cluster export ES_DOMAIN_NAME="eks-logging" # Elasticsearch version export ES_VERSION="7.10" # kibana admin user export ES_DOMAIN_USER="admin" # kibana admin password export ES_DOMAIN_PASSWORD="Wangzan@18" ``` 创建 ES 集群 ```bash # Download and update the template using the variables created previously mkdir ~/environment/logging/ && cd ~/environment/logging/ curl -sS https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/es-domain.json \ | envsubst > ~/environment/logging/es_domain.json # Create the cluster aws es create-elasticsearch-domain \ --cli-input-json file://~/environment/logging/es_domain.json ``` ![image-20210607230206132](https://imgs.wzlinux.com/blog/202106/07/230206-837255.png) # 为 Fluent bit 配置 IRSA 我们为 ES 开启了精细访问控制,因为 fluent 需要向 ElasticSearch 通信,我们需要为这个 fluent 创建一个具有基本权限的 serviceAccount,这里即便给了很大的权限也是无法写入 ES 集群的,请自行替换 Resource 里面的参数。 ```bash cd ~/environment/logging/ cat < ~/environment/logging/fluent-bit-policy.json { "Version": "2012-10-17", "Statement": [ { "Action": [ "es:ESHttp*" ], "Resource": "arn:aws:es:eu-west-1:921283538843:domain/eks-logging", "Effect": "Allow" } ] } EoF aws iam create-policy \ --policy-name fluent-bit-policy \ --policy-document file://~/environment/logging/fluent-bit-policy.json ``` ## 创建 serviceAccount 为 fluent serviceAccount 创建 IAM 角色。 ```bash kubectl create namespace logging eksctl create iamserviceaccount \ --name fluent-bit \ --namespace logging \ --cluster my-cluster \ --attach-policy-arn "arn:aws:iam::921283538843:policy/fluent-bit-policy" \ --approve \ --override-existing-serviceaccounts ``` 确认一下创建的 serviceAccount 已经 annotated 相应的角色。 ```bash kubectl -n logging describe sa fluent-bit ``` 输出如下: ```bash Name: fluent-bit Namespace: logging Labels: app.kubernetes.io/managed-by=eksctl Annotations: eks.amazonaws.com/role-arn: arn:aws:iam::921283538843:role/eksctl-my-cluster-addon-iamserviceaccount-lo-Role1-1628KE9D9FMEO Image pull secrets: Mountable secrets: fluent-bit-token-kjqnh Tokens: fluent-bit-token-kjqnh Events: ``` # 配置 ES 访问权限 角色映射是精细访问控制的最重要的方面。精细访问控制具有一些预定义的角色来帮助您入门,但除非您将角色映射到用户,否则,向集群发出的每个请求都会以权限错误结束。 *Backend roles*,提供了另一种将角色映射到用户的方法。您可以将同一角色映射到单个后端角色,然后确保所有用户都具有该后端角色,而不是将同一角色映射到几十个不同的用户。后端角色可以是 IAM 角色或任意字符串。 有上面的结果我们可以知道 fluent 的 serviceAccount 的 IAM 角色为: ```bash arn:aws:iam::921283538843:role/eksctl-my-cluster-addon-iamserviceaccount-lo-Role1-1628KE9D9FMEO ``` 因为 ES 已经创建好了,我们使用提前定义的账户和密码登陆进去,然后选择 `Open Distro for Elasticsearch` --> Security --> Roles --> all_access --> Mapped users --> Manage mapping 加上上面的角色。 ![image-20210607231953893](https://imgs.wzlinux.com/blog/202106/07/231954-920360.png) 也可以使用我们定义好的账户访问 ES 接口添加权限 ```bash # We need to retrieve the Fluent Bit Role ARN export FLUENTBIT_ROLE=$(eksctl get iamserviceaccount --cluster my-cluster --namespace logging -o json | jq '.[].status.roleARN' -r) # Get the Elasticsearch Endpoint export ES_ENDPOINT=$(aws es describe-elasticsearch-domain --domain-name ${ES_DOMAIN_NAME} --output text --query "DomainStatus.Endpoint") # Update the Elasticsearch internal database curl -sS -u "${ES_DOMAIN_USER}:${ES_DOMAIN_PASSWORD}" \ -X PATCH \ https://${ES_ENDPOINT}/_opendistro/_security/api/rolesmapping/all_access?pretty \ -H 'Content-Type: application/json' \ -d' [ { "op": "add", "path": "/backend_roles", "value": ["'${FLUENTBIT_ROLE}'"] } ] ' ``` 现在我们使用自己的 IAM user 打开 Console,可以看到会有下面的报错 ![image-20210607232313985](https://imgs.wzlinux.com/blog/202106/07/232314-521859.png) 虽然我们的 IAM user 具有最高权限,但是因为开启的精细访问,这里也会显示没有权限,按照上面的方式,我们可以把自己的 IAM user 也 Map user 里面的 user。 ![image-20210607232510859](https://imgs.wzlinux.com/blog/202106/07/232511-878719.png) # 部署 fluent bit 下载 fluent bit yaml 文件,修改其中一些参数 ```bash cd ~/environment/logging # get the Elasticsearch Endpoint export ES_ENDPOINT=$(aws es describe-elasticsearch-domain --domain-name ${ES_DOMAIN_NAME} --output text --query "DomainStatus.Endpoint") curl -Ss https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/fluentbit.yaml \ | envsubst > ~/environment/logging/fluentbit.yaml ``` 可以查看文件清单,确认一下要部署的资源,然后我们进行部署: ```bash kubectl apply -f ~/environment/logging/fluentbit.yaml ``` 部署的为 DaemonSet,每个 node 上面都会部署一个 fluent 来收取日志。 ```bash wangzan:~/environment/logging $ kubectl --namespace=logging get pods NAME READY STATUS RESTARTS AGE fluent-bit-cfqrn 1/1 Running 0 60s fluent-bit-cnfbl 1/1 Running 0 60s fluent-bit-n46wq 1/1 Running 0 60s fluent-bit-zhbxn 1/1 Running 0 60s ``` # Kibana 可视化 登陆到 Kibana 系统之后,我们选择 Kibana ---> Discover,选择创建 index。 ![image-20210607233724563](https://imgs.wzlinux.com/blog/202106/07/233725-533201.png) 输入 index pattern 的名字,然后点击下一步 ![image-20210607233820347](https://imgs.wzlinux.com/blog/202106/07/233821-999201.png) 我们选择 @timestamp ![image-20210607233921971](https://imgs.wzlinux.com/blog/202106/07/233922-296745.png) 然后再点击 Discover,就可以看到日志了。 ![image-20210607234035175](https://imgs.wzlinux.com/blog/202106/07/234035-230542.png) # 问题处理 我们在 ES 的界面中,可以看到大量的 fluent bit 的错误报告,内容如下: ```verilog [2021/06/17 01:46:35] [ warn] [engine] failed to flush chunk '1-1623894315.231527444.flb', retry in 359 seconds: task_id=1825, input=tail.0 > output=es.0 ``` 我们再去查看 fluent bit 的 Pod ,查看报错日志,会有一个 400 错误,尽量查看新创建的 Pod: ```json "index": { "_index": "fluent-bit", "_type": "_doc", "_id": "TUx4E3oB4v1-EVN7WM4m", "status": 400, "error": { "type": "mapper_parsing_exception", "reason": "Could not dynamically add mapping for field [app.kubernetes.io/name]. Existing mapping for [kubernetes.labels.app] must be of type object but found [text]." } } ``` 我们看到,当 fluent bit 去动态创建 mapping 的时候,无法创建,我们再去查看一下 ES 的 mapping。 ![image-20210617095246535](https://imgs.wzlinux.com/blog/202106/17/095247-151579.png) 这里的 app 类型为 text,无法被创建,为什么会出现这样的问题呢? 我们去查看一下部署的 Pod,发现其中有些 Pod 同时有如下的一些 lable: ```bash app.kubernetes.io/name: app.kubernetes.io/instance: app: ``` 一般来说,若您没有特别设定,当数据写入 ES 的时候,该 index 的 index mapping 便会自动被建立,并且随着数据格式的改变动态地调整 index mapping,因为有 app 这个 label,创建了如上的 mapping,当再创建含有”kubernetes.labels.app.kubernetes.io/name” 的栏位数据写入时, ES无法动态地将”kubernetes.labels.app” 由 text 转为 object,因此出现 http 400 mapper_parsing_exception 这样的错误信息。 ## 小测试 我们可以对 ES Dev Tools 进行一下测试,我们手动写入一份数据: ```json PUT fluent-bit-test-001/_doc/1 { "kubernetes": { "labels": { "app":"test" } } } ``` 然后查看一下 ES 自动创建的 Index mapping。 ```bash GET /fluent-bit-test-001/_mapping ``` ![image-20210617101342472](https://imgs.wzlinux.com/blog/202106/17/101343-316893.png) 若我再写一笔数据至fluent-bit-test-001。 ```json PUT fluent-bit-test-001/_doc/2 { "kubernetes": { "labels": { "app-test":"test" } } } ``` 此时该索引的mapping便随之更动如下: ```json { "fluent-bit-test-001" : { "mappings" : { "properties" : { "kubernetes" : { "properties" : { "labels" : { "properties" : { "app" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } }, "app-test" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } } } } } } } } } } ``` ![image-20210617101558456](https://imgs.wzlinux.com/blog/202106/17/101559-841545.png) 那么我们去重现一下上面的问题,写入如下数据 ```json PUT fluent-bit-test-001/_doc/3 { "kubernetes": { "labels": { "app": { "kubernetes": { "io/name":"test12345" } } } } } ``` 便会出现http 400 mapper_parsing_exception error. 又“kubernetes.labels.app” 无法同时为text及object 型态。 ![image-20210617101835707](https://imgs.wzlinux.com/blog/202106/17/101835-513511.png) ## 解决办法 调整 prod labels 的 key 值的 naming 规则,举例来说,若 labels 的 Key 已经有 app 这样的 key 值了,就不要有后续 app.kubernetes.io/name 这样的 Key 值。 我看了一下,同时有这两个 label 的 Pod 基本就是 ebs,efs,我们去修改他们的 deployment,删掉这些 app 这个标签。 **更改 ebs-csi-controller** ```bash kubectl delete deploy ebs-csi-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-csi-controller.yaml -n kube-system ``` **ebs-csi-node** ```bash kubectl delete daemonset ebs-csi-node -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-csi-node.yaml -n kube-system ``` **ebs-snapshot-controller** ```bash kubectl delete statefulset ebs-snapshot-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-snapshot-controller.yaml -n kube-system ``` **efs-csi-controller** ```bash kubectl delete deploy efs-csi-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/efs-csi-controller.yaml -n kube-system ``` **efs-csi-node** ```bash kubectl delete daemonset efs-csi-node -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/efs-csi-node.yaml -n kube-system ``` 然后查看命令,看看还有哪些 Pod 是带有 app 这个标签的。 ```bash kubectl get pod -n kube-system -l app --show-labels ``` 发现只有一个 cluster-autoscaler,我们修改最后一个 Pod。 **cluster-autoscaler** ```bash kubectl -n kube-system edit deployment.apps/cluster-autoscaler kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/cluster-autoscaler-autodiscover.yaml -n kube-system kubectl -n kube-system \ annotate deployment.apps/cluster-autoscaler \ cluster-autoscaler.kubernetes.io/safe-to-evict="false" deployment.apps/cluster-autoscaler annotated ``` 现在已经没有使用 app 标签的 Pod 了,我们下一步需要重建 ES 的 Index,我们适当的修改 fluent bit 的配置文件,在输出里面,添加一些参数,使得每天生成一个 Index,这样可以提升检索速度,记得把 yaml 下载下来,修改为自己的 ES 地址。 ```bash kubectl delete -f fluentbit.yaml kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/fluent-bit.yaml ``` **重新添加 Index pattern** ![image-20210617122645494](https://imgs.wzlinux.com/blog/202106/17/122646-295212.png) # 清理资源 ```bash cd ~/environment/ kubectl delete -f ~/environment/logging/fluentbit.yaml aws es delete-elasticsearch-domain \ --domain-name ${ES_DOMAIN_NAME} eksctl delete iamserviceaccount \ --name fluent-bit \ --namespace logging \ --cluster my-cluster \ --wait aws iam delete-policy \ --policy-arn "arn:aws:iam::921283538843:policy/fluent-bit-policy" kubectl delete namespace logging rm -rf ~/environment/logging unset ES_DOMAIN_NAME unset ES_VERSION unset ES_DOMAIN_USER unset ES_DOMAIN_PASSWORD unset FLUENTBIT_ROLE unset ES_ENDPOINT ``` # 欢迎大家扫码关注,获取更多信息 ![](https://imgs.wzlinux.com/wechat/wechat-8.jpg)
优秀的个人博客,低调大师

干货 | 14张图解读并发底层原理

爱生活,爱编码,本文已收录架构技术专栏关注这个喜欢分享的地方。本文 架构技术专栏 已收录,有各种JVM、多线程、源码视频、资料以及技术文章等你来拿 零、开局 前两天我搞了两个每日一个知识点,对多线程并发的部分知识做了下概括性的总结。但通过小伙伴的反馈是,那玩意写的比较抽象,看的云里雾里晕晕乎乎的。 所以又针对多线程底层这一块再重新做下系统性的讲解。 有兴趣的朋友可以先看下前两节,可以说是个笼统的概念版。 好了,回归正题。在多线程并发的世界里synchronized、volatile、JMM是我们绕不过去的技术坎,而重排序、可见性、内存屏障又有时候搞得你一脸懵逼。有道是知其然知其所以然,了解了底层的原理性问题,不论是日常写BUG还是面试都是必备神器了。 先看几个问题点: 1、处理器与内存之间是怎么交互的? 2、什么是缓存一致性协议? 3、高速缓存内的消息是怎么更新变化的? 4、内存屏障又和他们有什么关系? 如果上面的问题你都能倒背如流,那就去看看电影放松下吧! 一、高速缓存 目前的处理器的处理能力要远远的胜于主内存(DRAM)访问的效率,往往主内存执行一次读写操作所需的时间足够处理器执行上百次指令。所以为了填补处理器与主内存之间的差距,设计者们在主内存和处理器直接引入了高速缓存(Cache)。如图: 其实在现代处理器中,会有多级高速缓存。一般我们会成为一级缓存(L1 Cache)、二级缓存(L2 Cache)、三级缓存(L3 Cache)等,其中一级缓存一般会被集成在CPU内核中。如图: 内部结构 高速缓存存在于每个处理器内,处理器在执行读、写操作的时候并不需要直接与内存交互,而是通过高速缓存进行。 高速缓存内其实就是为应用程序访问的变量保存了一个数据副本。高速缓存相当于一个容量极小的散列表(Hash Table),其键是一个内存地址,值是内存数据的副本或是我们准备写入的数据。从其内部来看,其实相当于一个拉链散列表,也就是包含了很多桶,每个桶上又可以包含很多缓存条目(想想HashMap),如图: 缓存条目 在每个缓存条目中,其实又包含了Tag、Data Block、Flag三个部分,咱们来个小图: **Data Block : **也就是我们常常叨叨的缓存行(Cache Line),她其实是高速缓存与主内存间进行数据交互的最小单元,里面存储着我们需要的变量数据。 **Tag : **包含了缓存行中数据内存地址的信息(其实是内存地址的高位部分的比特) Flag : 标识了当前缓存行的状态(MESI咯) 那么,我们的处理器又是怎么寻找到我们需要的变量呢? 不多说,上图: 其实,在处理器执行内存访问变量的操作时,会对内存地址进行解码的(由高速缓存控制器执行)。而解码后就会得到tag、index 、offset三部分数据。 index : 我们知道高速缓存内的结构是一个拉链散列表,所以index就是为了帮我们来定位到底是哪个缓存条目的。 tag : 很明显和我们缓存条目中的Tag 一样,所以tag 相当于缓存条目的编号。主要用于,在同一个桶下的拉链中来寻找我们的目标。 offset : 我们要知道一个前提,就是一个缓存条目中的缓存行是可以存储很多变量的,所以offset的作用是用来确定一个变量在缓存行中的起始位置。 所以,在如果在高速缓存内能找到缓存条目并且定位到了响应得缓存行,而此时缓存条目的Flag标识为有效状态,这时候也就是我们所说的缓存命中(Cache Hit),否则就是缓存未命中(Cache Miss)。 缓存未命有包括读未命中(Read Miss)和写未命中(Write Miss)两种,对应着对内存的读写操作。 而在读未命中(Read Miss) 产生时,处理器所需要的数据会从主内存加载并被存入高速缓存对应的缓存行中,此过程会导致处理器停顿(Stall)而不能执行其他指令。 二、缓存一致性协议 在多线程进行共享变量访问时,因为各个线程执行的处理器上的高速缓存中都会保存一份变量的副本数据,这样就会有一个问题,那当一个副本更新后怎么保证其它处理器能马上的获取到最新的数据。这其实就是缓存一致性的问题,其本质也就是怎么防止数据的脏读。 为了解决这个问题,处理器间出现了一种通信机制,也就是缓存一致性协议(Cache Coherence Protocol)。 MESI是什么 缓存一致性协议有很多种,MESI(Modified-Exclusive-Shared-Invalid)协议其实是目前使用很广泛的缓存一致性协议,x86处理器所使用的缓存一致性协议就是基于MESI的。 我们可以把MESI对内存数据访问理解成我们常用的读写锁,它可以使对同一内存地址的读操作是并发的,而写操作是独占的。所以在任何时刻写操作只能有一个处理器执行。而在MESI中,一个处理器要向内存写数据时必须持有该数据的所有权。 MESI将缓存条目的状态分为了Modified、Exclusive、Shared、Invalid四种,并在此基础上定义了一组消息用于处理器的读、写内存操作。如图: MESI的四种状态 所以MESI其实就是使用四种状态来标识了缓存条目当前的状态,来保证了高速缓存内数据一致性的问题。那我们来仔细的看下四种状态 Modified : 表示高速缓存中相应的缓存行内的数据已经被更新了。由于MESI协议中任意时刻只能有一个处理器对同一内存地址对应的数据进行更新,也就是说再多个处理器的高速缓存中相同Tag值得缓存条目只能有一个处于Modified状态。处于此状态的缓存条目中缓存行内的数据与主内存包含的数据不一致。 Exclusive: 表示高速缓存相应的缓存行内的数据副本与主内存中的数据一样。并且,该缓存行以独占的方式保留了相应主内存地址的数据副本,此时其他处理上高速缓存当前都不保留该数据的有效副本。 Shared: 表示当前高速缓存相应缓存行包含相应主内存地址对应的数据副本,且与主内存中的数据是一致的。如果缓存条目状态是Shared的,那么其他处理器上如果也存在相同Tag的缓存条目,那这些缓存条目状态肯定也是Shared。 Invalid: 表示该缓存行中不包含任何主内存中的有效数据副本,这个状态也是缓存条目的初始状态。 MESI处理机制 前面说了那么多,都是MESI的基础理论,那么,MESI协议到底是怎么来协调处理器进行内存的读写呢? 其实,想协调处理必然需要先和各个处理器进行通信。所以MESI协议定义了一组消息机制用于协调各个处理器的读写操作。 我们可以参考HTTP协议来进行理解,可以将MESI协议中的消息分为请求和响应两类。处理器在进行主内存读写的时候会往总线(Bus)中发请求消息,同时每个处理器还会嗅探(Snoop)总线中由其他处理器发出的请求消息并在一定条件下往总线中回复响应得响应消息。 针对于消息的类型,有如下几种: Read : 请求消息,用于通知其他处理器、主内存,当前处理器准备读取某个数据。该消息内包含待读取数据的主内存地址。 Read Response: 响应消息,该消息内包含了被请求读取的数据。该消息可能是主内存返回的,也可能是其他高速缓存嗅探到Read 消息返回的。 Invalidate: 请求消息,通知其他处理器删除指定内存地址的数据副本。其实就是告诉他们你这个缓存条目内的数据无效了,删除只是逻辑上的,其实就是更新下缓存条目的Flag. Invalidate Acknowledge: 响应消息,接收到Invalidate消息的处理器必须回复此消息,表示已经删除了其高速缓存内对应的数据副本。 Read Invalidate: 请求消息,此消息为Read 和 Invalidate消息组成的复合消息,作用主要是用于通知其他处理器当前处理器准备更新一个数据了,并请求其他处理器删除其高速缓存内对应的数据副本。接收到该消息的处理器必须回复Read Response 和 Invalidate Acknowledge消息。 Writeback: 请求消息,消息包含了需要写入主内存的数据和其对应的内存地址。 了解完了基础的消息类型,那么我们就来看看MESI协议是如何协助处理器实现内存读写的,看图说话: 举例:假如内存地址0xxx上的变量s 是CPU1 和CPU2共享的我们先来说下CPU上读取数据s 高速缓存内存在有效数据时: CPU1会根据内存地址0xxx在高速缓存找到对应的缓存条目,并读取缓存条目的Tag和Flag值。如果此时缓存条目的Flag 是M、E、S三种状态的任何一种,那么就直接从缓存行中读取地址0xxx对应的数据,不会向总线中发送任何消息。 高速缓存内不存在有效数据时: 1、如CPU2 高速缓存内找到的缓存条目状态为I时,则说明此时CPU2的高速缓存中不包含数据s的有效数据副本。 2、CPU2向总线发送Read消息来读取地址0xxx对应的数据s. 3、CPU1(或主内存)嗅探到Read消息,则需要回复Read Response提供相应的数据。 4、CPU2接收到Read Response消息时,会将其中携带的数据s存入相应的缓存行并将对应的缓存条目状态更新为S。 从宏观的角度看,就是上面的流程了,我们再继续深入下,看看在缓存条目为I的时候到底是怎么进行消息处理的 说完了读取数据,我们就在说下CPU1是怎么写入一个地址为0xxx的数据s的 MESI协议解决了缓存一致性的问题,但其中有一个问题,那就是需要在等待其他处理器全部回复后才能进行下一步操作,这种等待明显是不能接受的,下面就继续来看看大神们是怎么解决处理器等待的问题的。 三、写缓冲和无效化队列 因为MESI自身有个问题,就是在写内存操作的时候必须等待其他所有处理器将自身高速缓存内的相应数据副本都删除后,并接收到这些处理器回复的Invalidate Acknowledge/Read Response消息后才能将数据写入高速缓存。 为了避免这种等待造成的写操作延迟,硬件设计引入了写缓冲器和无效化队列。 写缓冲器(Store Buffer) 在每个处理器内都有自己独立的写缓冲器,写缓冲器内部包含很多条目(Entry),写缓冲器比高速缓存还要小点。 那么,在引入了写缓冲器后,处理器在执行写入数据的时候会做什么处理呢?还会直接发送消息到BUS吗? 我们来看几个场景: (注意x86处理器是不管相应的缓存条目是什么状态,都会直接将每一个写操作结果存入写缓冲器) 1、如果此时缓存条目状态是E或者M: 代表此时处理器已经获取到数据所有权,那么就会将数据直接写入相应的缓存行内,而不会向总线发送消息。 2、如果此时缓存条目状态是S 此时处理器会将写操作的数据存入写缓冲器的条目中,并发送Invalidate消息。 如果此时相应缓存条目的状态是I ,那就称之为写操作遇到了写未命中(Write Miss),此时就会将数据先写入写缓冲器的条目中,然后在发送Read Invalidate来通知其他处理器我要进行数据更新了。 处理器的写操作其实在将数据写入缓冲器时就完成了,处理器并不需要等待其他处理器返回Invalidate Acknowledge/Read Response消息 当处理器接收到其他处理器回复的针对于同一个缓存条目的Invalidate Acknowledge消息时,就会将写缓冲内对应的数据写入相应的缓存行中 通过上面的场景描述我们可以看出,写缓冲器帮助处理器实现了异步写数据的能力,使得处理器处理指令的能力大大提升。 无效化队列(Invalidate Queue) 其实在处理器接到Invalidate类型的消息时,并不会删除消息中指定地址对应的数据副本(也就是说不会去马上修改缓存条目的状态为I),而是将消息存入无效化队列之后就回复Invalidate Acknowledge消息了,主要原因还是为了减少处理器等待的时间。 所以不管是写缓冲器还是无效化队列,其实都是为了减少处理器的等待时间,采用了空间换时间的方式来实现命令的异步处理。 总之就是,写缓冲器解决了写数据时要等待其他处理器响应得问题,无效化队列帮助解决了删除数据等待的问题。 但既然是异步的,那必然又会带来新的问题 -- 内存重排序和可见性问题。 所以,我们继续接着聊。 存储转发(Store Fowarding) 通过上面内容我们知道了有了写缓冲器后,处理器在写数据时直接写入缓冲器就直接返回了。 那么问题就来了,当我们写完一个数据又要马上进行读取可咋办呢?话不多说,咱们还是举个例子来说,如图: 此时第一步处理器将变量S的更新后的数据写入到写缓冲器返回,接着马上执行了第二布进行S变量的读取。由于此时处理器对S变量的更新结果还停留在写缓冲器中,因此从高速缓存缓存行中读到的数据还是变量S的旧值。 为了解决这种问题,存储转发(Store Fowarding)这个概念上线了。其理论就是处理器在执行读操作时会先根据相应的内存地址从写缓冲器中查询。如果查到了直接返回,否则处理器才会从高速缓存中查找,这种从缓冲器中读取的技术就叫做存储转发。看图: 内存重排序和可见性的问题 由于写缓冲器和无效化队列的出现,处理器的执行都变成了异步操作。缓冲器是每个处理器私有的,一个处理器所存储的内容是无法被其他处理器读取的。 举个例子: CPU1 更新变量到缓冲器中,而CPU2因为无法读取到CPU1缓冲器内容所以从高速缓存中读取的仍然是该变量旧值。 其实这就是写缓冲器导致StoreLoad重排序问题,而写缓冲器还会导致StoreStore重排序问题等。 为了使一个处理器上运行的线程对共享变量所做的更新被其他处理器上运行的线程读到,我们必须将写缓冲器的内容写到其他处理器的高速缓存上,从而使在缓存一致性协议作用下此次更新可以被其他处理器读取到。 处理器在写缓冲器满、I/O指令被执行时会将写缓冲器中的内容写入高速缓存中。但从变量更新角度来看,处理器本身无法保障这种更新的”及时“性。为了保证处理器对共享变量的更新可被其他处理器同步,编译器等底层系统借助一类称为内存屏障的特殊指令来实现。 内存屏障中的存储屏障(Store Barrier)会使执行该指令的处理器将写缓冲器内容写入高速缓存。 内存屏障中的加载屏障(Load Barrier)会根据无效化队列内容指定的内存地址,将相应处理器上的高速缓存中相应的缓存条目状态标记为I。 四、内存屏障 因为说了存储屏障(Store Barrier)和加载屏障(Load Barrier) ,所以这里再简单的提下内存屏障的概念。 划重点:(你细品) 处理器支持哪种内存重排序(LoadLoad重排序、LoadStore重排序、StoreStore重排序、StoreLoad重排序),就会提供相对应能够禁止重排序的指令,而这些指令就被称之为内存屏障(LoadLoad屏障、LoadStore屏障、StoreStore屏障、StoreLoad屏障) 划重点: 如果用X和Y来代替Load或Store,这类指令的作用就是禁止该指令左侧的任何 X 操作与该指令右侧的任何 Y 操作之间进行重排序(就是交换位置),确保指令左侧的所有 X 操作都优先于指令右侧的Y操作。 内存屏障的具体作用: 屏障名称 示例 具体作用 StoreLoad Store1;Store2;Store3;StoreLoad;Load1;Load2;Load3 禁止StoreLoad重排序,确保屏障之前任何一个写(如Store2)的结果都会在屏障后任意一个读操作(如Load1)加载之前被写入 StoreStore Store1;Store2;Store3;StoreStore;Store4;Store5;Store6 禁止StoreStore重排序,确保屏障之前任何一个写(如Store1)的结果都会在屏障后任意一个写操作(如Store4)之前被写入 LoadLoad Load1;Load2;Load3;LoadLoad;Load4;Load5;Load6 禁止LoadLoad重排序,确保屏障之前任何一个读(如Load1)的数据都会在屏障后任意一个读操作(如Load4)之前被加载 LoadStore Load1;Load2;Load3;LoadStore;Store1;Store2;Store3 禁止LoadStore重排序,确保屏障之前任何一个读(如Load1)的数据都会在屏障后任意一个写操作(如Store1)的结果被写入高速缓存(或主内存)前被加载 五、总结 其实从头看到尾就会发现,一个技术点的出现往往是为了填补另一个的坑。 为了解决处理器与主内存之间的速度鸿沟,引入了高速缓存,却又导致了缓存一致性问题 为了解决缓存一致性问题,引入了如MESI等技术,又导致了处理器等待问题 为了解决处理器等待问题,引入了写缓冲和无效化队列,又导致了重排序和可见性问题 为了解决重排序和可见性问题,引入了内存屏障,舒坦。。。 爱生活,爱编码,本文已收录架构技术专栏关注这个喜欢分享的地方。本文 架构技术专栏 已收录,有各种JVM、多线程、源码视频、资料以及技术文章等你来拿 往期推荐 每日一个知识点系列:volatile的可见性原理 (最新 9000字) Spring Boot 配置特性解析 何时用多线程?多线程需要加锁吗?线程数多少最合理? Spring Boot 知识清单(一)SpringApplication 高并发系统,你需要知道的指标(RT...)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册