首页 文章 精选 留言 我的

精选列表

搜索[Agent底座],共10000篇文章
优秀的个人博客,低调大师

数据中心与DDC控制器夯实机房稳定运行底座

数据中心对环境稳定性、设备运行安全性与能耗管控精度有着极高要求,机房空调、通风、给排水、照明等机电设备的精准调控,是保障服务器等核心算力设备稳定运行的关键。DDC直接数字控制器作为楼宇自控系统的核心控制单元,凭借高精度、高稳定性、可编程的优势,成为数据中心底层设备自控的核心载体,有效解决传统人工调控、粗放式设备管理的诸多弊端。 DDC控制器是专为工业及智能建筑场景设计的数字化控制设备,区别于传统模拟控制器,其依托数字化运算逻辑,可实现设备运行数据的实时采集、逻辑运算、自动调控与信号传输,是数据中心机电设备自动化运行的“核心大脑”。它可精准对接机房各类基础设备,实时采集温湿度、设备运行状态、风速、水压等核心数据,依托预设程序自主完成设备启停、参数调节,无需人工干预,适配数据中心7×24小时不间断运行的场景需求。 在数据中心实际运维中,DDC控制器的应用价值体现在多个核心场景。首先是机房环境精准调控,针对机房精密空调、新风系统,可根据区域温湿度变化自动调节运行功率与风速,精准平衡机房冷热环境,杜绝局部过热、温湿度超标等问题,保障算力设备运行环境恒定。其次是设备智能联动管控,可联动给排水、排烟、照明等附属设备,在机房出现环境异常、设备故障时自动触发联动机制,提升机房安全防护能力。同时,DDC控制器具备良好的兼容性与数据传输能力,可向上对接IBMS、BA系统,实现底层设备数据上传、远程监控与统一调度,彻底解决设备分散管控、数据不互通的问题,为机房精细化能耗管理、故障溯源提供数据支撑。 总而言之,DDC控制器是数据中心自动化、智能化运维的底层核心设备。其稳定的控制能力、灵活的可编程特性与良好的系统适配性,有效提升了机房机电设备的管控精度与运行效率,降低人工运维成本与能耗损耗,为数据中心安全、稳定、低碳、高效运行提供坚实的底层技术保障。

优秀的个人博客,低调大师

医院数据中心机房建设,打造医院高效算力底座

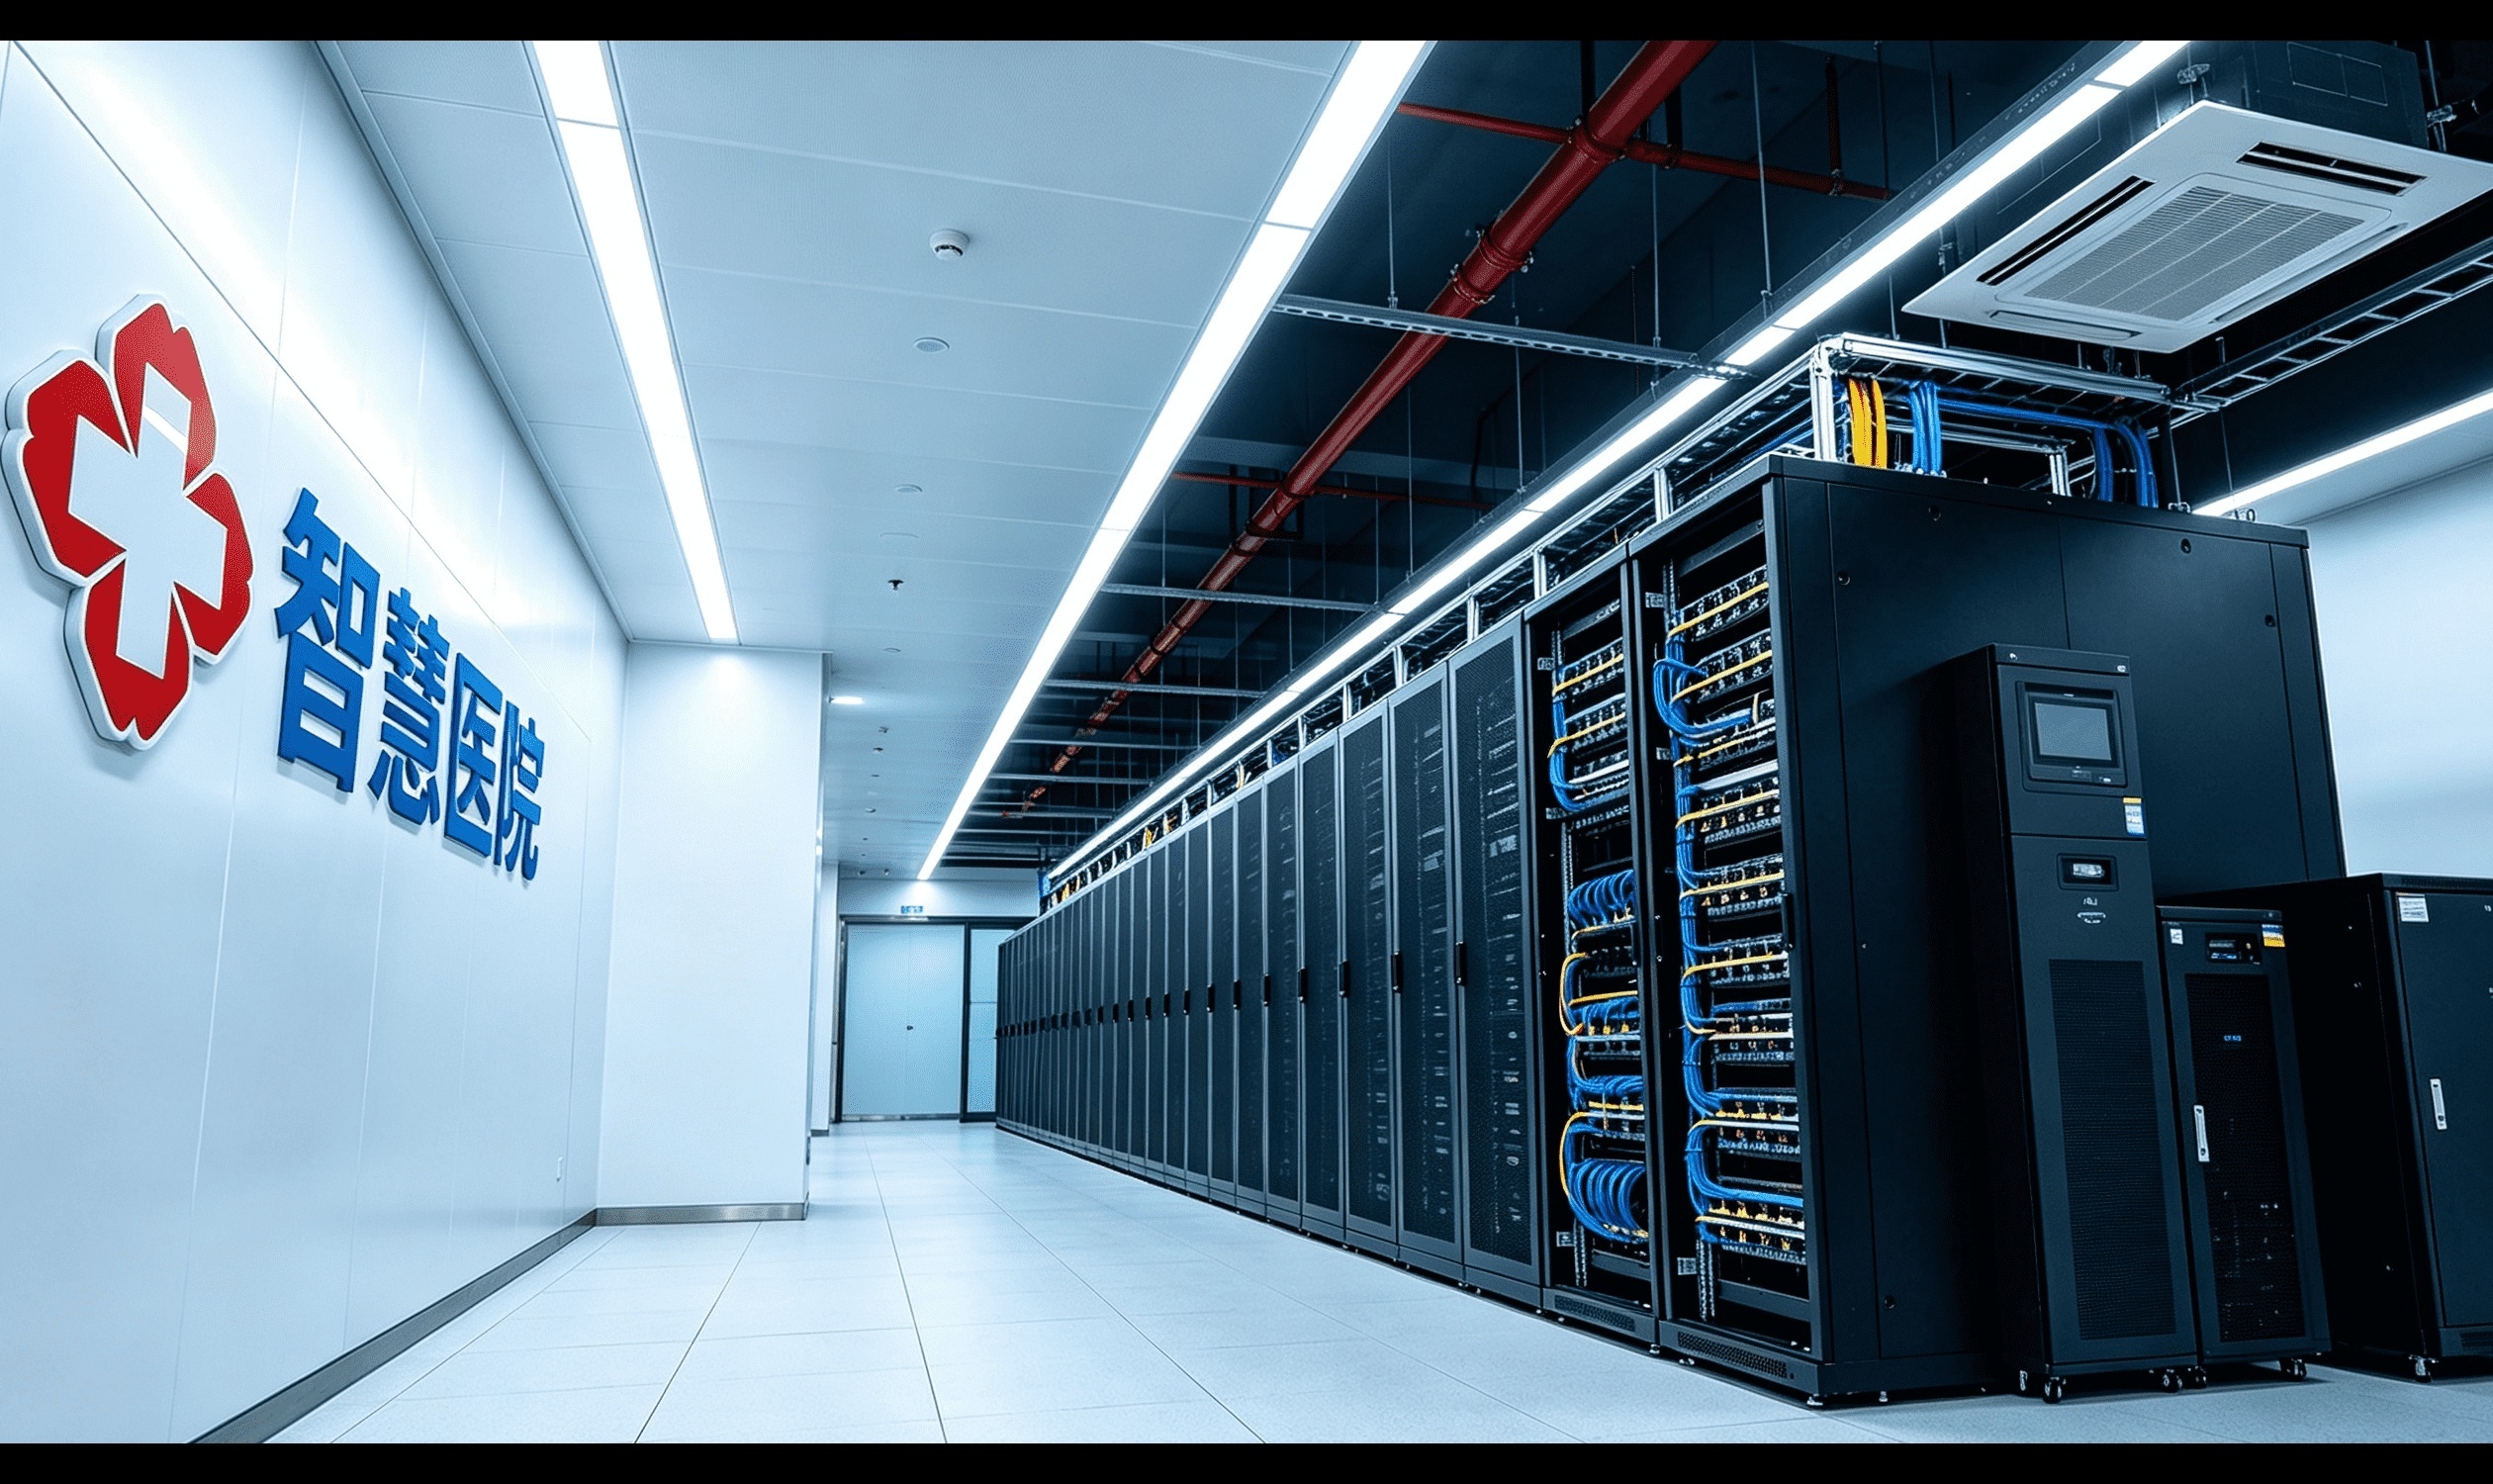
随着医疗信息化持续推进,现代医院的日常诊疗、行政管理、科研教学等工作,均高度依赖数字化系统支撑。数据中心机房是医院信息化体系的核心基础设施,承担着全院诊疗数据存储、各类医疗业务系统运行、数字化医疗服务支撑的重要作用。规范的医院数据中心机房建设,是保障HIS、PACS、电子病历、远程医疗等核心医疗系统稳定运行的基础,也是医院数据安全管理、数字化建设落地的重要前提。 医院数据中心机房建设区别于普通机房建设,需严格契合医疗卫生行业标准及国家相关建设规范,适配医疗业务高稳定、高连续、高安全的专属需求。医疗机房普遍采用模块化建设架构,集成供配电系统、恒温恒湿精密空调系统、气体消防系统、安防监控系统、动力环境监控系统以及数据容灾备份系统,实现软硬件一体化标准化部署。这种建设模式能够有效解决传统机房架构老旧、数据分散孤立、设备运行不稳定、故障多发等常见问题,适配医院全天候运行的工作特性。 ![](https://developer.qcloudimg.com/http-save/audit-12677032/d92d9fab463ac34ea1db3e0f1aabe157.png) 数据安全与业务连续是医院机房建设的核心重点。医疗数据包含患者隐私信息、诊疗记录、医疗科研资料等敏感内容,具备极高的保密性和重要性。因此,正规医院机房会搭建多层级安全防护与容灾体系,通过数据实时同步、双活备份、异地容灾等技术手段,实现业务故障自动切换,保障门诊诊疗、费用结算、病历管理等核心业务全年无间断运行,有效规避数据丢失、系统停运等安全风险,符合医疗数据合规管理要求。同时,智能动力环境监控系统可24小时不间断监测机房温湿度、电力负荷、设备运行状态,异常数据可实时预警,大幅提升机房运维的规范性与稳定性。 完善的数据中心机房可为医院智慧化建设提供充足算力支撑。稳定的机房算力可承载海量医学影像、诊疗档案、科研数据的存储与运算工作,为AI辅助诊断、智能分诊、远程会诊、医疗大数据科研等智慧医疗应用提供基础保障。标准化的机房数据架构能够打通各科室数据壁垒,实现院内医疗数据互联互通、资源共享,助力简化就医流程、提升诊疗效率,推动医院管理模式向精细化、数字化转型。同时,现代化机房采用节能型设备与科学布局设计,可有效降低设备能耗,实现绿色低碳运行。 综上所述,医院数据中心机房建设并非简单的设备搭建,而是医疗数字化体系的基础工程。其建设质量直接关系到医院医疗业务的稳定性、患者数据的安全性以及智慧医疗技术的落地应用。标准化、智能化、安全化的机房建设,是现代医院实现高质量数字化发展的必备条件,也是提升医疗服务规范化、现代化水平的重要基础。

优秀的个人博客,低调大师

开源鸿蒙技术大会2025即将启幕,共绘数字底座新蓝图

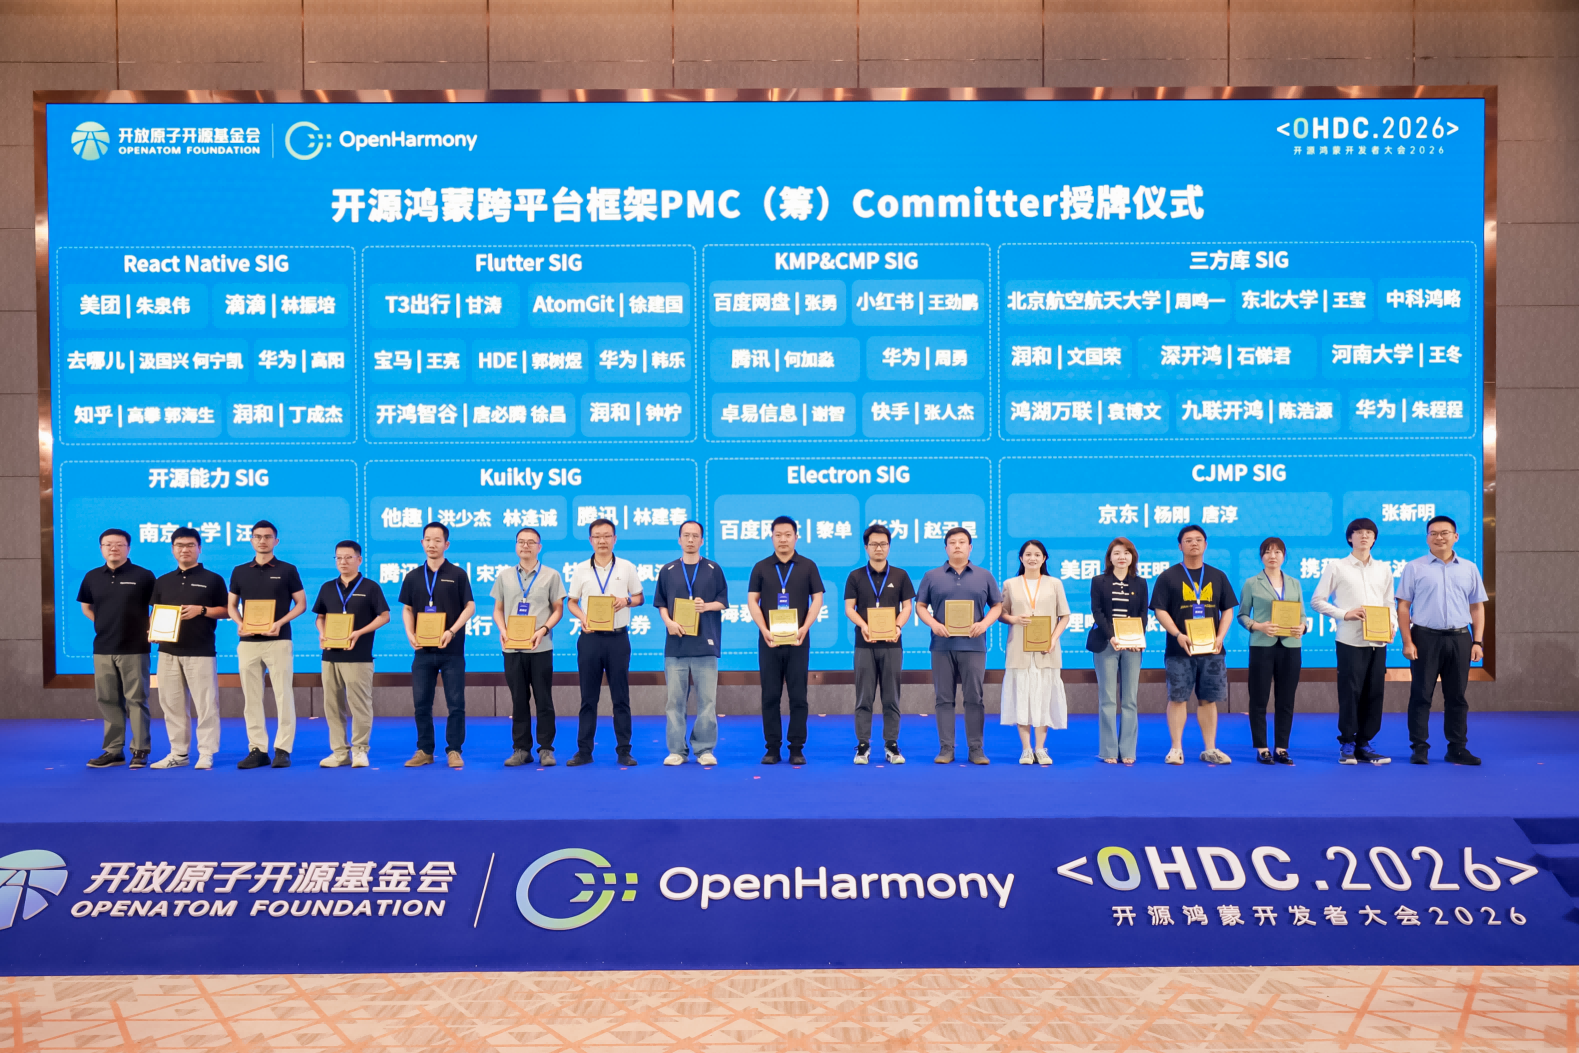
当前,数字经济已成为驱动全球经济增长的重要力量,在这一进程中,操作系统作为数字基础设施的关键组成部分,其发展水平与生态建设直接关系到众多行业数字化转型的进程。作为智能终端操作系统的开源根社区,开源鸿蒙依托其先进的技术架构与持续的智能化升级,正在为培育新质生产力提供重要支撑,并积极助力数字中国建设向纵深推进。 在万物智联从概念走向实践的关键阶段,开源操作系统如何突破技术瓶颈、构建成熟生态、赋能千行百业转型? 答案,即将于9月27日在长沙国际会议中心揭开——由开源鸿蒙项目群技术指导委员会(TSC,Technial Steering Committe)主办,华为承办,深开鸿、开鸿智谷、鸿湖万联、润开鸿、九联开鸿、中软国际、诚迈科技、北理工、中科鸿略、中国南方电网、中国科学院软件研究所、证通、国开鸿等合作单位支持举办的开源鸿蒙技术大会2025年度盛会,将面向全球开源操作系统领域,以更大规模、更高规格,迎接开源领袖、前沿实践专家、高校学者及生态伙伴,为全球开源从业者呈现一场兼具战略高度与实践深度的技术盛宴。 以核心突破,锚定操作系统技术演进新航向 作为大会的主场,主论坛将聚焦开源鸿蒙技术的年度核心进展,通过权威发声与重磅发布,勾勒智能终端操作系统全场景适配与技术深化的清晰路径。主论坛将邀请政府、产业界、学术界、开源界技术专家和权威代表,解读开源鸿蒙在数字基础设施建设中的核心价值。同时,应用生态伙伴与高校代表也将分享前沿实践成果,展现产学研用协同创新的生动实践,为开发者与企业伙伴提供可落地的技术方法论。 值得关注的是,本次主论坛将正式发布开源鸿蒙 6.0 Release版本,该版本进一步增强了系统能力,提升了系统整体可用性与开发效率,生态适配更友好。此外,大会还将举办开源鸿蒙跨平台框架PMC(筹)成立仪式,标志着开源鸿蒙在跨平台开发领域的重要布局,不断完善开源鸿蒙技术生态版图。 同时,本届大会共设置 21 场分论坛,无论在数量规模上,还是在领域覆盖广度上,均实现了近年来的新突破,展现出更全面的议题布局。分论坛将重点围绕开源鸿蒙相关技术垂域、行业与应用生态、教育及人才培养等多维度关键方向展开,全面覆盖从底层核心技术突破到前沿应用场景的全链条。大会旨在通过深入攻坚当前操作系统的核心技术难题、前瞻探索未来演进路径,并精准对接学术界研究、产业界应用与开发者实践需求,切实推动技术创新成为驱动产业转型升级的核心动力。 交流区全景呈现生态成果,见证开源协同五年发展收获 开源鸿蒙开源五年多以来,在全球开发者、生态伙伴的持续贡献下,生态不断繁荣。截至2025年8月31日,社区已汇聚超过9200名贡献者,累计贡献代码量超过1.3亿行,汇聚超480家伙伴参与共建,累计超1300+款产品通过兼容性测评,覆盖金融、超高清、航天、教育、商显、工业、警务、城市、交通、医疗、电力等多个领域。基于这一丰硕的生态共建成果,大会同步设置的6+N板块互动交流区,将集中展示基于"Powered by OpenHarmony"开源鸿蒙生态产品的创新成果与商业进展。 作为这一繁荣生态的集中缩影,开源鸿蒙项目群技术指导委员会(TSC)交流区将呈现其在开源鸿蒙技术生态领域的阶段性创新成果;开源鸿蒙社区公共交流区全面展现开源鸿蒙在千行百业的最佳实践与开源生态的繁荣;华为终端将首次与众多生态伙伴联袂亮相,共同展示基于开源鸿蒙的实践与创新成果;三方社区交流区则将呈现更广泛更多维的商业生态和落地部署情况。同时,仓颉编程语言&毕昇编译器以及应用生态开源技术等关键基础软件与工具链的集中展出,也将进一步凸显开源鸿蒙的产业落地价值,助力参会者清晰感知从技术创新到千行百业赋能的扎实路径,切身感受到开源鸿蒙在不同领域的应用实践与商业价值。 以致谢授牌,致敬贡献者,凝聚开源生态新合力 开源生态的繁荣,离不开每一位共建者的坚守与付出。本次大会将延续对贡献者的致敬传统,通过多场致谢与授牌仪式为社区力量加冕:通过对TSG、开源鸿蒙技术俱乐部的致谢授牌,肯定其在人才培育与技术推广中的杰出贡献;重磅发布开源鸿蒙年度课题,并为优秀技术课题成果授牌;开源鸿蒙项目群捐赠人授牌仪式,感谢生态伙伴为社区蓬勃发展所付出的努力;开源鸿蒙竞赛训练营颁奖,则将致敬在技术实践中表现卓越的开发者,进一步凝聚产学研用协同共进的开源生态新合力。 从底层技术突破到生态场景落地,从人才培养到全球协作,开源鸿蒙技术大会2025既是对过去一年技术进步与生态进展的盘点,更旨在展望以开源推动生态繁荣、以技术赋能产业转型的新未来。我们诚挚邀请全球技术领袖、高校学者、企业伙伴与开发者,于9月27日相聚长沙,在这场思想与技术创新交汇的盛会中共享成果、共探方向、共筑未来!

优秀的个人博客,低调大师

袋鼠云数据湖平台「DataLake」,存储全量数据,打造数字底座

一、什么是数据湖? 在探讨数据湖技术或如何构建数据湖之前,我们需要先明确,什么是数据湖? 数据湖的起源,应该追溯到2010年10月。基于对半结构化、非结构化存储的需求,同时为了推广自家的Pentaho产品以及Hadoop,2010年Pentaho的创始人兼CTO James Dixon首次提出了数据湖的概念。 数据湖概念一经提出,便受到了广泛关注,人们发现此概念代表了一种新的数据存储理念,海量异构数据统一存储可以很好地解决企业数据孤岛问题,方便企业数据管理与应用。 「技术概念的提出,本质都是为了业务场景服务的,是为解决某类特定场景的问题。」 随着新一代信息技术的发展,以及数字化转型的深入推进,数据作为一种“无形资产”的重要性变得比以往更为凸显。物联网、直播、医疗等各种业务场景每天都会生成几GB、几百GB,甚至TB级的原始数据。面对海量数据的存储以及结构化数据、文本、二进制(图片、音频、视频)等数据的存储应用,传统架构的离线数据仓库越来越“力不从心”。 与此同时,随着大数据技术的融合发展,数据湖不断演变,当前我们所讨论的数据湖,已经远远超过了当初 James Dixon 所定义的数据湖。 根据维基的定义,数据湖是一个以原始格式(通常是对象块或文件)存储数的系统或存储库。数据湖通常是所有企业数据的单一存储,用于报告、可视化、高级分析和机器学习等任务。数据湖可以包括来自关系数据库的结构化数据(行和列)、半结构化数据(CSV、日志、XML、JSON)、非结构化数据(电子邮件、文档、pdf)和二进制数据(图像、音频、视频)。 二、袋鼠云数据湖平台 数字经济时代,如何有效利用不同来源、规模巨大的数据,从而加快数据价值化的呈现,把数据用活,成为很多企业的难题。 秉承「让数据创造价值」的使命,袋鼠云进一步夯实企业数字化转型的数据基座。今年7月的2022年产品发布会上,袋鼠云首发数据湖平台——DataLake。 DataLake, 提供面向湖仓一体的数据湖管理分析服务,基于统一的元数据抽象构建一致性的数据访问,提供海量数据的存储管理和实时分析处理能力,可以帮助企业快速构建湖仓一体化平台,完成数字化基础建设。 DataLake让业务响应更加及时,让企业运转更加高效。 三、DataLake的核心特性 下文为大家着重介绍DataLake的核心特性: 1.高效数据入湖 通过⾃研批流⼀体数据集成框架ChunJun,可视化的任务配置,将外部数据高效入湖,让数据具备更高的新鲜度。同时也可对已有表hive结构进行快速扫描,一键生成湖表信息,节省10x倍数据的传输时间和50%磁盘空间。 • 引入ChunJun,提供数据同步效率实现秒级快速入湖 • 全数据同步量/增量一体化,链路短组件少开发维护成本低 • 不影响在线业务的稳定 2.统一元数据管理 支持物理表、虚拟元数据的统一管理,支持表结构变更、时间旅行、数据文件自动治理能力。 袋鼠云数据湖DataLake提供统一的在线数据目录和离线数据治理能力,主要由以下四个部分构成: • 元模型定义:是对元数据的抽象描述,定义了通用元模型和Iceberg元模型 • 元数据采集:支持基于PULL定时拉取和PUSH主动上报的两种方式采集元数据,保证元数据的实时同步 • 元数据存储:根据不同元数据的数据结构和用途,形成以Hive Metastore为主,关系型数据库为辅的存储架构 • 元数据应用:提供线数据目录和离线数据治理能力。在线数据目录可为数据湖的计算引擎提供Schema管理功能;离线数据治理包括,小文件合并、快照清理、孤儿文件清理能治理能力,可以有效降低数据存储提高数据查询效率。同时还支持表结构变更、时间旅行的能力,可以快速对湖表进行加列改列删列,而数据无需重写,支持对数据和Schema进行版本管理一键回滚 3.多级索引加速 高效Data Skipping方案,支持多种索引模式,如bloom index,data skipping index …… 4.高性能联邦查询 内置多种数据连接器,并在开源基础上提供更高效的索引结构,极大提高了数据的跨源联合分析查询能力,可快速完成各类分析需求,带来极致的交互式数据分析体验。 支持MySQL、Oracle、Hive、Iceberg、ClickHouse、MongoDB等30+异构数据源连接器,满足市场95%客户需求。进行Connector整合统一SQL,对外提供标准数据API服务,极大简化用户多数据源数据查询的复杂度,一个标准接口可以同时查询30+数据库。 5.事务支持 支持所有ACID语义,T+0数据更新。 • 基于Iceberg架构数据湖支持Merge On Read模式,数据实际应用时进行Merge操作,可以支持近实时的数据导入和实时数据读取 • 支持ACID,保证了多任务数据同步的写入和查询的隔离性,不会产生脏数据 • 支持行级别快速数据更新,极大提高数据更新效率 6.流批一体 基于数据存储层的统一逻辑,支持流和批的一体化分析,一套架构同时满足流批业务操作,降低学习、使用、维护成本。 异构数据源数据通过ChunJun同步到数据湖平台,历史数据存储Iceberg湖内,可以提供更高效的查询同时具备廉价存储。增量数据运用消息队列提供低延时的写入和消费能力,存储于kafka,同时kafka内数据自动同步到Iceberg内,并记录kafka偏移,以保证数据一致性。 数据进行流式消费时,湖内会自动根据数据读取情况判断读取Kafka 还是 Iceberg 内数据,系统进行自动切换,以实现秒级毫秒级的数据实时查询。 7.多种底层存储 湖仓平台支持HDFS、S3、OSS、MInio等多种底层存储,灵活满足客户不同数据存储需求。 四、一起体验DataLake 结合这些核心特性,接下来一起玩转袋鼠云数据湖平台DataLake吧~ 创建CalaLog 首先创建一个Calalog,一个Calalog只允许绑定一个Hive MetaStore,Calalog与Hive MetaStore是一一对应,用户可以使用Calalog进行业务部门数据隔离。 创建Database 创建一个Database绑定到Calalog上。 创建一张Table 选择Table所在的Catalog、Database,创建一张Iceberg湖表,设置表普通列。支持对普通列字段设置主键,可以用作表的唯一标识。 选择普通列字段作为分区字段,设置分区字段的转换函数,袋鼠云数据湖平台支持时间字段按照年、月、日和小时粒度划分区,支持行组级索引设置和自定义高级参数设置。 快照管理 袋鼠云数据湖平台支持快照历史管理,支持多版本间快照变更对比,支持湖表时间旅行,一键回滚到指定数据版本。 数据入湖 创建入湖任务,选择一张Hive进行转表入湖,一键生成湖表信息。对比数据同步入湖,可以节省10x倍数据的传输时间。 数据文件治理 创建数据文件治理任务模板,支持小文件合并、快照清理、孤儿文件清理等数据文件治理任务,支持立即支持、预约治理、周期治理多种数据治理方式。 想了解或咨询更多有关袋鼠云大数据产品、行业解决方案、客户案例的朋友,浏览袋鼠云官网:https://www.dtstack.com/?src=szkyzg 同时,欢迎对大数据开源项目有兴趣的同学加入「袋鼠云开源框架钉钉技术qun」,交流最新开源技术信息,qun号码:30537511,项目地址:https://github.com/DTStack/Taier

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册