首页 文章 精选 留言 我的

精选列表

搜索[Agent底座],共10000篇文章
优秀的个人博客,低调大师

“智谱AI输入法”发布,底座模型同步开源

智谱AI正式发布并开源GLM-ASR系列语音识别模型,并推出基于该系列模型打造的桌面端“智谱AI输入法”。 本次发布模型与产品包括: GLM-ASR-2512:全球领先的云端语音识别模型; GLM-ASR-Nano-2512:参数量仅1.5B的开源SOTA端侧语音模型; 智谱AI输入法:将语音识别与大模型深度融合的桌面端效率工具。 据介绍,GLM-ASR-2512是智谱新一代语音识别模型,支持将语音实时转换为文字。在多场景、多语种、多口音的真实复杂环境测试中,保持行业领先的识别表现,字符错误率(CER)仅为0.0717。 在此基础上,智谱AI开源了GLM-ASR-Nano-2512。这是一个1.5B参数的端侧模型,却取得了当前开源语音识别方向的SOTA表现,并在部分测试中优于若干闭源模型。它将识别能力压缩到本地运行,在保证高精度的同时,实现更强的隐私保护与更低的交互延迟。 基于上述模型能力,智谱AI正式上线智谱AI输入法,让用户在PC端用语音丝滑交互。用户不但可以实现精准的语音转文字,还可以实现翻译、改写等智能操作,真正实现“指尖即模型,语音即指令”。 即日起,智谱AI输入法面向所有用户开放,并免费提供2000积分,相当于28天使用时长。 GLM-ASR-2512 使用指南:https://docs.bigmodel.cn/cn/guide/models/sound-and-video/glm-asr-2512 体验中心:https://bigmodel.cn/trialcenter/modeltrial/voice 接口文档:https://docs.bigmodel.cn/api-reference/模型-api/语音转文本 GLM-ASR-Nano-2512 Hugging Face:https://huggingface.co/zai-org/GLM-ASR-Nano-2512 魔搭社区:https://www.modelscope.cn/models/ZhipuAI/GLM-ASR-Nano-2512 智谱AI输入法:Mac/Win访问下载:https://autoglm.zhipuai.cn/autotyper/

优秀的个人博客,低调大师

Lightmatter Passage 光互联重塑高性能 AI 训练与推理底座

![](https://developer.qcloudimg.com/http-save/yehe-11573193/2101f6f60a8b3da4d35e0ae6cc6b7f3c.png) 这份是 Lightmatter 在 Hot Interconnects 2026(HotI2026)发布的报告《The Interconnect Foundation for High‑Performance AI Training and Inference》,核心论证:光子互联是突破 AI 算力瓶颈的核心基础设施,详细介绍了 **Passage 光互联方案的性能收益**、**破解光纤与激光瓶颈的两大核心技术(BiDi、VLSP)**,同时**披露了产品路线图与开放产业生态布局**。 ## **一、核心定位:光子互联覆盖 AI 全场景算力瓶颈** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/af6938626b0bec9ea789c2e12fe90030.png) AI 训练与推理的不同阶段,面临差异化的算力约束,报告用 Roofline 图区分**不同阶段**下的瓶颈来源: **Decode(推理解码阶段):内存受限(Memory Bound)** 每单位字节产生的运算量(OPs/Byte)低,性能被内存带宽约束。token 逐一生成,token 间时延 ITL 是核心指标。 **Prefill(推理预填充,输入上下文处理):计算受限(Compute Bound)** 处理输入 prompt,大量矩阵运算,OPs/Byte 比值高,算力成为约束,但大上下文场景下,多卡间数据交互会放大网络压力。 **Training(训练):计算受限(Compute Bound)** 尤其是万亿参数 MoE 模型,专家分片分布在不同 XPU,all‑reduce、all‑to‑all 集合通信极度依赖互联带宽。 **二、分场景性能收益** Training、Prefill、Decode 三者瓶颈不一样,但 Passage 光互联架构可以同时加速三者,报告中给出了标称收益。 ## **Training:万亿参数 MoE 模型下,训练时间降低3倍** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/080ad0bf89258fed9adf9325bb6101d8.png) 针对万亿参数的混合专家(MoE)大模型,Passage 方案相对传统铜缆基线(Copper Baseline),可实现**训练时间缩短至原 1/3 以内**,具体配置与耗时对比如下(耗时数值越低,性能越好): - **铜缆基线**:14.4 Tbps 纵向扩展带宽,由 4 个 144-GPU Pod 组成,训练耗时基准为 1.00× - **Passage(同等14.4Tbps带宽配置)**:单 Pod 即可支持 512-GPU 规模,训练耗时降至 0.60×,相比铜快约1.67 倍 - **Passage(增强32Tbps带宽配置)**:单 Pod 支持 512-GPU 规模,训练耗时降至 0.37×,达成约2.7 倍加速 传统铜缆需要拆分成多个 GPU pod,带来跨 pod 通信开销;光互联可以把 512 个 GPU 收拢到单个 pod,更高的 scale‑up 带宽,减少跨 pod 通信损耗,MoE 的 all‑to‑all 专家调度收益尤为明显。 > 上述结论来源: M. Bernadskiy 等人发表于 IEEE Micro 的学术研究。 ## **Prefill:首 token 生成时间(TTFT )降低3倍** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/1c158c0c6368ab2aee087420425b8b77.png) 测试基于 **Lightmatter 自研Prefill 模拟器**,不同上下文长度对应不同 batch size: - 1K (batch=8192) - 8K (batch=1024) - 131K (batch=64) **Passage相对铜缆方案,TTFT性能收益:** - 1K 上下文:2 倍 TTFT 加速 - 8K 上下文:2 倍 TTFT 加速 - 131K 超长上下文:3 倍 TTFT 加速 - 上下文越长,光互联收益越大。超长上下文大模型,输入阶段大量 KV‑Cache 跨卡交互,铜互联带宽瓶颈凸显,光子互联优势被放大。 ### **Decode:全场景 Token 间延迟(ITL)减半** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/93e1738900a821ab680e555201af73a3.png) 在短到长的全范围上下文长度下,Passage 方案相对铜缆实现**2 倍解码速度提升**,有效降低 Token 间延迟(Inter-Token Latency, ITL)。 - **测试模型:**10T 参数 MoE 大语言模型,含 340B 激活参数、1024 个专家; - **硬件对比:** - 光互联:16×128 XPU HyperX;单链路带宽 4.0 TB/s;单跳延迟 **0.5 μs** - 铜缆:128-XPU 机架,机架内纵向拓展(scale-up)带宽 4.0 TB/s;单跳延迟** 1 μs**;机架间横向拓展(scale-out)带宽 200 GB/s、延迟 4 μs ## **三、两大关键技术:BiDi + VLSP** 报告提出业界面临Laser and Fiber Wall(光纤与激光器壁垒),传统可插拔光模块方案存在光纤数量爆炸、离散激光器供给不足、连接器故障点多、成本高等问题,依靠 BiDi 与 VLSP 解决。 ### **BiDi(双向传输)技术:破解光纤数量瓶颈** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/aa5f9191c37c3e6f617cf6bbdffcd39e.png) ![](https://developer.qcloudimg.com/http-save/yehe-11573193/471744c6abcdcb6ef58ae08c084cb50a.png) **1)技术背景**:传统光子方案仅作为电 SerDes 的补充,以太网 SerDes 按 56G→112G→224G→448G 的路线迭代;而在 OCI MSA 标准框架下,光子技术成为主导,依托 DWDM 波分复用与 BiDi 双向传输,实现单代带宽翻倍(Gen1 200 Gbps → Gen4 1600 Gbps)。 **2)核心原理**:单根单模光纤同时承载发射(Tx)和接收(Rx)双向路径,单空间模式支持 16 个波长,将数量直接减半(原收发各 8 路光纤缩减为单光纤双向传输)。 ![](https://developer.qcloudimg.com/http-save/yehe-11573193/5843b0070d2f482c1b0da3789cbd856e.png) ![](https://developer.qcloudimg.com/http-save/yehe-11573193/a9376e32d11434a571283085092993a0.png) **3)产品落地**: - **2027 年第一季度将推出支持 BiDi 的通用 NPO 光引擎** - **当前 Passage L20 产品已搭载 BiDi 能力**:单方向带宽 6.4 Tbps,总聚合带宽 12.8 Tbps;32 端口 × 单通道 200 Gbps,采用 200 Gbps PAM4 SerDes(符合 IEEE 802.3dj 标准);双波长 BiDi 方案(1311 / 1331 nm,DR 兼容);最大 TDP 功耗 30 W,且已纳入 NVIDIA NVLink Fusion 生态。 **4)成本与运维收益**:以典型 512 XPU 扩展集群(单 XPU 32 Tbps)为例,可节省 150 英里光纤、减少 2 万个连接器与故障点,整体网络支出降低 16%。 ### **VLSP(超大规模光子)技术:破解分立激光瓶颈** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/d7f42bdd99bdbe3fb741322cf3215982.png) ![](https://developer.qcloudimg.com/http-save/yehe-11573193/048a8084680a18e994f49c3971a390a4.png) **1)行业痛点**:传统分立 InP 激光方案面临扩展性与供应链双重约束 —— 分立 ELSFP 激光模块随带宽提升,模块数量指数级增长(800 Tbps 带宽需 128 个模块),成为性能、成本与可靠性的核心瓶颈;同时下一代光子链路对激光器的波长精度、功率稳定性、多波长集成度要求极高,分立方案难以满足。 ![](https://developer.qcloudimg.com/http-save/yehe-11573193/9679baef14eaeeee89b195ef6f1a0ecc.png) ![](https://developer.qcloudimg.com/http-save/yehe-11573193/0d361d662debe75098b5ea17fcfa7fe2.png) **2)解决方案**:Guide™ VLSP 激光芯片,基于 300mm CMOS SOI 晶圆实现片上光子器件集成,彻底替代分立激光方案。 **3)核心优势参数:** - 单芯片集成 128 + 个激光器,支持 64 + 波长多色输出 - 可靠性达 0.1 FIT,具备自愈能力 - 功率精度 0.25 dB,频率精度 3 GHz - 所有光学元件片上集成,替代传统多分立器件组合方案 ## **四、十年技术路线图与产业生态** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/f32dc3ac003c3ba2580e1dd01089677d.png) ### **1. 十年硅光落地路线图** Lightmatter 规划了光子技术从板级到芯片级的逐步集成路径: - 2027 年:落地 NPO(近封装光学)形态的通用光引擎 - 2028 年:推进 CPO(共封装光学)方案落地 - 2029 年及以后:实现中介层级别的深度集成 Guide 系列激光器作为底层光源技术,支撑全路线演进;当前 Passage EVK50、Passage EVK100、Passage M1000 EVK 等产品均已在验证数据中心部署,并向客户交付。 ## **2. 开放生态:OCP 推动 AI 开放硅光子** ![](https://developer.qcloudimg.com/http-save/yehe-11573193/65d5b8f4a4056405d91a010d6d1591de.png) 2026 年 7 月,Lightmatter 联合 OCP 开放计算项目发布白皮书《Architecture Vision: Open Silicon Photonics for AI Systems》(《架构愿景:面向 AI 系统的开放硅光》,版本 1.0.6,全文 294 页),协同上下游生态伙伴,共建CPO生态。白皮书由 Lightmatter、Dell Technologies、Qualcomm、Flex 的专家主导撰写,并有来自 GUC、Keysight、Intel、Corning、Celestica、Foxconn FIT、Jabil、Hyve Solutions、Wiwynn 等企业的三十余位协作者共同参与,AMD、Intel、Dell 的 OCP Server 项目成员提供特别支持。白皮书覆盖 XPU 托盘、交换机托盘、光纤布线、机架整机设计、开放硅光落地路线图等深度分析。OCP开放硅光子 AI 系统架构白皮书深度解读 ## **七、核心结论与行业启示** ### **1. AI 性能瓶颈转移** 大模型尤其是 MoE、超长上下文推理,性能瓶颈从计算芯片转移到互联网络。不同工作负载(Training/Prefill/Decode)瓶颈类型不同,但光互联可以同时优化三者。铜缆在规模扩大后,scale‑out 带宽、时延、布线、成本全面承压。 ### **2. BiDi 解决光纤物理布线难题** BiDi 双向光减半光纤数量,降低布线复杂度、连接器故障点、TCO,是大规模 AI 集群落地的必要工程手段;兼容现有标准,融入 NVLink 生态,便于现有 AI 集群升级。 ### **3. VLSP/GUIDE 解决激光器供应链卡脖子** 传统离散 InP 激光器,当 AI 集群带宽走向几十 Tbps per XPU,激光器数量爆炸,供应链、可靠性无法支撑。VLSP 将上百路激光器集成在 300mm 硅光芯片,是实现下一代大规模 CPO/NPO 的关键前提。 ### **4. 演进路径:NPO (2027) → CPO (2028) → Interposer (2029+)** 不是一步跳到 CPO;行业会先落地 NPO 近封装光学,逐步过渡到 CPO 共封装,最终中介层集成光子。Lightmatter 已经完成 EVK 验证,硬件原型已经交付客户。 ### **5. 局限(报告为厂商宣讲材料,需要注意)** 所有加速数据来自ScaleScope 仿真器、prefill 模拟器,并非完整大规模实测集群结果;3 倍训练加速、3 倍 TTFT、2 倍 Decode 是理想仿真条件下上限,实际落地会受软件栈、通信算法、流量模式影响。

优秀的个人博客,低调大师

DTDS筑牢数据中心运行底座 补齐末端配电短板

随着算力产业高速发展,数据中心已成为数字经济的核心基础设施,机房内精密电子设备密集、配电回路繁多、设备常年不间断运行,末端用电环境复杂多变,细微的电气异常都可能引发业务故障、设备损耗甚至安全隐患。DTDS末端用电防护治理系统,是针对配电末端场景研发的智能化综合治理设备,专门解决数据中心末端回路的用电难题,填补了传统配电系统在末梢用电管控上的空白,是现代化数据中心安全运维、节能增效的关键配套技术。 数据中心核心配电设备多聚焦于总路供电保护,对列头柜、机柜末端、分支回路的用电状态监测存在盲区,而绝大多数机房电气隐患都诞生于末端用电环节。服务器、交换机、UPS等大量非线性负载集中工作,极易产生谐波叠加、电压偏移、三相负荷不均、零线过热等问题,这类隐患隐蔽性极强,不会瞬间触发断电保护,却会持续造成设备老化加速、机房能耗升高、供电稳定性下降,严重时会导致数据传输异常、服务器宕机,影响业务连续性。DTDS系统主打末端就地化治理与全方位监测,可对每一条末端回路的电力参数、运行温度、电能质量进行24小时不间断采集分析,主动过滤谐波干扰、平衡不均衡负荷、抑制零线过载发热,从源头优化末端电能质量。同时,系统具备智能预警、故障精准定位和异常防护能力,能够提前识别漏电、电弧、过温等危险隐患,将传统被动抢修的运维模式转变为主动预判、提前处置,大幅降低末端电气故障发生率。 整体而言,DTDS系统精准适配数据中心不间断、高精密、低故障的运行需求,聚焦传统配电体系忽略的末端短板,兼顾安全防护、电能治理与智能运维多重价值,既有效规避了末端用电隐患带来的安全风险与设备损耗,也助力数据中心提升用电能效、降低运维成本,为数据中心安全、稳定、高效、合规运行提供了坚实的末端保障。 ![](https://developer.qcloudimg.com/http-save/audit-12677032/ba50419b25e03259cabf888040bee9f2.jpg)

优秀的个人博客,低调大师

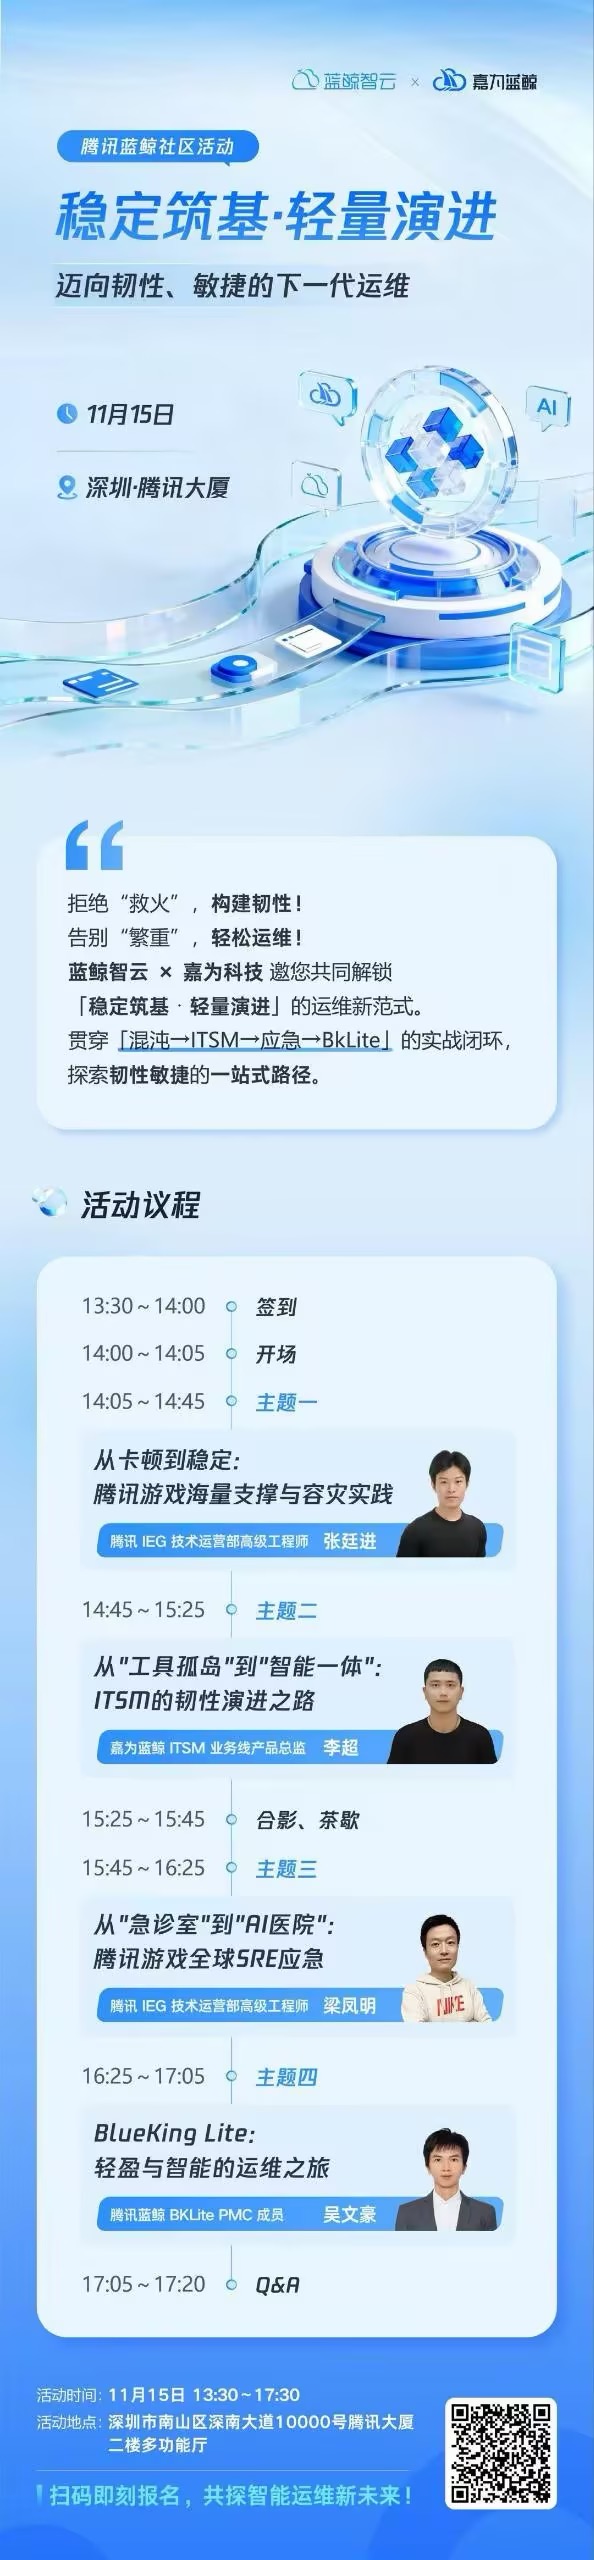
【腾讯 × 嘉为科技】 专题沙龙 |:共筑韧性运维底座

在数字化转型的浪潮中,运维不再只是“救火队”,而是企业韧性的基石。 11月15日,腾讯蓝鲸智云携手嘉为科技,邀您共赴【稳定筑基·轻量演进】运维主题沙龙。 从“卡顿到稳定”,从“工具孤岛到智能一体”,从“急诊室到PH医院”, 解锁蓝鲸生态的实战演进,体验 BkLite 带来的轻盈与智能运维新范式。 📅 活动时间: 11月15日 13:30 - 17:30 📍 活动地点: 深圳·腾讯大厦 二楼梦梦剧厅 扫码报名,共探未来运维的稳与轻!

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册