首页 文章 精选 留言 我的

精选列表

搜索[自然语言],共4357篇文章
优秀的个人博客,低调大师

Hanlp自然语言处理中的词典格式说明

使用过hanlp的都知道hanlp中有许多词典,它们的格式都是非常相似的,形式都是文本文档,随时可以修改。本篇文章详细介绍了hanlp中的词典格式,以满足用户自定义的需要。 基本格式 词典分为词频词性词典和词频词典。 1、词频词性词典(如CoreNatureDictionary.txt) (1)每一行代表一个单词,格式遵从[单词] [词性A] [A的频次] [词性B] [B的频次] ...。 (2)支持省略词性和频次,直接一行一个单词。 (3).txt词典文件的分隔符为空格或制表符,所以不支持含有空格的词语。如果需要支持空格,请使用英文逗号,分割的纯文本.csv文件。在使用Excel等富文本编辑器时,则请注意保存为纯文本形式。 2、词频词典(如CoreNatureDictionary.ngram.txt) (1)每一行代表一个单词或条目,格式遵从[单词] [单词的频次]。 (2)每一行的分隔符为空格或制表符。 少数词典有自己的专用格式,比如同义词词典兼容《同义词词林扩展版》的文本格式,而转移矩阵词典则是一个csv表格。 下文主要介绍通用词典,如不注明,词典特指通用词典。 数据结构 Trie树(字典树)是HanLP中使用最多的数据结构,为此,我实现了通用的Trie树,支持泛型、遍历、储存、载入。 用户自定义词典采用AhoCorasickDoubleArrayTrie和二分Trie树储存,其他词典采用基于双数组Trie树(DoubleArrayTrie)实现的AC自动机AhoCorasickDoubleArrayTrie。关于一些常用数据结构的性能评估,请参考wiki。 储存形式 词典有两个形态:文本文件(filename.txt)和缓存文件(filename.txt.bin或filename.txt.trie.dat和filename.txt.trie.value)。 1、文本文件 ·采用明文储存,UTF-8编码,CRLF换行符。 2、缓存文件 (1)就是一些二进制文件,通常在文本文件的文件名后面加上.bin表示。有时候是.trie.dat和.trie.value。后者是历史遗留产物,分别代表trie树的数组和值。 (2)如果你修改了任何词典,只有删除缓存才能生效。 修改方法 HanLP的核心词典训练自人民日报2014语料,语料不是完美的,总会存在一些错误。这些错误可能会导致分词出现奇怪的结果,这时请打开调试模式排查问题: HanLP.Config.enableDebug(); (1)核心词性词频词典 a)比如你在data/dictionary/CoreNatureDictionary.txt中发现了一个不是词的词,或者词性标注得明显不对,那么你可以修改它,然后删除缓存文件使其生效。 B)目前CoreNatureDictionary.ngram.txt的缓存依赖于CoreNatureDictionary.txt的缓存,修改了后者之后必须同步删除前者的缓存,否则可能出错 (2)核心二元文法词典 a) 二元文法词典data/dictionary/CoreNatureDictionary.ngram.txt储存的是两个词的接续,如果你发现不可能存在这种接续时,删掉即可。 B)你也可以添加你认为合理的接续,但是这两个词必须同时在核心词典中才会生效。 (3)命名实体识别词典 a)基于角色标注的命名实体识别比较依赖词典,所以词典的质量大幅影响识别质量。 b)这些词典的格式与原理都是类似的,请阅读相应的文章或代码修改它。
优秀的个人博客,低调大师

NLP自然语言处理中的hanlp分词实例

本篇分享的依然是关于hanlp的分词使用,文章内容分享自 gladosAI 的博客,本篇文章中提出了一个问题,hanlp分词影响了实验判断结果。为何会如此,不妨一起学习一下 gladosAI 的这篇文章。 学习内容 在之前的实验中得到了不在词向量里的词与分词结果,结果有500多个词不在词向量里,解决方案就是重新分词,或再追加训练这些词到词向量里。但后者相对麻烦且目前样本量不大。我跟据词向量的作者[6]所使用的分词工具来分词,会比不同工具(jieba)的效果要好,因为都是同一模式的分词,分出来的词应该都会存在于大型语料库中。实验证明思路是对的,最后结果是只有60几个词不在词向量里,其中大部分为名词,还有些为因语音翻译问题所造成的出错连词,所有这些词也只出现一次,这部分可以考虑最后删去也不会影响结果。改善未出现词是个关键步骤,因为此后模型会用到词向量,如果未出现词过多,会影响词向量效果。 问题:不过最后HANLP分词影响了实验判断结果,准确率从93%(jieba分词,同模型同参数)下降到90%。 实验:使用HanLP分词 1,前期准备,(环境ubuntu,python3)安装JAVA-10[3](hanlp是JAVA开发的,即使使用python调用pyhanlp需要借助java),jpype(python中虚拟java环境),hanlp(开源中文处理工具,不只是分词还有各种工具),hanlp的root路径配置及data数据包放置[4] 2,主要程序[5] w2v_model = KeyedVectors.load_word2vec_format(w2vpath, binary=False, unicode_errors='ignore') # 加载词向量 hanlppath=\"-Djava.class.path=/media/glados/Learning/project/NLP/hanlp/hanlp-1.6.4.jar:/media/glados/Learning/project/NLP/hanlp/" jp.startJVM(jp.getDefaultJVMPath(), hanlppath) # , "-Xms1g", "-Xmx1g") # 启动JVM, Xmx1g分配1g内存 jp.JClass('com.hankcs.hanlp.HanLP$Config').ShowTermNature = False # 关闭分词属性显示 HanLP = jp.JClass('com.hankcs.hanlp.HanLP') #普通分词模式 words = str(HanLP.segment(sentence)) #分词将结果转为str words = re.sub('[反斜杠[反斜杠],\n]', ' ', words) # 这里注意实际程序是单\,在blog里会出问题,所以用反斜杠替代 words = words.split() words = del_stopword(words) ... jp.shutdownJVM() # 最后关闭java虚拟环境 使用的是HANLP的普通分词功能,另外需注意,hanlp.segment()不能直接输出或赋值给python,因为其是java环境中数据,所以只有转为str()后,再进行处理,否则会报错#Afatalerror。(另外还有其他java与python数据对应问题,在这里没遇到,请参考其他) 词向量选用的是“Mixed-large综合”[6],其包括百度wiki百科、人民日报等,总共1293214个词。 Hanlp的中部份功能没法使用,例如精确分词CRF。另外,要先加载词向量再加载java虚拟环境。#AfatalerrorhasbeendetectedbytheJavaRuntimeEnvironment 3,实验结果 (模型使用的是特征为tfidf的lsi模型, 参数:num_topics=3, 判断是否相似阀值为0.45,即大于0.45为true相似 ) 同模型同参数下,jieba分词结果 jieba分词未出现在词向量的约500多,有些词出现了好几次,而hanlp分词只有60几个未出现,且多数为名词,只出现过一次。 4,分析 在样本中,所有样本分词结果jieba比hanlp要多分出100个词左右。所以推测因hanlp分词细粒度大,分出词少,导致较少的共现词出现(也可能是hanlp分词精度更高,分出很多虚词被停止词表过滤造成),也就是说,lsi+tfidf模型对词细粒度大、分词少的分词器不友好,所以最后hanlp出错率更大。 jieba与hanlp都是很不错的分词器,结巴使用更方便。hanlp准确度要高一些(感觉),而且与文中提到的词向量相匹配。 (我免贵姓AI,jieba:我免/贵姓/AI,hanlp:我/免/贵姓/AI,实际:我/免贵/姓AI)

优秀的个人博客,低调大师

自然语言处理 依存树的可视化

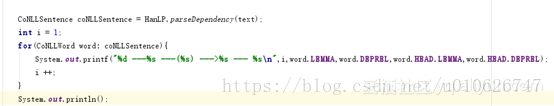
目标:NLP中依存树的可视化 首先需要准备的工具 Hanlp(借助hanlp神经网络的高性能依存句法分析器模型) Dependency Viewer可视化工具 对于一句话text,可以采用hanlp中的下图代码转化为conll格式 下图是采用了一些测试句子的结果(在conll文件中以空行隔开): 在dependency View中进行展示,打开dependency View,选择File----read Conll file打开本地的conll文件,即可看到依存树展示的结果 文章来源于醉意流年go的博客

优秀的个人博客,低调大师

hanlp自然语言处理包的人名识别代码解析

HanLP发射矩阵词典nr.txt中收录单字姓氏393个。袁义达在《中国的三大姓氏是如何统计出来的》文献中指出:当代中国100个常见姓氏中,集中了全国人口的87%,根据这一数据我们只保留nr.txt中的100个常见词语的姓氏角色,其他词语去掉其姓氏角色状态。过滤后,nr.txt中具有姓氏角色的单字共计97个。 列于下表:丁 万 乔 于 任 何 余 侯 傅 冯 刘 卢 史 叶 吕 吴 周 唐 夏 姚 姜 孔 孙 孟 宋 尹 崔 常 康 廖 张 彭 徐 戴 方 易 曹 曾 朱 李 杜 杨 林 梁 武 段 毛 江 汤 汪 沈 潘 熊 王 田 白 石 秦 程 罗 胡 苏 范 萧 董 蒋 薛 袁 许 谢 谭 贺 贾 赖 赵 邓 邱 邵 邹 郑 郝 郭 金 钟 钱 阎 陆 陈 雷 韩 顾 马 高 魏 黄 黎 龚 实验效果姓氏过滤前,各命名实体识别准确率nr 33%ns 83%nt 43%姓氏过滤后,各命名实体识别准确率nr 36%ns 83%nt 81%这里没有开层叠隐马预测机构名和地名,nt上升原因估计是由于很多不是人名的词语没被标为人名,那么nt的模式匹配规则匹配不上了,所以机构名准确率上来了。错误识别的人名,100个常用姓氏的不多,很多恐怕是HanLP里其他词表干预进来的。隐马一般用于分词和词性标注是比较好的,为什么通常的序列标注方法也就是BIEO方法直接用到实体识别不合适呢。用词性标注为例,每一个词它所对应的词性标记子集是有限的,而这个子集相对于词性标记全集来说是小的。但是到了实体识别则不一定,拿人名来说,除了姓氏以外,名字词语部分可以填充的词语是任意的,也就是说任何词语都有可能出现在中间位置,此时发射矩阵中的某些词实际上就没有太大意义了,因为它可能等可能的由BIEO标记发出,而如果指利用四种标记之间的转移概率信息来确定最优的标记序列势必就影响效果。因此,我们通过引入角色标记,实际上这就引入了先验知识,比如某些字只能由姓氏标记产生,某些字一般情况都充当名字首字,某些字一般情况都充当名字末字,通过给这些不同情况下的字集按照其出现的位置的分布和其语法意义做角色定义,可以缩小每种角色标记可发出的词语集合,也就是每种词语(字)所对应的标记集的大小,相当于使发射概率分布不是均匀分布,那么预测的准确性肯定就得到提高了。下边介绍一下HanLP人名识别的主要流程1.使用使用匹配法求出各种分词路径用变量wordNetAll存储2.用viterbi方法找到一条最优的分词路径,这里主要使用用户自定义词典以及核心词典,用序列变量vertexList存储。3.角色观察,也就是根据发射概率矩阵列出vertexList中每个词语可能对应的角色标记。roleObserve(...)方法实现。4.角色标注,利用viterbi方法求出最优角色标记序列。viterbiComputeSimply(...)方法实现。5.对角色序列进行模式匹配得到人名。模式匹配定义在NRPattern类中。 在精度要求比较高且时间紧的情况下,最好的提高准确率的方法为,只保留常用姓氏,只保留最可能的2gram角色标记模式。在做人名识别时还有一个注意的点,如果你的预测语料和训练语料完全在文体上差别很大,或者说你就是在公开的训练语料上训练而不在预测语料上训练的话,基本上上下文信息是没有用处的,甚至有可能上下文信息会给实体边界标注带来干扰,我想任何机器学习包括深度学习,不管是文本分类领域还是实体识别领域都会有这种泛化能力的问题,这种问题恐怕通过算法是没法解决的,如果可以解决那么任何语种任何领域都可以使用一种模型,一劳永逸了。

优秀的个人博客,低调大师

2018年,自然语言处理最全的应用与合作

2018年见证了 NLP 许多新的应用发展。Elvis Saravia 是计算语言学专家,也是2019 计算语言学会年度大会北美分部的项目委员之一。他在一份报告中总结出,NLP 不仅在聊天机器人和机器学习中有所突破,也在医疗健康、金融、法律和广告等行业中有崭新的表现。点击文章中的链接,可查看详细信息。 聊天机器人聊天机器人是一项非常重要的研究领域,因为包括了 NLP 所覆盖的几大目标。 这篇 Wired 文章,解释语音情感识别如何帮助机器与人类建立更加健康的关系。 梅赛德斯奔驰发布了聊天机器人 MBUX,据称能为顾客创造“最会聊天的汽车”,让人与汽车可以通过自然的对话进行聊天。 NLP 创业公司 Hugging Face 获得400万美元融资,打造情感智能聊天机器人。 Wired 还发布了一篇文章讨论 Facebook 的虚拟助理 M ,以及为何公司计划将其关闭。此前就有许多人认为,也许聊天机器人只是一个泡沫,因为目前的 NLP 和 AI 的技术水准还无法达到顾客的预期。 这篇文章讨论 Passage AI 如何使用 NLP 和深度学习技术来训练顶尖的聊天机器人,用英语、西班牙语和中文进行聊天。 谷歌研究人员开发了一系列技术,深化聊天中的语意文本相似度。 Mastercard 称,聊天银行也许已经成为主流。 艾伦 AI 研究院通过 Alexandria 项目开发具有常识的AI。 AskArvi 使用 NLP 和深度学习,理解顾客的需要,从而推荐合适的保险项目。 亚马逊的新技术和 API 将提供能够离线使用的机器学习工具。 Facebook 提交了一个电商聊天机器人的专利申请,以 NLP 为其核心技术。 谷歌发布 Google Duplex,用于进行自然聊天,通过电话实现“真实世界”任务。这项技术在谷歌2018 IO 大会发布。 医疗健康 Jessica Kent 探讨如何将 NLP 应用于电子医疗记录,精确分析并改善心脏衰竭的病人护理。 Anthem 与 doc.ai 合作,分析和预测病人的过敏模式。 MIT 研究人员打造了一个基于 AI 的众筹平台,打造一个可以分析药物与蛋白质的系统。 据一份新报告称,NLP 和 AI 将把医疗从线下服务,改变为不受医生地理位置限制的高质量服务。 DeepMind 称其开发了一项新技术,能自动探测和治疗视网膜疾病。 一种基于 NLP 的新文本挖掘技术,可以通过病人的生物标记来决定癌症治疗方案。 创业公司 Proven Beauty 使用 NLP 为顾客提供个人化的护肤产品线。 看 NLP 如何帮助改善医疗文档。 BrightSign 是一款智能手套,使得具有语言残疾的人能够更好地沟通。 一家医疗机构使用深度学习和计算机视觉技术在 CT 扫描中检测疾病,比人类肿瘤学家的速度快150倍。 看谷歌如何通过技术,提升人们的健康水平。 自动化心理治疗机器人 Woebot 获得A轮800万美元融资。 Stitch CEO 讨论如何通过数据来销售个人化时尚。 Linguamatics 提供基于文字药物发现和研究的工具库。 机器学习工具 谷歌发布 Cloud AutoML,目标是为大企业提供云端 AI 服务,这是谷歌普及 AI 使命的一部分。 谷歌 AI 发布 BigQuery ML,能让数据科学家在大规模结构化和半结构化数据库上使用机器学习模型。 Fast.ai 与 AWS Open Datasets 合作,标准化并发布开放数据库。 Facebook 通过多语言嵌入,提供更快速的翻译服务。 PyTorch Geometric 通过 PyTorch 进行几何深度学习。 简单的几项测试看出,最优秀的谷歌翻译也很肤浅。 Linguistics Agents Ltd. 发布了一个 NLP 平台,训练深度增强学习代理。 这里有一个简化电子游戏代码编写的 AI 工具。 谷歌 Brain 发布 Magenta.js,一个利用 TensorFlow.js 生成音乐和艺术内容的API。 谷歌发布谷歌文字语音转换,其基础是 DeepMind 开发的 WaveNet。 TensorFlow 1.9 和 TensorFlow 1.10.0 相继发布,TensorFlow 2.0 将于2019年初发布,在这个论坛可以看到新版本的预期特征。 PyTorch 主持了第一场开发者大会,讨论最新发布的 PyTorch 1.0 的研究和生产能力。 Intel 开源了名为 NLP Architect 的 Python 库。 Semantris 是一款基于 NLP 和机器学习的文字联想游戏。 金融、广告和法律 澳大利亚证券与投资委员会(ASIC)希望利用 NLP 加强管理公司和金融服务法律。 Tumi 使用 AI 和 NLP 进行目标营销。 华尔街和大型创业公司现在都下血本投资 NLP 和机器学习,用于为客户进行更好的投资,类似于一种自动化投资管理。 小型和大型律师事务所正在通过 AI 一决高下。 金融行业在使用机器学习和 NLP 来重新定义服务,开发新市场。 通过“数据转移项目”,谷歌希望实现数据移动化,包括给予用户完全的数据掌控。 更多的NLP故事 据称,DARPA 将在 AI Next Initiative 投资高达20亿美元,实现语境推理和问题解决能力。 著名教授及研究员 Pedro Domingos 计划成为纽约投资公司 D.E. Shaw 集团的管理总监,领导公司的机器学习工作。 微软最新的专利目标通过 NLP 将来电 ID 功能提升一个水准,系统将能够识别来电者的目标和行动。 使用 AI 改善呼叫中心服务的创业公司 Observe.ai 筹集800万美元资金,使用机器学习和 NLP 技术将呼叫中心体验自动化。 本文由阿里云云栖社区组织翻译。文章原标题《NLP highlights of 2018》,译者:炫,审校:袁虎。文章简译,更为详细的内容,请查看原文。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册