首页 文章 精选 留言 我的

精选列表

搜索[自然语言],共4357篇文章
优秀的个人博客,低调大师

自然语言处理hanlp的入门基础

此文整理的基础是建立在hanlp较早版本的基础上的,虽然hanlp的最新1.7版本已经发布,但对于入门来说差别不大!分享一篇比较早的“旧文”给需要的朋友! 安装HanLP HanLP将数据与程序分离,给予用户自定义的自由。 HanLP由三部分组成:HanLP = .jar + data + .properties ,请前往 项目主页 下载这三个部分。 1、下载jar 放入classpath并添加依赖。 2、下载数据集 HanLP 中的数据分为 词典 和 模型 ,其中 词典 是词法分析必需的, 模型 是句法分析必需的,data目录结构如下: data │ ├─dictionary └─model 用户可以自行增删替换,如果不需要句法分析功能的话,随时可以删除model文件夹。 可选数据集 3、配置文件 示例配置文件: #本配置文件中的路径的根目录,根目录+其他路径=绝对路径 #Windows用户请注意,路径分隔符统一使用/ root=E:/JavaProjects/HanLP/ #核心词典路径 CoreDictionaryPath=data/dictionary/CoreNatureDictionary.txt #2元语法词典路径 BiGramDictionaryPath=data/dictionary/CoreNatureDictionary.ngram.txt #停用词词典路径 CoreStopWordDictionaryPath=data/dictionary/stopwords.txt #同义词词典路径 CoreSynonymDictionaryDictionaryPath=data/dictionary/synonym/CoreSynonym.txt #人名词典路径 PersonDictionaryPath=data/dictionary/person/nr.txt #人名词典转移矩阵路径 PersonDictionaryTrPath=data/dictionary/person/nr.tr.txt #繁简词典路径 TraditionalChineseDictionaryPath=data/dictionary/tc/TraditionalChinese.txt #自定义词典路径,用;隔开多个自定义词典,空格开头表示在同一个目录,使用“文件名 词性”形式则表示这个词典的词性默认是该词性。优先级递减。 #另外data/dictionary/custom/CustomDictionary.txt是个高质量的词库,请不要删除 CustomDictionaryPath=data/dictionary/custom/CustomDictionary.txt; 现代汉语补充词库.txt; 全国地名大全.txt ns; 人名词典.txt; 机构名词典.txt; 上海地名.txt ns;data/dictionary/person/nrf.txt nrf 配置文件的作用是告诉HanLP数据包的位置,只需修改第一行 root=usr/home/HanLP/ 为data的 父目录 即可,比如data目录是 /Users/hankcs/Documents/data ,那么 root=/Users/hankcs/Documents/ 。 l 如果选用mini数据包的话,则需要修改配置文件: CoreDictionaryPath=data/dictionary/CoreNatureDictionary.mini.txt BiGramDictionaryPath=data/dictionary/CoreNatureDictionary.ngram.mini.txt 最后将HanLP.properties放入classpath即可: 对于Eclipse来讲 project/bin 对于IntelliJ IDEA来讲 project/target/classes 或者 project/out/production/project Web项目的话可以放在如下位置: Webapp/WEB-INF/lib Webapp/WEB-INF/classes Appserver/lib JRE/lib 快速上手 HanLP 几乎所有的功能都可以通过工具类 HanLP 快捷调用,当你想不起来调用方法时,只需键入 HanLP. ,IDE应当会给出提示,并展示HanLP完善的文档。 推荐用户始终通过工具类 HanLP 调用,这么做的好处是,将来 HanLP 升级后,用户无需修改调用代码。 所有Demo都位于 com.hankcs.demo 下。 第一个Demo: System.out.println(HanLP.segment("你好,欢迎使用HanLP!")); l 内存要求 1.HanLP 对词典的数据结构进行了长期的优化,可以应对绝大多数场景。哪怕 HanLP 的词典上百兆也无需担心,因为在内存中被精心压缩过。 2.如果内存非常有限,请使用小词典。 HanLP 默认使用大词典,同时提供小词典,请参考配置文件章节。 3.在一些句法分析场景中,需要加载几百兆的模型。如果发生 java.lang.OutOfMemoryError ,则建议使用JVM option -Xms1g -Xmx1g -Xmn512m。 l 写给正在编译 HanLP 的开发者 1.如果你正在编译运行从Github检出的 HanLP 代码,并且没有下载data,那么首次加载词典/模型会发生一个 自动缓存 的过程。 2.自动缓存 的目的是为了加速词典载入速度,在下次载入时,缓存的词典文件会带来毫秒级的加载速度。由于词典体积很大, 自动缓存 会耗费一些时间,请耐心等待。 3.自动缓存 缓存的不是明文词典,而是双数组Trie树、DAWG、AhoCorasickDoubleArrayTrie等数据结构。 如果一切正常,您会得到类似于如下的输出: [你好/vl, ,/w, 欢迎/v, 使用/v, HanLP/nx, !/w] 如果出现了问题,一般是由路径配置不对而引发的,请根据控制台输出的警告调整。比如: 核心词典 /Users/hankcs/JavaProjects/HanLP/data/data/dictionary/CoreNatureDictionary.txt加载失败 说明HanLP.properties中的root项配置不对,应当去掉后缀 data/,改为: root=/Users/hankcs/JavaProjects/HanLP/

优秀的个人博客,低调大师

自然语言处理多任务学习目标

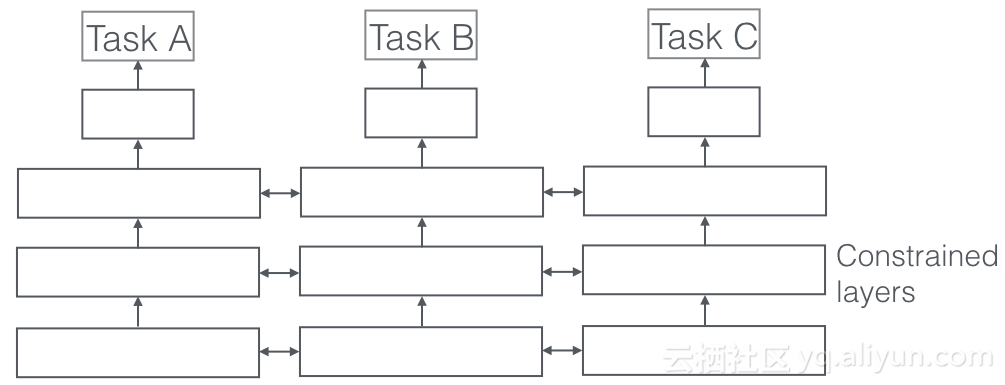
更多深度文章,请关注云计算频道:https://yq.aliyun.com/cloud 在之前的博文中,我讨论了如何利用相关任务提高多任务学习(MTL)模型的性能。在此之前,我们需要了解一下到底什么是多任务学习。 多任务学习是和单任务学习相对的一种机器学习方法。在机器学习领域,标准的算法理论是一次学习一个任务,而多任务学习是一种联合学习,多个任务并行学习,结果相互影响。简单来说,就是同时求解多个问题。例如我们经常探讨的“千人千面”这种个性化问题,就是一种典型的多任务学习问题,它可以同时学习多个用户的兴趣偏好。 多任务学习(MTL)主要是由两个部分组成:a)用于任务学习的架构、b)训练相关的辅助任务。而且这两个方面仍有很大的改进空间。此外,多任务学习有可能成为从有限数据中训练更强大的模型的关键技术:训练得到的模型可以执行更广泛的NLP任

优秀的个人博客,低调大师

如何编译运行HanLP自然语言处理包

master分支 对于master分支,编译方法如下: git clone https://github.com/hankcs/HanLP.git mvn install -DskipTests ·由于目前一些test不够规范,使用了硬编码路径下的资源,所以暂时跳过单元测试。 ·该方法不会将src/main/resources目录下的任何资源(包括hanlp.properties)打包进jar,如果需要打包资源文件,请切换到portable分支。 portable分支 git checkout portable 然后将需要的data放入src/main/resources,最后执行: mvn install -DskipTests 运行jar 目前jar包中有一些模块可以命令行执行,以感知机词法分析器为例。由于这些模块一般需要加载外部data,所以需要在运行时指定hanlp.properties。运行时,一个典型的目录结构如下: ·此处只列出了重要的目录。 ·一个良好的实践是把hanlp.properties放到resources目录下。 命令行需要指定jar包和hanlp.properties所在的目录: $ java -cp target/hanlp-1.6.0.jar:src/main/resources com.hankcs.hanlp.model.perceptron.Main -test \ <<< '华安集团胡花蕊来到纽约艺术博物馆参观' [华安/nz 集团/n]/nt 胡花蕊/nr 来到/v [纽约/ns 艺术/n 博物馆/n]/ns 参观/v ·Windows用户请使用分号java -cp target/hanlp-1.6.0.jar;src/main/resources

优秀的个人博客,低调大师

Pyhanlp自然语言处理中的新词识别

新词发现 本“新词发现”模块基于信息熵和互信息两种算法,可以在无语料的情况下提取一段长文本中的词语,并支持过滤掉系统中已存在的“旧词”,得到新词列表。 调用方法 静态方法 一句话静态调用接口已经封装到HanLP中: /** * 提取词语 * * @param text 大文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size) /** * 提取词语 * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size) throws IOException /** * 提取词语(新词发现) * * @param text 大文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size, boolean newWordsOnly) /** * 提取词语(新词发现) * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size, boolean newWordsOnly) throws IOException 调用示例请参考com.hankcs.demo.DemoNewWordDiscover。 值得注意的是,在计算资源允许的情况下,文本越长,结果质量越高。对于一些零散的文章,应当合并为整个大文件传入该算法。 高级参数 根据语料的长度或用词的不同,默认的参数有可能不能得到最佳的结果。我们可以通过构造不同的NewWordDiscover调整提取算法。该构造函数如下: /** * 构造一个新词识别工具 * @param max_word_len 词语最长长度 * @param min_freq 词语最低频率 * @param min_entropy 词语最低熵 * @param min_aggregation 词语最低互信息 * @param filter 是否过滤掉HanLP中的词库中已存在的词语 */ public NewWordDiscover(int max_word_len, float min_freq, float min_entropy, float min_aggregation, boolean filter) 其中: · max_word_len控制识别结果中最长的词语长度,默认值是4;该值越大,运算量越大,结果中出现短语的数量也会越多。 · min_freq控制结果中词语的最低频率,低于该频率的将会被过滤掉,减少一些运算量。由于结果是按照频率排序的,所以该参数其实意义不大。 · min_entropy控制结果中词语的最低信息熵的值,一般取0.5左右。该值越大,越短的词语就越容易被提取出来。 · min_aggregation控制结果中词语的最低互信息值,一般取50到200.该值越大,越长的词语就越容易被提取出来,有时候会出现一些短语。 · filter设为true的时候将使用内部词库过滤掉“旧词”。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册