首页 文章 精选 留言 我的

精选列表

搜索[笔记软件],共10010篇文章
优秀的个人博客,低调大师

Spark SQL 笔记

官方参考文档: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#creating-dataframes DataFrame A DataFrame is a Dataset organized into named columns. It is conceptually equivalent to a table in a relational database or a data frame in R/Python, but with richer optimizations under the hood. DataFrames can be constructed from a wide array of sources such as: structured data files, tables in Hive, external databases, or existing RDDs. The DataFrame API is available in Scala, Java, Python, and R. 对于熟悉python的同学,Spark的DataFrame和python的DF很像。对于structured data files同学比较熟知的有xml、jason、parquet等。 关于parquet,请参考: http://blog.csdn.net/yu616568/article/details/50993491 具体的df的操作请参考官网: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#creating-dataframes python操作演示: >>> df = sqlContext.read.json("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.json") >>> df.show() +----+-------+ | age| name| +----+-------+ |null|Michael| | 30| Andy| | 19| Justin| +----+-------+ >>> df.printSchema() root |-- age: long (nullable = true) |-- name: string (nullable = true) >>> df.select("name").show() +-------+ | name| +-------+ |Michael| | Andy| | Justin| +-------+ >>> df.select(df['name'], df['age'] + 1).show() +-------+---------+ | name|(age + 1)| +-------+---------+ |Michael| null| | Andy| 31| | Justin| 20| +-------+---------+ >>> df.filter(df['age'] > 21).show() +---+----+ |age|name| +---+----+ | 30|Andy| +---+----+ scala在eclipse中的实现 import org.apache.spark.SparkConf import org.apache.spark.SparkContext import org.apache.spark.sql.SQLContext object DataFrameOperation { def main(args: Array[String]): Unit = { //create datarame //首先创建程序入口 val conf=new SparkConf().setAppName("DataFrameOperation") val sc=new SparkContext(conf); //create sqlcontext val sqlContext=new SQLContext(sc); val df=sqlContext.read.json("hdfs://hadoop1:9000/examples/src/main/resources/people.json") df.show(); //print schema df.printSchema() //name age df.select("name").show(); // df.select(df("name"),df("age")+1).show() //where df.filter(df("age") > 21).show() //groupby df.groupBy("age").count().show(); } } 关于代码的提交: 将上面的代码的代码文件(文件 即可不用导出工程) export成jar 提交请参考 Run on a YARN cluster 在上一篇的spark教程里 Interoperating with RDDs(和RDD交互) Spark SQL supports two different methods for converting existing RDDs into DataFrames. The first method uses reflection to infer the schema of an RDD that contains specific types of objects. This reflection based approach leads to more concise code and works well when you already know the schema while writing your Spark application. The second method for creating DataFrames is through a programmatic interface that allows you to construct a schema and then apply it to an existing RDD. While this method is more verbose, it allows you to construct DataFrames when the columns and their types are not known until runtime. 通过reflection的方式将RDD转换成dataframe 注意:RDD是读取非结构化数据 java版本 import org.apache.spark.SparkConf; import org.apache.spark.api.java.JavaRDD; import org.apache.spark.api.java.JavaSparkContext; import org.apache.spark.api.java.function.Function; import org.apache.spark.api.java.function.VoidFunction; import org.apache.spark.sql.DataFrame; import org.apache.spark.sql.Row; import org.apache.spark.sql.SQLContext; public class RDD2DataFrameReflection { public static void main(String[] args) { SparkConf conf = new SparkConf(); conf.setAppName("RDD2DataFrameReflection"); JavaSparkContext sc = new JavaSparkContext(conf); SQLContext sqlContext = new SQLContext(sc); //生成一个RDD JavaRDD<Person> PersonRDD = sc.textFile("hdfs://hadoop1:9000/examples/src/main/resources/people.txt") .map(new Function<String, Person>() { public Person call(String line) throws Exception { String[] strs = line.split(","); String name=strs[0]; int age=Integer.parseInt(strs[1].trim()); Person person=new Person(age,name); return person; } }); //生成一个df DataFrame personDF = sqlContext.createDataFrame(PersonRDD, Person.class); //将df注册成临时表,之后就可以像操作表一样 personDF.registerTempTable("person"); DataFrame resultperson = sqlContext.sql("select name,age from person where age > 13 and age <= 19"); //当想使用RDD的算子是,将df转换为RDD就可以使用类似foreach的操作了 resultperson.javaRDD().foreach(new VoidFunction<Row>() { /** * */ private static final long serialVersionUID = 1L; public void call(Row row) throws Exception { //把每一条数据都看成是一个row row(0)=name row(1)=age System.out.println("name"+row.getString(0)); System.out.println("age"+row.getInt(1)); } }); resultperson.javaRDD().saveAsTextFile("hdfs://hadoop1:9000/reflectionresult"); } } python版本(reflection.py): # sc is an existing SparkContext. from pyspark import SparkContext, SparkConf from pyspark.sql import SQLContext, Row appName= "reflection" master = "local" conf1 = SparkConf().setAppName(appName).setMaster(master) sc = SparkContext(conf=conf1) sqlContext = SQLContext(sc) # Load a text file and convert each line to a Row. lines = sc.textFile("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.txt") parts = lines.map(lambda l: l.split(",")) people = parts.map(lambda p: Row(name=p[0], age=int(p[1]))) # Infer the schema, and register the DataFrame as a table. schemaPeople = sqlContext.createDataFrame(people) schemaPeople.registerTempTable("people") # SQL can be run over DataFrames that have been registered as a table. teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19") # The results of SQL queries are RDDs and support all the normal RDD operations. teenNames = teenagers.map(lambda p: "Name: " + p.name) for teenName in teenNames.collect(): print(teenName) 代码提交时,使用spark-submit reflection.py 用编程(programmatically)的方式将RDD转换成DF >>> lines = sc.textFile("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.txt") >>> parts = lines.map(lambda l: l.split(",")) >>> people = parts.map(lambda p: (p[0], p[1].strip())) >>> parts.collect() [[u'Michael', u' 29'], [u'Andy', u' 30'], [u'Justin', u' 19']] >>> people.collect() [(u'Michael', u'29'), (u'Andy', u'30'), (u'Justin', u'19')] >>> schemaString = "name age" >>> fields = [StructField(field_name, StringType(), True) for field_name in schemaString.split()] Traceback (most recent call last): File "<stdin>", line 1, in <module> NameError: name 'StructField' is not defined >>> from pyspark.sql.types import * >>> fields = [StructField(field_name, StringType(), True) for field_name in schemaString.split()] >>> fields.collect() Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'list' object has no attribute 'collect' >>> schema = StructType(fields) >>> schemaPeople = sqlContext.createDataFrame(people, schema) >>> schemaPeople.registerTempTable("people") >>> results = sqlContext.sql("SELECT name FROM people") >>> results.collect() [Row(name=u'Michael'), Row(name=u'Andy'), Row(name=u'Justin')] >>> names = results.map(lambda p: "Name: " + p.name) >>> names.collect() [u'Name: Michael', u'Name: Andy', u'Name: Justin'] >>> for name in names.collect(): ... print(name) ... Name: Michael Name: Andy Name: Justin >>> 不懂StructField和StructType的还请参考 http://spark.apache.org/docs/1.5.2/api/python/pyspark.sql.html?highlight=structfield#pyspark.sql.types.StructField DataFrame VS RDD 当生成DF的时候会返回schema类型(类似于postgresql的表结构),而RDD不会,仅仅返回的是一个Person,不知道里面具体的数据类型 数据的load以及save 参考: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#data-sources spark sql默认支持的是parquet文件格式,所以不制定load、save类型,默认都是parquet。关于parquet 参考 http://www.infoq.com/cn/articles/in-depth-analysis-of-parquet-column-storage-format Parquet是语言无关的,而且不与任何一种数据处理框架绑定在一起,适配多种语言和组件,能够与Parquet配合的组件有: 查询引擎: Hive, Impala, Pig, Presto, Drill, Tajo, HAWQ, IBM Big SQL 计算框架: MapReduce, Spark, Cascading, Crunch, Scalding, Kite 数据模型: Avro, Thrift, Protocol Buffers, POJOs 保存时是追加还是覆盖,请参考SaveModes parquet 文件操作 通用文件操作: df1 = sqlContext.read.load("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/users.parquet") >>> df1.show() +------+--------------+----------------+ | name|favorite_color|favorite_numbers| +------+--------------+----------------+ |Alyssa| null| [3, 9, 15, 20]| | Ben| red| []| +------+--------------+----------------+ df1.select("name", "favorite_color").show() +------+--------------+ | name|favorite_color| +------+--------------+ |Alyssa| null| | Ben| red| +------+--------------+ df1.select("name", "favorite_color").write.save("file:///home/zkpk/ecaoyng/input/namesAndFavColors.parquet") 自动推断分区(Partition Discovery) 看完下面的例子就知道什么是自动推断分区了 #在hdfs上新建一个目录country=US hadoop fs -mkdir -p /ecaoyng/country=US #将parquet文件上传到新建的目录 hadoop fs -put users.parquet /ecaoyng/country=US #之前读到的df1的内容 >>> df1.show() +------+--------------+----------------+ | name|favorite_color|favorite_numbers| +------+--------------+----------------+ |Alyssa| null| [3, 9, 15, 20]| | Ben| red| []| +------+--------------+----------------+ #在新建目录之后读取到的parquet文件,可以看出多了country这一列 >>> df2= sqlContext.read.parquet("hdfs:///ecaoyng/country=US/users.parquet") >>> df2.show() +------+--------------+----------------+-------+ | name|favorite_color|favorite_numbers|country| +------+--------------+----------------+-------+ |Alyssa| null| [3, 9, 15, 20]| US| | Ben| red| []| US| +------+--------------+----------------+-------+ schema的合并 >>> df3 = sqlContext.createDataFrame(sc.parallelize(range(1, 6)).map(lambda i : Row(single=i, double=i*2)) ... ) >>> df3.write.parquet("hdfs:///ecaoyng/test_table/key=1") >>> df4=sqlContext.createDataFrame(sc.parallelize(range(6,11)).map(lambda i : Row(single=i, triple=i*3))) >>> df4.write.parquet("hdfs:///ecaoyng/test_table/key=2") >>> df5 = sqlContext.read.option("mergeSchema", "true").parquet("hdfs:///ecaoyng/test_table") >>> df5.printSchema() root |-- double: long (nullable = true) |-- single: long (nullable = true) |-- triple: long (nullable = true) |-- key: integer (nullable = true) >>> df5.show() +------+------+------+---+ |double|single|triple|key| +------+------+------+---+ | null| 6| 18| 2| | null| 7| 21| 2| | null| 8| 24| 2| | null| 9| 27| 2| | null| 10| 30| 2| | 2| 1| null| 1| | 4| 2| null| 1| | 6| 3| null| 1| | 8| 4| null| 1| | 10| 5| null| 1| +------+------+------+---+ >>> 数据源之JDBC之mysql 以mysql为例,首先启动mysql. 遇到错误信息如下 nother MySQL daemon already running with the same unix socket. Starting mysqld: [FAILED] 解决方案,重命名/var/lib/mysql/mysql.sock 即可,重新启动mysql 其他的请参考如下链接 https://www.cnblogs.com/wwxbi/p/6978774.html http://spark.apache.org/docs/1.6.0/sql-programming-guide.html#jdbc-to-other-databases 注意,如果没有驱动包会报错: java.sql.SQLException: No suitable driver at java.sql.DriverManager.getDriver(DriverManager.java:278) 解决方法是: 下载驱动包 在spark-env.sh中设置 export SPARK_CLASSPATH=$SPARK_CLASSPATH:/usr/local/soft/hive/lib/mysql-connector-java-5.1.10.jar 那么在提交jdbc的脚本的时候就不可以设置--driver-class-path路径 如果在spark-env.sh脚本里没有设置MySQL驱动包的spark_classpath 那么需要在提交任务的时候在脚本里天如下内容: --driver-class-path /usr/local/soft/hive/lib/mysql-connector-java-5.1.10.jar 数据源之Hive 在spark开发中spark开发占了很大一部分,而基于hive的开发,又占了其中很大的比重。下面我们就来进行hive和spark集成

优秀的个人博客,低调大师

Docker入门笔记

原文链接: http://yangbingdong.com/2017/docker-learning/ Preface 为什么选择Docker?网上已经给出了很多说法,总结而言就是,趋势(这不是废话吗) 哈哈,词穷 作为一种新兴的虚拟化方式,Docker跟传统的虚拟化方式相比具有众多的优势,这里也不详细列举了 Docker对于持续交付和部署的DevOps人员来说也有着重要的意义... 本篇主要记录Docker的基础学习(安装、简单使用) Concept 以下是Docker的三个基本概念。 Image(镜像) 官方而言,Docker 镜像是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数(如匿名卷、环境变量、用户等)。镜像不包含任何动态数据,其内容在构建之后也不会被改变。 对博主而言,它相当于就是个Java Class(类)=.= 但它的存储结构类似Git,一层一层地网上盖,删除一个文件并不会真的删除,只是在那个文件上面做了一个标记为已删除。在最终容器运行的时候,虽然不会看到这个文件,但是实际上该文件会一直跟随镜像。因此,在构建镜像的时候,需要额外小心,每一层尽量只包含该层需要添加的东西,任何额外的东西应该在该层构建结束前清理掉。 Container(容器) 通俗来说,如果镜像是类,那么容器就是这个类的实例了,镜像是静态的定义,容器是镜像运行时的实体。容器可以被创建、启动、停止、删除、暂停等。 容器也有其特性,例如存储,不指定数据卷(Volume)的话,容器消亡数据也就跟着没了... 跟多特性请自行百度~ Repository(仓库) 仓库没啥好说的了,以 Ubuntu 镜像 为例,ubuntu 是仓库的名字,其内包含有不同的版本标签,如,14.04, 16.04。我们可以通过 ubuntu:14.04,或者 ubuntu:16.04 来具体指定所需哪个版本的镜像。如果忽略了标签,比如 ubuntu,那将视为 ubuntu:latest Install 这里以Ubuntu为例(当然是因为博主用的是Ubuntu= =),版本的话Docker目前支持的Ubuntu版本最低为12.04LTS,但从稳定性上考虑,推荐使用14.04LTS或更高的版本。 使用脚本自动安装 在测试或开发环境中 Docker 官方为了简化安装流程,提供了一套便捷的安装脚本,Ubuntu 系统上可以使用这套脚本安装: curl -fsSL get.docker.com -o get-docker.sh sudo sh get-docker.sh --mirror Aliyun 执行这个命令后,脚本就会自动的将一切准备工作做好,并且把 Docker 安装在系统中 使用 APT 镜像源 安装 sudo apt-get update sudo apt-get install \ apt-transport-https \ ca-certificates \ curl \ software-properties-common 鉴于国内网络问题,强烈建议使用国内源 国内源 curl -fsSL https://mirrors.aliyun.com/docker-ce/linux/ubuntu/gpg | sudo apt-key add - sudo add-apt-repository \ "deb [arch=amd64] https://mirrors.aliyun.com/docker-ce/linux/ubuntu \ $(lsb_release -cs) \ stable" 以上命令会添加 稳定 版本的 Docker CE APT 镜像源,如果需要最新版本的 Docker CE 请将 stable 改为 edge 或者 test 。从 Docker 17.06 开始,edge test 版本的 APT 镜像源也会包含稳定版本的 Docker 官方源 curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add - sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_release -cs) \ stable" 安装 Docker CE sudo apt-get update sudo apt-get install docker-ce 启动 Docker CE sudo systemctl enable docker sudo systemctl start docker 建立 docker 用户组 默认情况下,docker 命令会使用 Unix socket 与 Docker 引擎通讯。而只有 root 用户和 docker 组的用户才可以访问 Docker 引擎的 Unix socket。出于安全考虑,一般 Linux 系统上不会直接使用 root 用户。因此,更好地做法是将需要使用 docker 的用户加入 docker 用户组。 建立 docker 组(貌似执行了自动安装脚本会自动建一个docker的用户组): sudo groupadd docker 将当前用户加入 docker 组: sudo usermod -aG docker $USER 加入docker 组之后要重启才能生效哦... Mirror Acceleration 没有代理的话国内访问Docker Hub的速度实在感人,但Docker官方和国内很多云服务商都提供了加速器服务: Docker 官方提供的中国registry mirror 阿里云加速器 DaoCloud 加速器 灵雀云加速器 如阿里,注册并申请后会得到加速域名如https://vioqnt8w.mirror.aliyuncs.com,然后正如官方说的一样,通过修改daemon配置文件/etc/docker/daemon.json来使用加速器: sudo mkdir -p /etc/docker sudo tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": ["https://vioqnt8w.mirror.aliyuncs.com"] } EOF sudo systemctl daemon-reload sudo systemctl restart docker 查看生效: sudo docker info|grep "Registry Mirrors" -A 1 输出如下: Registry Mirrors: https://vioqnt8w.mirror.aliyuncs.com/ Use Image 获取 Docker Hub 上有大量的高质量的镜像可以用,我们可以通过以下的方式获取镜像: docker pull [选项] [Docker Registry地址]<仓库名>:<标签> 选项可以通过docker pull --help查看。 eg,从Docker Hub下载REPOSITORY为java的所有镜像: docker pull -a java 列出 使用docker images [OPTIONS] [REPOSITORY[:TAG]]列出已下载的镜像 列表包含了仓库名、标签、镜像 ID、创建时间以及所占用的空间 OPTIONS说明: -a :列出本地所有的镜像(含中间映像层,默认情况下,过滤掉中间映像层); --digests :显示镜像的摘要信息; -f :显示满足条件的镜像; --format :指定返回值的模板文件; --no-trunc :显示完整的镜像信息; -q :只显示镜像ID。 eg: # 看到在 mongo:3.2 之后建立的镜像,想查看某个位置之前的镜像也可以,只需要把 since 换成 before 即可 docker images -f since=mongo:3.2 虚悬镜像(dangling image) 举个例子:原来为 mongo:3.2,随着官方镜像维护,发布了新版本后,重新 docker pull mongo:3.2 时,mongo:3.2 这个镜像名被转移到了新下载的镜像身上,而旧的镜像上的这个名称则被取消,从而成为了 <none>。除了 docker pull 可能导致这种情况,docker build 也同样可以导致这种现象。由于新旧镜像同名,旧镜像名称被取消,从而出现仓库名、标签均为 <none> 的镜像。这类无标签镜像也被称为 虚悬镜像(dangling image) ,可以用下面的命令专门显示这类镜像: docker images -f dangling=true 一般来说,虚悬镜像已经失去了存在的价值,是可以随意删除的,可以用下面的命令删除: docker rmi $(docker images -q -f dangling=true) Commit 从容器创建一个新的镜像: docker commit [OPTIONS] CONTAINER [REPOSITORY[:TAG]] OPTIONS说明: -a :提交的镜像作者; -c :使用Dockerfile指令来创建镜像; -m :提交时的说明文字; -p :在commit时,将容器暂停。 eg: docker commit -a "ybd" -m "my apache" a404c6c174a2 mymysql:v1 当我们修改了镜像文件提交时候,可以使用docker diff [OPTIONS] CONTAINER查看修改了什么东西。 一般地,不推荐使用commit来构建镜像,之前也提过,镜像是特殊的文件系统,改了东西之后原来的基础之上叠加,使之变得越来越臃肿。此外,使用 docker commit 意味着所有对镜像的操作都是黑箱操作,生成的镜像也被称为黑箱镜像,换句话说,就是除了制作镜像的人知道执行过什么命令、怎么生成的镜像,别人根本无从得知。一般我们会使用Dockerfile定制镜像。 删除 删除镜像可以使用: docker rmi [OPTIONS] IMAGE [IMAGE...] OPTIONS说明: -f :强制删除; --no-prune :不移除该镜像的过程镜像,默认移除; 一般会组合使用: docker rmi $(docker images -q -f dangling=true) docker rmi $(docker images -q redis) docker rmi $(docker images -q -f before=mongo:3.2) 查看元数据 docker inspect : 获取容器/镜像的元数据。 docker inspect [OPTIONS] CONTAINER|IMAGE [CONTAINER|IMAGE...] OPTIONS说明: -f :指定返回值的模板文件。 -s :显示总的文件大小。 --type :为指定类型返回JSON。 实例 获取镜像mysql:5.6的元信息。 ~: docker inspect mysql:5.6 [ { "Id": "sha256:2c0964ec182ae9a045f866bbc2553087f6e42bfc16074a74fb820af235f070ec", "RepoTags": [ "mysql:5.6" ], "RepoDigests": [], "Parent": "", "Comment": "", "Created": "2016-05-24T04:01:41.168371815Z", "Container": "e0924bc460ff97787f34610115e9363e6363b30b8efa406e28eb495ab199ca54", "ContainerConfig": { "Hostname": "b0cf605c7757", "Domainname": "", "User": "", "AttachStdin": false, "AttachStdout": false, "AttachStderr": false, "ExposedPorts": { "3306/tcp": {} }, ... 获取正在运行的容器mymysql的 IP。 ~: docker inspect -f '' mymysql 172.17.0.3 Operating Container 开启 docker run :创建一个新的容器并运行一个命令 docker create :创建一个新的容器但不启动它 docker run [OPTIONS] IMAGE [COMMAND] [ARG...] docker create [OPTIONS] IMAGE [COMMAND] [ARG...] docker run OPTIONS说明: -a stdin: 指定标准输入输出内容类型,可选 STDIN/STDOUT/STDERR 三项; -d: 后台运行容器,并返回容器ID; -i: 以交互模式运行容器,通常与 -t 同时使用; -t: 为容器重新分配一个伪输入终端,通常与 -i 同时使用; -v: 挂载数据卷 --name="nginx-lb": 为容器指定一个名称; --restart=always: docker启动容器也跟着启动 --dns 8.8.8.8: 指定容器使用的DNS服务器,默认和宿主一致; --dns-search example.com: 指定容器DNS搜索域名,默认和宿主一致; -h "mars": 指定容器的hostname; -e username="ritchie": 设置环境变量; --env-file=[]: 从指定文件读入环境变量; --cpuset="0-2" or --cpuset="0,1,2": 绑定容器到指定CPU运行; -m :设置容器使用内存最大值; --net="bridge": 指定容器的网络连接类型,支持 bridge/host/none/container: 四种类型; --link=[]: 添加链接到另一个容器; --expose=[]: 开放一个端口或一组端口; <b>实例</b> 例如,启动一个 bash 终端,允许用户进行交互: docker run -t -i ubuntu:14.04 /bin/bash 当利用 docker run 来创建容器时,Docker 在后台运行的标准操作包括: 检查本地是否存在指定的镜像,不存在就从公有仓库下载 利用镜像创建并启动一个容器 分配一个文件系统,并在只读的镜像层外面挂载一层可读写层 从宿主主机配置的网桥接口中桥接一个虚拟接口到容器中去 从地址池配置一个 ip 地址给容器 执行用户指定的应用程序 执行完毕后容器被终止 停止 docker stop :停止一个运行中的容器: docker stop [OPTIONS] CONTAINER [CONTAINER...] 进入容器 使用docker exec : docker exec [OPTIONS] CONTAINER COMMAND [ARG...] OPTIONS说明: -d :分离模式: 在后台运行 -i :即使没有附加也保持STDIN 打开 -t :分配一个伪终端 例如进入ubuntu容器交互式模式: docker exec -it ubuntu /bin/sh 导出和导入容器 导出容器快照 docker export [OPTIONS] CONTAINER 例如: docker export 7691a814370e > ubuntu.tar 导入容器快照 docker import [OPTIONS] file|URL|- [REPOSITORY[:TAG]] OPTIONS说明: -c :应用docker 指令创建镜像; -m :提交时的说明文字; 例如: docker import ubuntu.tar ybd/ubuntu:v1 删除 docker rm [OPTIONS] CONTAINER [CONTAINER...] OPTIONS说明: -f :通过SIGKILL信号强制删除一个运行中的容器 -l :移除容器间的网络连接,而非容器本身 -v :-v 删除与容器关联的卷 删除所有容器: docker rm $(docker ps -a -q) 但这并不会删除运行中的容器 列出容器 docker ps [OPTIONS] OPTIONS说明: -a :显示所有的容器,包括未运行的。 -f :根据条件过滤显示的内容。 --format :指定返回值的模板文件。 -l :显示最近创建的容器。 -n :列出最近创建的n个容器。 --no-trunc :不截断输出。 -q :静默模式,只显示容器编号。 -s :显示总的文件大小。 例如列出最近创建的5个容器信息: docker ps -n 5 列出所有创建的容器ID: docker ps -a -q Dev Env In Docker mysql: docker run -p 6033:3306 --name mysql-master --restart=always -v $PWD/conf/my.cnf:/etc/mysql/my.cnf -v $PWD/logs:/var/log/mysql -v $PWD/data:/var/lib/mysql -e MYSQL_ROOT_PASSWORD=123456 -idt mysql:5.7.19 redis: docker run -p 6380:6379 --name redis-master --restart=always -v /home/ybd/docker/redis:/data -v /etc/redis/redis.conf:/usr/local/etc/redis/redis.conf -d redis:4.0.1 redis-server --appendonly yes Last 参考:Docker — 从入门到实践Docker命令大全

优秀的个人博客,低调大师

MessagePack 学习笔记

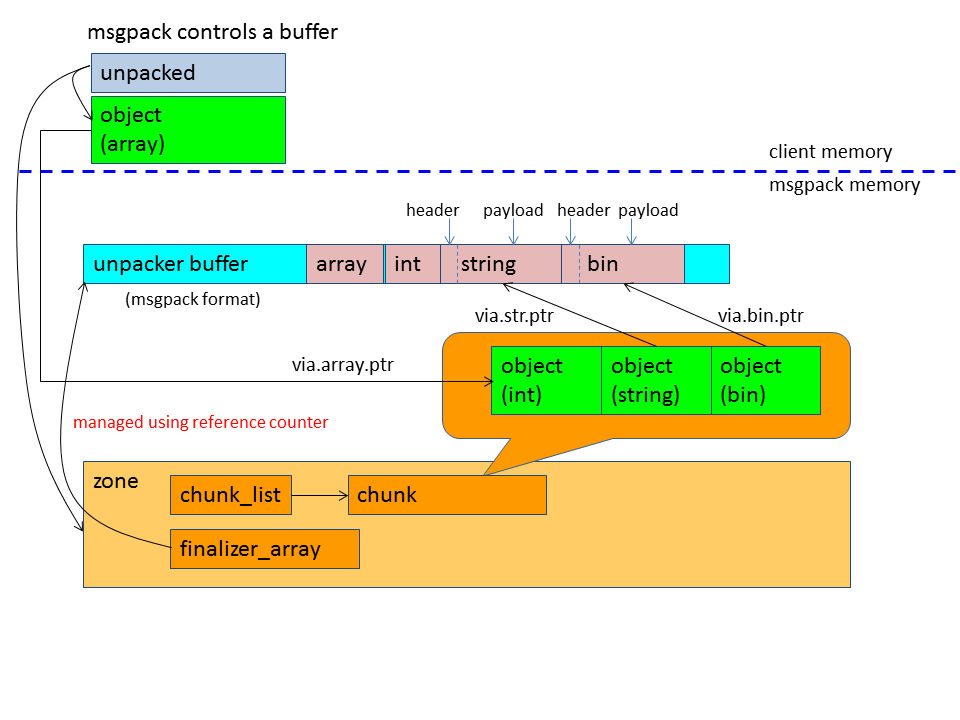
封装和解析类似json的 key-value 示例 {"ID" = 333,"name"="zds","3333"="ende"} msgpack::sbuffer sBuf; msgpack::packer<msgpack::sbuffer> pker(&sBuf); pker.pack_map(3); pker.pack(std::string("ID")); pker.pack(333); pker.pack(std::string("name")); pker.pack(std::string("zds")); pker.pack(std::string("333")); pker.pack(std::string("ende")); //unserilized msgpack::unpacked unpack; msgpack::unpack(unpack, sBuf.data(), sBuf.size()); msgpack::object obj = unpack.get(); std::cout << obj << std::endl; if (obj.type == msgpack::type::ARRAY) std::cout << "是array" << std::endl; else if (obj.type == msgpack::type::MAP) std::cout << "是map" << std::endl; if(obj.via.map.size > 0) { auto pkv = obj.via.map.ptr; auto pkv_end = obj.via.map.ptr + obj.via.map.size; do { auto key = pkv->key; auto val = pkv->val; std::cout << "key:" << key << " value:" << val << std::endl; ++pkv; } while (pkv < pkv_end); } 解析Socket示例 各类数据结构: msgpack::object 他是一个引用,拷贝他的代价少,因为他是浅拷贝msgpack::object_handle 他管理了一个对象的生命周期。他如果释放了,所有从他生成的object都是无效的引用 解析Socket示例 下列代码解析socke收包数据 unpacker.reserve_buffer 分配要收的数据的内存字节数unpacker..buffer() 返回数据地址unpacker.buffer_consumed() 设置实际收到的数据unpacker.next(object_handle& oh) 循环解析数据 int main() { boost::asio::io_service ios; std::uint16_t const port = 12345; // Server std::size_t const window_size = 10; boost::asio::ip::tcp::acceptor ac(ios, boost::asio::ip::tcp::endpoint(boost::asio::ip::tcp::v4(), port)); boost::asio::ip::tcp::socket ss(ios); std::function<void()> do_accept; std::function<void()> do_async_read_some; msgpack::unpacker unp; do_accept = [&] { ac.async_accept( ss, [&] (boost::system::error_code const& e) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } unp.reserve_buffer(window_size); do_async_read_some = [&] { ss.async_read_some( boost::asio::buffer(unp.buffer(), window_size), [&](boost::system::error_code const& e, std::size_t bytes_transferred) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } std::cout << bytes_transferred << " bytes read." << std::endl; unp.buffer_consumed(bytes_transferred); msgpack::object_handle oh; while (unp.next(oh)) { std::cout << oh.get() << std::endl; // In order to finish the program, // return if one complete msgpack is processed. // In actual server, don't return here. return; } do_async_read_some(); } ); }; do_async_read_some(); } ); }; do_accept(); // Client auto host = "localhost"; boost::asio::ip::tcp::resolver r(ios); boost::asio::ip::tcp::resolver::query q(host, boost::lexical_cast<std::string>(port)); auto it = r.resolve(q); boost::asio::ip::tcp::socket cs(ios); boost::asio::async_connect( cs, it, [&] (boost::system::error_code const& e, boost::asio::ip::tcp::resolver::iterator) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } std::cout << __LINE__ << ":client connected" << std::endl; msgpack::sbuffer sb; msgpack::pack(sb, std::make_tuple(42, false, "hello world", 12.3456)); write(cs, boost::asio::buffer(sb.data(), sb.size())); } ); // Start ios.run(); } 详解: msgpack controls a buffer msgpack provides a buffer management functionality named msgpack::unpacker. msgpack::unpacker is sutable for the following motivations: msgpack data is chopped, and the client doesn't know when it will complete. This is a typical situation when you develop streaming applications. You want to minimize copy opperations without careful memory management. Here is the basic (not all) interface of msgpack::unpacker: #ifndef MSGPACK_UNPACKER_INIT_BUFFER_SIZE #define MSGPACK_UNPACKER_INIT_BUFFER_SIZE (64*1024) #endif #ifndef MSGPACK_UNPACKER_RESERVE_SIZE #define MSGPACK_UNPACKER_RESERVE_SIZE (32*1024) #endif class unpacker { public: unpacker(unpack_reference_func f = &unpacker::default_reference_func, void* user_data = nullptr, std::size_t init_buffer_size = MSGPACK_UNPACKER_INIT_BUFFER_SIZE, unpack_limit const& limit = unpack_limit()); void reserve_buffer(std::size_t size = MSGPACK_UNPACKER_RESERVE_SIZE); char* buffer(); void buffer_consumed(std::size_t size); bool next(unpacked& result); }; Here is a basic pattern using msgpack::unpacker: // The size may decided by receive performance, transmit layer's protocol and so on. std::size_t const try_read_size = 100; msgpack::unpacker unp; // Message receive loop while (/* block until input becomes readable */) { unp.reserve_buffer(try_read_size); // unp has at least try_read_size buffer on this point. // input is a kind of I/O library object. // read message to msgpack::unpacker's internal buffer directly. std::size_t actual_read_size = input.readsome(unp.buffer(), try_read_size); // tell msgpack::unpacker actual consumed size. unp.buffer_consumed(actual_read_size); msgpack::unpacked result; // Message pack data loop while(unp.next(result)) { msgpack::object obj(result.get()); // Use obj } // All complete msgpack message is proccessed at this point, // then continue to read addtional message. } msgpack::unpacker::next() returns true if one complete msgpack messege is proccessed. If msgpack message is correct but insufficient, it returns false. However, parsing proccess is proceeded and the context information is preserved in the msgpack::unpacker. It helps leveling the load of parse. When msgpack message contains binary data, string data, or ext data, they are not copied but referenced from msgpack::object by default. See the following implementation: inline bool unpacker::default_reference_func(type::object_type type, uint64_t len, void*) { return true; } You can also customize unpack_reference_func. Even if you use references, you don't need to control buffer's lifetime. The buffers' lifetime is controled by msgpack using msgpack::zone's finalizer_array and msgpack::unpacker's reference counting mechanism. So, in most cases, the default behavior is enough. If you want to control the peak of memory consumption when receiving msgpack data patterns are predictable, customizing unpack_reference_func might be useful. You can get a reference information from msgpack::unpacker::next() using the following function: bool next(unpacked& result, bool& referenced); However, mostly you don't need to use that version of next() because referenced memories are managed by unpacker.

优秀的个人博客,低调大师

YARN 笔记(一)

YARN是Yet Another Resource Negotiator的简称,它仍可认为采用了master/slave结构,总体上采用了双层调度架构,它主要以下几部分组成: ResourceManager:负责资源管理的主服务,整个系统只有一个,负责资源管理、调度和监控,它支持可插拔的资源调度器,自带了FIFO、Fair Scheduler和Capacity Scheduler三种调度器; NodeManager:负责单个节点的资源管理和监控,它定期将资源使用情况汇报给ResourceManager,并接收来自ApplicationMaster的命令以启动Container(YARN中对资源的抽象),回收Container ApplicationMaster:负责管理单个应用程序,它向ResourceManager申请资源,并使用这些资源启动内部的任务,同时负责任务的运行监控和容错等; Container:对资源的抽象,它封装了某个节点上的CPU、内存等资源,ApplicationMaster只有获得一个Container后才能启动任务,另外,ApplicationMaster本身也是运行在一个Container之中。 用户将应用程序提交到ResourceManager上 ResourceManager为应用程序ApplicationMaster申请资源,并与某个NodeManager通信,以启动ApplicationMaster; ApplicationMaster与ResourceManager通信,为内部要执行的任务申请资源,一旦得到资源后,将于NodeManager通信,以启动对应的任务。 所有任务运行完成后,ApplicationMaster向ResourceManager注销,整个应用程序运行结束。

优秀的个人博客,低调大师

hiveql笔记(一)

1、创建表 create table if not exists mydb.employees{ name String COMMENT 'Employee name', salary FLOAT COMMENT 'Empolyee salary', subordinates APPAY<STRING> COMMENT 'Names of subordinates', deductions MAP<STRING,FLOAT> COMMENT 'Keys are deductions names,values are percentages' address STRUCT<street:STRING,city:String,state:STRING,zip:INT> COMMENT 'Home address') COMMENT 'Desription of the table' TBLPROPERITES ('creator '='me','created_at'='2012-01-02 10:00:00',...) LOCATION '/usr/hive/warehouse/mydb.db/employees'; Hive 会自动添加两个表属性:一个是last_modified_by,其保存着最后修改这个表的用户的用户名。另一个是last_modified_time,其保存着最后修改的新纪元时间秒。 2、查看表的详细表结构信息 DESCRIBE EXTENDED mydb.employees; //在表名后添加字段的名称,使用extended关键字也不会增加更多的输出信息。 DESCRIBE mydb.employees.salary; 3、外部表 CREATE EXTERNAL TABLE IF NOT EXISTS stocks ( exchange STRING, symbol STRING, ymd STRING, price_open FLOAT, price_high FLOAT, price_low FLOAT, price_close FLOAT, volume INT, price_adj_close FLOAT) ROW FORMAT DELIMITED FIELDS TERMINATED BY ‘,‘ LOCATION '/data/stocks'; 关键字EXTENAL告诉hive这个表是外部的,而后面的LOCATION..子句则用于告诉HIVE数据位于哪个路径下。 //还可以对一张存在的表进行结构复制(而不会复制数据) CREATE EXTERNAL TABLE IF NOT EXISTS mydb.employees3 LIKE mydb.employees LOCATION '/path/to/data'; 4、分区表、管理表 CREATE TABLE employees ( name String, salay FLOAT, subordinates APPAY<STRING>, deductions MAP<STRING,FLOAT>, address STRUCT<street:STRING,city:STRING,state:STRING,zip:INT> ) PARTITIONED BY (country STRING,state STRING); 分区表改变了Hive对数据存储的组织方式,这个表会有一个exployees目录与之对应,每个分区都有一个partXX //可以使用show partitions命令查看表中存在的所有分区: SHOW PARTITIONS employees; //如果表中存在很多的分区,而只想查看是否存储某个特定分区键的分区的话,还可以在命令上添加指定了一个或多个特定分区字段值的PARTITION子句: SHOW PARTITIONS employees PARTITION(country='US'); SHOW PARTITIONS employees PARTITION(country='US',state='AK'); 5、外部分区表 CREATE EXTERNAL TABLE IF NOT EXISTS log_messages ( hms INT, severity STRING, server STRING, porcess_id STRING, message STRING) PARTITIONED BY (year INT,month INT,day INT) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t'; ) //添加一个分区 ALTER TABLE log_messages ADD PARTITION(year = 2012,month = 1,day =2 ) LOCATITION 'hdfs://master_server/data/log_message/2012/01/02'; //将一个月前的分区数据拷贝到其他集群 hadoop distcp /data/log_message/2011/12/02 s3n://ourbucket/logs/2011/12/02 //修改表,将分区路径指向到S3路径: ALTER TABLE log_messages PARTITION(year = 2011,month = 12,day = 2) SET LOCATION 's3m://ourbucket/logs/2011/01/02'; //DESCRIBE EXTENDED log_message 语句会将分区键作为表的模式的一部分,和partitionKeys列表的内容同时进行显示: DESCRIBE EXTENDED log_messages; 6、删除表 DROP TABLE IF EXISTS employees; //这里有个知识点,如果开启了Hadoop回收站功能(默认是关闭),那么数据将会转移到用户在分布式文件系统中的用户跟目录下的.Trash目录下,也就是HDFS中的/usr/$USER/.Trash目录,如果要开启这个功能,需要配置fs.trash.internal的值。设置一个合理的整数,比如如果设置1440,那么就表示是24小时。 7、表重命名 ALTER TABLE log_messages RENAME TO logmsgs; 8、修改列信息 ALTER TABLE log_messages CHANGE COLUMN hms hours_minutes_seconds INT COMMENT 'The hours,minutes, and seconds part of the timestamp' AFTER severity; //这里说明,如果想将这个字段移动到第一个位置,需要使用FIRST关键字替代AFTER other_column子句即可。 9、增加列 ALTER TABLE log_messages ADD COLUMNS ( app_name STRING COMMENT 'Application name', session_id LONG COMMENT 'The current session id'); 10、删除或者替换列 //移除了之前所有的字段并重新指定了新的字段: ALTER TABLE log_messages REPLACE COLUMNS ( hours_mins_secs INT COMMENT 'hour,minute,seconds from timestamp', serverity STRING COMMENT 'The message severity' message STRING COMMENT 'The rest of the message'); 11、修改存储属性 ALTER TABLE log_messages PARTITION(year = 2012,month = 1,day = 1) SET FILEFORMAT SEQUENCEFILE; 12、通过查询语句向表中插入数据 INSERT OVERWRITE TABLE employees PARTITION (country = 'US' , state = 'OR' ) SELECT * FROM staged_employees se WHERE se.cnty = 'US' AND se.st = 'OR'; //如果是非分区表,之前表中的内容将会被覆盖掉 13、动态分区插入 //指定了country字段的值为静态的US,而分区字段state是动态值。 INSERT OVERWRITE TABLE employees PARTITION (country='US',state) SELECT ...,se.cnty,se.st FROM staged_employees se WHERE se.cnty = 'US'; (静态分区键必须出现在动态分区键之前) //延伸动态分区属性: hive.exec.dynamic.partition false 设置成true,表示开启动态分区功能 hive.exec.dynamic.partition.mode strict 设置成strict,表示允许所有分区都是动态的 hive.exec.max.dynamic.parition.pernode 100 每个mapper或reducer可以创建的最大动态分区个数。如果某个mapper或reducer尝试创建大于这个值得分区的话则会抛出一个致命错误信息。 hive.exec.max.dynamic.partitions +1000 一个动态分区创建语句可以创建的最大动态分区个数。如果超过这个值则会抛出一个致命错误信息。 hive.exec.max.created.files 100000 全局可以创建的最大文件个数。 eg: set hive.exec.dynamic.partition=true; set hive.exec.dynamic.partition.mode=nonstrct; set.hive.exec.max.dynamic.partitions.pernode=1000; INSERT OVERWRITE TABLE employees PARTITION (country,state) SELECT ...,se.cty,se.st FROM staged_employees se; 14、单个查询语句中创建表并加载数据 CREATE TABLE ca_employees as SELECT name,salary,address FROM employees WHERE se.state = 'CA'; 15、导出数据 hadoop fs -cp sorce_path target_path //也可以使用INSERT...DIRECTORY... INSERT OVERWRITE LOCAL DIRECTOR 'tmp/ca_employees' SELECT name,salary,address From employees WHERE se.state = 'CA'; 参考文献《Hive编程指南》

优秀的个人博客,低调大师

ISIS学习笔记

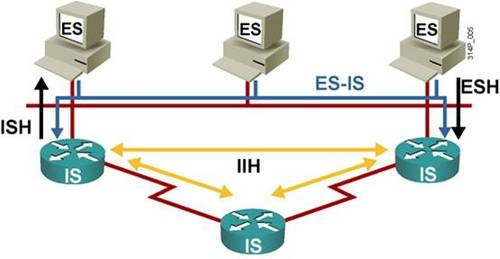
背景介绍 OSPF“表兄弟”,很另类,完全不同于OSI、TCP/IP协议栈,然而可以完全互相使用“双栈协议”。Intermediate system to intermediate system中间系统到中间系统 CLNS:ConnectionlessNetwork Service面向无连接的网络服务 IP ——àCLNS OSPF——àISIS ARP ——àESIS 链路状态路由协议,基于OSI七层模型设计 OSI参考模型确定了网络的标准,没有定义任何一个通信协议的细节但是提供了设计指导原则。 OSI网络层定义了两种服务:CONS与CLNS 基于CLNS的服务由以下网络层协议支持 – CLNP:无连接网络层协议 – ES-IS:终端系统-中间系统路由协议 – IS-IS :中间系统-中间系统路由协议 与OSPF拥有很多共同特性 – 维护一个链路状态数据库,使用SPF算法计算最短路径 – 使用Hello包形成和维护邻居关系 – 使用区域的概念来构建一个层次化的网络结构 – 支持手动汇总与VLSM – 在广播多路访问网络中都选举指定路由器 – 都具备认证功能 IS-IS基本术语 – IS:中间系统,相当于TCP/IP中的路由器 – ES:终端系统,相当于TCP/IP中的主机系统 – LSP:链路状态数据库报文 – NPDU:网络协议数据单元,ISO网络层报文,同IP包 – NSAP:网路服务接入点,即ISO中网络层地址 – (也称为CLNP地址) 地址格式 <8byte~20byte> DP:AFI、IDI DSP:High-order DSP、System-ID、NSEL Area:标识此IS端所在的区域 System:ID唯一标识次区域的IS 49.000x.0000.0000.000Y.00 AFI AreaID System-ID NSEI X->区域 Y->服务接口 基本原理 相同点 算法:SPF算法 特征:链路状态 无类:VLSM/CIDR 不相同 ①区域设计 OSPF:ABR链路两个区域 ISIS:没有明显的区域边界 ②分组类型 OSPF:非常多 ISIS:少,精简 ③路由器类型 OSPF 骨干路由器 常规路由器 ABR ISIS L1路由器 L2路由器 L1/2路由器 六种路由器是互相对应的 四种类型的路由 基本特征 属于网络层 链路状态协议 无类协议 最佳路径 AD:115àTCP/IP,115àOSI Metric:每跳,Metric为10 窄度量Narrow Metric接口2^6,总2^10 宽度量wide Metric接口2^24,总2^32 基本部署 接下去大都相同的,在开启clns路由,部署isis协议,在相应接口下部署isis 注意这个不同于osi模型,我们甚至查看不了路由 Ping的未知的地址回复也是不同的效果 然而仍然有表可查的 L1是常规区、L2骨干区 连通性测试 抓包之后发现不再是ICMP,这个也印证了ping不只是ICMP(其实TCP、ARP也可以~~) 修改区域类型 这里在L1,L1/2里面虽然都维护着R2的信息,但是对于R2来说根本没必要维护着R4的信息啊,所以就出现优化点。同理对于R4来说仅仅需要维护L2的信息即可 修改接口类型 我们知道R2是L1,R1、R3是L1/2,然而时不时R2会发送L2Hello包以维持R4的信息,所以需要相应的在接口下修改接口类型 结果 这里虽然没有路由信息竟然可以ping通!原因是什么?抓包可发现数据包的大小不同,但是在包里面却没有发现相应的路由信息啊。答案是,由于ISIS本身的算法,L1会寻找离它最近的L1/2(即默认路径)然后,通过该L1/2进行选路 修改度量值 双栈协议的体现 项目工程中很经常遇到的,集成ISIS,一般不会玩前面所说的纯ISIS。在这之前首先要给所有的路由器配上地址 结果 然而路由表、拓扑表中仍然没有信息 开始配置 根据拓扑,分别为其配置IP地址信息 不一一列举了,反正可以互相ping通就对了 提问 这两个命令意味着啥? ISIS路由分组 在R2与交换机之间进行抓包,可发现 从这个地方可以发现: 如果我们没有做优化,L1/2会向L1转发L2的hello事实上这些数据包对于R2来说是没有意义的,可以称之为垃圾包,这个就是需要进行链路优化的地方 Hello包发送非常密集,可以称之为”话痨“ Hello包 每3s发送一次,很消耗带宽,但可以很有效的报告当前的链路状态 CSNP包(DBD包) 每10s发送一次 PSNP 这个需要在串口状态下才能抓到,ISIS只认两种网络类型P2P、BMA ISIS DIS机制 vs OSPFDR机制 1、ISIS无备份机制 2、ISIS的DIS可抢占 3、ISIS默认优先级为64 4、ISIS的DIS hello间隔3.3s,Holdtime 10s R7R8一样的设置 LSP包 抓到这个包需要创建一个环回接口,然后才能抓到 虽然LSP是链路状态协议,但是完全可以说这个是EIGRP,因为几乎把所有的信息都公布出来了 ISIS路由算法 因为在OSPF的SPF算法的基础上多了PRC算法 ①算法优势:引入PRC,支持网络架构更大,网络更稳定; ②拓扑优势:区域设计不像OSPF有物理骨干区域的限制,ISIS的骨干区域相对比较灵活; ③分组优势:引入TLV 类型长度值的概念,可以更好的拓展新的特性和功能 ④迁移性:ISIS迁移到IPV4和IPV6,几乎无缝切换 路由汇总 汇总这个话题老生常谈~~ 汇总 需要在两个端口写,统一汇总信息,看效果 路由认证 跟EIGRP几乎没有区别 被动接口 跟前面的一样~~isis进程下使用passtive-interface 默认路由 ISIS路由泄露 根据ISIS的寻路算法,假如我们使用R2pingR7那么他们返回的路径是 因此需要相应的通过ACL人为的规定流量路径。哈?为啥要规定?不规定的话,路由拓扑就会被泄露啦 ISIS区域迁移 注意:由前面的配置经验可知,如果在相应进程下通告路由信息的话,原来的信息会被覆盖的,然而在ISIS里面却不会发生这样的情况 区域迁移的意义在于 OSPF与ISIS对比 共同之处 1 都是链路状态路由协议,都要求区域内的路由器交换链路状态信息,链路状态信息被收集到链路状态数据库中 2 都是用了一种实现路由选择信息交换相似机制 3 都在广播网络中选择指定路由器来控制扩散并降低这类介质中多对多邻接的系统资源需求 4 都是基于链路状态库中的信息,采用几乎相同的算法-SPF算法来计算最佳路由 5 都支持两个分层路由选择 6 都支持IP前缀的无类路由选择(支持VSLM) 7 都是共有协议 不同之处: ISIS OSPF 1 ISIS支持ISOCLNP和IP两种网络 仅支持IP网络 2 ISIS报文封装在数据链路层帧中 封装在IP包中 3 ISIS支持ISO无连接网络环境,注意数据链路是ISO协议(在以太网上数据链路类型为FEFE),在ISO协议栈中ISIS网络层协议ID是0x83 OSPF封装在IP报文当中,协议号89 4 ISIS路由器通告包含直连邻居及路由信息的TLV的LSP,使用LSP承载所有的路由选择信息 OSPF使用不同类型的LSA承载不同的路由信息,LSA被封装进LSU通告给邻居 5 ISIS数据包利用TLV字段承载所有易于扩散的信息 OSPF只有LSA可扩展,而LSA扩展性太差 6 ISIS可以忽略它所不支持的TLV 网络中的路由器为了进行适当的操作必须识别所有的LSA 7 ISIS数据包可以承载多个TLV,只有一个包头,节省带宽 1类,2类LSA可以承载多个IP前缀;3类,4类,5类LSA只能承载单个IP前缀,如果需要发送多个IP前缀信息,需要多个LSA 8 对于所有实际应用,ISIS仅支持广播和点对点链路。不支持NBMA链路。在NBMA环境下,可配置为p2p子接口或者广播链路(如果是全互联的连接方式)。 OSPF支持如下网络类型:p2p、广播、NMBA、点到多点和按需链路。 9 仅仅在广播链路实现3步邻接关系,IETF正在努力指定点到点链路的3步进程。 OSPF邻接关系的建立涉及到一个更加复杂的过程。 10 最初数据库同步在邻接关系建立后进行。 最初数据库同步在邻接关系形成前进行。 11 ISIS路由器只属于一个特定区域。 OSPF基于接口划分区域,路由器可属于不同的区域。 12 区域的边界在链路 区域的边界在路由器上。 13 默认情况下ISIS区域是stub区域,规定了level2到level1的路由泄漏 默认情况下,ospf区域不是stub,可以配置成为stub。 14 ISIS仅支持在点对点链路上可靠扩散,广播链路的扩散是不可靠的。然而通过DIS周期性的广播是可靠的。 OSPF确保所有链路上扩散的可靠性。 15 DIS无备份DIS,DIS可以被抢占,DIS以3被的频率发送HelloPDU 有BDR,DR不能被抢占,DR以正常的频率发送HelloPDU 16 默认情况下,ISIS的LSP最大生存时间为1200s刷新间隔为900s,而且定时器值可调。 OSPF的LSA的老化时间为3600s,刷新间隔为1800s,而且是固定值。 17 默认情况下,ISIS的接口cost值为10. 默认情况下,OSPF的保持时间(dead-interval)为40s,而且为了建立邻接关系,必须使双方的保持时间一致。 18 ISIS通过将HelloPDU的大小填充至接口MTU大小来检查双方MTU是否匹配。 OSPF通过在DBD报文中嵌入接口的MTU字段来检查MTU是否匹配。 19 由于ISIS区域中IP前缀是SPF数的叶子,故部分路由计算(PRC)较多,通常这就意味着在一个大的区域中路由处理器的负载较低。 部分SPF被限制用于域间和外部路由,任何要求较小的区域和分层拓扑扩展引起的域间链路动荡导致完全的SPF计算。 20 没有对IP组播路由选择的支持。 MOSPF扩展提供对IP组播路由选择的支持。

优秀的个人博客,低调大师

docker swarm笔记

1 准备节点: node-1 192.168.33.201 node-2 192.168.33.202 node-3 192.168.33.203 node-4 192.168.33.204 2 在每个节点分别安装docker服务。 sudo curl -sSL http://acs-public-mirror.oss-cn-hangzhou.aliyuncs.com/docker-engine/internet | sh - 安装后需要修改dockerd启动参数,增加: -H 0.0.0.0:2375 这个很重要,否则manager无法连接到节点。 docker 1.12以前,需要自己使用swarm镜像启动环境,这里整理一下。如果你已经是1.12+了,请直接跳到第4节。 3 Docker1.12以前的swarm-swarm container 3.1 在node-1启动swarm容器 docker pull warm 创建token $ docker run --rm swarm create 3445719bd06a6a19950c8a034f276cab 加入集群 docker run -d swarm join --addr=192.168.33.201:2375 token://3445719bd06a6a19950c8a034f276cab 3.2 在node-2启动swarm容器 重复node-1操作。记得修改IP地址。 3.3 查看集群节点 在其中一个节点查看集群 $ docker run --rm swarm list token://3445719bd06a6a19950c8a034f276cab 192.168.33.202:2375 192.168.33.201:2375 3.4 集群管理 3.4.1 启动管理节点 在测试机上开启管理程序。如果在node-1或node-2上,建议使用非2375端口,如:-p 5000:2375 $ docker run -d -p 2375:2375 swarm manage token://3445719bd06a6a19950c8a034f276cab 3eb0aec4c9917725c098d102aa12767803db59f869052c611d3be160971df534 3.4.2 查看集群状态 $ docker -H 192.168.33.203:2375 info Containers: 6 Running: 6 Paused: 0 Stopped: 0 Images: 4 Server Version: swarm/1.2.5 Role: primary Strategy: spread Filters: health, port, containerslots, dependency, affinity, constraint Nodes: 2 test1: 192.168.33.201:2375 └ ID: 52BN:6F2E:GMCP:4JYC:H3IW:VEUM:3ART:TAUE:4CLW:GR3I:S4KI:LKSR └ Status: Healthy └ Containers: 3 (3 Running, 0 Paused, 0 Stopped) └ Reserved CPUs: 0 / 1 └ Reserved Memory: 0 B / 1.018 GiB └ Labels: kernelversion=4.4.0-51-generic, operatingsystem=Ubuntu 16.04.1 LTS, storagedriver=aufs └ UpdatedAt: 2017-01-09T06:12:52Z └ ServerVersion: 1.12.5 test2: 192.168.33.202:2375 └ ID: I6N6:WJZH:B3S3:DW6E:MIPP:FIKF:EGIX:RAVH:XNKU:LHGL:WAE7:SBZ2 └ Status: Healthy └ Containers: 3 (3 Running, 0 Paused, 0 Stopped) └ Reserved CPUs: 0 / 1 └ Reserved Memory: 0 B / 1.018 GiB └ Labels: kernelversion=4.4.0-51-generic, operatingsystem=Ubuntu 16.04.1 LTS, storagedriver=aufs └ UpdatedAt: 2017-01-09T06:13:40Z └ ServerVersion: 1.12.5 Plugins: Volume: Network: Swarm: NodeID: Is Manager: false Node Address: Security Options: Kernel Version: 4.4.0-51-generic Operating System: linux Architecture: amd64 CPUs: 2 Total Memory: 2.035 GiB Name: cfa479ee8a5e Docker Root Dir: Debug Mode (client): false Debug Mode (server): false WARNING: No kernel memory limit support 其中Status: Healthy表示节点正常,如果前面提及的dockerd启动项未设置,这里将会是:Pending,服务不可用。 3.5 测试集群 3.5.1 查看容器 $ docker -H 192.168.33.203:2375 ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 3.5.2 设置命令别名 如果是2375,端口号可以省略。为了使用方便可以创建一个命令别名: alias docker-swarm='docker -H 192.168.33.203' 再测试: $ docker-swarm images REPOSITORY TAG IMAGE ID CREATED SIZE 3.5.3 启动容器 docker-swarm run -d --name web1 nginx docker-swarm run -d --name web2 nginx docker-swarm run -d --name web3 nginx docker-swarm run -d --name web4 nginx 3.5.4 查看整个集群的容器 $ docker-swarm ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 478206c91145 nginx "nginx -g 'daemon off" Less than a second ago Up Less than a second 80/tcp, 443/tcp test1/web4 07a70b5ba0c2 nginx "nginx -g 'daemon off" 4 seconds ago Up 4 seconds 80/tcp, 443/tcp test2/web3 dbd596f5464a nginx "nginx -g 'daemon off" 18 seconds ago Up 18 seconds 80/tcp, 443/tcp test2/web2 04c23c28bafb nginx "nginx -g 'daemon off" 54 seconds ago Up 54 seconds 80/tcp, 443/tcp test1/web1 查看NAMES数据,形如:test1/webx,其中test1表示节点名字 4 Docker1.12以后的swarmkit Docker 1.12 在 2016 年 7 月 28 日正式 GA,除了大量的在使用上的改进和 bug 修复外,最引人瞩目的是Docker原生支持了 Swarm 模式,而不是将Swarm作为一个容器对集群进行管理。而docker1.12的操作命令并不向下兼容,于是过去所有创建swarm集群的文档都不能参考了。 4.1 几个概念 4.1.1 节点类型 docker-swarm 把节点分为manager和worker,顾名思义,manager是管理节点,worker是工作节点。 4.1.2 service 区别于旧的swarm管理容器,新的docker-swarm抽象了一个service的概念,有点类似于kubernates的pod,它是管理的最小单元。 一个service是一个以上的容器的集合。 4.2 搭建swarm环境 仍然使用前面的节点服务来测试,第1、2节的工作还是需要有效的。 4.2.1 在node-1节点创建swarm环境 $ docker swarm init --advertise-addr 192.168.33.201 Swarm initialized: current node (9vpgoqj65y3kqo52jj3y6gcnj) is now a manager. To add a worker to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 To add a manager to this swarm, run 'docker swarm join-token manager' and follow the instructions. 他是使用Raft来管理节点的。事实上,如果你只有一个外网地址(即除了lo和docker网络等虚拟网络之外没有其他网络接口),可以直接执行:docker swarm init 4.2.2 将node-2节点加入到创建的swarm cluster 在node-2 执行: $ docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 This node joined a swarm as a worker. 4.2.3 在更多节点加入swarm cluster token没有记录下来?没关系,在node-1执行如下命令查看完整的命令提示: $ docker swarm join-token worker To add a worker to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 如果要加入的是manager节点,则如下查看: $ docker swarm join-token manager To add a manager to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-37rg2khjxgk1iis6dfds48b0s \ 192.168.33.201:2377 4.3 集群管理 4.3.1 查看集群节点 在manager节点: $ docker node list ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 9vpgoqj65y3kqo52jj3y6gcnj * test1 Ready Active Leader dc5t7rc04a69rzuahky6qh53x test2 Ready Active e4k1fjd93ukncipzy9cer0lcg test3 Ready Active 可以看到,一共有三个节点,node-1自身已经是一个worker了,他的MANAGER是Leader。 该命令只有在manager节点才有权限使用,如果你想在node-3上使用,则需要让node-3成为manager。。 一种方法是让node-3先从cluster重新以manager身份加入cluster。 $ docker swarm leave Node left the swarm. 注意:有时自己退出重新加入,反复操作,会让manager混乱,导致一些问题。如,test3已经leave,但manager看到它还是Reading状态,无法删除掉。docker node rm test3只能删除down状态的节点, 加上--force不是那么好使。 4.3.2 节点角色转换 接上,将node-3转换为manager最简单的方法是,角色提权:是在manager中把node-3的角色提升为manager: vagrant@test1:~$ docker node promote test3 Node test3 promoted to a manager in the swarm. vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 5awz4cd6auchp0knq0iljfudh test2 Ready Active a02rv4zuex14p03erer1h6zkz * test1 Ready Active Leader cq9q1su8ipkp9w80sabv16mmz test3 Ready Active Reachable 与之相反的就是降权: 一种方法是在manager中把node-3的角色提升为manager: vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 5awz4cd6auchp0knq0iljfudh test2 Ready Active a02rv4zuex14p03erer1h6zkz * test1 Ready Active Leader cq9q1su8ipkp9w80sabv16mmz test3 Ready Active 从安全性考虑,一个集群应该指定多个manager。但需要注意的是,如果一个manager宕机,那么另一个manager需要接管服务,需要至少有三个以上存活的节点。 4.3.3 删除节点 docker node rm [node_id] 如果节点状态是Down,可以直接删除,否则可以增加--force开关强制删除。 4.3.4 manager容灾测试 再增加一个node-4,并将node-3提权为manager。 vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg * test1 Ready Active Leader 8v5r3wb9sujlluqda6jv981ut test3 Ready Active Reachable 关闭node-1,在node-3检查节点: vagrant@test3:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg test1 Ready Active Unreachable 8v5r3wb9sujlluqda6jv981ut * test3 Ready Active Leader 此时test3接管Leader了。 启动node-1,检查节点: vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg * test1 Ready Active Reachable 8v5r3wb9sujlluqda6jv981ut test3 Ready Active Leader node-1已经变成了Reachable。 4.4 使用入门 4.4.1 创建service 折腾了半天,办点正事吧。 vagrant@test1:~$ docker service create --name web1 nginx bojkn65bzwpv2az82y3p7qssv vagrant@test1:~$ docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 0/1 nginx #稍等片刻 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 1/1 nginx REPLICAS 表示一共指定了1个副本,开始启动了0个,启动完成后,变成1/1。 4.4.2 查看服务中的容器 vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 3 minutes ago 4.4.3 调整容器副本 我们可以把web1服务中的容器多启动几个副本,如6个: vagrant@test1:~$ docker service scale web1=6 web1 scaled to 6 vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 4 minutes ago chy2qbqz3pbboyxxz90gb9vxb web1.2 nginx test3 Running Preparing 12 seconds ago 2ae4vz4lx8zcpacjepdzcxx5y web1.3 nginx test1 Running Preparing 13 seconds ago dfg1pul4brwa8xqutls2dddm1 web1.4 nginx test4 Running Preparing 13 seconds ago 2o39qlezex2ddk8ie0bzs9drv web1.5 nginx test4 Running Preparing 13 seconds ago bsduc9qvegikjs8fj94k4ogi8 web1.6 nginx test2 Running Running 6 seconds ago vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 2/6 nginx 其中的2/6以及前面看到的列表信息状态可以看出,我们指定了6个副本,目前web1.1和web1.6已经启动完成,其他还在Preparing。 6个副本中分别在test1启动了1个、test2启动了2个、test3启动了1个、test4启动了2个。 过一会再刷新: vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 7 minutes ago chy2qbqz3pbboyxxz90gb9vxb web1.2 nginx test3 Running Preparing 3 minutes ago 2ae4vz4lx8zcpacjepdzcxx5y web1.3 nginx test1 Running Preparing 3 minutes ago dfg1pul4brwa8xqutls2dddm1 web1.4 nginx test4 Running Running 9 seconds ago 2o39qlezex2ddk8ie0bzs9drv web1.5 nginx test4 Running Running 9 seconds ago bsduc9qvegikjs8fj94k4ogi8 web1.6 nginx test2 Running Running 3 minutes ago vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 4/6 nginx 最终会完全启动。 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 6/6 nginx 处理scale子命令,还可以使用update子命令完成同样的工作: vagrant@test1:~$ docker service update web1 --replicas=3 web1 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 2/3 nginx 4.5 负载均衡 多个副本容器启动后, swarm集群的service: 公共的端口会暴露在每一个swarm集群中的节点服务器上. 请求公共端口时,会负载均衡到所有的sevice实例上. 负载均衡模式有两种,vip和dnsrr,可以在出啊构建服务时指定: vagrant@test1:~$ docker service create --name web1 --replicas=6 --endpoint-mode=dnsrr nginx 4dx616zii0vgrz4s5oi2rwgsp 如果使用vip模式,应该有VirtualIP: $ docker service inspect --format='{{.Endpoint.VirtualIPs}}' web1 [] 怎么木有?你可能忘记在创建服务时发布端口了。 vagrant@test1:~$ docker service create --name web1 --replicas=6 -p 8888:80 nginx 8qlkxx7v643z7aenfrmfnksxk vagrant@test1:~$ docker service inspect --format='{{.Endpoint.VirtualIPs}}' web1 [{9h4hrcm7bv1ijdpzpyezy4pld 10.255.0.6/16}] 可以直接访问”http://10.255.0.6:8080“吗?no,它只是为容器间通信的,你可以访问任一台节点的IP:http://192.168.33.201:8888 4.6 启动时指定副本数 vagrant@test1:~$ docker service create --name nginx1 --replicas 2 nginx c79881b02bd7zrfg74a9qp8ji vagrant@test1:~$ docker service ps nginx1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 1ghmia00xkxucrisadlwyitv9 nginx1.1 nginx test3 Running Running 5 seconds ago 193mdx2xcja4qv8s9ssakt8w1 nginx1.2 nginx test4 Running Running 6 seconds ago 4.7 swarm网络 由于容器在不同的docker主机上,swarm是如何保证网络层的互通呢?swarm是使用overlay网络来解决这个问题的。 vagrant@test1:~$ docker network ls NETWORK ID NAME DRIVER SCOPE 180d624cf798 bridge bridge local 4d225a25b2b4 docker_gwbridge bridge local 6c1889cd666a host host local 9h4hrcm7bv1i ingress overlay swarm 839e8db03b09 none null local 其中的swarm是缺省创建的overlay网络。 你可以自己创建网络来管理一组服务的互通。 vagrant@test1:~$ docker network create --driver overlay test 17wzxz29pxdf6are8an6u0ep2 vagrant@test1:~$ docker network ls |grep test 17wzxz29pxdf test overlay swarm 在指定子网启动服务 vagrant@test1:~$ docker service create --network test --name myservice hello-world 5kz0imiep9fztvsev0c101568 vagrant@test1:~$ docker service ps myservice ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 6zww5ci2jhnvy05aj68ohb3do myservice.1 hello-world test2 Running Preparing 5 seconds ago 通过docker service inspect myservice返回的json中Networks元素可以看到网络信息,Target正是前面创建的test接口的id: "Networks": [ { "Target": "17wzxz29pxdf6are8an6u0ep2" } ] 你只要保证你启动的多个服务在同一个网络接口,就可以保证他们之间互相通信。 4.8 小结 swarmkit的引入,在docker中引入了三个子命令: docker swarm——swarm集群搭建 docker service——服务管理 docker node——集群节点管理 4.8.1 docker swarm 子命令 查看子命令 vagrant@test1:~$ docker swarm –help init 初始化swarm集群 join 将当前节点加入到集群中 join-token 管理加入token update 动态更新swarm配置 leave 当前节点主动退出集群(仅限worker节点) 4.8.2 docker service 子命令 查看子命令 vagrant@test1:~$ docker service –help create 创建服务 inspect 显示服务详情 ps 列出服务中的容器 ls 列出所有服务及简介 rm 删除服务 scale 调整服务的副本数 update 动态更新服务配置 4.8.3 docker node 子命令 查看子命令 vagrant@test1:~$ docker node –help demote 管理节点为指定子节点降权 inspect 显示节点详情 ls 列出集群中的节点 promote 管理节点为指定子节点提权 rm 删除一个节点 ps 列出指定子节点中running的容器 update 动态更新节点配置 4.8 使用帮助 本节实际上只是给出了查看帮助的方法。想了解某个命令的使用,只需要在子命令后面加上--help即可,逐级深入。如想了解docker node的子命令rm,则是: vagrant@test1:~$ docker node rm --help Usage: docker node rm [OPTIONS] NODE [NODE...] Remove one or more nodes from the swarm Aliases: rm, remove Options: --force Force remove an active node --help Print usage 祝好运。

优秀的个人博客,低调大师

Android学习笔记——文件路径、内容Uri学习笔记[转]

一、URI 通用资源标志符(Universal Resource Identifier, 简称"URI")。 Uri代表要操作的数据,Android上可用的每种资源 - 图像、视频片段等都可以用Uri来表示。 URI一般由三部分组成: 访问资源的命名机制。 存放资源的主机名。 资源自身的名称,由路径表示。 Android的Uri由以下三部分组成: "content://"、数据的路径、标示ID(可选) 举些例子,如: 所有联系人的Uri: content://contacts/people 某个联系人的Uri: content://contacts/people/5 所有图片Uri: content://media/external 某个图片的Uri:content://media/external/images/media/4 二、内部保存 首先我们来看一下android是如何管理多媒体文件(音频、视频、图片)的信息。通过DDMS,我们在/data/data/com.android.providers.media下找到数据库文件 打开external.db文件进一步查看:在media表格下,可以看到文件路径(_data)和Uri的标示ID(_id)的对应关系。 三、相互转换 1.从URI获得文件路径 1 string myImageUrl = "content://media/external/images/media/***"; 2 Uri uri = Uri.parse(myImageUrl); 3 4 5 String[] proj = { MediaStore.Images.Media.DATA }; 6 Cursor actualimagecursor = this.ctx.managedQuery(uri,proj,null,null,null); 7 int actual_image_column_index = actualimagecursor.getColumnIndexOrThrow(MediaStore.Images.Media.DATA); 8 actualimagecursor.moveToFirst(); 9 10 11 String img_path = actualimagecursor.getString(actual_image_column_index); 12 File file = new File(img_path); 13 Uri fileUri = Uri.fromFile(file); 2.由文件路径得到URI 1 Uri mUri = Uri.parse("content://media/external/images/media"); 2 Uri mImageUri = null; 3 4 Cursor cursor = managedQuery( 5 MediaStore.Images.Media.EXTERNAL_CONTENT_URI, null, null, 6 null, MediaStore.Images.Media.DEFAULT_SORT_ORDER); 7 cursor.moveToFirst(); 8 9 while (!cursor.isAfterLast()) { 10 String data = cursor.getString(cursor 11 .getColumnIndex(MediaStore.MediaColumns.DATA)); 12 if (picPath.equals(data)) { 13 int ringtoneID = cursor.getInt(cursor 14 .getColumnIndex(MediaStore.MediaColumns._ID)); 15 mImageUri = Uri.withAppendedPath(mUri, "" 16 + ringtoneID); 17 break; 18 } 19 cursor.moveToNext(); 20 } from:http://www.cnblogs.com/lingyun1120/archive/2012/04/18/2455212.html 欢迎加群互相学习,共同进步。QQ群:iOS: 58099570 | Android: 572064792 | Nodejs:329118122 做人要厚道,转载请注明出处! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sunshine-anycall/p/3544106.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

特征工程个人笔记

特征工程 1.概述 2方法 2.1去除唯一性 2.2处理缺失值 2.3 特征编码 2.3.1特征二元化 2.3.2独热编码(One-HotEncoding) 2.3.3标签编码 2.3.4多项式特征 2.3.5交叉验证 2.3.6网格搜索 2.3.7管道机制 2.4数据标准化、正则化 2.5 特征选择(降维) 1.概述 在工程实践中,我们得到的数据会存在有缺失值、重复值等,在使用之前需要进行数据预处理。数据预处理没有标准的流程,通常针对不同的任务和数据集属性的不同而不同。数据预处理的常用流程为:去除唯一属性、处理缺失值、属性编码、数据标准化正则化、特征选择、主成分分析。 2方法 2.1去除唯一性 唯一属性通常是一些id属性,这些属性并不能刻画样本自身的分布规律,所以简单地删除这些属性即可。 2.2处理缺失值 缺失值处理的三种方法:直接使用含有缺失值的特征;删除含有缺失值的特征(该方法在包含缺失值的属性含有大量缺失值而仅仅包含极少量有效值时是有效的)→dropna();缺失值补全→fillna( )。判断是否缺失→isnull( ) 常见的缺失值补全方法:均值插补、同类均值插补、建模预测、高维映射、多重插补、极大似然估计、压缩感知和矩阵补全。 (1)均值插补 如果样本属性的距离是可度量的,则使用该属性有效值的平均值来插补缺失的值; (2)同类均值插补 首先将样本进行分类,然后以该类中样本的均值来插补缺失值。 (3)建模预测 将缺失的属性作为预测目标来预测,将数据集按照是否含有特定属性的缺失值分为两类,利用现有的机器学习算法对待预测数据集的缺失值进行预测。 该方法的根本的缺陷是如果其他属性和缺失属性无关,则预测的结果毫无意义;但是若预测结果相当准确,则说明这个缺失属性是没必要纳入数据集中的;一般的情况是介于两者之间。 (4)高维映射 将属性映射到高维空间,采用独热码编码(one-hot)技术。将包含K个离散取值范围的属性值扩展为K+1个属性值,若该属性值缺失,则扩展后的第K+1个属性值置为1。 这种做法是最精确的做法,保留了所有的信息,也未添加任何额外信息,若预处理时把所有的变量都这样处理,会大大增加数据的维度。这样做的好处是完整保留了原始数据的全部信息、不用考虑缺失值;缺点是计算量大大提升,且只有在样本量非常大的时候效果才好。 (5)多重插补(MultipleImputation,MI) 多重插补认为待插补的值是随机的,实践上通常是估计出待插补的值,再加上不同的噪声,形成多组可选插补值,根据某种选择依据,选取最合适的插补值。 (6)压缩感知和矩阵补全 (7)手动插补 插补处理只是将未知值补以我们的主观估计值,不一定完全符合客观事实。在许多情况下,根据对所在领域的理解,手动对缺失值进行插补的效果会更好。 2.3 特征编码 2.3.1特征二元化 特征二元化的过程是将数值型的属性转换为布尔值的属性,设定一个阈值作为划分属性值为0和1的分隔点。二进制转化-Binarizer 2.3.2独热编码(One-HotEncoding) from sklearn.preprocessing import OneHotEncoder 独热编码采用N位状态寄存器来对N个可能的取值进行编码,每个状态都由独立的寄存器来表示,并且在任意时刻只有其中一位有效。 独热编码的优点:能够处理非数值属性;在一定程度上扩充了特征;编码后的属性是稀疏的,存在大量的零元分量。 pandas的独热编码: pandas.get_dummies(data, prefix=None, prefix_sep=’_’, dummy_na=False, columns=None, sparse=False, drop_first=False) data : array-like, Series, or DataFrame 输入的数据 prefix : string, list of strings, or dict of strings, default None get_dummies转换后,列名的前缀 columns : list-like, default None 指定需要实现类别转换的列名 dummy_na : bool, default False 增加一列表示空缺值,如果False就忽略空缺值 drop_first : bool, default False 获得k中的k-1个类别值,去除第一个 2.3.3标签编码 from sklearn.preprocessing LabelEncoder LabelEncoder可以将标签分配一个0—n_classes-1之间的编码-不考虑数据间平等性 2.3.4多项式特征 from sklearn.preprocessing import PolynomialFeatures 简单理解多项式特征处理:就是一个数据集假如有a,b两个特征,那么对这个特征进行2次多项式特征处理的结果就是(1,ab,a2,b^2)PolynomialFeatures有三个参数: degree:控制多项式的度,也就是多项式的最高次数,int类型 interaction_only: 默认为False,如果指定为True,那么就不会有特征自己和自己结合的项,上面的二次项中没有a2和b2。 include_bias:默认为True。如果为True的话,那么就会有上面的 1那一项。 2.3.5交叉验证 from sklearn.model_selection import cross_val_score 交叉验证种类:详细参考见此贴 train_test_split:在分类问题中,我们通常通过对训练集进行train_test_split,划分成train 和test 两部分,其中train用来训练模型,test用来评估模型,模型通过fit方法从train数据集中学习,然后调用score方法在test集上进行评估,打分;从分数上我们可以知道 模型当前的训练水平如何 —from sklearn.model_selection import train_test_split X_train,X_test, y_train, y_test =train_test_split(train_data,train_target,test_size=0.4, random_state=0,stratify=y_train) train_data:所要划分的样本特征集 train_target:所要划分的样本结果 test_size:样本占比,如果是整数的话就是样本的数量 random_state:是随机数的种子。 其实就是该组随机数的编号,在需要重复试验的时候,保证得到一组一样的随机数。比如你每次都填1,其他参数一样的情况下你得到的随机数组是一样的。但填0或不填,每次都会不一样。 随机数的产生取决于种子,随机数和种子之间的关系遵从以下两个规则: 种子不同,产生不同的随机数;种子相同,即使实例不同也产生相同的随机数。也可以对X,y进行切分K-Fold Cross-validation k折交叉验证:简言之,就是进行多次train_test_split划分;每次划分时,在不同的数据集上进行训练、测试评估,从而得出一个评价结果;如果是5折交叉验证,意思就是在原始数据集上,进行5次划分,每次划分进行一次训练、评估,最后得到5次划分后的评估结果,一般在这几次评估结果上取平均得到最后的评分。k-fold cross-validation ,其中,k一般取5或10。Stratified K-Fold Cross-validation 分层k折交叉验证:解决简单交叉验证带来的问题,所以进行分层交叉验证,保证每次划分中包含类别的比例数和原数据相同。如原数据有三类,比例为1:2:1,那么划分的k折中,每一折中的数据类别保持着1:2:1的比例,这样的验证结果更加可信。 实际上就是改变了交叉验证的划分函数。Leave-one-out Cross-validation 留一法:留一法是一种特殊的交叉验证方式,顾名思义就是每次留下一个样本进行验证,如果样本容量是n 那么k折中的k等于n,进行n折交叉验证,适合小样本数据,耗时,相当于n折交叉验证,改变交叉验证数据划分函数即可。 2.3.6网格搜索 —from sklearn.model_selection import GridSearchCV Grid Search:一种调参手段;穷举搜索:在所有候选的参数选择中,通过循环遍历,尝试每一种可能性,表现最好的参数就是最终的结果。其原理就像是在数组里找最大值。(为什么叫网格搜索?以有两个参数的模型为例,参数a有3种可能,参数b有4种可能,把所有可能性列出来,可以表示成一个3*4的表格,其中每个cell就是一个网格,循环过程就像是在每个网格里遍历、搜索,所以叫grid search) 2.3.7管道机制 —from sklearn.pipeline import Pipeline 注意管道机制里面的参数写法是列表+元组的格式,列表用于存放所有的特征和算法处理的过程,元组具体写每个处理方式,每个管道机制中最多可以在最后添加一个算法,或者不填,格式如下: 2.4数据标准化、正则化 数据标准化 数据标准化是将样本的属性缩放到某个指定的范围。 数据标准化的原因: 某些算法要求样本具有零均值和单位方差; 需要消除样本不同属性具有不同量级时的影响:①数量级的差异将导致量级较大的属性占据主导地位;②数量级的差异将导致迭代收敛速度减慢;③依赖于样本距离的算法对于数据的数量级非常敏感。 min-max标准化(归一化):对于每个属性,设minA和maxA分别为属性A的最小值和最大值,将A的一个原始值x通过min-max标准化映射成在区间[0,1]中的值x’,其公式为:新数据=(原数据 - 最小值)/(最大值 - 最小值) from sklearn.preprocessing import MinMaxScaler z-score标准化(规范化):基于原始数据的均值(mean)和标准差(standarddeviation)进行数据的标准化。将A的原始值x使用z-score标准化到x’。z-score标准化方法适用于属性A的最大值和最小值未知的情况,或有超出取值范围的离群数据的情况。新数据=(原数据- 均值)/ 标准差 from sklearn.preprocessing import StandardScaler 正则化——过拟合解决方案 数据正则化是将样本的某个范数(如L1范数)缩放到到位1,正则化的过程是针对单个样本的,对于每个样本将样本缩放到单位范数。 正则化包括L0、L1,L2正则: L0正则化的值是模型参数中非零参数的个数。 L1正则化表示各个参数绝对值之和,可以将一些参数直接缩减为0 L2正则化标识各个参数的平方的和的开方值,可以将一些参数变得很小但是不为0 参数稀疏一个好处是可以简化模型,避免过拟合。因为一个模型中真正重要的参数可能并不多,如果考虑所有的参数起作用,那么可以对训练数据可以预测的很好,但是对测试数据就只能呵呵了。另一个好处是参数变少可以使整个模型获得更好的可解释性。为什么参数越小,说明模型越简单呢,这是因为越复杂的模型,越是会尝试对所有的样本进行拟合,甚至包括一些异常样本点,这就容易造成在较小的区间里预测值产生较大的波动,这种较大的波动也反映了在这个区间里的导数很大,而只有较大的参数值才能产生较大的导数。因此复杂的模型,其参数值会比较大。 稀疏的参数可以防止过拟合,因此用L0范数(非零参数的个数)来做正则化项是可以防止过拟合的。 从直观上看,利用非零参数的个数,可以很好的来选择特征,实现特征稀疏的效果,具体操作时选择参数非零的特征即可。但因为L0正则化很难求解,是个NP难问题,因此一般采用L1正则化。L1正则化是L0正则化的最优凸近似,比L0容易求解,并且也可以实现稀疏的效果。 L1正则化-lasso(套索)回归 L2正则—Ridge(岭回归) 2.5 特征选择(降维) 从给定的特征集合中选出相关特征子集的过程称为特征选择。 进行特征选择的两个主要原因是: 减轻维数灾难问题; 降低学习任务的难度。 进行特征选择必须确保不丢失重要特征。 常见的特征选择类型分为三类:过滤式(filter)、包裹式(wrapper)、嵌入式(embedding)。 过滤式选择:该方法先对数据集进行特征选择,然后再训练学习器。特征选择过程与后续学习器无关。Relief是一种著名的过滤式特征选择方法。 包裹式选择:该方法直接把最终将要使用的学习器的性能作为特征子集的评价原则。其优点是直接针对特定学习器进行优化,因此通常包裹式特征选择比过滤式特征选择更好,缺点是由于特征选择过程需要多次训练学习器,故计算开销要比过滤式特征选择要大得多。 嵌入式选择 常见的降维方法:SVD、PCA、LDA

优秀的个人博客,低调大师

JavaScript数组排序笔记

工作中经常用到的几种排序方式,整理出来分享给大家以备不时之需。 1、array排序函数sort 使用Array的sort方法。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] arr.sort((a,b) => { return a - b }) console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 2、冒泡排序 将数组中的相邻两个元素进行比较,将比较大(较小)的数通过两两比较移动到数组末尾(开始),执行一遍内层循环,确定一个最大(最小)的数,外层循环从数组末尾(开始)遍历到开始(末尾)。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] for(var i=0;i<arr.length;i++) { for(var j=0;j<arr.length-1;j++) { if (arr[j]>arr[j+1]) { let news = arr[j] arr[j] = arr[j+1] arr[j+1] = news } } } console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 3、选择排序 首先从原始数组中找到最小的元素,并把该元素放在数组的最前面,然后再从剩下的元素中寻找最小的元素,放在之前最小元素的后面,minIndex始终保存着最小值的位置的索引,随着i的自增,遍历的数组长度越来越短,直到完成排序。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] for(var i=0;i<arr.length;i++) { var minIndex=i; for(var j=i+1;j<arr.length;j++) { if(arr[j]<arr[minIndex]){ minIndex=j } } if(minIndex!=i){ var news = arr[i]; arr[i]=arr[minIndex] arr[minIndex]=news } } console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 4、插入排序 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] //假设第0个元素是一个有序的数列,第1个以后的是无序的序列, //所以从第1个元素开始将无序数列的元素插入到有序数列中 for(var i = 1; i < arr.length; i++){ //升序 if(arr[i] < arr[i-1]){ //取出无序数列中的第i个作为被插入元素 var guard = arr[i]; //记住有序数列的最后一个位置,并且将有序数列位置扩大一个 var j = i - 1; arr[i] = arr[j]; //比大小,找到被插入元素所在的位置 while(j >= 0 && guard < arr[j]){ arr[j+1] = arr[j]; j--; } //插入 arr[j+1] = guard; } } console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 5、快速排序 快速排序涉及到了递归,将一个数组的排序问题看成是两个小数组的排序问题,而每个小的数组又可以继续看成更小的两个数组,一直递归下去,直到数组长度大小最大为2。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] function quickSort(arr){ if(arr.length<=1){//如果数组只有一个数,就直接返回; return arr; } var num=Math.floor(arr.length/2);//找到中间数的索引值,如果是浮点数,则向下取整 var newValue=arr.splice(num,1);//找到中间数的值 var left=[],right=[]; for(var i=0;i<arr.length;i++){ if(arr[i]<newValue){ left.push(arr[i]);//基准点的左边的数传到左边数组 }else{ right.push(arr[i]);//基准点的右边的数传到右边数组 } } return quickSort(left).concat(newValue,quickSort(right));//递归不断重复比较 } console.log(quickSort(arr)) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8]

优秀的个人博客,低调大师

Django学习笔记(一)

image.png 最近有个需求,老大让用 Django 来做,以前入门 Python 时就听过 Django 的大名,今日一见果然名不虚传~~~~。 特点 Django 最大的特点就是快速建站: 快速开发 内置应用 后台admin 用户认证系统auth 会话系统sessions 安全性高 表单验证 SQL注入 跨站点攻击 易于拓展 ....很多,这里不一一列举。 Django 应用(app)的概念 项目VS应用 项目与应用之间有什么不同之处?应用是一个提供功能的 Web 应用 – 例如:一个博客系统、一个公共记录的数据库或者一个简单的投票系统。 项目是针对一个特定的 Web 网站相关的配置和其应用的组合。一个项目可以包含多个应用。一个应用可以在多个项目中使用。 Django使用应用来分割功能,也就是app,每个应用分别为不同的app。 例如:我们创建一个电商网站,那么里边的购物车、用户管理、支付系统都可以成为独立的模块,也就是独立的三个app,这些模块可以用在别的网站中,不单单只针对于当前网站。 Django Demo Python版本2.7 Django版本1.8 查看已安装Django的版本:python -c "import django;print(django.get_version())" 创建一个名为web_Demo的Django项目 命令:django-admin startproject web_Demo 完成后,查看目录结构: image.png manage.py : 一个实用的命令行工具,可以让你以各种方式与该Django项目交互。可以在django-admin.py和manage.py查看源码的细节。 settings.py : 该项目的配置文件。 urls.py : 该项目的URL生明。 wsgi.py : 一个WSGI兼容的Web服务器入口。 接着,创建一个名为blog的应用(app):python manage.py startapp blog 查看新的目录结构: image.png 应用模块中各文件的作用: migrations:数据迁移模块 admin.py : 该应用的后台管理系统配置文件 apps.py : 当前应用的一些配置,1.9版本后才会自动生成,1.8 1.7都不会自动生成 models.py : 数据模型 使用ORM框架 django已经有所封装 tests.py : 自动化测试模块 views.py : 执行响应的逻辑代码,代码逻辑处理的主要地点,项目中大部分代码都在这里编写 然后,把blog app添加到配置文件中: 编辑settings.py: INSTALLED_APPS = ( 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', 'blog' ) 解释一下上边的配置信息代表什么意思: admin :身份验证系统 auth : contenttypes:内容类型框架 sessions :session框架 messages :消息框架 staticfiles :静态文件框架 再执行命令python manage.py migrate image.png 完成。 Admin Admin是Django自带的一个功能强大的自动化数据管理界面,被授权的用户可直接在admin中管理数据库。 Django提供了许多针对Admin的定制功能。 首先,创建超级用户查看admin系统:python manage.py createsuperuser 输入用户名、邮箱、密码,这里密码要难一些,简单的密码可能会不行。 image.png 启动web项目:python manage.py runserver 这里默认8000端口, 浏览器中打开127.0.0.1/8000/admin 输入刚才设置的用户名密码: image.png 登录: image.png 可以看到admin界面。 这里显示的是英文的admin,我们可以通过配置改为中文的。 更改settings中的配置: LANGUAGE_CODE = 'zh-Hans' image.png 完成。

优秀的个人博客,低调大师

HashMap源码学习笔记

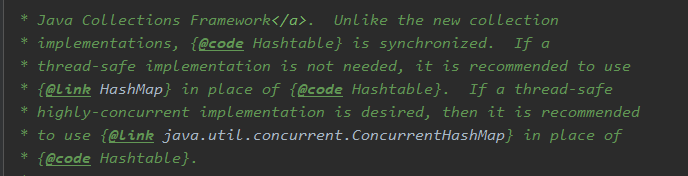
最近忙于各种事情,只能陆陆续续也看了一些东西,Java的HashMap应该算比较基础的东西,也是最近在看<<Redis设计与实现>>,其中也有HashMap的数据结构,又回去看了一下Java本身实现,这篇也就再记录一下。 Java数据结构中定义了Map接口,该接口有四个常用实现类:HashMap,Hashtable,LinkedHashMap和TreeMap。 针对上面四个常用类简单的介绍一下: 1. Hashtable: 从下面的Java doc就可以看出,其本身是线程安全的,但是并发性不如concurrent中的ConcurrentHashMap,而不需要线程安全时候,也推荐使用HashMap,故可以算是一个遗留类,不推荐使用。 Hashtable Java doc 2. LinkedHashMap:它是HashMap的一个子类,保存了记录的插入顺序,在用Iterator遍历LinkedHashMap时,先得到的记录肯定是先插入的。 LinkedHashMap java doc 3. TreeMap:TreeMap实现SortedMap接口,能够把它保存的记录根据键排序,默认是按键值的升序排序,也可以指定排序的比较器,当用Iterator遍历TreeMap时,得到的记录是排过序的。如果使用排序的映射,建议使用TreeMap。 TreeMap Java doc 4. HashMap:它根据键的hashCode值存储数据,大多数情况下可以直接定位到它的值,因而具有很快的访问速度,但遍历顺序却是不确定的。 HashMap最多只允许一条记录的键为null,允许多条记录的值为null。HashMap非线程安全,可能会导致数据的不一致。如果需要满足线程安全,可以使用之前提及的ConcurrentHashMap(不建议用Hashtable)。 本篇主要简单介绍的就是HashMap的实现,也是由于HashMap是最最常用的一个,可以满足大部分场景。自己工作了一年时间,基本也只用过HashMap= = 内部结构 HashMap内部的数据结构,就是最经典的数组+链表实现的哈希桶(JDK 1.7之前),从1.8之后,链表节点数量满足一定条件后,会自动转换成红黑树的数据结构,进一步提高查询效率。简单来说,HashMap的结构就是一个指针数组。 数据结构 图中的黑点则是存放Key-Value的Node,其数据结构如下: Node数据结构 其中 hash是用来定位数组索引位置, next是链表的下一个node。 字段 Map.put("key", "value") 在不考虑扩容的情况下,put操作会首先计算key的hash值,并通过取高位运算 + 取模运算两步,就能计算出该key在哈希桶的位置了。 当两个key定位在了同一个位置,则表示发生了Hash碰撞。因此,良好的Hash算法,能够尽量减少Hash碰撞,提高Map的存取效率。然而,即使很好的Hash算法,如果哈希桶的size很小(相比于Node数量),无论怎么计算,总是在这几个位置,也会出现很多碰撞。因此,解决碰撞,不仅需要良好的Hash算法,还需要一个良好的扩容机制。 要讨论扩容机制,就先看一下HashMap中的几个字段(附默认值): capacity: Hash桶容量 load_factor: 负载因子 size:已有node数量,modCount:内部结构变化次数,threshold=capacity * factor: 最大node数量 从上面几个字段可以看出,当put操作,使得size > threshold时,HashMap就会发生扩容。 并且从Java 动doc可以看出,Hash桶的大小一定是2的n次方。(正是这个限制,使得HashMap在扩容和计算key位置的运算效率提升了很多) 实现 Hash算法的实现,其实只有下面三行代码: int hashcode = key.hashCode(); // 获取hashcode int hashInt = hashcode ^(hashcode >>> 16 ); // 高位运算 int index = hashInt & (length - 1) // 取模运算,lenght是数组大小 第二步通过hashCode()的高16位异或低16位实现的:(h = k.hashCode()) ^ (h >>> 16),主要是从速度、功效、质量来考虑的,这么做可以在数组table的length比较小的时候,也能保证考虑到高低Bit都参与到Hash的计算中,同时不会有太大的开销。 第三步也是非常巧妙,因为Lenght是2的n次方,因此length - 1 永远是n个1,其实相当于对hashInt做了一次取模,但是效率极高。 下面是JDK 1.8的put代码实现: JDK1.8中put实现 line 627-628: table为空则创建. line 629-630: 计算index,并且check null, 如果为null, 直接创建一个index; line 633-635: 如果需要put的key和该位置原来的key一样,则直接覆盖value, 否则进行下面的追加操作 line 676-637: 红黑树操作,追加Node到红黑树 line 638-650: 链表操作,追加node到链表,并且判断是否需要转化为红黑树。 line 661-662: 判断是否需要扩容 扩容机制 扩容机制里的算法相对也比较复杂,HashMap的线程不安全性,也正是由于扩容时,链表操作可能导致的Infinite Loop引起。因此下一篇再具体举例说明吧。顺便可以一起把redis的HashMap resize机制一起说一下,基本都是大同小异。 总结 本篇就从源码角度,简单讲解HashMap的基本数据结构和关键操做的实现,以及简单介绍了扩容机制,由于JDK1.8以后的红黑树,导致扩容的代码更加复杂,但是扩容的算法相对于1.8之前,也有了不少优化,不过之后也不会深入算法方便,主要还是会介绍扩容的流程和原理。同事会结合redis的哈希表实现。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册