首页 文章 精选 留言 我的

精选列表

搜索[笔记软件],共10010篇文章
优秀的个人博客,低调大师

UnitTest笔记

UnitTest——测试模块 其他相关:使用coverage工具统计python单元测试覆盖率 一、简单示例 待测类/方法 book.py # 待测类 class Book(object): _page = 2000 def __init__(self, bookname, author): self.name = bookname self.author = author def get_page(self): return self._page # 待测方法 def get_name(book): return book.name 测试类test_book.py # 每个测试方法均以 test 开头,否则是不被unittest识别的。 class TestBook(unittest.TestCase): def test_init(self): print('test init()') book = main_class.Book('bookname', 'author') self.assertEquals(book.name, 'bookname') self.assertEquals(book.author, 'author') self.assertEquals(book._page, 2000) self.assertTrue(isinstance(book, main_class.Book)) def test_get(self): print('test get_name()') self.assertEquals(main_class.get_name(main_class.Book('bookname', 'author')), 'bookname') 运行 if __name__ == '__main__': unittest.main() 结果 test get_name() . test init() . ---------------------------------------------------------------------- Ran 2 tests in 0.001s OK ​ 给出的结果标识,成功是 .,失败是 F,出错是 E,跳过是 S。 ​ 测试的执行跟方法的顺序没有关系。 二、测试类 创建 继承unittest.TestCase。 以“test”开头的测试方法,每一类分别添加一个测试方法。 按需添加内置判断条件如:assertEquals()、assertRaises(Error)。 运行 1、pyCharm直接运行 ​ pycharm还是比较智能的,可以直接运行测试,不过有个地方需要特别注意,pyCharm会自动识别并测试鼠标所在当前代码块,所以有可能你ctrl+shift+f10后,可能运行结果就只是测试一个方法(笔者可是让这个弄的莫名其妙,一顿不得其解)。 2、main方法 ​ 在测试文件结尾添加 if __name__ == '__main__': unittest.main() 然后命令行运行 python xxxx.py 3、命令行运行 在命令行通过参数-m unittest直接运行单元测试: $ python -m unittest xxxx 这是推荐的做法,因为这样可以一次批量运行很多单元测试,并且,有很多工具可以自动来运行这些单元测试。 环境准备和尾处理 如果每个测试之前都需要准备环境如连接数据库、打开文件,或尾处理如关闭数据库、关闭数据流,不可能每个测试方法都写一遍。 setUp() ​ 在每个测试方法运行之前运行 tearDown() ​ 在每个测试方法运行之后运行 setUpClass() ​ 在每个单元测试开始之前运行 tearDownClass() ​ 在每个单元测试结束之后运行 示例: class TestBook(unittest.TestCase): def setUp(self): print('setUp++++++++') @classmethod def setUpClass(cls): print('setUpClass--------') def tearDown(self): print('tearDown++++++++++') @classmethod def tearDownClass(cls): print('tearDownClass--------') def test_init(self): print('test init()') def test_get(self): print('test get_name()') 运行结果: (UnitTest) D:\sHui\learn\UnitTest>python -m unittest test_class setUpClass-------- setUp++++++++ test get_name() tearDown++++++++++ .setUp++++++++ test init() tearDown++++++++++ .tearDownClass-------- ---------------------------------------------------------------------- Ran 2 tests in 0.003s OK 跳过某case 测试跳过某个case?unittest提供了几种方法。 1、skip装饰器 unittest.skip(reason) skip无条件跳过 unittest.skipIf(condition, reason) skipIf当condition为True时跳过 unittest.skipUnless(condition, reason) skipUnless当condition为False时跳过。 示例: class TestBook(unittest.TestCase): def test_init(self): print('test init()') @unittest.skip('skip this func ') def test_get(self): print('test get_name()') 结果: Skipped: skip this func test init() Ran 2 tests in 0.002s OK (skipped=1) 运行了两个测试,但test_get被跳过了 2、TestCase.skipTest() 测试类的skipTest()方法可以跳过当前测试方法。 class TestBook(unittest.TestCase): def test_init(self): print('test init()') # 跳过此方法 def test_get(self): self.skipTest('skip this func') print('test get_name()') 结果同上 调整测试顺序 新建文件test_suite.py import unittest import test_class if __name__ == '__main__': suite = unittest.TestSuite() tests = [test_class.TestBook('test_init'), test_class.TestBook('test_get')] suite.addTests(tests) runner = unittest.TextTestRunner(verbosity=2) runner.run(suite) 输出: test init() test get_name() test_init (test_class.TestBook) ... ok test_get (test_class.TestBook) ... ok ---------------------------------------------------------------- Ran 2 tests in 0.000s OK 三、测试输出 1、输出信息 verbosity参数可以控制执行结果的输出 0 是简单报告 1 是一般报告 2 是详细报告。 2、输出到文件 if __name__ == '__main__': suite = unittest.TestSuite() suite.addTests(unittest.TestLoader().loadTestsFromTestCase(test_class.TestBook)) with open('Unittest.txt', 'a') as f: runner = unittest.TextTestRunner(stream=f, verbosity=2) runner.run(suite) 运行结束会在同目录下生成了Unittest.txt 3、输出为HTML HTMLTestRunner是一个第三方的unittest HTML报告库,首先我们下载HTMLTestRunner.py,并放到当前目录下,或者你的’C:Python27Lib’下,就可以导入运行了。 官方原版:下载地址 灰蓝修改版:HTMLTestRunner.py(已调整格式,中文显示) 示例: from HTMLTestRunner import HTMLTestRunner if __name__ == '__main__': suite = unittest.TestSuite() suite.addTests(unittest.TestLoader().loadTestsFromTestCase(test_class.TestBook)) with open('HTMLReport.html', 'w') as f: runner = HTMLTestRunner(stream=f, title='MathFunc Test Report', description='generated by HTMLTestRunner.', verbosity=2) runner.run(suite) 四、Coverage的使用 1.命令行方式 详见:http://coverage.readthedocs.io/en/latest/cmd.html 可以使用help命令查看帮助:$ coverage help 关键命令如下: A.run 执行代码覆盖率统计,只需要通过coverage的run参数执行被统计代码即可。 $ coverage run test.py arg1 arg2 test.py是测试脚本,arg1 arg2是test.py执行需要的参数。跑完后,会自动生成一个覆盖率统计结果文件(data file):.coverage。 B.report 有了覆盖率统计结果文件,只需要再运行report参数,就可以在命令里看到统计的结果。 Stmts/Miss表示语句总数/未执行到的语句数 Cover=(Stmts-Miss)/Stmts c. html 生成html的测试报告。 $ coverage html -d covhtml 生成的报告直接关联代码,高亮显示覆盖和未覆盖的代码,支持排序。-d指定html文件夹。 2.API方式 除了使用命令行,还可以在python代码中直接调用coverage模块执行代码覆盖率的统计。使用方法也非常简单: import coverage cov = coverage.coverage(source = ['totest']) cov.start() #coding cov.stop() cov.report() cov.html_report(directory='covhtml') source指定要执行统计的文件,source = ['totest']只统计totest.py的覆盖率 directory指定生成html的路径 五、常用函数 Method Checks that assertEqual(a, b) a == b assertNotEqual(a, b) a != b assertTrue(x) bool(x) is True assertFalse(x) bool(x) is False assertIs(a, b) a is b assertIsNot(a, b) a is not b assertIsNone(x) x is None assertIsNotNone(x) x is not None assertIn(a, b) a in b assertNotIn(a, b) a not in b assertIsInstance(a, b) isinstance(a, b) assertNotIsInstance(a, b) not isinstance(a, b) assertRaises(exc, fun, *args, **kwds) fun(*args, **kwds) raises exc assertRaisesRegexp(exc, r, fun, *args, **kwds) fun(*args, **kwds) raises exc and the message matches regex r assertAlmostEqual(a, b) round(a-b, 7) == 0 assertNotAlmostEqual(a, b) round(a-b, 7) != 0 assertGreater(a, b) a > b assertGreaterEqual(a, b) a >= b assertLess(a, b) a < b assertLessEqual(a, b) a <= b assertRegexpMatches(s, r) r.search(s) assertNotRegexpMatches(s, r) not r.search(s) assertItemsEqual(a, b) sorted(a) == sorted(b) and works with unhashable objs assertDictContainsSubset(a, b) all the key/value pairs in a exist in b assertMultiLineEqual(a, b) strings assertSequenceEqual(a, b) sequences assertListEqual(a, b) lists assertTupleEqual(a, b) tuples 参考文章: 官方文档 Python必会的单元测试框架 —— unittest 廖雪峰

优秀的个人博客,低调大师

js笔记

1.window.open(''url'') 2.用自定义函数 <script> functionopenWin(tag,obj) { obj.target="_blank"; obj.href="Web/Substation/Substation.aspx?stationno="+tag; obj.click(); } </script> <ahref="javascript:void(0)"onclick="openWin(3,this)">株洲</a> 3、window.location.href="" checkbox选中 4、有以下一组checkbox列,在修改页面上如何根据从数据库里获取的数据来设置这里的checkbox选中与否: 这个提交到数据库后数据格式是这样子的:1, 2, 3, 5, 8, 9, 12 假设此字段为strB,假设checkbox的name="A" 下边的js脚本就是实现默认选中的: <script language="JavaScript"> <!-- var B="<%=strB%>"; with(document.form1) { for (i=0;i<A.length ;i ) { tmpB=B.split(", "); for (j=0;j<tmpB.length ;j ) { if(tmpB[j]==A[i].value) {A[i].checked=true;break;} } } } //--> </script> 本文转自 00_yatou 51CTO博客,原文链接:http://blog.51cto.com/ql0722/1656011,如需转载请自行联系原作者

优秀的个人博客,低调大师

hue笔记

创建Hue用户 建议为hue创建专职的用户,同时将/usr/local/hue的group和owner设给hue用户: groupadd hue useradd -g hue hue chown -R hue:hue /usr/local/hue 1 2 3 启动 启动: sudo -u hue nohup /usr/local/hue/build/env/bin/supervisor & 1 停止: pkill -U hue 1 常见问题 HUE页面提示:The app won’t work without a running Livy Spark Server Livy Server是Spark的Rest API服务,官方文档: https://github.com/cloudera/hue/tree/master/apps/spark/java 我们可以使用: sudo -u hue nohup /usr/local/hue/build/env/bin/hue livy_server & 1 来启动它,但是在启动前你需要了解它对Spark的版本依赖。Hue3.9中的Livy Server需要Spark 1.4,而HDP2.3安装的是Spark 1.3,也就是说如果你安装是的HDP,现在还不能在Hue上使用Spark,为了避免HUE页面上报:Spark The app won’t work without a running Livy Spark Server的错误提示,我们可以禁用Spark模块,同样是编辑hue.ini文件: app_blacklist=impala,security,spark 1 2 HUE页面报错:/wsgiserver.py line 1196 in communicatereq.respond() 如果打开HUE页面时出现: Traceback (most recent call last): File “/usr/local/hue/desktop/core/src/desktop/lib/wsgiserver.py”, line 1196, in communicate req.respond() 很有可能是早先使用rpm安装旧版本的Hue之后没有完全卸载干净的原因,除了检查相关文件是否已经彻底删除之外,务必删除早先建立的hue用户和用户组。 本文转自 yntmdr 51CTO博客,原文链接:http://blog.51cto.com/yntmdr/1747148,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop笔记

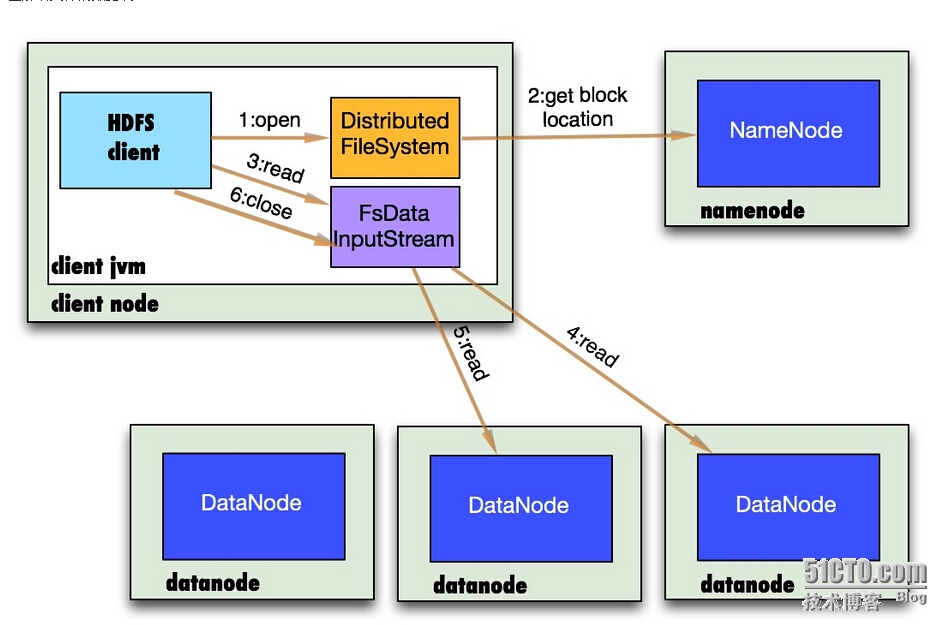
一、hadop的项目 Common:一系列组件和接品口,用于分布式文件系统和通用I/O(序列化,Java RPC 和持久化数据结构) Avro:一种序列化系统,用于支技高效,跨语言的RPC和持久化的数据存储 MapRedue:分布式数据处理模型和执行环境,运行于大型商用机集群 HDFS:分布式文件系统,运行于大型商用机集群 Pig:数据流语言和运行环境,用以探究非常庞大的的数据集。Pig运行在MapReduce和HDFS集群上 Hive:一种分布式,按列存储的数据仓库。Hive管理HDFS中存储数据,并提供基于SQL的查询语言(由运行时引擎翻译成MapReduce作业)用以查询数据 HBase:一种分布式,按列存储的数据库。HBase使用HDFS作为底层存储,同时支MapReduce的批量式计算和点查询(随机读取) Zookeeper:一种分布式,可用性高的协调服务。Zeekeeper提供分布式锁之类的基本服务用于构建分布式应用。 Sqooq:该工具用于在结构化数据存储(如关系型数据库)和HDFS之间高效批量传输数据。 Oozie:该服务用于运行和调度Hadoop作业(如MapReduce,Pig,Hive及sqoop)。 二、hadoop分布式文件系统 1、HDFS设计 存府超大文件 流式数据访问(一次写入多次读取) 商用硬件(不需要豪华配置) 低时间延迟的数据访问 大量的小文件 多用户写入,任意修改文件 2、数据块 磁盘一般512字节 HDFS默认64M 与其他文件系统不同的是,HDFS中小于一块大小的文件不会占据整个块的空间 HDFS的块比磁盘的块大,主要为了最小化寻址开销 块抽象好处。(一,一个文件的大小可以大于网络任意一个磁盘的容量。因为文件的所有块并不需要存储在同一个磁盘上。二,使用抽象块而非整个文件作为存储单元,简化了存储子系统的设计。三,块适用于数据备份,提供数据容错能力和提高可用性) 三、namenode和datanode HDFS以管理者-工作者模式运行,一个NN和多个DN,NM管理文件系统的命名空间,维护着文件系统树及整棵树内的所有文件和目录。这些信息保存在(命名镜像文件)和(编辑日志文件);存储元数据与文件到数据块映射的地方 DN是文件系统工作节点,存储并检索数据块,定期向NN发送它们存储块列表。 NN很重要,如果运行NM服务器损块,文件系统上的所有文件将会丢失。所以对NM容错,提供两种机制。一,备份那些组成文件系统元数据持久状态文件。hadoop可以配置使NN在多个文件系统上保存元数据的持久状态。写操作实时同步,是原子操作。一般配置,将持久状态写入本地磁盘的同时,写入一个远程挂载的网络文件系统(NFS)。二; 运行一个辅助NN,但它不能被用作NN,这个辅助NN的重要作用是定期通过编辑日志合并命名空间镜像,以防止编辑日志过大。这个SNN一般在另一台单独的无力计算机上运行,以为他需要占用大量的cpu和NN相同容量的内存来执行合并操作。它会保存合并后的命名空间镜像的副本,并在NN发生故障时启用。但是SNN滞后与NN,所以如果NN全部失效,难免会丢失部分数据。在这种情况下,一般把存储在NFS上的NN元数据复制到SNN并作为新的NN运行。 四、网络拓扑与hadoop 将两个节点间带宽作为距离的衡量标准,以下场景,可以可用带宽依次递减 同一节点上进程 同一机架上的不同节点 同一数据中心不同机架上的节点 不同数据中心的节点 五、数据流 1、剖析文件读取 客户端调用FileSystem 对象的open()方法来打开希望读取的文件, 1.首先调用FileSystem对象的open方法,其实是一个DistributedFileSystem的实例 2.DistributedFileSystem通过rpc获得文件的第一批个block的locations,同一block按照重复数会返回多个locations,这些locations按照hadoop拓扑结构排序,距离客户端近的排在前面. 3.前两步会返回一个FSDataInputStream对象,该对象会被封装成DFSInputStream对象,DFSInputStream可以方便的管理datanode和namenode数据流。客户端调用read方法,DFSInputStream最会找出离客户端最近的datanode并连接(参考第一小节)。 4.数据从datanode源源不断的流向客户端。 5.如果第一块的数据读完了,就会关闭指向第一块的datanode连接,接着读取下一块。这些操作对客户端来说是透明的,客户端的角度看来只是读一个持续不断的流。 6.如果第一批block都读完了,DFSInputStream就会去namenode拿下一批blocks的location,然后继续读,如果所有的块都读完,这时就会关闭掉所有的流。 如果在读数据的时候,DFSInputStream和datanode的通讯发生异常,就会尝试正在读的block的排第二近的datanode,并且会记录哪个datanode发生错误,剩余的blocks读的时候就会直接跳过该datanode。DFSInputStream也会检查block数据校验和,如果发现一个坏的block,就会先报告到namenode节点,然后DFSInputStream在其他的datanode上读该block的镜像 该设计的方向就是客户端直接连接datanode来检索数据并且namenode来负责为每一个block提供最优的datanode,namenode仅仅处理block location的请求,这些信息都加载在namenode的内存中,hdfs通过datanode集群可以承受大量客户端的并发访问。 2、剖析文件写入 客户端通过调用DistributedFileSystem的create方法创建新文件 DistributedFileSystem通过RPC调用namenode去创建一个没有blocks关联的新文件,创建前,namenode会做各种校验,比如文件是否存在,客户端有无权限去创建等。如果校验通过,namenode就会记录下新文件,否则就会抛出IO异常. 前两步结束后会返回FSDataOutputStream的对象,象读文件的时候相似,FSDataOutputStream被封装成DFSOutputStream.DFSOutputStream可以协调namenode和datanode。客户端开始写数据到DFSOutputStream,DFSOutputStream会把数据切成一个个小packet,然后排成队列data quene。 DataStreamer会去处理接受data quene,他先问询namenode这个新的block最适合存储的在哪几个datanode里(参考第二小节),比如重复数是3,那么就找到3个最适合的datanode,把他们排成一个pipeline.DataStreamer把packet按队列输出到管道的第一个datanode中,第一个datanode又把packet输出到第二个datanode中,以此类推。 DFSOutputStream还有一个对列叫ack quene,也是有packet组成,等待datanode的收到响应,当pipeline中的所有datanode都表示已经收到的时候,这时akc quene才会把对应的packet包移除掉。 如果在写的过程中某个datanode发生错误,会采取以下几步:1) pipeline被关闭掉;2)为了防止防止丢包ack quene里的packet会同步到data quene里;3)把产生错误的datanode上当前在写但未完成的block删掉;4)block剩下的部分被写到剩下的两个正常的datanode中;5)namenode找到另外的datanode去创建这个块的复制。当然,这些操作对客户端来说是无感知的。 客户端完成写数据后调用close方法关闭写入流 DataStreamer把剩余得包都刷到pipeline里然后等待ack信息,收到最后一个ack后,通知datanode把文件标示为已完成。 六、hadoop的I/O操作 1、HDFS的数据完整性 HDFS对写入的所有数据计算校验和,并在读取数据时验证交验和,它针对每个由io.bytes.per.checksum指定字节的数据计算校验和。默认512字节,由于CRC-32校验和是4个字节,所以存储校验和的额外开销低于1% 客户端在读取数据块时,如果检测到错误,首先向namenode报告已损坏的数据块及其正在尝试读操作的这个datanode,再抛出ChecksumException异常。namenode将这个数据块复本标记为已损坏,因此,它将不会处理请求直接发送到这个节点,或尝试将这个复本复制到另一个datanode。之后,安排这个数据块的一个复本复制到另一个datanode。 2、序列化 序列化是指将结构化对象转化为字节流以便在网络上传输的或写到磁盘进行永久存储过程。反序列是指将字节流转回结果化的逆向过程。 序列化在分布式数据处理的两大领域常出现:进程间通信和永久存储。 hadoop中,系统中多个节点上进程间通信是通过“远程过程调用(remote procedure call,RPC)实现”,RPC序列化格式如下 紧凑 紧凑格式能充分利用网络带宽(数据中心最稀缺的资源) 快速 进程间通信形成了分布式系统的骨架,尽量减少序列化和反序列的性能开销 可扩展 满足新需求,协议不断变化 支持互操作 支技以不同语言写的客户端与服务器交互 hadoop使用自己序列化格式writable,紧凑,速度化。但不太容易用java以外语言进行扩燕尾服或使用。Writable是hadoop核心(大多数的MapReduce程序都为会键和值使用它) 本文转自 zouqingyun 51CTO博客,原文链接:http://blog.51cto.com/zouqingyun/1710619,如需转载请自行联系原作者

优秀的个人博客,低调大师

【开发者笔记】MQTT python测试笔记

MQTT是基于订阅/发布的物联网协议。 python测试需要一个发送进程和接收进程,即一个发送客户端和一个接收客户端,如果这两个客户端工作在同一个topic下,那么就能进行消息互通了。 服务器用“iot.eclipse.org”就好了,避免了自己搭建服务器,然后流程还可以跑通。 发送客户端代码: import paho.mqtt.client as mqtt import paho.mqtt.publish as publish idx = 0#往paho/temperature 一直发送内容 while True: print("send success") publish.single("paho/temperature", payload="this is message:%s"%idx, hostname="iot.eclipse.org", client_id="lora1", # qos = 0, # tls=tls, port=1883, protocol=mqtt.MQTTv311) idx += 1 接收客户端代码: import paho.mqtt.client as mqtt # The callback for when the client receives a CONNACK response from the server. def on_connect(client, userdata, flags, rc): print("Connected with result code "+str(rc)) # The callback for when a PUBLISH message is received from the server. def on_message(client, userdata, msg): #在这里处理业务逻辑 print(msg.topic+" "+str(msg.payload)) client = mqtt.Client() client.on_connect = on_connect client.on_message = on_message client.connect("iot.eclipse.org", 1883, 60)#订阅频道 client.subscribe("paho/temperature") # Blocking call that processes network traffic, dispatches callbacks and # handles reconnecting. # Other loop*() functions are available that give a threaded interface and a # manual interface. client.loop_forever() 然后运行两个客户端,就可以在接收端收到消息了。 MQTT服务器不负责存储数据,需要编写额外的接收客户端来接收数据、分析、入库等。 MQTT服务器用的是iot.eclipse.org,如果碰巧两个人在用同一个频道,那可能收到别人的消息哦~ 如果要搭建自己的MQTT服务器,那么回头再说。 玩一玩就好了,不要给服务器增加太多负担哟~ 参考资料: paho-qtt说明文档 黑夜给了我黑色的眼睛,我却用它寻找光明

优秀的个人博客,低调大师

Flume学习笔记

Flume [fluːm] (引水槽、运河) 王洪亮 2021/05/07 15:05 1. 简介 大数据技术解决的三个问题,海量数据的传输、存储和计算。Flume属于传输框架。专门传输日志的,多媒体不行。 2.安装 官网 http://flume.apache.org/ 下载apache-flume-1.9.0-bin.tar.gz,下载后解压即可,类似tomcat中间件,需要改配置文件 , 把apache-flume-1.9.0-bin/conf/flume-env.sh.template改成flume-env.sh,里面配置jdk地址,安装完毕。 export JAVA_HOME=D:\sde\Java\jdk1.8.0_131 3.Hello Flume样例 flume是按任务启动的,这个任务在flume这里叫agent,每个agent分为三块,source(对接数据来源)、channel(中间缓冲区)、sink(数据去向)。任务过程简述就是从一个地方采集数据后送到其他地方。 此次案例source数据采集自端口,通过channel再经过sink将数据输出到终端屏幕上。 开始编写Hello Flume样例(win环境) 编写配置文件,参考官网例子 习惯上把任务的配置文件和conf区分开,这里新建jobs目录下新建netcat-flume-logger.conf,命名格式最好区分出source和sink的类型 #完整的conf分几块,变量声明区、source区、interceptor区、channelSelector区、channel区、sink区、关系绑定区 #变量声明区(必须) a1指的是agent的变量名,启动时指定 #分别声明 sources、channels、sinks、sinkgroups等 a1.sources = r1 a1.channels = c1 a1.sinks = k1 #source区(必须) 指定source类型 具体类型需要看官网文档source 部分 a1.sources.r1.type = netcat a1.sources.r1.bind = localhost a1.sources.r1.port = 44444 #interceptor区(可选),代码自写,配合multiplexing channelSelector使用 #channelSelector区(可选),不写默认是replicating,把数据发给每个sink a1.sources.r1.selector.type=replicating #channel区(必须) 指定channel类型 具体类型需要看官网文档channel部分 a1.channels.c1.type = memory #sink处理器区,声明sink组,选择处理器是故障转移还是负载均衡,不写就是默认 #sink区(必须) 指定sink类型 具体类型需要看官网文档sink部分 a1.sinks.k1.type = logger #关系绑定区(必须) a1.sources.r1.channels = c1 a1.sinks.k1.channel = c1 启动flume的agent #win环境启动命令 进入到bin目录 cmd flume-ng agent --conf ../conf --conf-file ../jobs/netcat-flume-logger.conf --name a1 -property flume.root.logger=INFO,console #简写 flume-ng agent -c ../conf -f ../jobs/netcat-flume-logger.conf -n a1 -property flume.root.logger=INFO,console #linux环境启动命令 那个logger不一样 #-Dflume.root.logger=INFO,console 启动结果显示端口已监听 [INFO - org.apache.flume.source.NetcatSource.start(NetcatSource.java:166)] Created serverSocket:sun.nio.ch.ServerSocketChannelImpl[/127.0.0.1:44444] 通过netcat工具向端口发送数据 没有netcat telnet 也可以 nc localhost 44444 > Hello Flume OK 查看flume的日志输出 [INFO - org.apache.flume.sink.LoggerSink.process(LoggerSink.java:95)] Event: { headers:{} body: 48 65 6C 6C 6F 20 46 6C 75 6D 65 Hello Flume } 4.Source种类 拉出几个常用的。其他的查看官方文档 1.Avro Source Flume集群使用,多个Fulme连接需要使用Avro的source和sink连接,自身相当于服务端,需要优先启动 #相关source区 写法 a1.sources.r1.type=avro a1.sources.r1.bind=0.0.0.0 a1.sources.r1.port=4141 2. Exec Source 用命令监控某个文件的变化,将变化的内容传送走,适用于监控一个实时变化的日志文件,缺点是不能断点续传,容易数据丢失或是数据重复 #相关source区 写法 a1.sources.r1.type=exec #后跟 监控文件的命令 a1.sources.r1.command=tail -F /var/log/secure 3. Spooling Directory Source 监控本地文件夹,文件夹中新增文件时,会将整个文件内容取走,并加后缀做标记(.COMPLETED),表示已经取过了,标记后的文件不在处理,内容变化也不管。适用于批量上传,缺点是不能适应动态变化的文件 #相关source区 写法 a1.sources.r1.type=spooldir #后跟监控文件的目录 a1.sources.r1.spoolDir=/var/log/apache/flumeSpool 4. Taildir Source 可以监控不同文件夹下的不同文件。支持断点续传 #相关source区 写法 a1.sources.r1.type = TAILDIR #指定保存断点续传的文件 a1.sources.r1.positionFile = /var/log/flume/position.json #指定文件组 可以多个 a1.sources.r1.filegroups = f1 f2 #指定 单个文件 a1.sources.r1.filegroups.f1 = /var/log/test1/example.log #指定多个文件 * 不能出现在第一位 a1.sources.r1.filegroups.f2 = /var/log/test2/.*log.* 5. NetCat TCP Source 监听TCP端口用的,还有个UDP Source 就type不一样 #相关source区 写法 udp 的type是netcatudp a1.sources.r1.type=netcat a1.sources.r1.bind=0.0.0.0 a1.sources.r1.port=6666 5.Channel种类 常用的Memory Channel和File Channel 1. Memory Channel 将数据缓存在内存中,快,闪断丢数据 #channel区 a1.channels.c1.type=memory 2. File Channel 将数据缓存在本地文件中,慢点,稳定 #channel区 a1.channels.c1.type=file #数据存放的目录,可以有多个目录,逗号分割 a1.channels.c1.dataDirs=/mnt/flume/data 6.Sink种类 常用的拉出 1. Avro Sink Flume集群收尾连接,相对source 而言这个算客户端,去绑定服务端IP和端口 #sink 区 a1.sinks.k1.type = avro a1.sinks.k1.hostname = 10.10.10.10 a1.sinks.k1.port = 4545 2. Logger Sink 日志打印在终端屏幕上,需要agent启动的时候搭配对应命令 问题:中文没打出来;maxBytesToLog这玩意不好使 #sink区 #-property flume.root.logger=INFO,console #-Dflume.root.logger=INFO,console a1.sinks.k1.type=logger 3. File Roll Sink 日志输出到本地文件,问题是就算没有接收到数据,也会不停的生成新的空文件 #sink区 a1.sinks.k2.type = file_roll #指定生成文件夹路径,文件名会自动生成 a1.sinks.k2.sink.directory = ../data/ #指定新文件生成频率,30s a1.sinks.k2.sink.rollInterval = 30 7.Channel Selector 这个就俩,算自定义的三个 1. Replicating Channel Selector (default) 默认的,可以不写,把数据发给所有sink #channel selector 区 a1.sources.r1.selector.type=replicating 2. Multiplexing Channel Selector 根据拦截器规则,选择发送到哪个sink #channel selector 区 a1.sources.r1.selector.type = multiplexing #这个关键变量,拦截器里写的,写什么是什么,不一定是state a1.sources.r1.selector.header = state #根据这个state的值选择sink,如果header中的state=CZ就发个c1 a1.sources.r1.selector.mapping.CZ = c1 # 等于US就给c2 c3 a1.sources.r1.selector.mapping.US = c2 c3 8.Sink Processor 目前算默认的三种,默认的数据给谁,谁就发走 1. Failover Sink Processor 故障转移,根据优先级,可着最高优先级的用,挂了再用优先级低的 #sink处理器区 #这个算声明,可以拿到声明区 a1.sinkgroups = g1 a1.sinkgroups.g1.sinks = k1 k2 #选择处理器类型为 故障转移 a1.sinkgroups.g1.processor.type = failover #指定sink组成员优先级 a1.sinkgroups.g1.processor.priority.k1 = 5 #最高等级k2一直使用,直到挂了为止,才能轮到k1 a1.sinkgroups.g1.processor.priority.k2 = 10 2. Load balancing Sink Processor 负载均衡,可选随机或是均衡发送 #sink处理器区 #这个算声明,可以拿到声明区 a1.sinkgroups = g1 a1.sinkgroups.g1.sinks = k1 k2 #选择处理器类型为 负载均衡 a1.sinkgroups.g1.processor.type = load_balance #指定模式为随机发送,还可以选round_robin均衡发送 a1.sinkgroups.g1.processor.selector = random 9.自定义Inteceptor idea新建maven项目开整 \> hello 1. 引入依赖 <dependency> <groupId>org.apache.flume</groupId> <artifactId>flume-ng-core</artifactId> <version>1.9.0</version> </dependency> 2. 写自己的拦截器 package com.flume; import org.apache.flume.Context; import org.apache.flume.Event; import org.apache.flume.interceptor.Interceptor; import java.util.HashMap; import java.util.List; import java.util.Map; public class MyInterceptor implements Interceptor { @Override public void initialize() { System.out.println("---------initialize---------"); } @Override public Event intercept(Event event) { String body = new String(event.getBody()); Map<String, String> map = new HashMap<>(); if(body.contains("hello")){ map.put("myStatus","up"); event.setHeaders(map); }else{ map.put("myStatus","down"); event.setHeaders(map); } return event; } @Override public List<Event> intercept(List<Event> list) { return null; } @Override public void close() {} public static class MyBuilder implements Interceptor.Builder{ @Override public Interceptor build() { return new MyInterceptor(); } @Override public void configure(Context context) {} } } 3. 项目打个jar包放到Flume的lib目录下 4. 编写Flume配置文件 netcat-flume-doubleLogger.conf,本来想两个sink都发到logger的,后来发现终端上分不出哪个是哪个,把其中一个sink改到落到本地文件了 #变量区 a1.sources = r1 a1.channels = c1 c2 a1.sinks = k1 k2 #source区 a1.sources.r1.type = netcat a1.sources.r1.bind = localhost a1.sources.r1.port = 44444 #intercetor区 a1.sources.r1.interceptors = i1 a1.sources.r1.interceptors.i1.type = com.flume.MyInterceptor$MyBuilder #channel selector 区 a1.sources.r1.selector.type = multiplexing #我代码里定义的是 myStatus a1.sources.r1.selector.header = myStatus #myStatus=up就发个c1 a1.sources.r1.selector.mapping.up = c1 # 等于down就给c2 a1.sources.r1.selector.mapping.down = c2 #channel区 a1.channels.c1.type = memory a1.channels.c2.type = memory #sink区 a1.sinks.k1.type = logger a1.sinks.k2.type = file_roll a1.sinks.k2.sink.directory = ../data/ #绑定区 a1.sources.r1.channels = c1 c2 a1.sinks.k1.channel = c1 a1.sinks.k2.channel = c2 5. 启动 flume-ng agent --conf ../conf --conf-file ../jobs/netcat-flume-doubleLogger.conf --name a1 -property flume.root.logger=INFO,console 6. 测试效果 启动netcat发送命令 > nc localhost 44444 6351 OK hello OK 一个在终端屏幕上有显示,一个在本地文件中有显示。 10自定义Source 1. 依赖 <dependency> <groupId>org.apache.flume</groupId> <artifactId>flume-ng-core</artifactId> <version>1.9.0</version> </dependency> 2. 代码 package com.flume; import org.apache.flume.Context; import org.apache.flume.Event; import org.apache.flume.PollableSource; import org.apache.flume.conf.Configurable; import org.apache.flume.event.SimpleEvent; import org.apache.flume.source.AbstractSource; public class MySource extends AbstractSource implements Configurable, PollableSource { private String aaa; private String bbb; /** * 定义配置文件中的变量 * @param context */ @Override public void configure(Context context) { aaa = context.getString("aaa"); //没取到值 就给默认值 bbb = context.getString("bbb", "GangZi"); } @Override public Status process(){ Status status = null; try { //创建个事件 Event e = new SimpleEvent(); String content = aaa+"->"+bbb+": "+Math.random(); e.setBody(content.getBytes("utf-8")); //把event传给channel getChannelProcessor().processEvent(e); status = Status.READY; } catch (Throwable t) { status = Status.BACKOFF; if (t instanceof Error) { throw (Error)t; } } try { //睡两秒 要不刷的太快了 Thread.sleep(2000); } catch (InterruptedException e) { e.printStackTrace(); } return status; } @Override public long getBackOffSleepIncrement() { return 0; } @Override public long getMaxBackOffSleepInterval() { return 0; } } 3. 写配置文件custom-flume-logger.conf #变量区 a1.sources = r1 a1.channels = c1 a1.sinks = k1 #source区 a1.sources.r1.type = com.flume.MySource a1.sources.r1.aaa = LiLei #a1.sources.r1.bbb = HanMeiMei #channel区 a1.channels.c1.type = memory #sink区 a1.sinks.k1.type = logger a1.sinks.k1.maxBytesToLog = 18 #绑定区 a1.sources.r1.channels = c1 a1.sinks.k1.channel = c1 4. 启动命令 flume-ng agent --conf ../conf --conf-file ../jobs/custom-flume-logger.conf --name a1 -property flume.root.logger=INFO,console 5. 查看效果 [INFO - org.apache.flume.sink.LoggerSink.process(LoggerSink.java:95)] Event: { headers:{} body: 4C 69 4C 65 69 2D 3E 47 61 6E 67 5A 69 3A 20 30 LiLei->GangZi: 0 } 11自定义Sink 1. 依赖 <dependency> <groupId>org.apache.flume</groupId> <artifactId>flume-ng-core</artifactId> <version>1.9.0</version> </dependency> 2. 代码 package com.flume; import org.apache.flume.*; import org.apache.flume.conf.Configurable; import org.apache.flume.sink.AbstractSink; public class MySink extends AbstractSink implements Configurable { private String ccc; private String ddd; @Override public void configure(Context context) { ccc = context.getString("ccc"); ddd = context.getString("ddd","xxxxxxxx"); } @Override public Status process() throws EventDeliveryException { Status status = null; Channel ch = getChannel(); Transaction txn = ch.getTransaction(); txn.begin(); try { Event event = ch.take(); if(event == null){ txn.rollback(); status = Status.BACKOFF; }else { byte[] body = event.getBody(); String content = new String(body); System.out.println("ccc="+ccc); System.out.println("content="+content); System.out.println("ddd="+ddd); txn.commit(); status = Status.READY; } } catch (Exception e) { e.printStackTrace(); txn.rollback(); status = Status.BACKOFF; }finally { txn.close(); } return status; } } 3. flume配置文件netcat-flume-custom.conf #变量区 a1.sources = r1 a1.channels = c1 a1.sinks = k1 #source区 a1.sources.r1.type = netcat a1.sources.r1.bind = localhost a1.sources.r1.port = 44444 #channel区 a1.channels.c1.type = memory #sink区 a1.sinks.k1.type = com.flume.MySink a1.sinks.k1.ccc =--hello-- a1.sinks.k1.ddd =--moto-- #绑定区 a1.sources.r1.channels = c1 a1.sinks.k1.channel = c1 4. 启动agent flume-ng agent --conf ../conf --conf-file ../jobs/netcat-flume-custom.conf --name a1 -property flume.root.logger=INFO,console 5. 客户端发送命令 telnet localhost 44444 > 1 OK 6. flume终端打印 ccc=--hello-- content=1 ddd=--moto-- 12.Flume监控工具 下面的实验,windows环境下怎么跟多个参数 不知道 1.Http监控,json形式文本 使用这种监控方式,只需要在启动flume的时候在启动参数上面加上监控配置,例如这样: bin/flume-ng agent --conf conf --conf-file conf/flume_conf.properties --name collect -Dflume.monitoring.type=http -Dflume.monitoring.port=1234 其中-Dflume.monitoring.type=http表示使用http方式来监控,后面的-Dflume.monitoring.port=1234表示我们需要启动的监控服务的端口号为1234,这个端口号可以自己随意配置。然后启动flume之后,通过http://ip:1234/metrics就可以得到flume的一个json格式的监控数据。 2.ganglia监控,图形化界面 这种监控方式需要先安装ganglia然后启动ganglia,然后再启动flume的时候加上监控配置,例如: bin/flume-ng agent --conf conf --conf-file conf/producer.properties --name collect -Dflume.monitoring.type=ganglia -Dflume.monitoring.hosts=ip:port 其中-Dflume.monitoring.type=ganglia表示使用ganglia的方式来监控,而-Dflume.monitoring.hosts=ip:port表示ganglia安装的ip和启动的端口号。 flume监控还可以使用zabbix,但是这种方式需要在flume源码中添加监控模块,相对比较麻烦,由于不是flume自带的监控方式,这里不讨论这种方式。 因此,flume自带的监控方式其实就是http、ganglia两种,http监控只能通过一个http地址访问得到一个json格式的监控数据,而ganglia监控是拿到这个数据后用界面的方式展示出来了,相对比较直观。

优秀的个人博客,低调大师

HTML 学习笔记

基本框架 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <meta http-equiv="X-UA-Compatible" content="ie=edge"> <title>标题</title> </head> <body> </body> </html> 可打开 .html 文件,直接输入 html:5 调出 语句 一些规范: 标签使用小写,元素必须闭合 空元素要加斜杠以闭合 eg. <br /> 不使用语义化,所有样式都存放于 CSS 中,内容与样式分离 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <meta http-equiv="X-UA-Compatible" content="ie=edge"> <title>标题</title> </head> <body> <h1>一级标题</h1> <h2>二级标题</h2> <p>段落</p> <!--换行符--> <br /> <!--分割线--> <hr /> <!--列表,可嵌套--> <!--有序列表--> <ol> <li>第一项</li> <li>第二项</li> </ol> <!--无序列表--> <ul> <li>第一项</li> <li>第二项</li> </ul> <!--链接--> <a href="https://www.google.com/">链接显示的文本</a> <!--链接到页面特定位置,使用 ID 特性--> <a href="#top">回到顶部</a> <p id="top">顶部</p> <!--链接到其他页面的特定位置--> <a href="http://wiki-power.com/#top">跳转到站外页面的某个位置</a> <!--图像--> <img src="/xx.png" alt="无法加载时的文字说明" /> <!--表格--> <table> <!--第一行--> <tr> <!--第一列--> <th></th> <!--第二列--> <th scope="col">周六</th> <!--第三列--> <th scope="col">周日</th> </tr> <!--第二行--> <tr> <th scope="row">数量</th> <td>120</td> <td>135</td> </tr> <!--第三行--> <tr> <th scope="row">收益</th> <!--跨列 colspan,跨行 rowspan--> <td colspan="2">500</td> </tr> </table> <!--表单,待补充--> <!--iframe,待补充--> <!--flash/视频/音频,待补充--> </body> </html> 参考与致谢 HTML 教程 | 菜鸟教程 HTML 30 分钟入门教程 HTML - head 头部浅析 文章作者:Power Lin 原文地址:https://wiki-power.com 版权声明:文章采用 CC BY-NC-SA 4.0 协议,转载请注明出处。

优秀的个人博客,低调大师

Flink学习笔记

Flink 基础 Flink特性 流式计算是大数据计算的痛点,第1代实时计算引擎Storm对Exactly Once 语义和窗口支持较弱,使用的场景有限且无法支持高吞吐计算;Spark Streaming 采用“微批处理”模拟流计算,在窗口设置很小的场景中有性能瓶颈,Spark 本身也在尝试连续执行模式(Continuous Processing),但进展缓慢。 Flink是一个低延迟、高吞吐的实时计算引擎,其利用分布式一致性快照实现检查点容错机制,并实现了更好的状态管理,Flink可在毫秒级的延迟下处理上亿次/秒的消息或者事件,同时提供了一个Exactly-once的一致性语义,保证了数据的正确性,使得Flink可以提供金融级的数据处理能力,总结其高级特性包括CSTW(CheckPoint,Statue,Time,windows) Flink和Spark对比 设计思路 Spark的技术理念是基于批来模拟流,微批处理的延时较高(无法优化到秒以下的数量级),且无法支持基于event_time的时间窗口做聚合逻辑。Flink和spark相反,它基于流计算来模拟批计算,更切合数据的生成方式,技术上有更好的扩展性。 状态管理 流处理任务要对数据进行统计,如Sum, Count, Min, Max,这些值是需要存储的,因为要不断更新,这些值或者变量就可以理解为一种状态,如果数据源是在读取Kafka, RocketMQ,可能要记录读取到什么位置,并记录Offset,这些Offset变量都是要计算的状态。 Flink提供了内置的状态管理,可以把这些状态存储在Flink内部,而不需要把它存储在外部系统,这样做的好处: ① 降低了计算引擎对外部系统的依赖以及部署,使运维更加简单; ② 对性能带来了极大的提升:如果通过外部去访问如Redis , HBase 需要网络及RPC资源,如果通过Flink内部去访问,只通过自身的进程去访问这些变量。 同时Flink会定期将这些状态做Checkpoint持久化,把Checkpoint存储到一个分布式的持久化系统中,比如HDFS,这样当Flink的任务出现任何故障时,它都会从最近的一次Checkpoint将整个流的状态进行恢复,然后继续运行它的流处理,对用户没有任何数据上的影响。 Flink 初探 设计架构 Flink是一个分层的架构系统,每一层所包含的组件都提供了特定的抽象,用来服务于上层组件,Flink的分层体现有四层,分别是Deploy层、core层、API层/Libraries层,其中Deploy层主要涉及的是Flink的部署模式及同资源调度组件的交互模式,Core层提供了支持Flink计算的全部核心实现,API层/Libraries层提供了Flink的API接口和基于API接口的特定应用的计算框架; Deploy层:该层主要涉及了Flink的部署模式,Flink支持多种部署模式:本地、集群(Standalone/YARN)、云(GCE/EC2),Standalone 部署模式与Spark类似; Runtime层:Runtime层提供了支持Flink计算的全部核心实现,比如:支持分布式Stream处理、Job Graph到Execution Graph的映射、调度 等,为上层API层提供基础服务。 API层:API层主要实现了面向无界Stream的流处理和面向Batch的批处理API,其中面向流处理对应DataStream API,面向批处理对应DataSet API。 Libraries层:该层也可以称为Flink应用框架层,根据API层的划分,在API层之上构建的满足特定应用的实时计算框架,也分别对应于面向流处理 和面向批处理两类。面向流处理支持:CEP(复杂事件处理)、SQL-like的操作(基于Table的关系操作);面向批处理支持:FlinkML(机器学习库)、Gelly(图处理)。 Flink on yarn Flink支持增量迭代,具有对迭代自行优化的功能,因此在on yarn上提交的任务性能略好于 Spark,Flink提供2种方式在yarn上提交任务:启动1个一直运行的 Yarn session(分离模式)和在 Yarn 上运行1个 Flink 任务(客户端模式); 分离模式:通过命令yarn-session.sh的启动方式本质上是在yarn集群上启动一个flink集群,由yarn预先给flink集群分配若干个container,在yarn的界面上只能看到一个Flink session with X TaskManagers的任务,并且只有一个Flink界面,可以从Yarn的Application Master链接进入; 客户端模式:通过命令bin/flink run -m yarn-cluster启动,每次发布1个任务,本质上给每个Flink任务启动了1个集群,yarn在任务发布时启动JobManager(对应Yarn的AM)和TaskManager,如果一个任务指定了n个TaksManager(-yn n),则会启动n+1个Container,其中一个是JobManager,发布m个应用,则有m个Flink界面,不同的任务不可能在一个Container(JVM)中,实现了资源隔离。 进入Flink的bin目录下运行./yarn-session.sh –help 查看帮助验证yarn是否成功配置,使用./yarn-session.sh –q 显示yarn所有nodeManager节点资源;部署On yarn模式的Flink只需要修改配置conf/flink-conf.yaml ,详细参数请参考官网:通用配置:Configuration,HA配置:High Availability (HA) 采用分离模式来启动Flink Yarn Session,提交后提示该yarn application成功提交到yarn并返回id,使用yarn application –kill application_id 来停止yarn上提交的任务; yarn-session.sh -n 3 -jm 700 -tm 700 -s 8 -nm FlinkOnYarnSession -d –st 可以直接提交自带的词频统计用例,验证on yarn模式是否配置成功: ~/bin/flinkrun-myarn-cluster-yn4-yjm2048-ytm2048~/flink/examples/batch/WordCount.jar 流程分析 分离模式:通过命令yarn-session.sh先启动集群,然后再提交作业,接着会向yarn申请一块空间后,资源永远保持不变。如果资源满了,下一个作业就无法提交,只能等到yarn中的其中一个作业执行完成后,释放了资源,下个作业才会正常提交。所有作业共享Dispatcher和ResourceManager;共享资源;适合规模小执行时间短的作业。 客户端模式: 通过命令bin/flink run -m yarn-cluster提交任务,每提交一个作业会根据自身的情况,都会单独向yarn申请资源,直到作业执行完成,一个作业的失败与否并不会影响下一个作业的正常提交和运行,适合规模大长时间运行的作业; DataStream DataStream是Flink的较低级API,用于进行数据的实时处理任务,可以将该编程模型分为DataSource、Transformation、Sink三个部分; DataSource 源是程序读取输入数据的位置,可以使用 StreamExecutionEnvironment.addSource(sourceFunction) 将源添加到程序,Flink 有许多预先实现的源函数,也可以通过实现 SourceFunction 方法自定义非并行源 ,或通过实现 ParallelSourceFunction 或扩展 RichParallelSourceFunction 自定义并行源。 有几个预定义的流数据源可从 StreamExecutionEnvironment 访问: 基于文件: readTextFile(path)#逐行读取文本文件(文件符合 TextInputFormat 格式),并作为字符串返回每一行。readFile(fileInputFormat,path)#按指定的文件输入格式(fileInputFormat)读取指定路径的文件。readFile(fileInputFormat,path,watchType,interval,pathFilter)#前两个方法的内部调用方法。根据给定文件格式(fileInputFormat)读取指定路径的文件。根据 watchType,定期监听路径下的新数据(FileProcessingMode.PROCESS_CONTINUOUSLY),或者处理当前在路径中的数据并退出(FileProcessingMode.PROCESS_ONCE),使用 pathFilter,可以进一步排除正在处理的文件。 基于Socket:socketTextStream 从 Socket 读取,元素可以用分隔符分隔。 基于集合: fromCollection(Seq)#用 Java.util.Collection 对象创建数据流,集合中的所有元素必须属于同一类型;fromCollection(Iterator)#用迭代器创建数据流。指定迭代器返回的元素的数据类型;fromElements(elements:_*)#从给定的对象序列创建数据流。所有对象必须属于同一类型;fromParallelCollection(SplittableIterator)#并行地从迭代器创建数据流。指定迭代器返回的元素的数据类型;generateSequence(from,to)#并行生成给定间隔的数字序列。 自定义:addSource 附加新的源函数。例如从 Apache Kafka 中读取,可以使用 addSource(new FlinkKafkaConsumer08<>(...))。请详细查看 连接器。 Transformation Transformation操作将1个或多个DataStream转换为新的DataStream,多个转换组合成复杂的数据流拓扑,如下图所示,DataStream会由不同的Transformation操作、转换、过滤、聚合成其他不同的流,从而完成业务要求; Map:DataStream -> DataStream,一个数据元生成一个新的数据元。将输入流的元素翻倍:dataStream.map { x => x * 2 } FlatMap:DataStream -> DataStream,一个数据元生成多个数据元(可以为0)。将句子分割为单词: dataStream.flatMap{str=>str.split("")} Filter:DataStream -> DataStream,每个数据元执行布尔函数,只保存函数返回 true 的数据元。过滤掉零值的过滤器: dataStream.filter{_!=0} KeyBy :DataStream -> KeyedStream,将流划分为不相交的分区。具有相同 Keys 的所有记录在同一分区。指定 key 的取值: dataStream.keyBy("someKey")//Keybyfield"someKey"dataStream.keyBy(0)//KeybythefirstelementofaTuple Reduce :KeyedStream -> DataStream,KeyedStream 元素滚动执行 Reduce。将当前数据元与最新的一个 Reduce 值组合作为新值发送。创建 key 的值求和:keyedStream.reduce { _ + _ } Aggregations :KeyedStream -> DataStream,应用于 KeyedStream 上的滚动聚合。 Window:KeyedStream -> WindowedStream,Windows 可以在已经分区的 KeyedStream 上定义。Windows 根据某些特征(例如,在最近5秒内到达的数据)对每个Keys中的数据进行分组。更多说明参考 Windows 或 译版。 dataStream.keyBy(0).window(TumblingEventTimeWindows.of(Time.seconds(5))) WindowAll :DataStream -> AllWindowedStream,Windows 也可以在 DataStream 上定义。在许多情况下,这是非并行转换。所有记录将收集在 windowAll 算子的一个任务中。 dataStream.windowAll(TumblingEventTimeWindows.of(Time.seconds(5))) Window Apply :WindowedStream -> DataStream 或 AllWindowedStream -> DataStream,将函数应用于整个窗口。一个对窗口数据求和: windowedStream.apply{WindowFunction}allWindowedStream.apply{AllWindowFunction} Window Reduce:WindowedStream -> DataStream,Reduce 函数应用于窗口并返回结果值。windowedStream.reduce { _ + _ } Aggregations on windows:WindowedStream -> DataStream,聚合窗口内容; Union :DataStream* -> DataStream,两个或多个数据流的合并,创建包含来自所有流的所有数据元的新流。如果将数据流与自身联合,则会在结果流中获取两次数据元。 dataStream.union(otherStream1,otherStream2,...) Window Join :DataStream,DataStream -> DataStream,Join 连接两个流,指定 Key 和窗口。 dataStream.join(otherStream).where(<keyselector>).equalTo(<keyselector>).window(TumblingEventTimeWindows.of(Time.seconds(3))).apply{...} Window CoGroup :DataStream,DataStream -> DataStream,CoGroup 连接两个流,指定 Key 和窗口。 dataStream.coGroup(otherStream).where(0).equalTo(1).window(TumblingEventTimeWindows.of(Time.seconds(3))).apply{} CoGroup 与 Join 的区别:CoGroup 会输出未匹配的数据,Join 只输出匹配的数据 Connect :DataStream,DataStream -> ConnectedStreams,连接两个有各自类型的数据流。允许两个流之间的状态共享。 someStream:DataStream[Int]=...otherStream:DataStream[String]=...valconnectedStreams=someStream.connect(otherStream) 可用于数据流关联配置流; CoMap, CoFlatMap :ConnectedStreams -> DataStream,作用域连接数据流(connected data stream)上的 map 和 flatMap: Split :DataStream -> SplitStream,将数据流拆分为两个或更多个流。 Select :SplitStream -> DataStream,从 SpliteStream 中选择一个流或多个流。 valeven=splitselect"even"valodd=splitselect"odd"valall=split.select("even","odd") Iterate :DataStream -> IterativeStream -> DataStream,将一个算子的输出重定向到某个先前的算子,在流中创建 feedback 循环。这对于定义不断更新模型的算法特别有用。以下代码以流开头并连续应用迭代体。大于0的数据元将被发送回 feedback,其余数据元将向下游转发。 Project:DataStream -> DataStream,作用于元组的转换,从元组中选择字段的子集。 DataStream<Tuple3<Integer,Double,String>>in=//[...]DataStream<Tuple2<String,Integer>>out=in.project(2,0); Sink Data Sink 消费 DataStream 并转发到文件,套接字,外部系统或打印到页面。Flink 带有各种内置输出格式,封装在 DataStreams 上的算子操作后面: writeAsText() / TextOutputFormat:按字符串顺序写入文件。通过调用每个元素的 toString() 方法获得字符串。 writeAsCsv(...) / CsvOutputFormat:将元组写为逗号分隔的形式写入文件。行和字段分隔符是可配置的。每个字段的值来自对象的 toString() 方法。 print() / printToErr():在标准输出/标准错误流上打印每个元素的 toString() 值。可以定义输出前缀,这有助于区分不同的打印调用。如果并行度大于1,输出也包含生成输出的任务的标识符。 writeUsingOutputFormat() / FileOutputFormat:自定义文件输出的方法和基类。支持自定义对象到字节的转换。 writeToSocket:将元素写入 Socket,使用 SerializationSchema 进行序列化。 addSink:调用自定义接收器函数。请详细查看 连接器。 DataStream 的 write*() 方法主要用于调试目的。他们没有参与 Flink checkpoint,这意味着这些函数通常具有至少一次的语义。刷新到目标系统的数据取决于 OutputFormat 的实现,并非所有发送到 OutputFormat 的数据都会立即显示在目标系统中。此外,在失败的情况下,这些记录可能会丢失。 要将流可靠、准确地传送到文件系统,请使用 flink-connector-filesystem。通过 .addSink(...) 方法的自定义实现,可以实现在 checkpoint 中精确一次的语义。 Time 流式数据处理最大的特点是数据具有时间属性特征,Flink根据时间产生的位置不同,将时间区分为三种概念:数据生成时间(Event_time)、事件接入时间(Ingestion_time)、事件处理时间(Processing_time),用户可以根据需要选择事件类型作为流式数据的时间属性,极大增强了数据处理的灵活性和准确性; Event_time:独立事件在产生它的设备上的发生时间,这个时间通常在到达Flink之前已经嵌入到生产数据中,因此时间顺序取决于事件产生的地方,和下游的数据处理系统的事件无关,需要在Flink中指定事件的时间属性或者设定时间提取器提取事件时间; Processing_time:指在操作算子计算过程中获取到的所在主机的时间,用户选择了Processing_time后,所有和时间相关的计算算子都直接使用其所在主机的系统时间,使用Processing_time的程序性能相对较高,延时相对较低,因为其所有操作不需要做任何时间上的对比和协调; Ingestion_time:指数据接入Flink系统的时间,依赖于Source Operator所在主机的系统时钟; 一般场景中选择event_time作为事件时间戳是最贴近生产的,但大多数情况下由于数据的延迟和乱序使用processing_time; Window窗口 Windows定义和分类 在流式计算中,数据持续不断的流入计算引擎,需要一个窗口限定计算范围,比如监控场景的近2分钟或者精准计算的每隔2分钟计算一次,窗口定义了该范围,辅助完成有界范围的数据处理; Flink的DataStream API将窗口抽象成独立的Operator,且支持很多窗口算子,每个窗口算子包含Window Assigner 、Windows Function、触发器、剔除器、时延设定等部分属性,其中Window Assigner 和 Windows Function是必须要指定的属性; Window Assigner用来决定某个元素被分配到哪个/哪些窗口中去;Trigger触发器决定了一个窗口何时能够被计算或清除,每个窗口都会拥有一个自己的Trigger; Evictor驱逐者在Trigger触发之后,在窗口被处理之前,Evictor(如果有Evictor的话)会用来剔除窗口中不需要的元素,相当于一个filter。 Flink支持多种窗口类型,按照驱动类型分为:时间驱动的Time Window(如每30秒钟)和数据驱动的Count Window(如每100个事件),按照窗口的滚动方式又可以分成:翻滚窗口(Tumbling Window,无重叠),滚动窗口(Sliding Window,有重叠)和会话窗口(Session Window,活动间隙),下图可以看出分类区别: Time Window 是根据时间对数据流进行分组的,且窗口机制和时间类型是完全解耦的,也就是说当需要改变时间类型时(三种时间)不需要更改窗口逻辑相关的代码,Time Window 中常见的即为Tumbling Time Window和Sliding Time Window; Count Window 是根据元素个数对数据流进行分组的,也包括Tumbling Count Window和Sliding Count Window; Windows实现 上图中的组件都位于一个算子(window operator)中,数据流源源不断地进入算子,每一个到达的元素都会被交给 WindowAssigner,WindowAssigner 会决定元素被放到哪个或哪些窗口(window),Window本身是一个ID标识符,其内部可能存储了一些元数据,如TimeWindow中有开始和结束时间,但是并不会存储窗口中的元素。窗口中的元素实际存储在 Key/Value State 中,key为Window,value为元素集合(或聚合值)。为了保证窗口的容错性,该实现依赖了 Flink 的 State 机制。 每一个窗口都拥有一个属于自己的 Trigger,Trigger上会有定时器,用来决定一个窗口何时能够被计算或清除,每当有元素加入到该窗口,或者之前注册的定时器超时了,那么Trigger都会被调用。Trigger的返回结果可以是 continue(不做任何操作),fire(处理窗口数据),purge(移除窗口和窗口中的数据),或者 fire + purge。一个Trigger的调用结果只是fire的话,那么会计算窗口并保留窗口原样,也就是说窗口中的数据仍然保留不变,等待下次Trigger fire的时候再次执行计算。一个窗口可以被重复计算多次知道它被 purge 了。在purge之前,窗口会一直占用着内存。 当Trigger fire了,窗口中的元素集合就会交给Evictor(如果指定了的话)。Evictor 主要用来遍历窗口中的元素列表,并决定最先进入窗口的多少个元素需要被移除。剩余的元素会交给用户指定的函数进行窗口的计算。如果没有 Evictor 的话,窗口中的所有元素会一起交给函数进行计算。 计算函数收到了窗口的元素(可能经过了 Evictor 的过滤),并计算出窗口的结果值,并发送给下游。窗口的结果值可以是一个也可以是多个。DataStream API 上可以接收不同类型的计算函数,包括预定义的sum(),min(),max(),还有 ReduceFunction,FoldFunction,还有WindowFunction。WindowFunction 是最通用的计算函数,其他的预定义的函数基本都是基于该函数实现的。 Flink 对于一些聚合类的窗口计算(如sum,min)做了优化,因为聚合类的计算不需要将窗口中的所有数据都保存下来,只需要保存一个result值就可以了。每个进入窗口的元素都会执行一次聚合函数并修改result值。这样可以大大降低内存的消耗并提升性能。但是如果用户定义了 Evictor,则不会启用对聚合窗口的优化,因为 Evictor 需要遍历窗口中的所有元素,必须要将窗口中所有元素都存下来。 Windows Function 在运用窗口计算时,Flink根据上有数据集是否是KeyedStream类型(数据是否按照Key分区),如果上游数据未分组则调用window()方法指定Windows Assigner,数据会根据Key在不同Task实例中并行计算,最后得出针对每个Key的统计结果,如果是Non-Keyed类型则调用WindowsAll()方法指定Windows Assigner,所有的数据都会在窗口算子中路由得到一个Task中计算,并得到全局统计结果; 定义完窗口分配器后,需要为每一个窗口指定计算逻辑,也就是Windows Function,Flink提供了四种类型Window Function,分别是ReduceFunction、AggreateFunction、FoldFunction、ProcessWindowFunction,其中FoldFunction将逐渐不再使用;四种类型有分为增量聚合操作(ReduceFunction、AggreateFunction、FoldFunction)和全量聚合操作(ProcessWindowFunction); 增量聚合函数计算性能高,占用存储空间少,因为其只需要维护窗口的中间结果状态值,不需要缓存原始数据;全量聚合函数使用代价相对高,性能较弱,因为算子需要缓存该窗口的接入数据,然后等窗口触发后对所有原始数据进行汇总计算,若接入数据量大或窗口时间长容易导致计算性能下降; ReduceFunction和AggreateFunction相似,但前者的输出类型和输入类型一致(如使用tuple的某个字段聚合),后者更加灵活地提供3个复写方法,add()定义数据的添加逻辑,getResult()定义根据Accumulator计算结果的逻辑,merge()方法定义合并accumulator的逻辑; ProcessWindowFunction可以支撑更复杂的算子,其支持基于窗口全部数据元素的结果计算,当算子需要窗口的元数据或状态数据,或者算子不支持运算交换律和结合律(统计所有元素的中位数和众数),需要该函数中的Context对象,Context类定义了Window的元数据及可以操作的Window的状态数据包括GlobalState和WindowState; 大部分情况下,需要增量计算和全量计算结合,因为增量计算虽然一定程度能够提升窗口性能,但灵活性不及ProcessWindowFunction,两者整合使用,既可以得到增量算子又可以得到窗口的元数据(窗口开始、终止时间等),比如在计算TOP N的场景中,分窗口计算完数据的计算后需要根据商品ID汇聚总的点击数; Watermark 由于网络或系统等外部因素影响,事件数据不能及时传输到Flink系统中,导致数据乱序、延迟等问题,因此需要一种机制能够控制数据处理的过程和进度;基于event_time时间的Windows创建后,具体如何确定属于该Windows中的数据元素已经全部到达,如果确定全部到达就可以对所有数据进行窗口计算操作(汇总、分组),如果数据没有全部到达,则继续等待该窗口中的数据,但是又不能无限期的等下去,需要有机制来保证一个特定的时间后,必须触发window去进行计算了,此时watermark发挥作用了,它表示当达到watermark后,在watermark之前的数据已经全部达到(即使后面还有延迟的数据);Watermark是处理EventTime 窗口计算提出的机制,本质上是一种时间戳,可以在读取 Source时候指定或者在transformation操作之前,用自定义的Watermark生成器按照需求指定; 正常情况下,流式数据的到达时间是有序的,如下图: 一般情况存在数据的乱序(out-of-order)和延迟(late element),此时水位线机制能表明该时间戳之前到当前水位线时间戳的数据已经全部达到,没有比它(水位线)更早的数据了,并触发计算; Flink中生成水位线的方式有两种:Periodic Watermarks(周期性)和Punctuated Watermarks,前者假设当前时间戳减去固定时间,所有数据都能达到,后者要在特定事件指示后触发生成水位线; 举例说明Periodic Watermarks 工作方式:当前window为10s,设想理想情况下消息都没有延迟,那么eventTime等于系统当前时间,假如设置watermark等于eventTime的时候,当watermark = 00:00:10的时候,就会触发w1的计算,这个时后因为消息都没有延迟,watermark之前的消息(00:00:00~00:00:10)都已经落入到window中,所以会计算window中全量的数据。那么假如有一条消息eventTime是00:00:01 应该属于w1,在00:00:11才到达,因为假设消息没有延迟,那么watermark等于当前时间,00:00:11,这个时候w1已经计算完毕,那么这条消息就会被丢弃,没有加入计算,这样就会出现问题。这是已经可以理解,代码中为什么要减去一个常量作为watermark,假设每次提取eventTime的时减去2s,那么当data1在00:00:11到达的时候,watermark是00:00:09这个时候,w1还没有触发计算,那么data1会被加入w1,这个时候计算完全没有问题,所以减去一个常量是为了对延时的消息进行容错; Punctuated Watermarks提供自定义条件生成水位,例如判断某个数据元素的当前状态或tuple类型的某个值,如果接入事件中状态为0则触发生成watermark,如果状态不为0则不触发,需要分别复写extractTimestamp和checkAndGetNextWatermark方法; Flink允许提前预定义数据的提取器Timestamp Extractors,在读取source时候定义提取时间戳; 延迟数据 基于Event_time的窗口计算虽然可以使用warterMark机制容忍部分延迟,但只能一定程度的缓解该问题,无法应对某些延迟特别严重的场景。Flink默认丢失延迟数据,但用户可以自定义延迟数据的处理方式,此时需要Allowed Lateness机制近数据的额外处理; DataStream API提供Allowed Lateness方法指定是否对迟到数据进行处理,参数是Time类型的时间间隔大小,代表允许的最大延迟时间,Flink的窗口计算中会将Window的Endtime加上该时间作为窗口最后释放的结束时间(P),当接入的数据中Event time未超过该时间(P),但WaterMark已经超过Window的Event_Time时直接触发窗口计算,若Event_Time超过了时间P,则做丢弃处理; 通常情况下可以使用sideOutputLateData 方法对迟到数据进行标记,然后使用getSideOutput()方法得到被标记的延迟数据,分析延迟原因; 多流合并/关联 合并 Connect:Flink 提供connect方法实现两个流或多个流的合并,合并后生成ConnectedStreams,会对两个流的数据应用不同的处理方法,并且双流之间可以共享状态(比如计数);ConnectedStream提供的map()和flatMap()需要定义CoMapFunction和CoFlatMapFunction分别处理输入的DataStream数据集; Union:Union算子主要实现两个或者多个输入流合并成一个数据集,需要保证两个流的格式一致,输出的流与输入完全一致; 关联 Flink支持窗口的多流关联,即在一个窗口上按照相同条件对多个输入流进行join操作,需要保证输入的Stream构建在相同的Windows上,且有相同类型的Key做为关联条件; 数据集inputStream1通过join方法形成JoinedStreams类型数据集,调用where()方法指定inputStream1数据集的key,调用equalTo()方法指定inputStream2对应关联的key,通过window()方法指定Window Assigner,最后通过apply()方法中传入用户自定义的JoinFunction或者FlatJoinFunction对输入数据元素进行窗口计算; Windows Join过程中所有的Join操作都是Inner Join类型,也就是必须满足相同窗口中,每个Stream都有Key,且key相同才能完成关联操作并输出结果; 状态和容错 有状态计算是Flink重要特性,其内部存储计算产生的中间结果并提供给后续的Function或算子使用,状态数据维系在本地存储中,可以是Flink的堆内存或者堆外内存中,也可以借助于第三方的存储介质,同storm+ redis / hbase模式相比,Flink完善的状态管理减少了对外部系统的依赖,减少维护成本; State和类型 Flink根据数据集是否根据key分区将状态分为Keyed State和 Operator State两种类型,Keyed State只能用于KeyedStream类型数据集对应的Function和Operation上,它是Operator State的特例; Operator State只和并行的算子实例绑定,和数据元素中的key无关,支持当算子实例并行度发生变化后自动重新分配状态数据; Keyed State和 Operator State均有两种形式,一种是托管状态,一种是原始状态,前者有Flink Runtime控制和管理状态数据并将状态数据转换成内存Hash tables 或RocksDB的对象存储,后者由算子自己管理数据结构,当触发CheckPoint后,Flink并不知道状态数据内部的数据结构,只是将数据转换成bytes数据存储在CheckPoint中,当从Checkpoint恢复任务时,算子自己反序列化出状态的数据结构; CheckPoint 和SavePoint Flink基于轻量级分布式快照算法提供了CheckPoint机制,分布式快照可以将同一时间点的Task/Operator状态数据全局统一快照处理,包括Keyed State和Operator State Savepoints是检查点的一种特殊实现,底层使用CheckPoint机制,Savepoint是用户以手工命令方式触发CheckPoint,并将结果持久化到指定的存储路径中,其主要目的是帮助用户在升级和维护集群过程中保存系统的状态数据,避免因停机运维或者升级到知道正常终止的应用数据状态无法恢复。 参考内容: https://www.cnblogs.com/leesf456/p/11136344.html https://blog.csdn.net/a_drjiaoda/article/details/89357916 https://www.jianshu.com/p/9e92cefa9d4e http://wuchong.me/blog/2018/11/18/flink-tips-watermarks-in-apache-flink-made-easy/ - END - 欢迎加入 大数据 |数仓技术交流群 。 进群方式:请加微信(微信号:dataclub_bigdata),回复:数据,通过审核会拉你进群。 (备注:行业-职位-城市) 福利时刻 01. 后台回复「数据」,即可领取大数据经典资料。 02.后台回复「转型」,即可传统数据仓库转型大数据必学资料。 03. 后台回复「加群」,或添加一哥微信ID:dataclub_bigdata拉您入群(大数据|数仓|分析)或领取资料。 !关注不迷路~ 各种福利、资源定期分享! 你点的每个 在看 ,我都认真当成了喜欢 本文分享自微信公众号 - 数据社(DataClub)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

STL笔记1

顺序容器有vector、list、deque。关联容器有map、set。容器类自动申请和释放内存,无需new和delete操作。但是需要连接STL各个容器的内存管理 STL六大组件:容器,算法,迭代器,仿函数、适配器和空间配置器容器:容纳一组元素的对象迭代器:提供一种访问容器中每一个元素的方法适配器:用来修饰容器,比如queue和stack,底层借助了deque。空间适配器:负责空间配置和管理 空间配置器:对象构造前的空间配置和对象析构后的空间释放,由负责。设计哲学如下:先system heap要求空间考虑多线程状态考虑内存不足时的应变措施考虑碎片问题 对于碎片问题,有双层及配置器:第一级直接使用allocate()调用malloc()、deallocate()调用free(),使用类似new_handler机制解决内存不足(抛出异常),配置无法满足的问题(如果在申请动态内存时找不到足够大的内存块,malloc 和new 将返回NULL 指针,宣告内存申请失败)。 第二级视情况使用不同的策略,当配置区块大于128bytes时,调用第一级配置器,当配置区块小于128bytes时,采用内存池的整理方式:配置器维护16个(128/8)自由链表,负责16种小型区块的此配置能力。内存池以malloc配置而得,如果内存不足转第一级配置器处理。 1、第一级配置器详解 2、第二级空间配置器详解 第二级空间配置器实际上是一个内存池,维护了16个自由链表。自由链表是一个指针数组,有点类似与hash桶,它的数组大小为16,每个数组元素代表所挂的区块大小,比如free list[0]代表下面挂的是8bytes的区块,free list[1]代表下面挂的是16bytes的区块…….依次类推,直到free _ list[15]代表下面挂的是128bytes的区块。 3、空间配置器存在的问题自由链表所挂区块都是8的整数倍,因此当我们需要非8倍数的区块,往往会导致浪费。 由于配置器的所有方法,成员都是静态的,那么他们就是存放在静态区。释放时机就是程序结束,这样子会导致自由链表一直占用内存,自己进程可以用,其他进程却用不了。 各种容器的特点和适用情况:vector:可变大小的数组,支持快速随机访问,在尾部之外的位置插入或删除元素会较慢。deque:双端队列,支持快速随机访问,在头尾位置插入删除速度快。list:双向链表,只支持双向顺序访问,在list任何位置插入/删除速度都很快。forward_list:单向链表,只支持单向顺序访问array:固定大小的数组支持随机访问,不能添加或者删除元素。string:和vector相似,随机访问快,在尾位置插入/删除元素快。

优秀的个人博客,低调大师

Scala Symbol笔记

Symbol This class provides a simple way to get unique objects for equal strings. Since symbols are interned, they can be compared using reference equality. symbols可以作为一种快速比较字符串的方式,如果字符串的值相同,则返回的symbol变量具有相同的引用地址。Symbol内部维护了一个字符串池。 object SymbolDemo { def main(args: Array[String]): Unit = { val s = 'nihao val n = 'nihao // return true println(s == n) } } Compare to Java 在Java中创建String实例有两种方式:1、直接给一个变量赋值;2、用new关键创建String对象;(下文记作:方式1 和 方式2) 方式1 我们都知道 “方式1” 每次都会创建一个新变量(所以for循环内拼接字符串不建议用 “+” 操作符,因为每次都会开辟一个新的内存)。但Java其实对该操作做了优化,在String类内部维护了一个字符串池,每次通过 “方式1” 创建String实例时,首先检查字符串池中有没有相同的字符串,如果字符串池中不存在该字符串,则将字符串放入字符串池中(此处开辟新内存),同时将字符串的引用地址赋值给变量;如果字符串池中存在该字符串,则直接将原有引用地址赋值给新变量。 当创建 “str1” 时,字符串池中没有 “Hello Str”,此时将 “Hello Str” 放入字符串池中,并将内存地址赋值给 “str1”。当创建 “str2”时,字符串池中已经存在 “Hello Str”,直接将原有内存地址赋值给 “str2”,所以 “str1 == str2” 返回 true 。 方式2 每次都会创建一个新的对象,当调用 intern() 时逻辑过程跟 “方式1” 相同。当字符串池中存在 “Hello Str”时直接返回内存地址,否则将 “Hello Str” 放入字符串池中,并返回内存地址。 public class Demo { public static void main(String[] args) { String str1 = "Hello Str"; String str2 = "Hello Str"; String str3 = new String("Hello Str"); // return true System.out.println(str1 == str2); // return false System.out.println(str1 == str3); // return true System.out.println(str1 == str3.intern()); } } Refer from: https://www.scala-lang.org/api/2.12.1/scala/Symbol.htmlhttps://stackoverflow.com/questions/3554362/purpose-of-scalas-symbol

优秀的个人博客,低调大师

leetCode 编程笔记

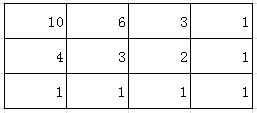
问:编写一个函数来查找字符串数组的最长公共前缀。如果不存在公共前缀,返回空字符串 “”。 示例输入:["flower", "flow", "flight"] 示例输出:"fl" 示例输入:["dog", "racecar", "car"] 示例输出:"" 解释:输入不存在公共前缀。 tips:所有的输入只包含小写字母 a-z 。 public class Solution { // 1. Method 1, start from the first one, compare prefix with next string, until end; // 2. Method 2, start from the first char, compare it with all string, and then the second char // I am using method 1 here public String longestCommonPrefix(String[] strs) { if (strs == null || strs.length == 0) { return ""; } String prefix = strs[0]; for(int i = 1; i < strs.length; i++) { int j = 0; while( j < strs[i].length() && j < prefix.length() && strs[i].charAt(j) == prefix.charAt(j)) { j++; } if( j == 0) { return ""; } prefix = prefix.substring(0, j); } return prefix; } } 有一个X x Y的网格,只能向右、向下移动,从(0, 0)走到(X - 1, Y - 1),中间某些位置有障碍物,打印一条路径(优化) 答:解题思路。 12.png 计算过程: 把底边和右边的每个格子标记为1 其余格子从右下角往右上角依次遍历 每个格子的值是其右边和下边格子值的和 遍历到右上角后求得最终结果 例如上图的结果为10。 这种解法依据的思路,由于每个格子只能向右或向下走,那么它的走法就由其右边格子的走法和下边格子的走法之和。而最下边和最右边的每个格子都只有唯一的走法。由此就能推导出其余格子的走法。 13.png tips:注意把握思想,把右下角右边和底部的边都设置为 1.之后向上推倒即可。最终结果是 10. 归并排序: //将有序数组a[]和b[]合并到c[]中 void MemeryArray(int a[], int n, int b[], int m, int c[]) { int i, j, k; i = j = k = 0; while (i < n && j < m) { if (a[i] < b[j]) c[k++] = a[i++]; else c[k++] = b[j++]; } // 当其中一个列表的所有数据都比另一个列表的所有数据小的时候,例如 i = n,j = 0; while (i < n) c[k++] = a[i++]; while (j < m) c[k++] = b[j++]; } tips: 解决了上面的合并有序数列问题,再来看归并排序,其的基本思路就是将数组分成二组A,B,如果这二组组内的数据都是有序的,那么就可以很方便的将这二组数据进行排序。如何让这二组组内数据有序了? 可以将A,B组各自再分成二组。依次类推,当分出来的小组只有一个数据时,可以认为这个小组组内已经达到了有序,然后再合并相邻的二个小组就可以了。这样通过先递归的分解数列,再合并数列就完成了归并排序。 构建 Hash 表的时候(散列函数的设计) f( key ) = key mod p ( p ≤ m ) mod ... 使用除留余数法的一个经验是,若散列表表长为m,通常p为小于或等于表 如何合理选取p值 使用除留余数法的一个经验是,若散列表表长为m,通常p为小于或等于表长(最好接近m)的最小质数或不包含小于20质因子的合数。 这句话怎么理解呢?要不这样吧,我再举个例子:某散列表的长度为100,散列函数H(k)=k%P,则P通常情况下最好选择哪个呢?A、91 B、93 C、97 D、99 实践证明,当P取小于哈希表长的最大质数时,产生的哈希函数较好。我选97,因为它是离长度值最近的最大质数。 可以盛最多水的容器 解法:我们可以循环遍历所有的两天边的乘积,取最大的值。 01.png 编程试题:求数列的和 使用语言:JAVA 参考正解代码如下: import java.util.*; class Main{ public static void main(String args[]){ int m; double sum,n; Scanner sc = new Scanner(System.in); while(sc.hasNext()){ n=sc.nextInt(); m=sc.nextInt(); sum=0; for(int i=0;i<m;i++){ sum=sum+n; n=Math.sqrt(n); } System.out.printf("%.2f",sum); System.out.println(); } } } 使用语言:C++ 参考正解代码如下: #include <math.h> #include <stdio.h> int main() { int n; double x, s; while (~scanf("%lf%d", &x, &n)) { for(s = 0.0; n--; x = sqrt(x)) s += x; printf("%.2lf\n", s); } return 0; } 使用语言:C# 参考正解代码如下: using System; namespace myApp { class Program { public static void Main() { string line; string[] p; int m, n; double nn; while (!string.IsNullOrEmpty(line = Console.ReadLine())) { p = line.Split(' '); n = int.Parse(p[0]); m = int.Parse(p[1]); double sum = 0; nn = n; for (int i = 0; i < m; i++) { sum = sum + nn; nn = Math.Sqrt(nn); } Console.WriteLine(string.Format("{0:f}", sum)); } } } } 使用语言:JavaScript 参考正解代码如下: var m; var sum,n; var sc while(sc = read_line()){ var arr = sc.split(' '); n=parseInt(arr[0]); m=parseInt(arr[1]); sum=0; for(var i=0;i<m;i++){ sum=sum+n; n=Math.sqrt(n); } print(sum.toFixed(2)); } 注意上面的三个代码有几点注意: 一:JavaScript 的输入和输出为 sc = read——line() 输出:print(); 精确到后两位:sum.toFixed(2) 二:C / C++ 精确到两位小数为:printf("%.2lf\n", s); 三:Java编写程序的时候精确到小数点后两位的写法:System.out.printf("%.2f",sum); 水仙花的求解 编程试题:水仙花 使用语言:JAVA 参考正解代码如下: import java.util.Scanner; public class Main{ public static void main(String args[]){ Scanner reader=new Scanner(System.in); while(reader.hasNextInt()){ int m=reader.nextInt(); int n=reader.nextInt(); if(100<=m&&m<=n&&n<=999){ int j=0; for(int i=m;i<=n;i++) { int geWei,shiWei,baiWei; baiWei=i/100; shiWei=(i-baiWei*100)/10; geWei=i-baiWei*100-shiWei*10; if(i==geWei*geWei*geWei+shiWei*shiWei*shiWei+baiWei*baiWei*baiWei) {j=j+1; if(j>1){ System.out.print(" "+i); } else{ System.out.print(i); } } } if(j==0){ System.out.print("no"); } System.out.println(); } } } } 使用语言:C++ 参考正解代码如下: #include<stdio.h> int main(){ int m,n; while(scanf("%d%d",&m,&n)!=EOF){ int t=0; for(int i=m; i<=n; i++){ int a=i/100; int b=i%100/10; int c=i%10; if(i==a*a*a+b*b*b+c*c*c && t==0){ printf("%d ",i); t++; } else if(i==a*a*a+b*b*b+c*c*c && t==1){ printf("%d ",i); } } if(t!=0){ printf("\n"); } if(t==0){ printf("no\n"); } } return 0; } 使用语言:C# 参考正解代码如下: using System; namespace myApp { class Program { public static void Main() { string line; string[] p; int m, n; while ((line = Console.ReadLine()) != null) { p = line.Split(' '); n = int.Parse(p[1]); m = int.Parse(p[0]); var j=0; for(var i=m;i<=n;i++) { int geWei,shiWei,baiWei; baiWei = (i/100); shiWei = ((i-baiWei*100)/10); geWei = i-baiWei*100-shiWei*10; if(i==geWei*geWei*geWei+shiWei*shiWei*shiWei+baiWei*baiWei*baiWei) { j=j+1; if(j>1) { Console.Write(" "+i); } else { Console.Write(i); } } } if(j==0) { Console.Write("no"); } Console.Write("\r\n"); } } } } 使用语言:JavaScript 参考正解代码如下: var sc; while(sc = read_line()){ var arr = sc.split(' '); n=parseInt(arr[1]); m=parseInt(arr[0]); if(100<=m&&m<=n&&n<=999){ var out = []; var j=0; for(var i=m;i<=n;i++) { var geWei,shiWei,baiWei; baiWei=parseInt(i/100); shiWei=parseInt((i-baiWei*100)/10); geWei=i-baiWei*100-shiWei*10; if(i==geWei*geWei*geWei+shiWei*shiWei*shiWei+baiWei*baiWei*baiWei) { j=j+1; if(j>1){ out.push(" "+i); } else{ out.push(i); } } } if(j==0){ out.push("no"); } print(out.join('')); } }

优秀的个人博客,低调大师

metaq学习笔记

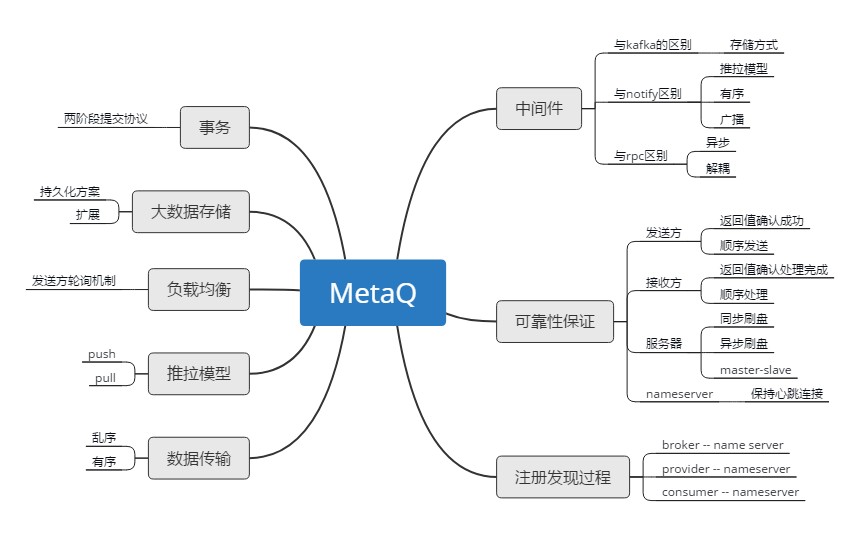
简介 metaq作为一款消息中间件,是支撑双11最为核心的系统之一,解耦收发双方,使得系统异步化,同时利用消息中间件堆积消息的功能,可以使得下游系统在可以慢慢消费消息,增强系统的缓冲能力,达到“削峰填谷”的目的 思维导图 在学习前先建立了思维导图,这样在学习过程中逐步深入,理解更加透彻 流程 发送端 1. UML图 2. 类 2.1 MetaProducer 发送端,可通过该类实例对象指定发送端分组(producerGroup),启动程序 2.2 Diamond 持久化配置中心,用于获取配置信息 2.3 MetaProducerImpl 用于初始化、注册埋点 2.4 DefaultMQProducerImpl 检查配置,注册发送方 2.5 MQClientInstance 若程序处于初始化状态,开启定时任务、拉取消息服务、负载平衡服务 2.6 MQClientAPIImpl 调用底层的 netty client 发送数据 metaq 的代码编写风格较为清爽,基本调用顺序为 MetaProducer --> MetaProducerImpl --> DefaultMQProducerImpl --> MQClientAPIImpl 3. 流程 具体流程见UML图中操作顺序,这里只列出重要的步骤 3.1 start 开启服务,程序入口 3.2 getConfig 获取配置信息,调用的是Diamond接口,本质是通过httpGet请求,使用netty从持久化配置中心下载配置文件,定位参数是指定的分组名(producerGroup) 3.3 addListener 添加监听,如果Diamond配置中心有数据变化,可获得新的数据 3.4 receive 通过设置AllowPushInterval变量,一分钟后再响应服务器配置变化 3.5 init 初始化,设置最大消息大小、埋点,这里设置的hook在最终发送消息时会依次调用 3.6 start DefaultMQProducerImpl 的 start 方法,根据serviceState决定执行流程;注意这里程序的入口包含参数 startFactory,boolean 类型判断是否需要开启服务,调用顺序为 DefaultMQProducerImpl.start( ) --> MQClientInstance.start( ) --> DefaultMQProducerImpl.start( ),只是在程序第二次调用时将标记位设为false 3.7 checkConfig 检查配置,判断分组名是否符合规范 3.8 start 开启MQClientInstance的服务,启动mqClientAPIImpl(底层netty通信客户端)、startScheduledTask(定时任务)、rebalanceService(负载均衡)、defaultMQProducerImpl 3.9 send 发送消息,此前需要对消息进行封装,指定消息主题topic、标签tag、内容body,其中通过topic即可实现收发双方的通信,接收方可以通过tag进行消息过滤 3.10 sendDefaultImpl 发送方法的默认实现,根据消息的发送方式选择不同的方法 3.11 sendKernelImpl 封装消息,执行之前设置的hook 3.1 sendMessage 调用底层的netty客户端发送消息,并返回SendResult 接收端 1. UML图 2. 类 2.1 MetaPushConsumer 接收方对象,程序入口,可订阅主题、设置监听、开启服务 2.2 DefaultMQPushConsumerImpl 默认实现方式,用于订阅和设置监听 2.3 MetaClientConfigChanged 用于获取配置 2.4 Diamond 调用接口,提供从持久化配置中心获取配置及设置监听的功能 2.5 MetaPushConsumerImpl 用于初始化服务 2.6 DefaultMQPushConusmerImpl 检查配置,开启服务 2.7 MQClientInstance 用于开启负载均衡、拉取消息等服务 可以看出,接收方和发送发的代码结构、类的命名方式极为相似,类的调用流程为 MetaPushConsumer --> DefaultMQPushConsumerImpl --> MetaPushConsumerImpl --> DefaultMQPushConsumerImpl --> MQClientInstance 3. 流程 具体流程见UML图中操作顺序,这里只列出重要的步骤 3.1 subscribe 程序入口,订阅相应主题,这里包含两个参数 3.1.1 topic:订阅主题,metaq发送发接收方通信的标识符,只要主题一致即可接收消息 3.1.2 subExpression:标记位tag,使用方式为“tag1 || tag2 || tag3”或者“*”,用于接收方过滤消息 3.2 registerMessageListener 注册消息监听,这里指定接受消息后的处理方式 3.3 getConfig 获取配置,与发送发方法一致 3.4 addListener 设置监听,当配置更新时获取新的信息 3.5 init 初始化,埋点 3.6 chechConfig 检查配置 3.7 mQClientAPIImpl.start( )、startScheduledtask( )、pullMessageService.start( )、rebalanceService.start( ) 与发送方类似 可以看出,metaq的代码编写风格极为规整,发送方接收方结构一致,方便阅读 broker broker的源代码暂无 源码解析 上述思维导图中,通过阅读源码,重点希望解决以下问题 1. 通讯建立 全网拓扑如下 各组件功能为: Name Server:注册服务器,需要将topic注册到上面,对应的操作是在metaq平台上发布topic(http://ons-api.taobao.net) Broker:存储转发服务器,每个broker需要与所有的name server建立长连接,从而获取topic信息;分为master和容灾的slaver Producer:消息发送方,需要与其中一个name server建立连接,获得路由信息,再与主题对应的broker建立长连接且定时向master发送心跳;消息由producer发送到master,再由master同步到所有broker Consumer:消息接收方,需要与其中一个name server建立连接,获得路由信息,再向提供服务的master、slaver建立长连接,具体接收消息时刻选择broker 这里需要建立的连接包括: Producer Consumer Name Server Broker Producer ---- 多对多 多对一 多对多 Consumer ---- 多对一 多对多 Name Server ---- 多对一 Broker ---- 1.1 producer <--> name server producer在初始化阶段需要与其中一个name server建立长连接,获得broker路由信息 1.1.1 获取name server 地址 源码提供了两种获取name server的地址,,默认地址为:http://jmenv.tbsite.net:8080/rocketmq/nsaddr MixAll //提供两种方式来指定获取name server地址:system environment variables 和 Java option //默认采用后者 public static String getWSAddr() { String wsDomainName = System.getProperty("rocketmq.namesrv.domain", DEFAULT_NAMESRV_ADDR_LOOKUP); String wsDomainSubgroup = System.getProperty("rocketmq.namesrv.domain.subgroup", "nsaddr"); String wsAddr = "http://" + wsDomainName + ":8080/rocketmq/" + wsDomainSubgroup; if (wsDomainName.indexOf(":") > 0) { wsAddr = "http://" + wsDomainName + "/rocketmq/" + wsDomainSubgroup; } return wsAddr; } producer在初始化时通过向固定地址发送httpGet请求,从而获得name server地址 TopAddressing public final String fetchNSAddr(boolean verbose, long timeoutMills) { String url = this.wsAddr; try { if (!UtilAll.isBlank(this.unitName)) { url = url + "-" + this.unitName + "?nofix=1"; } HttpTinyClient.HttpResult result = HttpTinyClient.httpGet(url, null, null, "UTF-8", timeoutMills); if (200 == result.code) { String responseStr = result.content; if (responseStr != null) { return clearNewLine(responseStr); } else { log.error("fetch nameserver address is null"); } } else { log.error("fetch nameserver address failed. statusCode=" + result.code); } } catch (IOException e) { if (verbose) { log.error("fetch name server address exception", e); } } if (verbose) { String errorMsg = "connect to " + url + " failed, maybe the domain name " + MixAll.getWSAddr() + " not bind in /etc/hosts"; errorMsg += FAQUrl.suggestTodo(FAQUrl.NAME_SERVER_ADDR_NOT_EXIST_URL); log.warn(errorMsg); } return null; } 1.1.2 与name server通信,获取主题路由信息,返回值为TopicRouteData,即主题对应的broker地址 在metaq中,所有请求的封装格式统一,区别在于请求码,最终通过netty client通信 MQClientAPIImpl public TopicRouteData getTopicRouteInfoFromNameServer(final String topic, final long timeoutMillis, boolean allowTopicNotExist) throws MQClientException, InterruptedException, RemotingTimeoutException, RemotingSendRequestException, RemotingConnectException { GetRouteInfoRequestHeader requestHeader = new GetRouteInfoRequestHeader(); requestHeader.setTopic(topic); RemotingCommand request = RemotingCommand.createRequestCommand(RequestCode.GET_ROUTEINTO_BY_TOPIC, requestHeader); RemotingCommand response = this.remotingClient.invokeSync(null, request, timeoutMillis); assert response != null; switch (response.getCode()) { case ResponseCode.TOPIC_NOT_EXIST: { if (allowTopicNotExist && !topic.equals(MixAll.DEFAULT_TOPIC)) { log.warn("get Topic [{}] RouteInfoFromNameServer is not exist value", topic); } break; } case ResponseCode.SUCCESS: { byte[] body = response.getBody(); if (body != null) { return TopicRouteData.decode(body, TopicRouteData.class); } } default: break; } throw new MQClientException(response.getCode(), response.getRemark()); } 1.2 producer <--> broker 遍历brokerAddrTable,对获取到的broker地址发送心跳sendHeartbeat建立长连接 MQClientInstance private void sendHeartbeatToAllBroker() { final HeartbeatData heartbeatData = this.prepareHeartbeatData(); final boolean producerEmpty = heartbeatData.getProducerDataSet().isEmpty(); final boolean consumerEmpty = heartbeatData.getConsumerDataSet().isEmpty(); if (producerEmpty && consumerEmpty) { log.warn("sending heartbeat, but no consumer and no producer"); return; } if (!this.brokerAddrTable.isEmpty()) { long times = this.sendHeartbeatTimesTotal.getAndIncrement(); Iterator<Entry<String, HashMap<Long, String>>> it = this.brokerAddrTable.entrySet().iterator(); while (it.hasNext()) { Entry<String, HashMap<Long, String>> entry = it.next(); String brokerName = entry.getKey(); HashMap<Long, String> oneTable = entry.getValue(); if (oneTable != null) { for (Map.Entry<Long, String> entry1 : oneTable.entrySet()) { Long id = entry1.getKey(); String addr = entry1.getValue(); if (addr != null) { if (consumerEmpty) { if (id != MixAll.MASTER_ID) continue; } try { int version = this.mQClientAPIImpl.sendHearbeat(addr, heartbeatData, 3000); if (!this.brokerVersionTable.containsKey(brokerName)) { this.brokerVersionTable.put(brokerName, new HashMap<String, Integer>(4)); } this.brokerVersionTable.get(brokerName).put(addr, version); if (times % 20 == 0) { log.info("send heart beat to broker[{} {} {}] success", brokerName, id, addr); log.info(heartbeatData.toString()); } } catch (Exception e) { if (this.isBrokerInNameServer(addr)) { log.info("send heart beat to broker[{} {} {}] failed", brokerName, id, addr); } else { log.info("send heart beat to broker[{} {} {}] exception, because the broker not up, forget it", brokerName, id, addr); } } } } } } } } consumer端连接建立过程和发送发相同,包含consumer <--> name server 和 consumer <--> broker,源码中consumer最终调用的是与producer相同的方法(MQClientInstance),这里就不再重复 broker需要与所有name server建立连接,从而获得topic信息,这里没有broker端源码,详细过程略 2. 存储方案 ata上不少文章都有对metaq物理存储的讲解,但这些内容大都混淆了metaq和kafka的存储结构,经过查阅相关资料,总结如下 2.1 kafka kafka采取的是分区+分段的方式,参考自Kafka设计解析(一)- Kafka背景及架构介绍 分区:partition,将物理broker映射为逻辑分区,实现了水平拓展,这样在传输时只需指定分区号即可,而broker可对应多个分区,这样就实现了分布式的存储 分段:segment,实际存储结构,包含数据文件和索引文件,顺序存储加快了速度,数据文件命名采用偏移量的方式,这样索引文件只需记录偏移量就可以二分查找快速定位 简单来说,kafka使用分区的方式实现了物理存储到逻辑分区的映射,能够轻松实现存储空间的扩展,而对用户透明;实际采用顺序存储的方式,用户只需指定索引(偏移量),就能快速查找;存储结构如下图所示 2.2 metaq metaq借鉴了kafka的思想(致敬kafka名作变形记),即一个topic对应一个顺序存储队列sequence,但是原有的分区的数量随着topic的增大而明显增大,本来高性能的顺序写文件会变成随机写,吞吐量会有较大的下降,因此在kafka的基础上进行了改进,取消 分区物理划分主题,而采用consume queue逻辑划分的方式,参考自阿里消息中间件架构演进之路:notify和metaq 2.1.1 commit log CommitLog属于物理队列,存储完整的消息数据,所有topic的消息都会写入到同一个CommitLog,这样就避免分区带来的影响,而划分主题的功能则交由consume queue实现 2.1.2 consume queue metaq对客户端暴露的主要是consume queue逻辑视图,提供队列访问接口,消费者通过指定consume queue的位点来读取消息,通过提交consume queue的位点来维护消费进度 2.1.3 改进 可以看出,kafka采用的是分区+分段的方式,即物理分区,分区划分主题、逻辑扩展,分段实际存储、索引查找;而metaq采取的是commitLog+consumeQueue,逻辑分区,即commitLog按照偏移量顺序存储,consumeQueue划分主题、索引查找,同时一个 broker对应多个队列,也可以达到存储拓展的功能;metaq的存储结构如下图所示 3. 推拉模式 3.1 pull 流程 程序初始化时启动pullMessageService服务,pullRequestQueue阻塞队列存储所有的pull任务,线程不停地从队列中获取新的任务并拉取消息 PullMessageService public void run() { log.info(this.getServiceName() + " service started"); while (!this.isStopped()) { try { PullRequest pullRequest = this.pullRequestQueue.take(); if (pullRequest != null) { this.pullMessage(pullRequest); } } catch (InterruptedException e) { } catch (Exception e) { log.error("Pull Message Service Run Method exception", e); } } log.info(this.getServiceName() + " service end"); } netty client 收到消息后,触发 processMessageReceived 方法,最终调用ConsumeConcurrentlyStatus status = this.messageListener.consumeMessage(msgs, content);这里的messageListener就是我们在main函数里设置的监听处理方法,同时在处理完一条消息后需要返回,只有确认正确处理才能继续传输,下面代码是处理和返回逻辑 ClientRemotingProcess private RemotingCommand consumeMessageDirectly(ChannelHandlerContext ctx, RemotingCommand request) throws RemotingCommandException { final RemotingCommand response = RemotingCommand.createResponseCommand(null); final ConsumeMessageDirectlyResultRequestHeader requestHeader = (ConsumeMessageDirectlyResultRequestHeader) request .decodeCommandCustomHeader(ConsumeMessageDirectlyResultRequestHeader.class); final MessageExt msg = MessageDecoder.decode(ByteBuffer.wrap(request.getBody())); ConsumeMessageDirectlyResult result = this.mqClientFactory.consumeMessageDirectly(msg, requestHeader.getConsumerGroup(), requestHeader.getBrokerName()); if (null != result) { response.setCode(ResponseCode.SUCCESS); response.setBody(result.encode()); } else { response.setCode(ResponseCode.SYSTEM_ERROR); response.setRemark(String.format("The Consumer Group <%s> not exist in this consumer", requestHeader.getConsumerGroup())); } return response; } 3.2 push 流程 metaq采用长轮询的方式模拟push,即在代码中将pull请求放入阻塞队列中,通过线程不停地从队列中take获取任务,达到push实时推送的功能;代码见3.1 pull 流程 4. 可靠性保证 4.1 producer可靠性保证 发送方与broker建立连接,使用netty传输消息message,同步传输确保消息能够到达服务器;源码如下,在得到response后需要调用processSendResponse方法对其进行分析,会根据response状态码更改responseCode,只有返回值的状态码正确才继续传输 private SendResult sendMessageSync( final String addr, final String brokerName, final Message msg, final long timeoutMillis, final RemotingCommand request ) throws RemotingException, MQBrokerException, InterruptedException { RemotingCommand response = this.remotingClient.invokeSync(addr, request, timeoutMillis); assert response != null; return this.processSendResponse(brokerName, msg, response); } 4.2 consumer可靠性保证 消费者顺序消费,只有在前一条消息成功后才会继续,如果持续失败(最多5次),则会将该条消息保存到本地,有后台进程继续尝试;具体消费流程见上述3.1 pull 流程 4.3 broker可靠性保证 notify服务器通过持久化保证消息的可靠性,但这样会带来io读写耗时大的问题,metaq对此进行了优化 4.3.1 master -- slaver 采用slaver的结构,一方面可以做到容灾,当master出现异常时可以自动顶替上去;另一方面,master--slaver的结构优化了读写操作,producer与master建立长连接,写操作进入master,再进行备份处理,而consumer与master和所有的slaver建立长连接,在读取时也可以对slaver的队列进行操作,优化了读取操作 4.3.2 持久化 metaq采用mmap(将一个文件或者其它对象映射到进程的地址空间,实现文件磁盘地址和进程虚拟地址空间中一段虚拟地址的一一对映关系)内存映射文件的方法,将消息持久到文件,提高了性能 4.4 总结 producer --> broker 、broker --> consumer 都依靠返回值的确认机制来保障,而broker端可靠性则依赖于本地文件持久化、容灾机制 5. 有序消息 metaq采用的是逻辑分区,即消息按序存储,但索引号是根据consumer queue决定,因此,只需保证producer单线程发送消息,且指定相同队列号即可保证消息的顺序性,源码中采用大小为1的semaphore信号量确保单线程传输 NettyRemotingAbstract public void invokeOnewayImpl(final Channel channel, final RemotingCommand request, final long timeoutMillis)throws InterruptedException, RemotingTooMuchRequestException, RemotingTimeoutException, RemotingSendRequestException { request.markOnewayRPC(); boolean acquired = this.semaphoreOneway.tryAcquire(timeoutMillis, TimeUnit.MILLISECONDS); if (acquired) { final SemaphoreReleaseOnlyOnce once = new SemaphoreReleaseOnlyOnce(this.semaphoreOneway); try { channel.writeAndFlush(request).addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture f) throws Exception { once.release(); if (!f.isSuccess()) { log.warn("send a request command to channel <" + channel.remoteAddress() + "> failed."); } } }); } catch (Exception e) { once.release(); log.warn("write send a request command to channel <" + channel.remoteAddress() + "> failed."); throw new RemotingSendRequestException(RemotingHelper.parseChannelRemoteAddr(channel), e); } } else { if (timeoutMillis <= 0) { throw new RemotingTooMuchRequestException("invokeOnewayImpl invoke too fast"); } else { String info = String.format("invokeOnewayImpl tryAcquire semaphore timeout, %dms, waiting thread nums: %d semaphoreAsyncValue: %d", timeoutMillis, this.semaphoreOneway.getQueueLength(), this.semaphoreOneway.availablePermits() ); log.warn(info); throw new RemotingTimeoutException(info); } } } 6. 负载均衡 由于消费者只需根据topic从broker拉取消息即可,这里只讨论消生产者的负载均衡,broker端采用逻辑分区,在生产者看来所有的分区组成了分区列表依次使用,本质就是发送消息时合理选择分区的问题,metaq在初始化时从配置中心获取publish的topic对应的broker和分区列表,生产者在发送消息的时候必须选择一台broker上的一个分区来发送消息,默认的策略是一个轮询的路由规则,以此达到负载均衡的效果 代码演示 1. 发布topic 这里是将topic发布到name server上,便于构建TopicRouteData,为主题分配broker 2. 添加maven依赖 <dependency> <groupId>com.taobao.metaq.final</groupId> <artifactId>metaq-client</artifactId> <version>4.2.0.Final</version> </dependency> 3. Producer public class Producer { public static void main(String[] args) throws MQClientException, InterruptedException { MetaProducer producer = new MetaProducer("intern-metaq-demo-normal-consumer"); producer.start(); for (int i = 0; i < 1000; i++) { try { Message msg = new Message("intern-demo-sc",// topic "TagA",// tag ("sc " + i).getBytes()// body ); SendResult sendResult = producer.send(msg); System.out.println(sendResult.getSendStatus()); //Thread.sleep(1000); } catch (Exception e) { e.printStackTrace(); Thread.sleep(1000); } } producer.shutdown(); } } 4. Consumer public class Consumer { public static void main(String[] args) throws InterruptedException, MQClientException, MQClientException { MetaPushConsumer consumer = new MetaPushConsumer("CID-sc"); consumer.subscribe("intern-demo-sc", "*"); consumer.registerMessageListener(new MessageListenerConcurrently() { public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> msgs, //监听消息 ConsumeConcurrentlyContext context) { for (MessageExt msg : msgs) { //处理消息 System.out.println("ReceivedMsgId: " + new String(msg.getMsgId()) + " ReceivedMsgBody: " + new String(msg.getBody())); } return ConsumeConcurrentlyStatus.CONSUME_SUCCESS; } }); consumer.start(); System.out.println("Consumer Started."); } } 总结 1. 中间件与 rpc区别 1.1 业务逻辑层面 rpc:远程过程调用,强调的是解耦,将不同的功能模块拆分,但程序运行上还是作为一个整体,各个模块内部由不同平台根据具体业务场景开发,彼此之间通过rpc远程调用 中间件:解耦+异步,达到了1+1 > 2 的效果,遵循的主旨是最终一致性原则 参考自Notify和Metaq ——学习总结,以用户注册为例,需要的流程如下 在早期的业务处理流程中,会采用串行的执行方式,这样程序运行逻辑和业务处理流程相一致,但带来的问题很多,一方面程序总体耗时是单纯的线性叠加,另一方面,若果业务流程中某一环节出错,就不得不全部rollback,这样的代价太大;而中间件的着 眼点在于业务层面的解耦,仔细分析,我们可以发现该业务的主要逻辑是用户注册,而后续的准备支付宝,通知sns等操作虽然必须要完成,但却是不需要让用户等待的,经过分拆的流程如下 这样采取异步并行的方式来完成业务,极大的减少延迟,但带来的问题就是如果某一环节出错,整体流程不会因此rollback,比如用户注册成功但是却没有通过合法性验证,这样带来的就是数据上的危害,因此需要确保拆分模块运行的可靠性,经过中间件分 拆的最终模块如下 可以看出,中间件在业务逻辑优化的过程中起到了:1. 异步:解耦功能模块,并行执行缩短耗时;2. 可靠性保证:通过内部机制确保并行模块运行的可靠性 1.2 使用方式 在代码使用方面,hsf采用的是本地代理,最终通过invoke反射调用方法并返回结果;metaq则是producer -- broker、broker -- consumer 直接传输消息 2. metaq 与 notify 区别 最本质的区别就是notify采用push方式,broker不停地向consumer推送消息,这样确保了消息的可达性但却牺牲了服务器的性能,而metaq采用pull方式(pull模拟push),服务端只保存一定时间内的消息,提升了broker的性能,各方面对比见下表,可见在绝大 多数领域metaq性能更加优秀,因此notify正逐渐合并到metaq项目中 性能 metaq notify 消息推送方式 pull push 顺序性 局部有序 不提供 消息重复 部分避免 不提供 实时性 较高 高 消息堆积能力 强 较强 分布式 不支持 支持 过滤机制 单一 多种过滤机制 广播 支持 不支持 3. 削峰填谷 在metaq的介绍中,开始看到这个名词时感觉很高深,但随着深入学习,metaq的功能逐渐清晰起来。简单来说,削峰填谷是概括了中间件的功能,即异步并发,阻挡前端的数据洪峰,舒缓下游机器压力。试想这样的情景,在双11等业务场景下,用户瞬间的请 求量是爆炸式的,如果采用传统的同步顺序执行逻辑,所有的请求在没有完成前都需要挂载在服务端,服务器的压力可想而知,但采用中间件解耦业务逻辑,则用户请求在完成主体需求后可以直接退出,由中间件堆积消息并确保剩余业务的完成,这就可以容纳更多 的用户请求,因此,一个设计规范,运行良好的中间件系统对于公司业务的拓展骑着极为重要的作用 参考文章 http://www.jasongj.com/2015/03/10/KafkaColumn1/ https://www.atatech.org/articles/95456 https://www.atatech.org/articles/36160#5 https://www.atatech.org/articles/102577 https://www.atatech.org/articles/108048 https://www.atatech.org/articles/110786 https://www.cnblogs.com/huxiao-tee/p/4660352.html

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册