首页 文章 精选 留言 我的

精选列表

搜索[笔记软件],共10010篇文章
优秀的个人博客,低调大师

JavaScript学习笔记

一:数组 //数组的构造的第一种方法 var arr=[1,2,3] var arr=[1,"2",true] //数组的构造的第二种方法 var arr1=new Array(5);//表示创建一个长度为5的数组 alert("arr1:"+arr1.length)//输出数组的长度 //数组的构造的第三种方法 var arr2=new Array(1,2,3); 二:方法的构造 //方法构造的第一种方法 function 方法名(参数列表){ 方法体; 返回值(可有可无) } //实例1 无参 function test(){ alert("aaa"); } //调用 test(); //实例2 有参 function test2(a,b){ var sum=a+b; alert(sum); } //调用 test(2,3); //方法构造的第二种方法 //匿名函数 var add=function(参数列表){ 方法体和返回值; } //实例 var add3= function(m,n){ alert(m+n); } //调用 add3(5,6); 三:js的全局变量和局部变量 **全局变量:在js页面标签中定义一个变量,这个变量在页面中的js部分都可以使用 - 在方法的外部使用,在方法的内部使用,在另一个Script标签使用 **局部变量:在方法内部定义一个变量,只能在方法内部使用 - 在方法外部调用这个变量会出错 【如果大家对程序员,web前端感兴趣,想要学习的,关注一下小编吧。加群:731771211。免费赠送web前端系统的学习资料!!前端学习必备公众号ID:mtbcxx】 四:js的重载 方法名相同,参数列表不同 function add1(a,b){ return (a+b); } function add2(a,b,c){ return (a+b+c); } add1(2,3); add2(2,3,4); 五:js的String对象 **创建String对象 ***var Str=""; **String属性 *** length 长度 **方法 (1)和html相关的方法 - bold();//加粗 var str1="sss"; document.write(Str1.blid); - fontcolor();//设置字符串的颜色 document.write(Str1.fontcolor("red")); - fontsize();//范围数字1-7,设置字体的大小 document.write(Str1.fontsize(2)); - link();//让字符串显示成超链接 document.write(Str1.link("hello.html")); - sub();//下标 document.write(Str1.sub()); //几次方 - sup();//上标 var str2="sss"; document.write(Str1.sup()); (2)与java相似的方法 var str1="abc"; var str2="def"; - concat();//连接字符串的方法 document.write(Str1.concat(str2));//abcdef - charAt();//返回指定位置的字符串 document.write(Str1.charAt(0));//a //字符串位置不存在,返回的是一个空的字符串 - indexOf();//返回字符串的位置 document.write(Str1.indexOf("a")); //字符串不存在返回-1 - split();//切分字符串,切分为数组 var str3="d-e-f"; var arr1=Str3.split("-"); document.write(Str3.length); - replace();//将指定得字符串替换成你将要换成的字符串 document.write(str1.replace("a","ttt")); - substr();和subString(); var str4="abcdefghuiop"; document.write(str4.sunstr(5,3));//fgh[5,3] //从第五位开始向后截取3位 document.write(str4.sunstrng(5,3));//fg //从第几位开始到第几位结束,但不包含最后一位[5,3) 六,js 的Array对象 **创建数组 -var arr1=[1,2,3]; -var arr2=new Array(3); -var arr3=new Array(1,32,3); **方法 -conact();//数组的连接 var arr1=[1,2,3]; var arr2=[4,5,6]; document.write(arr1.concat(arr2));//1,2,3,4,5,6 -join();//根据一个指定的字符进行数组分割 document.write(arr1.join("-"));//1-2-3 -push();//向数组的末尾添加一个或多个元素,返回新的数组长度 document.write(arr1.push("qwe"));//1,2,3,qwe document.write(arr1.push(arr2)); //把数组arr2添加到arr1之后,新的数组长度为四,因为是把数组arr2整体当成一个元素添加到了arr1中 -pop();//删除最后一个元素并返回 document.write(arr1.pop());//返回3 -reverse();//倒序 document.write(arr1.reverse()); 七.js的date对象 ** js获取当前时间 var date=new Date(); document.write(date);//未格式化的时间 document.write(date.toLocaleString());//格式化后的时间 -getFullYear();//获取当前的年份 document.write(date.getFullYear()); -getMonth();//获取当前月份,注意,获取的月份是(0-11) var month=date.getMonth(); document.write(month+1); -getDay();//获取当前的星期,注意,获取的星期是(0-6) -getDate();//获取当前的天 -getHours();//获取 当前的小时 -getMinutes();//获取当前的分钟 -getSeconds();//获取当前的秒 -getTime();//获取毫秒数,返回1970年1月1日至今的毫秒数 //应用场景 //使用毫秒数处理缓存http://www.baidu.com?毫秒数 八,js的Math对象 **数学 var mm=10.4; -cell(x);//向上舍入 document.write(Math.ceil(mm));//11 -floor(x);//向下舍入 document.write(Math.fllor(mm));//10 -round(x);//四舍五入 document.write(Math.round(mm));//10 -random();//得到随机数(0-1),是伪随机数 document.write(Math.random());//小数0.23131441 document.write(Math.floor(Math.random()*10));//0-9 -Max(x,y);//返回最大值 -pow(x,y);//返回x的y次方 九.js的全局函数 *由于不属于任何一个对象,直接写名称使用 -eval();//执行js代码 var str="alert('1234')"; eval(str);//1234 -encodeURI();// 对字符进行编码 var str="测试中文aaa1234"; var encode1=encodeURI(str); document.write(enocde1); -decodeURI();// 对字符进行解码 var encode2=encodeDRI(str); document.write(enocde2); -encodeURIComponent();// -decodeURIComponent();// -isNaN();//判断当前字符串是否为数字 var str="123";//false document.write(isNaN(str));//是数字返回false,如果不是数字返回的是true -parseInt();//类型转换 var str="123"; document.write(parseInt(str)+1);//124 十.js的重载 ** js的重载是否存在?不存在 **会调用最近的方法(面试题) (1)js里面不存在重载 (2)但是可以通过其他方法来模拟重载 arguments数组 十一.js的bom对象 ** broswer object model --对象 **navigater://获取浏览器的名称 document.write(navigater.appName); **screen:获取屏幕的信息 document.write(screen.height); document.write(screen.weight); **location:请求的URL地址 -href属性: ***获取请求的url地址 document.write(location.href); ***设置URL地址 一个页面中设置一个按钮,连接到另一个页面 鼠标点击事件 onclick="js的方法"; **history:请求URL的历史记录 // -到访问的上一个页面 function back(){ history.back(); //history.go(-1);//等同于back();方法 } -到访问的下一个页面 function next(){ history.forward(); //history.go(1);//等同于forward();方法 } **window(重点) *窗口对象 *顶层对象(所有的bom对象都是在window里面操作) **方法 -window.alert();//在窗口弹出一个页面 -window.confirm();//确认提示框 -var flag=window.confirm("是否删除"); alert(flag);//true -window.prompt();//输入对话框 window.prompt(text,defaulttext); window.prompt("显示输入提示","默认值"); window.prompt("请输入:","0"); -open();// window.open("连接到新的地址","","窗口特征,比如高和款等信息"); window.open("hello.html","","heigth=200,weight=300"); -close();//关闭窗口,兼容性比较差 -做定时器 ** setInterval("js代码",毫秒数); window.setInterval("alert('123')",3000);//每三秒就执行一次alert方法 ** setTimeout("js代码",毫秒数);//在指定的毫秒数之后去执行,但是只执行一次 window.setTimeout("alert('123')",3000);//在三秒之后执行alert,但是只执行一次 ** clearInterval();//清除setInterval的方法 var clear1=window.setInterval("alert('123')",3000);\ function clear1(){ clearInterval(clear1); } ** clearTimeout();//清除setTimeout的方法 var clear1=window.setTimeout("alert('123')",3000); function clear2(){ clearTimeout(clear1); } 十二.js的dom对象 * dom : document object model ** 文档 超文本标记文档 html xml ** 对象 提供了属性和方法 ** 模型 提供属性和方法操作超文本标记性文档 *** 可以使用js里面的dom对象进行操作 *** 想要对标记性超文本文档进行操作,首先需要对标记性超文本型文档里面所有的内容封装成对象 --需要把html里面的标签、属性、文本内容封装成对象 *** 解析过程 根据html的成绩结构,在内存中分配一个树形结构,需要把html中的每一个部分都封装成一个对象 -document对象:整个文档 -element对象:标签对象 -属性对象 -文本对象 --Node节点对象:这个对象时这些对象的父对象 *** 如果在这些对象里面找不到相对应的方法,这个时候需要到Node对象里面去找 * DHTML:是很多技术的简称 ** html:封装数据 ** css:使用属性和属性值设置样式 ** dom:操作html文档(标记性文档) ** JavaScript:专门指的是js的语法语句 十三.document对象:整个文档 * 表示整个文档 ** 常用方法 - write方法 (1)向页面输出变量值 document.write(str1); (2)向页面输出html代码 document.write(" "); - getElementById();//通过id得到标签,返回的是一个对象 var input=document.getElementById("nameid");//获取的是标签中的id值 //得到input里面的value值 alert(input.value); //向input里面设置一个value值 input.value="bbbb"; - getElementsByName();//通过标签的name属性值来得到标签,返回的是一个数组 var input=document.getElementsByName("name1"); alert(input.length); //遍历数组 for(var i=0;i var in=nput[i];//每次循环得到的是input的对象 alert(in.value);//得到每个input标签的value值 } - getElementsByTagName(“标签名称”);//返回的是一个数组 var in=document.getElementsByTagName("input");//传递的参数是标签名称 alert(in.length); //遍历集合,每次得一个input标签 for(var i=0;i var ip=in[i]; alert(ip.value); } *** 注意地方 //只有一个标签,这个标签智能通过name获取到,这个使用getElementByName返回的是一个数组 var in=document.getElementsByName("name1")[0]; alert(in.value); //通过input标签获取 var in=document.getElementsByName("input")[0]; alert(in.value); 十四.window弹窗案例 //实现s1的方法 //需要把num1和num2赋值到window页面 //跨页面操作 opener:创建这个窗口的窗口 得到window页面 function s1(num1,num2){ var pwin=window.opener;//得到window的页面 pwin.document.getElementById("nameId").value=num1; pwin.document.getElementById("pwdId").value=num2; window.close(); } 十五:元素对象(element) ** 要操作element对象,首先要获取element ** 方法 获取值 var input=document.getElementById("inid"); alert(input.getAttribute("value")); 设置值 input.setAttribute("参数名","haha"); input.setAttribute("class","haha"); 删除属性,但是不能删除value属性 input.removeAttribute("name"); ** 获取标签下面的子标签 childNodes()(兼容性差),getElementsByTagName()(兼容性高) 111 222 333 //获取ul标签 var ul1=document.getElementById("ulid"); //返回的是一个集合 //获取ul下面的子标签,兼容性差 var lis=ulid.childNodes; alert(lis.length); //获取ul下面的子标签,兼容性高 var lis1=ulid.getElementsByTagName("li") alert(lis.length); ** Node对象属性1 ***nodeName 节点名称 ***nodeType 节点类型 ***nodeValue 节点值 **标签节点对应的值 haha var span1=document.getElementById("spanid"); alert(span1.nodeName); // SPAN 大写标签名称 alert(span1.nodeType); // 1 alert(span1.nodeValue); // null //属性节点对应的值 var id1=spqn1.getAttributeNode("id"); alert(id1.nodeName); // id alert(id1.nodeType); // 2 alert(id1.nodeValue); // spanid //获取文本对象 var test1=span1.firstChild; //文本节点对应的值 alert(test1.nodeType); // 3 alert(test1.nodeName); // #text alert(test1.nodeValue); // haha ** Node对象属性2 111 222 333 var li1=document.getElementById("li1"); * 父节点 ul是li的父节点 parentNode:父节点 var ul1=li1.parentNode; //得到ul alert(ul1.id); * 子节点 li是ul的子节点 childNodes:得到所有的子节点,但是兼容性差 firstChild:第一个子节点 //获取ul的第一个子节点 //得到ul var ul1=document.getElementById("ulid"); var li1=ul1.firstChild; alert(li1.id); // li1 lastChild:最后一个子节点 //获取ul的最后一个子节点 //得到ul var ul1=document.getElementById("ulid"); var li4=ul1.lastChild; alert(li4.id); // li4 * 同辈对象 nextSibling:下一个兄弟节点 previousSibling:上一个兄弟节点 //获取li的id是li3的上个和先一个兄弟节点 var li=document.getElementById("li3"); alert(li.nextSibling.id); // li4 alert(li.previousSibling.id); // li2 十六.操作dom树 111 222 333 **apendChild方法 - 添加子节点到末尾,类似于剪切 //获取div2id的id var div2=document.getElementById("div2id"); //获取ulid的id var ul1=document.getElementById("ulid"); //把ulid中的li标签添加到div2中 ulid.apendChild(div2id); ** insertBefore(newNode,oldNode)方法 - 在么某个节点之前插入一个新的节点 //在 333 之前添加一个 000 111 222 333 function insert1(){ //获取li3的标签 var li3=document.getElementById("li3"); //获取ulid的标签 var ulid=document.getElementById("ulid"); //创建li标签 var li4=document.createElement("li"); //创建文本 var text4=document.createTextNode("000"); //把文本添加到ul标签里面(在 333 之前添加一个 000 ) ulid.insertBefore(li4,li3); } ** 不存在 insertAfter();方法 ** removeChild(); 删除节点 //删除li id="li3">333 //获取里标签 var li3=document.getElementById("li3"); //获取父节点 通过id获取或者是通过parentNode获取 var ulid=document.getElementById("ulid"); ulid.remove(li3); ** replaceChild(newNode,oldNode);//替换节点,通过父节点进行替换 //替换 333 为 444 111 222 333 function replace1(){ //获取li3的标签 var li3=document.getElementById("li3"); //创建新的标签 var li4=document.createElement("li"); //创建新的标签文本 var text4=document.createTextNode("444"); //把文本添加到标签 li4.apendChild(text4); //获取ulid标签 var uid=document.getElementById("ulid"); //执行替换方法 uid.replaceChild(li4,li3); } ** 赋值节点 ***cloneNode(boolean); 111 222 333 function cloneNode1(){ //复制 333 到div中 //获取ulid标签 var ulid=document.getElementById("ulid"); //执行复制方法 var copyul=ulid.cloneNode(true); //获取divv的标签 var divv=document.getElementById("divv"); //把复制的ul标签放在新的div里面 divv.apendChild(copyul); } ** 操作dom树的总结 * 获取节点使用方法 getElementById();//通过节点的id属性,查找相应的节点 getElementsByName();//通过节点的name属性,查找相应的节点 getElementsByTagName();//通过节点名称,查找相应的节点 *插入节点的方法 insertBefore方法: appendChild方法:添加到末尾 *删除方法 removeChild方法:通过父节点删除 * 替换节点的方法 replaceChild方法:通过父节点进行替换 十七.innerHTML属性 * 这个属性不是dom树的组成部分,但是大多数浏览器都支持的属性 第一个作用:获取文本的内容 haha //获取span标签 var span1=document.getElementById("spanid"); //获取标签的文本内容 alert(span1.innerHTML); 第二个作用:向标签里面设置内容(可以是HTML代码) haha //获取span标签 var span1=document.getElementById("spanid"); //获取div的标签 var div1=document.getElementById("divid"); //向div1标签里面设置内容(可以是HTML代码) div1.innerHTML=" hehehe "; * 案例 * 得到当前时间 var date =new date(); var d1= date.toLocaleString(); *需要每一秒获取时间 setInterval方法,定时器 *显示到页面上 每一秒向div写一次时间 * 使用innerHTML属性 function getd1(){ //获取当前时间 var date = new date(); //格式化当前时间 var d1 = date.toLocaleString(); //获取div的id var divv = document.getElementById("divid"); //添加到div中 divv.innerHTML = d1; } //使用定时器实现每一秒写一次时间 setInterval("getd1();",1000); 如果对你有帮助的话,可以点赞收藏哟! 【如果大家对程序员,web前端感兴趣,想要学习的,关注一下小编吧。加群:731771211。免费赠送web前端系统的学习资料!!前端学习必备公众号ID:mtbcxx】

优秀的个人博客,低调大师

Python进阶笔记

列表生成式 函数的参数类型 lambda函数 map, reduce, filter, sorted函数 eval, exec, join, zip函数 itertools中的函数 copy与deepcopy函数 模块 os、sys模块 迭代器 生成器 迭代器 参考网站: Python3教程: https://www.python-course.eu/python3_course.php Python之函数参数的使用:https://blog.csdn.net/jclian91/article/details/78309522 廖雪峰Python教程: https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000 Python之浅谈exec函数: https://blog.csdn.net/jclian91/article/details/80076512 Python官网的itertools说明: https://docs.python.org/3.6/library/itertools.html Python-copy()与deepcopy()区别: https://blog.csdn.net/qq_32907349/article/details/52190796 copy模块官网:https://docs.python.org/3.5/library/copy.html 列表生成式 列表生成式即List Comprehensions,是Python内置的非常简单却强大的可以用来创建list的生成式。一般是利用原有的数据结构来生成新的列表。 # 利用range()生成[1,2,...,9,10] list(range(1,11)) # 生成[1x1, 2x2, 3x3, ..., 10x10] [x * x for x in range(1, 11)] # 可以通过占位符_代表列表中的元素 [_*_ for _ in range(1,11)] # 筛选出仅偶数的平方, 在for循环后加上if判断语句 [x * x for x in range(1, 11) if x % 2 == 0] # 利用占位符简化 [_*_ for _ in range(1, 11) if not _%2] # 两层循环,三层循环,.... [m + n for m in 'ABC' for n in 'XYZ'] [x+y+z for x in 'ab' for y in 'cd' for z in 'ef'] # 遍历字典,生成列表 d = {'x': 'A', 'y': 'B', 'z': 'C' } [k + '=' + v for k, v in d.items()] 函数的参数类型 在Python中定义函数,其参数类型有: - 位置参数 - 默认参数 - 可变参数 - 关键字参数 这4种参数都可以一起使用,或者只用其中某些,但是请注意,参数定义的顺序必须是:位置参数、默认参数、可变参数和关键字参数。 可变参数以*开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个tuple。关键字参数以**开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个dict。若默认参数与可变参数放在一起,则接受完默认参数后,其后参数为可变参数。 位置参数 位置参数指定名称的必须放在未指定名称的后面 def person(name,age,city): s = "info: name=%s, age=%s, city=%s"%(name,age,city) return s print(person('Jack', 25, 'NY')) print(person(name='Jack', age=25, city='NY')) print(person('Jack', 25, city='NY')) # 下面的参数使用有误,位置参数指定名称的必须放在未指定名称的后面 print(person(name='Jack', 25, 'NY')) 默认参数 默认参数必须放在非默认参数的后面,可以该表默认参数的值 def person(name, city, age=18): s = "info: name=%s, age=%s, city=%s"%(name,age,city) return s print(person('Jack', 'NY')) print(person('Jack', 'NY', 20)) 可变参数 可变参数以*开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个tuple。函数参数的长度是可以变化的, 例如内置的sum, min, max等 def var_sum(*args): sum = 0 for i in args: sum += i return sum print(var_sum(1,2,3)) print(var_sum(1,2,3,4)) # 利用*号来分解参数 print(var_sum(*[1,2,3,4,5])) 若位置参数或默认参数与可变参数放在一起,则接受完位置参数或默认参数后,其后参数为可变参数。 def var_sum(a, *args): sum = 0 for i in args: sum += i print('a is %s, sum is %s'%(a,sum)) var_sum(1,2) var_sum(1,2,3) 关键字参数 关键字参数以**开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个dict。 def test_args(**kwargs): print('-'*20) for key in kwargs: print('key:', key, ',value:', kwargs[key]) print() test_args(a=1,b=2) test_args(a=1,b=2,c=3) lambda函数 lambda函数即为匿名函数,用关键字lambda表示,冒号(:)前面的为参数,后面为返回值,不用写return. 如: lambda x: x*x 匿名函数有个限制,就是只能有一个表达式,一般一行代码,不用写return,返回值就是该表达式的结果。 用匿名函数有个好处,因为函数没有名字,不必担心函数名冲突。此外,匿名函数也是一个函数对象,也可以把匿名函数赋值给一个变量,再利用变量来调用该函数,即函数也是变量,此为函数式编程(functional programming)思想。 f = lambda x: x*x f(5) map, reduce, filter, sorted函数 map函数 map()函数接收两个参数,一个是函数,一个是Iterable,map将传入的函数依次作用到序列的每个元素,并把结果作为新的Iterator返回。 可以直接作用于for循环的对象统称为可迭代对象:Iterable. 举例说明,比如我们有一个函数f(x)=x^2,要把这个函数作用在一个list [1, 2, 3, 4, 5, 6, 7, 8, 9]上,就可以用map()实现如下: # map函数: 一一映射 def f(x): return x * x r = map(f, [1, 2, 3, 4, 5, 6, 7, 8, 9]) list(r) # 利用lambda简化上述代码 list(map(lambda x: x*x, range(1, 11))) 再例如: 把list所有数字转为字符串: list(map(str, [1, 2, 3, 4, 5, 6, 7, 8, 9])) reduce函数 reduce把一个函数作用在一个序列[x1, x2, x3, …]上,这个函数必须接收两个参数,一个是函数,一个是Iterable. reduce把结果继续和序列的下一个元素做累积计算,其效果就是: reduce(f, [x1, x2, x3, x4]) = f(f(f(x1, x2), x3), x4) 比方说对一个序列求和,就可以用reduce实现: # 导入reduce, 这很重要 from functools import reduce def add(x, y): return x + y reduce(add, [1, 3, 5, 7, 9]) # 利用lambda函数简化 reduce(lambda x,y: x+y, range(1,10,2)) 作业: 利用reduce将序列[1, 3, 5, 7, 9]转化为整数13579. map, reduce的一个复杂例子: 将字符串列表[‘1’, ‘3’, ‘5’, ‘7’, ‘9’]转化为整数13579 from functools import reduce a = ['1', '3', '5', '7', '9'] t = reduce(lambda x,y: 10*x+y, map(int, a)) print(t) filter函数 Python内建的filter()函数用于过滤序列。 和map()类似,filter()也接收一个函数和一个序列。和map()不同的是,filter()把传入的函数依次作用于每个元素,然后根据返回值是True还是False决定保留还是丢弃该元素。 例如,在一个list中,删掉偶数,只保留奇数,可以这么写: list(filter(lambda x: x%2 == 1, [1, 2, 4, 5, 6, 9, 10, 15])) sorted函数 Python内置的sorted()函数就可以对list进行排序。 sorted([36, 5, -12, 9, -21]) 此外,sorted()函数还可以接收一个key函数来实现自定义的排序,例如按绝对值大小排序: sorted([36, 5, -12, 9, -21], key=abs) sorted(['bob', 'about', 'Zoo', 'Credit'], key=str.lower, reverse=True) 高阶函数,就是让函数的参数能够接收别的函数。map, reduce, filter, sorted都是高阶函数。 join, zip, eval, exec函数 join函数 Python中的join函数有两个,分别为: join()和os.path.join(),具体作用如下: join(): 连接字符串数组。将字符串、元组、列表中的元素以指定的字符(分隔符)连接生成一个新的字符串 os.path.join(): 将多个路径组合后返回 字符串中的join()函数的使用方法: ‘sep’.join(seq) sep:分隔符。可以为空。 seq:要连接的元素序列。 返回一个新的字符串。 seq = ['hello','good','boy','Dido'] print(' '.join(seq)) print('*'.join(seq)) zip函数 zip() 函数用于将可迭代的对象作为参数,将对象中对应的元素打包成一个个元组,然后返回由这些元组组成的列表。 如果各个迭代器的元素个数不一致,则返回列表长度与最短的对象相同,利用 * 号操作符,可以将元组解压为列表。 # basic use of zip x = [1, 2, 3] y = [4, 5, 6] zipped = zip(x, y) print(list(zipped)) # zip for loops for i,j in zip(x,y): print(i, "->", j) # unzip the list a = [(1,2,3), (3,4,5)] x2, y2, z2 = zip(*a) print(x2) print(y2) print(z2) # transpose a matrix mtx = [(1, 2), (3, 4), (5, 6)] print(list(zip(*mtx))) # clustering a data series into n-length groups idiom seq = range(1, 10) print(list(zip(*[iter(seq)]*3))) # dict and zip keys = ['spam', 'eggs'] vals = [42, 1729] d = dict(zip(keys, vals)) print(d) eval函数 eval函数用来计算字符串表达式的值 t = eval("23") print(t) print(type(t)) print(eval("(1+2)*(3+4)")) exec函数 exec()是Python的内置函数,不同于eval()函数只能执行计算数学表达式的结果的功能,exec()能够动态地执行复杂的Python代码,能够十分强大。 简单例子: # 执行简单的Python语句 i = 12 j = 13 exec("answer=i*j") print("Answer is %s"%answer) # 执行复杂的Python语句 func = "def fact(n):\n\treturn 1 if n==1 else n*fact(n-1)" exec(func) a = fact(5) print(a) exec函数还可以执行储存在其他文件中的Python代码,例如位于E盘的eg.txt,如下: def fact(n): if n==1: return 1 else: return n*fact(n-1) t = fact(6) print(t) 利用exec函数执行eg.txt中的代码: with open('E://eg.txt', 'r') as f: s = f.read() exec(s) 还可以在exec()函数中加入参数,参数的传递可以写成字典(dict)形式。 x = 10 expr = """ z = 30 sum = x + y + z print(sum) """ def func(): y = 20 exec(expr) exec(expr, {'x': 1, 'y': 2}) exec(expr, {'x': 1, 'y': 2}, {'y': 3, 'z': 4}) func() 输出结果为: 60 33 34 itertools模块中的函数 Python的内建模块itertools提供了非常有用的用于操作迭代对象的函数。 itertools模块提供的全部是处理迭代功能的函数,它们的返回值不是list,而是Iterator,只有用for循环迭代的时候才真正计算。 无穷迭代器 Iterator Arguments Results Example count() start, [step] start, start+step, start+2*step, … count(10) –> 10 11 12 13 14 … cycle() p p0, p1, … plast, p0, p1, … cycle(‘ABCD’) –> A B C D A B C D … repeat() elem [,n] elem, elem, elem, … endlessly or up to n times repeat(10, 3) –> 10 10 10 “有限”迭代器 Iterator Arguments Results Example accumulate() p [,func] p0, p0+p1, p0+p1+p2, … accumulate([1,2,3,4,5]) –> 1 3 6 10 15 chain() p, q, … p0, p1, … plast, q0, q1, … chain(‘ABC’, ‘DEF’) –> A B C D E F chain.from_iterable() iterable p0, p1, … plast, q0, q1, … chain.from_iterable([‘ABC’, ‘DEF’]) –> A B C D E F compress() data, selectors (d[0] if s[0]), (d[1] if s[1]), … compress(‘ABCDEF’, [1,0,1,0,1,1]) –> A C E F dropwhile() pred, seq seq[n], seq[n+1], starting when pred fails dropwhile(lambda x: x<5, [1,4,6,4,1]) –> 6 4 1 filterfalse() pred, seq elements of seq where pred(elem) is false filterfalse(lambda x: x%2, range(10)) –> 0 2 4 6 8 groupby() iterable[, keyfunc] sub-iterators grouped by value of keyfunc(v) islice() seq, [start,] stop [, step] elements from seq[start:stop:step] islice(‘ABCDEFG’, 2, None) –> C D E F G starmap() func, seq func(*seq[0]), func(*seq[1]), … starmap(pow, [(2,5), (3,2), (10,3)]) –> 32 9 1000 takewhile() pred, seq seq[0], seq[1], until pred fails takewhile(lambda x: x<5, [1,4,6,4,1]) –> 1 4 tee() it, n it1, it2, … itn splits one iterator into n zip_longest() p, q, … (p[0], q[0]), (p[1], q[1]), … zip_longest(‘ABCD’, ‘xy’, fillvalue=’-‘) –> Ax By C- D- groupby()函数 groupby()把迭代器中相邻的重复元素挑出来放在一起: for key, group in itertools.groupby('AAABBBCCAAA'): print(key, list(group)) A ['A', 'A', 'A'] B ['B', 'B', 'B'] C ['C', 'C'] A ['A', 'A', 'A'] 实际上挑选规则是通过函数完成的,只要作用于函数的两个元素返回的值相等,这两个元素就被认为是在一组的,而函数返回值作为组的key。 另一个例子 # 按身高归类 from itertools import * def height_class(h): if h>180: return 'tall' elif h<160: return 'short' else: return 'middle' friends = [191, 158, 159, 165, 170, 177, 181, 182, 190] for m,n in groupby(friends,key = height_class): print(m) print(list(n)) 作业: 对于一组身高的数据(list),利用上面代码给出的身高标准,将所以的tall, short, middle归为一类。注意与groupby()函数的区别。 tee()函数 把一个迭代器分为n个迭代器, 返回一个元组.默认是两个 from itertools import * a = "hello" c, d, e = tee(iter(a), 3) for i, j, k in zip(c, d, e): print(i, j, k) 组合生成器 Iterator Arguments Results product() p, q, … [repeat=1] cartesian product, equivalent to a nested for-loop permutations() p[, r] r-length tuples, all possible orderings, no repeated elements combinations() p, r r-length tuples, in sorted order, no repeated elements combinations_with_replacement() p, r r-length tuples, in sorted order, with repeated elements product(‘ABCD’, repeat=2) AA AB AC AD BA BB BC BD CA CB CC CD DA DB DC DD permutations(‘ABCD’, 2) AB AC AD BA BC BD CA CB CD DA DB DC combinations(‘ABCD’, 2) AB AC AD BC BD CD combinations_with_replacement(‘ABCD’, 2) AA AB AC AD BB BC BD CC CD DD copy与deepcopy函数 copy: 浅拷贝(shallow copy), deepcopy: 深拷贝(deep copy). 我们寻常意义的复制就是深复制,即将被复制对象完全再复制一遍作为独立的新个体单独存在。所以改变原有被复制对象不会对已经复制出来的新对象产生影响。 而浅复制并不会产生一个独立的对象单独存在,他只是将原有的数据块打上一个新标签,所以当其中一个标签被改变的时候,数据块就会发生变化,另一个标签也会随之改变。这就和我们寻常意义上的复制有所不同了。 对于简单的 object,用 shallow copy 和 deep copy 没区别 复杂的 object, 如 list 中套着 list 的情况,shallow copy 中的 子list,并未从原 object 真的「独立」出来。也就是说,如果你改变原 object 的子 list 中的一个元素,你的 copy 就会跟着一起变。这跟我们直觉上对「复制」的理解不同。 例子: from copy import copy, deepcopy #origin 里边有三个元素:1,2,[3, 4] origin = [1, 2, [3, 4]] # cop1为浅拷贝,cop2为深拷贝 cop1 = copy(origin) cop2 = deepcopy(origin) # cop1是否与cop2内容相同 print(cop1 == cop2) # cop1是否与cop2为同一个引用 print(cop1 is cop2) # 改变origin中嵌套列表中的元素 origin[2][0] = "hey" # 查看输出 print(origin) print(cop1) print(cop2) # 改变origin中嵌套列表中的元素 origin[1] = "hello" # 查看输出 print(origin) print(cop1) print(cop2) 输出结果: True False [1, 2, ['hey', 4]] [1, 2, ['hey', 4]] [1, 2, [3, 4]] [1, 'hello', ['hey', 4]] [1, 2, ['hey', 4]] [1, 2, [3, 4]] 模块 在Python中,一个Python文件就是一个模块。 模块让你能够有逻辑地组织你的 Python 代码段。 把相关的代码分配到一个模块里能让你的代码更好用,更易懂。 模块能定义函数,类和变量,模块里也能包含可执行的代码。 一个简单的模块例子: hello.py def say_hello(name): s = 'hello, %s!'%name return s 使用模块: import module from module import … import hello print(hello.say_hello("Lee")) from hello import say_hello print(say_hello("Jack")) os、sys模块 os模块 os模块包含普遍的操作系统功能。 os常用方法及属性 os.sep 可以取代操作系统特定的路径分隔符。windows下为 “\” os.name字符串指示你正在使用的平台。比如对于Windows,它是’nt’,而对于Linux/Unix用户,它是’posix’。 os.getcwd() 函数得到当前工作目录,即当前Python脚本工作的目录路径。 os.getenv() 获取一个环境变量,如果没有返回none os.putenv(key, value) 设置一个环境变量值 os.listdir(path) 返回指定目录下的所有文件和目录名。 os.remove(path) 函数用来删除一个文件。 os.system(command) 函数用来运行shell命令。 os.linesep 字符串给出当前平台使用的行终止符。例如,Windows使用’\r\n’,Linux使用’\n’而Mac使用’\r’。 os.curdir: 返回当前目录(’.’) os.chdir(dirname): 改变工作目录到dirname os.path常用方法: os.path.isfile()和os.path.isdir()函数分别检验给出的路径是一个文件还是目录。 os.path.existe()函数用来检验给出的路径是否真地存在 os.path.getsize(name):获得文件大小,如果name是目录返回0L os.path.abspath(name):获得绝对路径 os.path.normpath(path):规范path字符串形式 os.path.split(path) :将path分割成目录和文件名二元组返回。 os.path.splitext():分离文件名与扩展名 os.path.join(path,name):连接目录与文件名或目录;使用“\”连接 os.path.basename(path):返回文件名 os.path.dirname(path):返回文件路径 sys模块 sys模块提供了一系列有关Python运行环境的变量和函数。 sys模块的常用方法 sys.argv: 实现从终端向程序传递参数。 sys.exit([arg]): 程序中间的退出,arg=0为正常退出。 sys.getdefaultencoding(): 获取系统当前编码,一般默认为ascii。 sys.setdefaultencoding(): 设置系统默认编码,执行dir(sys)时不会看到这个方法,在解释器中执行不通过,可以先执行reload(sys),在执行 setdefaultencoding(‘utf8’),此时将系统默认编码设置为utf8。(见设置系统默认编码 ) sys.getfilesystemencoding(): 获取文件系统使用编码方式,Windows下返回’mbcs’,mac下返回’utf-8’. sys.path: 获取指定模块搜索路径的字符串集合,可以将写好的模块放在得到的某个路径下,就可以在程序中import时正确找到。 sys.platform: 获取当前系统平台。 sys.stdin, sys.stdout, sys.stderr: stdin , stdout , 以及stderr 变量包含与标准I/O 流对应的流对象. 如果需要更好地控制输出,而print 不能满足你的要求, 它们就是你所需要的. 你也可以替换它们, 这时候你就可以重定向输出和输入到其它设备( device ), 或者以非标准的方式处理它们 生成器 通过列表生成式,我们可以直接创建一个列表。但是,受到内存限制,列表容量肯定是有限的。而且,创建一个包含100万个元素的列表,不仅占用很大的存储空间,如果我们仅仅需要访问前面几个元素,那后面绝大多数元素占用的空间都白白浪费了。 所以,如果列表元素可以按照某种算法推算出来,那我们是否可以在循环的过程中不断推算出后续的元素呢?这样就不必创建完整的list,从而节省大量的空间。在Python中,这种一边循环一边计算的机制,称为生成器:generator。 创建generator的办法: 把一个列表生成式的[]改成() yield关键字 将列表的[]改成()的例子: # 列表生成式 L = [x * x for x in range(10)] print(type(L)) # 创建生成器 g = (x * x for x in range(10)) print(type(g)) # 获取下一个返回值 # 当没有更多元素时,会抛出StopIteration错误 print(next(g)) print(next(g)) print(next(g)) # for循环 for n in g: print(n) 通过yield创建生成器 # 普通方法生成斐波拉契数列 # 前几个斐波拉契数 def fib1(max): n, a, b = 0, 0, 1 while n < max: print(b) a, b = b, a + b n = n + 1 return 'done' fib1(6) # 通过yield创建生成器 # 注意yield的执行流程 def fib2(max): n, a, b = 0, 0, 1 while n < max: yield b a, b = b, a + b n = n + 1 return 'done' # 将生成器函数赋值给变量f f = fib2(6) print(type(f)) for n in f: print(n) generator和函数的执行流程不一样。函数是顺序执行,遇到return语句或者最后一行函数语句就返回。而变成generator的函数,在每次调用next()的时候执行,遇到yield语句返回,再次执行时从上次返回的yield语句处继续执行。 generator执行流程的理解: def odd(): print('step 1') yield 1 print('step 2') yield(3) print('step 3') yield(5) o = odd() print(next(o)) print(next(o)) print(next(o)) 迭代器 可以直接作用于for循环的数据类型有以下几种: 集合数据类型,如list、tuple、dict、set、str等; generator,包括生成器和带yield的generator function。 这些可以直接作用于for循环的对象统称为可迭代对象:==Iterable==。 可以使用isinstance()判断一个对象是否是Iterable对象: from collections import Iterable # 判断空列表是否为Iterable对象 # True print(isinstance([], Iterable)) # 判断空集合是否为Iterable对象 # True print(isinstance({}, Iterable)) # 判断字符是否为Iterable对象 # True print(isinstance('abc', Iterable)) # 判断生成器是否为Iterable对象 # True print(isinstance((x for x in range(10)), Iterable)) # 判断数字否为Iterable对象 # False print(isinstance(100, Iterable)) 可以被next()函数调用并不断返回下一个值的对象称为迭代器:Iterator。 可以使用isinstance()判断一个对象是否是Iterator对象: from collections import Iterator # 判断生成器是否为Iterator对象 # True print(isinstance((x for x in range(10)), Iterator)) # 判断空列表是否为Iterator对象 # False print(isinstance([], Iterator)) # 判断空集合是否为Iterator对象 # False print(isinstance({}, Iterator)) # 判断字符串是否为Iterator对象 # False print(isinstance('abc', Iterator)) 生成器都是Iterator对象,但list、dict、str虽然是Iterable,却不是Iterator。 把list、dict、str等Iterable变成Iterator可以使用iter()函数。

优秀的个人博客,低调大师

Java ClassLoader笔记

.java:保存需要执行的程序逻辑 编译  .class:保存java代码转换后的虚拟机指令要使用某个类时,虚拟机将加载.class文件,并创建对应的class对象。 将class文件加载到虚拟机的内存的过程叫类加载,过程如下:①加载Loading:利用class文件创建class对象②验证Verification:确保class文件的字节流中包含信息符合虚拟机要求,不会危害虚拟机本身安全,包括四种验证:文件格式验证;元数据验证;字节码验证;符号引用验证。③准备Preparation:为类变量(static修饰的变量)分配内存并设置该类变量的初始值0(static int i = 5;将只会把i初始化为0,5的值在初始化时赋值)。注意:智利不包含用final修饰的static,因为final在编译时就会分配了;这里不会为实例变量分配初始化,连变量会分配在方法区中,而实例变量是会随着对象一起分配到java堆中。④解析Resolution:将常量池中的符号引用替换为直接引用的过程。⑤初始化Initialization:执行静态初始化器和静态初始化成员变量。其中②③④被称为链接(Linking)过程。 符号引用:符号引用就是字符串,这个字符串包含足够的信息,以供实际使用时可以找到相应的位置。你比如说某个方法的符号引用,如:“java/io/PrintStream.println:(Ljava/lang/String;)V”。里面有类的信息,方法名,方法参数等信息。当第一次运行时,要根据字符串的内容,到该类的方法表中搜索这个方法。运行一次之后,符号引用会被替换为直接引用,下次就不用搜索了。直接引用就是偏移量,通过偏移量虚拟机可以直接在该类的内存区域中找到方法字节码的起始位置。直接引用:(1)直接指向目标的指针(比如,指向“类型”【Class对象】、类变量、类方法的直接引用可能是指向方法区的指针)(2)相对偏移量(比如,指向实例变量、实例方法的直接引用都是偏移量)(3)一个能间接定位到目标的句柄符号引用和直接引用的解释:https://www.zhihu.com/question/30300585https://blog.csdn.net/kkdelta/article/details/17752097启动(BootStrap)类加载器:加载JVM自身需要的类,是虚拟机自身的一部分,会将JAVA_HOME/lib下的核心类库或-Xbootclasspath参数指定路径下的jar包加载到内存中(出于安全考虑,bootstrap类加载器只加载包名为java、javax、sun等开头的类)。 扩展(Extension)类加载器:Sun公司实现的sum.misc.Luncher$ExtClassLoader类,是Luncher的静态内部类,负责加载JAVA_HOME/lib/ext下或由系统变量-Djava.ext.dir指定路径中的类库,开发者可以直接使用标准扩展类加载器。 系统(System)类加载器:也称应用程序加载器,指sun公司实现的sum.misc.Launcher$AppClassLoader。负责加载系统类路径java –classpath或 –Djava.class.path下的类库。一般情况下该类加载器是程序默认的类加载器,可以通过ClassLoader#getSystemClassLoader()方法获取到该类加载器。 双亲委派模式加载: 原理说明:一个类加载器收到了类加载请求,不会自己先加载,而是把这个请求委派给父类加载器去执行,如果父类还有父类则继续向上委托,最终达到顶层的启动类加载器,从启动类加载器开始进行加载,如果成功则返回,否则子加载器才会尝试自己加载。好处:①防止重复加载:如果父加载器已经加载了此类子加载器就没必要再加载了②安全考虑:如果运行时要加载一个java.lang.Integer类,会传递到启动类加载器,而启动类加载器发现在核心java API中有这个类已被加载,就直接返回已经加载了的Integer.class。再例如:要加载一个java.lang.FakeInteger,启动,扩展类加载器的路径下都没有该类,不会加载,会反向委托给系统类加载器加载,但是这样是不行的,因为java.lang是核心API包,需要访问权限,强制加载会报如下异常:java.lang.SecurityException: Prohibited package name: java.lang 类加载器常见类:通过上面的报错堆栈,可以看出几个ClassLoader相关类的关系如下: ①ClassLoader抽象类,定义了几个基本的类加载相关方法。②SecureClassLoader扩展了ClassLoader,新增了几个与使用相关的代码源和权限定义类验证。③URLClassLoader实现了ClassLoader没实现的几个方法,如findClass 等,有一个相关类URLClassPath负责获取Class字节码流,一般自定义类加载器继承URLClassLoader即可。这两个类的构造方法都有一个必填参数URL,该参数是一个路径,可能是文件或jar包,然后根据不同路径创建FileLoader或JarLoader或默认的Loader去加载相应路径下的class文件。 类加载器常用方法:①loadClass ②findClass③defineClass将byte字节流解析成JVM能够识别的Class对象,一般defineClass()方法通常与findClass()方法一起使用,一般在自定义类加载器时会覆盖ClassLoader类的findClass方法并编写加载规则,取的要加载类的字节码后转换成流,然后调用defineClass方法成成类的Class对象。④resolveClass(Class c)对Class对象进行解析。 ExtClassLoader和AppClassLoader他们都继承自URLClassLoader,是sun.misc.Launcher的静态内部类。类结构如下: 类加载器关系:①启动类加载器:由C++实现,没有父加载器②扩展类加载器(ExtClassLoader)由Java实现,父加载器为null③系统类加载器(AppClassLoader),父加载器为ExtClassLoader④自定义类加载器,父加载器为AppClassLoader 我们实现的自定义类加载器的父加载器都是AppClassLoader。Launcher类的源码如下: 如上:Launcher初始化时会创建ExtClassLoader,然后把ExtClassLoader作为parent入参构造AppClassLoader,然后将AppClassLoader默认设置为线程上下文加载器。而ExtClassLoader的parent为null,如下代码: 类与类加载器JVM中两个class对象是否是统一个类对象的必要条件为:①类的完整类名必须一致,包括包名②加载这个类的ClassLoader必须相同 实现自己的ClassLoaderpublic class MyClassLoader extends ClassLoader{ private String classPath; public MyClassLoader(){ super(); } public MyClassLoader(String classPath){ this.classPath = classPath; } public static void main(String[] args) { try { String path = "F:\\Learn\\Java\\workspace\\spring\\MyClassLoader\\bin"; MyClassLoader mcl1 = new MyClassLoader(path); // 自定义类加载器实例1 Class clazz1 = mcl1.findClass("com.classloader.MyClassLoader"); // 自定义类加载器加载自身类 MyClassLoader mcl2 = new MyClassLoader(path); // 自定义类加载器实例2 Class clazz2 = mcl2.findClass("com.classloader.MyClassLoader"); // 自定义类加载器加载自身类 Object inst = clazz1.newInstance(); //new一个自身类的实例 System.out.println(inst.toString()); System.out.println(mcl1.getClass().hashCode());//系统默认加载器加载的class类的实例是一样的 System.out.println(mcl2.getClass().hashCode());//系统默认加载器加载的class类的实例是一样的 System.out.println(clazz1.hashCode());//自定义加载器两次加载的class实例是不一样的(使用findClass) System.out.println(clazz2.hashCode());//自定义加载器两次加载的class实例是不一样的(使用findClass) System.out.println(mcl1.loadClass("com.classloader.MyClassLoader").hashCode());//loadClass和上面findClass的class对象实例是一样,因为loadClass时会先findClass,检查类是否已经被加载 System.out.println(mcl2.loadClass("com.classloader.MyClassLoader").hashCode());//loadClass和上面findClass的class对象实例是一样,因为loadClass时会先findClass,检查类是否已经被加载 System.out.println(mcl1.getSystemClassLoader());//系统类加载器是AppClassLoader System.out.println(mcl1.getParent());//自定义类加载器的父加载器是AppClassLoader System.out.println(mcl1.getSystemClassLoader().getParent());//系统类加载器的父加载器是ExtClassLoader System.out.println(mcl1.getSystemClassLoader().getParent().getParent());//ExtClassLoader的父加载器是null } catch (Exception e) { e.printStackTrace(); } } @Override public String toString() { return "MyClassLoader"; } public Class<?> findClass(String name) throws ClassNotFoundException { // 获取class文件的byte[]数组 try { byte[] classBytes = findClassBytes(name); if(null == classBytes){ throw new ClassNotFoundException(); } return defineClass(name,classBytes,0,classBytes.length); } catch (FileNotFoundException e) { e.printStackTrace(); } return null; } public byte[] findClassBytes(String className) throws FileNotFoundException { String path = this.classPath + File.separatorChar + className.replace('.', File.separatorChar) + ".class"; InputStream is = null; if(this.classPath.startsWith("http")){ try { /*URL u = new URL(path); is = u.openStream();*/ } catch (Exception e) { e.printStackTrace(); } }else{ is = new FileInputStream(path); } ByteArrayOutputStream baos = new ByteArrayOutputStream(); byte[] bs = new byte[1024]; int bytesNum = 0; try { while((bytesNum = is.read(bs)) != -1){ baos.write(bs,0,bytesNum); } return baos.toByteArray(); } catch (IOException e) { e.printStackTrace(); } finally{ try { is.close(); baos.close(); } catch (IOException e) { e.printStackTrace(); } } return null; } }

优秀的个人博客,低调大师

Yaml入门笔记

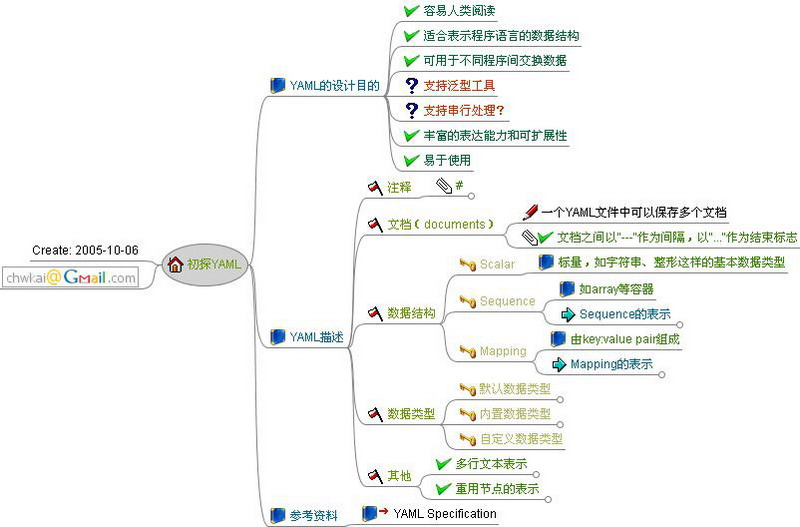
什么是yamlYAML是"YAML Ain't a Markup Language"(YAML不是一种置标语言)的递归缩写,早先YAML的意思其实是:"Yet Another Markup Language"(另外一种置标语言),但为了强调这种语言以数据做为中心,而不是以置标语言为重点,而用返璞词重新命名,YAML的官方定义很简单,即一种人性化的数据格式定义语言,其主要功能用途类似于XML或JSON,YAML使用空白字符和分行来分隔数据,且巧妙避开各种封闭符号,如:引号、括号等,以避免这些符号在复杂层次结构中变得难以辨认。YAML的语法与高阶语言类似,可以很简单地表述序列(java中的list)、杂凑表(java中的map)、标量(java中的基本类型等)数据结构,它重点强调可阅读性。 本文内容 image.png YAML的设计目的 容易人类阅读 适合表示程序语言的数据结构 可用于不同程序间交换数据 支持泛型工具 支持串行处理? 丰富的表达能力和可扩展性 易于使用 xml和yaml的代码块: xml代码块: <site> <name>github</name> <url>https://github.com</url> </site> <site> <name>简书</name> <url>https://www.jianshu.com</url> </site> yaml代码块: --- site: name: github url: https://github.com --- site: name: 简书 url: https://www.jianshu.com --- #或者 --- site:{name:github,url:https://github.com} --- site:{name:简书,url:https://jianshu.com} 主要标记 注释-comment 举例: # Comment Example # Profile Of Mary Mary: - name: Mary - age : 19 # age property 文档(document) # documents example --- site: name: github url: https://github.com --- site: name: 简书 url: https://www.jianshu.com 数据结构 YAML的设计者认为在配置文件中所要表达的数据内容有三种类型:标量(Scalar,如字符串和整数等)、序列(Sequence,如数组)和Mapping(类似hash的key/value pair)。 sequence.png mapping.png 例子:我们用YAML来描述一本书: # 《单元测试之道-c#版》描述 --- # begin of document 书名 : '单元测试之道-C#版' 出版社: '电子工业出版社' 原作者: ['Andrew Hunt', 'David Thomas'] 译者 : - 陈伟柱 - 陶文 前二章节 : - 第一章: 序言 - 第二章: 你的首个单元测试计划 #end document 注意:YAML推荐使用空格作为缩进,避免了在不同编辑器中对tab的表示形式不同而可能产生误解。 YAML 与 XML 优势: YAML的可读性好 YAML和脚本语言的交互性好 YAML使用实现语言的数据类型 YAML有一个一致的信息模型 YAML易于实现 上面5条是XML不足的地方,同时,YAML也具有XML的下列优点: YAML可以基于流来处理 YAML表达能力强,扩展性好 YAML类似于XML的数据描述语言,语法比XML简单很多,YAML试图用一种比XML更敏捷的方式,来完成XML所完成的任务。 YAML 与 JSON JSON的语法其实是YAML的子集,大部分的JSON文件都可以被YAML的剖析器剖析。虽然大部分的数据分层形式也可以使用类似JSON的格式,不过YAML并不建议这样使用,除非这样编写能让文件可读性增加,更重要的是,YAML的许多扩展在JSON是找不到的,如:进阶资料形态、关系锚点、字串不需要引号、映射资料形态会储存键值的顺序等。 YAML用途 脚本语言 由于实现简单,解析成本很低,YAML特别适合在脚本语言中使用。列一下现有的语言实现:Ruby,Java,Perl,Python,PHP,OCaml,JavaScript,除了Java,其他都是脚本语言。 序列化 YAML比较适合做序列化。因为它是宿主语言数据类型直转的。 配置文件 YAML做配置文件也不错。写YAML要比写XML快得多(无需关注标签或引号),并且比ini文档功能更强。 调试 由于其很强的阅读性,用于调试过程中dump出信息供分析也是一种比较方便的做法。 YAML缺陷与不足 YAML没有自己的数据类型的定义,而是使用实现语言的数据类型。一个YAML文件,在不同语言中解析后得到的数据类型可能会不同,由于其兼容性问题,不同语言间的数据流转不建议使用YAML。 YAML语法与范例 YAML使用可打印的Unicode字符,可使用UTF-8或UTF-16 使用空白字符(不能使用<kbd>Tab</kbd>)分层,同层元素左侧对齐 单行注解由井字号(<kbd> #</kbd> )开始,可以出现在行中任何位置 每个清单成员以单行表示,并用短杠+空白(<kbd>- </kbd>)起始 每个杂凑表的成员用冒号+空白(<kbd>: </kbd>)分开键和值 杂凑表的键值可以用问号 (<kbd>?</kbd>)起始,表示多个词汇组成的键值 字串一般不使用引号,但必要的时候可以用引号框住 使用双引号表示字串时,可用倒斜线(<kbd></kbd>)进行特殊字符转义 区块的字串用缩排和修饰词(非必要)来和其他资料分隔,有新行保留(使用符号<kbd>|</kbd>)或新行折叠(使用符号<kbd>></kbd>)两种方式 在单一档案中,可用连续三个连字号(<kbd>---</kbd>)区分多个档案 可选择性的连续三个点号(<kbd>...</kbd>)用来表示档案结尾(在流式传输时非常有用,不需要关闭流即可知道到达结尾处) 重复的内容可使从参考标记星号 (<kbd>*</kbd>)复制到锚点标记(<kbd>&</kbd>) 指定格式可以使用两个惊叹号 ( !! ),后面接上名称 receipt: Oz-Ware Purchase Invoice date: 2007-08-06 customer: given: Dorothy family: Gale items: - part_no: A4786 descrip: Water Bucket (Filled) price: 1.47 quantity: 4 - part_no: E1628 descrip: High Heeled "Ruby" Slippers price: 100.27 quantity: 1 bill-to: &id001 street: | 123 Tornado Alley Suite 16 city: East Westville state: KS ship-to: *id001 specialDelivery: > Follow the Yellow Brick Road to the Emerald City. Pay no attention to the man behind the curtain. ... 这个文件的的顶层由七个键值组成:其中一个键值"items",是个两个元素构成的清单,清单中的两个元素同时也是包含了四个键值的杂凑表。 文件中重复的部分处理方式:使用锚点(&)和参考(*)标签将"bill-to"杂凑表的内容复制到"ship-to"杂凑表。也可以在文件中加入选择性的空行,以增加可读性。 YAML的JAVA实现 YAML已经有了多种语言不少实现,详见YAML官网。 一般YAML文件扩展名为.yaml,比如John.yaml,其内容为: name: John Smith age: 37 children: - name: Jimmy Smith age: 15 - name: Jenny Smith age: 12 spouse: name: Jane Smith age: 25 由于yaml的超强可读性,我们了解到:John今年37岁,两个孩子Jimmy 和Jenny活泼可爱,妻子Jane年轻美貌,而且年仅25岁,一个幸福的四口之家。 对John.yaml进行java描述,抽象出一个Person类,如下: public class Person { private String name; private int age; private Person sponse; private Person[] children; // setXXX, getXXX方法略. } 现在我们使用java装配一个Jone: Person john = new Person(); john.setAge(37); john.setName("John Smith"); Person sponse = new Person(); sponse.setName("Jane Smith"); sponse.setAge(25); john.setSponse(sponse); Person[] children = {new Person(), new Person()}; children[0].setName("Jimmy Smith"); children[0].setAge(15); children[1].setName("Jenny Smith"); children[1].setAge(12); john.setChildren(children); 使用SnakeYAML实现 项目主页:http://code.google.com/p/snakeyaml/ 使用手册:https://code.google.com/p/snakeyaml/wiki/Documentation SnakeYAML是一个标准的YAML的java实现,它有以下特点: 完全支持YAML 1.1,可以跑通规范中的所有示例 支持YAML的所有类型 支持UTF-8/UTF-16的输入和输出 提供了本地java对象的序列化和反序列化的高层API 提供相对合理的错误提示信息 使用SnakeYAML将john dump出来,如果有引用相同对象,则dump出到yaml文件会自动使用<kbd>&</kbd>和<kbd></kbd>进行锚点和引用*: DumperOptions options = new DumperOptions(); options.setDefaultFlowStyle(DumperOptions.FlowStyle.BLOCK); Yaml yaml = new Yaml(options); //Yaml yaml = new Yaml(); String dump = yaml.dump(john); System.out.println(dump); 内容如下: !!Person age: 37 children: - age: 15 children: null name: Jimmy Smith sponse: null - age: 12 children: null name: Jenny Smith sponse: null name: John Smith sponse: age: 25 children: null name: Jane Smith sponse: null 现在用SnakeYAML把yaml load进来,如果yaml文件中使用了<kbd>&</kbd>和<kbd></kbd>,则会自动对load出来的对象赋相同的值*: Yaml yaml = new Yaml(); Object load = yaml.load(new FileInputStream(new File("jhon.yaml"))); System.out.println(load.getClass()); System.out.println(yaml.dump(load)); 或 Yaml yaml = new Yaml(options); Person person = yaml.loadAs(inputStream, Person.class); System.out.println(person.getSponse().getChildren().length); 如果一个yaml文件中有多个文档,由<kbd>---</kbd>分割,解析如下: Yaml yaml = new Yaml(); int counter = 0; for (Object data : yaml.loadAll(input)) { System.out.println(data); counter++; } 保存一个Map对象: Map<String, Object> data = new HashMap<String, Object>(); data.put("name", "Silenthand Olleander"); data.put("race", "Human"); data.put("traits", new String[] { "ONE_HAND", "ONE_EYE" }); Yaml yaml = new Yaml(); String output = yaml.dump(data); System.out.println(output); // or StringWriter writer = new StringWriter(); yaml.dump(data, writer); System.out.println(writer.toString()); 将多个文档dump出到同一个yaml文件中去: List<Integer> docs = new LinkedList<Integer>(); for (int i = 1; i < 4; i++) { docs.add(i); } DumperOptions options = new DumperOptions(); //options.setCanonical(true); options.explicitStart(true); Yaml yaml = new Yaml(options); System.out.println(yaml.dump(docs)); System.out.println(yaml.dumpAll(docs.iterator())); --- [1, 2, 3] --- 1 --- 2 --- 3 YAML JAVA !null null !!bool Boolean !!int Integer, Long, BigInteger !!float Double !!binary String !!timestamp java.util.Date, java.sql.Date, java.sql.Timestamp !!omap, !!pairs List of Object[] !!set Set !!str String !!seq List !!map Map YAML与java类型对照表: YAML JAVA !null null !!bool Boolean !!int Integer, Long, BigInteger !!float Double !!binary String !!timestamp java.util.Date, java.sql.Date, java.sql.Timestamp !!omap, !!pairs List of Object[] !!set Set !!str String !!seq List !!map Map 集合的默认实现是: List: ArrayList Map: LinkedHashMap 使用JYaml实现 JYaml(最新版本是2007年的,可以考虑放弃了),使用JYaml把Jone “Dump” 出来: File dumpfile = new File("John_dump.yaml"); Yaml.dump(john, dumpfile); 下面我们看看John_dump.yaml是什么样子: --- !yaml.test.internal.Person age: 37 children: !yaml.test.internal.Person[] - !yaml.test.internal.Person age: 15 name: Jimmy Smith - !yaml.test.internal.Person age: 12 name: Jenny Smith name: John Smith sponse: !yaml.test.internal.Person age: 25 name: Jane Smith 其中!yaml.test.internal.Person是一些类型的信息。load的时候需要用。 现在用JYaml把Jone_dump.yaml load进来: Person john2 = (Person) Yaml.loadType(dumpfile, Person.class); 还可以用下面的代码dump出没有类型信息的John.yaml: Yaml.dump(john,dumpfile, true); 我们再来看看JYaml对流处理的支持,为简便起见,我们只是把同一个john写10次: YamlEncoder enc = new YamlEncoder(new FileOutputStream(dumpfile)); for(int i=0; i<10; i++){ john.setAge(37+i); enc.writeObject(john); enc.flush(); } enc.close(); 下面再把这十个对象一个一个读出来(注意while循环退出的方式): YamlDecoder dec = new YamlDecoder(new FileInputStream(dumpfile)); int age = 37; while(true){ try{ john = (Person) dec.readObject(); assertEquals(age, john.getAge()); age++; }catch(EOFException eofe){ break; } } 参考文档: YAML Specification YAML 数据类型说明 http://blog.csdn.net/conquer0715/article/details/42108061 http://www.cnblogs.com/chwkai/archive/2009/03/01/249924.html

优秀的个人博客,低调大师

Python学习笔记

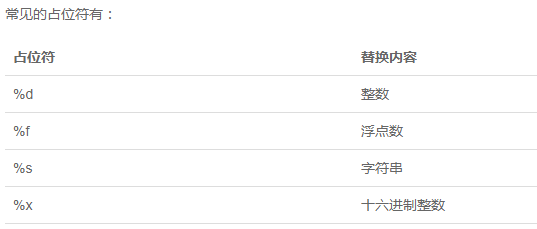
一:中文编码 1:指定编码 python-------》#!/usr/bin/python shell----------》#!/bin/bash 2:中文识别 # -*- coding: UTF-8 -*- 或 #coding=utf-8 3:多行语句 我们使用斜杠(/)将一行语句分成多行 如果是{},(),[]则直接可以进行换行 4.转义 \n表示换行、\t表示制表符、\\表示\、 如果有很多需要转义,则可使用r' ' ''' '''也可以表示换行 print('''line1 line2 line3''') 5:输出 print x,y print默认是换行的,如果再print末尾加个逗号“,”就回不换行 6.输入 shell:read -p "Please enter your age: " age python2:a = raw_input("请输入你的名字") python3:a = input("请输入你的名字") 二:变量和简单类型 python中数据类型分为5种:数字,字符串、列表、元组、字典 变量命名规则: python shell 文件名/模块名 小写,单词用“_”分割 ----->ad_stats.py 包名 小写,单词用“_”分割 类名 单词首字母大写----->ConfigUtil 全局变量名 大写字母,单词之间用_分割 ------->COLOR_WRITE 普通变量 小写字母,单词之间用_分割 ------->this_is_a_var 实例变量 以_开头,其他和普通变量一样 ----->_instance_var 普通函数 和普通变量一样-------------------->get_name() 2.1数字 整数:a=1 浮点数:a=1.234 2.2字符串 创:var1 = 'Hello World!' 查:print "var1[0]: ", var1[0] print "var2[1:5]: ", var2[1:5] 改:print "更新字符串 :- ", var1[:6] + 'Runoob!' rd()函数获取字符的整数表示,chr()函数把编码转换为对应的字符 占位符 'Hi, %s, you have $%d.' % ('Michael', 1000000) 如果你不太确定应该用什么,%s永远起作用,它会把任何数据类型转换为字符串 另外一种格式化字符串的方法是format(),他会将传入的参数依次替换{1},{2},{3}......,... 'Hello, {0}, 成绩提升了 {1:.1f}%'.format('小明', 17.125) 2.3布尔值 布尔值只有True、False两种值 2.4空值 2.5常量 10/3=3.3333 9/3=3.0 10//3=3 10%3=1 2.6除法 余数: >>> divmod(10,3) (3, 1) 四舍五入: >>> round(10/3,4) 3.0 >>> round(10.0/3,4) 3.3333 2.7数学函数与运算优先级 1.绝对值 abs(-10)=10 2.四舍五入 round(1.234)=1 三:高级特性 1.切片 L[0:3]表示,从索引0开始取,直到索引3为止,但不包括索引3。即索引0,1,2,正好是3个元素 如果第一个索引是0,还可以省略-------》L[:3] 前10个数,每两个取一个----------》L[:10:2] 所有数,每5个取一个--------------》L[::5] 什么都不写,只写[:]就可以原样复制一个list-----------》L[:] 2.迭代 3.列表生成器 [x * x for x in range(1, 11)]--------》[1, 4, 9, 16, 25, 36, 49, 64, 81, 100] 四:列表(List) list是一种有序的集合,可以随时添加和删除其中的元素。 list1 = ['Michael', 'Bob', 'Tracy'] 增:list1.append('adm')、 list1.insert(1,'jack') #插入元素到指定的位置 删:list1.pop(1) #不填则删除末尾元素 del list1[2] 查:list1[-1] 改:list1[1] ='Sarah',dellist1[2]; 附加:s = ['python','java', ['asp','php'],'scheme'],s[2][1] 五:元组 Python的元组与列表类似,不同之处在于元组的元素不能修改。 tup1 = ('physics', 'chemistry', 1997, 2000); 查:tup1[2] 较:cmp(tuple1, tuple2) 长:len(tup1) 六:字典 字典是另一种可变容器模型,且可存储任意类型对象。 d = {key1 : value1, key2 : value2 } 增: 删:del d['key1']; # 删除键是'key1'的条目 d.pop(key1) #删除对应的键值对 d.clear(); # 清空词典所有条目 del d; # 删除词典 查:d['key1'] d.get(key1)---------->value1 d..has_key(key1)-------->返回true或者false d.keys()-------------->返回所以键['key2','key1'] dict.values()---------->返回所以值[value1,value2] 改:d['key1']=value3 d.update(dict2)----------->将dict2添加到d后面 判:d.has_key(key1)---------->存在则返回true,否则为false 较:cmp(dict1, dict2) 长:len(dict) 七:运算符 python中运算符分为7种:1.算术运算符 2.比较(关系)运算符 3.赋值运算符 4.逻辑运算符 5.位运算符 6.成员运算符 7.身份运算符 1.算术运算符:+、-、*、%(求余)、**(次幂a**b)、//(取整) 2.比较运算符:==(比较是否相等)、!=、<>(比较两个数是否不相等)、>=、<= 3.赋值运算符:=、+=、-=、*=、/=(除法赋值运算符)、%=(取模赋值运算符)、**=(幂赋值运算符)、//=(取整运算符) 4.位运算符:&、|、^、 5.and(与)、or(或)、not 6.in(在)、not in(不在) 7.is(是)、is not(不是) 优先级 八:语句 python分为7种:条件语句,循环语句(while循环,for循环),break语句,continue循环语句,pass循环 python循环语句不用括号()括起来 1:条件语句 num = 5 if num == 3: # 判断num的值 print 'boss' elif num == 2:print 'user' elif num == 1:print 'worker' elif num < 0: # 值小于零时输出 print 'error' else:print 'roadman' # 条件均不成立时输出 2:循环语句 while...else循环 count = 0 while count < 5: print count, " is less than 5" count = count + 1 else: print count, " is not less than 5" for循环 for num in range(10,20): # 迭代 10 到 20 之间的数字 for i in range(2,num): # 根据因子迭代 if num%i == 0: # 确定第一个因子 j=num/i # 计算第二个因子 print '%d 等于 %d * %d' % (num,i,j) break # 跳出当前循环 else: # 循环的 else 部分 print num, '是一个质数' 九:函数 9.1函数规则 1:函数代码块以def关键字开头,后接函数标识符名称和圆括号() 2:任何传入参数和变量必须放在圆括号中间,圆括号中可以用于定义参数 3:函数第一行语句可以放文档字符串,用于存放函数说明 4:函数内容以冒号起始,并且缩进 #python函数 def printinfo( name, age ): "打印任何传入的字符串" print "Name: ", name; print "Age ", age; return; #调用printinfo函数 printinfo( age=50, name="miki" ); #shell函数 function RintedConfig(){ } 9.2函数参数 1.必备参数、2.关键字参数、3.默认参数、4.不定长参数 1:必备参数 必备参数须以正确的顺序传入函数。调用时的数量必须和声明时的一样。 2:关键字参数 使用关键字参数允许函数调用时参数的顺序与声明时不一致,因为 Python 解释器能够用参数名匹配参数值。 def printinfo( name, age ): printinfo( age=50, name="miki" ); 3:缺省参数 调用函数时,缺省参数的值如果没有传入,则被认为是默认值。 def printinfo( name, age = 35 ): printinfo( name="miki" ); 4:不定长参数 你可能需要一个函数能处理比当初声明时更多的参数。这些参数叫做不定长参数, def functionname([formal_args,] *var_args_tuple ): 加了星号(*)的变量名会存放所有未命名的变量参数 9.3高阶函数 1.map() map()可接受两个参数,一个是函数,一个是Iterable,map将传入的参数作用到序的每个元素,并把结果作为新的Iterable返回。 def f(x): return x*x map(f, [1,2,3,4]) >>[1,4,9,16] 2.return() return接收一个函数和两个参数,reduce把结果继续和序列的下一个元素做累积计算。 def f(x,y): return x+y >>map(f, [1,2,3,4]) >>25 3.filter() 用于过滤序列,filter()将元素作用于每个人元素,并根据返回值是true或者false来决定元素的去留。 def is_odd(n): return n % 2==1 filter(is_odd, [1,2,3,4,5,6]) 4.sorted() sorted()可将元素进行排序, def reversed_cmp(x, y): if x > y: return -1 if x < y: return 1 return 0 >>> sorted([36, 5, 12, 9, 21], reversed_cmp) [36, 21, 12, 9, 5] 9.4返回函数 高阶函数除了可以将函数作为参数,也可以将函数作为结果返回。 def lazy_sum(*args): def sum(): ax = 0 for n in args: ax = ax + n return ax return sum 9.5匿名函数 关键字lambda表示匿名函数, 匿名函数有个限制,就是只能使用一个表达式,返回值就是该表达式的结果。 map(lambda x: x*x, [1,2,3,4,5,6]) 使用匿名函数就不用担心名字冲突,同是匿名函数也是一个对象,可以将匿名函数作为参数。 ff = lambda x: x*x print ff(5) 9.6装饰器 有时候为了增强函数的功能,但又不改变函数的定义,这种在代码运行期间动态的增加函数的功能的方法叫装饰器。 def log(text): def decorator(func): def wrapper(*args, **kw): print('%s %s():' % (text, func.__name__)) return func(*args, **kw) return wrapper return decorator @log('execute') def now(): print('2015-3-25') >>> now() execute now(): 2015-3-25 9.7偏函数 十:模块 10.1作用域 有的函数和变量,我们仅仅希望在模块内使用,python中我们通过_前缀来实现。 正常的函数和变量都是被公开的,_xxx和__xxx这样的函数或变量就是非公开的(private),不应该被直接引用。 带下划线的函数,说明该函数不能根据 from * import来导入,明显在这个模块中你导入的还只是包,然后通过了这个导入的包去调用他内部存在的函数。 十一:面向对象编程 11.1类和实例 class Student (Object): class后面接的是类名,类名手写字母必须大写,紧接的是object,表示该类所继承的类,如果没有,则继承自object类。 class Student(object): def __init__(self, name, score): self.name = name self.score = score def print_score(self): print '%s: %s' % (self.name, self.score) 11.2访问限制 如果要让内部属性,不被外部访问,可以将属性的名称前面加两个下划线,python中变量以__开头的则为私有变量(private),只有内部可以访问,外部不能被访问。 外部要获取和改变,只能通过get和set方法来进行。 class Student(object): def __init__(self, name, score): self.__name = name self.__score = score def print_score(self): print '%s: %s' % (self.__name, self.__score) #外部直接获取 >>> bart = Student('Bart Simpson', 98) >>> bart.__name Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'Student' object has no attribute '__name'#必须使用getname和setname方法 class Student(object): ... def get_name(self): return self.__name def get_score(self): return self.__score 11.3基础多态 继承可以把父类的所有功能都直接拿过来,这样就不必重零做起,子类只需要新增自己特有的方法,也可以把父类不适合的方法覆盖重写; 有了继承,才能有多态。在调用类实例方法的时候,尽量把变量视作父类类型,这样,所有子类类型都可以正常被接收; 11.4获取对象信息 1.type() type可以判断一个变量、函数,类的类型。 2.isinstance() isinstance()判断的是一个对象是否是该类型本身,或者位于该类型的父继承链上。 3.dir() 如果要获得一个对象的所有属性和方法,可以使用dir()函数,它返回一个包含字符串的list。 11.5__slots__ 如果想对向前类进行限制只添加某几个属性,可以使用__slots__来进行限制。 __slots__只对当前类起作用,对继承的类不起作用。 class Student(object): __slots__=('name','age') s = Student() s.name = 'yaohong' s.age = 90 s.socre = 99 》》 s.socre = 99 AttributeError: 'Student' object has no attribute 'socre' 11.6@property Python内置的@property装饰器就是负责把一个方法变成属性调用的。 class Student(object): @property def birth(self): return self._birth @birth.setter def birth(self, value): self._birth = value @property def age(self): return 2014 - self._birth 11.7多继承 一个子类同时获得多个父类的所有功能。 由于Python允许使用多重继承,因此,Mixin就是一种常见的设计。 只允许单一继承的语言(如Java)不能使用Mixin的设计。 11.8定制类 __str__ class Student(object): def __init__(self, name): self.name = name def __str__(self): return self.name def __repr__(self): return self.name print Student('YAOHONG') print Student('YAOHONG') 11.9使用元类 十二:文件I/O 10.1打印到屏幕 print “”itnihao” 10.2读取输入 1.raw_input str = raw_input("请输入:"); print "你输入的内容是: ", str 2.input input可以接收一个函数表达式 str = input("请输入:"); print "你输入的内容是: ", str 3.open() file object = open(file_name [, access_mode][, buffering]) file_name:file_name变量是一个包含了你要访问的文件名称的字符串值。 access_mode:access_mode决定了打开文件的模式:只读,写入,追加等。所有可取值见如下的完全列表。这个参数是非强制的,默认文件访问模式为只读(r)。 buffering:如果buffering的值被设为0,就不会有寄存。如果buffering的值取1,访问文件时会寄存行。如果将buffering的值设为大于1的整数,表明了这就是的寄存区的缓冲大小。如果取负值,寄存区的缓冲大小则为系统默认。 4.close() close()方法刷新缓冲区里任何还没写入的信息,并关闭该文件,这之后便不能再进行写入。 5.write() write()方法可将任何字符串写入一个打开的文件 6.read() fo = open("foo.txt", "r+") str = fo.read(10); print "读取的字符串是 : ", str # 关闭打开的文件 fo.close() 7.rename() os.rename( "test1.txt", "test2.txt" ) 8.remove() os.remove("test2.txt") 8.mkdri() os.mkdir("test")在当前目录下创建新的test文件 9.chdir() os.chdir("/home/newdir")改变当前目录为/home/newdir目录 10.getcwd() os.getcwd()获取当前目录 11.rmdir() # 删除”/tmp/test”目录 os.rmdir( "/tmp/test" ) 十三:异常处理 1.捕获异常:try/except try: fh = open("testfile", "w") fh.write("这是一个测试文件,用于测试异常!!") except IOError: print "Error: 没有找到文件或读取文件失败" else: print "内容写入文件成功" fh.close() 2.try/finally try-finally 语句无论是否发生异常都将执行最后的代码。 3.触发异常 使用raise语句自己触发异常 def functionName( level ): if level < 1: raise Exception("Invalid level!", level) # 触发异常后,后面的代码就不会再执行 十四:file file使用open函数来创建 常用函数: file.close() file.flush() file.next() 返回下一行 file.read(size) 从文件读取指定的字节数,如果未给定或为负则读取所有。 file.readline(size) 读取整行 file.seek() 设置文件当前位置 file.tell() 返回文件当前位置 file.truncate() 截取文件,截取文件通过size指定 file.write() 将指定字符串写入文件 file.writelines() 向文件写入一个字符串列表 十五:OS os.access() 检测文件是否可读可写,文件是否存在,是否拥有执行权限 os.chdir(path) 切换到新的目录 os.chmod() 更改文件或者目录权限 os.chown() 更改文件所有者 os.close() 关闭文件 os.path.join('a','b')字符串拼接形成a/b os.system("ls") 执行shell命令,如assert os.system("rm -rf %s" % install_path) == 0, "卸载 失败" os.path.exists(BIN_PATH) 判断某个变量是否存在 os.unlink(path) 方法用于删除文件,如果文件是一个目录则返回一个错误。 os.remove() 删除文件 十六:open open(a.txt).read() 去取a.txt文件 十七:enumerate enumerate(list1) 枚举list,map等获取索引和元素for index, item in enumerate(list1): 十八:string str.strip("@") 去掉以@开头结尾的 str.startswith("#") 判断是否以#开头 十九:Python常见模块 python常见命令如下,点击链接查看详情 1.os 2.os.path 3.shutil 4.sys 5.inspect

优秀的个人博客,低调大师

Java synchronized笔记

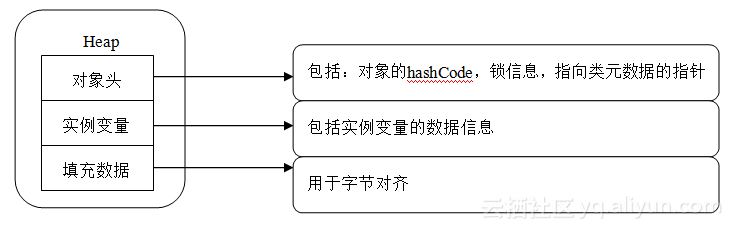
1,造成线程安全问题的原因①存在线程间的共享数据(例如堆内存)②存在多个线程同时操作共享数据 2,锁类型互斥锁:(重量级锁)同一时刻有且仅有一个线程操作共享数据,当某个线程正在操作共享数据时,其他线程处于等待状态,必须等到该线程处理完后再进行.偏向锁:java1.6的新锁,针对多个线程竞争较少的场景,如果一个线程获得了锁,那么锁就进入偏向模式,对象头Mark Word里面的锁结构也编程偏向锁结构,这个线程再次请求锁时,无需做任何操作。轻量级锁:依据是大部分的锁,整个同步周期内不存在竞争,适用线程交替执行同步块的场景。自旋锁:依据是大部分线程持有锁的时间不会太长,因此自旋锁假设很快当前线程就会获得锁,所以虚拟机会让想要获取锁的线程执行几个空循环,如果循环完成后得到锁,则顺利进入。否则就会将线程在操作系统层面挂起。锁消除:指虚拟机在编译时消除无用的锁。 3,synchronized关键字作用:①保证同一时刻只有一个线程可以执行某个方法或者代码块②可以保证一个线程操作的共享数据变化能立即被其他线程所见(可替代volatile) 4,synchronized关键字用法:①修饰实例方法:作用于当前实例的方法(不包括静态方法),进入同步代码前要获取当前实例的锁(JVM通过常量池中的方法结构表的acc_synchronized标识区分一个方法是否是同步方法。)public class SynchronizedClass extends Thread{ static int share = 0; //①修饰实例方法 public synchronized void increase() { share++; } //②修饰静态方法 public synchronized static void increase4ClassLock(){ share++; } public void run() { for (int i = 0; i < 1000; i++) { increase(); } } /** * @param args */ public static void main(String[] args) { try { //场景1,t1,t2线程执行需要获得实例sc1的互斥锁 SynchronizedClass sc1 = new SynchronizedClass(); Thread t1 = new Thread(sc1); Thread t2 = new Thread(sc1); t1.start(); t2.start(); // join()方法:当前线程结束之后join()方法才返回,如果不试用join,打印出来的数据可能是0,1000,2000 t1.join(); t2.join(); System.out.println("scene1 share:" + share); //share = 0; //场景2,t3,t4线程执行各自获得实例sc2,sc3的锁,可能同时访问共享的静态资源share出现线程安全问题 SynchronizedClass sc2 = new SynchronizedClass(); SynchronizedClass sc3 = new SynchronizedClass(); Thread t3 = new Thread(sc2); Thread t4 = new Thread(sc3); t3.start(); t4.start(); t3.join(); t4.join(); System.out.println("scene2 share:" + share); } catch (Exception e) { e.printStackTrace(); } } }上面例子中:当前线程的锁是实例对象instance,java的线程同步锁可以是任意对象。注意:如果一个线程正在访问一个实例instance的synchronized方法A时,其他线程不能访问该实例的其他synchronized方法,因为一个对象实例只有一把锁,但其他线程可访问该实例的非synchronized方法。当然,如果其他线程要访问另外一个实例instance1的任何方法都是不受限制的,但是如果他们访问的是共享数据那么就会出问题,例如上面例子场景2中的静态变量share,这时候就需要使用②进行修饰。②修饰静态方法:作用于当前类对象,进入同步代码前要获得当前类(class)对象的锁。注意:两个线程可以同时分别访问static synchronized修饰的方法和non-static synchronized修饰的方法,因为他们一个是类对象的锁,一个是实例对象的锁,但是此时两个方法如果同时操作共享数据,也可能出现线程安全问题。例如上面例子中两个线程分别同时访问:increase4ClassLock()和increase()方法,就会出现线程安全问题。③修饰代码块:指定加锁对象,给指定对象家锁,进入同步代码块前要获取指定对象的锁(可以是类对象,也可以是实例对象),样例如下:static SynchronizedClass inst1 = new SynchronizedClass();public void increase2MethodBlock1(){ //使用实例锁,获取当前对象实例的锁,inst1也可用this(synchronized (inst1)) synchronized (inst1) { share++; } }public void increase2MethodBlock2(){ //使用类对象锁,获取当前class对象的锁 synchronized (SynchronizedClass.class) { share++; } } 5,sychronized实现原理jvm中synchronized的同步是通过管程(Monitor)实现的,在java的堆内存中,一个对象实例信息是按照如下方式存储的: 如上如所示结构,java对象头里面有锁信息,锁信息里有一个指向monitor(管程)对象的指针,管程对象在java虚拟机中是使用OjbectMonitor类实现的,类结构大致如下:ObjectMonitor(){_count = 0; //计数器_WaitSet = null; _EntryList = null;_owner = null; //指向拥有ObjectMonitor对象的线程……}说明:①多个线程进入同步代码时,会先进入_ EntryList队列,获取到monitor对象后修改owner指向为当前对象线程,计数器加1②线程调用wait()方法进入_WaitSet队列,owner置为空,count减1③当前线程执行完毕也会重置owner为空,复位变量 6,synchronized需要注意的点①可重入性一个线程在synchronized方法体内部可以调用另外一个synchronized方法,因为是同一个线程请求同一个锁。子类继承父类时,子类可通过重入锁调用父类的synchronized方法。②在线程sleep时调用interrupt方法会打断阻塞并抛出异常(对阻塞线程进行中断操作): ③处于非阻塞状态的线程需要我们手动进行中断检测并结束程序: 如上②和③两种情况(阻塞/和线程运行时中断中断的操作方法是不一样的[前者要捕捉异常,后者要手动判断中断状态并做中断处理]),可用下面代码兼顾两种场景: ④线程状态转换1)等待阻塞:等待阻塞(使用wait,notify/notifyAll方法进入和退出)(wait是Object类的方法)2)锁定阻塞:synchronized同步锁的获得和释放3)其他阻塞:sleep,join,IO操作等(sleep是Thread类的静态方法)4)就绪状态获得时间片就进入运行态,时间片用完或yield操作回到就绪状态5)sleep和wait的区别:sleep方法是Thread类的今天方法而wait是Object类的方法;sleep方法不会释放对象锁,sleep时其他线程任然不能访问同步块,而wait方法会释放对象锁。⑤线程中断操作对正在等待获取锁的synchronized方法或者代码块是不起作用的:一个正在等待锁的线程要么获得锁继续执行,要么继续等待。 ⑥wait(); notify(); notifyAll();方法必须放在synchronized中,否则会抛出IllegalMonitorStateException异常,因为:调用这几个方法必须获取管程(ObjectMonitor)对象,该对象放在对象头中,而synchronized可以获取到该对象。

优秀的个人博客,低调大师

Java学习笔记

代码点与代码单元 codePoint codeUnit 这里当字符串中有辅助字符时,代码点是两个代码单元,需要以下遍历: int cp = sentence.codePointAt(i); if(Character.isSupplementaryCodePoint(cp)){ i += 2; }else{ i++; } String类对象->不可变字符串 不能修改字符串中的字符:编译器可以将字符串共享,以此带来高效率。 当将一个字符串与一个非字符串的值进行拼接时,后者将被转换成字符串。 任何一个对象都可以转换成字符串。 检测两字符串是否相等,而不区分大小写,可用equalsIgnoreCase()方法 Java中允许一个数组长度为0,不同于null。 Java中的多维数组实际上是数组的数组。 一个对象变量实际上是一个对象指针。 用clone()方法获得对象的完整拷贝。 不能编写返回引用可变对象的访问器方法。 一个方法可以访问所属类的所有对象的私有数据。 Sytem类中有一个setOut方法是一个本地方法,不是用Java语言实现的,可以绕过Java的存取控制机制(out是final的)。 每个类都可以有一个main方法,可用来进行单元测试。 一个方法不能修改一个基本数据; 一个方法可以改变一个对象参数的状态; 一个方法不能让对象参数引用一个新的对象。 方法签名:方法名、参数类型。 初始化块机制 首先运行初始化快,然后才运行构造器的主体部分 静态域初始化块: static{ } 只能使用*导入一个包,如: import java.util.*; 静态导入:静态方法、静态域 import static java.lang.System.*; 如果没有指定public或private,那么这个部分(类、方法或者变量)可被同一个包中的所有方法访问 包作用域:默认情况下是包可见的 包密封:(package sealing) jar文件密封包 /*…/->文档注释 javadoc 标记+自由格式,其中标记由”@”开始 类设计技巧: 一定要将数据设为私有; 一定要对数据初始化; 不要在类中使用过多的基本数据类型; 不是所有的域都需要独立的域访问器和域更改器; 使用标准格式进行类的定义; 将职责过多的类进行分解; 类名和方法名要能够体现它们的职责。 Java中的所有继承都是公有继承:超类和子类 覆盖(Override)子类使用super调用超类的方法以及构造器 一个对象变量可以引用多种实际类型的现象叫做多态(Polymorphism) 运行能够自动地选择调用的适当方法的现象称为动态绑定 虚拟机预先为各个类创建了一个方法表 在覆盖一个方法时,子类方法不能低于超类方法的可见性 阻止继承的两种方法:final类的方法自动成为final方法(不包括域),final方法 内联的概念:如果一个方法没有被覆盖并且很短,编译器就能够对它进行优化处理。 强制类型转换: 只能在继承层次内进行类型转换; 在将超类转换成子类的前应使用instanceof进行检查 抽象类可以包含非抽象方法,也可以不包含抽象方法。抽象方法充当着占位的角色,具体实现在子类中。 抽象类不能被实例化 只有子类实现了所有抽象方法,子类才不是抽象的了 子类不能访问超类的私有域 hashcode: 由对象导出的一个整型值 每个对象都有一个默认的散列码,其值为对象的存储地址 两个相等的对象要求必须返回一个相等的散列码 自动打包规范要求boolean byte char=0:x; 四个基本的抽象流类:InputStream OutputStream Reader Writer(这些对象由其他方法返回) 注意流过滤器的运用 对象序列化:ObjectOutputstream ObjectInputStream writeObject() readObject() 类必须实现Serializable 接口 Java使用SHA编码的前8字节作为类的指纹 在序列化的过程中内存地址会被替换为序列号(唯一) 流类关注的是文件内容,而File类关注的是文件在磁盘上的存储 原文出处:后端技术杂谈 原文链接 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

seaborn学习笔记

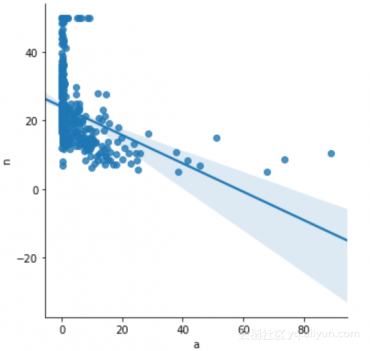
数据集的可视化展示对于分析数据集内在的规律有着很大帮助,因此我想着先学习一点matplotlib和seaborn的画图操作。 import numpy as np import pandas as pd import seaborn as sns from scipy import stats,integrate from sklearn.datasets import load_boston import matplotlib.pyplot as plt %matplotlib inline 加载数据集: Data = load_boston() X=pd.DataFrame(Data["data"]) y=pd.DataFrame(Data["target"]) Data=pd.DataFrame(np.hstack((X,y))) data=pd.read_csv("Desktop/creditcard.csv") iris_data = sns.load_dataset('iris') Data.columns=['a','b','c','d','e','f','g','h','i','j','k','l','m','n']#从数据集提取出的数据默认列名是自然数字,但是这样下面的lmplot函数会报错,所以手动修改了列名 print(list(Data))#打印列名 打印列名: ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j', 'k', 'l', 'm', 'n'] 中间取了几列做线性拟合: sns.lmplot(x='a',y='n',data=Data) sns.lmplot(x='c',y='n',data=Data) sns.lmplot(x='d',y='n',data=Data) sns.lmplot(x='sepal_length', y='sepal_width', hue='species', data=iris_data 可以看到,seaborn的lmpolt函数可以直接对数据线性回归拟合,还给出了置信区间。 lmplot中,参数x,y都是列名,data就是使用的数据集,hue是分类,按照鸢尾花的species类别进行分类 sns.distplot(data["V1"],bins=50,kde=False,fit=stats.gamma)#V1V2是数据集的列名 plt.show() sns.distplot(data["V2"],bins=20,kde=True,fit=stats.gamma)#bins为横轴等分数,kde是核分布 plt.show()#如果像lmplot一样不分开打印会导致图表重叠在一起``` 可视化结果如下: ![image](https://yqfile.alicdn.com/a0b90cef40f04e60263e7375698a9bb59ff935a4.png) ![image](https://yqfile.alicdn.com/a7c775b96a529532fb9c3d4ef53e39ee491cb90d.png) displot函数可以给出一个特征的分布情况,其中的fit=stats.gamma调用scipy中的计算高斯分布的函数,就是图上的黑色密度分布线。 类似的函数还有regplot。 sns.JointGrid(data=Data, x='e', y='n').plot(sns.regplot, sns.distplot)plt.show() 需要对图表设置样式,即加上.plot(sns.regplot, sns.distplot),否则不显示 这里默认选择了 seaborn 带有的回归拟合散点图以及单变量分布图 可视化结果为: ![image](https://yqfile.alicdn.com/5bd21401318668cf3ddda787eb5e909d7fb72d5b.png) JointGrid显示了回归结果的同时也给出边缘分布 多个特征相互比较,可以用PairGrid sns.PairGrid(data=iris_data,hue='species').map(plt.scatter) 同样也需要设置图表样式 结果的一部分: ![image](https://yqfile.alicdn.com/631f19541cdb4670ac74095096910c2100c968d7.png) 更多的还有像色彩矩阵,小提琴状图,箱形图等,不同的图适用不同的数据集。可视化的最终目的还是直观地了解数据集的嗯不状况,以方便做出最好的处理。

优秀的个人博客,低调大师

nignx笔记1

上图是单版的架构,理论一个tomcat并发就200到300,经过优化后的最多500,这很明显容量低,而且出现单点故障后应用服务就不可以访问了,比如tomcat,这样明显对于多并发是不行的。 那么如果我们从域名提供商哪里一个域名映射多个IP呢?下图,每一个IP对应一个tomcat,通过IP轮询来到底要访问哪个Tomcat,这样行不行呢?我们先看下面的图: 上图所示,这样虽然解决了单点故障,容量也提升了,但是又出现问题了,1.DNS服务器完全暴露在外网,造成不安全。2入口不集中。3.如果其中一个Tomcat挂了,那么用户通过对应的IP进入了那个坏的tomcat,还是不可以访问,这样很明显不行。 那么如果我们把用户的请求入口,集中管理起来,那么我们把所有用户的请求入口集中在nignx下,用nignx的反向代理/负载均衡的典型算法,如轮询或随机将请求分发到不同的Tomcat下,这样不就解决上面的问题了吗?如下图: 那么上图这个架构就没事了吗?明显出现了第一个架构出现的问题,还是出现单点故障了,因为如果nignx挂了,那么所有的应用就不能访问了,这样明显也是不可取的。那么我们就把nignx双机热备份,通过心跳检测,检测负载均衡服务器,如果一个挂了,立马切换虚拟IP到另外一台nignx备份机。如下图: 那么问题又来了,其实只有一台nignx在工作,另外一台只是待命,只有一台挂了,另外一台才工作,这明显利用率低。还有就是请求分发设备有流量并发上限。那么我们如何解决呢?试想,如果我们再到DNS动一下手脚呢?那么我们如果通过双击热备再加上DNS轮询 ,用户输入域名通过浏览器访问DNS服务器,得到一个虚拟IP,通过虚拟IP进入相应的双机热备份,下一个用户来了,就用过轮询,用下一个虚拟IP又进入了另外一个虚拟IP对应的双机热备份,这样不久解决了问题吗?如下图所示这样就解决了流量并发发问题

优秀的个人博客,低调大师

Android笔记:SlidingDrawer

一、概述 抽屉控件,官方已不建议用;但在某些需求下直接使用这个控件还是相当方便的。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 <SlidingDrawer android:id= "@+id/drawer" android:layout_width= "match_parent" android:layout_height= "match_parent" android:handle= "@+id/handle" android:content= "@+id/content" > <ImageView android:id= "@+id/handle" android:layout_width= "88dip" android:layout_height= "44dip" /> <GridView android:id= "@+id/content" android:layout_width= "match_parent" android:layout_height= "match_parent" /> </SlidingDrawer> 1.XML文件中的属性 属性名称 描述 android:allowSingleTap 是否可通过单击handle打开或关闭抽屉。默认是true。(如果是false,用户必须通过拖动,滑动或者使用轨迹球。) android:animateOnClick 顾名思义,点击的时候是否有动画。默认是true。 android:bottomOffset “手柄”距离SlidingDrawer底部的额外距离 。 android:content SlidingDrawer的内容。 android:handle SlidingDrawer的“手柄”。 android:orientation SlidingDrawer的方向。 android:topOffset “手柄”距离SlidingDrawer顶部的额外距离 。 2.一些重要的方法: voidsetOnDrawerCloseListener(SlidingDrawer.OnDrawerCloseListeneronDrawerCloseListener) 设置一个监听器,用来接收当抽屉被关闭时候的通知。 voidsetOnDrawerOpenListener(SlidingDrawer.OnDrawerOpenListeneronDrawerOpenListener) Since:API Level 3 设置一个监听器,用来接收当抽屉被打开的时候的通知。 voidsetOnDrawerScrollListener(SlidingDrawer.OnDrawerScrollListeneronDrawerScrollListener) 设置一个监听器,用来接收当抽屉处于正在打开或者正在结束的滚动时候的通知。 animateClose(): 使用动画关闭抽屉。 animateOpen(): 使用动画打开抽屉 getContent(): 获取内容 isMoving(): 指示SlidingDrawer是否在移动。 isOpened(): 指示SlidingDrawer是否已全部打开 lock(): 屏蔽触摸事件。 unlock(): 解除屏蔽触摸事件。 toggle(): 切换打开和关闭的抽屉SlidingDrawer。 3.一个简单的例子: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 public class SlidingDrawerDemoActivity extends Activity{ private SlidingDrawermyDrawer; private ImageViewmyImageView; private GridViewmyGridView; @Override protected void onCreate(BundlesavedInstanceState){ super .onCreate(savedInstanceState); setContentView(R.layout.main); myDrawer=(SlidingDrawer)findViewById(R.id.drawer); myImageView=(ImageView)findViewById(R.id.handle); myGridView=(GridView)findViewById(R.id.content); myDrawer.setOnDrawerOpenListener(newSlidingDrawer.OnDrawerOpenListener(){ @Override public void onDrawerOpened(){ myImageView.setImageResource(R.drawable.down); } }); myDrawer.setOnDrawerCloseListener(newSlidingDrawer.OnDrawerCloseListener(){ @Override public void onDrawerClosed(){ myImageView.setImageResource(R.drawable.up); } }); } } 二、可监听按钮点击事件的自定义SlidingDrawer 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 import android.content.Context; import android.graphics.Rect; import android.util.AttributeSet; import android.view.MotionEvent; import android.view.View; import android.view.ViewGroup; import android.widget.SlidingDrawer; /** *自定义SlidingDrawer:可监听按钮点击事件 *@authorzeng * */ public class ClickableSlidingDrawer extends SlidingDrawer { private ViewGroupmHandleLayout; private final RectmHitRect= new Rect(); public ClickableSlidingDrawer(Contextcontext,AttributeSetattrs, int defStyle) { super (context,attrs,defStyle); } public ClickableSlidingDrawer(Contextcontext,AttributeSetattrs) { super (context,attrs); } @Override protected void onFinishInflate() { super .onFinishInflate(); Viewhandle=getHandle(); if (handle instanceof ViewGroup) { mHandleLayout=(ViewGroup)handle; } } @Override public boolean onInterceptTouchEvent(MotionEventevent) { if (mHandleLayout!= null ) { int childCount=mHandleLayout.getChildCount(); int handleClickX=( int )(event.getX()-mHandleLayout.getX()); int handleClickY=( int )(event.getY()-mHandleLayout.getY()); RecthitRect=mHitRect; for ( int i= 0 ;i<childCount;i++) { ViewchildView=mHandleLayout.getChildAt(i); childView.getHitRect(hitRect); if (hitRect.contains(handleClickX,handleClickY)) { return false ; } } } return super .onInterceptTouchEvent(event); } } 三、控制SlidingDrawer在屏幕低端,而不会填满整个屏幕,同时handle按钮可点击的自定义SlidingDrawer 注:解决SlidingDrawer的高度设置为wrap_content时无法做到非全屏的问题。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 import android.content.Context; import android.graphics.Rect; import android.util.AttributeSet; import android.view.MotionEvent; import android.view.View; import android.view.ViewGroup; import android.widget.SlidingDrawer; /** *自定义SlidingDrawer,控制SlidingDrawer在屏幕低端,而不会填满整个屏幕,同时handle按钮可点击 *@authorzeng * */ public class ClickableWrapSlidingDrawer extends SlidingDrawer { private ViewGroupmHandleLayout; private final RectmHitRect= new Rect(); private boolean mVertical; private int mTopOffset; public ClickableWrapSlidingDrawer(Contextcontext,AttributeSetattrs, int defStyle) { super (context,attrs,defStyle); int orientation=attrs.getAttributeIntValue( "android" , "orientation" ,ORIENTATION_VERTICAL); mTopOffset=attrs.getAttributeIntValue( "android" , "topOffset" , 0 ); mVertical=(orientation==SlidingDrawer.ORIENTATION_VERTICAL); } public ClickableWrapSlidingDrawer(Contextcontext,AttributeSetattrs) { super (context,attrs); int orientation=attrs.getAttributeIntValue( "android" , "orientation" ,ORIENTATION_VERTICAL); mTopOffset=attrs.getAttributeIntValue( "android" , "topOffset" , 0 ); mVertical=(orientation==SlidingDrawer.ORIENTATION_VERTICAL); } @Override protected void onMeasure( int widthMeasureSpec, int heightMeasureSpec) { int widthSpecMode=MeasureSpec.getMode(widthMeasureSpec); int widthSpecSize=MeasureSpec.getSize(widthMeasureSpec); int heightSpecMode=MeasureSpec.getMode(heightMeasureSpec); int heightSpecSize=MeasureSpec.getSize(heightMeasureSpec); final Viewhandle=getHandle(); final Viewcontent=getContent(); measureChild(handle,widthMeasureSpec,heightMeasureSpec); if (mVertical) { int height=heightSpecSize-handle.getMeasuredHeight()-mTopOffset; content.measure(widthMeasureSpec,MeasureSpec.makeMeasureSpec(height,heightSpecMode)); heightSpecSize=handle.getMeasuredHeight()+mTopOffset+content.getMeasuredHeight(); widthSpecSize=content.getMeasuredWidth(); if (handle.getMeasuredWidth()>widthSpecSize) widthSpecSize=handle.getMeasuredWidth(); } else { int width=widthSpecSize-handle.getMeasuredWidth()-mTopOffset; getContent().measure(MeasureSpec.makeMeasureSpec(width,widthSpecMode),heightMeasureSpec); widthSpecSize=handle.getMeasuredWidth()+mTopOffset+content.getMeasuredWidth(); heightSpecSize=content.getMeasuredHeight(); if (handle.getMeasuredHeight()>heightSpecSize) heightSpecSize=handle.getMeasuredHeight(); } setMeasuredDimension(widthSpecSize,heightSpecSize); } @Override protected void onFinishInflate() { super .onFinishInflate(); Viewhandle=getHandle(); if (handle instanceof ViewGroup) { mHandleLayout=(ViewGroup)handle; } } @Override public boolean onInterceptTouchEvent(MotionEventevent) { if (mHandleLayout!= null ) { int childCount=mHandleLayout.getChildCount(); int handleClickX=( int )(event.getX()-mHandleLayout.getX()); int handleClickY=( int )(event.getY()-mHandleLayout.getY()); RecthitRect=mHitRect; for ( int i= 0 ;i<childCount;i++) { ViewchildView=mHandleLayout.getChildAt(i); childView.getHitRect(hitRect); if (hitRect.contains(handleClickX,handleClickY)) { return false ; } } } return super .onInterceptTouchEvent(event); } } 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1548354,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android笔记:stackview

stackview相关范例:(附件) 参考资料: 1.http://sampleprogramz.com/android/stackview.php 2.http://stackoverflow.com/questions/9997753/how-to-create-custom-stackview-for-android-2-2-or-2-3 3.http://stackoverflow.com/questions/5544112/alternative-views-instead-of-stackviews-for-android-versions-lower-to-android-3 4.http://stackoverflow.com/questions/12286506/simulate-stack-view-in-android2api-5 附件:http://down.51cto.com/data/2363570 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1304103,如需转载请自行联系原作者

优秀的个人博客,低调大师

[old]wireless 笔记

AD Hoc network IBSS: Independent basic service set AP是解决无线客户端访问有线设备资源AP是什么?802.11<-----> 802.3 DS:分布系统==> Used for Infrastructure Mode BSA=wireless cell(basic service area)表示一个范围 BSS :基础服务集,由多个BSS组成的网络叫ESS扩展服务集 SSID service set identifier服务标示符,相当于一个VLAN,一个subnet BSSID:基础服务集标示符,一个48bit的MAC地址,无线客户端物理关联的标示符 多个BSSID组成MBSSID 漫游的条件:两AP必须要有交集覆盖 AP工作的角色(模式): HUB竞争信道 Repeater Outdoor Bridge (包括户外网桥,多用定向天线) Wireless只关心微波波段. 信号有Free-Spare path loss:自由空间路径损失,网络上有公式算. 信号有吸收,反射,穿透,散射最终我们可能会收到multipath信号,multipath会导致信号不好<出现信号抵消> SNR: signal to noise ratio,信噪比 Signal Strength / Noise Level = SNR Decibels分贝DB,是两次数据的对比 0dB = same power 3dB = twice the power -3dB=half the power 10dB=10* the power -10DB = 1 tenth of the power DBm used for AP transmitters ===>对等单位mw 0dbm = 1 mW 30dbm= 1W -20 dbm=0.01 mw 20dbm = 100 mw DBI used for dipole antenna Gain (偶极天线) 0dBd = + 2.14 dBi EIRP = TX power /dbm(天线发射功率)+ Antenna Gain /dbi (天线增益dbi)– Loss /DB Effectivelsotropic radiated power (等效全向辐射功率) 波的三要素:频率,倒数为波长,天线长度最好为1/4波长 振幅,经过任何物体都会吸收振幅. 相位,多天线来解决多路径问题 影响的因数就是上面三种 天线计量单位:瓦特和分贝 802.11设备最大100mW 80.211帧和CSMA/CA载波侦听多路访问/冲突避免 以太网使用的是CSMA/CD冲突检测 TO DS / From DS字段:这个两个字段用来描述包的去向 Frame Type: 1-Control (Request to send RTS, clear to send CTS, ACK,PS-Poll power save poll) 2-Data (simple data, null function) 3-Management: Beacon: 100s发一次,公告SSID BSSID等信息,隐藏的SSID的AP也会发Beacon Authentication request / response Association request / response Announcement traffic indication message (ATIM) 802.11 n的优点: 天线多,会有多径问题,有相位的错位 1分集(多天线技术,不等于MIMO) ,提高吞吐量 2 MIMO:空分复用,波束赋形(根据对方的信号找到最好的路径),最大比合并(按比值信号合并) AP的接口: AP型号上字母的意思 AIR-AP1131AG-A-K9 AIR-AP1131G-A-K9 AIR-LAP1131AG-A-K9 AIR = Aironet一种产品 AP/LAP =不带L表示出厂默认胖APIOS,带L表示默认瘦APIOS 1131= 1130系列 A=5GHZ, G=2.4HZ<3502不再有这个标示> -x=代表国家代码 -A:美国-C:中国 K9:代表安全特性 AIR-SAP3502i-A-K9 AIR-CAP3502e-A-K9 SAP/CAP = S表示出厂默认胖<stay alone > AP IOS, C表示默认瘦APIOS i/e= i表示内置天线,e表示外置天线 3501/3502 :代表单双频 =================================配置试验===================================== 配置胖AP单SSID Test PC xxxxxxAP----SW---Admin PC 配置管理胖AP管理地址: Interface bvi 1 Ip add 172.16.100.11 255.255.255.0 No shut 然后web登入,默认的是enablepassword ,用户名可以不用填 修改加密方法:security----encryption manager 创建SSID: secrirty-----SSID manager—single SSID 是否广播SSID Enable radiointerface开启2.4G/5.0G射频 ------>看summary可以看到结果 配置胖AP多SSID Test PC xxxxxxAP----SW---Admin PC Show ip int b 1-service-vlan 2-Security-Encryption manager ----CIPHER---AESCCMP 3-Security-SSID Manager---Multiple SSID ----Multiple bssidbeacon ----“set ssid as guest mode” 4- Enable radiointerface 查看有多少个链接:可以在ASSOCIATION中查看到 胖瘦AP的区别: IOS的区别, w7代表胖AP IOS, W8代表瘦AP IOS 胖AP转瘦AP叫升级, 瘦AP转胖AP叫降级 降级方法:1-断电mode建还原法,2-AP已注册在wlc上,使用wlc上降级命令 Config ap tftp-downgrade xxx.tar <APName> Show ap summary 升级方法: 1-命令行下载解压(不太老款的AP) Boot system flash:可以决定由哪个IOS启动 本文转自 bilinyee博客,原文链接: http://blog.51cto.com/ericfu/1753341 如需转载请自行联系原作者

优秀的个人博客,低调大师

swift 笔记2

swift交流群:342581988,欢迎增加。 今天真郁闷啊,把mac升级到10.10了。如今好了,曾经的程序都跑不了了。哎,不说了,让我郁闷会再。 说说条件推断吧,事实上这些基本的语法大家都知道肯定差点儿相同。好吧,我就自己写写看吧。 上代码 let individualScores = [78,32,32,53,23] var teamScore = 0 for score in individualScore{ if score > 50{ teamScore += 3 }else{ teamScore += 1 } } teamScore 这个事实上和曾经的oc差点儿相同了,我想大家都注意到了。就是这个Swift把曾经用圆弧括号的地方所有去掉,把分号也去掉。大概就是这样子 在这里。要说说这个if推断语句,这个if后面的条件必须是个Boolean表达式。换句话说,假设上面这样写 if score{ ... } 那就是错的了 由于score是一个非Boolean值,这个在曾经都是会自己主动与0相比較,非零值就会运行if后面语句。 这个地方if和let能够一起使用。let修饰变量时可选的,能够是一个值。也能够是nil。在类型后面加一个?表示他是可选的。 let v : int;已分配内存; let v : int ? 还没分配内存 以下if里面用来推断optionName是否存在。 var optionString:String? = "Hello" optionString == nil var optionName: String ? = "John Appleseed" var greeting = "Hello!" if let name = optionName{ greeting = "Hello, \(name)" } 假设上面optionName = nil;那么结果将会不一样,会运行你后面else部分。 以下说说switch吧,这个我也还没搞太懂,所以大家一定要拍砖 这个switch支持不论什么数据 的比較操作。不不过整形之类的, let vegetable = "red pepper" switch vegetable { case "celery": let vegetableComment = "Add some raisins and make ants on a log." case "cucumber","watercress": let vegetableComment = "That would make a good team sandwich." case let x where x.hasSuffix("pepper"): let vegetableComment = "Is it a spicy \(x)?" default: let vegetableComment = "Everything tastes good in soup." } 这个地方后面的default是不能少的,不然就会报错,只是这个地方有点变化的是,break不见了。对的。break不要了。 再说说for-in迭代循环吧 let interestingNumbers = [ "Prime": [2, 3, 5, 7, 11, 13], "Fibonacci": [1, 1, 2, 3, 5, 8], "Square": [1, 4, 9, 16, 25], ] var largest = 0 for (kind, numbers) in interestingNumbers { for number in numbers { if number > largest { largest = number } } } largest 事实上这个没什么可说的了,看看即可了, 然后在看看while和do...while吧 var n = 2; while n < 100{ n = n * 2 } n var m = 2 do{ m = m * 2 }while m < 100 m 注意确保循环进行至少一次 好吧,再写最后一个,应该算是一种新的写法吧 var firstForLoop = 0 for i in 0..3{ firstForLoop += i } firstForLoop var secondForLoop = 0 for var i = 0;i < 3; ++i{ secondForLoop += 1 } secondForLoop ..代表值递增。貌似包含端点值。 好吧,今天就写这点吧,感觉好慢啊,以后不能这样写了。必须 加速了,捡重点写点吧。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5112570.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

hive 权限笔记

启动权限,hive默认是禁止的。 Configuration For Hive 0.13.x Set the following in hive-site.xml: hive.server2.enable.doAs to false. hive.users.in.admin.role to the list of comma-separated users who need to be added toadminrole. Note thata user who belongs to theadminrole needs to run the "set role" command before getting the privileges of theadminrole, as this role is not in current roles by default. Start HiveServer2 with the following additional command-line options: -hiveconf hive.security.authorization.manager=org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdHiveAuthorizerFactory -hiveconf hive.security.authorization.enabled=true -hiveconf hive.security.authenticator.manager=org.apache.hadoop.hive.ql.security.SessionStateUserAuthenticator -hiveconf hive.metastore.uris=' ' For Hive 0.14 and Newer Set the following in hive-site.xml: hive.server2.enable.doAsto false. hive.users.in.admin.roleto the list of comma-separated users who need to be added toadminrole. Note thata user who belongs to theadminrole needs to run the "set role" command before getting the privileges of theadminrole, as this role is not in current roles by default. Add org.apache.hadoop.hive.ql.security.authorization.MetaStoreAuthzAPIAuthorizerEmbedOnly tohive.security.metastore.authorization.manager. (It takes a comma separated list, so you can add it along with StorageBasedAuthorization parameter, if you want to enable that as well). This setting disallows any of the authorization api calls to be invoked in a remote metastore. HiveServer2 can be configured to use embedded metastore, and that will allow it to invoke metastore authorization api. Hive cli and any other remote metastore users would be denied authorization when they try to make authorization api calls. This restricts the authorization api to privileged HiveServer2 process. You should also ensure that the metastore rdbms access is restricted to the metastore server and hiverserver2. hive.security.authorization.managerto org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdConfOnlyAuthorizerFactory.This will ensure that any table or views created by hive-cli have default privileges granted for the owner. Set the following in hiveserver2-site.xml: -hiveconf hive.security.authorization.manager=org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdHiveAuthorizerFactory -hiveconf hive.security.authorization.enabled=true -hiveconf hive.security.authenticator.manager=org.apache.hadoop.hive.ql.security.SessionStateUserAuthenticator -hiveconf hive.metastore.uris=' ' 角色管理: 说明:默认hive有public和admin角色,hive.users.in.admin.role中指定的用户为admin角色,多个用户以逗号分隔。 1、SET ROLE (role_name|ALL|NONE); 一个用户可以有多个用户组,SET ROLE命令会把当前用户切换到指定的角色组。 本文转自 yntmdr 51CTO博客,原文链接:http://blog.51cto.com/yntmdr/1749839,如需转载请自行联系原作者

优秀的个人博客,低调大师

dockerfile指令 笔记

Dockerfile指令 1、FROM 如果在同一Dockerfile中创建多个镜像时,可以使用多个FROM指令(每个镜像一次) 1 2 3 FROM<image> 或 FROM<image>:<tag> 2、MAINTAINER 维护者信息 1 MAINTAINER<name> 3、RUN 执行指定命令 1 2 3 RUN< command >(the command isrun in ashell-` /bin/sh -c`) 或 RUN[ "executable" , "param1" , "param2" ...]( exec form) 4、CMD:用于指定一个容器启动时要运行的命令,如果指定了多条命令,最有最后一条会被执行 1 2 CMD[ "executable" , "param1" , "param2" ](likean exec ,thisisthepreferredform) CMD command param1param2(asashell) 5、EXPOSE 暴露docker容器的端口 1 EXPOSE<port>[<port>...] 1 <br data-filtered= "filtered" > 6、ENV 指定一个环境变量,会被后续RUN指令使用,并在容器运行时保持 1 ENV<key><value> 7、ADD 复制本地主机的内容到容器目标容器的目录,如果源文件是gzip/bzip2/xz等归档文件,会自动解开并添加到目的地 8、COPY 复制本地主机的内容到容器目标容器的目录 1 ADD<src><dest> 9、ENTRYPOINT 每个Dockerfile中只能有一个ENTRYPOINT,当指定多个ENTRYPOINT时,只有最后一个生效 1 2 ENTRYPOINT[ "executable" , "param1" , "param2" ](likean exec ,thepreferredform) ENTRYPOINT command param1param2(asashell) 10、VOLUME 创建一个可以从本地或其他容器挂载的挂载点 1 VOLUME[ "<mountpoint>" ] 11、USER 使用指定用户运行命令 1 2 3 4 5 #指定memcached的运行用户 ENTRYPOINT[ "memcached" ] USERdaemon 或 ENTRYPOINT[ "memcached" , "-u" , "daemon" ] 12、WORKDIR 切换工作目录 1 WORKDIR /path/to/workdir 13、ONBUILD 1 2 ONBUILD<Dockerfile关键字> ONBUILD指定的命令在构建镜像时并不执行,而是在它的子镜像中执行。 创建镜像: docker build [ 选项 ] dockerfile路径 sudo docker build -t centos6-ssh . 笼统的收集了Dockerfile的指令 本文转自 yanconggod 51CTO博客,原文链接:http://blog.51cto.com/yanconggod/1883346

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册