逻辑升级,深度解析如何实现业务中的且或组件
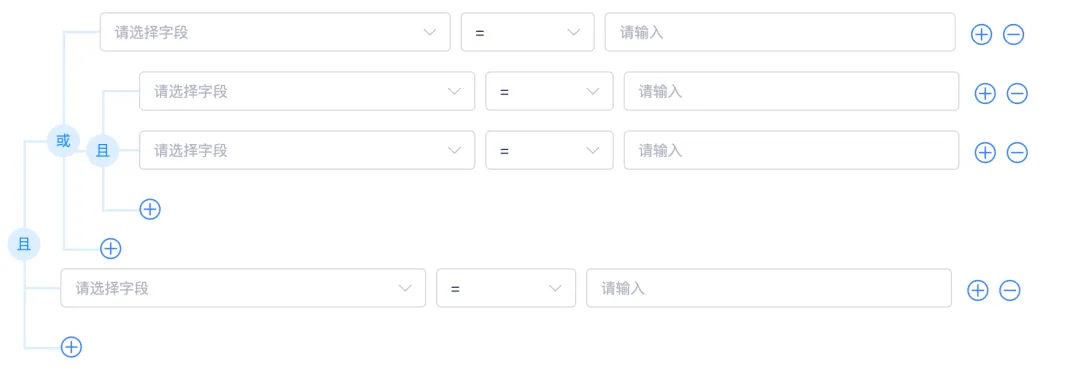
在业务实现的过程中,时常会出现且或关系逻辑的拼接。逻辑运算的组合使用,是实现复杂业务规则和决策支持系统的关键技术。 目前袋鼠云的指标管理平台、客户数据洞察平台、数据资产平台都有在使用。并且,且或组件已经在 RC 5.0 中添加到组件库,企业现在可以更加灵活地构建和实施复杂的业务规则。 本文将从前期分析、组件封装、具体实现三个维度深入探讨如何实现业务中的且或组件。 前期分析 01 确定好数据结构 因为是嵌套结构,可以通过 ➕➖ 来增加层级或者数据,因此采用树形结构来存储数据。 export interface IFilterValue<T> { key: string; level?: number; // 当前节点的层级,用于判断一些按钮的展示 type?: number; // 当前节点的条件关系,1 | 2 rowValues?: T; // Form 节点的相关的信息(子节点无条件节点时才有) children?: IFilterValue<T>[]; // 子节点的信息(子节点存在条件节点时才有) } 上述的图片的数据为: { "key": "qTipLrlUt", "level": 1, "children": [ { "key": "B6Jrbqcfof", "type": 2, "level": 2, "children": [ { "rowValues": { "condition": 1, "rowPermission": "" }, "key": "deg8x8UgZ", "level": 2 }, { "key": "_sczw_1h8H", "type": 1, "level": 3, "children": [ { "key": "Z5UkUPJoA", "rowValues": { "condition": 1, "rowPermission": "" }, "level": 3 }, { "key": "MbpJILqHGx", "rowValues": { "condition": 1, "rowPermission": "" }, "level": 3 } ] } ] }, { "rowValues": { "condition": 1, "rowPermission": "" }, "key": "qx6bG0o5H", "level": 1 } ], "type": 1 } 02 明确每个操作按钮的实现 03 明确组件的封装 · 组件只希望实现条件节点/线条/操作按钮的展示,因此后面的组件需要作为参数 component 传入 · 组件对层级有一个控制,支持 maxLevel 来控制 · 每一次新增数据的时候,默认值需要传入 initValues · 支持两种模式:「编辑状态」和「查看状态」 · 支持受控和非受控两种模式 组件封装 01 FilterRules 提供给用户使用的组件,实现数据的增删改查操作,可以采用受控和非受控两种模式。它接受的参数如下: interface IProps<T> { value?: IFilterValue<T>; disabled?: boolean; maxLevel?: number; initValues: T; notEmpty?: { data: boolean; message?: string }; component: (props: IComponentProps<T>) => React.ReactNode; onChange?: (value: IFilterValue<T> | undefined) => void; } export const FilterRules = <T>(props: IProps<T>) => { const { component, maxLevel = 5, disabled = false, notEmpty = { data: true, message: '必须有一条数据' }, value, initValues, onChange, } = props; // 查找当前操作的节点 const finRelationNode = ( parentData: IFilterValue<T>, targetKey: string, needCurrent?: boolean, ): IFilterValue<T> | null | undefined => {}; const handleAddCondition = (keyObj: { key: string; isOut?: boolean }) => {}; // 增加新的数据,判断是在当前节点下新增或者新生成一个条件节点 const addCondition = ( treeNode: any, keyObj: { key: string; isOut?: boolean }, initRowValue: T, ) => {}; const handleDeleteCondition = (key: string) => {}; // 删除节点,删除当前节点下的一条数据或者是删除一个条件节点 const deleteCondition = (parentData: IFilterValue<T>, key: string) => {}; // 删除一个条件节点时,更新当前数据的层级 const updateLevel = (node: IFilterValue<T>) => {}; // 更改条件节点的条件 const handleChangeCondition = ( key: string, type: ROW_PERMISSION_RELATION, ) => {}; // 改变节点的的数据 const handleChangeRowValues = (key: string, values: T) => {}; return ( <RulesController<T> maxLevel={maxLevel} disabled={disabled} value={value} component={component} onAddCondition={handleAddCondition} onDeleteCondition={handleDeleteCondition} onChangeCondition={handleChangeCondition} onChangeRowValues={handleChangeRowValues} /> ); }; ● 编辑情况 · 非受控组件使用 <Form form={form}> <Form.Item name={'condition'}> <FilterRules<IRowValue> component={(props) => ( <RowColumnConfig columns={record?.columns ?? []} {...props} /> )} maxLevel={MAX_LEVEL} initValues={INIT_ROW_VALUES} /> </Form.Item> </Form>; // RowColumnConfig 实现,name 可能是 children[0].formValues <Form.Item name={['condition', ...name, 'column']} rules={[{ message: '请选择字段', required: true }]} initialValue={column} > <Select placeholder="请选择字段"> {columns.map((item) => ( <Option key={item} value={item}> {item} </Option> ))} </Select> </Form.Item>; // 最后通过 form.validateFields() 拿到的和上述的数据结构一致 · 受控组件使用 const [ruleData, setRuleData] = useState({ key: shortid(), level: 0, rowValues: { column: first.column, condition: first.condition, rowPermission: first?.value, }, }); <FilterRules<IRowValue> value={ruleData} component={(props) => ( <RowColumnConfig columns={record?.columns ?? []} {...props} /> )} maxLevel={MAX_LEVEL} initValues={INIT_ROW_VALUES} onChange={setRuleData} />; // 通过 ruleData 就能够拿到最后的结果 ● 查看使用 <FilterRules component={(props) => <RowColumnConfig columns={[]} {...props} />} disabled value={value} /> ● 编辑查看使用(后续新增) 上图为最后实现的效果,适用于部分数据禁用且可以编辑其他数据。常见业务情景:上一次保存的数据不可修改,但需要在当前基础上继续新增数据。 在这种使用模式下,FilterRules 组件上的 props 依旧为 false,通过设置 value 中每一个节点的 disabled 属性来实现上述功能。 // 修改 IFilterValue 的类型 // 💭注意,如果当前节点是条件节点,children 内节点的状态和当前节点的 disabled 息息相关 export interface IFilterValue<T> { key: string; level?: number; // 当前节点的层级,用于判断一些按钮的展示 type?: number; // 当前节点的条件关系,1 | 2 + disabled?: boolean; // 当前节点的状态 rowValues?: T; // Form 节点的相关的信息(子节点无条件节点时才有) children?: IFilterValue<T>[]; // 子节点的信息(子节点存在条件节点时才有) } 上述图片的数据结构如下: const INIT_CHECK_DATA = { key: shortid(), level: 0, type: 1, children: [ { rowValues: { input: '', }, disabled: true, key: shortid(), level: 1, }, { key: shortid(), type: 1, level: 2, disabled: true, children: [ { rowValues: { input: '', }, key: shortid(), level: 2, }, { key: shortid(), rowValues: { input: '', }, level: 2, }, ], }, { rowValues: { input: '', }, key: shortid(), level: 1, }, { rowValues: { input: '', }, key: shortid(), level: 1, }, ], }; 在这种模式下,要去计算对应的高度和渲染正确的样式时,对于其 disabled 的计算需要改为 FilterRules 的 disabled 和当前节点的 disabled 做整合,disabled || !!item.disabled。 02 RulesController 做节点的展示,渲染正确的组件。 具体实现 01 编辑时高度计算 ● 计算每个节点的高度 · 如果是普通节点(蓝色),它的高度为 ITEM_HEIGHT + MARGIN (输入框的高度 + marginBottom) · 如果是条件节点(灰色),它的高度为 children 中每一个节点的高度 + 添加节点的高度 ITEM_HEIGHT const calculateTreeItemHeight = (item, isEdit) => { if (!item?.children) return weakMap.set(item, { height: ITEM_HEIGHT + MARGIN, lineHeight: ITEM_HEIGHT, }); item.children.map((child) => calculateTreeItemHeight(child, disabled)); const height = item.children.reduce( (prev, curr) => prev + weakMap.get(curr).height, ITEM_HEIGHT, ); weakMap.set(item, { height }); }; ● 计算每个节点的连线高度 · 如果是最后一个条件节点 线条长度(红色线条)为:块级高度 - (第一个节点高度 - MARGIN)/2 - 最后一个节点/2 · 如果不是最后一个条件节点 线条长度为:firstNodeLineHeight + 剩余子节点高度 + 添加节点/2 a.第一个子节点是普通节点(蓝色线条):firstNodeLineHeight = 节点高度/2 + MARGIN b.第一个子节点是条件节点(绿色线条):firstNodeLineHeight = 子节点线条高度 + 添加节点/2 const calculateTreeItemHeight = (item: IFilterValue<T>, disabled: boolean) => { if (!item?.children) return weakMap.set(item, { height: ITEM_HEIGHT + MARGIN, lineHeight: ITEM_HEIGHT, }); item.children.map((child) => calculateTreeItemHeight(child, disabled)); const isLastCondition = !item.children.some(isCondition); const firstNodeIsCondition = isCondition(item.children[0]); const height = item.children.reduce( (prev, curr) => prev + weakMap.get(curr).height, ITEM_HEIGHT, ); let lineHeight; // 如果当前节点是最后的判断节点 if (isLastCondition) { const firstNodeLineHeight = weakMap.get(item.children[0]).height - MARGIN; const lastNodeHeight = ITEM_HEIGHT; lineHeight = height - firstNodeLineHeight / 2 - lastNodeHeight / 2; } else { const firstNodeLineHeight = firstNodeIsCondition ? weakMap.get(item.children[0]).lineHeight / 2 + ITEM_HEIGHT / 2 : ITEM_HEIGHT / 2 + MARGIN; lineHeight = firstNodeLineHeight + item.children ?.slice(1) .reduce( (prev, curr) => prev + weakMap.get(curr).height, ITEM_HEIGHT / 2, ); } weakMap.set(item, { height, lineHeight }); }; 02 查看时高度计算 ● 计算每个节点的高度 节点高度,等于每一个节点的高度之和。 const calculateTreeItemHeight = (item: IFilterValue<T>, disabled: boolean) => { if (!item?.children) return weakMap.set(item, { height: ITEM_HEIGHT + MARGIN, lineHeight: ITEM_HEIGHT, }); item.children.map((child) => calculateTreeItemHeight(child, disabled)); const height = item.children.reduce( (prev, curr) => prev + weakMap.get(curr).height, 0, ); weakMap.set(item, { height }); }; 具体的高度图如下图所示: ● 计算每个节点的连线高度 连线高度为:firstNodeLineHeight + 中间节点高度 + lastNodeLineHeight · 如果是最后一个条件节点 lineHeight(红色)= 块级高度(蓝色)- MARGIN - ITEM_HEIGHT/2 - ITEM_HEIGHT/2(紫色) · 如果不是最后一个条件节点,需要根据其子节点再做计算 对于上述这种情况,我们需要递归计算当前条件节点的第一个节点应该减去的高度和最后节点应该减去的高度(蓝色部分)。 const firstNodeLineHeight = firstNode.height - getNodeReduceHeight(item, true); const lastNodeLineHeight = lastNode.height - MARGIN - getNodeReduceHeight(item, false); // 如果是普通节点,返回值为 ITEM_HEIGHT / 2 // 如果是条件节点,返回值 currentNode.lineHeight /2 + getNodeReduceHeight(currentNode, isFirst)。需要递归遍历对应的节点算出总共要减去的高度 const getNodeReduceHeight = (item: IFilterValue<T>, isFirst) => { const currentNode = isFirst ? item?.children?.[0] : item?.children?.[item?.children?.length - 1]; if (!currentNode) return ITEM_HEIGHT / 2; const currentNodeIsCondition = isCondition(currentNode); if (currentNodeIsCondition) { return ( currentNode.lineHeight / 2 + getNodeReduceHeight(currentNode, isFirst) ); } return ITEM_HEIGHT / 2; }; 03 添加新内容 · 最外层的添加(红色) 直接操作当前层级(最外层)的 children,添加一组 INIT_ROW_VALUES · 嵌套层的最下添加按钮(黄色) 获取到当前层的 children,添加一组 INIT_ROW_VALUES · 嵌套层的每一行添加按钮(紫色) 会新增一个嵌套关系 // 根据点击的按钮,来获取相关的 Node,对于红色/黄色按钮来说获取当前层级 Node const finRelationNode = ( parentData: IFilterValue<T>, targetKey: string, needCurrent?: boolean, ) => { const parentDataTemp = parentData; if (parentDataTemp.key === targetKey) return parentDataTemp; if (!parentDataTemp.children?.length) return null; for (let i = 0; i < parentDataTemp.children.length; i++) { const current = parentDataTemp.children[i]; if (current.key === targetKey) return needCurrent ? current : parentDataTemp; const node: IFilterValue<T> | null | undefined = finRelationNode( current, targetKey, needCurrent, ); if (node) return node; } }; const handleAddCondition = (keyObj: { key: string; isOut?: boolean }) => { const cloneData = clone(value); const appendNode = finRelationNode( cloneData as IFilterValue<T>, keyObj.key, keyObj.isOut, ); addCondition(appendNode, keyObj, initValues as T); onChange?.(cloneData); }; const addCondition = ( treeNode: any, keyObj: { key: string; isOut?: boolean }, initRowValue: T, ) => { const key = keyObj.key; if (keyObj.isOut) return treeNode.children.push( Object.assign( {}, { rowValues: initRowValue }, { key: shortId(), level: treeNode.level }, ), ); const children = treeNode?.children; if (!children) { const newNode = { key: treeNode.key, level: treeNode.level + 1, type: ROW_PERMISSION_RELATION.AND, children: [ { rowValues: treeNode.rowValues, key: shortId(), level: treeNode?.level + 1, }, { rowValues: initRowValue, key: shortId(), level: treeNode?.level + 1 }, ], }; delete treeNode.rowValues; Object.assign(treeNode, newNode); return; } for (let i = 0; i < children.length; i += 1) { if (children[i].key !== key) continue; if (treeNode?.level <= maxLevel) { children[i] = { key: children[i].key, type: ROW_PERMISSION_RELATION.AND, level: treeNode?.level + 1, children: [ Object.assign({}, children[i], { key: shortId(), level: treeNode?.level + 1, }), Object.assign({ key: shortId(), rowValues: initRowValue, level: treeNode?.level + 1, }), ], }; } } }; 04 点击删除内容 · 点击紫色按钮,第二个条件节点只剩一个 children,需要删除第二个条件节点,且重新计算每一行的层级 · 点击黄色按钮,当前条件节点的 children 删除一行数据 const deleteCondition = (parentData: IFilterValue<T>, key: string) => { let parentDataTemp = parentData; parentDataTemp.children = parentDataTemp?.children?.filter( (item) => item.key !== key, ); if (parentDataTemp?.children?.length === 1) { const newChild = updateLevel(parentDataTemp.children[0]); const key = parentDataTemp.key; delete parentDataTemp.children; delete parentDataTemp.type; parentDataTemp = Object.assign(parentDataTemp, { ...newChild, key, level: newChild.level, }); } }; const updateLevel = (node: IFilterValue<T>) => { let newChildren; if (node.children) newChildren = node.children.map((element) => updateLevel(element)); const newNode: IFilterValue<T> = { ...node, children: newChildren, level: (node?.level as number) - 1, }; return newNode; }; 05 切换条件节点 获取到当前层级的节点,改变对应的 type 值。 const handleChangeCondition = (key: string, type: ROW_PERMISSION_RELATION) => { const cloneData = clone(value); const changeNode = finRelationNode(cloneData, key, true); changeNode.type = type === ROW_PERMISSION_RELATION.AND ? ROW_PERMISSION_RELATION.OR : ROW_PERMISSION_RELATION.AND; onChange?.(cloneData); }; 06 改变组件数据 const handleChangeRowValues = (key: string, values: T) => { const cloneData = clone(value); const changeNode = finRelationNode(cloneData, key, true); changeNode.rowValues = { ...(changeNode.rowValues ?? {}), ...values, }; onChange?.(cloneData); }; 至此,且或组件已经实现完成,FilterRules 主要是操作数据,RuleController 主要是条件/线条/组件的渲染,支持用户自定义 component 传入 FilterRules。 《行业指标体系白皮书》下载地址:https://www.dtstack.com/resources/1057?src=szsm 《数栈产品白皮书》下载地址:https://www.dtstack.com/resources/1004?src=szsm 《数据治理行业实践白皮书》下载地址:https://www.dtstack.com/resources/1001?src=szsm 想了解或咨询更多有关大数据产品、行业解决方案、客户案例的朋友,浏览袋鼠云官网:https://www.dtstack.com/?src=szkyzg