首页 文章 精选 留言 我的

精选列表

搜索[fota升级],共10000篇文章
优秀的个人博客,低调大师

CXYGZL-程序员工作流,持续迭代升级中

概述 现在开源的工作流引擎,基本都是以BPMN.js为基础的,导致使用门槛过高,非专业人员无法驾驭。本工作流借鉴钉钉/飞书的方式,以低代码方式降低用户使用门槛,即使是普通企业用户也可以几分钟内就能搭建自己的工作流引擎。 官网:程序员工作流 本次更新内容 【新增】流程报表支持条件筛选导出 【新增】流程支持多版本管理,支持暂存功能 【新增】用户任务支持任务监听器 【新增】用户任务支持审批时限 【新增】支持用户属性中的多选当做分支条件 【新增】单选多选表单支持远程加载选项 【优化】流程报表在发起流程的时候记录数据,流程完成的时候完善数据;新增流程状态、审批结果等字段 【优化】签署合同自动生成电子证书并保存 【优化】流程结束删除相关流程实例字段 【优化】记录用户任务是否自动完成 【优化】创建流程添加redis锁防止重复创建 【修复】签署合同签章错位问题 功能介绍 便捷 已适配H5、微信小程序和钉钉小程序,随时随地可以发起流程、处理任务、查看流程执行情况,不遗漏任何一个瞬间 好用 通过低代码方式,拖拽表单、自定义流程图即可实现自己的工作流。所有配置所见所得,无需复杂配置 专业 支持排他网关、包容网关、延时器、子流程等多种节点以及流程监听器、动态表单权限等专业功能,实现流程与业务的丝滑接入 强大 审批只是其中一个功能,业务编排、动态表单等也不在话下。用户动态属性更是提供更多扩展,使得流程更加丰富

优秀的个人博客,低调大师

2023 基于 mybatis 的 orm:mybatis-mp 1.2.6 发布 - 重磅升级!

mybatis-mp 包含丰富的 api: 1:基于注解,映射数据库; 2:支持多表 join 和返回; 3:api 采用 lambda 和 stream 流式设计; 4:内置分页以及超强的 sql 优化功能; 5:稳定且性能极优; 6:轻量级封装 mybatis,几乎没有侵入; 7:api 丰富,支持数据库函数、多表、乐观锁、多租户、逻辑删除、默认值(可动态值) 等众多功能; 8:零学习成本,和写 sql 一样方便。 9:支持复杂的返回关系映射:例如一对一 ,一对多,多对多; 10:内置代码生成器,通过配置,可定制自身规范; 11:全新的框架,全新的设计理念,新的就是好! mybatis-mp 1.2.6 更新: 1:增加 and(动态条件) or(动态条件)方法 //Query中使用 Integer id = QueryChain.of(sysUserMapper) .select(SysUser::getId) .from(SysUser.class) .and(SysUser::getId, c -> c.concat("x1").eq("2x1")) .setReturnType(Integer.TYPE) .get(); //Where中使用 SysUser sysUser = sysUserMapper.get(where -> where.and(SysUser::getId, c -> c.concat("x1").eq("2x1"))); 2:增加mapWithKey 多个方法,用于指定 key ,value的map查询 //最强mapWithKey 完全自己构建 Map<Integer, SysRole> map = QueryChain.of(sysRoleMapper).mapWithKey(SysRole::getId); //根据where条件 Map<String, SysRole> map1 = sysRoleMapper.mapWithKey(SysRole::getName, where -> { where.gt(SysRole::getCreateTime, LocalDate.parse("2023-01-01").atStartOfDay()); }); //根据多个id Map<Integer, SysRole> map2 = sysRoleMapper.mapWithKey(SysRole::getId, 1, 2, 3); //根据List<id> Map<Integer, SysRole> map3 = sysRoleMapper.mapWithKey(SysRole::getId, Arrays.asList(1, 2, 3)); 3:围绕Mybatis Mapper接口 底层优化! 更新说明: 1.2.6版本大大方便了对条件的构建;mapWithKey 方法也给不喜欢join的开发提高了多表遍历的遍历,所以历时一天,决定更新,让更多的人用上!

优秀的个人博客,低调大师

版本升级 | v1.0.13 发布,传下去:更好用了

新发行版来啦~ 本次更新主要聚焦兼容性的提升及结果报告格式的增加,另外对部分解析逻辑及使用体验进行了优化。在这里特别鸣谢大佬@Hugo-X在社区仓库提交的PR~ 后续,OpenSCA项目组会继续致力于完善本地能力闭环,覆盖更多场景。 v1.0.13更新内容 本地漏洞库兼容多数据格式 支持SQLite、CSV格式结果报告 可选英文版HTML报告 优化JS解析逻辑 支持跳过解压步骤,分析文件目录 支持指定日志文件位置 更新说明 1. 漏洞库兼容多数据格式 本地漏洞库在支持JSON格式的基础上,新增支持SQL数据库格式。按照项目组提供的漏洞库字段样例( https://opensca.xmirror.cn/docs/v1/cli.html )创建好数据表,并在配置文件中配置即可: 图:通过配置文件配置多种漏洞库数据格式 图:MySQL漏洞库样例 2. 新增多种结果报告格式(@Hugo-X) 2.1支持SQLite、CSV报告输出 检测结果报告输出新增SQLite、CSV两种格式,仅需在检测命令的out参数中指定相应的结果文件后缀名为.sqlite、.csv。 目前,OpenSCA可输出 JSON / HTML / XML / SQLite / CSV 共5种格式的结果报告,以及SPDX / Cyclonedx / SWID三种国际标准格式SBOM清单。 2.1.1使用样例 # 输出sqlite报告opensca-cli -url https://opensca.xmirror.cn -token ${token} -path ${project_path} -out output.sqlite# 输出csv报告opensca-cli -url https://opensca.xmirror.cn -token ${token} -path ${project_path} -out output.csv 2.1.2报告示例 图:CSV格式结果报告 图:SQLite格式结果报告 2.2英文版HTML报告 在原有HTML报告基础上新增了英文选项,供用户自主选择。 2.2.1使用样例 opensca-cli -url https://opensca.xmirror.cn -token ${token} -path ${project_path} -out output.html 2.2.2报告示例 图:中英双语HTML报告 3. 优化部分解析逻辑及使用体验 3.1JS解析逻辑优化 优化了解析JS项目时对node_modules文件的处理逻辑,进一步提升了检测速度。 3.2支持跳过解压步骤,分析文件目录 新增命令行参数-dironly,用于绕过解压步骤直接分析目录,以便提升特定场景下的检测速度。 opensca-cli -url https://opensca.xmirror.cn -token ${token} -path ${project_path} -dironly -out output.html 3.3指定日志文件位置 新增命令行参数-log用于指定日志文件位置;本次检测的日志文件所在位置也会打印到命令行界面。 默认情况下,日志文件会在OpenSCA可执行文件的同目录下生成。 3.3.1使用样例 # Windows执行命令opensca-cli.exe-url https://opensca.xmirror.cn -token ${token} -path ${project_path} -log ${log_path} -out output.html 3.3.2命令行示意 图:通过命令行指定日志文件位置 以上就是本次更新的全部内容啦~ 共建开源项目 感谢每一位开源社区成员对OpenSCA的支持和贡献。OpenSCA的代码会在GitHub和Gitee持续迭代,欢迎Star和Fork,也欢迎向我们提交ISSUE和PR,参与我们的开源安全共建计划,与社区成员共同建设充满可能性的开源解决方案。

优秀的个人博客,低调大师

ModStartCMS v7.1.0 后台栏目模式切换,富文本公式升级

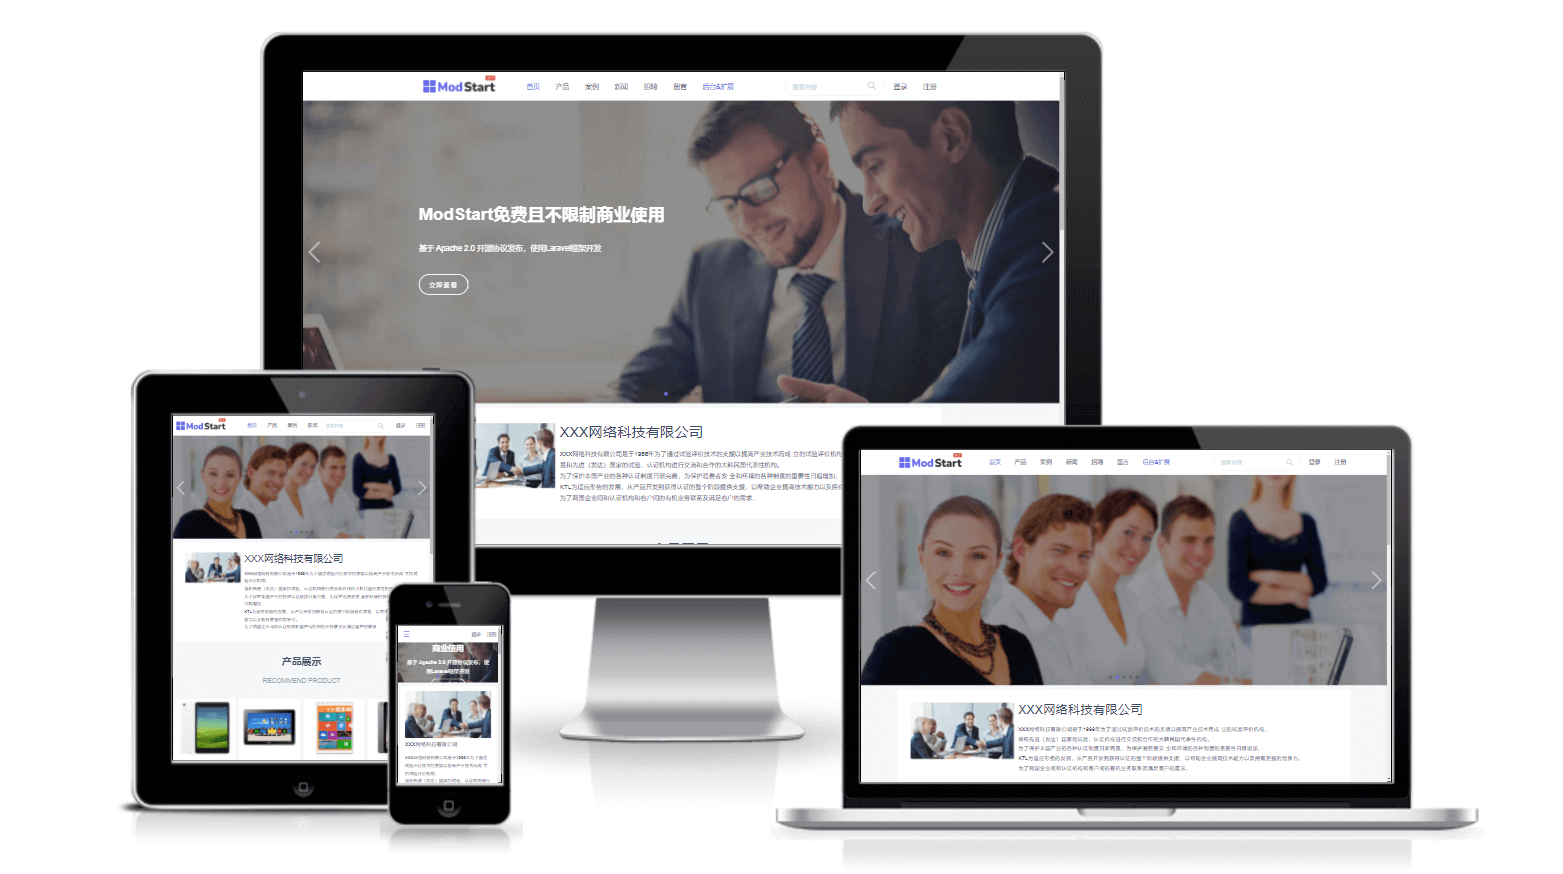
ModStart 是一个基于 Laravel 模块化极速开发框架。模块市场拥有丰富的功能应用,支持后台一键快速安装,让开发者能快的实现业务功能开发。 系统完全开源,基于 Apache 2.0 开源协议,免费且不限制商业使用。 功能特性 丰富的模块市场,后台一键快速安装 会员模块通用且完整,支持完整的API调用 大文件分片上传,进度条显示,已上传文件管理 强大的模块扩展功能,所有模块可以无缝集成,支持在线安装、卸载模块 完善的开发助手,实现模块、主题的的一键创建 完善的后台权限管理,支持基于RBAC的权限管理系统 后台管理支持使用手机、平板、PC,无论何时何地都可方便管理 第三方登录(QQ、微信、微博、支付宝、微信小程序) 第三方支付支持(微信、支付宝、支付宝当面付、微信扫码、微信小程序) 第三方云存储支持,支持云储存分片上传(阿里云、百度云、华为云、腾讯云、FTP、七牛云、UCloud、又拍云) 第三方短信支持(阿里云、腾讯云、华为云、百度云、253云通讯、聚合、七牛云、融云、赛邮、UCloud、云片、网易云) V7.1.0版本更新 2023年08月23日ModStartCMS发布v7.1.0版本,增加了以下12个特性: [新功能] 手机端Banner支持视频背景显示 [新功能] CMS内容管理分页增加跳转功能 [新功能] 富文本公式编辑默认替换为LatexEasy [新功能] 支持MS.ui.state库方法,历史状态管理 [新功能] 同时增加多个数据库表备注方法 [新功能] 后台栏目管理模式可控制,解决栏目管理条数太多显示问题 [系统优化] 样式sm、md、lg、xl尺寸优化 [系统优化] 面包屑分隔符样式优化 [系统优化] 图片类组件预览修改为contain模式 [系统优化] VIP开通快捷支付概率性异常问题 [Bug修复] 图片上传自动纠正方向和大小异常格式修复 [Bug修复] 数字组件为0时默认值显示异常问题 模块市场一键安装 系统内置模块市场,有行业应用、插件、云存储、云短信等功能模块,后台支持一键安装、启用、禁用、卸载,可快速搭建属于自己的系统应用。 系统演示与文档 码云仓库:https://gitee.com/modstart/ModStartCMS Github仓库:https://github.com/modstart/ModStartCMS 系统演示:https://cms.demo.tecmz.com/ 下载试用:https://modstart.com/download 开发者文档:https://modstart.com/doc 模块市场:https://modstart.com/store

优秀的个人博客,低调大师

StarRocks 3.1 重磅发布,云原生湖仓新范式再升级!

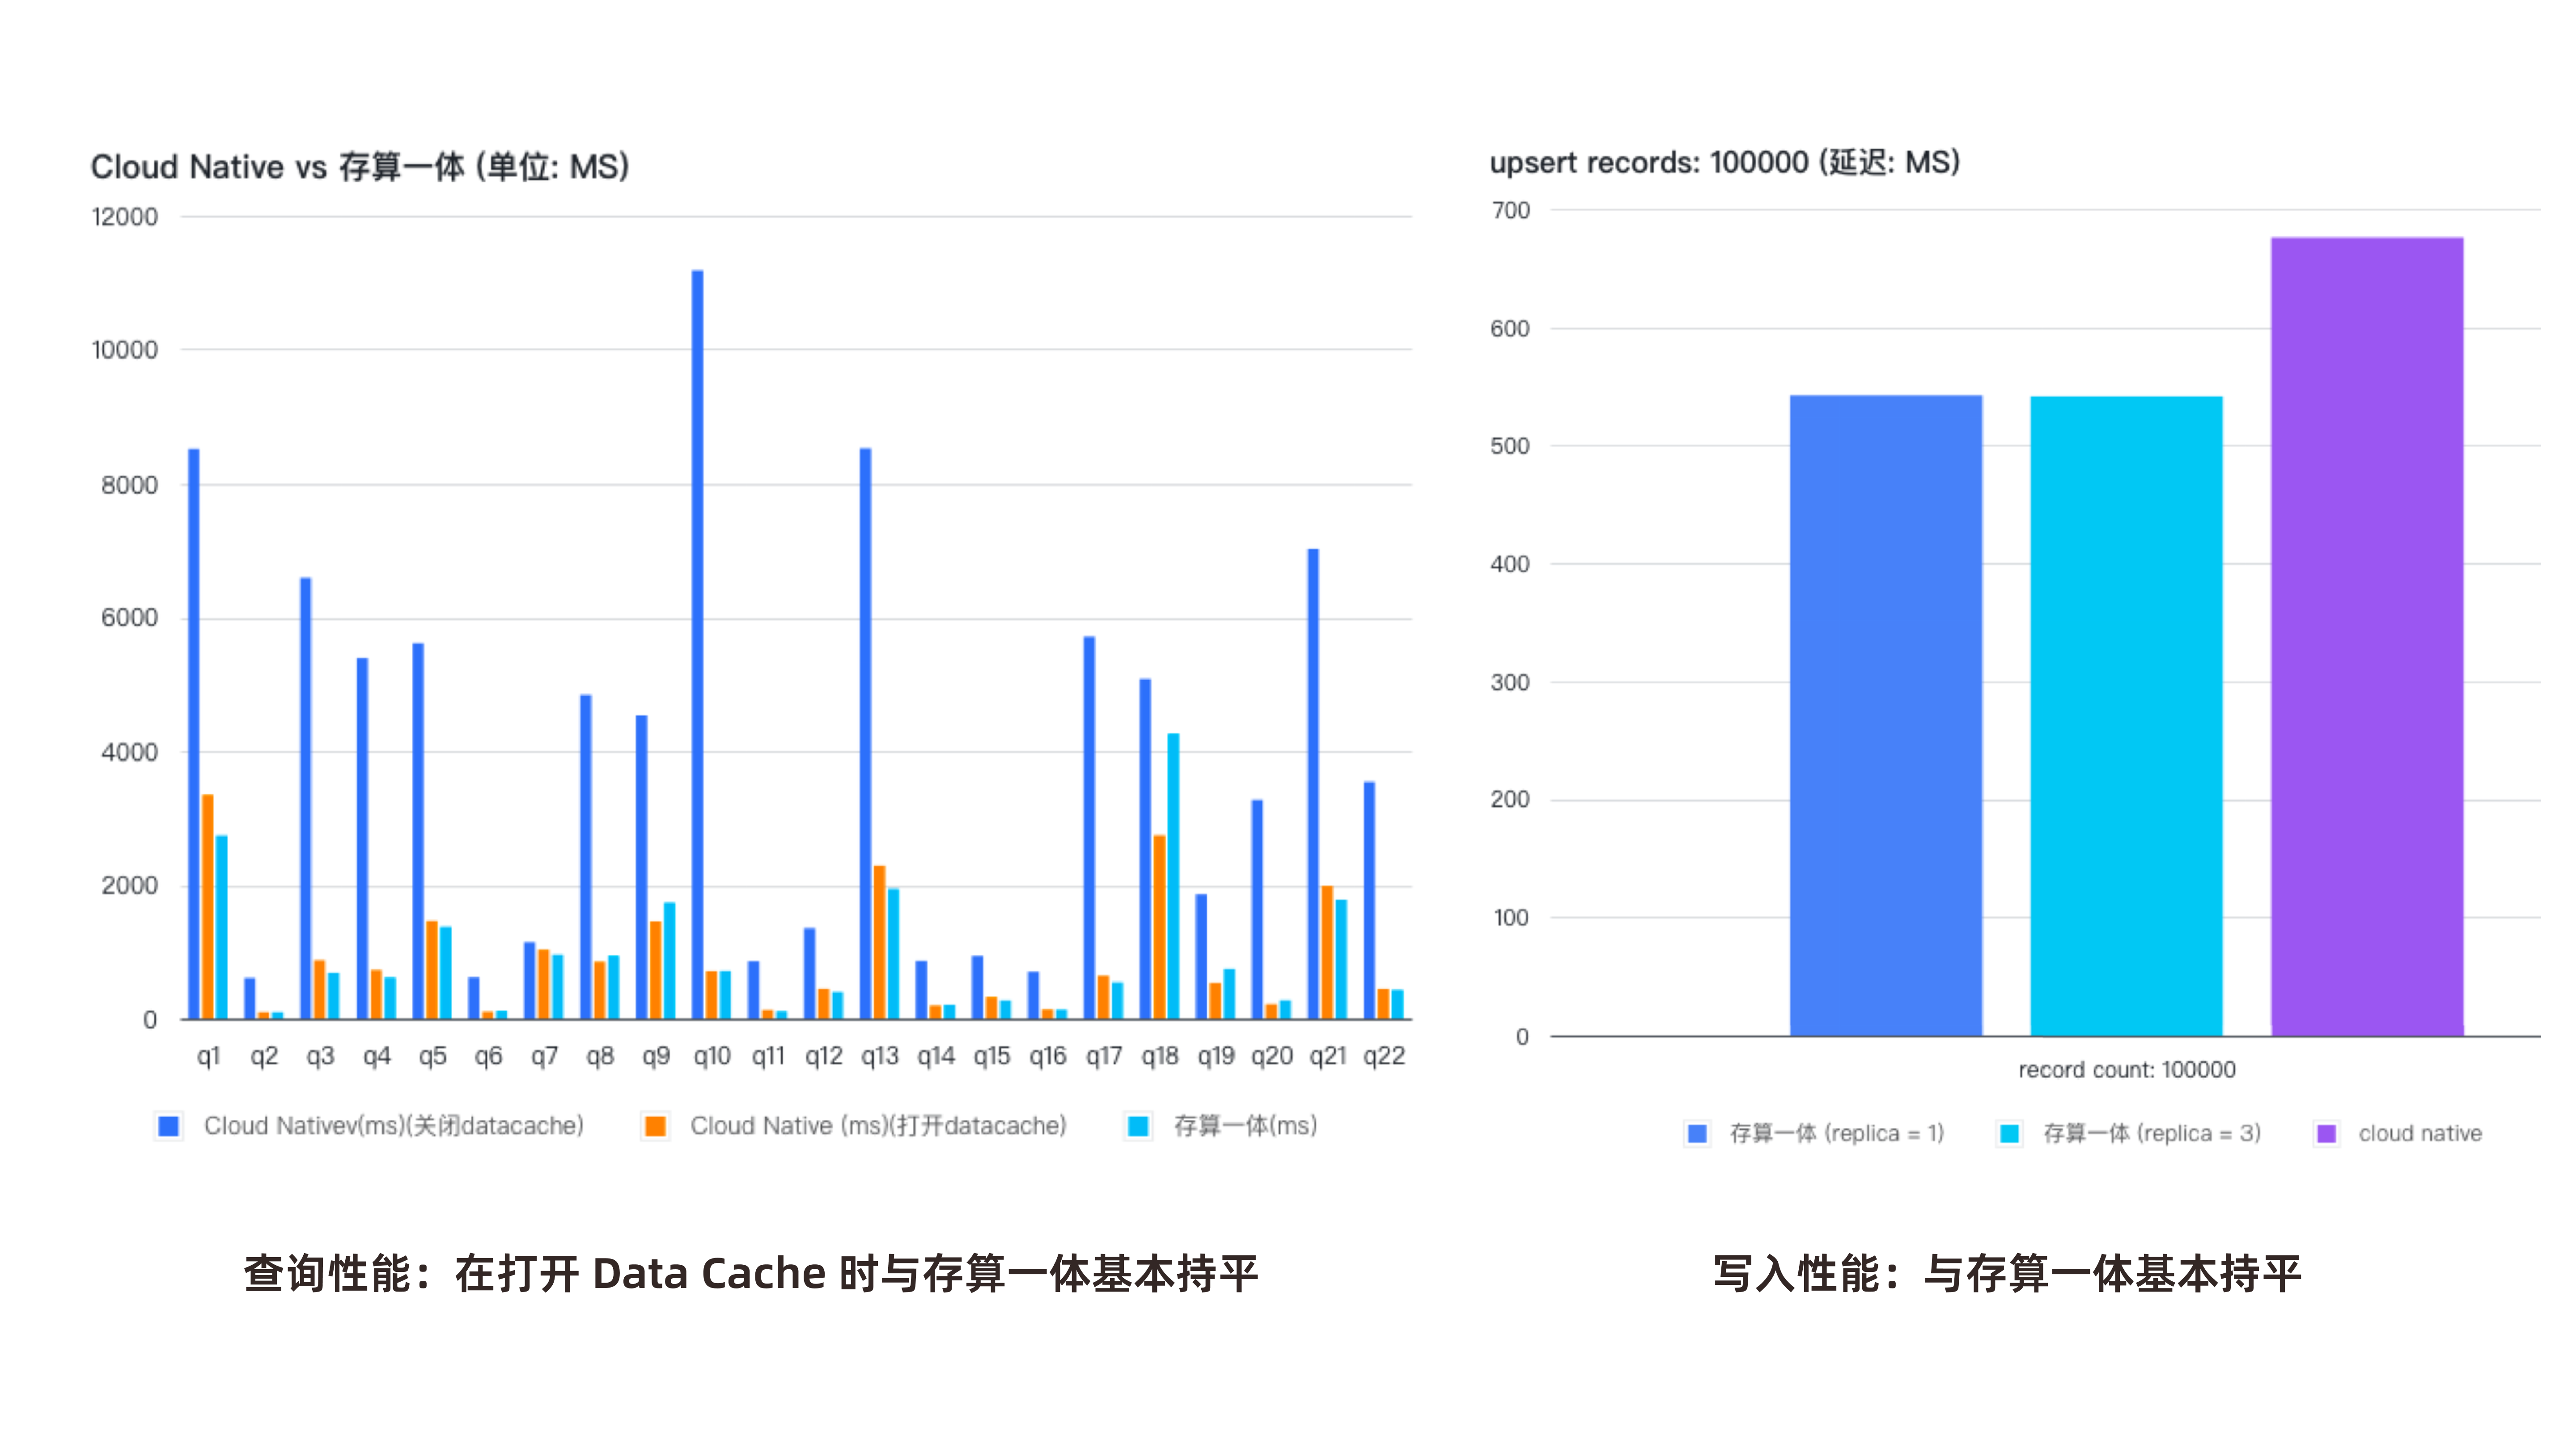
​StarRocks 自 4 月底发布 3.0 版本,拥抱云原生,开启极速统一的湖仓新范式;8月7日,StarRocks 正式发布全新 3.1 版本,全面提升云原生存算分离构架、极速数据湖分析、物化视图等重量级特性,让用户更简单的实现极速统一的湖仓分析。 StarRocks 3.1 版本湖仓一体分析功能更完善、更易用: 存算分离架构功能对齐存算一体,支持业界广泛应用的主键表模型及相关功能,让存算分离更好地支持实时分析场景;性能上,查询和导入性能也基本与存算一体架构持平。 极速数据湖分析性能进一步提升,比 Trino/Presto 快3-6倍, 并实现常用 Trino 语法的完全兼容;增加 Apache Iceberg 的读写支持、对流式数据湖 Apache Paimon 的分析支持,让数据湖分析更加实时、简单、高效。 异步物化视图上,进一步提升物化视图构建、刷新的稳定性,并提供更多灵活易用的创建和刷新参数、增加更多场景的 SQL 智能改写。 StarRocks 3.1 提供了随机分桶、表达式分区、FILES 表函数等更多新功能、新模式,进一步提升建表/分区/导入中的易用性。 毫无疑问,无论是功能、性能还是易用性,StarRocks 都将持续迈向新的台阶,打造 Lakehouse 的新范式,为用户提供极速统一的数据分析体验! 开始体验 StarRocks 3.1: 完整中文 release note:https://docs.mirrorship.cn/zh-cn/main/release_notes/release-3.1 GitHub 地址:https://github.com/StarRocks/starrocks 二进制包下载:https://www.mirrorship.cn/zh-CN/download/community 新增核心功能介绍 1、存算分离架构 3.1 版本,StarRocks 进一步完善对齐存算一体架构下的功能,包括新增支持主键模型表(包括支持部分列更新,但暂不支持持久化索引)、自增列属性 AUTO_INCREMENT、时间函数表达式分区及导入时自动创建分区。并且,进一步优化了数据缓存功能,可以指定热数据的缓存范围以防止冷数据过多占用缓存、影响热数据查询速度。在打开 Data cache 的情况下,存算分离架构与存算一体架构在查询性能、导入性能上都已基本持平。存算分离架构可以帮助用户在不损失查询性能的前提下,极大的降低存储成本。 2、数据湖分析 3.1 版本对 Iceberg Catalog 进行了完善与增强: 在查询能力上,新增支持了对 Parquet 格式的 Icerberg v2 MOR 表的访问。 在查询性能上,新增支持了对 Iceberg 元数据的内存+磁盘的两级缓存,在元数据文件较大的情况下显著提升查询性能。 在写入能力上,新增支持了在 Icerberg 内创建数据库、表,并通过 INSERT INTO/OVERWRITE 写入 Parquet 格式数据。方便用户将 StarRocks 处理好的数据通过开放格式提供给生态内的其他组件。 同时,3.1 版本新增支持了 Elasticsearch catalog、Paimon catalog,并进一步增强 Trino 语法兼容性,持续扩大生态打通和提升产品易用性。 3、物化视图 自从 2.4 版本支持异步物化视图以来,这一功能就已经被大量的用户应用在查询加速、数仓建模等场景中。3.1 版本在异步物化视图的创建管理、查询智能改写、使用易用性上继续做了大量的优化工作。 对于同步物化视图,StarRocks 也在 3.1 版本中扩展了它的能力边界,拓宽更多应用场景。 异步物化视图 StarRocks 致力于让异步物化视图拥有与内表相同的加速和管理能力,在 3.1 版本中: 支持通过ORDER BY 指定排序键,支持设置colocate_group,进一步利用 StarRocks 原生存储的优化来加速物化视图的查询性能。 支持配置存储介质和降冷时间(storage_medium 、cooldown_time ),方便数据的生命周期管理。 支持不指定分桶,默认采用随机分桶,提升创建物化视图的易用性。 并且为了使异步物化视图更加灵活,在 3.1 版本中: 支持为物化视图的刷新配置会话变量 (Session Variable),用户可以方便地为物化视图配置单独的执行策略,如查询超时时间、并行度、内存限制、是否开启算子落盘等。让物化视图的刷新不受集群整体变量的限制。 支持基于视图(View)创建物化视图,分层建模选择更加灵活。 支持通过SWAP原子替换物化视图,从而实现物化视图的 Schema Change 而不影响嵌套的血缘关系。 支持手动激活失效的物化视图,从而在基表重建后仍旧复用历史物化视图。 在查询改写上,StarRocks 致力于让更多场景能够被智能改写,更多发挥物化视图的加速效果。在 3.1 版本中: 新增支持 Join 派生改写、Count Distinct、time_slice 函数等场景的改写,并优化了 Union 改写能力。 新增支持 Stale Rewrite,即在一定时间内允许改写至还未刷新的物化视图上。从而在允许一定数据延迟的实时场景下,通过物化视图提高查询并发。 新增支持 View Delta Join,提升如指标平台、面向主题的宽表场景下的改写能力,降低物化视图的维护成本。 在刷新能力上,在 3.1 版本中: 支持全新同步物化视图刷新接口,同步获取刷新结果。 基于 Hive Catalog 创建的外表异步物化视图可以感知分区变动,按分区增量刷新,加速刷新的同时降低成本。 同步物化视图 同步物化视图因其同步更新、增量计算的能力受到广大用户的喜爱。在历史版本中,由于其支持的算子较少,应用场景较为受限。在 3.1 版本中,StarRocks 对同步物化视图能力边界进行拓展。在计算能力上,支持了CASE-WHEN、CAST、数学运算等表达式;支持在单个物化视图内设置多个聚合列;并且支持使用 HINT 来对同步物化视图进行直接查询。 CREATE MATERIALIZED VIEW v1 AS SELECT b, sum(a + 1) as sum_a1, min(cast (a as bigint)) as min_a FROM base_table GROUP BY b; 在未来,StarRocks 也将持续完善和挖掘同步和异步物化视图的能力,让物化视图功能成为数据湖查询的一大利器。 4、优化查询性能和稳定性 卓越的查询性能是 StarRocks 一直以来引以为傲的优势。3.1 版本中,新增了生成列(Generated Column)功能,StarRocks 会根据生成列表达式自动计算表达式的值并在导入时即存储,在查询时会自动判断并进行改写,在无需增加查询复杂性的情况下,再一步提升查询性能,尤其适用对 JSON、Array、Map、Struct 等半结构数据的查询加速和对复杂表达式的计算加速。并且,如果生成列的类型是简单类型,还能利用上 zonemap 等索引,会更进一步加速查询性能。 如下所示,newcol1、newcol2 是两个分别是对 data_array、data_json 列做了一些函数操作的生成列。 CREATE TABLE t ( id INT NOT NULL, data_array ARRAY < int > NOT NULL, data_json JSON NOT NULL, newcol1 DOUBLE AS array_avg(data_array), newcol2 STRING AS get_json_string(json_string(data_json), '$.a') ); 插入数据时正常插入即可(不用关心生成列),newcol1、newcol2 会自动计算并存储。 INSERT INTO t VALUES (1, [1,2], parse_json('{"a" : 1, "b" : 2}')), (2, [3,5], parse_json('{"a" : 8, "b" : 3}')) 查询时也正常查询即可,StarRocks 会自动改写 Query,变成对 newcol1、newcol2 的使用。 SELECT max(get_json_string(json_string(data_json),”$.a”)) AS a, min(array_avg(data_array)) AS b FROM t; 同时,StarRocks 优化了主键模型的部分列更新功能,执行 UPDATE 语句时会开启列模式(column mode),在更新少部分列但是有大量行的场景下,可提升十倍性能。 在原来的「行模式」下,部分列更新时,StarRocks 会需要重写整行数据。 在新的「列模式」下,只需要重写更新的列数据即可。 还有,StarRocks 支持了基数保持 JOIN 表(Cardinality-preserving Joins)的裁剪,优化了点查查询性能、统计信息收集、并行 merge 算法、优化内部锁使用的逻辑等等,进一步提升各类细分场景下的查询性能。其中「基数保持 JOIN 表的裁剪」功能在较多表的星型模型(比如 SSB)和雪花模型(TPC-H)中会有用武之地,当 JOIN 的表存在主键或者外键约束,且可以满足基数保持 JOIN 表裁剪的条件,一些经过裁剪后的 JOIN 的性能能加速 10X 倍以上。在风控领域进行多种组合的特征选择时,往往采用直接查询由较多表 JOIN 后的 View,此时的裁剪就会起到不错的效果。 ⚠SELECT view 时,view 中不需要用到的 Table-C 被自动裁剪掉了。使用中需要额外设置一些约束。 Spill To Disk 加强 除了卓越的查询性能,在大规模的数据集上查询时的稳定性也是很重要的一个方面。3.1 版本中,StarRocks 正式支持了部分阻塞算子的 Spill(中间数据落盘)能力,当查询中包括聚合、排序或者连接算子时,开启 Spill 功能将允许相关的算子将计算的中间结果缓存到磁盘上,从而降低内存占用,尽量避免查询因内存不足而失败,在物化视图构建、数据 ETL 处理等内存密集型的场景中,开启 Spill 会极大地提升查询的稳定性。在单个 BE、16core/内存限制20G 的测试环境中,开启 Spill 功能后,StarRocks 能完整地跑完 TPCH-1TB 和 TPCDS-1TB 测试集。 5、提升建表与导入的易用性 在不断优化查询性能的同时,StarRocks 持续在建表和导入方面提升产品易用性、提供更多实用功能。在建表时,用户可以配置随机分桶(Random Bucketing)方式(默认),不再需要设置分桶键,StarRocks 会将导入数据随机分发到各个分桶中,同时配合使用 2.5.7 版本起支持的自动设置分桶数量功能(默认),用户可以不再需要关心分桶配置。 CREATE TABLE site_access( event_day DATE, site_id INT DEFAULT '10', ... ) DUPLICATE KEY(event_day, site_id) PARTITION BY date_trunc('day', event_day) DISTRIBUTED BY HASH(event_day,site_id) BUCKETS 10; -- 可以不再需要指定 在导入数据时,如果数据是存储在 AWS S3/HDFS 上的 Parquet/ORC 格式文件,用户可以很简单地直接采用 INSERT + FILES() 表函数来导入数据,FILES 表函数会自动进行 table schema 推断,做到数据拿来即可 SELECT,用户甚至还可以使用 CTAS + FILES 一键式导入数据,在前期测试数据导入阶段尤其适用。 CREATE TABLE insert_wiki_edit AS SELECT * FROM FILES( 'path' = 's3://inserttest/parquet/insert_wiki_edit_append.parquet', 'format' = 'parquet'); 同时,关于建表时的分区设置,一般直接设置日期时间字段作为分区列即可,如果用户想要根据自己的数据更灵活地配置,也可以使用 StarRocks 新支持的表达式分区和LIST 分区方式,其中配置表达式分区后,StarRocks 会根据数据和分区表达式的定义规则自动创建分区。 并且,继 3.0 版本中湖分析支持查询 Map、Struct 类型数据后,3.1 版本中导入数据时也支持导入 Parquet/ORC 格式数据中的 Map、Struct 字段类型,为导入提供了更多选项。 StarRocks 在简化建表、简化导入方面将持续地进行端到端的优化,不断提升产品易用性和功能的完善性。 6、增强半结构化分析能力 3.1 版本中,StarRocks 正式原生支持了 Map 和 Struct 数据类型。除了基于湖上的半结构化数据分析,也支持建表、导入、创建物化视图。同时也补充了 Map 和 Struct 的更多函数,包括标量、聚合以及更多的 Map 高阶函数。 Array 数据类型支持了 Fast Decimal,并且 Array 函数支持了嵌套结构类型 Map、Struct 和 Array。让用户的查询分析体验更加灵活。 并且结合生成列的能力,可以进一步加速对复杂数据类型的计算与查询。例如对 JSON 内的对象的查询、大 ARRAY 的聚合计算等场景,均可以通过生成列在导入时预先完成计算,并在后续查询中通过自动改写完成查询加速。 可以认为,不论是从导入到查询的功能上、还是用生成列来优化性能上,StarRocks 基本完整地支持了 Array、JSON、Map、Struct 这类半结构化数据的能力。 最后,如你希望更加了解 StarRocks 3.1 版本,欢迎观看视频解说: https://starrocks.feishu.cn/docx/AjsWdc28ZoAygixhZd9cdubAnBd#G8dEdRt0hozBIAxPcc6c1J5TnML 💬StarRocks Feature Groups: StarRocks 社区为了让用户在使用新 features 时能更加得心应手,设立了包含”物化视图“、”湖仓分析“和”存算分离“等的用户群,欢迎小伙伴们入群对特定 feature 进行深入交流! 下方扫码添加小助手,回复关键字存算分离/湖仓分析/物化视图 即可加入对应的用户小组!👇🏻 https://wx.focussend.com/weComLink/mobileQrCodeLink/33412/0bfe8 在这个版本中,117 位贡献者 一共提交了 2785 个 Commits,感谢他们: stdpain, Astralidea, mofeiatwork, yandongxiao, kevincai, Seaven, hellolilyliuyi, EsoragotoSpirit, Youngwb, andyziye, packy92, sduzh, meegoo, zaorangyang, caneGuy, silverbullet233, chaoyli, LiShuMing, trueeyu, srlch, liuyehcf, ABingHuang, luohaha, amber-create, miomiocat, sevev, letian-jiang, stephen-shelby, zombee0, nshangyiming, satanson, fzhedu, Smith-Cruise, gengjun-git, decster, TszKitLo40, starrocks-xupeng, evelynzhaojie, ZiheLiu, zhenxiao, wyb, rickif, HangyuanLiu, liuzhongjun89, dirtysalt, abc982627271, wanpengfei-git, SilvaXiang, hongli-my, kangkaisen, liuyufei9527, ggKe, xuzifu666, ucasfl, GavinMar, jkim650, JackeyLee007, tracymacding, huzhichengdd, Moonm3n, silly-carbon, imay, szza, you06, leoyy0316, Johnsonginati, smartlxh, xiangguangyxg, vendanner, QingdongZeng3, zhangruchubaba, wxl24life, banmoy, matchyc, predator4ann, huangfeng1993, dengliu, choury, bowenliang123, sebpop, RamaMalladiAWS, dustinlineweber, jiacheng-celonis, chen9t, blanklin030, wangsimo0, howrocks, qmengss, alberttwong, before-Sunrise, chenjian2664, wangruin, kobebryantlin0, wangxiaobaidu11, creatstar, kateshaowanjou, huandzh, mlimwxxnn, goldenbean, Jay-ju, ss892714028, mchades, cbcbq, shileifu, xiaoyong-z, sfwang218, uncleGen, r-sniper, blackstar-baba, ldsink, gddezero, fieldsfarmer, even986025158, idomic, yangrong688, padmejin, zuyu


优秀的个人博客,低调大师

再升级!机器学习服务打造“发丝”级图像分割能力

电子证件照需要换底时,如何简单高效将人像边缘切割得顺滑自然?视频弹幕太多挡住了人物的脸,想要实现“弹幕蒙版”又该如何解决? 想要实现以上操作,传统的方式我们需要依赖专业的图像处理软件在电脑端进行手动裁剪人物、添加蒙版、替换画布等,如果人物边缘细节非常丰富,则需要耗费巨大的工作量。那么,有没有操作简单又能实现自然替换的方法呢? 华为机器学习服务提供优秀的静态和动态图像分割能力。基于深度学习框架,结合检测识别技术,实现高精视觉分割能力,可实现秒级全自动主体、场景像素级识别。通过使用具有创新意义的语义分割框架,将图像中的每个像素都进行标签化,可支持人像、天空、植物、美食、建筑、山峰等11大类元素的分割。 图像分割能力可以广泛应用于影像娱乐类App。例如,图像编辑类App集成该服务,可以快速更换图像背景。拍照类App集成该服务,可以识别不同的元素进行不同的优化,例如对植物元素的优化,让植物显得更加青翠。 虽然目前图像抠图市场持续火热,但市面上的一些抠图算法效果在人像发丝细节处理均不是很好,华为机器学习服务针对这一问题,不断深化发丝和高度镂空相关算法,无论是在直播还是图片编辑的人像处理中,都可保留发丝级的边缘细节,呈现出更好的抠图效果。 开发步骤 在进行开发之前,您需要完成必要的开发准备工作,同时请确保您的工程中已经配置HMS Core SDK的Maven仓地址,并且完成了本服务的SDK集成。 华为机器学习服务提供人像分割、多类别分割和头发分割三种能力。 人像分割模型包用于分割人像和背景,支持视频流和图片分割。如果您只需要分割人像和背景,建议使用人像分割模型包。人像分割返回值包括:人像元素的坐标数组、背景透明的人像前景图以及人像为白色,背景为黑色的灰度图。您的App可以在此返回值的基础上做进一步处理,如视频背景替换、人像抠图等。 多类别分割返回值为各元素的坐标数组。例如:一张图像中包含人像、天空、植物、猫狗这4种元素,返回值为这4种元素的坐标数组,以便后续进一步处理不同的元素,如替换天空元素。 头发分割模型包用于分割头发和背景,当前仅支持图片分割,不支持视频流分割,头发分割返回值为头发元素的坐标数据。例如:一张自拍图,返回值为头发元素的坐标数组,以便后续进一步处理,如头发染色等。 静态图像分割 创建图像分割器。 集成人像分割模型包 // 方式一:使用默认参数配置图像分割检测器。 // 默认模式为:人像分割模式+精度模式,返回人像分割的所有分割结果(像素级标记信息、背景透明的人像图、人像为白色,背景为黑色的灰度图以及被分割的原图)。 MLImageSegmentationAnalyzer analyzer = MLAnalyzerFactory.getInstance().getImageSegmentationAnalyzer(); // 方式二:使用自定义参数MLImageSegmentationSetting配置图像分割检测器。 MLImageSegmentationSetting setting = new MLImageSegmentationSetting.Factory() // 设置分割精细模式,true为精细分割模式,false为速度优先分割模式。 .setExact(false) // 设置分割模式为人像分割。 .setAnalyzerType(MLImageSegmentationSetting.BODY_SEG) // 设置返回结果种类。 // MLImageSegmentationScene.ALL: 返回所有分割结果,包括:像素级标记信息、背景透明的人像图和人像为白色,背景为黑色的灰度图以及被分割的原图。 // MLImageSegmentationScene.MASK_ONLY: 只返回像素级标记信息和被分割的原图。 // MLImageSegmentationScene.FOREGROUND_ONLY: 只返回背景透明的人像图和被分割的原图。 // MLImageSegmentationScene.GRAYSCALE_ONLY: 只返回人像为白色,背景为黑色的灰度图和被分割的原图。 .setScene(MLImageSegmentationScene.FOREGROUND_ONLY) .create(); MLImageSegmentationAnalyzer analyzer = MLAnalyzerFactory.getInstance().getImageSegmentationAnalyzer(setting); 集成多类型分割模型包 使用多类型分割模型包对图像进行多类别分割时,只支持通过图像分割检测配置器MLImageSegmentationSetting创建图像分割检测器。 MLImageSegmentationSetting setting = new MLImageSegmentationSetting .Factory() // 设置分割精细模式,true为精细分割模式,false为速度优先分割模式。 .setExact(true) // 设置分割模式为图像分割。 .setAnalyzerType(MLImageSegmentationSetting.IMAGE_SEG) .create(); MLImageSegmentationAnalyzer analyzer = MLAnalyzerFactory.getInstance().getImageSegmentationAnalyzer(setting); 集成头发分割模型包 使用头发分割模型包对图像进行头发分割时,只支持通过头发分割检测配置器MLImageSegmentationSetting创建头发分割检测器。 MLImageSegmentationSetting setting = new MLImageSegmentationSetting .Factory() // 设置分割模式为头发分割。 .setAnalyzerType(MLImageSegmentationSetting.HAIR_SEG) .create(); MLImageSegmentationAnalyzer analyzer = MLAnalyzerFactory.getInstance().getImageSegmentationAnalyzer(setting); 通过android.graphics.Bitmap创建MLFrame对象用于分析器检测图片,支持的图片格式包括:jpg/jpeg/png,建议图片尺寸不小于224224像素,不大于12801280像素。 // 通过bitmap创建MLFrame,bitmap为输入的Bitmap格式图片数据。 MLFrame frame = MLFrame.fromBitmap(bitmap); 调用asyncAnalyseFrame方法进行图像分割。 // 创建一个task,处理图像分割检测器返回的结果。 Task<MLImageSegmentation> task = analyzer.asyncAnalyseFrame(frame); // 异步处理图像分割检测器返回结果。 task.addOnSuccessListener(new OnSuccessListener<MLImageSegmentation>() { @Override public void onSuccess(MLImageSegmentation segmentation) { // 检测成功处理。 }}) .addOnFailureListener(new OnFailureListener() { @Override public void onFailure(Exception e) { // 检测失败处理。 }}); 检测完成,停止分析器,释放检测资源。 if (analyzer != null) { try { analyzer.stop(); } catch (IOException e) { // 异常处理。 } } 以上示例代码中使用了异步调用方式,图像分割还支持同步调用使用analyseFrame函数获取检测结果: SparseArray<MLImageSegmentation> segmentations = analyzer.analyseFrame(frame); 了解更多详情>> 访问机器学习服务联盟官网 获取机器学习服务开发指导文档 访问HMS Core 联盟官网 获取HMS Core 开发指导文档 关注我们,第一时间了解 HMS Core 最新技术资讯~

优秀的个人博客,低调大师

ModStartCMS v6.2.0,VIP 权益配置功能、界面 UI 优化升级

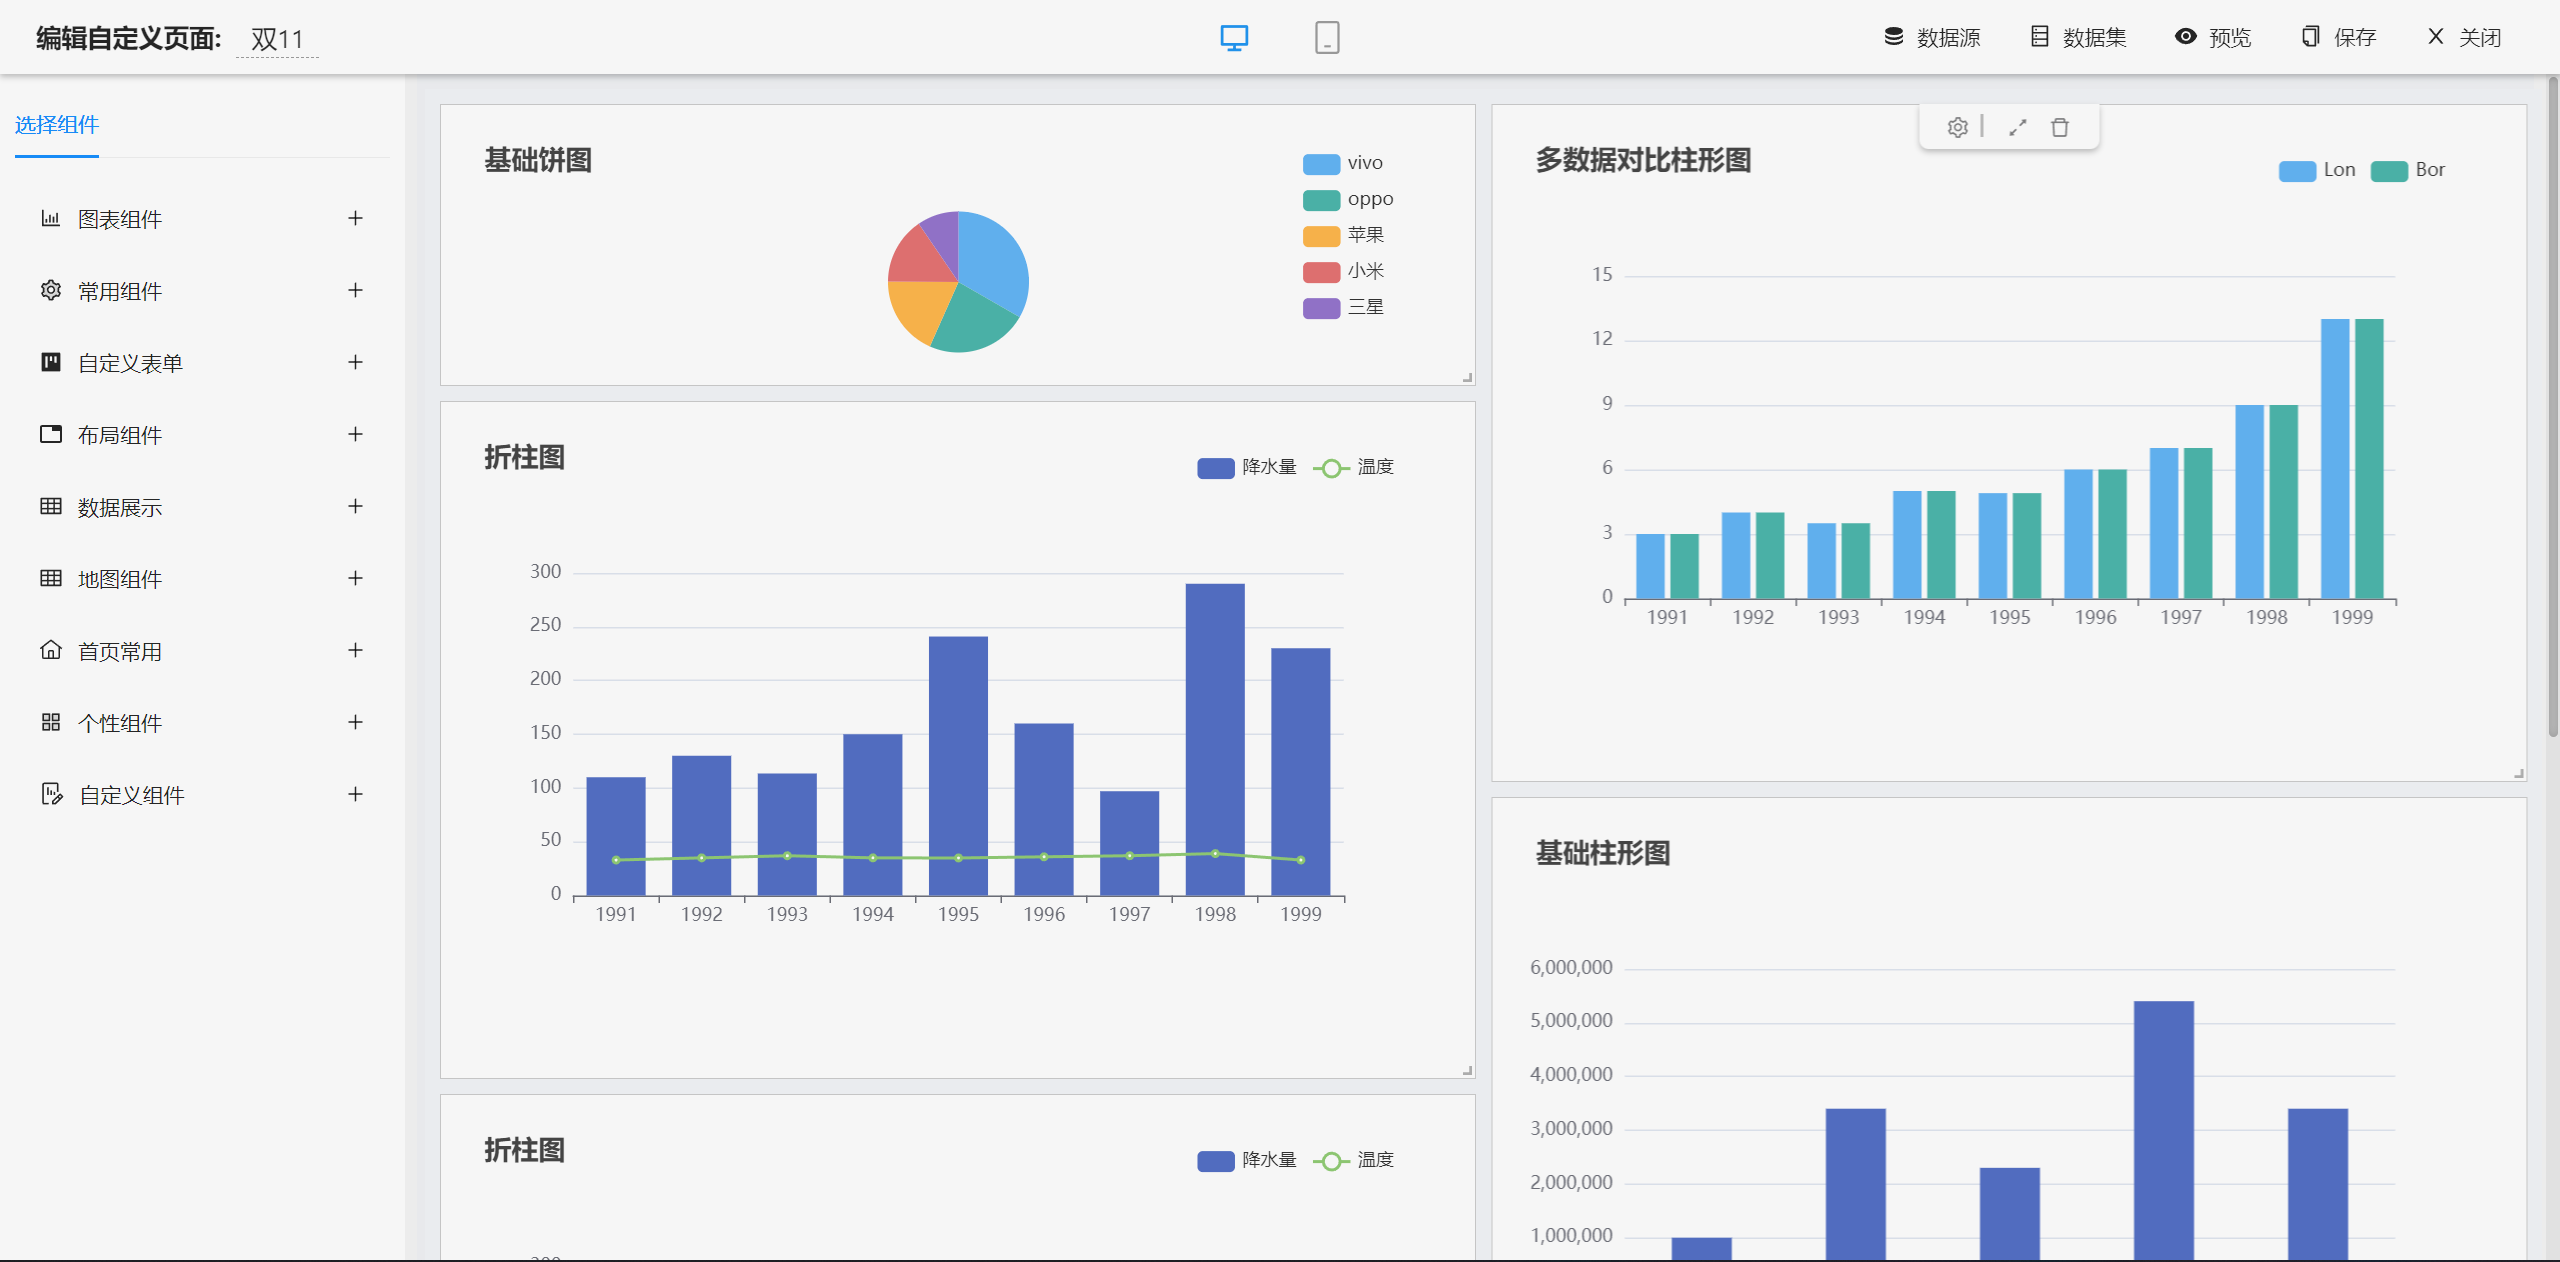
ModStart 是一个基于 Laravel 模块化极速开发框架。模块市场拥有丰富的功能应用,支持后台一键快速安装,让开发者能快的实现业务功能开发。 系统完全开源,基于 Apache 2.0 开源协议,免费且不限制商业使用。 功能特性 丰富的模块市场,后台一键快速安装 会员模块通用且完整,支持完整的API调用 大文件分片上传,进度条显示,已上传文件管理 强大的模块扩展功能,所有模块可以无缝集成,支持在线安装、卸载模块 完善的开发助手,实现模块、主题的的一键创建 完善的后台权限管理,支持基于RBAC的权限管理系统 后台管理支持使用手机、平板、PC,无论何时何地都可方便管理 第三方登录(QQ、微信、微博、支付宝、微信小程序) 第三方支付支持(微信、支付宝、支付宝当面付、微信扫码、微信小程序) 第三方云存储支持,支持云储存分片上传(阿里云、百度云、华为云、腾讯云、FTP、七牛云、UCloud、又拍云) 第三方短信支持(阿里云、腾讯云、华为云、百度云、253云通讯、聚合、七牛云、融云、赛邮、UCloud、云片、网易云) V6.2.0版本更新 2023年04月18日ModStartCMS发布v6.2.0版本,增加了以下18个特性: [新功能] 图表显示新增加另存为图片、数据视图功能 [新功能] Banner导航自动隐藏显示动画 [新功能] Grid过滤组件Range-Datetime增加快捷时间选取 [新功能] 用户注册IP长度限制 [新功能] Values组件增加Grid和Detail显示优化 [新功能] 轮播图片快速调用方式BannerView [新功能] CMS详情自定义字段自动反序列化 [新功能] Response::abortMsg支持JSON格式自动识别 [新功能] 安装引导界面静态文件强制清除缓存 [新功能] 用户VIP权益配置功能 [系统优化] FileUtil文件下载失败时异常捕获返回NULL [系统优化] 用户找回密码页面样式,增加密码找步骤 [系统优化] 用户注册自动关联默认VIP和默认分组 [系统优化] 后台Grid图片预览采用Contain模式 [系统优化] UEditorPlus富文本编辑器图片自动抓取忽略URL优化 [系统优化] 代码目录结构重新整理,优化命名空间,弃用标记 [Bug修复] Admin配置页面config获取数组逻辑异常问题 [Bug修复] Checkbox组件默认值不生效问题修复 模块市场一键安装 系统内置模块市场,有行业应用、插件、云存储、云短信等功能模块,后台支持一键安装、启用、禁用、卸载,可快速搭建属于自己的系统应用。 系统演示与文档 码云仓库:https://gitee.com/modstart/ModStartCMS Github仓库:https://github.com/modstart/ModStartCMS 系统演示:https://cms.demo.tecmz.com/ 下载试用:https://modstart.com/download 开发者文档:https://modstart.com/doc 模块市场:https://modstart.com/store

优秀的个人博客,低调大师

字节跳动开源 Katalyst:在离线混部调度,成本优化升级

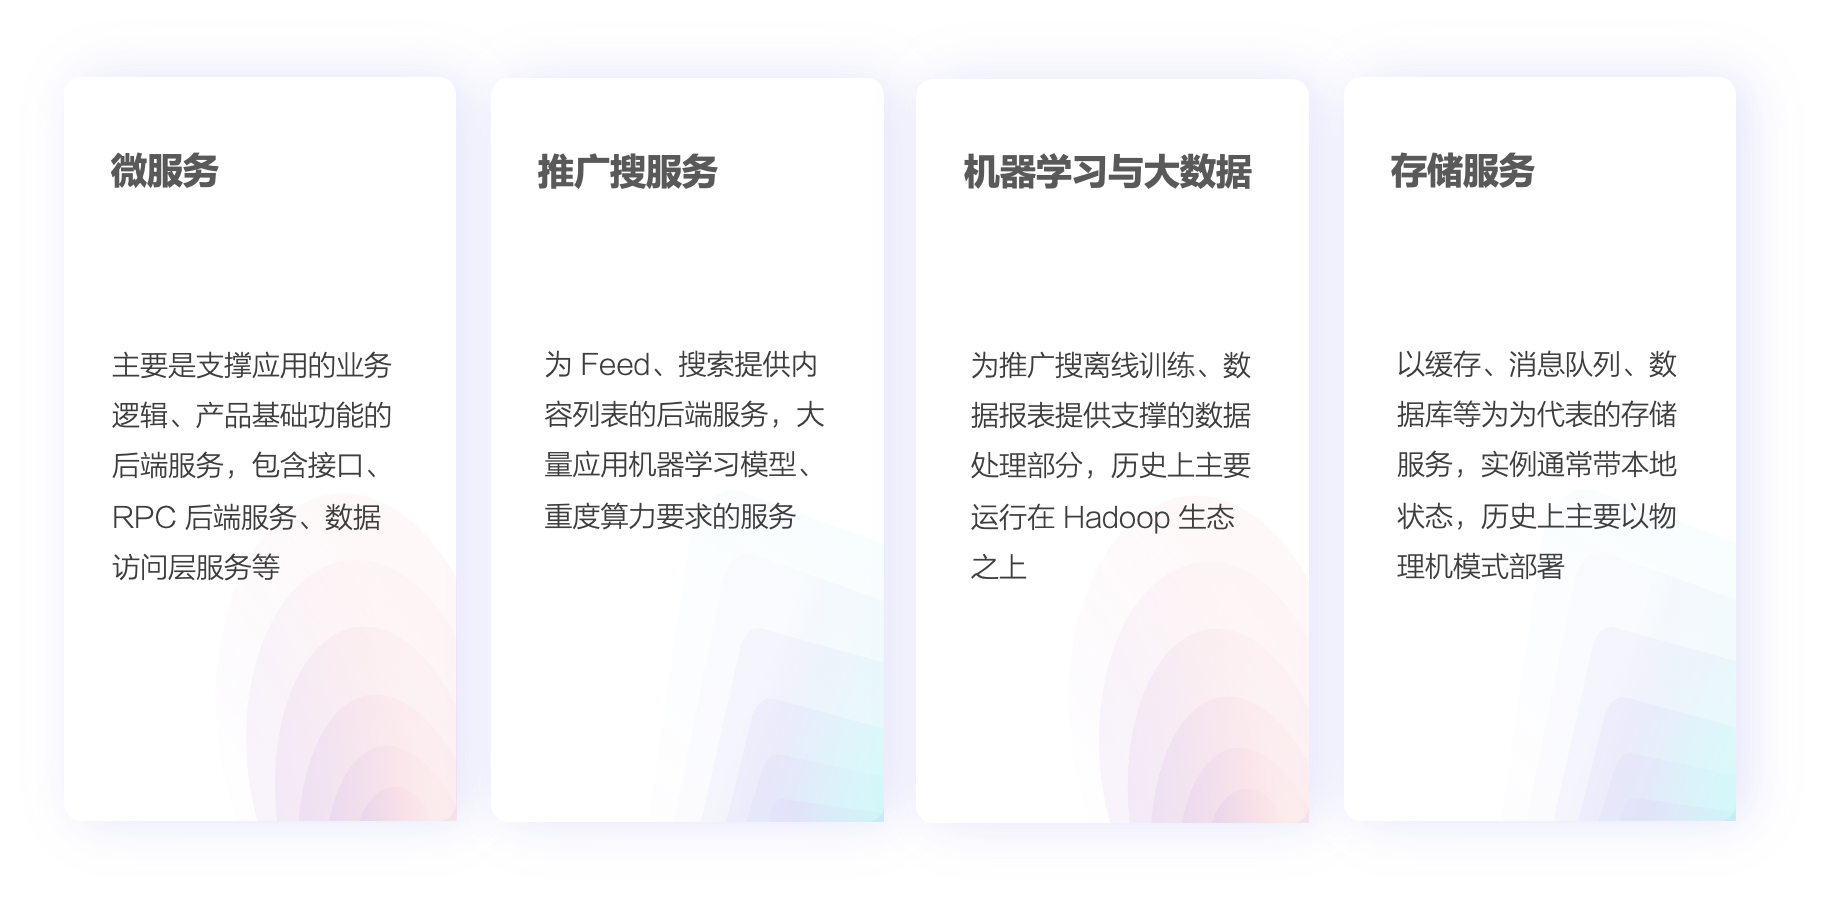
Katalyst 是字节跳动对多年大规模业务云原生化场景中资源管理能力的抽象和总结,我们期望通过 Katalyst 的开源直接或间接的帮助用户做好资源管理,实现降本增效。 当下互联网应用以天为单位,在线业务的资源使用情况往往会随着访问数量的波动而变化,具备明显的潮汐特性。为了确保业务稳定性,业务方往往会参考高峰时段的资源使用情况来申请资源,但这部分资源在低峰时段容易被闲置。 如果可以把这些闲置资源暂时出让给优先级低的服务,当在线业务需要使用的时候及时将资源归还,形成在离线服务混部,就可以达到削峰填谷,节约成本#的效果。 字节跳动云原生混部实践 字节跳动业务规模庞大、业务类型多元,其中涵盖了包括微服务、推广搜服务、机器学习与大数据、存储在内的多种业务类型。通常来说,不同业务类型对底层基础设施会有不同的资源管理诉求,传统的管理模式是基于业务线或者服务类型切分资源池,实现定制化需求。 但切分资源池的做法容易形成资源孤岛,无法实现资源层面的灵活拆借,不利于全局资源利用效率的提升和业务成本的优化,加重集群运维的负担。 此外,由于不同类型业务的 SLO 要求、资源潮汐特性存在互补,基础设施团队期望充分利用这些特性,通过调度和管控等手段去优化资源效率,实现资源池的融合统一,帮助业务团队获得更低的资源成本和更强的弹性能力。 为实现资源统一托管,字节跳动从 2016 年就开始基于 Kubernetes 构建统一的基础设施。 到现阶段,字节内部已经基本完成全量微服务、推广搜服务以及大部分机器学习与大数据业务的云原生化改造。在此过程中,基础架构团队持续探索统一资源池下的资源优化手段,并逐渐形成了 “弹性伸缩” 和 “常态混部” 互相配合的资源池混部方案。 弹性伸缩:实现机器级别、Numa 级别的资源分时复用,结合业务指标和系统指标,共同指导业务实例的横向和纵向扩缩容策略,最终使得离线类服务以更加低廉的价格购买更多闲时资源,在线类服务以更加高昂的价格购买更多峰时资源,通过资源市场化运营的方式实现综合效率的提升。 混合部署:提供资源超卖的能力,充分利用集群中 “已经售卖但未充分使用的资源” 部署更多低优业务,同时在系统侧完善 CPU、内存、磁盘、网络等多维度的资源隔离机制,并且智能预测、感知各类服务的负载变化,结合服务的分级机制,通过分钟级的指标感知和调控策略,保证服务的稳定性。 该方案在链路上基于 Kubernetes 和 Yarn 两套体系实现联合管控,在单机上同时运行 Kubernetes 和Yarn的管控组件,配合中心协调组件对两套系统可见的资源量进行分配。在联合管控系统之上,团队基于服务资源画像实现实时的资源预估,在保证各类服务 SLA 要求的前提下,实现更加灵活和动态的资源分配。 在该资源池混部方案落地实践的过程中,基础设施团队完成了资源并池可行性的验证,完成了混部基础能力的构建,并且在部分核心业务集群实现了整机天级利用率从 23% 到 60% 的提升。 Katalyst:从内部验证到开源 在经历内部抖音、今日头条等大规模潮汐流量业务验证后,字节跳动的云原生混部实践已日臻完善。 为了帮助更多人了解大规模资源混部实践的工作原理,方便更多开发者用户体验这种开箱即用、一键式部署的资源管控能力,研发团队决定回馈社区,采用 Kubernetes Native 的方式重构并增强了资源管控系统的实现,提炼出资源管控系统Katalyst并正式开源。 Katalyst 引申自单词 catalyst (音[ˈkætəlɪst]),本意为催化剂。首字母修改为 K,寓意该系统能够为所有运行在 Kubernetes 体系中的负载提供更加强劲的自动化资源管理能力。 什么是 Katalyst Katalyst 脱胎于字节跳动混部技术实践,同时也从资源、管控、调度等多个维度对资源管控能力进行了扩展和补充。它的主要特点包括: 完全孵化于超大规模混部实践,并在字节服务云原生化的进程中同步接管资源管控链路,真正实现内外技术体系的复用 搭载字节跳动内部的 Kubernetes 发行版 Enhanced Kubernetes同步开源,兼容性好,体验更多字节自研的核心功能 系统基于插件化模式构建,用户可以在 Katalyst Framework 之上自定制各类调度、管控、策略、数据等模块插件 提供一键式部署模版和详尽运维手册,降低外部用户的理解和接入使用成本 Katalyst 如何实现资源抽象 在资源层,Kubernetes 原生 QoS 分级无法满足大规模生产环境的要求,Katalyst 在此基础上进行了进一步的抽象。 Katalyst 以 CPU 为主维度,为应用提供了 system_core 系统核、dedicated_core 独占核、shared_core 共享核、reclaimed_core 回收核等多种不同等级,同时每种等级又辅助以多种 enhancement 机制(例如是否需要 numa node 绑定,是否需要网卡亲和或者带宽限制等),实现差异化的资源分配和管控策略。 通过抽象资源模型,Katalyst 为用户提供了统一的资源入口,用户根据实际业务需求,将业务服务映射到对应的 QoS 和售卖模式上准确地表达自身的需求,最终实现从统一的资源池获取资源而不用关注底层资源池细节。 Katalyst的架构设计 早期的混部架构存在几方面的问题:Kubernetes 和 Yarn 两套系统的联合管控虽然实现了在离线业务的常态混部,但是复杂的系统也使得维护成本变高。 另外这种架构也带来了额外的资源损耗,这些损耗一方面来自于联合管控模式下单机 Agent 组件资源占用,尤其在超大规模的集群中,这部分资源非常可观。此外,由于两套管控导致系统复杂度变高,系统交互过程中会产生多级资源漏斗,任何环节的异常都会导致资源丢失。 在 Katalyst 中,我们对整体的混部架构做了优化重构: 在管控层,我们将字节早期基于 Kubernetes 和 Yarn 两套体系的融合系统整合成一套基于 Kubernetes 的系统。 具体来说,我们在接入层同时保留了 Kubernetes 以及 Yarn 各自的 API 入口,底层系统的元数据管理和资源管控实现则统一收敛到基于 Kubernetes 的管控系统 Katalyst 上。 在调度层, Katalyst 在统一元数据的基础上实现了 “中心” 和 “单机” 互相协调的资源调度机制。 在单机调度侧:Katalyst 搭载 Enhanced Kubernetes 里的扩展模块 QoS Resource Manager (QRM) 能够实现可插件化的微拓扑亲和性分配,并通过自定 CRD 将微拓扑上报到中心打通调度流程;在服务运行过程中,Katalyst 会持续观察 Pod 运行时系统指标,集合业务 QoS 要求和业务指标反馈进行预估,决策出 Pod 在各个资源维度上的分配量,通过 QRM reconcile 机制实时下发到 CRI。上述过程中的资源预估模型和 QRM 实现,都可以通过插件化的方式定制,使得资源调控的策略更加匹配不同业务场景的诉求。 在中心调度侧:Katalyst 基于原生 Scheduler Framework 扩展了更加丰富的调度能力,在调度过程中同时考虑不同 QoS 业务在同一个集群中运行时资源层应该如何分配及协作,配合单机调度实现更加细粒度的调度语义要求;同时,中心调度还会结合业务容器运行时的实时数据和服务画像,在全集群范围内实现动态的 Rebalance 策略,降低集群空置率,提升业务稳定性。 通过收敛资源管控,Katalyst 有效减少了系统运行中的资源损耗。此外,在联合管控体系下,Katalyst 将旁路异步管控的实现切换成基于标准 CRI 接口的同步管控实现,避免因为各种异步引发的 race 或者冲突,从而引发服务性能抖动。 最后,在一套管控体系下,我们还能够充分享受 Kubernetes 面向 API 设计的优势,通过自定义 CRD 的方式去解耦内部系统,泛化管控策略,使得系统能够通过插件化的方式更加灵活地系统迭代,真正实现了内外同源。 RoadMap Katalyst 作为一个资源管理系统,在离线混部是其核心应用场景之一。除了抽象上述核心概念之外,我们还为 Katalyst 提供和规划了丰富的 QoS 能力: 精细化的资源出让策略:Katalyst 支持基于静态启发式、无监督算法、QoS Aware 的多种资源预估策略,更准确的计算和预测节点可出让资源量,进一步提高资源利用率。 多维度的资源隔离能力:基于 cgroup, rdt, iocost, tc 等能力,实现不同混部场景中对 cpu,内存,磁盘,网络等多种资源的有效隔离,保障在线业务的 QoS 不受影响。 多层级的负载驱逐策略:支持基于多种指标,多层级的驱逐策略,在保障在线业务 QoS 的同时也尽可能提高离线业务的 QoS。 除了混部场景,Katalyst 也提供一些增强的资源管理能力: 资源弹性管理:提供灵活可扩展的 HPA/VPA 资源弹性策略,帮助用户提高部署率和资源利用率。 微拓扑感知调度:感知节点上 CPU,内存,异构设备的微拓扑,基于更细粒度的微拓扑信息完成资源分配,满足高性能业务的 QoS 要求。 详细的功能规划请参考 roadmap。 虽然混部技术在字节内部已经经历了几次的技术迭代,但是一个通用、标准化的平台底座必然要经过各种场景的打磨,我们非常期待更多朋友加入到 Katalyst 开源社区中! 项目地址:github.com/kubewharf/katalyst-core

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册