首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

前端学习笔记(9)css grid网格布局

Grid 布局的属性分成两类。一类定义在容器上面,称为容器属性;另一类定义在项目上面,称为项目属性。 容器属性 1. display属性 指定一个容器采用网格布局 div { display: grid; } div { display: inline-grid; //设置为行内元素 } 注意,设为网格布局以后,容器子元素(项目)的float、display: inline-block、display: table-cell、vertical-align和column-*等设置都将失效。 2. grid-template-columns 属性,grid-template-rows 属性 grid-template-columns属性定义每一列的列宽,grid-template-rows属性定义每一行的行高。 .container { display: grid; grid-template-columns: 100px 100px 100px; grid-template-rows: 100px 100px 100px; } .container { display: grid; grid-template-columns: 33.33% 33.33% 33.33%; grid-template-rows: 33.33% 33.33% 33.33%; } .container { display: grid; grid-template-columns: repeat(3, 100px); grid-template-rows: repeat(3, 100px); } //grid-template-columns: repeat(2, 100px 20px 80px); repeat()接受两个参数,第一个参数是重复的次数(上例是3),第二个参数是所要重复的值。repeat()重复某种模式也是可以的。 auto-fill auto-fit关键字 .container { display: grid; grid-template-columns(auto-fill,100px); grid-template-columns(auto-fit,100px); } 有时,单元格的大小是固定的,但是容器的大小不确定。如果希望每一行(或每一列)容纳尽可能多的单元格,这时可以使用auto-fill关键字表示自动填充。假设容器可以容纳n个单元格,但是只有m个项目时(n>m),atuo-fill会生成n个单元格,auto-fit只会生成m个单元格。项目数多于容器单行可容纳单元格的情况下两个属性作用相同。 fr关键字 为了方便表示比例关系,网格布局提供了fr关键字(fraction 的缩写,意为"片段")。如果两列的宽度分别为1fr和2fr,就表示后者是前者的两倍。fr可以与绝对长度单位一起使用。 grid-template-columns: 1fr 2fr 3fr; grid-template-columns: 150px 1fr 2fr; //第一列的宽度为150像素,第二列的宽度是第三列的一半。 grid-template-columns: 1fr 1fr minmax(100px, 1fr); //表示列宽不小于100px,不大于1fr 网格线的名称 grid-template-columns属性和grid-template-rows属性里面,还可以使用方括号,指定每一根网格线的名字,方便以后的引用。上面代码指定网格布局为3行 x 3列,因此有4根垂直网格线和4根水平网格线。方括号里面依次是这八根线的名字。网格布局允许同一根线有多个名字,比如[fifth-line row-5]。.container { display: grid; grid-template-columns: [c1] 100px [c2] 100px [c3] auto [c4]; grid-template-rows: [r1] 100px [r2] 100px [r3] auto [r4];} 3.row-gap 属性,column-gap 属性,gap 属性 row-gap属性设置行与行的间隔(行间距),column-gap属性设置列与列的间隔(列间距)。gap属性是column-gap和row-gap的合并简写形式。 grid-gap: <grid-row-gap> <grid-column-gap>; grid-gap:20px 20px; 4.grid-template-areas 属性 网格布局允许指定"区域"(area),一个区域由单个或多个单元格组成。grid-template-areas属性用于定义区域。 .container { display: grid; grid-template-columns: 100px 100px 100px; grid-template-rows: 100px 100px 100px; grid-template-areas: 'a b c' 'd e f' 'g h i'; } //上面代码将9个单元格分成a、b、c三个区域。 grid-template-areas: 'a a a' 'b b b' 'c c c'; //如果某些区域不需要利用,则使用"点"(.)表示。 grid-template-areas: 'a . c' 'd . f' 'g . i'; 注意,区域的命名会影响到网格线。每个区域的起始网格线,会自动命名为区域名-start,终止网格线自动命名为区域名-end。比如,区域名为header,则起始位置的水平网格线和垂直网格线叫做header-start,终止位置的水平网格线和垂直网格线叫做header-end。 5.grid-auto-flow 默认值是row,即"先行后列"。也可以将它设成column,变成"先列后行"。 grid-auto-flow: column; grid-auto-flow属性除了设置成row和column,还可以设成row dense和column dense。这两个值主要用于,某些项目指定位置以后,剩下的项目怎么自动放置。 grid-auto-flow: row; grid-auto-flow: row dense; 6.justify-items 属性,align-items 属性,place-items 属性 justify-items属性设置单元格内容的水平位置(左中右),align-items属性设置单元格内容的垂直位置(上中下)。 .container { justify-items: start | end | center | stretch; align-items: start | end | center | stretch; } start:对齐单元格的起始边缘。 end:对齐单元格的结束边缘。 center:单元格内部居中。 stretch:拉伸,占满单元格的整个宽度(默认值)。 place-items属性是align-items属性和justify-items属性的合并简写形式。如果省略第二个值,则浏览器认为与第一个值相等。 place-items: <align-items> <justify-items>; 7.justify-content 属性,align-content 属性,place-content 属性 justify-content属性是整个内容区域在容器里面的水平位置(左中右),align-content属性是整个内容区域的垂直位置(上中下)。 .container { justify-content: start | end | center | stretch | space-around | space-between | space-evenly; align-content: start | end | center | stretch | space-around | space-between | space-evenly; } place-content属性是align-content属性和justify-content属性的合并简写形式。 place-content: <align-content> <justify-content> 8.grid-auto-columns 属性,grid-auto-rows 属性 有时候,一些项目的指定位置,在现有网格的外部。比如网格只有3列,但是某一个项目指定在第5行。这时,浏览器会自动生成多余的网格,以便放置项目。 grid-auto-columns属性和grid-auto-rows属性用来设置,浏览器自动创建的多余网格的列宽和行高。它们的写法与grid-template-columns和grid-template-rows完全相同。如果不指定这两个属性,浏览器完全根据单元格内容的大小,决定新增网格的列宽和行高。 grid-auto-rows: 200px; 9. grid-template和grid grid-template属性是grid-template-columns、grid-template-rows和grid-template-areas这三个属性的合并简写形式。 grid属性是grid-template-rows、grid-template-columns、grid-template-areas、 grid-auto-rows、grid-auto-columns、grid-auto-flow这六个属性的合并简写形式。 容器属性 1.grid-column-start 属性,grid-column-end 属性,grid-row-start 属性,grid-row-end 属性 用于指定项目位置 grid-column-start属性:左边框所在的垂直网格线 grid-column-end属性:右边框所在的垂直网格线 grid-row-start属性:上边框所在的水平网格线 grid-row-end属性:下边框所在的水平网格线 .item-1 { grid-column-start: 2; grid-column-end: 4; } .item-1 { grid-column-start: 1; grid-column-end: 3; grid-row-start: 2; grid-row-end: 4; } 这四个属性的值,除了指定为第几个网格线,还可以指定为网格线的名字。 .item-1 { grid-column-start: header-start; grid-column-end: header-end; } 这四个属性的值还可以使用span关键字,表示"跨越",即左右边框(上下边框)之间跨越多少个网格。 .item-1 { grid-column-start: span 2; // 效果等同于上面(start、end同时存在时优先使用start) // grid-column-end: span 2; } 使用这四个属性,如果产生了项目的重叠,则使用z-index属性指定项目的重叠顺序。 2. grid-column 属性,grid-row 属性 grid-column属性是grid-column-start和grid-column-end的合并简写形式,grid-row属性是grid-row-start属性和grid-row-end的合并简写形式。 .item-1 { grid-column: 1 / 3; grid-row: 1 / 2; } /* 等同于 */ .item-1 { grid-column-start: 1; grid-column-end: 3; grid-row-start: 1; grid-row-end: 2; } 3. grid-area 属性 grid-area属性指定项目放在哪一个区域。 .container{ grid-template-areas: 'a b c' 'd e f' 'g h i'; } .item-1{ grid-area: e; } grid-area与grid-column、grid-row同时存在时后指定的生效。 .container{ grid-template-areas: 'a b c' 'd e f' 'g h i'; } .item-1{ grid-column: 1/2; grid-area: e; grid-row: 1/2; } grid-area属性还可用作grid-row-start、grid-column-start、grid-row-end、grid-column-end的合并简写形式,直接指定项目的位置。 .item { grid-area: <row-start> / <column-start> / <row-end> / <column-end>; } 4. justify-self 属性,align-self 属性,place-self 属性 参考 justify-items 属性,align-items 属性,place-items 属性,针对当前项目使用。
优秀的个人博客,低调大师

华为 MateBook 笔记本 Linux 版正式开售

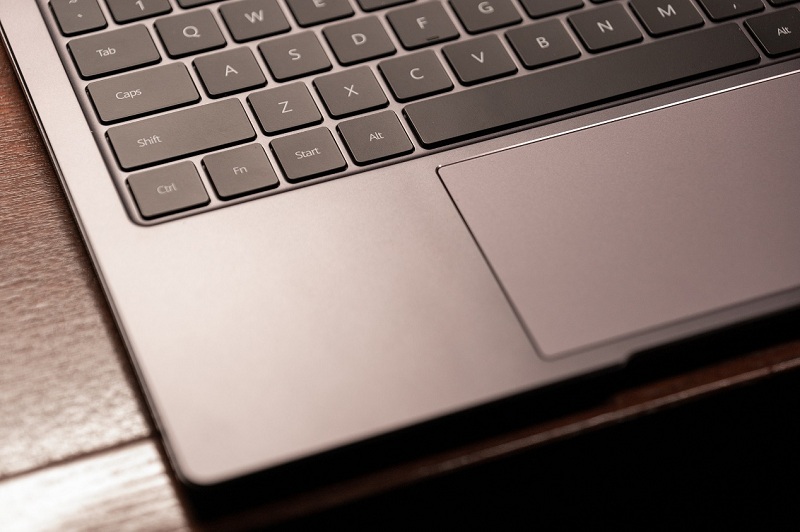
华为 MateBook 系列 Linux 版已于昨天正式开售,包括 MateBook13、MateBook14 和 MateBookX Pro 三款机型。售价方面: MateBook13 第三方 Linux 版 i5-8265U 8+512GB 独显售价 5399 元 MateBook14 第三方 Linux 版 i5-8265U 8+512GB 独显售价 5699 元 MateBookX Pro 2019 款第三方 Linux 版 i5-8265U 8+512GB 售价 8699 元 MateBookX Pro 2019 款第三方 Linux 版 i7-8565U 8+512GB 售价 9699 元 根据官方的介绍,Linux 系统是一种基于开源的、更开放的操作系统,通常适用开发者或对该系统比较了解的人群使用。和Windows版相比,Linux 版硬件方面无差别,但无法实现 Windows 版本下的一碰传、指纹开机等功能,如果自行安装其它系统和华为驱动之后,即可恢复上述功能。 另外,Linux 版预装的是 Deepin Linux 操作系统,硬件上和普通版没有任何差异,他们是完全相同的。只有价格相差 300 元。 ▲ 一些细节:键盘上的“Windows 徽标键”LOGO 被替换为"Start"

优秀的个人博客,低调大师

前端学习笔记(4) - JavaScript宏观与微观任务

宏观和微观任务 在 ES3 和更早的版本中,JavaScript 本身还没有异步执行代码的能力,这也就意味着,宿主环境传递给 JavaScript 引擎一段代码,引擎就把代码直接顺次执行了,这个任务也就是宿主发起的任务。 但是,在 ES5 之后,JavaScript 引入了 Promise,这样,不需要浏览器的安排,JavaScript 引擎本身也可以发起任务了。 由于我们这里主要讲 JavaScript 语言,那么采纳 JSC 引擎的术语,我们把宿主发起的任务称为宏观任务,把 JavaScript 引擎发起的任务称为微观任务。 宏观任务的队列就相当于事件循环。在宏观任务中,JavaScript 的 Promise 还会产生异步代码,JavaScript 必须保证这些异步代码在一个宏观任务中完成,因此,每个宏观任务中又包含了一个微观任务队列。 有了宏观任务和微观任务机制,我们就可以实现 JavaScript 引擎级和宿主级的任务了,例如:Promise 永远在队列尾部添加微观任务。setTimeout 等宿主 API,则会添加宏观任务。 如何分析异步执行的顺序 首先我们分析有多少个宏任务; 在每个宏任务中,分析有多少个微任务; 根据调用次序,确定宏任务中的微任务执行次序; 根据宏任务的触发规则和调用次序,确定宏任务的执行次序; 确定整个顺序。 setTimeout(()=>{console.log('c')},0) let x = new Promise((resolve,reject)=>{ console.log('a') resolve() }).then(res=>{ console.log('b') setTimeout(()=>{console.log('d')},0) })

优秀的个人博客,低调大师

Bytom Dapp 开发笔记(一):架构设计

简介 研究比原链已经一年了,用比原链做了几个dapp,而且最近还做了一个基于他们插件钱包的dapp,总结了一些遇到的坑,还有一些技术细节,接下来我会分成三章,从dapp设计架构上,到深入到源码分析去帮各位介绍一下比原链的dapp,还有分析比原官方最近发布的dapp的架构。 Dapp架构设计 这个是所有工作的基础,从看完比原链源码使用过比原的钱包后,我们就在思考比原链的dapp如何做,应该说是区块链应用应该如何做,我们之前尝试过用以太坊、比特币、超级账本去做dapp。先总结一下区块链dapp的痛点: 1)没办法保证上链前数据的真实性; 2)Tps很低; 3)接入成本高,需要自己搭建节点; Dapp架构方案 我现在总结了两个基于比原链的dapp架构方案:(如果有新版或者比较好的解决方案欢迎交流) Dapp肯定离不开复杂的业务,所以肯定会用到比原链的智能合约,以下方案都支持智能合约。 一、搭建区块链node 其实就是自己搭建个节点,然后应用直接调用节点提供的接口,完成了区块链的业务内容,比原链的源码整合了钱包功能,搭建也比较方便,几句代码就可以搭建完了,但是这样的业务视乎不大合理,因为这种后端整合比原源码钱包(以下称为“pc钱包”)的方式,相当于把所有的账户信息都托管给dapp,其实就是一个集中的官方的钱包,所有的账户都归官方管,这样会有中心化问题,最后会被怀疑用不用这个区块链是否有必要。 比原链自己有一套用户的模块,用户可以使用pc钱包、客户端钱包、手机钱包等,自己的用户信息可以自己备份,交易信息全部公开全部可以到区块链浏览器里面查到。这个方案只是主要实现了交易上链。 ps: 当然其实还是可以变通一下,就是说把PC钱包的所有接口在dapp实现一次,然后结合业务,但是比原的源码是会不断更新,还要随着它的版本更新,然后更新自己的应用,显然不实际。 说一下里面的坑: 1)账户BTM问题,这种方案每个dapp账户底层都要绑定一个钱包的用户,可以展现地址用户自己充值、直接在dapp里面充值、完成任务派送这些等,但是初始化账户拥有BTM需要有时间过程,正常应用这样的体验,早就让用户关闭了。 2)UTXO问题,比原链是基于utxo未花费输出交易模型,当自己的UTXO参与的交易没有确定是无法使用的,但是dapp这里绑定的用户,不能保证他有足够多的UTXO,除非自己转账的时候让他拆分,否则会类似单线程的操作,也是比较慢。 3)用户无法获取自己的私钥,在比原链PC钱包,是一套私钥,派生多个账号这样,就是说一个钱包就一套私钥,这个不能给用户。这样又违背了区块链的去中心化的问题。 总的来说,这个方案是单纯保证了dapp交易上链,但是各方面明显不足。 二、插件钱包(Byone)方案 这个方案是今年比原链推出的dapp新型的解决方案,有解决到方案一的痛点,这个也是我比较提倡的方案,现在比原链的智能合约功能已经非常强大,如果做复杂的dapp,用这个方式比较好。 简单来说就基于chrome开发了一个插件钱包,安装完插件,用户直接可以创建账户,使用账户的转账功能,里面有BTM的转账功能,账户的备份功能....是比较完整的一个钱包,这个钱包最大的作用就是包含了丰富的开发者api,可以支持开发者去实现智能合约交易。 我们重点说一下这个结构的技术原理,如图 1)Dapp前端,就是前端页面,插件钱包是基于chrome的,所以这里代表的就是新的页面集成了插件钱包(Byone)的api。 2)Byone,就是在chrome应用商店里面可以搜索到,点击安装就行,当前版本是2.0.0,非常好用。 3)Bufferserver服务器,官方提供demo里面这模块属于缓存服务器,其实这个应该改成Dapp后端,实际业务逻辑还有很多需要后端辅助,例如排行榜、非BTM比原资产交易等。(这块后面重点开一章去说清楚),现在理解称为后端就可以。 4)Blockcenter,其实就是官方提供的服务,直接提供接口可以触发比原链的交易功能,这样解决了上面的方案,避免需要自己搭建node节点,让dapp开发者更加容易接入。 总结 两套方案里面,方案一个人认为属于早期的方案,随着比原链的发展,我们可以适当了解有助于我们理解比原链的架构设计,而且在方案二里面,也一定要用到PC钱包,它可以协助我们开发者提高开发效率100倍,没有夸张,是100倍。 插件钱包现在还在推广还有完善当中,不过功能已经非常成熟了,所以Dapp开发者赶紧抓紧去使用来开发属于自己的dapp吧。 下一章我们重点说一下Dapp的开发流程。以及遇到的一些坑,还有粘贴源码。 作者:天才的饭桶

优秀的个人博客,低调大师

Python零基础学习笔记(三十九)—— time

#UTC(世界协调时间):格林尼治天文时间,世界标准时间,在中国来说是UTC+8(东八区) #DST(夏令时):是一种节约能源而人为规定的时间制度,在夏季调快一个小时 ''' 时间的表示形式: 1、时间戳 以整形或浮点型表示时间的一个以秒为单位的时间间隔 时间间隔的基础值是从1970年1月1号0点开始算起的 2、元组 一种Python的数据结构表示,这个元组有9个整形内容 year month day hours minutes seconds weekday Julia day fiag(1 【夏令时】或 -1【】 或 0【正常】) 3、格式化字符串 %y 两位数的年份表示(00-99) %Y 四位数的年份表示(000-9999) %m 月份(01-12) %d 月内中的一天(0-31) %H 24小时制小时数(0-23) %I 12小时制小时数(01-12) %M 分钟数(00=59) %S 秒(00-59) %a 本地简化星期名称 %A 本地完整星期名称 %b 本地简化的月份名称 %B 本地完整的月份名称 %c 本地相应的日期表示和时间表示 %j 年内的一天(001-366) %p 本地A.M.或P.M.的等价符 %U 一年中的星期数(00-53)星期天为星期的开始 %w 星期(0-6),星期天为星期的开始 %W 一年中的星期数(00-53)星期一为星期的开始 %x 本地相应的日期表示 %X 本地相应的时间表示 %Z 当前时区的名称 ''' import time #以浮点数形式返回当前时间的时间戳,不需要参数(UTC) c = time.time() print(c) #将时间戳转为UTC时间元组 t = time.gmtime(c) print(t) #将时间戳转为本地时间元组 b = time.localtime(c) print("b =", b) #将本地时间元组转换为时间戳 m = time.mktime(b) print(m) #将时间元组转换成字符串 s = time.asctime(b) print(s) #将时间戳转为字符串 h = time.ctime(c) print(h) #将时间元组转换为指定格式的字符串,参数2 为时间元祖,如果没有参数2, 默认转换为当前时间 q = time.strftime("%Y-%m-%d %H:%M:%S",b) print(q) #将时间字符串转换为时间元组 i = time.strptime(q, "%Y-%m-%d %H:%M:%S") print(i) #延迟一个时间,整形或浮点型 #time.sleep(1) #返回当前程序的cpu时间 #Unix系统始终返回全部的运行时间 #Windows从第二次开始,都是以第一个调用此函数的开始时间戳作为基数 j = time.clock() print(j) time.sleep(2) j1 =time.clock() print("%d" % j1) time.sleep(2) j2 =time.clock() print("%d" % j2)

优秀的个人博客,低调大师

Python零基础学习笔记(三十六)—— 递归

''' 递归调用:一个函数,调用了自身,成为递归调用 递归函数:一个会调用自身的函数 凡是循环能干的事,递归都能干 ''' ''' 方式: 1、写出临界条件 2、找这一次和上一次的关系 3、假设当前函数已经能用,调用自身计算行一次的结果,再求出本次的结果 ''' #输入一个数,求 1+2+3+……+ n 的和 def sum1(n): sum = 0 for x in range(1, n + 1): sum += x return sum res = sum1(10) print("res =", res) #递归方法 def sum2(n): if n == 1: return 1 else: return n + sum2(n - 1) res1 = sum2(10) print(res1)

优秀的个人博客,低调大师

Python零基础学习笔记(三十)—— 读文件

''' 过程: 1、打开文件 2、读文件内容 3、关闭文件 ''' ''' 1、打开文件 open(path, flag[, encoding]) path:要打开文件的路径 flag:打开方式 r(read) 以只读方式打开文件,文件的描述符放在文件的开头 rb 以为进制格式打开文件用于只读,文件的描述符放在文件的开头 r+ 打开一个文件用于读写,文件的描述符放在文件的开头 w 打开一个文件只用于写入,如果该文件已经存在会覆盖,不存在则创建新文件 wb 打开一个文件只用于写入二进制,如果该文件已经存在会覆盖,不存在则创建新文件 w+ 打开一个文件用于读写,如果该文件已经存在会覆盖,不存在则创建新文件 a 打开一个文件用于追加,如果文集那存在,文件描述符将会放到文件末尾 a+ encoding:编码格式 errors:错误处理 ''' #打开文件 path = r"E:\File.txt" #f = open(path, "r", encoding = "utf-8",errors = "ignore") f = open(path, "r") ''' 2、读文件内容 ''' #读文件的所有内容 str1 = f.read() print("str1 =", str1) #读文件中指定字符数 f.seek(0) #修改描述符的位置 str2 = f.read(5) print("str2 =", str2) #读取整行,包括"\n"字符 f.seek(0) str3 = f.readline() print("str3 =", str3) #读取所有行并返回列表 f.seek(0) str4 = f.readlines() print("str4 =", str4) #读取指定字符数 f.seek(0) str5 = f.readline(20) print("str5 =", str5) #修改描述符的位置 f.seek(0) ''' 3、关闭文件 ''' f.close() ''' 完整过程 ''' #第一种 try: f1 = open(path,"r") print(f1.read()) finally: if f1: f1.close() #更为简单的方法 with open(path, "r", encoding= "gbk", errors="ignore") as f2: print(f2.read())

优秀的个人博客,低调大师

Python零基础学习笔记(二十)—— tuple元组

#创建空元组 tuple1 = () print(tuple1) #创建带有元素的元组 tuple2 = (1, 2, 3, "jjking", True) #元素类型可以不同 print(tuple2) #定义只有1 个元素的元组 tuple3 = (1 ) #后面必须加逗号 print(tuple3) print(type(tuple3)) ''' 元组元素的访问 格式: 元组名[下标] 注意:下标不能越界 ''' tuple4 = (1, 2, 3, 4, 5) print(tuple4[3]) #获取最后一个元素 print(tuple4[-1]) #获取倒数第二个元素 print(tuple4[-2]) #修改元组,实际上修改的是元素里面的数据 tuple5 = (1, 2, 3, 4, [1, 2, 3], 5) print(tuple5) tuple5[4][2] = 4 print(tuple5) #删除元组 del tuple5 #print(tuple5) 因为被删除了所以打印不出来,会报错 #元组的操作 t1 = (1 ,2, 3, 4) t2 = (5, 6) t3 = t1 + t2 print(t3) #元组重复 print(t3 *3) #判断元素是否在元组中 print( 3 in t3) #元组的截取 #格式:元组名[ 开始下标:结束下标 ] #从开始下标开始截取,到结束下标之前,默认从头到尾 print(t3[1:4]) #二维元组:元素为一维元组的元组 t4 = ((1, 2, 3), (4, 5, 6), (7, 8, 9)) print(t4) print(t4[2][1]) '''元组的方法''' #len() 返回元组中元素的个数 print(len(t4)) #max() 返回元组中的最大值 print(max(t1)) #min() 返回元祖中的最小值 print(min(t1)) #列表转元组 list2 = [1, 2, 3, 4, 5] t5 = tuple(list2) print(t5) #元组转列表 list1 = list(t3) print(list1) ''' 一旦初始化元组里面的元素就不能修改了 和列表的区别就是不可变 这就提高了数据的安全性 所以说能用元组尽量用元组 ''' #元组的遍历 for i in (1, 2, 3, 4,5): print(i)

优秀的个人博客,低调大师

Python零基础学习笔记(十五)—— list(列表)

''' 本质;一种有序的集合 格式: 列表名 = [列表选项1, 列表选项2, ...列表选项n] ''' list1 = [23, 22, 24, 22, 25] print(list1) #元素数据可以不同 list2 = [1, 233, "name", "jjking", True] ''' 列表元素的访问 取值: 格式:列表名[下标] 注意:列表下标不要越界 ''' print(list1[2]) #列表操作: #列表组合 list3 = list1 + list2 print(list3) #列表的重复 print(list2 * 5) #判断元素是否在列表中 print(1 in list2) #列表截取 [2:3) print(list2[2:3]) #二维列表 list4 = [[123],[2,2,3],[1,2,3],[4,5,6,8]] print(list4[2][2]) #列表方法 list5 = [1,2,3,4,5,6] #appeng() 在列表末尾添加新的元素 list5.append(7) print(list5) list5.append([8,9]) print(list5) #extend() 在末尾一次性追加另一个列表中的多个值 list5.extend([1,2,3]) print(list5) #insert() 在下标处添加一个元素,元数据向后顺延 list5.insert(2,10) print(list5) #pop() 删除下标处的元素,默认为最后一个下标,并返回删除的数据 list5.pop() print(list5) list5.pop(2) print(list5) print(list5.pop(2)) #remove() 移除列表中的某个元素 list5.remove(5) list5.remove([8, 9]) print(list5) #clear() 清除列表中所有的数据 list6 = [1,2,3] list6.clear() print(list6) #index() 从列表中找出某个值的第一个匹配的索引值,可以加开始和结束的下标范围 print(list5.index(2)) print(list5.index(2, 4,8)) #len() 列表中的元素 print(len(list5)) #max() 获取列表中的最大值,只能是在一维列表,不然会报错 print(max(list5)) #min() 获取列表中的最小值,只能是在一维列表,不然会报错 print(min(list5)) #count() 某元素出现的次数 print(list5.count(2)) #浅拷贝 内存地址是一样的 lis7 = list5 print(id(list5)) print(id(lis7)) #copy() 深拷贝 内存的拷贝 内存的地址是不一样的 print(id(list5.copy())) #reverse() 倒序 list5.reverse() print(list5) #sort() 从小到大排序 list5.sort() print(list5) #元组转换成列表 list8 = list((1,2,3,4)) print(list8)

优秀的个人博客,低调大师

Python零基础学习笔记(十四)—— while语句

''' while 语句: 格式: while 表达式: 语句 逻辑:当程序遇到while语句的时候,首先计算【表达式】的值 如果【表达式】的值为假,那么结束整个while语句 如果表达式的值为真,则执行【语句】,循环调用,直到为假停止 ''' #从1打印到小于5的数 num = 1 while num < 5: print("num = %d"% num) num += 1 #计算1+2+3+...+100 sum = 0 num = 1 while num <= 100: sum += num num += 1 #print("sum = %d" % sum) print("sum = %d"% sum) #打印字符串里的每一个字符 str = "My name is jjking." index = 0 while index <= len(str): print(str[index]) index += 1 运行结果: num = 1 num = 2 num = 3 num = 4 sum = 5050 M y n a m e i s j j k i n g .

优秀的个人博客,低调大师

Python零基础学习笔记(八)—— 数学功能

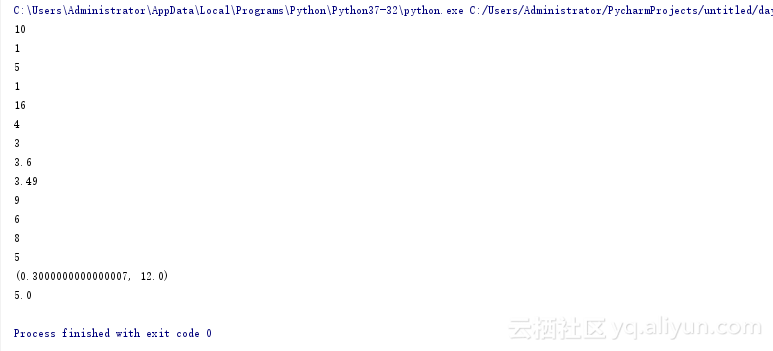
一定要导入math包,不然后面会报错 今日学习部分及执行结果如下图 import math # abs() 返回数的绝对值 a1 = -10 a2 = abs(a1) print(a2) #比较两个数的大小 a3 = 10 a4 = 9 print((a3>a4)-(a3<a4)) # max() 返回参数中的最大值 print(max(1,2,3,4,5)) # min() 返回参数中的最小值 print(min(1,2,3,4,5)) # pow() 求x的y次方 例如2^4 print(pow(2,4)) #round(x[, n]) x为数值,n为保留位数,n可有可无 # 四舍五入 print(round(3.576)) print(round(3.492)) #四舍五入保留位数 print(round(3.576, 1)) print(round(3.492, 2)) # math.ceil() 向上取整 print(math.ceil(8.1)) print(math.ceil(5.9)) # math.floor() 向下取整 print(math.floor(8.1)) print(math.floor(5.9)) # math.modf() 返回整数部分与小数部分 print(math.modf(12.3)) # math.sqrt() 开方 print(math.sqrt(25))

优秀的个人博客,低调大师

【NLP学习笔记】(二)gensim使用之Topics and Transformations

本文主要翻译自:https://radimrehurek.com/gensim/tut2.html 这个教程会向大家展示如何将代表文档的向量转换成另一种向量,做这件事的目的主要有两个: 发现语料中的隐藏结构,比如词与词之间的联系,然后用一种全新的方式、一种更能表现语义的方式(semantic way)来描述文档。 使文档的表示更加紧凑,这样可以提高效率和功效,因为新的表达方式消耗更少的资源,并且去除了噪音。 一、回顾 在之前的gensim基础使用中,我们介绍了如何将语料提取特征后转换为向量(基于词袋模型),上一章中的结果: # 清洗后的语料库,只有九句话,代表九个文档 [['human', 'interface', 'computer'], ['survey', 'user', 'computer', 'system', 'response', 'time'], ['eps', 'user', 'interface', 'system'], ['system', 'human', 'system', 'eps'], ['user', 'response', 'time'], ['trees'], ['graph', 'trees'], ['graph', 'minors', 'trees'], ['graph', 'minors', 'survey']] # 根据上面语料训练的词典,每个词都有一个id {'computer': 0, 'eps': 8, 'graph': 10, 'human': 1, 'interface': 2, 'minors': 11, 'response': 3, 'survey': 4, 'system': 5, 'time': 6, 'trees': 9, 'user': 7} # 根据词典基于词袋模型,训练上面语料的结果,(0,1.0)的意思是id为0的单词,即“computer”在第一篇文章中出现了1次。其它类似。 [[(0, 1.0), (1, 1.0), (2, 1.0)], [(0, 1.0), (3, 1.0), (4, 1.0), (5, 1.0), (6, 1.0), (7, 1.0)], [(2, 1.0), (5, 1.0), (7, 1.0), (8, 1.0)], [(1, 1.0), (5, 2.0), (8, 1.0)], [(3, 1.0), (6, 1.0), (7, 1.0)], [(9, 1.0)], [(9, 1.0), (10, 1.0)], [(9, 1.0), (10, 1.0), (11, 1.0)], [(4, 1.0), (10, 1.0), (11, 1.0)]] 二、加载上一章中结果(保存的字典和语料向量) from gensim import corpora, models, similarities import os if(os.path.exists('./gensim_out/deerwester.dict')): dictionary = corpora.Dictionary.load('./gensim_out/deerwester.dict') corpus = corpora.MmCorpus('./gensim_out/deerwester.mm') print("使用之前已经存储的字典和语料向量") else: print("请先通过上一章生成deerwester.dict和deerwester.mm") #pprint(dictionary.tokenz`2id) #pprint(corpus) 三、初始化一个转换模型(Creating a transformation) 转换模型是标准的python对象,通常需要传入一个语料库进行初始化。我们使用教程1中的旧语料库来初始化(训练)转换模型。也就是上面加载的corpus, 不同的转换模型一般需要不同的初始化参数; 在TfIdf的情况下,“训练”仅包括通过提供的语料库一次并计算其所有词频和逆文档频率。 训练其他模型,例如潜在语义分析或潜在狄利克雷分析,涉及更多,因此也会消耗更多时间。 tfidf = models.TfidfModel(corpus) #初始化一个模型 doc_bow = [(0, 1), (1, 1)] print(tfidf[doc_bow])#输出:[(0, 0.70710678), (1, 0.70710678)] 上面已经创建了tfidf模型,我们应该将其作为一个只读对象来看待,用它可以将旧的向量表示(上一节中的词袋模型)转换为新的向量表示(比如tf-idf权重)假设新文本为:“Human computer interaction”doc_bow是新文本经过上一章的清洗、分词、基于词袋模型转换后的结果,(0, 1)表示id为0,即“computer”。1表示“computer”在新文本中出现了1次;(1, 1)表示id为1,即“human”也出现了1次。tfidf模型将新文本从词袋向量模型([(0, 1), (1, 1)])转换为了词频-逆文档频率权重向量([(0, 0.70710678), (1, 0.70710678)]),即“computer”的权重为0 0.70710678,“human”的权重为0.70710678 四、序列化转换后的结果 调用model_name[corpus]仅在旧的语料库文档流周围创建一个包装器 ,实际转换在文档迭代期间即时完成。 我们无法在调用corpus_transformed = model [corpus]时转换整个语料库,因为这意味着将结果存储在内存中,这与gensim的内存独立的目标相矛盾。 如果您将多次迭代转换的corpus_transformed,并且转换成本很高,请先将生成的语料库序列化到磁盘然后再使用它。 #用tfidf转换语料库corpus corpus_tfidf = tfidf[corpus] #initialize an LSI transformation(初始化LSI模型) lsi = models.LsiModel(corpus_tfidf, id2word=dictionary, num_topics=2) #create a double wrapper over the original corpus: bow->tfidf->fold-in-lsicorpus_lsi = lsi[corpus_tfidf] lsi.print_topics(2) #输出:topic #0(1.594): -0.703*"trees" + -0.538*"graph" + -0.402*"minors" + -0.187*"survey" + -0.061*"system" + -0.060*"response" + -0.060*"time" + -0.058*"user" + -0.049*"computer" + -0.035*"interface" topic #1(1.476): -0.460*"system" + -0.373*"user" + -0.332*"eps" + -0.328*"interface" + -0.320*"response" + -0.320*"time" + -0.293*"computer" + -0.280*"human" + -0.171*"survey" + 0.161*"trees" 根据上面结果可以看出“trees”, “graph” and “minors都是相关联的词汇,并且对第一个主题的贡献度最高,第二个主题,更多的是关注其他的词汇 for doc in corpus_lsi: print(doc) #输出结果(可以看出前五个文档与第二个主题关联度更高): [(0, -0.066), (1, 0.520)] # "Human machine interface for lab abc computer applications" [(0, -0.197), (1, 0.761)] # "A survey of user opinion of computer system response time" [(0, -0.090), (1, 0.724)] # "The EPS user interface management system" [(0, -0.076), (1, 0.632)] # "System and human system engineering testing of EPS" [(0, -0.102), (1, 0.574)] # "Relation of user perceived response time to error measurement" [(0, -0.703), (1, -0.161)] # "The generation of random binary unordered trees" [(0, -0.877), (1, -0.168)] # "The intersection graph of paths in trees" [(0, -0.910), (1, -0.141)] # "Graph minors IV Widths of trees and well quasi ordering" [(0, -0.617), (1, 0.054)] # "Graph minors A survey" 保存模型与加载模型 lsi.save('./gensim_out/model.lsi') #保存 same for tfidf, lda, ... lsi = models.LsiModel.load('/tmp/model.lsi') #加载 gensim中可用的转换模型 1.Term Frequency * Inverse Document Frequency, Tf-Idf model = models.TfidfModel(corpus, normalize=True) 2.Latent Semantic Indexing, LSI (or sometimes LSA) model = models.LsiModel(tfidf_corpus, id2word=dictionary, num_topics=300) model.add_documents(another_tfidf_corpus) #now LSI has been trained on tfidf_corpus + another_tfidf_corpus lsi_vec = model[tfidf_vec] #convert some new document into the LSI space, without affecting the model ... model.add_documents(more_documents) #tfidf_corpus + another_tfidf_corpus + more_documents lsi_vec = model[tfidf_vec] ... 3.Random Projections, RP model = models.RpModel(tfidf_corpus, num_topics=500) 4.Latent Dirichlet Allocation, LDA model = models.LdaModel(corpus, id2word=dictionary, num_topics=100) 5.Hierarchical Dirichlet Process, HDP model = models.HdpModel(corpus, id2word=dictionary)

优秀的个人博客,低调大师

Dicom 学习笔记-DICOM C-Store 消息服务

引言 之前总体介绍了 DICOM 的消息服务,可以参考这篇博文,但是有关每个服务的详细信息没有讲解,本文就结合开源 DICOM 库 fo-dicom 详细介绍一下 C-Store 服务。 名词简介 在正式讲解前我们还需要弄明白以下几个名词 SCU:Service Class User,可以理解为客户端(用户端); SCP:Service Class Provider。可以理解为服务端; C-Store 消息服务 前文已经说明了 C-Store 服务用于一个 DIMSE-service-user 在同等的 DIMSE-service-user 上存储一个复合 SOP 实例,其实主要就是用来归档影像,在实际场景中,医院的设备(DR【普放】、CT【断层扫描】、MR【核磁】)做完检查后会产生影像文件(复合 SOP 实例),然后设备会通过 C-Store 服务将这些影像文件归档到 PACS 系统中。在这个过程中设备就相当于客户端,需要实现 C-Store SCU,PACS 系统相当于服务端,需要实现 C-Store SCP。 C-Store 流程如下: C-Store SCU 结合开源库 fo-dicom 我们可以很轻松的实现 C-Store SCU,fo-dicom 已经封装好了 C-Store Request,具体代码可以在 GitHub 上查看 DicomCStoreRequest.cs,我们只需要如下的代码就可以实现 C-Store SCU:这里需要引用命名空间【Dicom.Network】 using Dicom.Network; var client = new DicomClient(); client.NegotiateAsyncOps(); var request = new DicomCStoreRequest({DICOM file path}); request.OnResponseReceived += (req, response) => { Console.WriteLine("C-Store Response Received, Status: " + response.Status); }; client.AddRequest(request); client.Send({C-Store SCP IP}, {C-Store SCP Port}, false, {C-Store SCU AE Title}, {C-Store SCP AE Title}); DICOM file path 指待归档的 DICOM 文件路径; C-Store SCP IP 指 C-Store 服务端的 IP 地址或机器名; C-Store SCP Port 指 C-Store 服务端的端口; C-Store SCU AE Title 指 C-Store 客户端应用实体的名称; C-Store SCP AE Title 指 C-Store 服务端应用实体的名称; 基于以上代码就实现了一个简单的 C-Store 客户端,可用于归档单张影像,涉及到多张影像归档可在外层增加循环实现。 C-Store SCP C-Store SCP 可以通过派生 DicomService 服务类来实现 Dicom 服务的基本框架,然后实现 IDicomServiceProvider 和 IDicomCStoreProvider 接口来实现。具体代码可以参考这里。 最后我们将 C-Store SCP 的代码运行起来,然后使用上面 C-Store SCU 的代码来归档一张影像,然后我们会在 C-Store SCU 收到如下成功的消息【C-Store Response Received, Status: Success】,同时在 C-Store SCP 工程的【bin】目录下能找到一个【DICOM】文件夹,文件夹里面就是刚刚测试归档的影像。

优秀的个人博客,低调大师

ECS Ubuntu图形界面使用笔记1

apt-get update apt-get update时卡在 waiting for headers,等了好久,最后报出Hash Sum mismatch的错误 解决方法: rm /var/lib/apt/lists/* rm /var/lib/apt/lists/partial/* apt-get update apt-get install xinit 安装图形界面 atp-get install ubuntu-desktop 添加普通用户:hadoop sudo useradd -m hadoop -s /bin/bash sudo passwd hadoop sudo adduser hadoop sudo hadoop用户安装vim su hadoop sudo apt-get update sudo apt-get install vim hadoop登陆图形界面,安装汉语支持 firefox无法正常启动,尝试: sudo chown –R hadoop:hadoop ~/.mozilla/ sudo chown –R hadoop:hadoop ~/.cache/ 安装sougou拼音 sudo add-apt-repository ppa:fcitx-team/nightly sudo apt-get update sudo apt-get –f install sudo apt-get install fcitx sudo apt-get install fcitx-conffig-gtk sudo apt-get install fcitx-table-all sudo apt-get install im-switch (im-config) sudo dpkg –i souguopinyin.deb 安装VNC服务器并配置 apt-get install vnc4server apt-get install xfce4 apt-get install xfce4如果安装不上,就 apt-get update apt-get upgrade更新一下,一般是没有问题的 vi ~/.vnc/xstartup #!/bin/sh # Uncomment the following two lines for normal desktop: # unset SESSION_MANAGER # exec /etc/X11/xinit/xinitrc #xrdb $HOME/.Xresources #xsettroot -solid grey #startxfce4& [ -x /etc/vnc/xstartup ] && exec /etc/vnc/xstartup [ -r $HOME/.Xresources ] && xrdb $HOME/.Xresources xsetroot -solid grey vncconfig -iconic & x-terminal-emulator -geometry 80x24+10+10 -ls -title "$VNCDESKTOP Desktop" & #x-window-manager & sesion-manager & xfdesktop & xfce4-panel & xfce4-menu-plugin & xfsettingsd & xfconfd & xfwm4 & 1、关闭ubuntu的防火墙 ufw disable 开启防火墙 ufw enable 2、卸载了iptables apt-get remove iptables 3、关闭ubuntu中的防火墙的其余命令 iptables -P INPUT ACCEPT iptables -P FORWARD ACCEPT iptables -P OUTPUT ACCEPT iptables -F 在VNC中使用xfce桌面无法打开终端解决方案在 Settings Manager -> Preferred Applications 中重新设置默认终端(设置->首选应用程序 实用程序:终端模拟器->X终端)

优秀的个人博客,低调大师

Elastic Search 新手笔记(1)——入门篇

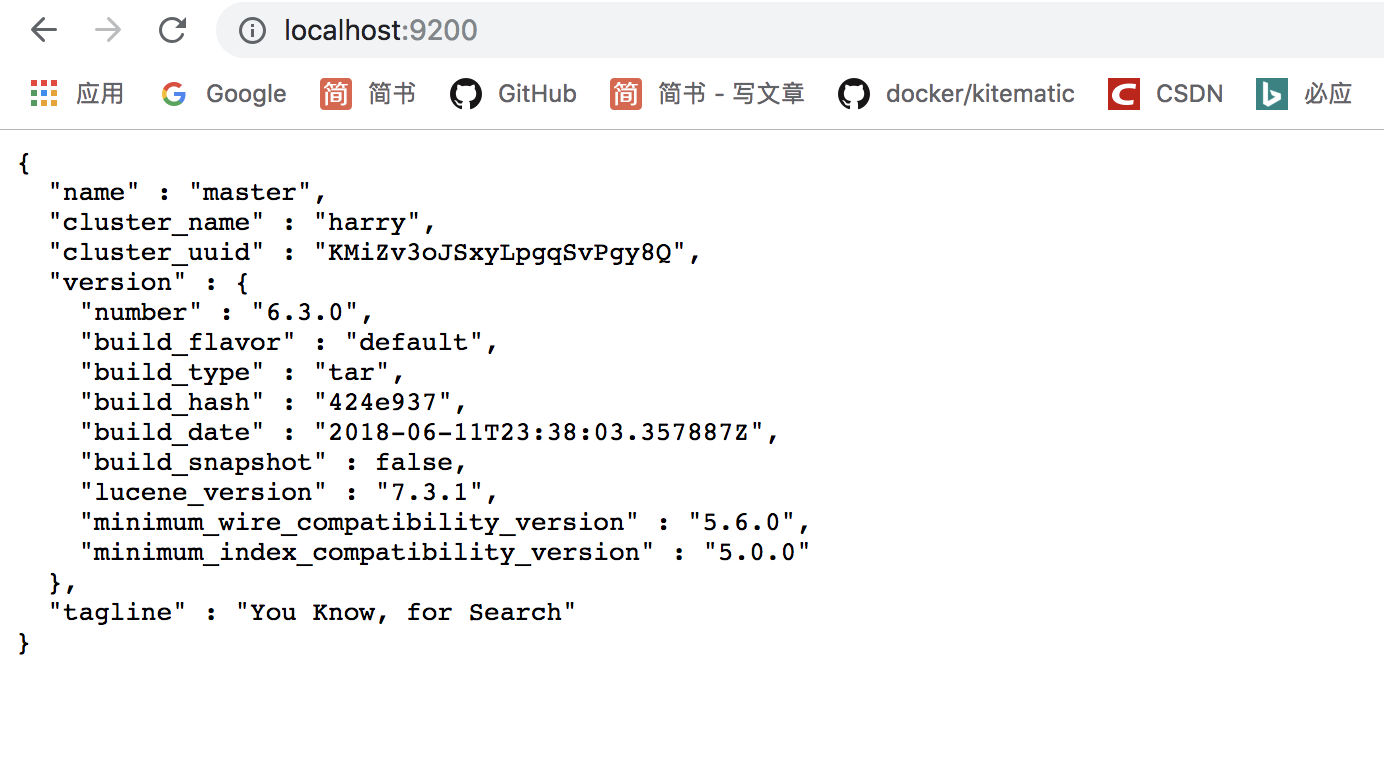
前言 之前写过一个关于Elastic Search的文章,当时的我还不会使用markdown,还不知道怎么好好把自己所想的,总结成一个有条理的文章,所以我就想写下了这一篇新文章,帮助自己消化所学的东西,也可以把知识分享给大家。 使用 版本 操作系统 MacOS ES版本 6.3.0 可视化插件 Head 安装 1.单实例安装 elasticSearch 的安装我觉得相对简单一些,我们可以在官网或者是别的途径,下载到它,官网的下载地址为https://www.elastic.co/downloads/elasticsearch,当前最新的版本为6.4.2。而我使用的版本是6.3.0,如果想要下载到原来版本的ES,可以进入以下网址进行下载https://www.elastic.co/downloads/past-releases。 下载好后,执行bin目录下的elasticsearch即可。 启动后,在浏览器输入http://localhost:9200/即可,效果如下: image.png 2.Head插件安装 Head插件是依托于node环境的,我们在使用插件之前需要先下载node.js。node.js下载好后,通过node -v 查看是否安装成功,然后就可以通过以下网址下载Head插件。Head 插件地址。下载好Head插件以及elasticsearch后,需要修改在elasticsearch 中的config的elasticsearch.yml中加上以下配置内容: http.cors.enabled: true http.cors.allow-original: "*" 保证了Es以及Head插件的连通性。 Head插件的启动 1.npm install phantomjs-prebuilt@2.1.15 --ignore-scripts(之所以不使用npm install 是因为这个包,一直都取不到,但是它也不怎么影响使用。) 2.npm install 3.npm run start 启动后,在浏览器输入http://localhost:9100,如果显示了相关内容即可。 3.分布式安装 分布式的安装和单实例安装大同小异,把下载下来的ElasticSearch复制两个副本,放在新创建的目录ES_slave(slave为随从奴隶的意思,在这里把我们之前安装好的当做一个master,然后其他的slave配合master形成一套分布式)中,如下图所示: image.png 这里是创建了两个,如果有需求,可以根据需求继续拓展。 然后把两个slave中的elasticsearch.yml文件进行修改,加入以下配置: #配置ElasticSearch的集群名称 cluster.name: harry #节点的名称(另一个节点名称可以使用slave2) node.name: slave1 #设置绑定的IP地址 network.host: 127.0.0.1 #设置对外服务的端口号,默认情况下为9200(这里只要使用没被使用的端口号即可) http.port: 8200 #设置是否打开多播发现节点,如果不进行配置,不会被主节点发现。 discovery.zen.ping.unicast.hosts: ["127.0.0.1"] 配置好后,启动slave的elasticsearch即可。 Tips:我启动的时候报了一个错误。 [2018-10-07T11:57:44,907][INFO ][o.e.d.z.ZenDiscovery ] [slave1] failed to send join request to master [{master}{dLNpAPsSTvCFgzow1nuM6g} {lZIG2Xm3Sx-4Y4eHU5x9CA}{127.0.0.1}{127.0.0.1:9300} {ml.machine_memory=8589934592, ml.max_open_jobs=20, xpack.installed=true, ml.enabled=true}], reason [RemoteTransportException[[master][127.0.0.1:9300] [internal:discovery/zen/join]]; nested: IllegalArgumentException[can't add node {slave1}{dLNpAPsSTvCFgzow1nuM6g}{4NUyj79cSxuaJL8BMtGejw}{127.0.0.1} {127.0.0.1:9301}{ml.machine_memory=8589934592, ml.max_open_jobs=20, xpack.installed=true, ml.enabled=true}, found existing node {master} {dLNpAPsSTvCFgzow1nuM6g}{lZIG2Xm3Sx-4Y4eHU5x9CA}{127.0.0.1} {127.0.0.1:9300}{ml.machine_memory=8589934592, xpack.installed=true, ml.max_open_jobs=20, ml.enabled=true} with the same id but is a different node instance]; ] 因为我是把master的Es复制过来,作为slave,但是data中还有原来的数据,所以报了这个错,只要把,Es中的data文件夹中的东西都删除就行。 我们现在把master 的ES启动,slave1的ES启动,slave2的ES启动,最后把Head也启动起来,然后浏览器输入http://localhost:9100,效果如下,证明成功。 image.png 基本概念 1.索引,类型,文档 Elastic Search 与关系型数据库对比 Elastic Search 关系型数据库 索引 数据库 类型 表 文档 行 这里的Elastic Search 泛指的是全文检索。一个索引中,包含多个类型,一个类型中包含着多个文档。 在刚接触的时候,我想过这样一个问题,在关系型数据库mysql的like进行模糊查询的效果,与Elastic Search这样的全文检索,效果几乎就是一样的,那为什么还要用全文检索呢? 原因我觉得一共有两个: 第一个是查询的速度特别快。在关系型数据库中,数据是结构化的,我们当要进行模糊查询的时候,会从想要查询的表的第一条数据开始比对,如果不是,继续下一条,如果再不是,继续去查,就这样一直查下去,直到查到了,自己想要的那条数据。而Elastic Search呢?它其实使用了倒排索引。大概意思其实是这样的:现在一个有三篇文章 id content 文章1 Java是世界上最好的 . 文章2 人生苦短,快学python 文章3 C++是世界上最难的 . 这也是存储在关系型数据库中的存储形式,查询的话,他会一行行的进行查询。而如果存在了Elastic Search 中会变成什么样子呢?在全文检索中存在这分词器这么个东西,分词器会把输入的句子自动的进行一定规律进行分割,例如过空格分割,下划线分割,等等。如果是中文,也有插件可以对其进行语义分割。分割后的效果如下所示(只是举例子,真实情况未必如此) 关键词 文章号 世界 1,3 人生苦短 2 . Java 1 . python 2 C++ 3 当我们输入世界,立刻就知道出现在了第一个,和第三个文章中。 第二个是因为我们在做全文检索的时候,根本用不到那么复杂的逻辑,我们用到基础的增删改查就行,使用了Elastic Search 之后,我们在也不用折腾数据库那么多的数据了。 2.分片与索引 每一个索引包含了多个分片,每个分片是一个lucene索引(lucene是Elasticsearch的底层引擎。)只需要将分片拷贝一份,就完成了分片的备份。 3.集群和节点 每一个集群都有一个集群的名字,一个集群包含多个节点。我们只需要知道集群的名称,便可以拓展集群中的节点。 4.elasticsearch.yml 我上面在启动head插件和设置分布式集群的时候,有修改过这个文件,但是这个文件还有别的可配置属性,我在这里说明一下,以备不时之需。 cluster.name: elasticsearch #设置集群名称,一个集群只可以有一个名称,ElasticSearch会自己去查找同一个网段下的所有节点 node.name: node-1 #设置节点名称 node.master: true #设置该节点是否是master节点,默认为true node.data: true #设置该节点,是否存储索引数据,默认为true index.number_of_shards: 5 #设置分片的数量,默认为5个,这个配置只在5.0版本之前好用 index.number_of_replicas: 1 #设置索引副本数量,默认为一个,同样也是只在5.0之前好用。 path.data: /path/to/data #设置索引数据的存储路径,默认在data文件夹下,可以设置多个文件存储路径,用逗号分隔。 path.logs: /path/to/logs #设置log日志的存储路径,默认情况下是在logs文件夹下。 bootstrap.mlockall: true #设置为true来锁住内存 network.host: 0.0.0.0 #设置绑定的Ip地址,默认为0.0.0.0 http.port: 9200 #设置对外服务的HTTP端口号 transport.tcp.port: 9300 #设置节点间交互的TCP端口号,也是给Java API使用的端口号,默认是9300。 transport.tcp.compress: false #是否压缩TCP传输的数据,默认为false http.cors.enabled:true #是否使用http提供对外的服务,默认为true http.max_content_length: 100mb #http传输内容的最大容量。 discovery.zen.minimum_master_nodes: 1 #发现master节点的数量,默认为1个。 discovery.zen.ping.timeout: 3s #发现其他节点,超时的时间。 discovery.zen.ping.multicast.enabled:true #是否打开多播发现节点。 discovery.zen.ping.unicast.hosts:["host1","host2:port","host3:[portX-portY]"] #设置集群master几点的初始列表。 script.engine.groovy.inline.update: on #开启groovy脚本的支持 script.inline: true #开始所有脚本语言行内执行所有的操作。 基本用法 Elastic Search 我们可以使用REST API与其进行交互,说白了就是使用url地址,通过不同的method(get,post,put,delete)传入不同的json数据。 head插件虽然很好,但是也并不是万能的,我比较习惯用Post man进行api交互。下面讲讲具体的操作。1.创建索引 url地址 method 用途 localhost:9200/索引名称 put 创建索引 在创建索引之前,我要先说两个概念分别是静态映射和动态映射。 动态映射是在创建索引之初,不添加索引的类型和文档中属性的格式,而是在添加文档的时候,格式会被自动转化。两种不同映射的设置,是由dynamic参数来决定的一共有三个可选值: true 动态映射自动添加字段 false 静态映射,不会自动添加字段 strict 静态映射,如果添加了新字段会报错 动态转换内容如下: JSON格式的数据 自动推测的字段类型 null 没有字段被添加 true or false boolean 浮点类型数字 float 数字 long JSON对象 object 数组 有数组中第一个非空值决定 string 有可能是date类型(开启日企检测),double,long,text,keyword 动态映射json体: { "settings":{ "number_of_shards":3, "number_of_replicas":1 } } number_of_shards是用来设置分片数量的 number_of_replicas是用来设置副本数量的 静态映射Json体: { "settings":{ "number_of_shards":3, "number_of_replicas":1 }, "mappings":{ "it": { "dynamic":"strict", "properties":{ "title":{ "type":"text" }, "content":{ "type":"text" }, "create_date":{ "type":"date" } } } } } 这里的it指的就是类型,在properties中添加自己的字段,并且指定属性的类型。 另外发送请求的content-type一定得是application/json,这个值得注意,成功后,会返回一个属性acknowledged 是true的,就说明创建成功,其他的如下图(Tips:几个更换 json体,这里的截图只是一个示范): image.png 查看head插件,如下图 image.png 我们可以看到这里创建了三个分片(细线为粗线的副本)。 2.插入文档 url地址 method 用途 localhost:9200/索引名称/类型名称/文档id put 创建文档(指定文档id) localhost:9200/索引名称/类型名称 post 创建文档(随机文档id) 3.修改文档 url地址 method 用途 localhost:9200/索引名称/类型名称/文档id/_update post 修改文档 json体: { "doc":{ "修改字段名称": "想要修改成的值" } } 4.删除文档 url地址 method 用途 localhost:9200/索引名称/类型名称/文档id delete 删除文档 5.查询文档 这里先介绍简单的查询,复杂的地方,会在后面说到。 url地址 method 用途 localhost:9200/索引名称/类型名称/文档id get 查询文档通过文档id localhost:9200/索引名称/类型名称/_search post 查询所有数据 简单查询数据结构体为 { "query":{ "match_all":{},(通过该属性查询所有数据) "match":{ "需要查询的字段名称":"查询的值" } }, "from": "从第几个开始"(可选), "size": "要查询多少个"(可选) , "sort": [ {"字段名称":{"order": "desc 或者是 asc"}}(自定义排序,默认通过score元字段进行排序) ] } 聚合查询结构体为: (可以定义多个聚合条件,放在不同的聚合名称中) { "aggs":{ "聚合名称1(自定义)": { "terms":{ "field": "通过该字段进行聚合" }, "status":{ "field": "通过该字段进行聚合"(status key可以计算这个聚合的相关参数) } }, "聚合名称2(自定义)": { "terms":{ "field": "通过该字段进行聚合" } } } } 后记 这篇文章是学习了慕课网上瓦力老师的教程并参考《从lucene到Elasticsearch全文检索实战》所写,课程地址为https://www.imooc.com/learn/889,在此感谢你们的分享,我会在后续的文章中继续总结elasticsearch的更多查询语法,以及Spring Boot 集成 Elastic Search 的相关知识。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册