首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

SpringMVC高能笔记|详解SpringMVC执行流程及原理

SpringMVC 是什么? SpringMVC 也叫 Spring web mvc。是 Spring 框架的一部分,是在Spring3.0 后发布的。 SpringMVC 优点 1. 基于MVC 架构 基于 MVC 架构,功能分工明确。解耦合, 2. 容易理解,上手快;使用简单。 就可以开发一个注解的 SpringMVC 项目,SpringMVC 也是轻量级的,jar 很小。不依赖的特定的接口和类。 3. 作为Spring 框架一部分,能够使用Spring 的IoC 和Aop。方便整合Strtus,MyBatis,Hiberate,JPA 等其他框架。 4. SpringMVC 强化注解的使用,在控制器,Service,Dao 都可以使用注解。方便灵活。使用@Controller 创建处理器对象,@Service 创建业务对象,@Autowired 或者@Resource 在控制器类中注入 Service, Service 类中注入Dao。 Spring MVC市场份额不断上升,势头已经盖过了的Struts2。分享给大家这套Springmvc视频教程,内容涵盖了SpringMVC基础以及与Spring框架集成(如IoC容器、AOP等)等高级内容。 通过学习可以让我们能非常简单的设计出干净的Web层和薄薄的Web层。掌握强大的约定大于配置的契约式编程支持。能简单的进行Web层的单元测试。非常容易与其它视图技术集成,如Velocity、FreeMarker等等,为后期的SSM项目奠定了基础。 在线观看:https://www.bilibili.com/video/BV1sk4y167pD 资料下载:http://www.bjpowernode.com/javavideo/222.html 第一个注解的 SpringMVC 程序 所谓 SpringMVC 的注解式开发是指,在代码中通过对类与方法的注解, 便可完成处理器在springmvc 容器的注册。注解式开发是重点。 项目:primary-annotation 完成功能:用户提交一个请求,服务端处理器在接收到这个请求后,给出一条欢迎信息,在响应页面中显示该信息。 新建maven web 项目 pom.xml 在创建好web 项目后,加入 Servlet 依赖,SpringMVC 依赖 依赖: 插件: 注册中央调度器 (1) 全限定性类名 该中央调度器为一个 Servlet,名称为 DispatcherServlet。中央调度器的全限定性类名在导入的Jar 文件spring-webmvc-5.2.5.RELEASE.jar 的第一个包org.springframework.web.servlet 下可找到。 (2) <load-on-startup/> 在<servlet/>中添加<load-on-startup/>的作用是,标记是否在Web 服务器(这里是 Tomcat)启动时会创建这个 Servlet 实例,即是否在Web 服务器启动时调用执行该 Servlet 的 init()方法,而不是在真正访问时才创建。 它的值必须是一个整数。 当值大于等于 0 时,表示容器在启动时就加载并初始化这个 servlet,数值越小,该Servlet 的优先级就越高,其被创建的也就越早; 当值小于 0 或者没有指定时,则表示该 Servlet 在真正被使用时才会去创建。 当值相同时,容器会自己选择创建顺序。 (3) <url-pattern/> 对于<url-pattern/>,可以写为 / ,建议写为*.do 的形式。 (4) 配置文件位置与名称 注册完毕后,可直接在服务器上发布运行。此时,访问浏览器页面,控制台均会抛出FileNotFoundException 异常。即默认要从项目根下的WEB-INF 目录下找名称为 Servlet 名称-servlet.xml 的配置文件。这里的“Servlet 名 称”指的是注册中央调度器<servlet-name/>标签中指定的 Servlet 的name 值。本例配置文件名为springmvc-servlet.xml。 而一般情况下,配置文件是放在类路径下,即resources 目录下。所以, 在注册中央调度器时,还需要为中央调度器设置查找 SpringMVC 配置文件路径,及文件名。 打开DispatcherServlet 的源码,其继承自FrameworkServlet,而该类中有一个属性 contextConfigLocation,用于设置 SpringMVC 配置文件的路径及文件名。该初始化参数的属性就来自于这里。 创建SpringMVC 配置文件 在工程的类路径即src 目录下创建 SpringMVC 的配置文件springmvc.xml。该文件名可以任意命名。 创建处理器 在类上与方法上添加相应注解即可。@Controller:表示当前类为处理器 @RequestMapping:表示当前方法为处理器方法。该方法要对 value 属性所指定的URI 进行处理与响应。被注解的方法的方法名可以随意。 若有多个请求路径均可匹配该处理器方法的执行,则@RequestMapping 的value 属性中可以写上一个数组。 ModelAndView 类中的addObject()方法用于向其 Model 中添加数据。Model 的底层为一个HashMap。 Model 中的数据存储在 request 作用域中,SringMVC 默认采用转发的方式跳转到视图,本次请求结束,模型中的数据被销毁。 声明组件扫描器 在springmvc.xml 中注册组件扫描器 定义目标页面 在webapp 目录下新建一个子目录jsp,在其中新建一个jsp 页面show.jsp。 修改视图解析器的注册 SpringMVC 框架为了避免对于请求资源路径与扩展名上的冗余,在视图解析器InternalResouceViewResolver 中引入了请求的前辍与后辍。而ModelAndView 中只需给出要跳转页面的文件名即可,对于具体的文件路径与文件扩展名,视图解析器会自动完成拼接。 把show.jsp 文件放到 /WEB-INF/jsp/路径中 修改处理器 使用逻辑视图名称,show 是逻辑视图名称。 使用SpringMVC 框架 web 请求处理顺序 SpringMVC 的 MVC 组件 SpringMVC 执行流程 流程图 执行流程简单分析 (1) 浏览器提交请求到中央调度器 (2) 中央调度器直接将请求转给处理器映射器。 (3) 处理器映射器会根据请求,找到处理该请求的处理器,并将其封装为处理器执行链后返回给中央调度器。 (4) 中央调度器根据处理器执行链中的处理器,找到能够执行该处理器的处理器适配器。 (5) 处理器适配器调用执行处理器。 (6) 处理器将处理结果及要跳转的视图封装到一个对象 ModelAndView 中,并将其返回给处理器适配器。 (7) 处理器适配器直接将结果返回给中央调度器。 (8) 中央调度器调用视图解析器,将 ModelAndView 中的视图名称封装为视图对象。 (9) 视图解析器将封装了的视图对象返回给中央调度器 (10) 中央调度器调用视图对象,让其自己进行渲染,即进行数据填充,形成响应对象。 (11) 中央调度器响应浏览器。

优秀的个人博客,低调大师

【React学习笔记】React的双向绑定(React State)

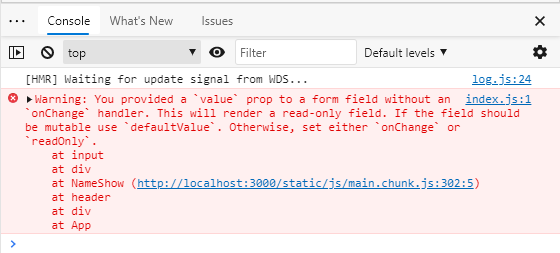
1、什么是双向绑定、为什么需要双向绑定? 本人是先入坑的vue,所以在开发时已经习惯了vue的自动双向绑定。 什么是双向绑定呢? 在没有前端框架之前的开发时光中,我们都是直接操作页面的DOM元素(element)的。将某个变量赋值到某个页面元素时都是一次性的操作,在此之后变量值的修改并不会影响页面元素的内容变化;而页面元素(比如input框)的内容变更以后,也不会使对应变量的值发生变化,我们需要通过document.getElementById()的方法获取到页面元素,然后再根据元素对象的value获取变化以后的值再手动处理。 在vue中,框架已经帮我们自动实现了双向绑定,任何一方(哪怕是页面上纯显示的)也会自动变化。(以下代码中,变量name的变化会直接反应到input框中,而input框中值得修改也会反向引起name变量的值变化。) <!-- Vue中一个最简单的双向绑定示例 --> <template> <div> <el-input v-model=“name” /> </div> </template> <script> export default { data() { return { name: "", } }, } </script> 而到了react,发现并没有双向绑定的功能,有点懊糟。 NameShow.js import React from 'react'; class NameShow extends React.Component { myName = "" // 定义myName变量 render() { return ( <div> {/*尝试将myName变量绑定到input框上*/} <input value={this.myName}/> {/*获取myName,并直接显示在页面上*/} <div>My Name Is {this.myName}</div> </div> ) } } export default NameShow 将以上组件引入APP中并添加到页面上启动,发现不仅无法双向绑定,甚至连修改input框的内容都没有任何反应,而且控制台有警告显示。大概的意思是value是只读的,值的修改必须通过onChange事件来修改。 所以添加一个onChange事件的handle方法handleChange以后再次启动。 NameShow.js import React from 'react'; class NameShow extends React.Component { myName = "" // 定义myName变量 handleChange = (event) => { // 此处需使用箭头函数,否则方法中的this将会识别为undefined console.log(event.target.value) this.myName = event.target.value } render() { return ( <div> {/*尝试将myName变量绑定到input框上*/} <input value={this.myName} onChange={this.handleChange}/> {/*获取myName,并直接显示在页面上*/} <div>My Name Is {this.myName}</div> </div> ) } } export default NameShow 在输入框中输入内容以后,发现控制台有反应,正常拿到了修改以后的值,但是输入框和下面显示的内容却依旧没有变化。 2、React不支持双向绑定?非也 react并不是不支持双向绑定,而是双向绑定需要我们自己来实现。这时候就是react中的一个重要概念登场了——React State。 在菜鸟教程中的解释是这样的:React 把组件看成是一个状态机(State Machines)。通过与用户的交互,实现不同状态,然后渲染 UI,让用户界面和数据保持一致。 现在回到上面那个例子,进行一下改造,由使用类成员变量myName改为使用state中的myName变量。 NameShow2.js import React from 'react'; class NameShow2 extends React.Component { constructor(props) { super(props); this.state = { // 注意1:此处需先对state进行初始化,不然编译会报错 myName: "" // 注意2:此处需要将变量在state中进行定义,否则会报警告 } } handleChange = (event) => { console.log(event.target.value) // this.state.myName = event.target.value // 注意3:此处直接赋值是无效的,一定要使用this的setState方法 this.setState( {myName: event.target.value} ) } render() { return ( <div> {/*尝试将myName变量绑定到input框上*/} <input value={this.state.myName} onChange={this.handleChange}/> {/*获取myName,并直接显示在页面上*/} <div>My Name Is {this.state.myName}</div> </div> ) } } export default NameShow2 将以上组件引入APP中并添加到页面上启动,并在input框填入内容,发现下面的显示也同步改变了,并且控制台也有输出。 到此,一个简单的react双向数据绑定的流程就完成了。 3、小结 在react中要实现数据的双向绑定,需要通过state来实现, 根据菜鸟解释,react将每个组件都定义为状态机,通过state来改变和控制组件的状态。 使用state之前需要先初始化,并且在state中定义所需要用到的变量, 这个类似于vue中使用前先要在data部分定义变量。 (一般使用时可以不用预先定义变量,只有在变量绑定对象为<input> <textarea> <select>时才需要,具体内容可以参考react官网相关解释。) 直接对state进行赋值是无效的,需要使用setState方法来赋值,这样才能触发状态的改变,从而达到值传递的效果。 另外补充一点,在上述两个例子中都将handleChange方法都以箭头函数的方式进行定义,这是由于js的闭包导致的。 如果想将handleChange定义为普通方法,可以在构造函数中将this对象绑定到handleChange方法 constructor(props) { super(props); this.state = { myName: "" } this.handleChange = this.handleChange.bind(this) // 将`this`对象绑定到`handleChange`方法 }

优秀的个人博客,低调大师

Spring学习笔记(五):JDBCTemplate+事务管理

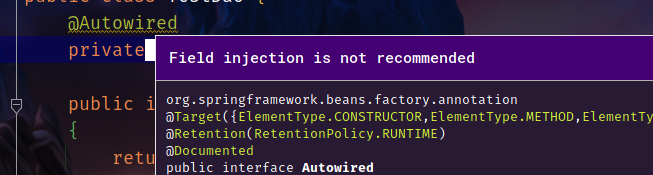
1 概述 Spring为开发者提供了JDBCTemplate,可以简化很多数据库操作相关的代码,本文主要介绍JDBCTemplate的使用以及事务管理功能。 2 JDBC Template 2.1 配置 配置的话主要配置以下几项: 数据源:org.springframework.jdbc.datasource.DriverManager.DataSource 数据库驱动:com.cj.mysql.jdbc.Driver,这里采用的是MySQL 8,注意MySQL 5.7以下的驱动名字不同,另外若是其他数据库请对应修改 数据库URL:jdbc:mysql://localhost:3306/test,MySQL默认的3306端口,数据库test 数据库用户名 数据库密码 JDBC模板:org.springframework.jdbc.core.jdbcTemplate 参考配置如下: <bean id="dataSource" class="org.springframework.jdbc.datasource.DriverManagerDataSource"> <property name="driverClassName" value="com.mysql.cj.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="test"/> <property name="password" value="test"/> </bean> <bean id="jdbcTemplate" class="org.springframework.jdbc.core.JdbcTemplate"> <property name="dataSource" ref="dataSource"/> </bean> <context:component-scan base-package="pers.dao"/> 2.2 常用方法 int update(String sql,Object args[]):增/删/改操作,使用args设置其中的参数,返回更新的行数 List<T> query(String sql,RowMapper<T> rowMapper,Object []args):查询操作,rowMapper将结果集映射到用户自定义的类中 2.3 示例 2.3.1 依赖 首先导入依赖: <dependency> <groupId>org.springframework</groupId> <artifactId>spring-jdbc</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.21</version> </dependency> MySQL的版本请根据个人需要更改,或使用其他数据库的驱动。 2.3.2 配置文件 完整配置文件如下: <?xml version="1.0" encoding="utf-8" ?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd"> <bean id="dataSource" class="org.springframework.jdbc.datasource.DriverManagerDataSource"> <property name="driverClassName" value="com.mysql.cj.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="test"/> <property name="password" value="test"/> </bean> <bean id="jdbcTemplate" class="org.springframework.jdbc.core.JdbcTemplate"> <property name="dataSource" ref="dataSource"/> </bean> <context:component-scan base-package="pers.dao"/> </beans> 2.3.3 实体类 public class MyUser { private Integer id; private String uname; private String usex; } 2.3.4 数据访问层 添加@Repository以及@RequiredArgsConstructor: @Repository @RequiredArgsConstructor(onConstructor = @__(@Autowired)) public class TestDao { private final JdbcTemplate template; public int update(String sql,Object[] args) { return template.update(sql,args); } public List<MyUser> query(String sql, Object[] args) { RowMapper<MyUser> mapper = new BeanPropertyRowMapper<>(MyUser.class); return template.query(sql,mapper,args); } } 因为直接使用@Autowired的话会提示不推荐: 所以利用了Lombok的注解@RequiredArgsConstructor,效果相当如下构造方法,只不过是简化了一点: @Autowired public TestDao(JdbcTemplate template) { this.template = template; } 2.3.5 测试 测试之前先建表: create table MyUser( id INT AUTO_INCREMENT PRIMARY KEY , uname varchar(20), usex varchar(20) ) 测试类: public class Main { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("applicationContext.xml"); TestDao dao = (TestDao)context.getBean("testDao"); String insertSql = "insert into MyUser(uname,usex) values(?,?)"; String[] param1 = {"chenhengfa1","男"}; String[] param2 = {"chenhengfa2","男"}; String[] param3 = {"chenhengfa3","男"}; String[] param4 = {"chenhengfa4","男"}; dao.update(insertSql,param1); dao.update(insertSql,param2); dao.update(insertSql,param3); dao.update(insertSql,param4); String selectSql = "select * from MyUser"; List<MyUser> list = dao.query(selectSql,null); for(MyUser mu:list) { System.out.println(mu); } } } 输出: 如果出现异常或插入不成功等其他情况,请检查SQL语句是否编写正确,包括表名以及字段名。 3 事务管理 Spring中的事务管理有两种方法: 编程式事务管理:代码中显式调用beginTransaction、commit、rollback等就是编程式事务管理 声明式事务管理:通过AOP实现,不需要通过编程方式管理事务,因此不需要再业务逻辑代码中掺杂事务处理的代码,开发更加简单,便于后期维护 下面先来看一下编程式事务管理的实现。 3.1 编程式事务管理 编程式事务管理的配置又有两种方法: 基于底层API 基于TransactionTemplate 需要的依赖如下: <dependency> <groupId>org.springframework</groupId> <artifactId>spring-tx</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-expression</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-aop</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.aspectj</groupId> <artifactId>aspectjweaver</artifactId> <version>1.9.6</version> <scope>runtime</scope> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-aspects</artifactId> <version>5.2.9.RELEASE</version> </dependency> 3.1.1 底层API实现 根据PlatformTransactionManager、TransactionDefinition、TransactionStatus几个核心接口,通过编程方式进行事务管理,首先配置事务管理器: <bean id="txManager" class="org.springframework.jdbc.datasource.DataSourceTransactionManager"> <property name="dataSource" ref="dataSource"/> </bean> 接着修改数据库访问类: @Repository @RequiredArgsConstructor(onConstructor = @__(@Autowired)) public class TestDao { private final JdbcTemplate template; private final DataSourceTransactionManager manager; public int update(String sql,Object[] args) { return template.update(sql,args); } public List<MyUser> query(String sql,Object[] args) { RowMapper<MyUser> mapper = new BeanPropertyRowMapper<>(MyUser.class); return template.query(sql,mapper,args); } public void testTransaction() { TransactionDefinition definition = new DefaultTransactionDefinition(); TransactionStatus status = manager.getTransaction(definition); String message = "执行成功,没有事务回滚"; try { String sql1 = "delete from MyUser"; String sql2 = "insert into MyUser(id,uname,usex) values(?,?,?)"; Object [] param2 = {1,"张三","男"}; template.update(sql1); template.update(sql2,param2); template.update(sql2,param2); manager.commit(status); } catch (Exception e) { e.printStackTrace(); manager.rollback(status); message = "主键重复,事务回滚"; } System.out.println(message); } } 3.1.1.1 事务定义 TransactionDefinition是事务定义,是一个接口: 主要定义了: 事务隔离级别 事务传播行为 事务超时时间 是否为只读事务 而DefaultTransactionDefinition就是上面属性的一些默认配置,比如: 也就是定义了: 传播行为为0:也就是常量PROPAGATION_REQUIREDE,表示如果当前存在一个事务,则加入当前事务,如果不存在任何事务,就创建一个新事务 隔离级别为-1:这个也是TransactionDefinition的默认参数,表示使用数据库的默认隔离级别,通常情况下为Read Committed 超时为-1:默认设置不超时,如需要设置超时请调用setTimeout方法,比如如果设置为了60,那么相当于如果操作时间超过了60s,而且后面还涉及到CRUD操作,那么会抛出超时异常并回滚,如果超时操作的后面没有涉及到CRUD操作,那么不会回滚 只读事务为false:默认为false,但是该变量不是表明“不能”进行修改等操作,而是一种暗示,如果不包含修改操作,那么JDBC驱动和数据库就有可能针对该事务进行一些特定的优化 3.1.1.2 具体执行流程 具体执行流程如下: 定义事务:实例类为DefaultTransactionDefinition 开启事务:通过getTransaction(TransactionDefinition)开启 执行业务方法 根据业务方法是否出现异常手动调用DataSourceTransaction的commit(TransactionStatus)进行提交 出现异常调用rollback(TransactionStatus)进行回滚 测试如下: 3.1.2 基于TransactionTemplate 步骤: 通过调用TransactionTemplate的execute实现 execute接受一个TransactionCallback接口参数 TransactionCallback定义了一个doInTransaction方法 通常以匿名内部类的方式实现TransactionCallback接口,在其中的doInTransaction编写业务逻辑代码 doInTransaction有一个TransactionStatus的参数,可以调用setRollbackOnly进行回滚 默认的回滚规则如下: 如果抛出未检查异常或者手动调用setRollbackOnly,则回滚 如果执行完成或抛出检查异常,则提交事务 示例如下,首先编写配置文件对Bean进行注入: <!--事务管理器--> <bean id="txManager" class="org.springframework.jdbc.datasource.DataSourceTransactionManager"> <property name="dataSource" ref="dataSource"/> </bean> <!--事务模板--> <bean id="transactionTemplate" class="org.springframework.transaction.support.TransactionTemplate"> <property name="transactionManager" ref="txManager"/> </bean> 其次修改数据访问类,添加一个测试方法: public void testTransactionTemplate() { System.out.println(transactionTemplate.execute((TransactionCallback<Object>) transactionStatus -> { String deleteSql = "delete from MyUser"; String insertSql = "insert into MyUser(id,uname,usex) values(?,?,?)"; Object[] parm = {1, "张三", "男"}; try { template.update(deleteSql); template.update(insertSql, parm); template.update(insertSql, parm); } catch (Exception e) { message = "主键重复,事务回滚"; e.printStackTrace(); } return message; })); } 大部分代码与第一个例子类似就不解释了,结果也是因为主键重复出现异常,造成事务回滚: 3.2 声明式事务管理 Spring声明式事务管理通过AOP实现,本质是在方法前后进行拦截,在目标方法开始之前创建或加入一个事务,执行目标方法完成之后根据执行情况提交或回滚事务。相比起编程式事务管理,声明式最大的优点就是不需要通过编程的方式管理事务,业务逻辑代码无需混杂事务代码,但是唯一不足的地方就是最细粒度只能作用到方法上,而不能做到代码块级别。 实现方式有如下两种: 基于XML实现 基于@Transactional实现 3.2.1 基于XML Spring提供了tx命令空间来配置事务: <tx:advice>:配置事务通知,一般需要指定id以及transaction-manager <tx:attributes>:配置多个<tx:method>指定执行事务的细节 3.2.1.1 配置文件 完整配置文件如下: <?xml version="1.0" encoding="utf-8" ?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xmlns:aop="http://www.springframework.org/schema/aop" xmlns:cache="http://www.springframework.org/schema/cache" xmlns:tx="http://www.springframework.org/schema/tx" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd http://www.springframework.org/schema/cache http://www.springframework.org/schema/cache/spring-cache.xsd http://www.springframework.org/schema/tx http://www.springframework.org/schema/tx/spring-tx.xsd http://www.springframework.org/schema/aop http://www.springframework.org/schema/aop/spring-aop.xsd" > <bean id="dataSource" class="org.springframework.jdbc.datasource.DriverManagerDataSource"> <property name="driverClassName" value="com.mysql.cj.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="test"/> <property name="password" value="test"/> </bean> <bean id="jdbcTemplate" class="org.springframework.jdbc.core.JdbcTemplate"> <property name="dataSource" ref="dataSource"/> </bean> <context:component-scan base-package="pers.dao"/> <!--事务管理器--> <bean id="txManager" class="org.springframework.jdbc.datasource.DataSourceTransactionManager"> <property name="dataSource" ref="dataSource"/> </bean> <bean id="transactionTemplate" class="org.springframework.transaction.support.TransactionTemplate"> <property name="transactionManager" ref="txManager"/> </bean> <!--声明式事务--> <tx:advice id="myAdvice" transaction-manager="txManager"> <tx:attributes> <!--任意方法--> <tx:method name="*" /> </tx:attributes> </tx:advice> <!--aop配置,具体可以看笔者之前的文章--> <aop:config> <!--定义切点,执行testXMLTranscation()时进行增强--> <aop:pointcut id="txPointCut" expression="execution(* pers.dao.TestDao.testXMLTransaction())"/> <!--切面--> <aop:advisor advice-ref="myAdvice" pointcut-ref="txPointCut"/> </aop:config> </beans> 3.2.1.2 测试 测试方法如下: public void testXMLTransaction() { String deleteSql = "delete from MyUser"; String saveSql = "insert into MyUser(id,uname,usex) values(?,?,?)"; Object [] parm = {1,"张三","男"}; template.update(deleteSql); template.update(saveSql,parm); template.update(saveSql,parm); } 运行结果: 可以看到提示主键重复了。 3.2.2 基于@Transactional @Transactional一般作用于类上,使得该类所有public方法都具有该类型的事务属性。下面创建一个示例。 3.2.2.1 配置文件 将上一个例子中的<aop:config>以及<tx:advice>注释掉,同时添加: <!--事务管理的注解驱动器--> <tx:annotation-driven transaction-manager="txManager"/> 3.2.2.2 测试 测试方法与上一个例子一致,结果也是如此: 4 参考源码 Java版: Github 码云 CODE.CHINA Kotlin版: Github 码云 CODE.CHINA

优秀的个人博客,低调大师

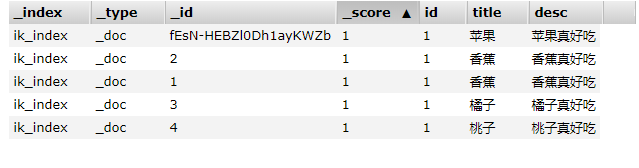
ES7学习笔记(十三)GEO位置搜索

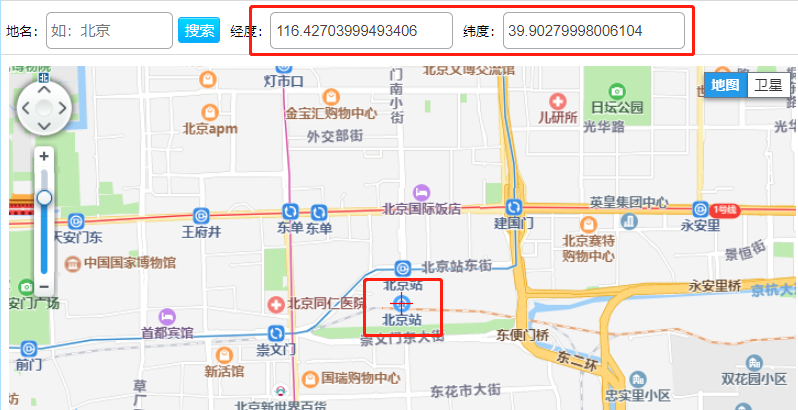
ES的基本内容介绍的已经差不多了,最后我们再来看看GEO位置搜索,现在大部分APP都有基于位置搜索的功能,比如:我们点外卖,可以按照离我们的距离进行排序,这样可以节省我们的配送费和送餐的时间;还有找工作时,也可以按照离自己家的距离进行排序,谁都想找个离家近的工作,对吧。这些功能都是基于GEO搜索实现的,目前支持GEO搜索功能的中间件有很多,像MySQL、Redis、ES等。我们看看在ES当中怎么实现GEO位置搜索。 GEO字段的创建 GEO类型的字段是不能使用动态映射自动生成的,我们需要在创建索引时指定字段的类型为geo_point,geo_point类型的字段存储的经纬度,我们看看经纬度是怎么定义的, 英文 简写 正数 负数 维度 latitude lat 北纬 南纬 经度 longitude lon或lng 东经 西经 经度的简写有2个,一般常用的是lon,lng则在第三方地图的开放平台中使用比较多。下面我们先创建一个带有geo_point类型字段的索引,如下: PUT /my_geo { "settings":{ "analysis":{ "analyzer":{ "default":{ "type":"ik_max_word" } } } }, "mappings":{ "dynamic_date_formats":[ "MM/dd/yyyy", "yyyy/MM/dd HH:mm:ss", "yyyy-MM-dd", "yyyy-MM-dd HH:mm:ss" ], "properties":{ "location":{ "type":"geo_point" } } } } 创建了一个my_geo索引,在索引中有一些基础的配置,默认IK分词器,动态映射的时间格式。重点是最后我们添加了一个字段location,它的类型是geo_point。 索引创建完了,我们添加两条数据吧,假设,路人甲在北京站,路人乙在朝阳公园。那么我们怎么“北京站”和“朝阳公园”的经纬度呢?我们在做项目时,前端都会接地图控件,经纬度的信息可以调用地图控件的API获取。在咱们的示例中,也不接地图控件了,太麻烦了,直接在网上找到“北京站”和“朝阳公园”的坐标吧。 我们查到“北京站”的坐标如下: 然后添加一条数据: POST /my_geo/_doc { "name":"路人甲", "location":{ "lat": 39.90279998006104, "lon": 116.42703999493406 } } 再查“朝阳公园”的坐标 再添加“路人乙”的信息 POST /my_geo/_doc { "name":"路人乙", "location":{ "lat": 39.93367367974064, "lon": 116.47845257733152 } } 我们再用elasticsearch-head插件看一下索引中的数据: GEO查询 “路人甲”和“路人乙”的信息都有了,但是没有location字段的信息,因为location是特性类型的字段,在这里是展示不出来的。我们搜索一下吧,看看怎么用geo搜索,假设“我”的位置在“工体”,我们先要查到“工体”的坐标, 然后再查询5km范围内都有谁,发送请求如下: POST /my_geo/_search { "query":{ "bool":{ "filter":{ "geo_distance":{ "distance":"5km", "location":{ "lat":39.93031708627304, "lon":116.4470385453491 } } } } } } 在查询的时候用的是filter查询,再filter查询里再使用geo_distance查询,我们定义距离distance为5km,再指定geo类型的字段location,当前的坐标为:39.93031708627304N,116.4470385453491E。查询一下,看看结果: { …… "hits":[ { "_index":"my_geo", "_type":"_doc", "_id":"AtgtXnIBOZNtuLQtIVdD", "_score":0, "_source":{ "name":"路人甲", "location":{ "lat": 39.90279998006104, "lon": 116.42703999493406 } } }, { "_index":"my_geo", "_type":"_doc", "_id":"ZdguXnIBOZNtuLQtMVfA", "_score":0, "_source":{ "name":"路人乙", "location":{ "lat": 39.93367367974064, "lon": 116.47845257733152 } } } ] } 看来,我们站在“工体”,“北京站”的路人甲和“朝阳公园”的路人乙都在5km的范围内。把范围缩短一点如何,改为3km看看,搜索的请求不变,只是把distance改为3km,看看结果吧, { …… "hits":[ { "_index":"my_geo", "_type":"_doc", "_id":"ZdguXnIBOZNtuLQtMVfA", "_score":0, "_source":{ "name":"路人乙", "location":{ "lat": 39.93367367974064, "lon": 116.47845257733152 } } } ] } 只有在“朝阳公园”的路人乙被搜索了出来。完全符合预期,我们再看看程序中怎么使用GEO搜索。 JAVA 代码 在定义实体类时,对应的GEO字段要使用特殊的类型,如下: @Setter@Getter public class MyGeo { private String name; private GeoPoint location; } location的类型是GeoPoint,添加数据的方法没有变化,转化成Json就可以了。再看看查询怎么用, public void searchGeo() throws IOException { SearchRequest searchRequest = new SearchRequest("my_geo"); SearchSourceBuilder ssb = new SearchSourceBuilder(); //工体的坐标 GeoPoint geoPoint = new GeoPoint(39.93367367974064d,116.47845257733152d); //geo距离查询 name=geo字段 QueryBuilder qb = QueryBuilders.geoDistanceQuery("location") //距离 3KM .distance(3d, DistanceUnit.KILOMETERS) //坐标工体 .point(geoPoint); ssb.query(qb); searchRequest.source(ssb); SearchResponse response = client.search(searchRequest, RequestOptions.DEFAULT); for (SearchHit hit : response.getHits().getHits()) { System.out.println(hit.getSourceAsString()); } } SearchRequest指定索引my_geo 创建工体的坐标点GeoPoint 创建geo距离查询,指定geo字段location,距离3km,坐标点工体 其他的地方没有变化 运行一下,看看结果, {"name":"路人乙","location":{"lat":39.93360786576342,"lon":116.47853840802}} 只有在“朝阳公园”的路人乙被查询了出来,符合预期。 距离排序 有的小伙伴可能会有这样的疑问,我不想按照距离去查询,只想把查询结果按照离“我”的距离排序,该怎么做呢?再看一下, public void searchGeoSort() throws IOException { SearchRequest searchRequest = new SearchRequest("my_geo"); SearchSourceBuilder ssb = new SearchSourceBuilder(); //工体的坐标 GeoPoint geoPoint = new GeoPoint(39.93367367974064d,116.47845257733152d); GeoDistanceSortBuilder sortBuilder = SortBuilders .geoDistanceSort("location", geoPoint) .order(SortOrder.ASC); ssb.sort(sortBuilder); searchRequest.source(ssb); SearchResponse response = client.search(searchRequest, RequestOptions.DEFAULT); for (SearchHit hit : response.getHits().getHits()) { System.out.println(hit.getSourceAsString()); } } 这次查询并没有设置查询条件,而是创建了一个geo距离排序,同样,先指定geo字段location,和当前的坐标工体,再设置排序是升序。运行一下,看看结果, {"name":"路人乙","location":{"lat":39.93360786576342,"lon":116.47853840802}} {"name":"路人甲","location":{"lat":39.902799980059335,"lon":116.42721165631102}} 离“工体”比较近的“路人乙”排在了第一个,也是符合预期的。有问题大家评论区留言吧~

优秀的个人博客,低调大师

ES[7.6.x]学习笔记(十)聚合查询

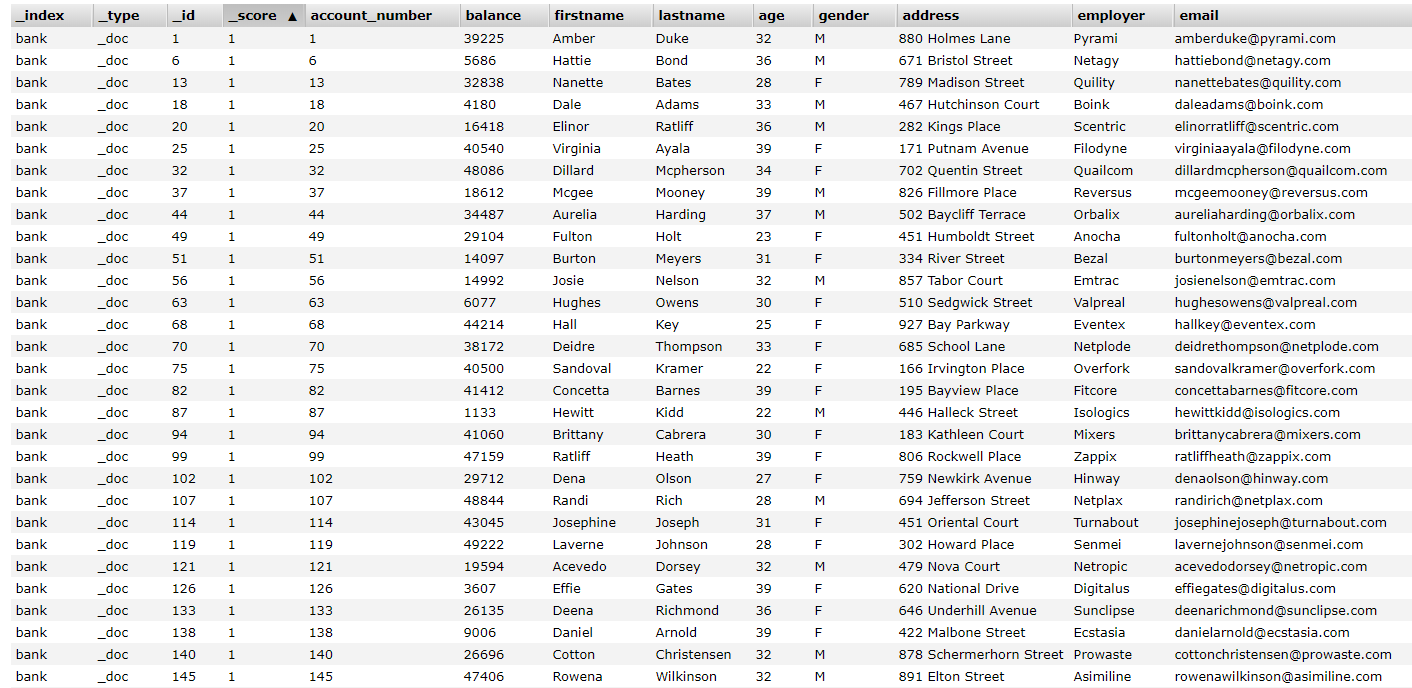
聚合查询,它是在搜索的结果上,提供的一些聚合数据信息的方法。比如:求和、最大值、平均数等。聚合查询的类型有很多种,每一种类型都有它自己的目的和输出。在ES中,也有很多种聚合查询,下面我们看看聚合查询的语法结构, "aggregations" : { "<aggregation_name>" : { "<aggregation_type>" : { <aggregation_body> } [,"meta" : { [<meta_data_body>] } ]? [,"aggregations" : { [<sub_aggregation>]+ } ]? } [,"<aggregation_name_2>" : { ... } ]* } aggregations实体包含了所有的聚合查询,如果是多个聚合查询可以用数组,如果只有一个聚合查询使用对象,aggregations也可以简写为aggs。aggregations里边的每一个聚合查询都有一个逻辑名称,这个名称是用户自定义的,在我们的语法结构中,对应的是<aggregation_name>。比如我们的聚合查询要计算平均价格,这时我们自定义的聚合查询的名字就可以叫做avg_price,这个名字要在聚合查询中保持唯一。 在自定义的聚合查询对象中,需要指定聚合查询的类型,这个类型字段往往是对象中的第一个字段,在上面的语法结构中,对应的是<aggregation_type>。在聚合查询的内部,还可以有子聚合查询,对应的是aggregations,但是只有Bucketing 类型的聚合查询才可以有子聚合查询。 metrics 聚合查询 metrics 我觉得在这里翻译成“指标”比较好,也不是太准确,我们还是用英文比较好。metrics 聚合查询的值都是从查询结果中的某一个字段(field)提炼出来的,下面我们就看看一些常用的metrics 聚合查询。我们有如下的一些索引数据,大家先看一下, 索引的名字叫做bank,一些关键的字段有account_number银行账号,balance账户余额,firstname和lastname等,大家可以直接看出它们代表的含义。假如我们想看看银行里所有人的平均余额是多少,那么查询的语句该怎么写呢? POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "avg_balance": { "avg": { "field": "balance" } } } } 在查询语句中,查询的条件匹配的是全部,在聚合查询中,我们自定义了一个avg_balance的聚合查询,它的类型是avg,求平均数,然后我们指定字段是balance,也就是我们要计算平均数的字段。我们执行一下,然后看看返回的结果, { "took": 11, "timed_out": false, "_shards": { "total": 1, "successful": 1, "skipped": 0, "failed": 0 }, "hits": …… "aggregations": { "avg_balance": { "value": 25714.837 } } } 在返回的结果中,我们看到在aggregations中,返回了我们自定义的聚合查询avg_balance,并且计算的平均值是25714.837。 如果我们要查询balance的最大、最小、平均、求和、数量等,可以使用stats查询,我们来看一下如何发送这个请求, POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "stats_balance": { "stats": { "field": "balance" } } } } 我们只需要把前面聚合查询的类型改为stats就可以了,我们看一下返回的结果, { "took": 20, "timed_out": false, "_shards": { "total": 1, "successful": 1, "skipped": 0, "failed": 0 }, "hits": …… "aggregations": { "stats_balance": { "count": 1000, "min": 1011, "max": 49989, "avg": 25714.837, "sum": 25714837 } } } 我们可以看到在返回的结果中,返回了5个字段,我们最常用的最大、最小、平均、求和、数量都包含在内,很方便是不是。 Bucket 聚合查询 Bucket 聚合不像metrics 那样基于某一个值去计算,每一个Bucket (桶)是按照我们定义的准则去判断数据是否会落入桶(bucket)中。一个单独的响应中,bucket(桶)的最大个数默认是10000,我们可以通过serarch.max_buckets去进行调整。 如果从定义来看,理解Bucket聚合查询还是比较难的,而且Bucket聚合查询的种类也有很多,给大家一一介绍不太可能,我们举两个实际中用的比较多的例子吧。在上面的metrics 聚合中,我们可以查询到数量(count),但是我们能不能分组呢?是不是和数据库中的group by联系起来了?对,Bucket 聚合查询就像是数据库中的group by,我们还用上面银行的索引,比如说我们要看各个年龄段的存款人数,那么查询语句我们该怎么写呢?这里就要使用Bucket 聚合中的Terms聚合查询,查询语句如下: POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "ages": { "terms": { "field": "age" } } } } 其中,ages是我们定义的聚合查询的名称,terms指定要分组的列,我们运行一下,看看结果, …… { "aggregations": { "ages": { "doc_count_error_upper_bound": 0, "sum_other_doc_count": 463, "buckets": [ { "key": 31, "doc_count": 61 } , { "key": 39, "doc_count": 60 } , { "key": 26, "doc_count": 59 } , { "key": 32, "doc_count": 52 } , { "key": 35, "doc_count": 52 } , { "key": 36, "doc_count": 52 } , { "key": 22, "doc_count": 51 } , { "key": 28, "doc_count": 51 } , { "key": 33, "doc_count": 50 } , { "key": 34, "doc_count": 49 } ] } } 我们可以看到在返回的结果中,每个年龄的数据都汇总出来了。假如我们要看每个年龄段的存款余额,该怎么办呢?这里就要用到子聚合查询了,在Bucket 聚合中,再加入子聚合查询了,我们看看怎么写, POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "ages": { "terms": { "field": "age" }, "aggs": { "sum_balance": { "sum": { "field": "balance" } } } } } } 我们在聚合类型terms的后面又加了子聚合查询,在子聚合查询中,又自定义了一个sum_balance的查询,它是一个metrics 聚合查询,要对字段balance进行求和。我们运行一下,看看结果。 "aggregations": { "ages": { "doc_count_error_upper_bound": 0, "sum_other_doc_count": 463, "buckets": [ { "key": 31, "doc_count": 61, "sum_balance": { "value": 1727088 } } , { "key": 39, "doc_count": 60, "sum_balance": { "value": 1516175 } } , { "key": 26, "doc_count": 59, "sum_balance": { "value": 1368494 } } , { "key": 32, "doc_count": 52, "sum_balance": { "value": 1245470 } } , { "key": 35, "doc_count": 52, "sum_balance": { "value": 1151108 } } , { "key": 36, "doc_count": 52, "sum_balance": { "value": 1153085 } } , { "key": 22, "doc_count": 51, "sum_balance": { "value": 1261285 } } , { "key": 28, "doc_count": 51, "sum_balance": { "value": 1441968 } } , { "key": 33, "doc_count": 50, "sum_balance": { "value": 1254697 } } , { "key": 34, "doc_count": 49, "sum_balance": { "value": 1313688 } } ] } } 我们看到返回结果中,增加了我们定义的sum_balance字段,它是balance余额的汇总。这个例子我们应该对bucket(桶)这个概念有了一个非常形象的认识了。还有一些其他的bucket聚合查询,这里就不给大家一一介绍了,比如:我们只想查某几个年龄段的余额汇总,就可以使用filters-aggregation。 好了,ES的一些基本的聚合查询就给大家介绍到这里了,如果要用到一些其他的聚合查询,可以参照ES的官方文档。

优秀的个人博客,低调大师

ES7学习笔记(六)分析器

在前面的章节中,我们给大家介绍了索引中的映射类型,也就是每一个字段都有一个类型,比如:long,text,date等。这和我们的数据库非常的相似,那么它的不同之处是什么呢?对了,就是全文索引,在ES当中,只有text类型的字段才会用的全文索引,那么这里就会引出ES中一个非常重要的概念,文本分析器(Text analysis)。 分析器使ES支持全文索引,搜索的结果是和你搜索的内容相关的,而不是你搜索内容的确切匹配。我们用ES官网中的例子给大家举例,假如你在搜索框中输入的内容是Quick fox jumps,你想得到的结果是A quick brown fox jumps over the lazy dog,或者结果中包含这样的词fast fox或foxes leap。 分析器之所以能够使搜索支持全文索引,都是因为有分词器(tokenization),它可以将一句话、一篇文章切分成不同的词语,每个词语都是独立的。假如你在ES索引中添加了一条记录the quick brown fox jumps,而用户搜索时输入的内容是quick fox,并没有完全匹配的内容,但是因为有了分词器,你索引的内容被切分成了不同的、独立的词,用户搜索的内容也会进行相应的切分,所以用户搜索的内容虽然没有完全匹配,但也能够搜索到想要的内容。 分析器除了要做分词,还要做归一化(Normalization)。分词器能够使搜索内容在每一个词上匹配,但这种匹配也只是在字面上进行的匹配。 比如你搜索Quick,但是不能匹配到quick,它们的大小写不同。 比如你搜索fox,但是不能匹配到foxes,它是复数形式。 比如你搜索jumps,不能匹配到leaps,虽然它们是同义词。 为了解决这些问题,分析器要把这些分词归一化到标准的格式。这样我们在搜索的时候就不用严格的匹配了,相似的词语我们也能够检索出来,上面的3种情况,我们也能够搜索出相应的结果。 分析器的组成 分析器,无论是内置的,还是自定义的,都是由3部分组成:字符过滤器(character filters)、分词器(tokenizers)、分词过滤器(token filters)。 字符过滤器 字符过滤器接收最原始的文档,并且可以改变其内容,比如:可以把中文的一二三四五六七八九,变成阿拉伯数字123456789。它还可以过滤html标签,并对其进行转义。还可以通过正则表达式,把匹配到的内容转化成其他的内容。一个分析器可以有多个字符过滤器,也可以没有字符过滤器。 分词器 一个分析器只能有一个确定的分词器,它可以把一句话分成若干个词,比如:空格分词器。当你输入一句话Quick brown fox!,它将被切分成[Quick, brown, fox!]。 分词过滤器 分词过滤器接收分词并且可以改变分词,比如:小写分词过滤器,它将接收到的分词全部转换成小写。助词过滤器,它将删除掉一些公共的助词,比如英语里的 the,is,are等,中文里的的,得等。同义词过滤器,它将在你的分词中,添加相应的同义词。一个分析器可以有多个分词过滤器,它们将按顺序执行。 我们在建立索引和搜索时,都会用的分析器。 配置文本分析器 前面我们讲了分析器的基本概念,也了解了全文搜索的基本步骤。下面我们看一下如何配置文本分析器,ES默认给我们配置的分析器是标准分析器。如果标准的分析器不适合你,你可以指定其他的分析器,或者自定义一个分析器。 ES有分析器的api,我们指定分析器和文本内容,就可以得到分词的结果。比如: POST _analyze { "analyzer": "whitespace", "text": "The quick brown fox." } 返回的结果如下: { "tokens": [ { "token": "The", "start_offset": 0, "end_offset": 3, "type": "word", "position": 0 }, { "token": "quick", "start_offset": 4, "end_offset": 9, "type": "word", "position": 1 }, { "token": "brown", "start_offset": 10, "end_offset": 15, "type": "word", "position": 2 }, { "token": "fox.", "start_offset": 16, "end_offset": 20, "type": "word", "position": 3 } ] } 我们指定的分析器是空格分析器,输入的文本内容是The quick brown fox.,返回结果是用空格切分的四个词。我们也可以测试分析器的组合,比如: POST _analyze { "tokenizer": "standard", "filter": [ "lowercase", "asciifolding" ], "text": "Is this déja vu?" } 我们指定了标准的分词器,小写过滤器和asciifolding过滤器。输入的内容是Is this déja vu?,我们执行一下,得到如下的结果: { "tokens": [ { "token": "is", "start_offset": 0, "end_offset": 2, "type": "<ALPHANUM>", "position": 0 }, { "token": "this", "start_offset": 3, "end_offset": 7, "type": "<ALPHANUM>", "position": 1 }, { "token": "deja", "start_offset": 8, "end_offset": 12, "type": "<ALPHANUM>", "position": 2 }, { "token": "vu", "start_offset": 13, "end_offset": 15, "type": "<ALPHANUM>", "position": 3 } ] } 我们可以看到结果中,is变成了小写,déja变成了deja,最后的?也过滤掉了。 为指定的字段配置分析器 我们在创建映射时,可以为每一个text类型的字段指定分析器,例如: PUT my_index { "mappings": { "properties": { "title": { "type": "text", "analyzer": "whitespace" } } } } 我们在my_index索引中,创建了title字段,它的类型是text,它的分析器是whitespace空格分析器。 为索引指定默认的分析器 如果我们觉得为每一个字段指定分析器过于麻烦,我们还可以为索引指定一个默认的分词器,如下: PUT my_index { "settings": { "analysis": { "analyzer": { "default": { "type": "whitespace" } } } } } 我们为my_index索引指定了默认的分析器whitespace。这样我们在创建text类型的字段时,就不用为其指定分析器了。 这一节给大家介绍了分析器,我们可以看到例子中都是使用的英文分析器,下一节我们一起看一下强大的中文分析器。

优秀的个人博客,低调大师

ES[7.6.x]学习笔记(五)动态映射

通常情况下,我们使用ES建立索引的步骤是,先创建索引,然后定义索引中的字段以及映射的类型,然后再向索引中导入数据。而动态映射是ES中一个非常重要的概念,你可以直接向文档中导入一条数据,与此同时,索引、字段、字段类型都会自动创建,无需你做其他的操作。这就是动态映射的神奇之处。 动态字段映射 ES的动态映射默认是开启的,动态映射的默认规则如下: JSON的数据类型 ES中的数据类型 null 不会映射字段 true 或 false boolean类型 浮点型数字 float 整型数字 long JSON对象 Object 数组 第一个非空值得类型 String 1、如果满足日期类型的格式,映射为日期类型 2、如果满足数字型的格式,映射为long或者float 3、如果就是字符串,会映射为一个text类型和一个keyword类型 接下来我们看看动态映射的一个例子,我们直接向dynamic-index索引中存放一条数据,注意,dynamic-index这个索引我们没有创建过,直接存放数据,索引会自动创建。接下来,我们看一下具体的请求: PUT /dynamic-index/_doc/1 { "my_null": null, "my_boolean": false, "my_float": 1.56, "my_long": 3, "my_object": { "my_first": "first value", "my_second": "second_value" }, "my_array": [1,2,3], "my_date_1": "2020-05-01", "my_date_2": "2020/05/01 12:03:03", "my_date_3": "05/01/2020", "my_string_long": "1", "my_string_float": "4.6", "my_string": "中华人民共和国" } 请求执行成功以后,我们先看一下索引的类型: GET /dynamic-index/_mapping 返回的结果如下: { "dynamic-index": { "mappings": { "properties": { "my_array": { "type": "long" }, "my_boolean": { "type": "boolean" }, "my_date_1": { "type": "date" }, "my_date_2": { "type": "date", "format": "yyyy/MM/dd HH:mm:ss||yyyy/MM/dd||epoch_millis" }, "my_date_3": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_float": { "type": "float" }, "my_long": { "type": "long" }, "my_object": { "properties": { "my_first": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_second": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } } } }, "my_string": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_string_float": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_string_long": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } } } } } } 返回的结果比较长,我们把每一个字段都看一下,看看动态映射的字段是否达到了我们的预期: 字段 映射结果 是否达到预期 原因 my_null 没有映射 是 null值不映射 my_boolean boolean 是 my_float float 是 my_long long 是 my_object object 是 my_object里自动生成了两个字段的映射 my_array long 是 数组中的数字是long型 my_date_1 date 是 my_date_2 date 是 my_date_3 text 否 没有指定这种日期格式,所以映射为text my_string_long text 否 数字探测默认关闭,没有打开 my_string_float text 否 数字探测默认关闭,没有打开 my_string text 是 普通字符串,映射为text 下面我们把数字探测打开,执行如下请求: PUT /dynamic-index { "mappings": { "numeric_detection": true } } 由于我们的索引dynamic-index中,存在了映射关系,再进行设置是会报错的,所以我们要将索引删除,执行如下请求: DELETE /dynamic-index 索引删除成功后,再执行前面的设置,执行成功,数字探测已经打开。然后再添加一种日期格式MM/dd/yyyy,请求如下: PUT /dynamic-index { "mappings": { "dynamic_date_formats": ["MM/dd/yyyy"] } } 执行报错,错误信息和之前一样,看来日期的设置要和数字探测一起才行,我们再将索引删除,然后再发送请求,两个设置一起: PUT /dynamic-index { "mappings": { "numeric_detection": true, "dynamic_date_formats": ["MM/dd/yyyy"] } } 执行成功,我们再发送之前创建索引数据的请求 PUT /dynamic-index/_doc/1 { "my_null": null, "my_boolean": false, "my_float": 1.56, "my_long": 3, "my_object": { "my_first": "first value", "my_second": "second_value" }, "my_array": [1,2,3], "my_date_1": "2020-05-01", "my_date_2": "2020/05/01 12:03:03", "my_date_3": "05/01/2020", "my_string_long": "1", "my_string_float": "4.6", "my_string": "中华人民共和国" } 执行成功,我们再看一下索引的映射, "my_string_float": { "type": "float" }, "my_string_long": { "type": "long" } "my_date_1": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_date_2": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_date_3": { "type": "date", "format": "MM/dd/yyyy" }, 我们重点看一下以上几个字段,my_string_float和my_string_long映射成我们想要的类型了,由于我们开启了数字探测。再看看我们映射的3个日期类型,咦?只有my_date_3映射了日期类型,其他两个都是映射成了text类型,这是由于我们在设置dynamic_date_formats时,只指定了一种格式。我们只需要把其他两种类型的日期格式也加上就可以了。 { "mappings": { "numeric_detection": true, "dynamic_date_formats": ["MM/dd/yyyy","yyyy/MM/dd HH:mm:ss","yyyy-MM-dd"] } } 这里就不给大家具体演示了,有兴趣的小伙伴去尝试一下把。 动态字段是ES中一个非常重要的功能,它给我们带来了极大的方便,也省去了我们在开发时创建索引字段的时间,真是事半功倍,小伙伴们要好好掌握哦~~

优秀的个人博客,低调大师

ES7学习笔记(四)字段类型(mapping)

在上一节中,我们创建了索引,在创建索引的时候,我们指定了mapping属性,mapping属性中规定索引中有哪些字段,字段的类型是什么。在mapping中,我们可以定义如下内容: 类型为String的字段,将会被全文索引; 其他的字段类型包括:数字、日期和geo(地理坐标); 日期类型的格式; 动态添加字段的映射规则; 字段的可用类型如下: 简单的类型,比如:text,keyword,date,long,double,boolean,ip。我们可以看到,类型当中没有String,字符串的类型是text,所有text类型的字段都会被全文索引。数字类型有两个,long(长整型)和double(浮点型)。 JSON的层级类型:Object(对象)和Nested(数组对象)。Object类型时,该字段可以存储一个JSON对象;Nested类型时,该字段可以存储一个数组对象。 复杂的类型:包括 geo_point、geo_shape和completion。 在索引中创建映射 我们在创建索引的时候可以同时创建映射,就如同上一节的内容。也可以在索引创建好以后,再去创建映射,请求的方式如下: PUT /my-index { "mappings": { "properties": { "age": { "type": "integer" }, "email": { "type": "keyword" }, "name": { "type": "text" } } } } 请求的方法我们要使用PUT,路径是我们的索引名称,请求体当中是我们为索引添加的字段和字段的类型。 在存在的映射中添加字段 正如上面所示,我们在一个索引中添加了字段,但是现在我们要补充额外的字段,这时,我们要怎么做呢? PUT /my-index/_mapping { "properties": { "employee-id": { "type": "keyword", "index": false } } } 我们使用PUT方法,后面跟随我们的索引名称,再接上_mapping,请求体中是我们新添加的映射字段,我们指定了字段的类型为keyword,index索引为false,说明这个字段只用于存储,不会用于搜索,搜索这个字段是搜索不到的。 我们在更新字段时候,是不能修改字段的类型的。如果我们要修改字段的类型,最好是新建一个新的字段,指定正确的类型,然后再更新索引,以后我们只需要查询这个新增的字段就可以了。 查看索引中的字段映射 如果我们要查看已知索引的字段映射,可以向ES发送如下的请求: GET /my-index/_mapping 请求的方法是GET,请求的路径是我们索引的名称my-index,再加上一个_mapping,得到的返回结果如下: { "my-index" : { "mappings" : { "properties" : { "age" : { "type" : "integer" }, "email" : { "type" : "keyword" }, "employee-id" : { "type" : "keyword", "index" : false }, "name" : { "type" : "text" } } } } } 返回的结果中,我们可以看到索引的名称my-index,还有我们添加的字段,也包括后续补充的employee-id字段。 好了,关于索引的字段映射就先给大家介绍到这里。

优秀的个人博客,低调大师

ES[7.6.x]学习笔记(三)新建索引

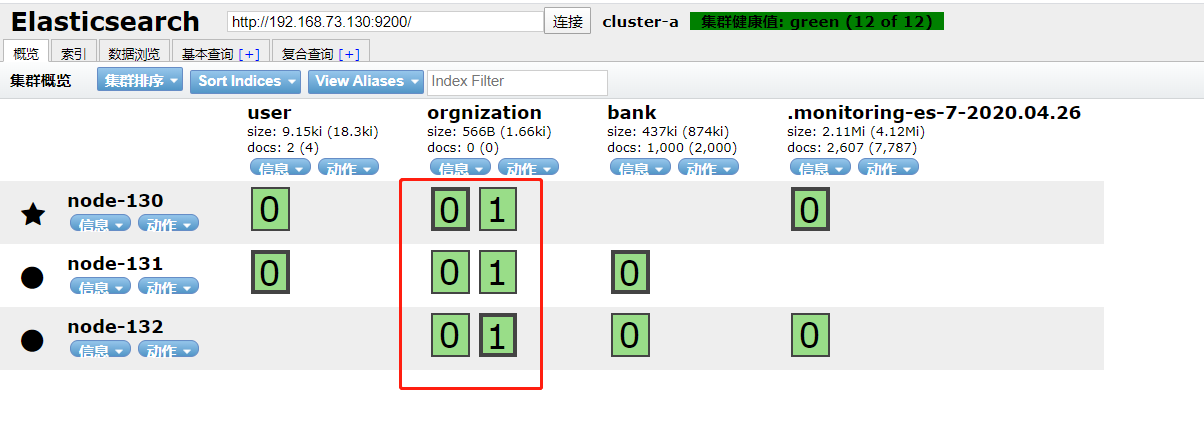
与ES的交互方式 与es的交互方式采用http的请求方式,请求的格式如下: curl -X<VERB> '<PROTOCOL>://<HOST>:<PORT>/<PATH>?<QUERY_STRING>' -d '<BODY>' 是请求的方法,比如:GET、POST、DELETE、PUT等。 协议:http或者https。 主机地址。 端口 API的路径。比如查看集群状态:/_cluster/stats。 参数。比如:?pretty,打印出格式化以后的Json。 请求的内容。比如:添加索引时的数据。 创建索引 es创建索引的请求方式如下: PUT /<index> 请求的方法用PUT。 /后面直接跟索引的名称即可。 索引的设置和字段都放在Body中。 比如我们创建一个名字叫组织机构的索引,这个索引只有两个字段,一个id,一个name。并且这个索引设置为2个分片,2个副本。 我们使用POSTMAN发送请求,如下: http://192.168.73.130:9200/orgnization 请求的方法选择PUT。然后在请求体(Body)中,写上索引的字段名称,索引的分片数和副本数,如下: { "settings":{ "number_of_shards":2, "number_of_replicas":2 }, "mappings":{ "properties":{ "id":{ "type":"long" }, "name":{ "type":"text" } } } } 我们观察一下,请求体中分为两个部分:settings和mappings。在settings中,我们设置了分片数和副本数。 number_of_shards:分片的数量; number_of_replicas:副本的数量; 在mappings中,我们设置索引的字段,在这里,我们只设置了id和name,id的映射类型是long,name的映射类型是text。这些类型我们会在后续为大家介绍。 请求体写完后,我们点击发送,es返回的结果如下: { "acknowledged": true, "shards_acknowledged": true, "index": "orgnization" } 说明索引创建成功,索引的名字正是我们在请求中设置的orgnization。 然后,我们通过elasticsearch-head插件观察一下刚才创建的索引,如图: 我们可以看到索引orgnization已经创建好了,它有2个分片,分别是0和1,并且每个分片都是两个副本。如果我们仔细观察这个图,可以看出node-130节点中的0分片,和node-132节点中的1分片,它们的边框是加粗的,这说明它们是主节点,而边框没有加粗的节点是从节点,也就是我们说的副本节点。 查看索引 如果我们要查看一个索引的设置,可以通过如下请求方式: GET /<index> 在我们的例子中,查看orgnization索引的设置,我们在POSTMAN中发送如下的请求: 我们可以看到索引的具体设置,比如:mapping的设置,分片和副本的设置。这些和我们创建索引时候的设置是一样的。 修改索引 索引一旦创建,我们是无法修改里边的内容的,不如说修改索引字段的名称。但是我们是可以向索引中添加其他字段的,添加字段的方式如下: PUT /<index>/_mapping 然后在我们的请求体中,写好新添加的字段。比如,在我们的例子当中,新添加一个type字段,它的类型我们定义为long,请求如下: http://192.168.73.130:9200/orgnization/_mapping 请求类型要改为PUT,请求体如下: { "properties": { "type": { "type": "long" } } } 我们点击发送,返回的结果如图所示: 添加索引字段成功,我们再使用GET查看一下索引,如图: 我们可以成功的查询到新添加的索引字段了。 删除索引 如果我们要删除一个索引,请求方式如下: DELETE /<index> 假如我们要删除刚才创建的orgnization索引,我们只要把请求的方法改成DELETE,然后访问我们索引就可以, http://192.168.73.130:9200/orgnization 关闭索引 如果索引被关闭,那么关于这个索引的所有读写操作都会被阻断。索引的关闭也很简单,请求方式如下: POST /<index>/_close 在我们的例子中,如果要关闭索引,降请求方法改成POST,然后发送如下请求: http://192.168.73.130:9200/orgnization/_close 打开索引 与关闭索引相对应的是打开索引,请求方式如下: POST /<index>/_open 在我们的例子中,如果要打开索引,降请求方法改成POST,然后发送如下请求: http://192.168.73.130:9200/orgnization/_open 冻结索引 冻结索引和关闭索引类似,关闭索引是既不能读,也不能写。而冻结索引是可以读,但是不能写。冻结索引的请求方式如下: POST /<index>/_freeze 对应我们的例子当中: http://192.168.73.130:9200/orgnization/_freeze 解冻索引 与冻结索引对应的是解冻索引,方式如下: POST /<index>/_unfreeze 对应我们的例子: http://192.168.73.130:9200/orgnization/_unfreeze

优秀的个人博客,低调大师

JavaScript数组精简技巧,要记好笔记了

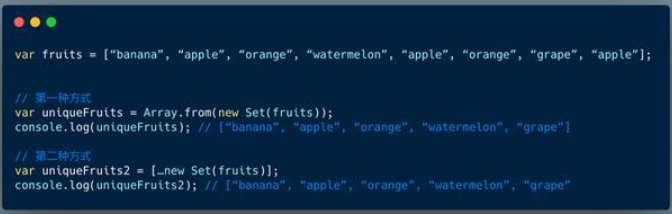
云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 数组是 JS 最常见的一种数据结构,咱们在开发中也经常用到,在这篇文章中,提供一些小技巧,帮助咱们提高开发效率。 删除数组的重复项 替换数组中的特定值 有时在创建代码时需要替换数组中的特定值,有一种很好的简短方法可以做到这一点,咱们可以使用.splice(start、value to remove、valueToAdd),这些参数指定咱们希望从哪里开始修改、修改多少个值和替换新值。 Array.from 达到 .map 的效果 咱们都知道 .map() 方法,.from() 方法也可以用来获得类似的效果且代码也很简洁。 4.置空数组 有时候我们需要清空数组,一个快捷的方法就是直接让数组的 length 属性为 0,就可以清空数组了。 将数组转换为对象 有时候,出于某种目的,需要将数组转化成对象,一个简单快速的方法是就使用展开运算符号(...): 用数据填充数组 在某些情况下,当咱们创建一个数组并希望用一些数据来填充它,这时 .fill()方法可以帮助咱们。 数组合并 使用展开操作符,也可以将多个数组合并起来。 8.求两个数组的交集 求两个数组的交集在面试中也是有一定难度的正点,为了找到两个数组的交集,首先使用上面的方法确保所检查数组中的值不重复,接着使用.filter 方法和.includes方法。如下所示: 9.从数组中删除虚值 在 JS 中,虚值有 false, 0,'', null, NaN, undefined。咱们可以 .filter() 方法来过滤这些虚值。 从数组中获取随机值 有时我们需要从数组中随机选择一个值。一种方便的方法是可以根据数组长度获得一个随机索引,如下所示: 11.反转数组 现在,咱们需要反转数组时,没有必要通过复杂的循环和函数来创建它,数组的 reverse 方法就可以做了: 12 lastIndexOf() 方法 13.对数组中的所有值求和 JS 面试中也经常用 reduce 方法来巧妙的解决问题 在本文中,介绍了13个技巧,希望它们可以帮助编写简洁代码,如果你还有更好的办法,欢迎留言讨论。 云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 原文发布时间:2020-02-27本文作者:前端小智本文来自:“今日头条”,了解相关信息可以关注“今日头条”

优秀的个人博客,低调大师

前端学习笔记(7)css选择器(一)

选择器分类 简单选择器:针对某一特征判断是否选中元素。 复合选择器:连续的简单选择器,根据元素特征判断是否选中单个元素。 复杂选择器:由“(空格)“ “ >” “ ~” “ +” “ ||” 等符号连接的复合选择器,根据父元素或者前序元素检查单个元素。 选择器类别:用逗号分隔的复杂选择器,表示“或”。 简单选择器 简单选择器分类: 类型选择器 全体选择器 id选择器 class选择器 属性选择器 伪类选择器 伪元素选择器 类型选择器 根据标签名来选中元素。 div{ } 全体选择器 “*”可以选中任意元素。 *{ } id选择器 “#”后面跟id名。 #myid{ } class选择器 “.”后面跟class名 c 一个元素可以拥有多个类。下例中“.a” “.b” “ .c”都可以选中div标签。 <div class="a b c"></div> .a{ } 属性选择器 第一种,[att]: 选中带有att属性的元素 <input type="text"/> [type]{ } 第二种,[att=val]: 选中att属性值为val的元素 <input type="text"/> [type=text]{ } 第三种,[att~=val]: 选中属性att的值中包含指定词汇的元素 <img src="" title="img1 img2" /> [type~=img1]{ } 第四种,[att|=val]: 选中属性att值以val开头的元素,val必须为整个单词 <p lang="en-us">Hello World!</p> [type|=en]{ } 第五种,[att^=val]: 选中属性att值以val开头的元素 <input type="text"/> [type^=te]{ } 第六种,[att$=val]: 选中属性att值以val结束的元素 <input type="text"/> [type^=xt]{ } 第七种,[att*=val]: 选中属性att值包含val的元素 <input type="text"/> [type*=ex]{ } 属性选择器中val可能包含特殊字符,所以可以使用单双引号包裹起来规避特殊字符,也可以使用反斜杠转义。 伪类选择器 伪类选择器是一系列由 CSS 规定好的选择器,它们以冒号开头。伪类选择器有普通型和函数型两种。 树结构关系伪类选择器 :root表示树的根元素,html文档中根元素为html标签。 :empty表示没有子节点的元素,拥有空白文本也不能被选中。 :nth-child和:nth-last-child,nth-child规则如下。nth-last-child为从后向前。 :first-child和:last-child分别表示第一个和最后一个元素。 :only-child表示唯一子元素 S:nth-of-type和S:nth-last-of-type表示只从S只选中。(of-type系列同理) <div> <p>1</p> <a>2</a> <p>3</p> <p>4</p> </div> div p:nth-child(1){ //选中 1 } div p:nth-child(2){ // 没有选中 } div p:nth-of-type(2){ // 选中3 } :first-of-type和:last-of-type <div> <p>1</p> <a>2</a> <p>3</p> <p>4</p> </div> div p:first-child{ //选中1 } div a:first-child{ //没有选中 } div a:first-of-type{ //选中2 } :only-of-type <div> <p>1</p> <a>2</a> </div> div p:only-child{ //没有选中 } div p:only-of-type{ //选中p } 链接与行为伪类选择器 :any-link 表示任意的链接,包括 a、area 和 link 标签都可能匹配到这个伪类。 :link 表示未访问过的链接, :visited 表示已经访问过的链接。 :hover 表示鼠标悬停在上的元素。 :active 表示用户正在激活这个元素,如用户按下按钮,鼠标还未抬起时,这个按钮就处于激活状态。 :focus 表示焦点落在这个元素之上。 :target 用于选中浏览器 URL 的 hash 部分所指示的元素。 逻辑伪类选择器 :not目前只支持简单选择器 <div> <p class="p1">1</p> <p>2</p> </div> div p:not(.p1){ //选中2 } 伪元素选择器 伪元素选择器选中的是不存在的元素。常用的伪元素选择器有以下几种。 first-line 选用元素的第一行 first-letter 选中元素的第一个字母 before after first-line 必须出现在最内层的块级元素之内。所以下例代码中第一行为蓝色。 <div> <p id=a>First paragraph</p> <p>Second paragraph</p> </div> div>p#a { color:green; } div::first-line { color:blue; } span标签为行级元素,所以伪元素在span之外,第一行为绿色。 <div> <span id=a>First paragraph</span> <span>Second paragraph</span> </div> div>span#a { color:green; } div::first-line { color:blue; } ::first-letter 的行为又有所不同,它的位置在所有标签之内。我们把前面的代码换成::first-letter,首字母为蓝色。 <div> <span id=a>First paragraph</span> <span>Second paragraph</span> </div> div>span#a { color:green; } div::first-letter { color:blue; } ::before 表示在元素内容之前插入一个虚拟的元素,::after 则表示在元素内容之后插入。这两个伪元素所在的 CSS 规则必须指定 content 属性才会生效,我们看下例子: <p class="hi">hellow world!</p> p.hi::before { display: block; content: "hi! "; }

优秀的个人博客,低调大师

前端学习笔记(8)css选择器(二)

选择器的组合 选择器列表是一个由逗号分隔的复杂选择器序列;复杂选择器则是用“空格”、“~”、“+”、“>”、“||”连接的复合选择器;复合选择器则是连写的简单选择器。选择器的连接方式可以理解为四则运算一样有优先级。 第一优先级:无连接符号,表示“且” 第二优先级:“空格”、“~”、“+”、“>”、“||” 第三优先级 :“,”表示“或”复杂选择器规定了五种连接符号。 “空格”:后代,表示选中所有符合条件的后代节点, 例如“ .a .b ”表示选中所有具有 class 为 a 的后代节点中 class 为 b 的节点。 “>” :子代,表示选中符合条件的子节点,例如“ .a>.b ”表示:选中所有“具有 class 为 a 的子节点中,class 为 b 的节点”。 “~”: 后继,表示选中所有符合条件的后继节点,后继节点即跟当前节点具有同一个父元素,并出现在它之后的节点,例如“ .a~.b ”表示选中所有具有 class 为 a 的后继中,class 为 b 的节点。 “+”:直接后继,表示选中符合条件的直接后继节点,直接后继节点即 nextSlibling。例如 “.a+.b ”表示选中所有具有 class 为 a 的下一个 class 为 b 的节点。 “||”:列选择器,表示选中对应列中符合条件的单元格。实际使用中“空格”、“>” 使用的比较常见。 选择器的优先级 id选择器的数目记为a; 伪类选择器、class选择器和属性选择器的数目记为b; 伪元素选择器和标签选择器的数目结尾c; “*”不影响优先级。 specificity = base * base * a + base * b + c 其中base是一个足够大的正整数。行内属性的优先级永远大于css规则。浏览器提供了“!important”关键字优先级高于行内属性,不推荐使用。不同属性选择器的优先级相同。例如下面一段代码中三个属性选择器的优先级是相同。 <input type="text"/> [type]{ } [type="text"]{ } [type^="t"]{ } 同一优先级的选择器遵循后面的覆盖前面的原则。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册