首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

Android Map开发基础知识学习笔记

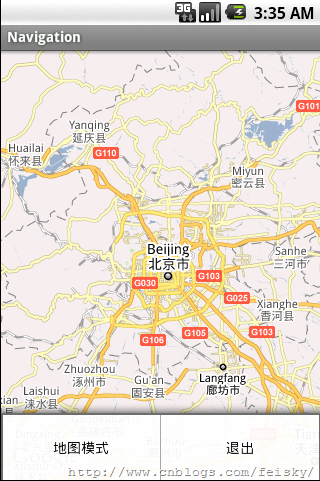
注册Android地图API密钥 运行:keytool -list -keystore ~/.android/debug.keystore 用得到的MD5码到http://code.google.com/intl/zh-CN/android/maps-api-signup.html注册API密钥。参考: http://www.cnblogs.com/feisky/archive/2010/01/17/1650083.html 注册完成后会得到如下的网页: 您的密钥是: XXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXX 此密钥适用于所有使用以下指纹所对应证书进行验证的应用程序: XX:XX:XX:XX:XX:XX:XX:XX:XX:XX:XX:XX 下面是一个xml格式的示例,帮助您了解地图功能: <com.google.android.maps.MapView android:layout_width="fill_parent" android:layout_height="fill_parent"android:apiKey="XXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXX" /> 模拟器设置 建立一个"Google Inc.:Google APIs:3"的模拟器。 手机终端需要支持Google Add-ons 作为与Google合作的手机终端的制造商,如果想在自己的Android终端中集成Google的一些应用,例如map,market,picasa,sync等,需要和Google签约,这样Google会有专人帮你将这一系列服务整合到你的平台中来。 作为没有和Google合作的手机终端的制造商,我们可以使用破解的方法将Add-ons中的运行库整合到自己的framework中来(build到手机终端的system.img中)。操作如下: 1.在Android中,额外支持GoogleAdd-ons(Google Maps),需要将如下档案(从标准的SDK中pull出来的,也可以从GPhone中pull出来)打包进System.img。GoogleAdd-ons只需要1--2,Goolge Maps(Google的地图程序)需要1--5: 1)system/frameworkcom.google.android.maps.jar 2)system/etc/permissionscom.google.android.maps.xml 3)system/frameworkcom.google.android.gtalkservice.jar 4)system/etc/permissionscom.google.android.gtalkservice.xml 5)system/appMaps.apk (Google Maps v3.0) 2.源码:Android Cupcake Release(经测试,在donut平台同样适用。) 1)编译源码(为了生成out/target目录中Android最原始的东西) 2)将以上文件加入out/target/product/generic相应目录,在源码根目录使用make snod打包,获得新的system.img 权限和Maps库设置 在manifest.xml中设置全相应的权限,比如: <uses-permission android:name="android.permission.ACCESS_COARSE_LOCATION"/> <uses-permission android:name="android.permission.INTERNET"/> 在manifest.xml中加上要用的maps库: <manifest xmlns:android="http://schemas.android.com/apk/res/android" package="com.example.package.name"> ... <application android:name="MyApplication"> <uses-library android:name="com.google.android.maps"/> ... </application> ... </manifest> Maps库分析 Maps库提供了十几个类,具体可以参考这里http://code.google.com/intl/ja/android/add-ons/google-apis/reference/index.html,包括Mapview,MapController,MapActivity等。 (1)MapController 控制地图移动,伸缩,以某个GPS坐标为中心,控制MapView中的view组件,管理Overlay,提供View的基本功能。使用多种地图模式(地图模式(某些城市可实时对交通状况进行更新),卫星模式,街景模式)来查看Google Map。 常用方法:animateTo(GeoPoint point)setCenter(GeoPoint point)setZoom(int zoomLevel)等。 (2)MapView Mapview是用来显示地图的view,它派生自android.view.ViewGroup。当MapView获得焦点,可以控制地图的移动和缩放。 地图可以以不同的形式来显示出来,如街景模式,卫星模式等,通过setSatellite(boolean)setTraffic(boolean), setStreetView(boolean)方法。 MapView只能被MapActivity来创建,这是因为mapview需要通过后台的线程来连接网络或者文件系统,而这些线程要由mapActivity来管理。 需要特别说明的一点是,android 1.5中,map的zoom采用了built-in机制,可以通过setBuiltInZoomControls(boolean)来设置是否在地图上显示zoom控件。 常用方法:getController()getOverlays()setSatellite(boolean)setTraffic(boolean),setStreetView(boolean)setBuiltInZoomControls(boolean)等。 (3)MapActivity 管理Activity的生命周期,为mapview建立及取消对map service的连接。 MapActivity是一个抽象类,任何想要显示MapView的activity都需要派生自MapActivity。并且在其派生类的onCreate()中,都要创建一个MapView实例,可以通过MapViewconstructor (然后添加到View中ViewGroup.addView(View))或者通过layout XML来创建。 (4)Overlay Overlay是覆盖到MapView的最上层,可以扩展其ondraw接口,自定义在MapView中显示一些自己的东西。MapView通过MapView.getOverlays()对Overlay进行管理。 除了Overlay这个基类,Google还扩展了2个比较有用的Overlay 1)MylocationOverlay—集成了Android.location中接收当前坐标的接口,集成SersorManager中CompassSensor的接口 我们只需要enableMyLocation(),enableCompass就可以让我们的程序拥有实时的MyLocation以及Compass功能(Activity.onResume()中)。 2)ItemlizedOverlay—管理一个OverlayItem链表,用图片等资源在地图上作风格相同的标记。 (5)Projection:MapView中GPS坐标与设备坐标的转换(GeoPoint和Point)。 一个简单的小例子 用一个小程序来演示一下android中地图功能的开发。主要功能是实现了地图的缩放,添加了菜单,从而可以手动选择地图的显示模式等。 Step1:新建一个android project,注意这里要选择的buildtarget为"GoogleAPIs" Step 2:修改menifest文件: <?xmlversion="1.0"encoding="utf-8"?> <manifest xmlns:android="http://schemas.android.com/apk/res/android" package="com.map.prac" android:versionCode="1" android:versionName="1.0"> <uses-permission android:name="android.permission.ACCESS_COARSE_LOCATION"/> <uses-permission android:name="android.permission.INTERNET" /> <application android:icon="@drawable/icon"android:label="@string/app_name"> <uses-library android:name="com.google.android.maps" /> <activity android:name=".MapViewPrac2" android:label="@string/app_name"> <intent-filter> <action android:name="android.intent.action.MAIN"/> <category android:name="android.intent.category.LAUNCHER" /> </intent-filter> </activity> </application> <uses-sdk android:minSdkVersion="3" /> </manifest> Step 3:修改layout文件,main.xml <?xmlversion="1.0"encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/main" android:layout_width="fill_parent" android:layout_height="fill_parent"> <com.google.android.maps.MapView android:id="@+id/map" android:layout_width="fill_parent" android:layout_height="fill_parent" android:enabled="true" android:clickable="true" android:apiKey="???????????????????????????????????" /> </LinearLayout> 这里需要将api key中的????????????改成你自己申请到的api key. Step4:修改代码: package feisky.navigation; import com.google.android.maps.GeoPoint; import com.google.android.maps.MapActivity; import com.google.android.maps.MapController; import com.google.android.maps.MapView; import android.app.AlertDialog; import android.app.Dialog; import android.content.DialogInterface; import android.os.Bundle; import android.view.KeyEvent; import android.view.Menu; import android.view.MenuItem; public class MainActivity extends MapActivity { // 地图显示控制相关变量定义 private MapView map=null; private MapController mapCon; // 菜单项 final private int menuMode=Menu.FIRST; final private int menuExit=Menu.FIRST+1; private int chooseItem=0; /** Called when the activity is first created. */ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); // 获取MapView map=(MapView)findViewById(R.id.map); // 设置显示模式 map.setTraffic(true); map.setSatellite(false); map.setStreetView(true); // 设置可以缩放 map.setBuiltInZoomControls(true); // 设置初始地图的中心位置 GeoPoint geoBeijing=new GeoPoint((int)(39.95*1000000), (int)(116.37*1000000)); mapCon=map.getController(); mapCon.setCenter(geoBeijing); } @Override public boolean onCreateOptionsMenu(Menu menu) { // 建立菜单 menu.add(0,menuMode,0,"地图模式"); menu.add(0, menuExit, 1, "退出"); return super.onCreateOptionsMenu(menu); } @Override public boolean onKeyDown(int keyCode, KeyEvent event) { return super.onKeyDown(keyCode, event); } @Override public boolean onMenuItemSelected(int featureId, MenuItem item) { switch (item.getItemId()) { case menuExit: finish(); break; case menuMode: Dialog dMode=new AlertDialog.Builder(this) .setTitle("地图模式设置") .setSingleChoiceItems(R.array.MapMode, chooseItem, new DialogInterface.OnClickListener() { @Override public void onClick(DialogInterface dialog, int which) { chooseItem=which; } }) .setPositiveButton("确定", new DialogInterface.OnClickListener() { @Override public void onClick(DialogInterface dialog, int which) { switch (which) { case 0: map.setSatellite(true); //map.setTraffic(false); //map.setStreetView(false); break; case 1: //map.setSatellite(false); map.setTraffic(true); //map.setStreetView(false); break; case 2: //map.setSatellite(false); //map.setTraffic(false); map.setStreetView(true); break; default: break; } } }) .setNegativeButton("取消", new DialogInterface.OnClickListener() { @Override public void onClick(DialogInterface dialog, int which) { } }) .create(); dMode.show(); break; default: break; } return super.onMenuItemSelected(featureId, item); } @Override protected boolean isRouteDisplayed() { return false; } } 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/20/1652230.html,如需转载请自行联系原作者


优秀的个人博客,低调大师

MyGeneration学习笔记(11) :dOOdad的架构(Architectures)

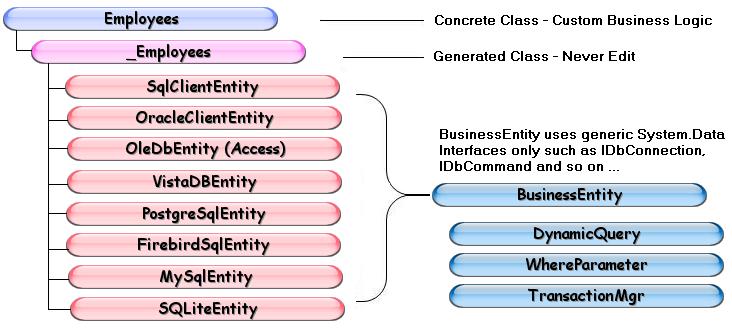
前面10篇介绍了使用dOOdads做ORM映射的基本使用方法和我在使用过程中的总结的一些技巧,这里我再对dOOdads项目做一个概要的总结: 1. 使用dOOdad的概要步骤: (1) 创建解决方案,将dOOdad项目加入该解决方案; (2) 使用MyGeneration的dOOdads存储过程模板生成存储过程,并手工写入数据库中; (3) 使用MyGeneration的dOOdads BusinessEntity模板和ConcreteClass模板生成实体类;并添加到项目中; (4) 配置数据库连接字符串; That's all! So Easy.详细步骤及我在使用中遇到的问题,我以前都有记录: http://www.cnblogs.com/happyhippy/category/79938.html 2. dOOdad的架构: (1) 模型(From MyGeneration): (2) 架构: 本文转自Silent Void博客园博客,原文链接:http://www.cnblogs.com/happyhippy/archive/2007/04/16/715501.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android网络连接处理学习笔记

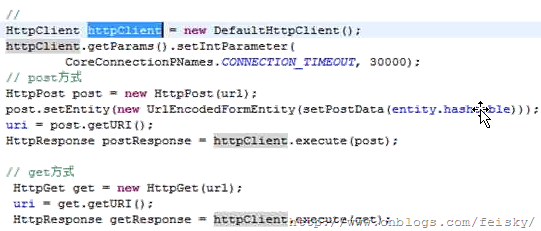
在Android中,可以有多种方式来实现网络编程: 创建URL,并使用URLConnection/HttpURLConnection 使用HttpClient 使用WebView 创建URL,并使用URLConnection/HttpURLConnection java.net.*下面提供了访问 HTTP 服务的基本功能。使用这部分接口的基本操作主要包括: 创建 URL 以及 URLConnection / HttpURLConnection 对象 设置连接参数 连接到服务器 向服务器写数据 从服务器读取数据 源码: try { // 创建URL对象 URL url = new URL("http://t.sina.cn/fesky"); // 创建URL连接 URLConnection connection = url.openConnection(); // 对于 HTTP 连接可以直接转换成 HttpURLConnection, // 这样就可以使用一些 HTTP 连接特定的方法,如 setRequestMethod() 等 // HttpURLConnection connection // =(HttpURLConnection)url.openConnection(Proxy_yours); // 设置参数 connection.setConnectTimeout(10000); connection.addRequestProperty("User-Agent", "J2me/MIDP2.0"); // 连接服务器 connection.connect(); } catch (IOException e) { // TODO Auto-generated catch block e.printStackTrace(); } 使用HttpClient 对于HttpClient类,可以使用HttpPost和HttpGet类以及HttpResponse来进行网络连接。 使用WebView Android手机中内置了一款高性能webkit内核浏览器,在SDK中封装成了WebView组件。 http://developer.android.com/guide/tutorials/views/hello-webview.html提供了一个简单的例子: 1. webview的XML定义: <WebView android:id="@+id/webview" android:layout_width="fill_parent" android:layout_height="fill_parent" /> 2.Manifest文件中权限的设定: <uses-permission android:name="android.permission.INTERNET" /> 3.如果想要支持JavaScript: webview.getSettings().setJavaScriptEnabled(true); 4.如果需要在WebView中显示网页,而不是在内置浏览器中浏览,则需要mWebView.setWebViewClient,并重写shouldOverrideUrlLoading方法。 5.如果不做任何处理,在显示你的Brower UI时,点击系统“Back”键,整个Browser会作为一个整体“Back"到其他Activity中,而不是希望的在Browser的历史页面中Back。如果希望实现在历史页面中Back,需要在当前Activity中处理Back事件:mWebView.goBack(); WebView webview; /** Called when the activity is first created. */ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); // 获取WebView对象 webview = (WebView) findViewById(R.id.webview); // 使能JavaScript webview.getSettings().setJavaScriptEnabled(true); // 如果需要在WebView中显示网页,而不是在内置浏览器中浏览, // 则需要mWebView.setWebViewClient,并重写 // shouldOverrideUrlLoading方法。 webview.setWebViewClient(new WebViewClientDemo()); // 加载网页 webview.loadUrl("http://t.sina.cn/fesky"); } @Override public boolean onKeyDown(int keyCode, KeyEvent event) { // 按下BACK键回到历史页面中 if ((keyCode == KeyEvent.KEYCODE_BACK) && webview.canGoBack()) { webview.goBack(); return true; } return super.onKeyDown(keyCode, event); } private class WebViewClientDemo extends WebViewClient { @Override // 在WebView中而不是默认浏览器中显示页面 public boolean shouldOverrideUrlLoading(WebView view, String url) { view.loadUrl(url); return true; } } 以上是采用loadUrl方法实现网页的加载,也可以采用loadData或者loadDataWithBaseURL方法实现网页的加载: webview.loadData(html, “text/html”, "utf-8”); 如果html中包含中文,则需要webview.loadData(URLEncoder.encode(html,encoding), mimeType, encoding); 对于本地图片或网页的显示,可以使用loadUrl,不过Url的地址前缀为file:///,如"file:///android_asset/test.htm”。 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/13/1646919.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

iOS内存管理学习笔记二

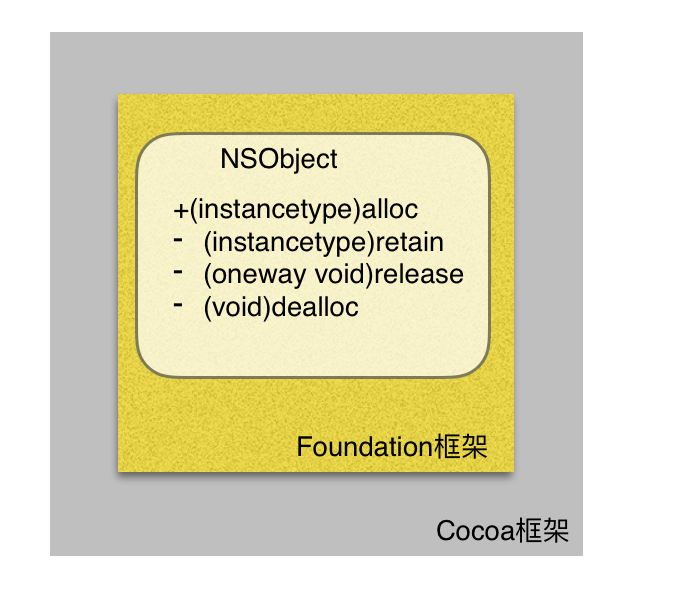
继续学习内存管理相关知识。 1、小小知识点 1>有关OC内存管理的方法并不包括在该语言中,而是包含在cocoa框架中,用于OS X,iOS的开发。 2>cocoa框架中foundation框架类库中的NSObject类负责内存管理的职责。 3>NSObject类的相关方法: (instancetype)alloc ------创建 (instancetype)retain ------引用计数增加 (oneway void)release ------引用计数减少 (void)dealloc 用图形表示如下: image.png 4>使用以下方法自己生成的对象,自己持有 +alloc +new +copy +mutableCopy 例如: NSObject * obj =[ [NSObject alloc]init]; 使用alloc方法生成对象,并把指向该对象的指针赋值给了obj这个变量,现在这个对象的retainCount值等于1。 另外,使用new方法生成对象基本等同于[ [NSObject alloc]init]。 即:[NSObject new] --------- [[NSObject alloc]init]; 题外话:[NSObject new]和 [[NSObject alloc]init]到底有什么区别呢? 我一直不相信他们没有任何区别,如果真是没有任何区别又为什么要写两个方法呢? new方法的源码: +new { id newObject = (*_alloc)((Class)self, 0); Class metaClass = self->isa; if (class_getVersion(metaClass) > 1) return [newObject init]; else return newObject; } 而 alloc/init 像这样 +alloc { return (*_zoneAlloc)((Class)self, 0, malloc_default_zone()); } -init { return self; } 概括来说,new和alloc/init在功能上几乎是一致的,分配内存并完成初始化。 差别在于,采用new的方式只能采用默认的init方法完成初始化,采用alloc的方式可以用其他定制的初始化方法。 5>非自己生成的对象,自己也能持有 id obj = [NSArray array]; obj可以取得对象的存在,但是并不持有该对象。 如果想持有该对象,需要主动调用retain方法,即: [obj retain]; 这样obj就持有了该对象。 6>自己持有的对象,如果不在需要了,就需要释放该对象,释放对象使用release方法。 //生成并持有该对象 id obj = [[NSObject alloc]init]; //释放该对象 [obj release]; //非自己生成对象 id obj = [NSArray array]; //持有对象 [obj retain]; //释放对象 [obj release]; 注意:已经释放的对象是不可以再次访问的,如果访问了已经被释放的对象,就会造成崩溃。(wow,好可怕,但是一定遇见过)。

优秀的个人博客,低调大师

iOS内存管理学习笔记一

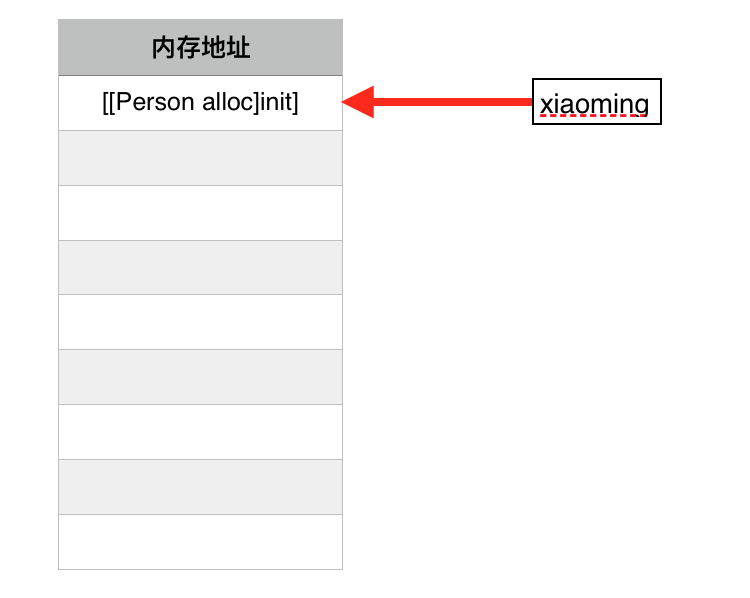
1、引用计数 引用计数就是当前的对象被多少个其他对象所引用。这是我自己的理解。 MRC:手动引用计数,开发者自己来计算每一个对象被引用了多少次,自己进行内存的释放。 ARC:自动引用计数,编译器(xcode)来计算每一个对象的引用次数,对象由编译器来决定什么时候释放。 进一步说,所谓的ARC就是编译器帮我们在代码的合适位置插入了retain和release等MRC需要开发者手动写的关于对象引用计数的代码。 ARC环境: 1>xcode4.2或以上版本 2>LLVM3.0以上的编译器 3>编译器选项中设置ARC为有效 2、理解引用计数 举个简单的例子(可能不是那么贴切): 假如工作室里只有一盏灯,每个上班的员工上班时间都需要开灯,下班时间都需要关灯。假如有很多人上下班,最早上班的人A开了灯,A工作了八个小时下班了,把灯关掉,这样的话,没有下班的其他人都会处在一片黑暗之中。这样显然是不合理的,那么该如何解决呢? 解决这一问题是在办公室至少还有一人的状态下保持开灯,在最后一个人离开办公室的时候关灯。 我们来捋一下这个过程: 1>第一个进来的人需要照明,开灯 2>之后进来的人需要照明 3>下班离开办公室的人不需要照明 4>最后一个离开办公室的人不需要照明(此时已经无人需要照明),关灯 我们可以使用“引用计数”来判断办公室里是否还有人需要照明。过程如下: 1>第一个人进来了,需要照明,引用计数从0变为1,要开灯 2>第二个人进来了,需要照明,引用计数从1变为2 3>第一个人离开了,不需要照明,引用计数从2变为1 4>第二个人离开了,不需要照明,引用计数从1变为0,关灯 总结:只要引用计数=0,就是关灯状态,否则就是开灯状态。 在OC中,“对象”就是照明设备,那些使用该对象的“环境”就相当于需要照明的人。 开灯——生成对象(alloc,new,copy等) 需要照明——持有对象(retain等) 不需要照明——释放对象(release) 关灯——废弃对象(地址被回收,这个对象烟消云散了) 下面是个人理解的对象生命周期: Person是一个类 Person * xiaoming = [[Person alloc]init]; 这个时候再内存中开辟了一块内存空间,并初始化这个对象。引用计数从0变为1,相当于开灯。 image.png Person * xiaohong = xiaoming; 这时候引用计数要增加了。相当于又有人需要照明,引用计数 = 2. image.png 然后xiaohong在使用完这个对象之后就把对象释放了。现在引用计数-1,引用计数=1 [xiaohong release]; image.png xiaoming在使用完这个对象的时候也进行了释放。相当于不需要照明,引用计数-1,引用计数 = 0 . [xiaoming release]; image.png 这个时候,系统发现引用计数已经等于0了,这块空间需要释放回收了,回到最初的状态,于是变成下图的样子。 image.png 在这里简单说说内存泄漏的情形吧。 内存泄漏就是有些地址已经不使用了,但是依然有指针指向它导致这块地址空间不能释放。如下图所示: image.png 这是我自己的理解,如有不妥之处还请各位不吝赐教。如果您看到这篇文章,对您有一点点的帮助,将是我最开心的事!

优秀的个人博客,低调大师

Android源码设计模式解析与实战笔记

1.单一职责原则:比如说一个ImageLoader,需要加载图片的缓存图片,此时如果将这两个功能都放在一个类中,就违反了这个原则, 我们需要将不同的功能用类精细组织起来,然后通过成员变量的形式将功能组合起来。 2.开闭原则:如果我们要在1的基础上增加更多的硬件缓存或者双缓存,此时如果只是在原来的类中使用if进行判断那么就违反了这个原则,因为对于一个类我们需要的是对于修改是关闭的,对于扩展是开发的,此时我们就可以将缓存类定义成抽象的接口,然后将各个缓存的实现,以多态的形式设置在ImageLoader之中,此时我们只需要为ImageLoader设置一个具体ImageCache实现类,而不需要对ImageLoader进行修改。 3.里氏替换原则:在2的基础上,接口的实现需要符合这个原则,这个原则是基于继承和多态这两个性质,而这个原则就是:如果将接口的实现 或者基类的子类设置进入ImageLoader之中,不会出现任何问题。 4.依赖倒置原则:模块之间的依赖关系通过抽象发送,实现类之间不发生直接的依赖关系,依赖关系是通过接口或者抽象产生的。 5.接口隔离原则:类之间的依赖关系应该建立在最小的接口之上,如果一个接口非常臃肿那么需要将这个接口细分。 6.迪米特原则:一个类应该对自己需要耦合或调用的类知道的越少越好,因为一个类对另一个类了解的越多,在重构的时候另一个类需要改的就越多。 1.单例模式: 1.两次判断法:在getInstance()中先判断是否为null,不为null就不进入加锁区,进入加锁区之后再判断一次。 2.静态成员变量法:使用类的构造方法时初始化静态变量,创建唯一的静态实例 3.按需创建:使用内部类,在不调用getInstance()的情况下,不会加载内部类 4.枚举单例:以上的几个方式在反序列化的时候都会出现重新创建对象的问题,而枚举单例不会,其默认是线程安全的。、 5.例子:LayoutInflater用的就是单例,其是通过ContextImpl的getService()获得的,在该类被第一次加载的时候会使用HashMap注册各种Service用ServiceFetcher包裹,其中就包括LayoutInflater。 6.深入理解LayoutInflater:ServiceFetcher需要实现createService()返回具体的Service,LayoutInflater是通过PolicyManger的makeNewLayoutInflater()创建的,这个类是一个代理类,具体的实现在Policy中,在Policy中返回了一个PhoneLayoutInflater。这个类覆写了LayoutInflater的onCreateView(),为传入的View找到具体路径。rInflate()是解析xml最核心的方法:其通过深度优先遍历的方式来构建传入的xml文件中的视图树,每解析到一个View就递归调用rInflater(),直到这个路径下的最后一个元素然后再回溯将该View添加到parent中。 7.运用单例模式:在ImageLoader中使用该模式 8.优缺点:1.减少内存开支 2.减少性能开销 3.避免对一个西苑的多重占用 4.便于全局访问1.没有接口扩展困难 2.单例持有Context容易造成内存泄露,所以推荐使用Application的Context。 2.Builder模式:适用于:对象初始化复杂、产品类复杂不同调用顺序产生最终类型不同、方法不同调用顺序产生最终结果不同。链式调用直观。 1.例子:AlterDialog中使用到 2.运用Builder:当ImageLoader中要设置的参数多了之后就会出现一个问题就是:比如我已经初始化了线程池了,但是我后面又通过set方法改变了线程数,此时就可以使用Builder方法将所有的字段都隐藏起来,只有第一次初始化的时候使用Builder来进行初始化。 3.原型模式:用户通过从一个样板对象中克隆出一个内部属性一致的对象。(跳过) 4.工厂方法模式:定义一个用于创建对象的接口。让其子类决定实例化哪个对象。复杂的对象时候用这个模式,直接可new的对象不需要用。 1.例子:Activity的onCreate() 2.实践:我们对数据进行持久化存储的时候可能会用到好几种方式:xml文件、普通文件、SQLite。此时我们就可以通过定义一个增删改查的接口,然后实现刚刚那三种方式的类最后使用工厂模式来对这些类进行创建。 5.抽象工厂模式:(跳过) 6.策略模式:策略模式定义了一堆算法并封装起来,使得他们可以互相替换,让算法独立于客户端变化。适用于:一类问题有多种处理方式、同一抽象类有多个子类需要使用if或switch来选择。 1.源码中的实现:动画中的插值器和估值器就使用了这个模式(源码具体分析跳过) 2.实战:比如我们使用ImageLoader加载图片的时候一般是顺序加载,但是如果我们要逆序加载的时候就可以通过策略模式来让用户自己选择加载的策略,然后设置。 3.总结:策略模式主要是用来分离不同的算法,很好演绎的开闭原则。 7.状态模式:结构和策略模式基本一致,但是状态模式是不可内替换的,其只是将对象不同的行为包装在不同的对象中,让状态对象有个抽象基类。当一个对象的行为取决于状态或者有许多开关就可以用。 1.例子:比如遥控电视,此时遥控器就是一个状态的组合,我们用基本类型来标记状态,当状态多起来的时候就会有大量的if代码而难以维护。此时我们可以给各种状态定义一个基类,在遥控器中设置一个这样的基类,扩展基类,在遥控器的各个函数中通过多态来设置当前的状态。这样一来减少了if代码,代码也变得可维护起来。 2.源码例子:WifiManager中使用了这个。(跳过) 3.实战:微博登陆就是一个例子,主界面(有转发和注销功能),登陆界面。当用户没登陆的时候点击转发会跳到登陆否则直接转发。此时一般的方式是使用if的方式判断如何进行跳转。但是如果这里用户的状态多了起来的话就会变得复杂起来。所以我们可以建立一个UserState的抽象类设置在LoginContext(负责设置UserState,维持单例)中,将主界面的操作交给LoginContext,然后扩展出已经登陆和未登陆的子类,最后由多态实现无if的可维护的代码。 8.责任链模式:许多对象都有机会处理某些请求,并且有先后顺序,此时为了避免请求者和接收者的耦合,将接收者对象按照一定的顺序连成一条链式结构,并将请求沿着链传递。 1.例子:现实中公司里报销,当经理报销的钱不够时就会去找总经理然后是大总经理,报销就是一个请求,每一层的经理就是处理者。所以我们可以定义一个请求的基类和一个处理者的基类 请求的基类中设置目的的行为,处理基类判断是否能处理和将事件转交给下一个处理基类。 2.源码例子:android的事件分发就使用了这个模式,当一个View不能处理本事件的时候就将该事件交给下一个View进行处理。 3.实战:对于有序广播就是类似于责任链模式,只有有接受者将其终止或者所有接受者都不终止。所以我们可以直接实现一个有序广播。 9.解释器模式:用的少跳过 10.命令模式:就是将函数对象化形成一个伪闭包,实现函数式编程。 1.源码例子:Android事件输入系统 11.观察者模式:将观察者和被观察者解耦,定义对象之间的一对多关系,当一发生变化的所有依赖于这个类的对象会得到通知并被自动更新。 1.例子:Java中提供了这种模式的支持,观察者需要继承Observer,被观察者需要继承Observable。创建一个被观察者,然后将所有观察者在被观察者中注册,然后调用被观察者的消息更新。 2.源码例子:ListView中使用的BaseAdapter就使用了观察者模式,当ListView更新数据之后会调用Adapter的notifyDataSetChanged()BaseAdapter中维持着一个数据观察者DataSetObservable。在这个方法中会调用notifyChanged()。而这里面就是遍历所有的观察者,进行onChanged()的调用。此时DataObservable就是被观察者。而观察者AdapterDataSetObserver在ListView的setAdapter()中创建,其是AdapterView的内部类,其中的onChanged()代码中是调用ListView的requestLayout()对界面进行更新。 3.深入:广播使用了观察者模式,我们注册的广播接收器就是观察者,我们可以在全局进行广播的发送,此时就是被观察者。(粗略看了一下) 12.备忘录模式:保存对象当前状态,在之后恢复状态 1.源码例子:Activity非正常销毁的时候会使用这个模式。 13.迭代器模式:Java的迭代器 14.模版方法模式: 在某些算法中,算法的步骤是一定的但是某些步骤的方式有所不同,我们将基类定义成模版然后由子类去实现。 1.例子:AsyncTask中使用到了这个模式 2.拓展:Activity的生命周期也实现了这个模式,Android系统启动时候Linux内核会启动init进程--》fork一个zygote进程 --》启动SystemService进行,里面有各种各样的服务如ActivityManagerService --》当启动一个应用时候zygote会fork一个进程然后调用ActivityThread的static main()进行默认Activity的加载 --》main()中会 创建UI线程的Lopper、创建ActivityThread、调用AT的attach()(Activity和Application的创建入口)、调用Looper的loop()让主线程开始循环 --》AT的attach()会创建一个ApplicationThread,然后调用远端的AMS,之后就是Activity的创建过程了。 3.实战:上面的ImageLoader,因为加载图片的流程是固定的所以我们可以将这些流程固定在基类中的一个final方法中,此时子类就不能覆盖这些固定的流程,但是各个流程对应的方法可以由子类来自由实现。 15.访问者模式:使用不多跳过 16.中介者模式:通过将一系列需要相互作用的类包装成一个对象,使得他们能够松散耦合,当一个类发生改变时,不会影响到其他对象之间的操作。 1.例子:比如说一台电脑,主板就是中介者,cpu等原件就是同事,此时如果不用中介者模式,所有原件都要互相建立联系,而了之后,可以由主板分配联系。当cpu和某个原件关系改变时不会影响到和其他类的关系。 2.源码例子:Keyguard锁屏功能,KeyguardViewMediator类中有许许多多XXXManager,此时这个类就充当了中介者。 17.代理模式:为其他对象提供一个代理类,来控制这个对象的访问,代理类和被控制对象实现了同样的接口保证了客户端的透明使用。 1.源码例子:ActivityManagerProxy代理了ActivityManagerNative的子类ActivityManagerService。 18.组合模式:就是将一些性质相同的类组合成一个类。简单跳过 19.适配器模式:这种模式使用继承和实现接口或者组合和实现接口的方式,将两个因为接口无法匹配的类一起工作。 1.源码例子:ListView中的Adapter,ListView为了将不同的ItemView展现出来,使用了Adapter。Adapter在ListView的父类AbsListView中。ListView等控件通过Adapter来获取ItemView的数量布局数据等信息,然后getView()返回每个View,ListView将这些View布局在对应位置上,然后再加上复用机制使得ListView运转起来。 2.扩展:RecycleView的设计与实现,与ListView最大的不同在于ListView的布局是通过直接的layoutChildren()来实现,而RecycleView是将布局的职责交给LayoutManager,在设置了LayoutManager之后会调用requestLayout()--》onLayout()--》dispatchLayout()--》LayoutManager#onLayoutChildren() --》LayoutManager#fill()其中会计算当前可用空间、循环调用layoutChunk()进行布局、每次子View布局完毕会计算布局偏移量和剩下的可用空间 --》LayoutManager#layoutChunk()其中会获取当前ItemView(使用了Recycler(其中有几个ViewHolder列表用于缓存ViewHolder)的getViewForPosition()(从几个ViewHolder的缓存列表中看看有没有缓存,没有的话就调用Adapter#onCreateViewHolder()来创建新ViewHolder,最后调用Adapter#onBindViewHolder()将数据绑定到View上))、获取ItemView布局参数、计算ItemView大小、计算ItemView上下左右坐标--》LayoutManager#layoutDecorated()--》调用了ItemView的layout()。 20.装饰模式:动态得给一个对象增加额外的功能,比子类更加灵活,比如java中的IO。 1.原理:创建一个基本装饰器在里面持有被装饰者的引用,用来调用被装饰者的行为,然后扩展装饰器在调用被装饰者行为的同时调用装饰器的行为,这样就起到了为被装饰者添加额外功能的作用,而且比继承更加灵活。 21.享元模式:系统中存在大量相似的对象、需要缓冲池的场景、对象内部与外部环境无关 1.春运时大量的人买火车票,如果每个人都创建一个车票对象,那么这些对象创建销毁就会很频繁,此时我们可以用HashSet将每个唯一的车票对象构成一个对象池,如果有大量相同的车票我们就不用重复创建。 2.Message中会创建一个链表来维护被回收的Message对象,如果不这样做由于事件驱动会产生大量对象,通过这个模式创建一个50的消息池就避免了上面的问题。 22.外观模式:一个子系统与外部通信的时候以一个统一的对象进行。 1.源码例子:Context是一个抽象类,很多方法都是由其他子系统实现的。Activity是ContextImpl的代理。ContextImpl实现了Activity的跳转、发送广播、启动服务等作用,但是里面的具体实现都是通过子系统来实现的。 2.深度扩展:插件化APK加上动态加载Resource 3.实践:将ImageLoader的功能集成在一个类中,只暴露出一个函数,将内部的细节实现隐藏起来。 23:桥接模式:将抽象部分与实现部分分离,或者一个类需要从多个维度扩展但是又不希望使用继承和实现。 1.例子:一杯咖啡加不加糖和大杯小杯能组成4种类型,但是这里的是两个维度,当然可以用多接口实现来解决这个问题。当我们不想用接口解决的话,就可以使用这种模式。我们可以将杯子的大小作为咖啡的继承标准,然后将加不加糖作为独立的类,在咖啡中引用加不加糖。或者将加不加糖和杯子的大小都当做独立的类被咖啡类引用。而这里的引用就可以被成为桥接模式。 2.源码例子:如View视图层级,每一种子View描述着本控件,但是每个View的绘制又是由Canvas等类实现,这就是两种不同的维度的扩展。还有就是Adapter和AdapterView,而比较典型的就是Window和WindowManager之间的关系。 3.实战:我们可以定义一系列不同的ProgressBar,继承一个View,作为绘制这个维度的类。然后定义一个ProgressBarImpl作为不同系列(圆形,条形等等)这一维度,最后让继承View的引用Impl。

优秀的个人博客,低调大师

fork函数替换为SylixOS进程技术笔记

1、使用范围 SylixOS是一款为嵌入式系统设计的硬实时系统。为了保证系统的实时性,系统创建子进程时不做页表切换(页表切换很耗时间,不利于实时性的体现),即父子进程共享同一个页表,而对于Linux下fork函数创建的父子进程是需要进行页表复制和切换的。为了在SylixOS下实现Linux的fork函数功能,本文总结了如何使用posix标准的posix_spawn函数替换fork函数。 2、原理介绍 SylixOS的posix_spawn函数是基于posix标准的,是fork函数和exec函数的功能合二为一,它只是创建一个新进程并执行指定程序。 2.1、Linux下fork函数功能浅析 由fork函数创建的子进程获得父进程的堆栈、数据段和执行文本段的拷贝,实质上我们可以这样理解:即子进程完全复制父进程的页表(对于有写时拷贝机制的fork函数我们也可以这么理解)。 父子进程均可修改各自的栈数据、以及堆段中的变量,而不影响另一进程。程序可以通过fork函数的返回值来区别父子进程,在父进程中fork函数将返回子进程的进程ID。鉴于父进程可能需要创建,进而追踪多个子进程(通过wait函数或类似的方法)。fork函数在子进程中返回0,子进程可以通过getpid函数以获得自身ID,可以使用getppid函数获得父进程的ID。 父子进程之间文件共享,子进程获得父进程所有文件描述符号的副本(副本的创建类似于dup函数的功能),且父子进程中对应的描述符均指向相同的文件句柄(即公用一个文件结构和文件节点),共享同一个文件句柄,这样公用的文件偏移量保证了父子进程写同一个文件时不会覆盖彼此写入的内容(但是父子进程的输出会随意混杂在一起,可用进程间同步来规避)。 总的来说fork函数创建子进程,复制父进程的信息可分为主要三个方面: 1、复制父进程的文件描述符表; 2、复制父进程数据段; 3、复制父进程的环境变量。 对于SylixOS系统来说不提供fork函数,也没有提供与fork函数相同功能的函数。而SylixOS提供一个posix标准的posix_spawn函数,我们可以根据fork函数功能进行使用posix_spawn函数替换fork函数。 2.2、posix_spawn原型介绍 #include <spawn.h>int posix_spawn(pid_t *pid, const char *path, constposix_spawn_file_actions_t *file_actions, constposix_spawnattr_t *attrp, char *const argv[], char *const envp[]); 函数成功返回 0,失败返回-1 并设置错误码。函数参数如表2-1函数参数对比: 表2-1 函数参数 项目 posix_spawn 进程号pid 新的进程号 文件操作集file_actions 新进程启动时需要处理的文件操作集, 为 0 表示不进行任何文件操作 新进程初始化属性attrp 新进程初始化属性,为 NULL 表示不设置 命令行参数字符串数组argv 命令行参数组成的字符串数组,数组以可执行文件名开始以 NULL结束,为 NULL 表示不使用命令行参数最多64个 进程环境变量字符串数组envp 需要预先设置的进程环境变量字符串数组,数组以 NULL 结束,为NULL 表示不需要设置环境变量不超过64个 可执行文件路径path path 是可执行文件路径 根据posix_spawn函数原型和功能可知,针对fork函数创建子进程时复制的主要三个方面有如下的方法替代: 1. 复制文件描述符表:posix_spawn函数自身在创建子进程时也复制父进程所有的文件描述符,父子进程的文件描述符表指向同一个文件结构,这个和fork函数一样; 2. 复制数据段:posix_spawn函数可以通过第五个参数指针数组argv[ ]进行数据传递,对于对父进程的代码段的复制只能通过再次编写来解决; 3. 复制坏境变量:posix_spawn函数可以使用第六个参数数指针数组envp[ ]来传递父进程的环境参数,并且可以认为设置envp[ ]参数来设置子进程的环境参数。 注:因为在SylixOS父子进程因为是共享同一张页表的,所以对于SylixOS操作系统的父子进程天生就有共享内存(即共享同一张页表地址),不过需要注意如果父子进程通过使用同一张页表同一个地址来传递数据很危险,需谨慎使用(比如子进程到共享页表地址进行读写操作,不小心踩到父进程的堆栈空间会造成不可估量的危险)。 3、技术实现 3.1、文件描述符 例程描述: 父进程创建子进程前已经打开一个文件,父进程将文件描述符值传递给子进程,父、子进程共同对同一文件进行写操作。 替换框图如图3-1所示: 图3-1 文件描述符 例程总结: 父进程在创建子进程时,子进程复制父进程的文件描述符表,所以只需要通过传参的方式把文件描述符告知给子进程,子进程就能够使用这个文件描述符,深入了解后发现使用posix_spawn函数创建子进程,父子进程也是公用一个文件结构和文件节点。posix_spawn函数也支持执行时关闭(close-on-exec) 标志,即文件描述符设置FD_CLOEXEC标志,在创建子进程时子进程不能复制该文件描述符。 注:close-on-exec标志可通过fnctl函数对文件描述符设置,具体实现可参考附录。 3.2、全局变量 例程描述: 父进程创建子进程时将全局变量值传递给子进程,随后父进程对全局变量进行加1操作,子进程对接收到的全局变量值也进行加1操作。 替换框图如图3-2所示: 图3-2 全局数据 例程总结: 父进程可通过传递参数的方式将子进程需要的数据传递给子进程,这样父子进程都有自己的数据,且互不干扰。 3.3、守护进程 例程描述: 父进程创建子进程,子进程执行daemon函数将自己设为守护进程,父进程手动退出。 替换框图如图3-3所示: 图3-3 守护进程 例程总结: SylixOS提供了设置守护进程daemon函数,该函数内部包含了部分fork函数创建守护进程的相关操作。 daemon原型介绍 SylixOS提供API接口daemon函数,可以设置当前进程为守护进程。 #include <unistd.h>int daemon(int nochdir, int noclose);函数 daemon 原型分析:l此函数成功返回 0,失败返回-1 并设置错误码;l参数 nochdir 表示是否切换进程当前工作目录到根目录“ /”。 0 表示切换,其他表示不切换;l参数 noclose 表示是否重定向标准输入、标准输出、标准错误输出到“ /dev/null”文件。 0 表示重定向,其他表示不重定向 4、posix_spawn函数源码实现框图 如图4-1所示: 图4-1 posix_spawn函数中的流程实现 如图4-2所示对于posix_spawn函数实现的核心步骤__processStart的实现流程: 图4-2 _processStart函数的实现流程 5、参考资料 《 SylixOS 应用开发手册》 附录置文件描述符不可复制 1.在open函数打开时设置标志位: iFd = open("./filetest", O_RDWR | O_CREAT | O_CLOEXEC , FILE_MODE); 加上这个标志:O_CLOEXEC 2.使用fcntl函数设置文件描述符不可复制: fcntl(iFd, F_SETFD, 0); 注:0表示不设置标志位,1表示设置标志位

优秀的个人博客,低调大师

MySQL的MyISAM InnoDB区别简单笔记!

MyISAM InnoDB 区别 一、MYISAM .frm:表结构 .MYD:表数据 .MYI:表索引 二、INNODB .frm:表结构 .idb:表空间 .opt:字符集和排列规则 MyISAM 和 InnoDB 讲解 InnoDB和MyISAM是许多人在使用MySQL时最常用的两个表类型,这两个表类型各有优劣,视具体应用而定。基本的差别为:MyISAM类型不支持事务处理等高级处理,而InnoDB类型支持。MyISAM类型的表强调的是性能,其执行数度比InnoDB类型更快。 ########################################################################### MyISAM 和 InnoDB 讲解 InnoDB和MyISAM是许多人在使用MySQL时最常用的两个表类型,这两个表类型各有优劣,视具体应用而定。基本的差别为:MyISAM类型不支持事务处理等高级处理,而InnoDB类型支持。MyISAM类型的表强调的是性能,其执行数度比InnoDB类型更快,但是不提供事务支持,而InnoDB提供事务支持已经外部键等高级数据库功能。 以下是一些细节和具体实现的差别: ◆1.InnoDB不支持FULLTEXT类型的索引。 ◆2.InnoDB 中不保存表的具体行数,也就是说,执行select count(*) from table时,InnoDB要扫描一遍整个表来计算有多少行,但是MyISAM只要简单的读出保存好的行数即可。注意的是,当count(*)语句包含 where条件时,两种表的操作是一样的。 ◆3.对于AUTO_INCREMENT类型的字段,InnoDB中必须包含只有该字段的索引,但是在MyISAM表中,可以和其他字段一起建立联合索引。 ◆4.DELETE FROM table时,InnoDB不会重新建立表,而是一行一行的删除。 ◆5.LOAD TABLE FROM MASTER操作对InnoDB是不起作用的,解决方法是首先把InnoDB表改成MyISAM表,导入数据后再改成InnoDB表,但是对于使用的额外的InnoDB特性(例如外键)的表不适用。 另外,InnoDB表的行锁也不是绝对的,假如在执行一个SQL语句时MySQL不能确定要扫描的范围,InnoDB表同样会锁全表,例如update table set num=1 wherename like “%aaa%” 两种类型最主要的差别就是Innodb 支持事务处理与外键和行级锁.而MyISAM不支持.所以MyISAM往往就容易被人认为只适合在小项目中使用。 ########################################################################### 我作为使用MySQL的用户角度出发,Innodb和MyISAM都是比较喜欢的,但是从我目前运维的数据库平台要达到需求:99.9%的稳定性,方便的扩展性和高可用性来说的话,MyISAM绝对是我的首选。 原因如下: 1、首先我目前平台上承载的大部分项目是读多写少的项目,而MyISAM的读性能是比Innodb强不少的。 2、MyISAM的索引和数据是分开的,并且索引是有压缩的,内存使用率就对应提高了不少。能加载更多索引,而Innodb是索引和数据是紧密捆绑的,没有使用压缩从而会造成Innodb比MyISAM体积庞大不小。 3、从平台角度来说,经常隔1,2个月就会发生应用开发人员不小心update一个表where写的范围不对,导致这个表没法正常用了,这个时候MyISAM的优越性就体现出来了,随便从当天拷贝的压缩包取出对应表的文件,随便放到一个数据库目录下,然后dump成sql再导回到主库,并把对应的binlog补上。如果是Innodb,恐怕不可能有这么快速度,别和我说让Innodb定期用导出xxx.sql机制备份,因为我平台上最小的一个数据库实例的数据量基本都是几十G大小。 4、从我接触的应用逻辑来说,select count(*) 和order by 是最频繁的,大概能占了整个sql总语句的60%以上的操作,而这种操作Innodb其实也是会锁表的,很多人以为Innodb是行级锁,那个只是where对它主键是有效,非主键的都会锁全表的。 5、还有就是经常有很多应用部门需要我给他们定期某些表的数据,MyISAM的话很方便,只要发给他们对应那表的frm.MYD,MYI的文件,让他们自己在对应版本的数据库启动就行,而Innodb就需要导出xxx.sql了,因为光给别人文件,受字典数据文件的影响,对方是无法使用的。 6、如果和MyISAM比insert写操作的话,Innodb还达不到MyISAM的写性能,如果是针对基于索引的update操作,虽然MyISAM可能会逊色Innodb,但是那么高并发的写,从库能否追的上也是一个问题,还不如通过多实例分库分表架构来解决。 7、如果是用MyISAM的话,merge引擎可以大大加快应用部门的开发速度,他们只要对这个merge表做一些select count(*)操作,非常适合大项目总量约几亿的rows某一类型(如日志,调查统计)的业务表。 当然Innodb也不是绝对不用,用事务的项目如模拟炒股项目,我就是用Innodb的,活跃用户20多万时候,也是很轻松应付了,因此我个人也是很喜欢Innodb的,只是如果从数据库平台应用出发,我还是会首选MyISAM。 另外,可能有人会说你MyISAM无法抗太多写操作,但是我可以通过架构来弥补,说个我现有用的数据库平台容量:主从数据总量在几百T以上,每天十多亿 pv的动态页面,还有几个大项目是通过数据接口方式调用未算进pv总数,(其中包括一个大项目因为初期memcached没部署,导致单台数据库每天处理 9千万的查询)。而我的整体数据库服务器平均负载都在0.5-1左右。

优秀的个人博客,低调大师

ZooKeeper 笔记(1) 安装部署及hello world

先给一堆学习文档,方便以后查看 官网文档地址大全: OverView(概述) http://zookeeper.apache.org/doc/r3.4.6/zookeeperOver.html Getting Started(开始入门) http://zookeeper.apache.org/doc/r3.4.6/zookeeperStarted.html Tutorial(教程) http://zookeeper.apache.org/doc/r3.4.6/zookeeperTutorial.html Java Example(Java示例) http://zookeeper.apache.org/doc/r3.4.6/javaExample.html Programmer's Guide(开发人员指南) http://zookeeper.apache.org/doc/r3.4.6/zookeeperProgrammers.html Recipes and Solutions(技巧及解决方案) http://zookeeper.apache.org/doc/r3.4.6/recipes.html 3.4.6 API online(在线API速查) http://zookeeper.apache.org/doc/r3.4.6/api/index.html 另外推荐园友sunddenly的zookeeper系列 http://www.cnblogs.com/sunddenly/category/620563.html 一、安装部署 本文在一台机器上模拟3个 zk server的集群安装 1.1下载解压 解压到3个目录(模拟3台zk server): /home/hadoop/zookeeper-1 /home/hadoop/zookeeper-2 /home/hadoop/zookeeper-3 1.2创建每个目录下conf/zoo.cfg配置文件 /home/hadoop/zookeeper-1/conf/zoo.cfg 内容如下: tickTime=2000 initLimit=10 syncLimit=5 dataDir=/home/hadoop/tmp/zk1/data dataLogDir=/home/hadoop/tmp/zk1/log clientPort=2181 server.1=localhost:2287:3387 server.2=localhost:2288:3388 server.3=localhost:2289:3389 /home/hadoop/zookeeper-2/conf/zoo.cfg 内容如下: tickTime=2000 initLimit=10 syncLimit=5 dataDir=/home/hadoop/tmp/zk2/data dataLogDir=/home/hadoop/tmp/zk2/log clientPort=2182 server.1=localhost:2287:3387 server.2=localhost:2288:3388 server.3=localhost:2289:3389 /home/hadoop/zookeeper-3/conf/zoo.cfg 内容如下: tickTime=2000 initLimit=10 syncLimit=5 dataDir=/home/hadoop/tmp/zk3/data dataLogDir=/home/hadoop/tmp/zk3/log clientPort=2183 server.1=localhost:2287:3387 server.2=localhost:2288:3388 server.3=localhost:2289:3389 注:因为是在一台机器上模拟集群,所以端口不能重复,这里用2181~2183,2287~2289,以及3387~3389相互错开。另外每个zk的instance,都需要设置独立的数据存储目录、日志存储目录,所以dataDir、dataLogDir这二个节点对应的目录,需要手动先创建好。 另外还有一个灰常关键的设置,在每个zk server配置文件的dataDir所对应的目录下,必须创建一个名为myid的文件,其中的内容必须与zoo.cfg中server.x 中的x相同,即: /home/hadoop/tmp/zk1/data/myid 中的内容为1,对应server.1中的1/home/hadoop/tmp/zk2/data/myid 中的内容为2,对应server.2中的2/home/hadoop/tmp/zk3/data/myid 中的内容为3,对应server.3中的3 生产环境中,分布式集群部署的步骤与上面基本相同,只不过因为各zk server分布在不同的机器,上述配置文件中的localhost换成各服务器的真实Ip即可。分布在不同的机器后,不存在端口冲突问题,可以让每个服务器的zk均采用相同的端口,这样管理起来比较方便。 1.3 启动验证 /home/hadoop/zookeeper-1/bin/zkServer.sh start /home/hadoop/zookeeper-2/bin/zkServer.sh start /home/hadoop/zookeeper-3/bin/zkServer.sh start 启用成功后,输入 jps 看下进程 20351 ZooKeeperMain20791 QuorumPeerMain20822 QuorumPeerMain20865 QuorumPeerMain 应该至少能看到以上几个进程。 可以启动客户端测试下: bin/zkCli.sh -server localhost:2181 (注:如果是远程连接,把localhost换成指定的IP即可) 成功后,应该会进到提示符下,类似下面这样: [zk: localhost:2181(CONNECTED) 0] 然后,就可以用一些基础命令,比如 ls ,create ,delete ,get 来测试了(关于这些命令,大家可以查看文档),特别提一个很有用的命令rmr 用来递归删除某个节点及其所有子节点 二、java 与 zk的连接示例 2.1maven项目的pom.xml中先添加以下依赖项 <!--zk--> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>3.4.6</version> </dependency> 2.2最基本的示例程序 package yjmyzz; import java.io.IOException; import org.apache.zookeeper.*; import org.apache.zookeeper.data.Stat; public class ZooKeeperHello { public static void main(String[] args) throws IOException, InterruptedException, KeeperException { ZooKeeper zk = new ZooKeeper("172.28.20.102:2181", 300000, new DemoWatcher());//连接zk server String node = "/app1"; Stat stat = zk.exists(node, false);//检测/app1是否存在 if (stat == null) { //创建节点 String createResult = zk.create(node, "test".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.PERSISTENT); System.out.println(createResult); } //获取节点的值 byte[] b = zk.getData(node, false, stat); System.out.println(new String(b)); zk.close(); } static class DemoWatcher implements Watcher { @Override public void process(WatchedEvent event) { System.out.println("----------->"); System.out.println("path:" + event.getPath()); System.out.println("type:" + event.getType()); System.out.println("stat:" + event.getState()); System.out.println("<-----------"); } } } 2.3 与zk集群的连接 zk的优点之一,就是高可用性,上面的代码连接的是单台zk server,如果这台server挂了,自然代码就会出错,事实上zk的API考虑到了这一点,把连接代码改成下面这样: ZooKeeper zk = new ZooKeeper("172.28.20.102:2181,172.28.20.102:2182,172.28.20.102:2183", 300000, new DemoWatcher());//连接zk server 即:IP1:port1,IP2:port2,IP3:port3... 用这种方式连接集群就行了,只要有超过半数的zk server还活着,应用一般就没问题。但是也有一种极罕见的情况,比如这行代码执行时,刚初始化完成,正准备连接ip1时,因为网络故障ip1对应的server挂了,仍然会报错(此时,zk还来不及选出新leader),这个问题详见:http://segmentfault.com/q/1010000002506725/a-1020000002507402,参考该文的做法,改成: 1 ZooKeeper zk = new ZooKeeper("172.28.20.102:2181,172.28.20.102:2182,172.28.20.102:2183", 300000, new DemoWatcher());//连接zk server 2 if (!zk.getState().equals(ZooKeeper.States.CONNECTED)) { 3 while (true) { 4 if (zk.getState().equals(ZooKeeper.States.CONNECTED)) { 5 break; 6 } 7 try { 8 TimeUnit.SECONDS.sleep(5); 9 } catch (InterruptedException e) { 10 e.printStackTrace(); 11 } 12 } 13 } 但是这样代码未免太冗长,建议用开源的zkClient,官方地址:https://github.com/sgroschupf/zkclient,使用方法很简单: <!--zkclient--> <dependency> <groupId>com.github.sgroschupf</groupId> <artifactId>zkclient</artifactId> <version>0.1</version> </dependency> pom.xml先加这一坨,然后这样用: 1 @Test 2 public void testZkClient() { 3 ZkClient zkClient = new ZkClient("172.28.20.102:2181,172.28.20.102:2182,172.28.20.102:2183"); 4 String node = "/app2"; 5 if (!zkClient.exists(node)) { 6 zkClient.createPersistent(node, "hello zk"); 7 } 8 System.out.println(zkClient.readData(node)); 9 }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册