首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

【C语言】学习笔记10——其他数据结构

1. 联合:能在同一内存空间中存储不同的数据类型(不是同时存储)。典型用法是,设计一种表以存储既无规律、事先也不知道顺序的混合类型。 下面是一个代表及的联合模板 union hold { int digit; double bigfl; char letter; } 根据以上形式声明的类型可以存储一个int类型或一个double类型或一个char类型的值。 2. 枚举类型:可以使用枚举类型声明符号名称来表示整型常量。 使用 enum 关键字, 可以创建一个新“类型”并指定它可具有的值。 enum spectrum {red, orange. yellow, green. blue, violet}; enum spectrum color; 枚举符是int类型,但是枚举变量可以是任意整数类型,前提是该整数类型足够长,可以存储所有的枚举常量。比如 spectrum 的枚举符范围是0~5, 所以编译器可以用 unsigned char 来表示color变量 C允许枚举变量使用 ++ 运算符,但是C++标准不允许 3. 在枚举声明中,可以为枚举常量指定整数值 enum levels {low = 100, medium = 500, high = 2000} 如果只给一个枚举常量赋值,后面的常量没有被赋值 enum feline(cat, lynx = 10, puma, tiger) // cat = 0, lynx = 10, puma = 11, tiger = 12 4. typedef: 类似别名,或者说更接近于包装

优秀的个人博客,低调大师

JVM笔记11-类加载器和OSGI

一.JVM 类加载器: 一个类在使用前,如何通过类调用静态字段,静态方法,或者new一个实例对象,第一步就是需要类加载,然后是连接和初始化,最后才能使用。 类从被加载到虚拟机内存中开始,到卸载出内存为止,它的整个生命周期包括:加载(Loading)、验证(Verification)、准备(Preparation)、解析(Resolution)、初始化(Initialzation)、使用(Using)和卸载(Unloading)7 个阶段。其中验证、准备、解析 3 个部分统称为连接(Linking),这 7 个阶段的发生顺序如下图所示: 加载、验证、准备、初始化和卸载这 5 个阶段的顺序是确定的,类的加载过程必须按照这种顺序按部就班地开始,而解析阶段则不一定:它在某些情况下可以在初始化阶段之后再开始,这是为了支持 Java 语言的运行时绑定(也称为动态绑定或晚期绑定)。注意,这里笔者写的是按部就班地 “开始”,而不是按部就班地 “进行” 或 “完成”,强调这点是因为这些阶段通常都是互相交叉地混合式进行的,通常会在一个阶段执行的过程中调用、激活另外一个阶段。 什么情况下需要开始类加载过程的第一个阶段:加载?Java 虚拟机规范中并没有进行强制约束,这点可以交给虚拟机的具体实现来自由把握。但是对于初始化阶段,虚拟机规范则是严格规定了有且只有 5 种情况必须立即对类进行 “初始化”(而加载、验证、准备自然需要在此之前开始): 遇到 new、getstatic、putstatic 或 invokestatic 这 4 条字节码指令时,如果类没有进行过初始化,则需要先触发其初始化。生成这 4 条指令的最常见的 Java 代码场景是:使用 new 关键字实例化对象的时候、读取或设置一个类的静态字段(被 final 修饰、已在编译期把结果放入常量池的静态字段除外)的时候,以及调用一个类的静态方法的时候。 使用 java.lang.reflect 包的方法对类进行反射调用的时候,如果类没有进行过初始化,则需要先触发其初始化。 当初始化一个类的时候,如果发现其父类还没有进行过初始化,则需要先触发其父类的初始化。 当虚拟机启动时,用户需要指定一个要执行的主类(包含 main() 方法的那个类),虚拟机会先初始化这个类。 当使用 JDK 1.7 的动态语言支持时,如果一个 java.lang.invoke.MethodHandle 实例最后的解析结构 REF_getStatic、REF_putStatic、REF_invokeStatic 的方法句柄,并且这个方法句柄所对应的类没有进行初始化,则需要先触发其初始化。 对于这 5 种会触发类进行初始化的场景,虚拟机规范中使用了一个很强烈的限定语:“有且只有”,这 5 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。 类加载器就是将 .java 代码文件编译成 .class 字节码文件后,Java虚拟机的类加载器通过读取此类的二进制流,转换成目标类的实例。 除了Java会生成字节码外,运行在JVM上的JRuby,Scala,Groovy同样需要编译成对应的 .class 文件,这里列举了四种不同的字节码,不单是Java才生成字节码文件。 常用的类加载器有4种: 1.Bootstrap ClassLoader:启动类加载器,加载JAVA_HOME/lib目录下的类。如下图选中的就是 2.ExtClassLoader:扩张类加载器,加载JAVA_HOME/lib/ext目录下的类。 3.AppClassLoader:应用程序类加载器,加载用户指定的classpath(存放 src 目录 Java 文件编译之后的 class 文件和 xml、properties 等资源配置文件的 src/main/webapp/WEB-INF/classes 目录)下的类 4.UserClassLoader:用户自定义的类加载器(只要继承 ClassLoader并实现 findClass(String name) 方法),自定义加载路径。 类加载时并不需要等到某个类被首次主动使用时再加载它,JVM类加载器会在预料某个类要使用时预先加载。双亲委派模型,如下图: Java 类加载基于双亲委派模型——当有类加载请求时,从下往上检查类是否被加载,如果没被加载,UserClassLoader 就委托父类 AppClassLoader 加载,AppClassLoader 继续委托其父类 ExtClassLoader 加载,接着分派给 Bootstrap ClasssLoader 加载; 如果无法加载就返回到发起加载请求的类加载一直到由最开始发起加载请求的 UserClassLoader 加载,所有类最终都会去到顶层。Bootstrap ClasssLoader 开始加载,无法加载就返回子加载器处理,一直到最开始的加载器。 这样子,就算用户自定义了 java.lang.Object 类和系统的 java.lang.Object 类重复,也不会被加载,下面我们就来自定义自己的类加载器。 /** * Created by cong on 2018/8/2. */ public class MyClassLoader extends ClassLoader { public MyClassLoader() { super(); } public MyClassLoader(ClassLoader parent) { super(parent); } @Override protected Class<?> findClass(String name) throws ClassNotFoundException { // do something // 自己先不加载,先让父类加载 return super.findClass(name); } public static void main(String[] args) throws ClassNotFoundException { MyClassLoader myLoader = new MyClassLoader(); // 打印当前类路径 System.out.println(System.getProperty("java.class.path")); // ClassPath路径下并不存在Demo.class类,故抛出异常 System.out.println(myLoader.loadClass("Demo").getClassLoader().getClass().getName()); } } 运行结果如下: 学习自定义类加载器后,我们看下源码里双亲委派模型是怎么加载类的。源码如下: public abstract class ClassLoader { private final ClassLoader parent; protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException { synchronized (getClassLoadingLock(name)) { // 先检查类是否已经被加载 Class c = findLoadedClass(name); if (c == null) { long t0 = System.nanoTime(); try { //如果存在父类加载器,就委托给父类加载器加载 if (parent != null) { c = parent.loadClass(name, false); } else { //如果不存在父类加载器,就委托给顶层的启动类加载器加载 c = findBootstrapClassOrNull(name); } } catch (ClassNotFoundException e) { // ClassNotFoundException异常被抛出则表明父类加载器加载失败 } if (c == null) { // 如果父类无法加载,就自己加载 long t1 = System.nanoTime(); c = findClass(name); sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0); sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1); sun.misc.PerfCounter.getFindClasses().increment(); } } if (resolve) { resolveClass(c); } return c; } } } 我们看到上面 loadClass 类里有同步代码块 synchronized (getClassLoadingLock(name)),而在 JDK1.6 之前是方法protected synchronized Class<?> loadClass(String name, boolean resolve)上锁,锁住方法当前对象。 这就导致一个问题,当 A 包依赖 B 包,A 在自己的类加载器的 loadClass 方法中,最终调用到 B 的类加载器的 loadClass 方法。A 先锁住自己的类加载器,然后去申请 B 的类加载器的锁,当 B 也依赖 A 包时,B 加载 A 的包时,过程相反,在多线程下,就容易产生死锁。如果类加载器是单线程运行就会安全,但效率会很低 同步代码块 synchronized (getClassLoadingLock(name)) 锁住的是一个特定对象。 private final ConcurrentHashMap<String, Object> parallelLockMap; protected Object getClassLoadingLock(String className) { Object lock = this; // parallelLockMap是一个ConcurrentHashMap if (parallelLockMap != null) { // 锁对象 Object newLock = new Object(); // putIfAbsent(K, V)方法查看K(className)和V(newLock)是否相互对应, // 是的就返回V(newLock),否则返回null // 每个className关联一个锁,并将这个锁返回,缩小了锁定粒度了,只要类名不同,就会匹配不同的锁, // 就是并行加载,类似ConcurrentHashMap里面的分段锁, // 不锁住整个Map,而是锁住一个Segment,每次只需要对Segment上锁或解锁,以空间换时间 lock = parallelLockMap.putIfAbsent(className, newLock); if (lock == null) { // 创建一个新锁对象 lock = newLock; } } return lock; 通过并行加载,可以提升加载效率,然后讲下类加载的面试题,在 Java 反射中 Class.forName() 加载类和使用 ClassLoader 加载类是不一样的。例子如下: /** * Created by cong on 2018/8/5. */ public class MyCase { static { System.out.println("执行了静态代码块"); } private static String field = methodCheck(); public static String methodCheck() { System.out.println("执行了静态代方法"); return "给静态变量赋值"; } } ---------------------------------------------------- /** * Created by cong on 2018/8/5. */ public class DemoTest { public static void main(String[] args) { try { System.out.println("Class.forName开始执行:"); //hjc是包名 Class.forName("hjc.MyCase"); System.out.println("ClassLoader开始执行:"); ClassLoader.getSystemClassLoader().loadClass("hjc.MyCase"); } catch (ClassNotFoundException e) { e.printStackTrace(); } } } 运行结果如下: Class.forName 是加载 MyCase 类并完成初始化,给静态代码块和静态变量赋值,而 ClassLoader 只是将类加载进 JVM 虚拟机,并没有初始化。 接下来我们进入Class.forName的源码探究,源码如下: @CallerSensitive public static Class<?> forName(String className) throws ClassNotFoundException { return forName0(className, true, ClassLoader.getClassLoader(Reflection.getCallerClass())); } Class.forName 底层也是调用了 ClassLoader,只是第二个参数为 true,即加载类并初始化,默认就会初始化类,JDBC 连接就是用 Class.forName 加载驱动。所以注册连接驱动会在静态代码块执行,Sprng 里的 IOC 是通过 ClassLoader 来产生,可以控制 Bean 的延迟加载(首次使用才创建)。 二.OSGI 实战: 为了实现代码热替换,模块化和动态化,就像鼠标一样即插即用,双亲委派这种树状的加载器就难以胜任,于是出现了 OSGI 加载模型,OSGI 里每个程序模块(Bundle,就是普通的 jar 包, 只是加入了特殊的头信息,是最小的部署模块)都会有自己的类加载器,当需要更换程序时,就连同 Bundle 和类加载器一起替换,是一种网状的加载模型,Bundle 间互相委托加载,并不是层次化的。 Java 类加载机制的隔离是通过不同类加载器加载指定目录来实现的,类加载的共享机制是通过双亲委派模型来实现,而 OSGI 实现隔离靠的是每个 Bundle 都自带一个独立的类加载器 ClassLoader。 OSGI 加载 Bundle 模块的顺序 首先检查包名是否以 java.* 开头,或者是否在一个特定的配置文件(org.osgi.framework.bootdelegation)中定义。如果是,则 bundle 类加载器立即委托给父类加载器(通常是 Application 类加载器),如果不是则进入 2 检查是否在 Import-Package、Require-Bundle 委派列表里,如果是委托给对应 Bundle 类加载器,如果不是,进入 3 检查是否在当前 Bundle 的 Classpath 里,如果是使用自己的类加载器加载,如果不是,进入 4 搜索可能附加在当前 bundle 上的 fragment 中的内部类,找到则委派给 Fragment bundle 类加载器加载,如果找不到,进入 5 查找动态导入列表里的 Bundle,委派给对应的类加载器加载,否则类加载失败 如果用 Java 的结构的项目去部署,当项目复杂度提升时,每次上线,代码只是增加或者修改了部分功能,但都得关掉服务,重新部署所有的代码和配置,管理沟通成本都很高,很容产生线上事故,而 OSGI 的应用是一个模块化的系统,避免了部署时 jar 或 classpath 错综复杂依赖管理,发布应用和更新应用都很强大,可以热替换特定的 Bundle 模块,提高部署可靠性。 接下来我们用IDE创建一个OSGI应用,首先要去http://download.eclipse.org/equinox/下载最新的OSGI 框架enquinox 创建一个 OSGI 应用。打开 Eclipse,File->New->Project: 选择 OSGI 框架 Equniox(Eclipse 强大的插件机制就是构建于 OSGI Bundle 之上,Eclipse 本身就包含了 Equniox) : 接下来,勾选创建 Activator 类,新建一个创Activator 类,每个 Bundle 启动时都会调用 Bundle(模块)里 Activator(类)的 start 方法,停止时调用 stop 方法,代码如下: import org.osgi.framework.BundleActivator; import org.osgi.framework.BundleContext; /** * Created by cong on 2018/8/5. */ public class Activator implements BundleActivator { private static BundleContext context; static BundleContext getContext() { return context; } public void start(BundleContext bundleContext) throws Exception { Activator.context = bundleContext; //添加输出This is OSGI Projcect System.out.println("This is OSGI Projcect"); } public void stop(BundleContext bundleContext) throws Exception { Activator.context = null; } } 接下来进行一下配置,Run->Run Configuration-> 双击 OSGI Framework 生成项目配置:如下图: 然后点击运行按钮,可以看到控制台输出 This is OSGI Projcect。在控制台我们输入 ss ( short status) 查看服务状态: This is OSGI Projcect osgi> ss "Framework is launched." id State Bundle 0 ACTIVE org.eclipse.osgi_3.12.100.v20180210-1608 1 ACTIVE org.apache.felix.gogo.runtime_0.10.0.v201209301036 2 ACTIVE org.apache.felix.gogo.command_0.10.0.v201209301215 // ACTIVE表明 com.osgi.bundle.demo Bundle运行中 3 ACTIVE com.osgi.bundle.demo_1.0.0.qualifier 4 ACTIVE org.apache.felix.gogo.shell_0.10.0.v201212101605 5 ACTIVE org.eclipse.equinox.console_1.1.300.v20170512-2111 // 停止 com.osgi.bundle.demo Bundle osgi> stop com.osgi.bundle.demo osgi> ss "Framework is launched." id State Bundle 0 ACTIVE org.eclipse.osgi_3.12.100.v20180210-1608 1 ACTIVE org.apache.felix.gogo.runtime_0.10.0.v201209301036 2 ACTIVE org.apache.felix.gogo.command_0.10.0.v201209301215 // RESOLVED 表明 Bundle com.osgi.bundle.demo 停止了 3 RESOLVED com.osgi.bundle.demo_1.0.0.qualifier 4 ACTIVE org.apache.felix.gogo.shell_0.10.0.v201212101605 5 ACTIVE org.eclipse.equinox.console_1.1.300.v20170512-2111 // 通过close关闭整个应用框架 osgi> close Really want to stop Equinox? (y/n; default=y) y osgi> 一个 Bundle 包含 MANIFEST.MF,也就是 Bundle 的头信息,Java 代码以及配置文件(XML,Properties),其中 MANIFEST.MF 包含了下面的信息。如下所示: /*版本号*/ Manifest-Version: 1.0 Bundle-ManifestVersion: 2 /*名字*/ Bundle-Name: Demo Bundle-SymbolicName: com.osgi.bundle.demo Bundle-Version: 1.0.0.qualifier /*Bundle类*/ Bundle-Activator: com.osgi.bundle.demo.Activator Bundle-Vendor: OSGI /*依赖环境*/ Bundle-RequiredExecutionEnvironment: JavaSE-1.7 /*导入的包*/ Import-Package: org.osgi.framework;version="1.3.0" Bundle-ActivationPolicy: lazy Equinox OSGi 命令列表 1.控制框架 1.launch 启动框架 2.shutdown 停止框架 3.close 关闭、退出框架 4.exit 立即退出,相当于 System.exit 5.init 卸载所有 bundle(前提是已经 shutdown) 6.setprop 设置属性,在运行时进行 2.控制 Bundle 1.Install 安装 uninstall 卸载 2.Stop 停止 3.Refresh 刷新 4.Update 更新 3.展示状态 1.Status 展示安装的 bundle 和注册的服务 2.Ss 展示所有 bundle 的简单状态 3.Services 展示注册服务的详细信息 4.Packages 展示导入、导出包的状态 5.Bundles 展示所有已经安装的 bundles 的状态 6.Headers 展示 bundles 的头信息,即 MANIFEST.MF 中的内容 7.Log 展示 LOG 入口信息 4.其他 Exec 在另外一个进程中执行一个命令(阻塞状态) 1.Fork 和 EXEC 不同的是不会引起阻塞 2.Gc 促使垃圾回收 3.Getprop 得到属性,或者某个属性 5.控制启动级别 1.Sl 得到某个 bundle 或者整个框架的 start level 信息 2.Setfwsl 设置框架的 start level 3.Setbsl 设置 bundle 的 start level 4.setibsl 设置初始化 bundle 的 start level

优秀的个人博客,低调大师

JVM笔记10-性能优化之高级特性

一.垃圾回收器配置和 GC 日志分析 1.堆典型配置: 32位的操作系统限制堆大小介于1.5G到2G,64位操作系统无限制,同时系统可用虚拟内存和可用物理内存都会限制最大堆的配置。 堆空间分配典型配置: 1.-Xms:初始堆大小 2.-Xmx:最大堆大小 3.-XX:NewSize=n:设置年轻代大小 4.-XX:NewRatio=n:设置年轻代和年老代的比值。如 n 为 2,表示年轻代与年老代比值为 1:2,年轻代占整个年轻代年老代和的 1/3 5.-XX:SurvivorRatio=n:年轻代中 Eden 区与两个 Survivor 区的比值。注意 Survivor 区有两个。如 n 为 2,表示 Eden:Survivor=1:2,一个 Survivor 区占整个年轻代的 1/4 6.-XX:MaxMetaspaceSize=:设置最大化元空间大小 7.XX:MetaspaceSize=64m 初始化元空间大小; 8.-Xmn2g:设置年轻代大小为 2G。整个 JVM 内存大小 = 年轻代大小 + 年老代大小 + 持久代大小。持久代一般固定大小为 64m,所以增大年轻代后,将会减小年老代大小。此值对系统性能影响较大,Sun 官方推荐配置为整个堆的 3/8。 9.-Xss128k:设置每个线程的栈大小。JDK5.0 以后每个线程堆栈大小为 1M,以前每个线程堆栈大小为 256K。在相同物理内存下,减小这个值能生成更多的线程。但是操作系统对一个进程内的线程数还是有限制的在 3000~5000 间。 10.-XX:SurvivorRatio=4:设置年轻代中 Eden 区与 Survivor 区的大小比值。 11.-XX:MaxMetaspaceSize=16m:设置元空间大小为 16m。 12.-XX:MaxTenuringThreshold=0:设置年轻代最大年龄。如果设置为 0 的话,则年轻代对象不经过 Survivor 区,直接进入年老代。对于年老代比较多的应用,可以提高效率。如果将此值设置为一个较大值,则年轻代对象会在 Survivor 区进行多次复制,这样可以增加对象再年轻代的存活时间,增加在年轻代即被回收的概率。 13.-XX:+DisableExplicitGC:这个将会忽略手动调用 GC 的代码使得 System.gc() 的调用就会变成一个空调用,完全不会触发任何 GC -Xmx5120m –Xms5120m -Xmn2g -Xss128k -XX:NewRatio=4 -XX:SurvivorRatio=4 -XX:MaxMetaspaceSize=16m -XX:MaxTenuringThreshold=0 2.垃圾回收器配置: 1.Serial 收集器: -XX:MaxTenuringThreshold默认值是 15,新生代对象晋升为老年代对象需要经过 15 次 GC。 2.ParNew 收集器: -XX:MaxTenuringThreshold默认值是 15,新生代对象晋升为老年代对象需要经过 15 次 GC。 -XX:UseAdaptiveSizePolicyJVM 根据运行参数,动态调整堆空间大小及晋升年龄值。 3.Parallel Scavenge/Parallel Old 收集器: -XX:ParallelGCThreads 设置并发收集器年轻代收集方式为并行收集时,使用的CPU数。并行收集线程数。 -XX:UseAdaptiveSizePolicy JVM根据运行参数,动态调整堆空间大小及晋升年龄值 -XX:MaxTenuringThreshold 默认值是15,新生代对象晋升为老年代对象需要经过15次GC -XX:GCTimeRatio 设置垃圾回收时间占程序运行时间的百分比(默认99),公式为1/(1+n) -XX:MaxGCPauseMillis 设置并行收集最大暂停时间。 4.CMS 收集器: -XX:ParallelCMSThreads 垃圾收集器线程数 -XX:CMSFullGCsBeforeCompaction CMS 采用标记-清理算法,会产生内存碎片,配置执行多少次 FullGC 后对内存进行整理。 -XX:UseCMSCompactAtFullCollection 配置 FullGC 后是否立即整理内存碎片。 -XX:CMSInitiatingOccupancyFraction 配置老年代内存使用率达到多少后进行内存回收( JDK6 及以上版本默认值 92%)。 -XX:CMSInitiatingOccupancyOnly 默认 false,不允许 HostSpot 根据成本自行进行决定何时进行垃圾回收。 -XX:CMSClassUnloadingEnabled 配置方法区使用 CMS 进行垃圾回收。 -XX:+CMSIncrementalMode 设置为增量模式,适用于单 CPU 情况。 -XX:+PrintGCApplicationStoppedTime 打印程序 Stop-the-World 的暂停时间。 5.G1 收集器: -XX:G1ReservePercent 默认值 10%,预留的空闲空间的百分比。 -XX:G1HeapRegionSize 配置 Region 块的大小,范围 1MB 到 32MB,设置后会根据最小堆 Java 堆内存划分出 2048 个 Region 块。 3.垃圾收集统计配置: -XX:+PrintGC -XX:+PrintGCDetails -XX:+PrintGCTimeStamps:可与上面参数一起使用 -XX:+PrintGCApplicationConcurrentTime:打印每次垃圾回收前,程序未中断的执行时间,可与上面参数一起使用 -XX:+PrintGCApplicationStoppedTime:打印垃圾回收期间程序暂停的时间,可与上面参数一起使用 -XX:PrintHeapAtGC:打印 GC 前后的详细堆栈信息 -Xloggc:filename:与上面几个配合使用,把日志信息记录到文件来分析 通过设定 -XX:+UseG1GC 在整个 Java 堆使用 G1 进行垃圾回收 通过 -XX:+UseConcMarkSweepGC 设定新生代使用 ParNew(并发复制)收集器,老年代使用 CMS Concurrent Mark-Sweep(并发标记清除)收集器执行内存回收 通过 -XX:+UseParallelOldGC 手动指定新生代使用 Parallel Scavenge(并行复制)收集器,老年代使用 Parallel Old(并行标记-压缩)收集器执行内存回收 通过 -XX:+UseSerialGC 手动指定新生代使用 Serial Coping(串行复制)收集器,老年代使用 Serial Old (串行标记-清理-压缩)收集器执行内存回收 通过 -XX:+UseParNewGC 手动指定新生代使用 ParNew(并发复制)收集器,老年代使用 Serial Old (串行标记-清理-压缩)收集器执行内存回收 通过 -XX:+UseParallelGC 手动指定新生代使用 Parallel Scavenge(并行复制)收集器,老年代使用 Serial Old (串行标记-清理-压缩)收集器执行内存回收 4.GC日志分析 /** * Created by cong on 2018/8/1. * * 堆溢出 * 通过run configurations配置下列参数 * VM Args:-Xms20M -Xmx20M -Xmn10M -XX:+PrintGCDetails * -XX:SurvivorRatio=8 -XX:+UseSerialGC * -XX:+HeapDumpOnOutOfMemoryError * 参数-XX:+HeapDumpOnOutOfMemoryError可以让虚拟机在出现内存溢出异常时Dump出当前的内存堆转储快照以便事后进行分析,文件在项目中lib目录的外层目录下 */ public class HeapOutOfMemory { static class OutOfMemoryObject { } public static void main(String[] args) { List<OutOfMemoryObject> list = new ArrayList<OutOfMemoryObject>(); while (true) { list.add(new OutOfMemoryObject()); } } } 在IDE上面配置虚拟机参数,如下: 然后点击 run,如果报错,那就是虚拟机参数里带了中文标点或者参数名字错了,使用 Serial Coping(串行复制)/Serial Old (串行标记-清理-压缩)组合打印的日志,日志跟下面的使用 -XX:+UseParallelOldGC 打印的日志类似,参考下面 Parallel 的日志分析。 -XX:+UseParNewGC 使用 ParNew(并发复制)/Serial Old (串行标记-清理-压缩),日志跟下面的使用 -XX:+UseParallelOldGC 打印的日志类似,参考下面 Parallel 的日志分析。 -XX:+UseParallelOldGC 使用 Parallel Scavenge(并行复制)/ Parallel Old(并行标记-压缩) 。日志分析如下: [GC [PSYoungGen: 7469K->1016K(9216K)] 7469K->5241K(19456K), 0.0110178 secs] [Times: user=0.05 sys=0.02, real=0.01 secs] /* * [PSYoungGen: 7469K->1016K(9216K)] PSYoungGen在新生代发生Minor * GC,回收前内存占用7469K,回收后内存占用1016K,新生代的总内存大小 7469K->5241K(19456K) * Java整个堆空间的内存占用变化,回收前7469K,回收 后5241K,整个堆19456K 0.0110178 secs,整个Minor * GC耗时多少秒,[Times: user=0.05 sys=0.02, real=0.01 secs] user程序耗时,sys系统耗时,real实际耗时 * 多少秒 */ [GC-- [PSYoungGen: 9208K->9208K(9216K)] 13433K->19440K(19456K), 0.0166318 secs] [Times: user=0.02 sys=0.00, real=0.02 secs] [Full GC [PSYoungGen: 9208K->0K(9216K)] [ParOldGen: 10232K->10207K(10240K)] 19440K->10207K(19456K) [PSPermGen: 2632K->2631K(21504K)], 0.1698064 secs] [Times: user=0.34 sys=0.00, real=0.17 secs] [Full GC [PSYoungGen: 7735K->7728K(9216K)] [ParOldGen: 10207K->8097K(10240K)] 17942K->15826K(19456K) [PSPermGen: 2631K->2631K(21504K)], 0.1632131 secs] [Times: user=0.42 sys=0.00, real=0.15 secs] /* * Full GC代码整个堆的GC,PSYoungGen新生代内存使用变化,ParOldGen老年代内存使用变化,PSPermGen永久代内存使用变化,0. * 1632131 secs本次Full GC消耗多少秒,Times: user=0.42 sys=0.00, real=0.15 secs 本次Full * GC各种时间消耗,所有参数含义跟上面一样。 */ [Full GC [PSYoungGen: 7728K->7728K(9216K)] [ParOldGen: 8097K->8089K(10240K)] 15826K->15818K(19456K) [PSPermGen: 2631K->2631K(21504K)], 0.0952587 secs] [Times: user=0.33 sys=0.02, real=0.10 secs] java.lang.OutOfMemoryError: Java heap space // 生成的堆快照文件java_pid26276.hprof,在lib目录下 Dumping heap to java_pid26276.hprof ... -XX:+UseConcMarkSweepGC 使用ParNew(并发复制)/ CMS Concurrent Mark-Sweep(并发标记清除),日志如下: [GC[ParNew: 7469K->1024K(9216K), 0.0339335 secs] 7469K->7079K(19456K), 0.0339810 secs] [Times: user=0.06 sys=0.00, real=0.03 secs] // 新生代使用ParNew做垃圾回收,参数含义跟上面分析的一样 Total time for which application threads were stopped: 0.0341067 seconds /* 程序暂停时间0.0341067秒,-XX:+PrintGCApplicationStoppedTime打印程序Stop-the-World的暂停时间 */ [GC[ParNew: 9216K->9216K(9216K), 0.0000205 secs][CMS: 6055K->8941K(10240K), 0.0319501 secs] 15271K->13881K(19456K), [CMS Perm : 2630K->2629K(21248K)], 0.0320168 secs] [Times: user=0.03 sys=0.00, real=0.03 secs] Total time for which application threads were stopped: 0.0321285 seconds [GC [1 CMS-initial-mark: 8941K(10240K)] 13881K(19456K), 0.0035077 secs] [Times: user=0.02 sys=0.00, real=0.01 secs] /*CMS初始标记,老年代内存占用大小8941K,总大小10240K,标记跟根对象集合直接相连接的对象的可达性*/ Total time for which application threads were stopped: 0.0035747 seconds [Full GC[CMS[CMS-concurrent-mark: 0.011/0.011 secs] [Times: user=0.01 sys=0.00, real=0.01 secs] //并发标记,从上次初始标记对象出发,标记垃圾对象和可回收对象 (concurrent mode failure): 8941K->8940K(10240K), 0.0385219 secs] 14326K->13896K(19456K), [CMS Perm : 2632K->2632K(21248K)], 0.0385659 secs] [Times: user=0.03 sys=0.00, real=0.03 secs] /* * 并发标记期间,新生成的对象在老年代无法有足够的内存容纳,产生concurrent mode * failure,老年代改用串行收集器,如果不产生concurrent mode * failure,后面还有CMS-remark,做最终标记,修正标记,会有暂停时间和内存占用和总内存,最后就是CMS-cocurrent-sweep, * 并发清除,会有清除耗时 */ Total time for which application threads were stopped: 0.0387397 seconds 接着我们将上面的例子进行改造,改造如下: /** * Created by cong on 2018/8/1. * * 堆溢出 * 通过run configurations配置下列参数 * VM Args:-Xms20M -Xmx20M -Xmn10M -XX:+PrintGCDetails * -XX:SurvivorRatio=8 -XX:+UseConcMarkSweepGC * -XX:+HeapDumpOnOutOfMemoryError * 参数-XX:+HeapDumpOnOutOfMemoryError可以让虚拟机在出现内存溢出异常时Dump出当前的内存堆转储快照以便事后进行分析,文件在项目中lib目录的外层目录下 */ public class HeapOutOfMemory { static class OutOfMemoryObject { public byte[] spaceSize = new byte[1024 * 1024]; // 产生1024*1024个字节,也就是1024*1KB的内存 ,大小1MB } public static void creatHeap(int num) throws Exception { ArrayList<OutOfMemoryObject> list = new ArrayList<OutOfMemoryObject>(); for (int i = 0; i < num; i++) { list.add(new OutOfMemoryObject()); } System.gc(); } public static void main(String[] args) throws Exception { while (true) { creatHeap(99); } } } 运行结果的,日志分析如下: [GC[ParNew: 8111K->8111K(9216K), 0.0000122 secs][CMS: 7176K->9216K(10240K), 0.0104259 secs] 15287K->14839K(19456K), [CMS Perm : 2632K->2632K(21248K)], 0.0104885 secs] [Times: user=0.01 sys=0.00, real=0.01 secs] Total time for which application threads were stopped: 0.0106245 seconds [GC [1 CMS-initial-mark: 9216K(10240K)] 15863K(19456K), 0.0004189 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] Total time for which application threads were stopped: 0.0006342 seconds [Full GC[CMS[CMS-concurrent-mark: 0.002/0.002 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] (concurrent mode failure): 9216K->9216K(10240K), 0.0043732 secs] 16947K->16887K(19456K), [CMS Perm : 2632K->2632K(21248K)], 0.0044245 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] java.lang.OutOfMemoryError: Java heap space Dumping heap to java_pid1264.hprof ... Total time for which application threads were stopped: 0.0171680 seconds Heap dump file created [17857505 bytes in 0.018 secs] [GC [1 CMS-initial-mark: 9216K(10240K)] 16876K(19456K), 0.0005822 secs] [Times: user=0.02 sys=0.00, real=0.00 secs] Total time for which application threads were stopped: 0.0014073 seconds [CMS-concurrent-mark: 0.002/0.002 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] [CMS-concurrent-preclean: 0.001/0.001 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] [CMS-concurrent-abortable-preclean: 0.000/0.000 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] [GC[YG occupancy: 7863 K (9216 K)][Rescan (parallel) , 0.0002252 secs][weak refs processing, 0.0000048 secs][scrub string table, 0.0001071 secs] [1 CMS-remark: 9216K(10240K)] 17079K(19456K), 0.0003718 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] /* * CMS-remark,做最终标记,修正标记,老年代已用内存9216K,总内存10240K,耗时 0.0003718 */ Total time for which application threads were stopped: 0.0005235 seconds [CMS-concurrent-mark: 0.002/0.002 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] /* * CMS-cocurrent-sweep,并发清除耗时0.002秒 */ 通过设定 -XX:+UseG1GC 在整个 Java 堆使用 G1 进行垃圾回收,日志分析如下: [GC pause (young) (initial-mark), 0.0028719 secs] [Parallel Time: 2.2 ms, GC Workers: 4] [GC Worker Start (ms): Min: 168.7, Avg: 168.8, Max: 168.9, Diff: 0.2] [Ext Root Scanning (ms): Min: 0.9, Avg: 1.1, Max: 1.5, Diff: 0.6, Sum: 4.6] [Update RS (ms): Min: 0.0, Avg: 0.0, Max: 0.0, Diff: 0.0, Sum: 0.0] [Processed Buffers: Min: 0, Avg: 2.0, Max: 8, Diff: 8, Sum: 8] [Scan RS (ms): Min: 0.0, Avg: 0.0, Max: 0.0, Diff: 0.0, Sum: 0.0] [Object Copy (ms): Min: 0.1, Avg: 0.3, Max: 0.5, Diff: 0.4, Sum: 1.3] [Termination (ms): Min: 0.0, Avg: 0.4, Max: 0.5, Diff: 0.5, Sum: 1.4] [GC Worker Other (ms): Min: 0.0, Avg: 0.0, Max: 0.0, Diff: 0.0, Sum: 0.1] [GC Worker Total (ms): Min: 1.6, Avg: 1.8, Max: 2.0, Diff: 0.4, Sum: 7.3] [GC Worker End (ms): Min: 170.3, Avg: 170.6, Max: 170.8, Diff: 0.5] [Code Root Fixup: 0.0 ms] [Clear CT: 0.1 ms] [Other: 0.6 ms] [Choose CSet: 0.0 ms] [Ref Proc: 0.5 ms] [Ref Enq: 0.0 ms] [Free CSet: 0.0 ms] [Eden: 1024.0K(10.0M)->0.0B(9216.0K) Survivors: 0.0B->1024.0K Heap: 4857.6K(20.0M)->4720.2K(20.0M)] [Times: user=0.00 sys=0.00, real=0.00 secs] Total time for which application threads were stopped: 0.0036639 seconds // 初始标记以及暂停时间0.0036639 seconds [GC concurrent-root-region-scan-start] [GC concurrent-root-region-scan-end, 0.0005495 secs] // 扫描根region,耗时0.0005495 secs [GC concurrent-mark-start] [GC concurrent-mark-end, 0.0004523 secs] // 并发标记,耗时0.0004523 secs [GC remark [GC ref-proc, 0.0000279 secs], 0.0006380 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] Total time for which application threads were stopped: 0.0008879 seconds [GC cleanup 6809K->6809K(20M), 0.0006380 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] // 清除阶段 Total time for which application threads were stopped: 0.0006810 seconds [GC pause (young) (to-space exhausted), 0.0044659 secs] [Parallel Time: 4.0 ms, GC Workers: 4] [GC Worker Start (ms): Min: 176.6, Avg: 176.6, Max: 176.6, Diff: 0.0] //Parallel Time 并行处理的部分占用时间,Worker Start – 工作线程启动的时刻 [Ext Root Scanning (ms): Min: 0.3, Avg: 0.3, Max: 0.3, Diff: 0.1, Sum: 1.1] //External root scanning 扫描外部根锁使用的时间 [Update RS (ms): Min: 0.0, Avg: 0.0, Max: 0.0, Diff: 0.0, Sum: 0.0] //Update Remembered Set 开始前更新缓存列表,后续并发线程可以正确处理 [Processed Buffers: Min: 0, Avg: 0.5, Max: 2, Diff: 2, Sum: 2] [Scan RS (ms): Min: 0.0, Avg: 0.0, Max: 0.0, Diff: 0.0, Sum: 0.0] //Scanning Remembered Sets 查询指向收集区域的指针. [Object Copy (ms): Min: 2.6, Avg: 3.4, Max: 3.7, Diff: 1.1, Sum: 13.6] //Object copy 每个独立线程复制和消亡对象锁花费的时间 [Termination (ms): Min: 0.0, Avg: 0.3, Max: 1.1, Diff: 1.1, Sum: 1.2] //Termination time 当一个工作线程结束了它对特定对象的复制和扫描 [GC Worker Other (ms): Min: 0.0, Avg: 0.0, Max: 0.0, Diff: 0.0, Sum: 0.0] [GC Worker Total (ms): Min: 4.0, Avg: 4.0, Max: 4.0, Diff: 0.0, Sum: 15.9] //GC Worker Total– 所有GC线程所使用的时间 [GC Worker End (ms): Min: 180.6, Avg: 180.6, Max: 180.6, Diff: 0.0] [Code Root Fixup: 0.0 ms] [Clear CT: 0.0 ms] [Other: 0.4 ms] [Choose CSet: 0.0 ms] [Ref Proc: 0.0 ms] [Ref Enq: 0.0 ms] [Free CSet: 0.0 ms] //释放那些已经被收集过的区域,remembered sets所花费的时间 [Eden: 1024.0K(9216.0K)->0.0B(10.0M) Survivors: 1024.0K->0.0B Heap: 9901.8K(20.0M)->9901.8K(20.0M)] [Times: user=0.00 sys=0.00, real=0.00 secs] Total time for which application threads were stopped: 0.0046272 seconds [Full GC 9901K->9719K(20M), 0.0030929 secs] [Eden: 0.0B(10.0M)->0.0B(10.0M) Survivors: 0.0B->0.0B Heap: 9901.8K(20.0M)->9719.5K(20.0M)] [Times: user=0.00 sys=0.00, real=0.00 secs] [Full GC 9719K->9708K(20M), 0.0028649 secs] [Eden: 0.0B(10.0M)->0.0B(10.0M) Survivors: 0.0B->0.0B Heap: 9719.5K(20.0M)->9708.5K(20.0M)] [Times: user=0.00 sys=0.00, real=0.00 secs] Total time for which application threads were stopped: 0.0060723 seconds java.lang.OutOfMemoryError: Java heap space Dumping heap to java_pid11772.hprof ... Total time for which application threads were stopped: 0.0118791 seconds Heap dump file created [10622284 bytes in 0.012 secs] Exception in thread "main" java.lang.OutOfMemoryError: Java heap space at com.jvm.outofmemory.HeapOutOfMemory$OutOfMemoryObject.<init>(HeapOutOfMemory.java:14) at com.jvm.outofmemory.HeapOutOfMemory.creatHeap(HeapOutOfMemory.java:21) at com.jvm.outofmemory.HeapOutOfMemory.main(HeapOutOfMemory.java:28) Heap garbage-first heap total 20480K, used 9708K [0x00000000f9a00000, 0x00000000fae00000, 0x00000000fae00000) region size 1024K, 1 young (1024K), 0 survivors (0K) compacting perm gen total 20480K, used 2663K //region 大小1M,一个年轻代region,没有幸存代region [0x00000000fae00000, 0x00000000fc200000, 0x0000000100000000) the space 20480K, 13% used [0x00000000fae00000, 0x00000000fb099cd0, 0x00000000fb099e00, 0x00000000fc200000) No shared spaces configured. 5.异常信息: 1.java.lang.OutOfMemoryError: PermGen space:永久代被占满,无法为 class 字节码文件分配空间,现在反射,动态代理使用越来越多,字节码插桩技术可以在类加载的前后插入自定义的内容,这些都会增大永久代的占用。 2.java.lang.OutOfMemoryError: Java heap space:内存泄漏 3.java.lang.StackOverflowError:栈空间溢出,通常是栈帧深度过深,如递归调用没有出口,造成死循环。 4.Fatal: Stack size too small:线程栈爆满,通常是方法体代码过多造成,可以通过拆分方法,让方法职责单一避免溢出,也可以通过 -Xss 增大线程栈空间。 6.Java引用类型: 1.强引用:强引用指向的对象在任何时候都不会被系统回收。即使当内存不足时,VM宁愿抛出内存不足的异常,也不会去回收这些对象。 使用场景:我们平常大部分使用的场景都是使用了强引用,比如new创建对象,反射获得一个对象等。如下: Object obj = new Object(); 2.软引用:一个持有软引用的对象,不会被 JVM 很快地回收,JVM 会根据当前堆的使用情况来判断何时回收。(通常用于缓存),如果内存空间不足时,就会回收这些对象的内存。 软引用还可以和一个引用队列进行关联,如果这个软引用的对象被垃圾回收,那么JVM就会将这个软引用加入到关联的队列中去。 使用场景:这种可用于那种有可能会在创建后使用的对象,不过为了内存消耗会选择使用软引用,比如缓存。如下所示: String cache = "{a=1,b=2,c=3,d=4}"; SoftReference<String> stringSoftReference = new SoftReference<String>(cache); System.out.println(cache); 3.弱引用:在系统 GC 时,只要发现弱引用,不管系统队空间是否足够,都会将对象进行回收。弱引用和软引用的区别在于,只具有弱引用的对象拥有更短暂的生命周期,在垃圾回收器线程扫描它管辖的内存区域的过程中,一旦发现对象只具有弱引用,不管当前内存空间是否足够,都会回收他的内存。它比软引用的生命周期更短,和软引用相似,它同样可以和引用队列关联,如果被垃圾回收了,就会加入到这个关联队列中。 使用场景:弱引用用于生命周期更短的,对内存更敏感的场景中,比如占用内存很大的Map,java api中就提供了WeakHashMap使用,就会是的大Map被及时清理掉。如下: WeakHashMap<String,Bean> weakHashMap = new WeakHashMap<>(); weakHashMap.put("a",new Bean(1)); weakHashMap.put("b",new Bean(2)); weakHashMap.put("c",new Bean(3)); System.out.println(weakHashMap); 4.虚引用:和没有引用几乎一样。虚引用”形同虚设,与其他几种引用都不同,虚引用并不会决定对象的生命周期,如果一个对象仅持有虚引用的话,那么它就和没有任何的引用一样,在任何时候都可能被垃圾回收器回收。虚引用必须和引用队列联合使用,引用队列的作用和软弱引用一样。 使用场景:我觉得他的使用场景应该在判断一个对象是否被垃圾回收了。例子如下: String name = "a"; ReferenceQueue<String> prq = new ReferenceQueue<>(); PhantomReference<String> nameRf = new PhantomReference<>(name, prq); System.out.println(prq.poll()); 接下来进行一个例子演示Java的引用类型,如下: package com; import java.util.ArrayList; import java.util.List; import java.util.Map; import java.util.WeakHashMap; /** * Created by cong on 2018/8/5. */ public class WeakReference { // 弱引用 public static Map map = new WeakHashMap(); // 强引用 public static List list = new ArrayList(); public static void main(String[] args) { for (int i = 0; i < 999; i++) { Integer j = new Integer(i); // j强引用 list.add(j); // 存放在weakHashMap中的key都存在强引用,那么weakHashMap就退化为HashMap,即强引用 map.put(j, new byte[i]); // 当内存足不足时,会报OutOfMemoryError,因为存在j强引用,没有被使用的map存在的垃圾却无法被清理,造成内存泄漏 } // //把for循环替换成 // for(int i=0;i<999;i++){ // Integer k = new Integer(i); // map.put(k,new byte[i]); // //当内存不足时,会被自动回收,weakHashMap 会在内存紧张时,自动释放持有弱引用的数据 // } } } 二.JVM 问题排查 1.CPU 使用率过高时: 通过 top 命令查看服务器的负载情况 通过top+H查看线程的使用情况 通过jstat -gcutil pid查看具体线程的 GC 前后内存变化(pid的地方用进程号代替) ps -mp pid -o THREAD,tid,time查看线程列表 printf "%x\n" tid将 tid 转换成 16 进制格式 jstack pid |grep tid -A 60打印线程(转换后 16 进制格式的数字)tid 的堆栈信息 通常计算密集型应用产生死锁或者死循环或超时重试导致的线程堆积都会占用 CPU 大量资源,CPU 使用率可能达到 200% 2.线上频繁 Full GC: 1.通过top+H查看线程的使用情况 2.jmap -histo:live pid(进程号) 这个会立即触发 Full GC 3.线上开启了-XX:+HeapDumpBeforeFullGC也就是 FullGC 前保存内存快照,JVM 在执行 dump 操作的时是会发生 stop the word,此时所有的用户线程都会暂停运行。为了对外能正常提供服务,可用分布式部署,匹配负载均衡 4.通过 MAT(Memory Analyzer Tool)分析内存快照,把 “Keep unreachable objects” 勾上,否则 MAT 会把堆中不可达的对象去除掉,反而不利于分析, 通过-XX:+HeapDumpOnOutOfMemoryError可以让虚拟机在出现内存溢出异常时 Dump 出当前的内存堆转储快照,然后看到 GC 日志Dumping heap to java_pid11772.hprof ...,我们可以在工程目录里打开 pid11772.hprof 日志文件(在 Eclipse 应用市场下载 Memory Analyzer Tool 插件并安装,就可以直接打开) 5.查看Dominator Tree选项,内存中所有对象都按照内存消耗排名从高到低进行排序 Class Name 是 Java 类的全限定名 Shallow Heap 是对象本身消耗内存大小。 Retained Heap 是对象本身和它所引用的对象的内存大小总和。 Percenttage 是对象消耗占整个堆快照的比率。 6.查看是否使用了大对象,或者长期持有对象的引用,或者大量堆积了全局的本地缓存 电商平台,在做活动促销时,瞬间有大量的客户登录,但是登录页面假死,造成登录失败,在服务器的 log 日志发现大量的超时信息,报线程耗尽,通过jstack pid打印进程中线程堆栈信息发现有上百个 thread 不断的重试发送请求,基本定位是大量超时请求重试导致服务器高负荷运行而假死。 我们把服务端提供者登录接口的线程并发数从 10 调成 15,并把消费者重试次数改为 0,请求失败后直接返回,让用户的客户端 Http 进行重试,同时在登录时关闭 Druid 的 SQL 监控功能,避免增加额外资源消耗,最后重新上线,问题修复。 JVM 生产监控的指标有哪些? 关于 GC 的监控,我认为最重要的三点为: 各个区的容量。 Full GC、Young GC 发生的次数。 当前系统的内存比、CPU 使用率。 我们以 java/bin/jstat 为例看看相关的参数细节有哪些。 数据列 描述 支持的jstat 选项 S0C Survivor0的当前容量 -gc -gccapacity -gcnew -gcnewcapacity S1C S1的当前容量 -gc -gccapacity -gcnew -gcnewcapacity S0U S0的使用量 -gc-gcnew S1U S1的使用量 -gc-gcnew EC Eden区的当前容量 -gc -gccapacity -gcnew -gcnewcapacity EU Eden区的使用量 -gc -gcnew OC old区的当前容量 -gc -gccapacity -gcnew -gcnewcapacity OU old区的使用量 -gc-gcnew PC 方法区的当前容量 -gc-gccapacity -gcold -gcoldcapacity -gcpermcapacity PU 方法区的使用量 -gc -gcold YGC Young GC次数 -gc -gccapacity -gcnew -gcnewcapacity -gcold -gcoldcapacity -gcpermcapacity -gcutil -gccause YGCT Young GC累积耗时 -gc -gcnew -gcutil -gccause FGC Full GC次数 -gc -gccapacity -gcnew -gcnewcapacity -gcold -gcoldcapacity -gcpermcapacity -gcutil -gccause FGCT Full GC累积耗时 -gc-gcold -gcoldcapacity -gcpermcapacity -gcutil -gccause GCT GC总的累积耗时 -gc -gcold -gcoldcapacity -gccapacity -gcpermcapacity -gcutil -gccause NGCMN 新生代最小容量 -gccapacity -gcnewcapacity NGCMX 新生代最大容量 -gccapacity -gcnewcapacity NGC 新生代当前容量 -gccapacity -gcnewcapacity OGCMN 老年代最小容量 -gccapacity -gcoldcapacity OGCMX 老年代最大容量 -gccapacity -gcoldcapacity OGC 老年代当前容量 -gccapacity -gcoldcapacity PGCMN 方法区最小容量 -gccapacity -gcpermcapacity PGCMX 方法区最大容量 -gccapacity -gcpermcapacity PGC 方法区当前容量 -gccapacity -gcpermcapacity PC 方法区的当前容量 -gccapacity -gcpermcapacity PU 方法区使用量 -gccapacity -gcold LGCC 上一次GC发生的原因 -gccause GCC 当前GC发生的原因 -gccause TT 存活阀值,如果对象在新生代移动次数超过此阀值,则会被移到老年代 -gcnew MTT 最大存活阀值,如果对象在新生代移动次数超过此阀值,则会被移到老年代 -gcnew DSS survivor区的理想容量 -gcnew 轻松应对 JVM 的面试和实际工作。 针对面试,建议读者保持两点: 思路清晰,说的是通的。建议读者可以根据作者整理的内容弄个简单的思路导图。 面要全,有一到两个点要细。概况起来了就三点,如下。 不同视角的内存模型、 GC 对应的4种算法。 GC 对应的5种收集器。 针对于工作,希望大家了解以下几点: 一定要知道 JDK 版本,JVM 默认参数有哪些? 我可以设置哪些?哪些是必须设置的? 可以直接参看很多容器,如 Tomcat、Jetty、Docker 的默认 JVM 参数。

优秀的个人博客,低调大师

Python可视化笔记之folium交互地图

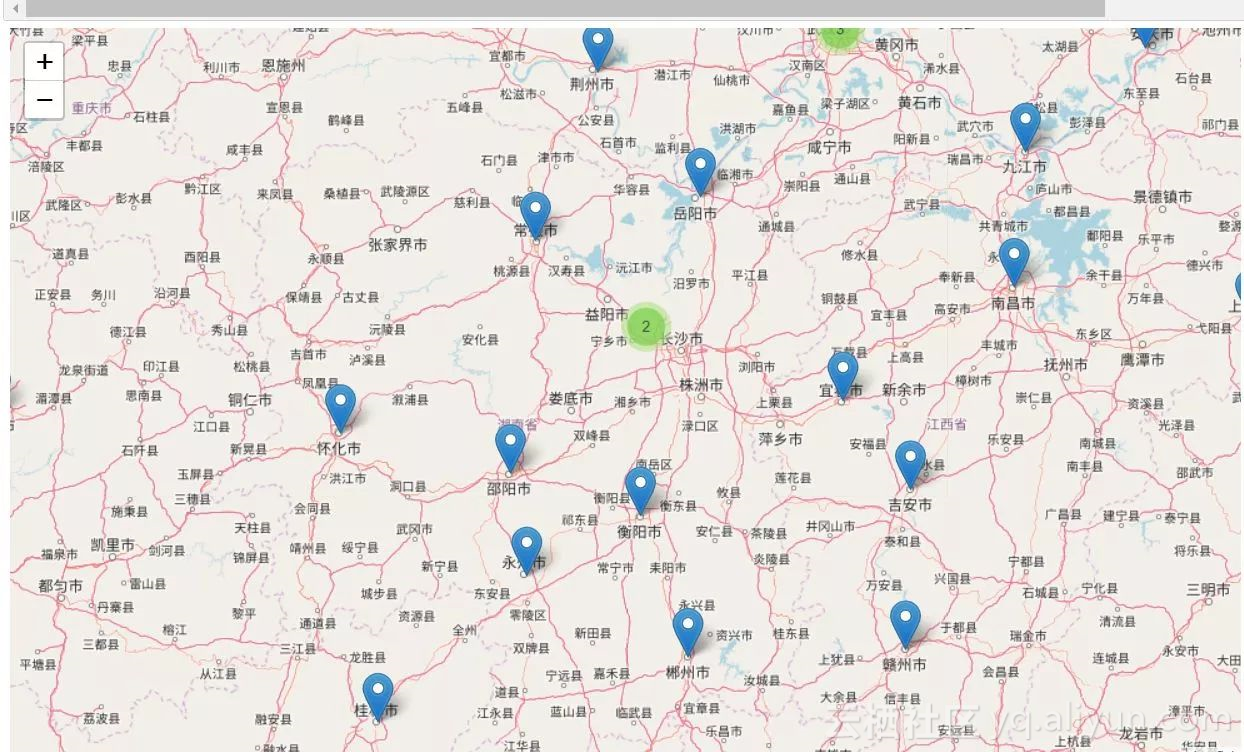
leftlet给R语言提供了很好用的交互式动态地图接口,其在Python中得API接口包名为folium(不知道包作者为何这样起名字,和leaflet已经扯不上关系了),可以满足我们平时常用的热力图、填充地图、路径图、散点标记等高频可视化场景。 本篇主要介绍其在point、line、polygon这三个地理信息场景下得应用: import pandas as pd import numpy as np import os import folium from folium import plugins import webbrowser import geopandas as gp Point: full = pd.read_excel("D:/Python/File/Cities2015.xlsx") full = full.dropna() 默认情况下folium.Marker函数用于在空间范围内标记点,点得样式是雨滴形状,但是也可以使用folium.RegularPolygonMarker函数来自定义点样式: schools_map = folium.Map(location=[full['lat'].mean(), full['lon'].mean()], zoom_start=10) marker_cluster = plugins.MarkerCluster().add_to(schools_map)for name,row in full.iterrows(): folium.Marker([row["lat"], row["lon"]], popup="{0}:{1}".format(row["cities"], row["GDP"])).add_to(marker_cluster) #folium.RegularPolygonMarker([row["lat"], row["lon"]], popup="{0}:{1}".format(row["cities"], row["GDP"]),number_of_sides=10,radius=5).add_to(marker_cluster) display(schools_map) #schools_map.save('schools_map.html') #webbrowser.open('schools_map.html') display用于在编辑器内展示交互地图,save方法可以将交互地图以html文件得形式保存至本地磁盘,webbrowser.open方法可以调用默认浏览器打开本地html格式的交互地图。 polygon: 因为leaflet使用的在线地图并不开放地址匹配功能,也就意味着我们无法通过直接输入行政区名称来获取行政区划边界,所以在制作填充地图时,仍然需要我们构建本地素材。 mydata = pd.read_csv("D:/R/rstudy/Province/geshengzhibiao.csv", encoding = 'gb18030') china_map = gp.GeoDataFrame.from_file("D:/R/rstudy/CHN_adm/bou2_4p.shp", encoding = 'gb18030') #china_map = gp.GeoDataFrame.from_file("D:/R/mapdata/State/china.geojson", encoding = 'gb18030') China_map = folium.Map(location=[35,120], zoom_start=4) China_map.choropleth( geo_data=open('D:/R/mapdata/State/china.geojson',encoding = 'utf-8').read(), data=mydata, columns=['province', 'zhibiao'], key_on= 'feature.properties.name', fill_color='YlGn', fill_opacity=0.7, line_opacity=0.2) display(China_map) China_map.save("China_map.html") 好在folium的choropleth函数直接支持json格式地图,仅需提供素材地址即可,data中应该包含与json素材中的属性表和地理信息边界保持一致得映射表,columns用于指定要用到的字段名称。key_on用于指定json地图数据中和你指定得data中对应得连接键(相当于主键)。fill_color可以指定用于配色的colorBrewer调色板。 polyline folium中得线图制作也较为简单,仅需提供给folium.PolyLine函数一组带有嵌套列表或者元组得经纬度点即可。 mydata1 =full.sample(20).loc[:,["lat","lon"]].values.tolist() mydata2 =[(i,j) for i,j in full.sample(20).loc[:,["lat","lon"]].values.tolist()] oneUserMap = folium.Map(location=[40.0764,116.2786],zoom_start=4) folium.PolyLine(mydata1,color = 'black').add_to(oneUserMap) display(oneUserMap) oneUserMap = folium.Map(location=[40.0764,116.2786],zoom_start=4) folium.PolyLine(mydata2,color = 'black').add_to(oneUserMap) display(oneUserMap) 稍微增加一些循环条件就可以构造出来实用的路径图场景: def map_fun(): myresult = full.loc[:,["lat","lon","cities","pop"]].values oneUserMap = folium.Map(location=[40.0764,116.2786],zoom_start=4) for e in myresult: folium.RegularPolygonMarker( [e[0],e[1]], popup=str(e[2])+":"+str(e[3]), fill_color='#769d96', number_of_sides=10, radius=10 ).add_to(oneUserMap) others = full.loc[full['cities']!='郑州市',["lat","lon"]].values.tolist() for i in range(len(others)): zhengzhou = full.loc[full['cities']=='郑州市',["lat","lon"]].values.tolist() zhengzhou.append(others[i]) folium.PolyLine( locations = zhengzhou, color = 'black' ).add_to(oneUserMap) display(oneUserMap) return Noneif __name__ == '__main__': map_fun() 原文发布时间为:2018-07-07本文作者: 杜雨本文来自云栖社区合作伙伴“ 数据小魔方”,了解相关信息可以关注“ 数据小魔方”

优秀的个人博客,低调大师

读书笔记-JavaScript高级程序设计(1)

1.组合继承 (JavaScript中最常用的继承模式 ) (position: page168) (书中定义了两个变量名SuperType SubType 乍一看 感觉不太能区分,我将改为 a b ,更加明显区分开来这是两个东西。) function a(name){ this.name = name; this.colors = ["red", "blue", "green"]; } a.prototype.sayName = function(){ alert(this.name);} function b(name, age){ //继承属性 a.call(this, name); this.age = age; } //继承方法 b.prototype = new a(); b.prototype.constructor = b; b.prototype.sayAge = function(){ alert(this.age); }; var instance1 = new b("Nicholas", 29); instance1.colors.push("black"); alert(instance1.colors); //"red,blue,green,black" instance1.sayName(); //"Nicholas"; instance1.sayAge(); //29 var instance2 = new b("Greg", 27); alert(instance2.colors); //"red,blue,green" instance2.sayName(); //"Greg"; instance2.sayAge(); //27 完成继承的思路: 使用原型链实现对原型属性和方法的继承, 使用构造函数来实现对实例属性的继承。 在这个例子中, a构造函数定义了两个属性: name 和 colors。 a的原型定义了一个方法 sayName()。 b构造函数在调用 a构造函数时传入了 name 参数,紧接着又定义了它自己的属性 age。然后,将 a的实例赋值给 b的原型, 然后又在该新原型上定义了方法 sayAge()。这样一来,就可以让两个不同的 b 实例既分别拥有自己属性——包括 colors 属性,又可以使用相同的方法了。 2.寄生组合式继承 (实现基于类型继承的最有效方式 ) function object(o){ function F(){} F.prototype = o; return new F(); } function inheritPrototype(subType, superType){ var prototype = object(superType.prototype); //创建对象 prototype.constructor = subType; //增强对象 subType.prototype = prototype; //指定对象 } function a(name){ this.name = name; this.colors = ["red", "blue", "green"]; } a.prototype.sayName = function(){ alert(this.name); }; function b(name, age){ a.call(this, name); this.age = age; } inheritPrototype(b, a); b.prototype.sayAge = function(){ alert(this.age); }; // 调用 var instance1 = new b("Nicholas", 29); instance1.colors.push("black"); alert(instance1.colors); //"red,blue,green,black" instance1.sayName(); //"Nicholas"; instance1.sayAge(); //29 var instance2 = new b("Greg", 27); alert(instance2.colors); //"red,blue,green" instance2.sayName(); //"Greg"; instance2.sayAge(); //27

优秀的个人博客,低调大师

spring cloud(学习笔记)微服务启动错误(1)

今天下午在启动spring cloud微服务的时候,报了这个错误: Error starting ApplicationContext. To display the auto-configuration report re-run your application with 'debug' enabled.2018-07-03 20:17:10.295 ERROR 19024 --- [ main] o.s.b.d.LoggingFailureAnalysisReporter : ***************************APPLICATION FAILED TO START*************************** Description: Cannot determine embedded database driver class for database type NONE Action: If you want an embedded database please put a supported one on the classpath. If you have database settings to be loaded from a particular profile you may need to active it (no profiles are currently active). Disconnected from the target VM, address: '127.0.0.1:55393', transport: 'socket' Process finished with exit code 1 刚开始我以为是端口被占用。果断cmd并输入netstat -aon,找半天没发现占用的端口,然后又网上看了一下, 转自:https://blog.csdn.net/Loser100/article/details/78190703?locationNum=9&fps=1 SpringBoot启动报错:Cannot determine embedded database driver class for database type NONE springboot启动时会自动注入数据源和配置jpa 解决办法一: 启动类中加入注解:@SpringBootApplication(exclude={DataSourceAutoConfiguration.class,HibernateJpaAutoConfiguration.class}) 解决方法二: 在Application.properties文件内配置数据源即可。代码如下: spring.datasource.url=jdbc:mysql://localhost:3306/test spring.datasource.username=root spring.datasource.password=123456 spring.datasource.driver-class-name=com.mysql.jdbc.Driver spring.datasource.max-idle=10 spring.datasource.max-wait=10000 spring.datasource.min-idle=5 spring.datasource.initial-size=5 我仔细的检查了一下,也加了注解,试了一下,我靠,没用啊,人生呐,真是改不完的bedug, 只好用出终极大招,拷贝我自己的代码,删除项目,从新从svn更新项目,导入运行,哎呦我去。怎么还是这问题?难道是我项目配置问题?不对啊,我其他的项目都没有问题啊。束手无策,只好求助小碗(一个认真工作的大佬); 通过反复调试,终于找到了。问题所在,pom.xml里面有一个错误的配置, <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <scope>runtime</scope> </dependency> 删了就可以运行,微服务也可以注册。配置文件请大家仔细检查。配置文件不对,什么都是扯淡。 小舟从此逝,江海寄余生。 --狐狸

优秀的个人博客,低调大师

Java并发编程笔记之StampedLock锁源码探究

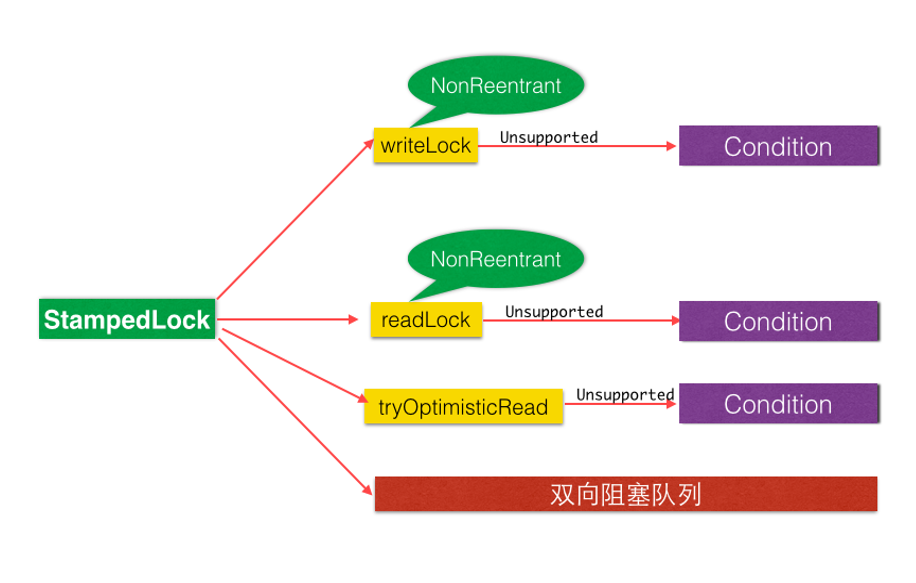
StampedLock是JUC并发包里面JDK1.8版本新增的一个锁,该锁提供了三种模式的读写控制,当调用获取锁的系列函数的时候,会返回一个long 型的变量,该变量被称为戳记(stamp),这个戳记代表了锁的状态。 try系列获取锁的函数,当获取锁失败后会返回为0的stamp值。当调用释放锁和转换锁的方法时候需要传入获取锁时候返回的stamp值。 StampedLockd的内部实现是基于CLH锁的,CLH锁原理:锁维护着一个等待线程队列,所有申请锁且失败的线程都记录在队列。一个节点代表一个线程,保存着一个标记位locked,用以判断当前线程是否已经释放锁。当一个线程试图获取锁时,从队列尾节点作为前序节点,循环判断所有的前序节点是否已经成功释放锁。 如下图所示: 我们首先看Stampedlock有哪些属性先,源码如下: private static final long serialVersionUID = -6001602636862214147L; /** 获取服务器CPU核数 */ private static final int NCPU = Runtime.getRuntime().availableProcessors(); /** 线程入队列前自旋次数 */ private static final int SPINS = (NCPU > 1) ? 1 << 6 : 0; /** 队列头结点自旋获取锁最大失败次数后再次进入队列 */ private static final int HEAD_SPINS = (NCPU > 1) ? 1 << 10 : 0; /** 重新阻塞前的最大重试次数 */ private static final int MAX_HEAD_SPINS = (NCPU > 1) ? 1 << 16 : 0; /** The period for yielding when waiting for overflow spinlock */ private static final int OVERFLOW_YIELD_RATE = 7; // must be power 2 - 1 /** 溢出之前用于阅读器计数的位数 */ private static final int LG_READERS = 7; // 锁定状态和stamp操作的值 private static final long RUNIT = 1L; private static final long WBIT = 1L << LG_READERS; private static final long RBITS = WBIT - 1L; private static final long RFULL = RBITS - 1L; private static final long ABITS = RBITS | WBIT; //前8位都为1 private static final long SBITS = ~RBITS; // 1 1000 0000 //锁state初始值,第9位为1,避免算术时和0冲突 private static final long ORIGIN = WBIT << 1; // 来自取消获取方法的特殊值,因此调用者可以抛出IE private static final long INTERRUPTED = 1L; // WNode节点的status值 private static final int WAITING = -1; private static final int CANCELLED = 1; // WNode节点的读写模式 private static final int RMODE = 0; private static final int WMODE = 1; /** Wait nodes */ static final class WNode { volatile WNode prev; volatile WNode next; volatile WNode cowait; // 读模式使用该节点形成栈 volatile Thread thread; // non-null while possibly parked volatile int status; // 0, WAITING, or CANCELLED final int mode; // RMODE or WMODE WNode(int m, WNode p) { mode = m; prev = p; } } /** CLH队头节点 */ private transient volatile WNode whead; /** CLH队尾节点 */ private transient volatile WNode wtail; // views transient ReadLockView readLockView; transient WriteLockView writeLockView; transient ReadWriteLockView readWriteLockView; /** 锁队列状态, 当处于写模式时第8位为1,读模式时前7为为1-126(附加的readerOverflow用于当读者超过126时) */ private transient volatile long state; /** 将state超过 RFULL=126的值放到readerOverflow字段中 */ private transient int readerOverflow; StampedLockd源码中的WNote就是等待链表队列,每一个WNode标识一个等待线程,whead为CLH队列头,wtail为CLH队列尾,state为锁的状态。long型即64位,倒数第八位标识写锁状态,如果为1,标识写锁占用!下面围绕这个state来讲述锁操作。 首先是常量标识: WBIT=1000 0000(即-128) RBIT =0111 1111(即127) SBIT =1000 0000(后7位表示当前正在读取的线程数量,清0) StampedLock 给我们提供了3种读写模式的锁,如下: 1.写锁writeLock是一个独占锁,同时只有一个线程可以获取该锁,当一个线程获取该锁后,其他请求读锁和写锁的线程必须等待,这跟ReentrantReadWriteLock 的写锁很相似,不过要注意的是StampedLock的写锁是不可重入锁, 当目前没有线程持有读锁或者写锁的时候才可以获取到该锁,请求该锁成功后会返回一个stamp 票据变量来表示该锁的版本,如下源码所示: /** * *获取写锁,获取失败会一直阻塞,直到获得锁成功 * @return 可以用来解锁或转换模式的戳记(128的整数) */ public long writeLock() { long s, next; return ((((s = state) & ABITS) == 0L && // 完全没有任何锁(没有读锁和写锁)的时候可以通过 U.compareAndSwapLong(this, STATE, s, next = s + WBIT)) ? //第8位置为1 next : acquireWrite(false, 0L)); } writeLock():典型的cas操作,如果STATE等于s,设置写锁位为1(s+WBIT)。acquireWrite跟acquireRead逻辑类似,先自旋尝试、加入等待队列、直至最终Unsafe.park()挂起线程。 private long acquireWrite(boolean interruptible, long deadline) { WNode node = null, p; for (int spins = -1;;) { // 入队时自旋 long m, s, ns; //无锁 if ((m = (s = state) & ABITS) == 0L) { if (U.compareAndSwapLong(this, STATE, s, ns = s + WBIT)) return ns; } else if (spins < 0) //持有写锁,并且队列为空 spins = (m == WBIT && wtail == whead) ? SPINS : 0; else if (spins > 0) { //恒成立 if (LockSupport.nextSecondarySeed() >= 0) --spins; } else if ((p = wtail) == null) { //初始化队列,写锁入队列 WNode hd = new WNode(WMODE, null); if (U.compareAndSwapObject(this, WHEAD, null, hd)) wtail = hd; } else if (node == null) //不为空,写锁入队列 node = new WNode(WMODE, p); else if (node.prev != p) node.prev = p; else if (U.compareAndSwapObject(this, WTAIL, p, node)) { p.next = node; break;//入队列成功退出循环 } } for (int spins = -1;;) { WNode h, np, pp; int ps; //前驱节点为头节点 if ((h = whead) == p) { if (spins < 0) spins = HEAD_SPINS; else if (spins < MAX_HEAD_SPINS) spins <<= 1; for (int k = spins;;) { // spin at head long s, ns; //无锁 if (((s = state) & ABITS) == 0L) { if (U.compareAndSwapLong(this, STATE, s, ns = s + WBIT)) { //当前节点设置为头结点 whead = node; node.prev = null; return ns; } } else if (LockSupport.nextSecondarySeed() >= 0 && --k <= 0) break; } } else if (h != null) { // help release stale waiters WNode c; Thread w; //头结点为读锁将栈中所有读锁线程唤醒 while ((c = h.cowait) != null) { if (U.compareAndSwapObject(h, WCOWAIT, c, c.cowait) && (w = c.thread) != null) U.unpark(w); } } // if (whead == h) { if ((np = node.prev) != p) { if (np != null) (p = np).next = node; // stale } else if ((ps = p.status) == 0) //前驱节点置为等待状态 U.compareAndSwapInt(p, WSTATUS, 0, WAITING); else if (ps == CANCELLED) { if ((pp = p.prev) != null) { node.prev = pp; pp.next = node; } } else { long time; // 0 argument to park means no timeout if (deadline == 0L) time = 0L; else if ((time = deadline - System.nanoTime()) <= 0L) return cancelWaiter(node, node, false); Thread wt = Thread.currentThread(); U.putObject(wt, PARKBLOCKER, this); node.thread = wt; if (p.status < 0 && (p != h || (state & ABITS) != 0L) && whead == h && node.prev == p) U.park(false, time); // emulate LockSupport.park node.thread = null; U.putObject(wt, PARKBLOCKER, null); if (interruptible && Thread.interrupted()) return cancelWaiter(node, node, true); } } } } 并且StampedLock还提供了非阻塞tryWriteLock方法,源码如下: /** * 没有任何锁时则获取写锁,否则返回0 * * @return 可以用来解锁或转换模式的戳记(128的整数),获取失败返回0 */ public long tryWriteLock() { long s, next; return ((((s = state) & ABITS) == 0L && U.compareAndSwapLong(this, STATE, s, next = s + WBIT)) ? next : 0L); } /** * unit时间内获得写锁成功返回状态值,失败返回0,或抛出InterruptedException * @return 0:获得锁失败 * @throws InterruptedException 线程获得锁之前调用interrupt()方法抛出的异常 */ public long tryWriteLock(long time, TimeUnit unit) throws InterruptedException { long nanos = unit.toNanos(time); if (!Thread.interrupted()) { long next, deadline; if ((next = tryWriteLock()) != 0L) //获得锁成功 return next; if (nanos <= 0L) //超时返回0 return 0L; if ((deadline = System.nanoTime() + nanos) == 0L) deadline = 1L; if ((next = acquireWrite(true, deadline)) != INTERRUPTED) //规定时间内获得锁结果 return next; } throw new InterruptedException(); } 当释放该锁的时候需要调用unlockWrite方法并传递获取锁的时候的stamp参数。源码如下: /** * state匹配stamp则释放写锁, * @throws IllegalMonitorStateException 不匹配则抛出异常 */ public void unlockWrite(long stamp) { WNode h; //state不匹配stamp 或者 没有写锁 if (state != stamp || (stamp & WBIT) == 0L) throw new IllegalMonitorStateException(); //state += WBIT, 第8位置为0,但state & SBITS 会循环,一共有4个值 state = (stamp += WBIT) == 0L ? ORIGIN : stamp; if ((h = whead) != null && h.status != 0) //唤醒继承者节点线程 release(h); } unlockWrite():释放锁与加锁动作相反。将写标记位清零,如果state溢出,则退回到初始值; 2.悲观锁readLock,是个共享锁,在没有线程获取独占写锁的情况下,同时多个线程可以获取该锁;如果已经有线程持有写锁,其他线程请求获取该锁会被阻塞,这类似ReentrantReadWriteLock 的读锁(不同在于这里的读锁是不可重入锁)。 这里说的悲观是指在具体操作数据前,悲观的认为其他线程可能要对自己操作的数据进行修改,所以需要先对数据加锁,这是在读少写多的情况下的一种考虑,请求该锁成功后会返回一个stamp票据变量来表示该锁的版本,源码如下: /** * 悲观读锁,非独占锁,为获得锁一直处于阻塞状态,直到获得锁为止 */ public long readLock() { long s = state, next; // 队列为空 && 没有写锁同时读锁数小于126 && CAS修改状态成功 则状态加1并返回,否则自旋获取读锁 return ((whead == wtail && (s & ABITS) < RFULL && U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) ? next : acquireRead(false, 0L)); } 乐观锁失败后锁升级为readLock():尝试state+1,用于统计读线程的数量,如果失败,进入acquireRead()进行自旋,通过CAS获取锁。 如果自旋失败,入CLH队列,然后再自旋,如果成功获得读锁,则激活cowait队列中的读线程Unsafe.unpark(),如果最终依然失败,则Unsafe().park()挂起当前线程。 /** * @param interruptible 是否允许中断 * @param 标识超时限时(0代表不限时),然后进入循环。 * @return next state, or INTERRUPTED */ private long acquireRead(boolean interruptible, long deadline) { WNode node = null, p; //自旋 for (int spins = -1;;) { WNode h; //判断队列为空 if ((h = whead) == (p = wtail)) { //定义 long m,s,ns,并循环 for (long m, s, ns;;) { //将state超过 RFULL=126的值放到readerOverflow字段中 if ((m = (s = state) & ABITS) < RFULL ? U.compareAndSwapLong(this, STATE, s, ns = s + RUNIT) : (m < WBIT && (ns = tryIncReaderOverflow(s)) != 0L)) //获取锁成功返回 return ns; //state高8位大于0,那么说明当前锁已经被写锁独占,那么我们尝试自旋 + 随机的方式来探测状态 else if (m >= WBIT) { if (spins > 0) { if (LockSupport.nextSecondarySeed() >= 0) --spins; } else { if (spins == 0) { WNode nh = whead, np = wtail; //一直获取锁失败,或者有线程入队列了退出内循环自旋,后续进入队列 if ((nh == h && np == p) || (h = nh) != (p = np)) break; } //自旋 SPINS 次 spins = SPINS; } } } } if (p == null) { //初始队列 WNode hd = new WNode(WMODE, null); if (U.compareAndSwapObject(this, WHEAD, null, hd)) wtail = hd; } //当前节点为空则构建当前节点,模式为RMODE,前驱节点为p即尾节点。 else if (node == null) node = new WNode(RMODE, p); //当前队列为空即只有一个节点(whead=wtail)或者当前尾节点的模式不是RMODE,那么我们会尝试在尾节点后面添加该节点作为尾节点,然后跳出外层循环 else if (h == p || p.mode != RMODE) { if (node.prev != p) node.prev = p; else if (U.compareAndSwapObject(this, WTAIL, p, node)) { p.next = node; //入队列成功,退出自旋 break; } } //队列不为空并且是RMODE模式, 添加该节点到尾节点的cowait链(实际上构成一个读线程stack)中 else if (!U.compareAndSwapObject(p, WCOWAIT, node.cowait = p.cowait, node)) //失败处理 node.cowait = null; else { //通过CAS方法将该节点node添加至尾节点的cowait链中,node成为cowait中的顶元素,cowait构成了一个LIFO队列。 //循环 for (;;) { WNode pp, c; Thread w; //尝试unpark头元素(whead)的cowait中的第一个元素,假如是读锁会通过循环释放cowait链 if ((h = whead) != null && (c = h.cowait) != null && U.compareAndSwapObject(h, WCOWAIT, c, c.cowait) && (w = c.thread) != null) U.unpark(w); //node所在的根节点p的前驱就是whead或者p已经是whead或者p的前驱为null if (h == (pp = p.prev) || h == p || pp == null) { long m, s, ns; do { //根据state再次积极的尝试获取锁 if ((m = (s = state) & ABITS) < RFULL ? U.compareAndSwapLong(this, STATE, s, ns = s + RUNIT) : (m < WBIT && (ns = tryIncReaderOverflow(s)) != 0L)) return ns; } while (m < WBIT);//条件为读模式 } if (whead == h && p.prev == pp) { long time; if (pp == null || h == p || p.status > 0) { //这样做的原因是被其他线程闯入夺取了锁,或者p已经被取消 node = null; // throw away break; } if (deadline == 0L) time = 0L; else if ((time = deadline - System.nanoTime()) <= 0L) return cancelWaiter(node, p, false); Thread wt = Thread.currentThread(); U.putObject(wt, PARKBLOCKER, this); node.thread = wt; if ((h != pp || (state & ABITS) == WBIT) && whead == h && p.prev == pp) U.park(false, time); node.thread = null; U.putObject(wt, PARKBLOCKER, null); //出现的中断情况下取消当前节点的cancelWaiter操作 if (interruptible && Thread.interrupted()) return cancelWaiter(node, p, true); } } } } for (int spins = -1;;) { //......都是类似的代码 } } 并且StampedLock还提供了非阻塞tryReadLock方法,源码如下: /** * 可以立即获得锁,则获取读锁,否则返回0 */ public long tryReadLock() { for (;;) { long s, m, next; //持有写锁返回0 if ((m = (s = state) & ABITS) == WBIT) return 0L; //读线程数 < RFULL,CAS变更状态 else if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) return next; } //将state超过 RFULL的值放到readerOverflow字段 else if ((next = tryIncReaderOverflow(s)) != 0L) return next; } } /** * unit时间内获得读锁成功返回状态值,失败返回0,或抛出InterruptedException */ public long tryReadLock(long time, TimeUnit unit) throws InterruptedException { long s, m, next, deadline; long nanos = unit.toNanos(time); if (!Thread.interrupted()) { if ((m = (s = state) & ABITS) != WBIT) { if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) return next; } else if ((next = tryIncReaderOverflow(s)) != 0L) return next; } if (nanos <= 0L) return 0L; if ((deadline = System.nanoTime() + nanos) == 0L) deadline = 1L; if ((next = acquireRead(true, deadline)) != INTERRUPTED) return next; } throw new InterruptedException(); } StampedLock的悲观读锁readLock 当释放该锁时候需要 unlockRead 并传递参数 stamp。源码如下: /** * state匹配stamp则释放读锁, */ public void unlockRead(long stamp) { long s, m; WNode h; for (;;) { //不匹配抛出异常 if (((s = state) & SBITS) != (stamp & SBITS) || (stamp & ABITS) == 0L || (m = s & ABITS) == 0L || m == WBIT) throw new IllegalMonitorStateException(); //小于最大记录数值 if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, s - RUNIT)) { if (m == RUNIT && (h = whead) != null && h.status != 0) release(h); break; } } //否则readerOverflow减一 else if (tryDecReaderOverflow(s) != 0L) break; } } 3.乐观读锁 tryOptimisticRead,是相对于悲观锁来说的,在操作数据前并没有通过 CAS 设置锁的状态,仅仅是通过位运算测试;如果当前没有线程持有写锁,则简单的返回一个非 0 的 stamp 版本信息, 获取该 stamp 后在具体操作数据前还需要调用 validate 验证下该 stamp 是否已经不可用,也就是看当调用 tryOptimisticRead 返回 stamp 后,到当前时间是否有其它线程持有了写锁,如果是那么 validate 会返回 0, 否者就可以使用该 stamp 版本的锁对数据进行操作。由于 tryOptimisticRead 并没有使用 CAS 设置锁状态,所以不需要显示的释放该锁。 该锁的一个特点是适用于读多写少的场景,因为获取读锁只是使用位操作进行检验,不涉及 CAS 操作,所以效率会高很多,但是同时由于没有使用真正的锁,在保证数据一致性上需要拷贝一份要操作的变量到方法栈,并且在操作数据时候可能其它写线程已经修改了数据, 而我们操作的是方法栈里面的数据,也就是一个快照,所以最多返回的不是最新的数据,但是一致性还是得到保障的。源码如下: /** * 获取乐观读锁,返回邮票stamp */ public long tryOptimisticRead() { long s; //有写锁返回0. 否则返回256 return (((s = state) & WBIT) == 0L) ? (s & SBITS) : 0L; } /** * 验证从调用tryOptimisticRead开始到现在这段时间内有无写锁占用过锁资源,有写锁获得过锁资源则返回false. stamp为0返回false. * @return 从返回stamp开始,没有写锁获得过锁资源返回true,否则返回false */ public boolean validate(long stamp) { //强制读取操作和验证操作在一些情况下的内存排序问题 U.loadFence(); //当持有写锁后再释放写锁,该校验也不成立,返回false return (stamp & SBITS) == (state & SBITS); } StamedLock还支持这三种锁在一定条件下进行相互转换,例如long tryConvertToWriteLock(long stamp)期望把stamp标示的锁升级为写锁,这个函数会在下面几种情况下返回一个有效的 stamp(也就是晋升写锁成功): 1.当前锁已经是写锁模式了。 2.当前锁处于读锁模式,并且没有其他线程是读锁模式 3.当前处于乐观读模式,并且当前写锁可用。 源码如下: /** * state匹配stamp时, 执行下列操作之一. * 1、stamp 已经持有写锁,直接返回. * 2、读模式,但是没有更多的读取者,并返回一个写锁stamp. * 3、有一个乐观读锁,只在即时可用的前提下返回一个写锁stamp * 4、其他情况都返回0 */ public long tryConvertToWriteLock(long stamp) { long a = stamp & ABITS, m, s, next; //state匹配stamp while (((s = state) & SBITS) == (stamp & SBITS)) { //没有锁 if ((m = s & ABITS) == 0L) { if (a != 0L) break; //CAS修改状态为持有写锁,并返回 if (U.compareAndSwapLong(this, STATE, s, next = s + WBIT)) return next; } //持有写锁 else if (m == WBIT) { if (a != m) //其他线程持有写锁 break; //当前线程已经持有写锁 return stamp; } //有一个读锁 else if (m == RUNIT && a != 0L) { //释放读锁,并尝试持有写锁 if (U.compareAndSwapLong(this, STATE, s, next = s - RUNIT + WBIT)) return next; } else break; } return 0L; } /** * state匹配stamp时, 执行下列操作之一. 1、stamp 表示持有写锁,释放写锁,并持有读锁 2 stamp 表示持有读锁 ,返回该读锁 3 有一个乐观读锁,只在即时可用的前提下返回一个读锁stamp 4、其他情况都返回0,表示失败 * */ public long tryConvertToReadLock(long stamp) { long a = stamp & ABITS, m, s, next; WNode h; //state匹配stamp while (((s = state) & SBITS) == (stamp & SBITS)) { //没有锁 if ((m = s & ABITS) == 0L) { if (a != 0L) break; else if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) return next; } else if ((next = tryIncReaderOverflow(s)) != 0L) return next; } //写锁 else if (m == WBIT) { //非当前线程持有写锁 if (a != m) break; //释放写锁持有读锁 state = next = s + (WBIT + RUNIT); if ((h = whead) != null && h.status != 0) release(h); return next; } //持有读锁 else if (a != 0L && a < WBIT) return stamp; else break; } return 0L; } 还有一个转换成乐观锁tryConvertToOptimisticRead(long stamp) ,这里就不讲了,道理都差不多。 另外StampedLock 的读写锁都是不可重入锁,所以当获取锁后释放锁前,不应该再调用会获取锁的操作,以避免产生死锁。 当多个线程同时尝试获取读锁和写锁的时候,谁先获取锁没有一定的规则,完全都是尽力而为,是随机的,并且该锁不是直接实现 Lock 或 ReadWriteLock 接口,而是内部自己维护了一个双向阻塞队列。 下面通过 JDK8 里面提供的一个管理二维点的例子讲解来加深对上面讲解的理解。代码如下所示: package com.hjc; import java.util.concurrent.locks.StampedLock; /** * Created by cong on 2018/6/16. */ public class Point { // 成员变量 private double x, y; // 锁实例 private final StampedLock sl = new StampedLock(); // 排它锁-写锁(writeLock) void move(double deltaX, double deltaY) { long stamp = sl.writeLock(); try { x += deltaX; y += deltaY; } finally { sl.unlockWrite(stamp); } } // 乐观读锁(tryOptimisticRead) double distanceFromOrigin() { // 尝试获取乐观读锁(1) long stamp = sl.tryOptimisticRead(); // 将全部变量拷贝到方法体栈内(2) double currentX = x, currentY = y; // 检查在(1)获取到读锁票据后,锁有没被其它写线程排它性抢占(3) if (!sl.validate(stamp)) { // 如果被抢占则获取一个共享读锁(悲观获取)(4) stamp = sl.readLock(); try { // 将全部变量拷贝到方法体栈内(5) currentX = x; currentY = y; } finally { // 释放共享读锁(6) sl.unlockRead(stamp); } } // 返回计算结果(7) return Math.sqrt(currentX * currentX + currentY * currentY); } // 使用悲观锁获取读锁,并尝试转换为写锁 void moveIfAtOrigin(double newX, double newY) { // 这里可以使用乐观读锁替换(1) long stamp = sl.readLock(); try { // 如果当前点在原点则移动(2) while (x == 0.0 && y == 0.0) { // 尝试将获取的读锁升级为写锁(3) long ws = sl.tryConvertToWriteLock(stamp); // 升级成功,则更新票据,并设置坐标值,然后退出循环(4) if (ws != 0L) { stamp = ws; x = newX; y = newY; break; } else { // 读锁升级写锁失败则释放读锁,显示获取独占写锁,然后循环重试(5) sl.unlockRead(stamp); stamp = sl.writeLock(); } } } finally { // 释放锁(6) sl.unlock(stamp); } } } 如上代码 Point 类里面有两个成员变量(x,y) 来标示一个点的二维坐标,和三个操作坐标变量的方法,另外实例化了一个 StampedLock 对象用来保证操作的原子性。 首先分析下 move 方法,该函数作用是使用参数的增量值,改变当前 point 坐标的位置;代码先获取到了写锁,然后对 point 坐标进行修改,然后释放锁。 该锁是排它锁,这保证了其它线程调用 move 函数时候会被阻塞,也保证了其它线程不能获取读锁,读取坐标的值,直到当前线程显示释放了写锁, 也就是保证了对变量 x,y 操作的原子性和数据一致性。 接下来再看 distanceFromOrigin 方法,该方法作用是计算当前位置到原点(坐标为 0,0)的距离,代码(1)首先尝试获取乐观读锁,如果当前没有其它线程获取到了写锁,那么(1)会返回一个非 0 的 stamp 用来表示版本信息,代码(2)拷贝坐标变量到本地方法栈里面。 代码(3)检查在(1)获取到的 stamp 值是否还有效,之所以还要在此校验是因为代码(1)获取读锁时候并没有通过 CAS 操作修改锁的状态,而是简单的通过与或操作返回了一个版本信息,这里校验是看在在获取版本信息到现在的时间段里面是否有其它线程持有了写锁,如果有则之前获取的版本信息就无效了。 这里如果校验成功则执行(7)使用本地方法栈里面的值进行计算然后返回。需要注意的是在代码(3) 校验成功后,代码(7)计算期间,其它线程可能获取到了写锁并且修改了 x,y 的值,而当前线程执行代码(7)进行计算时候采用的还是修改前值的拷贝,也就是操作的值是对之前值的一个拷贝,一个快照,并不是最新的值。 也许我们会想,代码(2) 和(3)能否互换?。 答案是明显不能的,如果位置换了,那么首先执行validate ,假设验证通过了,要拷贝x,y 值到本地方法栈,而在拷贝的过程中很有可能其他线程已经修改过了x,y 中的一个,这就造成了数据的不一致性了。 那么你可能还会这样会想,即使不交换代码 (2) 和(3),在拷贝 x,y 值到本地方法栈里面时,也会存在其他线程修改了x,y中的一个值,这不也会存在问题吗? 这个确实会存在,但是别忘记了拷贝后还有一道validate,如果这时候有线程修改了x,y 中的值,那么肯定是有线程在调用 validate 前,调用 sl.tryOptimisticRead 后获取了写锁,那么进行 validate 时候就会失败。 好了知道这么多原理后,我们就会惊叹这也是乐观读设计的精妙之处也是使用时候容易出问题的地方。下面继续分析 validate 失败后会执行代码(4)获取悲观读锁,如果这时候其他线程持有写锁则代码(4)会导致的当前线程阻塞直到其它线程释放了写锁。 如果这时候没有其他线程获取到写锁,那么当前线程就可以获取到读锁,然后执行代码(5)重新拷贝新的坐标值到本地方法栈,然后就是代码(6)释放了锁,拷贝的时候由于加了读锁,所以拷贝期间其它线程获取写锁时候会被阻塞, 这保证了数据的一致性,另外这里 x,y 没有被声明为 volatie,会不会存在内存不可见性问题那?答案是不会,因为加锁的语义保证了内存可见性, 最后代码(7)使用方法栈里面数据计算返回,同理这里在计算时候使用的数据也可能不是最新的,其它写线程可能已经修改过原来的 x,y 值了。 最后一个方法 moveIfAtOrigin 作用是如果当前坐标为原点则移动到指定的位置。代码(1)获取悲观读锁,保证其它线程不能获取写锁修改 x,y 值,然后代码(2)判断如果当前点在原点则更新坐标, 代码(3) 尝试升级读锁为写锁,这里升级不一定成功,因为多个线程都可以同时获取悲观读锁,当多个线程都执行到(3)时候只有一个可以升级成功,升级成功则返回非 0 的 stamp,否非返回 0。 这里假设当前线程升级成功,然后执行步骤(4)更新 stamp 值和坐标值,然后退出循环。如果升级失败则执行步骤(5)首先释放读锁然后申请写锁,获取到写锁后在循环重新设置坐标值。最后步骤(6) 释放锁。 使用乐观读锁还是很容易犯错误的,必须要严谨,必须要保证如下的使用顺序,用伪代码作为讲解,如下: long stamp = lock.tryOptimisticRead(); //非阻塞获取版本信息 copyVaraibale2ThreadMemory();//拷贝变量到线程本地堆栈 if(!lock.validate(stamp)){ // 校验 long stamp = lock.readLock();//获取读锁 try { copyVaraibale2ThreadMemory();//拷贝变量到线程本地堆栈 } finally { lock.unlock(stamp);//释放悲观锁 } } useThreadMemoryVarables();//使用线程本地堆栈里面的数据进行操作 总结:StampedLock 提供的读写锁与 ReentrantReadWriteLock 类似,只是前者的都是不可重入锁。但是前者通过提供乐观读锁在多线程多读的情况下提供更好的性能,这是因为获取乐观读锁时候不需要进行 CAS 操作设置锁的状态,而只是简单的测试状态。

优秀的个人博客,低调大师

《高性能Linux服务器构建实战》笔记

系统安全、故障排查、自动化运维、集群架构 1、账号安全,安装完后可以删除的账号: adm,lp,sync,shutdown,halt,news,uucp,operator,games,gopher 禁用登录功能:usermod -s /sbin/nologin nagios 2、关闭不需要的服务: anacron auditd autofs avahi-daemon avahi-dnsconfd bluetooth cpuspeed firstboot gpm haldaemon hidd ip6tables ipsec isdn lpd mcstrans messagebus netfs nfs nfslock nscd pcscd portmap readahead_early restorecond rpcgssd rpcidmapd rstatd sendmail setroubleshoot yppasswdd ypserv 系统必须运行的服务:

优秀的个人博客,低调大师

《图解服务器端网络架构》笔记

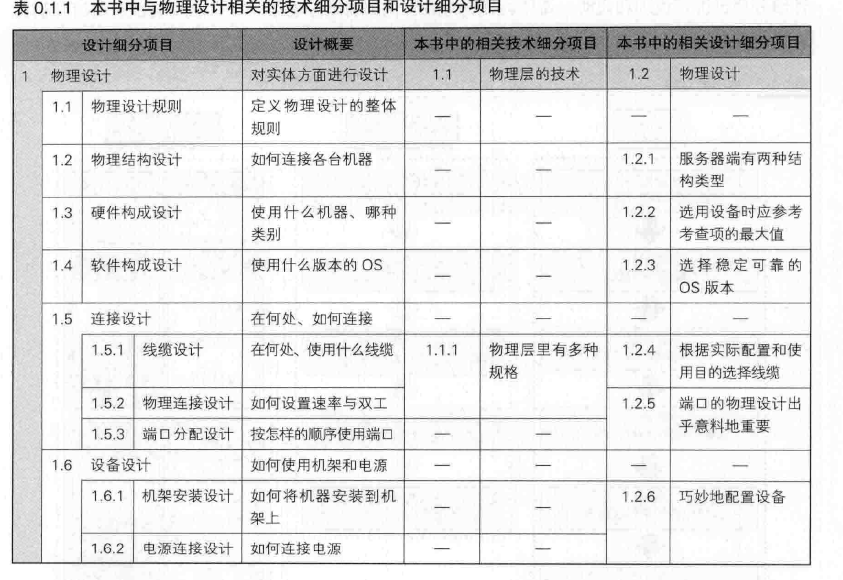
1、物理设计 以太网、WLAN 铜线、光纤 常用为LC 串联式结构 选设备时考虑:吞吐率、并发连接数、 选择光纤:远距离、高宽带、高可靠 速率和双工要一致 汇聚和核心放中间 还要考虑机架的承重 2、逻辑链路设计 DHCP 3、数据安全设计、负载均衡设计 常用端口 安全区域: 4、高可用 通过物理链路聚合成逻辑链路 多块网卡集合成一块

优秀的个人博客,低调大师

Kafka C++客户端库librdkafka笔记

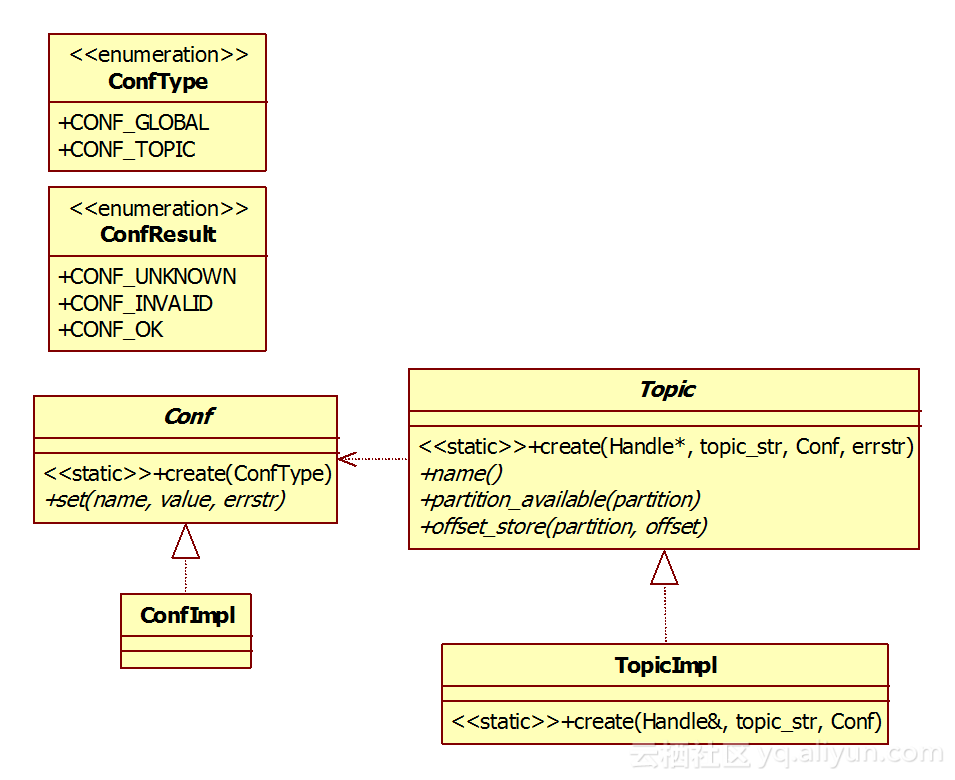
目录 目录 1 1.前言 2 2.缩略语 2 3.配置和主题 3 3.1.配置和主题结构 3 3.1.1.Conf 3 3.1.2.ConfImpl 3 3.1.3.Topic 3 3.1.4.TopicImpl 3 4.线程 4 5.消费者 5 5.1.消费者结构 5 5.1.1.Handle 5 5.1.2.HandleImpl 5 5.1.3.ConsumeCb 6 5.1.4.EventCb 6 5.1.5.Consumer 7 5.1.6.KafkaConsumer 7 5.1.7.KafkaConsumerImpl 7 5.1.8.rd_kafka_message_t 7 5.1.9.rd_kafka_msg_s 7 5.1.10.rd_kafka_msgq_t 8 5.1.11.rd_kafka_toppar_t 8 6.生产者 10 6.1.生产者结构 10 6.1.1.DeliveryReportCb 11 6.1.2.PartitionerCb 11 6.1.3.Producer 11 6.1.4.ProduceImpl 11 6.2.生产者启动过程1 11 6.3.生产者启动过程2 12 6.4.生产者生产过程 14 7.poll过程 15 1.前言 librdkafka提供的异步的生产接口,异步的消费接口和同步的消息接口,没有同步的生产接口。 2.缩略语 缩略语 缩略语全称 示例或说明 rd RapidDevelopment rd.h rk RdKafka toppar TopicPartition structrd_kafka_toppar_t { }; rep Reply, structrd_kafka_t{ rd_kafka_q_t*rk_rep }; msgq MessageQueue structrd_kafka_msgq_t{ }; rkb RdKafkaBroker Kafka代理 rko RdKafkaOperation Kafka操作 rkm RdKafkaMessage Kafka消息 payload 存在Kafka上的消息(或叫Log) 3.配置和主题 3.1.配置和主题结构 3.1.1.Conf 配置接口,配置分两种:全局的和主题的。 3.1.2.ConfImpl 配置的实现。 3.1.3.Topic 主题接口。 3.1.4.TopicImpl 主题的实现。 4.线程 RdKafka编程涉及到三类线程: 1)应用线程,业务代码的实现 2)KafkaBroker线程rd_kafka_broker_thread_main,负责与Broker通讯,多个 3)KafkaHandler线程rd_kafka_thread_main,每创建一个consumer或producer即会创建一个Handler线程。 5.消费者 5.1.消费者结构 5.1.1.Handle 定义了poll等接口,它的实现者为HandleImpl。 5.1.2.HandleImpl 实现了消费者和生产者均使用的poll等,其中poll的作用为: 1)为生产者回调消息发送结果; 2)为生产者和消费者回调事件。 classHandle{ /** *@briefPollstheprovidedkafkahandleforevents. * *Eventswilltriggerapplicationprovidedcallbackstobecalled. * *The\ptimeout_msargumentspecifiesthemaximumamountoftime *(inmilliseconds)thatthecallwillblockwaitingforevents. *Fornon-blockingcalls,provide0as\ptimeout_ms. *Towaitindefinatelyforevents,provide-1. * *Events: *-deliveryreportcallbacks(ifanRdKafka::DeliveryCbisconfigured)[producer] *-eventcallbacks(ifanRdKafka::EventCbisconfigured)[producer&consumer] * *@remarkAnapplicationshouldmakesuretocallpoll()atregular *intervalstoserveanyqueuedcallbackswaitingtobecalled. * *@warningThismethodMUSTNOTbeusedwiththeRdKafka::KafkaConsumer, *useitsRdKafka::KafkaConsumer::consume()instead. * *@returnsthenumberofeventsserved. */ virtualintpoll(inttimeout_ms)=0; }; 5.1.3.ConsumeCb 只针对消费者的Callback。 5.1.4.RebalanceCb 只针对消费者的Callback。 5.1.5.EventCb 消费者和生产者均可设置EventCb,如:_global_conf->set("event_cb",&_event_cb,errmsg);。 /** *@briefEventcallbackclass * *Eventsareagenericinterfaceforpropagatingerrors,statistics,logs,etc *fromlibrdkafkatotheapplication. * *@saRdKafka::Event */ classRD_EXPORTEventCb{ public: /** *@briefEventcallback * *@saRdKafka::Event */ virtualvoidevent_cb(Event&event)=0; virtual~EventCb(){} }; /** *@briefEventobjectclassaspassedtotheEventCbcallback. */ classRD_EXPORTEvent{ public: /**@briefEventtype*/ enumType{ EVENT_ERROR,/**<Eventisanerrorcondition*/ EVENT_STATS,/**<EventisastatisticsJSONdocument*/ EVENT_LOG,/**<Eventisalogmessage*/ EVENT_THROTTLE/**<Eventisathrottlelevelsignalingfromthebroker*/ }; }; 5.1.6.Consumer 简单消息者,一般不使用,而是使用KafkaConsumer。 5.1.7.KafkaConsumer 消费者和生产者均采用多重继承方式,其中KafkaConsumer为消费者接口,KafkaConsumerImpl为消费者实现。 5.1.8.KafkaConsumerImpl KafkaConsumerImpl为消费者实现。 5.1.9.rd_kafka_message_t 消息结构。 5.1.10.rd_kafka_msg_s 消息结构,但消息数据实际存储在rd_kafka_message_t,结构大致如下: structrd_kafka_msg_s { rd_kafka_message_trkm_rkmessage; struct { rd_kafka_msg_s*tqe_next; rd_kafka_msg_s**tqe_prev; int64_trkm_timestamp; rd_kafka_timestamp_type_trkm_tstype; }rkm_link; }; 5.1.11.rd_kafka_msgq_t 存储消息的消息队列,生产者生产的消息并不直接socket发送到brokers,而是放入了这个队列,结构大致如下: structrd_kafka_msgq_t { struct { rd_kafka_msg_s*tqh_first;//队首 rd_kafka_msg_s*tqh_last;//队尾 }; //消息个数 rd_atomic32_trkmq_msg_cnt; //所有消息加起来的字节数 rd_atomic64_trkmq_msg_bytes; }; 5.1.12.rd_kafka_toppar_t Topic-Partition队列,很复杂的一个结构,部分内容如下: //Topic+Partitioncombination typedefstructrd_kafka_toppar_s { struct { rd_kafka_toppar_s*tqe_next; rd_kafka_toppar_s**tqe_prev; }rktp_rklink; struct { rd_kafka_toppar_s*tqe_next; rd_kafka_toppar_s**tqe_prev; }rktp_rkblink; struct { rd_kafka_toppar_s*cqe_next; rd_kafka_toppar_s*cqe_prev; }rktp_fetchlink; struct { rd_kafka_toppar_s*tqe_next; rd_kafka_toppar_s**tqe_prev; }rktp_rktlink; struct { rd_kafka_toppar_s*tqe_next; rd_kafka_toppar_s**tqe_prev; }rktp_cgrplink; rd_kafka_itopic_t*rktp_rkt; int32_trktp_partition; int32_trktp_leader_id; rd_kafka_broker_t*rktp_leader; rd_kafka_broker_t*rktp_next_leader; rd_refcnt_trktp_refcnt; rd_kafka_msgq_trktp_msgq;//application->rdkafkaqueue }rd_kafka_toppar_t; 6.生产者 6.1.生产者结构 6.1.1.DeliveryReportCb 消息已经成功递送到Broker时回调,只针对生产者有效。 6.1.2.PartitionerCb 计算分区号回调函数,只针对生产者有效。 6.1.3.Producer Producer为生产者接口,它的实现者为ProducerImpl。 6.1.4.ProduceImpl ProducerImpl为生产者的实现。 6.2.生产者启动过程1 启动时会创建两组线程:一组Broker线程(rd_kafka_broker_thread_main,多个),实为与Broker间的网络IO线程;一组Handler线程(rd_kafka_thread_main,单个),每调用一次RdKafka::Producer::create或rd_kafka_new即创建一Handler线程。 Handler线程调用栈: (gdb)t17 [Switchingtothread17(Thread0x7ff7059d3700(LWP16765))] #00x00007ff7091e6cf2inpthread_cond_timedwait@@GLIBC_2.3.2()from/lib64/libpthread.so.0 (gdb)bt #00x00007ff7091e6cf2inpthread_cond_timedwait@@GLIBC_2.3.2()from/lib64/libpthread.so.0 #10x00000000005b4d2fincnd_timedwait_ms(cnd=0x1517748,mtx=0x1517720,timeout_ms=898)attinycthread.c:501 #20x0000000000580e16inrd_kafka_q_serve(rkq=0x1517720,timeout_ms=898,max_cnt=0,cb_type=RD_KAFKA_Q_CB_CALLBACK,callback=0x0,opaque=0x0)atrdkafka_queue.c:440 #30x000000000054ee9binrd_kafka_thread_main(arg=0x1516df0)atrdkafka.c:1227 #40x00000000005b4e0fin_thrd_wrapper_function(aArg=0x15179d0)attinycthread.c:624 #50x00007ff7091e2e25instart_thread()from/lib64/libpthread.so.0 #60x00007ff7082d135dinclone()from/lib64/libc.so.6 6.3.生产者启动过程2 创建网络IO线程,消费者启动过程类似,只是一个调用rd_kafka_broker_producer_serve(rkb),另一个调用rd_kafka_broker_consumer_serve(rkb)。 IO线程负责消息的收和发,发送底层调用的是sendmsg,收调用的是recvmsg(但MSVC平台调用send和recv)。 6.4.生产者生产过程 生产者生产的消息并不直接socket发送到brokers,而是放入队列rd_kafka_msgq_t中。Broker线程(rd_kafka_broker_thread_main)消费这个队列。 Broker线程同时监控与Broker间的网络连接,又要监控队列中是否有数据,如何实现的?这个队列和管道绑定在一起的,绑定的是管道写端(rktp->rktp_msgq_wakeup_fd=rkb->rkb_toppar_wakeup_fd;rkb->rkb_toppar_wakeup_fd=rkb->rkb_wakeup_fd[1])。 这样Broker线程即可同时监听网络数据和管道数据。 //intrd_kafka_msg_partitioner(rd_kafka_itopic_t*rkt,rd_kafka_msg_t*rkm,intdo_lock) (gdb)p*rkm $7={rkm_rkmessage={err=RD_KAFKA_RESP_ERR_NO_ERROR,rkt=0x1590c10,partition=1,payload=0x7f48c4001260,len=203,key=0x7f48c400132b,key_len=14,offset=0, _private=0x0},rkm_link={tqe_next=0x5b5d47554245445b,tqe_prev=0x6361667265746e69},rkm_flags=196610,rkm_timestamp=1524829399009, rkm_tstype=RD_KAFKA_TIMESTAMP_CREATE_TIME,rkm_u={producer={ts_timeout=16074575505526,ts_enq=16074275505526}}} (gdb)prkm->rkm_rkmessage $8={err=RD_KAFKA_RESP_ERR_NO_ERROR,rkt=0x1590c10,partition=1,payload=0x7f48c4001260,len=203,key=0x7f48c400132b,key_len=14,offset=0,_private=0x0} (gdb)prkm->rkm_rkmessage->payload $9=(void*)0x7f48c4001260 (gdb)p(char*)rkm->rkm_rkmessage->payload $10=0x7f48c4001260"{\"p\":\"f\",\"o\":1,\"d\":\"m\",\"d\":\"m\",\"i\":\"f2\",\"ip\":\"127.0.0.1\",\"pt\":2018,\"sc\":0,\"fc\":1,\"tc\":0,\"acc\":395,\"mcc\":395,\"cd\":\"test\",\"cmd\":\"tester\",\"cf\":\"main\",\"cp\":\"1.49.16.9"... 7.poll过程 poll的作用是触发回调,生产者即使不调用poll,消息也会发送出去,但是如果不通过poll触发回调,则不能确定消息发送状态(成功或失败等)。 消费队列rd_kafka_t->rk_rep,rk_rep为响应队列,类型为rd_kafka_q_t或rd_kafka_q_s:

优秀的个人博客,低调大师

Java消息中间件入门笔记 - ActiveMQ篇

入门 消息中间件带来的好处: 1)解耦:系统解耦 2)异步:异步执行 3)横向扩展 4)安全可靠 5)顺序保证 栗子: 通过服务调用让其它系统感知事件发生 系统之间高耦合 程序执行效率低 通过消息中间件解耦服务调用 1.Linux安装消息中间件ActiveMQ 1.下载安装包 wget http://120.221.32.78:6510/mirrors.shu.edu.cn/apache//activemq/5.15.3/apache-activemq-5.15.3-bin.tar.gz 解压 tar -zxvf apache-activemq-5.15.3-bin.tar.gz 2.启动与关闭 进入到bin目录,使用命令./activemq start启动服务 使用命令ps -ef |grep activemq查看进程是否存在 使用命令./activemq stop关闭服务 3.安装验证 访问地址:http://Linux主机IP:8161/ 默认用户:admin 默认密码:admin 4.Maven依赖 <dependency> <groupId>org.apache.activemq</groupId> <artifactId>activemq-all</artifactId> <version>5.15.3</version> </dependency> 2.队列模式的消息演示 队列模式: 1)客户端包括生产者和消费者 2)队列中的消息只能被一个消费者消费 3)消费者可以随时消费 1.编写AppProducer类 import javax.jms.Connection; import javax.jms.ConnectionFactory; import javax.jms.Destination; import javax.jms.JMSException; import javax.jms.MessageProducer; import javax.jms.Session; import javax.jms.TextMessage; import org.apache.activemq.ActiveMQConnectionFactory; /** * App 生产者-队列模式 * @author * */ public class AppProducer { /** 指定ActiveMQ服务的地址 */ private static final String URL = "tcp://127.0.0.1:61616"; /** 指定队列的名称 */ private static final String QUEUE_NAME = "queue-test"; public static void main(String[] args) throws JMSException { // 1.创建ConnectionFactory ConnectionFactory connectionFactory = new ActiveMQConnectionFactory(URL); // 2.创建Connection Connection connection = connectionFactory.createConnection(); // 3.启动连接 connection.start(); // 4.创建会话(第一个参数:是否在事务中处理) Session session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); // 5. 创建一个目标 Destination destination = session.createQueue(QUEUE_NAME); // 6.创建一个生产者 MessageProducer producer = session.createProducer(destination); for (int i = 0; i < 100; i++) { // 7.创建消息 TextMessage textMessage = session.createTextMessage("test" + i); // 8.发布消息 producer.send(textMessage); System.out.println("消息发送:" + textMessage.getText()); } // 9.关闭连接 connection.close(); } } 2.编写AppConsumer类 import javax.jms.Connection; import javax.jms.ConnectionFactory; import javax.jms.Destination; import javax.jms.JMSException; import javax.jms.Message; import javax.jms.MessageConsumer; import javax.jms.MessageListener; import javax.jms.Session; import javax.jms.TextMessage; import org.apache.activemq.ActiveMQConnectionFactory; /** * App 消费者-队列模式 * @author * */ public class AppConsumer { /** 指定ActiveMQ服务的地址 */ private static final String URL = "tcp://127.0.0.1:61616"; /** 指定队列的名称 */ private static final String QUEUE_NAME = "queue-test"; public static void main(String[] args) throws JMSException { // 1.创建ConnectionFactory ConnectionFactory connectionFactory = new ActiveMQConnectionFactory(URL); // 2.创建Connection Connection connection = connectionFactory.createConnection(); // 3.启动连接 connection.start(); // 4.创建会话(第一个参数:是否在事务中处理) Session session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); // 5.创建一个目标 Destination destination = session.createQueue(QUEUE_NAME); // 6.创建一个消费者 MessageConsumer consumer = session.createConsumer(destination); // 7.创建一个监听器 consumer.setMessageListener(new MessageListener() { public void onMessage(Message message) { TextMessage textMessage = (TextMessage)message; try { System.out.println("接收消息:" + textMessage.getText()); } catch (JMSException e) { System.out.println("接收消息异常:"); e.printStackTrace(); } } }); // 8.关闭连接 //connection.close(); } } 3.主题模式的消息演示 主题模式 1)客户端包括发布者和订阅者 2)主体中的消息被所有订阅者消费 3)消费者不能消费订阅之前就发送到主题中的消息 1.编写AppProducer类 import javax.jms.Connection; import javax.jms.ConnectionFactory; import javax.jms.Destination; import javax.jms.JMSException; import javax.jms.MessageProducer; import javax.jms.Session; import javax.jms.TextMessage; import org.apache.activemq.ActiveMQConnectionFactory; /** * App 生产者-主题模式 * @author * */ public class AppProducer { /** 指定ActiveMQ服务的地址 */ private static final String URL = "tcp://127.0.0.1:61616"; /** 指定主题的名称 */ private static final String TOPIC_NAME = "topic-test"; public static void main(String[] args) throws JMSException { // 1.创建ConnectionFactory ConnectionFactory connectionFactory = new ActiveMQConnectionFactory(URL); // 2.创建Connection Connection connection = connectionFactory.createConnection(); // 3.启动连接 connection.start(); // 4.创建会话(第一个参数:是否在事务中处理) Session session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); // 5. 创建一个目标 Destination destination = session.createTopic(TOPIC_NAME); // 6.创建一个生产者 MessageProducer producer = session.createProducer(destination); for (int i = 0; i < 100; i++) { // 7.创建消息 TextMessage textMessage = session.createTextMessage("test" + i); // 8.发布消息 producer.send(textMessage); System.out.println("消息发送:" + textMessage.getText()); } // 9.关闭连接 connection.close(); } } 2.编写AppConsumer类 import javax.jms.Connection; import javax.jms.ConnectionFactory; import javax.jms.Destination; import javax.jms.JMSException; import javax.jms.Message; import javax.jms.MessageConsumer; import javax.jms.MessageListener; import javax.jms.Session; import javax.jms.TextMessage; import org.apache.activemq.ActiveMQConnectionFactory; /** * App 消费者-主题模式 * @author * */ public class AppConsumer { /** 指定ActiveMQ服务的地址 */ private static final String URL = "tcp://127.0.0.1:61616"; /** 指定主题的名称 */ private static final String TOPIC_NAME = "topic-test"; public static void main(String[] args) throws JMSException { // 1.创建ConnectionFactory ConnectionFactory connectionFactory = new ActiveMQConnectionFactory(URL); // 2.创建Connection Connection connection = connectionFactory.createConnection(); // 3.启动连接 connection.start(); // 4.创建会话(第一个参数:是否在事务中处理) Session session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); // 5.创建一个目标 Destination destination = session.createTopic(TOPIC_NAME); // 6.创建一个消费者 MessageConsumer consumer = session.createConsumer(destination); // 7.创建一个监听器 consumer.setMessageListener(new MessageListener() { public void onMessage(Message message) { TextMessage textMessage = (TextMessage)message; try { System.out.println("接收消息:" + textMessage.getText()); } catch (JMSException e) { System.out.println("接收消息异常:"); e.printStackTrace(); } } }); // 8.关闭连接 //connection.close(); } } 4.Spring集成ActiveMQ 1.Maven依赖 <dependency> <groupId>org.apache.activemq</groupId> <artifactId>activemq-all</artifactId> <version>5.15.3</version> </dependency> <!--spring依赖 --> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-context</artifactId> <version>4.1.7.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-jms</artifactId> <version>4.1.7.RELEASE</version> </dependency> 2.spring配置文件 1)common.xml <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context-4.3.xsd"> <!-- 开启注解:可以使用@Autowired等 --> <context:annotation-config /> <!-- ActiveMQ为我们提供的ConnectionFactory --> <bean id="targetConnectionFactory" class="org.apache.activemq.ActiveMQConnectionFactory"> <property name="brokerURL" value="tcp://118.89.177.110:61616"></property> </bean> <!-- Spring jms为我们提供的连接池 --> <bean id="connectionFactory" class="org.springframework.jms.connection.SingleConnectionFactory"> <property name="targetConnectionFactory" ref="targetConnectionFactory"></property> </bean> <!-- 队列模式 --> <bean id="queueDestination" class="org.apache.activemq.command.ActiveMQQueue"> <constructor-arg value="queue"></constructor-arg> </bean> <!-- 主题模式--> <bean id="topicDestination" class="org.apache.activemq.command.ActiveMQTopic"> <constructor-arg value="topic"></constructor-arg> </bean> </beans> 2)consumer.xml <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context-4.3.xsd"> <!-- 引入配置 --> <import resource="common.xml"/> <!-- 配置消息监听器 --> <bean id="consumerMessageListener" class="cn.zyzpp.spring.consumer.ConsumerMessageListener"/> <!-- 配置消息容器 --> <bean id="jmsContainer" class="org.springframework.jms.listener.DefaultMessageListenerContainer"> <property name="connectionFactory" ref="connectionFactory" /> <!-- 队列模式 --> <!-- <property name="destination" ref="queueDestination" /> --> <!-- 主题模式 --> <property name="destination" ref="topicDestination" /> <property name="messageListener" ref="consumerMessageListener" /> </bean> </beans> 3)producer.xml <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context-4.3.xsd"> <!-- 引入配置 --> <import resource="common.xml"/> <!-- 配置JmsTemplate发送消息 --> <bean id="jmsTemplate" class="org.springframework.jms.core.JmsTemplate"> <property name="connectionFactory" ref="connectionFactory"></property> </bean> <!-- 注入实体Bean而不是接口 --> <bean class="cn.zyzpp.spring.producer.ProducerServiceImpl"></bean> </beans> 3)生产者消费者编码 ProducerService.java package cn.zyzpp.spring.producer; /** * Created by yster@foxmail.com */ public interface ProducerService { void sendMessage(String message); } ProducerServiceImpl.java package cn.zyzpp.spring.producer; import javax.annotation.Resource; import javax.jms.Destination; import javax.jms.JMSException; import javax.jms.Message; import javax.jms.Session; import javax.jms.TextMessage; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.jms.core.JmsTemplate; import org.springframework.jms.core.MessageCreator; /** * Created by yster@foxmail.com 2018年4月24日 下午7:13:27 */ public class ProducerServiceImpl implements ProducerService { @Autowired private JmsTemplate jmsTemplate; // @Resource(name = "queueDestination") //队列模式 @Resource(name = "topicDestination") //主题模式 private Destination destination; @Override public void sendMessage(String message) { //使用jmsTemplate发送消息 jmsTemplate.send(destination, new MessageCreator() { @Override public Message createMessage(Session session) throws JMSException { //创建一个消息 TextMessage textMessage = session.createTextMessage(message); return textMessage; } }); System.out.println("发送消息:" + message); } } AppProducer.java package cn.zyzpp.spring.producer; import org.springframework.context.support.ClassPathXmlApplicationContext; /** * Created by yster@foxmail.com * 2018年4月24日 下午7:29:30 */ public class AppProducer { public static void main(String[] args) { ClassPathXmlApplicationContext context = new ClassPathXmlApplicationContext("classpath:producer.xml"); ProducerService service = context.getBean(ProducerService.class); for(int i=0; i<100; i++){ service.sendMessage("消息发送:"+i); } context.close(); } } ConsumerMessageListener.java package cn.zyzpp.spring.consumer; import javax.jms.JMSException; import javax.jms.Message; import javax.jms.MessageListener; import javax.jms.TextMessage; /** * Created by yster@foxmail.com * 2018年4月24日 下午8:48:39 */ public class ConsumerMessageListener implements MessageListener { @Override public void onMessage(Message message) { TextMessage textMessage = (TextMessage) message; try { System.out.println("接受消息:" + textMessage.getText()); } catch (JMSException e) { e.printStackTrace(); } } } AppConsumer.java package cn.zyzpp.spring.consumer; import org.springframework.context.ApplicationContext; import org.springframework.context.support.ClassPathXmlApplicationContext; /** * Created by yster@foxmail.com * 2018年4月24日 下午7:29:30 */ public class AppConsumer { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("classpath:consumer.xml"); } } 5.ActiveMQ集群 为什么要对消息中间件集群 实现高可用,以排除单点故障引起的服务中断 实现负载均衡,以提升效率为更多客户提供服务 集群方式 客户端集群:让多个消费者消费同一个队列 Broker cluster:多个Broker之间同步消息 Master Slave:实现高可用 ActiveMQ失效转移(failover)-客户端配置 允许当其中一台消息服务器宕机时,客户端在传输层上重新连接到其它消息服务器 语法:failover:(uri1,…,uriN)?transportOptions transportOptions参数说明 randomize默认为true,表示在URI列表中选择URI连接时是否采用随机策略 initialReconnectDelay默认为10,单位毫秒,表示第一次尝试重连之间等待的时间 maxReconnectDelay默认为30000,单位毫秒,最长重连的时间间隔 Broker cluster集群配置-原理 NetworkConnector(网络连接器) 网络连接器主要用于配置ActiveMQ服务器与服务器之间的网络通讯方式, 用于服务器透传消息。 网络连接器分为静态连接器和动态连接器 静态连接器 动态连接器 5-2 ActiveMQ集群理论 ActiveMQ Master Slace集群方案 Share nothing storage master/slave(已过时,5.8+后移除) Shared storage master/slave 共享存储 Replicated LevelDB Store基于负责的LevelDB Store 共享存储集群的原理 基于复制的LevelDB Store的原理 两种集群方式对比 三台服务器的完美集群方案 ActiveMQ集群配置方案 配置过程 1.节点准备 mkdir activemq创建目录 cp -rf apache-activemq-5.15.3 activemq/activemq-a cp -rf apache-activemq-5.15.3 activemq/activemq-b cp -rf apache-activemq-5.15.3 activemq/activemq-c cd activemq mkdir kahadb 2.配置a节点 cd activemq-a/ cd conf/ vim activemq.xml <networkConnectors> <networkConnector name="local_network" uri="static:(tcp://127.0.0.1:61617,tcp://127.0.0.1:61618)" /> </networkConnectors> vim jetty.xml:配置管理端口号,a节点使用默认端口,无须配置 3.配置b节点 vim activemq.xml 配置网络连接器 <networkConnectors> <networkConnector name="network_a" uri="static:(tcp://127.0.0.1:61616)" /> </networkConnectors> 配置持久化存储路径 <persistenceAdapter> <kahaDB directory="/***/activemq/kahadb"/> </persistenceAdapter> 配置服务端口 <transportConnector name="openwire" uri="tcp://0.0.0.0:61617?maximumConnections=1000&amp;wireFormat.maxFrameSize=104857600"/> vim jetty.xml 配置管理端口号 <bean id="jettyPort" class="org.apache.activemq.web.WebConsolePort" init-method="start"> <!-- the default port number for the web console --> <property name="host" value="0.0.0.0"/> <property name="port" value="8162"/> </bean> 4.配置c节点 vim activemq.xml 配置网络连接器 <networkConnectors> <networkConnector name="network_a" uri="static:(tcp://127.0.0.1:61616)" /> </networkConnectors> 配置持久化存储路径 <persistenceAdapter> <kahaDB directory="/***/activemq/kahadb"/> </persistenceAdapter> 配置服务端口 <transportConnector name="openwire" uri="tcp://0.0.0.0:61618?maximumConnections=1000&amp;wireFormat.maxFrameSize=104857600"/> vim jetty.xml 配置管理端口号 <bean id="jettyPort" class="org.apache.activemq.web.WebConsolePort" init-method="start"> <!-- the default port number for the web console --> <property name="host" value="0.0.0.0"/> <property name="port" value="8163"/> </bean> 5.启动服务 回到activemq目录,分别启动a,b,c三个节点 ./activemq-a/bin/activemq start ./activemq-b/bin/activemq start ./activemq-c /bin/activemq start 检查是否都启动成功 ps -ef |grep activemq 检查是否对外提供服务,即端口是否被监听(占用) netstat -anp |grep 61616 netstat -anp |grep 61617 netstat -anp |grep 61618 检查发现61618即c节点没有提供服务,但是c节点的进程是启动成功了的。因为b节点和c点击是master/slave配置,现在b节点获取到了共享文件夹的所有权,所以c节点正在等待获得资源,并且提供服务。即c节点在未获得资源之前,是不提供服务的。 测试,把b节点杀掉,看c节点能不能提供61618的服务 ./activemq-b/bin/activemq stop netstat -anp |grep 61618 ./activemq-b/bin/activemq start netstat -anp |grep 61617 检查发现,重新启动b节点后,b节点61617端口并没有提供服务,是因为现在b节点成为了slave节点,而c节点成为了master节点。所以,现在b节点启动了,但是它并不对外提供服务。只有当c节点出现问题后,b节点才对外提供服务。 6.通过代码测试集群配置是否生效 生产者 import javax.jms.Connection; import javax.jms.ConnectionFactory; import javax.jms.Destination; import javax.jms.JMSException; import javax.jms.MessageProducer; import javax.jms.Session; import javax.jms.TextMessage; import org.apache.activemq.ActiveMQConnectionFactory; /** * App 生产者-队列模式-集群配置测试 * @author * */ public class AppProducerTest { /** failover 为状态转移的存在部分 * 因a节点只作为消费者使用,所以这里不配置61616节点了。 * */ private static final String URL = "failover:(tcp://127.0.0.1:61617,tcp://127.0.0.1:61618)?randomize=true"; /** 指定队列的名称 */ private static final String QUEUE_NAME = "queue-test"; public static void main(String[] args) throws JMSException { // 1.创建ConnectionFactory ConnectionFactory connectionFactory = new ActiveMQConnectionFactory(URL); // 2.创建Connection Connection connection = connectionFactory.createConnection(); // 3.启动连接 connection.start(); // 4.创建会话(第一个参数:是否在事务中处理) Session session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); // 5. 创建一个目标 Destination destination = session.createQueue(QUEUE_NAME); // 6.创建一个生产者 MessageProducer producer = session.createProducer(destination); for (int i = 0; i < 100; i++) { // 7.创建消息 TextMessage textMessage = session.createTextMessage("test" + i); // 8.发布消息 producer.send(textMessage); System.out.println("消息发送:" + textMessage.getText()); } // 9.关闭连接 connection.close(); } } 消费者 import javax.jms.Connection; import javax.jms.ConnectionFactory; import javax.jms.Destination; import javax.jms.JMSException; import javax.jms.Message; import javax.jms.MessageConsumer; import javax.jms.MessageListener; import javax.jms.Session; import javax.jms.TextMessage; import org.apache.activemq.ActiveMQConnectionFactory; /** * App 消费者-队列模式-集群配置测试 * @author * */ public class AppConsumerTest { /** failover 为状态转移的存在部分 * */ private static final String URL = "failover:(tcp://127.0.0.1:61616,tcp://127.0.0.1:61617,tcp://127.0.0.1:61618)?randomize=true"; /** 指定队列的名称 */ private static final String QUEUE_NAME = "queue-test"; public static void main(String[] args) throws JMSException { // 1.创建ConnectionFactory ConnectionFactory connectionFactory = new ActiveMQConnectionFactory(URL); // 2.创建Connection Connection connection = connectionFactory.createConnection(); // 3.启动连接 connection.start(); // 4.创建会话(第一个参数:是否在事务中处理) Session session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); // 5.创建一个目标 Destination destination = session.createQueue(QUEUE_NAME); // 6.创建一个消费者 MessageConsumer consumer = session.createConsumer(destination); // 7.创建一个监听器 consumer.setMessageListener(new MessageListener() { public void onMessage(Message message) { TextMessage textMessage = (TextMessage)message; try { System.out.println("接收消息:" + textMessage.getText()); } catch (JMSException e) { System.out.println("接收消息异常:"); e.printStackTrace(); } } }); // 8.关闭连接 //connection.close(); } } 管理界面查看消息 http://127.0.0.1:8161 http://127.0.0.1:8162 http://127.0.0.1:8163 6.扩展 本文记录简要,推荐阅读 慕课网-Java消息中间件学习总结

优秀的个人博客,低调大师

Java小白进阶笔记(4)-流程控制语句

继续学习:5.偏头痛杨的Java入门教学系列之流程控制语句篇 详细的去看原文,这里分割线中摘录一些我觉得对新手比较重要的概念(也容易混淆)。 方法的种类 1.实例方法 属于每个实例的方法,必须使用对象来调用,方法前不要加static修饰。 2.类方法 属于类的方法,必须加static修饰,使用类名调用(当然类方法也可以使用实例调用,但是不建议这么做),为什么要用类名来访问一些方法呢?因为不耗费内存,不用创建实例。 3.构造方法/构造器(Constructor) 构造方法是一个类创建对象的根本途径,如果一个类没有构造方法,这个类通常无法创建实例。因此如果程序员忘记定义构造方法的话,Java编译器将会为该类提供一个默认构造方法(无参的构造方法),一旦程序员已经定义了构造方法,则系统不再提供默认的构造方法。(注意:如果程序员定义了一个有参构造,系统也不再提供默认的无参构造)当然,如果你也想使用无参数构造方法,就可以自己手动写一个。 构造方法的作用 通过new关键字来调用某个类的构造方法,即可创建这个类的实例。在创建一个对象(类实例化成对象)的时候,至少要调用一个构造方法。 构造方法的作用是完成对象的创建,即完成对象的实例化,在构造方法中一般可以对成员变量进行初始化 构造方法的特点 构造方法的名称必须与类同名 一个类可以有多个构造方法(参数列表不同) 构造方法没有返回类型,不能return 构造方法可以设置为private即在外部无法调用该类的构造方法(单例模式) 方法的重载(overload) 方法的重载就是在同一个类中允许同时存在一个以上同名的方法。 方法名称相同,方法的参数必须不同,参数个数不同,参数类型不同,方法的返回值类型可以相同,也可以不同。 类变量与实例变量 类变量 也叫静态变量 说明类的属性 类变量声明在类中,方法体之外,必须声明为static类型 类变量在创建类时被初始化 类的所有示例变量在调用该变量的时候共享一块内存空间,可以类名直接调用,也可拿对象调用(不推荐) 实例变量 说明类的一个实例的属性 实例变量定义在类中,方法体之外,不声明成static类型 实例变量在创建对象的时候被初始化 类所有实例调用该变量的时候都开辟一块新内存,只能拿对象调用实例变量。 局部变量 在方法内、代码块内、形参中定义的变量被称为局部变量 所有局部变量均在方法的栈内存中存储 方法、代码块结束后,变量就会自动销毁。 部变量的作用范围越小,它在内存里停留的时间就越短,程序运行性能就越好。因此能用代码块局部变量的地方,就不要使用方法局部变量 访问修饰符不能用于局部变量 作业 编写一个方法,需要传1个整型变量作为参数,方法中先把参数输出,再判断参数为偶数就返回true,非偶数返回false。在main方法中调用该方法3次,分别传入参数为3、4、5,并将方法的返回值输出。答: 代码: package test; import java.util.Scanner; public class Getodd { public static boolean judge(int tem) { if(tem%2==0) { return true; } else { return false; } } public static void main(String [] args) { Scanner sc=new Scanner(System.in); for(int i=1;i<=3;i++){ int tem=sc.nextInt(); boolean ans=judge(tem); System.out.println("the"+i+" 's ans: "+ans); } } } 输出: 3 the1 's ans: false 4 the2 's ans: true 5 the3 's ans: false 编写一个方法,需要传入2个整型变量作为参数,方法中返回数值较大的参数,在main方法中调用该方法几次,参数自定义,并将方法的返回值输出。答: 代码: package test; import java.util.Scanner; public class WhoIsMax { public static int judge(int a,int b) { if(a>b) { return a; } else { return b; } } public static void main(String[] args) { Scanner sc=new Scanner(System.in); for(int i=0;i<3;i++) { int a=sc.nextInt(); int b=sc.nextInt(); int ans=judge(a,b); System.out.println("the max between "+a+" and "+b+" is "+ans); } } } 输出: 2 3 the max between 2 and 3 is 3 5 8 the max between 5 and 8 is 8 99 22 the max between 99 and 22 is 99 编写一个方法,需要传入1个整型变量作为参数,方法中使用switch做判断,如果参数值为1则输出"星期一",如果参数值为2则输出"星期二",依此类推,如果参数值不在1-7的范围内则输出"参数错误",在main方法中调用该方法几次,参数自定义。答: 代码: package test; import java.util.Scanner; public class DateShow { public static void judge(int tem) { switch(tem) { case 1: System.out.println("Monday"); break; case 2: System.out.println("Tuesday"); break; case 3: System.out.println("Wednesday"); break; case 4: System.out.println("Thursday"); break; case 5: System.out.println("Friday"); break; case 6: System.out.println("Saturday"); break; case 7: System.out.println("Sunday"); break; default:System.out.println("Wrong input!"); } } public static void main (String [] args){ Scanner sc=new Scanner(System.in); for(int i=0;i<3;i++) { int tem=sc.nextInt(); judge(tem); } } } 输出: 3 Wednesday 5 Friday 9 Wrong input! 编写一个方法,打印出一个菱形(这道题比较难,不允许搜百度上的答案)。 * *** ***** ******* ***** *** * 友情提示: System.out.println();输出是带换行的 System.out.print();输出是不带换行的 需要使用嵌套for循环 一个循环输出空格,一个循环输出星号;一个循环输出换行答: 代码: package test; import java.util.Scanner; public class DrawPic { public static void drawPic(int num) { int half=num/2+1; for(int i=0;i<half;i++) { for(int j=0;j<half-1-i;j++) { System.out.print(' '); } for(int k=0;k<2*i+1;k++) { System.out.print('*'); } System.out.println(); } for(int i=0;i<half-1;i++) { for(int j=0;j<i+1;j++) { System.out.print(' '); } for(int k=0;k<num-2*(i+1);k++) { System.out.print('*'); } System.out.println(); } } public static void main(String [] args) { Scanner sc=new Scanner(System.in); int tem = sc.nextInt(); drawPic(tem); } } 输出: 17 * *** ***** ******* ********* *********** ************* *************** ***************** *************** ************* *********** ********* ******* ***** *** *

优秀的个人博客,低调大师

Jenkins 构建JAVA的Helloworld程序(学习笔记四)

1、 Jenkins上新建任务,输入任务名,选择构建一个自由风格的软件项目: 2、构建任务上配置:丢弃旧的构建、源码管理选择SVN(SVN的账号密码自己添加)、构建环境选ANT,保存 3、在某一台LINUX服务器上添加两个文件:build.xml helloworld.java #build.xml #helloworld.java packageoata; publicclassHelloWorld{ publicstaticvoidmain(String[]args){ System.out.println("HelloWorld"); } } 4、SVN提交: svn add build.xml svn add helloworld.java svn commit -m "build.xml" build.xml svn commit -m "helloworld.java" helloworld.java 5、执行构建,蓝灯表示构建正常:

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册