首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

Java8之深入理解Lambda

lambda表达式实战 从例子引出lambda 传递Runnable创建Thread java8之前 Thread thread=new Thread(new Runnable() { @Override public void run() { // do something } }); java 8 之后 new Thread(()->{}); 上边的例子比较简单,但是有两个疑问。什么是Lambda表达式?怎么使用lambda表达式? 什么是Lambda表达式? 从上述例子入手,首先我们知道Lambda一般代表的是一个匿名对象;其次我们点击“->”,IDE会帮助我们进入到符合Lambda规范的函数接口。我们来观察下这个符合规范的类的变化。 java7 Runnable // 省略注释 package java.lang; public interface Runnable { public abstract void run(); } java8 Runnable // 省略注释 package java.lang; @FunctionalInterface public interface Runnable { public abstract void run(); } 我们发现java8后Runnable接口新增了一个注解@FunctionalInterface。下边我们一起来看下这个注解是什么。 FunctionalInterface /** * An informative annotation type used to indicate that an interface * type declaration is intended to be a <i>functional interface</i> as * defined by the Java Language Specification. * * Conceptually, a functional interface has exactly one abstract * method. Since {@linkplain java.lang.reflect.Method#isDefault() * default methods} have an implementation, they are not abstract. If * an interface declares an abstract method overriding one of the * public methods of {@code java.lang.Object}, that also does * <em>not</em> count toward the interface's abstract method count * since any implementation of the interface will have an * implementation from {@code java.lang.Object} or elsewhere. * * <p>Note that instances of functional interfaces can be created with * lambda expressions, method references, or constructor references. * * <p>If a type is annotated with this annotation type, compilers are * required to generate an error message unless: * * <ul> * <li> The type is an interface type and not an annotation type, enum, or class. * <li> The annotated type satisfies the requirements of a functional interface. * </ul> * * <p>However, the compiler will treat any interface meeting the * definition of a functional interface as a functional interface * regardless of whether or not a {@code FunctionalInterface} * annotation is present on the interface declaration. * * @jls 4.3.2. The Class Object * @jls 9.8 Functional Interfaces * @jls 9.4.3 Interface Method Body * @since 1.8 */ @Documented @Retention(RetentionPolicy.RUNTIME) @Target(ElementType.TYPE) public @interface FunctionalInterface {} 上边文档的核心意思是:@FunctionInterface注解是为了表明这个类是一个函数式接口。 函数式接口有这样的特点:只有一个抽象方法。java8提供了default方法,以及超类Object中的方法(toString,Equals),这些方法不计算抽象方法数量的统计中。 使用上:函数式接口可以配合lambda表达式、方法引用、构造引用使用。 如果类上标记了这个注解,编译器会在编译期进行检查 最后,即使我们没有标注这个注解,编译器也会将它看待成一个函数式接口 好了,从上边我们知道了lambda的特点,接下来我们来聊下怎么使用? 如何使用Lambda 首先,我们去官网查阅Java8新特性,找到Lambda表达式的说明。我们从这个文档的**“Syntax of Lambda Expressions”**部分入手,大概可以得到如下的结论。 Lambda的组成 Lambda主要由下边几部分组成;参数列表,连接符,主体。 参数列表 圆括号内部,参数以“,”分割开来。如(String a,Object b)。 此外,参数的类型和括号,有些时候是可以省略 箭头记号 通过“->”这种特殊符号形式,连接前后。 主体 可以由单个表达式,或者语句块组成。 单个表达式,如"System.out.println("xxx")" 语句块 示例1 { System.out.println("xxx"); } 示例2 { // do something return some result return 100; } Lambda的完整用法示例 无返回值的lambda的用例 目的,将具体业务实现交给调用者处理。 定义一个无返回值,符合FunctionInterface规范的接口对象 interface Print<String>{ void printName(String string); } 使用示例1 我这里的业务逻辑是根据输入参数,执行日志打印操作。实际业务场景下,可能对应的是发送邮件或者MQ这样的具体操作。 public class LambdaDemo { public static void main(String[] args) { PrintSomeThing(name->System.out.println(name),"Hello baigt"); } public static void PrintSomeThing(Print<String> str,String name) { str.printName(name); } } 使用示例1 的延伸使用 定义 一个使用类 class Doctor{ String name; String interest; public Doctor(String name, String interest) { this.name = name; this.interest = interest; } public void printName(Print<String> str) { str.printName(name); } } 具体使用 Doctor doctor=new Doctor("baigt","java and javascript"); doctor.printName(name->System.out.println(name)); 有返回值的lambda的用例 目的,将具体业务实现交给调用者处理,并将结果返回。 定义一个有返回值,符合FunctionInterface规范的接口对象 interface GetSomething<String>{ String getThing(); } 定义一个使用者 class Doctor{ String name; String interest; public Doctor(String name, String interest) { this.name = name; this.interest = interest; } public String getInterest(GetSomething<String> get) { return get.getThing()+","+name; } } 使用示例 我这里的业务逻辑是根据输入参数(隐式interest),计算出一个结果返回出来,并对这个结果执行打印操作。 Doctor doctor=new Doctor("baigt","java and javascript"); System.out.println(doctor.getInterest(() -> "Hi")); 到此处,我们已经大概明白lambda表达式的基本用法。但是还会有两个疑问? 上边例子我们自定义了几个函数式接口,那么还有其他常用的函数式接口? 函数式接口不仅可以通过lambda表达式使用,还可以通过方法引用和构造引用来使用。那么这种引用又是怎么回事? 常用函数接口 我们选中@FunctionInterface注解类,通过Ide的Find Usages功能,会发现在java.util.function包下java8新增了很多类。这里挑几个基础的(其他的基本是功能上的增强或变种)来说。大致上有这么几种。 Consumer Supplier Predicate Function 下边会做一个简单的说明和使用。可能不会细致的去讲每一个Api。旨在让大家快速熟悉使用java8 lambda。 Consumer /** * Represents an operation that accepts a single input argument and returns no * result. Unlike most other functional interfaces, {@code Consumer} is expected * to operate via side-effects. * * <p>This is a <a href="package-summary.html">functional interface</a> * whose functional method is {@link #accept(Object)}. * * @param <T> the type of the input to the operation * * @since 1.8 */ @FunctionalInterface public interface Consumer<T> { /** * Performs this operation on the given argument. * * @param t the input argument */ void accept(T t); /** * Returns a composed {@code Consumer} that performs, in sequence, this * operation followed by the {@code after} operation. If performing either * operation throws an exception, it is relayed to the caller of the * composed operation. If performing this operation throws an exception, * the {@code after} operation will not be performed. * * @param after the operation to perform after this operation * @return a composed {@code Consumer} that performs in sequence this * operation followed by the {@code after} operation * @throws NullPointerException if {@code after} is null */ default Consumer<T> andThen(Consumer<? super T> after) { Objects.requireNonNull(after); return (T t) -> { accept(t); after.accept(t); }; } } 首先此接口只有一个抽象方法accept,该方法接收一个入参,不返回结果。 定义使用类 public static void doConsumer(Consumer consumer,String input) { consumer.accept(input); } 使用示例1 接收 “something input”输入,并执行打印操作 Consumer consumer = input -> System.out.println(input); doConsumer(consumer,"something input"); 使用示例2 将两个Consumer操作串连起来,andThen的后执行。 Consumer consumer = input -> System.out.println(input); doConsumer(consumer.andThen(input2->{ System.out.println("input2"); }),"something input"); Supplier /** * Represents a supplier of results. * * <p>There is no requirement that a new or distinct result be returned each * time the supplier is invoked. * * <p>This is a <a href="package-summary.html">functional interface</a> * whose functional method is {@link #get()}. * * @param <T> the type of results supplied by this supplier * * @since 1.8 */ @FunctionalInterface public interface Supplier<T> { /** * Gets a result. * * @return a result */ T get(); } 首先此接口只有一个抽象方法get,该方法不接收参数,返回一个T类型的结果。 定义使用类 public static <T> T doSupplier(Supplier<T> supplier) { return supplier.get(); } 使用示例1 不传入参数,生成一个指定类型为String或Integer的对象 System.out.println(doSupplier(() -> "baigt")); System.out.println(doSupplier(() -> {return Integer.valueOf("10");})); Predicate import java.util.Objects; /** * Represents a predicate (boolean-valued function) of one argument. * * <p>This is a <a href="package-summary.html">functional interface</a> * whose functional method is {@link #test(Object)}. * * @param <T> the type of the input to the predicate * * @since 1.8 */ @FunctionalInterface public interface Predicate<T> { /** * Evaluates this predicate on the given argument. * * @param t the input argument * @return {@code true} if the input argument matches the predicate, * otherwise {@code false} */ boolean test(T t); /** * Returns a composed predicate that represents a short-circuiting logical * AND of this predicate and another. When evaluating the composed * predicate, if this predicate is {@code false}, then the {@code other} * predicate is not evaluated. * * <p>Any exceptions thrown during evaluation of either predicate are relayed * to the caller; if evaluation of this predicate throws an exception, the * {@code other} predicate will not be evaluated. * * @param other a predicate that will be logically-ANDed with this * predicate * @return a composed predicate that represents the short-circuiting logical * AND of this predicate and the {@code other} predicate * @throws NullPointerException if other is null */ default Predicate<T> and(Predicate<? super T> other) { Objects.requireNonNull(other); return (t) -> test(t) && other.test(t); } } 首先此接口只有一个抽象方法test,该方法接受一个T类型的对象,返回一个boolean类型的结果。 定义使用类 public static boolean doPredicate(Predicate<String> predicate,String string) { return predicate.test(string); } 使用示例1 根据条件,判断输入对象是否符合过滤规则。 System.out.println(doPredicate(input -> input.length() > 5, "12345")); System.out.println(doPredicate(((Predicate<String>) (input -> input.length() > 5)) .and(input -> input.equalsIgnoreCase("12345")), "12345")); Function import java.util.Objects; /** * Represents a function that accepts one argument and produces a result. * * <p>This is a <a href="package-summary.html">functional interface</a> * whose functional method is {@link #apply(Object)}. * * @param <T> the type of the input to the function * @param <R> the type of the result of the function * * @since 1.8 */ @FunctionalInterface public interface Function<T, R> { /** * Applies this function to the given argument. * * @param t the function argument * @return the function result */ R apply(T t); /** * Returns a composed function that first applies the {@code before} * function to its input, and then applies this function to the result. * If evaluation of either function throws an exception, it is relayed to * the caller of the composed function. * * @param <V> the type of input to the {@code before} function, and to the * composed function * @param before the function to apply before this function is applied * @return a composed function that first applies the {@code before} * function and then applies this function * @throws NullPointerException if before is null * * @see #andThen(Function) */ default <V> Function<V, R> compose(Function<? super V, ? extends T> before) { Objects.requireNonNull(before); return (V v) -> apply(before.apply(v)); } /** * Returns a composed function that first applies this function to * its input, and then applies the {@code after} function to the result. * If evaluation of either function throws an exception, it is relayed to * the caller of the composed function. * * @param <V> the type of output of the {@code after} function, and of the * composed function * @param after the function to apply after this function is applied * @return a composed function that first applies this function and then * applies the {@code after} function * @throws NullPointerException if after is null * * @see #compose(Function) */ default <V> Function<T, V> andThen(Function<? super R, ? extends V> after) { Objects.requireNonNull(after); return (T t) -> after.apply(apply(t)); } /** * Returns a function that always returns its input argument. * * @param <T> the type of the input and output objects to the function * @return a function that always returns its input argument */ static <T> Function<T, T> identity() { return t -> t; } } 首先此接口只有一个抽象方法apply,该方法接收一个T类型对象,返回一个R类型的结果。 定义使用类 public static Integer doFunction(Function<String,Integer> function,String input) { return function.apply(input); } 使用示例1 接收一个String类型的入参,返回Integer类型的结果。示例中没做具体异常判断。 System.out.println(doFunction(input -> input.length(), "baigt")); // 上述结果为 5 System.out.println(doFunction(((Function<String, Integer>) (input -> input.length())).compose(input -> String.valueOf(input.length() * 3)), "baigt")); // 上述结果为 2 System.out.println(doFunction(((Function<String, Integer>) (input -> { System.out.println("notcompose:"+input); return Integer.valueOf(input)+1; })).compose(input -> { System.out.println("compose:"+input); return String.valueOf(Integer.valueOf(input)*3); }), "22")); // 上述结果为 67 compose是先执行的部分,上述例子中,是根据输入参数进行进一步的加工,再作为输入参数传递给具体调用者。 引用 前边提到了方法引用和构造引用两种,其实构造引用是一种特殊方法引用。具体参照官方文档说明中“Kinds of Method References”部分。 种类 用例 类名::静态方法 String::valueOf 实例对象::实例方法 doctor1::getInterest 类名::实例方法 String::toUpperCase 类名::new (构造引用) String::new 静态引用 使用类 public static String doStaticReference(Function<Integer,String> function, Integer input) { return function.apply(input); } 示例 doStaticReference(String::valueOf,123456); 实例对象引用实例方法 使用类 class Doctor{ String name; String interest; public Doctor(String name, String interest) { this.name = name; this.interest = interest; } public String getStringInstance(){ return new String(name); } } 示例 Doctor doctor1=new Doctor("baigt007","java"); Supplier<String> instance = doctor1::getInterest; 类引用实例方法 使用类 public static String doMethodReference(Function<String,String> function, String input) { return function.apply(input); } 示例 doMethodReference(String::toUpperCase,"baigt");O 构造引用 示例 Supplier<String> stringInstance = String::new; 结语 上述是个人心得,不对之处,欢迎指正。 作者:baigt 交流群:244930845

优秀的个人博客,低调大师

深入理解 Go-Defer的机制

defer 的作用和执行时机go 的 defer 语句是用来延迟执行函数的,而且延迟发生在调用函数 return 之后,比如 func a() int { defer b() return 0}b 的执行是发生在return 0之后,注意defer 的语法,关键字defer之后是函数的调用。 defer 的重要用途一:清理释放资源由于defer 的延迟特性,defer常用在函数调用结束之后清理相关的资源,比如 f, _ := os.Open(filename)defer f.Close()文件资源的释放会在函数调用结束之后借助 defer 自动执行,不需要时刻记住哪里的资源需要释放,打开和释放必须相对应。 用一个例子深刻诠释一下defer带来的便利和简洁。 代码的主要目的是打开一个文件,然后复制内容到另一个新的文件中,没有defer时这样写: func CopyFile(dstName, srcName string) (written int64, err error) { src, err := os.Open(srcName) if err != nil { return } dst, err := os.Create(dstName) if err != nil { //1 return } written, err = io.Copy(dst, src) dst.Close() src.Close() return }代码在 #1处返回之后,src文件没有执行关闭操作,可能会导致资源不能正确释放,改用 defer实现: func CopyFile(dstName, srcName string) (written int64, err error) { src, err := os.Open(srcName) if err != nil { return } defer src.Close() dst, err := os.Create(dstName) if err != nil { return } defer dst.Close() return io.Copy(dst, src) }src 和dst都能及时清理和释放,无论return在什么地方执行。 鉴于defer 的这种作用,defer常用来释放数据库连接,文件打开句柄等释放资源的操作。 defer的重要用途二:执行recover被 defer的函数在return之后执行,这个时机点正好可以捕获函数抛出的 panic,因而 defer 的另一个重要用途就是执行 recover。 recover 只有在defer中使用才更有意义,如果在其他地方使用,由于 program已经调用结束而提前返回而无法有效捕捉错误。 package main import ( "fmt" ) func main() { defer func() { if ok := recover(); ok != nil { fmt.Println("recover") } }() panic("error") }记住defer要放在panic执行之前。 多个 defer 的执行顺序defer 的作用就是把关键字之后的函数执行压入一个栈中延迟执行,多个defer的执行顺序是后进先出LIFO: defer func() { fmt.Println("1") }()defer func() { fmt.Println("2") }()defer func() { fmt.Println("3") }()输出顺序是 321。 这个特性可以对一个 array实现逆序操作。 被 deferred 函数的参数在 defer 时确定这是 defer的特点,一个函数被 defer时,它的参数在defer 时进行计算确定,即使defer之后参数发生修改,对已经defer的函数没有影响,什么意思?看例子: func a() { i := 0 defer fmt.Println(i) i++ return }a 执行输出的是 0 而不是 1,因为defer 时,i 的值是 0,此时被 defer的函数参数已经进行执行计算并确定了。 再看一个例子: func calc(index string, a, b int) int { ret := a + b fmt.Println(index, a, b, ret) return ret } func main() { a := 1 b := 2 defer calc("1", a, calc("10", a, b)) a = 0 return }执行代码输出 10 1 2 3 1 1 3 4defer函数的参数 第三个参数在 defer时就已经计算完成并确定,第二个参数 a 也是如此,无论之后 a 变量是否修改都不影响。 被 defer的函数可以读取和修改带名称的返回值func c() (i int) { defer func() { i++ }() return 1 }被 defer的函数是在return 之后执行,可以修改带名称的返回值,上面的函数 c 返回的是 2。 参考资料https://blog.golang.org/defer-panic-and-recover

优秀的个人博客,低调大师

深入理解Presto(1) : Presto的架构

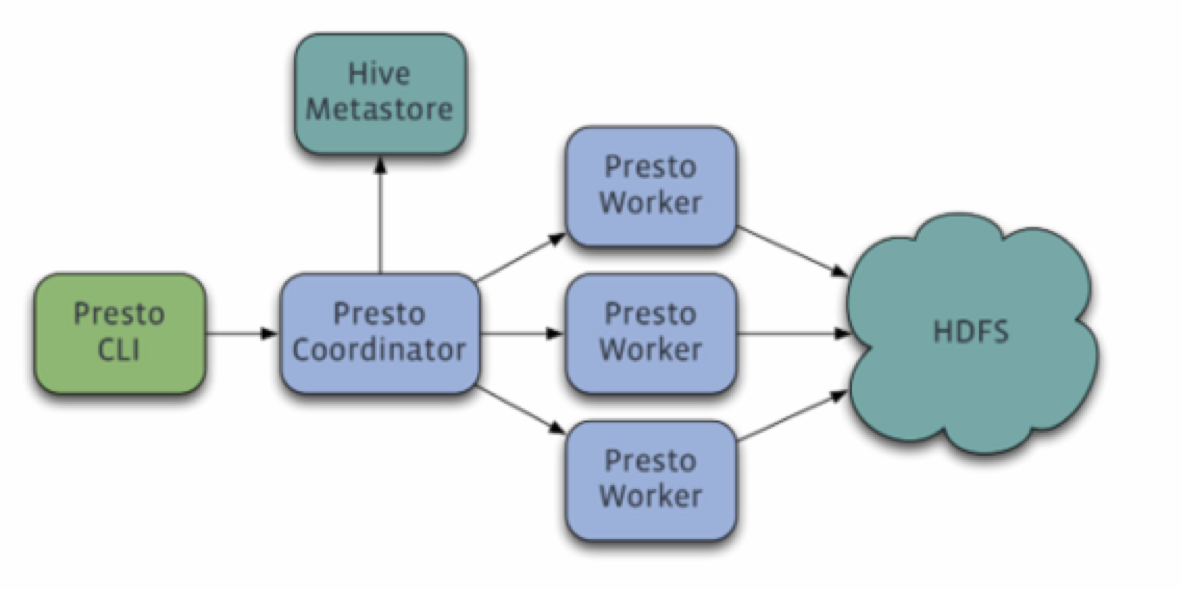
简介 Presto是一个facebook开源的分布式SQL查询引擎,适用于交互式分析查询,数据量支持GB到PB字节。presto的架构由关系型数据库的架构演化而来。presto之所以能在各个内存计算型数据库中脱颖而出,在于以下几点: 清晰的架构,是一个能够独立运行的系统,不依赖于任何其他外部系统。例如调度,presto自身提供了对集群的监控,可以根据监控信息完成调度。 简单的数据结构,列式存储,逻辑行,大部分数据都可以轻易的转化成presto所需要的这种数据结构。 丰富的插件接口,完美对接外部存储系统,或者添加自定义的函数。 本文从外到内,依次来介绍presto。 架构 Presto采用典型的master-slave模型: coordinator(master)负责meta管理,worker管理,query的解析和调度 worker则负责计算和读写

优秀的个人博客,低调大师

你真的理解 Android 中的 Context 么?

概述 在使用getContext方法的时候有没有想过,在不同的场景下,取到的Context到底有什么不同,View,Fragment,Activity和Application的getContext又究竟是怎么样? 下面来分析一下。 获取Context DecorView DecorView的Context是Application Context。 ActivityThread.addView -> PhoneWindow.generateDecor View 一般View是从LayoutInflater类中inflate生成的,查看inflate方法,会调用rinflate 发现是入参Context,在inflate方法内赋值,其实最后就是LayoutInflater.from的参数Context。 所以结论是普通View是LayoutInflater.from的参数Context。 但是对于xml这样的布局文件里面的View又是怎么样的呢? 看一下Activity.setContentView方法的调用过程是: Activity.setContentView -> PhoneWindow.setContentView -> LayoutInflater.inflate方法,而这个LayoutInflater是在PhoneWindow的构造方法内创建的,回到Activity.attach方法,看到构造方法的参数是Activity的Context。 于是增加一个结论,在xml中解析的View的Context属于Activity。 可能有人问,那Fragment也是吗?看一下Fragment.onCreateView中参数有LayoutInflater,跟踪一下 Fragment.onCreateView <- Fragment.performCreateView -> FragmentManagerImpl.moveToState <- Fragment.performGetLayoutInflater <- Fragment.getLayoutInflater <- FragmentHostCallback.onGetLayoutInflater 结果是用了FramgentHostCallback构造方法的参数Context 结论也是Activity的Context。 FragmentActivity 一般使用FragmentActivity.this和FragmentActivity.getContext方法取到Context,最终取到的都是Activity的Context,不再赘述。 Fragment 通过Fragment.getContext取到Context,结果是取到FragmentHostCallback.getContext也是Activity的Context。 Application 取到的是Application Context。 Applicaiton与Activity的区别 所以最终的目的是区分Application与Activity的Context有什么不同。所以看它们各自的实现,Application与Activity都继承于ContextWrapper,ContextWrapper就是包装了一下抽象类Context,在构造方法里传入Context对象,根本在于构建Application和Activity的地方。 追踪一下发现Context构建都在ContextImpl类内,Application对应createAppContext,而Activity则对应createActivityContext,都在ActivityThread中调用各自创建Context方法进行初始化。 对比ContextImpl的构建,前三个参数都一致,Activity的Context多了activityToken和classLoder,其中activityToken对应ActivityRecord类,接着调用Context.setResource方法设置Activity的配置和逻辑显示相关的信息Display。 看一下这个熟悉的错误,这个是使用Application的Context启动Activity时报的错误,这个mSourceRecord就是AcitivityRecord对象,对于Application而言为null,所以需要指定New_Task这个标志。 两者之间更重要的一个区别是:生命周期。 对于Application的Context而言,在整个应用的生命周期内都不会改变;而对于不同的Activity,其Context有可能不同,例如添加一个Dialog必须附着在Activity上,所以使用Application就会报错。 总结 除了Application,DecorView和getApplicationContext方法会取到Application Context外,其他方法getContext都会取到Activity Context或者传入的Context。 一般来说,Application Context存在于整个应用的生命周期中,不会随场景变化而改变,所以对于打开不同的Activity,Activity Context可能存在不同,而且生命周期跟Activity的生命周期一致。 原文发布时间为:2018-11-22 本文作者:豆沙包67 本文来自云栖社区合作伙伴“安卓巴士Android开发者门户”,了解相关信息可以关注“安卓巴士Android开发者门户”。

优秀的个人博客,低调大师

深入理解Java内存模型(五)——锁

锁的释放-获取建立的happens before 关系 锁是java并发编程中最重要的同步机制。锁除了让临界区互斥执行外,还可以让释放锁的线程向获取同一个锁的线程发送消息。 下面是锁释放-获取的示例代码: class MonitorExample { int a = 0; public synchronized void writer() { //1 a++; //2 } //3 int i = a; //5 public synchronized void reader() { //4 …… } //6 } 假设线程A执行writer()方法,随后线程B执行reader()方法。根据happens before规则,这个过程包含的happens before 关系可以分为两类: ●根据程序次序规则,1 happens before 2, 2 happens before 3; 4 happens before 5, 5 happens before 6。 ●根据监视器锁规则,3 happens before 4。 ●根据happens before 的传递性,2 happens before 5。 在上图中,每一个箭头链接的两个节点,代表了一个happens before 关系。黑色箭头表示程序顺序规则;橙色箭头表示监视器锁规则;蓝色箭头表示组合这些规则后提供的happens before保证。 上图表示在线程A释放了锁之后,随后线程B获取同一个锁。在上图中,2 happens before 5。因此,线程A在释放锁之前所有可见的共享变量,在线程B获取同一个锁之后,将立刻变得对B线程可见。 锁释放和获取的内存语义 当线程释放锁时,JMM会把该线程对应的本地内存中的共享变量刷新到主内存中。以上面的MonitorExample程序为例,A线程释放锁后,共享数据的状态 当线程获取锁时,JMM会把该线程对应的本地内存置为无效。从而使得被监视器保护的临界区代码必须要从主内存中去读取共享变量。下面是锁获取的状态 对比锁释放-获取的内存语义与volatile写-读的内存语义,可以看出:锁释放与volatile写有相同的内存语义;锁获取与volatile读有相同的内存语义。 下面对锁释放和锁获取的内存语义做个总结: ●线程A释放一个锁,实质上是线程A向接下来将要获取这个锁的某个线程发出了(线程A对共享变量所做修改的)消息。 ●线程B获取一个锁,实质上是线程B接收了之前某个线程发出的(在释放这个锁之前对共享变量所做修改的)消息。 ●线程A释放锁,随后线程B获取这个锁,这个过程实质上是线程A通过主内存向线程B发送消息。 锁内存语义的实现 本文将借助ReentrantLock的源代码,来分析锁内存语义的具体实现机制。 请看下面的示例代码: class ReentrantLockExample { int a = 0; ReentrantLock lock = new ReentrantLock(); public void writer() { lock.lock(); //获取锁 try { public void reader () { a++; } finally { lock.unlock(); //释放锁 } } lock.unlock(); //释放锁 lock.lock(); //获取锁 try { int i = a; …… } finally { } } } 在ReentrantLock中,调用lock()方法获取锁;调用unlock()方法释放锁。 ReentrantLock的实现依赖于java同步器框架AbstractQueuedSynchronizer(本文简称之为AQS)。AQS使用一个整型的volatile变量(命名为state)来维护同步状态,马上我们会看到,这个volatile变量是ReentrantLock内存语义实现的关键。 ReentrantLock分为公平锁和非公平锁,我们首先分析公平锁。 使用公平锁时,加锁方法lock()的方法调用轨迹如下: ●ReentrantLock : lock() ●FairSync : lock() ●AbstractQueuedSynchronizer : acquire(int arg) ●ReentrantLock : tryAcquire(int acquires) 在第4步真正开始加锁,下面是该方法的源代码: protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); if (c == 0) { int c = getState(); //获取锁的开始,首先读volatile变量state if (isFirst(current) && else if (current == getExclusiveOwnerThread()) { compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } setState(nextc); int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); return true; } } return false; 从上面源代码中我们可以看出,加锁方法首先读volatile变量state。 在使用公平锁时,解锁方法unlock()的方法调用轨迹如下: ●ReentrantLock : unlock() ●AbstractQueuedSynchronizer : release(int arg) ●Sync : tryRelease(int releases) 在第3步真正开始释放锁,下面是该方法的源代码: protected final boolean tryRelease(int releases) { int c = getState() - releases; if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; if (c == 0) { return free; free = true; setExclusiveOwnerThread(null); } setState(c); //释放锁的最后,写volatile变量state } 从上面的源代码我们可以看出,在释放锁的最后写volatile变量state。 公平锁在释放锁的最后写volatile变量state;在获取锁时首先读这个volatile变量。根据volatile的happens-before规则,释放锁的线程在写volatile变量之前可见的共享变量,在获取锁的线程读取同一个volatile变量后将立即变的对获取锁的线程可见。 现在我们分析非公平锁的内存语义的实现。 非公平锁的释放和公平锁完全一样,所以这里仅仅分析非公平锁的获取。 使用公平锁时,加锁方法lock()的方法调用轨迹如下: ●ReentrantLock : lock() ●NonfairSync : lock() ●AbstractQueuedSynchronizer : compareAndSetState(int expect, int update) 在第3步真正开始加锁,下面是该方法的源代码: protected final boolean compareAndSetState(int expect, int update) { return unsafe.compareAndSwapInt(this, stateOffset, expect, update); } 该方法以原子操作的方式更新state变量,本文把java的compareAndSet()方法调用简称为CAS。JDK文档对该方法的说明如下:如果当前状态值等于预期值,则以原子方式将同步状态设置为给定的更新值。此操作具有 volatile 读和写的内存语义。 这里我们分别从编译器和处理器的角度来分析,CAS如何同时具有volatile读和volatile写的内存语义。 前文我们提到过,编译器不会对volatile读与volatile读后面的任意内存操作重排序;编译器不会对volatile写与volatile写前面的任意内存操作重排序。组合这两个条件,意味着为了同时实现volatile读和volatile写的内存语义,编译器不能对CAS与CAS前面和后面的任意内存操作重排序。 下面我们来分析在常见的intel x86处理器中,CAS是如何同时具有volatile读和volatile写的内存语义的。 下面是sun.misc.Unsafe类的compareAndSwapInt()方法的源代码: public final native boolean compareAndSwapInt(Object o, long offset, int expected, int x); 可以看到这是个本地方法调用。这个本地方法在openjdk中依次调用的c++代码为:unsafe.cpp,atomic.cpp和atomicwindowsx86.inline.hpp。这个本地方法的最终实现在openjdk的如下位置:openjdk-7-fcs-src-b147-27jun2011openjdkhotspotsrcoscpuwindowsx86vm atomicwindowsx86.inline.hpp(对应于windows操作系统,X86处理器)。下面是对应于intel x86处理器的源代码的片段: // Adding a lock prefix to an instruction on MP machine // VC++ doesn't like the lock prefix to be on a single line // so we can't insert a label after the lock prefix. // By emitting a lock prefix, we can define a label after it. #define LOCK_IF_MP(mp) __asm cmp mp, 0 __asm je L0 __asm _emit 0xF0 __asm L0: // alternative for InterlockedCompareExchange inline jint Atomic::cmpxchg (jint exchange_value, volatile jint* dest, jint compare_value) { int mp = os::is_MP(); __asm { mov edx, dest mov ecx, exchange_value } mov eax, compare_value LOCK_IF_MP(mp) cmpxchg dword ptr [edx], ecx } 如上面源代码所示,程序会根据当前处理器的类型来决定是否为cmpxchg指令添加lock前缀。如果程序是在多处理器上运行,就为cmpxchg指令加上lock前缀(lock cmpxchg)。反之,如果程序是在单处理器上运行,就省略lock前缀(单处理器自身会维护单处理器内的顺序一致性,不需要lock前缀提供的内存屏障效果)。 intel的手册对lock前缀的说明如下: ●确保对内存的读-改-写操作原子执行。在Pentium及Pentium之前的处理器中,带有lock前缀的指令在执行期间会锁住总线,使得其他处理器暂时无法通过总线访问内存。很显然,这会带来昂贵的开销。从Pentium 4,Intel Xeon及P6处理器开始,intel在原有总线锁的基础上做了一个很有意义的优化:如果要访问的内存区域(area of memory)在lock前缀指令执行期间已经在处理器内部的缓存中被锁定(即包含该内存区域的缓存行当前处于独占或以修改状态),并且该内存区域被完全包含在单个缓存行(cache line)中,那么处理器将直接执行该指令。由于在指令执行期间该缓存行会一直被锁定,其它处理器无法读/写该指令要访问的内存区域,因此能保证指令执行的原子性。这个操作过程叫做缓存锁定(cache locking),缓存锁定将大大降低lock前缀指令的执行开销,但是当多处理器之间的竞争程度很高或者指令访问的内存地址未对齐时,仍然会锁住总线。 ●禁止该指令与之前和之后的读和写指令重排序。 ●把写缓冲区中的所有数据刷新到内存中。 上面的第2点和第3点所具有的内存屏障效果,足以同时实现volatile读和volatile写的内存语义。 经过上面的这些分析,现在我们终于能明白为什么JDK文档说CAS同时具有volatile读和volatile写的内存语义了。 现在对公平锁和非公平锁的内存语义做个总结: ●公平锁和非公平锁释放时,最后都要写一个volatile变量state。 ●公平锁获取时,首先会去读这个volatile变量。 ●非公平锁获取时,首先会用CAS更新这个volatile变量,这个操作同时具有volatile读和volatile写的内存语义。 从本文对ReentrantLock的分析可以看出,锁释放-获取的内存语义的实现至少有下面两种方式: ●利用volatile变量的写-读所具有的内存语义。 ●利用CAS所附带的volatile读和volatile写的内存语义。 concurrent包的实现 由于java的CAS同时具有 volatile 读和volatile写的内存语义,因此Java线程之间的通信现在有了下面四种方式: ●A线程写volatile变量,随后B线程读这个volatile变量。 ●A线程写volatile变量,随后B线程用CAS更新这个volatile变量。 ●A线程用CAS更新一个volatile变量,随后B线程用CAS更新这个volatile变量。 ●A线程用CAS更新一个volatile变量,随后B线程读这个volatile变量。 Java的CAS会使用现代处理器上提供的高效机器级别原子指令,这些原子指令以原子方式对内存执行读-改-写操作,这是在多处理器中实现同步的关键(从本质上来说,能够支持原子性读-改-写指令的计算机器,是顺序计算图灵机的异步等价机器,因此任何现代的多处理器都会去支持某种能对内存执行原子性读-改-写操作的原子指令)。同时,volatile变量的读/写和CAS可以实现线程之间的通信。把这些特性整合在一起,就形成了整个concurrent包得以实现的基石。如果我们仔细分析concurrent包的源代码实现,会发现一个通用化的实现模式: ●首先,声明共享变量为volatile; ●然后,使用CAS的原子条件更新来实现线程之间的同步; ●同时,配合以volatile的读/写和CAS所具有的volatile读和写的内存语义来实现线程之间的通信。 原文发布时间为:2018-09-27 本文来自云栖社区合作伙伴“Java杂记”,了解相关信息可以关注“Java杂记”。

优秀的个人博客,低调大师

深入理解Java中的反射机制

JAVA反射机制是在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意方法和属性;这种动态获取信息以及动态调用对象方法的功能称为java语言的反射机制。 一:Class类 在面向对象的世界里,万物皆对象。类也是对象,类是java.lang.Class类的实例对象。 Class类的实例表示正在运行的 Java 应用程序中的类和接口。枚举是一种类,注释是一种接口。每个数组属于被映射为 Class 对象的一个类,所有具有相同元素类型和维数的数组都共享该 Class 对象。 基本的 Java 类型(boolean、byte、char、short、int、long、float 和 double)和关键字 void 也表示为 Class 对象。 Class 没有公共构造方法。Class 对象是在加载类时由 Java 虚拟机以及通过调用类加载器中的 defineClass 方法自动构造的。 上面来自于JDK的罗里吧嗦,下面我来说下自己的体会: 类不是抽象的,类是具体的! 类是.class字节码文件,要想获取一个Class实例对象,首先需要获取.class字节码文件! 然后调用Class对象的一些方法,进行动态获取信息以及动态调用对象方法! 二:类类型 新建一个Foo类。Foo这个类也是实例对象,是Class的实例对象。 不知道你是否在意过类的声明与方法的声明: public class Foo{ Foo(){ //构造方法 } } public Foo method(){ //... } 我们知道public后跟返回类型,也就可以知道class也是一个类型。 如何表示Class的实例对象? public static void main(String[] args) { //Foo的实例对象,new 就出来了 Foo foo1 = new Foo(); //如何表示? //第一种:告诉我们任何一个类都有一个隐含的静态成员变量class Class c1 = Foo.class; //第二种:已经知道该类的对象通过getClass方法 Class c2 = foo1.getClass(); System.out.println(c1 == c2); //第三种:动态加载 Class c3 = null; try { c3 = Class.forName("cn.zyzpp.reflect.Foo"); } catch (ClassNotFoundException e) { e.printStackTrace(); } System.out.println(c2 == c3); } 上述打印结果全是true 尽管 c1或c2 都代表了Foo的类类型,一个类只能是Class类的一个实例变量。 我们完全可以通过类的类类型(Class类型)创建类的实例对象。 //此时c1 c2 c3为Class的实例对象 try { // Foo foo = (Foo)c1.newInstance(); Foo foo = (Foo)c3.newInstance(); foo.print(); } catch (InstantiationException e) { e.printStackTrace(); } catch (IllegalAccessException e) { e.printStackTrace(); } 静态加载 new 创建对象是静态加载类,在编译时刻就需要加载所有的可能使用到的类 。 动态加载 使用 Class.forName("类的全称") 加载类称作为动态加载 。 编译时刻加载类是静态加载类,运行时刻加载类是动态加载类。 举个例子 定义Office类 public class Office { public void print() { System.out.println("office"); } } 定义Loading类 public class Loading { public static void main(String[] args) { try { //在运行时再动态加载类 //arg[0] 为java执行命令时传的参数 Class<?> a = Class.forName(args[0]); Office office = (Office) a.newInstance(); office.print(); } catch (ClassNotFoundException e) { e.printStackTrace(); } catch (IllegalAccessException e) { e.printStackTrace(); } catch (InstantiationException e) { e.printStackTrace(); } } } 执行过程 D:\>javac -encoding utf-8 Loading.java Office.java D:\>java Loading Office office 通过Class a=Class.forName(arg[0])动态加载获取类,因编译时不知道使用哪个类,因此编译没有加载任何类,直接通过编译,运行时,根据 java Loading Office (office是一个类类型/类,下标arg[0]),去确定a是哪个类。这就是动态加载。如果Office类不存在,此时运行会报错。这就是为何有时候会出现编译通过,运行报错的原因。 动态加载一个好处,就是可以随时增加需要编译的类。例如把Office改造为抽象类或接口,定义不同的子类,动态选择加载。 三:类的反射 通过上面的三种方法获取到类的类类型,就可以获取到该类的成员方法,成员变量,方法参数注释等信息。 方法对象是Method类,一个成员方法就是一个Method对象。 方法 解释 getMethods() 返回该类继承以及自身声明的所有public的方法数组 getDeclaredMethods() 返回该类自身声明的所有public的方法数组,不包括继承而来 成员变量也是对象,是java.lang.reflect.Field对象,Field类封装了关于成员变量的操作。 方法 解释 getFields() 获取所有的public的成员变量信息,包括继承的。 getDeclaredFields() 获取该类自己声明的成员变量信息,public,private等 获取Java语言修饰符(public、private、final、static)的int返回值,再调用Modifier.toString()获取修饰符的字符串形式,注意该方法会返回所有修饰符。 方法 解释 getModifiers() 以整数形式返回由此对象表示的字段的 Java 语言修饰符。 获取注释 方法 解释 getAnnotations() 返回此元素上存在的所有注释。 getDeclaredAnnotations() 返回直接存在于此元素上的所有注释。 构造函数也是对象,是java.lang.reflect.Constructor的对象。 方法 解释 getConstructors() 返回所有public构造方法 getDeclaredConstructors() 返回类的所有构造方法,不止public 完整示例 private void printClassMessage(Object obj){ //要获取类的信息,首先获取类的类类型 Class clazz = obj.getClass(); //获取类的名称 System.out.println(Modifier.toString(clazz.getModifiers())+" "+ clazz.getClass().getName()+" "+clazz.getName()+"{"); System.out.println("----构造方法----"); //构造方法 Constructor[] constructors = clazz.getDeclaredConstructors(); for (Constructor constructor: constructors){ //构造方法修饰符与名字 System.out.print(Modifier.toString(constructor.getModifiers())+" "+constructor.getName()+"("); //构造函数的所有参数类型 Class[] parameterTypes = constructor.getParameterTypes(); for (Class c: parameterTypes){ System.out.print(c.getName()+", "); } System.out.println("){}"); } System.out.println("----成员变量----"); //成员变量 Field[] fields = clazz.getDeclaredFields(); for (Field field: fields){ System.out.println(" "+Modifier.toString(field.getModifiers())+" "+field.getType().getName() + " " + field.getName()+";"); } System.out.println("----成员方法----"); //Method类,方法对象,一个成员方法就是一个Method对象 Method[] methods = clazz.getDeclaredMethods(); for (Method method : methods){ //获取方法返回类型 Class returnType = method.getReturnType(); //获取方法上的所有注释 Annotation[] annotations = method.getAnnotations(); for (Annotation annotation: annotations){ //打印注释类型 System.out.println(" @"+annotation.annotationType().getName()+" "); } //打印方法声明 System.out.print(" "+Modifier.toString(returnType.getModifiers())+" "+returnType.getName()+" "+method.getName()+"("); //获取方法的所有参数类型 Class<?>[] parameterTypes = method.getParameterTypes(); //获取方法的所有参数 Parameter[] parameters = method.getParameters(); for (Parameter parameter: parameters){ //参数的类型,形参(全是arg123..) System.out.print(parameter.getType().getName()+" "+parameter.getName()+", "); } System.out.println(")"); } System.out.println("}"); } 以String对象为例,打印结果: public final java.lang.Class java.lang.String{ ----构造方法---- public java.lang.String([B, int, int, ){} java.lang.String([C, boolean, ){} ----成员变量---- private final [C value; private int hash; ----成员方法---- @java.lang.Deprecated public abstract final void getBytes(int arg0, int arg1, [B arg2, int arg3, ) ...... } 四:方法的反射 定义了一个类Foo用于测试 public class Foo{ public void print(String name,int num) { System.out.println("I am "+name+" age "+num); } } 目标:通过反射获取该方法,传入参数,执行该方法! 1.获取类的方法就是获取类的信息,获取类的信息首先要获取类的类类型 Class clazz = Foo.class; 2.通过名称+参数类型获取方法对象 Method method = clazz.getMethod("print", new Class[]{String.class,int.class}); 3.方法的反射操作是通过方法对象来调用该方法,达到和new Foo().print()一样的效果 方法若无返回值则返回null Object o = method.invoke(new Foo(),new Object[]{"name",20}); 五:通过反射认识泛型 public static void main(String[] args) { ArrayList<String> stringArrayList = new ArrayList<>(); stringArrayList.add("hello"); ArrayList arrayList = new ArrayList(); Class c1 = stringArrayList.getClass(); Class c2 = arrayList.getClass(); System.out.println(c1 == c2); } 打印结果为true c1==c2的结果返回说明编译之后集合的泛型是去泛型化的。换句话说,泛型不同,对类型没有影响。 Java中集合的泛型其实只是为了防止错误输入,只在编译阶段有效,绕过编译就无效。 验证 我们可以通过反射来操作,绕过编译。 public static void main(String[] args) { ArrayList<String> stringArrayList = new ArrayList<>(); stringArrayList.add("hello"); ArrayList arrayList = new ArrayList(); Class c1 = stringArrayList.getClass(); Class c2 = arrayList.getClass(); System.out.println(c1 == c2); try { Method method = c1.getMethod("add",Object.class); method.invoke(stringArrayList,20); System.out.println(stringArrayList.toString()); } catch (NoSuchMethodException e) { e.printStackTrace(); } catch (IllegalAccessException e) { e.printStackTrace(); } catch (InvocationTargetException e) { e.printStackTrace(); } } 打印结果: true [hello, 20] 成功绕过了泛型<String>的约束。

优秀的个人博客,低调大师

深入理解SpringBoot的过滤条件--AutoConfigure

我们知道在Spring及SpringBoot里按条件创建Bean的核心是Condition接口与Conditional注解,其实在SpringBoot里还有一种AutoConfigure也可以来过滤配置,只不过使用这种技术,能够让SpringBoot更快速的启动,那么下面我们就来看一下具体怎么实现的。 autoconfigure Module SpringBoot使用一个Annotation的处理器来收集一些自动装配的条件,那么这些条件可以在META-INF/spring-autoconfigure-metadata.properties进行配置。SpringBoot会将收集好的@Configuration进行一次过滤进而剔除不满足条件的配置类。 演示示例 在我们创建好的SpringBoot项目里添加一个AutoConfiguration: package com.ys.zhshop.member.config; import com.ys.zhshop.member.service.MemberRegisterService; import org.springframework.context.annotation.Bean; public class MemberAutoConfiguration { @Bean public MemberRegisterService registerService() { return new MemberRegisterService(); } } 在MemberRegisterService里的构造函数输出一段内容看看Spring是否帮我们初始化 紧接着在META-INF/spring.factories里配置对应的引导: org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ com.ys.zhshop.member.config.MemberAutoConfiguration 随后我们需要在META-INF目录下创建一个spring-autoconfigure-metadata.properties 文件,内容如下: com.ys.zhshop.member.config.MemberAutoConfiguration.ConditionalOnClass=java.lang.Strings 格式:自动配置的类全名.条件=值 在这里我们先指定一个类路径下不存在的Java类,启动后并没有相关信息的输出,那么把其值改成java.land.String,那么我们启动可以发现: 在这里,我们可以在控制台看到构造函数输出的值,这就说明我们的Bean的的确确被创建了 下面我贴出一个spring-cloud-netflix-core下的配置,主要来看看这些条件该怎么写,大家如果想使用可以参考人家的来配置: #Mon Jun 18 19:13:37 UTC 2018 org.springframework.cloud.netflix.hystrix.HystrixAutoConfiguration.ConditionalOnClass=com.netflix.hystrix.Hystrix,org.springframework.boot.actuate.health.HealthIndicator org.springframework.cloud.netflix.hystrix.HystrixAutoConfiguration= org.springframework.cloud.netflix.hystrix.security.HystrixSecurityAutoConfiguration= org.springframework.cloud.netflix.hystrix.HystrixAutoConfiguration.Configuration= org.springframework.cloud.netflix.hystrix.HystrixCircuitBreakerConfiguration= org.springframework.cloud.netflix.hystrix.HystrixAutoConfiguration.AutoConfigureAfter=org.springframework.boot.actuate.autoconfigure.health.HealthIndicatorAutoConfiguration org.springframework.cloud.netflix.hystrix.HystrixCircuitBreakerConfiguration.Configuration= org.springframework.cloud.netflix.hystrix.security.HystrixSecurityAutoConfiguration.Configuration= org.springframework.cloud.netflix.hystrix.security.HystrixSecurityAutoConfiguration.ConditionalOnClass=com.netflix.hystrix.Hystrix,org.springframework.security.core.context.SecurityContext 根据官网说法,使用这种配置方式可以有效的降低SpringBoot的启动时间,因为通过这种过滤方式能减少@Configuration类的数量,从而降低初始化Bean时的耗时,官网原话描述如下: Spring Boot uses an annotation processor to collect the conditions on auto-configurations in a metadata file (META-INF/spring-autoconfigure-metadata.properties). If that file is present, it is used to eagerly filter auto-configurations that do not match, which will improve startup time. 源码追踪 我们再次打开自动化配置的核心类AutoConfigurationImportSelector,看看它的selectImport方法: @Override public String[] selectImports(AnnotationMetadata annotationMetadata) { if (!isEnabled(annotationMetadata)) { return NO_IMPORTS; } AutoConfigurationMetadata autoConfigurationMetadata = AutoConfigurationMetadataLoader .loadMetadata(this.beanClassLoader);//1 AnnotationAttributes attributes = getAttributes(annotationMetadata); List<String> configurations = getCandidateConfigurations(annotationMetadata, attributes);//2 configurations = removeDuplicates(configurations); Set<String> exclusions = getExclusions(annotationMetadata, attributes); checkExcludedClasses(configurations, exclusions); configurations.removeAll(exclusions); configurations = filter(configurations, autoConfigurationMetadata);//3 fireAutoConfigurationImportEvents(configurations, exclusions); return StringUtils.toStringArray(configurations); } 在代码1处创建用于加载spring-autoconfigure-metadata.properties里的元数据,在这里我们可以看到其指定文件的位置: protected static final String PATH = "META-INF/" + "spring-autoconfigure-metadata.properties"; 2.在代码2处主要通过SpringFactoriesLoader加载spring.factories里的EnableAutoConfiguration3.根据AutoConfigurationMetaData进行一次过滤: private List<String> filter(List<String> configurations, AutoConfigurationMetadata autoConfigurationMetadata) { long startTime = System.nanoTime(); String[] candidates = StringUtils.toStringArray(configurations); boolean[] skip = new boolean[candidates.length]; boolean skipped = false; for (AutoConfigurationImportFilter filter : getAutoConfigurationImportFilters()) { invokeAwareMethods(filter); boolean[] match = filter.match(candidates, autoConfigurationMetadata);//代码1 for (int i = 0; i < match.length; i++) { if (!match[i]) { skip[i] = true; skipped = true; } } } if (!skipped) { return configurations; } List<String> result = new ArrayList<>(candidates.length); for (int i = 0; i < candidates.length; i++) { if (!skip[i]) { result.add(candidates[i]); } } if (logger.isTraceEnabled()) { int numberFiltered = configurations.size() - result.size(); logger.trace("Filtered " + numberFiltered + " auto configuration class in " + TimeUnit.NANOSECONDS.toMillis(System.nanoTime() - startTime) + " ms"); } return new ArrayList<>(result); } 我们在这里主要关注代码1。OnClassCondition是AutoConfigurationImportFilter接口的实现类,我这里贴一下与主题相关的代码: @Order(Ordered.HIGHEST_PRECEDENCE) class OnClassCondition extends SpringBootCondition implements AutoConfigurationImportFilter, BeanFactoryAware, BeanClassLoaderAware { @Override public boolean[] match(String[] autoConfigurationClasses, AutoConfigurationMetadata autoConfigurationMetadata) { ConditionEvaluationReport report = getConditionEvaluationReport(); ConditionOutcome[] outcomes = getOutcomes(autoConfigurationClasses, autoConfigurationMetadata); boolean[] match = new boolean[outcomes.length]; for (int i = 0; i < outcomes.length; i++) { match[i] = (outcomes[i] == null || outcomes[i].isMatch()); if (!match[i] && outcomes[i] != null) { logOutcome(autoConfigurationClasses[i], outcomes[i]); if (report != null) { report.recordConditionEvaluation(autoConfigurationClasses[i], this, outcomes[i]); } } } return match; } //..... private ConditionOutcome[] getOutcomes(String[] autoConfigurationClasses, int start, int end, AutoConfigurationMetadata autoConfigurationMetadata) { ConditionOutcome[] outcomes = new ConditionOutcome[end - start]; for (int i = start; i < end; i++) { String autoConfigurationClass = autoConfigurationClasses[i]; Set<String> candidates = autoConfigurationMetadata .getSet(autoConfigurationClass, "ConditionalOnClass"); if (candidates != null) { outcomes[i - start] = getOutcome(candidates); } } return outcomes; } } 上述代码虽然多,但最终还是要调用AutoConfigurationMetadata 的getSet方法,我们继续追踪一下这个接口的实现类,它是位于AutoConfigurationMetadataLoader的内部类: /** * {@link AutoConfigurationMetadata} implementation backed by a properties file. */ private static class PropertiesAutoConfigurationMetadata implements AutoConfigurationMetadata { //....省略其他代码 @Override public Set<String> getSet(String className, String key) { return getSet(className, key, null); } @Override public Set<String> getSet(String className, String key, Set<String> defaultValue) { String value = get(className, key); return (value != null ? StringUtils.commaDelimitedListToSet(value) : defaultValue); } @Override public String get(String className, String key) { return get(className, key, null); } @Override public String get(String className, String key, String defaultValue) { String value = this.properties.getProperty(className + "." + key); return (value != null ? value : defaultValue); } } 最后我们可以发现其get方法还是通过java.util.Properties的getProperty方法来获取的值

优秀的个人博客,低调大师

深入理解Java中的逃逸分析

在Java的编译体系中,一个Java的源代码文件变成计算机可执行的机器指令的过程中,需要经过两段编译,第一段是把.java文件转换成.class文件。第二段编译是把.class转换成机器指令的过程。 第一段编译就是javac命令。 在第二编译阶段,JVM 通过解释字节码将其翻译成对应的机器指令,逐条读入,逐条解释翻译。很显然,经过解释执行,其执行速度必然会比可执行的二进制字节码程序慢很多。这就是传统的JVM的解释器(Interpreter)的功能。为了解决这种效率问题,引入了 JIT(即时编译) 技术。 引入了 JIT 技术后,Java程序还是通过解释器进行解释执行,当JVM发现某个方法或代码块运行特别频繁的时候,就会认为这是“热点代码”(Hot Spot Code)。然后JIT会把部分“热点代码”翻译成本地机器相关的机器码,并进行优化,然后再把翻译后的机器码缓存起来,以备下次使用。 由于关于JIT编译和热点检测的内容,我在深入分析Java的编译原理中已经介绍过了,这里就不在赘述,本文主要来介绍下JIT中的优化。JIT优化中最重要的一个就是逃逸分析。 逃逸分析 关于逃逸分析的概念,可以参考对象并不一定都是在堆上分配内存的一文,这里简单回顾一下: 逃逸分析的基本行为就是分析对象动态作用域:当一个对象在方法中被定义后,它可能被外部方法所引用,例如作为调用参数传递到其他地方中,称为方法逃逸。 例如以下代码: public static StringBuffer craeteStringBuffer(String s1, String s2) { StringBuffer sb = new StringBuffer(); sb.append(s1); sb.append(s2); return sb;}public static String createStringBuffer(String s1, String s2) { StringBuffer sb = new StringBuffer(); sb.append(s1); sb.append(s2); return sb.toString();} 第一段代码中的sb就逃逸了,而第二段代码中的sb就没有逃逸。 使用逃逸分析,编译器可以对代码做如下优化: 一、同步省略。如果一个对象被发现只能从一个线程被访问到,那么对于这个对象的操作可以不考虑同步。 二、将堆分配转化为栈分配。如果一个对象在子程序中被分配,要使指向该对象的指针永远不会逃逸,对象可能是栈分配的候选,而不是堆分配。 三、分离对象或标量替换。有的对象可能不需要作为一个连续的内存结构存在也可以被访问到,那么对象的部分(或全部)可以不存储在内存,而是存储在CPU寄存器中。 在Java代码运行时,通过JVM参数可指定是否开启逃逸分析, -XX:+DoEscapeAnalysis : 表示开启逃逸分析 -XX:-DoEscapeAnalysis : 表示关闭逃逸分析 从jdk 1.7开始已经默认开始逃逸分析,如需关闭,需要指定-XX:-DoEscapeAnalysis 同步省略 在动态编译同步块的时候,JIT编译器可以借助逃逸分析来判断同步块所使用的锁对象是否只能够被一个线程访问而没有被发布到其他线程。 如果同步块所使用的锁对象通过这种分析被证实只能够被一个线程访问,那么JIT编译器在编译这个同步块的时候就会取消对这部分代码的同步。这个取消同步的过程就叫同步省略,也叫锁消除。 如以下代码: public void f() { Object hollis = new Object(); synchronized(hollis) { System.out.println(hollis); }} 代码中对hollis这个对象进行加锁,但是hollis对象的生命周期只在f()方法中,并不会被其他线程所访问到,所以在JIT编译阶段就会被优化掉。优化成: public void f() { Object hollis = new Object(); System.out.println(hollis);} 所以,在使用synchronized的时候,如果JIT经过逃逸分析之后发现并无线程安全问题的话,就会做锁消除。 标量替换 标量(Scalar)是指一个无法再分解成更小的数据的数据。Java中的原始数据类型就是标量。相对的,那些还可以分解的数据叫做聚合量(Aggregate),Java中的对象就是聚合量,因为他可以分解成其他聚合量和标量。 在JIT阶段,如果经过逃逸分析,发现一个对象不会被外界访问的话,那么经过JIT优化,就会把这个对象拆解成若干个其中包含的若干个成员变量来代替。这个过程就是标量替换。 public static void main(String[] args) { alloc();}private static void alloc() { Point point = new Point(1,2); System.out.println("point.x="+point.x+"; point.y="+point.y);}class Point{ private int x; private int y;} 以上代码中,point对象并没有逃逸出alloc方法,并且point对象是可以拆解成标量的。那么,JIT就会不会直接创建Point对象,而是直接使用两个标量int x ,int y来替代Point对象。 以上代码,经过标量替换后,就会变成: private static void alloc() { int x = 1; int y = 2; System.out.println("point.x="+x+"; point.y="+y);} 可以看到,Point这个聚合量经过逃逸分析后,发现他并没有逃逸,就被替换成两个聚合量了。那么标量替换有什么好处呢?就是可以大大减少堆内存的占用。因为一旦不需要创建对象了,那么就不再需要分配堆内存了。 标量替换为栈上分配提供了很好的基础。 栈上分配 在Java虚拟机中,对象是在Java堆中分配内存的,这是一个普遍的常识。但是,有一种特殊情况,那就是如果经过逃逸分析后发现,一个对象并没有逃逸出方法的话,那么就可能被优化成栈上分配。这样就无需在堆上分配内存,也无须进行垃圾回收了。 关于栈上分配的详细介绍,可以参考对象并不一定都是在堆上分配内存的 这里,还是要简单说一下,其实在现有的虚拟机中,并没有真正的实现栈上分配,在对象并不一定都是在堆上分配内存的中我们的例子中,对象没有在堆上分配,其实是标量替换实现的。 逃逸分析并不成熟 关于逃逸分析的论文在1999年就已经发表了,但直到JDK 1.6才有实现,而且这项技术到如今也并不是十分成熟的。 其根本原因就是无法保证逃逸分析的性能消耗一定能高于他的消耗。虽然经过逃逸分析可以做标量替换、栈上分配、和锁消除。但是逃逸分析自身也是需要进行一系列复杂的分析的,这其实也是一个相对耗时的过程。 一个极端的例子,就是经过逃逸分析之后,发现没有一个对象是不逃逸的。那这个逃逸分析的过程就白白浪费掉了。 虽然这项技术并不十分成熟,但是他也是即时编译器优化技术中一个十分重要的手段。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册