首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

深入理解 Serverless 计算的并发度

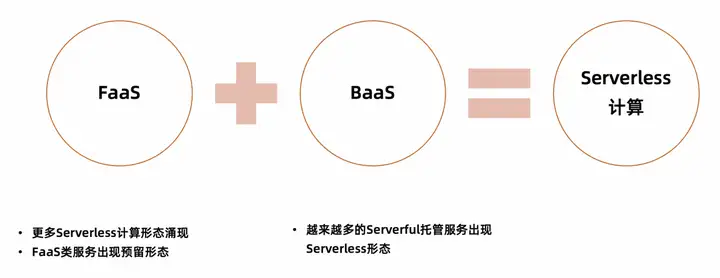
背景 2019 年 Berkeley 预测 Serverless 将取代 Serverful 计算[1],成为云计算的计算新范式。Serverless 为应用程序开发提供了一种全新的系统架构,其凭借着弹性伸缩省事省心,按需付费更低成本、聚焦业务降低 OPS 这三大核心价值,将开发人员从繁重的手动资源管理和性能成本优化中解放出来,让工程师的生产力再次发生变革。 根据 CNCF 官方定义[2]: “Serverless is a cloud native development model that allows developers to build and run applications without having to manage servers. There are still servers in serverless, but they are abstracted away from app development. A cloud provider handles the routine work of provisioning, maintaining, and scaling the server infrastructure. Developers can simply package their code in containers for deployment. Once deployed, serverless apps respond to demand and automatically scale up and down as needed. Serverless offerings from public cloud providers are usually metered on-demand through an event-driven execution model. As a result, when a serverless function is sitting idle, it doesn’t cost anything. ” 从上面的定义可以看出, Severless != No Server, 只是对于开发者来说,没有了 Server 去管理。而在云厂商提供的服务中, Serverless 架构应该是采用 FaaS(Function as a service, 函数即服务)和 BaaS(后端服务)服务来解决问题的一种设计。 FaaS 服务的典型代表: AWS lambda、 阿里云函数计算 FC、Azure Functions、Google Cloud Functions 等 BaaS 服务典型代表: AWS: S3、Dynamodb、SQS 等; 阿里云: OSS、 TableStore、MNS 等 Serverless 计算 当然随着需求和技术的发展,业界出现了一些 FaaS 以外的其它形态的 Serverless 计算服务,比如 Google Cloud Run、AWS App Runner、阿里云 Serverless 应用引擎 SAE、 阿里云 Serverless Kubernetes ASK 等,这些服务也提供了弹性伸缩能力和按使用计费的收费模式,具备 Serverless 服务的形态,可以说进一步扩大了Serverless 计算的阵营。 而在 Serverless 计算领域最典型的两种产品形态代表 FaaS 和 Google Cloud Run, 都不约而同采用了并发度(Concurrency)这个指标作为扩缩容策略。接下来我们重点剖析下不同产品形态下并发的语义以及为什么这些流行的 Serverless 计算产品为什么采用并发度作为扩缩容的策略。 什么是并发? 并发是现代计算的核心原则之一, 并发是指计算系统同时处理多个任务的能力。例如,如果您的计算机同时运行多个程序,则具有多个并发进程/线程可以共享 CPU 时间。如果单个应用程序进程同时处理多个网络请求,或者并行处理队列中的多个作业,则也可以认为该应用程序正在执行并发工作。 比如 “世界第一语言 PHP” 在 Web 领域的实践,使用就是进程池,如下图中的 FastCGI 进程管理器。发送到服务器的 Web 请求将被分配给进程池中的 CGI 进程。该 CGI 进程将处理该单个请求。如果同时收到多个请求,则将启动多个 CGI 进程并行处理它们。然而,每个进程一次只能处理一个请求。服务器能够通过对 CGI 进程进行上下文切换来处理并发请求。操作系统调度程序将跟踪所有 CGI 进程,并在需要时切换正在 CPU 上运行的 CGI 进程,以使每个 CGI 进程在需要时都能获得属于自己的、公平的 CPU 时间份额。 PHP Web 运行原理图 如今,有更多用于并发的工具, 这包括现代编程语言内置的强大异步并发机制,以及帮助简化并发的云计算服务。让我们看看一些云计算服务如何设计和使用并发。 单实例单并发 云厂商的 FaaS 服务的并发扩缩容原理基本大同小异, 我们以 AWS Lambda 官方文档[3] 为参考: 当首次调用一个函数时,FaaS 服务会创建一个函数实例,并运行处理程序方法以处理事件。完成后,函数会在一段时间内保持可用状态,以处理后续的事件。如果在函数忙碌时有其他事件到达,FaaS 会创建更多的函数实例来同时处理这些请求。 从文档中我们可以看出,每个函数实例一次只能处理一个事件请求(即 one concurrent request per instance,也称为单实例单并发)。在处理事件请求时,函数被认为是繁忙的,因此任何并发事件都必须转到另一个函数实例。每次必须创建函数的新实例时,都会出现短暂的“冷启动”(Cold Start)延迟。这个冷启动的持续时间取决于您的代码大小和使用的运行时 Runtime。下图[4]显示了当有多个并发请求需要进行并行处理时,FaaS 如何实时扩展函数实例的数量: Tips: 只有绿色部分是毫秒计费, 黄色和空白部分均不会计费, 真正100%为计算资源付费。 FaaS scaling and concurrency 这使得 FaaS 的并发模型在某些方面类似于那些老式的 PHP 进程管理器。在这两种情况下: 1). PHP 进程管理器通过并行启动更多进程来实现并发。单个进程一次只能处理一个事件请求。2). FaaS 通过并行启动更多的执行环境容器实例来实现并发, 单个实例一次只能处理一个事件请求。 但使用 PHP 进程管理器那样的进程级别的并发有两个经典难题需要解决: 进程之间的安全隔离:您必须在操作系统分配 CPU 时间和系统资源给进程时做出正确的决策。一个进程可能会消耗过多的资源,影响在同一台机器上运行的其他进程的性能。 自动扩缩容:以 PHP 应用程序为例,您必须管理每个服务器上的 PHP CGI 进程数量,并且必须对运行这些进程的服务器数量进行手动扩缩容。 FaaS 能很好解决上述两个难题,FaaS 明显有一些现代化的特点, 以函数计算执行环境容器的安全隔离为例[5]: 阿里云FC计算节点安全隔离 虚拟化级别安全隔离 神龙裸金属计算节点可运行来自不同用户的函数实例,使用阿里云安全沙箱提供函数级别虚拟化及容器隔离,ECS虚拟机只允许运行同用户的函数实例,借助ECS隔离提供用户级别虚拟化隔离,使用Runc等容器技术实现函数级别的容器隔离。 函数实例网络访问受限,用户决定网络外访权限 函数实例配置私有IP地址,用户不可直接访问,且实例间网络不可达,网络隔离使用 open vSwitch、iptables 和 routing tables 实现。 函数实例资源受限函数CPU/内存设置的配额 函数计算负责函数实例沙箱容器的漏洞修复及安全升级 使用 FaaS 这种事件驱动的全托管计算服务,您将自动获得隔离的执行环境实例,FaaS 服务自动管理执行环境实例的数量和容量。您所要做的事情就是提供您的代码到 FaaS 服务,并向 FaaS 服务发送事件以触发该代码执行即可。 FaaS 简略概览 从上面对 FaaS 并发扩缩容的讨论中,相信大家很快 get 到单个实例一个并发的能力对 CPU 密集型的逻辑非常友好。而现代的许多工作负载都充满了 I/O 操作,如果我们采用 FaaS 经典的 one concurrent request per instance 模式,会有如下痛点问题: 严重的资源浪费 IO-intensive workload[11] 2.蓝色方框表示程序正在工作时的时间,红色方框表示等待 IO 操作完成所花费的时间。由于 IO 请求可能比 CPU 指令花费的时间长几个数量级,因此您的程序可能会花费大部分时间等待, 实例资源浪费严重。并且随着并并发数目的变大,浪费的资源也呈线性增长,如下面红色部分即为浪费的计算资源: FaaS IO-intensive workload 3.可能会对共享资源造成意想不到的后果 数据库是一个典型的例子。当使用传统的关系型数据库(如 mysql)时,数据库有一个最大并发连接数。传统常驻型服务器通常使用“数据库连接池”进行优化。“数据库连接池”限制了单个服务器实例对数据库的最大并发连接数,同时允许并发的请求能有效地共享“数据库连接池”的连接。然而,如果每个实例只能处理一个请求并维持与数据库的开放连接,则请求的数量与到数据库的连接数之间存在一对一的关系。结果是在负载高峰期间,数据库可能会因过多连接而打满,并最终拒绝新连接。如果一个数据库实例的最大连接数为 100,使用 FaaS, 示意图如下: FaaS with DB 单实例多并发 因此,就 FaaS 领域的 one concurrent request per instance 的痛点问题, Google Cloud Run 提供了 multi concurrent requests per instance 的能力[6],这就很好解决我们上文讨论的单实例单并发扩缩容模型的痛点: Google Cloud Run单个实例默认最大并发度(即单个实例的并发请求数上限)为80,最大可调整到100 1.IO等待期间不再是资源浪费 Google Cloud Run IO-Intensive workload 2.对共享资源造成影响可预期:提高数据库连接吞吐 Google Cloud Run With DB 如果每个实例配置了数据库连接池大小为 10,那么每个实例可以允许 10 个并行请求到数据库。由于每个实例可能会接收高达 80 个并发请求,“数据库连接池”将在等待数据库连接被释放并返回到池中时,自动阻止传入的请求。通过使用 10 个数据库连接响应 80 个请求,理论上可以在数据库达到其最大连接限制之前将数据库的吞吐量提高 10 倍。 有趣的是, 一些 FaaS 厂商勇敢做出了 multi concurrent requests per instance的尝试, 比如阿里云函数计算设置实例并发度, Google Cloud Functions 第2代也开始支持设置实例并发度。旨在解决现代很重要的 IO 密集型工作负载问题。 为什么 Serverless 使用并发度进行扩缩容 FaaS 和 Google Cloud Run 采用实例并发度(即实例的并发请求数上限)这个指标进行扩缩容,而不是采用 CPU 指标等 HPA 策略,是因为在Serverless领域,实例并发度是“基于请求处理/事件驱动进行扩缩容”表达最好的一个方式。 FaaS 和 Google Cloud Run 都有实例缩至为 0 和有请求进来可以拉起一个新实例的能力,在实例 0-1 过程中无法使用 CPU 或内存等指标进行扩容。 更好地匹配请求处理:并发度能够更好地匹配实际请求的数量,因此可以更好地利用计算资源,同时确保请求能够快速得到响应。以阿里云函数计算和 K8S 做一个资源匹配请求速度的对比[7]: 更好的资源利用率:实例并发度策略可以更好地利用计算资源,可以在请求高峰期间快速扩容,而在请求较少时保持最小的实例数量,从而减少资源浪费。FaaS 和 Google Cloud Run 允许用户运行任何语言的代码,并自动扩展以匹配流量: 并发度总数 = 同时处理请求的实例数量 * 每个实例的最大并发请求数上限 当然,引入的并发度的概念也给习惯了 CPU 指标等扩缩容的开发者带来的新的疑惑, 对于 IO 密集型的应用,基于 CPU 指标的 HPA 扩容策略很简单就可以提高应用程序的可用性、性能和可靠性,并使资源更高效地利用。反而单个实例的最大并发度的合理值怎么去设置是一个比较头疼的问题? 这个问题,业界通常都是建议您根据自己的负载情况做压测迭代出合适的并发度值。 阿里云函数计算为此做了一个业界最前沿的探索, 提供了自动化推荐能力:从青铜到王者,揭秘 Serverless 自动化函数最佳配置[8], 并由此展望智能动态并发度:在这种模式下,用户不需要通过手动配置参数,而是在函数运行时动态调整,根据实例 CPU 负载的健康指标自动调整到最佳值。 结论 基于上文对并发度的讨论,对于单实例单并发(云产品代表 FaaS)和 单实例多并发(云产品代表 Google Cloud Run) 这两种形态的 Serverless 产品, 我应该选择哪个产品来托管我的应用程序呢? 以下是一些情景是我个人会选择哪种产品的建议: 但最终还是需要根据您具体的业务需求做取舍,选择最合适的产品和方案。 注:FaaS 中的函数计算 FC 和 Google Cloud Functions V2 也支持单实例多并发 上述表格中的建议是基于阿里云函数计算应用中心[9]中的用户对于应用的偏好部署次数【见下图】以及客户落地案例【见参考12】来佐证的, 尤其对于每个请求必须相互隔离或者 CPU 密集型任务, FaaS 具有无与伦比的优势: 对于存量应用,将 CPU 密集型任务从应用中抽离出来,提升服务的稳定性,这个文章PDF Generation With AWS Lambda[10] 深入讨论了这种实践的收益。 对于新业务 CPU/GPU 密集型应用, 如音视频处理以及最近大火的大模型 AIGC(AI generated content ) 应用, 是 FaaS 天然契合的场景 。 在 AI 场景中请求和后端资源的调度比传统的微服务场景的要求会更高,主要原因是 AI 场景的请求对资源的消耗特别大。比如一个 Stable Diffusion 使用 A10 GPU 卡部署,一块 A10 卡(ecs.gn7i-c8g1.2xlarge) 启动 Stable Diffusion 服务一次只能处理个位数的文本绘图请求。一旦同时进来请求过多,就会出现计算资源竞争从而导致请求超时的情况。而 FaaS 的 "one concurrent request per instance" 天然契合这个场景, 简直就是绝配。 函数计算FC应用中心文件处理应用部署情况图 函数计算 FC 应用中心音视频处理应用部署情况图 函数计算FC应用中心AI应用部署情况图 参考文献 https://www2.eecs.berkeley.edu/Pubs/TechRpts/2019/EECS-2019-3.pdf https://glossary.cncf.io/serverless/ https://docs.aws.amazon.com/lambda/latest/operatorguide/scaling-concurrency.html https://nathanpeck.com/concurrency-compared-lambda-fargate-app-runner/files/Concurrency%20Compared.pptx https://help.aliyun.com/document_detail/438853.html https://cloud.google.com/run/docs/about-concurrency?hl=zh-cn https://developer.aliyun.com/article/1243681 https://developer.aliyun.com/article/1161868 https://help.aliyun.com/document_detail/606948.html https://medium.com/1mgofficial/pdf-generation-with-aws-lambda-627b8dd07c77 https://realpython.com/python-concurrency/ 基于函数计算应用中心落地案例参考 网易云音乐音视频算法的 Serverless 探索之路 聚焦弹性问题,杭州铭师堂的 Serverless 之路 优化 20% 资源成本,新东方的 Serverless 实践之路 当 Rokid 遇上函数计算 多家游戏公司 apk 实时打渠道包repackAPK 作者|西流(阿里云技术专家) 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。
优秀的个人博客,低调大师

Arctic 自动优化湖仓原理解析

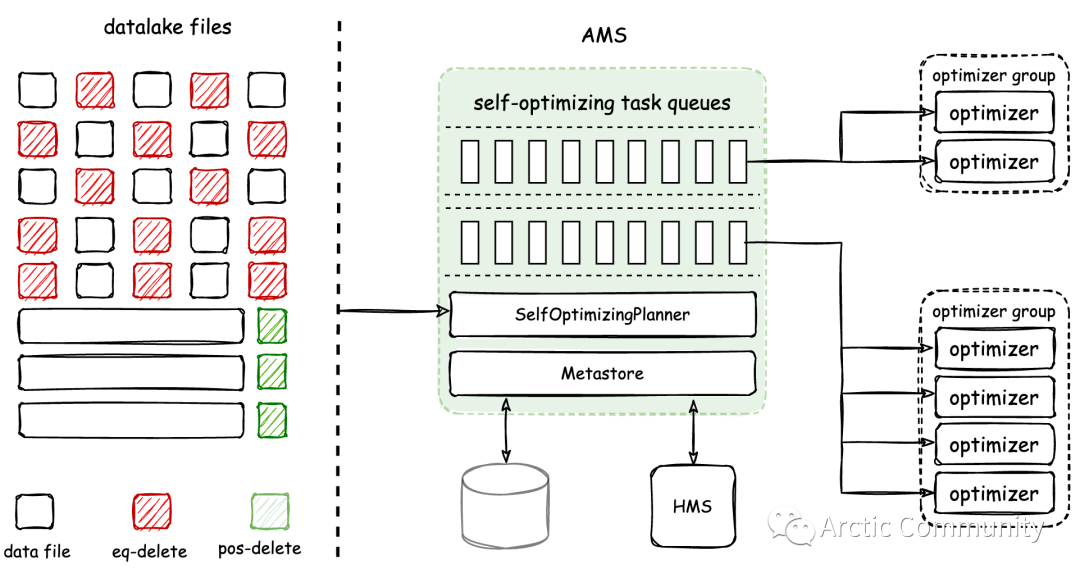
Arctic 是一个开放式架构下的湖仓管理系统,在开放的 lceberg 数据湖格式之上, 提供更多面向流和更新场景的优化,以及一套可插拔的数据自优化机制和管理服务。 背景 湖数据与数据仓库都是常见的大数据存储系统。得益于其低廉的成本优势,数据湖一般用来存储海量的原始数据。原始数据经过清洗、标准化后会再导入到数据仓库中进行数据分析。数据在两个系统间流转无疑增加了额外的存储与维护开销。 近年来随着 Apache lceberg、Apache Hudi、Delta Lake 等数据湖表格式技术的不断发展使得直接在数据湖上构建一套统一的存储系统来满足所有的大数据存储需求成为可能。业界将这种直接建立在数据湖之上,却能同时覆盖数据湖与数据仓库存储场景的架构为湖仓一体(LakeHouse)。 然而开源表格式距离生产可用的湖仓一体架构还有着较大的鸿沟,在这个背景下网易在 2022 年开源了湖仓管理系统——Arctic。Arctic 是一个开放式架构下的湖仓管理系统,在开放的数据湖格式之上,Arctic 提供更多面向流和更新场景的优化,以及一套可插拔的数据自优化机制和管理服务。基于 Arctic 可以帮助各类数据平台,工具和产品快速搭建开箱即用,流批统一的湖仓。 要构建一套开箱即用的湖仓系统,自动优化是第一个需要解决的需求。现在大部分开源的数据湖表格式都要求用户投入大量的精力来维护你数据湖表中的文件结构,稍不留神表的查询性能就可能出现较大的下滑。 湖仓优化的需求与难点 湖仓上有两类常见的优化需求:文件合并与文件清理。文件合并可分为以下场景: 合并碎片文件:数据写入时受限于本次写入的数据量和写入并发,很难保证每个写入文件都达到用户预期的大小。特别的在实时场景下为了降低湖仓中数据的延迟,需要频繁地提交新文件,这无疑将会带来大量的碎片文件。过多的碎片文件会造成数据膨胀,进一步降低湖仓表的读取性能,故及时得合并碎片文件到用户的预期大小对湖仓表的性能至关重要。 合并变更文件:现代的湖仓表格式通常都有行级更新的能力,而实现行级更新的一般方法是将更新操作写入到单独的变更文件里,这样能快速完成数据变更。但随着变更文件越来越多,在读取表中数据时需要的合并变更文件与数据文件的资也越来越多,而这个变化一般成指数级上升,故用户也需要及时合并变更文件到数据文件中。 常见的文件清理场景包括: 清理过期文件:表中被删除的文件现在一般不会被立即删除掉以应对用户查询历史数据的需求,而过期了的历史书库文件则需要文件清理流程来处理。 清理垃圾文件:写入失败的任务可能遗留下一些不再需要的垃圾文件,这些文件同样需要文件清理流程来应对。 Apache lceberg 通过在 Spark 引擎内提供了丰富的存储过程来应对文件合并与文件清理的优化需求。不过在实际使用时需要用户来判断何时需要进行优化、使用什么样的优化参数,并保证优化任务能正确完成工作。这无疑增大了用户的使用成本。 Apache Hudi 则提供在写入任务里同时运行优化任务,与使用另一个独立任务来完成优化的方式。前者可能造成写入任务与优化任务互相影响的问题。后者则需要为每个表维护一个长期运行的优化任务,任务多了将难以管理,同时很难保证优化任务的资源使用率。 可见要解决湖仓表的自动优化需求并没有那么简单,我们要面临如下难点: 什么时候进行优化:不同的表在数据写入上一般存在着较大的差异,即使同一张表在不同时间段也可能有着较大的数据写入变化,在进行优化时我们需要根据表当前的实际文件情况来判断是否需要进行优化。 对哪些文件进行优化:优化过程将对表中的文件进行重写,这个过程会造成写放大问题。而读取未优化过的文件将增大读取开销,造成读放大问题。文件优化过程需要追求达到写放大与读放大的平衡,用最小的优化资讯开销取得最大的优化收益。为了达到这个目的选取合适的文件来进行优化就至关重要了。 如何执行优化任务:随着表的增多,可能同事存在较多的优化任务,如何保证这些优化任务能够快速完成,在出现异常时能够自动恢复,并且能保证优化资源的利用率是另外一个需要解决的问题。 如何评估优化效果:优化任务完成后我们还需要能够直观的看到其开销和带来的收益,以帮助用户进一步评估优化任务的合理性,并进一步优化这个过程。 Arctic 自动优化湖仓原理 Arctic 引入了一套 Self-optimizing 机制,目标是基于新型数据湖表格式打造像数据库,传统数据一样开箱即用的流式湖仓服务,Self-optimizing 包含但不限于文件合并、去重、排序、孤儿文件和过期快照的清理。Self-optimizing 的架构与工作机制如下图所示: AMS (Arctic Management Service) 是 Arctic 的中心管理服务,它负责规划所有表的 self-optimizing 任务,并将任务下发给下面的 Optimizer 执行。Optimizer 是 self-optimizing 的执行组件,收到优化任务后负责具体的任务执行过程,最后再将执行结果上报给 AMS 后进行提交。Arctic 通过 Optimizer Group 对 Optimizers 实现物理隔离。 Arctic 的 self-optimizing 的核心特性有: 自动、异步与透明——后台持续检测文件变化,异步分布式执行优化任务,对用户透明无感 资源隔离和共享——允许资源在表级隔离和共享,以及设置资源配额 灵活可扩展的部署方式——执行节点支持多种部署方式,便捷的扩缩容 按需触发优化 AMS 会持续收集表上的写入信息并实时更新表上的统计信息,当表上的统计指标达到了触发自动优化的条件即会开始对表进行自动优化。统计指标会精确到分区级别,即写入频繁的分区会更频繁得触发自动优化。触发自动优化的条件包括: 分区的文件碎片数量:当分区内新增的文件碎片达到一定数量会触发当前分区的自动优化。 分区内的变更文件体量:当分区内的变更文件体量达到配置的大小会触发自动优化。 周期性进行文件优化:如果配置了周期性执行自动优化的策略,则会定期进行自动优化。 细分优化任务 频繁的对表里的文件进行优化会消耗过多的资源,而如果不及时进行文件优化又会造成表上查询性能的下降。为了权衡资源开销与查询性能,Arctic 将文件优化任务进行了进一步的细分。 Arctic 将表中的文件按照大小分为了两类: Fragment File:碎片文件,默认配置下小于 16MB 的文件,此类文件需要及时得合并成更大的文件,以及升读取性能 Segment File:默认配置下大雨 16MB 的文件,此类文件已经具备一定的大小,但还不到理想的 128MB. 基于以上的文件分类,Arctic 将文件优化任务分为以下三类: 类型 定义 目标 任务大小 调度频率 MinorOptimizing 在 Fragment File 上的优化任务 降低文件碎片,将写友好的文件转换为读友好的文件 较小(比如 16MB) 非常频繁(比如每 5分钟一次) Major Optimizing 在 Segment File 上的优化任务 将文件大小推进到目标大小,并减少冗余数据 中等(比如 128MB) 较频繁(比如每 1小时一次) Full Optimizing 表或者分区内所有文件上的优化任务 将所以文件全局排序后重写 取决于表或分区的大小 不频繁(比如每一天) 具体来说,对于 Iceberg 格式的表,Minor optimizing 会将小于 16MB 的 insert File 合并到大于 16MB,并将 equality-delete file 转换为 position-delete file,转换过程中会为每个 insert file 生成对应的 position-delete file,并将已有的 position-delete file 数据合并到新的 position-delete file 内,具体过程如下图: 而 Major optimizing 则会将那些已经积攒了较大的 position-delete file 的 insert file 与其对应的 delete file 进行合并而消除其冗余数据。Full optimizing 会将所有的文件进行重写,重写过程会消除掉多有的 delete file。具体过程如下图: 资源隔离与共享 为了保证优化任务能被及时调度执行,Arctic 采用维护一套长期运行的优化资源而非为每个优化任务临时调度优化资源的方案。所有表的优化任务都运行在统一的资源上,为了提升优化资源的利用率,同时避免表与表之间的相互影响,Arctic 提出了如下概念: Optimizing group:一个优化组,每个表必须且只能归属于一个优化组,相同优化组内的表共享优化资源,不同优化组的表在优化资源上进行物理隔离。 Optimizing quota:每个表会被分配一个自动优化的配额,如果表上优化任务过多,导致配额被使用完则该表需要等待一段时间之后才能继续进行自动优化。 一个 Optimizing group 下一般会有多个 Optimizer,Optimizer 是一个独立的无状态的计算资源,如果某个 Optimizer 离线了,它上面的任务会被重新调度到同 group 下的其他 optimizer 上继续执行。当某个 group 下的 optimizer 利用率过大时,用户也可以简单的扩容新的 optimizer 来提升处理能力。 Arctic 抽象了一套 Optimizer container 接口来扩展不同的 optimizer 调度方式,项目内已经实现了新增本地进程和在 Yarn 集群上调度 Flink 任务的实现。用户也可以根据自己内部的调度框架扩展自己的 optimizer 运行方式。 监控与展示 Arctic 在其 WEB 界面工具中提供了单独的页面展示系统内每个表所处的自动优化状态,具体如下图: 界面中不仅展示了表当前是否正在进行 自动优化,也给出了当前待优化的文件的具体情况,及配置和已经消耗的优化资源。 另外每个表的详情页面里也能看到已经发生过的自动优化任务,具体如下图: 界面中展示了每次自动优化任务的类型、耗时、优化前的文件情况和优化后的文件情况。 总结与未来规划 Arctic 提供了一套自动、异步、透明的自动优化服务保证湖仓表的性能。这套实现方案已经在网易内部和开源社区内都得到了验证。 为了更直观得展现自动优化的效果,下面是 Arctic 团队内部分别测试在开启和关闭自动优化功能时,Iceberg 表的分析性能表现。测试模拟了表上持续有写入的情况下,Iceberg 表的查询性能,测试中发现随着时间推移不开启自动优化功能时,Iceberg 表查询性能急剧下降,在超过一小时后甚至因为内存溢出无法正确查询出需要的数据,而开启自动优化后随着时间变化表的查询耗时都能维持在一个较低的水平。具体的测试场景可以参考:Arctic Benchmark(https://arctic.netease.com/ch/benchmark/benchmark/) 未来 Arctic 在湖仓表的自动优化方面将沿着下面的路径继续演进: 集成更多的表格式:现阶段 Arctic 只实现了对 Apache Iceberg 表格式的自动优化,后面计划将集成更多的表格式,以帮助其他表格式的用户提升其在湖仓建设上的体验。 更智能的任务规划:现阶段对表中的哪些文件进行怎样的文件优化仍然基于表上的配置,这就造成有时用户需要手动进行参数调优来取得更好的优化效果。未来 Arctic 将探索如何智能地动态调整优化策略以达到更好的使用体验。 作者简介:周劲松,网易数帆平台研发专家,从事大数据与数据库方向开发工作经验7年,曾负责分库分表系统,数据传输系统研发工作,目前作为 Arctic 湖仓管理系统的项目负责人,在构建数据基础设施方面有着充分经验。 了解更多: 【GitHub】 地址:https://github.com/NetEase/arctic 【Arctic】 文档地址:https://arctic.netease.com/ch/ 【社群】:微信添加 kllnn999(后台回复【社群】可直接加入)

优秀的个人博客,低调大师

云原生(cloud native)是什么,怎么理解

很多人都会问“到底什么是云原生”,对此,CNCF 官方大使、阿里云容器平台高级技术专家张磊曾经做过精彩的解释。 实际上,云原生是一条最佳路径或者最佳实践。更详细的说,云原生为用户指定了一条低心智负担的、敏捷的、能够以可扩展、可复制的方式最大化地利用云的能力、发挥云的价值的最佳路径。 因此,云原生其实是一套指导进行软件架构设计的思想。按照这样的思想而设计出来的软件:首先,天然就“生在云上,长在云上”;其次,能够最大化地发挥云的能力,使得我们开发的软件和“云”能够天然地集成在一起,发挥出“云”的最大价值。 所以,云原生最大的价值和愿景,就是认为未来的软件,会从诞生起就生长在云上,并且遵循一种新的软件开发、发布和运维模式,从而使得软件能够最大化地发挥云的能力。说到了这里,你也可以思考一下为什么容器技术具有革命性? 其实,容器技术和集装箱技术的革命性非常类似,即:容器技术使得应用具有了一种“自包含”的定义方式。所以,这样的应用才能以敏捷的、以可扩展可复制的方式发布在云上,发挥出云的能力。这也就是容器技术对云发挥出的革命性影响所在,所以说,容器技术正是云原生技术的核心底盘。 云原生的技术范畴 云原生的技术范畴包括了以下几个方面: 第一部分是云应用定义与开发流程。这包括应用定义与镜像制作、配置 CI/CD、消息和 Streaming 以及数据库等。 第二部分是云应用的编排与管理流程。这也是 Kubernetes 比较关注的一部分,包括了应用编排与调度、服务发现治理、远程调用、API 网关以及 Service Mesh。 第三部分是监控与可观测性。这部分所强调的是云上应用如何进行监控、日志收集、Tracing 以及在云上如何实现破坏性测试,也就是混沌工程的概念。 第四部分就是云原生的底层技术,比如容器运行时、云原生存储技术、云原生网络技术等。 第五部分是云原生工具集,在前面的这些核心技术点之上,还有很多配套的生态或者周边的工具需要使用,比如流程自动化与配置管理、容器镜像仓库、云原生安全技术以及云端密码管理等。 最后则是 Serverless。Serverless 是一种 PaaS 的特殊形态,它定义了一种更为“极端抽象”的应用编写方式,包含了 FaaS 和 BaaS 这样的概念。而无论是 FaaS 还是 BaaS,其最为典型的特点就是按实际使用计费(Pay as you go),因此 Serverless 计费也是重要的知识和概念。 MBaaS(Mobile Backend as a Service),简称 BaaS FaaS(Function as a Service) 总的来说,云原生技术有利于各组织在公有云、私有云和混合云等新型动态环境中,构建和运行可弹性扩展的应用。除了容器、Kubernetes、Service Mesh等当前比较有代表性的技术,很多企业也在边缘计算方面开展了很多工作 基础设施向云演进的意义 其实,传统的应用所依赖的基础设施正在经历一个向云演进的过程,在此过程中,为我们提供了两个非常重要的优点。 第一个优点是基础设施的一致性和可靠性。同样一个镜像,无论是在美国打开,在中国打开,还是在印度打开都是一样的。并且其中的 OS 环境对于应用而言都是一致的。而对于应用而言,它就不需要关心容器跑在哪里,这就是基础设施一致性非常重要的一个特征。 第二个优点即这样的镜像本身就是自包含的,其包含了应用运行所需要的所有依赖,因此也可以漂移到云上的任何一个位置。 此外,云原生的基础设施还提供了简单、可预测的部署和运维能力。由于现在有了镜像,应用还是自描述的,通过镜像运行起来的整个容器其实可以像 Kubernetes 的 Operator 技术一样将其做成自运维的,所以整个应用本身都是自包含的行为,使得其能够迁移到云上任何一个位置。这也使得整个流程的自动化变得非常容易。 应用本身也可以更好地扩容,从 1 个实例变成 100 个实例,进而变成 1 万个实例。最后,我们可以通过不可变的基础设施来快速部署周围的管控系统和支撑组件。因为,这些组件本身也是容器化的,是符合不可变基础设施理论的组件。这些就是不可变基础设施为用户带来的最大优点。 本文转载自https://mp.weixin.qq.com/s/lbXH0Zk89A9Sf-yy8oveDA

优秀的个人博客,低调大师

MySQL 的 crash-safe 原理解析

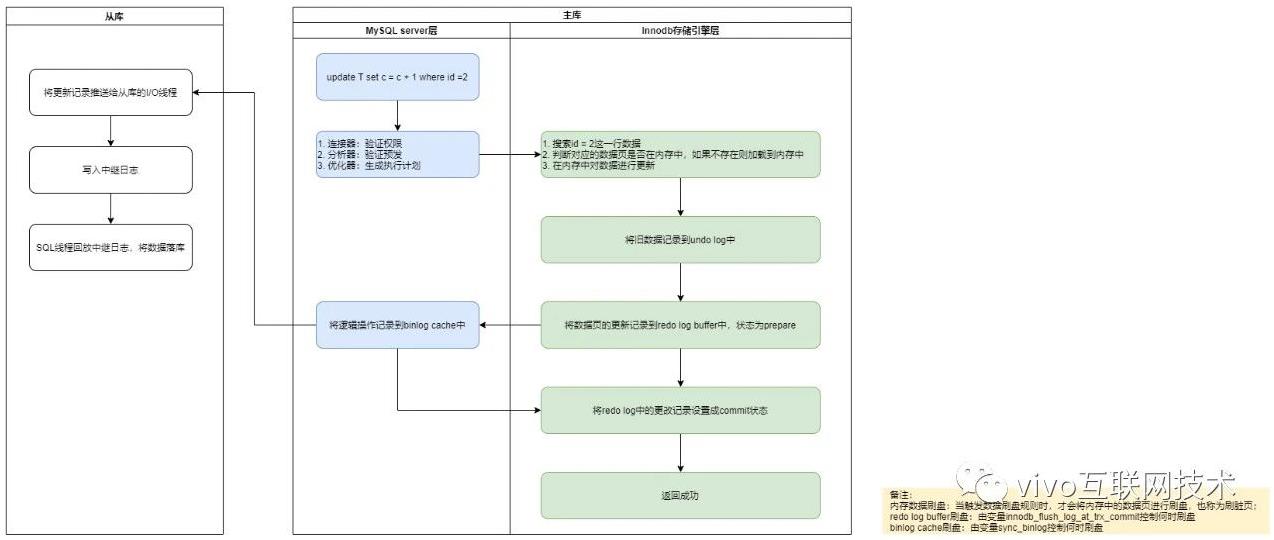
本文首发于 vivo互联网技术 微信公众号 链接:https://mp.weixin.qq.com/s/5i9wmJs4_Er7RaYfNnETyA 作者:xieweipeng MySQL作为当下最流行的开源关系型数据库,有一个很关键和基本的能力,就是必须能够保证数据不会丢。那么在这个能力背后,MySQL是如何设计才能保证不管在什么时间崩溃,恢复后都能保证数据不会丢呢?有哪些关键技术支撑了这个能力?本文将为我们一一揭晓。 一、前言 MySQL保证数据不会丢的能力主要体现在两方面: 能够恢复到任何时间点的状态; 能够保证MySQL在任何时间段突然奔溃,重启后之前提交的记录都不会丢失; 对于第一点将MySQL恢复到任何时间点的状态,相信很多人都知道,只要保留有足够的binlog,就能通过重跑binlog来实现。 对于第二点的能力,也就是本文标题所讲的crash-safe。即在 InnoDB 存储引擎中,事务提交过程中任何阶段,MySQL突然奔溃,重启后都能保证事务的完整性,已提交的数据不会丢失,未提交完整的数据会自动进行回滚。这个能力依赖的就是redo log和unod log两个日志。 因为crash-safe主要体现在事务执行过程中突然奔溃,重启后能保证事务完整性,所以在讲解具体原理之前,先了解下MySQL事务执行有哪些关键阶段,后面才能依据这几个阶段来进行解析。下面以一条更新语句的执行流程为例,话不多说,直接上图: 从上图可以清晰地看出一条更新语句在MySQL中是怎么执行的,简单进行总结一下: 从内存中找出这条数据记录,对其进行更新; 将对数据页的更改记录到redo log中; 将逻辑操作记录到binlog中; 对于内存中的数据和日志,都是由后台线程,当触发到落盘规则后再异步进行刷盘; 上面演示了一条更新语句的详细执行过程,接下来咱们通过解答问题,带着问题来剖析这个crash-safe的设计原理。 二、WAL机制 问题:为什么不直接更改磁盘中的数据,而要在内存中更改,然后还需要写日志,最后再落盘这么复杂? 这个问题相信很多同学都能猜出来,MySQL更改数据的时候,之所以不直接写磁盘文件中的数据,最主要就是性能问题。因为直接写磁盘文件是随机写,开销大性能低,没办法满足MySQL的性能要求。所以才会设计成先在内存中对数据进行更改,再异步落盘。但是内存总是不可靠,万一断电重启,还没来得及落盘的内存数据就会丢失,所以还需要加上写日志这个步骤,万一断电重启,还能通过日志中的记录进行恢复。 写日志虽然也是写磁盘,但是它是顺序写,相比随机写开销更小,能提升语句执行的性能(针对顺序写为什么比随机写更快,可以比喻为你有一个本子,按照顺序一页一页写肯定比写一个字都要找到对应页写快得多)。 这个技术就是大多数存储系统基本都会用的WAL(Write Ahead Log)技术,也称为日志先行的技术,指的是对数据文件进行修改前,必须将修改先记录日志。保证了数据一致性和持久性,并且提升语句执行性能。 三、核心日志模块 问题:更新SQL语句执行流程中,总共需要写3个日志,这3个是不是都需要,能不能进行简化? 更新SQL执行过程中,总共涉及MySQL日志模块其中的三个核心日志,分别是redo log(重做日志)、undo log(回滚日志)、binlog(归档日志)。这里提前预告,crash-safe的能力主要依赖的就是这三大日志。 接下来,针对每个日志将单独介绍各自的作用,然后再来评估是否能简化掉。 1、重做日志 redo log redo log也称为事务日志,由InnoDB存储引擎层产生。记录的是数据库中每个页的修改,而不是某一行或某几行修改成怎样,可以用来恢复提交后的物理数据页(恢复数据页,且只能恢复到最后一次提交的位置,因为修改会覆盖之前的)。 前面提到的WAL技术,redo log就是WAL的典型应用,MySQL在有事务提交对数据进行更改时,只会在内存中修改对应的数据页和记录redo log日志,完成后即表示事务提交成功,至于磁盘数据文件的更新则由后台线程异步处理。由于redo log的加入,保证了MySQL数据一致性和持久性(即使数据刷盘之前MySQL奔溃了,重启后仍然能通过redo log里的更改记录进行重放,重新刷盘),此外还能提升语句的执行性能(写redo log是顺序写,相比于更新数据文件的随机写,日志的写入开销更小,能显著提升语句的执行性能,提高并发量),由此可见redo log是必不可少的。 redo log是固定大小的,所以只能循环写,从头开始写,写到末尾就又回到开头,相当于一个环形。当日志写满了,就需要对旧的记录进行擦除,但在擦除之前,需要确保这些要被擦除记录对应在内存中的数据页都已经刷到磁盘中了。在redo log满了到擦除旧记录腾出新空间这段期间,是不能再接收新的更新请求,所以有可能会导致MySQL卡顿。(所以针对并发量大的系统,适当设置redo log的文件大小非常重要!!!) 2、回滚日志 undo log undo log顾名思义,主要就是提供了回滚的作用,但其还有另一个主要作用,就是多个行版本控制(MVCC),保证事务的原子性。在数据修改的流程中,会记录一条与当前操作相反的逻辑日志到undo log中(可以认为当delete一条记录时,undo log中会记录一条对应的insert记录,反之亦然,当update一条记录时,它记录一条对应相反的update记录),如果因为某些原因导致事务异常失败了,可以借助该undo log进行回滚,保证事务的完整性,所以undo log也必不可少。 3、归档日志 binlog binlog在MySQL的server层产生,不属于任何引擎,主要记录用户对数据库操作的SQL语句(除了查询语句)。之所以将binlog称为归档日志,是因为binlog不会像redo log一样擦掉之前的记录循环写,而是一直记录(超过有效期才会被清理),如果超过单日志的最大值(默认1G,可以通过变量 max_binlog_size 设置),则会新起一个文件继续记录。但由于日志可能是基于事务来记录的(如InnoDB表类型),而事务是绝对不可能也不应该跨文件记录的,如果正好binlog日志文件达到了最大值但事务还没有提交则不会切换新的文件记录,而是继续增大日志,所以 max_binlog_size 指定的值和实际的binlog日志大小不一定相等。 正是由于binlog有归档的作用,所以binlog主要用作主从同步和数据库基于时间点的还原。 那么回到刚才的问题,binlog可以简化掉吗?这里需要分场景来看: 如果是主从模式下,binlog是必须的,因为从库的数据同步依赖的就是binlog; 如果是单机模式,并且不考虑数据库基于时间点的还原,binlog就不是必须,因为有redo log就可以保证crash-safe能力了;但如果万一需要回滚到某个时间点的状态,这时候就无能为力,所以建议binlog还是一直开启; 根据上面对三个日志的详解,我们可以对这个问题进行解答:在主从模式下,三个日志都是必须的;在单机模式下,binlog可以视情况而定,保险起见最好开启。 四、两阶段提交 问题:为什么redo log要分两步写,中间再穿插写binlog呢? 从上面可以看出,因为redo log影响主库的数据,binlog影响从库的数据,所以redo log和binlog必须保持一致才能保证主从数据一致,这是前提。 相信很多有过开发经验的同学都知道分布式事务,这里的redo log和binlog其实就是很典型的分布式事务场景,因为两者本身就是两个独立的个体,要想保持一致,就必须使用分布式事务的解决方案来处理。而将redo log分成了两步,其实就是使用了两阶段提交协议(Two-phase Commit,2PC)。 下面对更新语句的执行流程进行简化,看一下MySQL的两阶段提交是如何实现的: 从图中可看出,事务的提交过程有两个阶段,就是将redo log的写入拆成了两个步骤:prepare和commit,中间再穿插写入binlog。 如果这时候你很疑惑,为什么一定要用两阶段提交呢,如果不用两阶段提交会出现什么情况,比如先写redo log,再写binlog或者先写binlog,再写redo log不行吗?下面我们用反证法来进行论证。 我们继续用update T set c=c+1 where id=2这个例子,假设id=2这一条数据的c初始值为0。那么在redo log写完,binlog还没有写完的时候,MySQL进程异常重启。由于redo log已经写完了,系统重启后会通过redo log将数据恢复回来,所以恢复后这一行c的值是1。但是由于binlog没写完就crash了,这时候binlog里面就没有记录这个语句。因此,不管是现在的从库还是之后通过这份binlog还原临时库都没有这一次更新,c的值还是0,与原库的值不同。 同理,如果先写binlog,再写redo log,中途系统crash了,也会导致主从不一致,这里就不再详述。 所以将redo log分成两步写,即两阶段提交,才能保证redo log和binlog内容一致,从而保证主从数据一致。 两阶段提交虽然能够保证单事务两个日志的内容一致,但在多事务的情况下,却不能保证两者的提交顺序一致,比如下面这个例子,假设现在有3个事务同时提交: T1 (--prepare--binlog---------------------commit) T2 (-----prepare-----binlog----commit) T3 (--------prepare-------binlog------commit) 解析: redo log prepare的顺序:T1 --》T2 --》T3 binlog的写入顺序:T1 --》 T2 --》T3 redo log commit的顺序:T2 --》 T3 --》T1 结论:由于binlog写入的顺序和redo log提交结束的顺序不一致,导致binlog和redo log所记录的事务提交结束的顺序不一样,最终导致的结果就是主从数据不一致。 因此,在两阶段提交的流程基础上,还需要加一个锁来保证提交的原子性,从而保证多事务的情况下,两个日志的提交顺序一致。所以在早期的MySQL版本中,通过使用prepare_commit_mutex锁来保证事务提交的顺序,在一个事务获取到锁时才能进入prepare,一直到commit结束才能释放锁,下个事务才可以继续进行prepare操作。通过加锁虽然完美地解决了顺序一致性的问题,但在并发量较大的时候,就会导致对锁的争用,性能不佳。除了锁的争用会影响到性能之外,还有一个对性能影响更大的点,就是每个事务提交都会进行两次fsync(写磁盘),一次是redo log落盘,另一次是binlog落盘。大家都知道,写磁盘是昂贵的操作,对于普通磁盘,每秒的QPS大概也就是几百。 五、组提交 问题:针对通过在两阶段提交中加锁控制事务提交顺序这种实现方式遇到的性能瓶颈问题,有没有更好的解决方案呢? 答案自然是有的,在MySQL 5.6 就引入了binlog组提交,即BLGC(Binary Log Group Commit)。binlog组提交的基本思想是,引入队列机制保证InnoDB commit顺序与binlog落盘顺序一致,并将事务分组,组内的binlog刷盘动作交给一个事务进行,实现组提交目的。具体如图: 第一阶段(prepare阶段): 持有prepare_commit_mutex,并且write/fsync redo log到磁盘,设置为prepared状态,完成后就释放prepare_commit_mutex,binlog不作任何操作。 第二个阶段(commit阶段):这里拆分成了三步,每一步的任务分配给一个专门的线程处理: Flush Stage(写入binlog缓存) ① 持有Lock_log mutex [leader持有,follower等待] ② 获取队列中的一组binlog(队列中的所有事务) ③ 写入binlog缓存 Sync Stage(将binlog落盘) ①释放Lock_log mutex,持有Lock_sync mutex[leader持有,follower等待] ②将一组binlog落盘(fsync动作,最耗时,假设sync_binlog为1)。 CommitStage(InnoDB commit,清楚undo信息) ①释放Lock_sync mutex,持有Lock_commit mutex[leader持有,follower等待] ② 遍历队列中的事务,逐一进行InnoDB commit ③ 释放Lock_commit mutex 每个Stage都有自己的队列,队列中的第一个事务称为leader,其他事务称为follower,leader控制着follower的行为。每个队列各自有mutex保护,队列之间是顺序的。只有flush完成后,才能进入到sync阶段的队列中;sync完成后,才能进入到commit阶段的队列中。但是这三个阶段的作业是可以同时并发执行的,即当一组事务在进行commit阶段时,其他新事务可以进行flush阶段,实现了真正意义上的组提交,大幅度降低磁盘的IOPS消耗。 针对组提交为什么比两阶段提交加锁性能更好,简单做个总结:组提交虽然在每个队列中仍然保留了prepare_commit_mutex锁,但是锁的粒度变小了,变成了原来两阶段提交的1/4,所以锁的争用性也会大大降低;另外,组提交是批量刷盘,相比之前的单条记录都要刷盘,能大幅度降低磁盘的IO消耗。 六、数据恢复流程 问题:假设事务提交过程中,MySQL进程突然奔溃,重启后是怎么保证数据不丢失的? 下图就是MySQL重启后,提供服务前会先做的事 -- 恢复数据的流程: 对上图进行简单描述就是:奔溃重启后会检查redo log中是完整并且处于prepare状态的事务,然后根据XID(事务ID),从binlog中找到对应的事务,如果找不到,则回滚;找到并且事务完整则重新commit redo log,完成事务的提交。 下面我们根据事务提交流程,在不同的阶段时刻,看看MySQL突然奔溃后,按照上述流程是如何恢复数据的。 时刻A(刚在内存中更改完数据页,还没有开始写redo log的时候奔溃): 因为内存中的脏页还没刷盘,也没有写redo log和binlog,即这个事务还没有开始提交,所以奔溃恢复跟该事务没有关系; 时刻B(正在写redo log或者已经写完redo log并且落盘后,处于prepare状态,还没有开始写binlog的时候奔溃): 恢复后会判断redo log的事务是不是完整的,如果不是则根据undo log回滚;如果是完整的并且是prepare状态,则进一步判断对应的事务binlog是不是完整的,如果不完整则一样根据undo log进行回滚; 时刻C(正在写binlog或者已经写完binlog并且落盘了,还没有开始commit redo log的时候奔溃): 恢复后会跟时刻B一样,先检查redo log中是完整并且处于prepare状态的事务,然后判断对应的事务binlog是不是完整的,如果不完整则一样根据undo log回滚,完整则重新commit redo log; 时刻D(正在commit redo log或者事务已经提交完的时候,还没有反馈成功给客户端的时候奔溃): 恢复后跟时刻C基本一样,都会对照redo log和binlog的事务完整性,来确认是回滚还是重新提交。 七、总结 至此对MySQL 的crash-safe原理细节就基本讲完了,简单回顾一下: 首先简单介绍了WAL日志先行技术,包括它的定义、流程和作用。WAL是大部分数据库系统实现一致性和持久性的通用设计模式。; 接着对MySQL的日志模块,redo log、undo log、binlog、两阶段提交和组提交都进行了详细介绍; 最后讲解了数据恢复流程,并从不同时刻加以验证。 更多内容敬请关注vivo 互联网技术微信公众号 注:转载文章请先与微信号:Labs2020联系。

优秀的个人博客,低调大师

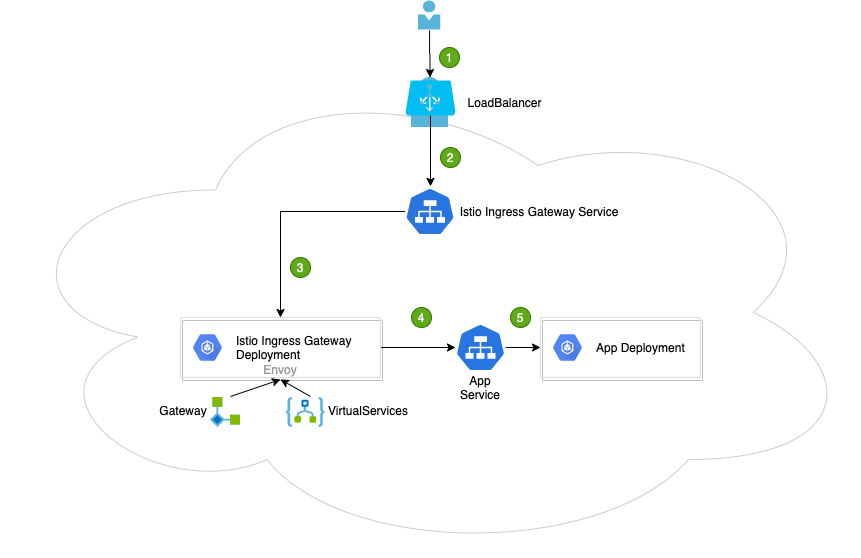
一张图理解 Istio Ingress Gateway

在Kubernetes环境中,Ingress controller用于管理进入集群的流量。在Istio服务网格中 Istio Ingress Gateway承担相应的角色,它使用新的配置模型(Gateway 和 VirtualServices)完成流量管理的功能。通过下图做一个总的描述。 用户向某端口发出请求 负载均衡器监听端口,并将请求转发到集群中的某个节点上。Istio Ingress Gateway Service 会监听集群节点端口的请求 Istio Ingress Gateway Service 将请求交给Istio Ingress Gateway Pod 处理。IngressGateway Pod 通过 Gateway 和 VirtualService 配置规则处理请求。其中,Gateway 用来配置端口、协议和证书;VirtualService 用来配置一些路由信息(找到请求对应处理的服务App Service) Istio Ingress Gateway Pod将请求转给App Service 最终的请求会交给App Service 关联的App Deployment处理

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册