首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10000篇文章
优秀的个人博客,低调大师

阿里三面:让你怀疑人生的Java锁机制夺命连环21问

前言 锁机制无处不在,锁机制是实现线程同步的基础,锁机制并不是Java锁独有的,其他各种计算机语言中也有着锁机制相关的实现,数据库中也有锁的相关内容,这篇文章总结的Java锁机制笔记也为大家打包好了,需要的自取即可,希望可以帮助大家从Java入手,深入学习、理解Java中的锁机制,提升Java并发编程能力。 1、乐观锁 乐观锁是一种乐观思想,假定当前环境是读多写少,遇到并发写的概率比较低,读数据时认为别的线程不会正在进行修改(所以没有上锁)。写数据时,判断当前 与期望值是否相同,如果相同则进行更新(更新期间加锁,保证是原子性的)。 Java 中的乐观锁: CAS,比较并替换,比较当前值(主内存中的值),与预期值(当前线程中的值,主内存中值的一份拷贝)是否一样,一样则更新,否则继续进行 CAS 操作。 如上图所示,可以同时进行读操作,读的时候其他线程不能进行写操作。 2、悲观锁 悲观锁是一种悲观思想,即认为写多读少,遇到并发写的可能性高,每次去拿数据的时候都认为其他线程会修改,所以每次读写数据都会认为其他线程会修改,所以每次读写数据时都会上锁。其他线程想要读写这个数据时,会被这个线程 block,直到这个线程释放锁然后其他线程获取到锁。 Java 中的悲观锁: synchronized修饰的方法和方法块、ReentrantLock。 如上图所示,只能有一个线程进行读操作或者写操作,其他线程的读写操作均不能进行。 3、自旋锁 自旋锁是一种技术: 为了让线程等待,我们只须让线程执行一个忙循环(自旋)。 现在绝大多数的个人电脑和服务器都是多路(核)处理器系统,如果物理机器有一个以上的处理器或者处理器核心。 能让两个或以上的线程同时并行执行,就可以让后面请求锁的那个线程“稍等一会”,但不放弃处理器的执行时间,看看持有锁的线程是否很快就会释放锁。 自旋锁的优点: 避免了线程切换的开销。挂起线程和恢复线程的操作都需要转入内核态中完成,这些操作给 Java 虚拟机的并发性能带来了很大的压力。 自旋锁的缺点: 占用处理器的时间,如果占用的时间很长,会白白消耗处理器资源,而不会做任何有价值的工作,带来性能的浪费。因此自旋等待的时间必须有一定的限度,如果自旋超过了限定的次数仍然没有成功获得锁,就应当使用传统的方式去挂起线程。 自旋次数默认值:10 次,可以使用参数-XX:PreBlockSpin 来自行更改。 自适应自旋: 自适应意味着自旋的时间不再是固定的,而是由前一次在同一个锁上的自旋时间及锁的拥有者的状态来决定的。有了自适应自旋,随着程序运行时间的增长及性能监控信息的不断完善,虚拟机对程序锁的状态预测就会越来越精准。 Java 中的自旋锁: CAS 操作中的比较操作失败后的自旋等待。 4、可重入锁(递归锁) 可重入锁是一种技术: 任意线程在获取到锁之后能够再次获取该锁而不会被锁所阻塞。 可重入锁的原理: 通过组合自定义同步器来实现锁的获取与释放。 再次获取锁:识别获取锁的线程是否为当前占据锁的线程,如果是,则再次成功获取。获取锁后,进行计数自增, 释放锁:释放锁时,进行计数自减。 Java 中的可重入锁: ReentrantLock、synchronized 修饰的方法或代码段。 可重入锁的作用: 避免死锁。 面试题 1: 可重入锁如果加了两把,但是只释放了一把会出现什么问题? 答:程序卡死,线程不能出来,也就是说我们申请了几把锁,就需要释放几把锁。 面试题 2: 如果只加了一把锁,释放两次会出现什么问题? 答:会报错, java.lang.IllegalMonitorStateException。 5、读写锁 读写锁是一种技术: 通过ReentrantReadWriteLock类来实现。为了提高性能, Java 提供了读写锁,在读的地方使用读锁,在写的地方使用写锁,灵活控制,如果没有写锁的情况下,读是无阻塞的,在一定程度上提高了程序的执行效率。读写锁分为读锁和写锁,多个读锁不互斥,读锁与写锁互斥,这是由 jvm 自己控制的。 读锁: 允许多个线程获取读锁,同时访问同一个资源。 写锁: 只允许一个线程获取写锁,不允许同时访问同一个资源。 如何使用: /** * 创建一个读写锁 * 它是一个读写融为一体的锁,在使用的时候,需要转换 */ private ReentrantReadWriteLock rwLock = new ReentrantReadWriteLock(); 获取读锁和释放读锁 // 获取读锁 rwLock.readLock().lock(); // 释放读锁 rwLock.readLock().unlock(); 获取写锁和释放写锁 // 创建一个写锁 rwLock.writeLock().lock(); // 写锁 释放 rwLock.writeLock().unlock(); **Java 中的读写锁:**ReentrantReadWriteLock 6、公平锁 公平锁是一种思想: 多个线程按照申请锁的顺序来获取锁。在并发环境中,每个线程会先查看此锁维护的等待队列,如果当前等待队列为空,则占有锁,如果等待队列不为空,则加入到等待队列的末尾,按照 FIFO 的原则从队列中拿到线程,然后占有锁。 7、非公平锁 非公平锁 非公平锁是一种思想: 线程尝试获取锁,如果获取不到,则再采用公平锁的方式。多个线程获取锁的顺序,不是按照先到先得的顺序,有可能后申请锁的线程比先申请的线程优先获取锁。 优点: 非公平锁的性能高于公平锁。 缺点: 有可能造成线程饥饿(某个线程很长一段时间获取不到锁) Java 中的非公平锁:synchronized 是非公平锁,ReentrantLock 通过构造函数指定该锁是公平的还是非公平的,默认是非公平的。 8、共享锁 共享锁是一种思想: 可以有多个线程获取读锁,以共享的方式持有锁。和乐观锁、读写锁同义。 Java 中用到的共享锁: ReentrantReadWriteLock。 9、独占锁 独占锁是一种思想: 只能有一个线程获取锁,以独占的方式持有锁。和悲观锁、互斥锁同义。 Java 中用到的独占锁: synchronized,ReentrantLock 10、重量级锁 重量级锁是一种称谓: synchronized是通过对象内部的一个叫做监视器锁(monitor)来实现的,监视器锁本身依赖底层的操作系统的 Mutex Lock来实现。操作系统实现线程的切换需要从用户态切换到核心态,成本非常高。这种依赖于操作系统 Mutex Lock来实现的锁称为重量级锁。为了优化synchonized,引入了轻量级锁,偏向锁。 Java 中的重量级锁: synchronized 11、轻量级锁 轻量级锁是 JDK6 时加入的一种锁优化机制: 轻量级锁是在无竞争的情况下使用 CAS 操作去消除同步使用的互斥量。轻量级是相对于使用操作系统互斥量来实现的重量级锁而言的。 轻量级锁在没有多线程竞争的前提下,减少传统的重量级锁使用操作系统互斥量产生的性能消耗。如果出现两条以上的线程争用同一个锁的情况,那轻量级锁将不会有效,必须膨胀为重量级锁。 优点: 如果没有竞争,通过 CAS 操作成功避免了使用互斥量的开销。 缺点: 如果存在竞争,除了互斥量本身的开销外,还额外产生了 CAS 操作的开销,因此在有竞争的情况下,轻量级锁比传统的重量级锁更慢。 12、偏向锁 偏向锁是 JDK6 时加入的一种锁优化机制: 在无竞争的情况下把整个同步都消除掉,连 CAS 操作都不去做了。偏是指偏心,它的意思是这个锁会偏向于第一个获得它的线程,如果在接下来的执行过程中,该锁一直没有被其他的线程获取,则持有偏向锁的线程将永远不需要再进行同步。 持有偏向锁的线程以后每次进入这个锁相关的同步块时,虚拟机都可以不再进行任何同步操作(例如加锁、解锁及对 Mark Word 的更新操作等)。 优点: 把整个同步都消除掉,连 CAS 操作都不去做了,优于轻量级锁。 缺点: 如果程序中大多数的锁都总是被多个不同的线程访问,那偏向锁就是多余的。 13、分段锁 分段锁是一种机制: 最好的例子来说明分段锁是 ConcurrentHashMap。**ConcurrentHashMap 原理:**它内部细分了若干个小的 HashMap,称之为段(Segment)。默认情况下一个 ConcurrentHashMap 被进一步细分为 16 个段,既就是锁的并发度。 如果需要在 ConcurrentHashMap 添加一项 key-value,并不是将整个 HashMap 加锁,而是首先根据 hashcode 得到该 key-value 应该存放在哪个段中,然后对该段加锁,并完成 put 操作。 在多线程环境中,如果多个线程同时进行 put 操作,只要被加入的 key-value 不存放在同一个段中,则线程间可以做到真正的并行。 线程安全:ConcurrentHashMap 是一个 Segment 数组, Segment 通过继承 ReentrantLock 来进行加锁,所以每次需要加锁的操作锁住的是一个 segment,这样只要保证每个 Segment 是线程安全的,也就实现了全局的线程安全 14、互斥锁 互斥锁与悲观锁、独占锁同义,表示某个资源只能被一个线程访问,其他线程不能访问。 读-读互斥 读-写互斥 写-读互斥 写-写互斥 Java 中的同步锁: synchronized 15、同步锁 同步锁与互斥锁同义,表示并发执行的多个线程,在同一时间内只允许一个线程访问共享数据。 Java 中的同步锁: synchronized 16、死锁 死锁是一种现象:如线程 A 持有资源 x,线程 B 持有资源 y,线程 A 等待线程 B 释放资源 y,线程 B 等待线程 A 释放资源 x,两个线程都不释放自己持有的资源,则两个线程都获取不到对方的资源,就会造成死锁。 Java 中的死锁不能自行打破,所以线程死锁后,线程不能进行响应。所以一定要注意程序的并发场景,避免造成死锁。 17、锁粗化 锁粗化是一种优化技术: 如果一系列的连续操作都对同一个对象反复加锁和解锁,甚至加锁操作都是出现在循环体体之中,就算真的没有线程竞争,频繁地进行互斥同步操作将会导致不必要的性能损耗,所以就采取了一种方案:把加锁的范围扩展(粗化)到整个操作序列的外部,这样加锁解锁的频率就会大大降低,从而减少了性能损耗。 18、锁消除 锁消除是一种优化技术: 就是把锁干掉。当 Java 虚拟机运行时发现有些共享数据不会被线程竞争时就可以进行锁消除。 那如何判断共享数据不会被线程竞争? 利用逃逸分析技术:分析对象的作用域,如果对象在 A 方法中定义后,被作为参数传递到 B 方法中,则称为方法逃逸;如果被其他线程访问,则称为线程逃逸。 在堆上的某个数据不会逃逸出去被其他线程访问到,就可以把它当作栈上数据对待,认为它是线程私有的,同步加锁就不需要了。 19、synchronized synchronized是 Java 中的关键字:用来修饰方法、对象实例。属于独占锁、悲观锁、可重入锁、非公平锁。 1.作用于实例方法时,锁住的是对象的实例(this); 2.当作用于静态方法时,锁住的是 Class 类,相当于类的一个全局锁, 会锁所有调用该方法的线程; 3.synchronized 作用于一个非 NULL 的对象实例时,锁住的是所有以该对象为锁的代码块。它有多个队列,当多个线程一起访问某个对象监视器的时候,对象监视器会将这些线程存储在不同的容器中。 每个对象都有个 monitor 对象, 加锁就是在竞争 monitor 对象,代码块加锁是在代码块前后分别加上 monitorenter 和 monitorexit 指令来实现的,方法加锁是通过一个标记位来判断的。 20、Lock 和 synchronized 的区别 自动挡和手动挡的区别 Lock: 是 Java 中的接口,可重入锁、悲观锁、独占锁、互斥锁、同步锁。 1.Lock 需要手动获取锁和释放锁。就好比自动挡和手动挡的区别 2.Lock 是一个接口,而 synchronized 是 Java 中的关键字, synchronized 是内置的语言实现。 3.synchronized 在发生异常时,会自动释放线程占有的锁,因此不会导致死锁现象发生;而 Lock 在发生异常时,如果没有主动通过 unLock()去释放锁,则很可能造成死锁现象,因此使用 Lock 时需要在 finally 块中释放锁。 4.Lock 可以让等待锁的线程响应中断,而 synchronized 却不行,使用 synchronized 时,等待的线程会一直等待下去,不能够响应中断。 5.通过 Lock 可以知道有没有成功获取锁,而 synchronized 却无法办到。 6.Lock 可以通过实现读写锁提高多个线程进行读操作的效率。 synchronized 的优势: 足够清晰简单,只需要基础的同步功能时,用 synchronized。 Lock 应该确保在 finally 块中释放锁。如果使用 synchronized,JVM 确保即使出现异常,锁也能被自动释放。 使用 Lock 时,Java 虚拟机很难得知哪些锁对象是由特定线程锁持有的。 21、ReentrantLock 和 synchronized 的区别 ReentrantLock是 Java 中的类 : 继承了 Lock 类,可重入锁、悲观锁、独占锁、互斥锁、同步锁。 划重点 相同点: 1.主要解决共享变量如何安全访问的问题 2.都是可重入锁,也叫做递归锁,同一线程可以多次获得同一个锁, 3.保证了线程安全的两大特性:可见性、原子性。 不同点: 1.ReentrantLock 就像手动汽车,需要显示的调用 lock 和 unlock 方法, synchronized 隐式获得释放锁。 2.ReentrantLock 可响应中断, synchronized 是不可以响应中断的,ReentrantLock 为处理锁的不可用性提供了更高的灵活性 3.ReentrantLock 是 API 级别的, synchronized 是 JVM 级别的 4.ReentrantLock 可以实现公平锁、非公平锁,默认非公平锁,synchronized 是非公平锁,且不可更改。 5.ReentrantLock 通过 Condition 可以绑定多个条件

优秀的个人博客,低调大师

Spark性能调优-RDD算子调优篇(深度好文,面试常问,建议收藏)

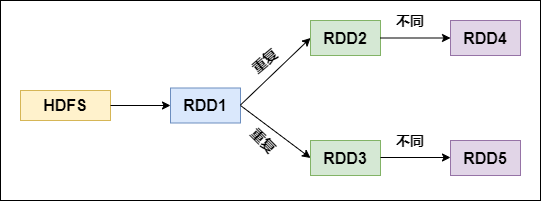
Spark调优之RDD算子调优 不废话,直接进入正题! 1. RDD复用 在对RDD进行算子时,要避免相同的算子和计算逻辑之下对RDD进行重复的计算,如下图所示: RDD的重复计算 对上图中的RDD计算架构进行修改,得到如下图所示的优化结果: RDD架构优化 2. 尽早filter 获取到初始RDD后,应该考虑尽早地过滤掉不需要的数据,进而减少对内存的占用,从而提升Spark作业的运行效率。 本文首发于公众号:五分钟学大数据,欢迎围观!回复【书籍】即可获得上百本大数据书籍 3. 读取大量小文件-用wholeTextFiles 当我们将一个文本文件读取为 RDD 时,输入的每一行都会成为RDD的一个元素。 也可以将多个完整的文本文件一次性读取为一个pairRDD,其中键是文件名,值是文件内容。 valinput:RDD[String]=sc.textFile("dir/*.log") 如果传递目录,则将目录下的所有文件读取作为RDD。文件路径支持通配符。 但是这样对于大量的小文件读取效率并不高,应该使用 wholeTextFiles返回值为RDD[(String, String)],其中Key是文件的名称,Value是文件的内容。 defwholeTextFiles(path:String,minPartitions:Int=defaultMinPartitions):RDD[(String,String)]) wholeTextFiles读取小文件: valfilesRDD:RDD[(String,String)]=sc.wholeTextFiles("D:\\data\\files",minPartitions=3)vallinesRDD:RDD[String]=filesRDD.flatMap(_._2.split("\\r\\n"))valwordsRDD:RDD[String]=linesRDD.flatMap(_.split(""))wordsRDD.map((_,1)).reduceByKey(_+_).collect().foreach(println) 4. mapPartition和foreachPartition mapPartitions map(_....) 表示每一个元素 mapPartitions(_....) 表示每个分区的数据组成的迭代器 普通的map算子对RDD中的每一个元素进行操作,而mapPartitions算子对RDD中每一个分区进行操作。 如果是普通的map算子,假设一个partition有1万条数据,那么map算子中的function要执行1万次,也就是对每个元素进行操作。 map 算子 如果是mapPartition算子,由于一个task处理一个RDD的partition,那么一个task只会执行一次function,function一次接收所有的partition数据,效率比较高。 mapPartition 算子 比如,当要把RDD中的所有数据通过JDBC写入数据,如果使用map算子,那么需要对RDD中的每一个元素都创建一个数据库连接,这样对资源的消耗很大,如果使用mapPartitions算子,那么针对一个分区的数据,只需要建立一个数据库连接。 mapPartitions算子也存在一些缺点:对于普通的map操作,一次处理一条数据,如果在处理了2000条数据后内存不足,那么可以将已经处理完的2000条数据从内存中垃圾回收掉;但是如果使用mapPartitions算子,但数据量非常大时,function一次处理一个分区的数据,如果一旦内存不足,此时无法回收内存,就可能会OOM,即内存溢出。 因此,mapPartitions算子适用于数据量不是特别大的时候,此时使用mapPartitions算子对性能的提升效果还是不错的。(当数据量很大的时候,一旦使用mapPartitions算子,就会直接OOM) 在项目中,应该首先估算一下RDD的数据量、每个partition的数据量,以及分配给每个Executor的内存资源,如果资源允许,可以考虑使用mapPartitions算子代替map。 foreachPartition rrd.foreache(_....) 表示每一个元素 rrd.forPartitions(_....) 表示每个分区的数据组成的迭代器 在生产环境中,通常使用foreachPartition算子来完成数据库的写入,通过foreachPartition算子的特性,可以优化写数据库的性能。 如果使用foreach算子完成数据库的操作,由于foreach算子是遍历RDD的每条数据,因此,每条数据都会建立一个数据库连接,这是对资源的极大浪费,因此,对于写数据库操作,我们应当使用foreachPartition算子。 与mapPartitions算子非常相似,foreachPartition是将RDD的每个分区作为遍历对象,一次处理一个分区的数据,也就是说,如果涉及数据库的相关操作,一个分区的数据只需要创建一次数据库连接,如下图所示: foreachPartition 算子 使用了foreachPartition 算子后,可以获得以下的性能提升: 对于我们写的function函数,一次处理一整个分区的数据; 对于一个分区内的数据,创建唯一的数据库连接; 只需要向数据库发送一次SQL语句和多组参数; 在生产环境中,全部都会使用foreachPartition算子完成数据库操作。foreachPartition算子存在一个问题,与mapPartitions算子类似,如果一个分区的数据量特别大,可能会造成OOM,即内存溢出。 5. filter+coalesce/repartition(减少分区) 在Spark任务中我们经常会使用filter算子完成RDD中数据的过滤,在任务初始阶段,从各个分区中加载到的数据量是相近的,但是一旦进过filter过滤后,每个分区的数据量有可能会存在较大差异,如下图所示: 分区数据过滤结果 根据上图我们可以发现两个问题: 每个partition的数据量变小了,如果还按照之前与partition相等的task个数去处理当前数据,有点浪费task的计算资源; 每个partition的数据量不一样,会导致后面的每个task处理每个partition数据的时候,每个task要处理的数据量不同,这很有可能导致数据倾斜问题。 如上图所示,第二个分区的数据过滤后只剩100条,而第三个分区的数据过滤后剩下800条,在相同的处理逻辑下,第二个分区对应的task处理的数据量与第三个分区对应的task处理的数据量差距达到了8倍,这也会导致运行速度可能存在数倍的差距,这也就是数据倾斜问题。 针对上述的两个问题,我们分别进行分析: 针对第一个问题,既然分区的数据量变小了,我们希望可以对分区数据进行重新分配,比如将原来4个分区的数据转化到2个分区中,这样只需要用后面的两个task进行处理即可,避免了资源的浪费。 针对第二个问题,解决方法和第一个问题的解决方法非常相似,对分区数据重新分配,让每个partition中的数据量差不多,这就避免了数据倾斜问题。 那么具体应该如何实现上面的解决思路?我们需要coalesce算子。 repartition与coalesce都可以用来进行重分区,其中repartition只是coalesce接口中shuffle为true的简易实现,coalesce默认情况下不进行shuffle,但是可以通过参数进行设置。 假设我们希望将原本的分区个数A通过重新分区变为B,那么有以下几种情况: A > B(多数分区合并为少数分区) A与B相差值不大此时使用coalesce即可,无需shuffle过程。 A与B相差值很大此时可以使用coalesce并且不启用shuffle过程,但是会导致合并过程性能低下,所以推荐设置coalesce的第二个参数为true,即启动shuffle过程。 A < B(少数分区分解为多数分区) 此时使用repartition即可,如果使用coalesce需要将shuffle设置为true,否则coalesce无效。 我们可以在filter操作之后,使用coalesce算子针对每个partition的数据量各不相同的情况,压缩partition的数量,而且让每个partition的数据量尽量均匀紧凑,以便于后面的task进行计算操作,在某种程度上能够在一定程度上提升性能。 注意:local模式是进程内模拟集群运行,已经对并行度和分区数量有了一定的内部优化,因此不用去设置并行度和分区数量。 6. 并行度设置 Spark作业中的并行度指各个stage的task的数量。 如果并行度设置不合理而导致并行度过低,会导致资源的极大浪费,例如,20个Executor,每个Executor分配3个CPU core,而Spark作业有40个task,这样每个Executor分配到的task个数是2个,这就使得每个Executor有一个CPU core空闲,导致资源的浪费。 理想的并行度设置,应该是让并行度与资源相匹配,简单来说就是在资源允许的前提下,并行度要设置的尽可能大,达到可以充分利用集群资源。合理的设置并行度,可以提升整个Spark作业的性能和运行速度。 Spark官方推荐,task数量应该设置为Spark作业总CPU core数量的2~3倍。之所以没有推荐task数量与CPU core总数相等,是因为task的执行时间不同,有的task执行速度快而有的task执行速度慢,如果task数量与CPU core总数相等,那么执行快的task执行完成后,会出现CPU core空闲的情况。如果task数量设置为CPU core总数的2~3倍,那么一个task执行完毕后,CPU core会立刻执行下一个task,降低了资源的浪费,同时提升了Spark作业运行的效率。 Spark作业并行度的设置如下: valconf=newSparkConf().set("spark.default.parallelism","500") 原则:让 cpu 的 Core(cpu 核心数) 充分利用起来, 如有100个 Core,那么并行度可以设置为200~300。 7. repartition/coalesce调节并行度 我们知道 Spark 中有并行度的调节策略,但是,并行度的设置对于Spark SQL是不生效的,用户设置的并行度只对于Spark SQL以外的所有Spark的stage生效。 Spark SQL的并行度不允许用户自己指定,Spark SQL自己会默认根据hive表对应的HDFS文件的split个数自动设置Spark SQL所在的那个stage的并行度,用户自己通 spark.default.parallelism 参数指定的并行度,只会在没Spark SQL的stage中生效。 由于Spark SQL所在stage的并行度无法手动设置,如果数据量较大,并且此stage中后续的transformation操作有着复杂的业务逻辑,而Spark SQL自动设置的task数量很少,这就意味着每个task要处理为数不少的数据量,然后还要执行非常复杂的处理逻辑,这就可能表现为第一个有Spark SQL的stage速度很慢,而后续的没有Spark SQL的stage运行速度非常快。 为了解决Spark SQL无法设置并行度和task数量的问题,我们可以使用repartition算子。 repartition 算子使用前后对比图如下: repartition 算子使用前后对比图 Spark SQL这一步的并行度和task数量肯定是没有办法去改变了,但是,对于Spark SQL查询出来的RDD,立即使用repartition算子,去重新进行分区,这样可以重新分区为多个partition,从repartition之后的RDD操作,由于不再涉及Spark SQL,因此stage的并行度就会等于你手动设置的值,这样就避免了Spark SQL所在的stage只能用少量的task去处理大量数据并执行复杂的算法逻辑。使用repartition算子的前后对比如上图所示。 8. reduceByKey本地预聚合 reduceByKey相较于普通的shuffle操作一个显著的特点就是会进行map端的本地聚合,map端会先对本地的数据进行combine操作,然后将数据写入给下个stage的每个task创建的文件中,也就是在map端,对每一个key对应的value,执行reduceByKey算子函数。 reduceByKey算子的执行过程如下图所示: reduceByKey 算子执行过程 使用reduceByKey对性能的提升如下: 本地聚合后,在map端的数据量变少,减少了磁盘IO,也减少了对磁盘空间的占用; 本地聚合后,下一个stage拉取的数据量变少,减少了网络传输的数据量; 本地聚合后,在reduce端进行数据缓存的内存占用减少; 本地聚合后,在reduce端进行聚合的数据量减少。 基于reduceByKey的本地聚合特征,我们应该考虑使用reduceByKey代替其他的shuffle算子,例如groupByKey。 groupByKey与reduceByKey的运行原理如下图1和图2所示: 图1:groupByKey原理 图2:reduceByKey原理 根据上图可知,groupByKey不会进行map端的聚合,而是将所有map端的数据shuffle到reduce端,然后在reduce端进行数据的聚合操作。由于reduceByKey有map端聚合的特性,使得网络传输的数据量减小,因此效率要明显高于groupByKey。 9. 使用持久化+checkpoint Spark持久化在大部分情况下是没有问题的,但是有时数据可能会丢失,如果数据一旦丢失,就需要对丢失的数据重新进行计算,计算完后再缓存和使用,为了避免数据的丢失,可以选择对这个RDD进行checkpoint,也就是将数据持久化一份到容错的文件系统上(比如HDFS)。 一个RDD缓存并checkpoint后,如果一旦发现缓存丢失,就会优先查看checkpoint数据存不存在,如果有,就会使用checkpoint数据,而不用重新计算。也即是说,checkpoint可以视为cache的保障机制,如果cache失败,就使用checkpoint的数据。 使用checkpoint的优点在于提高了Spark作业的可靠性,一旦缓存出现问题,不需要重新计算数据,缺点在于,checkpoint时需要将数据写入HDFS等文件系统,对性能的消耗较大。 持久化设置如下: sc.setCheckpointDir(‘HDFS’)rdd.cache/persist(memory_and_disk)rdd.checkpoint 10. 使用广播变量 默认情况下,task中的算子中如果使用了外部的变量,每个task都会获取一份变量的复本,这就造成了内存的极大消耗。一方面,如果后续对RDD进行持久化,可能就无法将RDD数据存入内存,只能写入磁盘,磁盘IO将会严重消耗性能;另一方面,task在创建对象的时候,也许会发现堆内存无法存放新创建的对象,这就会导致频繁的GC,GC会导致工作线程停止,进而导致Spark暂停工作一段时间,严重影响Spark性能。 假设当前任务配置了20个Executor,指定500个task,有一个20M的变量被所有task共用,此时会在500个task中产生500个副本,耗费集群10G的内存,如果使用了广播变量, 那么每个Executor保存一个副本,一共消耗400M内存,内存消耗减少了5倍。 广播变量在每个Executor保存一个副本,此Executor的所有task共用此广播变量,这让变量产生的副本数量大大减少。 在初始阶段,广播变量只在Driver中有一份副本。task在运行的时候,想要使用广播变量中的数据,此时首先会在自己本地的Executor对应的BlockManager中尝试获取变量,如果本地没有,BlockManager就会从Driver或者其他节点的BlockManager上远程拉取变量的复本,并由本地的BlockManager进行管理;之后此Executor的所有task都会直接从本地的BlockManager中获取变量。 对于多个Task可能会共用的数据可以广播到每个Executor上: val广播变量名=sc.broadcast(会被各个Task用到的变量,即需要广播的变量)广播变量名.value//获取广播变量 11. 使用Kryo序列化 默认情况下,Spark使用Java的序列化机制。Java的序列化机制使用方便,不需要额外的配置,在算子中使用的变量实现Serializable接口即可,但是,Java序列化机制的效率不高,序列化速度慢并且序列化后的数据所占用的空间依然较大。 Spark官方宣称Kryo序列化机制比Java序列化机制性能提高10倍左右,Spark之所以没有默认使用Kryo作为序列化类库,是因为它不支持所有对象的序列化,同时Kryo需要用户在使用前注册需要序列化的类型,不够方便,但从Spark 2.0.0版本开始,简单类型、简单类型数组、字符串类型的Shuffling RDDs 已经默认使用Kryo序列化方式了。 Kryo序列化注册方式的代码如下: publicclassMyKryoRegistratorimplementsKryoRegistrator{@OverridepublicvoidregisterClasses(Kryokryo){kryo.register(StartupReportLogs.class);}} 配置Kryo序列化方式的代码如下: //创建SparkConf对象valconf=newSparkConf().setMaster(…).setAppName(…)//使用Kryo序列化库conf.set("spark.serializer","org.apache.spark.serializer.KryoSerializer");//在Kryo序列化库中注册自定义的类集合conf.set("spark.kryo.registrator","bigdata.com.MyKryoRegistrator"); 本文首发于公众号:五分钟学大数据,回复【666】即可获得全套大数据笔面试教程

优秀的个人博客,低调大师

面试官:我问的是Java内存模型,你回答堆栈方法区干嘛?

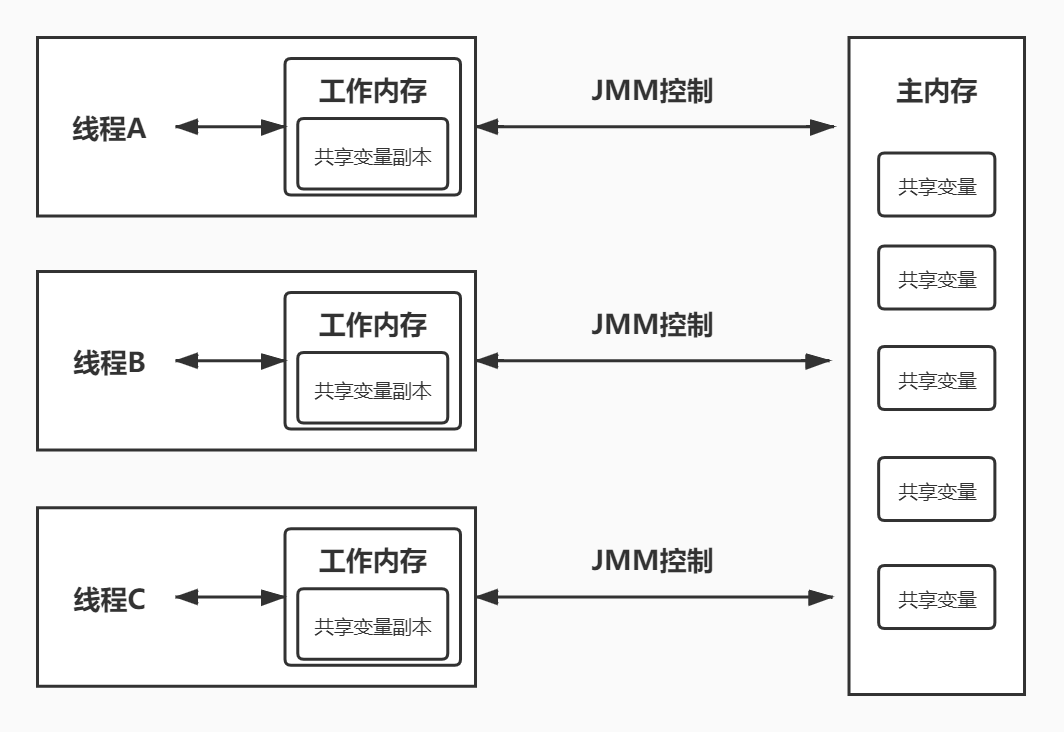
听说微信搜索《Java鱼仔》会变更强哦! 本文收录于JavaStarter,里面有我完整的Java系列文章,学习或面试都可以看看哦 (一)概述 很多人会把Java内存区域(运行时数据区)和Java内存模型(JMM)搞混,这两者是完全不一样的东西。 Java内存区域是指JVM运行时数据分区域存储,而Java内存模型是定义了线程和主内存之间的抽象关系,了解Java内存模型是学好Java并发编程的基础。 (二)Java内存模型 Java内存模型中规定了所有的变量都存储在主内存中,每条线程还有自己的工作内存,线程对变量的所有操作都必须在工作内存中进行,而不能直接读写主内存中的变量。我们来看一张图: 每个线程拥有一个自己的私有工作内存,需要变量时从主内存中拷贝一份到工作内存,如果更新过变量之后再将共享变量刷新到主内存。 但是两个线程之间,是没有办法读取对方工作内存中的变量值的。看一个例子: public class Test { private static boolean flag=false; public static void main(String[] args) throws InterruptedException { new Thread(new Runnable() { @Override public void run() { System.out.println("waiting"); while (!flag){} System.out.println("in"); } }).start(); Thread.sleep(2000); new Thread(new Runnable() { @Override public void run() { System.out.println("change flag"); flag=true; System.out.println("change success"); } }).start(); } } 首先定义了一个静态变量flag为false,A线程等待flag等于true后输出in,于是我们新开一个线程将flag修改为true。结果是A线程依旧无法输出in。 原理看Java内存模型的图就理解了,不同的线程修改变量,对本地线程是不可见的。 (三)JMM数据的原子操作 通过上面这段代码,我们已经知道了Java内存模型的结构,那么工作内存和主内存之间是如何读取变量又是如何修改变量的呢?JMM提供了对变量的一系列原子操作。我们先不讲理论,看个图,这个图描述了上面一段代码的执行过程: 整个过程一共十步,重复几个步骤不讲了,我把不重复的六个操作列一下: read:从主内存读取数据 load:将主内存读取到的数据写入工作内存 use :从工作内存中读取数据来使用 assign:把计算好的值重新赋值到工作内存中 store:将工作内存数据写入主内存 write:将store过去的变量赋值给主内存中的变量 通过上面的图,对下面六个原子操作的理解应该可以更加深刻了。JMM的原子操作一共有八个,下面列出剩下的两个 lock:将主内存变量加锁,标识为线程独占状态 unlock:将主内存变量解锁,解锁后其他线程可以锁定该变量 (四)JMM缓存不一致问题 从前面的例子我们已经看到了,一个线程修改完数据,另外一个线程无法立即可见,这就是JMM缓存不一致的问题,有两种解决办法: 加锁: 还记得我们没有用到过的JMM原操作的最后两个吗,lock和unlock,使用这两个操作就可以实现缓存一致性,一个线程想要获取某个主内存变量时,先使用lock将主内存变量加锁,只有他才能使用,等用完后再unlock,其他线程才能竞争。但是加锁意味着性能低。 MESI缓存一致性协议: 这个协议涉及到cpu的总线嗅探机制,从上面的JMM执行的流程图中我们可以看到当某个线程修改了共享变量后,他会回写到主内存,MESI缓存一致性协议就是通过cpu的总线嗅探机制,将其他也正在使用该变量的线程的数据失效掉,使得这些线程要重新读取主内存中的值,从而保证缓存最终一致性。(volatile的实现原理) (五)总结 Java内存模型在多并发中十分重要,包括后面学习volatile或者synchronized这个关键字的时候,都会回到这个Java内存模型中。

优秀的个人博客,低调大师

面试阿里被问:“你的项目是如何处理重复请求/并发请求的?”

利用唯一请求编号去重 业务参数去重 计算请求参数的摘要作为参数标识 继续优化,考虑剔除部分时间因子 请求去重工具类,Java实现 总结 对于一些用户请求,在某些情况下是可能重复发送的,如果是查询类操作并无大碍,但其中有些是涉及写入操作的,一旦重复了,可能会导致很严重的后果,例如交易的接口如果重复请求可能会重复下单。 重复的场景有可能是: 黑客拦截了请求,重放 前端/客户端因为某些原因请求重复发送了,或者用户在很短的时间内重复点击了。 网关重发 …. 本文讨论的是如何在服务端优雅地统一处理这种情况,如何禁止用户重复点击等客户端操作不在本文的讨论范畴。 利用唯一请求编号去重 你可能会想到的是,只要请求有唯一的请求编号,那么就能借用Redis做这个去重——只要这个唯一请求编号在redis存在,证明处理过,那么就认为是重复的 代码大概如下: String KEY = "REQ12343456788";//请求唯一编号 long expireTime = 1000;// 1000毫秒过期,1000ms内的重复请求会认为重复 long expireAt = System.currentTimeMillis() + expireTime; String val = "expireAt@" + expireAt; //redis key还存在的话要就认为请求是重复的 Boolean firstSet = stringRedisTemplate.execute((RedisCallback<Boolean>) connection -> connection.set(KEY.getBytes(), val.getBytes(), Expiration.milliseconds(expireTime), RedisStringCommands.SetOption.SET_IF_ABSENT)); final boolean isConsiderDup; if (firstSet != null && firstSet) {// 第一次访问 isConsiderDup = false; } else {// redis值已存在,认为是重复了 isConsiderDup = true; } 业务参数去重 上面的方案能解决具备唯一请求编号的场景,例如每次写请求之前都是服务端返回一个唯一编号给客户端,客户端带着这个请求号做请求,服务端即可完成去重拦截。 但是,很多的场景下,请求并不会带这样的唯一编号!那么我们能否针对请求的参数作为一个请求的标识呢? 先考虑简单的场景,假设请求参数只有一个字段reqParam,我们可以利用以下标识去判断这个请求是否重复。用户ID:接口名:请求参数 String KEY = "dedup:U="+userId + "M=" + method + "P=" + reqParam; 那么当同一个用户访问同一个接口,带着同样的reqParam过来,我们就能定位到他是重复的了。 但是问题是,我们的接口通常不是这么简单,以目前的主流,我们的参数通常是一个JSON。那么针对这种场景,我们怎么去重呢? 计算请求参数的摘要作为参数标识 假设我们把请求参数(JSON)按KEY做升序排序,排序后拼成一个字符串,作为KEY值呢?但这可能非常的长,所以我们可以考虑对这个字符串求一个MD5作为参数的摘要,以这个摘要去取代reqParam的位置。 String KEY = "dedup:U="+userId + "M=" + method + "P=" + reqParamMD5; 这样,请求的唯一标识就打上了! 注:MD5理论上可能会重复,但是去重通常是短时间窗口内的去重(例如一秒),一个短时间内同一个用户同样的接口能拼出不同的参数导致一样的MD5几乎是不可能的。 继续优化,考虑剔除部分时间因子 上面的问题其实已经是一个很不错的解决方案了,但是实际投入使用的时候可能发现有些问题:某些请求用户短时间内重复的点击了(例如1000毫秒发送了三次请求),但绕过了上面的去重判断(不同的KEY值)。 原因是这些请求参数的字段里面,是带时间字段的,这个字段标记用户请求的时间,服务端可以借此丢弃掉一些老的请求(例如5秒前)。如下面的例子,请求的其他参数是一样的,除了请求时间相差了一秒: //两个请求一样,但是请求时间差一秒 String req = "{\n" + "\"requestTime\" :\"20190101120001\",\n" + "\"requestValue\" :\"1000\",\n" + "\"requestKey\" :\"key\"\n" + "}"; String req2 = "{\n" + "\"requestTime\" :\"20190101120002\",\n" + "\"requestValue\" :\"1000\",\n" + "\"requestKey\" :\"key\"\n" + "}"; 这种请求,我们也很可能需要挡住后面的重复请求。所以求业务参数摘要之前,需要剔除这类时间字段。还有类似的字段可能是GPS的经纬度字段(重复请求间可能有极小的差别)。 请求去重工具类,Java实现 public class ReqDedupHelper { /** * * @param reqJSON 请求的参数,这里通常是JSON * @param excludeKeys 请求参数里面要去除哪些字段再求摘要 * @return 去除参数的MD5摘要 */ public String dedupParamMD5(final String reqJSON, String... excludeKeys) { String decreptParam = reqJSON; TreeMap paramTreeMap = JSON.parseObject(decreptParam, TreeMap.class); if (excludeKeys!=null) { List<String> dedupExcludeKeys = Arrays.asList(excludeKeys); if (!dedupExcludeKeys.isEmpty()) { for (String dedupExcludeKey : dedupExcludeKeys) { paramTreeMap.remove(dedupExcludeKey); } } } String paramTreeMapJSON = JSON.toJSONString(paramTreeMap); String md5deDupParam = jdkMD5(paramTreeMapJSON); log.debug("md5deDupParam = {}, excludeKeys = {} {}", md5deDupParam, Arrays.deepToString(excludeKeys), paramTreeMapJSON); return md5deDupParam; } private static String jdkMD5(String src) { String res = null; try { MessageDigest messageDigest = MessageDigest.getInstance("MD5"); byte[] mdBytes = messageDigest.digest(src.getBytes()); res = DatatypeConverter.printHexBinary(mdBytes); } catch (Exception e) { log.error("",e); } return res; } } 下面是一些测试日志: public static void main(String[] args) { //两个请求一样,但是请求时间差一秒 String req = "{\n" + "\"requestTime\" :\"20190101120001\",\n" + "\"requestValue\" :\"1000\",\n" + "\"requestKey\" :\"key\"\n" + "}"; String req2 = "{\n" + "\"requestTime\" :\"20190101120002\",\n" + "\"requestValue\" :\"1000\",\n" + "\"requestKey\" :\"key\"\n" + "}"; //全参数比对,所以两个参数MD5不同 String dedupMD5 = new ReqDedupHelper().dedupParamMD5(req); String dedupMD52 = new ReqDedupHelper().dedupParamMD5(req2); System.out.println("req1MD5 = "+ dedupMD5+" , req2MD5="+dedupMD52); //去除时间参数比对,MD5相同 String dedupMD53 = new ReqDedupHelper().dedupParamMD5(req,"requestTime"); String dedupMD54 = new ReqDedupHelper().dedupParamMD5(req2,"requestTime"); System.out.println("req1MD5 = "+ dedupMD53+" , req2MD5="+dedupMD54); } 日志输出: req1MD5 = 9E054D36439EBDD0604C5E65EB5C8267 , req2MD5=A2D20BAC78551C4CA09BEF97FE468A3F req1MD5 = C2A36FED15128E9E878583CAAAFEFDE9 , req2MD5=C2A36FED15128E9E878583CAAAFEFDE9 日志说明: 一开始两个参数由于requestTime是不同的,所以求去重参数摘要的时候可以发现两个值是不一样的 第二次调用的时候,去除了requestTime再求摘要(第二个参数中传入了”requestTime”),则发现两个摘要是一样的,符合预期。 总结 至此,我们可以得到完整的去重解决方案,如下: String userId= "12345678";//用户 String method = "pay";//接口名 String dedupMD5 = new ReqDedupHelper().dedupParamMD5(req,"requestTime");//计算请求参数摘要,其中剔除里面请求时间的干扰 String KEY = "dedup:U=" + userId + "M=" + method + "P=" + dedupMD5; long expireTime = 1000;// 1000毫秒过期,1000ms内的重复请求会认为重复 long expireAt = System.currentTimeMillis() + expireTime; String val = "expireAt@" + expireAt; // NOTE:直接SETNX不支持带过期时间,所以设置+过期不是原子操作,极端情况下可能设置了就不过期了,后面相同请求可能会误以为需要去重,所以这里使用底层API,保证SETNX+过期时间是原子操作 Boolean firstSet = stringRedisTemplate.execute((RedisCallback<Boolean>) connection -> connection.set(KEY.getBytes(), val.getBytes(), Expiration.milliseconds(expireTime), RedisStringCommands.SetOption.SET_IF_ABSENT)); final boolean isConsiderDup; if (firstSet != null && firstSet) { isConsiderDup = false; } else { isConsiderDup = true; } Java 的知识面非常广,面试问的涉及也非常广泛,重点包括:Java 基础、Java 并发,JVM、MySQL、数据结构、算法、Spring、微服务、MQ 等等,涉及的知识点何其庞大,所以我们在复习的时候也往往无从下手,今天小编给大家带来一套 Java 面试题,题库非常全面,包括 Java 基础、Java 集合、JVM、Java 并发、Spring全家桶、Redis、MySQL、Dubbo、Netty、MQ 等等,包含 Java 后端知识点 2000 + 资料获取方式:关注公众号:“程序员白楠楠”获取
优秀的个人博客,低调大师

Android Material Design Ripple Effect在Android5.0(SDK=21)以下Android版本崩溃问...

Android Material Design Ripple Effect在Android5.0(SDK=21)以下Android版本崩溃问题解决 附录1的Android Ripple Effect水波波纹荡漾的视觉交互设计,在Android SDK版本21上运作良好,但是放到21版本以下,比如Android 4.0.3(SDK=15),就会导致整个APP崩溃,其中一个解决方案:以附录文章1为例,不仅需要在drawable-v21中写好ripple_effect.xml,同时需要再在普通的res/drawable下面放一个同名ripple_effect.xml文件,在res/drawable目录下放的ripple_effect.xml,目的就是为了向下兼容到低版本的Android设备,但是在Android低版本设备中,我把ripple effect退化成一个简单的点击背景变灰色的交互设计: <?xml version="1.0" encoding="utf-8"?> <selector xmlns:android="http://schemas.android.com/apk/res/android"> <item android:drawable="@android:color/white" android:state_window_focused="false" /> <item android:drawable="@android:color/darker_gray" android:state_pressed="true" /> <item android:drawable="@android:color/darker_gray" android:state_focused="true" /> <item android:drawable="@android:color/transparent" /> </selector> 这样就可以正常兼容低版本的Android设备了,但这个解决方案的遗憾就是只是解决了代码向下兼容到低版本Android设备的问题,代价是牺牲了Android Material Design的Ripple Effect水波波纹荡漾视觉交互设计效果。 附录:1,《Android Material Design : Ripple Effect水波波纹荡漾的视觉交互设计》链接:http://blog.csdn.net/zhangphil/article/details/52451848 

优秀的个人博客,低调大师

智能客服API最佳实践---智能物流客服

代码地址https://github.com/yolo3a525/intelligent_logistics_cs 简介把源码如何编译打包apk,让手机能够安装使用编译打包环境要求Windows7 及以上操作系统Android studio 3.0.1及以上版本Git工具 安装 通过git下载代码到本地 通过android studio导入工程(目录为source) 通过菜单栏 build->build apk 打包apk,apk位置为 sourceappbuildoutputsapk目录下。 也可以直接连接手机,手机打开开发者模式,通过菜单栏Run-> run app.选择自己的手机进行安装。 配置&部署在打包apk之前,先要进行一些配置修改才能在手机上正确运行。修改ApiConstants.java文件中的以下3处。 //需要根据自己账号进行配置 public final static String Ali_Key = "goxvu6Jqj3I4TCAe"; public final static String Ali_Secret = "xxxxxxxxxxx"; /** https://market.aliyun.com/products/56928004/cmapi023201.html?spm=5176.730005.0.0.2L4ktL#sku=yuncode1720100000 以上地址需要在阿里云api市场购买,下面是购买后的配置 */ public final static String EXPRESSAGE_API_CODE = "9b840f20e0a04651ad8f5464da7b21b4"; 代码基本结构及调用流程AESDecode 加密签名使用ApiConstants 需要配置数据以及api urlExpressage 物流数据api请求封装,根据物流编号与快递公司查询物流情况。NLPUtil 自然语言处理中的分词api 通过引入nlsclientSDK.完成语音到文字的转变 通过NLP 自然语言分词处理,获取物流公司名称与快递单号 通过调用物流数据api,返回单号的物流情况。 建议&反馈如有任何关于最佳实践的问题和建议,请直接联系最佳实践Owner。如有任何关于阿里云API的建议和反馈,请通过阿里云聆听平台提交,地址: https://connect.aliyun-inc.com/ 提交时注明标签:API最佳实践

优秀的个人博客,低调大师

VLAN 和广播域到底怎么数,关键不在交换机有几台

一台交换机接着财务、研发和访客区的电脑。财务电脑发出一条 ARP 广播,询问默认网关的 MAC 地址,研发电脑和访客电脑会不会收到?这个问题比数交换机端口更能说明 VLAN 的作用。假如三组电脑都处于同一个普通二层网络,交换机会把这条广播转发到该网络的其他相关端口。假如三组电脑分别属于 VLAN 10、VLAN 20 和 VLAN 30,财务电脑的广播就留在 VLAN 10 内,不会因为另外两组电脑也插在同一台交换机上,就跑到它们的端口。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册