首页 文章 精选 留言 我的

精选列表

搜索[Vite构建],共10000篇文章
优秀的个人博客,低调大师

VMware正式加入Open-O 构建NFV未来

全球云基础架构和移动商务解决方案的领导厂商VMware近日宣布正式加入OPEN-O项目。 OPEN-O是Linux Foundation基金会主办的一个开源项目,意在帮助电信、有线和云领域的领先运营商通过网络功能虚拟化(NFV)基础设施、软件定义网络(SDN)和传统网络实现端到端的服务编排。 作为该项目的白金会员,VMware将加入管理委员会、技术指导委员会和营销委员会,从而推动基于开放标准的编排创新浪潮。 今天,全球已经有超过400家的CSP和电信公司,其中许多公司正在寻求加快创新,在更短的时间内推出更容易使用,成本更低的新服务。 CSP和电信公司都在努力将网络、云、移动和IT架构整合到一个融合平台,打造具有非凡敏捷性和符合行业标准经济性的网络服务和应用。OPEN-O项目将帮助各运营商显著提高服务灵活性和响应速度,从而增加收益,降低成本以期提高利润。目前,全球最大的几个运营商包括中国移动、中国电信和香港电信(HKT)都已加入OPEN-O项目,此外也包括了像VMware一样的众多开放网络创新者。 OPEN-O执行董事兼Linux Foundation基金会网络战略副总裁Marc Cohn表示:“OPEN-O项目证明了整个行业都在采用和部署基于开放标准的服务编排,以确保运营商能够充分利用NFV和SDN架构。加入OPEN-O项目的运营商拥有超过十亿的移动、家庭和商业用户群。随着VMware等领先NFV供应商的加入,我们相信,该项目将成功推动通过SDN、NFV基础设施及传统网络来提供复杂服务的进程。” VMware电信NFV事业部解决方案副总裁Gabriele Di Piazza认为:“实施NFV需要强大的NFV基础设施,综合NFV所赋予的灵活性以及OPEN-O项目所确保的多重云编排,客户最终会选择最有助于其实现数字转型的途径,VMware一直是电信公司和通信服务供应商发展和应用NFV的主要推动者,而加入OPEN-O将进一步提升我们的领导地位。” 本文转自d1net(转载)

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 使用 Maven 构建 Storm 应用

在开发拓扑的时候,你需要在 classpath 中包含 Storm 的相关 jar 包。你可以将各个 jar 包直接包含到你的项目的 classpath 中,也可以使用 Maven 将 Storm 添加到依赖项中。Storm 已经集成到 Maven 的中心仓库中。你可以在项目的 pom.xml 中添加以下依赖来将 Storm 包含进项目中: <dependency> <groupId>org.apache.storm</groupId> <artifactId>storm-core</artifactId> <version>0.9.3</version> <scope>provided</scope> </dependency> 这里有一个 Storm 项目的 pom.xml 文件的例子(依赖中的版本号与实际 Storm 发行版相关,目前最新的正式版本为 0.9.5 —— 译者注)。 Storm 开发 如果对 Storm 的开发很感兴趣,请参考DEVELOPER一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Docker1.12 + Swarm 构建动态微服务应用

我们在之前提到过一个示例,即一款由前端与多项后端服务共同构成的微服务应用。其中前端为Traefik HTTP代理,负责将各项请求路由至后端服务。而后端则非常简单,是一套基于Go的HTTP Web服务器,负责返回其运行所在的容器ID。 新的Docker Swarm不再需要为应用容器设置独立的HTTP代理。如上图所示的原有架构现在被精简为下图所示的形式: 移动部件更少了——赞! 另外,我们还为后端服务内置了负载均衡机制。我们甚至能够立足于集群内的任一节点访问这些服务。Docker Swarm还集成有一种内置网状路由机制,用于将各请求路由至适合的后端容器当中。 面对这些新功能,有些朋友可能认为Docker Swarm集群的设置过程会比原本更为复杂。事实上,整个流程反而更加简单。 仍然半信半疑?下面一起来看。 没错,这次我们仍然使用Raspberry Pi集群。我使用的是Docker 1.12内部版本,并将其安装在Raspberry Pi上。当Docker 1.12推出正式版后,我们会对内容做出针对性更新。 下面看看当前配置: root@pi6 $ docker version Client: Version: 1.12.0-rc1 API version: 1.24 Go version: go1.6.2 Git commit: 1f136c1-unsupported Built: Wed Jun 15 15:35:51 2016 OS/Arch: linux/arm Server: Version: 1.12.0-rc1 API version: 1.24 Go version: go1.6.2 Git commit: 1f136c1-unsupported Built: Wed Jun 15 15:35:51 2016 OS/Arch: linux/arm 很好,Docker 1.12 RC1已经准备就绪。下面启动各项必要服务。 首先看看我们能否在Docker CLI中找到隐藏的各项新功能。 root@pi6 $ docker Usage: docker [OPTIONS] COMMAND [arg...] docker [ --help | -v | --version ] A self-sufficient runtime for containers. ... service Manage Docker services ... stats Display a live stream of container(s) resource usage statistics ... swarm Manage Docker Swarm ... update Update configuration of one or more containers Run 'docker COMMAND --help' for more information on a command. 我直接去掉了其中与上代版本完全一致的部分,而只留了不同之处。 现在我们可以使用docker swarm命令了。 查询其具体作用: root@pi6 $ docker swarm Usage: docker swarm COMMAND Manage Docker Swarm Options: --help Print usage Commands: init Initialize a Swarm. join Join a Swarm as a node and/or manager. update update the Swarm. leave Leave a Swarm. inspect Inspect the Swarm Run 'docker swarm COMMAND --help' for more information on a command. 就是说其用于“初始化一套Swarm”。看起来正是我们需要的。首先启动该命令。 root@pi6 $ docker swarm init Swarm initialized: current node (1njlvzi9rk2syv3xojw217o0g) is now a manager. 现在我们的Swarm管理节点已经开始运行,接下来为集群添加更多节点。 前往集群中的另一节点并执行: root@pi1 $ docker swarm join pi6:2377 This node joined a Swarm as a worker. 使用上述命令,我们在刚刚创建的初始Swarm集群中声明了应当加入该Swarm管理节点的各个新节点。Docker Swarm会在后台执行相关操作。 举例来说,其会为不同集群节点设置经过加密的彼此通信通道。我们不再需要自行管理TLS证书。 每位曾经设置过Docker Swarm集群的朋友,都会意识到新的流程有多么简单。 不过到这儿还没有结束。 Swarm管理节点中的一条“docker info”带来了一些有趣的提示。我仍然删去其中不必要的部分: root@pi6 $ docker info ... Swarm: active NodeID: 1njlvzi9rk2syv3xojw217o0g IsManager: Yes Managers: 1 Nodes: 2 CACertHash: sha256:de4e2bff3b63700aad01df97bbe0397f131aabed5fabb7732283f044472323fc ... Kernel Version: 4.4.10-hypriotos-v7+ Operating System: Raspbian GNU/Linux 8 (jessie) OSType: linux Architecture: armv7l CPUs: 4 Total Memory: 925.4 MiB Name: pi6 ... 如大家所见,我们现在已经在“docker info”输出结果中有了新的“Swarm”部分,其告诉我们当前节点属于一套Swarm管理节点,且该集群由两个集群节点构成。 在第二个节点上,其输出结果与管理节点稍有不同: Swarm: active NodeID: 3fmwt4taurwxczr2icboojz8g IsManager: No 到这里,我们已经拥有了一套有趣但仍然空空如也的Swarm集群。 我们还需要了解Docker 1.12中的service这项全新抽象定义。大家可能在前面的输出结果中注意到了docker service命令。所谓docker service,是指运行在容器当中且负责为外部世界提供运行在Swarm集群内的“service”的软件片段。 这样的一项服务可以由单一或者多套容器构成。在后一种情况下,我们可以确保服务拥有高可用性及/或负载均衡能力。 下面使用之前创建的“whoami”镜像建立这样一项服务。 root@pi6 $ docker service create --name whoami -p 80:8000 hypriot/rpi-whoami buy0q65lw7nshm76kvy5imxk3 在“docker swarm ls”命令的帮助下,我们可以检查这项新服务的状态。 root@pi6 $ docker service ls ID NAME SCALE IMAGE COMMAND buy0q65lw7ns whoami 1 hypriot/rpi-whoami 下面检查我们是否能够通过curl命令向eth0网络接口发送l http命令,从而请求目录页面。 root@pi6 $ curl http://192.168.178.24 I'm 1b6df814c654 一切顺利,鼓掌! 有些朋友可能注意到,“docker swarm ls”命令的标题行中存在“SCALE”部分,这似乎意味着我们可以对服务进行扩展。 root@pi6 $ docker service scale whoami=5 whoami scaled to 5 那就来实际验证一下吧: root@pi6 $ docker service ls ID NAME SCALE IMAGE COMMAND buy0q65lw7ns whoami 5 hypriot/rpi-whoami root@pi6 $ for i in {1..5}; do curl http://192.168.178.24; done I'm 8db1657e8517 I'm e1863a2be88d I'm 1b6df814c654 I'm 8db1657e8517 I'm e1863a2be88d 非常简单。 但这种方式与原有Swarm其实差不多,只不过在使用感受上更便捷也更快速。请注意,我们使用的是Raspberry Pi而非强大的服务器,所以要对性能拥有较为保守的估计。 下面从单一Docker引擎的角度来看看目前的运行状态: root@pi6 $ docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES e1863a2be88d hypriot/rpi-whoami:latest "/http" 2 minutes ago Up 2 minutes 8000/tcp whoami.4.0lg12zndbal72exqe08r9wvpg 8db1657e8517 hypriot/rpi-whoami:latest "/http" 2 minutes ago Up 2 minutes 8000/tcp whoami.5.5z6mvsrdy73m5w24icgsqc8i2 1b6df814c654 hypriot/rpi-whoami:latest "/http" 8 minutes ago Up 8 minutes 8000/tcp whoami.1.bg4qlpiye6h6uxyf8cmkwuh52 如大家所见,已经启动的容器有5套,其中3套驻留于“pi6”中。 下面看看是否能够找到其它容器: root@pi1 docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES db411a119c0a hypriot/rpi-whoami:latest "/http" 6 minutes ago Up 6 minutes 8000/tcp whoami.2.2tf7yhmx9haol7e2b7xib2emj 0a4bf32fa9c4 hypriot/rpi-whoami:latest "/http" 6 minutes ago Up 6 minutes 8000/tcp whoami.3.2r6mm091c2ybr0f9jz4qaxw9k 那么如果我们将这套Swarm集群驻留在“pi1”上,结果又会如何? root@pi1 docker swarm leave Node left the default swarm. 下面看看另一节点上的运行情况: docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 58620e3d533c hypriot/rpi-whoami:latest "/http" 46 seconds ago Up 43 seconds 8000/tcp whoami.2.cgc4e2ixulc2f3ehr4laoursg acc9b523f434 hypriot/rpi-whoami:latest "/http" 46 seconds ago Up 43 seconds 8000/tcp whoami.3.67bhlo3nwgehthi3bg5bfdzue e1863a2be88d hypriot/rpi-whoami:latest "/http" 8 minutes ago Up 8 minutes 8000/tcp whoami.4.0lg12zndbal72exqe08r9wvpg 8db1657e8517 hypriot/rpi-whoami:latest "/http" 8 minutes ago Up 8 minutes 8000/tcp whoami.5.5z6mvsrdy73m5w24icgsqc8i2 1b6df814c654 hypriot/rpi-whoami:latest "/http" 15 minutes ago Up 14 minutes 8000/tcp whoami.1.bg4qlpiye6h6uxyf8cmkwuh52 这里的情况相当于“pi1”节点发生故障,此时“pi1”中运行的全部容器都会被自动迁移至另一集群节点。这项机制在实际生产当中无疑非常重要。 那么下面我们回顾一下之前了解到的信息: 我们创建了一款小型动态微服务应用,完全由Docker构成。Docker Swarm现在被整合至Docker-Engine当中,而不再以独立软件形式存在。在多数情况下,这能够为应用后端服务建立起独立的代理机制。不再需要使用nginx、HAProxy或者Traefik。 尽管活动部件数量有所减少,但我们现在反而拥有了内置的高可用性与负载均衡功能。我非常期待未来Docker Swarm正式版本中会带来哪些新的惊喜,又如何与Docker Compose进行协作。 原文发布时间为:2016-07-23 本文来自云栖社区合作伙伴“Linux中国”

优秀的个人博客,低调大师

如何在阿里云上构建高可用应用

业务高可用是我们每个项目的需求,一个经常故障的项目,会让我们觉得不靠谱而选择放弃,从而导致项目的失败。今天,我们来聊一聊,如何让你自己的业务能够更加稳固的运行! 本次我们从四个不同的角度,来分析,如何让我们的应用更加稳固,平稳运行。 一、 程序架构 优秀的代码 优秀的代码非常重要,即使我们拥有最好的硬件资源和架构,如果我们没有一套健壮的代码,其他资源再好都没有用,所以代码在设计和编写时,应当注意代码的健壮程度。优秀的代码不止开发起来方便,同时维护成本也较低,对于后续的优化来说,健壮的代码会让优化人员更加容易的找到问题的关键。 合理的架构 一个大型的、负载的单体应用可能会让你的整个开发进度缓慢、部署困难。所以,为了解决这种问题,不妨在开发初期便将应用程序设计为微服务架构的程序,虽然可能会提升程序之间的沟通难度,但却为你的应用提供了

优秀的个人博客,低调大师

docker(6):使用dokcer 构建 mariadb 数据库

本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/53540615 未经博主允许不得转载。 博主地址是:http://blog.csdn.net/freewebsys 1,关于mariadb 其实就是mysql的另外一个开源项目。不想被oracle控制的开源版本。 这里有个方便的做法,使用docker的官方的镜像。 自己弄镜像还需要安装,编译配置啥的。 这个特别的省事。只要下载安装就可以了。 项目地址: /mariadb/”>https://hub.docker.com/r//mariadb/ 2,下载使用 首先下载本地镜像,然后启动就行了。 1),参考文档 如果系统开启了SELinux 需要设置文件夹权限,否则mariadb启动不了。 mkdir -p /data/mysql/data chcon -Rt svirt_sandbox_file_t /data/mysql/data docker run -v /data/mysql/data:/var/lib/mysql -p 3306:3306 -e MYSQL_ROOT_PASSWORD=root --name mariadb -d mariadb:latest MYSQL_ROOT_PASSWORD 是设置root的密码。 然后使用docker ps查看: 启动成功,并且绑定了端口 3306 可以使用mysql了。 docker exec -it mariadb bash root@XXXX:/# mysql -uroot -proot 可以使用mysql了。 Welcome to the MariaDB monitor. Commands end with ; or \g. Your MariaDB connection id is 3 Server version: 10.1.19-MariaDB-1~jessie mariadb.org binary distribution Copyright (c) 2000, 2016, Oracle, MariaDB Corporation Ab and others. Type 'help;' or '\h' for help. Type '\c' to clear the current input statement. MariaDB [(none)]> show databases; +--------------------+ | Database | +--------------------+ | information_schema | | mysql | | performance_schema | +--------------------+ 3 rows in set (0.00 sec) MariaDB [(none)]> 3,总结 本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/53540615 未经博主允许不得转载。 博主地址是:http://blog.csdn.net/freewebsys 使用一个最简单的办法安装了mariadb。并且将数据放到了,宿主的/data/mysql/data 目录下面了。 方便数据备份。数据迁移,同时暴露了3306端口对外。 使用docker还是非常的方便的,比起yum安装配置简单多了。 配置文件也可以通过目录映射的方式修改。 而且完全的拆分了服务,存储,接口。真的是一个集装箱了。

优秀的个人博客,低调大师

iOS 高性能异构滚动视图构建方案 —— LazyScrollView

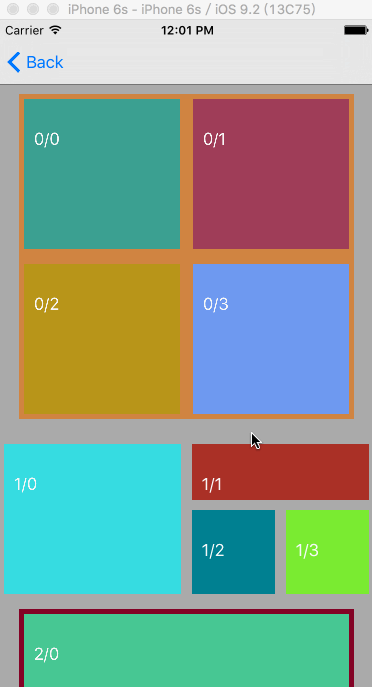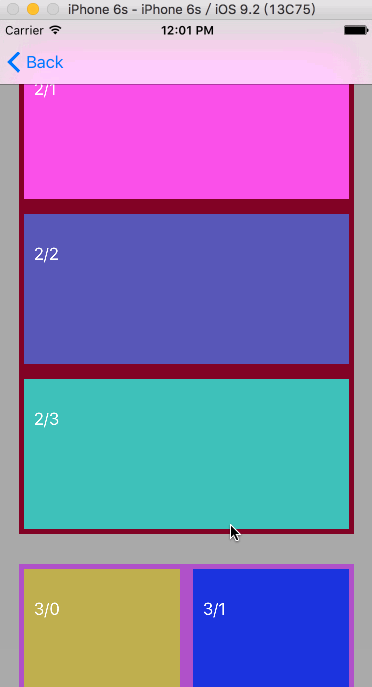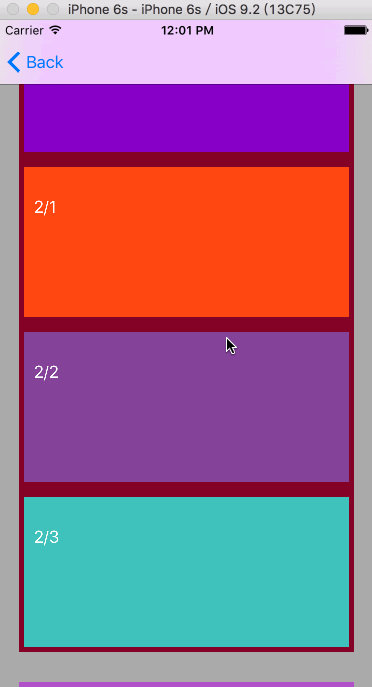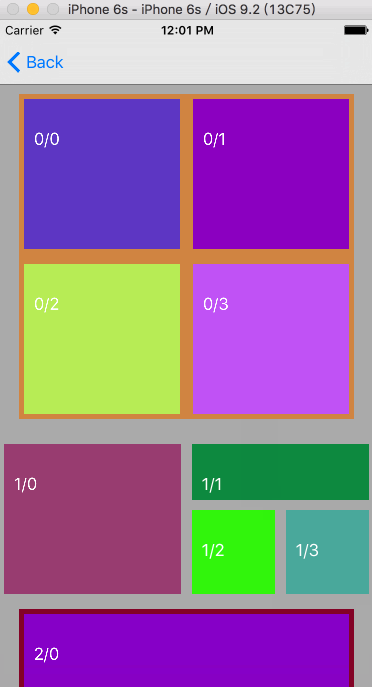
##LazyScroll是什么 LazyScrollView 继承自ScrollView,目标是解决异构(与TableView的同构对比)滚动视图的复用回收问题。它可以支持跨View层的复用,用易用方式来生成一个高性能的滚动视图。此方案最先在天猫iOS客户端的首页落地。 为什么要用LazyScrollView 猫客首页之前首页的View比较少,不需要复用和回收也有很优秀的性能,但是之后首页的View数量逐渐膨胀,没有一套复用回收机制的ScrollView已经影响到性能了,迫切需要处理对ScrollView中View的复用和回收。 使用TableView只能用来解决同类Cell的展示,而在猫客首页这个ScrollView里面,View的种类太多了。不适合我们的场景。 而UICollectionView本身的布局和复用回收机制不够灵活,用起来也较为繁琐。并且本来猫客的首页就有一套相对成熟的卡片布局方案。所以诞生了LazyScrollView去解决这个问题。 LazyScroll如何用 LazyScrollView的使用和TableView很像,不过多了一个需要实现的方法:返回对应index的View 相对LazyScrollView的绝对坐标。 实现LazyScrollViewDatasource 类似TableView的用法,我们需要使用方实现LazyScrollViewDatasource这个Delegate @protocol TMMuiLazyScrollViewDataSource <NSObject> @required //ScrollView一共展示多少个item - (NSUInteger)numberOfItemInScrollView:(TMMuiLazyScrollView *)scrollView; //要求根据index直接返回RectModel - (TMMuiRectModel *)scrollView:(TMMuiLazyScrollView *)scrollView rectModelAtIndex:(NSUInteger)index; //返回下标所对应的view - (UIView *)scrollView:(TMMuiLazyScrollView *)scrollView itemByMuiID:(NSString *)muiID; @end LazyScrollView的核心是在初始状态就得知所有View应该显示的位置。这个Protocol可以让LazyScrollView获取到这些信息。 第一个方法很简单,获取LazyScrollView中item的个数。 第二个方法需要按照Index返回TMMuiRectModel,它会携带对应index的View 相对LazyScrollView的绝对坐标。TMMuiRectModel是这么个东西: @interface TMMuiRectModel:NSObject //转换后的绝对值rect @property (nonatomic,assign) CGRect absRect; //业务下标 @property (nonatomic,copy) NSString *muiID; @end absRect是LazyScroll中的View相对LazyScrollView的绝对坐标,muiID是这个View在LazyScrollView中唯一的标识符,可赋值也可不赋值,不赋值的话LazyScroll会处理成转换为字符串的下标。如果这个标识符在Protocol的第三个方法中会用到。 第三个方法,返回View。首先,我们在UIView之外加了一个Category: @interface UIView(TMMui) //索引过的标识,在LazyScrollView范围内唯一 @property (nonatomic, copy) NSString *muiID; //重用的ID @property (nonatomic, copy) NSString *reuseIdentifier; 这个category可以让View携带muiID和reuseIdentifier,对于返回的View来说,只需要在乎对View的reuseIdentifier赋值,muiID的赋值会在lazyScrollView中处理掉。reuseIdentifier相同的View会被复用,如果这个View的reuseIdentifier是nil或者空字符串,则不会被复用。 调用核心API - (void)reloadData; 重新走一遍DataSource的这些方法,等同于TableView中的reloadData - (UIView *)dequeueReusableItemWithIdentifier:(NSString *)identifier 根据identifier获取可以复用的View。和TableView的dequeueReusableCellWithIdentifier:(NSString *)identifier方法意义相同。通常是在LazyScrollViewDatasource第三个方法,返回View的时候使用。先尝试获取复用池中的View,如果没有再去新建。 LazyScrollView的内部实现 这是一个Demo, 被复用的View,标记的backgroundColor会和之前生成的时候有所不同。 STEP 1 根据DataSource获取所有的TMMuiRectModel 根据DataSource的Delegate,拿到所有的View应该被显示的位置。这一步,核心是拿到的位置是确定的。 根据Demo,我们观察从 0/1 - 2/3 之间这些View 这个时候LazyScrollView拿到的Rect如下: Index 标号(MUIID) Rect 0 0/0 origin = (x = 25, y = 15), size = (width = 156, height = 150 1 0/1 origin = (x = 194, y = 15), size = (width = 156, height = 150) 2 0/2 origin = (x = 25, y = 180), size = (width = 156, height = 150) 3 0/3 origin = (x = 194, y = 180), size = (width = 156, height = 150 4 1/0 origin = (x = 5, y = 360), size = (width = 177.5, height = 150) 5 1/1 origin = (x = 192.5, y = 426), size = (width = 84, height = 84) 6 1/2 origin = (x = 192.5, y = 360), size = (width = 177.5, height = 56) 7 1/3 origin = (x = 286.5, y = 426), size = (width = 83.5, height = 84) 8 2/0 origin = (x = 25, y = 530), size = (width = 325, height = 150) 9 2/1 origin = (x = 25, y = 695), size = (width = 325, height = 150) 10 2/2 origin = (x = 25, y = 860), size = (width = 325, height = 150) STEP 2 排序 拿到了这些位置之后,接下来做的事情就是排序。排序生成的索引会有两个:根据顶边(y)升序排序的索引和根据底边(y+height)降序排序的索引。 根据顶边(y)升序排序的索引 RANK 标号(MUIID) Rect 0 0/0 origin = (x = 25, y = 15), size = (width = 156, height = 150 1 0/1 origin = (x = 194, y = 15), size = (width = 156, height = 150) 2 0/2 origin = (x = 25, y = 180), size = (width = 156, height = 150) 3 0/3 origin = (x = 194, y = 180), size = (width = 156, height = 150 4 1/0 origin = (x = 5, y = 360), size = (width = 177.5, height = 150) 5 1/2 origin = (x = 192.5, y = 360), size = (width = 177.5, height = 56) 6 1/1 origin = (x = 192.5, y = 426), size = (width = 84, height = 84) 7 1/3 origin = (x = 286.5, y = 426), size = (width = 83.5, height = 84) 8 2/0 origin = (x = 25, y = 530), size = (width = 325, height = 150) 9 2/1 origin = (x = 25, y = 695), size = (width = 325, height = 150) 10 2/2 origin = (x = 25, y = 860), size = (width = 325, height = 150) 根据底边(y+height)降序排序的索引 RANK 标号(MUIID) Rect 0 2/2 origin = (x = 25, y = 860), size = (width = 325, height = 150) 1 2/1 origin = (x = 25, y = 695), size = (width = 325, height = 150) 2 2/0 origin = (x = 25, y = 530), size = (width = 325, height = 150) 3 1/0 origin = (x = 5, y = 360), size = (width = 177.5, height = 150) 4 1/2 origin = (x = 192.5, y = 360), size = (width = 177.5, height = 56) 5 1/3 origin = (x = 286.5, y = 426), size = (width = 83.5, height = 84) 6 1/1 origin = (x = 192.5, y = 426), size = (width = 84, height = 84) 7 0/2 origin = (x = 25, y = 180), size = (width = 156, height = 150) 8 0/3 origin = (x = 194, y = 180), size = (width = 156, height = 150 9 0/0 origin = (x = 25, y = 15), size = (width = 156, height = 150 10 0/1 origin = (x = 194, y = 15), size = (width = 156, height = 150) STEP 3 查找 前两步是在执行完reload,在视图还没有生成的时候就开始做了,而接下来的步骤在要生成视图(初始化或滚动的时候)才会去做。 我们设定了Buffer为上下各20,滚动超过20个像素后才会指定查找视图并显示的动作。 接下来就是找哪些View应该被显示了。举个例子,如下图,红圈是应该显示的区域。 现在已知的是红圈顶边y是242,底边y是949,加上缓冲区Buffer,应该是找222 - 969之间的View。我们要做的是,找到底边y小于969的Model和顶边y大于222的Model,取交集,就是我们要显示的View 采用的方法为二分查找,在根据顶边升序排序的索引中找949,找到的index为0(MUIID为2/2),我们使用一个Set,把根据顶边排序中index >= 0的元素先放在这里。获取的Set中包含的muiID为0/0,0/1,0/2,0/3,1/0,1/1,1/2,1/3,2/0,2/1,2/2。 根据底边排序的索引中找222,找到的index为2,我们把index >= 2的元素放在另一个Set,获取的Set中包含的muiID为0/2,0/3,1/0,1/1,1/2,1/3,2/0,2/1,2/2 两个Set取交集,得到的就是我们的ResultSet,这里面都是我们要显示View的Model,它们的muiID是0/2,0/3,1/0,1/1,1/2,1/3,2/0,2/1,2/2。 STEP 4 回收、复用、生成 我们知道了应该显示哪些View,但是我们之后做的第一步是把不需要显示的View加入到复用池中。 LazyScroll可以取到当前显示了的View,拿当前显示的View的muiID和将要显示view的Model的muiID做对比,可以知道当前显示的View哪些应该被回收。 LazyScrollView中有一个Dictionary,key是reuseIdentifier,Value是对应reuseIdentifier被回收的View,当LazyScrollView得知这个View不该再出现了,会把View放在这里,并且把这个View hidden掉。 接下来,LazyScrollView会去调用datasource的- (UIView *)scrollView:(TMMuiLazyScrollView *)scrollView itemByMuiID:(NSString *)muiID;复用还是不复用,是由datasource决定的。如果要复用,需要datasource方法内调用- (UIView *)dequeueReusableItemWithIdentifier:(NSString *)identifier获取复用的View,这个方法取出来的View就是在上一段所说的Dictionary中拿的。 这样,我们就完成了一次完整的循环 : 找到所有View将要显示的位置 – 排序 – 查找应该显示的View – 回收 – 创建/复用。 ##最后 LazyScroll的复用和回收能力是比较强大的,在猫客首页使用之后,因为View数量而导致内存过多的问题得到了解决。 在这套复用和回收机制的加持之下,我们将LazyScrollView继续延伸,构造出一套完整的布局解决方案Tangram,它将Native中View的布局方式变得更动态化,敬请期待。


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册