首页 文章 精选 留言 我的

精选列表

搜索[Vite构建],共10000篇文章
优秀的个人博客,低调大师

构建Hadoop+Hbase+ZooKeeper分布式存储

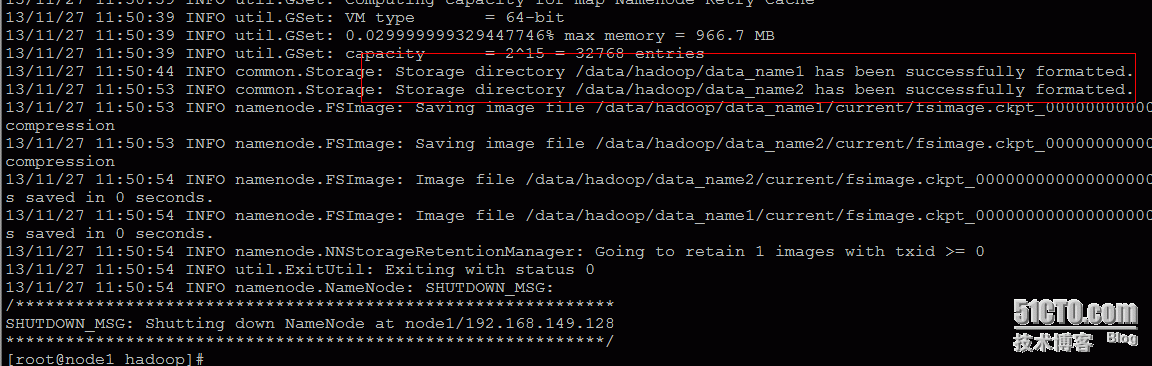
前言*Hadoop是Apache开源组织的一个分布式计算开源框架,在很多大型网站上都已经得到了应用,如亚马逊、Facebook和Yahoo等等。对于我来说,最近的一个使用点就是服务集成平台的日志分析。服务集成平台的日志量将会很大,而这也正好符合了分布式计算的适用场景(日志分析和索引建立就是两大应用场景)。 今天我们来实际搭建一下Hadoop 2.2.0版,实战环境为目前主流服务器操作系统CentOS 6.5系统。 一、实战环境 1 2 3 4 5 6 系统版本:CentOS6.5x86_64 JAVA版本:JDK-1.7.0_25 Hadoop版本:hadoop-2.2.0 192.168.172.59namenode(充当namenode、secondarynamenode和ResourceManager角色) 192.168.172.88datanode1(充当datanode、nodemanager角色) 192.168.172.89datanode2(充当datanode、nodemanager角色) 二、系统准备 1)Hadoop可以从Apache官方网站直接下载最新版本Hadoop2.2。官方目前是提供了linux32位系统可执行文件,所以如果需要在64位系统上部署则需要单独下载src源码自行编译。(如果是真实线上环境,请下载64位hadoop版本,这样可以避免很多问题,这里我实验采用的是32位版本) 1 2 3 4 Hadoop下载地址 http: //apache .claz.org /hadoop/common/hadoop-2 .2.0/ Java下载下载 http: //www .oracle.com /technetwork/java/javase/downloads/index .html 2)我们这里采用三台CnetOS服务器来搭建Hadoop集群,分别的角色如上已经注明。 第一步:我们需要在三台服务器的/etc/hosts里面设置对应的主机名如下(真实环境可以使用内网DNS解析) 1 2 3 4 5 6 7 [root@node1hadoop] #cat/etc/hosts #Donotremovethefollowingline,orvariousprograms #thatrequirenetworkfunctionalitywillfail. 127.0.0.1localhost.localdomainlocalhost 192.168.172.59node1 192.168.172.88node2 192.168.172.89node3(注*我们需要在namenode、datanode三台服务器上都配置hosts解析) 3)从namenode上无密码登陆各台datanode服务器,需要做如下配置: 1 2 3 4 在namenode128上执行 ssh -keygen,一路Enter回车即可。 然后把公钥 /root/ . ssh /id_rsa .pub拷贝到datanode服务器即可,拷贝方法如下: ssh -copy- id -i. ssh /id_rsa .pubroot@192.168.172.88 ssh -copy- id -i. ssh /id_rsa .pubroot@192.168.172.89 三、Java安装配置 1 2 3 4 5 tar -xvzfjdk-7u25-linux-x64. tar .gz&& mkdir -p /usr/java/ ; mv /jdk1 .7.0_25 /usr/java/ 即可。 安装完毕并配置java环境变量,在 /etc/profile 末尾添加如下代码: export JAVA_HOME= /usr/java/jdk1 .7.0_25/ export PATH=$JAVA_HOME /bin :$PATH export CLASSPATH=$JAVE_HOME /lib/dt .jar:$JAVE_HOME /lib/tools .jar:./ 保存退出即可,然后执行source/etc/profile生效。在命令行执行java -version如下代表JAVA安装成功。 1 2 3 4 [root@node1~] #java-version javaversion "1.7.0_25" Java(TM)SERuntimeEnvironment(build1.7.0_25-b15) JavaHotSpot(TM)64-BitServerVM(build23.25-b01,mixedmode) (注*我们需要在namenode、datanode三台服务器上都安装Java JDK版本) 四、Hadoop版本安装 官方下载的hadoop2.2.0版本,不用编译直接解压安装就可以使用了,如下: 1)解压: tar-xzvfhadoop-2.2.0.tar.gz&&mvhadoop-2.2.0/data/hadoop/ (注*先在namenode服务器上都安装hadoop版本即可,datanode先不用安装,待会修改完配置后统一安装datanode) 2)配置变量: 1 2 3 4 5 在 /etc/profile 末尾继续添加如下代码,并执行 source /etc/profile 生效。 export HADOOP_HOME= /data/hadoop/ export PATH=$PATH:$HADOOP_HOME /bin/ export JAVA_LIBRARY_PATH= /data/hadoop/lib/native/ (注*我们需要在namenode、datanode三台服务器上都配置Hadoop相关变量) 五、配置Hadoop 在namenode上配置,我们需要修改如下几个地方: 1)修改vi/data/hadoop/etc/hadoop/core-site.xml内容为如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 <? xml version = "1.0" ?> <? xml-stylesheet type = "text/xsl" href = "configuration.xsl" ?> <!--Putsite-specificpropertyoverridesinthisfile.--> < configuration > < property > < name >fs.default.name</ name > < value >hdfs://node1:9000</ value > </ property > < property > < name >hadoop.tmp.dir</ name > < value >/tmp/hadoop-${user.name}</ value > < description >Abaseforothertemporarydirectories.</ description > </ property > </ configuration > 2)修改vi/data/hadoop/etc/hadoop/mapred-site.xml内容为如下: 1 2 3 4 5 6 7 8 9 <? xml version = "1.0" ?> <? xml-stylesheet type = "text/xsl" href = "configuration.xsl" ?> <!--Putsite-specificpropertyoverridesinthisfile.--> < configuration > < property > < name >mapred.job.tracker</ name > < value >node1:9001</ value > </ property > </ configuration > 3)修改vi/data/hadoop/etc/hadoop/hdfs-site.xml内容为如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 <? xml version = "1.0" encoding = "UTF-8" ?> <? xml-stylesheet type = "text/xsl" href = "configuration.xsl" ?> < configuration > < property > < name >dfs.name.dir</ name > < value >/data/hadoop/data_name1,/data/hadoop/data_name2</ value > </ property > < property > < name >dfs.data.dir</ name > < value >/data/hadoop/data_1,/data/hadoop/data_2</ value > </ property > < property > < name >dfs.replication</ name > < value >2</ value > </ property > </ configuration > 4)在/data/hadoop/etc/hadoop/hadoop-env.sh文件末尾追加JAV_HOME变量: 1 echo "exportJAVA_HOME=/usr/java/jdk1.7.0_25/" >> /data/hadoop/etc/hadoop/hadoop-env .sh 5)修改vi /data/hadoop/etc/hadoop/masters文件内容为如下: 1 node1 6)修改vi/data/hadoop/etc/hadoop/slaves文件内容为如下: 1 2 node2 node3 如上配置完毕,以上的配置具体含义在这里就不做过多的解释了,搭建的时候不明白,可以查看一下相关的官方文档。 如上namenode就基本搭建完毕,接下来我们需要部署datanode,部署datanode相对简单,执行如下操作即可。 1 for i in ` seq 8889`; do scp -r /data/hadoop/ root@192.168.172.$i: /data/ ; done 自此整个集群基本搭建完毕,接下来就是启动hadoop集群了。 六、启动hadoop并测试 在启动hadoop之前,我们需要做一步非常关键的步骤,需要在namenode上执行如下命令初始化name目录和数据目录。 1 cd /data/hadoop/ ;. /bin/hadoop namenode- format 那如何算初始化成功呢,如下截图成功创建name目录即正常: 然后启动hadoop所有服务,如下命令: [root@node1hadoop]#./sbin/start-all.sh 我们还可以查看相应的端口是否启动:netstat -ntpl 访问如下地址:http://192.168.172.59:50070/ 访问地址:http://192.168.172.59:8088/ 搭建完成后,我们简单的实际操作一下,如下图: 自此hadoop基本搭建完毕。 七、部署ZooKeeper服务 在node1上配置: 下载zookeeper3.4.6版本: 1 2 wgethttp: //apache .fayea.com /zookeeper/zookeeper-3 .4.6 /zookeeper-3 .4.6. tar .gz tar -xzfzookeeper-3.4.6. tar .gz-C /export/servers/ #vim /export/servers/ zookeeper-3.4.6/conf/zoo.cfg写入如下内容: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 #Thenumberofmillisecondsofeachtick tickTime=2000 #Thenumberofticksthattheinitial #synchronizationphasecantake initLimit=10 #Thenumberofticksthatcanpassbetween #sendingarequestandgettinganacknowledgement syncLimit=5 #thedirectorywherethesnapshotisstored. dataDir= /export/zookeeper #theportatwhichtheclientswillconnect clientPort=2181 initLimit=5 syncLimit=2 dataLogDir= /export/zookeeper/logs server.1=node1:2888:3888 server.2=node2:2888:3888 server.3=node3:2888:3888 注意:zk里面的node节点名称要一一对应哦,然后创建zk数据目录和日志路径: 1 2 mkdir -p /export/zookeeper/logs echo 1> /export/zookeeper/myid 如上在node1上配置好zk后,把zk整个程序同步到另外两台node2、node3。 执行如下脚本: 1 for i in ` seq 8889`; do rsync -aP--delete /export/servers/zookeeper-3 .4.6/root@192.168.172.$i: /export/servers/zookeeper-3 .4.6/; rsync -av /export/zookeeper/ root@192.168.172.$i: /export/ ; done 然后分别修改node2、node3的myid为2和3,命令如下: 在node2上执行: 1 echo 2> /export/zookeeper/myid 在node3上执行: 1 echo 3> /export/zookeeper/myid 执行完后,分别启动三台服务器的zk服务: 1 cd /export/servers/zookeeper-3 .4.6/;. /bin/zkServer .shstart 如上配置,zookeeper配置完毕。 八、部署Hbase服务 在node1上配置: 1 2 3 4 下载软件:hbase-0.96.2-hadoop2. tar .gz,然后执行如下命令: tarxfhbase-0.96.2-hadoop2. tar .gz; mv hbase-0.96.2-hadoop2 /export/hbase 然后进入hbase配置文件目录,如下图: cd /export/hbase/conf/ vim hbase-site.xml内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 < configuration > < property > < name >hbase.tmp.dir</ name > < value >/export/hbase/tmp</ value > </ property > < property > < name >zookeeper.session.timeout</ name > < value >3600000</ value > </ property > < property > < name >hbase.zookeeper.property.tickTime</ name > < value >180000</ value > </ property > < property > < name >hbase.rootdir</ name > < value >hdfs://node1:9000/hbase</ value > </ property > < property > < name >hbase.cluster.distributed</ name > < value >true</ value > </ property > < property > < name >hbase.zookeeper.quorum</ name > < value >node1,node2,node3</ value > </ property > <!--禁止magorcompaction--> < property > < name >hbase.hregion.majorcompaction</ name > < value >0</ value > </ property > <!--禁止split--> < property > < name >hbase.hregion.max.filesize</ name > < value >536870912000</ value > </ property > <!----> < property > < name >hbase.hstore.blockingStoreFiles</ name > < value >2100000000</ value > </ property > < property > < name >hbase.regionserver.handler.count</ name > < value >100</ value > </ property > </ configuration > vim hbase-env.sh内容如下: 1 2 3 4 exportJAVA_HOME= /export/servers/jdk1 .6.0_25/ exportHBASE_OPTS= "-XX:+UseConcMarkSweepGC" exportHBASE_MANAGES_ZK= false exportHADOOP_HOME= /export/hadoop/ vim regionservers内容如下: 1 2 node2 node3 然后将node1 habse配置同步至node2、node3: 1 for i in ` seq 8889`; do rsync -av /export/hbase/ root@192.168.172.$i: /export/ ; done 最好在node1启动整个集群hbase即可: 1 cd /export/hbase/ ;shbin /start-hbase .sh 查看node1 JAVA进程信息如下: 最好查看hbase日志如下: 通过web查看hbase截图如下: NODE2状态: ----------------------------------------------------------- 你若觉得作者的文章写得不错,请奖励作者几锭银子,让作者感受到来自你满满的鼓励和继续创作的动力!我们支持原创!鼓励原创! 打赏之后,文章底部显示参与打赏者的记录,可以直接通过微信扫描打赏哟,直接按打赏根据提示操作。 自定义打赏金额,友情提示打赏金额不要超过50元哦,土豪可以随意哦,51CTO谢谢您对作者的支持!谢谢你的慷慨大方! 本文转自 wgkgood 51CTO博客,原文链接:http://blog.51cto.com/wgkgood/1899771

优秀的个人博客,低调大师

Varnish+Xcache构建高性能WEB构架初探

本文主要讲述web优化方案和缓存工具的调研及使用。根据目前的测试结果来看,采用varnish+xcache作为 apache和php缓存这种架构具有高并发、高稳定性,易扩展等优点,服务器的动态请求处理能力是之前的7倍之多。通过分析发现,目前对服务器的负载主要是在cpu使用方面,随着流量的增加瓶颈也将出现在cpu方面,而内存和IO方面都不是问题。针对这样的情况,我们就要研究怎么去降低cpu的负载,消除或降低系统的瓶颈。业务特点分析U服务采用的是LAMP(Linux Apache mysql php)架构,而服务本身的逻辑比较简单,就是根据不同的url返回特定的页面内容,而这些页面内容基本是不会变的。整个过程是由php动态完成的,不需 要和其他服务器交互。在一个请求的响应过程中,系统cpu的消耗基本都在php处理上面。我们要做的就是尽量减少php的动态处理。优化方案调研性能优化通常的方法是采用缓存策略。根据U服务的业务特点,优化主要从两个方面进行,php缓存和前端缓存,原理图如下: Php缓存调研每次HTTP请求PHP页面时,PHP代码都会被解析和翻译为操作码(PHP 引擎直接执行的原语指令--类似于汇编语言)再执行。在要求很低或可忽略的情况下,服务器看上去能立即执行这个复杂的解释过程。但是一旦处理的页面增加, 重复工作就会对服务器造成很大的负担。在某些情况下,“编译”PHP代码的时间会远远超过执行该代码所需的时间,并且会对服务器负载造成很大压力。Php缓存主要是缓存opcode,避免重复编译PHP代码。目前针对php的内存缓存策略主要有 memcache 、 eAccelerator 、 xcache 和 APC 。Memcache是一种基于网络的缓存策略,是 一个高性能的分布式的内存对象缓存系统,通过在内存里维护一个统一的巨大的hash表,它能够用来存储各种格式的数据,包括图像、视频、文件以及数据库检 索的结果等。从memcache的特点来看,更适合用于分布式数据库和分布式计算领域。光从页面缓存和加速角度来说远不及eAccelerator、 xcache和APC。eAccelerator、 xcache 和 APC 差 不多,都是自由开放源码php加速器,优化和动态内容缓存,能够大大提高php脚本性能。它使得PHP脚本在编译的状态下,对服务器的开销几乎完全消除。 其中xcache是一种比较新的加速器,是eAccelerator的替代产品,更加稳定和高效,目前shifen前端已在使用。Http前端缓存调研针对HTTP的内存缓存策略使用得比较多就是 squid 和 varnish 。Squid 是一种在Linux下使用得比较 多的优秀的代理服务器,针对web用户来说,它还是一个高性能的代理缓存服务器,它将数据缓存在内存中,同时也缓存DNS的查询结果,可以加快网络浏览的 速度,提高客户机的访问命中率。Squid是目前使用的最广的HTTP加速器之一,目前在百度使用得还很少。Varnish 是另一种高性能的开源 HTTP加速器。Varnish 的作者Poul-Henning Kamp是FreeBSD的内核开发者之一,他认为现在的计算机比起1975年已经复杂许多。在1975年时,储存媒介只有两种:内存与硬盘。但现在计算 机系统的内存除了主存外,还包括了CPU内的L1、L2,甚至有L3快取。硬盘上也有自己的快取装置,因此Squid Cache自行处理物件替换的架构不可能得知这些情况而做到最佳化,但操作系统可以得知这些情况,所以这部份的工作应该交给操作系统处理,这就是 Varnish cache设计架构。目前国内有些门户网站如新浪,腾讯正在使用。缓存工具性能对比及选择测试平台: HOST:tc-un-ct00.tc OS: Linux 2.6.9_5-4-0-2 #1 SMP CPU: Intel(R) Xeon(R) CPU 5150 @ 2.66GHz × 4 MEM: 8GB 测试数据 : jx-rcv00 20081028日18:00 – 19:00 间的数据 压力工具 : pfmtestPhp缓存工具对比测试几个主流php缓存工具性能对比测试如下: 前端缓存工具对比测试apache,squid+apache,varnish+apache 性能对比如下: 测试结论Php缓存工具测试中,xcache在响应时间,cpu占用的方面均有最佳的表现;另一方面,从前端缓存测试结果来看,varnish更适合U服务的全动态服务。Varnish及xcache的使用Varnish的使用varnish 工具的介绍及详细使用方法参见http://varnish.projects.linpro.no/Xcache的使用Xcache的介绍及详细使用方法参加http://xcache.lighttpd.net/ 【本文首发于: 百度运维空间】 http://hi.baidu.com/ops_bd/blog/item/83601d38e33ffcd17c1e71ca.html 【 关注百度技术沙龙】 本文转自百度技术51CTO博客,原文链接:http://blog.51cto.com/baidutech/748272 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Windows Docker镜像构建之Oracle客户端

新版的Windows 2016已经支持原生Docker,现在也将部分服务往Docker上迁移进行测试。 环境中有使用.net 3.5和.net 4.0以及有使用Oracle客户端,因此Web容器就需要安装Oracle客户端 Dockerfile 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 FROMmicrosoft /iis #install.NET3.5 ADDsxs /sxs RUNDism /online /enable-feature /featurename :NetFX3 /All /Source :C:\sxs /LimitAccess &&del /S /Q C:\sxs #installASP.NET4.5 RUNdism /online /enable-feature /all /featurename :NetFx4 /featurename :IIS-ApplicationInit /featurename :IIS-ASPNET45 /featurename :IIS-ASPNET /NoRestart #enablewindowseventlog RUNpowershell.exe- command Set-ItemPropertyHKLM:\SYSTEM\CurrentControlSet\Control\WMI\Autologger\EventLog-ApplicationStart1 #setIISlogfields RUN /windows/system32/inetsrv/appcmd .exe set config /section :system.applicationHost /sites /siteDefaults .logFile.logExtFileFlags: "Date,Time,ClientIP,UserName,SiteName,ServerIP,Method,UriStem,UriQuery,HttpStatus,Win32Status,TimeTaken,ServerPort,UserAgent,Referer,HttpSubStatus" /commit :apphost #installOracleClient ADDwin64_11gR2_client.zip /win64_11gR2_client .zip ADDunzip.exe /unzip .exe RUN /unzip .exe /win64_11gR2_client .zip&&del /S /Q win64_11gR2_client.zip ADDclient.rsp /client/client .rsp RUN /client/setup .exe-silent-force-noconsole-ignoreSysPrereqs-ignorePrereq-waitforcompletion-responseFileC:\client\client.rsp&&del /S /Q client #RUNcaclsc:\app/T/E/C/Gusers:r #deploywebapp #COPYpublish/inetpub/wwwroot/html #setentrypointscript ADDSetHostsAndStartMonitoring.cmd\SetHostsAndStartMonitoring.cmd ENTRYPOINT[ "C:\\SetHostsAndStartMonitoring.cmd" ] #declarevolumes VOLUME[ "c:/inetpub/logs/LogFiles" , "C:/inetpub/wwwroot/html" ] Dockerfile涉及的文件内容有 sxs #在Windows Server 2016 安装包的\sources\sxs\目录 unzip.exe #Oracle Client客户端安装包的client\install目录下 win64_11gR2_client.zip #自行到官方下载 client.rsp #Oracle客户端安装响应文件 SetHostsAndStartMonitoring.cmd client.rsp 1 2 3 4 5 6 7 8 9 10 11 12 13 oracle. install .responseFileVersion=http: //www .oracle.com /2007/install/rspfmt_clientinstall_response_schema_v11_2_0 ORACLE_HOSTNAME= UNIX_GROUP_NAME= INVENTORY_LOCATION=C:\ProgramFiles\Oracle\Inventory SELECTED_LANGUAGES=zh_CN,en ORACLE_HOME=C:\app\Administrator\product\11.2.0\client_1 ORACLE_BASE=C:\app\Administrator oracle. install .client.installType=Runtime oracle. install .client.customComponents= "oracle.precomp:11.2.0.1.0" , "oracle.ons:11.2.0.0.0" , "oracle.oraolap.mgmt:11.2.0.1.0" , "oracle.rdbms.scheduler:11.2.0.1.0" oracle. install .client.customComponents= oracle. install .client.oramtsPortNumber=49152 oracle. install .client.schedulerAgentHostName= oracle. install .client.schedulerAgentPortNumber= SetHostsAndStartMonitoring.cmd 1 2 3 4 5 6 echo %HOST%>> /Windows/System32/drivers/etc/hosts /windows/system32/inetsrv/appcmd .exedeletesite "DefaultWebSite/" /windows/system32/inetsrv/appcmd .exeaddapppool /name : "%site_name%" /managedRuntimeVersion : "v%site_version%.0" /managedPipelineMode :Classic-queueLength:65535 /windows/system32/inetsrv/appcmd .exeaddsite /name : "%site_name%" /physicalPath : "c:\inetpub\wwwroot\html" -serverAutoStart: true /bindings :http: // *:80 /windows/system32/inetsrv/appcmd .exe set site /site .name: "%site_name%" /[path= '/' ].applicationPool: "%site_name%" c:\ServiceMonitor.exew3svc 文件中涉及到三个环境变量 HOST #因为windows Docker无法通过--add-host指host这里通过这种方法指host site_name #站点域名 site_version #.net版本 Docker启动示例: 1 dockerrun-d-p80-esite_name=fengwan.blog.51cto.com-esite_version=4-ehost= "192.168.2.2db.51cto.com" - v c: /webroot/fengwan :c: /inetpub/wwwroot/html - v c: /logs :c: /inetpub/logs/logFiles image_name 本文转自 rong341233 51CTO博客,原文链接:http://blog.51cto.com/fengwan/1943280


优秀的个人博客,低调大师

如何利用docker 构建golang线上部署环境

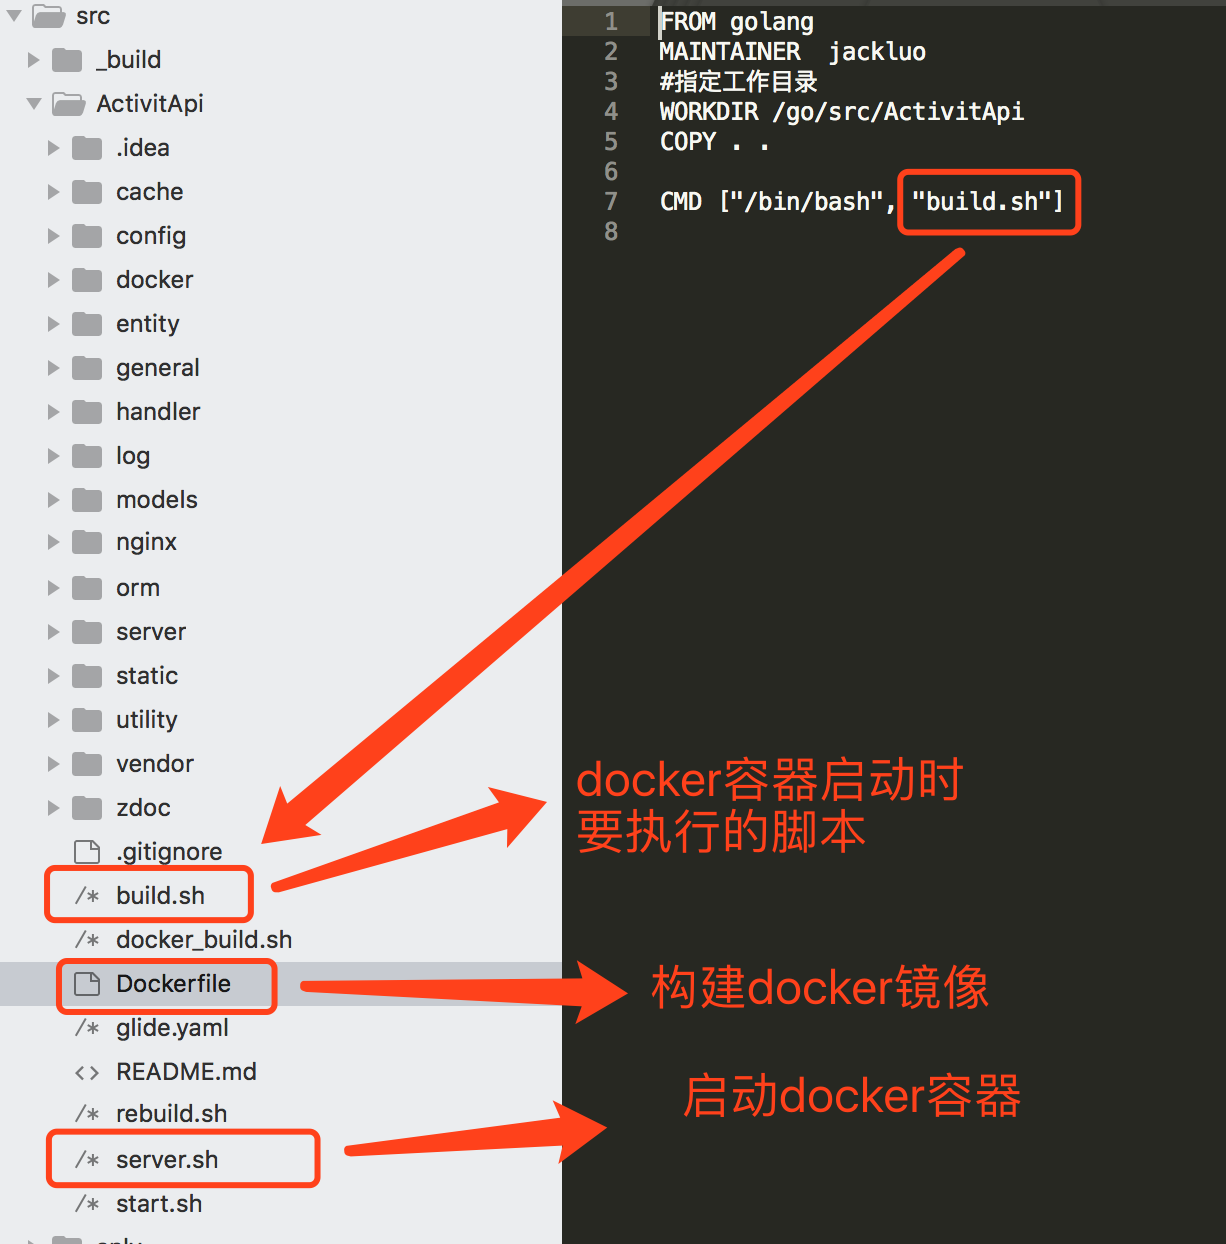
公司最近开发了一个项目是用golang 写的,现在要部署到线上环境去,又不想在服务器上装单独的golang,决定用docker 封装下,直接打到镜像里面,然后就直接在hub.docker.com上面搜了下golang的镜像,直接就docker pull golang 最新的是1.9的版本 然后参考官方的文档弄了下Dockerfile大概是这样: FROM golang MAINTAINER jackluo #指定工作目录 WORKDIR /go/src/ActivitApi COPY . . CMD ["/bin/bash", "build.sh"] build.sh里面的代码是这样,大概就是进入目录,编译golang ,最后运行编译好的server 文件 #!/usr/bin/env bash cd /go/src/ActivitApi/server && go build && ./server 其实可以直接运行编译好的.server 文件,因为每次启动的时候,它才去编译,可能启个服务,需要几秒钟的时间,我们写的大概编译再启动需要10秒左右的时间 最后启用docker #!/usr/bin/env bash docker stop apihdtest docker rm apihdtest docker run -d --name apihdtest \ -p 17071:17071 \ --link mysql:mysql.io \ --link redis:redis.io \ -v $(pwd):/go/src/ActivitApi \ activityapi #docker exec -it apihdtest /bin/bash /go/src/ActivitApi/build.sh 然后这个就启起来了 最后,我们看下完整的截图吧 仅参考.

优秀的个人博客,低调大师

Apache Spark探秘:利用Intellij IDEA构建开发环境

1)准备工作 1) 安装JDK 6或者JDK 7 或者JDK8 mac 的 参看http://docs.oracle.com/javase/8/docs/technotes/guides/install/mac_jdk.html 2) 安装scala 2.10.x (注意版本) 参看 http://www.cnblogs.com/xd502djj/p/6546514.html 2)下载Intellij IDEA最新版(本文以IntelliJ IDEA Community Edition 13.1.1为例说明,不同版本,界面布局可能不同):http://www.jetbrains.com/idea/download/ 3)将下载的Intellij IDEA解压后,安装scala插件,流程如下: 依次选择“Configure”–> “Plugins”–> “Browse repositories”,输入scala,然后安装即可 (2)搭建Spark源码阅读环境(需要联网) 一种方法是直接依次选择“import project”–> 选择spark所在目录 –> “SBT”,之后intellij会自动识别SBT文件,并下载依赖的外部jar包,整个流程用时非常长,取决于机器的网络环境(不建议在windows下操作,可能遇到各种问题),一般需花费几十分钟到几个小时。注意,下载过程会用到git,因此应该事先安装了git。 第二种方法是首先在linux操作系统上生成intellij项目文件,然后在intellij IDEA中直接通过“Open Project”打开项目即可。在linux上生成intellij项目文件的方法(需要安装git,不需要安装scala,sbt会自动下载)是:在spark源代码根目录下,输入sbt/sbt gen-idea 注:如果你在windows下阅读源代码,建议先在linux下生成项目文件,然后导入到windows中的intellij IDEA中。 (3)搭建Spark开发环境 在intellij IDEA中创建scala project,并依次选择“File”–> “project structure” –> “Libraries”,选择“+”,将spark-hadoop 对应的包导入,比如导入spark-assembly_2.10-0.9.0-incubating-hadoop2.2.0.jar(只需导入该jar包,其他不需要),如果IDE没有识别scala 库,则需要以同样方式将scala库导入。之后开发scala程序即可: 编写完scala程序后,可以直接在intellij中,以local模式运行,方法如下: 点击“Run”–> “Run Configurations”,在弹出的框中对应栏中填写“local”,表示将该参数传递给main函数,如下图所示,之后点击“Run”–> “Run”运行程序即可。 如果想把程序打成jar包,通过命令行的形式运行在spark 集群中,可以按照以下步骤操作: 依次选择“File”–> “Project Structure” –> “Artifact”,选择“+”–> “Jar” –> “From Modules with dependencies”,选择main函数,并在弹出框中选择输出jar位置,并选择“OK”。 最后依次选择“Build”–> “Build Artifact”编译生成jar包。具体如下图所示。 原创文章,转载请注明:转载自董的博客 本文链接地址:http://dongxicheng.org/framework-on-yarn/apache-spark-intellij-idea/ 作者:Dong,作者介绍:http://dongxicheng.org/about/ 本博客的文章集合:http://dongxicheng.org/recommend/ 本文转自茄子_2008博客园博客,原文链接:http://www.cnblogs.com/xd502djj/p/6551293.html,如需转载请自行联系原作者。

优秀的个人博客,低调大师

《虚拟数据中心构建指南》——2.1 VMware概述

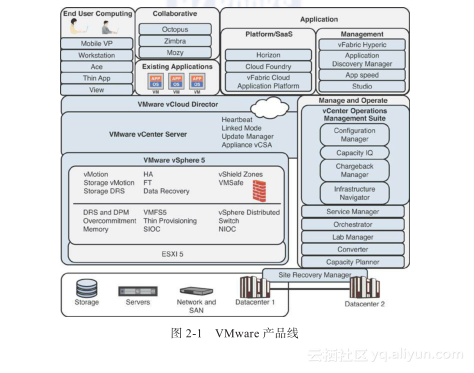
在深入研究VMware新的vSphere 5产品的软件组件和架构之前,我们先来看看这家公司及其虚拟化产品的演变过程。 2.1 VMware概述 VMware由如下几位知名人士于1998年创立:Diane Greene,总裁兼总经理(1998~2008年)Mendel Rosenblum博士,首席科学家(1998~2008年)Scott Devine,主任工程师(1998年起)Edward Wang博士,主任工程师(1998~2009年)Edouard Bugnion,首席架构师(1998~2004年) 2004年,EMC以6.25亿美元的价格收购了VMware。在收购时,该公司的销售额已经达到约1亿美元,拥有370名员工。2011年,销售额接近37亿美元,到2012年,公司的雇员已经超过9000人。 Pat Gelsinger于2012年9月就任VMware的CEO(此前,Paul Maritz从2008年7月起担任这一职务)。 2.1.1 VMware产品线 在过去几年,VMware的产品线有了很大的扩展。早年,该公司主要提供虚拟化管理器,而现在的重心已经扩展到云计算服务、管理工具、协作工具和应用程序。本书的焦点是vSphere 5的数据中心虚拟化平台,并将详细介绍作为数据中心管理基础的组件,书中提及的其他组件仅是为了提供信息。图2-1提供了VMware目前产品的一个概览。 VMware的策略明显是面向云计算解决方案,包括了图2-2中所示的元素。 2.1.2 VMware的发展 VMware ESX的第一个版本于2001年发布,vSphere 5是其第5代产品。每个新版本带来的革新和技术跨越都值得回顾。图2-3提供了这些革新的时间轴。 第1代(1998~2003年)ESX1是x86平台的第一个虚拟化管理器,提供本地存储。此时还没有集中化的能力,服务器必须逐个管理。这一版本适用于低负载机器。这个虚拟化管理器用于测试和开发环境,没有直接的竞争对手。 可用版本:VMware ESX 1.x 第2代(2003~2006年) vMotion是第一种能够动态移动虚拟机器的技术,Virtual Center能够集中管理多个物理服务器。虚拟化不再限于测试,也可以用于生产环境。VMware在全球有超过20 000个客户,在这个市场上完全处于统治地位。竞争对手很弱,但是出现了有趣的开源解决方案,如KVM和Xem。2004年EMC收购了VMware。技术跨越:vMotionVirtual Center可用版本:VMware ESX 2.x和Virtual Center 1.x 3.第3代:Virtual Infrastructure 3(2006~2009年) 虚拟化管理器不再相互独立。它们将资源聚合成统一的实体,提供很高的服务水平,具备高可用性和负载分配能力,由Framework VCB进行备份。VMware在全球大部分大企业中成为必不可少的资产。Citrix于2007年以5亿美元的价格收购Xen加入了竞争。Microsoft推出了Hyper-V,进入这一领域。 技术跨越:VMware HA(High Availability,高可用性)VMware DRS(Distributed Resource Scheduling ,分布式资源调度)VCB(VMware Consolidated Backup,VMware整合备份)Storage vMotion(从第3.5版开始)可用版本:Virtual Infrastructure 3(VMware ESX 3.x、Virtual Center 2.x) 4.第4代:vSphere 4(2009~2011年)vSphere 4扩展存储和网络功能并提供更多的可用性和安全功能。尽管VMware在这一市场处于统治地位,但是Citrix Xen Server,尤其是Microsoft推出的Hyper-V R2,都加剧了竞争。2009年是重要的一年,生产环境中的VM在数量上超过了物理服务器。技术跨越:VMware FT(Fault Tolerance ,容错)vNetwork分布式交换机(vNetwork Distributed Switch,)各种API变更数据块跟踪(Changed Block Tracking)数据恢复(Data Recovery)可用版本:vSphere 4(VMware ESX4/ESXi4、vCenter Server 4)5.第5代:vSphere 5(2011年以后)现在,vSphere 5自身的定位是为云计算优化的数据中心虚拟化平台。存储级的多项改进以及与最重要的软件和硬件制造商之间的稳固关系,使得VMware成为最能满足部署关键应用程序重要需求的解决方案。许可证策略也进行了修改,根据VM中配置的处理器和内存颁发许可证。放弃服务控制台得到更轻量级的ESXi。许多新产品补充进来,如vCenter Operations Management Suite、SRM 5、vShield 5和vCloud Director 1.5。技术跨越:Storage DRS新的存储APIVMFS-5(Virtual Machine File system 5,虚拟机文件系统5)vStorage AppliancevSphere Replication for SRM 5可用版本:vSphere 5(VMware ESXi 5、 vCenter Server 5)表2-1展示了最后三个版本的对比。

优秀的个人博客,低调大师

《虚拟数据中心构建指南》——3.3 存储网络

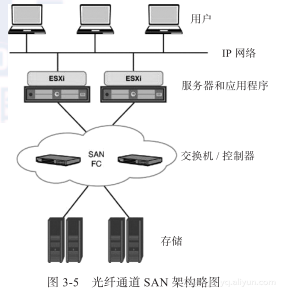
3.3 存储网络 前一节已经作过解释,可能使用的网络有两种:IP以太网(NAS或者iSCSI模式)和FC网络(FC或者FCoE)。 3.3.1 IP存储网络 这类网络原来的设计不是用于提供高性能存储的,而是在网络不同要素之间传递信息。因此,它不适合于需要高性能的应用,例如数据库应用。IP网络处于OSI第3层,所以它可以路由,适合于长距离网络互联。FC网络位于第2层,因此无法路由。目前,IP网络的吞吐量达到10GbE,未来将达到40GbE和100GbE。 IP网络的问题在于因为如下因素而导致“丢包”:物理线路上的信号衰减路由问题缓冲区溢出(接收器无法处理输入流)TCP/IP协议允许丢包重传(如果发送数据没有得到接收方的确认),但是这对性能有显著影响。 另一个问题是,在一个IP包中只能传输有限的数据量,称作最大传输单元(Meximum Tranomission Unit,MTU)。这个数量(有效载荷,payload)对于以太网数据包为1500个字节。超过1500个字节的数据在发送之前必须分段。每当网卡接收到一个包,就向主机发送一个中断以确定接收。这增加了主机的负载和CPU周期(称作开销,overhead)。随着发送包数增加,路由变得更加复杂和费时。 注意:在整合的虚拟环境中,需要考虑这种开销。它不应该恶化主机服务器的性能,主机服务器的处理能力应该专用于应用。 为了减少这种数据帧碎片,创建了超长帧(jumbo frame)。这种帧允许传递大于1500个字节的包(MTU最大为9000个字节)。超长帧在效率改进中起到了很大的作用,一些研究显示,它将CPU开销减少了50%。MTU必须在整个传输链条中激活和兼容,包括物理交换机、网卡、电缆等。 注意:9000字节的超长帧替换了6个标准的1500字节以太网包,主机的CPU周期消耗减少了5倍。 不过,需要当心的是,如果出现问题,源和目标之间的MTU越大,重传的包也就越大,这会降低性能,增加延迟。为了最大限度地利用超长帧,网络必须稳定并且很好地实现。 IP存储网络的优点是比SAN FC设备便宜,以太网络已经部署,所以在某些情况下,需要的实现工作较少,这种网络更容易使用。而且,IT团队对这种技术已经有多年的使用经验。 1. VMware中的iSCSI 在VMware环境中,iSCSI协议在2006年开始才被支持。如果以最优化的方式部署,这种协议能提供非常好的性能。IP网络由存储团队之外的团队管理。 优点:iSCSI已经得到许多活动部门的采用,因为它使用了公司的TCP/IP网络进行块模式访问,不需要投资FC设备。因此,它更容易安装,从而对于某些环境来说是理想的选择。使用传统的以太网络,意味着覆盖更长的距离,而不需要特殊的转换设备(例如FC-IP转换器),例如,用于复制。实施这种技术所需的技能是网络技能,而不是高级的存储技能。 缺点:测试证明,iSCSI协议是消耗CPU资源最多的协议。因此,监控CPU的使用很重要,应该在网络部署时加以考虑。 我们建议如下的最佳实践:只在架构能够启用超长帧(MTU 9000),从而最大限度地利用该协议的时候,使用iSCSI才有价值,这种情况能够提供出色的性能。启用超长帧必须在传输链的两端进行。 iSCSI HBA卡在使用10GB连接时必不可少,应该尽可能实现链路聚合,以提供高性能和冗余,以防故障。建议从物理上分隔iSCSI存储网络和标准IP网络。如果不可能,应该使用虚拟局域网(Virtual Local-Area Network,VLAN)隔离传输流。 使用具有TCP减负引擎(TCP Offload Engine ,TOE)的网卡,从主机接管某些与iSCSI层相关的指令,减少开销。 实施服务质量(QoS),为传输流设置优先级。在vSphere中,可以使用存储I/O控制(Storage I/O Control,SIOC)功能实现。 网络丢包是获得好的iSCSI网络性能所面临的主要挑战之一。丢包可能是因为错误的网络配置或者错误的线路质量引起的(例如,在千兆链路上使用5类线而没有使用6类线)。 2. VMware中的NFS 网络文件系统(NFS)是NAS使用的协议,从2006年起得到ESX的支持。它通过网络提供文件系统级的存储共享。VMware支持NFS over TCP第3版。和某些说法相反,测试显示在正确实现的情况下,这个协议的性能很好。因此,某些条件下在虚拟环境中可以使用这种协议。超长帧(MTU 9000)的启用允许传输8192(8KB)NFS数据块,很适合于这个协议。默认情况下,ESXi主机可以安装8个NFS,并且可以扩展到256个NFS。如果将最大NFS安装数增加到超过默认的8个,确保一定要增加Net.TcpipHeapSize和Net. TcpipHeapMax。这些值在高级配置中,控制堆存储的数量(以兆字节为单位),这些存储分配用于管理VMkernel TCP/IP网络连通性。 ESXi 5.0:将Net.TcpipHeapSize设置为32ESXi 5.0:将Net.TcpipHeapMax设置为128 注意:默认情况下,精简配置是NFS数据存储上创建的虚拟磁盘所用的格式。 优点:和iSCSI一样,NFS使用标准的TCP/IP网络,非常易于实施,不需要专用的存储架构。这是最便宜的解决方案,也不需要特殊的存储技能。NAS往往提供重复数据消除功能,这能减少存储空间需要量。 缺点:在这里描述的所有解决方案中,NFS的性能最低,但是接近于iSCSI。它所利用的主机服务器CPU比FC协议多,但是少于iSCSI软件。所以可以想象,它可以用于以下生产环境:VM要求第2层和第3层应用的平均性能。 注意:在vSphere 5中,这个协议不支持NFS启动或者RDM的使用。 我们建议如下的最佳实践:每个NFS卷使用100~400个vmdk文件。对于最大尺寸为64TB的NFS卷来说,最大可能逻辑单元号(Logic Unit Number,LUN)为256。(制造商可能提供文件系统支持限额的信息,通常是16TB)使用专用交换机或者VLAN分隔专门的存储网络和以太网络。 启用流控制使用具有大的端口缓存的专用交换机,启用超长帧启用生成树协议使用10Gb网络(强烈推荐)使用全双工TOE卡降低ESXi主机服务器负载为NFS和iSCSI流量使用专用的交换机或者VLAN,将存储流量与其他网络流量分离 3.3.2 光纤通道网络 从根本上说,光纤通道网络是专用于存储的,提供对块模式数据的直接无丢失访问。这种网络是为高性能存储设计的,通过缓冲区信用阀值(buffer credit,一种用于调整SAN数据流的缓存)等高级机制得到很低的延迟。FC协议通过专用的光纤通道网络封装SCSI包。速度为1Gbps、2 Gbps、4 Gbps、8 Gbps或者16Gbps。FC包携带的有效载荷为2112个字节。这种存储网络通过光纤通道交换机在服务器和存储设备之间传送数据。图3-5中展示的SAN实现了存储整合,提供了高伸缩性。 1.VMware中的SAN FC 光纤通道(Fibre Channel,FC)是VMware支持的最高级协议。这也是它成为生产环境中最常用协议的原因。 优点:目前为止,FC似乎是性能最高的协议,和NFS和iSCSI相比,它所使用的主机服务器CPU资源也最少。该协议能实现很高的性能,而且因为这种技术是无丢失的,因此网络是可预测的。这种协议适用于所有流行的应用,对于数据库或者企业资源计划(Enterprise Resource Planning,ERP)等I/O密集型应用很理想。 缺点:FC是最昂贵的解决方案,因为它需要建设特殊的存储架构,并且需要投资HBA卡、FC交换机、小封装热插拔收发器(Small form-factor pluggable transceiver ,SFP)和电缆。而且,实现这种解决方案更为复杂,需要专门的存储技能。培训是必需的,还要学习管理SAN的新术语,例如LUN masking、Zoning WWN和Fabric。 我们建议如下的最佳实践: 为了减少损坏的链路,在每个服务器上插入多张HBA卡,并使用多存储阵列访问路径。 使用负载均衡软件(如ESXi Round Robin或者EMC PowerPath/Virtual Edition),优化服务器和存储之间的路径管理。使用符合ALUA,与VMware的VAAI API兼容的存储阵列。在群集所有成员之间使用相同数量的路径,群集中的所有主机服务器应该看到相同的卷。服从ESXi群集成员和存储之间的连接兼容性矩阵。 注意:我们曾经遇到一些管理员,他们将服务器直接连接到控制器存储阵列,以节约交换机的成本!这样的做法失去了FC SAN提供的冗余性,不建议这么做。 在所有连接中使用相同速度的交换机,避免在SAN中造成竞争点。 示例:某公司有具备FC 8Gb端口的刀片服务器。SAN核心交换机速度为4Gbps。在核心交换机上出现一个明显的竞争点,对所有连接的元素都有影响。正确的做法是强制新设备采用4Gbps的速度。 检查FC交换机和HBA的固件级别,遵循存储阵列制造商的使用说明。 2.VMware中的SAN FcoE 以太网光纤通道(FCoE)代表着几个不同领域的融合:以太网络(TCP/IP)、存储用的SAN(SAN FC)和群集所用的InfiniBand(IPC)。这意味着,现在可以在这些不同的协议上使用一种类型的接口卡、交换机电缆和管理接口。FC帧被封装在以太帧中,提供了比TCP/IP更有效的传输。 FCoE帧携带2500个字节的有效载荷。目标是实现和FC类似的以太网无丢失性能。这通过加强物理网络可靠性和一些改进(尤其是关于QoS的改进)来实现。FCoE需要专用的设备,也需要启用超长帧(2180字节)。通过流控机制消除了拥堵。 因为FCoE在2012年中还相对不常见,我们对这种协议在VMware环境中的优缺点还缺乏实际的经验。 3.3.3 哪个协议最适合你 在我们的经验中,SAN FC是虚拟生产环境中管理员首选的协议管理器。据估计,有70%的客户在VMware生产环境中使用SAN FC。然而,具有超长帧的10GbE的出现,使得SAN IP基础架构易于实现,同时保持着能够满足某些情况的性能水平。除了技术标准之外,最好的选择还要根据现有架构和预算来决定。 总结如下:SAN FC应该是需要高性能(第1层和第2层)的应用(如数据库应用)首选的方案。 iSCSC可以用于2层应用。有些公司在iSCSI中使用IP进行远程数据复制,这很有效且能控制成本。NAS可以用于网络服务,例如基础架构VM—域控制器、DNS、文件或者非关键应用服务器(第3层应用),也可以用于ISO映像、模板和VM备份存储。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册