首页 文章 精选 留言 我的

精选列表

搜索[插件解析],共10000篇文章
优秀的个人博客,低调大师

基于OGG Datahub插件将Oracle数据同步上云

本文用到的 阿里云数加-大数据计算服务MaxCompute产品地址:https://www.aliyun.com/product/odps 一、背景介绍 随着数据规模的不断扩大,传统的RDBMS难以满足OLAP的需求,本文将介绍如何将Oracle的数据实时同步到阿里云的大数据处理平台当中,并利用大数据工具对数据进行分析。 OGG(Oracle GoldenGate)是一个基于日志的结构化数据备份工具,一般用于Oracle数据库之间的主从备份以及Oracle数据库到其他数据库(DB2, MySQL等)的同步。下面是Oracle官方提供的一个OGG的整体架构图,从图中可以看出OGG的部署分为源端和目标端两部分组成,主要有Manager,Extract,Pump,Collector,Replicat这么一些组件。 Manager:在源端和目标端都

优秀的个人博客,低调大师

React Hooks源码深度解析

作者:京东零售 郑炳懿 前言 React Hooks是React16.8 引入的一个新特性,它允许函数组件中使用state和其他 React 特性,而不必使用类组件。Hooks是一个非常重要的概念,因为它们提供了更简单、更易于理解的React开发体验。 React Hooks的核心源码主要包括两个部分:React内部的Hook管理器和一系列预置的Hook函数。 首先,让我们看一下React内部的Hook管理器。这个管理器是React内部的一个重要机制,它负责管理组件中的所有Hook,并确保它们在组件渲染期间以正确的顺序调用。 内部Hook管理器 示例: const Hook = { queue: [], current: null, }; function useState(initialState) { const state = Hook.current[Hook.queue.length]; if (!state) { Hook.queue.push({ state: typeof initialState === 'function' ? initialState() : initialState, setState(value) { this.state = value; render(); }, }); } return [state.state, state.setState.bind(state)]; } function useHook(callback) { Hook.current = { __proto__: Hook.current, }; try { callback(); } finally { Hook.current = Hook.current.__proto__; } } function render() { useHook(() => { const [count, setCount] = useState(0); console.log('count:', count); setTimeout(() => { setCount(count + 1); }, 1000); }); } render(); 在这个示例中,Hook对象有两个重要属性:queue和current。queue存储组件中所有Hook的状态和更新函数,current存储当前正在渲染的组件的Hook链表。useState和useHook函数则分别负责创建新的Hook状态和在组件中使用Hook。 预置 Hook 函数 useState Hook 以下是useState Hook的实现示例: function useState(initialState) { const hook = updateWorkInProgressHook(); if (!hook.memoizedState) { hook.memoizedState = [ typeof initialState === 'function' ? initialState() : initialState, action => { hook.queue.pending = true; hook.queue.dispatch = action; scheduleWork(); }, ]; } return hook.memoizedState; } 上述代码实现了useState Hook,其主要作用是返回一个state和更新函数的数组,state 初始值为initialState。 在这个实现中,updateWorkInProgressHook()函数用来获取当前正在执行的函数组件的 fiber 对象并判断是否存在对应的hook。它的实现如下: function updateWorkInProgressHook() { const fiber = getWorkInProgressFiber(); let hook = fiber.memoizedState; if (hook) { fiber.memoizedState = hook.next; hook.next = null; } else { hook = { memoizedState: null, queue: { pending: null, dispatch: null, last: null, }, next: null, }; } workInProgressHook = hook; return hook; } getWorkInProgressFiber()函数用来获取当前正在执行的函数组件的fiber对象,workInProgressHook则用来存储当前正在执行的hook对象。在函数组件中,每一个useState调用都会创建一个新的 hook 对象,并将其添加到fiber对象的hooks链表中。这个hooks链表是通过fiber对象的memoizedState属性来维护的。 我们还需要注意到在useState Hook的实现中,每一个hook对象都包含了一个queue对象,用来存储待更新的状态以及更新函数。scheduleWork()函数则用来通知React调度器有任务需要执行。 在React的源码中,useState函数实际上是一个叫做useStateImpl的内部函数。 下面是useStateImpl的源码: function useStateImpl<S>(initialState: (() => S) | S): [S, Dispatch<SetStateAction<S>>] { const dispatcher = resolveDispatcher(); return dispatcher.useState(initialState); } 可以看到,useStateImpl函数的作用就是获取当前的dispatcher并调用它的useState方法,返回一个数组,第一个元素是状态的值,第二个元素是一个dispatch函数,用来更新状态。这里的resolveDispatcher函数用来获取当前的dispatcher,其实现如下: function resolveDispatcher(): Dispatcher { const dispatcher = currentlyRenderingFiber?.dispatcher; if (dispatcher === undefined) { throw new Error('Hooks can only be called inside the body of a function component. (https://fb.me/react-invalid-hook-call)'); } return dispatcher; } resolveDispatcher函数首先尝试获取当前正在渲染的fiber对象的dispatcher属性,如果获取不到则说 明当前不在组件的渲染过程中,就会抛出一个错误。 最后,我们来看一下useState方法在具体的dispatcher实现中是如何实现的。我们以useReducer的 dispatcher为例,它的实现如下: export function useReducer<S, A>( reducer: (prevState: S, action: A) => S, initialState: S, initialAction?: A, ): [S, Dispatch<A>] { const [dispatch, currentState] = updateReducer<S, A>( reducer, // $FlowFixMe: Flow doesn't like mixed types [initialState, initialAction], // $FlowFixMe: Flow doesn't like mixed types reducer === basicStateReducer ? basicStateReducer : updateStateReducer, ); return [currentState, dispatch]; } 可以看到,useReducer方法实际上是调用了一个叫做updateReducer的函数,返回了一个包含当前状态和dispatch函数的数组。updateReducer的实现比较复杂,涉及到了很多细节,这里不再展开介绍。 useEffect Hook useEffect是React中常用的一个Hook函数,用于在组件中执行副作用操作,例如访问远程数据、添加/移除事件监听器、手动操作DOM等等。useEffect的核心功能是在组件的渲染过程结束之后异步执行回调函数,它的实现方式涉及到 React 中的异步渲染机制。 以下是useEffect Hook的实现示例: function useEffect(callback, dependencies) { // 通过调用 useLayoutEffect 或者 useEffect 方法来获取当前的渲染批次 const batch = useContext(BatchContext); // 根据当前的渲染批次判断是否需要执行回调函数 if (shouldFireEffect(batch, dependencies)) { callback(); } // 在组件被卸载时清除当前 effect 的状态信息 return () => clearEffect(batch); } 在这个示例中,useEffect接收两个参数:回调函数和依赖项数组。当依赖项数组中的任何一个值发生变化时, React会在下一次渲染时重新执行useEffect中传入的回调函数。 useEffect函数的实现方式主要依赖于React中的异步渲染机制。当一个组件需要重新渲染时,React会将所有的state更新操作加入到一个队列中,在当前渲染批次结束之后再异步执行这些更新操作,从而避免在同一个渲染批次中连续执行多次更新操作。 在useEffect函数中,我们通过调用useContext(BatchContext)方法来获取当前的渲染批次,并根据shouldFireEffect方法判断是否需要执行回调函数。在回调函数执行完毕后,我们需要通过clearEffect方法来清除当前effect的状态信息,避免对后续的渲染批次产生影响。 总结 总的来说,React Hooks的实现原理并不复杂,它主要依赖于React内部的fiber数据结构和调度系统,通过这些机制来实现对组件状态的管理和更新。Hooks能够让我们在函数组件中使用状态和其他React特性,使得函数组件的功能可以和类组件媲美。 除了useState、useEffect等hook,React还有useContext等常用的Hook。它们的实现原理也基本相似,都是利用fiber架构来实现状态管理和生命周期钩子等功能。 以上是hook简单实现示例,它们并不是React中实际使用的代码,但是可以帮助我们更好地理解hook的核心实现方式。

优秀的个人博客,低调大师

Function源码解析与实践

作者:陈昌浩 1 导读 if…else…在代码中经常使用,听说可以通过 Java 8 的 Function 接口来消灭 if…else…!Function 接口是什么?如果通过 Function 接口接口消灭 if…else…呢?让我们一起来探索一下吧。 2 Function 接口 Function 接口就是一个有且仅有一个抽象方法,但是可以有多个非抽象方法的接口,Function 接口可以被隐式转换为 lambda 表达式。可以通过 FunctionalInterface 注解来校验 Function 接口的正确性。Java 8 允许在接口中加入具体方法。接口中的具体方法有两种,default 方法和 static 方法。 @FunctionalInterfaceinterface TestFunctionService{ void addHttp(String url);} 那么就可以使用 Lambda 表达式来表示该接口的一个实现。 TestFunctionService testFunctionService = url -> System.out.println("http:" + url); 2.1 FunctionalInterface 2.1.1 源码 @Documented@Retention(RetentionPolicy.RUNTIME)@Target(ElementType.TYPE)public @interface FunctionalInterface {} 2.1.2 说明 上图是 FunctionalInterface 的注解说明。通过上面的注解说明,可以知道 FunctionalInterface 是一个注解,用来说明一个接口是函数式接口。 函数式接口只有一个抽象方法。 可以有默认方法,因为默认方法有一个实现,所以不是抽象的。函数接口的实例可以用 lambda 表达式、方法引用或构造函数引用创建。 FunctionalInterface 会校验接口是否满足函数式接口: 类型必须是接口类型,不能是注释类型、枚举或类。 只能有一个抽象方法。 可以有多个默认方法和静态方法。 可以显示覆盖 java.lang.Object 中的抽象方法。 编译器会将满足函数式接口定义的任何接口视为函数式接口,而不管该接口声明中是否使用 FunctionalInterface 注解。 3 Function 接口主要分类 Function 接口主要分类: Function:Function 函数的表现形式为接收一个参数,并返回一个值。 Supplier:Supplier 的表现形式为不接受参数、只返回数据。 Consumer:Consumer 接收一个参数,没有返回值。 Runnable:Runnable 的表现形式为即没有参数也没有返回值。 3.1 Function Function 函数的表现形式为接收一个参数,并返回一个值。 3.1.1 源码 @FunctionalInterfacepublic interface Function<T, R> { R apply(T t); default <V> Function<V, R> compose(Function<? super V, ? extends T> before) { Objects.requireNonNull(before); return (V v) -> apply(before.apply(v)); } default <V> Function<T, V> andThen(Function<? super R, ? extends V> after) { Objects.requireNonNull(after); return (T t) -> after.apply(apply(t)); } static <T> Function<T, T> identity() { return t -> t; }} 3.1.2 方法说明 apply:抽象方法。将此函数应用于给定的参数。参数 t 通过具体的实现返回 R。 compose:default 方法。返回一个复合函数,首先执行 fefore 函数应用于输入,然后将该函数应用于结果。如果任意一个函数的求值引发异常,则将其传递给组合函数的调用者。 andThen:default 方法。返回一个复合函数,该复合函数首先对其应用此函数它的输入,然后对结果应用 after 函数。如果任意一个函数的求值引发异常,则将其传递给组合函数的调用者。 identity:static 方法。返回一个始终返回其输入参数的函数。 3.1.3 方法举例 1)apply 测试代码: public String upString(String str){ Function<String, String> function1 = s -> s.toUpperCase(); return function1.apply(str);} public static void main(String[] args) { System.out.println(upString("hello!")); } 通过 apply 调用具体的实现。执行结果: 2)compose 测试代码: public static void main(String[] args) { Function<String, String> function1 = s -> s.toUpperCase(); Function<String, String> function2 = s -> "my name is "+s; String result = function1.compose(function2).apply("zhangSan"); System.out.println(result);} 执行结果 如结果所示:compose 先执行 function2 后执行 function1。 3)andThen 测试代码: public static void main(String[] args) { Function<String, String> function1 = s -> s.toUpperCase(); Function<String, String> function2 = s -> "my name is "+s; String result = function1.andThen(function2).apply("zhangSan"); System.out.println(result);} 执行结果: 如结果所示: andThen 先执行 function1 后执行 function2。 identity 测试代码: public static void main(String[] args) { Stream<String> stream = Stream.of("order", "good", "lab", "warehouse"); Map<String, Integer> map = stream.collect(Collectors.toMap(Function.identity(), String::length)); System.out.println(map);} 执行结果: 3.2 Supplier Supplier 的表现形式为不接受参数、只返回数据。 3.2.1 源码 @FunctionalInterfacepublic interface Supplier<T> { /** * Gets a result. * * @return a result */ T get();} 3.2.2 方法说明 get:抽象方法。通过实现返回 T。 3.2.3 方法举例 public class SupplierTest { SupplierTest(){ System.out.println(Math.random()); System.out.println(this.toString()); }} public static void main(String[] args) { Supplier<SupplierTest> sup = SupplierTest::new; System.out.println("调用一次"); sup.get(); System.out.println("调用二次"); sup.get();} 执行结果: 如结果所示:Supplier 建立时并没有创建新类,每次调用 get 返回的值不是同一个。 3.3 Consumer Consumer 接收一个参数,没有返回值。 3.3.1 源码 @FunctionalInterfacepublic interface Consumer<T> { void accept(T t); default Consumer<T> andThen(Consumer<? super T> after) { Objects.requireNonNull(after); return (T t) -> { accept(t); after.accept(t); }; }} 3.3.2 方法说明 accept:对给定参数 T 执行一些操作。 andThen:按顺序执行 Consumer -> after ,如果执行操作引发异常,该异常被传递给调用者。 3.3.3 方法举例 public static void main(String[] args) { Consumer<String> consumer = s -> System.out.println("consumer_"+s); Consumer<String> after = s -> System.out.println("after_"+s); consumer.accept("isReady"); System.out.println("========================"); consumer.andThen(after).accept("is coming");} 执行结果: 如结果所示:对同一个参数 T,通过 andThen 方法,先执行 consumer,再执行 fater。 3.4 Runnable Runnable:Runnable 的表现形式为即没有参数也没有返回值。 3.4.1 源码 @FunctionalInterfacepublic interface Runnable { public abstract void run();} 3.4.2 方法说明 run:抽象方法。run 方法实现具体的内容,需要将 Runnale 放入到 Thread 中,通过 Thread 类中的 start()方法启动线程,执行 run 中的内容。 3.4.3 方法举例 public class TestRun implements Runnable { @Override public void run() { System.out.println("TestRun is running!"); }} public static void main(String[] args) { Thread thread = new Thread(new TestRun()); thread.start(); } 执行结果: 如结果所示:当线程实行 start 方法时,执行 Runnable 的 run 方法中的内容。 4 Function 接口用法 Function 的主要用途是可以通过 lambda 表达式实现方法的内容。 4.1 差异处理 原代码: @Datapublic class User { /** * 姓名 */ private String name; /** * 年龄 */ private int age; /** * 组员 */ private List<User> parters;} public static void main(String[] args) { User user =new User(); if(user ==null ||user.getAge() <18 ){ throw new RuntimeException("未成年!"); }} 执行结果: 使用 Function 接口后的代码: @FunctionalInterfacepublic interface testFunctionInfe { /** * 输入异常信息 * @param message */ void showExceptionMessage(String message);} public static testFunctionInfe doException(boolean flag){ return (message -> { if (flag){ throw new RuntimeException(message); } }); } public static void main(String[] args) { User user =new User(); doException(user ==null ||user.getAge() <18).showExceptionMessage("未成年!");} 执行结果: 使用 function 接口前后都抛出了指定的异常信息。 4.2 处理 if…else… 原代码: public static void main(String[] args) { User user =new User(); if(user==null){ System.out.println("新增用户"); }else { System.out.println("更新用户"); }} 使用 Function 接口后的代码: public static void main(String[] args) { User user =new User(); Consumer trueConsumer = o -> { System.out.println("新增用户"); }; Consumer falseConsumer= o -> { System.out.println("更新用户"); }; trueOrFalseMethdo(user).showExceptionMessage(trueConsumer,falseConsumer);}public static testFunctionInfe trueOrFalseMethdo(User user){ return ((trueConsumer, falseConsumer) -> { if(user==null){ trueConsumer.accept(user); }else { falseConsumer.accept(user); } });}@FunctionalInterfacepublic interface testFunctionInfe { /** * 不同分处理不同的事情 * @param trueConsumer * @param falseConsumer */ void showExceptionMessage(Consumer trueConsumer,Consumer falseConsumer);} 执行结果: 4.3 处理多个 if 原代码: public static void main(String[] args) { String flag=""; if("A".equals(flag)){ System.out.println("我是A"); }else if ("B".equals(flag)) { System.out.println("我是B"); }else if ("C".equals(flag)) { System.out.println("我是C"); }else { System.out.println("没有对应的指令"); }} 使用 Function 接口后的代码: public static void main(String[] args) { String flag="B"; Map<String, Runnable> map =initFunctionMap(); trueOrFalseMethdo(map.get(flag)==null).showExceptionMessage(()->{ System.out.println("没有相应指令"); },map.get(flag));}public static Map<String, Runnable> initFunctionMap(){ Map<String,Runnable> result = Maps.newHashMap(); result.put("A",()->{System.out.println("我是A");}); result.put("B",()->{System.out.println("我是B");}); result.put("C",()->{System.out.println("我是C");}); return result;}public static testFunctionInfe trueOrFalseMethdo(boolean flag){ return ((runnable, falseConsumer) -> { if(flag){ runnable.run(); }else { falseConsumer.run(); } });} 执行结果: 5 总结 Function 函数式接口是 java 8 新加入的特性,可以和 lambda 表达式完美结合,是非常重要的特性,可以极大的简化代码。

优秀的个人博客,低调大师

Autograd解析|OneFlow学习笔记

撰文|月踏 更新|赵露阳 前文《AI杂谈:手推BP》讲了Backward Propagation的数学原理。本文以OneFlow的代码为例,梳理Autograd模块的实现细节。 1 一个求梯度的小例子 先看下面这个简单的例子: import oneflow as ofx = of.randn(2, 2, requires_grad=True)y = x + 100z = y.sum()z.backward() forward pass可以对应到下面的计算图: 图1 即对应下面公式: 根据前文《 AI杂谈:手推‍BP 》很容易手动计算出x的梯度值,即: x1、x2、x3的计算过程类似,不再赘述,下面看一下OneFlow的执行结果,执行print(x.grad)可得到如下输出: tensor([[1., 1.], [1., 1.]], dtype=oneflow.float32) 可以看出,结果和前面公式(3)的计算结果一致,下面通过具体的代码实现来分析OneFlow的Autograd模块。 2 backward接口 上面例子中的python端的backward接口,调用的是python/oneflow/framework/tensor.py中的_backward接口: def _backward(self, gradient=None, retain_graph=False, create_graph=False): if not lazy_mode.is_enabled(): flow.autograd.backward(self, gradient, retain_graph, create_graph) else: ... 可以看到backward只支持eager模式,这是因为graph静态图模式下,计算图是提前编译好的,无需手动通过.backward()调用。flow.autograd.backward()会调用 oneflow/api/python/autograd/autograd.cpp 中导出的backward方法: ONEFLOW_API_PYBIND11_MODULE("autograd", m) { m.def("backward", &Backward); m.def("grad", &Grad);} 从pybind定义来看,这里面总共导出了两个接口(autograd.backward和autograd.grad)。其中,backward是对所有的requires_grad属性为True的节点求梯度,grad只对指定的叶子结点求梯度,原理上是相同的,本文只以backward为例来看代码的实现,backward接口会调用到同一个文件中的Backward函数: Maybe<one::TensorTuple> Backward(const one::TensorTuple& outputs, const one::TensorTuple& out_grads, bool retain_graph, bool create_graph) { if (create_graph) { retain_graph = true; } std::shared_ptr<one::TensorTuple> gradients = JUST(CheckAndInitOutGrads(outputs, out_grads)); JUST(one::GetThreadLocalAutogradEngine()->RunBackwardAndSaveGrads4LeafTensorIf( outputs, *gradients, retain_graph, create_graph)); return std::make_shared<one::TensorTuple>(0);} 这里的GetThreadLocalAutogradEngine()可以看作是一个thread_local的单例,位于 oneflow/core/autograd/autograd_engine.cpp ,返回一个autograd引擎(AutogradEngine)对象的指针: AutogradEngine* GetThreadLocalAutogradEngine() { thread_local static GraphAutogradEngine autograd_engine; return &autograd_engine;} AutogradEngine是OneFlow的Autograd的核心数据结构,它的继承关系如下: 图2 这里autograd引擎的子类实现有基于栈式的、基于图式的实现,默认使用基于图式的GraphAutogradEngine。从前面代码中可以看到,获取autograd引擎指针后,通过调用RunBackwardAndSaveGrads4LeafTensor函数,位于 oneflow/core/autograd/autograd_engine.cpp:L315 : Maybe<void> GraphAutogradEngine::RunBackwardAndSaveGrads4LeafTensor(const TensorTuple& outputs, const TensorTuple& out_grads, bool retain_graph, bool create_graph) { for (int i = 0; i < outputs.size(); ++i) { JUST(JUST(outputs.at(i)->current_grad())->PushPartialTensor(out_grads.at(i))); } GraphTask graph_task(outputs, retain_graph, create_graph); JUST(graph_task.ComputeDependencies()); JUST(graph_task.Apply(/*save_grad_for_leaf=*/true)); return Maybe<void>::Ok();} 这就真正进入了autograd模块的内部处理流程,后面继续分析。 3 FunctionNode和建立反向图 在进行backward pass时,执行的是一张反向图,反向图中的节点是在forward pass的时候建立的,其中的每个节点被称作FunctionNode,主要数据结构如下: 图3 先说图3中FunctionNode( oneflow/core/autograd/autograd_engine.h:L42) ,包含next_functions_、input_meta_data_、output_meta_data_这三个数据成员,其中next_functions_表示出边,另外两个表示一些meta信息,下面列几个主要的: is_leaf_:是不是叶子节点 requires_grad_:是不是需要求梯度值 retain_grad_:对于非叶子节点,是不是保存梯度值 acc_grad_:在gradient accumulation的的情况下,多个mini-batch的梯度累加 current_grad_:当前这个batch的梯度值 我们用到的是GraphFunctionNod( oneflow/core/autograd/autograd_engine.cpp:L178) GraphFunctionNode::GraphFunctionNode(const std::string& name, const std::shared_ptr<BackwardFunction>& backward_fn, const TensorTuple& inputs, const TensorTuple& outputs) : FunctionNode(name, backward_fn) { input_meta_data_.resize(inputs.size()); next_functions_.reserve(inputs.size()); for (int i = 0; i < inputs.size(); ++i) { if (inputs.at(i)->requires_grad()) { input_meta_data_.at(i) = inputs.at(i)->mut_autograd_meta(); next_functions_.emplace_back(inputs.at(i)->mut_grad_fn_node()); } } output_meta_data_.resize(outputs.size()); output_tensor_infos_.reserve(outputs.size()); for (int i = 0; i < outputs.size(); ++i) { const auto& autograd_meta = NewAutogradMeta(outputs.at(i)->requires_grad(), outputs.at(i)->is_leaf()); outputs.at(i)->set_autograd_meta(autograd_meta); output_meta_data_.at(i) = outputs.at(i)->mut_autograd_meta(); output_tensor_infos_.emplace_back(TensorInfo(*outputs.at(i))); } backward_fn_ = backward_fn;} 可见它主要对FunctionNode中的重要数据成员做了初始化,其中input_meta_data_、output_meta_data_中的AutogradMeta信息是从相应的input、output tensor中获取的,tensor通过桥接模式保存了一个TensorImpl对象指针,这个TensorImpl对象则维护了一个AutogradMeta对象。 继续看下FunctionNode中的反向函数backward_fn_,在《 OneFlow学习笔记:从Functor到OpExprInterpreter 》中讲到了在进行一个op调用的时候会执行AutogradInterpreter::Apply这个函数( oneflow/core/framework/op_interpreter/op_interpreter.cpp:L86 ),里面会创建这个反向函数: Maybe<void> AutogradInterpreter::Apply( const OpExpr& op_expr, const TensorTuple& inputs, TensorTuple* outputs, const OpExprInterpContext& ctx) const { ... autograd::AutoGradMode mode(false); JUST(internal_->Apply(op_expr, inputs, outputs, ctx)); std::shared_ptr<OpExprGradClosure> grad_closure(nullptr); if (requires_grad && !LazyMode::is_enabled()) { grad_closure = JUST(op_expr.GetOrCreateOpGradClosure()); auto backward_fn = std::make_shared<BackwardFunction>(); backward_fn->body = [=](const TensorTuple& out_grads, TensorTuple* in_grads, bool create_graph) -> Maybe<void> { autograd::AutoGradMode mode(create_graph); JUST(grad_closure->Apply(out_grads, in_grads)); return Maybe<void>::Ok(); }; backward_fn->status = [=]() { return grad_closure->state()->SavedTensors().size() > 0; }; JUST(GetThreadLocalAutogradEngine()->AddNode(op_expr.op_type_name() + "_backward", backward_fn, inputs, outputs)); } ... return Maybe<void>::Ok();} 可以看到反向图节点的名字是以正向图op的type name加上_backward的后缀来组成的,使用AddNode方法来创建FunctionNode( oneflow/core/autograd/autograd_engine.cpp:L356 ) Maybe<FunctionNode> GraphAutogradEngine::AddNode( const std::string& name, const std::shared_ptr<BackwardFunction>& backward_fn, const TensorTuple& inputs, TensorTuple* outputs) { // Firstly push function_node of tensor in stack which is leaf and requires_grad for (const std::shared_ptr<Tensor>& in_tensor : inputs) { if (in_tensor->is_leaf() && in_tensor->requires_grad()) { if (!in_tensor->grad_fn_node()) { JUST(AddAccumulateFunctionNode(in_tensor)); } } } std::shared_ptr<FunctionNode> func_node = std::make_shared<GraphFunctionNode>(name, backward_fn, inputs, *outputs); for (const std::shared_ptr<Tensor>& out_tensor : *outputs) { out_tensor->set_grad_fn_node(func_node); } return func_node;} 可见FunctionNode是挂在Tensor上的,通过Tensor的set_grad_fn_node接口维护到Tensor的数据结构中,在《 OneFlow学习笔记: Gl o bal View的相关概念和实现 》中画过Tensor的继承关系图,FunctionNode就是保存在TensorIf中: 图4 至此,已经理清了FunctionNode中各个成员的作用以及来历,假如以第二节的图1为例来画出对应的反向图的话,如下图所示: 图5 计算好的梯度值会被放到output_meta_data_中得AutogradMeta中,它可以通过tensor的acc_grad、current_grad接口来获取。 4 反向图的执行流程 接第三节列出的最后一段代码,其中最重要的两句话是: ...JUST(graph_task.ComputeDependencies());JUST(graph_task.Apply(/*save_grad_for_leaf=*/true));... 这里面的graph_task是GraphTask类型,它是一个很重要的数据结构,用来调度反向图中所有FunctionNode的执行,下面列一下它的主要成员: class GraphTask final { bool retain_graph_; bool create_graph_; std::vector<FunctionNode*> roots_; HashMap<FunctionNode*, int> dependencies_; HashSet<FunctionNode*> need_execute_;}; 先看本节开头的graph_task.ComputeDependencies,它主要是在初始化dependencies_这个map,这个map维护了每个FunctionNode的入度信息,再看graph_task.Apply,它主要是在通过拓扑序来访问反向图中的每个FunctionNode,并且对当前的FunctionNode进行各种操作( oneflow/core/autograd/autograd_engine.cpp:L287 ) Maybe<void>GraphTask::Apply(boolsave_grad_for_leaf){ std::queue<FunctionNode*> queue; for (FunctionNode* node : roots_) { if (dependencies_[node] == 0) { queue.push(node); } } while (!queue.empty()) { FunctionNode* node = queue.front(); queue.pop(); if (!need_execute_.empty() && need_execute_.find(node) == need_execute_.end()) { node->ReleaseOutTensorArgs(); continue; } if (/*bool not_ready_to_apply=*/!(JUST(node->Apply(create_graph_)))) { continue; } if (save_grad_for_leaf) { JUST(node->AccGrad4LeafTensor(create_graph_)); } JUST(node->AccGrad4RetainGradTensor()); node->ReleaseOutTensorArgs(); if (!retain_graph_) { node->ReleaseData(); } for (const auto& next_grad_fn : node->next_functions()) { FunctionNode* next_node = next_grad_fn.get(); dependencies_[next_node] -= 1; if (dependencies_[next_node] == 0) { queue.push(next_node); } } } return Maybe<void>::Ok();} 这里最重要的是下面两个语句: node->Apply node->AccGrad4LeafTensor 下面来逐个分析,先看node->Apply( oneflow/core/autograd/autograd_engine.cpp:L143 ),首先利用output_meta_data_初始化了output_grads,把它作为反向函数的输入,调用反向函数来求梯度值,求出的梯度值暂存在input_grads中,然后再更新到input_meta_data_中: Maybe<bool> FunctionNode::Apply(bool create_graph) { ... JUST(backward_fn_->body(output_grads, &input_grads, create_graph)); for (int i = 0; i < input_meta_data_.size(); ++i) { if (input_grads.at(i)) { ... JUST(input_meta_data_.at(i)->current_grad()->PushPartialTensor(input_grads.at(i))); } } return true;} 再看node->AccGrad4LeafTensor,这个函数最终会调用到CopyOrAccGrad,它主要用于在gradient accumulation的时候,多个mini-batch之间把梯度值多累加,和如果有hook函数的的话,使用注册的hook对当前的梯度值进行处理: Maybe<void> CopyOrAccGrad(AutogradMeta* autograd_meta, bool autograd_mode) { autograd::AutoGradMode mode(autograd_mode); auto current_grad = JUST(autograd_meta->current_grad()->GetAccTensor({})); if (!current_grad) { return Maybe<void>::Ok(); } if (autograd_meta->acc_grad()) { ... DevVmDepObjectConsumeModeGuard guard(DevVmDepObjectConsumeMode::NONE); const auto& output = JUST(functional::Add(autograd_meta->acc_grad(), current_grad, /*alpha=*/1, /*inplace=*/autograd_meta->is_grad_acc_inplace())); JUST(autograd_meta->set_acc_grad(output)); } else { JUST(autograd_meta->set_acc_grad(current_grad)); } for (const auto& hook : autograd_meta->post_grad_accumulation_hooks()) { auto new_grad = hook(autograd_meta->acc_grad()); if (new_grad) { JUST(autograd_meta->set_acc_grad(new_grad)); } } return Maybe<void>::Ok();} (特别感谢同事yinggang中间的各种答疑解惑。本文主要参考代码:https://github.com/Oneflow-Inc/oneflow/commit/a4144f9ecb7e85ad073a810c3359bce7bfeb05e1) 其他人都在看 25倍性能加速,OneFlow“超速”了 一个GitHub史上增长最快的AI项目 手把手推导Ring All-reduce的数学性质 DeepMind爆发史:决定AI高峰的“游戏玩家” 解读Pathways(二):向前一步是OneFlow 五年ML Infra生涯,我学到最重要的3个教训 OneFlow v0.7.0发布:全新分布式接口,LiBai、Serving等一应俱全 欢迎下载体验OneFlow v0.7.0:https://github.com/Oneflow-Inc/oneflow/ 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

解析HetuEngine实现On Yarn原理

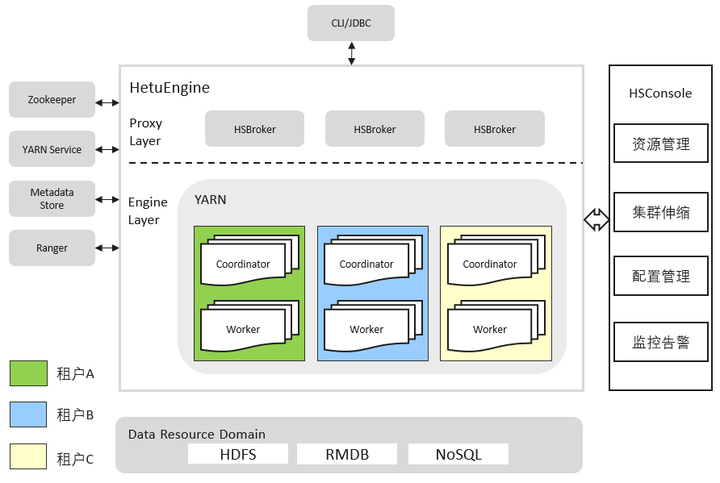
摘要:本文介绍HetuEngine实现On Yarn的原理,通过阅读本文,读者可以了解HetuEngine如何在资源使用方面融入Hadoop生态体系。 本文分享自华为云社区《MRS HetuEngine 特性之 On Yarn原理介绍》,作者:一颗柠檬。 HetuEngine是华为自研高性能分布式SQL查询&数据虚拟化引擎。与大数据生态无缝融合,实现海量数据秒级查询;支持多源异构协同,使能数据湖内一站式SQL融合分析。在整合开源能力的同时,MRS HetuEngine相较于开源社区也做了大量的优化,其中一个重要的特性就是On Yarn。 什么是On Yarn? 顾名思义,就是将进程运行在Yarn上,由Yarn进行资源的管理和调度。 不论是TrinoDB/PrestoDB还是openLooKeng,部署方式都是将coordinator和worker进程直接运行在主机上,与主机上的其他应用程序共享资源,无法做到资源隔离,并且难以扩展。 MRS HetuEngine借助Yarn Service提供的能力,将coordinator和worker进程以Yarn application的形式运行在Yarn container中,通过MRS集群的租户划分,可以将HetuEngine计算实例启动在特定租户队列里,从而实现资源隔离。 HetuEngine架构 下图是HetuEngine的拓扑图。HetuEngine向下可以对接各类数据源(比如Hive,GaussDB,HBASE,Elasticsearch等),对外向用户提供CLI/JDBC接口。在同一套MRS集群中,HetuEngine可以在不同租户队列中启动多个HetuEngine计算实例,支持一个租户队列上启动一个计算实例。由HetuEngine的HSBroker实例与Yarn Service交互,将租户队列与计算实例绑定,由HSConsole提供运维管理页面,对HetuEngine的多个计算实例进行运维管理操作,包括启动、停止、删除计算实例,对计算实例进行资源配置,扩缩容等。 HetuEngine On Yarn原理 如前所述,On Yarn就是把进程运行在了Yarn 的container中。HetuEngine 是如何实现将coordinator 和worker运行中Yarn中呢? Yarn Service提供了一系列API以及一个通用的AM,让用户可以调用API即可将任务提交到Yarn上,由Yarn实现任务的容器化,对容器进行资源和生命周期管理。详细请参考开源社区的介绍。https://hadoop.apache.org/docs/r3.1.0/hadoop-yarn/hadoop-yarn-site/yarn-service/Overview.html HetuEngine的 On Yarn实现正是借助了Yarn Service所提供的能力。在HetuEngine的HSBroker中,调用Yarn Service的API,拉起application,在container中运行HetuEngine自己的进程,也就是coordinator和worker。其中有以下几个关键点: Yarn Service API 创建一个Yarn Service服务的接口是/app/v1/services,参数json结构如下。 POST /app/v1/services { "name": "hello-world", "version": "1.0.0", "description": "hello world example", "components" : [ { "name": "hello", "number_of_containers": 1, "artifact": { "id": "nginx:latest", "type": "DOCKER" }, "launch_command": "./start_nginx.sh", "resource": { "cpus": 1, "memory": "256", "additional" : { "yarn.io/gpu" : { "value" : 4, "unit" : "" } } } } ] name:服务名称,显示在Yarn的resource manager WEB界面servicename; version:版本号 description:服务的描述 components:一个service中可以包含多个component,以运行不同的任务; components.name:component名称 number_of_containers:此component中container的数量; artifact:进程依赖的资源文件,包含id和type信息,type支持docker和tarball launch_command:进程启动命令 resource:此component所需的资源。 HetuEngine的HSBroker根据用户输入构造此json,然后调用Yarn Service API,实现On Yarn。此外Yarn Service还提供stop/delete等API,也由HSBroker调用,实现对HetuEngine计算实例的停止/删除等运维操作。 依赖文件 Yarn Service支持资源文件在HDFS上的形式启动进程,其提供的API可以接收tar包以及docker等形式的资源文件,由Yarn Service自行将HDFS上的文件进行资源本地化。因此,HetuEngine只需将依赖的jar包和资源文件提前部署在HDFS上的指定位置,在调用Yarn Service的API时指定资源文件即可。 租户绑定 HetuEngine支持将计算实例与Yarn的租户队列绑定,每个队列上都可以运行一套coordinator + worker的组合。基于前面Yarn Service能力,只需在构造json时,指定队列信息即可。除了队列,还可以设置container的放置策略(plecement policy),这里不进行详述,可以参考yarn的文档。 资源管理 HetuEngine支持用户自定义coordinator和worker的个数以及CPU内存大小。如下图,在HetuEngine的HSConsole页面,用户可以设置计算实例的CPU,内存,节点个数。内部实现是由HSBroker接收用户输入,将container运行所需的资源大小设置在json的resource段中。 当前HetuEngine支持横向扩展worker的个数,实现资源的弹性伸缩。即使在计算实例处于运行中时,也可以手动调整worker的个数,无需重启计算实例。这得益于Yarn Service的API中提供的flex接口,可以实现向一个运行中的application增加或者减少container的数量。 客户端使用 HetuEngine的计算实例创建完成后,用户可以通过hetu-cli或者JDBC程序进行访问,需要用户绑定对应的租户队列权限,才能向指定的队列提交任务。 Hetu CLI示例: hetu-cli --catalog hive --tenant tenantName --schema schemaName 租户名:(可选)租户名。指定HetuEngine启动的租户资源队列,不指定为租户的默认队列。使用此参数时,kinit的用户需要具有该租户对应角色的权限。 Hetu JDBC示例: Properties properties = new Properties(); ...… properties.setProperty("tenant", "default"); properties.setProperty("deploymentMode", "on_yarn"); …… connection = DriverManager.getConnection(url, properties); …… 本文主要介绍了HetuEngine On Yarn的原理,其实现主要是借助了Yarn Service提供的能力,感兴趣的读者可以深入阅读开源社区相关的介绍。 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册