首页 文章 精选 留言 我的

精选列表

搜索[Table组件],共10000篇文章
优秀的个人博客,低调大师

如何写好一个 Spring 组件

背景 Spring 框架提供了许多接口,可以使用这些接口来定制化 bean ,而非简单的 getter/setter 或者构造器注入。细翻 Spring Cloud Netflix、Spring Cloud Alibaba 等这些构建在 Spring Framework 的成熟框架源码,你会发现大量的扩展 bean 例如 Eureka 健康检查 package org.springframework.cloud.netflix.eureka; public class EurekaHealthCheckHandler implements InitializingBean {} Seata Feign 配置 package com.alibaba.cloud.seata.feign; public class SeataContextBeanPostProcessor implements BeanPostProcessor {} 代码示例 DemoBean @Slf4j public class DemoBean implements InitializingBean { public DemoBean() { log.info("--> instantiate "); } @PostConstruct public void postConstruct() { log.info("--> @PostConstruct "); } @Override public void afterPropertiesSet() throws Exception { log.info("--> InitializingBean.afterPropertiesSet "); } public void initMethod() { log.info("--> custom initMehotd"); } } DemoBeanPostProcessor @Configuration public class DemoBeanPostProcessor implements BeanPostProcessor { @Override public Object postProcessBeforeInitialization(Object bean, String beanName) throws BeansException { if ("demoBean".equals(beanName)){ log.info("--> BeanPostProcessor.postProcessBeforeInitialization "); } return bean; } @Override public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException { if ("demoBean".equals(beanName)){ log.info("--> BeanPostProcessor.postProcessAfterInitialization "); } return bean; } } DemoConfig @Configuration public class DemoConfig { @Bean(initMethod = "initMethod") public DemoBean demoBean() { return new DemoBean(); } } 运行输出日志 整个 bean 的创建过程日志输出如下和文首图片横线以上 bean 创建周期一致 DemoBean : --> instantiate DemoBeanPostProcessor: --> BeanPostProcessor.postProcessBeforeInitialization DemoBean : --> @PostConstruct DemoBean : --> InitializingBean.afterPropertiesSet DemoBean : --> custom initMehotd DemoBeanPostProcessor: --> BeanPostProcessor.postProcessAfterInitialization 执行过程核心源码 AbstractAutowireCapableBeanFactory.initializeBean protected Object initializeBean(final String beanName, final Object bean, @Nullable RootBeanDefinition mbd) { // 执行BeanPostProcessor.postProcessBeforeInitialization Object wrappedBean = wrappedBean = applyBeanPostProcessorsBeforeInitialization(wrappedBean, beanName); ... // 执行用户自定义初始化and JSR 250 定义的方法 invokeInitMethods(beanName, wrappedBean, mbd); ... // 执行执行BeanPostProcessor.postProcessAfterInitialization wrappedBean = applyBeanPostProcessorsAfterInitialization(wrappedBean, beanName); return wrappedBean; } 下文就详细说明一下每个 bean 的扩展周期的最佳使用场景 BeanPostProcessor BeanPostProcessor 是一个可以自定义实现回调方法接口,来实现自己的实例化逻辑、依赖解决逻辑等,如果想要在 Spring 完成对象实例化、配置、初始化之后实现自己的业务逻辑,可以通过扩展实现一个或多个 BeanPostProcessor 处理。 多用于适配器模式,可以在实现同一接口 bean 创建前后进行包装转换 // seata 上下文转换,将其他类型 wrap 成 SeataFeignContext public class SeataContextBeanPostProcessor implements BeanPostProcessor { @Override public Object postProcessBeforeInitialization(Object bean, String beanName){ if (bean instanceof FeignContext && !(bean instanceof SeataFeignContext)) { return new SeataFeignContext(getSeataFeignObjectWrapper(), (FeignContext) bean); } return bean; } } 自定义 注解查找扩展 net.dreamlu.mica.redisson.stream.RStreamListenerDetector 查找自定义 @RStreamListener 实现 基于 Redisson 的 pub/sub public class RStreamListenerDetector implements BeanPostProcessor { @Override public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException { Class<?> userClass = ClassUtils.getUserClass(bean); ReflectionUtils.doWithMethods(userClass, method -> { RStreamListener listener = AnnotationUtils.findAnnotation(method, RStreamListener.class); .... do something }, ReflectionUtils.USER_DECLARED_METHODS); return bean; } } PostConstruct JavaEE5 引入了@PostConstruct 作用于 Servlet 生命周期的注解,实现 Bean 初始化之前的自定义操作。 只能有一个非静态方法使用此注解 被注解的方法不能有返回值和方法参数 被注解的方法不得抛出异常 这里需要注意的 这个注解不是 Spring 定义的,而是属于 JavaEE JSR-250 规范定义的注解,当你在使用 Java11 的时候要手动引入相关 jar(因为 Java11 移除了) <dependency> <groupId>javax.annotation</groupId> <artifactId>javax.annotation-api</artifactId> </dependency> 使用场景: 在之前的版本,我们可以在启动后通过 @PostConstruct 注解的方法执行初始化数据。但由于 Java 高版本已经移除相关 API ,我们不推荐使用此 注解,可以通过 Spring 相关 Event 回调事件处理 @PostConstruct 注解的方法在项目启动的时候执行这个方法,也可以理解为在 spring 容器启动的时候执行,可作为一些数据的常规化加载,比如数据字典之类的。 InitializingBean InitializingBean 接口方法会在 容器初始化(getter/setter/构造器)完成 bean 的属性注入后执行。 应用场景: 动态修改容器注入的 Bean 参数 正常用户配置参数注入到 bean security: oauth2: ignore-urls: - '/ws/**' @ConfigurationProperties(prefix = "security.oauth2") public class PermitAllUrlProperties { @Getter @Setter private List<String> ignoreUrls = new ArrayList<>(); } 我们发现此时用户配置并不完整,还有一些通用不需要用户维护,可通过实现 InitializingBean 接口回调扩展 @ConfigurationProperties(prefix = "security.oauth2.ignore") public class PermitAllUrlProperties implements InitializingBean { @Getter @Setter private List<String> urls = new ArrayList<>(); @Override public void afterPropertiesSet() { urls.add("/common/*"); } } initMethod 上文 @PostConstruct 已经不推荐大家使用,可以使用 Bean(initMethod = 'initMehotd') 替代,相关的限制如上。 @Bean(initMethod = "initMethod") public DemoBean demoBean() { return new DemoBean(); } public void initMethod() { log.info("--> custom initMehotd"); } 总结 参考 https://docs.spring.io/spring/docs/5.2.6.RELEASE/spring-framework-reference/core.html#beans-factory-nature mica : https://github.com/lets-mica/mica pig: https://github.com/lltx/pig 项目推荐: Spring Cloud 、Spring Security OAuth2的RBAC权限管理系统 欢迎关注

优秀的个人博客,低调大师

SpringCloud微服务(03):Hystrix组件,实现服务熔断

本文源码:GitHub·点这里 || GitEE·点这里 一、熔断器简介 微服务架构特点就是多服务,多数据源,支撑系统应用。这样导致微服务之间存在依赖关系。如果其中一个服务故障,可能导致系统宕机,这就是所谓的雪崩效应。 1、服务熔断 微服务架构中某个微服务发生故障时,要快速切断服务,提示用户,后续请求,不调用该服务,直接返回,释放资源,这就是服务熔断。 熔断生效后,会在指定的时间后调用请求来测试依赖是否恢复,依赖的应用恢复后关闭熔断。 2、服务降级 服务器高并发下,压力剧增的时候,根据当业务情况以及流量,对一些服务和页面有策略的降级(可以理解为关闭不必要的服务),以此缓解服务器资源的压力以保障核心任务的正常运行。 双十一期间,支付宝很多功能都会提示,[双十一期间,保障核心交易,某某服务数据延迟]。 3、核心依赖 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-hystrix</artifactId> </dependency> 4、核心注解 @EnableHystrix 启动类注解控制熔断功能。 @HystrixCommand 方法注解,熔断控制配置。 5、案例模块描述 演示基于Ribbon服务的熔断 node03-consume-8001 演示基于Feign服务的熔断 node03-consume-8002 Eureka注册中心 node03-eureka-7001 两个服务提供方 node03-provider-6001 node03-provider-6002 二、基于Ribbon服务熔断 1、熔断执行方法 /** * 服务熔断调用方法 */ public String getDefaultInfo (){ return "服务被熔断" ; } 2、简单案例 /** * 简单配置 */ @RequestMapping("/showInfo1") @HystrixCommand(fallbackMethod = "getDefaultInfo") public String showInfo1 (){ return restTemplate.getForObject(server_name+"/getInfo",String.class) ; } Hystrix默认的超时时间是1秒,超时时间内部响应,就会执行熔断,进入fallback程序。由于Spring的懒加载机制,首次请求往往比较慢,可以通过配置Hystrix超时时间解决。 3、复杂案例 配置超时、并发、线程池、指定异常熔断忽略 /** * 复杂配置 */ @RequestMapping("/showInfo2") @HystrixCommand( fallbackMethod = "getDefaultInfo", commandProperties={ // 降级处理超时时间设置 @HystrixProperty(name = "execution.isolation.thread.timeoutInMilliseconds", value = "3000"), // 任意时间点允许的最高并发数。超过该设置值后,拒绝执行请求。 @HystrixProperty(name = "fallback.isolation.semaphore.maxConcurrentRequests", value = "1000"), }, // 配置执行的线城池 threadPoolProperties = { @HystrixProperty(name = "coreSize", value = "20"), @HystrixProperty(name = "maxQueueSize", value = "-1"), }, // 该异常不执行熔断,去执行该异常抛出的自己逻辑 ignoreExceptions = {ServiceException.class} ) public String showInfo2 (){ String value = "" ; // 测试配置异常不熔断 // 响应:{"code":500,"msg":"运行异常"} if (value.equals("")){ throw new ServiceException("运行异常") ; } // 该异常被熔断 // if (value.equals("")){ // throw new RuntimeException("抛出错误") ; // } return restTemplate.getForObject(server_name+"/getInfo",String.class) ; } 4、启动类注解 @EnableHystrix 三、基于Feign服务熔断 1、Jar包说明 通过观察Fegin依赖的JAR可知,Fegin的Jar下包含Hystrix需要的Jar包,这里不用再次导入依赖。 2、熔断配置 Feign用接口实现的声明式Rest请求,所以配置也就在接口上面了。 1)、接口代码 @FeignClient(value = "NODE02-PROVIDER",fallback = FallbackService.class) public interface GetAuthorService { @RequestMapping(value = "/getAuthorInfo/{authorId}",method = RequestMethod.GET) String getAuthorInfo (@PathVariable("authorId") String authorId) ; } 2)、熔断执行代码 @Component public class FallbackService implements GetAuthorService { @Override public String getAuthorInfo(String authorId) { return "服务被熔断"+authorId; } } 3)、配置文件 开启熔断功能 feign: hystrix: enabled: true 3、服务类注解 由于上面的接口和熔断代码是在不同的Jar模块中,所以要在启动类@SpringBootApplication注解中扫描,如下。 @SpringBootApplication(scanBasePackages = {"cloud.node02.consume","cloud.block.code.service"}) @EnableEurekaClient // 本服务启动后会自动注册进eureka服务中 @EnableDiscoveryClient // 因为包名路径不同,需要加basePackages属性 @EnableFeignClients(basePackages={"cloud.block.code.service"}) public class Application_8002 { public static void main(String[] args) { SpringApplication.run(Application_8002.class,args) ; } } 四、源代码说明 GitHub地址:知了一笑 https://github.com/cicadasmile/spring-cloud-base 码云地址:知了一笑 https://gitee.com/cicadasmile/spring-cloud-base

优秀的个人博客,低调大师

Mybatis执行SQL的4大基础组件详解

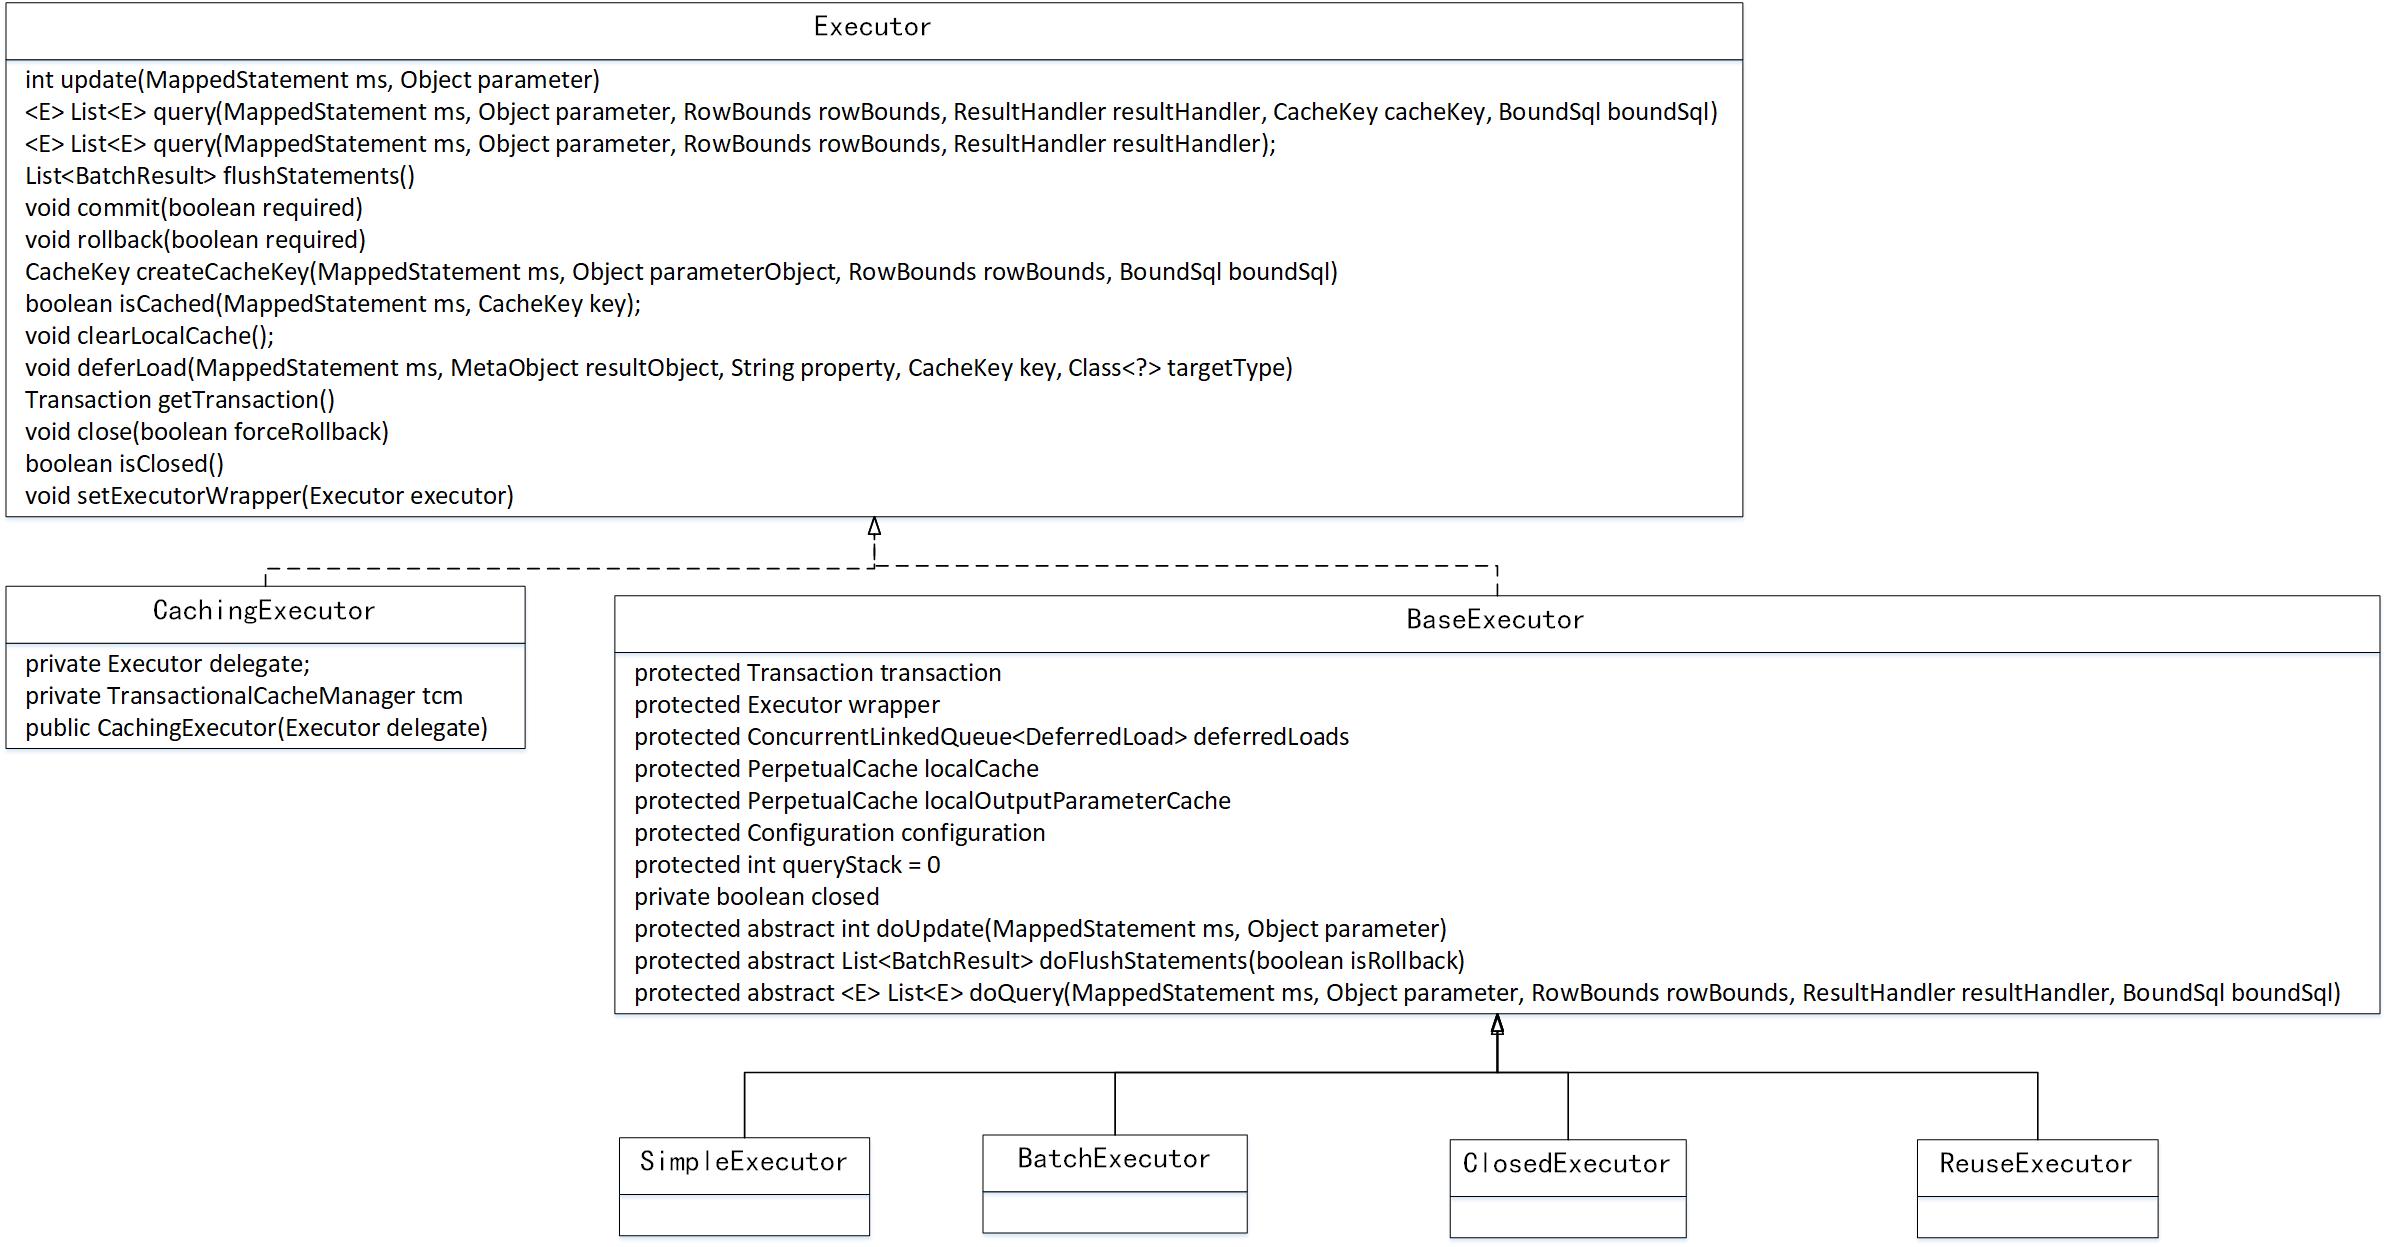
温馨提示:本篇是源码分析Mybatis ShardingJdbc SQL语句执行的前置篇。源码分析Mybatis系列目录: 1、源码分析Mybatis MapperProxy初始化之Mapper对象的扫描与构建2、源码分析Mybatis MappedStatement的创建流程 1、Executor sql执行器,其对应的类全路径:org.apache.ibatis.executor.Executor。 1.1 Executor类图 Executor执行器根据接口,定义update(更新或插入)、query(查询)、commit(提交事务)、rollback(回滚事务)。接下来简单介绍几个重要方法: int update(MappedStatement ms, Object parameter) throws SQLException更新或插入方法,其参数含义如下:、 1)MappedStatement ms:SQL映射语句(Mapper.xml文件每一个方法对应一个MappedStatement对象)2)Object parameter:参数,通常是List集合。 - < E> List< E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler) 查询方法,其参数含义如下:1)RowBounds:行边界,主要值分页参数limit、offset。2)ResultHandler resultHandler:结果处理器。 - CacheKey createCacheKey(MappedStatement ms, Object parameterObj, RowBounds bounds, BoundSql bSql) 创建缓存Key,Mybatis一二级缓存的缓存Key,可以看出Key由上述4个参数来决定。1)BoundSql boundSql:可以通过该对象获取SQL语句。 CachingExecutor支持结果缓存的SQL执行器,注意其设计模式的应用,该类中,会持有Executor的一个委托对象,CachingExecutor关注与缓存特定的逻辑,其最终的SQL执行由其委托对象来实现,即其内部的委托对象为BaseExecutor的实现类。 BaseExecutorExecutor的基础实现类,该类为抽象类,关于查询、更新具体的实现由其子类来实现,下面4个都是其子类。 SimpleExecutor简单的Executor执行器。 BatchExecutor支持批量执行的Executor执行器。 ClosedExecutor表示一个已关闭的Executor。 ReuseExecutor支持重复使用Statement,以SQL为键,缓存Statement对象。 1.2 创建Executor 在Mybatis中,Executor的创建由Configuration对象来创建,具体的代码如下: Configuration#newExecitor public Executor newExecutor(Transaction transaction) { return newExecutor(transaction, defaultExecutorType); // @1 } public Executor newExecutor(Transaction transaction, ExecutorType executorType) { executorType = executorType == null ? defaultExecutorType : executorType; executorType = executorType == null ? ExecutorType.SIMPLE : executorType; Executor executor; if (ExecutorType.BATCH == executorType) { // @2 executor = new BatchExecutor(this, transaction); } else if (ExecutorType.REUSE == executorType) { executor = new ReuseExecutor(this, transaction); } else { executor = new SimpleExecutor(this, transaction); } if (cacheEnabled) { // @3 executor = new CachingExecutor(executor); } executor = (Executor) interceptorChain.pluginAll(executor); // @4 return executor; } 从上面的代码可以看出,Executor的创建由如下三个关键点:代码@1:默认的ExecutorType为ExecutorType.SIMPLE,即默认创建的Executory为SimpleExecutor。代码@2:根据executorType的值创建对应的Executory。代码@3:如果cacheEnabled为true,则创建CachingExecutory,然后在其内部持有上面创建的Executor,cacheEnabled默认为true,则默认创建的Executor为CachingExecutor,并且其内部包裹着SimpleExecutor。代码@4:使用InterceptorChain.pluginAll为executor创建代理对象,即Mybatis的拆件机制,将在该系列文章中详细介绍。 2、StatementHandler 在学习StatementHandler之前,我们先来回顾一下JDBC相关的知识。JDBC与语句执行的两大主流对象:java.sql.Statement、java.sql.PrepareStatement对象大家应该不会陌生,该对象的execute方法就是执行SQL语句的入口,通过java.sql.Connection对象创建Statement对象。Mybatis的StatementHandler,是Mybatis创建Statement对象的处理器,即StatementHandler会接管Statement对象的创建。 2.1 StatementHandler类图 StatementHandler根接口,我们重点关注一下其定义的方法: Statement prepare(Connection connection)创建Statement对象,即该方法会通过Connection对象创建Statement对象。 void parameterize(Statement statement)对Statement对象参数化,特别是PreapreStatement对象。 void batch(Statement statement)批量执行SQL。 int update(Statement statement)更新操作。 < E> List< E> query(Statement statement, ResultHandler resultHandler)查询操作。 BoundSql getBoundSql()获取SQL语句。 ParameterHandler getParameterHandler()获取对应的参数处理器。 BaseStatementHandlerStatementHandler的抽象实现类,SimpleStatementHandler、PrepareStatementHandler、CallableStatementHandler是其子类。 我们来一一看一下其示例变量: - Configuration configuration Mybatis全局配置对象。 - ObjectFactory objectFactory 对象工厂。 - TypeHandlerRegistry typeHandlerRegistry 类型注册器。 - ResultSetHandler resultSetHandler 结果集Handler。 - ParameterHandler parameterHandler 参数处理器Handler。 - Executor executor SQL执行器。 - MappedStatement mappedStatement SQL映射语句(Mapper.xml文件每一个方法对应一个MappedStatement对象) - RowBounds rowBounds 行边界,主要值分页参数limit、offset。 - BoundSql boundSql 可以通过该对象获取SQL语句。 SimpleStatementHandler具体的StatementHandler实现器,java.sql.Statement对象创建处理器。 PrepareStatementHandlerjava.sql.PrepareStatement对象的创建处理器。 CallableStatementHandlerjava.sql.CallableStatement对象的创建处理器,可用来执行存储过程调用的Statement。 RoutingStatementHandlerStatementHandler路由器,我们看一下其构造方法后,就会对该类了然于胸。 public RoutingStatementHandler(Executor executor, MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql) { switch (ms.getStatementType()) { // @1 case STATEMENT: delegate = new SimpleStatementHandler(executor, ms, parameter, rowBounds, resultHandler, boundSql); break; case PREPARED: delegate = new PreparedStatementHandler(executor, ms, parameter, rowBounds, resultHandler, boundSql); break; case CALLABLE: delegate = new CallableStatementHandler(executor, ms, parameter, rowBounds, resultHandler, boundSql); break; default: throw new ExecutorException("Unknown statement type: " + ms.getStatementType()); } } 原来是会根据MappedStatement对象的statementType创建对应的StatementHandler。 2.2 创建StatementHandler Configuration#newStatementHandler public StatementHandler newStatementHandler(Executor executor, MappedStatement mappedStatement, Object parameterObject, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql) { StatementHandler statementHandler = new RoutingStatementHandler(executor, mappedStatement, parameterObject, rowBounds, resultHandler, boundSql); // @1 statementHandler = (StatementHandler) interceptorChain.pluginAll(statementHandler); // @2 return statementHandler; } 该方法的两个关键点如下:代码@1:创建RoutingStatementHandler对象,在其内部再根据SQL语句的类型,创建对应的StatementHandler对象。代码@2:对StatementHandler引入拆件机制,该部分将在该专题的后续文章中会详细介绍,这里暂时跳过。 3、ParameterHandler 参数处理器。同样我们先来看一下其类图。 3.1 ParameterHandler类图 这个比较简单,就是处理PreparedStatemet接口的参数化处理,也可以顺便看一下其调用链(该部分会在下一篇中详细介绍)。 3.2 创建ParameterHandler Configuration#newParameterHandler public ParameterHandler newParameterHandler(MappedStatement mappedStatement, Object parameterObject, BoundSql boundSql) { ParameterHandler parameterHandler = mappedStatement.getLang().createParameterHandler(mappedStatement, parameterObject, boundSql); parameterHandler = (ParameterHandler) interceptorChain.pluginAll(parameterHandler); // @1 return parameterHandler; } 同样该接口也支持插件化机制。 4、ResultSetHandler 处理结果的Handler。我们同样看一下其类图。 4.1 ResultSetHandler类图 处理Jdbc ResultSet的处理器。 4.2 ResultSetHandler创建 Configuration#newResultSetHandler public ResultSetHandler newResultSetHandler(Executor executor, MappedStatement mappedStatement, RowBounds rowBounds, ParameterHandler parameterHandler, ResultHandler resultHandler, BoundSql boundSql) { ResultSetHandler resultSetHandler = new DefaultResultSetHandler(executor, mappedStatement, parameterHandler, resultHandler, boundSql, rowBounds); resultSetHandler = (ResultSetHandler) interceptorChain.pluginAll(resultSetHandler); return resultSetHandler; } 同样支持插件化机制,我们也稍微再看一下其调用链:可以看出其调用的入口为SQL执行时。 本文作为下一篇《源码分析Mybatis整合ShardingJdbc SQL执行流程》的前置篇,重点介绍Executor、StatementHandler、ParameterHandler、ResultSetHandler的具体职责,以类图为基础并详细介绍其核心方法的作用,然后详细介绍了这些对象是如何创建,并引出Mybatis拆件机制。 原文发布时间为:2019-05-21本文作者:丁威,《RocketMQ技术内幕》作者。本文来自中间件兴趣圈,了解相关信息可以关注中间件兴趣圈。
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册