首页 文章 精选 留言 我的

精选列表

搜索[超融合软件],共10000篇文章
优秀的个人博客,低调大师

豆包大模型日均 tokens 使用量超 5000 亿

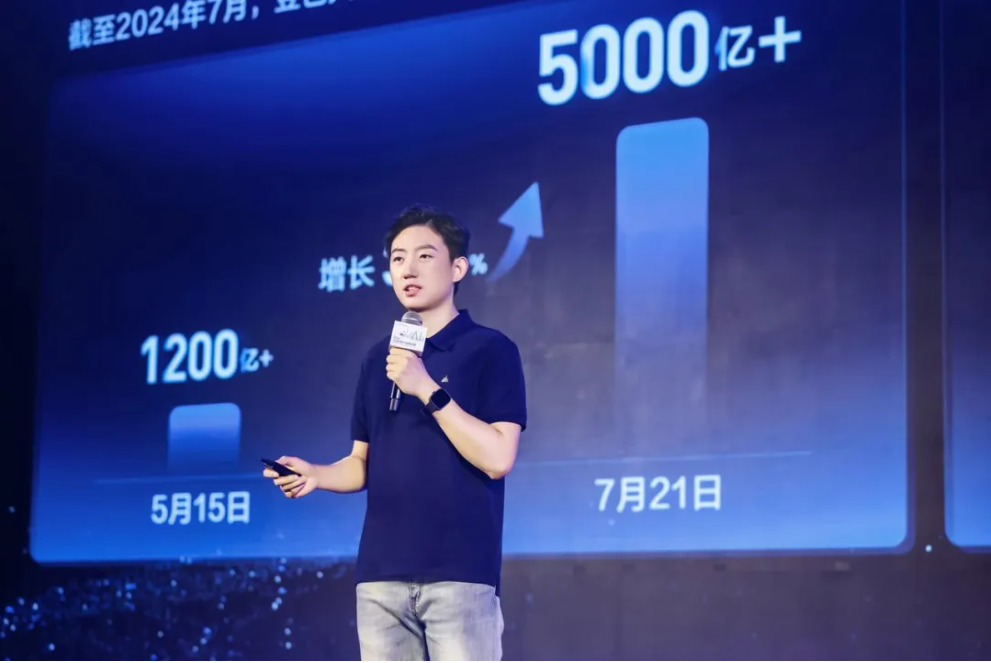
在 2024火山引擎 AI 创新巡展·成都站上,火山引擎方面透露,截至今年7月,豆包大模型日均 tokens 使用量超过5000亿。 火山引擎在今年5月发布豆包大模型,提供包含大语言模型、语音模型、视觉模型的豆包模型家族,以满足不同场景的关键需求。自今年5月15日豆包大模型发布的2个月内,平均每家企业客户日均 tokens 使用量增长了22倍。 火山引擎副总裁张鑫在会上介绍,在字节内部,有50多个业务在使用豆包大模型,覆盖了协同办公、数据分析、文案创作、辅助编程、内容审核、客服、游戏NPC、角色对话、教育等各种场景,基于豆包大模型打造的新技术引擎正在加速业务创新。 此外,豆包大模型的外部客户已覆盖手机、汽车、金融、消费、互娱等30多个行业。

优秀的个人博客,低调大师

技术解密Java Chassis 3超实用的可观测性

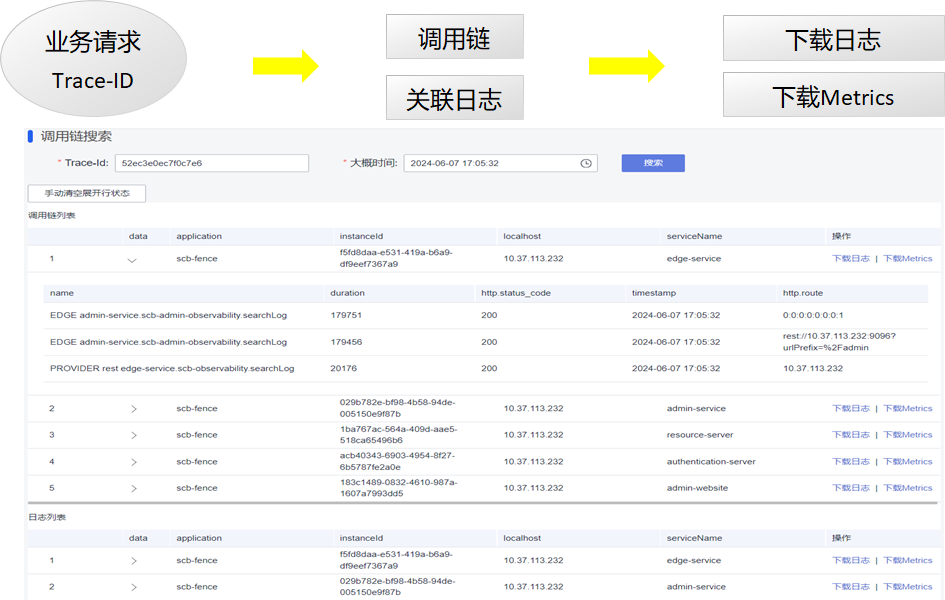
本文分享自华为云社区《Java Chassis 3技术解密:实用的可观测性》,作者:liubao68。 狭义的可观测性,指日志、调用链和指标,广义的可观测性则包含更多的内容,一般的,应用程序暴露出来的便于理解其运行状态、运行轨迹、内部结构和功能集合的信息,都是可观测性的范围,本文只讨论狭义的可观测性。日志揭露了应用程序内部运行的轨迹,通过异常日志,可以理解错误产生的原因;调用链反映的是一次业务操作经过的关键处理节点,可以帮助快速确定问题发生的边界;指标反映错误发生时应用程序的当前或者历史状态,帮助分析需要一定的时间或者流量积累才会发生的问题,比如过载问题、性能问题等。可以看出,为了分析故障,具备可观测性能力非常重要。 微服务系统具备复杂的调用关系和分布式部署特征,为了更好的分析和处理日志、调用链和指标,通常会部署ELK、SkyWalking和Prometheus等外部系统。 这些系统完全搭建起来,会花费数十万每年的计算成本,而且很可能并没有显著提升日常问题定位的效率,不恰当的使用还可能会引入性能问题。针对问题定位难的情况,Java Chassis 3提供了非常简单高效,而且低成本的解决方案。由于采集的数据,都是和Java Chassis运行过程和系统架构强相关的,也避免了采集海量无关数据,使得数据对于问题分析更具有针对性,能够更加快速识别问题根因。 在下面的部分,我们首先解密如何使用可观测能力来快速定位问题,然后再解密这个能力是如何构建起来的。 问题定位流程 在很多组织里面,问题定位都是由不太熟悉系统结构和技术细节的运维人员开始的,或者是由工作交接后刚刚接触系统的新人开始的,这给快速定界问题,收集和问题相关的信息带来了巨大的挑战。一个问题从发现到传递给责任模块,数个小时的时间就过去了。 设计一个简单的问题定位流程,快速定界问题和收集关联信息,是可观测系统搭建的起点。 当用户识别到一个故障,比如交易失败,在系统层面,会对应到一次系统请求的失败。在系统设计之初,会采用一个请求标识将用户故障和系统请求关联起来,即 TraceId, 这个是所有调用链系统设计的基础。 通常建议前端在发送请求的时候,都携带 TraceId, 便于将前后端请求进行关联。在前端未按照要求携带 TraceId 的情况下,Java Chassis会在应用网关 Edge Service生成 TraceId, 并在给前端响应的HTTP头中携带 TraceId。 当用户识别到一个故障,可以通过浏览器等前端工具获取到 TraceId。 问题定位的起点是获取TraceId。 在管理控制台,输入TraceId 和问题发生大概时间,可以检索出关键的调用链信息和关键日志信息。 通过调用链信息,可以知道请求的执行轨迹和发生问题的节点,通过关键日志信息,能够快速确定问题根因。 对于一些简单常见的问题,经过这个简单的步骤,就能够确定问题根因。 对于一些复杂的问题,需要获取上下文日志或者指标来进行深入的分析,运维人员可以在检索结果里面将完整的日志文件和指标信息下载下来,提供给故障服务的技术人员。 从上面的过程可以看出,运维人员在不理解系统实现细节的情况下,也能快速定界和定位一些简单问题,并能够快速收集详细的和问题强相关的信息提供给技术人员做进一步处理。 实现原理 Java Chassis在设计之初,就内置了大量的可观测能力。使用上述流程,无需部署ELK、SkyWalking和Prometheus去采集数据,也不需要集成这些工具的SDK或者Agent。 通过一些开发规范约束和可观测API就能够实现一个简单高效和易用的定位系统。 动手试试: 可以通过下载和运行fence项目,体验上述问题定位流程和了解本章节介绍的实现原理。 也可以在实际的业务系统中,参考该项目构筑业务需要的可观测能力。 Java Chassis通过集成 应用性能监控(https://servicecomb.apache.org/references/java-chassis/zh_CN/general-development/metrics.html) 、 微服务调用链(https://servicecomb.apache.org/references/java-chassis/zh_CN/general-development/microservice-invocation-chain.html) 来生成调用链和指标,日志则使用 slf4j 来记录。 这些数据构成了可观测的基础, 接下来就是如何存储和采集这些数据。 通过配置 log4j2 , 可以将日志、调用链和指标都输出到日志文件。 特别的,该日志配置约束了数据存储的规则、路径,为可观测API提供了简单的实现方案。 <Configuration> <Properties> <property name="FILE_PATH" value="./logs/admin-website"/> </Properties> <Appenders> <Console name="Console" target="SYSTEM_OUT"> <PatternLayout pattern="%-d{yyyy-MM-dd HH:mm:ss} [%X{SERVICECOMB_TRACE_ID}][%p][%t][%c:%L] %m%n"/> </Console> <RollingFile name="RootLog" fileName="${FILE_PATH}/root.log" filePattern="${FILE_PATH}/root-%d{yyyy-MM-dd-HH}.log"> <PatternLayout pattern="%-d{yyyy-MM-dd-HH:mm:ss} [%X{SERVICECOMB_TRACE_ID}][%p][%t][%c:%L] %m%n"/> <Policies> <TimeBasedTriggeringPolicy interval="3"/> </Policies> <DefaultRolloverStrategy max="100"/> </RollingFile> <RollingFile name="TraceLog" fileName="${FILE_PATH}/trace.log" filePattern="${FILE_PATH}/trace-%d{yyyy-MM-dd-HH}.log"> <PatternLayout pattern="%-d{yyyy-MM-dd HH:mm:ss} %m%n"/> <Policies> <TimeBasedTriggeringPolicy interval="3"/> </Policies> <DefaultRolloverStrategy max="100"/> </RollingFile> <RollingFile name="MetricsLog" fileName="${FILE_PATH}/metrics.log" filePattern="${FILE_PATH}/metrics-%d{yyyy-MM-dd-HH}.log"> <PatternLayout pattern="%-d{yyyy-MM-dd HH:mm:ss} %m%n"/> <Policies> <TimeBasedTriggeringPolicy interval="3"/> </Policies> <DefaultRolloverStrategy max="100"/> </RollingFile> </Appenders> <Loggers> <Logger name="scb-trace" level="INFO" additivity="false"> <AppenderRef ref="TraceLog"/> </Logger> <Logger name="scb-metrics" level="INFO" additivity="false"> <AppenderRef ref="MetricsLog"/> </Logger> <Root level="INFO"> <AppenderRef ref="Console"/> <AppenderRef ref="RootLog"/> </Root> </Loggers> </Configuration> 每个微服务都集成和实现可观测API。 @Path("/v1/scb/observability") public interface ObservabilityService { String NAME = "scb-observability"; @Path("/searchTrace") @GET SearchTraceResponse searchTrace(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/searchLog") @GET SearchLogResponse searchLog(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/downloadLog") @GET Part downloadLog(@NotNull @QueryParam("timestamp") String timestamp); @Path("/downloadMetrics") @GET Part downloadMetrics(@NotNull @QueryParam("timestamp") String timestamp); } 最后,我们可以开发一个管理控制服务,实现管理面可观测API, 就完成了可观测能力的构建: @Path("/v1/scb/admin/observability") public interface AdminObservabilityService { String NAME = "scb-admin-observability"; @Path("/searchTrace") @GET List<SearchTraceResponse> searchTrace(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/searchLog") @GET List<SearchLogResponse> searchLog(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/downloadLog") @GET Part downloadLog(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("serviceName") String serviceName, @NotNull @QueryParam("instanceId") String instanceId); @Path("/downloadMetrics") @GET Part downloadMetrics(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("serviceName") String serviceName, @NotNull @QueryParam("instanceId") String instanceId); } 和传统方案的对比分析 与部署ELK、SkyWalking和Prometheus去采集数据的传统方案对比,上述方案非常简单和实用,能够帮助实时在线分析问题,该方案也无需将日志、调用链和指标等数据集中存储下来,可以节省大量的存储设备空间。 当然它的缺点也是显而易见的,对于已经下线的服务,或者对于历史问题需要追溯的情况,则采集不到相关的信息。 站在问题定位的角度,存储海量的日志、调用链和指标数据,大量数据都是和问题无关的,并且多数情况是要在第一时间完成问题定界和信息收集,因此上述方案相比于传统方案就有了非常大的竞争力优势。 客户故事:很多客户花了大量成本构建可观测能力,依然无法指导运维人员快速定界和定位问题。通过建立一个简单实用的问题定界流程和采集数据的手段,可以帮助提升问题定位效率。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

AMD 开源 GPU 内核驱动的代码行数超 500 万

科技媒体 Phoronix 对 AMD 的 Linux 内核图形驱动程序代码进行了一些 cloc 统计,尤其是drivers/gpu/drm/amd/模块,这些模块包含了围绕 AMDGPU DRM 驱动程序的现代代码,其中包括 AMDKFD 计算、用于显示的代码、通用头文件等(但不包括 drivers/gpu/drm/radeon/中的旧版 "Radeon" 驱动程序)。 据统计,开源 AMD Linux 内核图形驱动程序的代码行数超过 500 万: 当然,大部分是自动生成的头文件,其中很大一部分是 AMD 在每一代/每一个给定区块的新版本中不断引入新的自动生成头文件。这些冗长的头文件已成为 AMD 为其 GPU 创建详尽的公共文档的替代方案。 与此同时,英伟达的开源"Nouveau"驱动程序大约有 20 多万行(2 万多空行、2.4 万行注释和 15.5 万行代码)。英特尔 i915 DRM 内核图形驱动程序通过相同的 cloc 统计,约为 38.1 万行。 上面提到的只是内核图形驱动程序代码,还不包括 Mesa 中用于提供 OpenGL 和 Vulkan 驱动程序支持或其他用户空间组件的所有代码。 截至现在,整个 Linux 内核源代码树大约有 3480 万行,包括文档、各种树内实用程序/工具、其他辅助工具等。

优秀的个人博客,低调大师

中文大模型评测:国内大模型首超 GPT 3.5

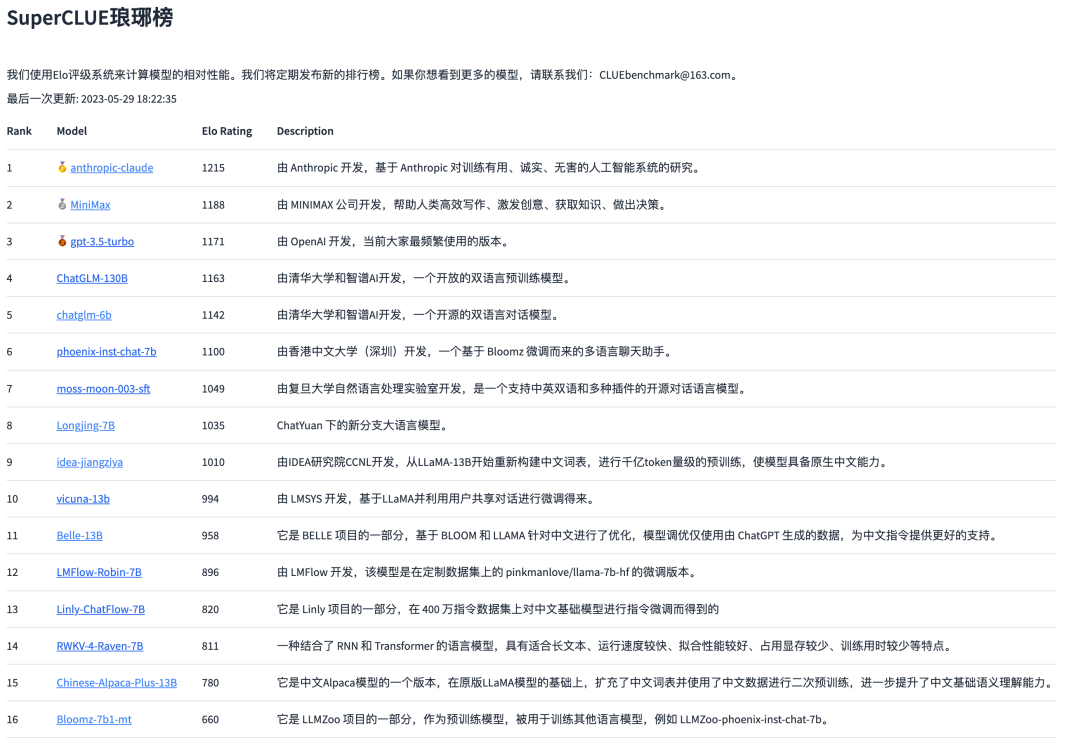
最近,来自中文语言理解测评基准开源社区 CLUE 的成员发起了中文大模型匿名对战平台 SuperCLUE-琅琊榜,目前已经获得有效投票 5.8K。 以下是截至2023年5月29日18点22分的 SuperCLUE 琅琊榜初始排名。 SuperCLUE-琅琊榜官方唯一地址:www.SuperCLUEAI.com SuperCLUE 是中文通用大模型综合性测评基准。 它主要回答的问题是:在当前通用大模型大力发展的情况下,中文大模型的效果情况。包括但不限于: 这些模型不同任务的效果情况 相较于国际上的代表性模型做到了什么程度 这些模型与人类的效果对比如何? 它尝试在一系列国内外代表性的模型上使用多个维度能力进行测试。SuperCLUE 是中文语言理解测评基准 (CLUE) 在通用人工智能时代的进一步发展。 在初始排名中,由 Anthropic 公司开发的Claude 模型以 1215 分暂居第一。在国内模型中,MiniMax 模型以 1188 的高分力压众多国产大模型登顶 SuperCLUE 琅琊榜,暂居国服第一,也是国内大模型首次在公开测评中超过 GPT3.5。 其中,GPT 3.5 以 1171 分排名第三。由清华大学和智谱AI开发的 ChatGLM-130B 则以 8 分微弱差距排名第四,ChatGLM-6B以仅 60 亿参数量的模型跻身前五,表现不俗。香港中文大学和复旦大学同样表现优异,分列 6、7 名,IDEA研究院的姜子牙大模型同样也超过了 1000 分,排名第 9。 相比之下在英文上表现强劲的 vicuna-13b 模型,仅仅排名第 10,在中文能力上明显弱于国内中文大模型。 值得提及的是,在英文对战排名中表现优异的 RWKV,在中文对战表现上稍显不足。RWKV 团队表示正在训练中文基底模型,后续会以中文身份加入对战。 CLUE 团队表示,之后会定期更新 SuperCLUE 琅琊榜排名,同时加入更多具有代表性的大模型。

优秀的个人博客,低调大师

【建议收藏】超详细的Canal入门,看这篇就够了!!!

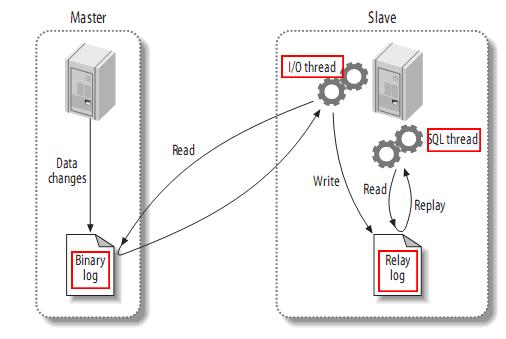
概述 canal是阿里巴巴旗下的一款开源项目,纯Java开发。基于数据库增量日志解析,提供增量数据订阅&消费,目前主要支持了MySQL(也支持mariaDB)。 背景 早期,阿里巴巴B2B公司因为存在杭州和美国双机房部署,存在跨机房同步的业务需求。不过早期的数据库同步业务,主要是基于trigger的方式获取增量变更,不过从2010年开始,阿里系公司开始逐步的尝试基于数据库的日志解析,获取增量变更进行同步,由此衍生出了增量订阅&消费的业务,从此开启了一段新纪元。ps. 目前内部使用的同步,已经支持mysql5.x和oracle部分版本的日志解析 基于日志增量订阅&消费支持的业务: 数据库镜像 数据库实时备份 多级索引 (卖家和买家各自分库索引) search build 业务cache刷新 价格变化等重要业务消息 当前的 canal 支持源端 MySQL 版本包括 5.1.x , 5.5.x , 5.6.x , 5.7.x , 8.0.x 工作原理 Mysql的BinLog 它记录了所有的DDL和DML(除了数据查询语句)语句,以事件形式记录,还包含语句所执行的消耗的时间。主要用来备份和数据同步。 binlog 有三种模式:STATEMENT、ROW、MIXED STATEMENT 记录的是执行的sql语句 ROW 记录的是真实的行数据记录 MIXED 记录的是1+2,优先按照1的模式记录 举例说明 举例来说,下面的sql COPYupdate user set age=20 对应STATEMENT模式只有一条记录,对应ROW模式则有可能有成千上万条记录(取决数据库中的记录数)。 MySQL主备复制原理 Slave 上面的IO线程连接上 Master,并请求从指定日志文件的指定位置(或者从最开始的日志)之后的日志内容; Master 接收到来自 Slave 的 IO 线程的请求后,通过负责复制的 IO 线程根据请求信息读取指定日志指定位置之后的日志信息,返回给 Slave 端的 IO 线程。返回信息中除了日志所包含的信息之外,还包括本次返回的信息在 Master 端的 Binary Log 文件的名称以及在 Binary Log 中的位置; Slave 的 IO 线程接收到信息后,将接收到的日志内容依次写入到 Slave 端的Relay Log文件(mysql-relay-bin.xxxxxx)的最末端,并将读取到的Master端的bin-log的文件名和位置记录到master- info文件中,以便在下一次读取的时候能够清楚的高速Master“我需要从某个bin-log的哪个位置开始往后的日志内容,请发给我” Slave 的 SQL 线程检测到 Relay Log 中新增加了内容后,会马上解析该 Log 文件中的内容成为在 Master 端真实执行时候的那些可执行的 Query 语句,并在自身执行这些 Query。这样,实际上就是在 Master 端和 Slave 端执行了同样的 Query,所以两端的数据是完全一样的。 当然这个过程本质上还是存在一定的延迟的。 mysql的binlog文件长这个样子。 COPYmysql-bin.003831 mysql-bin.003840 mysql-bin.003849 mysql-bin.003858 启用Binlog注意以下几点: Master主库一般会有多台Slave订阅,且Master主库要支持业务系统实时变更操作,服务器资源会有瓶颈; 需要同步的数据表一定要有主键; canal能够同步数据的原理 理解了mysql的主从同步的机制再来看canal就比较清晰了,canal主要是听过伪装成mysql从server来向主server拉取数据。 canal模拟mysql slave的交互协议,伪装自己为mysql slave,向mysql master发送dump协议 mysql master收到dump请求,开始推送binary log给slave(也就是canal) canal解析binary log对象(原始为byte流) Canal架构 canal的设计理念 canal的组件化设计非常好,有点类似于tomcat的设计。使用组合设计,依赖倒置,面向接口的设计。 canal的组件 canal server 这个代表了我们部署的一个canal 应用 canal instance 这个代表了一个canal server中的多个 mysql instance ,从这一点说明一个canal server可以搜集多个库的数据,在canal中叫 destionation。 每个canal instance 有多个组件构成。在conf/spring/default-instance.xml中配置了这些组件。他其实是使用了spring的容器来进行这些组件管理的。 instance 包含的组件 这里是一个cannalInstance工作所包含的大组件。截取自 conf/spring/default-instance.xml COPY<bean id="instance" class="com.alibaba.otter.canal.instance.spring.CanalInstanceWithSpring"> <property name="destination" value="${canal.instance.destination}" /> <property name="eventParser"> <ref local="eventParser" /> </property> <property name="eventSink"> <ref local="eventSink" /> </property> <property name="eventStore"> <ref local="eventStore" /> </property> <property name="metaManager"> <ref local="metaManager" /> </property> <property name="alarmHandler"> <ref local="alarmHandler" /> </property> </bean> EventParser设计 eventParser 最基本的组件,类似于mysql从库的dump线程,负责从master中获取bin_log 整个parser过程大致可分为几步: Connection获取上一次解析成功的位置 (如果第一次启动,则获取初始指定的位置或者是当前数据库的binlog位点) Connection建立链接,发送BINLOG_DUMP指令 // 0. write command number // 1. write 4 bytes bin-log position to start at // 2. write 2 bytes bin-log flags // 3. write 4 bytes server id of the slave // 4. write bin-log file name Mysql开始推送Binaly Log 接收到的Binaly Log的通过Binlog parser进行协议解析,补充一些特定信息 // 补充字段名字,字段类型,主键信息,unsigned类型处理 传递给EventSink模块进行数据存储,是一个阻塞操作,直到存储成功 存储成功后,定时记录Binaly Log位置 EventSink设计 eventSink 数据的归集,使用设置的filter对bin log进行过滤,工作的过程如下。 说明: 数据过滤:支持通配符的过滤模式,表名,字段内容等 数据路由/分发:解决1:n (1个parser对应多个store的模式) 数据归并:解决n:1 (多个parser对应1个store) 数据加工:在进入store之前进行额外的处理,比如join 数据1:n业务 为了合理的利用数据库资源, 一般常见的业务都是按照schema进行隔离,然后在mysql上层或者dao这一层面上,进行一个数据源路由,屏蔽数据库物理位置对开发的影响,阿里系主要是通过cobar/tddl来解决数据源路由问题。 所以,一般一个数据库实例上,会部署多个schema,每个schema会有由1个或者多个业务方关注 数据n:1业务 同样,当一个业务的数据规模达到一定的量级后,必然会涉及到水平拆分和垂直拆分的问题,针对这些拆分的数据需要处理时,就需要链接多个store进行处理,消费的位点就会变成多份,而且数据消费的进度无法得到尽可能有序的保证。 所以,在一定业务场景下,需要将拆分后的增量数据进行归并处理,比如按照时间戳/全局id进行排序归并. EventStore设计 eventStore 用来存储filter过滤后的数据,canal目前的数据只在这里存储,工作流程如下 目前仅实现了Memory内存模式,后续计划增加本地file存储,mixed混合模式 借鉴了Disruptor的RingBuffer的实现思路 定义了3个cursor Put : Sink模块进行数据存储的最后一次写入位置 Get : 数据订阅获取的最后一次提取位置 Ack : 数据消费成功的最后一次消费位置 借鉴Disruptor的RingBuffer的实现,将RingBuffer拉直来看: 实现说明: Put/Get/Ack cursor用于递增,采用long型存储 buffer的get操作,通过取余或者与操作。(与操作: cusor & (size - 1) , size需要为2的指数,效率比较高) metaManager metaManager 用来存储一些原数据,比如消费到的游标,当前活动的server等信息 alarmHandler alarmHandler 报警,这个一般情况下就是错误日志,理论上应该是可以定制成邮件等形式,但是目前不支持 各个组件目前支持的类型 canal采用了spring bean container的方式来组装一个canal instance ,目的是为了能够更加灵活。 canal通过这些组件的选取可以达到不同使用场景的效果,比如单机的话,一般使用file来存储metadata就行了,HA的话一般使用zookeeper来存储metadata。 eventParser eventParser 目前只有三种 MysqlEventParser 用于解析mysql的日志 GroupEventParser 多个eventParser的集合,理论上是对应了分表的情况,可以通过这个合并到一起 RdsLocalBinlogEventParser 基于rds的binlog 的复制 eventSink eventSink 目前只有EntryEventSink 就是基于mysql的binlog数据对象的处理操作 eventStore eventStore 目前只有一种 MemoryEventStoreWithBuffer,内部使用了一个ringbuffer 也就是说canal解析的数据都是存在内存中的,并没有到zookeeper当中。 metaManager metaManager 这个比较多,其实根据元数据存放的位置可以分为三大类,memory,file,zookeeper Canal-HA机制 canal是支持HA的,其实现机制也是依赖zookeeper来实现的,用到的特性有watcher和EPHEMERAL节点(和session生命周期绑定),与HDFS的HA类似。 canal的ha分为两部分,canal server和canal client分别有对应的ha实现 canal server: 为了减少对mysql dump的请求,不同server上的instance(不同server上的相同instance)要求同一时间只能有一个处于running,其他的处于standby状态(standby是instance的状态)。 canal client: 为了保证有序性,一份instance同一时间只能由一个canal client进行get/ack/rollback操作,否则客户端接收无法保证有序。 server ha的架构图如下 大致步骤: canal server要启动某个canal instance时都先向zookeeper_进行一次尝试启动判断_(实现:创建EPHEMERAL节点,谁创建成功就允许谁启动) 创建zookeeper节点成功后,对应的canal server就启动对应的canal instance,没有创建成功的canal instance就会处于standby状态。 一旦zookeeper发现canal server A创建的instance节点消失后,立即通知其他的canal server再次进行步骤1的操作,重新选出一个canal server启动instance。 canal client每次进行connect时,会首先向zookeeper询问当前是谁启动了canal instance,然后和其建立链接,一旦链接不可用,会重新尝试connect。 Canal Client的方式和canal server方式类似,也是利用zookeeper的抢占EPHEMERAL节点的方式进行控制. canal的工作过程 dump日志 启动时去MySQL 进行dump操作的binlog 位置确定 工作的过程。在启动一个canal instance 的时候,首先启动一个eventParser 线程来进行数据的dump 当他去master拉取binlog的时候需要binlog的位置,这个位置的确定是按照如下的顺序来确定的(这个地方讲述的是HA模式哈)。 在启动的时候判断是否使用zookeeper,如果是zookeeper,看能否拿到 cursor (也就是binlog的信息),如果能够拿到,把这个信息存到内存中(MemoryLogPositionManager),然后拿这个信息去mysql中dump binlog 通过1拿不到的话(一般是zookeeper当中每一,比如第一次搭建的时候,或者因为某些原因zk中的数据被删除了),就去配置文件配置当中的去拿,把这个信息存到内存中(MemoryLogPositionManager),然后拿这个信息去mysql中dump binlog 通过2依然没有拿到的话,就去mysql 中执行一个sql show master status 这个语句会显示当前mysql binlog最后位置的信息,也就是刚写入的binlog所在的位置信息。把这个信息存到内存中(MemoryLogPositionManager),然后拿这个信息去mysql中dump binlog。 后面的eventParser的操作就会以内存中(MemoryLogPositionManager)存储的binlog位置去master进行dump操作了。 mysql的show master status 操作 COPYmysql> show master status\G *************************** 1. row *************************** File: mysql-bin.000028 Position: 635762367 Binlog_Do_DB: Binlog_Ignore_DB: Executed_Gtid_Set: 18db0532-6a08-11e8-a13e-52540042a113:1-2784514, 318556ef-4e47-11e6-81b6-52540097a9a8:1-30002, ac5a3780-63ad-11e8-a9ac-52540042a113:1-5, be44d87c-4f25-11e6-a0a8-525400de9ffd:1-156349782 1 row in set (0.00 sec 归集(sink)和存储(store) 数据在dump回来之后进行的归集(sink)和存储(store) sink操作是可以支撑将多个eventParser的数据进行过滤filter filter使用的是instance.properties中配置的filter,当然这个filter也可以由canal的client端在进行subscribe的时候进行设置。如果在client端进行了设置,那么服务端配置文件instance.properties的配置都会失效 sink 之后将过滤后的数据存储到eventStore当中去。 目前eventStore的实现只有一个MemoryEventStoreWithBuffer,也就是基于内存的ringbuffer,使用这个store有一个特点,这个ringbuffer是基于内存的,大小是有限制的(bufferSize = 16 * 1024 也就是16M),所以,当canal的客户端消费比较慢的时候,ringbuffer中存满了就会阻塞sink操作,那么正读取mysql binlog的eventParser线程也会受阻。 这种设计其实也是有道理的。 因为canal的操作是pull 模型,不是producer push的模型,所以他没必要存储太多数据,这样就可以避免了数据存储和持久化管理的一些问题。使数据管理的复杂度大大降低。 上面这些整个是canal的parser 线程的工作流程,主要对应的就是将数据从mysql搞下来,做一些基本的归集和过滤,然后存储到内存中。 binlog的消费者 canal从mysql订阅了binlog以后主要还是想要给消费者使用。那么binlog是在什么时候被消费呢。这就是另一条主线了。就像咱们做一个toC的系统,管理系统是必须的,用户使用的app或者web又是一套,eventParser 线程就像是管理系统,往里面录入基础数据。canal的client就像是app端一样,是这些数据的消费方。 binlog的主要消费者就是canal的client端。使用的协议是基于tcp的google.protobuf,当然tcp的模式是io多路复用,也就是nio。当我们的client发起请求之后,canal的server端就会从eventStore中将数据传输给客户端。根据客户端的ack机制,将binlog的元数据信息定期同步到zookeeper当中。 canal的目录结构 配置父目录: 在下面可以看到 COPYcanal ├── bin │ ├── canal.pid │ ├── startup.bat │ ├── startup.sh │ └── stop.sh └── conf ├── canal.properties ├── gamer ---目录 ├── ww_social ---目录 ├── wother ---目录 ├── nihao ---目录 ├── liveim ---目录 ├── logback.xml ├── spring ---目录 ├── ym ---目录 └── xrm_ppp ---目录 这里是全部展开的目录 COPYcanal ├── bin │ ├── canal.pid │ ├── startup.bat │ ├── startup.sh │ └── stop.sh └── conf ├── canal.properties ├── game_center │ └── instance.properties ├── ww_social │ ├── h2.mv.db │ ├── h2.trace.db │ └── instance.properties ├── wwother │ ├── h2.mv.db │ └── instance.properties ├── nihao │ ├── h2.mv.db │ ├── h2.trace.db │ └── instance.properties ├── movie │ ├── h2.mv.db │ └── instance.properties ├── logback.xml ├── spring │ ├── default-instance.xml │ ├── file-instance.xml │ ├── group-instance.xml │ ├── local-instance.xml │ ├── memory-instance.xml │ └── tsdb │ ├── h2-tsdb.xml │ ├── mysql-tsdb.xml │ ├── sql │ └── sql-map └── ym └── instance.properties Canal应用场景 同步缓存redis/全文搜索ES canal一个常见应用场景是同步缓存/全文搜索,当数据库变更后通过binlog进行缓存/ES的增量更新。当缓存/ES更新出现问题时,应该回退binlog到过去某个位置进行重新同步,并提供全量刷新缓存/ES的方法,如下图所示。 下发任务 另一种常见应用场景是下发任务,当数据变更时需要通知其他依赖系统。其原理是任务系统监听数据库变更,然后将变更的数据写入MQ/kafka进行任务下发,比如商品数据变更后需要通知商品详情页、列表页、搜索页等先关系统。这种方式可以保证数据下发的精确性,通过MQ发送消息通知变更缓存是无法做到这一点的,而且业务系统中不会散落着各种下发MQ的代码,从而实现了下发归集,如下图所示。 数据异构 在大型网站架构中,DB都会采用分库分表来解决容量和性能问题,但分库分表之后带来的新问题。比如不同维度的查询或者聚合查询,此时就会非常棘手。一般我们会通过数据异构机制来解决此问题。 所谓的数据异构,那就是将需要join查询的多表按照某一个维度又聚合在一个DB中。让你去查询。canal就是实现数据异构的手段之一。 本文由传智教育博学谷狂野架构师教研团队发布。 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。 转载请注明出处!

优秀的个人博客,低调大师

全新的eMPP(Elastic MPP),超越MPP的超弹性架构

“大数据时代”的概念最早由著名咨询公司麦肯锡提出。麦肯锡表示:”数据已渗透到今天的每个行业和业务功能领域,并已成为重要的生产要素。” 数据在精巧的算法中被挖掘,数据分析变得至关重要,大家开始达成一个共识:”数据计算,能够找到新发现。” 博思艾伦咨询公司的合伙人 Josh Suillivan 在其著作《数字时代的企业进化》一书中提到,其团队研究了数百个组织,提炼出构成未来成功组织模型的要素,这类成功组织被称为”数据公司”。而进化成”数字公司”的关键,是”组织是由数据驱动的”。 在大数据时代,企业不再随便删除数据,而是希望把数据存储起来用于分析。数据库也成为了企业基础架构必不可少的一部分。 什么是MPP? MPP(Massive Parallel Processing,大规模并行处理),一直被誉为当今数据库的主流架构,被广泛用于众多数据库产品中,包括Greenplum、Teradata、Vertica等。MPP数据库是针对分析工作负载进行了优化的数据库,以满足用户聚合和处理大型数据集的需求。 MPP分析型数据库将任务并行的分布到多个服务器和节点上,并在完成计算后,将结果返回并汇总,从而完成对海量数据的分析处理。 MPP数据库的优势 MPP数据库集群有可扩展性、高可用性、高性能等众多优势。MPP数据库的诞生解决了单个SQL数据库无法存放海量数据,很难在一台物理机器上完成分析需求的难题。 海量数据处理能力 MPP架构的数据库以PC服务器为单位,通过如下图所示的集群方式来扩展存储和计算。假设一个宽表有3亿条记录,MPP数据库会尝试在每台PC服务器的硬盘上分布1亿条记录。数据计算时,所有机器同时并行计算,理论上最高可以把计算时间降低到单机部署的1/n(n为机器数量),节省了海量数据的处理时间。 对SQL的完美兼容 大部分传统MPP数据库均实现了对SQL的完美兼容,包括ANSI SQL 2008标准,以及 SQL 2003 OLAP 扩展。对SQL的全面支持使得MPP数据库可以无缝集成业内常见的提取/转换/加载(ETL)和BI(商业智能)工具,完全支持和认证标准数据库接口。企业只需安排少量的集成工作,就可以使用现有的使用标准 SQL 结构和接口的分析工具让应用在 数据库上运行,从而避免了企业受制于供应商,帮助企业在抑制业务风险的同时推动创新。 计算的高度并行化 MPP架构给数据库的高并发性带来了极大的弹性。架构赋予数据库数据和查询的自动并行化能力,数据可以做到自动在数据库的所有节点上分区,并以高度协调的方式使用所有节点来规划和执行查询。企业可以根据自身的并发需求扩展集群,达到所需的并发需求。 水平扩展能力 MPP数据库具有良好的水平扩展能力,企业可以根据业务需求,通过增加服务器,用更多的节点支撑更大的分析需求。 传统MPP数据库的瓶颈 虽然MPP数据库有众多优势,因而成为众多分析型数据库产品的主流架构。然而,传统MPP数据库也有众多瓶颈和限制。 存算耦合 传统数据仓库的计算和存储是紧密耦合的,计算资源和存储资源按某一比例强绑定,因此用户在扩容时,必须同时扩容计算资源和存储资源,在扩容、运维、迁移上都存在一定的挑战。企业业务发展的不确定性,当企业遇到负载高峰时刻,传统数据仓库无法及时扩资源,可能会导致大数据系统无法及时分析业务数据,错失了充分挖掘数据价值所带来的商业机会。 业务受限 传统的 MPP 数据库虽然实现了水平扩展,但是由于存算耦合,水平扩展流程复杂且缓慢。随着用户的数据规模增长,每次扩缩容进行增加节点的操作时,大量的I/O请求会影响业务的处理速度,对业务的持续性会造成一定的影响。当用户负载突然增大时,无法迅速提高算力以响应业务变化,在负载降低时也无法收缩以节约成本。存算的紧密耦合,导致用户无法根据实际需求申请资源,动态扩展,导致用户的业务受限。 成本高昂 传统数据库价格高昂的软硬件导致巨大的前期投入。随着存储和工作负载需求的日益增长,面临数据库的扩容和升级时,由于传统MPP数据库架构存储和计算的紧密耦合,往往需要企业花费巨大的运维和时间成本,且操作繁琐。 木桶效应 传统MPP数据库架构存在”木桶效应”,数据库整体执行速度取决于最”短板”单机(Straggler)的性能。单机故障会”拖垮”整个数据库的性能,导致查询速度变慢。 因此传统的MPP架构往往要求新增的PC机和之前的PC机是一样的老配置,不然任何一个集群的”短板”就会影响整个数据库的性能,也就说摩尔定理不管多厉害,MPP集群拿老机器的存储和性能”一刀切”而取低值。 数据孤岛 随着业务的发展,数据量的增加,和信息化建设的需求,企业会为不同部门建设相应的业务信息化系统。然而MPP的水平”扩展“能力和事实上的”静态“项目实施是矛盾的。“扩展”理论上是和时间关联的一个概念,而基于PC机的MPP设计并不是”时间的朋友“。由于前面提到的存算耦合和”木桶效应”,企业在购买新机器的时候,往往会选择”另起炉灶”,新建一个集群,从而造成”数据孤岛”,严重阻碍了企业实现大数据目标。 全新的eMPP:传统MPP数据库的进阶版 面对传统MPP数据库的短板,OpenPie 团队打造的云原生数据库 PieCloudDB,创造了全新的eMPP分布式架构,构建以云原生、分析型分布式数据库为引擎数据计算平台。 什么是eMPP? eMPP由OpenPie团队打造,全称是 Elastic Massive Parallel Processing(Elastic MPP,弹性大规模并行计算)。 eMPP超越传统MPP架构,更符合云时代的需求。云平台在信息技术发展过程中具有划时代意义,它带给用户的不仅仅是快捷和便利,更是极大的灵活性和可配置性。用户可以自行定义云主机的配置,定义云主机的数量等,并且可以便捷的增加和删除云主机。一句话来说,云平台给企业应用架构带来了极大的弹性。 MPP架构和云平台相结合,就诞生了eMPP。为了适应云平台的弹性,新的eMPP架构实现了云上存储计算分离。也就是说,计算资源和存储资源可以在云上实现独立的进行水平扩展。 eMPP的优势 存算分离赋予 eMPP 数据库 ”真正” 的弹性。eMPP架构继承了前文中提到的MPP数据库所有优势,并从根本上规避了传统MPP数据库的缺陷,拥有众多优势。 弹性扩展 基于云计算平台、存算分离的eMPP(弹性大规模并行计算)架构赋予数据库多维度、智能弹性扩展能力,让用户能够根据业务需求进行横向或纵向的弹性伸缩。 存储侧支持标准对象存储,可以充分利用云计算平台的优势,让对象存储接近无限的容量,避免了企业对集群进行扩容时,因计算资源和存储资源的绑定而造成的资源浪费,可单独进行计算或者存储资源的扩展,存储扩容性价比高。 计算侧在设计上充分考虑无状态实现,计算节点可以充分利用云平台海量的计算节点池,可以按需扩容和缩容。企业可以灵活考虑业务和数据量的变化,动态调整 数据库集群中计算节点的数量,用最适合的资源量来满足其业务需求。 灵活敏捷 eMPP架构计算和存储分离,避免了资源的浪费。企业可根据对资源的需求,灵活的以低成本和高效的方式,单独地进行存储或计算资源的弹性扩展,提高了资源的利用率,节省空间成本和能耗开销。 降本增效 eMPP架构带来的动态扩展能力,企业可根据自己对资源的需求进行扩展,避免了资源的浪费,相比于传统数据库,具有更高的性价比。 高可用性 eMPP架构中,计算节点不存储用户数据,保证了计算节点的无状态性。无状态的计算节点启动和停止非常容易,企业可以根据自身的需求启动足够的冗余计算节点保证eMPP数据库的高可用性。在 eMPP 数据库 中,用户数据存储在云计算平台的对象存储中,充分利用云存储的优势保障用户数据高可用性。 PieCloudDB Database:基于云计算的全新 eMPP 架构 PieCloudDB,采用基于云计算的全新 eMPP(Elastic MPP)弹性并行计算架构,集成了MPP数据库的众多优点,并完美解决了基于PC的传统MPP数据库的缺陷。计算和存储分离。存储和计算作为两个独立变量,可以在云端进行独立的弹性伸缩,避免了资源的浪费。企业可根据业务对资源的需求,灵活的以低成本和高效的方式,单独地进行存储或计算资源的弹性扩展,提高了资源的利用率,节省空间成本和能耗开销。 元数据-计算-数据分离的三层独立架构让 PieCloudDB 实现了将数据集中存储,而元数据独立存储。企业可以像管理商品数据一样来管理自己的数据产品的元数据。企业可以将所有数据在云中存储,为已有和未来的应用真正实现数据共享。

优秀的个人博客,低调大师

每日一博 | 超详细的 Angular 国际化方案

第一次在 Angular 框架上落地国际化方案,将 Eoapi 的经验分享给大家~ 1. 项目背景 需要支持 Web 和 Electron 桌面端 技术栈 Angular 14 Electron 19 NG-ZORR 13.0.6 2. 可能遇到的困难 各语言下样式不统一,例如阿拉伯文字展示从右到左,英文比中文长等等 变量本地化,例如初始化 API 数据、日志、时间戳、金额等单位 翻译成本高 协作流程复杂 技术标准的制定、落地 3. 调研 3.1 结论 先上表格看结论,满分三颗星,最终选定 I18n 方案。 一直在运行时语言包和编译手段两种方案徘徊,最后还是选定了使用 I18n 方案,有以下几点考虑: 对代码侵入性低,不影响现有开发模式 方案成熟,经过 angular 团队/社区验证,提前考虑到了各种条件 生成的文件 xlf 遵循国际规范 XLIFF,较通用,即使技术变迁,语言包仍通用 虽然无法支持同一个 URL 动态切换语言包,多套代码方案在桌面端实现不常规(可能需要把各种语言的安装包打进去),但考虑需求上切换语言包是一个超低频的操作以及使用编译手段可以提高良好的开发体验,还是为 i18n 方案所折服。 其实无论是运行时方案和编译手段,只要官方支持,完全可以实现相互转换,期待后续 Angular 支持将语言包反向编译成代码后支持动态切换语言包,那就是我理想中的完美方案了。 3.2 分析 3.2.1 在线翻译 API切换语言包的时候再调用 OpenAPI 翻译当前页面,类似于 google 翻译。 实现难度一般,只要实现了此工具,可以兼容各种语言。 翻译 API 不一定稳定,同时免费的有次数限制,适合表达精确度要求不高,需要支持多语言的静态页。 3.2.2 自研语言编译器 使用编译手段提取,例如识别到代码中的中文,提取出来成为语言包,打包的时候 感兴趣可以看这篇,原理类似:https://juejin.cn/post/6844904042489970695#heading-3 不改变原有开发的模式,没有学习成本。 对代码有一定的侵入性,同时针对不同母语的代码有不同的语言匹配规则。 自研的实现成本较高,可能无法配合市面上热门翻译平台打通流程,工具生态成熟需要时间沉淀。 3.2.3 Angular I18n 方案https://angular.cn/guide/i18n-overview 和自研编译提取语言文本类似,使用一些标识符标记哪些字段需要翻译,同时提供一些额外的附加规则,例如同词不同含义的标记。 较为成熟,代码侵入性低,有一定的开发学习成本。 官方文档推荐的实践都是不同的语言包打包成不同的代码,然后通过 nginx 映射到不同的代码,这适合 web,但在桌面端实现比较麻烦,无法动态加载文件。 理想情况是 angular 方案下支持一套代码加载语言包的国际化方案(one bundle for all languages),官方关于动态切换语言包的讨论: https://github.com/angular/angular/issues/24549#issuecomment-398371120 https://github.com/angular/angular/issues/38953#issuecomment-862492065 截至本方案完成,Angular 只支持打包成多种语言包文件,动态切换语言包目前处于提案通过阶段,未来可期。 3.2.4 运行时语言包 支持 Angular 的方案有: http://www.ngx-translate.com/ https://ngneat.github.io/transloco/docs/translation-in-the-template https://github.com/lokalise/i18n-ally 我认为这种方案最大的问题是开发体验较差,虽然很多工具可以使用 VSCode 插件显示【默认语言文本】抹平差异,但源码仍然是各种变量。 其次是切换语言包是一个低频操作,一般用户长期只会选择一种语言包,运行时方案也会增加不必要的内存占用(当然你要说可以忽略不计那我也不和你辩,算你赢)。 3.2.5 多套代码 没什么技术难点,同步成本高,灵活性高。 4. 技术实现 以下代码配置的源码都在这个仓库,有需要可以拉下来部署看看具体效果。 https://github.com/eolinker/eoapi 国际化主要分为几个流程: 4.1 语言包 4.1.1 语言包配置 4.1.1.1 命令行配置 使用 angular 提供的指令 ng extract-i18n ,同时制定语言包生成的目录 src/locale ng extract-i18n --output-path src/locale 运行后就会生成一个默认语言包 message.xlf 建议使用如下 npm 命令封装,运行 npm run lang:gen 即可生成语言包文件 "scripts": { "lang:gen": "ng extract-i18n --output-path src/locale", .... **4.1.1.2 angular.json ** 配置想要加其他语言包,从默认语言包 message.xlf 复制一个文件,然后配置一下就可以支持多语言。 文件名语言 ID 命名请参考(en-US、zh-Hans) 在 angular.json 中告诉构建工具你语言包叫啥,位置在哪 { ... "projects": { "eoapi": { ... "i18n": { "sourceLocale": "zh-Hans",//中文语言包 "locales": { "en-US": "src/locale/messages.en-US.xlf"//英文语言包 } }, 4.1.1.3 Ant-Design 配置 https://ng.ant.design/docs/i18n/zh /** 导入需要使用的语言包 **/ import { LOCALE_ID } from '@angular/core'; import { registerLocaleData } from '@angular/common'; import en from '@angular/common/locales/en'; import zh from '@angular/common/locales/zh'; registerLocaleData(en); registerLocaleData(zh); /** 配置 ng-zorro-antd 国际化 **/ import { en_US, NZ_I18N, zh_CN } from 'ng-zorro-antd/i18n'; ... { provide: NZ_I18N, useFactory: (localId: string) => { switch (localId) { case 'zh': return zh_CN; default: return en_US; } }, deps: [LOCALE_ID], } 4.1.2 调试 官方原话:由于 i18n 的部署复杂性和最小化重建时间的需要,开发服务器一次仅支持本地化单个语言环境 我来翻译一下:你这需求也不常见,实现太麻烦了,你调试麻烦点就麻烦点吧,构建时间多快呀,我是为你好。 总而言之就是 Angular 调试时只会支持一种语言包,同时意味着你没法直接运行时测试切换语言包的效果(当然可以通过运行两个服务间接实现),关系不大。 你可以使用下面两种配置进行调试: 调试时可以通过设置 "localize":false 在调试时禁用本地化 "architect": { "build": { "builder": "@angular-builders/custom-webpack:browser", "options": { "localize":false, "aot":true,//本地化一定要开启 AOT ... angular.json指定使用某种语言包 { ... "projects": { "eoapi": { ... "architect": { "build": { "options": { "localize":true,//开启本地化 "aot": true, ... }, "configurations": { "web": { //指定某个运行环境下的语言包,传入上面 i18n 定义的语言包名称 "localize": ["zh-Hans"], ... } } }, "serve": { ... "configurations": { "web": { "browserTarget": "eoapi:build:web" } ... 运行时使用命令制定使用 --configuration web 即可 ng serve -c web -o 4.1.3 构建 Angular i18n 方案会打包成两个文件夹,所以需要注意资源在代码里面的相对地址。 4.1.3.1 web 和之前区别不大,主要是通过 index.html 里面的 <base> 标签来指定基础路径,打包后的代码结果如图: 英语语言包的 href="en-US" !DOCTYPE html><html lang="en-US" dir="ltr"><head> <meta charset="utf-8"> <title>Eoapi</title> <base href="/en-US/"> <meta name="viewport" content="width=device-width, initial-scale=1"> <script src="https://lf1-cdn-tos.bytegoofy.com/obj/iconpark/icons_12799_18.e98aaa4d03d4378a3a2c18bfd1670872.js"></script> ... 4.1.3.2 桌面端 Electron 启动需要指定语言 https://github.com/electron/electron/issues/5649 桌面端使用 file 协议,需要将 base href 改成相对路径 ./。 即使使用 ng build --base-href ./,打包后还是会自动在 href 前加语言标识 <base href="./en-US/"> 所以需要在 angular.json 18n 指定 baseHref 为空字符串 "projects": { "eoapi": { "root": "", "i18n": { "sourceLocale": { "code": "zh-Hans", "baseHref": ""//. }, "locales": { "en-US": { "baseHref": "", "translation": "src/locale/messages.en-US.xlf" } } }, 4.1.3.3 Build.js 命令 一般情况下 Angular 框架会帮我们处理好,但是我们产品涉及到 Web 和桌面端,有两套打包逻辑,所以使用了 Node 脚本去执行 Build 命令,在执行 ng build 命令前修改 angular.json 文件。 //change angular.json const fs = require('fs'); const { execSync } = require('child_process'); class webPlatformBuilder { resetBuildConfig(json) { delete json.projects.eoapi.i18n.sourceLocale.baseHref; Object.keys(json.projects.eoapi.i18n.locales).forEach((val) => { delete json.projects.eoapi.i18n.locales[val].baseHref; }); return json; } executeBuild() { execSync('ng build -c production', { stdio: 'inherit' }); } } class appPlatformBuilder { resetBuildConfig(json) { ... } executeBuild() { ... } } class PlatformBuilder { constructor(platForm) { switch (platForm) { case 'web': { this.instance = new webPlatformBuilder(); break; } case 'app': { this.instance = new appPlatformBuilder(); break; } } } build() { const filePath = '../angular.json'; let buildConfigJson = require(filePath); buildConfigJson = this.instance.resetBuildConfig(buildConfigJson); let that=this; fs.writeFile(filePath, JSON.stringify(buildConfigJson), function (err) { if (err) { console.error('build/beforeBuild.js:', err); } that.instance.executeBuild(); }); } } 4.1.4 部署 4.1.4.1 Vercel vercel 不支持多项目配置,所以只能重定向到固定 Language 而不是用户配置的 Language。 { "rewrites": [ { "source": "/:path((?!en/).*)", "destination": "/en/:path*" }, { "source": "/:path((?!zh/).*)", "destination": "/zh/:path*" } ] } 这个方案表现还是不好,拿不到一些初始化的路由信息,所以我手动写了个脚本生产空白 HTML,再手动重定向到相应位置。 fs.writeFile( './dist/index.html', `<!DOCTYPE html> <html> <head> <meta charset="utf-8" /> <title>Eoapi - Easy &amp; Open Source API Ecosystem</title> <script> let lang=window.location.href.includes("/en")?'en':'zh'; try{ lang=JSON.parse(window.localStorage.getItem("LOCAL_SETTINGS_KEY"))["eoapi-language"]=='en-US'?'en':'zh'; }catch(e){ } let baseDir="/"+lang+'/' let search={}; if(window.location.search){ window.location.href=baseDir+window.location.search; }else{ window.location.href=baseDir; } </script> </head> <body></body> </html> `, () => {} ); 4.1.4.2 Nginx 如果使用 Nginx 部署,可以按照官方提供的文件配置。 https://angular.cn/guide/i18n-common-deploy#configure-a-server 4.2 翻译流程工具调研 https://github.com/alibaba/kiwi https://github.com/mozilla/pontoon/(开源) https://www.volcengine.com/product/i18ntranslate 4.2.1 Poeditor https://poeditor.com 免费,体验一般,数据没有丢失,协作流程不够清晰,自动翻译用不了 4.2.2 Crowdin(electron 官方使用) https://zh.crowdin.com/ 体验好,协作清晰,但未来可能付费 5. 结语 整个 Angular 落地国际化的方案讲完了,国际化不止涉及到技术实现,还包括翻译协作流程,如图是一个常见的翻译流程: 以及整个技术团队的国际化技术规范,毕竟翻译不止涉及到 UI,还有各种时间数据储存的格式等等数据规范。 感谢你的阅读,上面实践都落地到开源项目 Eoapi,欢迎关注~[在线体验功能] (https://www.eoapi.io/?utm_source=OS0903) Github:https://github.com/eolinker/eoapi Gitee: https://gitee.com/eolink_admin/eoapi 6. 资料 Angular 项目 国际化方案设计以人为本的国际化(i18n) 工程方案 国际化与本地化 前端国际化 Angular internationalization (i18n) tutorial - Localizely https://cloud.tencent.com/developer/section/1489559 Taobao FED | 淘系前端团队

优秀的个人博客,低调大师

超详细maven的卸载、重新安装与配置

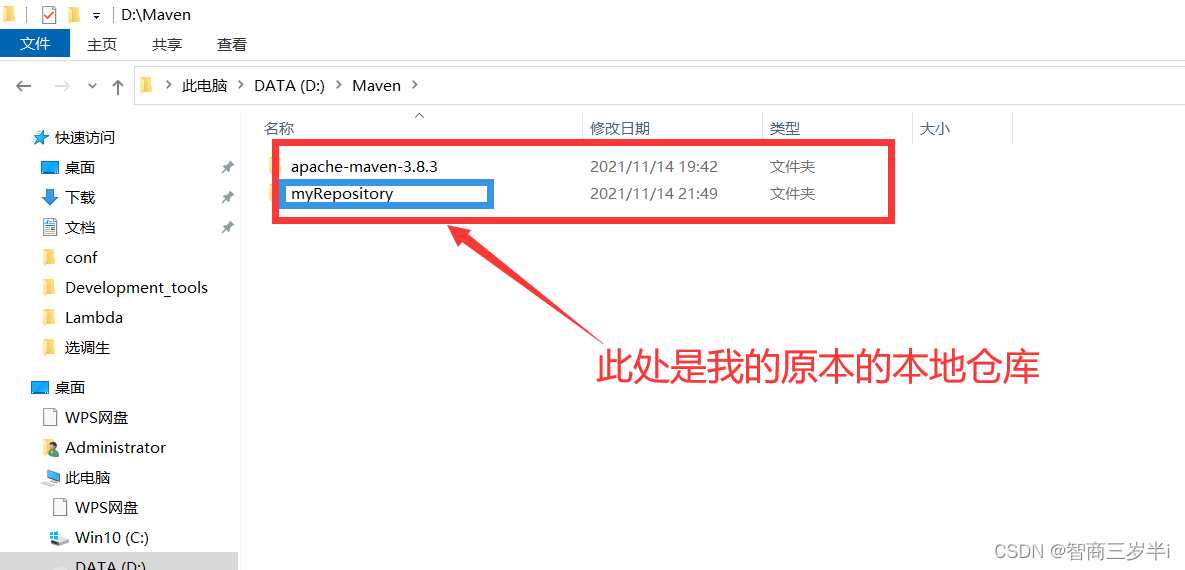
镜像下载、域名解析、时间同步请点击 阿里巴巴开源镜像站 一、maven的卸载 maven在使用时只是配置了环境变量和本地仓库,我们只需要删除本地仓库,在环境变量中移除maven的环境变量。 1.删除解压的maven文件夹; 在之前的安装中,我将本地仓库和maven解压后的文件放在同一个文件夹下。 此时删除Maven文件夹即可 2.删除设置的环境变量MAVEN_HOME,删除path里添加的 “ %MAVEN_HOME%\bin; ”; 删除Path中的 %MAVEN_HOME%\bin; 后面的窗口全部点:确定!!!(否则可能会不生效,删除不成功) 3.删除本地仓库; 我们在第一步已经删除了本地仓库,根据之前的配置的本地仓库的位置删除即可,若没有配置,则默认在:C:\Users\Administrator.m2\repository路径下,将名为:repository的文件夹删除即可。 删除repository 至此,maven已经全部删除成功!!! 接下来开始maven的重新安装和配置。 二、maven的下载 1.进入官网下载:maven官网下载 2.下翻找到Download,如果是需要最新版,选择apache-maven-3.8.4-bin.zip点击就可以下载。 (出于稳定性考虑,不推荐下载最新版,若选择下载最新版,就可以点击等待下载完成,后面的小步骤不再看) (若需要下载其他的版本,则继续看以下的小步骤) ① 下翻找到如下界面,点击: archives ② 下翻找到自己要下载的版本,点击即可 ③ 点击:binaries/ ④ 点击:apache-maven-3.8.1-bin.zip ,等待下载完成。 三、配置maven环境变量 1.解压到指定的文件夹下,解压完成是这样: 2.配置环境变量 ① 此电脑—>属性—>高级系统设置—>环境变量 ② 选择系统变量,点击:新建 ③ 输入变量名和变量值 变量名:MAVEN_HOME 变量值:D:\Environment\maven-3.8.1\apache-maven-3.8.1 (变量名为MAVEN_HOME,变量值就是安装路径,就是第一步时的路径) ④ 配置Path,双击打开Path—>新建 ⑤ 输入:%MAVEN_HOME%\bin 3.测试环境变量配置是否成功 ① 打开cmd,以管理员身份运行 ② 输入:mvn -v 若出现maven的版本信息,证明配置成功。若不成功,仔细检查一下上述环境变量的配置是否正确。 四、配置maven本地仓库 1.在maven的安装目录下,创建一个名为myRepository的文件夹。 2.修改settings.xml配置文件,位置在\conf目录下。 ① 使用记事本打开settings.xml,将文件中的所有信息替换为如下,并保存后退出: (注意: D:/Environment/maven-3.8.1/myRepository中间的路径是之前创建的本地仓库的位置,根据实际改成自己的仓库位置,路径的分隔符改为/ ) <?xml version="1.0" encoding="UTF-8"?> <settings xmlns="http://maven.apache.org/SETTINGS/1.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/SETTINGS/1.0.0 http://maven.apache.org/xsd/settings-1.0.0.xsd"> <!-- <localRepository>/Users/Fred/Downloads/apache-maven-3.5.4/repository</localRepository> --> <localRepository>D:/Environment/maven-3.8.1/myRepository</localRepository> <pluginGroups> </pluginGroups> <proxies> </proxies> <servers> </servers> <mirrors> <mirror> <id>alimaven</id> <name>aliyun maven</name> <url>http://maven.aliyun.com/nexus/content/groups/public/</url> <mirrorOf>central</mirrorOf> </mirror> <mirror> <id>aliyun</id> <mirrorOf>central</mirrorOf> <name>aliyun-public</name> <url>https://maven.aliyun.com/repository/public/</url> </mirror> <mirror> <id>aliyun-spring</id> <mirrorOf>spring</mirrorOf> <name>aliyun-spring</name> <url>https://maven.aliyun.com/repository/spring</url> </mirror> <!-- 中央仓库在中国的镜像 --> <mirror> <id>maven.net.cn</id> <name>one of the central mirrors in china</name> <url>http://maven.net.cn/content/groups/public/</url> <mirrorOf>central</mirrorOf> </mirror> <!-- 中央仓库1 --> <mirror> <id>repo1</id> <mirrorOf>central</mirrorOf> <name>Human Readable Name for this Mirror.</name> <url>https://repo1.maven.org/maven2/</url> </mirror> </mirrors> <profiles> <profile> <id>jdk-1.8</id> <activation> <activeByDefault>true</activeByDefault> <jdk>1.8</jdk> </activation> <properties> <maven.compiler.source>1.8</maven.compiler.source> <maven.compiler.target>1.8</maven.compiler.target> <maven.compiler.compilerVersion>1.8</maven.compiler.compilerVersion> </properties> </profile> </profiles> <activeProfiles> <activeProfile>jdk-1.8</activeProfile> </activeProfiles> </settings> 修改完记得保存,然后退出!!! 3.打开cmd,执行:mvn help:system 此时本地仓库就会从中央仓库下载需要的文件。 下载过程根据网速会有所不同,耐心等待即可,直至出现BUILD SUCCESS则证明下载完成!!! 打开本地仓库可以看查看,已经下载了一些文件。 本文转自:https://blog.csdn.net/weixin_46081857/article/details/121719684

优秀的个人博客,低调大师

超6100万可穿戴设备用户信息被曝光

随着更多的设备连接到互联网,不断存储和分享信息,数据安全已经成为一个长期关注的问题。网络安全研究员 Jeremiah Fowler 在 WebsitePlanet 上发布报告,表示由于一个集中式数据库并未受到保护,有超过 6100 万可穿戴设备的用户数据在网络上曝光。 Fowler 和他的团队通过扫描分析,发现 GetHealth 的数据库存在暴露风险。这是一个为从数百个可穿戴设备、医疗设备和应用程序访问健康和保健数据的统一解决方案的 API。 进一步的调查显示,这些数据包含潜在的敏感信息,包括人们的姓名、出生日期、体重、身高、性别,甚至地理位置。此外,研究人员发现,这些信息的流向可以追溯到 Fitbit、Microsoft Band、Misfit Wearables、Google Fit 和 Strava等来源,其用户来自世界各地。所有这些信息都是以纯文本形式存储的,而一个 ID 是加密的。 在确认了数据的所有权后,福勒私下联系了GetHealth,该公司对通知的反应很快。该公司在同一天晚些时候对研究人员表示感谢,声称该问题已经解决。不过,目前还不清楚这 16.71GB 的用户数据被暴露了多长时间,甚至也不清楚在此期间谁可能访问了该数据库。

优秀的个人博客,低调大师

数据泄露平均消耗成本已超420万美元

据外媒报道,由IBM安全部委托进行的一项全球研究发现,近三年来数据泄露的平均成本已超过420万美元。该研究在2020年5月至2021年3月期间考察了全球500家机构。结果显示,有14家公司被确认遭受了重大的数据泄露,涉及1000多万条记录的泄露,造成5200万美元损失,到涉及6500多万条记录的泄露事件,损失4.01亿美元不等。 研究显示,企业识别和控制漏洞所需的天数比前一年多了7天,平均为287.7天。数据泄露的成本中值比前一年增长了大约10%,从386万美元增长到424万美元。 研究还发现,近一半的违规事件涉及到个人信息暴露。每条个人信息暴露的平均成本为180美元,而每条记录的平均总成本为161美元,这两个数字都高于前一年的中位数146美元。医疗保健行业连续11年发生了最大的数据泄露平均成本,为923万美元,高于前一年的713万美元。另一方面,能源行业的数据泄露的平均成本在同一时期从639万美元下降到465万美元。 鸿蒙官方战略合作共建――HarmonyOS技术社区 【责任编辑:赵宁宁 TEL:(010)68476606】

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册