首页 文章 精选 留言 我的

精选列表

搜索[超融合软件],共10000篇文章
优秀的个人博客,低调大师

超详细的TCP、Sokcket和SuperSocket与TCP入门指导

kiba518脚本之家 作者 |kiba518 出品 | 脚本之家(ID:jb51net) 前言 本文主要介绍TCP、Sokcket和SuperSocket的基础使用。 创建实例模式的SuperSocket服务 首先创建控制台项目,然后Nuget添加引用SuperSocket.Engine。 然后编写服务代码,SuperSocket的服务代码主要是配置AppServer对象,因为AppServer已经很好的封装端口监听了。 代码如下所示: class Program { static AppServer appServer { get; set; } static void Main(string[] args) { var serverConfig = new SuperSocket.SocketBase.Config.ServerConfig(); serverConfig.Port = 5180; serverConfig.TextEncoding = "gb2312"; serverConfig.MaxConnectionNumber = 1000; appServer = new AppServer(); //配置 if (!appServer.Setup(serverConfig)) { Console.WriteLine("配置失败!"); return; } //启动 if (!appServer.Start()) { Console.WriteLine("启动失败!"); return; } Console.WriteLine("启动成功,按Q退出!"); appServer.NewSessionConnected += new SessionHandler<AppSession>(appServer_NewSessionConnected); appServer.SessionClosed += appServer_NewSessionClosed; appServer.NewRequestReceived += new RequestHandler<AppSession, StringRequestInfo>(appServer_NewRequestReceived); while (Console.ReadKey().KeyChar != 'q') { continue; } //停止 appServer.Stop(); Console.WriteLine("服务已停止"); Console.ReadKey(); } static void appServer_NewSessionConnected(AppSession session) { var count = appServer.SessionCount; Console.WriteLine($"服务端得到来自客户端的连接成功 ,当前会话数量:" + count); //这里也可以向会话的stream里写入数据,如果在这里向流写入数据,则客户端需要在Send之前先接收一次,不然的话,Send后接收的就是这条数据了 session.Send("连接成功"); } static void appServer_NewSessionClosed(AppSession session, CloseReason aaa) { var count = appServer.SessionCount; Console.WriteLine($"服务端 失去 来自客户端的连接" + session.SessionID + aaa.ToString()+ " 当前会话数量:" + count); } static void appServer_NewRequestReceived(AppSession session, StringRequestInfo requestInfo) { Console.WriteLine($"Key:" + requestInfo.Key + $" Body:" + requestInfo.Body); session.Send("我是返回值:" + requestInfo.Body); } } AppServer:AppServer是SuperSocket中定义的Socket服务类,他替我们实现了复杂的端口监听,不用再写While循环,不用再关心线程阻塞的问题,在监听端口在这里,我们只要调用AppServer的对象的Start方法,就可以了;AppServer还提供了一个配置文件类—ServerConfig,通过它,我们可以配置具体监听的端口、并发数量、编码、最大传输字节数、传输模式(TCP/UDP)等等属性;此外还提供三个重要事件:会话连接启动事件(NewSessionConnected)、会话关闭事件(SessionClosed)、请求接受事件(NewRequestReceived)。 注:文中在连接成功的事件中,我们向客户端发送消息了,即,客户端在连接后,发送消息前,需要接收该信息。 创建TCP发送消息客户端 服务建立后,我们建立客户端。 代码如下所示: staticvoidMain(string[]args){TCPConnect("127.0.0.1",5180);Console.ReadKey();}staticvoidTCPConnect(Stringserver,Int32port){stringmessage=$"ADDkiba518518"+"\r\n";try{TcpClientclient=newTcpClient();client.Connect(server,port);Byte[]data=System.Text.Encoding.Default.GetBytes(message);StringresponseData=String.Empty;NetworkStreamstream=client.GetStream();byte[]buffer=newbyte[1024*1024*2];Int32bytes=stream.Read(buffer,0,buffer.Length);responseData=System.Text.Encoding.Default.GetString(buffer,0,bytes);Console.WriteLine("接收服务器在连接事件中写入的数据:{0}",responseData);stream.Write(data,0,data.Length);Console.WriteLine("发送数据:{0}",message);data=newByte[256];bytes=stream.Read(buffer,0,buffer.Length);responseData=System.Text.Encoding.Default.GetString(buffer,0,bytes);Console.WriteLine("接收返回值:{0}",responseData);stream.Close();client.Close();}catch(ArgumentNullExceptione){Console.WriteLine("ArgumentNullException:{0}",e.Message);}catch(SocketExceptione){Console.WriteLine("SocketException:{0}",e.Message);}Console.Read();} 代码很简单,就是使用TcpClient连接服务器的IP和端口,然后发送消息。 因为我们使用的SuperSocket,有格式要求,所以我们需要准守。 格式要求如下: 命令名称+空格+参数+参数+...参数+"\r\n" 对应的字符串如下: $"ADD kiba518 518" + "\r\n" 因为上文中,服务在连接成功后就向客户端发送的流中写入了数据,所以,我们在Send消息前,先接收一下流中的数据。 客户端与服务联调 先运行服务,在运行客户端,结果服务端与客户端成功的完成了一次通信,如下图所示: 为了更清晰的了解通信内容,我们在服务接收消息事件中断点,如下图: 可以看到参数requestInfo完整的解析了我们发送的字符串【"ADD kiba518 518" + "\r\n"】。 创建配置模式的SuperSocket服务 现在我们创建一个配置模式的SuperSocket服务,这种模式客户通过配置创建多个SuperSocket,即可以在一个项目里通过配置监听多个端口,这里,我们只做一个端口监听的配置例子。 与实例模式的开始一样,先创建一个控制台程序,然后Nuget添加引用SuperSocket.Engine。 然后进行三步操作。 一,编写Main函数,启动SuperSocket,通过启动引导工厂BootstrapFactory实例化一个启动引导对象,然后初始化化,该初始化会遍历当前项目中所有继承了AppServer的类,然后调用他们的Start方法,代码如下所示: static void Main(string[] args){ #region 初始化Socket IBootstrap bootstrap = BootstrapFactory.CreateBootstrap(); if (!bootstrap.Initialize()) { Console.WriteLine(DateTime.Now + ":Socket初始化失败\r\n"); return; } var result = bootstrap.Start(); foreach (var server in bootstrap.AppServers) { if (server.State == ServerState.Running) { Console.WriteLine(DateTime.Now + ":serverName为:" + server.Name + "Socket运行中\r\n"); } else { Console.WriteLine(DateTime.Now + ":serverName为:" + server.Name + "Socket启动失败\r\n"); } } Console.ReadKey(); #endregion} 二,修改App.config配置文件,在configuration节点下,增加superSocket的section,并配置superSocket,代码如下: <configSections><sectionname="superSocket"type="SuperSocket.SocketEngine.Configuration.SocketServiceConfig,SuperSocket.SocketEngine"/></configSections><!--配置SocketServer路径--><superSocket><servers><!--serverType属性有两个参数,第一个是服务类的完全限定名,第二个是服务类的命名空间--><servername="MySocket"textEncoding="gb2312"serverType="SuperSocketServerSessionMode.SocketServer,SuperSocketServerSessionMode"ip="Any"port="5180"maxConnectionNumber="100"></server></servers></superSocket> 三,创建SocketServer类、SocketSession类、SocketCommand类。 SocketServer类:继承泛型AppServer(其泛型类指定一个会话类)该类用于创建SuperSocket的服务并监听端口;其Setup方法,默认读取App.config配置文件中的superSocket节点—servers节点—server节点;读取时根据server的serverType属性匹配读取。 publicclassSocketServer:AppServer<SocketSession>{protectedoverrideboolSetup(IRootConfigrootConfig,IServerConfigconfig){Console.WriteLine("正在准备配置文件");returnbase.Setup(rootConfig,config);}protectedoverridevoidOnStarted(){Console.WriteLine("服务已开始");base.OnStarted();}protectedoverridevoidOnStopped(){Console.WriteLine("服务已停止");base.OnStopped();}protectedoverridevoidOnNewSessionConnected(SocketSessionsession){Console.WriteLine("新的连接地址为"+session.LocalEndPoint.Address.ToString()+",时间为"+DateTime.Now);base.OnNewSessionConnected(session);}} SocketSession类:继承AppSession,是SuperSocket的会话类。 如果客户端所发送的消息不合法,则会被会话的HandleUnknownRequest函数截获,如果合法,则发送到指定的命令类中。 代码如下: publicclassSocketSession:AppSession<SocketSession>{publicoverridevoidSend(stringmessage){Console.WriteLine("发送消息:"+message);base.Send(message);}protectedoverridevoidOnSessionStarted(){Console.WriteLine("Session已启动");base.OnSessionStarted();}protectedoverridevoidOnInit(){this.Charset=Encoding.GetEncoding("gb2312");base.OnInit();}protectedoverridevoidHandleUnknownRequest(StringRequestInforequestInfo){Console.WriteLine($"遇到未知的请求Key:"+requestInfo.Key+$"Body:"+requestInfo.Body);base.HandleUnknownRequest(requestInfo);}} SocketCommand类:是SuperSocket的命令类,定义明确的会话命令;类名即客户端发送消息的第一个空格前的字符串。 代码如下: publicclassSocketCommand:CommandBase<SocketSession,StringRequestInfo>{publicoverridevoidExecuteCommand(SocketSessionsession,StringRequestInforequestInfo){//根据参数个数或者其他条件判断,来进行一些自己的操作Console.WriteLine($"调用成功Key:"+requestInfo.Key+$"Body:"+requestInfo.Body);session.Send("已经成功接收到你的请求\r\n");}} 创建配置模式的SuperSocket客户端 创建一个配置模式的SuperSocket客户端,这一次我们使用Socket类创建。 代码如下: staticSocketsocketClient{get;set;}staticvoidMain(string[]args){socketClient=newSocket(SocketType.Stream,ProtocolType.Tcp);IPAddressip=IPAddress.Parse("127.0.0.1");IPEndPointpoint=newIPEndPoint(ip,5180);socketClient.Connect(point);Threadthread=newThread(Recive);//不停的接收服务器端发送的消息thread.Start();Threadthread2=newThread(Send);//不停的给服务器发送数据thread2.Start();}staticvoidRecive(){while(true){//获取发送过来的消息byte[]buffer=newbyte[1024*1024*2];vareffective=socketClient.Receive(buffer);if(effective==0){break;}varstr=Encoding.Default.GetString(buffer,0,effective);Console.WriteLine("服务器---"+str);Thread.Sleep(2000);}}staticvoidSend(){inti=0;intparam1=0;intparam2=0;while(true){i++;param1=i+1;param2=i+2;Console.WriteLine($"Sendi:{i}param1:{param1}param2:{param2}");stringmsg=$"SocketCommand{param1}{param2}"+"\r\n";Console.WriteLine($"msg:{msg}");varbuffter=Encoding.Default.GetBytes(msg);vartemp=socketClient.Send(buffter);Console.WriteLine($"Send发送的字节数:{temp}");Thread.Sleep(1000);}} 可以看到Socket的使用方式与Tcp的使用方式几乎相同,都是指定IP和端口号,只是Socket多了一步,需要指定协议类型ProtocolType,这里我们指定了是TCP。 客户端与服务联调 先运行服务,在运行客户端,结果通信成功,如下图所示: 到此TCP、Sokcket和SuperSocket的基本使用已经介绍完了,代码已经传到Github上了,欢迎大家下载。 Github地址:https://github.com/kiba518/SuperSocketConsole 本文作者:kiba518,.NET系统架构师 声明:本文为 脚本之家专栏作者 投稿,未经允许请勿转载。

优秀的个人博客,低调大师

我国5G网络建设累计投资超2600亿

2月23日,世界移动通信大会上海展开幕,5G发展依然是最大的关注点。会上,工信部副部长刘烈宏透露,中国在5G网络建设方面的累计投入已经超过2600亿元,已建成开通的5G基站占到全球的70%。SA独立组网模式的5G网络也已覆盖全国所有地市。 主办方全球移动通信系统协会(GSMA)大中华区总裁斯寒表示,尽管有疫情爆发,2020年中国仍新增5G基站超过60万个。根据GSMA在展会期间发布的《2021中国移动经济发展报告》,截止2020年,5G终端连接数超过2亿,占全球的87%。根据预测,到2025年,5G连接数有望达到8亿多。 刘烈宏还强调,5G赋能产业数字化发展,是5G成功商用的关键。通信运营企业以及5G应用集成方案供应商应做好协同,加强5G安全领域的国际合作,加强5G网络标准建设,践行全球数据安全倡议。加快5G应用创新,抢抓经济社会数字化、网络化、智能化发展的重大机遇。此前,工业和信息化部新闻发言人、信息通信管理局局长赵志国也曾在国新办的新闻发布会上表示,今年要重点抓好三方面工作,包括提升网络覆盖能力、应用创新能力与产业基础能力。 2019年是5G元年,工业和信息化部与国务院国有资产监督管理委员会联合发布了《关于2019年推进电信基础设施共建共享的实施意见》。其中特别强调通过电信基础设施的共建共享来促进降本增效,包括对铁塔和室内分布系统、住宅小区和商务楼宇通信配套设施、杆路和管道等设施的共建共享。2020年,工信部又发布了《关于推动5G加快发展的通知》(下称《通知》),在网络建设部署上,明确提出控制非独立组网的建设规模,支持5G独立组网。此外,《通知》中也强调要丰富5G技术应用场景,与医疗健康、工业互联网、车联网等领域结合。 相关政策的引导将为5G带来更多的发展空间和商业价值。不久前,工信部赛迪智库发布了《5G发展2021展望白皮书》,其中表示,2021年我国将持续加大5G网络投资力度,预计将是2020年的1.5-2倍。中国信息通信研究院统计数据也预计,2020-2025年期间我国5G商用将带动经济总产出10.6万亿元,直接创造经济增加值3.3万亿元。 去年初,三大电信运营商就曾提到,预计2020年在5G方面的资本开支将超过1800亿元,其中中国2020年5G资本开支预算约453亿元,中国移动2020年公司资本开支预算为1798亿元,其中5G相关投资计划为1000亿元。中国联通2020年资本开支预算为700亿元,其中5G相关投资计划约350亿元。 在去年的中国网络媒体论坛上,刘烈宏曾表示,未来3年5G仍将处于“导入期”,需保持定力,稳扎稳打。他建议坚持适度超前的建设节奏,形成“以建促用”的良性模式。伴随着技术成熟和布局推进,人工智能、物联网、大数据等技术都会进入高速发展阶段。 对此,通信专家项立刚告诉北京商报记者:“作为智能互联网的基础和底座,5G将对城市管理、移动医疗、智能家居、智慧教育等各方面产生影响。”他认为传统的4G无法满足大规模接入的需求,而5G的移动互联能力将会渗透到各个领域,推动转型升级,降低成本,提升效率,从而促进新的发展。

优秀的个人博客,低调大师

基于redis和shedlock实现分布式锁(超简单)

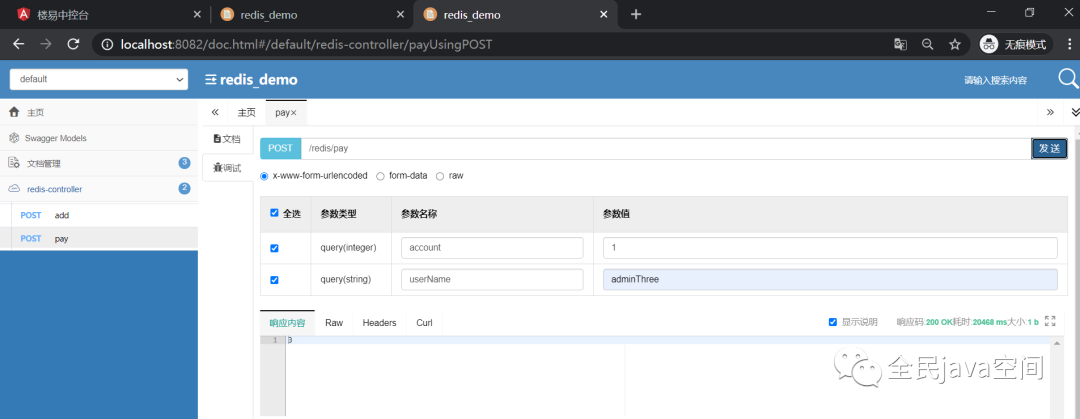
一、背景 线上部署了两台服务器,通过nginx轮询的方式进行负载均衡。但是这样存在一个问题同一个用户的session共享问题。你或许会说,使用ipHash模式就可以解决session共享的问题,是的确实可以解决这个问题,但是同样也会带来另外一个问题,就是一台服务器很繁忙,另外一台服务器闲置的情况。所以为了避免服务器闲置的现象,我们采用了ip轮询和共享session存入redis的解决方案。不过今天要讲的主题不是这个,我们在单机测试的时候完全运行正常,但是部署了到正式的环境的时候出现了客户支付金额对应不上的情况。后来经过排查发现是并发问题,虽然单机做了并发处理,但是如果有多台服务器的时候就会出现服务器之间的并发问题。所以需要引入分布式锁,解决多服务器间的。 二、分布式锁的实现 1. jar包的引入 <dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-web</artifactId></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-test</artifactId><scope>test</scope><exclusions><exclusion><groupId>org.junit.vintage</groupId><artifactId>junit-vintage-engine</artifactId></exclusion></exclusions></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-data-redis</artifactId></dependency><dependency><groupId>net.javacrumbs.shedlock</groupId><artifactId>shedlock-provider-redis-spring</artifactId><version>2.3.0</version></dependency><dependency><groupId>org.apache.commons</groupId><artifactId>commons-pool2</artifactId><version>2.0</version></dependency><dependency><groupId>net.javacrumbs.shedlock</groupId><artifactId>shedlock-spring</artifactId><version>2.3.0</version></dependency><dependency><groupId>org.projectlombok</groupId><artifactId>lombok</artifactId></dependency><!--swagger--><!--https://mvnrepository.com/artifact/io.springfox/springfox-swagger-ui--><dependency><groupId>com.github.xiaoymin</groupId><artifactId>swagger-bootstrap-ui</artifactId><version>1.9.6</version></dependency><dependency><groupId>io.springfox</groupId><artifactId>springfox-swagger2</artifactId><version>2.9.2</version></dependency><dependency><groupId>org.aspectj</groupId><artifactId>aspectjweaver</artifactId><version>1.9.2</version></dependency> 2. redis的配置 配置文件 #redisredis.host=192.168.1.6redis.password=redis.port=6379redis.taskScheduler.poolSize=100redis.taskScheduler.defaultLockMaxDurationMinutes=10redis.default.timeout=10redisCache.expireTimeInMilliseconds=1200000 配置类 packagecom.example.redis_demo_limit.redis;importio.lettuce.core.ClientOptions;importio.lettuce.core.resource.ClientResources;importio.lettuce.core.resource.DefaultClientResources;importnet.javacrumbs.shedlock.core.LockProvider;importnet.javacrumbs.shedlock.provider.redis.spring.RedisLockProvider;importnet.javacrumbs.shedlock.spring.ScheduledLockConfiguration;importnet.javacrumbs.shedlock.spring.ScheduledLockConfigurationBuilder;importorg.apache.commons.pool2.impl.GenericObjectPoolConfig;importorg.springframework.beans.factory.annotation.Value;importorg.springframework.boot.autoconfigure.condition.ConditionalOnMissingBean;importorg.springframework.context.annotation.Bean;importorg.springframework.context.annotation.Configuration;importorg.springframework.context.annotation.Primary;importorg.springframework.data.redis.connection.RedisConnectionFactory;importorg.springframework.data.redis.connection.RedisPassword;importorg.springframework.data.redis.connection.RedisStandaloneConfiguration;importorg.springframework.data.redis.connection.lettuce.LettuceConnectionFactory;importorg.springframework.data.redis.connection.lettuce.LettucePoolingClientConfiguration;importorg.springframework.data.redis.core.RedisTemplate;importjava.time.Duration;@ConfigurationpublicclassRedisConfig{@Value("${redis.host}")privateStringredisHost;@Value("${redis.port}")privateintredisPort;@Value("${redis.password}")privateStringpassword;@Value("${redis.taskScheduler.poolSize}")privateinttasksPoolSize;@Value("${redis.taskScheduler.defaultLockMaxDurationMinutes}")privateintlockMaxDuration;@Bean(destroyMethod="shutdown")ClientResourcesclientResources(){returnDefaultClientResources.create();}@BeanpublicRedisStandaloneConfigurationredisStandaloneConfiguration(){RedisStandaloneConfigurationredisStandaloneConfiguration=newRedisStandaloneConfiguration(redisHost,redisPort);if(password!=null&&!password.trim().equals("")){RedisPasswordredisPassword=RedisPassword.of(password);redisStandaloneConfiguration.setPassword(redisPassword);}returnredisStandaloneConfiguration;}@BeanpublicClientOptionsclientOptions(){returnClientOptions.builder().disconnectedBehavior(ClientOptions.DisconnectedBehavior.REJECT_COMMANDS).autoReconnect(true).build();}@BeanLettucePoolingClientConfigurationlettucePoolConfig(ClientOptionsoptions,ClientResourcesdcr){returnLettucePoolingClientConfiguration.builder().poolConfig(newGenericObjectPoolConfig()).clientOptions(options).clientResources(dcr).build();}@BeanpublicRedisConnectionFactoryconnectionFactory(RedisStandaloneConfigurationredisStandaloneConfiguration,LettucePoolingClientConfigurationlettucePoolConfig){returnnewLettuceConnectionFactory(redisStandaloneConfiguration,lettucePoolConfig);}@Bean@ConditionalOnMissingBean(name="redisTemplate")@PrimarypublicRedisTemplate<Object,Object>redisTemplate(RedisConnectionFactoryredisConnectionFactory){RedisTemplate<Object,Object>template=newRedisTemplate<>();template.setConnectionFactory(redisConnectionFactory);returntemplate;}@BeanpublicLockProviderlockProvider(RedisConnectionFactoryconnectionFactory){returnnewRedisLockProvider(connectionFactory);}@BeanpublicScheduledLockConfigurationtaskSchedulerLocker(LockProviderlockProvider){returnScheduledLockConfigurationBuilder.withLockProvider(lockProvider).withPoolSize(tasksPoolSize).withDefaultLockAtMostFor(Duration.ofMinutes(lockMaxDuration)).build();}} 操作类 packagecom.example.redis_demo_limit.redis;publicinterfaceDataCacheRepository<T>{booleanadd(Stringcollection,Stringhkey,Tobject,Longtimeout);booleandelete(Stringcollection,Stringhkey);Tfind(Stringcollection,Stringhkey,Class<T>tClass);BooleanisAvailable();/***redis加锁**@paramkey*@paramsecond*@return*/Booleanlock(Stringkey,Stringvalue,Longsecond);ObjectgetValue(Stringkey);/***redis解锁**@paramkey*@return*/voidunLock(Stringkey);voidsetIfAbsent(Stringkey,longvalue,longttl);voidincrement(Stringkey);Longget(Stringkey);voidset(Stringkey,longvalue,longttl);voidset(Objectkey,Objectvalue,longttl);ObjectgetByKey(Stringkey);voidgetLock(Stringkey,StringclientID)throwsException;voidreleaseLock(Stringkey,StringclientID);booleanhasKey(Stringkey);} 实现类 packagecom.example.redis_demo_limit.redis;importcom.fasterxml.jackson.databind.ObjectMapper;importlombok.extern.slf4j.Slf4j;importorg.slf4j.Logger;importorg.slf4j.LoggerFactory;importorg.springframework.beans.factory.annotation.Autowired;importorg.springframework.beans.factory.annotation.Value;importorg.springframework.data.redis.core.RedisTemplate;importorg.springframework.data.redis.core.ValueOperations;importorg.springframework.data.redis.support.atomic.RedisAtomicLong;importorg.springframework.stereotype.Repository;importjava.time.Duration;importjava.util.TimeZone;importjava.util.concurrent.TimeUnit;@Slf4j@RepositorypublicclassCacheRepository<T>implementscom.example.redis_demo_limit.redis.DataCacheRepository<T>{privatestaticfinalObjectMapperOBJECT_MAPPER;privatestaticfinalTimeZoneDEFAULT_TIMEZONE=TimeZone.getTimeZone("UTC");static{OBJECT_MAPPER=newObjectMapper();OBJECT_MAPPER.setTimeZone(DEFAULT_TIMEZONE);}Loggerlogger=LoggerFactory.getLogger(CacheRepository.class);@AutowiredRedisTemplatetemplate;//andwe'reinbusiness@Value("${redis.default.timeout}00")LongdefaultTimeOut;publicbooleanaddPermentValue(Stringcollection,Stringhkey,Tobject){try{StringjsonObject=OBJECT_MAPPER.writeValueAsString(object);template.opsForHash().put(collection,hkey,jsonObject);returntrue;}catch(Exceptione){logger.error("Unabletoaddobjectofkey{}tocachecollection'{}':{}",hkey,collection,e.getMessage());returnfalse;}}@Overridepublicbooleanadd(Stringcollection,Stringhkey,Tobject,Longtimeout){LonglocalTimeout;if(timeout==null){localTimeout=defaultTimeOut;}else{localTimeout=timeout;}try{StringjsonObject=OBJECT_MAPPER.writeValueAsString(object);template.opsForHash().put(collection,hkey,jsonObject);template.expire(collection,localTimeout,TimeUnit.SECONDS);returntrue;}catch(Exceptione){logger.error("Unabletoaddobjectofkey{}tocachecollection'{}':{}",hkey,collection,e.getMessage());returnfalse;}}@Overridepublicbooleandelete(Stringcollection,Stringhkey){try{template.opsForHash().delete(collection,hkey);returntrue;}catch(Exceptione){logger.error("Unabletodeleteentry{}fromcachecollection'{}':{}",hkey,collection,e.getMessage());returnfalse;}}@OverridepublicTfind(Stringcollection,Stringhkey,Class<T>tClass){try{StringjsonObj=String.valueOf(template.opsForHash().get(collection,hkey));returnOBJECT_MAPPER.readValue(jsonObj,tClass);}catch(Exceptione){if(e.getMessage()==null){logger.error("Entry'{}'doesnotexistincache",hkey);}else{logger.error("Unabletofindentry'{}'incachecollection'{}':{}",hkey,collection,e.getMessage());}returnnull;}}@OverridepublicBooleanisAvailable(){try{returntemplate.getConnectionFactory().getConnection().ping()!=null;}catch(Exceptione){logger.warn("Redisserverisnotavailableatthemoment.");}returnfalse;}@OverridepublicBooleanlock(Stringkey,Stringvalue,Longsecond){Booleanabsent=template.opsForValue().setIfAbsent(key,value,second,TimeUnit.SECONDS);returnabsent;}@OverridepublicObjectgetValue(Stringkey){returntemplate.opsForValue().get(key);}@OverridepublicvoidunLock(Stringkey){template.delete(key);}@Overridepublicvoidincrement(Stringkey){RedisAtomicLongcounter=newRedisAtomicLong(key,template.getConnectionFactory());counter.incrementAndGet();}@OverridepublicvoidsetIfAbsent(Stringkey,longvalue,longttl){ValueOperations<String,Object>ops=template.opsForValue();ops.setIfAbsent(key,value,Duration.ofSeconds(ttl));}@OverridepublicLongget(Stringkey){RedisAtomicLongcounter=newRedisAtomicLong(key,template.getConnectionFactory());returncounter.get();}@Overridepublicvoidset(Stringkey,longvalue,longttl){RedisAtomicLongcounter=newRedisAtomicLong(key,template.getConnectionFactory());counter.set(value);counter.expire(ttl,TimeUnit.SECONDS);}@Overridepublicvoidset(Objectkey,Objectvalue,longttl){template.opsForValue().set(key,value,ttl,TimeUnit.SECONDS);}@OverridepublicObjectgetByKey(Stringkey){returntemplate.opsForValue().get(key);}@OverridepublicvoidgetLock(Stringkey,StringclientID)throwsException{Booleanlock=false;//重试3次,每间隔1秒重试1次for(intj=0;j<=3;j++){lock=lock(key,clientID,10L);if(lock){log.info("获得锁》》》"+key);break;}try{Thread.sleep(5000);}catch(InterruptedExceptione){log.error("线程休眠异常",e);break;}}//重试3次依然没有获取到锁,那么返回服务器繁忙,请稍后重试if(!lock){thrownewException("服务繁忙");}}@OverridepublicvoidreleaseLock(Stringkey,StringclientID){if(clientID.equals(getByKey(key))){unLock(key);}}@OverridepublicbooleanhasKey(Stringkey){returntemplate.hasKey(key);}} 三、使用方法 importcom.example.redis_demo_limit.annotation.LimitedAccess;importcom.example.redis_demo_limit.redis.DataCacheRepository;importlombok.extern.slf4j.Slf4j;importorg.springframework.web.bind.annotation.PostMapping;importorg.springframework.web.bind.annotation.RequestMapping;importorg.springframework.web.bind.annotation.RestController;importjavax.annotation.Resource;importjava.util.UUID;@Slf4j@RestController@RequestMapping("/redis")publicclassRedisController{privatestaticfinalStringKEY="key";@ResourceprivateDataCacheRepositorydataCacheRepository;@LimitedAccess(frequency=1,second=1)@PostMapping("/add")publicStringadd(Stringstr){dataCacheRepository.set("str","addsuccess",200L);return"success";}//分布式锁使用示例@PostMapping("/pay")publicStringpay(StringuserName,Integeraccount){StringclientID=UUID.randomUUID().toString();//设置锁的过期时间,避免死锁Booleanlock=dataCacheRepository.lock(userName,clientID,6000L);if(!lock){log.info("未获取到锁{}",userName);return"程序繁忙,请稍后再试!";}try{//等待5s,方便测试Thread.sleep(5000);if(dataCacheRepository.hasKey(KEY)){LongaLong=dataCacheRepository.get(KEY);dataCacheRepository.set(KEY,aLong+account,-1);returnaccount+aLong+"";}else{dataCacheRepository.set(KEY,account,-1);returnaccount+"";}}catch(InterruptedExceptione){log.error(e.getMessage(),e);return"程序运行异常,请联系管理员!";}finally{if(clientID.equals(dataCacheRepository.getByKey(userName))){log.info("finally删除锁{}",userName);dataCacheRepository.unLock(userName);}}}} 四、结果测试 先在8082点击pay 再在8081点击pay 从结果来看,分布式锁起到了作用。很简单吧,还不来试一下! 本文分享自微信公众号 - 全民java空间(ljl236915692)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

从渲染原理出发探究Flutter内存泄漏(超详细)

作者:闲鱼技术-萧湘 背景 众所周知,内存的高低是评判一款app的性能优劣的重要的指标之一。作为开发者而言,都会尽可能的减少内存的使用,清除无用的内存块,从而减少整个app的内存使用量。这也是历来开发者是追求的目标。然而,开发者难免时常因为语言用法或者写法的缘故,导致该释放而未释放的对象迟迟未释放,从而内存泄漏,消耗殆尽内存空间,从而导致系统崩溃的情况。 如何更简单的帮助开发者分析、暴露且解决内存泄漏问题,几乎是每一个平台或框架、开发者亟需的一个的"标配"的feature。例如:苹果的instruments,Linux的Kmemleak等。但是对于flutter社区,缺少一款用得顺手的内存泄漏工具。对于使用flutter而言,因使用dart语言,通过形成渲染树提交到c++的skia进行渲染,从dart层到c++层拥有很长的渲染链路,使用者必须对整个渲染链路有通盘深刻的理解,才能深刻此时此刻的内存使用情况。 本文从flutter渲染原理出发,分析flutter的内存分配情况,理清渲染流程,提出一种基于渲染树个数的方式寻找内存泄漏的解决方案 flutter内存都包含哪些 虚拟内存还是物理内存? 当我们谈论内存时,通常说的是物理内存(Physical memory),同一个应用程序运行在不同机器或者操作系统上时,会因不同操作系统和机器的硬件条件的不同,分配的到物理内存大小会有所不同,但大致而言,一款应用程序所使用到的虚拟内存(Virtual Memory)而言便会大致一样,本文讨论的都值的是虚拟内存。 我们可以直观的理解,代码中操作的所有对象都是能用虚拟内存衡量,而不太关心对象是否存在于物理内存与否,只要能减少对象的应用,尽量少的持有对象,不管白猫黑猫,能减少对象的,都是“好猫”。 讨论flutter内存时,我们在谈论什么 flutter从使用的语言上,可以分成3大部分, Framework层 由Dart编写,开发者接触到顶层,用于应用层开发 Engine 层,由C/C++编写,主要进行图形渲染 Embedder层,由植入层语言编写,如iOS使用Objective-C/swift,Android使用java 当我们从进程角度谈论flutter应用的内存时,指的是这个三者所有的内存的总和。 为简化,这里可以简单的以使用者能直接接触的代码为边界,将其分成DartVM和native内存,DartVM指Dart虚拟机占用内存,而native内存包含Engine和平台相关的代码运行的内存。 既然说Flutter的使用者能接触到的最直接的对象都是使用Dart语言生成的对象,那么对于Engine层的对象的创建与销毁,使用者似乎鞭长莫及了?这就不得不说Dart虚拟机绑定层的设计了。 Dart绑定层如何工作 出于性能或者跨平台或其他原因,脚本语言或者基于虚拟机的语言都会提供c/c++或函数对象绑定到具体语言对象的接口,以便在语言中接着操控c/c++对象或函数,这层API称为绑定层。例如: 最易嵌入应用程序中的Lua binding ,Javascript V8 引擎的binding 等等。 Dart虚拟机在初始化时,会将C++声明的某个类或者函数和某个函数和Dart中的某个类或者绑定起来,依次注入Dart运行时的全局遍历中,当Dart代码执行某一个函数时,便是指向具体的C++对象或者函数。 下面是几个常见的绑定的几个c++类和对应的Dart类 flutter::EngineLayer --> ui.EngineLayer flutter::FrameInfo --> ui.FrameInfo flutter::CanvasImage --> ui.Image flutter::SceneBuilder --> ui.SceneBuilder flutter::Scene --> ui.Scene 以ui.SceneBuilder一个例子了解下Dart是如何绑定c++对象实例,并且控制这个c++实例的析构工作。 Dart层渲染过程是配置的layer渲染树,并且提交到c++层进行渲染的过程。ui.SceneBuilder便是这颗渲染树的容器 Dart代码调用构造函数ui.SceneBuilder()时,调用c++方法SceneBuilder_constructor 调用flutter::SceneBuilder的构造方法并生成c++实例sceneBuilder 因flutter::SceneBuilder 继承自内存计数对象RefCountedDartWrappable,对象生成后会内存计数加1 将生成c++实例sceneBuilder使用Dart的API生成一个WeakPersitentHandle,注入到Dart上下中。在这里之后,Dart便可使用这个builder对象,便可操作这个c++的flutter::SceneBuilder 实例。 程序运行许久后,当Dart虚拟机判断Dart 对象builder没有被任何其他对象引用时(例如简单的情况是被置空builder=null,也称为无可达性),对象就会被垃圾回收器(Garbage Collection)回收释放,内存计数将会减一 当内存计数为0时,会触发c++的析构函数,最终c++实例指向的内存块被回收 可以看到,Dart是通过将C/C++实例封装成WeakPersitentHandle且注入到Dart上下文的方式,从而利用Dart虚拟机的GC(Garbage Collection)来控制C/C++实例的创建和释放工作 更直白而言,只要C/C++实例对应的Dart对象能正常被GC回收,C/C++所指向的内存空间便会正常释放。 WeakPersistentHandle是什么 因为Dart对象在VM中会因为GC整理碎片化中经常移动,所以使用对象时不会直接指向对象,而是使用句柄(handle)的方式间接指向对象,再者c/c++对象或者实例是介乎于Dart虚拟机之外,生命周期不受作用域约束,且一直长时间存在于整个Dart虚拟机中,所以称为常驻(Persistent),所以WeakPersistentHandle专门指向生命周期与常在的句柄,在Dart中专门用来封装C/C++实例。 在flutter官方提供的Observatory工具中,可以查看所有的WeakPersistentHandle对象 其中Peer这栏也就是封装c/c++对象的指针 Dart对象的可达性 Dart对象释放会被垃圾回收器(Garbage Collection)进行释放,是通过判定对象是否还有可达性(availability)来达到的。可达性是指通过某些根节点出发,通过对象与对象间的引用链去访问对象,如可通过引用链去访问对象,则说明对象有可达性,否则无可达性。 黄色有可达性,蓝色无可达性 难以察觉的内存泄漏 看到这里我们会发现一个问题,其实我们很难从Dart侧难感知C/C++对象的消亡,因为Dart对象无统一的如同C++类一样的析构函数,一旦对象因为循环引用等的原因被长期其他对象长期引用,GC将无法将其释放,最终导致内存泄漏。 将问题放大一点,我们知道flutter是一个渲染引擎,我们通过编写Dart语言构建出一颗Widget树,进而经过绘制等过程简化成Element树,RenderObject树,Layer树,并将这颗Layer树提交至C++层,进而使用Skia进行渲染。 如果某个Wigdet树或Element树的某个节点长期无法得到释放,将可能造成他的子节点也牵连着无法释放,将泄漏的内存空间迅速扩大。 例如,存在两个A,B界面,A界面通过Navigator.push的方式添加B界面,B界面通过Navigator.pop回退到A。如果B界面因为某些写法的缘故导致B的渲染树虽然被从主渲染树解开后依然无法被释放,这会导致整个原来B的子树都无法释放。 通过检测渲染树节点来检测内存泄漏 基于上面的这一个情况,我们其实可以通过对比当前帧使用到的渲染节点个数,对比当前内存中渲染节点的个数来判断前一个界面释放存在内存泄漏的情况。 Dart代码中都是通过往ui.SceneBuilder添加EngineLayer的方式去构建渲染树,那么我们只要检测c++中内存中EngineLayer的个数,对比当前帧使用的EngineLayer个数,如果内存中的EngineLayer个数长时间大于使用的个数,那么我们可以判断存在有内存泄漏 依然以上次A页面pushB界面,B界面pop回退A界面为例子。正常无内存泄漏的情况下,正在使用的layer个数(蓝色),内存中的layer个数(橙色)两条曲线的虽然有波动,但是最终都会比较贴合。 但是在B页面存在内存泄漏的时候,退到A界面后,B树完全无法释放,内存中的layer个数(橙色)无法最终贴合蓝色曲线(正在使用的layer个数) 也就是说,对于渲染而言,如果代码导致Widget树或Element树长时间无法被GC回收,很可能会导致严重的内存泄漏情况。 如何导致内存泄漏? 目前发现异步执行的代码的场景(Feature, async/await,methodChan)长期持有传入的BuildContext,导致 element 被移除后,依然长期存在,最终导致以及关联的 widget, state 发生泄漏。 再继续看B页面泄漏的例子 正确与错误的写法的区别在于,错误的仅是在调用Navigator.pop之前,使用异步方法Future引用了BuildContext,便会导致B界面内存泄漏。 怎么发现泄漏点? 目前flutter内存泄漏检测工具的设计思路是,对比界面进入前后的对象,寻找出未被释放的对象,进而查看未释放的引用关系(Retaining path或Inbound references),再结合源码进行分析,最后找到错误代码。 使用Flutter自带的Observatory纵然可以一个一个查看每个泄漏对象的引用关系,但是对于一个稍微复杂一点的界面而言,最终生成的layer个数是非常庞杂的,想要在Observatory所有的泄漏对象中找到有问题的代码是一项非常庞杂的任务。 为此我们将这些繁杂的定位工作都进行了可视化。 我们这里将每一帧提交到engine的所有EngineLayer进行了一个记录,并且以折线图的形式记录下来,如果上文说的内存中的layer个数异常的大于使用中的layer个数,那么就可判断前一个页面存在有内存泄漏。 进而,还可以抓取当前页面的layer树的结构,用以辅助定位具体由哪个RenderObject树生成的Layer树,进而继续分析由哪个Element节点生成的RenderObject节点 或者也可以打印出WeakPersitentHandle的引用链辅助分析 但如今的痛点依然存在,依然需要通过查看Handle的引用链,结合源码的分析才能最终比较快捷的定位问题。这也是接下来亟需解决的问题。 总结与展望 我们这种从渲染树的角度去探寻flutter内存泄漏的方法,可以推广到所以其他Dart不同类型的对象。 开发者在编写代码时,需要时刻注意异步调用,以及时刻注意操纵的Element会否被引用而导致无法释放 闲鱼作为长期深耕flutter的团队,也在持续在flutter工具链中持续发力,当然也少不了这一重要的内存检测工具的深入开发,欢迎大家持续关注!

优秀的个人博客,低调大师

Nginx 安装 SSL 配置 HTTPS 超详细完整全过程

说到 [Nginx]() 服务器,个人认为最大特点就是轻量级和高性能。通过在几台不同的服务器上进行测试,发现它的并发能力特别强,并且相对而言吃的[内存]()少很多。目前已是绝大多数站长的首选 HTTP 和反向代理服务器。站长自己的网站,包括承接企业服务器运维服务所采用的都是 Nginx。Apache 当然也可以,如果有兴趣,可以看一下 Nginx 和 Apache 区别对比。 本文主要分享下 Nginx 安装 SSL 模块并且开启配置 HTTPS 的操作过程。 一、Nginx 的 SSL 模块安装 查看 nginx 是否安装 http_ssl_module 模块。 $ /usr/local/nginx/sbin/nginx -V 如果出现 configure arguments: –with-http_ssl_module, 则已安装(下面的步骤可以跳过,进入 nginx.conf 配置)。 下载 Nginx 安装包,当然是要去 Nginx 官网下载。 下载安装包到 src 目录 $ cd /usr/local/src $ wget http://nginx.org/download/nginx-1.15.9.tar.gz 解压安装包。 $ tar -zxvf nginx-1.15.9.tar.gz 配置 SSL 模块。 $ cd nginx-1.15.9 $ ./configure --prefix=/usr/local/nginx --with-http_ssl_module 使用 make 命令编译(使用make install会重新安装nginx),此时当前目录会出现 objs 文件夹。 用新的 nginx 文件覆盖当前的 nginx 文件。 $ cp ./objs/nginx /usr/local/nginx/sbin/ 再次查看安装的模块(configure arguments: –with-http_ssl_module说明ssl模块已安装)。 $ /usr/local/nginx/sbin/nginx -V nginx version: nginx/1.15.9 ... configure arguments: --with-http_ssl_module 二、SSL 证书部署 这里使用的是阿里云的免费证书,期限为1年,申请地址在此。 找不到阿里云免费ssl入口的可以参考文章:阿里云免费SSL HTTPS证书没有了?原来是被隐藏了!(图) 下载申请好的 ssl 证书文件压缩包到本地并解压(这里是用的 pem 与 key 文件,文件名可以更改)。 在 nginx 目录新建 cert 文件夹存放证书文件。 $ cd /usr/local/nginx $ mkdir cert 将这两个文件上传至服务器的 cert 目录里。这里使用 mac 终端上传至服务器的 scp 命令(这里需要新开一个终端,不要使用连接服务器的窗口): $ scp /Users/yourname/Downloads/ssl.pem root@xxx.xx.xxx.xx:/usr/local/nginx/cert/ $ scp /Users/yourname/Downloads/ssl.key root@xxx.xx.xxx.xx:/usr/local/nginx/cert/ scp [本地文件路径,可以直接拖文件至终端里面] [<服务器登录名>@<服务器IP地址>:<服务器上的路径>] 三、Nginx.conf 配置 编辑 /usr/local/nginx/conf/nginx.conf 配置文件: 配置 https server。注释掉之前的 http server 配置,新增 https server: server { # 服务器端口使用443,开启ssl, 这里ssl就是上面安装的ssl模块 listen 443 ssl; # 域名,多个以空格分开 server_name hack520.com www.hack520.com; # ssl证书地址 ssl_certificate /usr/local/nginx/cert/ssl.pem; # pem文件的路径 ssl_certificate_key /usr/local/nginx/cert/ssl.key; # key文件的路径 # ssl验证相关配置 ssl_session_timeout 5m; #缓存有效期 ssl_ciphers ECDHE-RSA-AES128-GCM-SHA256:ECDHE:ECDH:AES:HIGH:!NULL:!aNULL:!MD5:!ADH:!RC4; #加密算法 ssl_protocols TLSv1 TLSv1.1 TLSv1.2; #安全链接可选的加密协议 ssl_prefer_server_ciphers on; #使用服务器端的首选算法 location / { root html; index index.html index.htm; } } 将 http 重定向 https。 server { listen 80; server_name hack520.com www.hack520.com; return 301 https://$server_name$request_uri; } 四、重启 nginx $ /usr/local/nginx/sbin/nginx -c /usr/local/nginx/conf/nginx.conf 如果 80 端口被占用,用kill [id]来结束进程: # 查看端口使用 $ netstat -lntp Active Internet connections (only servers) Proto Recv-Q Send-Q Local Address Foreign Address State PID/Program name tcp 0 0 0.0.0.0:80 0.0.0.0:* LISTEN 21307/nginx: master tcp 0 0 0.0.0.0:22 0.0.0.0:* LISTEN 3072/sshd tcp 0 0 0.0.0.0:443 0.0.0.0:* LISTEN 21307/nginx: master # 结束 80 端口进程 $ kill 21307 再次重启 nginx: $ /usr/local/nginx/sbin/nginx -c /usr/local/nginx/conf/nginx.conf 或者: service nginx restart 往期文章 Nginx系列教程(1)nginx基本介绍和安装入门 Nginx系列教程(2)nginx搭建静态资源web服务器 Nginx系列教程(3)nginx缓存服务器上的静态文件 Nginx系列教程(4)nginx处理web应用负载均衡问题以保证高并发 Nginx系列教程(5)如何保障nginx的高可用性(keepalived) Nginx系列教程(6)nginx location 匹配规则详细解说 Nginx系列教程(7)nginx rewrite配置规则详细说明 Nginx系列教程(8)nginx配置安全证书SSL Nginx系列教程(9)nginx 解决session一致性 Nginx系列教程(10)基于nginx解决前端访问后端服务跨域问题(Session和cookie无效)基于Nginx解决前端访问后端服务跨域问题(Session和cookie无效)")

优秀的个人博客,低调大师

12个超好用的IntelliJ IDEA 插件!你用过几个?

一、前言 IntelliJ IDEA如果说IntelliJ IDEA是一款现代化智能开发工具的话,Eclipse则称得上是石器时代的东西了。其实笔者也是一枚从Eclipse转IDEA的探索者,随着近期的不断开发实践和调试,逐步体会到这款智能IDE带来的巨大开发便利,在强大的插件功能支持下,诸如对Git和Maven的支持简直让人停不下来,各种代码提示,包括JS更是手到擒来,最终不得不被这款神奇的IDE所折服。为了让身边更多的小伙伴参与进来,决定写下这篇文章。 二、IDEA VS Eclipse 核心术语比较 由下图可见:两者最大的转变就在于工作空间概念的转变,并且在IDEA当中,Project和 Module是作为两个不同的概念,对项目结构是具有重大意义的,这也恰恰是许多IDEA初学者觉得困扰的地方。 1 为什么要取消工作空间?答:简单来说,IDEA不需要设置工作空间,因为每一个Project都具备一个工作空间!!对于每一个IDEA的项目工程(Project)而言,它的每一个子模块(Module)都可以使用独立的JDK和MAVEN配置。这对于传统项目迈向新项目的重构添加了极大的便利性,这种多元化的灵活性正是Eclipse所缺失的,因为开始Eclipse在初次使用时已经绑死了工作空间。2 此外,很多新手都会问,为什么IDEA里面的子工程要称为Module ?答:其实就是模块化的概念,作为聚合工程亦或普通的根目录,它称之为Project,而下面的子工程称为模块,每一个子模块之间可以相关联,也可以没有任何关联。 三、IDEA的插件介绍 1.插件的安装 打开setting文件选择Plugins选项Ctrl + Alt + SFile -> Setting 分别是安装JetBrains插件,第三方插件,本地已下载的插件包。详情见往期关于settings的文章。2.各种插件 1. activate-power-mode 和 Power mode II 根据Atom的插件activate-power-mode的效果移植到IDEA上 写代码是整个屏幕都在抖动,activate-power-mode是白的的,Power mode II色彩更酷炫点。 2.Background Image Plus idea背景修改插件,让你的idea与众不同,可以设置自己喜欢的图片作为code背景。 安装成功之后重启,菜单栏的VIew标签>点击Set Background Image(没安装插件是没有这个标签的),在弹框中路由选择到本地图片,点击OK即可。 3.Grep console 自定义日志颜色,idea控制台可以彩色显示各种级别的log,安装完成后,在console中右键就能打开。 并且可以设置不同的日志级别的显示样式。 可以直接根据关键字搜索你想要的,搜索条件是支持正则表达式的。 4.Free Mybatis plugin mybatis 插件,让你的mybatis.xml像java代码一样编辑。我们开发中使用mybatis时时长需要通过mapper接口查找对应的xml中的sql语句,该插件方便了我们的操作。安装完成重启IDEA之后,我们会看到code左侧或多出一列绿色的箭头,点击箭头我们就可以直接定位到xml相应文件的位置。mapper xml 5.MyBatis Log Plugin Mybatis现在是java中操作数据库的首选,在开发的时候,我们都会把Mybatis的脚本直接输出在console中,但是默认的情况下,输出的脚本不是一个可以直接执行的。 如果我们想直接执行,还需要在手动转化一下。MyBatis Log Plugin 这款插件是直接将Mybatis执行的sql脚本显示出来,无需处理,可以直接复制出来执行的,如图: 执行程序后,我们可以很清晰的看到我们执行了哪些sql脚本,而且脚本可以执行拿出来运行。 6.String Manipulation 强大的字符串转换工具。使用快捷键,Alt+m。 切换样式(camelCase, hyphen-lowercase, HYPHEN-UPPERCASE, snake_case, SCREAMING_SNAKE_CASE, dot.case, words lowercase, Words Capitalized, PascalCase)转换为SCREAMING_SNAKE_CASE (或转换为camelCase)转换为 snake_case (或转换为camelCase)转换为dot.case (或转换为camelCase)转换为hyphen-case (或转换为camelCase)转换为hyphen-case (或转换为snake_case)转换为camelCase (或转换为Words)转换为camelCase (或转换为lowercase words)转换为PascalCase (或转换为camelCase)选定文本大写样式反转 7.Alibaba Java Coding Guidelines 阿里巴巴代码规范检查插件,当然规范可以参考《阿里巴巴Java开发手册》。 8.Lombok Java语言,每次写实体类的时候都需要写一大堆的setter,getter,如果bean中的属性一旦有修改、删除或增加时,需要重新生成或删除get/set等方法,给代码维护增加负担,这也是Java被诟病的一种原因。Lombok则为我们解决了这些问题,使用了lombok的注解(@Setter,@Getter,@ToString,@@RequiredArgsConstructor,@EqualsAndHashCode或@Data)之后,就不需要编写或生成get/set等方法,很大程度上减少了代码量,而且减少了代码维护的负担。安装完成之后,在应用Lombok的时候注意别忘了需要添加依,maven为例: 9.Key promoter Key promoter 是IntelliJ IDEA的快捷键提示插件,会统计你鼠标点击某个功能的次数,提示你应该用什么快捷键,帮助记忆快捷键,等熟悉了之后可以关闭掉这个插件。 10.Gsonformat 可根据json数据快速生成java实体类。自定义个javaBean(无任何内容,就一个空的类),复制你要解析的Json,然后alt+insert弹出如下界面或者使用快捷键 Alt+S,在里面粘贴刚刚复制的Json,点击OK即可。 11.Restfultoolkit Spring MVC网页开发的时候,我们都是通过requestmapping的方式来定义页面的URL地址的,为了找到这个地址我们一般都是cmd+shift+F的方式进行查找,大家都知道,我们URL的命名一个是类requestmapping+方法requestmapping,查找的时候还是有那么一点不方便的,restfultookit就能很方便的帮忙进行查找。例如:我要找到/user/add 对应的controller,那么只要Ctrl+斜杠 ,(图片来自于网络) 就能直接定位到我们想要的controller。这个也是真心方便,当然restfultookit还为我们提供的其他的功能。根据我们的controller帮我们生成默认的测试数据,还能直接调用测试,这个可以是解决了我们每次postman调试数据时,自己傻傻的组装数据的的操作,这个更加清晰,比在console找数据包要方便多了。(图片来自于网络) 12.JRebel JRebel是一种热部署生产力工具,修改代码后不用重新启动程序,所有的更改便可以生效。它跳过了Java开发中常见的重建、重新启动和重新部署周期。 四、最后 欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

超详细hadoop集群服务器安装配置教程

虚拟机以及Linux系统安装在之前的两篇分享中已经详细的介绍了方法,并且每一步的都配图了。如果有朋友还是看不懂,那我也爱莫能助了。本篇主要就hadoop服务器操作系统配置进行详细说明,hadoop安装会在下一篇文章中详细的介绍。 hadoop安装包用的是大快DKHadoop发行版,个人觉得DKHadoop的安装过程是比较简单,关于dkhadoop的安装在下一次的分享中再详细介绍吧。下面进入到本篇的主题——服务器操作系统配置教程 一、安装包准备 1、虚拟机分布式安装(三台及以上虚拟机) 若是个人电脑Windows系统或Linux系统,虚拟机上虚拟的三台服务器,则将安装包拷贝到服务器上,进行安装操作即可。 2、物理集群(三台及以上实体服务器) 1、 外网下载模式 2、 本地文件模式 将安装包文件直接拷贝到实体服务器root目录下,进行安装操作即可。 3、上传模式 当服务器在机房,且无显示和输入设备的情况下,应用该模式。 现将文件,安装在本地计算机上(默认为笔记本电脑,在机房现场),并将计算机与服务器连接,将安装包install、DKHInstall上传到服务器root目录下。 二、服务器操作系统配置教程 准备工作完成之后,就要进行服务器配置操作,首先必须三台服务器之间要互相ping通。所谓ping通,就是两台设备之间网络是通的。从一端发送一个数据包,另一端就能够收到,就代表两台设备是能够ping通了。 1、修改权限 目的:使install、DKHInstall两个安装包有可执行的权限。权限不足无法执行一些操作。install里面是脚本和所有组件,DKHInstall里面是安装界面。 步骤:在准备工作中拷贝安装包 install、DKHInstall到主节点目录后,修改文件权限。首先进入root目录,安装目录 install、DKHInstall的权限改为:文件所有者可读可写可执行,与文件所有者属于一个用户组的其他用户可读可执行,其他用户组可读可执行。 命令: cd /root/ unzip DKHPlantform.zip chmod -R 755 DKHPlantform 2、搭建Hadoop集群设置SSH免密登录 目的:Hadoop运行过程中需要管理远端Hadoop守护进程,在Hadoop启动以后,NameNode是通过SSH(Secure Shell)来启动和停止各个DataNode上的各种守护进程的。这就必须在节点之间执行指令的时候是不需要输入密码的形式,所以我们需要配置SSH运用无密码公钥认证的形式,这样NameNode使用SSH无密码登录并启动DataName进程,同样原理,DataNode上也能使用SSH无密码登录到NameNode。 步骤: (1)修改本机hosts文件,写入对应关系 为了区分局域网内的每台主机,都会给主机配一个主机名,每台主机之间又是通过IP进行通信,但IP地址不方便记忆,所以配置主机名和IP映射能够实现主机之间的快速方便的访问。 命令: vi /etc/hosts 通过按键盘上的insert或是I键进入编辑模式,编辑完成后按一下Esc键然后按一下按Shift+: 键,输入wq,后回车就可以保存。输入q!后回车则是放弃保存并退出. 进入编辑模式后,按照规则写入主机与ip的对应关系(主机名称dk41是自己命名的,如下图)例: 192.168.1.41 dk41 192.168.1.42 dk42 192.168.1.43 dk43 编辑完后,保存退出。把对应关系拷到其他两台或多台机器上。 命令: scp-r/etc/hosts192.168.1.42:/etc scp-r/etc/hosts192.168.1.43:/etc (2)执行集群之间免密前的准备工作 执行sshpass.sh的脚本的时候会去读sshhosts和sshslaves这两个文件,替换sshpass.sh中的master和slave文件。 修改文件sshhosts,输入全部机器的主机名,每行一个主机名(如下图) 命令: vi /root/DKHPlantform/autossh/sshhosts 通过按键盘上的insert或是I键进入编辑模式,编辑完成后按一下Esc键然后按一下按Shift+:键,输入wq,后回车就可以保存。输入q!后回车则是放弃保存并退出. 修改文件sshslaves,写入除主机名之外的所有机器名(如下图) 命令: vi /root/DKHPlantform/autossh/sshslaves 通过按键盘上的insert或是I键进入编辑模式,编辑完成后按一下Esc键然后按一下按Shift+:键,输入wq,后回车就可以保存。输入q!后回车则是放弃保存并退出. (3)执行集群免密工作 命令: cd /root/DKHPlantform/autossh ./autossh 主节点主机名 集群密码 例: ./autossh dk41 123456 (4)关闭防火墙 防止访问服务器时某些服务被拦截,需关闭防火墙。 命令: cd /root/DKHPlantform/autossh ./offIptables.sh 3、安装双机热备份的MySQL 目的:存放Hive的元数据 步骤: (1)从主节点分发mySQL安装目录到第二节点 命令: scp-r/root/DKHPlantform/mysqlInst/192.168.1.42:/root/ (2)主节点执行: 命令: cd /root/DKHPlantform/mysqlInst/ ./mysql.sh 1 从节点执行: 命令: cd /root/mysqlInst/ ./mysql.sh 2 (3)执行成功之后执行热备份(两台机器上都要执行,两个ip互换,41上写42,42上写41,密码是MySQL的密码为:123456。平台内已经设定好,请勿修改): 命令: source /etc/profile ./sync.sh 192.168.1.xxx(另一台mysql地址) 4、创建数据库 目的:MySQL是一种关联数据库管理系统,关联数据库将数据保存在不同的表中,增加了速度并提高了灵活性。 步骤: (1)导入MySQL数据表,只在主节点执行: 命令: mysql -uroot -p123456 < { 此处为sql文件,主目录下文件: dkh.sql} 如:mysql -uroot -p123456 </root/DKHPlantform/dkh.sql (2)执行完后查看一下两台mysql的数据表是否存在,从主节点中查看执行: 命令: mySQL-uroot-p123456showdatabases; use dkh; show tables; 5、启动安装 目的:服务器配置操作完成之后,启动DKH。 步骤:执行以下命令。 命令: cd /root/DKHPlantform/dkh-tomcat*/bin/ ./startup.sh 6、本地时间服务器搭建步骤 没联网或者装系统时时间未同步,需要搭建本地时间服务器。 (1)搭建内网的ntp服务器 修改/etc/ntp.conf 命令: Vim /etc/ntp.conf 通过按键盘上的insert或是I键进入编辑模式,编辑完成后按一下Esc键然后按一下按Shift+:键,输入wq后回车就可以保存。输入q!后回车则是放弃保存并退出. 修改下列三行: #server0.centos.pool.ntp.org #server1.centos.pool.ntp.org #server2.centos.pool.ntp.org 在文件最后添加下列两行: server127.127.1.0 fudge127.127.1.0stratum10 (2)启动ntp服务 service ntpd start (3)开机自动启动 chkconfig ntpd on (4)客户端同步时间 命令: Vim /etc/ntp.conf 通过按键盘上的insert或是I键进入编辑模式,编辑完成后按一下Esc键然后按一下按Shift+:键,输入wq,后回车就可以保存。输入q!后回车则是放弃保存并退出. 在文件最后添加一行: */15****root ntpdate192.168.27.35;hwclock-w

优秀的个人博客,低调大师

超实用的Spark数据倾斜解决姿势,学起来!

本文将结合实例详细阐明Spark数据倾斜(Data Skew)的几种场景及对应的解决方案,包括避免数据源倾斜、调整并行度、使用自定义Partitioner、使用Map侧Join代替Reduce侧Join、给倾斜Key加上随机前缀等。 一、为何要处理数据倾斜 1、什么是数据倾斜 对Spark/Hadoop这样的大数据系统来讲,数据量大并不可怕,可怕的是数据倾斜。 那何谓数据倾斜?数据倾斜指的是并行处理的数据集中,某一部分(如Spark或Kafka的一个Partition)的数据显著多于其它部分,从而使得该部分的处理速度成为整个数据集处理的瓶颈。 2、数据倾斜是如何造成的 在Spark中,同一个Stage的不同Partition可以并行处理,而具有依赖关系的不同Stage之间是串行处理的。假设某个Spark Job分为Stage 0和Stage 1两个Stage,且Stage 1依赖于Stage 0,那Stage 0完全处理结束之前不会处理Stage 1。而Stage 0可能包含N个Task,这N个Task可以并行进行。如果其中N-1个Task都在10秒内完成,而另外一个Task却耗时1分钟,那该Stage的总时间至少为1分钟。换句话说,一个Stage所耗费的时间,主要由最慢的那个Task决定。 由于同一个Stage内的所有Task执行相同的计算,在排除不同计算节点计算能力差异的前提下,不同Task之间耗时的差异主要由该Task所处理的数据量决定。 Stage的数据来源主要分为如下两类: 从数据源直接读取,如读取HDFS、Kafka 读取上一个Stage的Shuffle数据 二、如何缓解/消除数据倾斜 1、尽量避免数据源的数据倾斜 以Spark Stream通过DirectStream方式读取Kafka数据为例。由于Kafka的每一个Partition对应Spark的一个Task(Partition),所以Kafka内相关Topic的各Partition之间数据是否平衡,直接决定Spark处理该数据时是否会产生数据倾斜。 Kafka某一Topic内消息在不同Partition之间的分布,主要由Producer端所使用的Partition实现类决定。如果使用随机Partitioner,则每条消息会随机发送到一个Partition中,那么从概率上来讲,各Partition间的数据会达到平衡。此时源Stage(直接读取Kafka数据的Stage)不会产生数据倾斜。 但很多时候,业务场景可能会要求将具备同一特征的数据顺序消费,此时就需要将具有相同特征的数据放于同一个Partition中。一个典型的场景是,需要将同一个用户相关的PV信息置于同一个Partition中。此时,如果产生了数据倾斜,则需要通过其它方式处理。 2、调整并行度分散同一个Task的不同Key 原理 Spark在做Shuffle时,默认使用HashPartitioner(非Hash Shuffle)对数据进行分区。如果并行度设置得不合适,可能造成大量不相同的Key对应的数据被分配到了同一个Task上,造成该Task所处理的数据远大于其它Task,从而造成数据倾斜。 如果调整Shuffle时的并行度,使得原本被分配到同一Task的不同Key发配到不同Task上处理,则可降低原Task所需处理的数据量,从而缓解数据倾斜问题造成的短板效应 案例 现有一张测试表,名为student_external,内有10.5亿条数据,每条数据有一个唯一的id值。现从中取出id取值为9亿到10.5亿的共1.5亿条数据,并通过一些处理,使得id为9亿到9.4亿间的所有数据对12取模后余数为8(即在Shuffle并行度为12时该数据集全部被HashPartition分配到第8个Task),其它数据集对其id除以100取整,从而使得id大于9.4亿的数据在Shuffle时可被均匀分配到所有Task中,而id小于9.4亿的数据全部分配到同一个Task中。 处理过程如下: 通过上述处理,一份可能造成后续数据倾斜的测试数据即以准备好。接下来,使用Spark读取该测试数据,并通过groupByKey(12)对id分组处理,且Shuffle并行度为12。代码如下: 本次实验所使用集群节点数为4,每个节点可被Yarn使用的CPU核数为16,内存为16GB。使用如下方式提交上述应用,将启动4个Executor,每个Executor可使用核数为12(该配置并非生产环境下的最优配置,仅用于本文实验),可用内存为12GB。 spark-submit--queueambari--num-executors4--executor-cores12--executor-memory12g--classcom.jasongj.spark.driver.SparkDataSkew--masteryarn--deploy-modeclientSparkExample-with-dependencies-1.0.jar GroupBy Stage的Task状态如下图所示,Task 8处理的记录数为4500万,远大于(9倍于)其它11个Task处理的500万记录。而Task 8所耗费的时间为38秒,远高于其它11个Task的平均时间(16秒)。整个Stage的时间也为38秒,该时间主要由最慢的Task 8决定。 在这种情况下,可以通过调整Shuffle并行度,使得原来被分配到同一个Task(即该例中的Task 8)的不同Key分配到不同Task,从而降低Task 8所需处理的数据量,缓解数据倾斜。 通过groupByKey(48)将Shuffle并行度调整为48,重新提交到Spark。新的Job的GroupBy Stage所有Task状态如下图所示。 从上图可知,记录数最多的Task 20处理的记录数约为1125万,相比于并行度为12时Task 8的4500万,降低了75%左右,而其耗时从原来Task 8的38秒降到了24秒。 在这种场景下,调整并行度,并不意味着一定要增加并行度,也可能是减小并行度。如果通过groupByKey(11)将Shuffle并行度调整为11,重新提交到Spark。新Job的GroupBy Stage的所有Task状态如下图所示。 从上图可见,处理记录数最多的Task 6所处理的记录数约为1045万,耗时为23秒。处理记录数最少的Task 1处理的记录数约为545万,耗时12秒。 小结 适用场景: 大量不同的Key被分配到了相同的Task造成该Task数据量过大。 解决方案: 调整并行度。一般是增大并行度,但有时如本例减小并行度也可达到效果。 优势: 实现简单,可在需要Shuffle的操作算子上直接设置并行度或者使用spark.default.parallelism设置。如果是Spark SQL,还可通过SET spark.sql.shuffle.partitions=[num_tasks]设置并行度。可用最小的代价解决问题。一般如果出现数据倾斜,都可以通过这种方法先试验几次,如果问题未解决,再尝试其它方法。 劣势: 适用场景少,只能将分配到同一Task的不同Key分散开,但对于同一Key倾斜严重的情况该方法并不适用。并且该方法一般只能缓解数据倾斜,没有彻底消除问题。从实践经验来看,其效果一般。 3、自定义Partitioner 原理 使用自定义的Partitioner(默认为HashPartitioner),将原本被分配到同一个Task的不同Key分配到不同Task。 案例 以上述数据集为例,继续将并发度设置为12,但是在groupByKey算子上,使用自定义的Partitioner(实现如下): 由下图可见,使用自定义Partition后,耗时最长的Task 6处理约1000万条数据,用时15秒。并且各Task所处理的数据集大小相当。 小结 适用场景: 大量不同的Key被分配到了相同的Task,造成该Task数据量过大。 解决方案: 使用自定义的Partitioner实现类代替默认的HashPartitioner,尽量将所有不同的Key均匀分配到不同的Task中。 优势: 不影响原有的并行度设计。如果改变并行度,后续Stage的并行度也会默认改变,可能会影响后续Stage。 劣势: 适用场景有限,只能将不同Key分散开,对于同一Key对应数据集非常大的场景不适用。效果与调整并行度类似,只能缓解数据倾斜而不能完全消除数据倾斜。而且需要根据数据特点自定义专用的Partitioner,不够灵活。 4、将Reduce side Join转变为Map side Join 原理 通过Spark的Broadcast机制,将Reduce侧Join转化为Map侧Join,避免Shuffle从而完全消除Shuffle带来的数据倾斜。 案例 通过如下SQL创建一张具有倾斜Key且总记录数为1.5亿的大表test。 使用如下SQL创建一张数据分布均匀且总记录数为50万的小表test_new。 直接通过Spark Thrift Server提交如下SQL将表test与表test_new进行Join并将Join结果存于表test_join中。 该SQL对应的DAG如下图所示。从该图可见,该执行过程总共分为三个Stage,前两个用于从Hive中读取数据,同时二者进行Shuffle,通过最后一个Stage进行Join并将结果写入表test_join中。 从下图可见,Join Stage各Task处理的数据倾斜严重,处理数据量最大的Task耗时7.1分钟,远高于其它无数据倾斜的Task约2秒的耗时。 接下来,尝试通过Broadcast实现Map侧Join。实现Map侧Join的方法,并非直接通过CACHE TABLE test_new将小表test_new进行cache。现通过如下SQL进行Join。 通过如下DAG图可见,该操作仍分为三个Stage,且仍然有Shuffle存在,唯一不同的是,小表的读取不再直接扫描Hive表,而是扫描内存中缓存的表。 并且数据倾斜仍然存在。如下图所示,最慢的Task耗时为7.1分钟,远高于其它Task的约2秒。 正确的使用Broadcast实现Map侧Join的方式是,通过SET spark.sql.autoBroadcastJoinThreshold=104857600;将Broadcast的阈值设置得足够大。 再次通过如下SQL进行Join。 通过如下DAG图可见,该方案只包含一个Stage。 并且从下图可见,各Task耗时相当,无明显数据倾斜现象。并且总耗时为1.5分钟,远低于Reduce侧Join的7.3分钟。 小结 适用场景: 参与Join的一边数据集足够小,可被加载进Driver并通过Broadcast方法广播到各个Executor中。 解决方案: 在Java/Scala代码中将小数据集数据拉取到Driver,然后通过Broadcast方案将小数据集的数据广播到各Executor。或者在使用SQL前,将Broadcast的阈值调整得足够多,从而使用Broadcast生效。进而将Reduce侧Join替换为Map侧Join。 优势: 避免了Shuffle,彻底消除了数据倾斜产生的条件,可极大提升性能。 劣势: 要求参与Join的一侧数据集足够小,并且主要适用于Join的场景,不适合聚合的场景,适用条件有限。 5、为skew的key增加随机前/后缀 原理 为数据量特别大的Key增加随机前/后缀,使得原来Key相同的数据变为Key不相同的数据,从而使倾斜的数据集分散到不同的Task中,彻底解决数据倾斜问题。Join另一则的数据中,与倾斜Key对应的部分数据,与随机前缀集作笛卡尔乘积,从而保证无论数据倾斜侧倾斜Key如何加前缀,都能与之正常Join。 案例 通过如下SQL,将id为9亿到9.08亿共800万条数据的id转为9500048或者9500096,其它数据的id除以100取整。从而该数据集中,id为9500048和9500096的数据各400万,其它id对应的数据记录数均为100条。这些数据存于名为test的表中。 对于另外一张小表test_new,取出50万条数据,并将id(递增且唯一)除以100取整,使得所有id都对应100条数据。 通过如下代码,读取test表对应的文件夹内的数据并转换为JavaPairRDD存于leftRDD中,同样读取test表对应的数据存于rightRDD中。通过RDD的join算子对leftRDD与rightRDD进行Join,并指定并行度为48。 从下图可看出,整个Join耗时1分54秒,其中Join Stage耗时1.7分钟。 通过分析Join Stage的所有Task可知,在其它Task所处理记录数为192.71万的同时Task 32的处理的记录数为992.72万,故它耗时为1.7分钟,远高于其它Task的约10秒。这与上文准备数据集时,将id为9500048为9500096对应的数据量设置非常大,其它id对应的数据集非常均匀相符合。 现通过如下操作,实现倾斜Key的分散处理: 将leftRDD中倾斜的key(即9500048与9500096)对应的数据单独过滤出来,且加上1到24的随机前缀,并将前缀与原数据用逗号分隔(以方便之后去掉前缀)形成单独的leftSkewRDD 将rightRDD中倾斜key对应的数据抽取出来,并通过flatMap操作将该数据集中每条数据均转换为24条数据(每条分别加上1到24的随机前缀),形成单独的rightSkewRDD 将leftSkewRDD与rightSkewRDD进行Join,并将并行度设置为48,且在Join过程中将随机前缀去掉,得到倾斜数据集的Join结果skewedJoinRDD 将leftRDD中不包含倾斜Key的数据抽取出来作为单独的leftUnSkewRDD 对leftUnSkewRDD与原始的rightRDD进行Join,并行度也设置为48,得到Join结果unskewedJoinRDD 通过union算子将skewedJoinRDD与unskewedJoinRDD进行合并,从而得到完整的Join结果集 具体实现代码如下: 从下图可看出,整个Join耗时58秒,其中Join Stage耗时33秒。 通过分析Join Stage的所有Task可知: 由于Join分倾斜数据集Join和非倾斜数据集Join,而各Join的并行度均为48,故总的并行度为96 由于提交任务时,设置的Executor个数为4,每个Executor的core数为12,故可用Core数为48,所以前48个Task同时启动(其Launch时间相同),后48个Task的启动时间各不相同(等待前面的Task结束才开始) 由于倾斜Key被加上随机前缀,原本相同的Key变为不同的Key,被分散到不同的Task处理,故在所有Task中,未发现所处理数据集明显高于其它Task的情况 实际上,由于倾斜Key与非倾斜Key的操作完全独立,可并行进行。而本实验受限于可用总核数为48,可同时运行的总Task数为48,故而该方案只是将总耗时减少一半(效率提升一倍)。如果资源充足,可并发执行Task数增多,该方案的优势将更为明显。在实际项目中,该方案往往可提升数倍至10倍的效率。 小结 适用场景: 两张表都比较大,无法使用Map则Join。其中一个RDD有少数几个Key的数据量过大,另外一个RDD的Key分布较为均匀。 解决方案: 将有数据倾斜的RDD中倾斜Key对应的数据集单独抽取出来加上随机前缀,另外一个RDD每条数据分别与随机前缀结合形成新的RDD(相当于将其数据增到到原来的N倍,N即为随机前缀的总个数),然后将二者Join并去掉前缀。然后将不包含倾斜Key的剩余数据进行Join。最后将两次Join的结果集通过union合并,即可得到全部Join结果。 优势: 相对于Map则Join,更能适应大数据集的Join。如果资源充足,倾斜部分数据集与非倾斜部分数据集可并行进行,效率提升明显。且只针对倾斜部分的数据做数据扩展,增加的资源消耗有限。 劣势: 如果倾斜Key非常多,则另一侧数据膨胀非常大,此方案不适用。而且此时对倾斜Key与非倾斜Key分开处理,需要扫描数据集两遍,增加了开销。 6、大表随机添加N种随机前缀,小表扩大N倍 原理 如果出现数据倾斜的Key比较多,上一种方法将这些大量的倾斜Key分拆出来,意义不大。此时更适合直接对存在数据倾斜的数据集全部加上随机前缀,然后对另外一个不存在严重数据倾斜的数据集整体与随机前缀集作笛卡尔乘积(即将数据量扩大N倍)。 案例 这里给出示例代码,读者可参考上文中分拆出少数倾斜Key添加随机前缀的方法,自行测试。 小结 适用场景: 一个数据集存在的倾斜Key比较多,另外一个数据集数据分布比较均匀。 优势: 对大部分场景都适用,效果不错。 劣势: 需要将一个数据集整体扩大N倍,会增加资源消耗。 三、总结 对于数据倾斜,并无一个统一的一劳永逸的方法。更多的时候,是结合数据特点(数据集大小,倾斜Key的多少等)综合使用上文所述的多种方法。希望本文能对你有所帮助和启发。 本文作者:郭俊 来源:51CTO

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册