首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

刨析SpringIOC及其启动原理

IOC总结 1. IOC概述 >三个问题: > > 1. IOC是什么 > 2. 为什么用它 > 3. 怎么用 1.1 是什么? 两个概念:控制反转,依赖注入 来看一下传统的干活方式:在对象单一职责原则的基础上,一个对象很少有不依赖其他对象而完成自己的工作,所以这个时候就会出现对象之间的依赖。而体现在我们的开发中,就是需要什么对象的时候,就创建什么对象,此时对象创建的控制权在我们自己手里。当对象创建的太多的时候,就会出现一个对象更改,就得更改所有依赖它的对象,耦合性大。自主性体现的同时也出现了对象耦合严重的情况。 这个时候,我们就会思考,能不能我们在用的时候直接拿到这个对象去用,而将创建对象的能力交给第三方,这样我们就不需要关心对象是怎么创建的了。即将自己的控制权交出去。这就是控制反转 这个时候,就会有另一个问题产生了,对象怎么才能直接被我们拿来用呢。对象创建的时候,我们把这个对象注入到这个对象中,然后就可以使用了。这就是依赖注入 另一个问题,**耦合性怎么被解决掉的?**通过控制反转我们仅仅使用了这个对象,如果对象发生了修改,我们仅仅需要修改第三方创建对象的方式即可,这个时候难道还会出现所谓的对象耦合吗?:smile: 完成这些工作的就是IOC容器,它帮助我们创建对象,然后在对象被使用的时候,将对象注入到这个对象中。而由于IOC创建对象是通过反射来创建的,所以其速度不如直接new对象 还不理解???放心,听笔者讲一个故事,笔者最喜欢讲故事了 前段时间,天气逐渐回暖,鉴于家里没有短袖的情况,笔者只能选择购买了。这个时候笔者有两种选择,第一、去生产衣服的厂家直接去买(便宜);第二、去实体店或者网店购买(较昂贵)。之后,由于笔者属于宅男大军的一员,直接网上购物。 这个场景就是一个典型的控制反转的过程。笔者不需要关注衣服怎么生产的,而是仅仅去淘宝(IOC容器)上,寻找自己想要的衣服(对象),然后直接拿过来用即可。但是由于存在中间商赚差价,所以价格更贵(时间更长):see_no_evil: 最后两句话: 控制反转:将自己的控制权交给自己信任的第三方,甲乙之间不存在依赖关系 依赖注入:开放一个端口留给A,然后在需要的时候,将B注入到A中。 1.2 为什么用 在上面,笔者已经很清晰的描述了为什么要使用IOC,主要原因就是由于对象之间的耦合。 1.3 怎么用 1.3.1 XML 通过书写XML配置文件,向容器中添加需要注入的Bean 1.3.2 Annotation 通过@Configuration注解指定配置类。 2. IOC架构 一个图搞定,这个就是IOC的架构思路,这不是其执行流程图。 我们接下来一步一步来解读。 2.1 白话版 在第一章中我们了解了IOC是来帮助我们管理和创建对象的。 这个时候我们需要一个承载我们需要创建信息的容器,即图中的XML或者注解,那么有了我们自己的BeanDefiniton信息以后,我们需要一个接口用来读取这些信息,于是出现了BeanDefinitionReader用来读取我们自己的Bean信息。 那么我们需要考虑一个问题了,那么多的对象怎么生产呢? 答案就是工厂模式。Spring默认的工厂是DefaultListableBeanFactory,没错,Spring中的所有对象(容器对象和我们自己创建的对象)都是由他创建的。大批量生产对象 这个时候又有了一个问题,我们不想通过BeanFactory直接生产了,需要对这个工厂进行一些特定处理,于是出现了BeanFactoryPostProcessor,用来对工厂做一些特定的处理。我们自己可以通过实现这个接口,进行自定义BeanFactory。又有兄弟说了:我想单独创建一些我喜欢的对象,安排,FactoryBean诞生了,它可以帮助我们创建一个我们需要的对象(第四部分详细解释他们之间的区别)。 那又有兄弟说了:我想让统一的对象创建之前按照我的方式进行一些特殊的行为,简单,安排:see_no_evil: BeanPostProcessor出现了,他提供了两个方法:一个在对象实例化之后初始化之前,执行内部的Before方法,在初始化之后,执行After方法。(Bean生命周期,第四部分详解) 这个时候有兄弟有疑问了,不是说BeanPostProcessor在创建对象之前执行吗?怎么是创建完毕以后才执行的Before方法。 如果各位兄弟了解过指令重排序这个概念,那么一定会听过一个案例,创建一个对象需要三步 创建空间(实例化) 初始化 赋值 其中在初始化和赋值会出现指令重排序 根据这个点,应该可以get到一个点,实例化和初始化不一样。 所以又引出了一个点,我们对Bean进行一些操作,怎么操作,肯定是修改属性,或者添加一些属性等等,需要等待其在堆中开辟空间即实例化完成以后执行吧。 所以BeanPostProcessor的before方法在实例化之后执行,初始化之前执行。 经历过前面一大堆的操作以后,终于我们的对象进入我们兜里了(容器里)。 关于销毁,一般情况下我们通过ApplicationContext拿不到其销毁方法,只能通过其子类实现获取,关于销毁同样的流程,先执行一个销毁之前的操作,然后再销毁。 2.2 实际工作流程 看过Spring源码或者听过的都知道里面有一个方法叫做refresh,他完成了好多事情。当然他的行为也代表了整个IOC容器加载和实例化对象的过程。第三章的代码解读中我们仔细看 执行过程: 加载配置文件,初始化系统环境Environment接口 准备上下文环境,初始化一些配置资源 创建一个工厂 为工厂添加各种环境 获取子类自己重写的BeanFactoryPostProcessor 执行容器和我们自己的BeanFactoryPostProcessor 注册BeanPostProcessor 国际化处理 转播器 子类初始化Bean 注册监听器,观察者模式 完成Bean创建 发布相应的事件,监听器 3. IOC源码解读 >写在之前:IOC的源码比较复杂,所以个人建议视频方式学习,大家可以B站搜索阁主梧桐(笔者认为讲的不错的一个解读),如果大家不喜欢视频的方式,又想深度学习IOC源码那么推荐**程序员囧辉**它的博客对于IOC的讲解非常深入。另外本文接下来的Spring源码,主要是通过图示的方法梳理其流程,作者水平有限。如有错误请留言。 3.1 上下文配置启动 在创建ClassPathXmlApplicationContext的时候,构造方法中执行了这些方法。 说白了,加载了一个解析配置文件路径的加载器;然后又通过系统环境变量拿到这个配置文件,进行一些配置文件的去空格,转换表达式等等操作(没有进行解析);最后就是那个被我标成红色东东,refresh方法中它完成了几乎所有的工作。下面细聊 3.2 refresh 这个方法几乎完成了所有的操作,创建工厂,执行Processor等等,实例化对象,开启事件监听等等。 接下来细聊 3.3.1 prepareRefresh() 这个方法的主要作用是为应用上下文的刷新做一些准备性的工作。校验资源文件,设置启动时间和活跃状态等。 3.3.2 obtainFreshBeanFactory() 可以get到,它主要就是创建了一个工厂BeanFactory,并且解析了配置文件,加载了Bean定义信息(面试的时候直接答这个点就够了,如果想说的可以将下面的bean信息加载聊聊) 没错,标红的就是咱接下来细聊的点 这个就是加载配置文件的过程,注意:此时仍然没有解析,解析在标红的下面 这个就是读取的过程,具体解析流程来自parse中,这个直接调用了Java中的解析XML的类库,有兴趣自行翻阅,最后返回了一个Document对象。 通过Document对象,读取内部的标签,执行不同的方法,逻辑和MyBatis中解析配置文件的思想相同,大家自行翻阅。 此时所有的Bean定义信息都被保存到了BeanDefinitionRegistry接口,然后走子类DefaultListableBeanFactory工厂的注册方法 3.3.3 prepareBeanFactory(beanFactory) 为BeanFactory准备一些环境,方便在实例化的时候使用,同时添加容器自己的BeanPostProcessor 3.3.4 postProcessBeanFactory 留给子类扩展的BeanFactoryPostProcessor, 3.3.5 invokeBeanFactoryPostProcessors(beanFactory) 这个类,涉及到了两个接口。 BeanFactoryPostProcessor BeanDefinitionRegistryPostProcessor接口,这个接口是BeanFactoryPostProcessor的子接口,它的优先级比BeanFactoryPostProcessor更高 它的总体执行流程是:先执行BeanDefinitionRegistryPostProcessor的BeanFactoryPostProcessor,然后再执行BeanFactoryPostProcessor 下图是BeanDefinitionRegistryPostProcessor接口的处理过程 BeanFactoryPostProcessor的处理逻辑 总逻辑就是先分类,已经处理过的直接跳过,没有处理过的,分类处理,逻辑和上面的相同。 3.3.6 registerBeanPostProcessors 这个方法的逻辑和上面的一样,只不过上面是直接执行了BeanFactoryPostProcessor,而这个仅仅注册没执行。 首先拿到工厂中所有的BeanPostProcessor类型的Bean,然后分类处理,排序注册。 3.3.7 initMessageSource() 执行国际化内容 3.3.8 initApplicationEventMulticaster 创建了一个多播器,为添加Listener提供支持。 主要逻辑: 容器中是否存在applicationEventMulticaster,如果存在直接注册 如果不存在,创建一个SimpleApplicationEventMulticaster,注册到容器中。 3.3.9 onRefresh() 子类扩展 3.3.10 registerListeners() 观察者模式的实现 protected void registerListeners() { // 拿到当前容器中的监听器,注册到多播器中 for (ApplicationListener<!--?--> listener : getApplicationListeners()) { getApplicationEventMulticaster().addApplicationListener(listener); } //拿到容器中为监听器的Bean,注册 String[] listenerBeanNames = getBeanNamesForType(ApplicationListener.class, true, false); for (String listenerBeanName : listenerBeanNames) { getApplicationEventMulticaster().addApplicationListenerBean(listenerBeanName); } // 清空开始的事件,到广播器中 Set<applicationevent> earlyEventsToProcess = this.earlyApplicationEvents; this.earlyApplicationEvents = null; if (earlyEventsToProcess != null) { for (ApplicationEvent earlyEvent : earlyEventsToProcess) { getApplicationEventMulticaster().multicastEvent(earlyEvent); } } } 3.3.11 finishBeanFactoryInitialization >这一部分的内容太多了,所以采用代码和图解的方式来讲解。 /** * Finish the initialization of this context's bean factory, * initializing all remaining singleton beans. 在上下文工厂中完成所有Bean 的初始化 */ protected void finishBeanFactoryInitialization(ConfigurableListableBeanFactory beanFactory) { // 初始化上下文转换服务Bean if (beanFactory.containsBean(CONVERSION_SERVICE_BEAN_NAME) &amp;&amp; beanFactory.isTypeMatch(CONVERSION_SERVICE_BEAN_NAME, ConversionService.class)) { beanFactory.setConversionService( beanFactory.getBean(CONVERSION_SERVICE_BEAN_NAME, ConversionService.class)); } //如果不存在前入值解析器,则注册一个默认的嵌入值解析器,主要是注解属性解析 if (!beanFactory.hasEmbeddedValueResolver()) { beanFactory.addEmbeddedValueResolver(strVal -&gt; getEnvironment().resolvePlaceholders(strVal)); } // 初始化LoadTimeWeaverAware String[] weaverAwareNames = beanFactory.getBeanNamesForType(LoadTimeWeaverAware.class, false, false); for (String weaverAwareName : weaverAwareNames) { getBean(weaverAwareName); } // Stop using the temporary ClassLoader for type matching. beanFactory.setTempClassLoader(null); // Allow for caching all bean definition metadata, not expecting further changes. beanFactory.freezeConfiguration(); // Instantiate all remaining (non-lazy-init) singletons. //实例化,重点 beanFactory.preInstantiateSingletons(); } 下图是创建Bean的主要流程 按照途中的序号一个一个说: BeanDefinition是否需要合并。BeanDefinition根据不同类型的配置文件信息,会将Bean封装到不同的Bean信息定义类中。比如我们常用的配置文件版的GenericBeanDefinition;注解扫描版的ScannedGenericBeanDefinition等等。 而在这个过程中就出现了,父定义和子定义,我们需要在实际处理定义信息的时候进行合并处理,主要有一下三个方面 存在父定义信息,使用父定义信息创建一个RootBeanDefinition,然后将自定义信息作为参数传入。 不存在父定义信息,并且当前BeanDefinition是RootBeanDefintion类型的,直接返回一份RootBeanDefintion的克隆 不存在父定义信息,并且当前BeanDefintion不是RootBeanDefintiton类型的,直接通过该BeanDefintion构建一个RootBeanDefintion返回 上面的流程也是源码中的执行流程 isFactoryBean。判断是否为FactoryBean 简单介绍一下:FactoryBean是让开发者创建自己需要Bean接口。内部提供了三个方法 T getObject() throws Exception;//返回的Bean信息 Class<!--?--> getObjectType();//返回的Bean类型 default boolean isSingleton() {return true;}//是否单例 当我们通过GetBean直接该Bean的时候,获取到的是该工厂指定返回的Bean类型。如果想要获取该Bean本身,需要通过一个前缀获得&amp; @Override public boolean isFactoryBean(String name) throws NoSuchBeanDefinitionException { String beanName = transformedBeanName(name); //解析真正的BeanName Object beanInstance = getSingleton(beanName, false);//获取容器中的bean if (beanInstance != null) {//如果容器中存在,直接返回该Bean是否为FactoryBea类型 return (beanInstance instanceof FactoryBean); } //没有Bean信息,检查这个Bean信息 if (!containsBeanDefinition(beanName) &amp;&amp; getParentBeanFactory() instanceof ConfigurableBeanFactory) { // 从父工厂中获取 return ((ConfigurableBeanFactory) getParentBeanFactory()).isFactoryBean(name); } //MergedBeanDefinition来检查beanName对应的Bean是否为FactoryBean return isFactoryBean(beanName, getMergedLocalBeanDefinition(beanName)); } 再来看一个点,这个就是从容器中获取Bean的主要方法,也是解决循环依赖的逻辑 protected Object getSingleton(String beanName, boolean allowEarlyReference) { //查看当前容器中是否存在该Bean Object singletonObject = this.singletonObjects.get(beanName); //如果不存在,且当前Bean正在被创建 if (singletonObject == null &amp;&amp; isSingletonCurrentlyInCreation(beanName)) { synchronized (this.singletonObjects) { //从早期的容器中获取Bean singletonObject = this.earlySingletonObjects.get(beanName); //如果早期容器也没有且允许创建早期引用 if (singletonObject == null &amp;&amp; allowEarlyReference) { //获取该Bean的ObjectFactory工厂 ObjectFactory<!--?--> singletonFactory = this.singletonFactories.get(beanName); //如果当前工厂不为空 if (singletonFactory != null) { //创建一个对象实例,此时处于半初始化状态 singletonObject = singletonFactory.getObject(); //添加到早期引用中 this.earlySingletonObjects.put(beanName, singletonObject); //移除创建早期引用的工厂,因为该Bean已经创建且添加到了早期容器中,不需要再次进行创建了。 this.singletonFactories.remove(beanName); } } } } return singletonObject; } 来聊一下它是怎么解决循环引用的? 它引入了一个三级缓存的概念 /**存放了所有的单例Bean */ private final Map<string, object> singletonObjects = new ConcurrentHashMap&lt;&gt;(256); /** 存放了Bean创建需要的ObejctFactory */ private final Map<string, objectfactory<?>&gt; singletonFactories = new HashMap&lt;&gt;(16); /** 存放了早期创建的Bean,此时的Bean没有进行属性赋值,仅仅通过构造方法创建了一个实例 */ private final Map<string, object> earlySingletonObjects = new HashMap&lt;&gt;(16); //正在创建的Bean private final Set<string> singletonsCurrentlyInCreation = Collections.newSetFromMap(new ConcurrentHashMap&lt;&gt;(16)); 在发生循环引用的时候,它首先通过ObejctFactory工厂将Bean创建出来,**此时的对象并没有进行属性赋值,仅仅在堆中开辟了空间。**然后将此时的Bean添加到earlySingletonObjects容器里,**也就是说这个容器中保存的Bean都是半成品。**而在之后的属性赋值中,由于对象为单例的,所以其引用地址不会发生变化,即对象最终是完整的。 getBean。通过这个方法直接创建了所有的对象,这也是Spring最核心的方法了 先来看一下它整体的一个流程 它的主要逻辑是:先拿到当前要实例化的Bean的真实名字,主要是为了处理FactoryBean,拿到以后,从当前容器中看是否已经创建过该Bean,如果存在直接返回。 如果不存在,获取其父工厂,如果父工厂不为空,而且当前容器中不存在当前Bean的信息,则尝试从父工厂中获取Bean定义信息,进行Bean实例化 如果父工厂为空,将当前Bean信息存放到alreadyCreated缓存中。 获取当前Bean的合并信息(getMergedLocalBeanDefinition),查看当前Bean是否存在依赖,如果存在则判断当前Bean和依赖Bean是否为循环依赖,如果不是循环依赖则先创建依赖Bean 判断当前Bean的作用域。 如果当前Bean是单例对象,直接创建Bean实例 如果当前Bean是多例对象,将当前Bean信息添加到正在创建多例缓存中,创建完毕以后移除 如果当前Bean是其他类型,如Requtst,Session等类型,则自定义一个ObejctFacotry工厂,重写getObject方法,创建对象 对象创建以后,判断当前对象是否为自己需要的对象,如果是直接返回;如果不是进行类型转换,如果类型转换失败,直接抛异常 接下来看一眼CreateBean的执行 这个方法主要完成的事情是:通过Bean的名字拿到对应的Class对象;如果当前Bean获取到的Class对象不为空且该RootDefintiton可以直接获取到该Bean,克隆一份Bean定义信息,方便之后使用。 验证当前Bean上的@Override信息。执行BeanPostProcessor,返回一个代理对象(如果存在代理的话) 如果不存在代理,则直接创建Bean 接下来我们来聊一下这个玩意——resolveBeforeInstantiation protected Object resolveBeforeInstantiation(String beanName, RootBeanDefinition mbd) { Object bean = null; if (!Boolean.FALSE.equals(mbd.beforeInstantiationResolved)) { // Make sure bean class is actually resolved at this point. //当前定义信息不是合并,且存在Bean增强器 if (!mbd.isSynthetic() &amp;&amp; hasInstantiationAwareBeanPostProcessors()) { //获取Bean的Class类型 Class<!--?--> targetType = determineTargetType(beanName, mbd); if (targetType != null) { //如果不为null,则执行前置处理器 bean = applyBeanPostProcessorsBeforeInstantiation(targetType, beanName); if (bean != null) { //如果前置处理器不为null,则后置处理器执行,跳过spring默认初始化 bean = applyBeanPostProcessorsAfterInitialization(bean, beanName); } } } //代表已经再实例化之前进行了解析 mbd.beforeInstantiationResolved = (bean != null); } return bean; } 来吧,继续,看一下那个前置处理器逻辑 protected Object applyBeanPostProcessorsBeforeInstantiation(Class<!--?--> beanClass, String beanName) { for (BeanPostProcessor bp : getBeanPostProcessors()) { //拿到工厂中的所有的BeanPostProcessor if (bp instanceof InstantiationAwareBeanPostProcessor) { //找到所有我们需要的增强器 InstantiationAwareBeanPostProcessor ibp = (InstantiationAwareBeanPostProcessor) bp; // 返回一个代理实例 Object result = ibp.postProcessBeforeInstantiation(beanClass, beanName); if (result != null) { return result; } } } return null; } 后置处理器就不看了,就调用了所有的后置处理器,然后执行了一遍,没有其他逻辑。 接下来继续我们的正题:doCreateBean 其大致流程如上图: 先判断以后是否单例,然后从FactoryBean缓存中看一下是否存在正在创建的Bean,如果存在拿出,如果不存在则创建一个当前Bean的包装类实例。然后拿到这个类的实例和实例类型,执行以后后置处理器。 当前Bean是否为单例,是否允许循环依赖,时候正在进行创建,如果是,创建一个当前Bean的ObejctFactory以解决循环依赖的问题 填充Bean的属性,进行Bean的实例化。 查看早期容器缓存中(缓存中的二级缓存中是否有该Bean)。如果有,则说明存在循环依赖,则进行处理 先看循环依赖吧 if (earlySingletonExposure) { //从早期的Bean容器中拿到实例对象,此时的Bean必然存在循环依赖 Object earlySingletonReference = getSingleton(beanName, false); if (earlySingletonReference != null) { if (exposedObject == bean) { exposedObject = earlySingletonReference; } else if (!this.allowRawInjectionDespiteWrapping &amp;&amp; hasDependentBean(beanName)) { //获取依赖的全部Bean信息 String[] dependentBeans = getDependentBeans(beanName); Set &lt; String &gt; actualDependentBeans = new LinkedHashSet &lt; &gt; (dependentBeans.length); for (String dependentBean: dependentBeans) { //清除这些Bean信息,此时的Bean已经是脏数据了 if (!removeSingletonIfCreatedForTypeCheckOnly(dependentBean)) { //无法清理存入actualDependentBeans中 actualDependentBeans.add(dependentBean); } } if (!actualDependentBeans.isEmpty()) { throw new BeanCurrentlyInCreationException } } } } // Register bean as disposable. try { registerDisposableBeanIfNecessary(beanName, bean, mbd); } catch (BeanDefinitionValidationException ex) { throw new BeanCreationException( mbd.getResourceDescription(), beanName, "Invalid destruction signature", ex); } 接着来,createBeanInstance Spring提供了三种方式创建对象的包装: 通过供给者对象对象直接创建。obtainFromSupplier 通过工厂方法直接创建。 默认创建。 构造方法是否需要自动注入 构造方法不需要自动注入,调用默认的构造方法 这个方法执行完毕以后,你应该知晓的一个点是:此时对象实例已经创建了,剩下的就是执行一系列增强器和初始化方法,属性填充等等。 我们按照代码执行顺序来,属性填充即populateBean 这个方法执行逻辑: 首先判断传入的Bean是否为null,如果为null则判断Bean定义信息中是否存在属性值,如果存在,异常;如果不存在跳过 当前Bean定义信息是否为合并以后的,如果是且此时的工厂中存在InstantiationAwareBeanPostProcessors,那么在属性填充之前进行修改Bean的信息 拿到所有的属性值,解析属性值的自动注入方式,Type或者Name,进行自动注入 判断是否存在InstantiationAwareBeanPostProcessors,修改之前设置的属性 判断是否存在依赖检查,检查依赖 属性赋值 接下来看执行初始化方法,就是调用BeanPostprocessor,init等方法 这个就是这个方法的执行流程图,相信到这个地方,大家应该对于为什么BeanPostProcessor的before方法会在init方法执行了解了。这个方法的作用仅仅是用来进行一个生命周期的打印,对象在之前已经创建了。 接下来看一下销毁的方法。registerDisposableBeanIfNecessary 对于单例Bean来说,Spring将需要销毁的Bean存放到了disposableBeans缓存中,通过DisposableBeanAdapter封装了销毁Bean 对于其他作用域来说,自定义了销毁回调函数,不过最后还是封装为DisposableBeanAdapter 在封装为DisposableBeanAdapter的过程中,会首先判断该Bean中是否存在destroy方法,然后给赋值给destroyMethodName变量。再次判断这个方法的参数,如果参数的个数大于1,则抛出异常 3.3.12 finishRefresh 这个方法进行了一系列的资源清理和 protected void finishRefresh() { // 清空上下文资源缓存 clearResourceCaches(); // 初始化生命周期处理器 initLifecycleProcessor(); // 将已经刷新完毕的处理器传播(扔到)生命周期处理器中 getLifecycleProcessor().onRefresh(); // 推送上下文刷新完毕的时间到相应的监听器 publishEvent(new ContextRefreshedEvent(this)); // Participate in LiveBeansView MBean, if active. LiveBeansView.registerApplicationContext(this); } initLifecycleProcessor,这个方法极具简单,就看一下当前Bean中是否存在生命周期处理器,如果存在直接使用这个,如果不存在则创建一个默认的,并且注册为一个单例的扔到容器中。 4. 常见题目 4.1 Bean的生命周期? >Spring官方解释在BeanDefinition接口的注释里 答:Bean完整的生命周期是: 设置一系列Aware接口的功能 实例化Bean 调用BeanPostProcessor的before方法 执行InitializingBean接口方法afterPropertiesSet 执行init方法 调用BeanPostProcessor的postProcessAfterInitialization方法 调用DestructionAwareBeanPostProcessors接口的postProcessBeforeDestruction方法 调用destory方法 4.2 FactoryBean和BeanFactory的区别 答:BeanFactory是Spring默认生产对象的工厂。 ​ FactoryBean是Spring提供的一个生产特定类型和特定对象的工厂。例如Mybatis-spring中的SqlSessionFactoryBean就是通过这种方法创建的。 4.3 什么是循环依赖?Spring如何处理循环依赖的? 答:循环依赖是指:在创建A对象的时候需要注入B对象;在创建B对象的时候需要注入A对象,两者互相依赖。 出现循环依赖有两种情况: 构造器依赖(无法解决) 属性注入(可以解决) 解决循环依赖,Spring引入了三级缓存的概念。上面的源码讲解中介绍过 singletonObjects存放了所有的单例Bean,此时所有的Bean信息都是完整的 earlySingletonObjects存放了早期的Bean,此时仅仅创建了一个Bean实例,未进行属性填充 singletonFactories存放了Bean的工厂 Spring通过将创建Bean的工厂暴露出来,然后在出现循环依赖的时候通过这个工厂常见一个bean,然后将这个Bean注入,由于对象是单例的,所以在接下来的属性填充中,可以保证为同一个对象,至此,循环依赖解除。 > 使用三太子敖丙的一句话:解决循环依赖的过程就是力扣中的第一题两数之和的过程 4.4 什么是IOC 答:IOC存在两个点: 控制反转。将常见对象的控制权交给第三方,这里的第三方就是Spring 依赖注入。在类中需要使用到的对象,全部通过反射从第三方容器注入而不是自己创建。这里的第三方容器即Spring 4.5 ApplicationContext和BeanFactory的区别 答: ApplicationContext采用了立即加载,即加载配置文件的时候就创建了对象。BeanFactory采用了延时加载的方式,使用的时候才创建。 对于BeanPostProcessor和BeanFactoryProcessor而言,BeanFactory是手动注册,ApplicationContext采用了自动注册。 4.6 Spring 框架中都用到了哪些设计模式? 答: 单例模式。这个不需要多说 代理模式。AOP使用到的 装饰着模式。BeanWrapper 工厂模式。BeanFactory,创建对象的时候 模板方法模式。JDBCTemplate 观察者模式。各种事件监听 …… </string></string,></string,></string,></applicationevent>

优秀的个人博客,低调大师

Redis GeoHash核心原理解析

1. 引言 小麦同学是个吃货+技术宅,平日里就喜欢拿着手机地图点点按按来查询一些好玩的东西。某一天到北海公园游玩,肚肚饿了,于是乎打开手机地图,搜索北海公园附近的餐馆,并选了其中一家用餐。饱暖思yin欲的麦叔饭后思考地图后台如何根据自己所在位置查询来查询附近餐馆的呢?苦思冥想了半天,小麦想出了个方法:计算所在位置P与北京所有餐馆的距离,然后返回距离<=1000米的餐馆。小得意了一会儿,小麦发现北京的餐馆何其多啊,这样计算不得了,于是想了,既然知道经纬度了,那它应该知道自己在西城区,那应该计算所在位置P与西城区所有餐馆的距离啊,机机运用了递归的思想,想到了西城区也很多餐馆啊,应该计算所在位置P与所在街道所有餐馆的距离,这样计算量又小了,效率也提升了。 小麦的计算思想很朴素,就是通过过滤的方法来减小参与计算的餐馆数目,从某种角度上讲,机机在使用索引技术。 一提到索引,大家脑子里马上浮现出B树索引,因为大量的数据库(如MySQL、oracle、PostgreSQL等)都在使用B树。B树索引本质上是对索引字段进行排序,然后通过类似二分查找的方法进行快速查找,即它要求索引的字段是可排序的,一般而言,可排序的是一维字段,比如时间、年龄、薪水等等。但是对于空间上的一个点(二维,包括经度和纬度),如何排序呢?又如何索引呢?解决的方法很多,下文介绍一种方法来解决这一问题。 思想:如果能通过某种方法将二维的点数据转换成一维的数据,那样不就可以继续使用B树索引了嘛。那这种方法真的存在嘛,答案是肯定的。目前很火的GeoHash算法就是运用了上述思想,下面我们就开始GeoHash之旅吧。 2. 感性认识 先来两个干货,在线查看GPS某个区域的GeoHash值。 1. http://geohash.gofreerange.com/ 在这里插入图片描述 2. http://www.geohash.cn/ 跟更好用些 3. 通俗说 GeoHash将二维的经纬度转换成字符串,比如下图展示了北京9个区域的GeoHash字符串,分别是WX4ER,WX4G2、WX4G3等等,每一个字符串代表了某一矩形区域。也就是说,这个矩形区域内所有的点(经纬度坐标)都共享相同的GeoHash字符串,这样既可以保护隐私(只表示大概区域位置而不是具体的点),又比较容易做缓存,比如左上角这个区域内的用户不断发送位置信息请求餐馆数据,由于这些用户的GeoHash字符串都是WX4ER,所以可以把WX4ER当作key,把该区域的餐馆信息当作value来进行缓存,而如果不使用GeoHash的话,由于区域内的用户传来的经纬度是各不相同的,很难做缓存。字符串越长,表示的范围越精确。如图所示,5位的编码能表示10平方千米范围的矩形区域,而6位编码能表示更精细的区域(约0.34平方千米)字符串相似的表示距离相近(特殊情况后文阐述),这样可以利用字符串的前缀匹配来查询附近的POI信息。如下两个图所示,第一个在城区,第二个在郊区,城区的GeoHash字符串之间比较相似,郊区的字符串之间也比较相似,而城区和郊区的GeoHash字符串相似程度要低些。通过上面的介绍我们知道了GeoHash就是一种将经纬度转换成字符串的方法,并且使得在大部分情况下,字符串前缀匹配越多的距离越近,回到我们的案例,根据所在位置查询来查询附近餐馆时,只需要将所在位置经纬度转换成GeoHash字符串,并与各个餐馆的GeoHash字符串进行前缀匹配,匹配越多的距离越近。 4. GeoHash算法的步骤 下面以北海公园附近随便一个位置为例介绍GeoHash算法的计算步骤,先用百度 GPS反定位系统查找看下经纬度。纬度=116.395371,经度=39.931957。 根据经纬度计算GeoHash二进制编码 地球纬度区间是[-90,90], 北海公园的纬度是39.928167,可以通过下面算法对纬度39.928167进行逼近编码: 区间[-90,90]进行二分为[-90,0),[0,90],称为左右区间,可以确定39.928167属于右区间[0,90],给标记为1; 接着将区间[0,90]进行二分为 [0,45),[45,90],可以确定39.928167属于左区间 [0,45),给标记为0; 递归上述过程39.928167总是属于某个区间[a,b]。随着每次迭代区间[a,b]总在缩小,并越来越逼近39.928167; 如果给定的纬度x(39.928167)属于左区间,则记录0,如果属于右区间则记录1,这样随着算法的进行会产生一个序列1011100,序列的长度跟给定的区间划分次数有关。 39.928167 根据纬度算编码 bit min mid max 1 -90.000 0.000 90.000 0 0.000 45.000 90.000 1 0.000 22.500 45.000 1 22.500 33.750 45.000 1 33.750 39.375 45.000 0 39.375 42.188 45.000 0 39.375 40.7815 42.188 0 39.375 40.07825 40.7815 1 39.375 39.726625 40.07825 1 39.726625 39.9024375 40.07825 同理,地球经度区间是[-180,180],可以对经度116.389550进行编码。根据经度算编码 bit min mid max 1 -180 0.000 180 1 0.000 90 180 0 90 135 180 1 90 112.5 135 0 112.5 123.75 135 0 112.5 118.125 123.75 1 112.5 115.3125 118.125 0 115.3125 116.71875 118.125 1 115.3125 116.015625 116.71875 1 116.015625 116.3671875 116.71875 组码 通过上述计算,纬度产生的编码为10111 00011,经度产生的编码为11010 01011。偶数位放经度,奇数位放纬度,把2串编码组合生成新串:11100 11101 00100 01111。最后使用用0-9、b-z(去掉a, i, l, o)这32个字母进行base32编码,首先将11100 11101 00100 01111转成十进制,对应着28、29、4、15,十进制对应的编码就是wx4g。同理,将编码转换成经纬度的解码算法与之相反,具体不再赘述。 5. GeoHash Base32编码长度与精度 可以看出,当geohash base32编码长度为8时,精度在19米左右,而当编码长度为9时,精度在2米左右,编码长度需要根据数据情况进行选择。 一、经纬度距离换算 在纬度相等的情况下: 经度每隔0.00001度,距离相差约1米; 每隔0.0001度,距离相差约10米; 每隔0.001度,距离相差约100米; 每隔0.01度,距离相差约1000米; 每隔0.1度,距离相差约10000米。 在经度相等的情况下: 纬度每隔0.00001度,距离相差约1.1米; 每隔0.0001度,距离相差约11米; 每隔0.001度,距离相差约111米; 每隔0.01度,距离相差约1113米; 每隔0.1度,距离相差约11132米。 6. GeoHash算法 上文讲了GeoHash的计算步骤,仅仅说明是什么而没有说明为什么?为什么分别给经度和维度编码?为什么需要将经纬度两串编码交叉组合成一串编码?本节试图回答这一问题。 如下图所示,我们将二进制编码的结果填写到空间中,当将空间划分为四块时候,编码的顺序分别是左下角00,左上角01,右下脚10,右上角11,也就是类似于Z的曲线,当我们递归的将各个块分解成更小的子块时,编码的顺序是自相似的(分形),每一个子快也形成Z曲线,这种类型的曲线被称为Peano空间填充曲线。 这种类型的空间填充曲线的优点是将二维空间转换成一维曲线(事实上是分形维),对大部分而言,编码相似的距离也相近, 但Peano空间填充曲线最大的缺点就是突变性,有些编码相邻但距离却相差很远,比如0111与1000,编码是相邻的,但距离相差很大。 除Peano空间填充曲线外,还有很多空间填充曲线,如图所示,其中效果公认较好是Hilbert空间填充曲线,相较于Peano曲线而言,Hilbert曲线没有较大的突变。为什么GeoHash不选择Hilbert空间填充曲线呢?可能是Peano曲线思路以及计算上比较简单吧,事实上,Peano曲线就是一种四叉树线性编码方式。 7. 使用注意点 1. 临界问题 由于GeoHash是将区域划分为一个个规则矩形,并对每个矩形进行编码,这样在查询附近POI信息时会导致以下问题,比如红色的点是我们的位置,绿色的两个点分别是附近的两个餐馆,但是在查询的时候会发现距离较远餐馆的GeoHash编码与我们一样(因为在同一个GeoHash区域块上),而较近餐馆的GeoHash编码与我们不一致。这个问题往往产生在边界处。 解决的思路很简单,我们查询时,除了使用定位点的GeoHash编码进行匹配外,还使用周围8个区域的GeoHash编码,这样可以避免这个问题。 2. 注意点 我们已经知道现有的GeoHash算法使用的是Peano空间填充曲线,这种曲线会产生突变,造成了编码虽然相似但距离可能相差很大的问题,因此在查询附近餐馆时候,首先筛选GeoHash编码相似的POI(point of interest)点,然后进行实际距离计算。 3. 使用心得 GeoHash只是空间索引的一种方式,特别适合点数据,而对线、面数据采用R树索引更有优势(可为什么需要空间索引)。 GeoHash值可以区分精度,位数越多,精度越高,表达的地理位置越精细;如一位的GeoHash值把地球划分为32个矩形,8位的geohash值把地球划分为32^8个小矩形 适合根据某个经纬度坐标position计算出GeoHash值,然后和数据库中精度更高的GeoHash值做前缀比较 8.空间索引 常见问题:如何根据自己所在位置查询来查询附近50米的POI(point of interest,比如商家、景点等)呢(图1a)?每个POI都有经纬度信息,用图1b的SQL语句在mySQL中建立了POI_spatial的表,其中lat和lng两个字段来代表纬度和经度。为后续分析方便起见,我人造了40万个POI数据。 方法一:暴力方法 该方法的思路很直接:计算位置与所有POI的距离,并保留距离小于50米的POI。 插句题外话,计算经纬度之间的距离不能像求欧式距离那样平方开根号,因为地球是个不规整的球体(图2a),普通计算适合都是默认按最简单的完美球体假设,两点之间的距离函数应该如图2b所示。 该方法的复杂度为:40万*距离函数。我们将球体距离函数写为mysql存储过程distance,之后我们执行查询操作(图3),发现花费了4.66秒。 方法二:矩形过滤方法 该方法采用逐步细化的方式,一般分为两部: 先用矩形框过滤(图4a),判断一个点在矩形框内很简单,只要进行两次判断(LtMin<lat<LtMax; LnMin<lng<LnMax),落在矩形框内的POI个数为n(n<<40万); 用球面距离公式计算位置与矩形框内n个POI的距离(图4b),并保留距离小于50米的POI 矩形过滤方法的复杂度:40万矩形过滤函数 + n距离函数(n<<40万)。 根据这个思路我们执行SQl查询(图5)(注:经度或纬度每隔0.001度,距离相差约100米,由此推算出矩形左下角和右上角坐标),发现过滤后正好剩下两个POI。 此查询花费了0.36秒,相比于方法一查询时间大大降低,但是对于一次查询来说还是很长。时间长的原因在于遍历了40万次。 方法三:B树对经度或纬度建立索引 方法二耗时的原因在于执行了遍历操作,为了不进行遍历,我们自然想到了索引。我们对纬度进行了B树索引。 altertablepoi_spatialaddindexlatindex(lat);altertablepoi_spatialaddindexlngindex(lng); 此方法包括三个步骤: 通过B树快速找到某纬度范围的POI(图6a),个数为m(m<40万),复杂度为Log(40万)*过滤函数; 在步骤a过滤得到的m个POI中查找某经度范围的POI(图6b),个数为n(n<m),复杂度为m*过滤函数; 用球面距离公式计算位置与步骤b得到的n个POI的距离(图6c),并保留距离小于50米的POI 执行SQL查询(图7),发现时间已经大大降低,从方法2的0.36秒下降到0.01秒 三、B树能索引空间数据吗? 这时候有人会说了:方法三效果如此好,能够满足我们附近POI查询问题啊,看来B树用来索引空间数据也是可以的嘛!那么B树真的能够索引空间数据吗? 只能对经度或纬度索引(一维索引),与期望的不符 我们期待的是快速找出落在某一空间范围的POI(如矩形)(图8a),而不是快速找出落在某纬度或经度范围的POI(图8b),想象一下,我要查询北京某区的POI,但是B树索引不仅给我找出了北京的,还有与北京同一维度的天津、大同、甚至国外城市的POI,当数据量很大时,效率很低。 当数据是多维,比如三维(x,y,z),B树怎么索引?比如z可能是高程值,也可能是时间。有人会说B树其实可以对多个字段进行索引,但这时需要指定优先级,形成一个组合字段,而空间数据在各个维度方向上不存在优先级,我们不能说纬度比经度更重要,也不能说纬度比高程更重要。 当空间数据不是点,而是线(道路、地铁、河流等),面(行政区边界、建筑物等),B树怎么索引?对于面来说,它由一系列首尾相连的经纬度坐标点组成,一个面可能有成百上千个坐标,这时数据库怎么存储,B树怎么索引,这些都是问题。 既然传统的索引不能很好的索引空间数据,我们自然需要一种方法能对空间数据进行索引,即空间索引。 参考 Java实现GPS范围查找 浙大大佬通俗说GPS 本文分享自微信公众号 - sowhat1412(sowhat9094)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Java注解@Cacheable的工作原理

In order to avoid unnecessary query on database it is a common pattern to define a cache in application layer to cache the query result from database. See one example below. Here the application cache is maintained in a custom class CacheContext. public class AccountService1 { private final Logger logger = LoggerFactory.getLogger(AccountService1.class); private CacheContext<Account> accountCacheContext; public Account getAccountByName(String accountName) { Account result = accountCacheContext.get(accountName); if (result != null) { logger.info("get from cache... {}", accountName); return result; } Optional<Account> accountOptional = getFromDB(accountName); if (!accountOptional.isPresent()) { throw new IllegalStateException(String.format("can not find account by account name : [%s]", accountName)); } Account account = accountOptional.get(); accountCacheContext.addOrUpdateCache(accountName, account); return account; } In Spring there is an annotation @Cacheable which can make the cache managed by Spring instead of application developer. See improved version: public class AccountService2 { private final Logger logger = LoggerFactory.getLogger(AccountService2.class); @Cacheable(value="accountCache") public Account getAccountByName(String accountName) { logger.info("in method getAccountByName, querying account... {}", accountName); Optional<Account> accountOptional = getFromDB(accountName); if (!accountOptional.isPresent()) { throw new IllegalStateException(String.format("can not find account by account name : [%s]", accountName)); } return accountOptional.get(); } In this example, there is no more cache evaluation and cache fill logic. All such stuff are taken over by Spring under the hood and completely transparent to application developer, with the help of following bean configuration in xml: <bean id="cacheManager" class="org.springframework.cache.support.SimpleCacheManager"> <property name="caches"> <set> <bean class="org.springframework.cache.concurrent.ConcurrentMapCacheFactoryBean"> <property name="name" value="default" /> </bean> <bean class="org.springframework.cache.concurrent.ConcurrentMapCacheFactoryBean"> <property name="name" value="accountCache" /> </bean> </set> </property> </bean> And how to research what magic has been done by Spring to achieve this behavior?We use the following code to research. It is expected that the request sent by line 31 will directly reach database, while the second request in line 34 will be handled by Spring cache handler. Here in line 31, in debugger we can find that accountService2 is not an instance of application class com.sap.AccountService2, but a dynamic proxy class generated by Spring. As a result after pressing F5, the intercept method of this dynamic proxy class is called: In this method, the execution will be delegated to Spring cache handler class: In example 1, the logic of cache evaluation and fill is done by application, and now it is done in method execute below. First internal cache managed by Spring is checked in line 336 via method findCachedItem. Due to expected cache miss, our application method will be called as usual via reflection, as demonstrated below: After application method to retrieve account from database is done, the result, Account instance with id 2495 is filled to Spring cache, the variable contexts below. Below is the screenshot for Spring internal cache to store application data, which is based on ConcurrentHashMap. Our cached Account instance with id 2495 could be found there. For the second query request issued by application, the cached result will be returned by Spring handler: The last question is, how and when the dynamic proxy is generated?Again let’s go to the entry point of Beans initialization: Here the dynamic proxy is created based on configuration defined in xml with the help of CGlibAopProxy. For more detail about CGlibAopProxy, please refer to Spring official document. 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

hbase shell实现原理简析

hbase的交互式命令行是通过jruby实现的,当我们输入hbase shell时,实际上最终执行的是org.jruby.Main,并以bin/hirb.rb作为参数,注意是根目录下bin目录中的hirb.rb,而不是hbase-shell中的irb/hirb.rb;这个类来自jruby的包,作用是把ruby编写的代码转换成java字节码,进而能够运行在JVM中; 实现逻辑大体可分为2个阶段:初始化阶段和命令执行阶段,前者是启动shell时的执行逻辑,后者是输入命令后的执行逻辑,以下分别简述其流程; 初始化阶段 1、创建HBaseConfiguration实例,并将启动时带的键值对参数设置进去;2、创建Hbase实例,初始化connection,代码在hbase.rb中;3、创建Shell实例,此时会执行一些load_command_group方法,这些方法实际上是初始化了commands和command_groups这2个map变量,commands中存放了各个命令的name与class的映射关系,代码在shell.rb中;4、接下来执行Shell实例的export_commands方法,通过instance_eval为commands中的所有命令动态添加一个方法到Shell实例中; 命令执行阶段(以list命令为例) 1、执行前述动态生成的list方法;2、执行Shell实例的command方法,参数为list;3、执行internal_command,该方法内部先调用command_instance按一定规则创建该命令对应class的实例:List,所有命令的class都会继承Command类;4、执行List的command_safe方法,这个方法在Command类中,该方法内部通过调用send(cmd, *args)来执行List的command方法,List类定义在list.rb中,Command类定义在commands.rb中;5、List的command方法先后调用了Command、Shell、Hbase等类中的admin方法,最后得到一个Admin实例,该类定义在admin.rb中;6、执行Admin实例的list方法,该方法内部实际上执行了HBaseAdmin的listTableNames来得到结果; 调试 如果希望在本地环节启动hbase shell,可参考如下配置; //Main class org.jruby.Main //VM Options -Dhbase.ruby.sources=E:\github\hbase\hbase-shell\src\main\ruby //Program argument E:\github\hbase\bin\hirb.rb //Use classpath of module hbase-shell 默认情况下连的是localhost的hbase,如果希望连远程集群,可以修改hbase-shell模块中hbase.rb的configuration,指定hbase.zookeeper.quorum参数即可;

优秀的个人博客,低调大师

SAP CRM Relationship API设计原理

Unlike settype, relationship does not have a dedicated read function module maintained in its metadata table. Instead, the generic read function module COM_IL_DB_READ is used. Below is a simple explanation about each parameter of FM COM_IL_DB_READ, using read on relationship PRDCPN for example. IV_RELTYPE PRDCPN - relationship name IV_ATTR_TYPE COMT_IL_PRDCPN_ATTR_TYPE - contains relationship specific business data, in this example, the customer product id is stored in field PRID_VENDOR IT_LINK_IDENTS sourceguid or destiguid contains product guid. This will be used by the generic read API to select against DB table using OPEN SQL. The exporting parameter: ET_INTERLINKAGE - relationship header data - generic data ET_IL_ATTR Relationship specific data, in this example, PRID_VENDOR, stores the detail value. Approach1 If we can enhance COM_IL_DB_READ, we then redirect the read from CRM relationship storage table to S4 relationship storage table.Since it is not allowed to enhance SAP_ABA function module, we have to consider CDS view redirect.Further research is needed here: compare the structure of both storage table in CRM and S4 and evaluate whether view direct is feasible or not. Approach2 Since we can only make changes on BBPCRM, we have to copy the whole implementation which are in SAP_ABAP listed below into new function & subroutine, make needed changes ( table redirect ) and let FORM UI_GETDETAIL call those new implementations. This approach takes huge effort. 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

MySQL运行原理与基础架构!

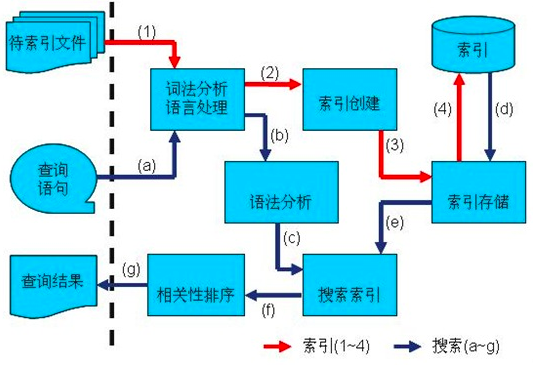
下面是关于上述部件的介绍: connectors 与其他编程语言中的sql 语句进行交互,如php、java等。 Management Serveices & Utilities系统管理和控制工具 Connection Pool (连接池)管理缓冲用户连接,线程处理等需要缓存的需求 SQL Interface (SQL接口)接受用户的SQL命令,并且返回用户需要查询的结果。比如select from就是调用SQL Interface Parser (解析器)SQL命令传递到解析器的时候会被解析器验证和解析。 主要功能: a . 将SQL语句分解成数据结构,并将这个结构传递到后续步骤,后面SQL语句的传递和处理就是基于这个结构的 如果在分解构成中遇到错误,那么就说明这个sql语句是不合理的,语句将不会继续执行下去 Optimizer (查询优化器)SQL语句在查询之前会使用查询优化器对查询进行优化(产生多种执行计划,最终数据库会选择最优化的方案去执行,尽快返会结果) 他使用的是“选取-投影-联接”策略进行查询。 用一个例子就可以理解: select uid,name from user where gender = 1; 这个select 查询先根据where 语句进行选取,而不是先将表全部查询出来以后再进行gender过滤 这个select查询先根据uid和name进行属性投影,而不是将属性全部取出以后再进行过滤 将这两个查询条件联接起来生成最终查询结果. Cache和Buffer (查询缓存)如果查询缓存有命中的查询结果,查询语句就可以直接去查询缓存中取数据。 这个缓存机制是由一系列小缓存组成的。比如表缓存,记录缓存,key缓存,权限缓存等 8.Engine (存储引擎) 存储引擎是MySql中具体的与文件打交道的子系统。也是Mysql最具有特色的一个地方。 Mysql的存储引擎是插件式的。它根据MySql AB公司提供的文件访问层的一个抽象接口来定制一种文件访问机制(这种访问机制就叫存储引擎) SQL 语句执行过程 数据库通常不会被直接使用,而是由其他编程语言通过SQL语句调用mysql,由mysql处理并返回执行结果。那么Mysql接受到SQL语句后,又是如何处理的呢? 首先程序的请求会通过mysql的connectors与其进行交互,请求到处后,会暂时存放在连接池(connection pool)中并由处理器(Management Serveices & Utilities)管理。当该请求从等待队列进入到处理队列,管理器会将该请求丢给SQL接口(SQL Interface)。SQL接口接收到请求后,它会将请求进行hash处理并与缓存中的结果进行对比,如果完全匹配则通过缓存直接返回处理结果;否则,需要完整的走一趟流程: (1)由SQL接口丢给后面的解释器(Parser),上面已经说到,解释器会判断SQL语句正确与否,若正确则将其转化为数据结构。 (2)解释器处理完,便来到后面的优化器(Optimizer),它会产生多种执行计划,最终数据库会选择最优化的方案去执行,尽快返会结果。 (3)确定最优执行计划后,SQL语句此时便可以交由存储引擎(Engine)处理,存储引擎将会到后端的存储设备中取得相应的数据,并原路返回给程序。 这里有几点需要注意: (1)如何缓存查询数据? 存储引擎处理完数据,并将其返回给程序的同时,它还会将一份数据保留在缓存中,以便更快速的处理下一次相同的请求。具体情况是,mysql会将查询的语句、执行结果等进行hash,并保留在cache中,等待下次查询。 (2)buffer与cache的区别? 从上面的图可以看到,缓存那里实际上有buffer和cache两个,那它们之间是否有什么不同呢?简单的说就是,buffer是写缓存,cache是读缓存。 (3)如何判断缓存中是否已缓存需要的数据 这里可能有一个误区,觉得处理SQL语句的时候,为了判断是否已缓存查询结果,会将整个流程走一遍,取得执行结果后再与需要的进行对比,看看是否命中,并以此说,既然不管缓存中有没有缓存到查询内容,都要整个流程走一遍,那么缓存的优势又在哪里?? 实际上,并非如此,在第一次查询后,mysql便将查询语句以及查询结果进行hash处理并保留在缓存中,SQL查询到达之后,对其进行同样的hash处理后,将两个hash值进行对照,如果一样,则命中,从缓存中返回查询结果;否则,需要整个流程走一遍。 ​

优秀的个人博客,低调大师

HashMap原理及内部存储结构

本文将通过如下简单的代码来分析HashMap的内部数据结构的变化过程。 public static void main(String[] args) { Map<String, String> map = new HashMap<>(); for (int i = 0; i < 50; i++) { map.put("key" + i, "value" + i); } } 1 数据结构说明 HashMap中本文需要用到的几个字段如下: 下面说明一下几个字段的含义 1.1 table // HashMap内部使用这个数组存储所有键值对 transient Node<K,V>[] table; Node的结构如下: 可以发现,Node其实是一个链表,通过next指向下一个元素。 1.2 size 记录了HashMap中键值对的数量 1.3 modCount 记录了HashMap在结构上更改的次数,包括可以更改键值对数量的操作,例如put、remove,还有可以修改内部结构的操作,例如rehash。 1.4 threshold 记录一个临界值,当已存储键值对的个数大于这个临界值时,需要扩容。 1.5 loadFactor 负载因子,通常用于计算threshold,threshold=总容量*loadFactor。 2 new HashMap new HashMap的源码如下: /** * The load factor used when none specified in constructor. * 负载因子,当 已使用容量 > 总容量 * 负载因子 时,需要扩容 */ static final float DEFAULT_LOAD_FACTOR = 0.75f; public HashMap() { this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted } 此时,HashMap只初始化了负载因子(使用默认值0.75),并没有初始化table数组。其实HashMap使用的是延迟初始化策略,当第一次put的时候,才初始化table(此时table是null)。 3 table数组的初始化 当第一次put的时候,HashMap会判断当前table是否为空,如果是空,会调用resize方法进行初始化。resize方法会初始化一个容量大小为16 的数组,并赋值给table。 并计算threshold=16*0.75=12。 此时table数组的状态如下: 4 put过程 map.put("key0", "value0"); 首先计算key的hash值,hash("key0") = 3288451 计算这次put要存入数组位置的索引值:index=(数组大小 - 1) & hash = 3 判断 if (table[index] == null) 就new一个Node放到这里,此时为null,所以直接new Node放到3上,此时table如下: 然后判断当前已使用容量大小(size)是否已经超过临界值threshold,此时size=1,小于12,不做任何操作,put方法结束(如果超过临界值,需要resize扩容)。 继续put。。。 map.put("key1", "value1"); map.put("key1", "value1"); map.put("key2", "value2"); map.put("key3", "value3"); map.put("key4", "value4"); map.put("key5", "value5"); map.put("key6", "value6"); map.put("key8", "value7"); map.put("key9", "value9"); map.put("key10", "value10"); map.put("key11", "value11"); 此时size=12,下一次put后size为13,大于当前threshold,将触发扩容(resize) map.put("key12", "value12"); 计算Key的hash值,hash("key12")=101945043,计算要存入table位置的索引值 = (总大小 - 1) & hash = (16 - 1) & 101945043 = 3 从目前的table状态可知,table[3] != null,但此时要put的key与table[3].key不相等,我们必须要把他存进去,此时就产生了哈希冲突(哈希碰撞)。 这时链表就派上用场了,HashMap就是通过链表解决哈希冲突的。 HashMap会创建一个新的Node,并放到table[3]链表的最后面。 此时table状态如下: 5 resize扩容 此时table中一共有13个元素,已经超过了threshold(12),需要对table调用resize方法扩容。 HashMap会创建一个容量为之前两倍(162=32)的table,并将旧的Node复制到新的table中,新的临界值(threshold)为24(320.75)。 下面主要介绍一下复制的过程(并不是原封不动的复制,Node的位置可能发生变化) 先来看源码: for (int j = 0; j < oldCap; ++j) { // oldCap:旧table的大小 =16 Node<K,V> e; if ((e = oldTab[j]) != null) { // oldTab:旧table的备份 oldTab[j] = null; // 如果数组中的元素没有后继节点,直接计算新的索引值,并将Node放到新数组中 if (e.next == null) newTab[e.hash & (newCap - 1)] = e; // 忽略这个else if。其实,如果链表的长度超过8,HashMap会把这个链表变成一个树结构,树结构中的元素是TreeNode else if (e instanceof TreeNode) ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); // 有后继节点的情况 else { // preserve order Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; // 【说明1】 if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); if (loTail != null) { loTail.next = null; newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; //【说明2】 newTab[j + oldCap] = hiHead; } } } } 【说明1】遍历链表,计算链表每一个节点在新table中的位置。 计算位置的方式如下: 1)如果节点的 (hash & oldCap) == 0,那么该节点还在原来的位置上,为什么呢? 因为oldCap=16,二进制的表现形式为0001 0000,任何数&16,如果等于0,那么这个数的第五个二进制位必然为0。 以当前状态来说,新的容量是32,那么table的最大index是31,31的二进制表现形式是00011111。 计算index的方式是 hash & (容量 - 1),也就是说,新index的计算方式为 hash & (32 - 1) 假设Node的hash = 01101011,那么 01101011 & 00011111 ---------- 00001011 = 11 2)下面再对比(hash & oldCap) != 0的情况 如果节点的(hash & oldCap) != 0,那么该节点的位置=旧index + 旧容量大小 假设Node的hash = 01111011,那么 01111011 & 00011111 ---------- 00011011 = 27 上一个例子的hash值01101011跟这个例子的hash值01111011只是在第5位二进制上不同,可以发现,这两个值在旧的table中,是在同一个index中的,如下: 01101011 & 00001111 ---------- 00001011 = 11 01111011 & 00001111 ---------- 00001011 = 11 由于扩容总是以2倍的方式进行,也就是:旧容量 << 1,这也就解释了【说明2】,当(hash & oldCap) != 0时,这个Node的新index = 旧index + 旧容量大小。 扩容后,table状态如下所示: 最终,重新分配完所有的Node后,扩容结束。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册