首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

sqlx操作MySQL实战及其原理

sqlx是Golang中的一个知名三方库,其为Go标准库database/sql提供了一组扩展支持。使用它可以方便的在数据行与Golang的结构体、映射和切片之间进行转换,从这个角度可以说它是一个ORM框架;它还封装了一系列地常用SQL操作方法,让我们用起来更爽。 sqlx实战 这里以操作MySQL的增删改查为例。 准备工作 先要准备一个MySQL,这里通过docker快速启动一个MySQL 5.7。 docker run -d --name mysql1 -p 3306:3306 -e MYSQL_ROOT_PASSWORD=123456 mysql:5.7 在MySQL中创建一个名为test的数据库: CREATE DATABASE `test` /*!40100 DEFAULT CHARACTER SET utf8mb4 */; 数据库中创建一个名为Person的数据库表: CREATE TABLE test.Person ( Id integer auto_increment NOT NULL, Name VARCHAR(30) NULL, City VARCHAR(50) NULL, AddTime DATETIME NOT NULL, UpdateTime DATETIME NOT NULL, CONSTRAINT Person_PK PRIMARY KEY (Id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci; 然后创建一个Go项目,安装sqlx: go get github.com/jmoiron/sqlx 因为操作的是MySQL,还需要安装MySQL的驱动: go get github.com/go-sql-driver/mysql 编写代码 添加引用 添加sqlx和mysql驱动的引用: import ( "log" _ "github.com/go-sql-driver/mysql" "github.com/jmoiron/sqlx" ) MySQL的驱动是隐式注册的,并不会在接下来的程序中直接调用,所以这里加了下划线。 创建连接 操作数据库前需要先创建一个连接: db, err := sqlx.Connect("mysql", "root:123456@tcp(127.0.0.1:3306)/test?charset=utf8mb4&parseTime=true&loc=Local") if err != nil { log.Println("数据库连接失败") } 这个连接中指定了程序要用MySQL驱动,以及MySQL的连接地址、用户名和密码、数据库名称、字符编码方式;这里还有两个参数parseTime和loc,parseTime的作用是让MySQL中时间类型的值可以映射到Golang中的time.Time类型,loc的作用是设置time.Time的值的时区为当前系统时区,不使用这个参数的话保存到的数据库的就是UTC时间,会和北京时间差8个小时。 增删改查 sqlx扩展了DB和Tx,继承了它们原有的方法,并扩展了一些方法,这里主要看下这些扩展的方法。 增加 通用占位符的方式: insertResult := db.MustExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES (?, ?, ?, ?)", "Zhang San", "Beijing", time.Now(), time.Now()) lastInsertId, _ := insertResult.LastInsertId() log.Println("Insert Id is ", lastInsertId) 这个表的主键使用了自增的方式,可以通过返回值的LastInsertId方法获取。 命名参数的方式: insertPerson := &Person{ Name: "Li Si", City: "Shanghai", AddTime: time.Now(), UpdateTime: time.Now(), } insertPersonResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:Name, :City, :AddTime, :UpdateTime)", insertPerson) 命名参数的方式是sqlx扩展的,这个方式就是常说的ORM。这里需要注意给struct字段添加上db标签: type Person struct { Id int `db:"Id"` Name string `db:"Name"` City string `db:"City"` AddTime time.Time `db:"AddTime"` UpdateTime time.Time `db:"UpdateTime"` } struct中的字段名称不必和数据库字段相同,只需要通过db标签映射正确就行。注意SQL语句中使用的命名参数需要是db标签中的名字。 除了可以映射struct,sqlx还支持map,请看下面这个示例: insertMap := map[string]interface{}{ "n": "Wang Wu", "c": "HongKong", "a": time.Now(), "u": time.Now(), } insertMapResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:n, :c, :a, :u)", insertMap) 再来看看批增加的方式: insertPersonArray := []Person{ {Name: "BOSIMA", City: "Wu Han", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOSSMA", City: "Xi An", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOMA", City: "Cheng Du", AddTime: time.Now(), UpdateTime: time.Now()}, } insertPersonArrayResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:Name, :City, :AddTime, :UpdateTime)", insertPersonArray) if err != nil { log.Println(err) return } insertPersonArrayId, _ := insertPersonArrayResult.LastInsertId() log.Println("InsertPersonArray Id is ", insertPersonArrayId) 这里还是采用命名参数的方式,参数传递一个struct数组或者切片就可以了。这个执行结果中也可以获取到最后插入数据的自增Id,不过实测返回的是本次插入的第一条的Id,这个有点别扭,但是考虑到增加多条只获取一个Id的场景似乎没有,所以也不用多虑。 除了使用struct数组或切片,也可以使用map数组或切片,这里就不贴出来了,有兴趣的可以去看文末给出的Demo链接。 删除 删除也可以使用通用占位符和命名参数的方式,并且会返回本次执行受影响的行数,某些情况下可以使用这个数字判断SQL实际有没有执行成功。 deleteResult := db.MustExec("Delete from Person where Id=?", 1) log.Println(deleteResult.RowsAffected()) deleteMapResult, err := db.NamedExec("Delete from Person where Id=:Id", map[string]interface{}{"Id": 1}) if err != nil { log.Println(err) return } log.Println(deleteMapResult.RowsAffected()) 修改 Sqlx对修改的支持和删除差不多: updateResult := db.MustExec("Update Person set City=?, UpdateTime=? where Id=?", "Shanghai", time.Now(), 1) log.Println(updateResult.RowsAffected()) updateMapResult, err := db.NamedExec("Update Person set City=:City, UpdateTime=:UpdateTime where Id=:Id", map[string]interface{}{"City": "Chong Qing", "UpdateTime": time.Now(), "Id": 1}) if err != nil { log.Println(err) } log.Println(updateMapResult.RowsAffected()) 查询 Sqlx对查询的支持比较多。 使用Get方法查询一条: getPerson := &Person{} db.Get(getPerson, "select * from Person where Name=?", "Zhang San") 使用Select方法查询多条: selectPersons := []Person{} db.Select(&selectPersons, "select * from Person where Name=?", "Zhang San") 只查询部分字段: getId := new(int64) db.Get(getId, "select Id from Person where Name=?", "Zhang San") selectTowFieldSlice := []Person{} db.Select(&selectTowFieldSlice, "select Id,Name from Person where Name=?", "Zhang San") selectNameSlice := []string{} db.Select(&selectNameSlice, "select Name from Person where Name=?", "Zhang San") 从上可以看出如果只查询部分字段,还可以继续使用struct;特别的只查询一个字段时,使用基本数据类型就可以了。 除了这些高层次的抽象方法,Sqlx也对更低层次的查询方法进行了扩展: 查询单行: row = db.QueryRowx("select * from Person where Name=?", "Zhang San") if row.Err() == sql.ErrNoRows { log.Println("Not found Zhang San") } else { queryPerson := &Person{} err = row.StructScan(queryPerson) if err != nil { log.Println(err) return } log.Println("QueryRowx-StructScan:", queryPerson.City) } 查询多行: rows, err := db.Queryx("select * from Person where Name=?", "Zhang San") if err != nil { log.Println(err) return } for rows.Next() { rowSlice, err := rows.SliceScan() if err != nil { log.Println(err) return } log.Println("Queryx-SliceScan:", string(rowSlice[2].([]byte))) } 命名参数Query: rows, err = db.NamedQuery("select * from Person where Name=:n", map[string]interface{}{"n": "Zhang San"}) 查询出数据行后,这里有多种映射方法:StructScan、SliceScan和MapScan,分别对应映射后的不同数据结构。 预处理语句 对于重复使用的SQL语句,可以采用预处理的方式,减少SQL解析的次数,减少网络通信量,从而提高SQL操作的吞吐量。 下面的代码展示了sqlx中如何使用stmt查询数据,分别采用了命名参数和通用占位符两种传参方式。 bosima := Person{} bossma := Person{} nstmt, err := db.PrepareNamed("SELECT * FROM Person WHERE Name = :n") if err != nil { log.Println(err) return } err = nstmt.Get(&bossma, map[string]interface{}{"n": "BOSSMA"}) if err != nil { log.Println(err) return } log.Println("NamedStmt-Get1:", bossma.City) err = nstmt.Get(&bosima, map[string]interface{}{"n": "BOSIMA"}) if err != nil { log.Println(err) return } log.Println("NamedStmt-Get2:", bosima.City) stmt, err := db.Preparex("SELECT * FROM Person WHERE Name=?") if err != nil { log.Println(err) return } err = stmt.Get(&bosima, "BOSIMA") if err != nil { log.Println(err) return } log.Println("Stmt-Get1:", bosima.City) err = stmt.Get(&bossma, "BOSSMA") if err != nil { log.Println(err) return } log.Println("Stmt-Get2:", bossma.City) 对于上文增删改查的方法,sqlx都有相应的扩展方法。与上文不同的是,需要先使用SQL模版创建一个stmt实例,然后执行相关SQL操作时,不再需要传递SQL语句。 数据库事务 为了在事务中执行sqlx扩展的增删改查方法,sqlx必然也对数据库事务做一些必要的扩展支持。 tx, err = db.Beginx() if err != nil { log.Println(err) return } tx.MustExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES (?, ?, ?, ?)", "Zhang San", "Beijing", time.Now(), time.Now()) tx.MustExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES (?, ?, ?, ?)", "Li Si Hai", "Dong Bei", time.Now(), time.Now()) err = tx.Commit() if err != nil { log.Println(err) return } log.Println("tx-Beginx is successful") 上面这段代码就是一个简单的sqlx数据库事务示例,先通过db.Beginx开启事务,然后执行SQL语句,最后提交事务。 如果想要更改默认的数据库隔离级别,可以使用另一个扩展方法: tx, err = db.BeginTxx(context.Background(), &sql.TxOptions{Isolation: sql.LevelRepeatableRead}) sqlx干了什么 通过上边的实战,基本上就可以使用sqlx进行开发了。为了更好的使用sqlx,我们可以再了解下sqlx是怎么做到上边这些扩展的。 Go的标准库中没有提供任何具体数据库的驱动,只是通过database/sql库定义了操作数据库的通用接口。sqlx中也没有包含具体数据库的驱动,它只是封装了常用SQL的操作方法,让我们的SQL写起来更爽。 MustXXX sqlx提供两个几个MustXXX方法。 Must方法是为了简化错误处理而出现的,当开发者确定SQL操作不会返回错误的时候就可以使用Must方法,但是如果真的出现了未知错误的时候,这个方法内部会触发panic,开发者需要有一个兜底的方案来处理这个panic,比如使用recover。 这里是MustExec的源码: func MustExec(e Execer, query string, args ...interface{}) sql.Result { res, err := e.Exec(query, args...) if err != nil { panic(err) } return res } NamedXXX 对于需要传递SQL参数的方法, sqlx都扩展了命名参数的传参方式。这让我们可以在更高的抽象层次处理数据库操作,而不必关心数据库操作的细节。 这种方法的内部会解析我们的SQL语句,然后从传递的struct、map或者slice中提取命名参数对应的值,然后形成新的SQL语句和参数集合,再交给底层database/sql的方法去执行。 这里摘抄一些代码: func NamedExec(e Ext, query string, arg interface{}) (sql.Result, error) { q, args, err := bindNamedMapper(BindType(e.DriverName()), query, arg, mapperFor(e)) if err != nil { return nil, err } return e.Exec(q, args...) } NamedExec 内部调用了 bindNamedMapper,这个方法就是用于提取参数值的。其内部分别对Map、Slice和Struct有不同的处理。 func bindNamedMapper(bindType int, query string, arg interface{}, m *reflectx.Mapper) (string, []interface{}, error) { ... switch { case k == reflect.Map && t.Key().Kind() == reflect.String: ... return bindMap(bindType, query, m) case k == reflect.Array || k == reflect.Slice: return bindArray(bindType, query, arg, m) default: return bindStruct(bindType, query, arg, m) } } 以批量插入为例,我们的代码是这样写的: insertPersonArray := []Person{ {Name: "BOSIMA", City: "Wu Han", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOSSMA", City: "Xi An", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOMA", City: "Cheng Du", AddTime: time.Now(), UpdateTime: time.Now()}, } insertPersonArrayResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:Name, :City, :AddTime, :UpdateTime)", insertPersonArray) 经过bindNamedMapper处理后SQL语句和参数是这样的: 这里使用了反射,有些人可能会担心性能的问题,对于这个问题的常见处理方式就是缓存起来,sqlx也是这样做的。 XXXScan 这些Scan方法让数据行到对象的映射更为方便,sqlx提供了StructScan、SliceScan和MapScan,看名字就可以知道它们映射的数据结构。而且在这些映射能力的基础上,sqlx提供了更为抽象的Get和Select方法。 这些Scan内部还是调用了database/sql的Row.Scan方法。 以StructScan为例,其使用方法为: queryPerson := &Person{} err = row.StructScan(queryPerson) 经过sqlx处理后,调用Row.Scan的参数是: 以上就是本文的主要内容,如有错漏,欢迎指正。 老规矩,Demo程序已经上传到Github,欢迎访问:https://github.com/bosima/go-demo/tree/main/sqlx-mysql 收获更多架构知识,请关注微信公众号 萤火架构。原创内容,转载请注明出处。

优秀的个人博客,低调大师

StarRocks 技术内幕:查询原理浅析

一条查询 SQL 在关系型分布式数据库中的处理,通常需要经过 3 大步骤: 1. 将 SQL 文本转换成一个 “最佳的”分布式物理执行计划 2. 将执行计划调度到计算节点 3. 计算节点执行具体的物理执行计划 本文将详细解释在 StarRocks 中如何完成一条查询 SQL 的处理。 首先来了解 StarRocks 中的基本概念: FE: 负责查询解析,查询优化,查询调度和元数据管理 BE: 负责查询执行和数据存储 #01 从 SQL 文本到执行计划 — 从 SQL 文本到分布式物理执行计划, 在 StarRocks 中,需要经过以下 5 个步骤: 1. SQL Parse:将 SQL 文本转换成一个 AST(抽象语法树) 2. SQL Analyze:基于 AST 进行语法和语义分析 3. SQL Logical Plan:将 AST 转换成逻辑计划 4. SQL Optimize:基于关系代数、统计信息、Cost 模型,对逻辑计划进行重写、转换,选择出 Cost “最低” 的物理执行计划 5. 生成 Plan Fragment:将 Optimizer 选择的物理执行计划转换为 BE 可以直接执行的 Plan Fragment SQL Parse 图 1 Query Parse 的输入是 SQL 的 String 字符串,Query Parse 的输出是 Abstract Syntax Tree,每个节点都是一个 ParseNode 。 一个查询 SQL Parse 后生成一个 QueryStmt, 由 SelectList, FromClause, wherePredicate, GroupByClause, havingPredicate, OrderByElement, LimitElement 等组成,基本和 SQL 文本一一对应。 StarRocks 目前使用的 Parser 是 ANTLR4,语法规则定义的文件可在 GitHub 搜索StarRocks g4 获取。 SQL Analyze StarRocks 获取到 AST 后,接着会进行语法分析和语义分析,完成下面的工作: 1. 检查并绑定 Database, Table, Column 等元信息 2. SQL 的合法性检查:Where 中不能有 Grouping 操作, HLL 和 Bitmap 列不能 Sum 等 3. Table 和 Column 的别名处理 4. 函数参数的合法性检测: Sum的参数类型必须是数值类型,Lead 和 Lag 窗口函数第 2 和第 3 个参数必须常量等 5. 类型检查和类型转换:BIGINT 和 DECIMAL 比较,BIGINT 类型需要 Cast 成 DECIMAL SQL Analyze 的结果是一个有层级结构的 Relation,如图 2 所示,比如一个 From 子句对应一个 TableRelation, 一个子查询对应一个 SubqueryRelation。 SQL Logical Plan 图 2 接下来,StarRocks 会将 Relations 转化成一颗 Logical Plan Tree, 如图 2 所示,可以简单理解为每个集合操作都会对应一个 Logical Node。 SQLOptimize 图 3 StarRocks Optimizer 的输入是一棵逻辑计划树,输出是一棵 Cost “最低” 的分布式物理计划树。 一般 SQL 越复杂,Join 的表越多,数据量越大,Optimizer 的意义就越大,因为不同执行方式的性能差别可能有成百上千倍。StarRocks 优化器完全自研,主要基于 Cascades 和 ORCA 论文实现,并结合 StarRocks 执行器和调度器进行了深度定制,优化和创新。 它完整支持了 TPC-DS 99 条 SQL,实现了公共表达式复用,相关子查询重写,Lateral Join, CTE 复用,Join Rorder,Join 分布式执行策略选择,Global Runtime Filter 下推,低基数字典优化等重要功能和优化。 Logical Plan Rewrite 图 4 在正式进入 CBO 之前,StarRocks 会首先进行一系列 Logical Plan 的 Rewrite,Rewrite 阶段的 Rule 我们认为都会生成更优的 Logical Plan,主要的 Rewrite Rule 有下面这些: 各种表达式的重写和化简 列裁剪 谓词下推 Limit Merge, Limit 下推 聚合 Merge 等价谓词推导(常量传播) Outer Join 转 Inner Join 常量折叠 公共表达式复用 子查询重写 Lateral Join 化简 分区分桶裁剪 Empty Node 优化 Empty Union, Intersect, Except 裁剪 Intersect Reorder Count Distinct 相关聚合函数重写 CBO Transform 我们在 Logical Plan Rewrite 完成后,正式基于 Columbia 论文进行 CBO 优化,主要包括下面的优化: 多阶段聚合优化:普通聚合(count, sum, max, min 等)会拆分成两阶段,单个 Count Distinct 查询会拆分成三阶段或是四阶段。 Join 左右表调整:StarRocks 始终用右表构建 Hash 表,所以右表应该是小表,StarRocks 可以基于 cost 自动调整左右表顺序,也会自动把 Left Join 转 Right Join。 Join 多表 Reorder:多表 Join 如何选择出正确的 Join 顺序,是 CBO 优化器的核心。当 Join 表的数量小于等于 5 时,StarRocks 会基于 Join 交换律和结合律进行 Join Reorder,大于 5 时,StarRocks 会基于贪心算法和动态规划进行 Join Reorder。 Join 分布式执行选择:StarRocks 支持的分布式 Join 方式有 Broadcast、Shuffle、单边 Shuffle、Colocate、Replicated。StarRocks 会基于 Cost 估算和 Property Enforce 机制选择出 “最佳” 的 Join 分布式执行方式。 Push Down Aggregate to Join 物化视图选择与重写 图 5 如图 5 所示, 在 CBO 优化中,Logical Plan 会先转成 Memo 的数据结构。Memo 的中文含义是备忘录,所有的逻辑计划和物理计划都会记录在 Memo 中, Memo 就构成了整个搜索空间 。 然后如图 6 所示,StarRocks 应用各种 Rule 扩展搜索空间,并生成对应的物理执行计划,再基于统计信息和 Cost 估计从 Memo 中选择一组 Cost 最低的物理执行计划。 图 6 统计信息 和 Cost 估计 CBO 优化器好坏的关键之一是 Cost 估计是否准确,而 Cost 估计是否准确的关键点之一是统计信息是否收集及时准确。 StarRocks 目前支持表级别和列级别的统计信息,支持自动收集和手动收集两种方式。无论自动还是手动,都支持全量和抽样收集两种方式。 有了统计信息之后, StarRocks 就会基于统计信息进行 Cost 估算。StarRocks 估算 Cost 时会考虑 CPU、内存、网络、IO 等资源因子,每个资源因子会有不同的权重,每个执行算子的 Cost 计算公式都不太一样。 当你使用 StarRocks 发现 Join 左右表不合理、Join 分布式执行策略不合理时,可以参考 StarRocks CBO 使用文档收集统计信息。 生成 Plan fragment 图 7 StarRocks Optimizer 的输出是一棵分布式物理执行计划树,但并不能直接被 BE 节点执行,所以需要转换成 BE 可以直接执行的 PlanFragment。转换过程基本是个一一映射的过程。 #02 执行计划的调度 — 在生成查询的分布式 Plan 之后,FE 调度模块会负责 PlanFragment 的执行实例生成、PlanFragment 的调度、每个 BE 执行状态的管理、查询结果的接收。 图 8 有了分布式执行计划之后,我们需要解决下面的问题: 1. 哪个 BE 执行哪个 PlanFragment 2. 每个 Tablet 选择哪个副本去查询 3. 多个 PlanFragment 如何调度 StarRocks 会首先确认 Scan Operator 所在的 Fragment 在哪些 BE 节点执行,每个 Scan Operator 有需要访问的 Tablet 列表。然后对于每个 Tablet,StarRocks 会先选择版本匹配的、健康的、所在的 BE 状态正常的副本进行查询。在最终决定每个 Tablet 选择哪个副本查询时,采用的是随机方式,不过 StarRocks 会尽可能保证每个 BE 的请求均衡。假如我们有 10 个 BE、10 个 Tablet,最终调度的结果理论上就是每个 BE 负责 1 个 Tablet 的 Scan。 当确定包含 Scan 的 PlanFragment 由哪些 BE 节点执行后,其他的 PlanFragment 实例也会在 Scan 的 BE 节点上执行 (也可以通过参数选择其他 BE 节点 ),不过具体选择哪个 BE 是随机选取的。 当 FE 确定每个 PlanFragment 由哪个 BE 执行,每个 Tablet 查询哪个副本后,FE 就会将 PlanFragment 执行相关的参数通过 Thrift 的方式发送给 BE。 目前 FE 对多个 PlanFragment 调度的方式是 All At Once 的方式,是按照自顶向下的方式遍历 PlanFragment 树,将每个 PlanFragment 的执行信息发送给对应的 BE。 #03 执行计划的执行 — StarRocks 是通过 MPP 多机并行机制来充分利用多机的资源,通过 Pipeline 并行机制来充分利用单机上多核的资源,通过向量化执行来充分利用单核的资源,进而达到极致的查询性能。 MPP 多机并行执行 MPP 是大规模并行计算的简称,核心做法是将查询 Plan 拆分成很多可在单个节点上执行的计算实例,然后多个节点并行执行。每个节点不共享 CPU、内存、磁盘资源。MPP 数据库的查询性能可以随着集群的水平扩展而不断提升。 图 9 如图 9 所示,StarRocks 会将一个查询在逻辑上切分为多个 Query Fragment(查询片段),每个 Query Fragment 可以有一个或者多个 Fragment 执行实例,每个 Fragment 执行实例会被调度到集群某个 BE 上执行。一个 Fragment 可以包括一个或者多个 Operator(执行算子),图中的 Fragment 包括了Scan、Filter、Aggregate。每个 Fragment 可以有不同的并行度。 图 10 如图 10 所示,多个 Fragment 之间会以 Pipeline 的方式在内存中并行执行,而不是像批处理引擎那样 Stage By Stage 执行。Shuffle (数据重分布)操作是 MPP 数据库查询性能可以随着集群的水平扩展而不断提升的关键,也是实现高基数聚合和大表 Join 的关键。 Pipeline 单机并行执行 StarRocks 在 Fragment 和 Operator 之间引入了 Pipeline 的概念,一个 Pipeline 内的数据没有到达终点前不需要 Materialize,遇到需要 Materialize 的算子(Agg, Sort, Join),则需要拆分出一个新的 Pipeline,所以 1 个 Fragment 会对应多个 Pipeline。 图 11 如图 11 所示,一个 Pipeline 由多个 Operator 组成。第一个 Operator 是 Source Operator,负责产生数据,一般是 Scan 节点 和 Exchange 节点。最后一个 Operator 是 Sink Operator,负责物化或者消费数据。中间的 Operator 负责对数据进行 Transform。 图 12 那么 Pipeline 如何并行呢?答案是 Pipeline 和 Fragment 一样,可以生成多个实例,每个实例称为一个 Pipeline Driver。当一个 Pipeline 需要 N 个并行度去执行时,一个 Pipeline 就会生成 N 个 Pipeline Driver,如图 12 所示,并行度是 3,一个 Pipeline 就产生了 3个 Pipeline Driver。 图 13 如图 13 所示,一个 Pipeline 执行中,当前一个 Operator 可以产生数据,且后一个 Operator 可以消费数据时,Pipeline 的执行线程就会从前一个 Operator Pull 出数据,然后 Push 到后一个 Operator。每个 Pipeline 的执行状态是很清晰的,简单可以理解为有 Ready、Running、Blocked 等 3 种状态。当前面的 Operator 无法产生数据,或者后面的 Operator 不需要消费数据时,Pipeline 就会处于 Blocked 的状态。 图 14 如图 14 所示, Pipeline 并行执行框架的核心是实现一个用户态的协程调度,不再依赖操作系统的内核态线程调度,减少线程创建、线程销毁、线程上下文切换的成本。 在 Pipeline 并行执行框架中,StarRocks 会启动机器 CPU 核数个执行线程,每个执行线程会从一个多级反馈就绪队列中获取 Ready 状态的 Pipeline 去执行,同时会有一个全局 Poller 线程不断检查 Blocked 队列中的 Pipeline 是否解除了阻塞,可以变为 Ready 状态。如果可以变为了 Ready 状态,就可以把 Pipeline 从 阻塞队列移到多级反馈就绪队列中。 向量化执行 图 15、16 随着数据库执行的瓶颈逐渐从 IO 转移到 CPU,为了充分发挥 CPU 的执行性能,StarRocks 基于向量化技术重新实现了整个执行引擎,向量化执行引擎是为了充分利用单核 CPU 的能力。 向量化在实现上主要是算子和表达式的向量化,图 15 是算子向量化的示例,图 16 是表达式向量化的示例,算子和表达式向量化执行的核心是批量按列执行。相比于单行执行,批量执行可以有更少的虚函数调用,更少的分支判断;相比于按行执行,按列执行对 CPU Cache 更友好,更易于 SIMD 优化。 向量化执行不仅仅是数据库所有算子的向量化和表达式的向量化,而是一项巨大和复杂的性能优化工程,包括数据在磁盘、内存、网络中的按列组织,数据结构和算法的重新设计,内存管理的重新设计,SIMD 指令优化,CPU Cache 优化,C++ Level 优化等。经过努力,StarRocks 向量化执行引擎相比之前的按行执行,取得了整体 5 到 10 倍的性能提升。 每个算子和表达式具体如何实现、如何进行向量化,之后的文章会详细解释,本文不再赘述。 #04 总结 — 本文主要介绍了 StarRocks 如何完成一条查询 SQL 的处理: 1. 通过高效强大的 CBO 优化器生成最佳的分布式物理执行计划; 2. 通过查询调度器选择合适的数据副本,并将分布式物理执行计划调度到合适的计算节点进行计算; 3. 通过 MPP 分布式执行框架充分利用多机的资源,做到查询性能可以随着机器数量近似线性扩展; 4. 通过 Pipeline 并行执行框架充分利用多核资源,做到查询性能可以随着机器核数近似线性扩展; 5. 通过向量化执行引擎充分利用 CPU 单核资源,将单核执行性能做到极致。 作者 康凯森 | StarRocks 核心研发、StarRocks 查询团队负责人

优秀的个人博客,低调大师

图解MongoDB集群部署原理(3)

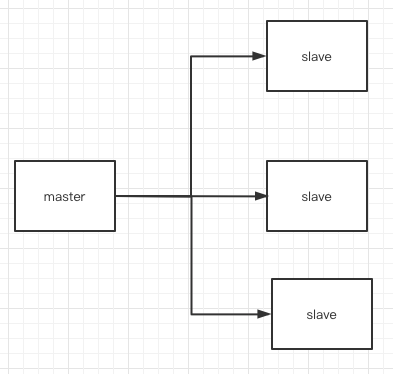
MongoDB的集群部署方案中有三类角色:实际数据存储结点、配置文件存储结点和路由接入结点。 连接的客户端直接与路由结点相连,从配置结点上查询数据,根据查询结果到实际的存储结点上查询和存储数据。MongoDB的部署方案有单机部署、复本集(主备)部署、分片部署、复本集与分片混合部署。 混合的部署方式如图: 混合部署方式下向MongoDB写数据的流程如图: 混合部署方式下读MongoDB里的数据流程如图: 对于副本集,又有主和从两种角色,写数据和读数据也是不同,写数据的过程是只写到主结点中,由主结点以异步的方式同步到从结点中: 而读数据则只要从任一结点中读取,具体到哪个结点读取是可以指定的: 对于MongoDB的分片,假设我们以某一索引键(ID)为片键,ID的区间[0,50],划分成5个chunk,分别存储到3个片服务器中,如图所示: 假如数据量很大,需要增加片服务器时可以只要移动chunk来均分数据即可。 配置结点: 存储配置文件的服务器其实存储的是片键与chunk以及chunk与server的映射关系,用上面的数据表示的配置结点存储的数据模型如下表: Map1 Key range chunk [0,10) chunk1 [10,20) chunk2 [20,30) chunk3 [30,40) chunk4 [40,50) chunk5 Map2 chunk shard chunk1 shard1 chunk2 shard1 chunk3 shard2 chunk4 shard2 chunk5 shard3 路由结点: 路由角色的结点在分片的情况下起到负载均衡的作用。 关注微信公众号『 Tom弹架构 』回复“MongoDB”可获取配套资料。 本文为“Tom弹架构”原创,转载请注明出处。技术在于分享,我分享我快乐! 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。关注微信公众号『 Tom弹架构 』可获取更多技术干货! 原创不易,坚持很酷,都看到这里了,小伙伴记得点赞、收藏、在看,一键三连加关注!如果你觉得内容太干,可以分享转发给朋友滋润滋润!

优秀的个人博客,低调大师

全网最全-混合精度训练原理

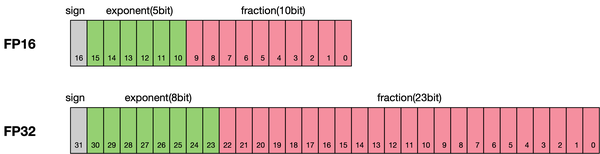
通常我们训练神经网络模型的时候默认使用的数据类型为单精度FP32。近年来,为了加快训练时间、减少网络训练时候所占用的内存,并且保存训练出来的模型精度持平的条件下,业界提出越来越多的混合精度训练的方法。这里的混合精度训练是指在训练的过程中,同时使用单精度(FP32)和半精度(FP16)。 1、浮点数据类型 浮点数据类型主要分为双精度(Fp64)、单精度(Fp32)、半精度(FP16)。在神经网络模型的训练过程中,一般默认采用单精度(FP32)浮点数据类型,来表示网络模型权重和其他参数。在了解混合精度训练之前,这里简单了解浮点数据类型。 根据IEEE二进制浮点数算术标准(IEEE 754)的定义,浮点数据类型分为双精度(Fp64)、单精度(Fp32)、半精度(FP16)三种,其中每一种都有三个不同的位来表示。FP64表示采用8个字节共64位,来进行的编码存储的一种数据类型;同理,FP32表示采用4个字节共32位来表示;FP16则是采用2字节共16位来表示。如图所示: 从图中可以看出,与FP32相比,FP16的存储空间是FP32的一半,FP32则是FP16的一半。主要分为三个部分: 最高位表示符号位sign bit。 中间表示指数位exponent bit。 低位表示分数位fraction bit。 以FP16为例子,第一位符号位sign表示正负符号,接着5位表示指数exponent,最后10位表示分数fraction。公式为: 同理,一个规则化的FP32的真值为: 一个规格化的FP64的真值为: FP16可以表示的最大值为 0 11110 1111111111,计算方法为: FP16可以表示的最小值为 0 00001 0000000000,计算方法为: 因此FP16的最大取值范围是[-65504 - 66504],能表示的精度范围是 2^{-24} ,超过这个数值的数字会被直接置0。 2、使用FP16训练问题 首先来看看为什么需要混合精度。使用FP16训练神经网络,相对比使用FP32带来的优点有: 减少内存占用 :FP16的位宽是FP32的一半,因此权重等参数所占用的内存也是原来的一半,节省下来的内存可以放更大的网络模型或者使用更多的数据进行训练。 加快通讯效率 :针对分布式训练,特别是在大模型训练的过程中,通讯的开销制约了网络模型训练的整体性能,通讯的位宽少了意味着可以提升通讯性能,减少等待时间,加快数据的流通。 计算效率更高 :在特殊的AI加速芯片如华为Ascend 910和310系列,或者NVIDIA VOTAL架构的Titan V and Tesla V100的GPU上,使用FP16的执行运算性能比FP32更加快。 但是使用FP16同样会带来一些问题,其中最重要的是1)精度溢出和2)舍入误差。 数据溢出: 数据溢出比较好理解,FP16的有效数据表示范围为 6.10\times10^{-5}\sim 65504 ,FP32的有效数据表示范围为 1.4\times10^{-45} ~ 1.7\times10^{38} 。可见FP16相比FP32的有效范围要窄很多,使用FP16替换FP32会出现上溢(Overflow)和下溢(Underflow)的情况。而在深度学习中,需要计算网络模型中权重的梯度(一阶导数),因此梯度会比权重值更加小,往往容易出现下溢情况。 舍入误差: Rounding Error指示是当网络模型的反向梯度很小,一般FP32能够表示,但是转换到FP16会小于当前区间内的最小间隔,会导致数据溢出。如0.00006666666在FP32中能正常表示,转换到FP16后会表示成为0.000067,不满足FP16最小间隔的数会强制舍入。 3、混合精度相关技术 为了想让深度学习训练可以使用FP16的好处,又要避免精度溢出和舍入误差。于是可以通过FP16和FP32的混合精度训练(Mixed-Precision),混合精度训练过程中可以引入权重备份(Weight Backup)、损失放大(Loss Scaling)、精度累加(Precision Accumulated)三种相关的技术。 3.1、权重备份(Weight Backup) 权重备份主要用于解决舍入误差的问题。其主要思路是把神经网络训练过程中产生的激活activations、梯度 gradients、中间变量等数据,在训练中都利用FP16来存储,同时复制一份FP32的权重参数weights,用于训练时候的更新。具体如下图所示。 从图中可以了解,在计算过程中所产生的权重weights,激活activations,梯度gradients等均使用 FP16 来进行存储和计算,其中权重使用FP32额外进行备份。由于在更新权重公式为: 深度模型中,lr x gradent的参数值可能会非常小,利用FP16来进行相加的话,则很可能会出现舍入误差问题,导致更新无效。因此通过将权重weights拷贝成FP32格式,并且确保整个更新过程是在 fp32 格式下进行的。即: 权重用FP32格式备份一次,那岂不是使得内存占用反而更高了呢?是的,额外拷贝一份weight的确增加了训练时候内存的占用。 但是实际上,在训练过程中内存中分为动态内存和静态内容,其中动态内存是静态内存的3-4倍,主要是中间变量值和激活activations的值。而这里备份的权重增加的主要是静态内存。只要动态内存的值基本都是使用FP16来进行存储,则最终模型与整网使用FP32进行训练相比起来, 内存占用也基本能够减半。 3.2、损失缩放(Loss Scaling) 如图所示,如果仅仅使用FP32训练,模型收敛得比较好,但是如果用了混合精度训练,会存在网络模型无法收敛的情况。原因是梯度的值太小,使用FP16表示会造成了数据下溢出(Underflow)的问题,导致模型不收敛,如图中灰色的部分。于是需要引入损失缩放(Loss Scaling)技术。 下面是在网络模型训练阶段, 某一层的激活函数梯度分布式中,其中有68%的网络模型激活参数位0,另外有4%的精度在2^-32~2^-20这个区间内,直接使用FP16对这里面的数据进行表示,会截断下溢的数据,所有的梯度值都会变为0。 为了解决梯度过小数据下溢的问题,对前向计算出来的Loss值进行放大操作,也就是把FP32的参数乘以某一个因子系数后,把可能溢出的小数位数据往前移,平移到FP16能表示的数据范围内。根据链式求导法则,放大Loss后会作用在反向传播的每一层梯度,这样比在每一层梯度上进行放大更加高效。 损失放大是需要结合混合精度实现的,其主要的主要思路是: Scale up阶段 ,网络模型前向计算后在反响传播前,将得到的损失变化值DLoss增大2^K倍。 Scale down阶段 ,反向传播后,将权重梯度缩2^K倍,恢复FP32值进行存储。 动态损失缩放(Dynamic Loss Scaling): 上面提到的损失缩放都是使用一个默认值对损失值进行缩放,为了充分利用FP16的动态范围,可以更好地缓解舍入误差,尽量使用比较大的放大倍数。总结动态损失缩放算法,就是每当梯度溢出时候减少损失缩放规模,并且间歇性地尝试增加损失规模,从而实现在不引起溢出的情况下使用最高损失缩放因子,更好地恢复精度。 动态损失缩放的算法如下: 动态损失缩放的算法会从比较高的缩放因子开始(如2^24),然后开始进行训练迭代中检查数是否会溢出(Infs/Nans); 如果没有梯度溢出,则不进行缩放,继续进行迭代;如果检测到梯度溢出,则缩放因子会减半,重新确认梯度更新情况,直到数不产生溢出的范围内; 在训练的后期,loss已经趋近收敛稳定,梯度更新的幅度往往小了,这个时候可以允许更高的损失缩放因子来再次防止数据下溢。 因此,动态损失缩放算法会尝试在每N(N=2000)次迭代将损失缩放增加F倍数,然后执行步骤2检查是否溢出。 3.3、精度累加(Precision Accumulated) 在混合精度的模型训练过程中,使用FP16进行矩阵乘法运算,利用FP32来进行矩阵乘法中间的累加(accumulated),然后再将FP32的值转化为FP16进行存储。简单而言,就是利用FP16进行矩阵相乘,利用FP32来进行加法计算弥补丢失的精度。 这样可以有效减少计算过程中的舍入误差,尽量减缓精度损失的问题。 例如在Nvidia Volta 结构中带有Tensor Core,可以利用FP16混合精度来进行加速,还能保持精度。Tensor Core主要用于实现FP16的矩阵相乘,在利用FP16或者FP32进行累加和存储。在累加阶段能够使用FP32大幅减少混合精度训练的精度损失。 4、混合精度训练策略(Automatic Mixed Precision,AMP) 混合精度训练有很多有意思的地方,不仅仅是在深度学习,另外在HPC的迭代计算场景下,从迭代的开始、迭代中期和迭代后期,都可以使用不同的混合精度策略来提升训练性能的同时保证计算的精度。以动态的混合精度达到计算和内存的最高效率比也是一个较为前言的研究方向。 以NVIDIA的APEX混合精度库为例,里面提供了4种策略,分别是默认使用FP32进行训练的O0,只优化前向计算部分O1、除梯度更新部分以外都使用混合精度的O2和使用FP16进行训练的O3。具体如图所示。 这里面比较有意思的是O1和O2策略。 O1策略中,会根据实际Tensor和Ops之间的关系建立黑白名单来使用FP16。例如GEMM和CNN卷积操作对于FP16操作特别友好的计算,会把输入的数据和权重转换成FP16进行运算,而softmax、batchnorm等标量和向量在FP32操作好的计算,则是继续使用FP32进行运算,另外还提供了动态损失缩放(dynamic loss scaling)。 而O2策略中,模型权重参数会转化为FP16,输入的网络模型参数也转换为FP16,Batchnorms使用FP32,另外模型权重文件复制一份FP32用于跟优化器更新梯度保持一致都是FP32,另外还提供动态损失缩放(dynamic loss scaling)。使用了权重备份来减少舍入误差和使用损失缩放来避免数据溢出。 当然上面提供的策略是跟硬件有关系,并不是所有的AI加速芯片都使用,这时候针对自研的AI芯片,需要找到适合得到混合精度策略。 5、实验结果 从下图的Accuracy结果可以看到,混合精度基本没有精度损失: Loss scale的效果: 题外话,前不久去X公司跟X总监聊下一代AI芯片架构的时候,他认为下一代芯片可以不需要加入INT8数据类型,因为Transformer结构目前有大一统NLP和CV等领域的趋势,从设计、流片到量产,2年后预计Transformer会取代CNN成为最流行的架构。我倒是不同意这个观点,目前来看神经网络的4个主要的结构MLP、CNN、RNN、Transformer都有其对应的使用场景,并没有因为某一种结构的出现而推翻以前的结构。只能说根据使用场景的侧重点比例有所不同,我理解Int8、fp16、fp32的数据类型在AI芯片中仍然会长期存在,针对不同的应用场景和计算单元会有不同的比例。 参考文献: Micikevicius, Paulius, et al. "Mixed precision training." arXiv preprint arXiv:1710.03740 (2017). Ott, Myle, et al. "Scaling neural machine translation." arXiv preprint arXiv:1806.00187 (2018). https://en.wikipedia.org/wiki/Half-precision_floating-point_format apex.amp - Apex 0.1.0 documentation . Automatic Mixed Precision for Deep Learning . Training With Mixed Precision . Dreaming.O:浅谈混合精度训练 .

优秀的个人博客,低调大师

深入了解 ConcurrentHashMap 底层原理

在上一篇文章[【简单了解系列】从基础的使用来深挖HashMap](https://mp.weixin.qq.com/s/-ZE8eA-2CFYsgwRbwjEVnw)里,我从最基础的使用中介绍了HashMap,大致是JDK1.7和1.8中底层实现的变化,和介绍了为什么在多线程下可能会造成死循环,扩容机智是什么样的。感兴趣的可以先看看。 我们知道,HashMap是非线程安全的容器,那么为什么ConcurrentHashMap能够做到线程安全呢? # 底层结构 首先看一下ConcurrentHashMap的底层数据结构,在Java8中,其底层的实现方式与HashMap一样的,同样是数组、链表再加红黑树,具体的可以参考上面的HashMap的文章,下面所有的讨论都是基于Java 1.8。 ```java transient volatile Node [] table; ``` ## volatile关键字 对比HashMap的底层结构可以发现,table的定义中多了一个**volatile**关键字。这个关键字是做什么的呢?我们知道所有的共享变量都存在**主内存**中,就像table。 而线程对变量的所有操作都必须在线程自己的**工作内存**中完成,而不能直接读取主存中的变量,这是JMM的规定。所以每个线程都会有自己的工作内存,工作内存中存放了共享变量的副本。而正是因为这样,才造成了可见性的问题。 ABCD四个线程同时在操作一个共享变量X,此时如果A从主存中读取了X,改变了值,并且写回了内存。那么BCD线程所得到的X副本就已经失效了。此时如果没有被**volatile**修饰,那么BCD线程是不知道自己的变量副本已经失效了。继续使用这个变量就会造成**数据不一致**的问题。 ## 内存可见性 而如果加上了volatile关键字,BCD线程就会立马看到最新的值,这就是**内存可见性**。你可能想问,凭什么加了volatile的关键字就可以保证共享变量的内存可见性? 那是因为如果变量被volatile修饰,在线程进行**写操作**时,会直接将新的值写入到主存中,而不是线程的工作内存中;而在**读操作**时,会直接从主存中读取,而不是线程的工作内存。 # 基础使用 首先这个使用与HashMap没有任何区别,只是实现改成了ConcurrentHashMap。 ```java Map map = new ConcurrentHashMap<>(); map.put("微信搜索", "SH的全栈笔记"); map.get("微信搜索"); // SH的全栈笔记 ``` ## 取值 首先我们来看一下get方法的使用,源码如下。 ```java public V get(Object key) { Node [] tab; Node e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } ``` 大概解释一下这个过程发生了什么,首先根据key计算出哈希值,如果找到了就直接返回值。如果是红黑树的话,就在红黑树中查找值,否则就按照链表的查找方式查找。 这与HashMap也差不多的,元素会首先以链表的方式进行存储,如果该桶中的元素数量大于`TREEIFY_THRESHOLD`的值,就会触发树化。将当前的链表转换为红黑树。因为如果数量太多的话,链表的查询效率就会变得非常低,时间复杂度为O(n),而红黑树的查询时间复杂度则为O(logn),这个阈值在Java 1.8中的默认值为8,定义如下。 ```java static final int TREEIFY_THRESHOLD = 8; ``` ## 赋值 `put`的源码就不放出来了,放在这大家估计也不会一行一行的去看。所以我就简单的解释一下put的过程发生了什么事,并贴上关键代码就好了。 整个过程,除开并发的一些细节,大致的流程和1.8中的HashMap是差不多的。 - 首先会根据传入的key计算出hashcode,如果是第一次被赋值,那自然需要进行初始化table - 如果这个key没有存在过,直接用CAS在当前槽位的头节点创建一个Node,会用自旋来保证成功 - 如果当前的Node的hashcode是否等于-1,如果是则证明有其它的线程正在执行扩容操作,当前线程就加入到扩容的操作中去 - 且如果该槽位(也就是桶)上的数据结构如果是链表,则按照链表的插入方式,直接接在当前的链表的后面。如果数量大于了树化的阈值就会转为红黑树。 - 如果这个key存在,就会直接覆盖。 - 判断是否需要扩容 看到这你可能会有一堆的疑问。 > 例如在多线程的情况下,几个线程同时来执行put操作时,怎么保证只执行一次初始化,或者怎么保证只执行一次扩容呢?万一我已经写入了数据,另一个线程又初始化了一遍,岂不是造成了数据不一致的问题。同样是多线程的情况下, 怎么保证put值的时候不会被其他线程覆盖。CAS又是什么? 接下来我们就来看一下在多线程的情况下,`ConcurrentHashMap`是如何保证线程安全的。 # 初始化的线程安全 首先我们来看初始化的源码。 ```java private final Node [] initTable() { Node [] tab; int sc; while ((tab = table) == null || tab.length == 0) { if ((sc = sizeCtl) < 0) Thread.yield(); // lost initialization race; just spin else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) { try { if ((tab = table) == null || tab.length == 0) { int n = (sc > 0) ? sc : DEFAULT_CAPACITY; @SuppressWarnings("unchecked") Node [] nt = (Node [])new Node[n]; table = tab = nt; sc = n - (n >>> 2); } } finally { sizeCtl = sc; } break; } } return tab; } ``` 可以看到有一个关键的变量,`sizeCtl`,其定义如下。 ```java private transient volatile int sizeCtl; ``` sizeCtl使用了关键字`volatile`修饰,说明这是一个多线程的共享变量,可以看到如果是首次初始化,第一个判断条件`if ((sc = sizeCtl) < 0)`是不会满足的,正常初始化的话sizeCtl的值为0,初始化设定了size的话sizeCtl的值会等于传入的size,而这两个值始终是大于0的。 ## CAS 然后就会进入下面的`U.compareAndSwapInt(this, SIZECTL, sc, -1)`方法,这就是上面提到的**CAS**,Compare and Swap(Set),比较并交换,Unsafe是位于`sun.misc`下的一个类,在Java底层用的比较多,它让Java拥有了类似C语言一样直接操作内存空间的能力。 例如可以操作内存、CAS、内存屏障、线程调度等等,但是如果Unsafe类不能被正确使用,就会使程序变的不安全,所以不建议程序直接使用它。 `compareAndSwapInt`的四个参数分别是,实例、偏移地址、预期值、新值。偏移地址可以快速帮我们在实例中定位到我们要修改的字段,此例中便是`sizeCtl`。如果内存当中的sizeCtl是传入的预期值,则将其更新为新的值。这个Unsafe类的方法可以保证这个操作的**原子性**。当你在使用parallelStream进行并发的foreach遍历时,如果涉及到修改一个整型的共享变量时,你肯定不能直接用i++,因为在多线程下,i++每次操作不能保证原子性。所以你可能会用到如下的方式。 ```java AtomicInteger num = new AtomicInteger(); arr.parallelStream().forEach(item -> num.getAndIncrement()); ``` 你可能会好奇,为什么使用了`AtomicInteger`就可以保证原子性,跟Unsafe类和CAS又有什么关系,让我们接着往下,看`getAndIncrement`方法的底层实现。 ```java public final int getAndIncrement() { return unsafe.getAndAddInt(this, valueOffset, 1); } ``` 可以看到,底层调用的是Unsafe类的方法,这不就联系上了吗,而`getAndIncrement`的实现又长这样。 ```java public final int getAndAddInt(Object var1, long var2, int var4) { int var5; do { var5 = this.getIntVolatile(var1, var2); } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); return var5; } ``` 没错,这里底层调用了`compareAndSwapInt`方法。可以看到这里加了while,如果该方法返回false就一直循环,直到成功为止。这个过程有个牛批的名字,叫**自旋**。特别高端啊,说人话就是无限循环。 什么情况会返回false呢?那就是`var5`变量存储的值,和现在内存中实际`var5`的值**不同**,说明这个变量已经被其他线程修改过了,此时通过自旋来重新获取,直到成功为止,然后自旋结束。 ## 结论 聊的稍微有点多,这小节的问题是如何保证不重复初始化。那就是执行首次扩容时,会将变量`sizeCtl`设置为`-1`,因为其被`volatile`修饰,所以其值的修改对其他线程可见。 其它线程再调用初始化时,就会发现`sizeCtl`的值为`-1`,说明已经有线程正在执行初始化的操作了,就会执行`Thread.yield()`,然后退出。 `yield`相信大家都不陌生,和`sleep`不同,`sleep`可以让线程进入阻塞状态,且可以指定阻塞的时间,同时释放CPU资源。而`yield`不会让线程进入阻塞状态,而且也不能指定时间,它让线程重新进入可执行状态,让出CPU调度,让CPU资源被同优先级或者高优先级的线程使用,稍后再进行尝试,这个时间依赖于当前CPU的时间片划分。 # 如何保证值不被覆盖 我们在上一节举了在并发下i++的例子,说在并发下i++并不是一个具有**原子性**的操作,假设此时`i=1`,线程A和线程B同时取了i的值,同时+1,然后此时又同时的写回。那么此时`i++`的值会是2而不是3,在并发下`1+1+1=2`是可能出现的。 让我们来看一下`ConcurrentHashMap`在目标key已经存在时的赋值操作,因为如果不存在会直接调用Unsafe的方法创建一个Node,所以后续的线程就会进入到下面的逻辑中来,由于太长,我省略了一些代码。 ```java ...... V oldVal = null; synchronized (f) { if (tabAt(tab, i) == f) { if (fh >= 0) { binCount = 1; for (Node e = f;; ++binCount) { ...... } } else if (f instanceof TreeBin) { Node p; binCount = 2; if ((p = ((TreeBin )f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } ``` 上述代码在赋值的逻辑外层包了一个`synchronized`,这个有什么用呢? ## synchronized关键字 这个地方也可以换一个方式来理解,那就是`synchronized`如何保证线程安全的。线程安全,我认为更多的是描述一种**风险**。在堆内存中的数据由于可以被任何线程访问到,在没有任何限制的情况下存在被意外修改的风险。 而`synchronized`是通过对共享资源加锁的方式,使同一时间只能有一个线程能够访问到临界区(也就是共享资源),共享资源包括了方法、锁代码块和对象。 那是不是使用了`synchronized`就一定能保证线程安全呢?不是的,如果不能正确的使用,很可能就会引发死锁,所以,保证线程安全的前提是**正确的使用**`synchronized`。 # 自动扩容的线程安全 除了初始化、并发的写入值,还有一个问题值得关注,那就是在多线程下,`ConcurrentHashMap`是如何保证自动扩容是线程安全的。 扩容的关键方案是`transfer`,但是由于代码太多了,贴在这个地方可能会影响大家的理解,感兴趣的可以自己的看一下。 还是大概说一下自动扩容的过程,我们以一个线程来举例子。在`putVal`的最后一步,会调用`addCount`方法,然后在方法里判读是否需要扩容,如果容量超过了`实际容量 * 负载因子`(也就是sizeCtl的值)就会调用`transfer`方法。 ## 计算分区的范围 因为`ConcurrentHashMap`是支持多线程同时扩容的,所以为了避免每个线程处理的数量不均匀,也为了提高效率,其对当前的所有桶按数量(也就是上面提到的槽位)进行分区,每个线程只处理自己分到的区域内的桶的数据即可。 当前线程计算当前stride的代码如下。 ```java stride = (NCPU > 1) ? (n >>> 3) / NCPU : n); ``` 如果计算出来的值小于设定的最小范围,也就是`private static final int MIN_TRANSFER_STRIDE = 16;`,就把当前分区范围设置为16。 ## 初始化nextTable `nextTable`也是一个共享变量,定义如下,用于存放在正在扩容之后的`ConcurrentHashMap`的数据,当且仅当正在**扩容**时才不为空。 ```java private transient volatile Node [] nextTable; ``` 如果当前transfer方法传入的nextTab(这是个局部变量,比上面提到的nextTable少了几个字母,不要搞混了)是null,说明是当前线程是第一个调用扩容操作的线程,就需要初始化一个size为原来容量2被的nextTable,核心代码如下。 ```java Node [] nt = (Node [])new Node[n << 1]; // 可以看到传入的初始化容量是n << 1。 ``` 初始化成功之后就更新**共享变量**`nextTable`的值,并设置`transferIndex`的值为扩容前的length,这也是一个共享的变量,表示扩容使还未处理的桶的下标。 ## 设置分区边界 一个新的线程加入扩容操作,在完成上述步骤后,就会开始从现在正在扩容的Map中找到自己的分区。例如,如果是第一个线程,那么其取到的分区就会如下。 ```java start = nextIndex - 1; end = nextIndex > stride ? nextIndex - stride : 0; // 实际上就是当还有足够的桶可以分的时候,线程分到的分区为 [n-stride, n - 1] ``` 可以看到,分区是从尾到首进行的。而如果是首次进入的线程,`nextIndex` 的值会被初始化为共享变量`transferIndex` 的值。 ## Copy分区内的值 当前线程在自己划分到的分区内开始遍历,如果当前桶是null,那么就生成一个 `ForwardingNode`,代码如下。 ```java ForwardingNode fwd = new ForwardingNode (nextTab); ``` 并把当前槽位赋值为fwd,你可以把`ForwardingNode`理解为一个标志位,如果有线程遍历到了这个桶, 发现已经是`ForwardingNode`了,就代表这个桶已经被处理过了,就会跳过这个桶。 如果这个桶没有被处理过,就会开始给当前的桶加锁,我们知道`ConcurrentHashMap`会在多线程的场景下使用,所以当有线程正在扩容的时候,可能还会有线程正在执行put操作,所以如果当前Map正在执行扩容操作,如果此时再写入数据,很可能会造成的数据丢失,所以要对桶进行加锁。 # 总结 对比在1.7中采用的`Segment`分段锁的臃肿设计,1.8中直接使用了`CAS`和`Synchronized`来保证并发下的线程安全。总的来说,在1.8中,ConcurrentHashMap和HashMap的底层实现都差不多,都是数组、链表和红黑树的方式。其主要区别就在于应用场景,非并发的情况可以使用HashMap,而如果要处理并发的情况,就需要使用ConcurrentHashMap。关于ConcurrentHashMap就先聊到这里。 > 好了以上就是本篇博客的全部内容了,欢迎微信搜索关注【**SH的全栈笔记**】,回复【**队列**】获取MQ学习资料,包含基础概念解析和RocketMQ详细的源码解析,持续更新中。 > > > > 如果你觉得这篇文章对你有帮助,还麻烦**点个赞**,**关个注**,**分个享**,**留个言**。 ![](https://tva1.sinaimg.cn/large/008eGmZEgy1go0v5rrqp4j31eg0hcwhm.jpg)

优秀的个人博客,低调大师

Java 8 Stream原理解析

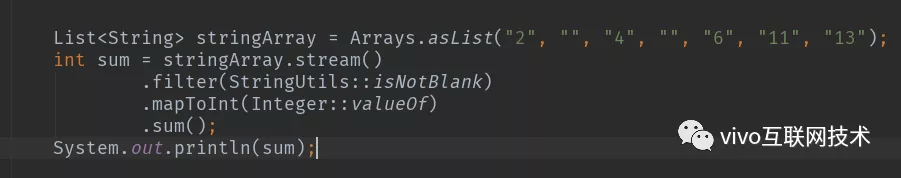
说起 Java 8,我们知道 Java 8 大改动之一就是增加函数式编程,而 Stream API 便是函数编程的主角,Stream API 是一种流式的处理数据风格,也就是将要处理的数据当作流,在管道中进行传输,并在管道中的每个节点对数据进行处理,如过滤、排序、转换等。 首先我们先看一个使用Stream API的示例,具体代码如下: code1 Stream example 这是个很简单的一个Stream使用例子,我们过滤掉空字符串后,转成int类型并计算出最大值,这其中包括了三个操作:filter、mapToInt、sum。相信大多数人再刚使用Stream API的时候都会有个疑问,Stream是指怎么实现的,是每一次函数调用就执行一次迭代吗?答案肯定是否,因为如果真的是每一次函数调用就执行一次迭代,这个效率是很难接受的,Stream也不会那么受欢迎。 其实Stream内部是通过流水线(Pipeline)的方式来实现的,基本思想是在迭代的时候顺着流水线尽可能的执行更多的操作,从而避免多次迭代。为了对Stream的操作有更清晰的认识,我们汇总了Stream的所有操作。 从上表可以看出Stream将所有操作分为两类:中间操作和终止操作。其中中间操作分为无状态和有状态,终止操作分为非短路操作和短路操作,下面是针对这几个操作的含义说明: 1、中间操作:中间操作只是一种标记,只有结束操作才会触发实际计算 无状态:指元素的处理不受前面元素的影响; 有状态:有状态的中间操作必须等到所有元素处理之后才知道最终结果,比如排序是有状态操作,在读取所有元素之前并不能确定排序结果。 2、终止操作:顾名思义,就是得出最后计算结果的操作 短路操作:指不用处理全部元素就可以返回结果; 非短路操作:指必须处理所有元素才能得到最终结果。 Stream流水线解决方案 通过上面的介绍,我们了解到Stream在执行中间操作时仅仅是记录,当用户调用终止操作时,会在一个迭代里将已经记录的操作顺着流水线全部执行掉。沿着这个思路,有几个问题需要解决: 用户的操作如何记录? 操作如何叠加? 叠加之后的操作如何执行? 1、操作如何记录 图1-1 关于操作如何记录,在JDK源码注释中多次用(操作)stage来标识用户的每一次操作,而通常情况下Stream的操作又需要一个回调函数,所以一个完整的操作是由数据来源、操作、回调函数组成的三元组来表示。而在具体实现中,使用实例化的ReferencePipeline来表示,即图1-1中的Head、StatelessOp、StatefulOp的实例。接下来我们来看下Stream几个常用方法的源码。 code2 Collection.Stream() code3StreamSupport.stream() code4 ReferencePipeline.map() 从上面源码中可以看出来,我们调用stream()方法时最终会创建一个Head实例来表示流操作的头,当调用map()方法时则会创建无状态的中间操作实例StatelessOp,同样调用其他操作对应的方法也会生成一个ReferencePipeline实例,在这里就不一一列举。在用户调用一系列操作后,最终会形成一个双向链表,如下图所示: 图1-2 2、操作如何叠加 上面我们说明了Stream是通过stage记录操作,但stage只保存当前操作,它并不知道下个stage如何操作,需要什么操作。所以要执行的话还需要某种协议将各个stage关联起来。jdk中就是使用Slink接口来实现的,Slink接口定义begin()、end()、cancellationRequested()、accept()四个方法,如下表所示。 往回看code3 ReferencePipeline.map()的方法,我们会发现我们在创建一个ReferencePipeline实例的时候,需要重写opWrapSink方法来生成对应Sink实例。而且通过阅读源码会发现常用的操作都会创建一个ChainedReference实例。我们可以看下code5 ChainedReference抽象类的源码实现,因为ChainedReference只是个抽象实现,不携带具体操作的特性,所以是更能体现作者的设计理念。 通过查看源码可以发现ChainedReference会持有下一个操作的Slink,并在调用begin、end、cancellationRequested方法会调用下一个操作的Slink的相应方法,以此来达到叠加的效果。 code5ChainedReference 3、叠加之后的操作如何执行 Sink完美封装了Stream每一步操作,并给出了[处理->转发]的模式来叠加操作。这一连串的齿轮已经咬合,就差最后一步拨动齿轮启动执行。是什么启动这一连串的操作呢?也许你已经想到了启动的原始动力就是结束操作(Terminal Operation),一旦调用某个结束操作,就会触发整个流水线的执行。 结束操作之后不能再有别的操作,所以结束操作不会创建新的流水线阶段(Stage),直观的说就是流水线的链表不会在往后延伸了。结束操作会创建一个包装了自己操作的Sink,这也是流水线中最后一个Sink,这个Sink只需要处理数据而不需要将结果传递给下游的Sink(因为没有下游)。对于Sink的[处理->转发]模型,结束操作的Sink就是调用链的出口。 我们再来考察一下上游的Sink是如何找到下游Sink的。一种可选的方案是在PipelineHelper中设置一个Sink字段,在流水线中找到下游Stage并访问Sink字段即可。但Stream类库的设计者没有这么做,而是设置了一个Sink AbstractPipeline.opWrapSink(int flags, Sink downstream)方法来得到Sink,该方法的作用是返回一个新的包含了当前Stage代表的操作以及能够将结果传递给downstream的Sink对象。为什么要产生一个新对象而不是返回一个Sink字段?这是因为使用opWrapSink()可以将当前操作与下游Sink(上文中的downstream参数)结合成新Sink。试想只要从流水线的最后一个Stage开始,不断调用上一个Stage的opWrapSink()方法直到最开始(不包括stage0,因为stage0代表数据源,不包含操作),就可以得到一个代表了流水线上所有操作的Sink,用代码表示就是这样: code6AbstractPipeline.wrapSink 现在流水线上从开始到结束的所有的操作都被包装到了一个Sink里,执行这个Sink就相当于执行整个流水线,执行Sink的代码如下: code7AbstractPipeline.copyInto 上述代码首先调用wrappedSink.begin()方法告诉Sink数据即将到来,然后调用spliterator.forEachRemaining()方法对数据进行迭代,最后调用wrappedSink.end()方法通知Sink数据处理结束。逻辑如此清晰。 作者:Huang Rongpeng

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册