首页 文章 精选 留言 我的

精选列表

搜索[infra],共607篇文章
优秀的个人博客,低调大师

AI Infra 系列 · 第四章 推理引擎 (上):为什么 LLM 一次只蹦一个 token,vLLM 和 SGLang 到底差在哪

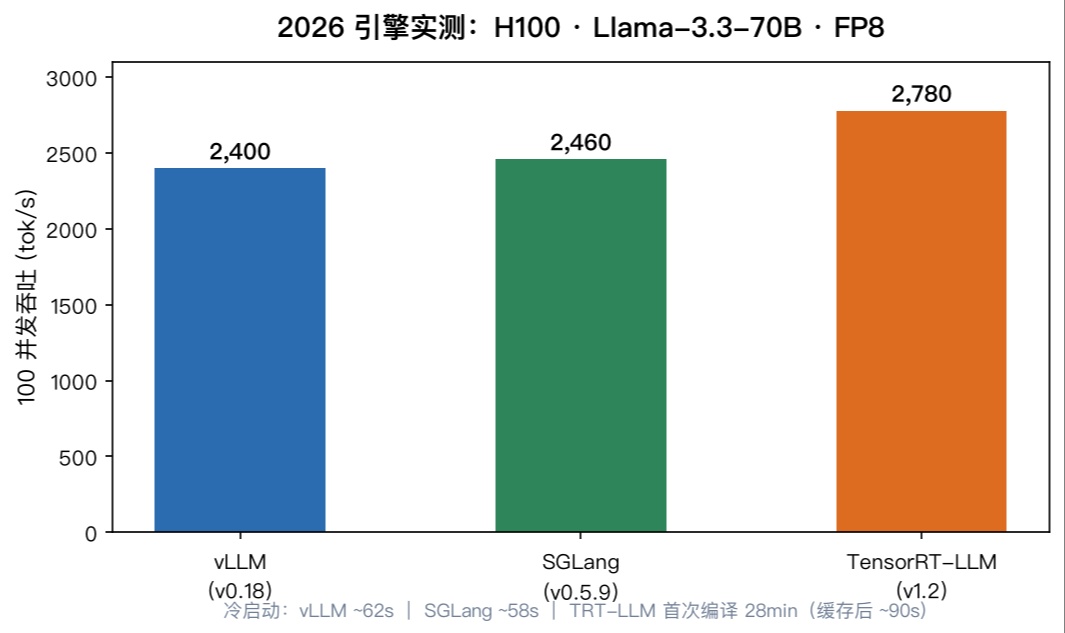
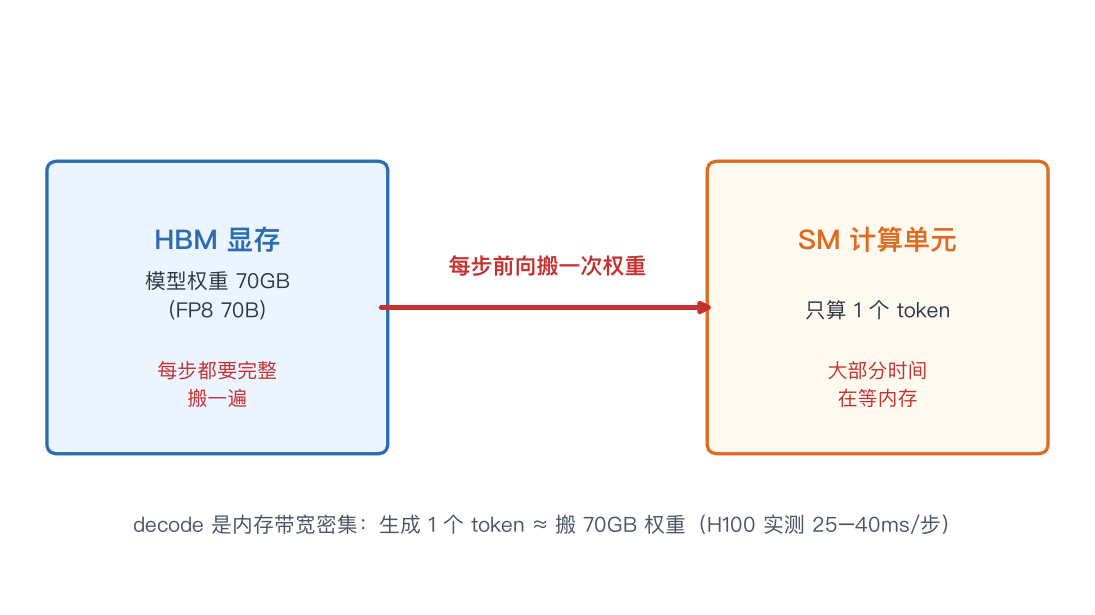
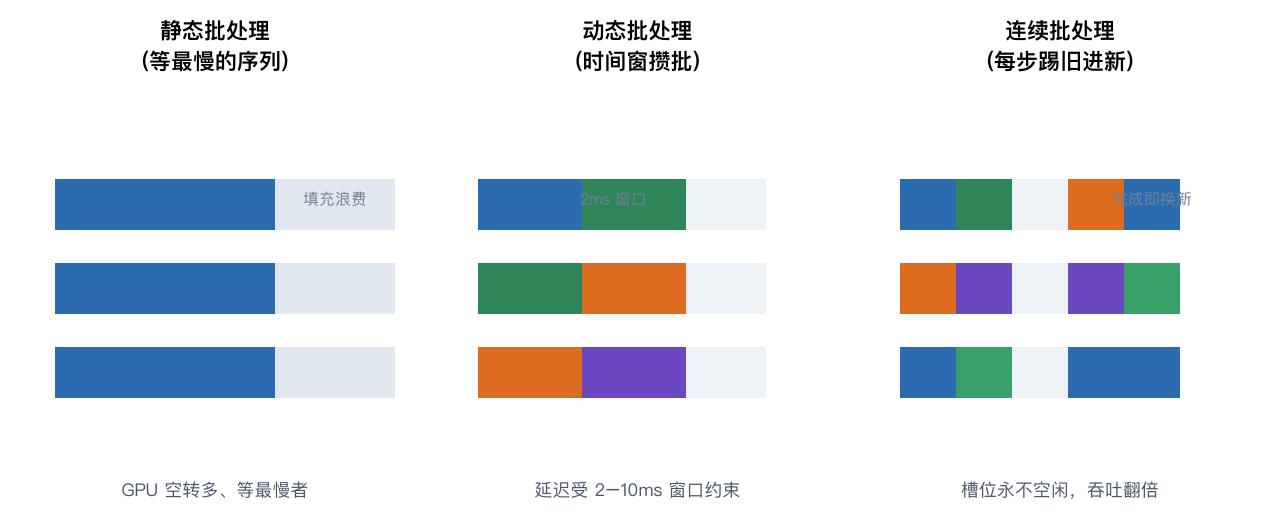
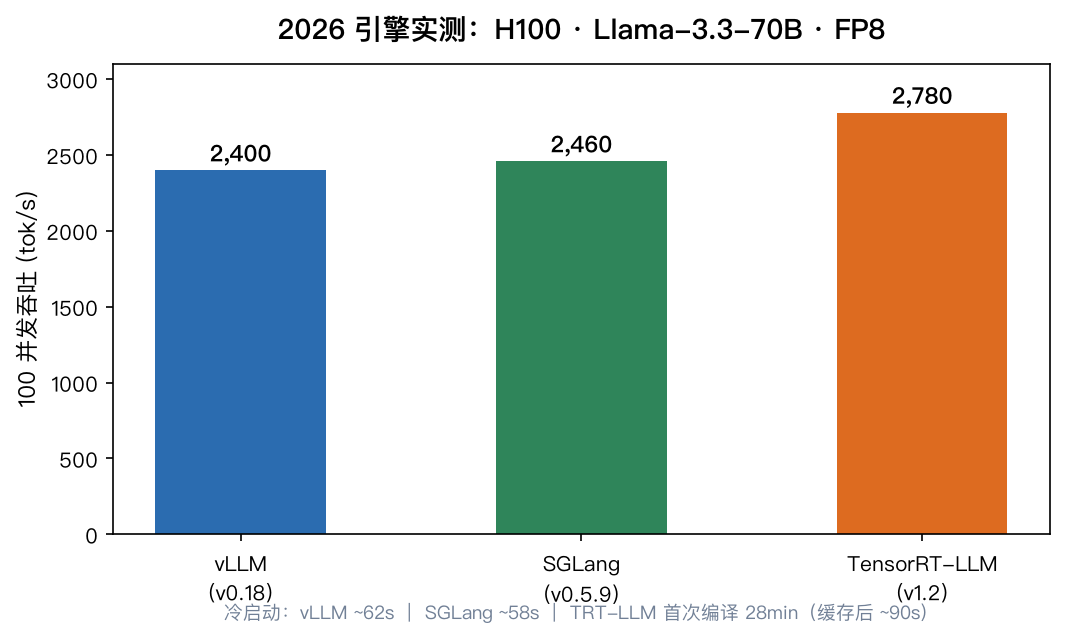
## 一、推理和训练,是两种完全不同的动物 训练是流水线:几千个 token 一起过一遍模型,计算密集,GPU 吃得饱饱的。 推理是单行道:用户的问题(prompt)先整体算一遍(这叫 **prefill**),然后一次只能生成一个 token(这叫 **decode**)。生成第 2 个 token 依赖第 1 个,第 3 个依赖前两个,天生串行,没法并行。 decode 为什么这么贵?因为它是**内存带宽密集**而不是计算密集: - 每一步前向,都要把整个模型的权重从显存(HBM)搬到计算单元(SM)。 - 70B 模型 FP8 权重大约 70GB,每一步都要完整搬一遍,而实际算的只是一个 token 的矩阵乘。 - 结果就是 GPU 的计算单元大部分时间在等内存,利用率只有个位数百分比。 ![fig9-memory-wall.png](https://developer.qcloudimg.com/http-save/yehe-11479707/2a6c65752925271bc4c4271d00c72d5d.png) 一个直观的数字:H100 上跑 70B 模型 FP8,单个请求生成一个 token 大约要 25–40ms(纯权重搬运的理论下限约 20ms,全栈实测更高,2026 年公开基准)。这不是算得慢,是权重搬得太慢。这个"内存墙"是整个推理优化领域的出发点。 ## 二、批处理演进:从"等最慢的人"到"边跑边上下车" 既然单请求喂不饱 GPU,很自然的思路是让多个请求一起算。但怎么批,学问很大。 **静态批处理**:攒够一批才开工,整批做完才放人。问题是序列长短不一,所有人都要等最长的那个,短的序列在"填充"上浪费大量计算。 **动态批处理**:设置一个 2–10ms 的窗口,窗口到了就把已经到的请求一起发出去,用延迟换吞吐(书第 16 章)。 **连续批处理**:真正的革命。不再等整批完成,而是每个 token 生成步结束时,把完成的请求踢出去、立刻拉新请求进来,GPU 槽位永远不空(书第 16 章)。大模型上批 4–8 个请求,吞吐通常能比 1–2 个请求翻一倍到三倍。 **分块预填充**:一个大 prompt 的 prefill 会独占 GPU 很久,把其他用户的 decode 全部堵死。解法是把大 prompt 切成小块,和 decode 交错着算,避免一个请求饿死整批人。 ![fig9-batching.png](https://developer.qcloudimg.com/http-save/yehe-11479707/ad806d4395565960761f80d6db898a86.png) 2026 年,连续批处理已经是所有主流引擎的标配(vLLM、SGLang、TensorRT-LLM、NVIDIA Dynamo 都支持)。 ## 三、PagedAttention:把显存当内存分页管 批处理做起来了,下一个瓶颈是显存放不下。 每个请求的 KV Cache(记录历史 token 的 key-value 张量)随序列长度线性增长。算笔账:Llama-3-70B 在 FP16 下,128K 上下文的 KV Cache 大约 35–40GB(随 GQA 头数而异),而模型权重约 140GB;高并发场景下,KV Cache 能占到显存需求的八成以上(2026 年 KV Cache 架构分析)。 传统做法是给每个请求预分配连续显存,浪费极大,利用率常不足 60%。 vLLM 的 **PagedAttention** 借鉴操作系统虚拟内存的分页思想,把 KV Cache 切成 16 或 64 token 的固定块,按需分配、不连续存储,物理块可以共享(Copy-on-Write)。效果:把显存浪费从传统预分配的 60–80% 压到 4% 以下(利用率约 96%),ShareGPT 真实对话负载下有效并发请求数从 7 提升到 30(来源:vLLM PagedAttention 论文)。 以前是每个请求占一整间房,现在改成按床位分配,还能多人拼床。 ## 四、2026 引擎矩阵比较:vLLM vs SGLang vs TensorRT-LLM 引擎是推理性能的最终落点。同一个模型,不同引擎能差出 10% 以上的吞吐。 下面是 2026 年一组公开基准的量级对比(H100 80GB、Llama-3.3-70B FP8、100 并发,来源:Spheron Network 与掘金等公开评测): | 指标 | vLLM | SGLang | TensorRT-LLM | | -------------------- | ------------------------ | ------------------------------- | ------------ | | 100 并发吞吐 (tok/s) | ~2.4k | ~2.5k | **~2.8k** | | 100 并发 p95 TTFT (ms) | ~1.45s | ~1.38s | **~1.28s** | | 冷启动到首请求 | ~1 分钟 | ~1 分钟 | 首次编译约 30 分钟 | | 前缀共享场景 | 一般 | **最高(比 vLLM 高约 25–45%,视前缀命中率)** | 一般 | | 硬件支持 | 最广(NVIDIA/AMD/Intel/TPU) | NVIDIA 为主 | **仅 NVIDIA** | | 部署复杂度 | 简单 | 简单 | 较复杂(需编译流水线) | ![fig9-engine.png](https://developer.qcloudimg.com/http-save/yehe-11479707/262c951f0a5c261b8f6c7b4099ddf941.png) > 以上为公开基准的量级(模拟基准,仅示相对差距),不同负载、不同批次下结论会变,上线前务必用你自己的流量实测。 **选型决策树**(2026 年多篇引擎评测的共识): 1. 硬件不是纯 NVIDIA?只有 vLLM 能选。 2. 模型经常换?选 vLLM,兼容性最广,先跑通再说。 3. 共享前缀多(agent、多轮对话、RAG)?选 SGLang,RadixAttention 前缀共享能多出约 25–45% 吞吐(视前缀命中率)。 4. 固定一个模型、追求极致性能、团队有运维余力?选 TensorRT-LLM。 5. 都不确定?选 vLLM,它是 2026 年的安全选择。 ### 踩坑现场:三件容易被背刺的事 **① 70B 模型塞进 80GB 卡,上下文窗口一调大就 OOM。** 权重占了 70GB(FP8),剩下的显存全被 KV Cache 吃掉。调上下文长度前,一定先算显存账:KV Cache 是隐形内存怪兽。 **② TensorRT-LLM 首次编译要等半小时。** 它不是慢,是"一次性重活":编译好的引擎二进制存下来,重启只要 90 秒。但如果模型一个月换三次,这半小时会变成日常开销。新出的 PyTorch 后端把冷启动压到 1 分钟左右,代价是吞吐低 15–20%。 **③ 无脑上 INT4。** 很多人以为 4-bit 一定比 8-bit 快。错。Hopper 上 INT4 权重没有真正的 4-bit 计算,要先把权重反量化回 FP16 再做矩阵乘,提速高度依赖场景(低并发 decode 才划算);而 FP8 是 Hopper 原生精度,又快又准,精度损失还更小。**Hopper 上 FP8 优先于 INT4**(2026 年量化实测)。 ## 五、一个反共识判断 市面上到处是"推理性能 PK"的榜单,但我的建议是:不要在开发阶段追极致优化。 先用 vLLM 默认配置把整个应用流程跑通,确认功能正确、拿到指标基线,再按瓶颈逐步开优化(量化、前缀缓存、PD 分离、投机解码)。过早优化是工程大忌,推理优化尤其如此,每一步优化都会引入新的配置面和排障成本。 vLLM 先跑通,瓶颈再换枪。这也是为什么 vLLM 能成为 2026 年开源推理引擎的事实标准(GitHub 8 万+ star,阿里、腾讯、字节等都在用)。 --- ## 你被哪件事坑过? 你线上推理遇到过 OOM、冷启动爆炸,还是无脑量化翻车?评论区说说你的引擎选型和踩坑经历。 --- ## 参考资料 - Chris Fregly, *AI Systems Performance Engineering*, O'Reilly Media(第 15–16 章) - vLLM PagedAttention(SOSP 2023 论文)与 vLLM 官方文档 - Spheron Network:《vLLM vs TensorRT-LLM vs SGLang: H100 Benchmarks 2026》(掘金等转载复测) - 掘金:《LLM 推理引擎实战横评:H100 上真实表现》 - AITechConnect:《Picking an LLM Serving Engine》 - ZOOZ Engineering:《LLM Inference Concepts and Optimization Techniques》 > 说明:图 fig9-memory-wall / fig9-batching 为示意。引擎对比为 2026 年公开基准量级(仅示相对差距),不同负载下结论可能不同;连续批处理、PagedAttention 机制沿用书第 16 章,截至 2026 年 8 月。
优秀的个人博客,低调大师

AI Infra 系列 · 第五章 训练与调度(上): 8 张卡 7 张闲?单机调优才是你欠下的第一笔账

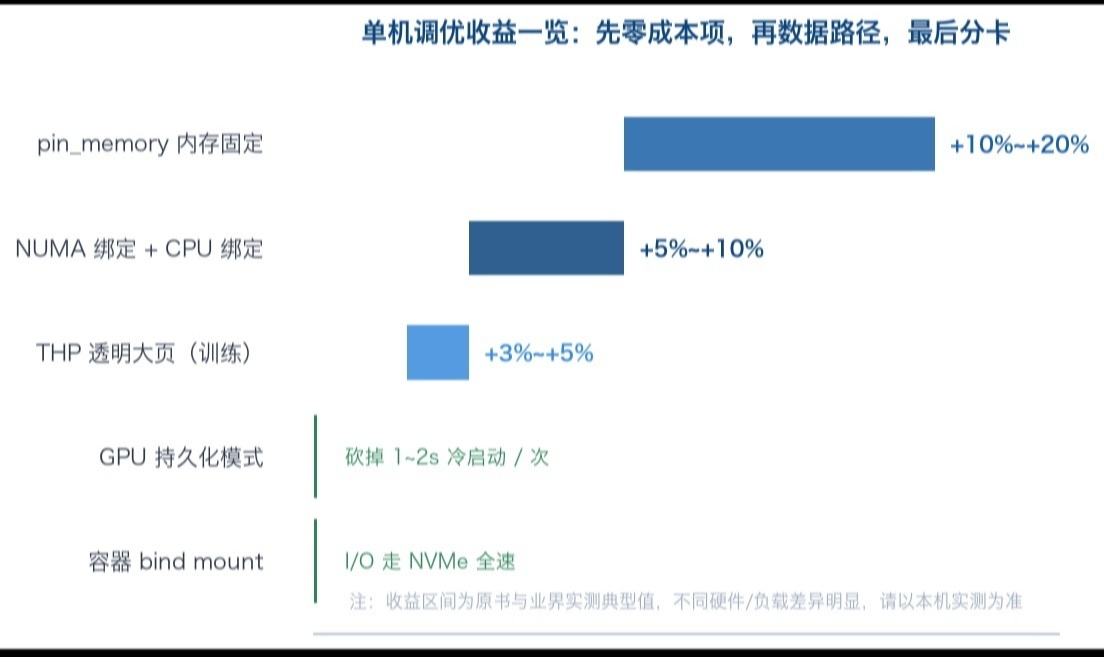
## 一、一个让人心疼的现场:GPU 99% 的时间在等 CPU 先讲个真实的烦恼。你组里一个训练任务,跑了三天,`nvidia-smi` 一查:GPU 利用率 60%,还一跳一跳的,像打摆子。算法同学说"代码没问题",网络同学说"带宽没跑满",存储同学说"I/O 也没瓶颈"。 那 GPU 的时间去哪了? 答案是:**CPU 没把活喂到 GPU 嘴边**。训练循环里,CPU 要干的事一大堆——从磁盘读数据、分词、做数据增强、把 batch 搬进显存、调度 kernel 启动、协调多线程。这一长串主机侧工作里任何一环慢半拍,昂贵的 GPU 就得空转等下一批数据 书里那句原话很扎心:GPU 饿肚子最常见的原因,就是 CPU 没给它提供有用的工作。 这一篇就把"喂 GPU"这件事拆开,从 CPU 内存拓扑、内存管理、GPU 运行时、容器四个层面,把单机性能的每一分钱都抠出来。 ![fig11-numa-topology.png](https://developer.qcloudimg.com/http-save/yehe-11479707/7c145b8edaee7575693ef6a3648ef2c0.png) ## 二、NUMA:GPU 跟错了 CPU,数据要"跨城快递" 现代服务器是双路(甚至更多路)CPU,每路 CPU 连着自己的内存和一部分 GPU/NIC,这个物理分组叫 **NUMA 节点**。同一个节点内的访问是"同城快递",跨节点就是"跨城快递"——延迟直接翻倍。 书里给了一组实测:本地 NUMA 内存访问延迟约 **80ns**,跨节点约 **139ns**,暴涨 75%。别小看这几十纳秒,训练循环里 CPU 要做的内存访问是亿次级的,每次多等 60ns,累积起来就是肉眼可见的吞吐差(来源:*AI Systems Performance Engineering* 第 3 章 3.3.1 节)。 **白话解释**:NUMA 就是"谁的东西离谁近"。GPU 0 插在 CPU 0 的 PCIe 槽上,它俩是一伙的;如果进程跑在 CPU 1 上却要伺候 GPU 0,那 CPU 1 得先"跨城"去读 CPU 0 侧的内存,再把数据搬到 GPU 0——两头都是冤枉路。 Linux 默认有 NUMA balancing,但对 AI 这种性能敏感负载通常不够,进程还会被调度器到处迁移。正确做法是**显式绑定**,三个工具任选: ```bash # 方式一:numactl 同时绑定 CPU 节点和内存节点 numactl --cpunodebind=1 --membind=1 python train.py --gpu 5 # 方式二:taskset 绑定具体核心 taskset -c 24-31 python train.py --gpu 5 # 方式三(推荐动态写法):先查 GPU 属于哪个 NUMA 节点 for GPU in 0 1 2 3; do NODE=$(nvidia-smi topo -m -i $GPU | awk '/NUMA Affinity/ {print $NF}') numactl --cpunodebind=$NODE --membind=$NODE \ bash -c "CUDA_VISIBLE_DEVICES=$GPU python train.py --gpu $GPU" done ``` 注意 `--membind` 要和 `--cpunodebind` 一起用:只绑 CPU 不绑内存,进程可能跑在节点 0 却用着节点 1 的内存,绑定白做(来源:*AI Systems Performance Engineering* 第 3 章 3.3.2 节)。 还有个细节:numactl 的策略会被 fork 出来的子进程继承,但 **spawn 启动的子进程不继承**。PyTorch DataLoader 的 worker 如果走 spawn,内存绑定就丢了——所以要么保持 fork 模型,要么在 worker 里手动设置亲和性(`worker_init_fn`)。 在 GH200/GB200 这类 Grace 超级芯片上,CPU 和 GPU 用 NVLink-C2C 直连(约 900GB/s 一致性带宽),但 Linux 仍把 CPU 内存和 GPU HBM 分开管理,照样要尊重数据局部性。 **我的判断**:NUMA 绑定是单机调优里投入产出比最高的一步,纯配置、零代码改动、风险几乎为零。K8s 环境别忘了配合拓扑管理器(后面集群篇细说),物理机直接上 numactl。 ## 三、内存:固定、大页、别交换,三件套 CPU 侧的第二个大头是内存管理。三个旋钮,按收益排序: **① 内存固定(pinned memory):+10%~20% 吞吐** 普通内存是"可分页"的,OS 随时可能把它挪走;固定内存(页锁定)OS 不能动它,GPU/NIC 就能直接 DMA 读走,不需要 CPU 临时钉页。从固定内存拷数据到 GPU,比从可分页内存**快 2-3 倍**。 落地极其简单——PyTorch DataLoader 加一个参数: ```python DataLoader(dataset, batch_size=256, pin_memory=True) ``` 就这一行,很多团队实测主机到设备传输吞吐提升 10%~20%(来源:同上)。 两个坑: - OS 对锁定内存有上限(`ulimit -l`),默认可能只有 64KB,大 buffer 直接分配失败。AI 集群惯例是设成 unlimited,容器里对应 `--ulimit memlock=-1`。 - GPUDirect RDMA / GDS 都是建立在"内存固定"之上的,固定内存是它们的地基。 **② 透明大页(THP):+3%~5% 吞吐,但推理慎用** Linux 默认用 4KB 小页管理内存,大模型动辄几十上百 GB 内存,管理几百万个小页,页表(TLB)压力很大。打个**比**——大页就像把散装小信封换成整箱发货,量大快递费便宜,可**整箱打包时会卡一下**——这就是 THP 的后台压缩。THP 用 2MB 大页兜底,减少页错误和 TLB miss,一般能拿 3%~5% 吞吐。 **但**:THP 的整箱压缩会引入不可预测的停顿,对延迟敏感的推理负载是灾难。业界共识是——**训练开 THP,推理关 THP**(或改 madvise 模式)。分布式训练里多个 rank 同时申请大内存的场景同样建议关闭,避免压缩风暴。 **③ 交换(swap):必须杜绝** GPU 程序会在主机内存里缓存大量数据,一旦 OS 把一部分换到磁盘,GPU 要数据时就是灾难性的、数量级的延迟。书里的建议很直接:`vm.swappiness=0`,除非极端内存压力否则不交换;容器里再用 cgroup 内存限制把作业隔离起来。 ![fig11-cpu-binding.png](https://developer.qcloudimg.com/http-save/yehe-11479707/18962fef1549cc811ed38252c68bf234.png) ## 四、GPU 运行时:持久化模式,别让 GPU 反复"开机" GPU 驱动默认在没人用的时候会把卡降到低功耗状态、卸载驱动上下文。下一个任务要用时,驱动重新初始化要花一两秒。训练集群里作业频繁启停,推理集群里请求稀疏——每来一个请求都要等 GPU"睡醒",积少成多就是白白流失的吞吐。 解法是**持久化模式**:跑一个 `nvidia-persistenced` 守护进程,让驱动常驻、GPU 保持就绪,下一个作业零启动延迟。AI 集群的惯例是开机就在所有卡上启用: ```bash systemctl enable nvidia-persistenced ``` K8s 环境用 NVIDIA GPU Operator 也能自动在所有 GPU 上开启。唯一代价是空闲功耗略高,对数据中心 GPU 来说,用这点电换性能一致性,值。 **白话解释**:持久化模式就是不让 GPU 睡懒觉。它不会让数学算得更快,但能砍掉冷启动延迟——作业一来就能开跑。 ## 五、一张卡多人用:MPS、MIG、时间片怎么选 这是多租户/多任务场景的经典选择题。一张 80GB 的卡,四个推理服务各用 5-10GB、各占 30% 算力,怎么分? **默认行为(时间分片)**:GPU 调度器在进程间频繁切换,同一时刻只有一个进程的 kernel 在跑,其他三个等着。结果就是卡 70% 时间闲着。 **MPS(进程级并发)**:把多个进程的上下文合并进一个调度上下文,kernel 可以真正并发跑——A 在等内存时 B 的 kernel 填上来。书里给的数据:两个各占 40% 的进程,开 MPS 后整卡利用率能到 80%~90%;两个原本各要 1 小时的训练进程,并发跑总共只要 1 小时多一点而不是 2 小时(来源:同上)。 **MIG(硬件级隔离)**:把 GPU 在硬件层面切成最多 7 个实例,每个有独立的内存和 SM。隔离最强、互不干扰,适合"不同租户、安全隔离、SLA 严格"的场景;代价是灵活性差——空闲实例的资源不能借给邻居,切 MIG 模式要重启 GPU,是静态配置不是动态调度。 三者的取舍一句话:**MPS 要并发、MIG 要隔离、时间片只图省事**。推理服务密集小任务用 MPS;多租户强隔离用 MIG;交互式/开发环境图省事才用时间片。MPS 有个安全坑要注意:所有客户端共享完整显存空间,一个进程 OOM 会带走整卡上所有进程,且默认要求同一 Unix 用户(现代驱动支持多用户 MPS,但无内存隔离)。 ![fig11-gpu-share.png](https://developer.qcloudimg.com/http-save/yehe-11479707/68a624ad091ee8cf4b8e322e4c31e64b.png) ## 六、容器:别让 OverlayFS 拖后腿 容器本身对 GPU 性能几乎无损耗——配好 NVIDIA Container Toolkit 后,容器内 GPU 性能和裸机差异 <2%(MLPerf Inference v5.0 就是用容器编排环境跑的)。真正的坑在别处: **① 数据别放镜像里,用 bind mount。** 容器的可写层是 OverlayFS + 写时复制,大文件读写(数据集、checkpoint)走可写层会有额外开销。正确姿势是把数据集目录从宿主机挂进来,只读挂载,读写直接走宿主机文件系统,拿到 NVMe 的全部性能: ```bash docker run -v /data/dataset:/mnt/dataset:ro -v /data/ckpt:/mnt/ckpt ... ``` **② 镜像瘦身,启动提速。** 镜像越大,拉取越慢。训练任务一次跑几小时几周,启动慢几分钟可忽略;但如果是短作业多的调度环境,镜像大小直接决定排队成本。别把构建工具和临时文件打进镜像。 **③ 多节点训练用 hostNetwork。** K8s 默认的 overlay 网络 + NAT 会给 MPI/集合通信引入额外开销和端口映射麻烦。性能敏感的 GPU 作业设 `hostNetwork: true`,让容器直接用宿主机网络栈访问 InfiniBand,零转换零防火墙层(来源:*AI Systems Performance Engineering* 第 3 章 3.6.4 节)。 **④ CUDA 与驱动版本匹配。** 容器里装的是 CUDA 运行时,驱动在宿主机。CUDA 13.x 需要宿主驱动 R580+,CUDA 12.x 需要 R525+。驱动比 CUDA 要求的版本旧,CUDA 初始化直接失败。用 NGC 官方基础镜像(nvcr.io/nvidia/pytorch 之类)最省心,镜像标注了所需的最低驱动。 ## 七、调优顺序:先算账,再动手 单机调优旋钮很多,但别全上,先算账: 1. **先做基线**:跑同一 benchmark,记下 GPU 利用率、吞吐、kernel 间隙(Nsight Systems 看 timeline,gap 一目了然)。 2. **零成本项先上**:NUMA 绑定 + pin_memory + swappiness=0 + 持久化模式——全是配置,没代码风险,通常能回收 10%+ 的利用率。 3. **再看数据路径**:数据集是不是走 bind mount?是不是还在镜像里?这一步经常被忽略。 4. **最后才考虑分卡**:多租户场景才需要 MPS/MIG 决策,单机单任务别折腾。 5. **验证再验收**:改完一项重跑一次基线,别一口气全改——出了问题都不知道是哪个旋钮引入的。 下次再遇到 GPU 利用率掉,先别急着抄别人的算法 trick,把主机侧这四个旋钮拧完再说。算法是"锅"的概率,远低于 CPU/内存/存储是"锅"的概率。 ## 参考资料 - Chris Fregly, *AI Systems Performance Engineering*, O'Reilly Media(第 3 章:GPU 环境的 OS/Docker/K8s 调优) - NVIDIA:《Automating GPU Kernel Generation with DeepSeek-R1 and Inference Time Scaling》 - NVIDIA MLPerf Inference v5.0 提交说明(容器编排环境性能)

优秀的个人博客,低调大师

AI Infra 系列 · 第六章 GPU 性能工程(二):B200 算力涨 2.25 倍,运数据的路一寸没宽,你的内核其实在等数据

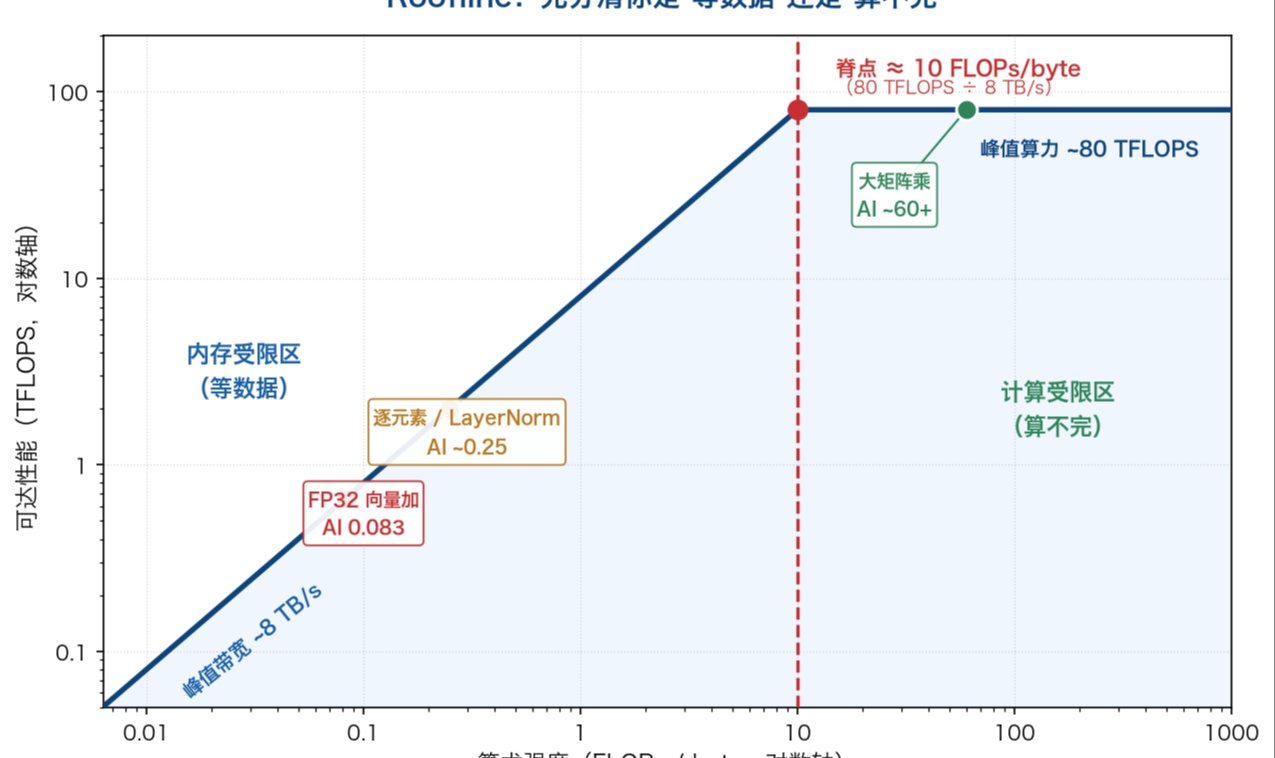
## 一、先从一个"跑偏了"的优化说起 2026 年 3 月,Tri Dao 和 Colfax、Meta、NVIDIA 的人一起发了 FlashAttention-4(arXiv:2603.05451,3 月 5 日)。论文里有一句话很值得琢磨(来源:FlashAttention-4 论文及 Colfax Research 解读博客,2026-03): > 一个朴素的观点可能认为,GEMM 的速度完全决定了 attention 内核的性能,其他部分至少在一阶近似下可以忽略。但在 B200 上做"喂料与速度"分析,结论恰恰相反:主要瓶颈不在张量核心做 MMA 有多快,而在于(a)前向计算时 softmax 指数运算用的 SFU 单元,(b)反向计算时的共享内存流量。 翻译成人话:**你以为 GPU 在忙着算矩阵,其实它有一半时间在排队等指数运算、等共享内存倒腾数据。** 为什么会这样?因为硬件是"偏科"长大的。从 Hopper H100 到 Blackwell B200,BF16 张量核心吞吐从 1 PFLOPS 涨到 2.25 PFLOPS,涨了 2.25 倍;但 **SFU 数量没变,共享内存带宽也没变**。作者给这种现象起了个名字,叫**非对称硬件扩展(asymmetric hardware scaling)**——算力单元一路狂奔,其他配套设施原地踏步。 这件事的意义超出 attention 本身。它意味着:**你从 H100 换到 B200,代码一行不改,内核大概率不会快 2.25 倍,因为卡住你的那个东西根本没升级。** ## 二、Roofline:一张图分清"算不完"和"等数据" 判断卡在哪,最趁手的工具是 **Roofline 模型**。它把硬件的两条性能上限画在一张图上:一条水平线是峰值算力,一条斜线是峰值内存带宽,两条线组成一个"屋顶"。你的内核是坐标上的一个点,落在斜线下面就是内存受限(等数据),贴到水平线就是计算受限(算不完)(来源:*AI Systems Performance Engineering* 第 6 章 6.13 节)。 ![fig12-roofline.png](https://developer.qcloudimg.com/http-save/yehe-11479707/12033061331f2fc0baea9ce83015d392.png) 图里两条线的交点叫**脊点(ridge point)**,对应的横坐标就是"算术强度"的门槛。算术强度的定义很朴素:**每从显存搬 1 字节数据,能干多少浮点运算(FLOPs/byte)**。 原书举了个特别有说服力的例子:一个内核读两个 FP32 浮点数(8 字节),做一次加法(1 FLOP),写回一个 FP32(4 字节)。一共搬了 12 字节,干了 1 个 FLOP,算术强度是 **0.083 FLOPs/byte**。而一块 Blackwell 级 GPU 的脊点在 **10 FLOPs/byte** 左右(约 80 TFLOPS ÷ 8 TB/s)。 差多少?**约 120 倍**——原书写"100 倍以上 / 两个数量级",120 是精确算出来的。 这个内核的算术强度比门槛低了两个数量级,它连算术逻辑单元的牙缝都塞不满。向量加法、激活函数、LayerNorm、逐元素乘——所有"读一遍写一遍"的操作,算术强度都在 0.1 这个量级,全是内存受限。反过来,一个大尺寸的矩阵乘法,数据搬进来要在片上被复用成百上千次,算术强度能轻松过百,那就是计算受限。 Nsight Compute 里怎么分辨?原书写得很直接:**内存受限的内核,DRAM 带宽利用率非常高,同时算力类指标(比如 ALU 利用率)很低**,说明 warp 大部分时间卡在访存上;而 warp stall reason 里会显示大量的内存依赖停顿。 大白话版:算术强度就是"出一趟差能办多少事"。你跑一趟 HBM 要几百个时钟周期,如果只为了加两个数就回来,那时间全耗在路上了;聪明做法是搬一批数据到片上,在片上把能算的都算完再回去。 ## 三、内存层次:一步慢,处处慢 既然关键是把数据留在片上,就得知道片上到底有多快。Blackwell 的内存层次是这样的(来源:*AI Systems Performance Engineering* 第 6 章表 6-5): | 层级 | 容量 | 延迟 | 带宽(约) | | ---------- | ------------------------------- | -------------- | ---------------- | | 寄存器 | 每 SM 64K 个 32 位寄存器(每线程最多 255 个) | 单周期,基本免费 | 每 SM 数十 TB/s | | TMEM | 每 SM 256 KB(张量核心专用) | ~10 周期 | TB/s 级,直连张量核心 | | 共享内存 / L1 | 每 SM 228 KB(可用 227 KB) | ~20-30 周期 | TB/s(无 bank 冲突时) | | 常量缓存 | 每 SM ~8 KB | ~1 周期(warp 广播) | TB/s 级 | | L2 | 全 GPU 126 MB | ~200 周期 | 多 TB/s 聚合 | | 全局内存 HBM3e | B200 最多 180 GB(B300 约 288 GB) | 数百 → 1000+ 周期 | ~8 TB/s | ![fig12-mem-hierarchy.png](https://developer.qcloudimg.com/http-save/yehe-11479707/c5760c600b17f7911f40a87bc1fba95a.png) 看最后两行的落差:**从共享内存到 HBM,延迟从几十周期跳到几百上千周期,差了一个到两个数量级;带宽侧则是另一种故事——共享内存每 SM 是 TB/s 级的吞吐,而 HBM 那 8 TB/s 是整张卡共享的封顶值,几千个线程来抢。** 这里有个隐蔽的坑:**寄存器溢出(register spilling)**。每个线程最多 255 个寄存器,如果你的内核局部变量太多、或者融合得太狠,编译器会把溢出的变量丢进"本地内存"——而本地内存就 backing 在 DRAM 上,延迟直接回到数百周期。你以为自己在用最快的存储,其实早就掉回最慢那一层了。这也是为什么 Nsight Compute 会专门追踪 spill 指标。 还有个 Blackwell 的新成员值得认识:**TMEM**。它是每 SM 256 KB 的专用片上内存,直连张量核心,延迟约 10 周期,不在 CUDA C++ 里直接指针寻址,而是由 TMA(Tensor Memory Accelerator)硬件搬运数据。你可以把它理解成"给张量核心开的专属备料台":TMA 负责把数据从全局内存搬到共享内存,张量核心指令(tcgen05)再在共享内存和 TMEM 之间隐式倒腾,全程不回 HBM,人不用手动管。 顺带一提,B200 看起来是一块 GPU,实际是两个受光刻限制的裸片通过 10 TB/s 的片间互连拼起来的,每边挂 4 个 HBM3e 堆栈,共 8 个。地址空间对开发者是统一的,看到性能 profile 时注意一下"跨裸片访问"可能有差异就行。 ## 四、合并访问:一个 stride 把带宽打到 25% 知道了层次,下一步是"怎么搬才不亏"。这里有个原书第 7 章的实测案例,数字挺吓人。 现代 GPU 的缓存行是 **128 字节**,由 **4 个 32 字节扇区**组成。如果一个 warp 的 32 个线程访问连续且 128 字节对齐的地址,硬件会合并成最少的 4 个扇区,一次拿完。但如果线程用跨步索引(比如 stride=2),或者起始地址没对齐,请求就会跨缓存行,扇区数膨胀。 原书实测:跨步版本的每个 warp 请求被拆成平均 **8 个独立的 32 字节扇区**,是理想值的两倍。结果是 **Nsight Compute 只报告约 25% 的持续峰值 DRAM 吞吐**——四分之三的带宽白扔了。打个比方:32 个人打饭,挨着拿一次端走;隔一个拿一次,同样的饭得跑八趟,多出来的七趟全在排队。 对应的诊断指标也有明确阈值(来源:同书第 7 章): - **Global Memory Load Efficiency** 明显偏低 - **DRAM 扇区读取计数**偏高 - **平均每请求扇区数(sectors per request)超过 4.0** - DRAM 吞吐百分比远低于峰值 在 PyTorch 里这个坑很好踩:一个带跨步索引的 `torch.index_select`,底层 gather 内核就会发出非合并加载——32 个线程访问的地址相隔 `stride * 4` 字节,硬件没法合并,只能发 32 次独立加载。 修法通常很简单:让每个 warp 的 32 个线程读连续元素,用 `idx = blockIdx.x * blockDim.x + threadIdx.x` 这种线性索引;或者把数据布局从 AoS(结构体数组)换成 SoA(数组结构体),让线程 i 永远访问元素 i。改完再看 Nsight Compute,效率指标会立刻回升。 同类的坑还有**共享内存 bank 冲突**——共享内存像 32 个并行收银台,多个线程同时挤同一个台,请求就被串行化,TB/s 级的吞吐说没就没。原书给的规避办法是填充(padding)或交叉(swizzle)数据。这两类问题都属于"代码看起来没错,但带宽只剩零头"。 ## 五、提算术强度的三板斧 + 一个偏方 判断清楚、访问也合并了,接下来才是真正提性能。手段就三类,都是围绕"每搬一个字节多干点活"。 ![fig12-arith-intensity.png](https://developer.qcloudimg.com/http-save/yehe-11479707/a388147348f383a0e8cfeb90555c2c02.png) **第一斧:分块复用(tiling)。** 把 A、B 的小子矩阵搬进共享内存,让每个字节在片上被反复用。极端一点算:一个 32×32 的块加载到共享内存后,每块贡献 1024 次乘加(32×32),相当于平均每个元素被复用 **32 次**。相比每次都从 DRAM 取数,算术强度直接乘上复用因子。Blackwell 上还有个更狠的招:**线程块集群 + TMA 多播**,2×2 的四个 CTA 协作加载同一个块,全局内存流量最多能降到 1/4。Blackwell 支持到 16 个 CTA 的集群,但要注意——集群越大占用率越低,开之前先测(来源:同书第 9 章)。 **第二斧:内核融合(fusion)。** 把多个操作合成一个内核,中间结果留在寄存器或共享内存里,不写回 HBM。原书给了个直观对比: - 不融合:4 FLOPS 对应 36 字节的加载与存储(中间结果来回倒腾) - 融合后:4 FLOPS 只对应 12 字节 同样的活,内存流量少了三分之二,算术强度是原来的 3 倍。这也解释了为什么 TorchInductor 之类的编译器那么热衷于自动融合逐元素操作——收益太直接了。不过融合不是无脑堆,寄存器压力上去会触发溢出,反而吃亏,所以原书提醒"一定要分析融合后的内核"。 **第三斧:降精度。** 这是最便宜的杠杆。同一个 128 字节事务,能装 32 个 FP32、64 个 FP16、128 个 FP8 或 256 个 FP4。把 FP32 换成 FP16,每字节干的工作量**立刻翻倍**。换个出差的比喻:之前一趟车装 32 个 FP32,现在换装 64 个 FP16——路费一样,每趟办的活翻倍。降精度之所以最划算,就因为它几乎不动代码结构。Blackwell 甚至引入了硬件解压缩——权重可以用比 FP4 更激进的方案压着存在 HBM 里,加载时硬件现场解压,等于凭空多出一部分有效带宽。 **偏方:重计算(recomputation)。** 内存带宽是瓶颈时,宁可重新算,也别存了再读。比如 `x*x` 这种廉价表达式,在寄存器里重算一遍通常比从显存把之前算好的 `x*x` 读回来快。放大到模型层面就是**激活检查点(activation checkpointing)**:反向传播要用到的激活值不存了,到时候重算,用一点额外 FLOPS 换掉大量的显存占用和访存流量。推理引擎也常用这招省显存、给更大 batch 腾空间(来源:原书第 9.5 节)。 **我的实践排序**:先做降精度(改一行 `torch.set_float32_matmul_precision('high')` 就能看到效果),再做融合(TorchInductor 自动),最后才动分块(要重写调度)。前三板斧吃下大部分收益,分块属于拼最后那 10%。改了之后记得复测——可能动了精度,数值稳定性要先观察。 ## 六、Rubin 来了,墙更高了 讲到这里,你可能会想:新一代硬件总该把带宽提上来了吧?提了,但没提够。 看 NVIDIA 官方数字(来源:NVIDIA 技术博客 *Inside NVIDIA Rubin GPU Architecture*,2026):Rubin 用 HBM4,接口宽度相对 HBM3e 翻倍,单 GPU 提供**最多 288 GB 容量、最高 22 TB/s 带宽**,是 Blackwell 的 **2.8 倍**;同时第三代 Transformer Engine 提供**最高 50 PFLOPS 的 NVFP4 推理算力**。 | 维度 | Blackwell B200 | Rubin | 倍数 | | -------------- | --------------------- | ------------------ | ------------------------------- | | HBM 带宽 | ~8 TB/s(HBM3e) | 最高 22 TB/s(HBM4) | 2.8× | | 显存容量 | 180 GB(B300 约 288 GB) | 288 GB | 1.6× | | NVFP4 推理算力 | ~10 PFLOPS(dense) | 50 PFLOPS(稀疏) | dense 对 dense 约 3.5×,稀疏口径标称约 5× | | NVLink(双向/GPU) | 1.8 TB/s | 3.6 TB/s(NVLink 6) | 2× | (来源:NVIDIA 官方技术博客,2026;不同口径下数字会有差异) 留意 NVIDIA 给 Rubin 标的 50 PFLOPS 是 **NVFP4 稀疏口径**;B200 对应数字是 dense FP4,dense 对 dense 的实际倍数约 3.5×。但不论按哪个口径看,**算力的涨幅都明显大于带宽**——这意味着同一份代码搬到 Rubin 上,掉进内存受限区的概率反而更高:想喂饱那些张量核心,每个字节得干比以前多一截的活。 ## 七、2026 的四种破墙姿势 既然墙在加高,2026 年最前沿的内核优化本质都是跟它较劲。FlashAttention-4 论文实际上列了四招,最关键的第一招是**重设计的全异步 MMA 流水线**——利用 Blackwell 完全异步的 MMA 指令和更大 tile,让 tensor core 与 softmax 指数运算、内存搬运三件事真正并行起来。这是后面三招能见效的基础。 第二到第四招是: 1. **软件模拟指数函数**:既然 SFU 是瓶颈、而 FMA 单元充裕,那就用多项式近似(Cody-Waite + 三次多项式)在通用算力单元上算 exp,只覆盖 10-25% 的指数运算元素,把稀缺 SFU 解放出来。 2. **条件 softmax 重缩放**:online softmax 通常每次运行最大值变化都要重缩放,FA4 只在变化大到威胁数值稳定时才做,据 Tri Dao 在 Hot Chips 的分享,**重缩放操作减少约 10 倍**。 3. **2-CTA MMA + TMEM 存中间结果**:反向传播把中间结果放 TMEM 缓解共享内存流量,再用 Blackwell 的 2-CTA MMA 模式让一个 UMMA 跨 CTA 对执行,进一步减少共享内存流量,同时把原子归约砍半。 结果:B200 BF16 下前向峰值 **1613 TFLOPS**,硬件利用率 **71%**,比 cuDNN 9.13 快最高 **1.3 倍**,比 Triton 快 **2.7 倍**(来源:FA4 论文 arXiv:2603.05451,2026-03-05)。另外 FA4 整个用 CuTe-DSL(Python 内嵌的 DSL,属于 CUTLASS)实现,编译时间比传统 C++ 模板快 **20-30 倍**——内核开发从写 C++ 模板变成写 Python,迭代速度上来才有空间反复试错(比如 FA4 一连试了多种 softmax 重缩放策略,普通工程节奏根本撑不住)。论文同时提到 NVIDIA 后续已把部分 FA4 技术吸收进新版 cuDNN。 再讲个"土法炼钢"的真实案例,能让你对内存层次有多敏感。DeepSeek 的 DeepEP 专家并行库里用了这么一条定制 PTX 指令: ``` ld.global.nc.l1::no_allocate.l2::256b ``` 意思是:发起非一致的全局加载,**不在 L1 分配**(`l1::no_allocate`),而是以 **256 字节块直接灌进 L2**(`l2::256b`)。为什么?因为专家并行的 all-to-all 通信内核每次调度都只读一遍大块连续缓冲区,如果这些加载走 L1,会把 SM 正在频繁使用的缓存行挤出去。绕开 L1 直取 L2,就保护了热数据。 严格地说,这几个修饰符本身在 NVIDIA PTX ISA 文档里能找到,但 DeepSeek 把它们组合起来精确控制 H800 受出口限制版本的缓存行为,被 DeepEP README 标为"未定义/文档外用法"。风险也很实在:不保证跨代稳定,所以 DeepEP 里专门留了构建开关 `DISABLE_AGGRESSIVE_PTX_INSTRS=1`,出问题可以一键关掉(来源:*AI Systems Performance Engineering* 第 9 章)。 这故事说明两件事:一是内存层次的行为值得抠到指令级;二是非常规手段要配逃生开关。 ## 八、给你的排查清单 把这篇和上一篇的四步体检接起来,落到单卡内核上,顺序大概是这样: 1. **先算算术强度**:你的内核每搬 1 字节干多少活?对照脊点(Blackwell 约 10 FLOPs/byte),先判断是在"等数据"区还是"算不完"区。方向错了,后面全白做。 2. **看内存层次有没有用起来**:Nsight Compute 里查寄存器溢出、共享内存命中率、L2 命中率。溢出到 local memory 是最容易被忽略的性能杀手。 3. **查合并访问**:sectors per request 是不是超过 4.0?Global Memory Load Efficiency 低不低?PyTorch 侧重点查 `index_select` 之类的 gather。 4. **上三板斧**:降精度 → 内核融合 → 分块复用。优先级按这个顺序,因为前两个几乎不动代码结构,分块要重写调度。 5. **带宽还是紧就考虑重计算**:廉价表达式重算、激活检查点,用算力换带宽。 6. **改一处测一处**:每次改动后用同一个 ncu 命令复测,看内核在 Roofline 上是往右移了(强度提高)还是往上移了(更接近屋顶)。 ---

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册