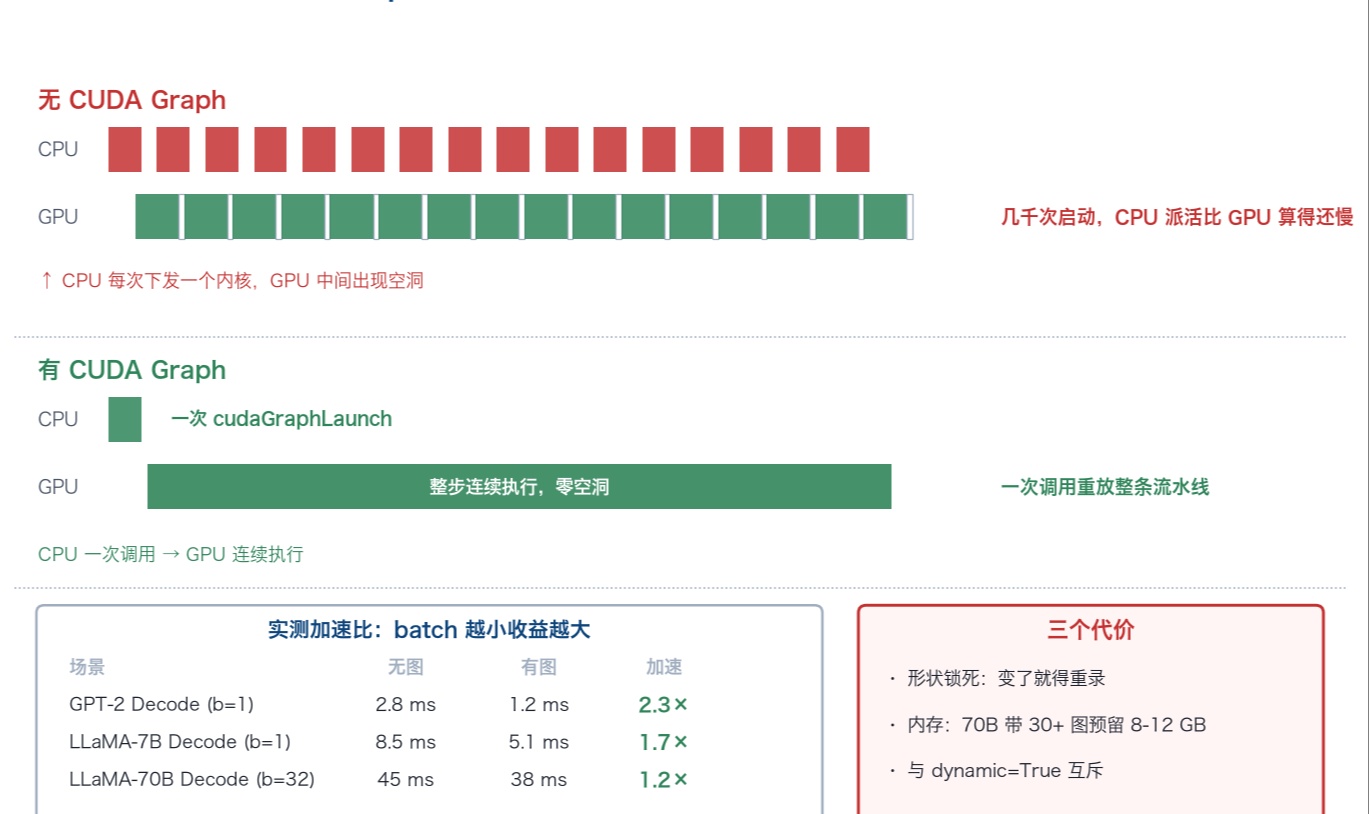
AI Infra 系列 · 第六章 GPU 性能工程(三):torch.compile 不是开关——碎算子能快一倍,GEMM 基本白搭
先别急着读下去。花两分钟跑一下这段,它会把你后面要看的东西全部验证一遍。 ```python import torch, time dev = "cuda" def bench(fn, iters=200, warmup=30): for _ in range(warmup): fn() # 预热:compile 的编译时间在这里花掉 torch.cuda.synchronize() t0 = time.perf_counter() for _ in range(iters): fn() torch.cuda.synchronize() return (time.perf_counter() - t0) / iters * 1000 # ms/次 x = torch.randn(1024, 1024, device=dev) w_small = torch.randn(1024, 1024, device=dev) w_big = torch.randn(4096, 4096, device=dev) def many_small_ops(): # A:8 段逐元素链 + 小 matmul,像 MoE / 归一化密集的负载 h = x for _ in range(8): h = torch.relu(h + 1.0) * 0.5 h = torch.matmul(h, w_small) return h def one_big_gemm(): # B:就一个大矩阵乘,从头算到尾 return torch.matmul(x, w_big) for name, fn in [("A 碎算子密集", many_small_ops), ("B 单 GEMM 主导", one_big_gemm)]: eager = bench(fn) cfn = torch.compile(fn) cfn() # 触发编译 compiled = bench(cfn) print(f"{name:16s} eager {eager:7.3f} ms compile {compiled:7.3f} ms {eager/compiled:.2f}x") ``` 跑出来的样子(数字随你的卡变化,看**两行的倍数差**,不看绝对值): ``` A 碎算子密集 eager 0.412 ms compile 0.198 ms 2.08x B 单 GEMM 主导 eager 1.847 ms compile 1.781 ms 1.04x ``` 同一个 `torch.compile`,A 快了一倍,B 基本没动。这就是本篇全部内容的缩影:**编译器省的是开销,不是算力**。算子越碎、Python 胶水越重,能省的越多;模型里已经是一个大 GEMM 从头算到尾,编译器没什么开销可省。 我在自己的机器上测过好几次,规律稳定:开 compile 之前瞄一眼 GPU 利用率,已经 80% 以上基本不用指望,三四十还上不去的往往能救回来一点。  --- ## 一、这行代码背后,是四个阶段在干活 `torch.compile` 听起来是一个东西,其实是四段流水线串起来。断在哪一段,丢的加速比不一样。 **① TorchDynamo 抓图。** PyTorch 默认是 eager 的,你写一行它算一行。Dynamo 挂在 CPython 的字节码求值上,边跑边把张量操作记成一张 FX 图的节点。碰到它跟不上的代码——一个 `print`,或者 `if x.sum() > 0` 这种拿 Python 布尔值做判断的控制流——就**断开**,那段退回 eager 跑完,之后再接着抓。比老一代 `torch.jit.trace` 强的地方在于,它不会偷偷只跟一条分支。 **② AOT Autograd 拼前后向。** eager 模式下反向图是前向跑的时候动态记录的,编译器没法提前优化。AOT Autograd 把前向和反向拼成一张联合图,于是"前向某个算子"和"它为反向存的激活"可以一起融合。这也是 compile 对训练的收益常常比推理更大的原因。 **③ TorchInductor 生成内核。** 拿到图之后做算子融合,GPU 上吐 Triton 内核,CPU 上吐 C++。上面脚本里 A 那个 `(h + 1.0) → relu → * 0.5` 的链条,eager 要 3 个内核、3 读 3 写,Inductor 合成 1 个内核、1 读 1 写——这正是上一篇讲的"少搬数据"。而 GEMM 它不自己造,转手交给 cuBLAS/CUTLASS,所以 B 那行几乎没变化。 **④ CUDA Graph 收尾。** 把整个 step 的几百次 kernel launch 录成一张图,之后一次 CPU 调用重放,几乎零启动开销。只在特定模式下开,第四节展开。 业界实践资料常引用的区间是训练 **1.3-2×**、推理常见 **1.3-2×**,轻量算子密集的负载能到 **3×**。这是经验区间不是官方基准,不同模型结构能差出好几倍——所以才让你先跑那段脚本。 ## 二、图断点:加速比是怎么被吃掉的 图断点是"开了 compile 怎么没变快"最常见的原因。每断一次,前面攒好的一段图就被掐断,Python 解释器重新登场。 打个比方:编译器抓图像把整个方队带进车间,队伍里有人擅自离队(一个 print、一个数据相关的 if),车间只能让他出去、整队重列一次——每断一次,前面攒的加速全白费。 诊断工具是现成的: ```python # 开发期:一断点就报错,把问题全逼出来 torch.compiler.set_stance("fail_on_recompile") # 看每个断点是谁造成的、断在哪一行 torch._dynamo.explain(model, *inputs) # 日志里直接读原因,比 explain 更细 # TORCH_LOGS="graph_breaks,guards,recompiles" python train.py ``` 最常见的凶手是**数据相关的 Python 控制流**。把 `if x.sum() > 0:` 换成 `torch.where(mask, a, b)`,整段就能被抓进去。新版本还有 `torch.cond`,能把 if/else 两个分支都编进图里(要求两个分支返回结构和 dtype 一致、运行时形状一致)。 想亲手见一次断点长什么样,跑这个: ```python import torch def with_break(x): h = torch.relu(x) if h.sum() > 0: # ← 用 Python 布尔值做判断,Dynamo 跟不上去 h = h * 2 return h def no_break(x): h = torch.relu(x) return torch.where(h.sum() > 0, h * 2, h) x = torch.randn(1024, 1024, device="cuda") print(torch._dynamo.explain(with_break, x).graph_break_count) # 1 print(torch._dynamo.explain(no_break, x).graph_break_count) # 0 ``` 有一类断点不用管:FSDP 这类分布式策略在 all-gather、reduce-scatter 处通常会有断点,这是设计使然,PyTorch 靠它把通信和计算重叠起来。真正要做的是把每个 transformer block 包成独立的 FSDP 子模块,让 Dynamo 在子模块边界显式断点;不包的话整个模型退化成一个大桶,编译收益明显缩水(来源:PyTorch 官方 FSDP2 与 torch.compile 集成文档)。 还有个容易忽略的信号:**训练循环跑到前几步之后应该就零重编译了**。如果几百步还在重编,八成是每步都有东西在变——带自增计数器的 debug print、或者某一步传 CPU 张量下一步传 GPU 张量,都会触发 guard 失效。 ## 三、CUDA Graph:专治"启动开销" CUDA Graph 是这套流水线里最容易被低估、也最容易踩坑的一环。 它解决什么问题?自 2016 年 GP100 以来,NVIDIA GPU 的半精度算力涨了约 **47 倍**,显存带宽只涨了 **4.6 倍**(来源:Fireworks AI 公开分析,GP100 21 TFLOPS / 730 GB/s → H100 989 TFLOPS / 3350 GB/s)。GPU 越来越快,主机 CPU 没跟上。一个 7B transformer 的前向要发几千次小内核启动,batch=1 的 decode 步里 GPU 算完只要几微秒,CPU 派活的时间比它算的时间还长。 CUDA Graph 的做法是:预热时把一次前向的所有内核启动、内存分配、同步事件录下来,之后一次 `cudaGraphLaunch` 重放。 实测收益的规律很一致(来源:2026 年 LLM 推理调度实测汇总): | 场景 | 无 CUDA Graph | 有 CUDA Graph | 加速比 | | --------------------------- | ------------ | ------------ | -------- | | GPT-2 Decode (batch=1) | 2.8 ms/token | 1.2 ms/token | **2.3×** | | LLaMA-7B Decode (batch=1) | 8.5 ms/token | 5.1 ms/token | **1.7×** | | LLaMA-70B Decode (batch=32) | 45 ms/token | 38 ms/token | **1.2×** | batch 越小、内核越碎收益越大;batch 一大,内核计算本身占主导,边际收益就塌了。另有 H100 上 7B 量级 decode 实测约 **1.4-1.7×**,小 batch 下 CPU 启动开销会吃掉 20%-30% 的步时间(来源:blog.prompt20.com 2026 年 CUDA Graph 生产实践资料)。  主流框架 2026 年都把它当标配:**vLLM 在 decode 阶段默认开启**,启动时按 batch size 分桶预录若干张图;**SGLang 用 CUDAGraphRunner** 按 (batch_size, seq_len) 索引管理;**TRT-LLM 深度集成**,支持 inflight batching 下的图切换(来源:各框架公开文档)。 代价也得说清楚: - **静态形状的硬约束。** 图录制时锁死了张量地址和形状,形状一变就得重录。生产上都是"分桶 + padding"——把输入向上取整到 512/1024/2048/4096 这些档位,每档预录一张。 - **内存开销。** 每张图要占一个私有内存池,地址被锁住不能给别人用。70B 模型带 30 多张图,预留 8-12 GB 给图池是常态(来源:2026 年 CUDA Graph 生产实践资料)。 - **和 `dynamic=True` 互斥。** 开了动态形状,CUDA Graph 就不生效了。道理很直白:录的时候尺寸已经焊死,下一句长度一变这张图就作废;动态形状会改 guard 和内存规划,直接禁用图捕获(来源:PyTorch 官方文档)。 想确认图到底捕获了没有,在日志里搜这行: ```bash TORCH_LOGS="cudagraphs" python train.py 2>&1 | grep -i cudagraph # 看到 "cudagraph static input" / capturing 就说明抓到了; # 看到 "skipping cudagraphs due to" 后面会直接写原因 ``` ## 四、库 / 编译器 / 手写:三层怎么分工 这是本篇最容易被误读的一节。 "编译器时代"常常被理解成"手写内核已死"。PyTorch 官方博客 2026 年发的一份实测,把这个判断劈成了两半。他们用 **Helion**(PyTorch 自己的内核 DSL)重写了 vLLM 里 Qwen3 FP8 推理的融合内核,在 H100 和 B200 上对比 CUTLASS(来源:PyTorch 官方博客 *Portable vLLM Model Inference Kernels in Helion*, 2026)。下面是 Helion 内核对 CUTLASS 的加速比: | 内核 | H100 vs CUTLASS | B200 vs CUTLASS | | ---------------------------- | --------------- | --------------- | | rms_norm + per-block 量化 | **2.055×** | **2.128×** | | silu_and_mul + per-block 量化 | **2.269×** | **2.325×** | | per-token group FP8 量化 | 1.408× | 1.446× | | scaled_mm(标准 GEMM) | **1.080×** | **0.739×** | | scaled_mm_blockwise(分块 GEMM) | 0.957× | 0.782× | 量化、归一化、融合这类"杂活"上,编译器生成的内核把 CUTLASS 甩开一倍多;但一到 GEMM,H100 上 Helion 的 scaled_mm 还能赢 8%,B200 上两个 GEMM 内核一起输(0.739× 和 0.782×),输 22%-26%。官方原话是 *On H100, scaled_mm outperformed CUTLASS; On B200, both GEMM kernels currently lagged behind CUTLASS*——分界线正好卡在硬件换代上。 官方给的原因是:卡点不在 Helion 的编程模型,而在 Triton 在 Blackwell 上生成 GEMM 内核的当前水平。Blackwell 的 TCGEN05、TMEM 这些新硬件单元,Triton 还没吃透。这和上一篇 FA4 那篇论文说的是同一件事:新架构刚出来,软件栈要追一阵子。 所以 2026 年比较务实的分工是这样: - **通用算子、融合杂活 → 交给编译器。** 自己写的 CUDA 大概率打不过自动调优搜出来的版本,而且硬件一换代就得重写。 - **GEMM 和注意力 → 交给库,但也别迷信"库永远更快"。** cuBLAS、CUTLASS、cuDNN、FlashAttention 系列仍是主力,不过同一份库代码在 H100 和 B200 上的表现能差出四分之一。 - **真正的长尾定制算子 → 才考虑手写。** 而且先用 Triton 或 Helion 试,别直接上 CUDA C++。  ## 五、Helion:200 行 CUDA 变成 15 行 既然提到了,多说两句。Helion 是 PyTorch 官方的 Python 嵌入式 DSL,定位比 Triton 再高一层抽象: ```python import torch, helion, helion.language as hl @helion.kernel() def matmul(x, y): m, k = x.size() k2, n = y.size() out = torch.empty([m, n], dtype=x.dtype, device=x.device) for tile_m, tile_n in hl.tile([m, n]): acc = hl.zeros([tile_m, tile_n], dtype=torch.float32) for tile_k in hl.tile(k): acc = torch.addmm(acc, x[tile_m, tile_k], y[tile_k, tile_n]) out[tile_m, tile_n] = acc return out ``` 同样的矩阵乘,CUDA C++ 要 200 多行,Triton 约 80 行,Helion 大概 15 行(来源:Red Hat Developer, *From 200 lines to 15: How Helion is rewriting the rules of GPU programming*, 2026-04)。索引、掩码、stride、grid 尺寸、内存布局全自动生成。 真正的杀器是**自动调优**:一个 Helion 内核,编译器会生成成百上千个 Triton 变体(不同块大小、循环顺序、PID 映射、warp 数、流水线深度、展开策略),再用 LFBO 这类搜索策略挑最快的,通常几分钟搜完。打个比方:同一道菜做几百遍,每遍改点火候、换个盘子,挑最好吃那版锁死。锁定之后运行时零调优成本,同一份代码拿到 Ampere、Hopper、Blackwell 上都能自动适配。 后端也不只 Triton:Pallas(TPU)、CuTe(CUTLASS Python DSL,要 CUDA 13+)、TileIR(Blackwell 专用)。上面那张表里 B200 的 GEMM 输了,官方正在做的 CuTe 后端就是来补这个洞的。 ## 六、四种模式怎么选,以及三个坑 | 模式 | 干什么 | 什么时候用 | | ---------------------------- | ---------------------------- | ------------------ | | `default` | 完整 Inductor 融合,不开 CUDA Graph | 先拿它试,调图断点时也用它 | | `reduce-overhead` | 融合 + CUDA Graph 捕获 | 形状固定的生产推理 | | `max-autotune` | 穷举搜索内核变体 + CUDA Graph | 延迟敏感、离线基准,能忍较长编译时间 | | `max-autotune-no-cudagraphs` | 穷举搜索但不要图 | 动态形状场景 | 三个坑: **坑一:`reduce-overhead` 首次调用要 30-90 秒。** 这是内核编译时间,省不掉,只能缓存。vLLM 就是这么做的——一个 60GB 模型的编译产物只有约 15MB(Triton 内核源 + .cubin),缓存下来新 Pod 直接复用。AWS EKS 文档的实测:同节点冷启动从约 53 秒降到 6 秒,整体新节点从 8-15 分钟降到约 5 分钟(来源:AWS EKS 机器学习推理文档,2026)。生产环境记得配 `TORCHINDUCTOR_CACHE_DIR`,指向持久卷。 **坑二:`dynamic=True` 会关掉 CUDA Graph。** 前面说过。形状稳定的用 `reduce-overhead` 拿图;变长序列用 `default` 或 `max-autotune-no-cudagraphs`,再配合**在 ±10-20% 范围内分桶/填充**把重编译次数压下去。 **坑三:短任务不划算。** 编译开销要摊到足够多的迭代里才有得赚。跑几十步的小实验,编译时间可能比省下的还多——这也是开头那段脚本为什么先跑 30 次预热再计时。 ## 七、我一般按这个顺序查 不一定适合所有人,供参考: 1. **先看利用率。** 已经 80%+ 就不用指望 compile,去查算法和并行。 2. **查图断点。** `explain()` 或 `TORCH_LOGS=graph_breaks`。目标是整个模型一张图;FSDP 通信处的断点是预期的,跳过。 3. **确认零重编译。** 跑几十步后应该不再重编。还在编,查是不是每步有东西在变。 4. **形状稳不稳。** 稳定就用 `reduce-overhead` 拿 CUDA Graph,不稳定就分桶 + `max-autotune-no-cudagraphs`。 5. **热点是不是 GEMM/注意力。** 是的话 compile 帮不上多少,去换库(更新的 FA 版本、FP8/FP4 量化)。 6. **还是不行就写内核。** 先用 Triton/Helion 试。 7. **缓存编译产物。** 生产环境不配这个,每次重启白等几分钟。 ## 参考资料 - PyTorch 官方博客:*Portable vLLM Model Inference Kernels in Helion*(2026,Qwen3 FP8 在 H100/B200 上的内核级与端到端实测) - Red Hat Developer:*From 200 lines to 15: How Helion is rewriting the rules of GPU programming*(2026-04) - PyTorch 官方文档:FSDP2 与 torch.compile 集成、CUDA Graph 与动态形状的互斥说明 - PyTorch 官方博客:*PyTorch 2.9: FlexAttention Optimization Practice on Intel GPUs*(2026) - AWS 文档:*Accelerate model loading on Amazon EKS*(2026,torch.compile 冷启动与编译产物缓存) - Fireworks AI 公开分析:GPU 算力与带宽增长剪刀差(GP100 21 TFLOPS / 730 GB/s → H100 989 TFLOPS / 3350 GB/s,半精度算力约 47×、带宽约 4.6×) - blog.prompt20.com:*Speeding Up PyTorch: CUDA Graphs, torch.compile, FlashAttn*(2026 年 CUDA Graph 生产实践资料) - jonathanding 调度与执行优化专栏:CUDA Graph 在 GPT-2 / LLaMA-7B / LLaMA-70B 上的加速比 - vLLM、SGLang、TensorRT-LLM 公开文档:CUDA Graph 在主流推理框架的 2026 集成现状 **延伸阅读**(本篇的数据不依赖这本书,想系统性补内核与编译器基础可以翻):Chris Fregly, *AI Systems Performance Engineering*, O'Reilly Media(第 12-14 章讲 CUDA Graph、TorchDynamo/AOT Autograd/Inductor/Triton 与图断点)。 > 说明:本文所有数字都来自公开可查来源或可自行复现的脚本,没有引用任何闭源案例。CUDA Graph 三组加速比(2.3×/1.7×/1.2×)引自 jonathanding 专栏 2026 年汇总,属特定配置下的测量值,无原始基准,只看量级;Helion 的 H100/B200 对比数字引自 PyTorch 官方博客,B200 上 GEMM 落后反映的是 Triton 在 Blackwell 上生成 GEMM 内核的当前水平,不是 Helion 编程模型本身的局限;"训练/推理 1.3-2×,轻量算子密集可达 3×"为业界经验区间而非官方基准,以你自己的实测为准。