首页 文章 精选 留言 我的

精选列表

搜索[笔记],共7227篇文章
优秀的个人博客,低调大师

Docker 学习笔记

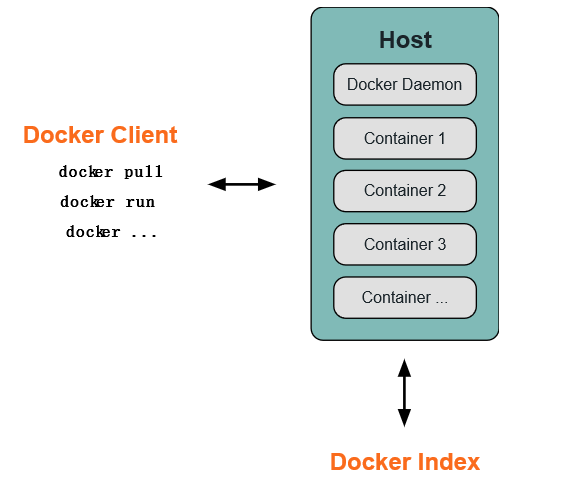
一、Docker 简介 Docker 两个主要部件: Docker: 开源的容器虚拟化平台 Docker Hub: 用于分享、管理 Docker 容器的 Docker SaaS 平台 -- Docker Hub Docker 使用客户端-服务器 (C/S) 架构模式。Docker 客户端会与 Docker 守护进程进行通信。Docker 守护进程会处理复杂繁重的任务,例如建立、运行、发布你的 Docker 容器。Docker 客户端和守护进程可以运行在同一个系统上,当然你也可以使用 Docker 客户端去连接一个远程的 Docker 守护进程。Docker 客户端和守护进程之间通过 socket 或者 RESTful API 进行通信。 1.1 Docker 守护进程 如上图所示,Docker 守护进程运行在一台主机上。用户并不直接和守护进程进行交互,而是通过 Docker 客户端间接和其通信。 1.2 Docker 客户端 Docker 客户端,实际上是 docker 的二进制程序,是主要的用户与 Docker 交互方式。它接收用户指令并且与背后的 Docker 守护进程通信,如此来回往复。 1.3 Docker 内部 要理解 Docker 内部构建,需要理解以下三种部件: Docker 镜像 - Docker images Docker 仓库 - Docker registeries Docker 容器 - Docker containers Docker 镜像 Docker 镜像是 Docker 容器运行时的只读模板,每一个镜像由一系列的层 (layers) 组成。Docker 使用 UnionFS 来将这些层联合到单独的镜像中。UnionFS 允许独立文件系统中的文件和文件夹(称之为分支)被透明覆盖,形成一个单独连贯的文件系统。正因为有了这些层的存在,Docker 是如此的轻量。当你改变了一个 Docker 镜像,比如升级到某个程序到新的版本,一个新的层会被创建。因此,不用替换整个原先的镜像或者重新建立(在使用虚拟机的时候你可能会这么做),只是一个新 的层被添加或升级了。现在你不用重新发布整个镜像,只需要升级,层使得分发 Docker 镜像变得简单和快速。 Docker 仓库 Docker 仓库用来保存镜像,可以理解为代码控制中的代码仓库。同样的,Docker 仓库也有公有和私有的概念。公有的 Docker 仓库名字是 Docker Hub。Docker Hub 提供了庞大的镜像集合供使用。这些镜像可以是自己创建,或者在别人的镜像基础上创建。Docker 仓库是 Docker 的分发部分。 Docker 容器 Docker 容器和文件夹很类似,一个Docker容器包含了所有的某个应用运行所需要的环境。每一个 Docker 容器都是从 Docker 镜像创建的。Docker 容器可以运行、开始、停止、移动和删除。每一个 Docker 容器都是独立和安全的应用平台,Docker 容器是 Docker 的运行部分。 1.4 libcontainer Docker 从 0.9 版本开始使用 libcontainer 替代 lxc,libcontainer 和 Linux 系统的交互图如下: 图片来源: Docker 0.9: introducing execution drivers and libcontainer 1.5 命名空间「Namespaces」 pid namespace 不同用户的进程就是通过 pid namespace 隔离开的,且不同 namespace 中可以有相同 PID。具有以下特征: 每个 namespace 中的 pid 是有自己的 pid=1 的进程(类似 /sbin/init 进程) 每个 namespace 中的进程只能影响自己的同一个 namespace 或子 namespace 中的进程 因为 /proc 包含正在运行的进程,因此在 container 中的 pseudo-filesystem 的 /proc 目录只能看到自己 namespace 中的进程 因为 namespace 允许嵌套,父 namespace 可以影响子 namespace 的进程,所以子 namespace 的进程可以在父 namespace 中看到,但是具有不同的 pid 参考文档:Introduction to Linux namespaces – Part 3: PID mnt namespace 类似 chroot,将一个进程放到一个特定的目录执行。mnt namespace 允许不同 namespace 的进程看到的文件结构不同,这样每个 namespace 中的进程所看到的文件目录就被隔离开了。同 chroot 不同,每个 namespace 中的 container 在 /proc/mounts 的信息只包含所在 namespace 的 mount point。 net namespace 网络隔离是通过 net namespace 实现的, 每个 net namespace 有独立的 network devices, IP addresses, IP routing tables, /proc/net 目录。这样每个 container 的网络就能隔离开来。 docker 默认采用 veth 的方式将 container 中的虚拟网卡同 host 上的一个 docker bridge 连接在一起。 参考文档:Introduction to Linux namespaces – Part 5: NET uts namespace UTS ("UNIX Time-sharing System") namespace 允许每个 container 拥有独立的 hostname 和 domain name, 使其在网络上可以被视作一个独立的节点而非 Host 上的一个进程。 参考文档:Introduction to Linux namespaces – Part 1: UTS ipc namespace container 中进程交互还是采用 Linux 常见的进程间交互方法 (interprocess communication - IPC), 包括常见的信号量、消息队列和共享内存。然而同 VM 不同,container 的进程间交互实际上还是 host 上具有相同 pid namespace 中的进程间交互,因此需要在IPC资源申请时加入 namespace 信息 - 每个 IPC 资源有一个唯一的 32bit ID。 参考文档:Introduction to Linux namespaces – Part 2: IPC user namespace 每个 container 可以有不同的 user 和 group id, 也就是说可以以 container 内部的用户在 container 内部执行程序而非 Host 上的用户。 有了以上 6 种 namespace 从进程、网络、IPC、文件系统、UTS 和用户角度的隔离,一个 container 就可以对外展现出一个独立计算机的能力,并且不同 container 从 OS 层面实现了隔离。 然而不同 namespace 之间资源还是相互竞争的,仍然需要类似 ulimit 来管理每个 container 所能使用的资源 - cgroup。 Reference Docker Getting Start: Related Knowledge Docker 介绍以及其相关术语、底层原理和技术 1.6 资源配额「cgroups」 cgroups 实现了对资源的配额和度量。 cgroups 的使用非常简单,提供类似文件的接口,在 /cgroup 目录下新建一个文件夹即可新建一个 group,在此文件夹中新建 task 文件,并将 pid 写入该文件,即可实现对该进程的资源控制。具体的资源配置选项可以在该文件夹中新建子 subsystem ,{子系统前缀}.{资源项} 是典型的配置方法, 如 memory.usageinbytes 就定义了该 group 在 subsystem memory 中的一个内存限制选项。 另外,cgroups 中的 subsystem 可以随意组合,一个 subsystem 可以在不同的 group 中,也可以一个 group 包含多个 subsystem - 也就是说一个 subsystem。 memory 内存相关的限制 cpu 在 cgroup 中,并不能像硬件虚拟化方案一样能够定义 CPU 能力,但是能够定义 CPU 轮转的优先级,因此具有较高 CPU 优先级的进程会更可能得到 CPU 运算。 通过将参数写入 cpu.shares ,即可定义改 cgroup 的 CPU 优先级 - 这里是一个相对权重,而非绝对值 blkio block IO 相关的统计和限制,byte/operation 统计和限制 (IOPS 等),读写速度限制等,但是这里主要统计的都是同步 IO devices 设备权限限制 参考文档:how to use cgroup 二、Docker 安装 docker 的相关安装方法这里不作介绍,具体安装参考 官档 获取当前 docker 版本 $ sudo docker version Client version: 1.3.2 Client API version: 1.15 Go version (client): go1.3.3 Git commit (client): 39fa2fa/1.3.2 OS/Arch (client): linux/amd64 Server version: 1.3.2 Server API version: 1.15 Go version (server): go1.3.3 Git commit (server): 39fa2fa/1.3.2 三、Docker 基础用法 Docker HUB : Docker镜像首页,包括官方镜像和其它公开镜像 因为国情的原因,国内下载 Docker HUB 官方的相关镜像比较慢,可以使用 docker.cn 镜像,镜像保持和官方一致,关键是速度块,推荐使用。 3.1 Search images $ sudo docker search ubuntu 3.2 Pull images $ sudo docker pull ubuntu # 获取 ubuntu 官方镜像 $ sudo docker images # 查看当前镜像列表 3.3 Running an interactive shell $ sudo docker run -i -t ubuntu:14.04 /bin/bash docker run - 运行一个容器 -t - 分配一个(伪)tty (link is external) -i - 交互模式 (so we can interact with it) ubuntu:14.04 - 使用 ubuntu 基础镜像 14.04 /bin/bash - 运行命令 bash shell 注: ubuntu 会有多个版本,通过指定 tag 来启动特定的版本 [image]:[tag] $ sudo docker ps # 查看当前运行的容器, ps -a 列出当前系统所有的容器 CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 6c9129e9df10 ubuntu:14.04 /bin/bash 6 minutes ago Up 6 minutes cranky_babbage 3.4 相关快捷键 退出:Ctrl-Dorexit detach:Ctrl-P + Ctrl-Q attach:docker attach CONTAINER-ID 四、Docker 命令帮助 4.1 docker help docker command $ sudo docker # docker 命令帮助 Commands: attach Attach to a running container # 当前 shell 下 attach 连接指定运行镜像 build Build an image from a Dockerfile # 通过 Dockerfile 定制镜像 commit Create a new image from a container's changes # 提交当前容器为新的镜像 cp Copy files/folders from the containers filesystem to the host path # 从容器中拷贝指定文件或者目录到宿主机中 create Create a new container # 创建一个新的容器,同 run,但不启动容器 diff Inspect changes on a container's filesystem # 查看 docker 容器变化 events Get real time events from the server # 从 docker 服务获取容器实时事件 exec Run a command in an existing container # 在已存在的容器上运行命令 export Stream the contents of a container as a tar archive # 导出容器的内容流作为一个 tar 归档文件[对应 import ] history Show the history of an image # 展示一个镜像形成历史 images List images # 列出系统当前镜像 import Create a new filesystem image from the contents of a tarball # 从tar包中的内容创建一个新的文件系统映像[对应 export] info Display system-wide information # 显示系统相关信息 inspect Return low-level information on a container # 查看容器详细信息 kill Kill a running container # kill 指定 docker 容器 load Load an image from a tar archive # 从一个 tar 包中加载一个镜像[对应 save] login Register or Login to the docker registry server # 注册或者登陆一个 docker 源服务器 logout Log out from a Docker registry server # 从当前 Docker registry 退出 logs Fetch the logs of a container # 输出当前容器日志信息 port Lookup the public-facing port which is NAT-ed to PRIVATE_PORT # 查看映射端口对应的容器内部源端口 pause Pause all processes within a container # 暂停容器 ps List containers # 列出容器列表 pull Pull an image or a repository from the docker registry server # 从docker镜像源服务器拉取指定镜像或者库镜像 push Push an image or a repository to the docker registry server # 推送指定镜像或者库镜像至docker源服务器 restart Restart a running container # 重启运行的容器 rm Remove one or more containers # 移除一个或者多个容器 rmi Remove one or more images # 移除一个或多个镜像[无容器使用该镜像才可删除,否则需删除相关容器才可继续或 -f 强制删除] run Run a command in a new container # 创建一个新的容器并运行一个命令 save Save an image to a tar archive # 保存一个镜像为一个 tar 包[对应 load] search Search for an image on the Docker Hub # 在 docker hub 中搜索镜像 start Start a stopped containers # 启动容器 stop Stop a running containers # 停止容器 tag Tag an image into a repository # 给源中镜像打标签 top Lookup the running processes of a container # 查看容器中运行的进程信息 unpause Unpause a paused container # 取消暂停容器 version Show the docker version information # 查看 docker 版本号 wait Block until a container stops, then print its exit code # 截取容器停止时的退出状态值 Run 'docker COMMAND --help' for more information on a command. docker option Usage of docker: --api-enable-cors=false Enable CORS headers in the remote API # 远程 API 中开启 CORS 头 -b, --bridge="" Attach containers to a pre-existing network bridge # 桥接网络 use 'none' to disable container networking --bip="" Use this CIDR notation address for the network bridge's IP, not compatible with -b # 和 -b 选项不兼容,具体没有测试过 -d, --daemon=false Enable daemon mode # daemon 模式 -D, --debug=false Enable debug mode # debug 模式 --dns=[] Force docker to use specific DNS servers # 强制 docker 使用指定 dns 服务器 --dns-search=[] Force Docker to use specific DNS search domains # 强制 docker 使用指定 dns 搜索域 -e, --exec-driver="native" Force the docker runtime to use a specific exec driver # 强制 docker 运行时使用指定执行驱动器 --fixed-cidr="" IPv4 subnet for fixed IPs (ex: 10.20.0.0/16) this subnet must be nested in the bridge subnet (which is defined by -b or --bip) -G, --group="docker" Group to assign the unix socket specified by -H when running in daemon mode use '' (the empty string) to disable setting of a group -g, --graph="/var/lib/docker" Path to use as the root of the docker runtime # 容器运行的根目录路径 -H, --host=[] The socket(s) to bind to in daemon mode # daemon 模式下 docker 指定绑定方式[tcp or 本地 socket] specified using one or more tcp://host:port, unix:///path/to/socket, fd://* or fd://socketfd. --icc=true Enable inter-container communication # 跨容器通信 --insecure-registry=[] Enable insecure communication with specified registries (no certificate verification for HTTPS and enable HTTP fallback) (e.g., localhost:5000 or 10.20.0.0/16) --ip="0.0.0.0" Default IP address to use when binding container ports # 指定监听地址,默认所有 ip --ip-forward=true Enable net.ipv4.ip_forward # 开启转发 --ip-masq=true Enable IP masquerading for bridge's IP range --iptables=true Enable Docker's addition of iptables rules # 添加对应 iptables 规则 --mtu=0 Set the containers network MTU # 设置网络 mtu if no value is provided: default to the default route MTU or 1500 if no default route is available -p, --pidfile="/var/run/docker.pid" Path to use for daemon PID file # 指定 pid 文件位置 --registry-mirror=[] Specify a preferred Docker registry mirror -s, --storage-driver="" Force the docker runtime to use a specific storage driver # 强制 docker 运行时使用指定存储驱动 --selinux-enabled=false Enable selinux support # 开启 selinux 支持 --storage-opt=[] Set storage driver options # 设置存储驱动选项 --tls=false Use TLS; implied by tls-verify flags # 开启 tls --tlscacert="/root/.docker/ca.pem" Trust only remotes providing a certificate signed by the CA given here --tlscert="/root/.docker/cert.pem" Path to TLS certificate file # tls 证书文件位置 --tlskey="/root/.docker/key.pem" Path to TLS key file # tls key 文件位置 --tlsverify=false Use TLS and verify the remote (daemon: verify client, client: verify daemon) # 使用 tls 并确认远程控制主机 -v, --version=false Print version information and quit # 输出 docker 版本信息 4.2 docker search $ sudo docker search --help Usage: docker search TERM Search the Docker Hub for images # 从 Docker Hub 搜索镜像 --automated=false Only show automated builds --no-trunc=false Don't truncate output -s, --stars=0 Only displays with at least xxx stars 示例: $ sudo docker search -s 100 ubuntu # 查找 star 数至少为 100 的镜像,找出只有官方镜像 start 数超过 100,默认不加 s 选项找出所有相关 ubuntu 镜像 NAME DESCRIPTION STARS OFFICIAL AUTOMATED ubuntu Official Ubuntu base image 425 [OK] 4.3 docker info $ sudo docker info Containers: 1 # 容器个数 Images: 22 # 镜像个数 Storage Driver: devicemapper # 存储驱动 Pool Name: docker-8:17-3221225728-pool Pool Blocksize: 65.54 kB Data file: /data/docker/devicemapper/devicemapper/data Metadata file: /data/docker/devicemapper/devicemapper/metadata Data Space Used: 1.83 GB Data Space Total: 107.4 GB Metadata Space Used: 2.191 MB Metadata Space Total: 2.147 GB Library Version: 1.02.84-RHEL7 (2014-03-26) Execution Driver: native-0.2 # 存储驱动 Kernel Version: 3.10.0-123.el7.x86_64 Operating System: CentOS Linux 7 (Core) 4.4 docker pull && docker push $ sudo docker pull --help # pull 拉取镜像 Usage: docker pull [OPTIONS] NAME[:TAG] Pull an image or a repository from the registry -a, --all-tags=false Download all tagged images in the repository $ sudo docker push # push 推送指定镜像 Usage: docker push NAME[:TAG] Push an image or a repository to the registry 示例: $ sudo docker pull ubuntu # 下载官方 ubuntu docker 镜像,默认下载所有 ubuntu 官方库镜像 $ sudo docker pull ubuntu:14.04 # 下载指定版本 ubuntu 官方镜像 $ sudo docker push 192.168.0.100:5000/ubuntu # 推送镜像库到私有源[可注册 docker 官方账户,推送到官方自有账户] $ sudo docker push 192.168.0.100:5000/ubuntu:14.04 # 推送指定镜像到私有源 4.5 docker images 列出当前系统镜像 $ sudo docker images --help Usage: docker images [OPTIONS] [NAME] List images -a, --all=false Show all images (by default filter out the intermediate image layers) # -a 显示当前系统的所有镜像,包括过渡层镜像,默认 docker images 显示最终镜像,不包括过渡层镜像 -f, --filter=[] Provide filter values (i.e. 'dangling=true') --no-trunc=false Don't truncate output -q, --quiet=false Only show numeric IDs 示例: $ sudo docker images # 显示当前系统镜像,不包括过渡层镜像 $ sudo docker images -a # 显示当前系统所有镜像,包括过渡层镜像 $ sudo docker images ubuntu # 显示当前系统 docker ubuntu 库中的所有镜像 REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE ubuntu 12.04 ebe4be4dd427 4 weeks ago 210.6 MB ubuntu 14.04 e54ca5efa2e9 4 weeks ago 276.5 MB ubuntu 14.04-ssh 6334d3ac099a 7 weeks ago 383.2 MB 4.6 docker rmi 删除一个或者多个镜像 $ sudo docker rmi --help Usage: docker rmi IMAGE [IMAGE...] Remove one or more images -f, --force=false Force removal of the image # 强制移除镜像不管是否有容器使用该镜像 --no-prune=false Do not delete untagged parents # 不要删除未标记的父镜像 4.7 docker run $ sudo docker run --help Usage: docker run [OPTIONS] IMAGE [COMMAND] [ARG...] Run a command in a new container -a, --attach=[] Attach to stdin, stdout or stderr. -c, --cpu-shares=0 CPU shares (relative weight) # 设置 cpu 使用权重 --cap-add=[] Add Linux capabilities --cap-drop=[] Drop Linux capabilities --cidfile="" Write the container ID to the file # 把容器 id 写入到指定文件 --cpuset="" CPUs in which to allow execution (0-3, 0,1) # cpu 绑定 -d, --detach=false Detached mode: Run container in the background, print new container id # 后台运行容器 --device=[] Add a host device to the container (e.g. --device=/dev/sdc:/dev/xvdc) --dns=[] Set custom dns servers # 设置 dns --dns-search=[] Set custom dns search domains # 设置 dns 域搜索 -e, --env=[] Set environment variables # 定义环境变量 --entrypoint="" Overwrite the default entrypoint of the image # ? --env-file=[] Read in a line delimited file of ENV variables # 从指定文件读取变量值 --expose=[] Expose a port from the container without publishing it to your host # 指定对外提供服务端口 -h, --hostname="" Container host name # 设置容器主机名 -i, --interactive=false Keep stdin open even if not attached # 保持标准输出开启即使没有 attached --link=[] Add link to another container (name:alias) # 添加链接到另外一个容器 --lxc-conf=[] (lxc exec-driver only) Add custom lxc options --lxc-conf="lxc.cgroup.cpuset.cpus = 0,1" -m, --memory="" Memory limit (format: <number><optional unit>, where unit = b, k, m or g) # 内存限制 --name="" Assign a name to the container # 设置容器名 --net="bridge" Set the Network mode for the container # 设置容器网络模式 'bridge': creates a new network stack for the container on the docker bridge 'none': no networking for this container 'container:<name|id>': reuses another container network stack 'host': use the host network stack inside the container. Note: the host mode gives the container full access to local system services such as D-bus and is therefore considered insecure. -P, --publish-all=false Publish all exposed ports to the host interfaces # 自动映射容器对外提供服务的端口 -p, --publish=[] Publish a container's port to the host # 指定端口映射 format: ip:hostPort:containerPort | ip::containerPort | hostPort:containerPort (use 'docker port' to see the actual mapping) --privileged=false Give extended privileges to this container # 提供更多的权限给容器 --restart="" Restart policy to apply when a container exits (no, on-failure[:max-retry], always) --rm=false Automatically remove the container when it exits (incompatible with -d) # 如果容器退出自动移除和 -d 选项冲突 --security-opt=[] Security Options --sig-proxy=true Proxify received signals to the process (even in non-tty mode). SIGCHLD is not proxied. -t, --tty=false Allocate a pseudo-tty # 分配伪终端 -u, --user="" Username or UID # 指定运行容器的用户 uid 或者用户名 -v, --volume=[] Bind mount a volume (e.g., from the host: -v /host:/container, from docker: -v /container) # 挂载卷 --volumes-from=[] Mount volumes from the specified container(s) # 从指定容器挂载卷 -w, --workdir="" Working directory inside the container # 指定容器工作目录 示例: $ sudo docker images ubuntu REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE ubuntu 14.04 e54ca5efa2e9 4 weeks ago 276.5 MB ... ... $ sudo docker run -t -i -c 100 -m 512MB -h test1 -d --name="docker_test1" ubuntu /bin/bash # 创建一个 cpu 优先级为 100,内存限制 512MB,主机名为 test1,名为 docker_test1 后台运行 bash 的容器 a424ca613c9f2247cd3ede95adfbaf8d28400cbcb1d5f9b69a7b56f97b2b52e5 $ sudo docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES a424ca613c9f ubuntu:14.04 /bin/bash 6 seconds ago Up 5 seconds docker_test1 $ sudo docker attach docker_test1 root@test1:/# pwd / root@test1:/# exit exit 关于cpu优先级: By default all groups have 1024 shares. A group with 100 shares will get a ~10% portion of the CPU time - archlinux cgroups 4.8 docker start|stop|kill... ... dockerstart|stop|kill|restart|pause|unpause|rm|commit|inspect|logs docker start CONTAINER [CONTAINER...] # 运行一个或多个停止的容器 docker stop CONTAINER [CONTAINER...] # 停掉一个或多个运行的容器-t选项可指定超时时间 docker kill [OPTIONS] CONTAINER [CONTAINER...] # 默认 kill 发送 SIGKILL 信号-s可以指定发送 kill 信号类型 docker restart [OPTIONS] CONTAINER [CONTAINER...] # 重启一个或多个运行的容器-t选项可指定超时时间 docker pause CONTAINER # 暂停一个容器,方便 commit docker unpause CONTAINER # 继续暂停的容器 docker rm [OPTIONS] CONTAINER [CONTAINER...] # 移除一个或多个容器 -f, --force=false Force removal of running container -l, --link=false Remove the specified link and not the underlying container -v, --volumes=false Remove the volumes associated with the container docker commit [OPTIONS] CONTAINER [REPOSITORY[:TAG]] # 提交指定容器为镜像 -a, --author="" Author (e.g., "John Hannibal Smith hannibal@a-team.com") -m, --message="" Commit message -p, --pause=true Pause container during commit # 默认 commit 是暂停状态 docker inspect CONTAINER|IMAGE [CONTAINER|IMAGE...] # 查看容器或者镜像的详细信息 docker logs CONTAINER # 输出指定容器日志信息 -f, --follow=false Follow log output # 类似 tail -f -t, --timestamps=false Show timestamps --tail="all" Output the specified number of lines at the end of logs (defaults to all logs) 参考文档:Docker Run Reference 4.9 Docker 1.3 新增特性和命令 Digital Signature Verification Docker 1.3 版本将使用数字签名自动验证所有官方库的来源和完整性,如果一个官方镜像被篡改或者被破坏,目前 Docker 只会对这种情况发出警告而并不阻止容器的运行。 Inject new processes withdocker exec docker exec --help Usage: docker exec [OPTIONS] CONTAINER COMMAND [ARG...] Run a command in an existing container -d, --detach=false Detached mode: run command in the background -i, --interactive=false Keep STDIN open even if not attached -t, --tty=false Allocate a pseudo-TTY 为了简化调试,可以使用docker exec命令通过 Docker API 和 CLI 在运行的容器上运行程序。 $ docker exec -it ubuntu_bash bash 上例将在容器 ubuntu_bash 中创建一个新的 Bash 会话。 Tune container lifecycles withdocker create 我们可以通过docker run <image name>命令创建一个容器并运行其中的程序,因为有很多用户要求创建容器的时候不启动容器,所以docker create应运而生了。 $ docker create -t -i fedora bash 6d8af538ec541dd581ebc2a24153a28329acb5268abe5ef868c1f1a261221752 上例创建了一个可写的容器层 (并且打印出容器 ID),但是并不运行它,可以使用以下命令运行该容器: $ docker start -a -i 6d8af538ec5 bash-4.2# Security Options 通过--security-opt选项,运行容器时用户可自定义 SELinux 和 AppArmor 卷标和配置。 $ docker run --security-opt label:type:svirt_apache -i -t centos \ bash 上例只允许容器监听在 Apache 端口,这个选项的好处是用户不需要运行 docker 的时候指定--privileged选项,降低安全风险。 参考文档:Docker 1.3: signed images, process injection, security options, Mac shared directories 4.10 Docker 1.5 新特性 参考文档:Docker 1.5 新特性 五、Docker 端口映射 # Find IP address of container with ID <container_id> 通过容器 id 获取 ip $ sudo docker inspect <container_id> | grep IPAddress | cut -d ’"’ -f 4 无论如何,这些 ip 是基于本地系统的并且容器的端口非本地主机是访问不到的。此外,除了端口只能本地访问外,对于容器的另外一个问题是这些 ip 在容器每次启动的时候都会改变。 Docker 解决了容器的这两个问题,并且给容器内部服务的访问提供了一个简单而可靠的方法。Docker 通过端口绑定主机系统的接口,允许非本地客户端访问容器内部运行的服务。为了简便的使得容器间通信,Docker 提供了这种连接机制。 5.1 自动映射端口 -P使用时需要指定--expose选项,指定需要对外提供服务的端口 $ sudo docker run -t -P --expose 22 --name server ubuntu:14.04 使用docker run -P自动绑定所有对外提供服务的容器端口,映射的端口将会从没有使用的端口池中 (49000..49900) 自动选择,你可以通过docker ps、docker inspect <container_id>或者docker port <container_id> <port>确定具体的绑定信息。 5.2 绑定端口到指定接口 基本语法 $ sudo docker run -p [([<host_interface>:[host_port]])|(<host_port>):]<container_port>[/udp] <image> <cmd> 默认不指定绑定 ip 则监听所有网络接口。 绑定 TCP 端口 # Bind TCP port 8080 of the container to TCP port 80 on 127.0.0.1 of the host machine. $ sudo docker run -p 127.0.0.1:80:8080 <image> <cmd> # Bind TCP port 8080 of the container to a dynamically allocated TCP port on 127.0.0.1 of the host machine. $ sudo docker run -p 127.0.0.1::8080 <image> <cmd> # Bind TCP port 8080 of the container to TCP port 80 on all available interfaces of the host machine. $ sudo docker run -p 80:8080 <image> <cmd> # Bind TCP port 8080 of the container to a dynamically allocated TCP port on all available interfaces $ sudo docker run -p 8080 <image> <cmd> 绑定 UDP 端口 # Bind UDP port 5353 of the container to UDP port 53 on 127.0.0.1 of the host machine. $ sudo docker run -p 127.0.0.1:53:5353/udp <image> <cmd> 六、Docker 网络配置 图: Docker - container and lightweight virtualization Dokcer 通过使用 Linux 桥接提供容器之间的通信,docker0 桥接接口的目的就是方便 Docker 管理。当 Docker daemon 启动时需要做以下操作: creates the docker0 bridge if not present # 如果 docker0 不存在则创建 searches for an IP address range which doesn’t overlap with an existing route # 搜索一个与当前路由不冲突的 ip 段 picks an IP in the selected range # 在确定的范围中选择 ip assigns this IP to the docker0 bridge # 绑定 ip 到 docker0 6.1 Docker 四种网络模式 四种网络模式摘自 Docker 网络详解及 pipework 源码解读与实践 docker run 创建 Docker 容器时,可以用 --net 选项指定容器的网络模式,Docker 有以下 4 种网络模式: host 模式,使用 --net=host 指定。 container 模式,使用 --net=container:NAMEorID 指定。 none 模式,使用 --net=none 指定。 bridge 模式,使用 --net=bridge 指定,默认设置。 host 模式 如果启动容器的时候使用 host 模式,那么这个容器将不会获得一个独立的 Network Namespace,而是和宿主机共用一个 Network Namespace。容器将不会虚拟出自己的网卡,配置自己的 IP 等,而是使用宿主机的 IP 和端口。 例如,我们在 10.10.101.105/24 的机器上用 host 模式启动一个含有 web 应用的 Docker 容器,监听 tcp 80 端口。当我们在容器中执行任何类似 ifconfig 命令查看网络环境时,看到的都是宿主机上的信息。而外界访问容器中的应用,则直接使用 10.10.101.105:80 即可,不用任何 NAT 转换,就如直接跑在宿主机中一样。但是,容器的其他方面,如文件系统、进程列表等还是和宿主机隔离的。 container 模式 这个模式指定新创建的容器和已经存在的一个容器共享一个 Network Namespace,而不是和宿主机共享。新创建的容器不会创建自己的网卡,配置自己的 IP,而是和一个指定的容器共享 IP、端口范围等。同样,两个容器除了网络方面,其他的如文件系统、进程列表等还是隔离的。两个容器的进程可以通过 lo 网卡设备通信。 none模式 这个模式和前两个不同。在这种模式下,Docker 容器拥有自己的 Network Namespace,但是,并不为 Docker容器进行任何网络配置。也就是说,这个 Docker 容器没有网卡、IP、路由等信息。需要我们自己为 Docker 容器添加网卡、配置 IP 等。 bridge模式 图:The Container World | Part 2 Networking bridge 模式是 Docker 默认的网络设置,此模式会为每一个容器分配 Network Namespace、设置 IP 等,并将一个主机上的 Docker 容器连接到一个虚拟网桥上。当 Docker server 启动时,会在主机上创建一个名为 docker0 的虚拟网桥,此主机上启动的 Docker 容器会连接到这个虚拟网桥上。虚拟网桥的工作方式和物理交换机类似,这样主机上的所有容器就通过交换机连在了一个二层网络中。接下来就要为容器分配 IP 了,Docker 会从 RFC1918 所定义的私有 IP 网段中,选择一个和宿主机不同的IP地址和子网分配给 docker0,连接到 docker0 的容器就从这个子网中选择一个未占用的 IP 使用。如一般 Docker 会使用 172.17.0.0/16 这个网段,并将 172.17.42.1/16 分配给 docker0 网桥(在主机上使用 ifconfig 命令是可以看到 docker0 的,可以认为它是网桥的管理接口,在宿主机上作为一块虚拟网卡使用) 6.2 列出当前主机网桥 $ sudo brctl show # brctl 工具依赖 bridge-utils 软件包 bridge name bridge id STP enabled interfaces docker0 8000.000000000000 no 6.3 查看当前 docker0 ip $ sudo ifconfig docker0 docker0 Link encap:Ethernet HWaddr xx:xx:xx:xx:xx:xx inet addr:172.17.42.1 Bcast:0.0.0.0 Mask:255.255.0.0 在容器运行时,每个容器都会分配一个特定的虚拟机口并桥接到 docker0。每个容器都会配置同 docker0 ip 相同网段的专用 ip 地址,docker0 的 IP 地址被用于所有容器的默认网关。 6.4 运行一个容器 $ sudo docker run -t -i -d ubuntu /bin/bash 52f811c5d3d69edddefc75aff5a4525fc8ba8bcfa1818132f9dc7d4f7c7e78b4 $ sudo brctl show bridge name bridge id STP enabled interfaces docker0 8000.fef213db5a66 no vethQCDY1N 以上, docker0 扮演着 52f811c5d3d6 container 这个容器的虚拟接口 vethQCDY1N interface 桥接的角色。 使用特定范围的 IP Docker 会尝试寻找没有被主机使用的 ip 段,尽管它适用于大多数情况下,但是它不是万能的,有时候我们还是需要对 ip 进一步规划。Docker 允许你管理 docker0 桥接或者通过-b选项自定义桥接网卡,需要安装bridge-utils软件包。 基本步骤如下: ensure Docker is stopped # 确保 docker 的进程是停止的 create your own bridge (bridge0 for example) # 创建自定义网桥 assign a specific IP to this bridge # 给网桥分配特定的 ip start Docker with the -b=bridge0 parameter # 以 -b 的方式指定网桥 # Stopping Docker and removing docker0 $ sudo service docker stop $ sudo ip link set dev docker0 down $ sudo brctl delbr docker0 # Create our own bridge $ sudo brctl addbr bridge0 $ sudo ip addr add 192.168.5.1/24 dev bridge0 $ sudo ip link set dev bridge0 up # Confirming that our bridge is up and running $ ip addr show bridge0 4: bridge0: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state UP group default link/ether 66:38:d0:0d:76:18 brd ff:ff:ff:ff:ff:ff inet 192.168.5.1/24 scope global bridge0 valid_lft forever preferred_lft forever # Tell Docker about it and restart (on Ubuntu) $ echo 'DOCKER_OPTS="-b=bridge0"' >> /etc/default/docker $ sudo service docker start 参考文档: Network Configuration 6.5 不同主机间容器通信 不同容器之间的通信可以借助于 pipework 这个工具: $ git clone https://github.com/jpetazzo/pipework.git $ sudo cp -rp pipework/pipework /usr/local/bin/ 安装相应依赖软件 $ sudo apt-get install iputils-arping bridge-utils -y 桥接网络 桥接网络可以参考 日常问题处理 Tips 关于桥接的配置说明,这里不再赘述。 # brctl show bridge name bridge id STP enabled interfaces br0 8000.000c291412cd no eth0 docker0 8000.56847afe9799 no vetheb48029 可以删除 docker0,直接把 docker 的桥接指定为 br0。也可以保留使用默认的配置,这样单主机容器之间的通信可以通过 docker0,而跨主机不同容器之间通过 pipework 新建 docker 容器的网卡桥接到 br0,这样跨主机容器之间就可以通信了。 ubuntu $ sudo service docker stop $ sudo ip link set dev docker0 down $ sudo brctl delbr docker0 $ echo 'DOCKER_OPTS="-b=br0"' >> /etc/default/docker $ sudo service docker start CentOS 7/RHEL 7 $ sudo systemctl stop docker $ sudo ip link set dev docker0 down $ sudo brctl delbr docker0 $ cat /etc/sysconfig/docker | grep 'OPTIONS=' OPTIONS=--selinux-enabled -b=br0 -H fd:// $ sudo systemctl start docker pipework 不同容器之间的通信可以借助于 pipework 这个工具给 docker 容器新建虚拟网卡并绑定 IP 桥接到 br0 $ git clone https://github.com/jpetazzo/pipework.git $ sudo cp -rp pipework/pipework /usr/local/bin/ $ pipework Syntax: pipework <hostinterface> [-i containerinterface] <guest> <ipaddr>/<subnet>[@default_gateway] [macaddr][@vlan] pipework <hostinterface> [-i containerinterface] <guest> dhcp [macaddr][@vlan] pipework --wait [-i containerinterface] 如果删除了默认的 docker0 桥接,把 docker 默认桥接指定到了 br0,则最好在创建容器的时候加上--net=none,防止自动分配的 IP 在局域网中有冲突。 $ sudo docker run --rm -ti --net=none ubuntu:14.04 /bin/bash root@a46657528059:/# $ # Ctrl-P + Ctrl-Q 回到宿主机 shell,容器 detach 状态 $ sudo docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES a46657528059 ubuntu:14.04 "/bin/bash" 4 minutes ago Up 4 minutes hungry_lalande $ sudo pipework br0 -i eth0 a46657528059 192.168.115.10/24@192.168.115.2 # 默认不指定网卡设备名,则默认添加为 eth1 # 另外 pipework 不能添加静态路由,如果有需求则可以在 run 的时候加上 --privileged=true 权限在容器中手动添加, # 但这种安全性有缺陷,可以通过 ip netns 操作 $ sudo docker attach a46657528059 root@a46657528059:/# ifconfig eth0 eth0 Link encap:Ethernet HWaddr 86:b6:6b:e8:2e:4d inet addr:192.168.115.10 Bcast:0.0.0.0 Mask:255.255.255.0 inet6 addr: fe80::84b6:6bff:fee8:2e4d/64 Scope:Link UP BROADCAST RUNNING MULTICAST MTU:1500 Metric:1 RX packets:8 errors:0 dropped:0 overruns:0 frame:0 TX packets:9 errors:0 dropped:0 overruns:0 carrier:0 collisions:0 txqueuelen:1000 RX bytes:648 (648.0 B) TX bytes:690 (690.0 B) root@a46657528059:/# route -n Kernel IP routing table Destination Gateway Genmask Flags Metric Ref Use Iface 0.0.0.0 192.168.115.2 0.0.0.0 UG 0 0 0 eth0 192.168.115.0 0.0.0.0 255.255.255.0 U 0 0 0 eth0 使用ip netns添加静态路由,避免创建容器使用--privileged=true选项造成一些不必要的安全问题: $ docker inspect --format="` `.`State`.`Pid `" a46657528059 # 获取指定容器 pid 6350 $ sudo ln -s /proc/6350/ns/net /var/run/netns/6350 $ sudo ip netns exec 6350 ip route add 192.168.0.0/16 dev eth0 via 192.168.115.2 $ sudo ip netns exec 6350 ip route # 添加成功 192.168.0.0/16 via 192.168.115.2 dev eth0 ... ... 在其它宿主机进行相应的配置,新建容器并使用 pipework 添加虚拟网卡桥接到 br0,测试通信情况即可。 另外,pipework 可以创建容器的 vlan 网络,这里不作过多的介绍了,官方文档已经写的很清楚了,可以查看以下两篇文章: Pipework 官方文档 Docker 网络详解及 pipework 源码解读与实践 七、Dockerfile Docker 可以通过 Dockerfile 的内容来自动构建镜像。Dockerfile 是一个包含创建镜像所有命令的文本文件,通过docker build命令可以根据 Dockerfile 的内容构建镜像,在介绍如何构建之前先介绍下 Dockerfile 的基本语法结构。 Dockerfile 有以下指令选项: FROM MAINTAINER RUN CMD EXPOSE ENV ADD COPY ENTRYPOINT VOLUME USER WORKDIR ONBUILD 7.1 FROM 用法: FROM <image> 或者 FROM <image> FROM指定构建镜像的基础源镜像,如果本地没有指定的镜像,则会自动从 Docker 的公共库 pull 镜像下来。 FROM必须是 Dockerfile 中非注释行的第一个指令,即一个 Dockerfile 从FROM语句开始。 FROM可以在一个 Dockerfile 中出现多次,如果有需求在一个 Dockerfile 中创建多个镜像。 如果FROM语句没有指定镜像标签,则默认使用latest标签。 7.2 MAINTAINER 用法: MAINTAINER <name> 指定创建镜像的用户 RUN 有两种使用方式 RUN RUN "executable", "param1", "param2" 每条RUN指令将在当前镜像基础上执行指定命令,并提交为新的镜像,后续的RUN都在之前RUN提交后的镜像为基础,镜像是分层的,可以通过一个镜像的任何一个历史提交点来创建,类似源码的版本控制。 exec 方式会被解析为一个 JSON 数组,所以必须使用双引号而不是单引号。exec 方式不会调用一个命令 shell,所以也就不会继承相应的变量,如: RUN [ "echo", "$HOME" ] 这种方式是不会达到输出 HOME 变量的,正确的方式应该是这样的 RUN [ "sh", "-c", "echo", "$HOME" ] RUN产生的缓存在下一次构建的时候是不会失效的,会被重用,可以使用--no-cache选项,即docker build --no-cache,如此便不会缓存。 7.3 CMD CMD有三种使用方式: CMD "executable","param1","param2" CMD "param1","param2" CMD command param1 param2 (shell form) CMD指定在 Dockerfile 中只能使用一次,如果有多个,则只有最后一个会生效。 CMD的目的是为了在启动容器时提供一个默认的命令执行选项。如果用户启动容器时指定了运行的命令,则会覆盖掉CMD指定的命令。 CMD会在启动容器的时候执行,build 时不执行,而RUN只是在构建镜像的时候执行,后续镜像构建完成之后,启动容器就与RUN无关了,这个初学者容易弄混这个概念,这里简单注解一下。 7.4 EXPOSE EXPOSE <port> [<port>...] 告诉 Docker 服务端容器对外映射的本地端口,需要在 docker run 的时候使用-p或者-P选项生效。 7.5 ENV ENV <key> <value> # 只能设置一个变量 ENV <key>=<value> ... # 允许一次设置多个变量 指定一个环节变量,会被后续RUN指令使用,并在容器运行时保留。 例子: ENV myName="John Doe" myDog=Rex\ The\ Dog \ myCat=fluffy 等同于 ENV myName John Doe ENV myDog Rex The Dog ENV myCat fluffy 7.6 ADD ADD <src>... <dest> ADD复制本地主机文件、目录或者远程文件 URLS 从 并且添加到容器指定路径中 。 支持通过 GO 的正则模糊匹配,具体规则可参见 Go filepath.Match ADD hom* /mydir/ # adds all files starting with "hom" ADD hom?.txt /mydir/ # ? is replaced with any single character 路径必须是绝对路径,如果 不存在,会自动创建对应目录 路径必须是 Dockerfile 所在路径的相对路径 如果是一个目录,只会复制目录下的内容,而目录本身则不会被复制 7.7 COPY COPY <src>... <dest> COPY复制新文件或者目录从 并且添加到容器指定路径中 。用法同ADD,唯一的不同是不能指定远程文件 URLS。 7.8 ENTRYPOINT ENTRYPOINT "executable", "param1", "param2" ENTRYPOINT command param1 param2 (shell form) 配置容器启动后执行的命令,并且不可被 docker run 提供的参数覆盖,而CMD是可以被覆盖的。如果需要覆盖,则可以使用docker run --entrypoint选项。 每个 Dockerfile 中只能有一个ENTRYPOINT,当指定多个时,只有最后一个生效。 Exec form ENTRYPOINT 例子 通过ENTRYPOINT使用 exec form 方式设置稳定的默认命令和选项,而使用CMD添加默认之外经常被改动的选项。 FROM ubuntu ENTRYPOINT ["top", "-b"] CMD ["-c"] 通过 Dockerfile 使用ENTRYPOINT展示前台运行 Apache 服务 FROM debian:stable RUN apt-get update && apt-get install -y --force-yes apache2 EXPOSE 80 443 VOLUME ["/var/www", "/var/log/apache2", "/etc/apache2"] ENTRYPOINT ["/usr/sbin/apache2ctl", "-D", "FOREGROUND"] Shell form ENTRYPOINT 例子 这种方式会在/bin/sh -c中执行,会忽略任何CMD或者docker run命令行选项,为了确保docker stop能够停止长时间运行ENTRYPOINT的容器,确保执行的时候使用exec选项。 FROM ubuntu ENTRYPOINT exec top -b 如果在ENTRYPOINT忘记使用exec选项,则可以使用CMD补上: FROM ubuntu ENTRYPOINT top -b CMD --ignored-param1 # --ignored-param2 ... --ignored-param3 ... 依此类推 7.9 VOLUME VOLUME ["/data"] 创建一个可以从本地主机或其他容器挂载的挂载点,后续具体介绍。 7.10 USER USER daemon 指定运行容器时的用户名或 UID,后续的RUN、CMD、ENTRYPOINT也会使用指定用户。 7.11 WORKDIR WORKDIR /path/to/workdir 为后续的RUN、CMD、ENTRYPOINT指令配置工作目录。可以使用多个WORKDIR指令,后续命令如果参数是相对路径,则会基于之前命令指定的路径。 WORKDIR /a WORKDIR b WORKDIR c RUN pwd 最终路径是/a/b/c。 WORKDIR指令可以在ENV设置变量之后调用环境变量: ENV DIRPATH /path WORKDIR $DIRPATH/$DIRNAME 最终路径则为 /path/$DIRNAME。 7.12 ONBUILD ONBUILD [INSTRUCTION] 配置当所创建的镜像作为其它新创建镜像的基础镜像时,所执行的操作指令。 例如,Dockerfile 使用如下的内容创建了镜像 image-A: [...] ONBUILD ADD . /app/src ONBUILD RUN /usr/local/bin/python-build --dir /app/src [...] 如果基于 image-A 创建新的镜像时,新的 Dockerfile 中使用 FROM image-A 指定基础镜像时,会自动执行 ONBUILD 指令内容,等价于在后面添加了两条指令。 # Automatically run the following ADD . /app/src RUN /usr/local/bin/python-build --dir /app/src 使用ONBUILD指令的镜像,推荐在标签中注明,例如 ruby:1.9-onbuild。 7.13 Dockerfile Examples # Nginx # # VERSION 0.0.1 FROM ubuntu MAINTAINER Victor Vieux <victor@docker.com> RUN apt-get update && apt-get install -y inotify-tools nginx apache2 openssh-server # Firefox over VNC # # VERSION 0.3 FROM ubuntu # Install vnc, xvfb in order to create a 'fake' display and firefox RUN apt-get update && apt-get install -y x11vnc xvfb firefox RUN mkdir ~/.vnc # Setup a password RUN x11vnc -storepasswd 1234 ~/.vnc/passwd # Autostart firefox (might not be the best way, but it does the trick) RUN bash -c 'echo "firefox" >> /.bashrc' EXPOSE 5900 CMD ["x11vnc", "-forever", "-usepw", "-create"] # Multiple images example # # VERSION 0.1 FROM ubuntu RUN echo foo > bar # Will output something like ===> 907ad6c2736f FROM ubuntu RUN echo moo > oink # Will output something like ===> 695d7793cbe4 # Youll now have two images, 907ad6c2736f with /bar, and 695d7793cbe4 with # /oink. 7.14 docker build $ docker build --help Usage: docker build [OPTIONS] PATH | URL | - Build a new image from the source code at PATH --force-rm=false Always remove intermediate containers, even after unsuccessful builds # 移除过渡容器,即使构建失败 --no-cache=false Do not use cache when building the image # 不实用 cache -q, --quiet=false Suppress the verbose output generated by the containers --rm=true Remove intermediate containers after a successful build # 构建成功后移除过渡层容器 -t, --tag="" Repository name (and optionally a tag) to be applied to the resulting image in case of success 参考文档:Dockerfile Reference 7.15 dockerfile 最佳实践 使用.dockerignore文件 为了在docker build过程中更快上传和更加高效,应该使用一个.dockerignore文件用来排除构建镜像时不需要的文件或目录。例如,除非.git在构建过程中需要用到,否则你应该将它添加到.dockerignore文件中,这样可以节省很多时间。 避免安装不必要的软件包 为了降低复杂性、依赖性、文件大小以及构建时间,应该避免安装额外的或不必要的包。例如,不需要在一个数据库镜像中安装一个文本编辑器。 每个容器都跑一个进程 在大多数情况下,一个容器应该只单独跑一个程序。解耦应用到多个容器使其更容易横向扩展和重用。如果一个服务依赖另外一个服务,可以参考 Linking Containers Together。 最小化层 我们知道每执行一个指令,都会有一次镜像的提交,镜像是分层的结构,对于Dockerfile,应该找到可读性和最小化层之间的平衡。 多行参数排序 如果可能,通过字母顺序来排序,这样可以避免安装包的重复并且更容易更新列表,另外可读性也会更强,添加一个空行使用\换行: RUN apt-get update && apt-get install -y \ bzr \ cvs \ git \ mercurial \ subversion 创建缓存 镜像构建过程中会按照Dockerfile的顺序依次执行,每执行一次指令 Docker 会寻找是否有存在的镜像缓存可复用,如果没有则创建新的镜像。如果不想使用缓存,则可以在docker build时添加--no-cache=true选项。 从基础镜像开始就已经在缓存中了,下一个指令会对比所有的子镜像寻找是否执行相同的指令,如果没有则缓存失效。在大多数情况下只对比Dockerfile指令和子镜像就足够了。ADD和COPY指令除外,执行ADD和COPY时存放到镜像的文件也是需要检查的,完成一个文件的校验之后再利用这个校验在缓存中查找,如果检测的文件改变则缓存失效。RUN apt-get -y update命令只检查命令是否匹配,如果匹配就不会再执行更新了。 为了有效地利用缓存,你需要保持你的 Dockerfile 一致,并且尽量在末尾修改。 Dockerfile 指令 FROM: 只要可能就使用官方镜像库作为基础镜像 RUN: 为保持可读性、方便理解、可维护性,把长或者复杂的RUN语句使用\分隔符分成多行 不建议RUN apt-get update独立成行,否则如果后续包有更新,那么也不会再执行更新 避免使用RUN apt-get upgrade或者dist-upgrade,很多必要的包在一个非privileged权限的容器里是无法升级的。如果知道某个包更新,使用apt-get install -y xxx 标准写法 RUN apt-get update && apt-get install -y package-bar package-foo 例子: RUN apt-get update && apt-get install -y \ aufs-tools \ automake \ btrfs-tools \ build-essential \ curl \ dpkg-sig \ git \ iptables \ libapparmor-dev \ libcap-dev \ libsqlite3-dev \ lxc=1.0* \ mercurial \ parallel \ reprepro \ ruby1.9.1 \ ruby1.9.1-dev \ s3cmd=1.1.0* CMD: 推荐使用CMD [“executable”, “param1”, “param2”…]这种格式,CMD [“param”, “param”]则配合ENTRYPOINT使用 EXPOSE: Dockerfile 指定要公开的端口,使用docker run时指定映射到宿主机的端口即可 ENV: 为了使新的软件更容易运行,可以使用ENV更新PATH变量。如ENV PATH /usr/local/nginx/bin:$PATH确保CMD ["nginx"]即可运行 ENV也可以这样定义变量: ENV PG_MAJOR 9.3 ENV PG_VERSION 9.3.4 RUN curl -SL http://example.com/postgres-$PG_VERSION.tar.xz | tar -xJC /usr/src/postgress && … ENV PATH /usr/local/postgres-$PG_MAJOR/bin:$PATH ADDorCOPY:ADD比COPY多一些特性「tar 文件自动解包和支持远程 URL」,不推荐添加远程 URL 如不推荐这种方式: ADD http://example.com/big.tar.xz /usr/src/things/ RUN tar -xJf /usr/src/things/big.tar.xz -C /usr/src/things RUN make -C /usr/src/things all 推荐使用 curl 或者 wget 替换,使用如下方式: RUN mkdir -p /usr/src/things \ && curl -SL http://example.com/big.tar.gz \ | tar -xJC /usr/src/things \ && make -C /usr/src/things all 如果不需要添加 tar 文件,推荐使用COPY。 参考文档: Best practices for writing Dockerfiles Dockerfile最佳实践(一) Dockerfile最佳实践(二) 八、容器数据管理 docker管理数据的方式有两种: 数据卷 数据卷容器 8.1 数据卷 数据卷是一个或多个容器专门指定绕过Union File System的目录,为持续性或共享数据提供一些有用的功能: 数据卷可以在容器间共享和重用 数据卷数据改变是直接修改的 数据卷数据改变不会被包括在容器中 数据卷是持续性的,直到没有容器使用它们 添加一个数据卷 你可以使用-v选项添加一个数据卷,或者可以使用多次-v选项为一个 docker 容器运行挂载多个数据卷。 $ sudo docker run --name data -v /data -t -i ubuntu:14.04 /bin/bash # 创建数据卷绑定到到新建容器,新建容器中会创建 /data 数据卷 bash-4.1# ls -ld /data/ drwxr-xr-x 2 root root 4096 Jul 23 06:59 /data/ bash-4.1# df -Th Filesystem Type Size Used Avail Use% Mounted on ... ... ext4 91G 4.6G 82G 6% /data 创建的数据卷可以通过docker inspect获取宿主机对应路径 $ sudo docker inspect data ... ... "Volumes": { "/data": "/var/lib/docker/vfs/dir/151de401d268226f96d824fdf444e77a4500aed74c495de5980c807a2ffb7ea9" }, # 可以看到创建的数据卷宿主机路径 ... ... 或者直接指定获取 $ sudo docker inspect --format="` `.`Volumes `" data map[/data: /var/lib/docker/vfs/dir/151de401d268226f96d824fdf444e77a4500aed74c495de5980c807a2ffb7ea9] 挂载宿主机目录为一个数据卷 -v选项除了可以创建卷,也可以挂载当前主机的一个目录到容器中。 $ sudo docker run --name web -v /source/:/web -t -i ubuntu:14.04 /bin/bash bash-4.1# ls -ld /web/ drwxr-xr-x 2 root root 4096 Jul 23 06:59 /web/ bash-4.1# df -Th ... ... ext4 91G 4.6G 82G 6% /web bash-4.1# exit 默认挂载卷是可读写的,可以在挂载时指定只读 $ sudo docker run --rm --name test -v /source/:/test:ro -t -i ubuntu:14.04 /bin/bash 8.2 创建和挂载一个数据卷容器 如果你有一些持久性的数据并且想在容器间共享,或者想用在非持久性的容器上,最好的方法是创建一个数据卷容器,然后从此容器上挂载数据。 创建数据卷容器 $ sudo docker run -t -i -d -v /test --name test ubuntu:14.04 echo hello 使用--volumes-from选项在另一个容器中挂载 /test 卷。不管 test 容器是否运行,其它容器都可以挂载该容器数据卷,当然如果只是单独的数据卷是没必要运行容器的。 $ sudo docker run -t -i -d --volumes-from test --name test1 ubuntu:14.04 /bin/bash 添加另一个容器 $ sudo docker run -t -i -d --volumes-from test --name test2 ubuntu:14.04 /bin/bash 也可以继承其它挂载有 /test 卷的容器 $ sudo docker run -t -i -d --volumes-from test1 --name test3 ubuntu:14.04 /bin/bash 8.3 备份、恢复或迁移数据卷 备份 $ sudo docker run --rm --volumes-from test -v $(pwd):/backup ubuntu:14.04 tar cvf /backup/test.tar /test tar: Removing leading `/' from member names /test/ /test/b /test/d /test/c /test/a 启动一个新的容器并且从test容器中挂载卷,然后挂载当前目录到容器中为 backup,并备份 test 卷中所有的数据为 test.tar,执行完成之后删除容器--rm,此时备份就在当前的目录下,名为test.tar。 $ ls # 宿主机当前目录下产生了 test 卷的备份文件 test.tar test.tar 恢复 你可以恢复给同一个容器或者另外的容器,新建容器并解压备份文件到新的容器数据卷 $ sudo docker run -t -i -d -v /test --name test4 ubuntu:14.04 /bin/bash $ sudo docker run --rm --volumes-from test4 -v $(pwd):/backup ubuntu:14.04 tar xvf /backup/test.tar -C / # 恢复之前的文件到新建卷中,执行完后自动删除容器 test/ test/b test/d test/c test/a 8.4 删除 Volumes Volume 只有在下列情况下才能被删除: docker rm -v删除容器时添加了-v选项 docker run --rm运行容器时添加了--rm选项 否则,会在/var/lib/docker/vfs/dir目录中遗留很多不明目录。 参考文档: Managing Data in Containers 深入理解Docker Volume(一) 深入理解Docker Volume(二) 九、链接容器 docker 允许把多个容器连接在一起,相互交互信息。docker 链接会创建一种容器父子级别的关系,其中父容器可以看到其子容器提供的信息。 9.1 容器命名 在创建容器时,如果不指定容器的名字,则默认会自动创建一个名字,这里推荐给容器命名: 1、给容器命名方便记忆,如命名运行 web 应用的容器为 web 2、为 docker 容器提供一个参考,允许方便其他容器调用,如把容器 web 链接到容器 db 可以通过--name选项给容器自定义命名: $ sudo docker run -d -t -i --name test ubuntu:14.04 bash $ sudo docker inspect --format="` `.`Nmae `" test /test 注:容器名称必须唯一,即你只能命名一个叫test的容器。如果你想复用容器名,则必须在创建新的容器前通过docker rm删除旧的容器或者创建容器时添加--rm选项。 9.2 链接容器 链接允许容器间安全通信,使用--link选项创建链接。 $ sudo docker run -d --name db training/postgres 基于 training/postgres 镜像创建一个名为 db 的容器,然后下面创建一个叫做 web 的容器,并且将它与 db 相互连接在一起 $ sudo docker run -d -P --name web --link db:db training/webapp python app.py --link <name or id>:alias选项指定链接到的容器。 查看 web 容器的链接关系: $ sudo docker inspect -f "` `.`HostConfig`.`Links `" web [/db:/web/db] 可以看到 web 容器被链接到 db 容器为/web/db,这允许 web 容器访问 db 容器的信息。 容器之间的链接实际做了什么?一个链接允许一个源容器提供信息访问给一个接收容器。在本例中,web 容器作为一个接收者,允许访问源容器 db 的相关服务信息。Docker 创建了一个安全隧道而不需要对外公开任何端口给外部容器,因此不需要在创建容器的时候添加-p或-P指定对外公开的端口,这也是链接容器的最大好处,本例为 PostgreSQL 数据库。 Docker 主要通过以下两个方式提供连接信息给接收容器: 环境变量 更新/etc/hosts文件 环境变量 当两个容器链接,Docker 会在目标容器上设置一些环境变量,以获取源容器的相关信息。 首先,Docker 会在每个通过--link选项指定别名的目标容器上设置一个<alias>_NAME环境变量。如果一个名为 web 的容器通过--link db:webdb被链接到一个名为 db 的数据库容器,那么 web 容器上会设置一个环境变量为WEBDB_NAME=/web/webdb. 以之前的为例,Docker 还会设置端口变量: $ sudo docker run --rm --name web2 --link db:db training/webapp env . . . DB_NAME=/web2/db DB_PORT=tcp://172.17.0.5:5432 DB_PORT_5432_TCP=tcp://172.17.0.5:5432 # <name>_PORT_<port>_<protocol> 协议可以是 TCP 或 UDP DB_PORT_5432_TCP_PROTO=tcp DB_PORT_5432_TCP_PORT=5432 DB_PORT_5432_TCP_ADDR=172.17.0.5 . . . 注:这些环境变量只设置给容器中的第一个进程,类似一些守护进程 (如 sshd ) 当他们派生 shells 时会清除这些变量 更新/etc/hosts文件 除了环境变量,Docker 会在目标容器上添加相关主机条目到/etc/hosts中,上例中就是 web 容器。 $ sudo docker run -t -i --rm --link db:db training/webapp /bin/bash root@aed84ee21bde:/opt/webapp# cat /etc/hosts 172.17.0.7 aed84ee21bde . . . 172.17.0.5 db /etc/host文件在源容器被重启之后会自动更新 IP 地址,而环境变量中的 IP 地址则不会自动更新的。 十、构建私有库 Docker 官方提供了 docker registry 的构建方法 docker-registry 10.1 快速构建 快速构建 docker registry 通过以下两步: 安装 docker 运行 registry:docker run -p 5000:5000 registry 这种方法通过 Docker hub 使用官方镜像 official image from the Docker hub 10.2 不使用容器构建 registry 安装必要的软件 $ sudo apt-get install build-essential python-dev libevent-dev python-pip liblzma-dev 配置 docker-registry sudo pip install docker-registry 或者 使用 github clone 手动安装 $ git clone https://github.com/dotcloud/docker-registry.git $ cd docker-registry/ $ cp config/config_sample.yml config/config.yml $ mkdir /data/registry -p $ pip install . 运行 docker-registry 高级启动方式 [不推荐] 使用gunicorn控制: gunicorn -c contrib/gunicorn_config.py docker_registry.wsgi:application 或者对外监听开放 gunicorn --access-logfile - --error-logfile - -k gevent -b 0.0.0.0:5000 -w 4 --max-requests 100 docker_registry.wsgi:application 10.3 提交指定容器到私有库 $ docker tag ubuntu:12.04 私有库IP:5000/ubuntu:12.04 $ docker push 私有库IP:5000/ubuntu 更多的配置选项推荐阅读官方文档: Docker-Registry README Docker-Registry advanced use 本文转自 运维小当家 51CTO博客,原文链接:http://blog.51cto.com/solin/1886455,如需转载请自行联系原作者

优秀的个人博客,低调大师

hive 权限笔记

启动权限,hive默认是禁止的。 Configuration For Hive 0.13.x Set the following in hive-site.xml: hive.server2.enable.doAs to false. hive.users.in.admin.role to the list of comma-separated users who need to be added toadminrole. Note thata user who belongs to theadminrole needs to run the "set role" command before getting the privileges of theadminrole, as this role is not in current roles by default. Start HiveServer2 with the following additional command-line options: -hiveconf hive.security.authorization.manager=org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdHiveAuthorizerFactory -hiveconf hive.security.authorization.enabled=true -hiveconf hive.security.authenticator.manager=org.apache.hadoop.hive.ql.security.SessionStateUserAuthenticator -hiveconf hive.metastore.uris=' ' For Hive 0.14 and Newer Set the following in hive-site.xml: hive.server2.enable.doAsto false. hive.users.in.admin.roleto the list of comma-separated users who need to be added toadminrole. Note thata user who belongs to theadminrole needs to run the "set role" command before getting the privileges of theadminrole, as this role is not in current roles by default. Add org.apache.hadoop.hive.ql.security.authorization.MetaStoreAuthzAPIAuthorizerEmbedOnly tohive.security.metastore.authorization.manager. (It takes a comma separated list, so you can add it along with StorageBasedAuthorization parameter, if you want to enable that as well). This setting disallows any of the authorization api calls to be invoked in a remote metastore. HiveServer2 can be configured to use embedded metastore, and that will allow it to invoke metastore authorization api. Hive cli and any other remote metastore users would be denied authorization when they try to make authorization api calls. This restricts the authorization api to privileged HiveServer2 process. You should also ensure that the metastore rdbms access is restricted to the metastore server and hiverserver2. hive.security.authorization.managerto org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdConfOnlyAuthorizerFactory.This will ensure that any table or views created by hive-cli have default privileges granted for the owner. Set the following in hiveserver2-site.xml: -hiveconf hive.security.authorization.manager=org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdHiveAuthorizerFactory -hiveconf hive.security.authorization.enabled=true -hiveconf hive.security.authenticator.manager=org.apache.hadoop.hive.ql.security.SessionStateUserAuthenticator -hiveconf hive.metastore.uris=' ' 角色管理: 说明:默认hive有public和admin角色,hive.users.in.admin.role中指定的用户为admin角色,多个用户以逗号分隔。 1、SET ROLE (role_name|ALL|NONE); 一个用户可以有多个用户组,SET ROLE命令会把当前用户切换到指定的角色组。 本文转自 yntmdr 51CTO博客,原文链接:http://blog.51cto.com/yntmdr/1749839,如需转载请自行联系原作者

优秀的个人博客,低调大师

dockerfile指令 笔记

Dockerfile指令 1、FROM 如果在同一Dockerfile中创建多个镜像时,可以使用多个FROM指令(每个镜像一次) 1 2 3 FROM<image> 或 FROM<image>:<tag> 2、MAINTAINER 维护者信息 1 MAINTAINER<name> 3、RUN 执行指定命令 1 2 3 RUN< command >(the command isrun in ashell-` /bin/sh -c`) 或 RUN[ "executable" , "param1" , "param2" ...]( exec form) 4、CMD:用于指定一个容器启动时要运行的命令,如果指定了多条命令,最有最后一条会被执行 1 2 CMD[ "executable" , "param1" , "param2" ](likean exec ,thisisthepreferredform) CMD command param1param2(asashell) 5、EXPOSE 暴露docker容器的端口 1 EXPOSE<port>[<port>...] 1 <br data-filtered= "filtered" > 6、ENV 指定一个环境变量,会被后续RUN指令使用,并在容器运行时保持 1 ENV<key><value> 7、ADD 复制本地主机的内容到容器目标容器的目录,如果源文件是gzip/bzip2/xz等归档文件,会自动解开并添加到目的地 8、COPY 复制本地主机的内容到容器目标容器的目录 1 ADD<src><dest> 9、ENTRYPOINT 每个Dockerfile中只能有一个ENTRYPOINT,当指定多个ENTRYPOINT时,只有最后一个生效 1 2 ENTRYPOINT[ "executable" , "param1" , "param2" ](likean exec ,thepreferredform) ENTRYPOINT command param1param2(asashell) 10、VOLUME 创建一个可以从本地或其他容器挂载的挂载点 1 VOLUME[ "<mountpoint>" ] 11、USER 使用指定用户运行命令 1 2 3 4 5 #指定memcached的运行用户 ENTRYPOINT[ "memcached" ] USERdaemon 或 ENTRYPOINT[ "memcached" , "-u" , "daemon" ] 12、WORKDIR 切换工作目录 1 WORKDIR /path/to/workdir 13、ONBUILD 1 2 ONBUILD<Dockerfile关键字> ONBUILD指定的命令在构建镜像时并不执行,而是在它的子镜像中执行。 创建镜像: docker build [ 选项 ] dockerfile路径 sudo docker build -t centos6-ssh . 笼统的收集了Dockerfile的指令 本文转自 yanconggod 51CTO博客,原文链接:http://blog.51cto.com/yanconggod/1883346

优秀的个人博客,低调大师

Spark SQL 笔记

官方参考文档: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#creating-dataframes DataFrame A DataFrame is a Dataset organized into named columns. It is conceptually equivalent to a table in a relational database or a data frame in R/Python, but with richer optimizations under the hood. DataFrames can be constructed from a wide array of sources such as: structured data files, tables in Hive, external databases, or existing RDDs. The DataFrame API is available in Scala, Java, Python, and R. 对于熟悉python的同学,Spark的DataFrame和python的DF很像。对于structured data files同学比较熟知的有xml、jason、parquet等。 关于parquet,请参考: http://blog.csdn.net/yu616568/article/details/50993491 具体的df的操作请参考官网: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#creating-dataframes python操作演示: >>> df = sqlContext.read.json("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.json") >>> df.show() +----+-------+ | age| name| +----+-------+ |null|Michael| | 30| Andy| | 19| Justin| +----+-------+ >>> df.printSchema() root |-- age: long (nullable = true) |-- name: string (nullable = true) >>> df.select("name").show() +-------+ | name| +-------+ |Michael| | Andy| | Justin| +-------+ >>> df.select(df['name'], df['age'] + 1).show() +-------+---------+ | name|(age + 1)| +-------+---------+ |Michael| null| | Andy| 31| | Justin| 20| +-------+---------+ >>> df.filter(df['age'] > 21).show() +---+----+ |age|name| +---+----+ | 30|Andy| +---+----+ scala在eclipse中的实现 import org.apache.spark.SparkConf import org.apache.spark.SparkContext import org.apache.spark.sql.SQLContext object DataFrameOperation { def main(args: Array[String]): Unit = { //create datarame //首先创建程序入口 val conf=new SparkConf().setAppName("DataFrameOperation") val sc=new SparkContext(conf); //create sqlcontext val sqlContext=new SQLContext(sc); val df=sqlContext.read.json("hdfs://hadoop1:9000/examples/src/main/resources/people.json") df.show(); //print schema df.printSchema() //name age df.select("name").show(); // df.select(df("name"),df("age")+1).show() //where df.filter(df("age") > 21).show() //groupby df.groupBy("age").count().show(); } } 关于代码的提交: 将上面的代码的代码文件(文件 即可不用导出工程) export成jar 提交请参考 Run on a YARN cluster 在上一篇的spark教程里 Interoperating with RDDs(和RDD交互) Spark SQL supports two different methods for converting existing RDDs into DataFrames. The first method uses reflection to infer the schema of an RDD that contains specific types of objects. This reflection based approach leads to more concise code and works well when you already know the schema while writing your Spark application. The second method for creating DataFrames is through a programmatic interface that allows you to construct a schema and then apply it to an existing RDD. While this method is more verbose, it allows you to construct DataFrames when the columns and their types are not known until runtime. 通过reflection的方式将RDD转换成dataframe 注意:RDD是读取非结构化数据 java版本 import org.apache.spark.SparkConf; import org.apache.spark.api.java.JavaRDD; import org.apache.spark.api.java.JavaSparkContext; import org.apache.spark.api.java.function.Function; import org.apache.spark.api.java.function.VoidFunction; import org.apache.spark.sql.DataFrame; import org.apache.spark.sql.Row; import org.apache.spark.sql.SQLContext; public class RDD2DataFrameReflection { public static void main(String[] args) { SparkConf conf = new SparkConf(); conf.setAppName("RDD2DataFrameReflection"); JavaSparkContext sc = new JavaSparkContext(conf); SQLContext sqlContext = new SQLContext(sc); //生成一个RDD JavaRDD<Person> PersonRDD = sc.textFile("hdfs://hadoop1:9000/examples/src/main/resources/people.txt") .map(new Function<String, Person>() { public Person call(String line) throws Exception { String[] strs = line.split(","); String name=strs[0]; int age=Integer.parseInt(strs[1].trim()); Person person=new Person(age,name); return person; } }); //生成一个df DataFrame personDF = sqlContext.createDataFrame(PersonRDD, Person.class); //将df注册成临时表,之后就可以像操作表一样 personDF.registerTempTable("person"); DataFrame resultperson = sqlContext.sql("select name,age from person where age > 13 and age <= 19"); //当想使用RDD的算子是,将df转换为RDD就可以使用类似foreach的操作了 resultperson.javaRDD().foreach(new VoidFunction<Row>() { /** * */ private static final long serialVersionUID = 1L; public void call(Row row) throws Exception { //把每一条数据都看成是一个row row(0)=name row(1)=age System.out.println("name"+row.getString(0)); System.out.println("age"+row.getInt(1)); } }); resultperson.javaRDD().saveAsTextFile("hdfs://hadoop1:9000/reflectionresult"); } } python版本(reflection.py): # sc is an existing SparkContext. from pyspark import SparkContext, SparkConf from pyspark.sql import SQLContext, Row appName= "reflection" master = "local" conf1 = SparkConf().setAppName(appName).setMaster(master) sc = SparkContext(conf=conf1) sqlContext = SQLContext(sc) # Load a text file and convert each line to a Row. lines = sc.textFile("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.txt") parts = lines.map(lambda l: l.split(",")) people = parts.map(lambda p: Row(name=p[0], age=int(p[1]))) # Infer the schema, and register the DataFrame as a table. schemaPeople = sqlContext.createDataFrame(people) schemaPeople.registerTempTable("people") # SQL can be run over DataFrames that have been registered as a table. teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19") # The results of SQL queries are RDDs and support all the normal RDD operations. teenNames = teenagers.map(lambda p: "Name: " + p.name) for teenName in teenNames.collect(): print(teenName) 代码提交时,使用spark-submit reflection.py 用编程(programmatically)的方式将RDD转换成DF >>> lines = sc.textFile("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.txt") >>> parts = lines.map(lambda l: l.split(",")) >>> people = parts.map(lambda p: (p[0], p[1].strip())) >>> parts.collect() [[u'Michael', u' 29'], [u'Andy', u' 30'], [u'Justin', u' 19']] >>> people.collect() [(u'Michael', u'29'), (u'Andy', u'30'), (u'Justin', u'19')] >>> schemaString = "name age" >>> fields = [StructField(field_name, StringType(), True) for field_name in schemaString.split()] Traceback (most recent call last): File "<stdin>", line 1, in <module> NameError: name 'StructField' is not defined >>> from pyspark.sql.types import * >>> fields = [StructField(field_name, StringType(), True) for field_name in schemaString.split()] >>> fields.collect() Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'list' object has no attribute 'collect' >>> schema = StructType(fields) >>> schemaPeople = sqlContext.createDataFrame(people, schema) >>> schemaPeople.registerTempTable("people") >>> results = sqlContext.sql("SELECT name FROM people") >>> results.collect() [Row(name=u'Michael'), Row(name=u'Andy'), Row(name=u'Justin')] >>> names = results.map(lambda p: "Name: " + p.name) >>> names.collect() [u'Name: Michael', u'Name: Andy', u'Name: Justin'] >>> for name in names.collect(): ... print(name) ... Name: Michael Name: Andy Name: Justin >>> 不懂StructField和StructType的还请参考 http://spark.apache.org/docs/1.5.2/api/python/pyspark.sql.html?highlight=structfield#pyspark.sql.types.StructField DataFrame VS RDD 当生成DF的时候会返回schema类型(类似于postgresql的表结构),而RDD不会,仅仅返回的是一个Person,不知道里面具体的数据类型 数据的load以及save 参考: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#data-sources spark sql默认支持的是parquet文件格式,所以不制定load、save类型,默认都是parquet。关于parquet 参考 http://www.infoq.com/cn/articles/in-depth-analysis-of-parquet-column-storage-format Parquet是语言无关的,而且不与任何一种数据处理框架绑定在一起,适配多种语言和组件,能够与Parquet配合的组件有: 查询引擎: Hive, Impala, Pig, Presto, Drill, Tajo, HAWQ, IBM Big SQL 计算框架: MapReduce, Spark, Cascading, Crunch, Scalding, Kite 数据模型: Avro, Thrift, Protocol Buffers, POJOs 保存时是追加还是覆盖,请参考SaveModes parquet 文件操作 通用文件操作: df1 = sqlContext.read.load("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/users.parquet") >>> df1.show() +------+--------------+----------------+ | name|favorite_color|favorite_numbers| +------+--------------+----------------+ |Alyssa| null| [3, 9, 15, 20]| | Ben| red| []| +------+--------------+----------------+ df1.select("name", "favorite_color").show() +------+--------------+ | name|favorite_color| +------+--------------+ |Alyssa| null| | Ben| red| +------+--------------+ df1.select("name", "favorite_color").write.save("file:///home/zkpk/ecaoyng/input/namesAndFavColors.parquet") 自动推断分区(Partition Discovery) 看完下面的例子就知道什么是自动推断分区了 #在hdfs上新建一个目录country=US hadoop fs -mkdir -p /ecaoyng/country=US #将parquet文件上传到新建的目录 hadoop fs -put users.parquet /ecaoyng/country=US #之前读到的df1的内容 >>> df1.show() +------+--------------+----------------+ | name|favorite_color|favorite_numbers| +------+--------------+----------------+ |Alyssa| null| [3, 9, 15, 20]| | Ben| red| []| +------+--------------+----------------+ #在新建目录之后读取到的parquet文件,可以看出多了country这一列 >>> df2= sqlContext.read.parquet("hdfs:///ecaoyng/country=US/users.parquet") >>> df2.show() +------+--------------+----------------+-------+ | name|favorite_color|favorite_numbers|country| +------+--------------+----------------+-------+ |Alyssa| null| [3, 9, 15, 20]| US| | Ben| red| []| US| +------+--------------+----------------+-------+ schema的合并 >>> df3 = sqlContext.createDataFrame(sc.parallelize(range(1, 6)).map(lambda i : Row(single=i, double=i*2)) ... ) >>> df3.write.parquet("hdfs:///ecaoyng/test_table/key=1") >>> df4=sqlContext.createDataFrame(sc.parallelize(range(6,11)).map(lambda i : Row(single=i, triple=i*3))) >>> df4.write.parquet("hdfs:///ecaoyng/test_table/key=2") >>> df5 = sqlContext.read.option("mergeSchema", "true").parquet("hdfs:///ecaoyng/test_table") >>> df5.printSchema() root |-- double: long (nullable = true) |-- single: long (nullable = true) |-- triple: long (nullable = true) |-- key: integer (nullable = true) >>> df5.show() +------+------+------+---+ |double|single|triple|key| +------+------+------+---+ | null| 6| 18| 2| | null| 7| 21| 2| | null| 8| 24| 2| | null| 9| 27| 2| | null| 10| 30| 2| | 2| 1| null| 1| | 4| 2| null| 1| | 6| 3| null| 1| | 8| 4| null| 1| | 10| 5| null| 1| +------+------+------+---+ >>> 数据源之JDBC之mysql 以mysql为例,首先启动mysql. 遇到错误信息如下 nother MySQL daemon already running with the same unix socket. Starting mysqld: [FAILED] 解决方案,重命名/var/lib/mysql/mysql.sock 即可,重新启动mysql 其他的请参考如下链接 https://www.cnblogs.com/wwxbi/p/6978774.html http://spark.apache.org/docs/1.6.0/sql-programming-guide.html#jdbc-to-other-databases 注意,如果没有驱动包会报错: java.sql.SQLException: No suitable driver at java.sql.DriverManager.getDriver(DriverManager.java:278) 解决方法是: 下载驱动包 在spark-env.sh中设置 export SPARK_CLASSPATH=$SPARK_CLASSPATH:/usr/local/soft/hive/lib/mysql-connector-java-5.1.10.jar 那么在提交jdbc的脚本的时候就不可以设置--driver-class-path路径 如果在spark-env.sh脚本里没有设置MySQL驱动包的spark_classpath 那么需要在提交任务的时候在脚本里天如下内容: --driver-class-path /usr/local/soft/hive/lib/mysql-connector-java-5.1.10.jar 数据源之Hive 在spark开发中spark开发占了很大一部分,而基于hive的开发,又占了其中很大的比重。下面我们就来进行hive和spark集成

优秀的个人博客,低调大师

Docker入门笔记

原文链接: http://yangbingdong.com/2017/docker-learning/ Preface 为什么选择Docker?网上已经给出了很多说法,总结而言就是,趋势(这不是废话吗) 哈哈,词穷 作为一种新兴的虚拟化方式,Docker跟传统的虚拟化方式相比具有众多的优势,这里也不详细列举了 Docker对于持续交付和部署的DevOps人员来说也有着重要的意义... 本篇主要记录Docker的基础学习(安装、简单使用) Concept 以下是Docker的三个基本概念。 Image(镜像) 官方而言,Docker 镜像是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数(如匿名卷、环境变量、用户等)。镜像不包含任何动态数据,其内容在构建之后也不会被改变。 对博主而言,它相当于就是个Java Class(类)=.= 但它的存储结构类似Git,一层一层地网上盖,删除一个文件并不会真的删除,只是在那个文件上面做了一个标记为已删除。在最终容器运行的时候,虽然不会看到这个文件,但是实际上该文件会一直跟随镜像。因此,在构建镜像的时候,需要额外小心,每一层尽量只包含该层需要添加的东西,任何额外的东西应该在该层构建结束前清理掉。 Container(容器) 通俗来说,如果镜像是类,那么容器就是这个类的实例了,镜像是静态的定义,容器是镜像运行时的实体。容器可以被创建、启动、停止、删除、暂停等。 容器也有其特性,例如存储,不指定数据卷(Volume)的话,容器消亡数据也就跟着没了... 跟多特性请自行百度~ Repository(仓库) 仓库没啥好说的了,以 Ubuntu 镜像 为例,ubuntu 是仓库的名字,其内包含有不同的版本标签,如,14.04, 16.04。我们可以通过 ubuntu:14.04,或者 ubuntu:16.04 来具体指定所需哪个版本的镜像。如果忽略了标签,比如 ubuntu,那将视为 ubuntu:latest Install 这里以Ubuntu为例(当然是因为博主用的是Ubuntu= =),版本的话Docker目前支持的Ubuntu版本最低为12.04LTS,但从稳定性上考虑,推荐使用14.04LTS或更高的版本。 使用脚本自动安装 在测试或开发环境中 Docker 官方为了简化安装流程,提供了一套便捷的安装脚本,Ubuntu 系统上可以使用这套脚本安装: curl -fsSL get.docker.com -o get-docker.sh sudo sh get-docker.sh --mirror Aliyun 执行这个命令后,脚本就会自动的将一切准备工作做好,并且把 Docker 安装在系统中 使用 APT 镜像源 安装 sudo apt-get update sudo apt-get install \ apt-transport-https \ ca-certificates \ curl \ software-properties-common 鉴于国内网络问题,强烈建议使用国内源 国内源 curl -fsSL https://mirrors.aliyun.com/docker-ce/linux/ubuntu/gpg | sudo apt-key add - sudo add-apt-repository \ "deb [arch=amd64] https://mirrors.aliyun.com/docker-ce/linux/ubuntu \ $(lsb_release -cs) \ stable" 以上命令会添加 稳定 版本的 Docker CE APT 镜像源,如果需要最新版本的 Docker CE 请将 stable 改为 edge 或者 test 。从 Docker 17.06 开始,edge test 版本的 APT 镜像源也会包含稳定版本的 Docker 官方源 curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add - sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_release -cs) \ stable" 安装 Docker CE sudo apt-get update sudo apt-get install docker-ce 启动 Docker CE sudo systemctl enable docker sudo systemctl start docker 建立 docker 用户组 默认情况下,docker 命令会使用 Unix socket 与 Docker 引擎通讯。而只有 root 用户和 docker 组的用户才可以访问 Docker 引擎的 Unix socket。出于安全考虑,一般 Linux 系统上不会直接使用 root 用户。因此,更好地做法是将需要使用 docker 的用户加入 docker 用户组。 建立 docker 组(貌似执行了自动安装脚本会自动建一个docker的用户组): sudo groupadd docker 将当前用户加入 docker 组: sudo usermod -aG docker $USER 加入docker 组之后要重启才能生效哦... Mirror Acceleration 没有代理的话国内访问Docker Hub的速度实在感人,但Docker官方和国内很多云服务商都提供了加速器服务: Docker 官方提供的中国registry mirror 阿里云加速器 DaoCloud 加速器 灵雀云加速器 如阿里,注册并申请后会得到加速域名如https://vioqnt8w.mirror.aliyuncs.com,然后正如官方说的一样,通过修改daemon配置文件/etc/docker/daemon.json来使用加速器: sudo mkdir -p /etc/docker sudo tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": ["https://vioqnt8w.mirror.aliyuncs.com"] } EOF sudo systemctl daemon-reload sudo systemctl restart docker 查看生效: sudo docker info|grep "Registry Mirrors" -A 1 输出如下: Registry Mirrors: https://vioqnt8w.mirror.aliyuncs.com/ Use Image 获取 Docker Hub 上有大量的高质量的镜像可以用,我们可以通过以下的方式获取镜像: docker pull [选项] [Docker Registry地址]<仓库名>:<标签> 选项可以通过docker pull --help查看。 eg,从Docker Hub下载REPOSITORY为java的所有镜像: docker pull -a java 列出 使用docker images [OPTIONS] [REPOSITORY[:TAG]]列出已下载的镜像 列表包含了仓库名、标签、镜像 ID、创建时间以及所占用的空间 OPTIONS说明: -a :列出本地所有的镜像(含中间映像层,默认情况下,过滤掉中间映像层); --digests :显示镜像的摘要信息; -f :显示满足条件的镜像; --format :指定返回值的模板文件; --no-trunc :显示完整的镜像信息; -q :只显示镜像ID。 eg: # 看到在 mongo:3.2 之后建立的镜像,想查看某个位置之前的镜像也可以,只需要把 since 换成 before 即可 docker images -f since=mongo:3.2 虚悬镜像(dangling image) 举个例子:原来为 mongo:3.2,随着官方镜像维护,发布了新版本后,重新 docker pull mongo:3.2 时,mongo:3.2 这个镜像名被转移到了新下载的镜像身上,而旧的镜像上的这个名称则被取消,从而成为了 <none>。除了 docker pull 可能导致这种情况,docker build 也同样可以导致这种现象。由于新旧镜像同名,旧镜像名称被取消,从而出现仓库名、标签均为 <none> 的镜像。这类无标签镜像也被称为 虚悬镜像(dangling image) ,可以用下面的命令专门显示这类镜像: docker images -f dangling=true 一般来说,虚悬镜像已经失去了存在的价值,是可以随意删除的,可以用下面的命令删除: docker rmi $(docker images -q -f dangling=true) Commit 从容器创建一个新的镜像: docker commit [OPTIONS] CONTAINER [REPOSITORY[:TAG]] OPTIONS说明: -a :提交的镜像作者; -c :使用Dockerfile指令来创建镜像; -m :提交时的说明文字; -p :在commit时,将容器暂停。 eg: docker commit -a "ybd" -m "my apache" a404c6c174a2 mymysql:v1 当我们修改了镜像文件提交时候,可以使用docker diff [OPTIONS] CONTAINER查看修改了什么东西。 一般地,不推荐使用commit来构建镜像,之前也提过,镜像是特殊的文件系统,改了东西之后原来的基础之上叠加,使之变得越来越臃肿。此外,使用 docker commit 意味着所有对镜像的操作都是黑箱操作,生成的镜像也被称为黑箱镜像,换句话说,就是除了制作镜像的人知道执行过什么命令、怎么生成的镜像,别人根本无从得知。一般我们会使用Dockerfile定制镜像。 删除 删除镜像可以使用: docker rmi [OPTIONS] IMAGE [IMAGE...] OPTIONS说明: -f :强制删除; --no-prune :不移除该镜像的过程镜像,默认移除; 一般会组合使用: docker rmi $(docker images -q -f dangling=true) docker rmi $(docker images -q redis) docker rmi $(docker images -q -f before=mongo:3.2) 查看元数据 docker inspect : 获取容器/镜像的元数据。 docker inspect [OPTIONS] CONTAINER|IMAGE [CONTAINER|IMAGE...] OPTIONS说明: -f :指定返回值的模板文件。 -s :显示总的文件大小。 --type :为指定类型返回JSON。 实例 获取镜像mysql:5.6的元信息。 ~: docker inspect mysql:5.6 [ { "Id": "sha256:2c0964ec182ae9a045f866bbc2553087f6e42bfc16074a74fb820af235f070ec", "RepoTags": [ "mysql:5.6" ], "RepoDigests": [], "Parent": "", "Comment": "", "Created": "2016-05-24T04:01:41.168371815Z", "Container": "e0924bc460ff97787f34610115e9363e6363b30b8efa406e28eb495ab199ca54", "ContainerConfig": { "Hostname": "b0cf605c7757", "Domainname": "", "User": "", "AttachStdin": false, "AttachStdout": false, "AttachStderr": false, "ExposedPorts": { "3306/tcp": {} }, ... 获取正在运行的容器mymysql的 IP。 ~: docker inspect -f '' mymysql 172.17.0.3 Operating Container 开启 docker run :创建一个新的容器并运行一个命令 docker create :创建一个新的容器但不启动它 docker run [OPTIONS] IMAGE [COMMAND] [ARG...] docker create [OPTIONS] IMAGE [COMMAND] [ARG...] docker run OPTIONS说明: -a stdin: 指定标准输入输出内容类型,可选 STDIN/STDOUT/STDERR 三项; -d: 后台运行容器,并返回容器ID; -i: 以交互模式运行容器,通常与 -t 同时使用; -t: 为容器重新分配一个伪输入终端,通常与 -i 同时使用; -v: 挂载数据卷 --name="nginx-lb": 为容器指定一个名称; --restart=always: docker启动容器也跟着启动 --dns 8.8.8.8: 指定容器使用的DNS服务器,默认和宿主一致; --dns-search example.com: 指定容器DNS搜索域名,默认和宿主一致; -h "mars": 指定容器的hostname; -e username="ritchie": 设置环境变量; --env-file=[]: 从指定文件读入环境变量; --cpuset="0-2" or --cpuset="0,1,2": 绑定容器到指定CPU运行; -m :设置容器使用内存最大值; --net="bridge": 指定容器的网络连接类型,支持 bridge/host/none/container: 四种类型; --link=[]: 添加链接到另一个容器; --expose=[]: 开放一个端口或一组端口; <b>实例</b> 例如,启动一个 bash 终端,允许用户进行交互: docker run -t -i ubuntu:14.04 /bin/bash 当利用 docker run 来创建容器时,Docker 在后台运行的标准操作包括: 检查本地是否存在指定的镜像,不存在就从公有仓库下载 利用镜像创建并启动一个容器 分配一个文件系统,并在只读的镜像层外面挂载一层可读写层 从宿主主机配置的网桥接口中桥接一个虚拟接口到容器中去 从地址池配置一个 ip 地址给容器 执行用户指定的应用程序 执行完毕后容器被终止 停止 docker stop :停止一个运行中的容器: docker stop [OPTIONS] CONTAINER [CONTAINER...] 进入容器 使用docker exec : docker exec [OPTIONS] CONTAINER COMMAND [ARG...] OPTIONS说明: -d :分离模式: 在后台运行 -i :即使没有附加也保持STDIN 打开 -t :分配一个伪终端 例如进入ubuntu容器交互式模式: docker exec -it ubuntu /bin/sh 导出和导入容器 导出容器快照 docker export [OPTIONS] CONTAINER 例如: docker export 7691a814370e > ubuntu.tar 导入容器快照 docker import [OPTIONS] file|URL|- [REPOSITORY[:TAG]] OPTIONS说明: -c :应用docker 指令创建镜像; -m :提交时的说明文字; 例如: docker import ubuntu.tar ybd/ubuntu:v1 删除 docker rm [OPTIONS] CONTAINER [CONTAINER...] OPTIONS说明: -f :通过SIGKILL信号强制删除一个运行中的容器 -l :移除容器间的网络连接,而非容器本身 -v :-v 删除与容器关联的卷 删除所有容器: docker rm $(docker ps -a -q) 但这并不会删除运行中的容器 列出容器 docker ps [OPTIONS] OPTIONS说明: -a :显示所有的容器,包括未运行的。 -f :根据条件过滤显示的内容。 --format :指定返回值的模板文件。 -l :显示最近创建的容器。 -n :列出最近创建的n个容器。 --no-trunc :不截断输出。 -q :静默模式,只显示容器编号。 -s :显示总的文件大小。 例如列出最近创建的5个容器信息: docker ps -n 5 列出所有创建的容器ID: docker ps -a -q Dev Env In Docker mysql: docker run -p 6033:3306 --name mysql-master --restart=always -v $PWD/conf/my.cnf:/etc/mysql/my.cnf -v $PWD/logs:/var/log/mysql -v $PWD/data:/var/lib/mysql -e MYSQL_ROOT_PASSWORD=123456 -idt mysql:5.7.19 redis: docker run -p 6380:6379 --name redis-master --restart=always -v /home/ybd/docker/redis:/data -v /etc/redis/redis.conf:/usr/local/etc/redis/redis.conf -d redis:4.0.1 redis-server --appendonly yes Last 参考:Docker — 从入门到实践Docker命令大全

优秀的个人博客,低调大师

MessagePack 学习笔记

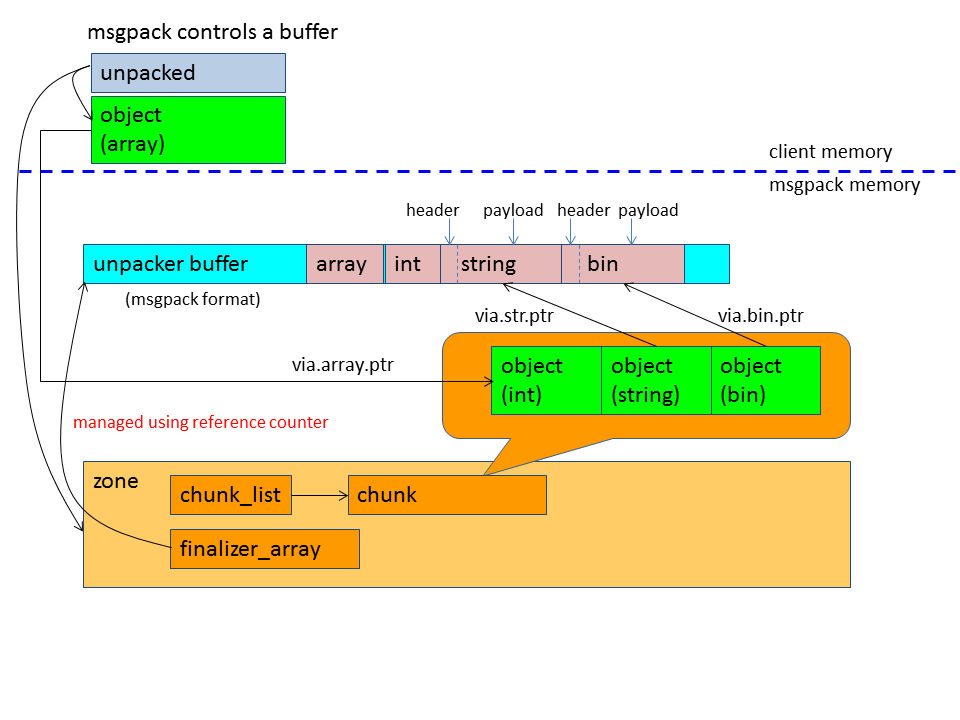
封装和解析类似json的 key-value 示例 {"ID" = 333,"name"="zds","3333"="ende"} msgpack::sbuffer sBuf; msgpack::packer<msgpack::sbuffer> pker(&sBuf); pker.pack_map(3); pker.pack(std::string("ID")); pker.pack(333); pker.pack(std::string("name")); pker.pack(std::string("zds")); pker.pack(std::string("333")); pker.pack(std::string("ende")); //unserilized msgpack::unpacked unpack; msgpack::unpack(unpack, sBuf.data(), sBuf.size()); msgpack::object obj = unpack.get(); std::cout << obj << std::endl; if (obj.type == msgpack::type::ARRAY) std::cout << "是array" << std::endl; else if (obj.type == msgpack::type::MAP) std::cout << "是map" << std::endl; if(obj.via.map.size > 0) { auto pkv = obj.via.map.ptr; auto pkv_end = obj.via.map.ptr + obj.via.map.size; do { auto key = pkv->key; auto val = pkv->val; std::cout << "key:" << key << " value:" << val << std::endl; ++pkv; } while (pkv < pkv_end); } 解析Socket示例 各类数据结构: msgpack::object 他是一个引用,拷贝他的代价少,因为他是浅拷贝msgpack::object_handle 他管理了一个对象的生命周期。他如果释放了,所有从他生成的object都是无效的引用 解析Socket示例 下列代码解析socke收包数据 unpacker.reserve_buffer 分配要收的数据的内存字节数unpacker..buffer() 返回数据地址unpacker.buffer_consumed() 设置实际收到的数据unpacker.next(object_handle& oh) 循环解析数据 int main() { boost::asio::io_service ios; std::uint16_t const port = 12345; // Server std::size_t const window_size = 10; boost::asio::ip::tcp::acceptor ac(ios, boost::asio::ip::tcp::endpoint(boost::asio::ip::tcp::v4(), port)); boost::asio::ip::tcp::socket ss(ios); std::function<void()> do_accept; std::function<void()> do_async_read_some; msgpack::unpacker unp; do_accept = [&] { ac.async_accept( ss, [&] (boost::system::error_code const& e) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } unp.reserve_buffer(window_size); do_async_read_some = [&] { ss.async_read_some( boost::asio::buffer(unp.buffer(), window_size), [&](boost::system::error_code const& e, std::size_t bytes_transferred) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } std::cout << bytes_transferred << " bytes read." << std::endl; unp.buffer_consumed(bytes_transferred); msgpack::object_handle oh; while (unp.next(oh)) { std::cout << oh.get() << std::endl; // In order to finish the program, // return if one complete msgpack is processed. // In actual server, don't return here. return; } do_async_read_some(); } ); }; do_async_read_some(); } ); }; do_accept(); // Client auto host = "localhost"; boost::asio::ip::tcp::resolver r(ios); boost::asio::ip::tcp::resolver::query q(host, boost::lexical_cast<std::string>(port)); auto it = r.resolve(q); boost::asio::ip::tcp::socket cs(ios); boost::asio::async_connect( cs, it, [&] (boost::system::error_code const& e, boost::asio::ip::tcp::resolver::iterator) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } std::cout << __LINE__ << ":client connected" << std::endl; msgpack::sbuffer sb; msgpack::pack(sb, std::make_tuple(42, false, "hello world", 12.3456)); write(cs, boost::asio::buffer(sb.data(), sb.size())); } ); // Start ios.run(); } 详解: msgpack controls a buffer msgpack provides a buffer management functionality named msgpack::unpacker. msgpack::unpacker is sutable for the following motivations: msgpack data is chopped, and the client doesn't know when it will complete. This is a typical situation when you develop streaming applications. You want to minimize copy opperations without careful memory management. Here is the basic (not all) interface of msgpack::unpacker: #ifndef MSGPACK_UNPACKER_INIT_BUFFER_SIZE #define MSGPACK_UNPACKER_INIT_BUFFER_SIZE (64*1024) #endif #ifndef MSGPACK_UNPACKER_RESERVE_SIZE #define MSGPACK_UNPACKER_RESERVE_SIZE (32*1024) #endif class unpacker { public: unpacker(unpack_reference_func f = &unpacker::default_reference_func, void* user_data = nullptr, std::size_t init_buffer_size = MSGPACK_UNPACKER_INIT_BUFFER_SIZE, unpack_limit const& limit = unpack_limit()); void reserve_buffer(std::size_t size = MSGPACK_UNPACKER_RESERVE_SIZE); char* buffer(); void buffer_consumed(std::size_t size); bool next(unpacked& result); }; Here is a basic pattern using msgpack::unpacker: // The size may decided by receive performance, transmit layer's protocol and so on. std::size_t const try_read_size = 100; msgpack::unpacker unp; // Message receive loop while (/* block until input becomes readable */) { unp.reserve_buffer(try_read_size); // unp has at least try_read_size buffer on this point. // input is a kind of I/O library object. // read message to msgpack::unpacker's internal buffer directly. std::size_t actual_read_size = input.readsome(unp.buffer(), try_read_size); // tell msgpack::unpacker actual consumed size. unp.buffer_consumed(actual_read_size); msgpack::unpacked result; // Message pack data loop while(unp.next(result)) { msgpack::object obj(result.get()); // Use obj } // All complete msgpack message is proccessed at this point, // then continue to read addtional message. } msgpack::unpacker::next() returns true if one complete msgpack messege is proccessed. If msgpack message is correct but insufficient, it returns false. However, parsing proccess is proceeded and the context information is preserved in the msgpack::unpacker. It helps leveling the load of parse. When msgpack message contains binary data, string data, or ext data, they are not copied but referenced from msgpack::object by default. See the following implementation: inline bool unpacker::default_reference_func(type::object_type type, uint64_t len, void*) { return true; } You can also customize unpack_reference_func. Even if you use references, you don't need to control buffer's lifetime. The buffers' lifetime is controled by msgpack using msgpack::zone's finalizer_array and msgpack::unpacker's reference counting mechanism. So, in most cases, the default behavior is enough. If you want to control the peak of memory consumption when receiving msgpack data patterns are predictable, customizing unpack_reference_func might be useful. You can get a reference information from msgpack::unpacker::next() using the following function: bool next(unpacked& result, bool& referenced); However, mostly you don't need to use that version of next() because referenced memories are managed by unpacker.

优秀的个人博客,低调大师

YARN 笔记(一)

YARN是Yet Another Resource Negotiator的简称,它仍可认为采用了master/slave结构,总体上采用了双层调度架构,它主要以下几部分组成: ResourceManager:负责资源管理的主服务,整个系统只有一个,负责资源管理、调度和监控,它支持可插拔的资源调度器,自带了FIFO、Fair Scheduler和Capacity Scheduler三种调度器; NodeManager:负责单个节点的资源管理和监控,它定期将资源使用情况汇报给ResourceManager,并接收来自ApplicationMaster的命令以启动Container(YARN中对资源的抽象),回收Container ApplicationMaster:负责管理单个应用程序,它向ResourceManager申请资源,并使用这些资源启动内部的任务,同时负责任务的运行监控和容错等; Container:对资源的抽象,它封装了某个节点上的CPU、内存等资源,ApplicationMaster只有获得一个Container后才能启动任务,另外,ApplicationMaster本身也是运行在一个Container之中。 用户将应用程序提交到ResourceManager上 ResourceManager为应用程序ApplicationMaster申请资源,并与某个NodeManager通信,以启动ApplicationMaster; ApplicationMaster与ResourceManager通信,为内部要执行的任务申请资源,一旦得到资源后,将于NodeManager通信,以启动对应的任务。 所有任务运行完成后,ApplicationMaster向ResourceManager注销,整个应用程序运行结束。

优秀的个人博客,低调大师

RNACocktail安装笔记

前段时间,估计2个月之前了吧,Nature Commnication 上发了一篇史上最强RNA-Seq数据分析测评文章,本来一直想介绍一下的,但是尴尬的是实验室一直没来RNA-Seq数据让我分析,所以就一直没写文章提供的"RNACocktail",现在终于能够写一下如何布置RNACocktail的工作环境了。 官方地址:【https://bioinform.github.io/rnacocktail/】 如果你懂docker,并且有管理员权限,那你可以尝试他们提供的docker image, 也就是docker pull marghoob/rnacocktail.但这里,我们采用的是conda进行软件管理,为了保证环境的一致性和稳定性,我重新建立一个虚拟环境,国内用户可以需要添加清华镜像源提高下载速度(后面提到的配置文件里设置了清华镜像源)。 按照往常,我可能要把每一行下载的代码都要罗列出来才行,但是conda install有一个选项是-file, 通过已有的环境设置参数文件,一步搞定。我的配置文件放在我的GitHub上,下载后用conda install --file fileName.txt进行安装。 注意,RNACocktail是大杂烩的体系,下面不同步骤及其对应的主要软件 比对,align, HISAT2 转录本重建,reconstruct, StringTie 基因定量,quantify, Salmon-SMEM 差异表达,diff, DESeq2 短读长序列从头组装,denovo, Oases 长读长序列矫正,long_correct, loRDEC 长读长序列比对,long_align, STARlong 长读长序列转录本重建,long_reconstruct,IDP 长读长序列转录融合检测,long_fusion, IDP-fusion 变异位点识别,variant,GATK RNA编辑检测,editing, GIREMI RNA融合检测,fusion, FusionCatcher 并且,最后以上步骤最后都加入了all豪华套餐。 那么问题来了,我目前不需要三代测序,也不需要做RNA edit 和 fusion的分析,主要工作就是基因定量和差异表达分析,我不需要安装所有的软件。 安装方法: 我提供的requirement.txt文件安装的软件是RNACocktail流程的中配版本,而且我以身试坑,能够运行。大家可以根据需要,在此基础上添加不同口味的软件。 # 方法1,自定义环境名 conda env create -n rnacocktial(名字随意) -f=requiremment.txt # 方法2, 指定安装路径 crate env create -p $HOME/software/rnacocktail(路径自选) -f=requiremment.txt 如下是我将服务器导出环境配置文件,在我本地电脑上运行的示例图。 以身测坑 最后需要自己安装作者放在GitHub上最新版本的RNACocktial source activate rnacocktail pip install https://github.com/bioinform/RNACocktail/archive/v0.2.1.tar.gz 如果不需要可以一键删除, conda env remove -n rnacocktial 定量流程测试 由于安装的软件版本和官方的未必一样,需要先用quantify这一步探探雷。官方给的推荐命令如下: run_rnacocktail.py quantify --quantifier_idx salmon_fmd_idx # 使用salmon index -t reference.fa -i salmon_index_basename --type fmd 构建 --1 seq_1.fq.gz --2 seq_2.fq.gz #双端测序 --libtype IU # 无链特异性,双端 --salmon_k 19 # salmon教程75bp以上推荐31 --outdir out # --workdir work --salmon /path/to/salmon #salmon所在位置 --threads 10 #线程数 --sample A #表示样本A --unzip # 解压 之前写过是时候来一波RNA-Seq差异表达分析实操了 用的就是salmon,刚好能派上用场。 下载(拟南芥cDNA)序列,也就是转录组数据库,建立索引 # downlaod data from ensemblgenomes curl ftp://ftp.ensemblgenomes.org/pub/plants/release-28/fasta/arabidopsis_thaliana/cdna/Arabidopsis_thaliana.TAIR10.28.cdna.all.fa.gz -o athal.fa.gz # build quasi-mapping-based index salmon index -t athal.fa.gz -i Athaliana --type fmd 使用run_rancocktail对样本定量 for fn in ERR1698{194..209};ERR1698{194..209}; do samp=`basename ${fn}` echo "Processin sample ${sampe}" run_rnacocktail.py quantify \ --quantifier_idx /public1/wangjw/database/TAIR10/Athaliana/\ --1 ${samp}_1.fastq.gz \ --2 ${samp}_2.fastq.gz \ --libtype IU \ --salmon_k 31\ --workdir data \ --salmon $PATH/miniconda3/envs/rnacocktail/bin/salmon \ --threads 10 \ --sample ${sampe} \ --unzip 运行成功 最后结果会存放在 data/salmon-smem下(截图是目前分析的数据),说明配置没有问题。GITHUB地址:https://github.com/xuzhougeng/zgtoolkits/blob/master/requirement_of_rnacocktial.txt 一不小心被我删了。。尴尬

优秀的个人博客,低调大师

hiveql笔记(一)

1、创建表 create table if not exists mydb.employees{ name String COMMENT 'Employee name', salary FLOAT COMMENT 'Empolyee salary', subordinates APPAY<STRING> COMMENT 'Names of subordinates', deductions MAP<STRING,FLOAT> COMMENT 'Keys are deductions names,values are percentages' address STRUCT<street:STRING,city:String,state:STRING,zip:INT> COMMENT 'Home address') COMMENT 'Desription of the table' TBLPROPERITES ('creator '='me','created_at'='2012-01-02 10:00:00',...) LOCATION '/usr/hive/warehouse/mydb.db/employees'; Hive 会自动添加两个表属性:一个是last_modified_by,其保存着最后修改这个表的用户的用户名。另一个是last_modified_time,其保存着最后修改的新纪元时间秒。 2、查看表的详细表结构信息 DESCRIBE EXTENDED mydb.employees; //在表名后添加字段的名称,使用extended关键字也不会增加更多的输出信息。 DESCRIBE mydb.employees.salary; 3、外部表 CREATE EXTERNAL TABLE IF NOT EXISTS stocks ( exchange STRING, symbol STRING, ymd STRING, price_open FLOAT, price_high FLOAT, price_low FLOAT, price_close FLOAT, volume INT, price_adj_close FLOAT) ROW FORMAT DELIMITED FIELDS TERMINATED BY ‘,‘ LOCATION '/data/stocks'; 关键字EXTENAL告诉hive这个表是外部的,而后面的LOCATION..子句则用于告诉HIVE数据位于哪个路径下。 //还可以对一张存在的表进行结构复制(而不会复制数据) CREATE EXTERNAL TABLE IF NOT EXISTS mydb.employees3 LIKE mydb.employees LOCATION '/path/to/data'; 4、分区表、管理表 CREATE TABLE employees ( name String, salay FLOAT, subordinates APPAY<STRING>, deductions MAP<STRING,FLOAT>, address STRUCT<street:STRING,city:STRING,state:STRING,zip:INT> ) PARTITIONED BY (country STRING,state STRING); 分区表改变了Hive对数据存储的组织方式,这个表会有一个exployees目录与之对应,每个分区都有一个partXX //可以使用show partitions命令查看表中存在的所有分区: SHOW PARTITIONS employees; //如果表中存在很多的分区,而只想查看是否存储某个特定分区键的分区的话,还可以在命令上添加指定了一个或多个特定分区字段值的PARTITION子句: SHOW PARTITIONS employees PARTITION(country='US'); SHOW PARTITIONS employees PARTITION(country='US',state='AK'); 5、外部分区表 CREATE EXTERNAL TABLE IF NOT EXISTS log_messages ( hms INT, severity STRING, server STRING, porcess_id STRING, message STRING) PARTITIONED BY (year INT,month INT,day INT) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t'; ) //添加一个分区 ALTER TABLE log_messages ADD PARTITION(year = 2012,month = 1,day =2 ) LOCATITION 'hdfs://master_server/data/log_message/2012/01/02'; //将一个月前的分区数据拷贝到其他集群 hadoop distcp /data/log_message/2011/12/02 s3n://ourbucket/logs/2011/12/02 //修改表,将分区路径指向到S3路径: ALTER TABLE log_messages PARTITION(year = 2011,month = 12,day = 2) SET LOCATION 's3m://ourbucket/logs/2011/01/02'; //DESCRIBE EXTENDED log_message 语句会将分区键作为表的模式的一部分,和partitionKeys列表的内容同时进行显示: DESCRIBE EXTENDED log_messages; 6、删除表 DROP TABLE IF EXISTS employees; //这里有个知识点,如果开启了Hadoop回收站功能(默认是关闭),那么数据将会转移到用户在分布式文件系统中的用户跟目录下的.Trash目录下,也就是HDFS中的/usr/$USER/.Trash目录,如果要开启这个功能,需要配置fs.trash.internal的值。设置一个合理的整数,比如如果设置1440,那么就表示是24小时。 7、表重命名 ALTER TABLE log_messages RENAME TO logmsgs; 8、修改列信息 ALTER TABLE log_messages CHANGE COLUMN hms hours_minutes_seconds INT COMMENT 'The hours,minutes, and seconds part of the timestamp' AFTER severity; //这里说明,如果想将这个字段移动到第一个位置,需要使用FIRST关键字替代AFTER other_column子句即可。 9、增加列 ALTER TABLE log_messages ADD COLUMNS ( app_name STRING COMMENT 'Application name', session_id LONG COMMENT 'The current session id'); 10、删除或者替换列 //移除了之前所有的字段并重新指定了新的字段: ALTER TABLE log_messages REPLACE COLUMNS ( hours_mins_secs INT COMMENT 'hour,minute,seconds from timestamp', serverity STRING COMMENT 'The message severity' message STRING COMMENT 'The rest of the message'); 11、修改存储属性 ALTER TABLE log_messages PARTITION(year = 2012,month = 1,day = 1) SET FILEFORMAT SEQUENCEFILE; 12、通过查询语句向表中插入数据 INSERT OVERWRITE TABLE employees PARTITION (country = 'US' , state = 'OR' ) SELECT * FROM staged_employees se WHERE se.cnty = 'US' AND se.st = 'OR'; //如果是非分区表,之前表中的内容将会被覆盖掉 13、动态分区插入 //指定了country字段的值为静态的US,而分区字段state是动态值。 INSERT OVERWRITE TABLE employees PARTITION (country='US',state) SELECT ...,se.cnty,se.st FROM staged_employees se WHERE se.cnty = 'US'; (静态分区键必须出现在动态分区键之前) //延伸动态分区属性: hive.exec.dynamic.partition false 设置成true,表示开启动态分区功能 hive.exec.dynamic.partition.mode strict 设置成strict,表示允许所有分区都是动态的 hive.exec.max.dynamic.parition.pernode 100 每个mapper或reducer可以创建的最大动态分区个数。如果某个mapper或reducer尝试创建大于这个值得分区的话则会抛出一个致命错误信息。 hive.exec.max.dynamic.partitions +1000 一个动态分区创建语句可以创建的最大动态分区个数。如果超过这个值则会抛出一个致命错误信息。 hive.exec.max.created.files 100000 全局可以创建的最大文件个数。 eg: set hive.exec.dynamic.partition=true; set hive.exec.dynamic.partition.mode=nonstrct; set.hive.exec.max.dynamic.partitions.pernode=1000; INSERT OVERWRITE TABLE employees PARTITION (country,state) SELECT ...,se.cty,se.st FROM staged_employees se; 14、单个查询语句中创建表并加载数据 CREATE TABLE ca_employees as SELECT name,salary,address FROM employees WHERE se.state = 'CA'; 15、导出数据 hadoop fs -cp sorce_path target_path //也可以使用INSERT...DIRECTORY... INSERT OVERWRITE LOCAL DIRECTOR 'tmp/ca_employees' SELECT name,salary,address From employees WHERE se.state = 'CA'; 参考文献《Hive编程指南》

优秀的个人博客,低调大师

ISIS学习笔记

背景介绍 OSPF“表兄弟”,很另类,完全不同于OSI、TCP/IP协议栈,然而可以完全互相使用“双栈协议”。Intermediate system to intermediate system中间系统到中间系统 CLNS:ConnectionlessNetwork Service面向无连接的网络服务 IP ——àCLNS OSPF——àISIS ARP ——àESIS 链路状态路由协议,基于OSI七层模型设计 OSI参考模型确定了网络的标准,没有定义任何一个通信协议的细节但是提供了设计指导原则。 OSI网络层定义了两种服务:CONS与CLNS 基于CLNS的服务由以下网络层协议支持 – CLNP:无连接网络层协议 – ES-IS:终端系统-中间系统路由协议 – IS-IS :中间系统-中间系统路由协议 与OSPF拥有很多共同特性 – 维护一个链路状态数据库,使用SPF算法计算最短路径 – 使用Hello包形成和维护邻居关系 – 使用区域的概念来构建一个层次化的网络结构 – 支持手动汇总与VLSM – 在广播多路访问网络中都选举指定路由器 – 都具备认证功能 IS-IS基本术语 – IS:中间系统,相当于TCP/IP中的路由器 – ES:终端系统,相当于TCP/IP中的主机系统 – LSP:链路状态数据库报文 – NPDU:网络协议数据单元,ISO网络层报文,同IP包 – NSAP:网路服务接入点,即ISO中网络层地址 – (也称为CLNP地址) 地址格式 <8byte~20byte> DP:AFI、IDI DSP:High-order DSP、System-ID、NSEL Area:标识此IS端所在的区域 System:ID唯一标识次区域的IS 49.000x.0000.0000.000Y.00 AFI AreaID System-ID NSEI X->区域 Y->服务接口 基本原理 相同点 算法:SPF算法 特征:链路状态 无类:VLSM/CIDR 不相同 ①区域设计 OSPF:ABR链路两个区域 ISIS:没有明显的区域边界 ②分组类型 OSPF:非常多 ISIS:少,精简 ③路由器类型 OSPF 骨干路由器 常规路由器 ABR ISIS L1路由器 L2路由器 L1/2路由器 六种路由器是互相对应的 四种类型的路由 基本特征 属于网络层 链路状态协议 无类协议 最佳路径 AD:115àTCP/IP,115àOSI Metric:每跳,Metric为10 窄度量Narrow Metric接口2^6,总2^10 宽度量wide Metric接口2^24,总2^32 基本部署 接下去大都相同的,在开启clns路由,部署isis协议,在相应接口下部署isis 注意这个不同于osi模型,我们甚至查看不了路由 Ping的未知的地址回复也是不同的效果 然而仍然有表可查的 L1是常规区、L2骨干区 连通性测试 抓包之后发现不再是ICMP,这个也印证了ping不只是ICMP(其实TCP、ARP也可以~~) 修改区域类型 这里在L1,L1/2里面虽然都维护着R2的信息,但是对于R2来说根本没必要维护着R4的信息啊,所以就出现优化点。同理对于R4来说仅仅需要维护L2的信息即可 修改接口类型 我们知道R2是L1,R1、R3是L1/2,然而时不时R2会发送L2Hello包以维持R4的信息,所以需要相应的在接口下修改接口类型 结果 这里虽然没有路由信息竟然可以ping通!原因是什么?抓包可发现数据包的大小不同,但是在包里面却没有发现相应的路由信息啊。答案是,由于ISIS本身的算法,L1会寻找离它最近的L1/2(即默认路径)然后,通过该L1/2进行选路 修改度量值 双栈协议的体现 项目工程中很经常遇到的,集成ISIS,一般不会玩前面所说的纯ISIS。在这之前首先要给所有的路由器配上地址 结果 然而路由表、拓扑表中仍然没有信息 开始配置 根据拓扑,分别为其配置IP地址信息 不一一列举了,反正可以互相ping通就对了 提问 这两个命令意味着啥? ISIS路由分组 在R2与交换机之间进行抓包,可发现 从这个地方可以发现: 如果我们没有做优化,L1/2会向L1转发L2的hello事实上这些数据包对于R2来说是没有意义的,可以称之为垃圾包,这个就是需要进行链路优化的地方 Hello包发送非常密集,可以称之为”话痨“ Hello包 每3s发送一次,很消耗带宽,但可以很有效的报告当前的链路状态 CSNP包(DBD包) 每10s发送一次 PSNP 这个需要在串口状态下才能抓到,ISIS只认两种网络类型P2P、BMA ISIS DIS机制 vs OSPFDR机制 1、ISIS无备份机制 2、ISIS的DIS可抢占 3、ISIS默认优先级为64 4、ISIS的DIS hello间隔3.3s,Holdtime 10s R7R8一样的设置 LSP包 抓到这个包需要创建一个环回接口,然后才能抓到 虽然LSP是链路状态协议,但是完全可以说这个是EIGRP,因为几乎把所有的信息都公布出来了 ISIS路由算法 因为在OSPF的SPF算法的基础上多了PRC算法 ①算法优势:引入PRC,支持网络架构更大,网络更稳定; ②拓扑优势:区域设计不像OSPF有物理骨干区域的限制,ISIS的骨干区域相对比较灵活; ③分组优势:引入TLV 类型长度值的概念,可以更好的拓展新的特性和功能 ④迁移性:ISIS迁移到IPV4和IPV6,几乎无缝切换 路由汇总 汇总这个话题老生常谈~~ 汇总 需要在两个端口写,统一汇总信息,看效果 路由认证 跟EIGRP几乎没有区别 被动接口 跟前面的一样~~isis进程下使用passtive-interface 默认路由 ISIS路由泄露 根据ISIS的寻路算法,假如我们使用R2pingR7那么他们返回的路径是 因此需要相应的通过ACL人为的规定流量路径。哈?为啥要规定?不规定的话,路由拓扑就会被泄露啦 ISIS区域迁移 注意:由前面的配置经验可知,如果在相应进程下通告路由信息的话,原来的信息会被覆盖的,然而在ISIS里面却不会发生这样的情况 区域迁移的意义在于 OSPF与ISIS对比 共同之处 1 都是链路状态路由协议,都要求区域内的路由器交换链路状态信息,链路状态信息被收集到链路状态数据库中 2 都是用了一种实现路由选择信息交换相似机制 3 都在广播网络中选择指定路由器来控制扩散并降低这类介质中多对多邻接的系统资源需求 4 都是基于链路状态库中的信息,采用几乎相同的算法-SPF算法来计算最佳路由 5 都支持两个分层路由选择 6 都支持IP前缀的无类路由选择(支持VSLM) 7 都是共有协议 不同之处: ISIS OSPF 1 ISIS支持ISOCLNP和IP两种网络 仅支持IP网络 2 ISIS报文封装在数据链路层帧中 封装在IP包中 3 ISIS支持ISO无连接网络环境,注意数据链路是ISO协议(在以太网上数据链路类型为FEFE),在ISO协议栈中ISIS网络层协议ID是0x83 OSPF封装在IP报文当中,协议号89 4 ISIS路由器通告包含直连邻居及路由信息的TLV的LSP,使用LSP承载所有的路由选择信息 OSPF使用不同类型的LSA承载不同的路由信息,LSA被封装进LSU通告给邻居 5 ISIS数据包利用TLV字段承载所有易于扩散的信息 OSPF只有LSA可扩展,而LSA扩展性太差 6 ISIS可以忽略它所不支持的TLV 网络中的路由器为了进行适当的操作必须识别所有的LSA 7 ISIS数据包可以承载多个TLV,只有一个包头,节省带宽 1类,2类LSA可以承载多个IP前缀;3类,4类,5类LSA只能承载单个IP前缀,如果需要发送多个IP前缀信息,需要多个LSA 8 对于所有实际应用,ISIS仅支持广播和点对点链路。不支持NBMA链路。在NBMA环境下,可配置为p2p子接口或者广播链路(如果是全互联的连接方式)。 OSPF支持如下网络类型:p2p、广播、NMBA、点到多点和按需链路。 9 仅仅在广播链路实现3步邻接关系,IETF正在努力指定点到点链路的3步进程。 OSPF邻接关系的建立涉及到一个更加复杂的过程。 10 最初数据库同步在邻接关系建立后进行。 最初数据库同步在邻接关系形成前进行。 11 ISIS路由器只属于一个特定区域。 OSPF基于接口划分区域,路由器可属于不同的区域。 12 区域的边界在链路 区域的边界在路由器上。 13 默认情况下ISIS区域是stub区域,规定了level2到level1的路由泄漏 默认情况下,ospf区域不是stub,可以配置成为stub。 14 ISIS仅支持在点对点链路上可靠扩散,广播链路的扩散是不可靠的。然而通过DIS周期性的广播是可靠的。 OSPF确保所有链路上扩散的可靠性。 15 DIS无备份DIS,DIS可以被抢占,DIS以3被的频率发送HelloPDU 有BDR,DR不能被抢占,DR以正常的频率发送HelloPDU 16 默认情况下,ISIS的LSP最大生存时间为1200s刷新间隔为900s,而且定时器值可调。 OSPF的LSA的老化时间为3600s,刷新间隔为1800s,而且是固定值。 17 默认情况下,ISIS的接口cost值为10. 默认情况下,OSPF的保持时间(dead-interval)为40s,而且为了建立邻接关系,必须使双方的保持时间一致。 18 ISIS通过将HelloPDU的大小填充至接口MTU大小来检查双方MTU是否匹配。 OSPF通过在DBD报文中嵌入接口的MTU字段来检查MTU是否匹配。 19 由于ISIS区域中IP前缀是SPF数的叶子,故部分路由计算(PRC)较多,通常这就意味着在一个大的区域中路由处理器的负载较低。 部分SPF被限制用于域间和外部路由,任何要求较小的区域和分层拓扑扩展引起的域间链路动荡导致完全的SPF计算。 20 没有对IP组播路由选择的支持。 MOSPF扩展提供对IP组播路由选择的支持。

优秀的个人博客,低调大师

docker swarm笔记

1 准备节点: node-1 192.168.33.201 node-2 192.168.33.202 node-3 192.168.33.203 node-4 192.168.33.204 2 在每个节点分别安装docker服务。 sudo curl -sSL http://acs-public-mirror.oss-cn-hangzhou.aliyuncs.com/docker-engine/internet | sh - 安装后需要修改dockerd启动参数,增加: -H 0.0.0.0:2375 这个很重要,否则manager无法连接到节点。 docker 1.12以前,需要自己使用swarm镜像启动环境,这里整理一下。如果你已经是1.12+了,请直接跳到第4节。 3 Docker1.12以前的swarm-swarm container 3.1 在node-1启动swarm容器 docker pull warm 创建token $ docker run --rm swarm create 3445719bd06a6a19950c8a034f276cab 加入集群 docker run -d swarm join --addr=192.168.33.201:2375 token://3445719bd06a6a19950c8a034f276cab 3.2 在node-2启动swarm容器 重复node-1操作。记得修改IP地址。 3.3 查看集群节点 在其中一个节点查看集群 $ docker run --rm swarm list token://3445719bd06a6a19950c8a034f276cab 192.168.33.202:2375 192.168.33.201:2375 3.4 集群管理 3.4.1 启动管理节点 在测试机上开启管理程序。如果在node-1或node-2上,建议使用非2375端口,如:-p 5000:2375 $ docker run -d -p 2375:2375 swarm manage token://3445719bd06a6a19950c8a034f276cab 3eb0aec4c9917725c098d102aa12767803db59f869052c611d3be160971df534 3.4.2 查看集群状态 $ docker -H 192.168.33.203:2375 info Containers: 6 Running: 6 Paused: 0 Stopped: 0 Images: 4 Server Version: swarm/1.2.5 Role: primary Strategy: spread Filters: health, port, containerslots, dependency, affinity, constraint Nodes: 2 test1: 192.168.33.201:2375 └ ID: 52BN:6F2E:GMCP:4JYC:H3IW:VEUM:3ART:TAUE:4CLW:GR3I:S4KI:LKSR └ Status: Healthy └ Containers: 3 (3 Running, 0 Paused, 0 Stopped) └ Reserved CPUs: 0 / 1 └ Reserved Memory: 0 B / 1.018 GiB └ Labels: kernelversion=4.4.0-51-generic, operatingsystem=Ubuntu 16.04.1 LTS, storagedriver=aufs └ UpdatedAt: 2017-01-09T06:12:52Z └ ServerVersion: 1.12.5 test2: 192.168.33.202:2375 └ ID: I6N6:WJZH:B3S3:DW6E:MIPP:FIKF:EGIX:RAVH:XNKU:LHGL:WAE7:SBZ2 └ Status: Healthy └ Containers: 3 (3 Running, 0 Paused, 0 Stopped) └ Reserved CPUs: 0 / 1 └ Reserved Memory: 0 B / 1.018 GiB └ Labels: kernelversion=4.4.0-51-generic, operatingsystem=Ubuntu 16.04.1 LTS, storagedriver=aufs └ UpdatedAt: 2017-01-09T06:13:40Z └ ServerVersion: 1.12.5 Plugins: Volume: Network: Swarm: NodeID: Is Manager: false Node Address: Security Options: Kernel Version: 4.4.0-51-generic Operating System: linux Architecture: amd64 CPUs: 2 Total Memory: 2.035 GiB Name: cfa479ee8a5e Docker Root Dir: Debug Mode (client): false Debug Mode (server): false WARNING: No kernel memory limit support 其中Status: Healthy表示节点正常,如果前面提及的dockerd启动项未设置,这里将会是:Pending,服务不可用。 3.5 测试集群 3.5.1 查看容器 $ docker -H 192.168.33.203:2375 ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 3.5.2 设置命令别名 如果是2375,端口号可以省略。为了使用方便可以创建一个命令别名: alias docker-swarm='docker -H 192.168.33.203' 再测试: $ docker-swarm images REPOSITORY TAG IMAGE ID CREATED SIZE 3.5.3 启动容器 docker-swarm run -d --name web1 nginx docker-swarm run -d --name web2 nginx docker-swarm run -d --name web3 nginx docker-swarm run -d --name web4 nginx 3.5.4 查看整个集群的容器 $ docker-swarm ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 478206c91145 nginx "nginx -g 'daemon off" Less than a second ago Up Less than a second 80/tcp, 443/tcp test1/web4 07a70b5ba0c2 nginx "nginx -g 'daemon off" 4 seconds ago Up 4 seconds 80/tcp, 443/tcp test2/web3 dbd596f5464a nginx "nginx -g 'daemon off" 18 seconds ago Up 18 seconds 80/tcp, 443/tcp test2/web2 04c23c28bafb nginx "nginx -g 'daemon off" 54 seconds ago Up 54 seconds 80/tcp, 443/tcp test1/web1 查看NAMES数据,形如:test1/webx,其中test1表示节点名字 4 Docker1.12以后的swarmkit Docker 1.12 在 2016 年 7 月 28 日正式 GA,除了大量的在使用上的改进和 bug 修复外,最引人瞩目的是Docker原生支持了 Swarm 模式,而不是将Swarm作为一个容器对集群进行管理。而docker1.12的操作命令并不向下兼容,于是过去所有创建swarm集群的文档都不能参考了。 4.1 几个概念 4.1.1 节点类型 docker-swarm 把节点分为manager和worker,顾名思义,manager是管理节点,worker是工作节点。 4.1.2 service 区别于旧的swarm管理容器,新的docker-swarm抽象了一个service的概念,有点类似于kubernates的pod,它是管理的最小单元。 一个service是一个以上的容器的集合。 4.2 搭建swarm环境 仍然使用前面的节点服务来测试,第1、2节的工作还是需要有效的。 4.2.1 在node-1节点创建swarm环境 $ docker swarm init --advertise-addr 192.168.33.201 Swarm initialized: current node (9vpgoqj65y3kqo52jj3y6gcnj) is now a manager. To add a worker to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 To add a manager to this swarm, run 'docker swarm join-token manager' and follow the instructions. 他是使用Raft来管理节点的。事实上,如果你只有一个外网地址(即除了lo和docker网络等虚拟网络之外没有其他网络接口),可以直接执行:docker swarm init 4.2.2 将node-2节点加入到创建的swarm cluster 在node-2 执行: $ docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 This node joined a swarm as a worker. 4.2.3 在更多节点加入swarm cluster token没有记录下来?没关系,在node-1执行如下命令查看完整的命令提示: $ docker swarm join-token worker To add a worker to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 如果要加入的是manager节点,则如下查看: $ docker swarm join-token manager To add a manager to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-37rg2khjxgk1iis6dfds48b0s \ 192.168.33.201:2377 4.3 集群管理 4.3.1 查看集群节点 在manager节点: $ docker node list ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 9vpgoqj65y3kqo52jj3y6gcnj * test1 Ready Active Leader dc5t7rc04a69rzuahky6qh53x test2 Ready Active e4k1fjd93ukncipzy9cer0lcg test3 Ready Active 可以看到,一共有三个节点,node-1自身已经是一个worker了,他的MANAGER是Leader。 该命令只有在manager节点才有权限使用,如果你想在node-3上使用,则需要让node-3成为manager。。 一种方法是让node-3先从cluster重新以manager身份加入cluster。 $ docker swarm leave Node left the swarm. 注意:有时自己退出重新加入,反复操作,会让manager混乱,导致一些问题。如,test3已经leave,但manager看到它还是Reading状态,无法删除掉。docker node rm test3只能删除down状态的节点, 加上--force不是那么好使。 4.3.2 节点角色转换 接上,将node-3转换为manager最简单的方法是,角色提权:是在manager中把node-3的角色提升为manager: vagrant@test1:~$ docker node promote test3 Node test3 promoted to a manager in the swarm. vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 5awz4cd6auchp0knq0iljfudh test2 Ready Active a02rv4zuex14p03erer1h6zkz * test1 Ready Active Leader cq9q1su8ipkp9w80sabv16mmz test3 Ready Active Reachable 与之相反的就是降权: 一种方法是在manager中把node-3的角色提升为manager: vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 5awz4cd6auchp0knq0iljfudh test2 Ready Active a02rv4zuex14p03erer1h6zkz * test1 Ready Active Leader cq9q1su8ipkp9w80sabv16mmz test3 Ready Active 从安全性考虑,一个集群应该指定多个manager。但需要注意的是,如果一个manager宕机,那么另一个manager需要接管服务,需要至少有三个以上存活的节点。 4.3.3 删除节点 docker node rm [node_id] 如果节点状态是Down,可以直接删除,否则可以增加--force开关强制删除。 4.3.4 manager容灾测试 再增加一个node-4,并将node-3提权为manager。 vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg * test1 Ready Active Leader 8v5r3wb9sujlluqda6jv981ut test3 Ready Active Reachable 关闭node-1,在node-3检查节点: vagrant@test3:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg test1 Ready Active Unreachable 8v5r3wb9sujlluqda6jv981ut * test3 Ready Active Leader 此时test3接管Leader了。 启动node-1,检查节点: vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg * test1 Ready Active Reachable 8v5r3wb9sujlluqda6jv981ut test3 Ready Active Leader node-1已经变成了Reachable。 4.4 使用入门 4.4.1 创建service 折腾了半天,办点正事吧。 vagrant@test1:~$ docker service create --name web1 nginx bojkn65bzwpv2az82y3p7qssv vagrant@test1:~$ docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 0/1 nginx #稍等片刻 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 1/1 nginx REPLICAS 表示一共指定了1个副本,开始启动了0个,启动完成后,变成1/1。 4.4.2 查看服务中的容器 vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 3 minutes ago 4.4.3 调整容器副本 我们可以把web1服务中的容器多启动几个副本,如6个: vagrant@test1:~$ docker service scale web1=6 web1 scaled to 6 vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 4 minutes ago chy2qbqz3pbboyxxz90gb9vxb web1.2 nginx test3 Running Preparing 12 seconds ago 2ae4vz4lx8zcpacjepdzcxx5y web1.3 nginx test1 Running Preparing 13 seconds ago dfg1pul4brwa8xqutls2dddm1 web1.4 nginx test4 Running Preparing 13 seconds ago 2o39qlezex2ddk8ie0bzs9drv web1.5 nginx test4 Running Preparing 13 seconds ago bsduc9qvegikjs8fj94k4ogi8 web1.6 nginx test2 Running Running 6 seconds ago vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 2/6 nginx 其中的2/6以及前面看到的列表信息状态可以看出,我们指定了6个副本,目前web1.1和web1.6已经启动完成,其他还在Preparing。 6个副本中分别在test1启动了1个、test2启动了2个、test3启动了1个、test4启动了2个。 过一会再刷新: vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 7 minutes ago chy2qbqz3pbboyxxz90gb9vxb web1.2 nginx test3 Running Preparing 3 minutes ago 2ae4vz4lx8zcpacjepdzcxx5y web1.3 nginx test1 Running Preparing 3 minutes ago dfg1pul4brwa8xqutls2dddm1 web1.4 nginx test4 Running Running 9 seconds ago 2o39qlezex2ddk8ie0bzs9drv web1.5 nginx test4 Running Running 9 seconds ago bsduc9qvegikjs8fj94k4ogi8 web1.6 nginx test2 Running Running 3 minutes ago vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 4/6 nginx 最终会完全启动。 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 6/6 nginx 处理scale子命令,还可以使用update子命令完成同样的工作: vagrant@test1:~$ docker service update web1 --replicas=3 web1 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 2/3 nginx 4.5 负载均衡 多个副本容器启动后, swarm集群的service: 公共的端口会暴露在每一个swarm集群中的节点服务器上. 请求公共端口时,会负载均衡到所有的sevice实例上. 负载均衡模式有两种,vip和dnsrr,可以在出啊构建服务时指定: vagrant@test1:~$ docker service create --name web1 --replicas=6 --endpoint-mode=dnsrr nginx 4dx616zii0vgrz4s5oi2rwgsp 如果使用vip模式,应该有VirtualIP: $ docker service inspect --format='{{.Endpoint.VirtualIPs}}' web1 [] 怎么木有?你可能忘记在创建服务时发布端口了。 vagrant@test1:~$ docker service create --name web1 --replicas=6 -p 8888:80 nginx 8qlkxx7v643z7aenfrmfnksxk vagrant@test1:~$ docker service inspect --format='{{.Endpoint.VirtualIPs}}' web1 [{9h4hrcm7bv1ijdpzpyezy4pld 10.255.0.6/16}] 可以直接访问”http://10.255.0.6:8080“吗?no,它只是为容器间通信的,你可以访问任一台节点的IP:http://192.168.33.201:8888 4.6 启动时指定副本数 vagrant@test1:~$ docker service create --name nginx1 --replicas 2 nginx c79881b02bd7zrfg74a9qp8ji vagrant@test1:~$ docker service ps nginx1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 1ghmia00xkxucrisadlwyitv9 nginx1.1 nginx test3 Running Running 5 seconds ago 193mdx2xcja4qv8s9ssakt8w1 nginx1.2 nginx test4 Running Running 6 seconds ago 4.7 swarm网络 由于容器在不同的docker主机上,swarm是如何保证网络层的互通呢?swarm是使用overlay网络来解决这个问题的。 vagrant@test1:~$ docker network ls NETWORK ID NAME DRIVER SCOPE 180d624cf798 bridge bridge local 4d225a25b2b4 docker_gwbridge bridge local 6c1889cd666a host host local 9h4hrcm7bv1i ingress overlay swarm 839e8db03b09 none null local 其中的swarm是缺省创建的overlay网络。 你可以自己创建网络来管理一组服务的互通。 vagrant@test1:~$ docker network create --driver overlay test 17wzxz29pxdf6are8an6u0ep2 vagrant@test1:~$ docker network ls |grep test 17wzxz29pxdf test overlay swarm 在指定子网启动服务 vagrant@test1:~$ docker service create --network test --name myservice hello-world 5kz0imiep9fztvsev0c101568 vagrant@test1:~$ docker service ps myservice ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 6zww5ci2jhnvy05aj68ohb3do myservice.1 hello-world test2 Running Preparing 5 seconds ago 通过docker service inspect myservice返回的json中Networks元素可以看到网络信息,Target正是前面创建的test接口的id: "Networks": [ { "Target": "17wzxz29pxdf6are8an6u0ep2" } ] 你只要保证你启动的多个服务在同一个网络接口,就可以保证他们之间互相通信。 4.8 小结 swarmkit的引入,在docker中引入了三个子命令: docker swarm——swarm集群搭建 docker service——服务管理 docker node——集群节点管理 4.8.1 docker swarm 子命令 查看子命令 vagrant@test1:~$ docker swarm –help init 初始化swarm集群 join 将当前节点加入到集群中 join-token 管理加入token update 动态更新swarm配置 leave 当前节点主动退出集群(仅限worker节点) 4.8.2 docker service 子命令 查看子命令 vagrant@test1:~$ docker service –help create 创建服务 inspect 显示服务详情 ps 列出服务中的容器 ls 列出所有服务及简介 rm 删除服务 scale 调整服务的副本数 update 动态更新服务配置 4.8.3 docker node 子命令 查看子命令 vagrant@test1:~$ docker node –help demote 管理节点为指定子节点降权 inspect 显示节点详情 ls 列出集群中的节点 promote 管理节点为指定子节点提权 rm 删除一个节点 ps 列出指定子节点中running的容器 update 动态更新节点配置 4.8 使用帮助 本节实际上只是给出了查看帮助的方法。想了解某个命令的使用,只需要在子命令后面加上--help即可,逐级深入。如想了解docker node的子命令rm,则是: vagrant@test1:~$ docker node rm --help Usage: docker node rm [OPTIONS] NODE [NODE...] Remove one or more nodes from the swarm Aliases: rm, remove Options: --force Force remove an active node --help Print usage 祝好运。

优秀的个人博客,低调大师

hadoop笔记一

Hadoop是Apache软件基金会旗下的一个开源分布式计算平台。 是 Apache 下的一个项目,由 HDFS 、 MapReduce 、 HBase 、 Hive 和 ZooKeeper 等成员组成。其中, HDFS 和 MapReduce 是两个最基础最重要的成员 Hadoop 由许多元素构成。其最底部是 Hadoop Distributed File System [3] (HDFS),它存储 Hadoop 集群中所有存储节点上的文件。HDFS(对于本文)的上一层是 MapReduce 引擎,该引擎由 JobTrackers 和 TaskTrackers 组成 ​hadoop两部分组成 1、分布式文件系统( HDFS Hadoop distributed FileSystem ) 2、MapReduce ​hadoop两大类角色: 1、master 主服务器 2、salve 子服务器 1、分布式文件系统 1、NameNode 作为主服务器,管理文件系统的命名空间和客户端对文件系统的访问操作(CRUD) 统计数据需要多大的空间,多少个DataNode块,进行存储数据 2、DataNode 管理存储的数据 数据真正储存的节点内容、或者物理地址 存储(blockID-块地址, data- 数据) hadoop启动时会将dataNode节点的数据主动上传到NameNode空间中,让所有的数据都让nameNode维护起来,DataNode与NameNode保持心跳(实时通信)实现数据共享、 ​2、 MapReduce 分布式计算 和 任务处理 JobTrackers 和 TaskTrackers 组成 ​1、Map 接受数据并且将数据抓换成key \ value形式保存 2、Reduce 对Map进行逻辑处理 排序 、 计算、处理的逻辑处理 同时又两个集中处理的子任务 1、 JobTracker、 分解任务的执行 2、TaskTracker、 任务的执行(分解出来的任务执行(存储在硬盘或DataNode)) 假设输入域是 one small step for man,one giant leap for mankind。在这个域上运行 Map 函数将得出以下的键/值对列表: (one,1) (small,1) (step,1) (for,1) (man,1) MapReduce 流程的概念流 (one,1) (giant,1) (leap,1) (for,1) (mankind,1) 如果对这个键/值对列表应用 Reduce 函数,将得到以下一组键/值对: (one,2) (small,1) (step,1) (for,2) (man,1)(giant,1) (leap,1) (mankind,1) ​ HDFS在MapReduce任务处理过程中提供了文件操作和存储等支持, MapReduce在HDFS的基础上实现了任务的分发、跟踪、执行等工作,并收集结果

优秀的个人博客,低调大师

特征工程个人笔记

特征工程 1.概述 2方法 2.1去除唯一性 2.2处理缺失值 2.3 特征编码 2.3.1特征二元化 2.3.2独热编码(One-HotEncoding) 2.3.3标签编码 2.3.4多项式特征 2.3.5交叉验证 2.3.6网格搜索 2.3.7管道机制 2.4数据标准化、正则化 2.5 特征选择(降维) 1.概述 在工程实践中,我们得到的数据会存在有缺失值、重复值等,在使用之前需要进行数据预处理。数据预处理没有标准的流程,通常针对不同的任务和数据集属性的不同而不同。数据预处理的常用流程为:去除唯一属性、处理缺失值、属性编码、数据标准化正则化、特征选择、主成分分析。 2方法 2.1去除唯一性 唯一属性通常是一些id属性,这些属性并不能刻画样本自身的分布规律,所以简单地删除这些属性即可。 2.2处理缺失值 缺失值处理的三种方法:直接使用含有缺失值的特征;删除含有缺失值的特征(该方法在包含缺失值的属性含有大量缺失值而仅仅包含极少量有效值时是有效的)→dropna();缺失值补全→fillna( )。判断是否缺失→isnull( ) 常见的缺失值补全方法:均值插补、同类均值插补、建模预测、高维映射、多重插补、极大似然估计、压缩感知和矩阵补全。 (1)均值插补 如果样本属性的距离是可度量的,则使用该属性有效值的平均值来插补缺失的值; (2)同类均值插补 首先将样本进行分类,然后以该类中样本的均值来插补缺失值。 (3)建模预测 将缺失的属性作为预测目标来预测,将数据集按照是否含有特定属性的缺失值分为两类,利用现有的机器学习算法对待预测数据集的缺失值进行预测。 该方法的根本的缺陷是如果其他属性和缺失属性无关,则预测的结果毫无意义;但是若预测结果相当准确,则说明这个缺失属性是没必要纳入数据集中的;一般的情况是介于两者之间。 (4)高维映射 将属性映射到高维空间,采用独热码编码(one-hot)技术。将包含K个离散取值范围的属性值扩展为K+1个属性值,若该属性值缺失,则扩展后的第K+1个属性值置为1。 这种做法是最精确的做法,保留了所有的信息,也未添加任何额外信息,若预处理时把所有的变量都这样处理,会大大增加数据的维度。这样做的好处是完整保留了原始数据的全部信息、不用考虑缺失值;缺点是计算量大大提升,且只有在样本量非常大的时候效果才好。 (5)多重插补(MultipleImputation,MI) 多重插补认为待插补的值是随机的,实践上通常是估计出待插补的值,再加上不同的噪声,形成多组可选插补值,根据某种选择依据,选取最合适的插补值。 (6)压缩感知和矩阵补全 (7)手动插补 插补处理只是将未知值补以我们的主观估计值,不一定完全符合客观事实。在许多情况下,根据对所在领域的理解,手动对缺失值进行插补的效果会更好。 2.3 特征编码 2.3.1特征二元化 特征二元化的过程是将数值型的属性转换为布尔值的属性,设定一个阈值作为划分属性值为0和1的分隔点。二进制转化-Binarizer 2.3.2独热编码(One-HotEncoding) from sklearn.preprocessing import OneHotEncoder 独热编码采用N位状态寄存器来对N个可能的取值进行编码,每个状态都由独立的寄存器来表示,并且在任意时刻只有其中一位有效。 独热编码的优点:能够处理非数值属性;在一定程度上扩充了特征;编码后的属性是稀疏的,存在大量的零元分量。 pandas的独热编码: pandas.get_dummies(data, prefix=None, prefix_sep=’_’, dummy_na=False, columns=None, sparse=False, drop_first=False) data : array-like, Series, or DataFrame 输入的数据 prefix : string, list of strings, or dict of strings, default None get_dummies转换后,列名的前缀 columns : list-like, default None 指定需要实现类别转换的列名 dummy_na : bool, default False 增加一列表示空缺值,如果False就忽略空缺值 drop_first : bool, default False 获得k中的k-1个类别值,去除第一个 2.3.3标签编码 from sklearn.preprocessing LabelEncoder LabelEncoder可以将标签分配一个0—n_classes-1之间的编码-不考虑数据间平等性 2.3.4多项式特征 from sklearn.preprocessing import PolynomialFeatures 简单理解多项式特征处理:就是一个数据集假如有a,b两个特征,那么对这个特征进行2次多项式特征处理的结果就是(1,ab,a2,b^2)PolynomialFeatures有三个参数: degree:控制多项式的度,也就是多项式的最高次数,int类型 interaction_only: 默认为False,如果指定为True,那么就不会有特征自己和自己结合的项,上面的二次项中没有a2和b2。 include_bias:默认为True。如果为True的话,那么就会有上面的 1那一项。 2.3.5交叉验证 from sklearn.model_selection import cross_val_score 交叉验证种类:详细参考见此贴 train_test_split:在分类问题中,我们通常通过对训练集进行train_test_split,划分成train 和test 两部分,其中train用来训练模型,test用来评估模型,模型通过fit方法从train数据集中学习,然后调用score方法在test集上进行评估,打分;从分数上我们可以知道 模型当前的训练水平如何 —from sklearn.model_selection import train_test_split X_train,X_test, y_train, y_test =train_test_split(train_data,train_target,test_size=0.4, random_state=0,stratify=y_train) train_data:所要划分的样本特征集 train_target:所要划分的样本结果 test_size:样本占比,如果是整数的话就是样本的数量 random_state:是随机数的种子。 其实就是该组随机数的编号,在需要重复试验的时候,保证得到一组一样的随机数。比如你每次都填1,其他参数一样的情况下你得到的随机数组是一样的。但填0或不填,每次都会不一样。 随机数的产生取决于种子,随机数和种子之间的关系遵从以下两个规则: 种子不同,产生不同的随机数;种子相同,即使实例不同也产生相同的随机数。也可以对X,y进行切分K-Fold Cross-validation k折交叉验证:简言之,就是进行多次train_test_split划分;每次划分时,在不同的数据集上进行训练、测试评估,从而得出一个评价结果;如果是5折交叉验证,意思就是在原始数据集上,进行5次划分,每次划分进行一次训练、评估,最后得到5次划分后的评估结果,一般在这几次评估结果上取平均得到最后的评分。k-fold cross-validation ,其中,k一般取5或10。Stratified K-Fold Cross-validation 分层k折交叉验证:解决简单交叉验证带来的问题,所以进行分层交叉验证,保证每次划分中包含类别的比例数和原数据相同。如原数据有三类,比例为1:2:1,那么划分的k折中,每一折中的数据类别保持着1:2:1的比例,这样的验证结果更加可信。 实际上就是改变了交叉验证的划分函数。Leave-one-out Cross-validation 留一法:留一法是一种特殊的交叉验证方式,顾名思义就是每次留下一个样本进行验证,如果样本容量是n 那么k折中的k等于n,进行n折交叉验证,适合小样本数据,耗时,相当于n折交叉验证,改变交叉验证数据划分函数即可。 2.3.6网格搜索 —from sklearn.model_selection import GridSearchCV Grid Search:一种调参手段;穷举搜索:在所有候选的参数选择中,通过循环遍历,尝试每一种可能性,表现最好的参数就是最终的结果。其原理就像是在数组里找最大值。(为什么叫网格搜索?以有两个参数的模型为例,参数a有3种可能,参数b有4种可能,把所有可能性列出来,可以表示成一个3*4的表格,其中每个cell就是一个网格,循环过程就像是在每个网格里遍历、搜索,所以叫grid search) 2.3.7管道机制 —from sklearn.pipeline import Pipeline 注意管道机制里面的参数写法是列表+元组的格式,列表用于存放所有的特征和算法处理的过程,元组具体写每个处理方式,每个管道机制中最多可以在最后添加一个算法,或者不填,格式如下: 2.4数据标准化、正则化 数据标准化 数据标准化是将样本的属性缩放到某个指定的范围。 数据标准化的原因: 某些算法要求样本具有零均值和单位方差; 需要消除样本不同属性具有不同量级时的影响:①数量级的差异将导致量级较大的属性占据主导地位;②数量级的差异将导致迭代收敛速度减慢;③依赖于样本距离的算法对于数据的数量级非常敏感。 min-max标准化(归一化):对于每个属性,设minA和maxA分别为属性A的最小值和最大值,将A的一个原始值x通过min-max标准化映射成在区间[0,1]中的值x’,其公式为:新数据=(原数据 - 最小值)/(最大值 - 最小值) from sklearn.preprocessing import MinMaxScaler z-score标准化(规范化):基于原始数据的均值(mean)和标准差(standarddeviation)进行数据的标准化。将A的原始值x使用z-score标准化到x’。z-score标准化方法适用于属性A的最大值和最小值未知的情况,或有超出取值范围的离群数据的情况。新数据=(原数据- 均值)/ 标准差 from sklearn.preprocessing import StandardScaler 正则化——过拟合解决方案 数据正则化是将样本的某个范数(如L1范数)缩放到到位1,正则化的过程是针对单个样本的,对于每个样本将样本缩放到单位范数。 正则化包括L0、L1,L2正则: L0正则化的值是模型参数中非零参数的个数。 L1正则化表示各个参数绝对值之和,可以将一些参数直接缩减为0 L2正则化标识各个参数的平方的和的开方值,可以将一些参数变得很小但是不为0 参数稀疏一个好处是可以简化模型,避免过拟合。因为一个模型中真正重要的参数可能并不多,如果考虑所有的参数起作用,那么可以对训练数据可以预测的很好,但是对测试数据就只能呵呵了。另一个好处是参数变少可以使整个模型获得更好的可解释性。为什么参数越小,说明模型越简单呢,这是因为越复杂的模型,越是会尝试对所有的样本进行拟合,甚至包括一些异常样本点,这就容易造成在较小的区间里预测值产生较大的波动,这种较大的波动也反映了在这个区间里的导数很大,而只有较大的参数值才能产生较大的导数。因此复杂的模型,其参数值会比较大。 稀疏的参数可以防止过拟合,因此用L0范数(非零参数的个数)来做正则化项是可以防止过拟合的。 从直观上看,利用非零参数的个数,可以很好的来选择特征,实现特征稀疏的效果,具体操作时选择参数非零的特征即可。但因为L0正则化很难求解,是个NP难问题,因此一般采用L1正则化。L1正则化是L0正则化的最优凸近似,比L0容易求解,并且也可以实现稀疏的效果。 L1正则化-lasso(套索)回归 L2正则—Ridge(岭回归) 2.5 特征选择(降维) 从给定的特征集合中选出相关特征子集的过程称为特征选择。 进行特征选择的两个主要原因是: 减轻维数灾难问题; 降低学习任务的难度。 进行特征选择必须确保不丢失重要特征。 常见的特征选择类型分为三类:过滤式(filter)、包裹式(wrapper)、嵌入式(embedding)。 过滤式选择:该方法先对数据集进行特征选择,然后再训练学习器。特征选择过程与后续学习器无关。Relief是一种著名的过滤式特征选择方法。 包裹式选择:该方法直接把最终将要使用的学习器的性能作为特征子集的评价原则。其优点是直接针对特定学习器进行优化,因此通常包裹式特征选择比过滤式特征选择更好,缺点是由于特征选择过程需要多次训练学习器,故计算开销要比过滤式特征选择要大得多。 嵌入式选择 常见的降维方法:SVD、PCA、LDA

优秀的个人博客,低调大师

JavaScript数组排序笔记

工作中经常用到的几种排序方式,整理出来分享给大家以备不时之需。 1、array排序函数sort 使用Array的sort方法。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] arr.sort((a,b) => { return a - b }) console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 2、冒泡排序 将数组中的相邻两个元素进行比较,将比较大(较小)的数通过两两比较移动到数组末尾(开始),执行一遍内层循环,确定一个最大(最小)的数,外层循环从数组末尾(开始)遍历到开始(末尾)。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] for(var i=0;i<arr.length;i++) { for(var j=0;j<arr.length-1;j++) { if (arr[j]>arr[j+1]) { let news = arr[j] arr[j] = arr[j+1] arr[j+1] = news } } } console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 3、选择排序 首先从原始数组中找到最小的元素,并把该元素放在数组的最前面,然后再从剩下的元素中寻找最小的元素,放在之前最小元素的后面,minIndex始终保存着最小值的位置的索引,随着i的自增,遍历的数组长度越来越短,直到完成排序。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] for(var i=0;i<arr.length;i++) { var minIndex=i; for(var j=i+1;j<arr.length;j++) { if(arr[j]<arr[minIndex]){ minIndex=j } } if(minIndex!=i){ var news = arr[i]; arr[i]=arr[minIndex] arr[minIndex]=news } } console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 4、插入排序 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] //假设第0个元素是一个有序的数列,第1个以后的是无序的序列, //所以从第1个元素开始将无序数列的元素插入到有序数列中 for(var i = 1; i < arr.length; i++){ //升序 if(arr[i] < arr[i-1]){ //取出无序数列中的第i个作为被插入元素 var guard = arr[i]; //记住有序数列的最后一个位置,并且将有序数列位置扩大一个 var j = i - 1; arr[i] = arr[j]; //比大小,找到被插入元素所在的位置 while(j >= 0 && guard < arr[j]){ arr[j+1] = arr[j]; j--; } //插入 arr[j+1] = guard; } } console.log(arr) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8] 5、快速排序 快速排序涉及到了递归,将一个数组的排序问题看成是两个小数组的排序问题,而每个小的数组又可以继续看成更小的两个数组,一直递归下去,直到数组长度大小最大为2。 var arr = [2, 8, 5, 0, 5, 2, 6, 7, 2] function quickSort(arr){ if(arr.length<=1){//如果数组只有一个数,就直接返回; return arr; } var num=Math.floor(arr.length/2);//找到中间数的索引值,如果是浮点数,则向下取整 var newValue=arr.splice(num,1);//找到中间数的值 var left=[],right=[]; for(var i=0;i<arr.length;i++){ if(arr[i]<newValue){ left.push(arr[i]);//基准点的左边的数传到左边数组 }else{ right.push(arr[i]);//基准点的右边的数传到右边数组 } } return quickSort(left).concat(newValue,quickSort(right));//递归不断重复比较 } console.log(quickSort(arr)) // 结果:[0, 2, 2, 2, 5, 5, 6, 7, 8]

优秀的个人博客,低调大师

Kubernetes架构学习笔记

Kubernetes是Google开源的容器集群管理系统,其提供应用部署、维护、 扩展机制等功能,利用Kubernetes能方便地管理跨机器运行容器化的应用,是Docker分布式系统的解决方案。k8s里所有的资源都可以用yaml或Json定义。 1 K8s基本概念 1.1 Master Master节点负责整个集群的控制和管理,所有的控制命令都是发给它,上面运行着一组关键进程: kube-apiserver:提供了HTTP REST接口,是k8s所有资源增删改查等操作的唯一入口,也是集群控制的入口。 kube-controller-manager:所有资源的自动化控制中心。当集群状态与期望不同时,kcm会努力让集群恢复期望状态,比如:当一个pod死掉,kcm会努力新建一个pod来恢复对应replicas set期望的状态。 kube-scheduler:负责Pod的调度。 实际上,Master只是一个名义上的概念,三个关键的服务不一定需要运行在一个节点上。 1.1.1 API Server的原理 集群中的各个功能模块通过 apiserver将信息存储在Etcd,当需要修改这些信息的时候通过其REST接口来实现。 1.1.2 Controller Manager的原理 内部包含: Replication Controller Node Controller ResourceQuota Controller Namespace Controller ServiceAccount Controller Token Controller Service Controller Endpoint Controller等 这些Controller通过API Server实时监控各个资源的状态,当有资源因为故障导致状态变化,Controller就会尝试将系统由“现有状态”恢复到“期待状态”。 1.1.3 Scheduler的原理 作用是将apiserver或controller manager创建的Pod调度和绑定到具体的Node上,一旦绑定,就由Node上的kubelet接手Pod的接下来的生命周期管理。 1.2 Node Node是工作负载节点,运行着Master分配的负载(Pod),但一个Node宕机时,其上的负载会被自动转移到其他Node上。其上运行的关键组件是: kubelet:负责Pod的生命周期管理,同时与Master密切协作,实现集群管理的基本功能。 kube-proxy:实现Service的通信与负载均衡机制的重要组件,老版本主要通过设置iptables规则实现,新版1.9基于kube-proxy-lvs 实现。 Docker Engine:Docker引擎,负责Docker的生命周期管理。 1.2.1 kube-proxy的原理 每个Node上都运行着一个kube-proxy进程,它在本地建立一个SocketServer接收和转发请求,可以看作是Service的透明代理和负载均衡器,负载均衡策略模式是Round Robin。也可以设置会话保持,策略使用的是“ClientIP”,将同一个ClientIP的请求转发同一个Endpoint上。 Service的Cluster IP和NodePort等概念都是kube-proxy服务通过Iptables的NAT转换实现,Iptables机制针对的是kube-proxy监听的端口,所以每个Node上都要有kube-proxy。 1.2.2 kubelet原理 每个Node都会启动一个kubelet,主要作用有: (1)Node管理 注册节点信息; 通过cAdvisor监控容器和节点的资源; 定期向Master(实际上是apiserver)汇报本节点资源消耗情况 (2)Pod管理 所以非通过apiserver方式创建的Pod叫Static Pod,这里我们讨论的都是通过apiserver创建的普通Pod。kubelet通过apiserver监听etcd,所有针对Pod的操作都会被监听到,如果其中有涉及到本节点的Pod,则按照要求进行创建、修改、删除等操作。 (3)容器健康检查 kubelet通过两类探针检查容器的状态: LivenessProbe:判断一个容器是否健康,如果不健康则会删除这个容器,并按照restartPolicy看是否重启这个容器。实现的方式有ExecAction(在容器内部执行一个命令)、TCPSocketAction(如果端口可以被访问,则健康)、HttpGetAction(如果返回200则健康)。 ReadinessProbe:用于判断容器是否启动完全。如果返回的是失败,则Endpoint Controller会将这个Pod的Endpoint从Service的Endpoint列表中删除。也就是,不会有请求转发给它。 1.3 Pod Pod是k8s进行资源调度的最小单位,每个Pod中运行着一个或多个密切相关的业务容器,这些业务容器共享这个Pause容器的IP和Volume,我们以这个不易死亡的Pause容器作为Pod的根容器,以它的状态表示整个容器组的状态。一个Pod一旦被创建就会放到Etcd中存储,然后由Master调度到一个Node绑定,由这个Node上的Kubelet进行实例化。 每个Pod会被分配一个单独的Pod IP,Pod IP + ContainerPort 组成了一个Endpoint。 1.4 Service K8s中一个Service相当于一个微服务的概念,一个Service对应后端多个Pod计算实例,使用LabelSelector将一类Pod都绑定到自己上来。一般还会需要一个Deployment或者RC来帮助这个Service来保证这个Service的服务能力和质量。 1.4.1 kube-proxy负载均衡 运行在每个Node上的kube-proxy其实就是一个智能的软件负载均衡器,它负载将发给Service的请求转发到后端对应的Pod,也就是说它负责会话保持和负责均衡。 1.4.2 Cluster IP 负载均衡的基础是负载均衡器要维护一个后端Endpoint列表,但是Pod的Endpoint会随着Pod的销毁和重建而改变,k8s使这个问题透明化。一旦Service被创建,就会立刻分配给它一个Cluster IP,在Service的整个生命周期内,这个Cluster IP不会改变。于是,服务发现的问题也解决了:只要用Service Name和Service Cluster IP做一个DNS域名映射就可以了。 1.4.3 DNS 从Kubernetes 1.3开始,DNS通过使用插件管理系统cluster add-on,成为了一个内建的自启动服务。Kubernetes DNS在Kubernetes集群上调度了一个DNS Pod和Service,并配置kubelet,使其告诉每个容器使用DNS Service的IP来解析DNS名称。 (1)Service 集群中定义的每个Service(包括DNS Service它自己)都被分配了一个DNS名称。默认的,Pod的DNS搜索列表中会包含Pod自己的命名空间和集群的默认域,下面我们用示例来解释以下。 假设有一个名为foo的Service,位于命名空间bar中。运行在bar命名空间中的Pod可以通过DNS查找foo关键字来查找到这个服务,而运行在命名空间quux中的Pod可以通过关键字foo.bar来查找到这个服务。 普通(非headless)的Service都被分配了一个DNS记录,该记录的名称格式为my-svc.my-namespace.svc.cluster.local,通过该记录可以解析出服务的集群IP。 Headless(没有集群IP)的Service也被分配了一个DNS记录,名称格式为my-svc.my-namespace.svc.cluster.local。与普通Service不同的是,它会解析出Service选择的Pod的IP列表。 (2)Pod Pod也可以使用DNS服务。pod会被分配一个DNS记录,名称格式为pod-ip-address.my-namespace.pod.cluster.local。 比如,一个pod,它的IP地址为1.2.3.4,命名空间为default,DNS名称为cluster.local,那么它的记录就是:1-2-3-4.default.pod.cluster.local。 当pod被创建时,它的hostname设置在Pod的metadata.name中。 在v1.2版本中,用户可以指定一个Pod注解,pod.beta.kubernetes.io/hostname,用于指定Pod的hostname。这个Pod注解,一旦被指定,就将优先于Pod的名称,成为pod的hostname。比如,一个Pod,其注解为pod.beta.kubernetes.io/hostname: my-pod-name,那么该Pod的hostname会被设置为my-pod-name。 v1.2中还引入了一个beta特性,用户指定Pod注解,pod.beta.kubernetes.io/subdomain,来指定Pod的subdomain。比如,一个Pod,其hostname注解设置为“foo”,subdomain注解为“bar”,命名空间为“my-namespace”,那么它最终的FQDN就是“foo.bar.my-namespace.svc.cluster.local”。 在v1.3版本中,PodSpec有了hostname和subdomain字段,用于指定Pod的hostname和subdomain。它的优先级则高于上面提到的pod.beta.kubernetes.io/hostname和pod.beta.kubernetes.io/subdomain。 1.4.4 外部访问Service的问题 先明确这样几个IP: Node IP:Node主机的IP,与它是否属于K8s无关。 Pod IP:是Dokcer Engine通过docker0网桥的IP地址段进行分配的,通常是一个虚拟的二层网络。k8s中一个Pod访问另一个Pod就是通过Pod IP。 Cluster IP:仅用于Service对象,属于k8s的内部IP,外界无法直接访问。 (1)NodePort 在Service的yaml中定义NodePort,k8s为集群中每个Node都增加对这个端口的监听,使用这种方式往往需要一个独立与k8s之外的负载均衡器作为流量的入口。 (2)使用External IP 运行Hello World应用程序的五个实例。 创建一个暴露外部IP地址的Service对象。 使用Service对象访问正在运行的应用程序。 使用deployment创建暴露的Service对象: ~ kubectl expose deployment hello-world --type=LoadBalancer --name=my-service 显示关于Service的信息: ~ kubectl get services my-service NAME CLUSTER-IP EXTERNAL-IP PORT(S) AGE my-service 10.3.245.137 104.198.205.71 8080/TCP 54s ~ kubectl describe services my-service Name: my-service Namespace: default Labels: run=load-balancer-example Selector: run=load-balancer-example Type: LoadBalancer IP: 10.3.245.137 LoadBalancer Ingress: 104.198.205.71 Port: <unset> 8080/TCP NodePort: <unset> 32377/TCP Endpoints: 10.0.0.6:8080,10.0.1.6:8080,10.0.1.7:8080 + 2 more... Session Affinity: None Events: 在此例子中,外部IP地址为104.198.205.71。还要注意Port的值。在这个例子中,端口是8080。在上面的输出中,您可以看到该服务有多个端点:10.0.0.6:8080,10.0.1.6:8080,10.0.1.7:8080 + 2 more…。这些是运行Hello World应用程序的pod的内部地址。 使用外部IP地址访问Hello World应用程序: ~ curl http://<external-ip>:<port> Hello Kubernetes! 删除服务 ~ kubectl delete services my-service ~ kubectl delete deployment hello-world 1.5 Ingress 通常情况下,service和pod仅可在集群内部网络中通过IP地址访问。所有到达边界路由器的流量或被丢弃或被转发到其他地方。Ingress是授权入站连接到达集群服务的规则集合。你可以给Ingress配置提供外部可访问的URL、负载均衡、SSL、基于名称的虚拟主机等。用户通过POST Ingress资源到API server的方式来请求ingress。 Ingress controller负责实现Ingress,通常使用负载平衡器,它还可以配置边界路由和其他前端,这有助于以HA方式处理流量。 最简化的Ingress配置: apiVersion: extensions/v1beta1 kind: Ingress metadata: name: test-ingress spec: rules: - http: paths: - path: /testpath backend: serviceName: test servicePort: 80 - path: /bar backend: serviceName: s2 servicePort: 80 1-4行:跟Kubernetes的其他配置一样,ingress的配置也需要apiVersion,kind和metadata字段。配置文件的详细说明请查看部署应用, 配置容器和 使用resources. 5-7行: Ingress spec 中包含配置一个loadbalancer或proxy server的所有信息。最重要的是,它包含了一个匹配所有入站请求的规则列表。目前ingress只支持http规则。 8-9行:每条http规则包含以下信息:一个host配置项(比如for.bar.com,在这个例子中默认是*),path列表(比如:/testpath),每个path都关联一个backend(比如test:80)。在loadbalancer将流量转发到backend之前,所有的入站请求都要先匹配host和path。 10-12行:backend是一个service:port的组合。Ingress的流量被转发到它所匹配的backend。 配置TLS证书 你可以通过指定包含TLS私钥和证书的secret来加密Ingress。 目前,Ingress仅支持单个TLS端口443,并假定TLS termination。 如果Ingress中的TLS配置部分指定了不同的主机,则它们将根据通过SNI TLS扩展指定的主机名(假如Ingress controller支持SNI)在多个相同端口上进行复用。 TLS secret中必须包含名为tls.crt和tls.key的密钥,这里面包含了用于TLS的证书和私钥,例如: (1)创建Secret apiVersion: v1 data: tls.crt: base64 encoded cert tls.key: base64 encoded key kind: Secret metadata: name: testsecret namespace: default type: Opaque (2)创建Ingress: apiVersion: extensions/v1beta1 kind: Ingress metadata: name: no-rules-map spec: tls: - secretName: testsecret backend: serviceName: s1 servicePort: 80 2 高可用 Kubernetes服务本身的稳定运行对集群管理至关重要,影响服务稳定的因素一般来说分为两种,一种是服务本身异常或者服务所在机器宕机,另一种是因为网络问题导致的服务不可用。本文将从存储层、管理层、接入层三个方面介绍高可用Kubernetes集群的原理。 2.1 Etcd高可用方案 Kubernetes的存储层使用的是Etcd。Etcd是CoreOS开源的一个高可用强一致性的分布式存储服务,Kubernetes使用Etcd作为数据存储后端,把需要记录的pod、rc、service等资源信息存储在Etcd中。 Etcd使用raft算法将一组主机组成集群,raft 集群中的每个节点都可以根据集群运行的情况在三种状态间切换:follower, candidate 与 leader。leader 和 follower 之间保持心跳。如果follower在一段时间内没有收到来自leader的心跳,就会转为candidate,发出新的选主请求。 集群初始化的时候内部的节点都是follower节点,之后会有一个节点因为没有收到leader的心跳转为candidate节点,发起选主请求。当这个节点获得了大于一半节点的投票后会转为leader节点。当leader节点服务异常后,其中的某个follower节点因为没有收到leader的心跳转为candidate节点,发起选主请求。只要集群中剩余的正常节点数目大于集群内主机数目的一半,Etcd集群就可以正常对外提供服务。 当集群内部的网络出现故障集群可能会出现“脑裂”问题,这个时候集群会分为一大一小两个集群(奇数节点的集群),较小的集群会处于异常状态,较大的集群可以正常对外提供服务。 2.2 Master高可用方案 Master上有三个关键的服务:apiserver、controller-manager和scheduler,这三个不一定要运行在一台主机上。 2.2.1 controller-manager和scheduler的选举配置 Kubernetes的管理层服务包括kube-scheduler和kube-controller-manager。kube-scheduer和kube-controller-manager使用一主多从的高可用方案,在同一时刻只允许一个服务处以具体的任务。Kubernetes中实现了一套简单的选主逻辑,依赖Etcd实现scheduler和controller-manager的选主功能。 如果scheduler和controller-manager在启动的时候设置了leader-elect参数,它们在启动后会先尝试获取leader节点身份,只有在获取leader节点身份后才可以执行具体的业务逻辑。它们分别会在Etcd中创建kube-scheduler和kube-controller-manager的endpoint,endpoint的信息中记录了当前的leader节点信息,以及记录的上次更新时间。leader节点会定期更新endpoint的信息,维护自己的leader身份。每个从节点的服务都会定期检查endpoint的信息,如果endpoint的信息在时间范围内没有更新,它们会尝试更新自己为leader节点 scheduler服务以及controller-manager服务之间不会进行通信,利用Etcd的强一致性,能够保证在分布式高并发情况下leader节点的全局唯一性。整体方案如下图所示: 当集群中的leader节点服务异常后,其它节点的服务会尝试更新自身为leader节点,当有多个节点同时更新endpoint时,由Etcd保证只有一个服务的更新请求能够成功。通过这种机制sheduler和controller-manager可以保证在leader节点宕机后其它的节点可以顺利选主,保证服务故障后快速恢复。当集群中的网络出现故障时对服务的选主影响不是很大,因为scheduler和controller-manager是依赖Etcd进行选主的,在网络故障后,可以和Etcd通信的主机依然可以按照之前的逻辑进行选主,就算集群被切分,Etcd也可以保证同一时刻只有一个节点的服务处于leader状态。 2.2.2 apiserver的高可用 Kubernetes的接入层服务主要是kube-apiserver。apiserver本身是无状态的服务,它的主要任务职责是把资源数据存储到Etcd中,后续具体的业务逻辑是由scheduler和controller-manager执行的。所以可以同时起多个apiserver服务,使用nginx把客户端的流量转发到不同的后端apiserver上实现接入层的高可用。具体的实现如下图所示: 接入层的高可用分为两个部分,一个部分是多活的apiserver服务,另一个部分是一主一备的nginx服务。 2.3 Keepalived简介 Keepalived软件起初是专为LVS负载均衡软件设计的,用来管理并监控LVS集群系统中各个服务节点的状态,后来又加入了可以实现高可用的VRRP功能。因此,Keepalived除了能够管理LVS软件外,还可以作为其他服务(例如:Nginx、Haproxy、MySQL等)的高可用解决方案软件。Keepalived软件主要是通过VRRP协议实现高可用功能的。VRRP是Virtual Router RedundancyProtocol(虚拟路由器冗余协议)的缩写,VRRP出现的目的就是为了解决静态路由单点故障问题的,它能够保证当个别节点宕机时,整个网络可以不间断地运行。所以,Keepalived 一方面具有配置管理LVS的功能,同时还具有对LVS下面节点进行健康检查的功能,另一方面也可实现系统网络服务的高可用功能。 故障切换转移原理 Keepalived高可用服务对之间的故障切换转移,是通过 VRRP (Virtual Router Redundancy Protocol ,虚拟路由器冗余协议)来实现的。在 Keepalived服务正常工作时,主 Master节点会不断地向备节点发送(多播的方式)心跳消息,用以告诉备Backup节点自己还活看,当主 Master节点发生故障时,就无法发送心跳消息,备节点也就因此无法继续检测到来自主 Master节点的心跳了,于是调用自身的接管程序,接管主Master节点的 IP资源及服务。而当主 Master节点恢复时,备Backup节点又会释放主节点故障时自身接管的IP资源及服务,恢复到原来的备用角色。 3 容器网络 3.1 docker默认容器网络 在默认情况下会看到三个网络,它们是Docker Deamon进程创建的。它们实际上分别对应了Docker过去的三种『网络模式』,可以使用docker network ls来查看: master@ubuntu:~$ sudo docker network ls NETWORK ID NAME DRIVER SCOPE 18d934794c74 bridge bridge local f7a7b763f013 host host local 697354257ae3 none null local 这 3 个网络包含在 Docker 实现中。运行一个容器时,可以使用 the –net标志指定您希望在哪个网络上运行该容器。您仍然可以使用这 3 个网络。 bridge 网络表示所有 Docker 安装中都存在的 docker0 网络。除非使用 docker run –net=选项另行指定,否则 Docker 守护进程默认情况下会将容器连接到此网络。在主机上使用 ifconfig命令,可以看到此网桥是主机的网络堆栈的一部分。 none 网络在一个特定于容器的网络堆栈上添加了一个容器。该容器缺少网络接口。 host 网络在主机网络堆栈上添加一个容器。您可以发现,容器中的网络配置与主机相同。 3.2 跨主机通信的方案 和host共享network namespace 这种接入模式下,不会为容器创建网络协议栈,即容器没有独立于host的network namespace,但是容器的其他namespace(如IPC、PID、Mount等)还是和host的namespace独立的。容器中的进程处于host的网络环境中,与host共用L2-L4的网络资源。该方式的优点是,容器能够直接使用host的网络资源与外界进行通信,没有额外的开销(如NAT),缺点是网络的隔离性差,容器和host所使用的端口号经常会发生冲突。 和host共享物理网卡 2与1的区别在于,容器和host共享物理网卡,但容器拥有独立于host的network namespace,容器有自己的MAC地址、IP地址、端口号。这种接入方式主要使用SR-IOV技术,每个容器被分配一个VF,直接通过PCIe网卡与外界通信,优点是旁路了host kernel不占任何计算资源,而且IO速度较快,缺点是VF数量有限且对容器迁移的支持不足。 Behind the POD 这种方式是Google在Kubernetes中的设计中提出来的。Kubernetes中,POD是指一个可以被创建、销毁、调度、管理的最小的部署单元,一个POD有一个基础容器以及一个或一组应用容器,基础容器对应一个独立的network namespace并拥有一个其它POD可见的IP地址(以IP A.B.C.D指代),应用容器间则共享基础容器的network namespace(包括MAC、IP以及端口号等),还可以共享基础容器的其它的namespace(如IPC、PID、Mount等)。POD作为一个整体连接在host的vbridge/vswitch上,使用IP地址A.B.C.D与其它POD进行通信,不同host中的POD处于不同的subnet中,同一host中的不同POD处于同一subnet中。这种方式的优点是一些业务上密切相关的容器可以共享POD的全部资源(它们一般不会产生资源上的冲突),而这些容器间的通信高效便利。 3.3 Flannel 在k8s的网络设计中,服务以POD为单位,每个POD的IP地址,容器通过Behind the POD方式接入网络(见“容器的网络模型”),一个POD中可包含多个容器,这些容器共享该POD的IP地址。另外,k8s要求容器的IP地址都是全网可路由的,那么显然docker0+iptables的NAT方案是不可行的。 实现上述要求其实有很多种组网方法,Flat L3是一种(如Calico),Hierarchy L3(如Romana)是一种,另外L3 Overlay也是可以的,CoreOS就采用L3 Overlay的方式设计了flannel, 并规定每个host下各个POD属于同一个subnet,不同的host/VM下的POD属于不同subnet。我们来看flannel的架构,控制平面上host本地的flanneld负责从远端的ETCD集群同步本地和其它host上的subnet信息,并为POD分配IP地址。数据平面flannel通过UDP封装来实现L3 Overlay,既可以选择一般的TUN设备又可以选择VxLAN设备(注意,由于图来源不同,请忽略具体的IP地址)。 flannel是CoreOS提供用于解决Dokcer集群跨主机通讯的覆盖网络工具。它的主要思路是:预先留出一个网段,每个主机使用其中一部分,然后每个容器被分配不同的ip;让所有的容器认为大家在同一个直连的网络,底层通过UDP/VxLAN等进行报文的封装和转发。 flannel默认使用8285端口作为UDP封装报文的端口,VxLan使用8472端口。那么一条网络报文是怎么从一个容器发送到另外一个容器的呢? 容器直接使用目标容器的ip访问,默认通过容器内部的eth0发送出去。 报文通过veth pair被发送到vethXXX。 vethXXX是直接连接到虚拟交换机docker0的,报文通过虚拟bridge docker0发送出去。 查找路由表,外部容器ip的报文都会转发到flannel0虚拟网卡,这是一个P2P的虚拟网卡,然后报文就被转发到监听在另一端的flanneld。 flanneld通过etcd维护了各个节点之间的路由表,把原来的报文UDP封装一层,通过配置的iface发送出去。 报文通过主机之间的网络找到目标主机。 报文继续往上,到传输层,交给监听在8285端口的flanneld程序处理。 数据被解包,然后发送给flannel0虚拟网卡。 查找路由表,发现对应容器的报文要交给docker0。 docker0找到连到自己的容器,把报文发送过去。 作者:奋起直追CDS 原文:https://blog.csdn.net/Dustin_CDS/article/details/79439596

优秀的个人博客,低调大师

Django学习笔记(一)

image.png 最近有个需求,老大让用 Django 来做,以前入门 Python 时就听过 Django 的大名,今日一见果然名不虚传~~~~。 特点 Django 最大的特点就是快速建站: 快速开发 内置应用 后台admin 用户认证系统auth 会话系统sessions 安全性高 表单验证 SQL注入 跨站点攻击 易于拓展 ....很多,这里不一一列举。 Django 应用(app)的概念 项目VS应用 项目与应用之间有什么不同之处?应用是一个提供功能的 Web 应用 – 例如:一个博客系统、一个公共记录的数据库或者一个简单的投票系统。 项目是针对一个特定的 Web 网站相关的配置和其应用的组合。一个项目可以包含多个应用。一个应用可以在多个项目中使用。 Django使用应用来分割功能,也就是app,每个应用分别为不同的app。 例如:我们创建一个电商网站,那么里边的购物车、用户管理、支付系统都可以成为独立的模块,也就是独立的三个app,这些模块可以用在别的网站中,不单单只针对于当前网站。 Django Demo Python版本2.7 Django版本1.8 查看已安装Django的版本:python -c "import django;print(django.get_version())" 创建一个名为web_Demo的Django项目 命令:django-admin startproject web_Demo 完成后,查看目录结构: image.png manage.py : 一个实用的命令行工具,可以让你以各种方式与该Django项目交互。可以在django-admin.py和manage.py查看源码的细节。 settings.py : 该项目的配置文件。 urls.py : 该项目的URL生明。 wsgi.py : 一个WSGI兼容的Web服务器入口。 接着,创建一个名为blog的应用(app):python manage.py startapp blog 查看新的目录结构: image.png 应用模块中各文件的作用: migrations:数据迁移模块 admin.py : 该应用的后台管理系统配置文件 apps.py : 当前应用的一些配置,1.9版本后才会自动生成,1.8 1.7都不会自动生成 models.py : 数据模型 使用ORM框架 django已经有所封装 tests.py : 自动化测试模块 views.py : 执行响应的逻辑代码,代码逻辑处理的主要地点,项目中大部分代码都在这里编写 然后,把blog app添加到配置文件中: 编辑settings.py: INSTALLED_APPS = ( 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', 'blog' ) 解释一下上边的配置信息代表什么意思: admin :身份验证系统 auth : contenttypes:内容类型框架 sessions :session框架 messages :消息框架 staticfiles :静态文件框架 再执行命令python manage.py migrate image.png 完成。 Admin Admin是Django自带的一个功能强大的自动化数据管理界面,被授权的用户可直接在admin中管理数据库。 Django提供了许多针对Admin的定制功能。 首先,创建超级用户查看admin系统:python manage.py createsuperuser 输入用户名、邮箱、密码,这里密码要难一些,简单的密码可能会不行。 image.png 启动web项目:python manage.py runserver 这里默认8000端口, 浏览器中打开127.0.0.1/8000/admin 输入刚才设置的用户名密码: image.png 登录: image.png 可以看到admin界面。 这里显示的是英文的admin,我们可以通过配置改为中文的。 更改settings中的配置: LANGUAGE_CODE = 'zh-Hans' image.png 完成。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册