首页 文章 精选 留言 我的

精选列表

搜索[笔记],共7227篇文章
优秀的个人博客,低调大师

HashMap源码学习笔记

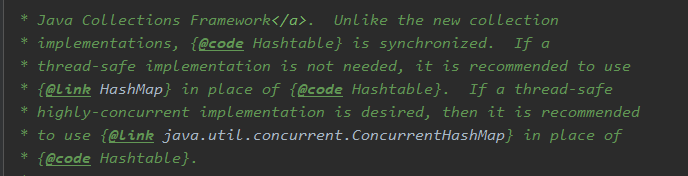
最近忙于各种事情,只能陆陆续续也看了一些东西,Java的HashMap应该算比较基础的东西,也是最近在看<<Redis设计与实现>>,其中也有HashMap的数据结构,又回去看了一下Java本身实现,这篇也就再记录一下。 Java数据结构中定义了Map接口,该接口有四个常用实现类:HashMap,Hashtable,LinkedHashMap和TreeMap。 针对上面四个常用类简单的介绍一下: 1. Hashtable: 从下面的Java doc就可以看出,其本身是线程安全的,但是并发性不如concurrent中的ConcurrentHashMap,而不需要线程安全时候,也推荐使用HashMap,故可以算是一个遗留类,不推荐使用。 Hashtable Java doc 2. LinkedHashMap:它是HashMap的一个子类,保存了记录的插入顺序,在用Iterator遍历LinkedHashMap时,先得到的记录肯定是先插入的。 LinkedHashMap java doc 3. TreeMap:TreeMap实现SortedMap接口,能够把它保存的记录根据键排序,默认是按键值的升序排序,也可以指定排序的比较器,当用Iterator遍历TreeMap时,得到的记录是排过序的。如果使用排序的映射,建议使用TreeMap。 TreeMap Java doc 4. HashMap:它根据键的hashCode值存储数据,大多数情况下可以直接定位到它的值,因而具有很快的访问速度,但遍历顺序却是不确定的。 HashMap最多只允许一条记录的键为null,允许多条记录的值为null。HashMap非线程安全,可能会导致数据的不一致。如果需要满足线程安全,可以使用之前提及的ConcurrentHashMap(不建议用Hashtable)。 本篇主要简单介绍的就是HashMap的实现,也是由于HashMap是最最常用的一个,可以满足大部分场景。自己工作了一年时间,基本也只用过HashMap= = 内部结构 HashMap内部的数据结构,就是最经典的数组+链表实现的哈希桶(JDK 1.7之前),从1.8之后,链表节点数量满足一定条件后,会自动转换成红黑树的数据结构,进一步提高查询效率。简单来说,HashMap的结构就是一个指针数组。 数据结构 图中的黑点则是存放Key-Value的Node,其数据结构如下: Node数据结构 其中 hash是用来定位数组索引位置, next是链表的下一个node。 字段 Map.put("key", "value") 在不考虑扩容的情况下,put操作会首先计算key的hash值,并通过取高位运算 + 取模运算两步,就能计算出该key在哈希桶的位置了。 当两个key定位在了同一个位置,则表示发生了Hash碰撞。因此,良好的Hash算法,能够尽量减少Hash碰撞,提高Map的存取效率。然而,即使很好的Hash算法,如果哈希桶的size很小(相比于Node数量),无论怎么计算,总是在这几个位置,也会出现很多碰撞。因此,解决碰撞,不仅需要良好的Hash算法,还需要一个良好的扩容机制。 要讨论扩容机制,就先看一下HashMap中的几个字段(附默认值): capacity: Hash桶容量 load_factor: 负载因子 size:已有node数量,modCount:内部结构变化次数,threshold=capacity * factor: 最大node数量 从上面几个字段可以看出,当put操作,使得size > threshold时,HashMap就会发生扩容。 并且从Java 动doc可以看出,Hash桶的大小一定是2的n次方。(正是这个限制,使得HashMap在扩容和计算key位置的运算效率提升了很多) 实现 Hash算法的实现,其实只有下面三行代码: int hashcode = key.hashCode(); // 获取hashcode int hashInt = hashcode ^(hashcode >>> 16 ); // 高位运算 int index = hashInt & (length - 1) // 取模运算,lenght是数组大小 第二步通过hashCode()的高16位异或低16位实现的:(h = k.hashCode()) ^ (h >>> 16),主要是从速度、功效、质量来考虑的,这么做可以在数组table的length比较小的时候,也能保证考虑到高低Bit都参与到Hash的计算中,同时不会有太大的开销。 第三步也是非常巧妙,因为Lenght是2的n次方,因此length - 1 永远是n个1,其实相当于对hashInt做了一次取模,但是效率极高。 下面是JDK 1.8的put代码实现: JDK1.8中put实现 line 627-628: table为空则创建. line 629-630: 计算index,并且check null, 如果为null, 直接创建一个index; line 633-635: 如果需要put的key和该位置原来的key一样,则直接覆盖value, 否则进行下面的追加操作 line 676-637: 红黑树操作,追加Node到红黑树 line 638-650: 链表操作,追加node到链表,并且判断是否需要转化为红黑树。 line 661-662: 判断是否需要扩容 扩容机制 扩容机制里的算法相对也比较复杂,HashMap的线程不安全性,也正是由于扩容时,链表操作可能导致的Infinite Loop引起。因此下一篇再具体举例说明吧。顺便可以一起把redis的HashMap resize机制一起说一下,基本都是大同小异。 总结 本篇就从源码角度,简单讲解HashMap的基本数据结构和关键操做的实现,以及简单介绍了扩容机制,由于JDK1.8以后的红黑树,导致扩容的代码更加复杂,但是扩容的算法相对于1.8之前,也有了不少优化,不过之后也不会深入算法方便,主要还是会介绍扩容的流程和原理。同事会结合redis的哈希表实现。

优秀的个人博客,低调大师

Maven学习笔记(一)

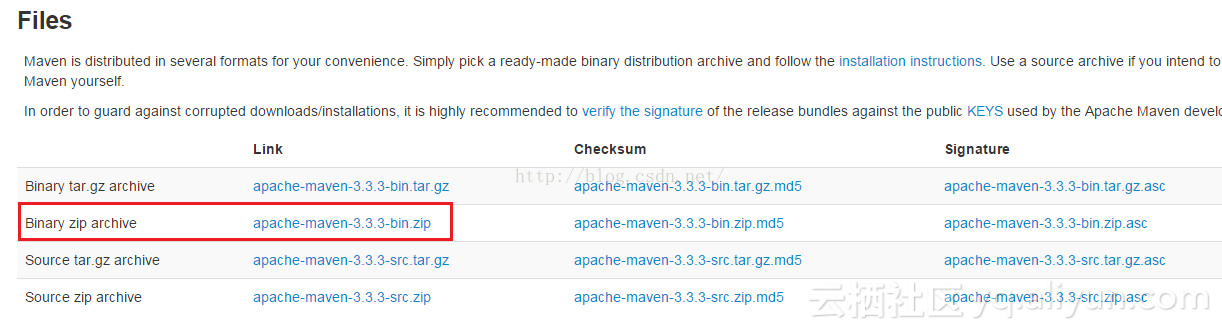
前言在2013年左右的时候Maven工具就非常火了,在IT技术日新月异的今天,Maven工具热度依然不减,可见Maven依旧是相当受欢迎的项目管理框架之一了,废话不多说,开启Maven学习之旅。 Maven是什么? 当你利用搜索引擎搜索Maven会出来很多名词:对象模型、标准集合、依赖管理系统这是啥啊?差不多得你会用了Maven才会理解这些名称吧,我找到了一个博主的博客blog.csdn.net/qq_27376871/article/details/51612742他做了不错的总结,Maven可以干什么: 1 . 帮你下载jar包 maven项目会有一个 pom.xml文件, 在这个文件里面,只要你添加相应配置,他就会自动帮你下载相应jar包,不用你铺天盖地的到处搜索你需要的jar包了 。maven都会通过:项目名-项目模块-项目版本来maven在互联网上的代码库中下载相应jar包。寻找jar的地址:http://search.maven.org所以这就是maven的功能之一,帮你下载jar包 2 . 寻找依赖,帮你下载依赖 寻找jar包是第一基本功能,寻找依赖在这个是在这个基础上的功能。 在maven的代码库中,每一个jar包也有自己的 pom.xml文件,而这个文件里面也会有配置,什么依赖范围我就不细说了,我想表达的就是,只要你配置的jar包所依赖的其他jar包都会被maven自动下载下来。 例如:你配置了 <dependency> <groupId>org.springframework</groupId> <artifactId>spring-core</artifactId> <version>3.6</version> </dependency> 你需要maven帮你下载spring-core-3.6.jar包 ,而这个jar包里面需要用到commons-logging.jar这个包, 这叫就依赖,spring-core-3.6.jar依赖于commons-logging.jar。 这就是maven第二个作用,帮你下载依赖包。 3 . 热部署,热编译 意思就是,在你web项目已经运行的时候,修改代码的能直接被web服务器所接受,就不需要你 重启服务器了,或者重新部署代码了,而且你可以直接通过maven 打包war或者jar项目。 此处关于Maven的介绍借鉴于博主「qq_27376871」的博客,可以上方提到的原文链接关注博主。 下载与安装在Maven的官方网站即可下载,当前的最新版本是3.5.3:http://maven.apache.org/download.cgi我们这里采用的是3.3.3版本,虽然不是最新版本,但是对于初学者来讲并无大碍,新版本增添了一些新的特性,核心的东西还是那些,并不影响学习。Windows系统的话我们下载已编译的二进制压缩包文件即可: 下载好之后我们解压后可以看到如下目录: 接下来就是安装Maven了,与安装JDK类似,首先需要新建一个Maven的环境变量: 接下来把Maven的bin目录加入到Path环境变量中,这样我们就可以通过命令行直接运行Maven命令了: 最后通过命令mvn -v 或mvn -version即可查看到Maven是否安装成功,安装成功即可看到相关版本信息: 这里还需要强调一点就是安装Maven之前务必确保正确安装了JDK,我们这里安装的maven-3.3.3必须要装JDK1.7+,否则Maven无法正常使用,关于这一点我们在官网的Documentation的Download目录下可以看到: 所以需要注意一下JDK的版本,如果你以后使用IDE去创建Maven项目的话也务必要配置好正确版本的JDK。 到此环境搭建算是完成了,简要介绍了Maven的下载与安装,下面介绍Maven的约定目录结构,一些基本命令以及如何去创建一个Maven项目。Maven的约定目录结构使用Maven管理项目的话,那么项目的结构目录务必要按照Maven约定的目录结构来创建项目,我们在官方文档中可以看到Maven提供的目录结构图: 简单介绍一下每个目录下应当存放的文件类型,在官网中可以看到标准的Introduction to the Standard Directory Layout,如下图所示: 显而易见,每个目录下应当放什么样类型的文件都说的很清楚了,一般情况下常用的是以下4个目录: src/main/java:存放项目的java类源文件,即:Xxx.java src/main/resources:存放项目的资源文件,如spring、mybatis的配置文件等等 src/test/java: 存放项目的用于测试的java类源文件,即:XxxTest.java src/test/resources: 存放项目的测试相关的资源文件 在上面的上面的图中我们还看到了一个pom.xml配置文件,这个文件很重要,它是Maven的核心配置文件,我们的项目版本,jar包依赖等等都以标签的形式保存在了这个配置文件中,在官方文档中也可以具体查看关于这个文件的介绍: 我在上图中标记出来的4个元素是必须配置的4个基础元素,至于为什么,我们可以在Introduction to the POM中看一下pom.xml的Minimal POM: 显而易见,已经说的很清楚了,the minimum requirement for a POM的配置,缺一不可。如果懒得看那一大段英文的原版解释,那么我下面就简要的解释一下这4个元素的含义。 modelVersion: 描述这个pom.xml文件是遵从哪个版本的项目描述符,maven3应当设置成4.0.0 groupId: 指明了创建项目的组织的唯一标识符,一般就是包名了 artifactId: 指的是项目中的主要的模块名(primary artifact),默认命名方式是“项目名-模块名” version: 指的是项目模块的版本,通常使用的是Maven的快照版本(例如:0.0.1-SNAPSHOT) Maven的目录结构清楚了之后,我们现在就通过手动创建文件夹的方式去创建一个Maven结构的项目并尝试编译运行。不过在此之前我们需要一个包含文件头的pom.xml的模板文件,在哪找呢?很简单,现在许多开源项目都是通过maven去打包的,比如mybatis,我们找到mybatis的jar包,解压后可以在如下目录中看到pom.xml文件: 把pom.xml拷贝出来,删除掉多余的部分,只留一个文件头即可: <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd"> 好了,现在我们就可以根据上面介绍的Maven目录和pom.xml的必备元素来手动构建一个基于Maven的java项目了。创建基于Maven的Java项目 首先我们依据Maven约定的目录结构创建文件夹以及pom.xml文件,如下图所示,首先在src/main/java目录下创建我们的java类源文件: 代码很简单,返回一个字符串: public class HelloWorld{ public String sayHello(){ return "Hello World!"; } } 接下来在src/test/java目录下创建用于测试的测试类java源文件: 主要用于测试HelloWorld类的sayHello方法的返回值与断言是否一致,代码如下: public class HelloWorldTest{ @Test public void testHello(){ Assert.assertEquals("Hello World!",new HelloWorld().sayHello()); } } 这里引入了junit的jar包,Maven的一大特点就是通过pom.xml去管理jar包以及相关依赖,我们只需要在配置文件中写入依赖的相关配置,那么Maven就会自动从Maven中央仓库中将我们的jar包下载到本地仓库,关于依赖和仓库的概念后面再细说。这里我们只需要知道我们的Maven项目不必再手动将jar包add到项目的classpath中,而是在pom.xml中声明即可,Maven会自动下载到本地。下面看看我们的pom.xml文件: <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.wl.maven01</groupId> <artifactId>maven-test</artifactId> <version>0.0.1-SNAPSHOT</version> <dependencies> <dependency> <groupId>junit</groupId> <artifactId>junit</artifactId> <version>4.11</version> </dependency> </dependencies> </project> 可以看到我们通过元素来声明了我们的依赖jar包,当我们编辑pom文件后保存的时候Maven就会自动去下载jar包了,这也是Maven最主要的优点之一。配置文件和java文件都写好之后,我们就可以通过Maven去编译、测试以及打包我们项目了,下篇文章展开讲解。总结本篇文章简单介绍了Maven的相关概念,以及讲解了Maven的约定目录结构。下一篇文章将学习Maven的三个基本命令 compile、test和package,以及了解Maven的一些核心概念。 原文发布时间为:2018-08-05本文作者:小灯光环本文来自云栖社区合作伙伴“ Web项目聚集地”,了解相关信息可以关注“ Web项目聚集地”。

优秀的个人博客,低调大师

xcode 使用笔记

最近做个 IM 相关的项目,为了搞个开源的 IOS 版本,因此开启了 XCode 开发使用 遇见了如下几点问题 环境说明 Mac macOS High Sierra. 版本 10.13.6 XCode Version 9.4.1 (9F2000) 1. Pod 在 Java 的世界呆时间长了,习惯了 mvn, ant 等内容, Pod 可以认为是 ios 下的 mvn 用来管理依赖包,类似 mvn 或其他的工具类似,它有自己独立的命令,如下所示 引用于 pod命令汇总: pod 命令列表 如需要进一步了解其使用,可以参见 pod <cmd> --help 进行查看, 比如: pod install --help 2. llvm 控制台 进入 llvm 控制台的方式有两种: 调试模式下进入到断点或Pause执行程序 发生异常错误 当进入到 llvm 控制台之后,可以进行如下操作: # 常见的 po 命令,用于打印对象内容 # 比如 打印当前模拟器运行时生成的工程文件位置 (llvm) po NSHomeDirectory() "/Users/mac/Library/Developer/CoreSimulator/Devices/4467A339-CA05-4FBB-83A5-5C396770EFB1/data/Containers/Data/Application/2A4E420E-1575-461F-BBE3-85E2880C3749" # 打印当前线程堆栈信息 (lldb) bt * thread #1, queue = 'com.apple.main-thread', stop reason = signal SIGSTOP * frame #0: 0x0000000116ec920a libsystem_kernel.dylib`mach_msg_trap + 10 frame #1: 0x0000000116ec8724 libsystem_kernel.dylib`mach_msg + 60 frame #2: 0x00000001103257d5 CoreFoundation`__CFRunLoopServiceMachPort + 229 frame #3: 0x0000000110324c19 CoreFoundation`__CFRunLoopRun + 1689 frame #4: 0x000000011032430b CoreFoundation`CFRunLoopRunSpecific + 635 frame #5: 0x0000000119a66a73 GraphicsServices`GSEventRunModal + 62 frame #6: 0x00000001124b0057 UIKit`UIApplicationMain + 159 frame #7: 0x000000010efc13c7 UCreaterChat`main at AppDelegate.swift:12 frame #8: 0x0000000116a5b955 libdyld.dylib`start + 1 同时也能执行 gdb 信息,比如: 命令 备注 break NUM 在指定的行上设置断点。 bt 显示所有的调用栈帧。该命令可用来显示函数的调用顺序。 clear 删除设置在特定源文件、特定行上的断点。其用法为:clear FILENAME:NUM。 continue 继续执行正在调试的程序。该命令用在程序由于处理信号或断点而导致停止运行时。 display EXPR 每次程序停止后显示表达式的值。表达式由程序定义的变量组成。 file FILE 装载指定的可执行文件进行调试。 help NAME 显示指定命令的帮助信息。 info break 显示当前断点清单,包括到达断点处的次数等。 info files 显示被调试文件的详细信息。 info func 显示所有的函数名称。 info local 显示当函数中的局部变量信息。 info prog 显示被调试程序的执行状态。 info var 显示所有的全局和静态变量名称。 kill 终止正被调试的程序。 list 显示源代码段。 make 在不退出 gdb 的情况下运行 make 工具。 next 在不单步执行进入其他函数的情况下,向前执行一行源代码。 print EXPR 显示表达式 EXPR 的值。 print-object 打印一个对象 (即 po ) print (int) name 打印一个类型 print-object [artist description] 调用一个函数 (即 po ) set artist = @"test" 设置变量值 whatis 查看变理的数据类型 3. 断点问题 [问题 1] 将某些变量放到 Watch 中之后,每次进入到那个Watch 执行的地方时候,基本都会发生崩溃( 原因是构建那个对象时候,里面不支持,这时候直接 exit 0 ... ) [解决方法] 删除 .xcworkspace/ 目录下的 Expressions.xcexplist 文件即可。 mac$ find . -name "Expressions.xcexplist" -exec rm -f {} \; 4. 查看当前调试界面对应的 ViewController 等信息 在 XCode 中存在类似 Android 开发的 View Hierarchy 通过它可以打开相应的界面查看属性元素信息,如下图: 界面元素 注意点击如下图标(Debug View Hierarchy) 按钮,即可出现如上界面 Debug View Hierarchy 其附近也存在类似的如 调试内存使用的 按钮 。 5. 调试相关参数设定 类似 Eclipse 或 Android Studio 中运行时参数设定一样,对 IOS 中设定一些初始化设置,进入方式如下: [Product] -> [Edit Scheme] 即可进入如下界面: Edit Scheme 界面 比如 Enable Zombi Objects 或添加参数等,均在此进行操作。 6. Profile 相关使用 将程序运行起来之后,进入方式:[Product] -> [Profile] 进入如下Instrument 模板界面: Profile界面 选择 [Time Profiler] 类似 Android 中可以调试函数执行的时间消耗等信息,充分调试那些函数是最耗时步骤。 7. 常见快捷键 快捷键 说明 command + 1 工程导航器 command + 0 显示/隐藏导航器面板 command + [/] 向前/后缩进(Shift Left/Right) command + option + [/] 将当前光标所在行代码上移或者下移(Move Line Up/Down) option+command+←/→ 折叠当前代码块,包括@interface …@end、@implementation …@end option+shift+command+←/→ 折叠该文件内所有代码块(方法/函数:{ Methods&Functions }) control+shift+command+←/→ 折叠当前注释块(/Comment Blocks/) shift+command+J 在项目导航中定位当前编辑其中打开的文件(Reveal in Project Navigator)。 command+L 跳转到指定行。 shift+command+O Open Quickly,快速全局查找文件、符号,非常常用! command+点击Editor中选中的符号 跳转到符号定义(jump to definition)。 control+command+J 跳转到指定符号的定义处或实现处(Go to Declaration/Definition)。有时工程正在Loading、Indexing或Processing files时,“command+点击”无法响应,此时可试试control+command+J shift+command+Y 显示控制台(Show/Hide the debug area) shift+command+C 激活聚焦控制台,光标定位到控制台呈可输入状态 command+K 清除控制台(Debug->Debug Workflow->Clear Console) command + \ 当前行设置/取消断点;通过鼠标点击边列中的蓝色断点来启用/禁用当前行断点。 command + Y 全局激活或禁用所有的断点,激活进入调试模式(此时断点蓝色可见)。 command + R 运行 command + control + i 进入 Profile 界面 参考 pod命令汇总Xcode的控制台调试命令

优秀的个人博客,低调大师

TweenMax学习笔记整理

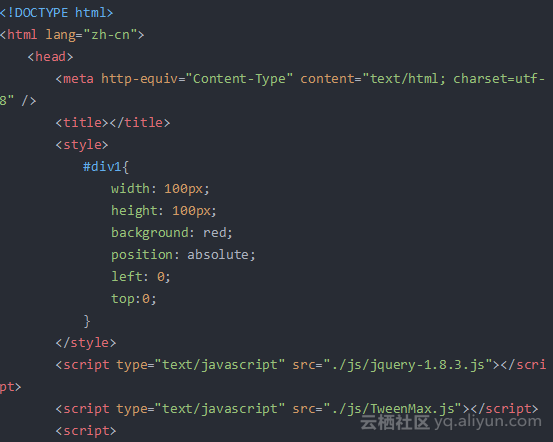
因为要做一个案例,里面用到了很多动画,TweenMax真的是一个很强大的动画库,所以就学了一点里面的方法,现在整理出来 官网:https://greensock.com/tweenmax 注意:这个动画库是基于jQuery的,所以使用前要先引入jQuery哦! 下面的所有方法都在TimelineMax对象下,要先得到动画实例,所以使用我下面的方法的时候要注意先写下面的代码: var t = new TimelineMax(); 用到的方法整理: to():添加动画; 参数说明: 元素选择器或对象 持续时间 对象(变化的属性->值) 【可选】动画延迟发生的时间(可写数字,“-=0.5”,“+=0.5”) 一例胜千言,嗯,先看看下面的小实例 在这个例子中,等待1s后,元素"#div1"的left和width同时变化,left用时1s后到达目标点,width用时2s到达目标点,过1s钟高度开始变化,高度到达目标点后(用时2s),元素围绕z轴旋转180deg(用时2s),旋转后,透明度发生变化(用时2s) 注意:第四个参数是可选参数,如果我们没有写第四个参数,意味着,下面的动画执行都会在上一动画执行完之后开始执行,如果加了第四个参数,就是在上一动画的时间基础上加上或减少延迟时间(针对"+="或"-="),当然如果是数字num,那么 如果num>=0,那就是延迟num执行(注意:不是相对于前一个动画,而是相对于动画的开始时间哦),如果num<0,对于第一个t.to(),延迟负数就相当于0,第二个及以后的t.to,如果延迟时间小于0,则一打开页面运动已经执行完毕(看不到运动的过程) 2、staggerTo():添加动画 参数说明:1. 元素选择器或对象2. 持续时间3. 对象 变化的属性->值 4.【可选】一组动画间的延迟时间,数字 5. 【可选】一组动画整体延迟发生时间 可写数字,“-=0.5”,“+=0.5“ 这个方法和t.to()方法语法和使用都一样,那两者不一样的地方就是,先看下面的例子吧! 在这个例子中,如果我们没有加第四个参数的时候,两者的效果是一样的,即所有的div都同时执行,然后同时到达目标点 但是如果我们加了第四个参数的话,使用t.to()方法的时候,所有的div还是同时执行,但是如果我们使用的是t.staggerTo(),后面的div都会等到前面的div执行完成之后再执行(不是一起执行,而是依次执行) 注意:个人比较建议使用这个方法,一般是针对一类元素,然后,第四个参数,如果为正数,代表正序执行,绝对值代表延迟时间,如果是负数,则表示倒序执行,绝对值也是延迟时间(个人测试得出的结论) 如果是不同的类别元素使用t.staggerTo()方法,我测试发现,其实第四个参数并不起作用,不管时间是多少,都是按照写的顺序依次执行,并且中间是没有间隔的 <div class="div1"> </div> <div class="div2"> </div> <div class="div3"> </div> $(function(){ var t = new TimelineMax(); t.staggerTo( ".div1",1,{width:300},2 ); t.staggerTo( ".div2",3,{height:300},0); t.staggerTo( ".div3",1,{background:"blue"},-1); }); 上面的执行顺序是先div1宽度变化,然后div2的height发生变化,最后是div3的background发生变化 第五个参数,代表一组动画整体提前或延迟多少执行 上面的是我自己经过不断测试得出的结论,如果有什么地方不正确,欢迎指正哦 3、下面的比较好理解,看字面意思就知道了 stop():停止动画 play():开始动画 reverse():反向开始动画 onComplete():运动结束后触发对应的函数 onReverseComplete():反向运动结束后触发对应的函数 看例子吧 <!DOCTYPE html> <html lang="zh-cn"> <head> <meta http-equiv="Content-Type" content="text/html; charset=utf-8" /> <title></title> <style> #div1{ width: 100px; height: 100px; background: red; position: absolute; left: 0; top:50px; } </style> <script type="text/javascript" src="./js/jquery-1.8.3.js"></script> <script type="text/javascript" src="./js/TweenMax.js"></script> <script> $(function(){ var t = new TimelineMax(); t.stop(); t.to( "#div1",1,{left:300,onComplete:function(){ alert("left:300") },onReverseComplete:function(){ alert("反向left:0"); }} ); t.to( "#div1",2,{width:300,onComplete:function(){ alert("width:300") },onReverseComplete:function(){ alert("反向width:100") }} ); $("#play").click(function (){ t.play(); }) $("#stop").click(function (){ t.stop(); }) $("#reverse").click(function (){ t.reverse(); }) }) </script> </head> <body> <input type="button" id="play" value="播放" /> <input type="button" id="stop" value="停止" /> <input type="button" id="reverse" value="反向动画" /> <div id="div1"></div> </body> </html> 注意:如果我们没有加t.stop()方法的时候,元素都是在打开页面后便开始执行动画,当我们加了t.stop()方法后,所有的的动画都不会执行,只有我们调用t.play()方法的时候,才会开始执行 4、add---添加状态 参数说明: 1. 字符串或一个函数 TweenTo---完成指定的动画(过渡) 参数说明: 1. 指定时间或状态的字符串 这两个方法一般都是结合使用的,所以先看例子呗 <!DOCTYPE html> <html lang="zh-cn"> <head> <meta http-equiv="Content-Type" content="text/html; charset=utf-8" /> <title></title> <style> #div1{ width: 100px; height: 100px; background: red; position: absolute; left: 0; top:50px; } </style> <script type="text/javascript" src="./js/jquery-1.8.3.js"></script> <script type="text/javascript" src="./js/TweenMax.js"></script> <script> $(function(){ var t = new TimelineMax(); t.add("state1"); t.to( "#div1",1,{left:300} ); t.to( "#div1",2,{width:300} ); t.add("state2"); t.to( "#div1",3,{height:300} ); t.add("state3") t.tweenTo( "state2" ); }) </script> </head> <body> <div id="div1"></div> </body> </html> 注意:当我们使用t.tweenTo()方法的时候,即便我们添加了t.stop()方法,也不会影响t.tweenTo()方法的执行,比如在这个例子中,即便我们添加了t.stop()方法,页面在打开的时候,还是会立即执行到状态2 5、seek():完成指定的动画(无过渡) 参数说明: 1. 指定时间或状态 2. 【可选】布尔值 true:不执行函数 默认 false: 执行函数 和上面的t.tweenTo()方法很相似,不同的是,这个没有过渡效果,如果把上面的例子中t.tweenTo()方法换成t,seek()方法,结果就是一打开页面,元素的left和width就为300,看不多动画效果 5、下面两个很好理解了,就不啰嗦了 time():动画已执行的时间 clear:清除所有动画 6、 totalDuration():获取动画的总时长 getLabelTime():返回从开始到当前状态的时间参数说明:1. 状态的字符串返回值是一个数字 currentLabel():获取当前状态 返回值是状态的字符串 没什么好解释的,看例子就都懂了 <!DOCTYPE html> <html lang="zh-cn"> <head> <meta http-equiv="Content-Type" content="text/html; charset=utf-8" /> <title></title> <style> #div1{ width: 100px; height: 100px; background: red; position: absolute; left: 0; top:50px; } </style> <script type="text/javascript" src="./js/jquery-1.8.3.js"></script> <script type="text/javascript" src="./js/TweenMax.js"></script> <script> $(function(){ var t = new TimelineMax(); t.add( "state1" ); t.to( "#div1",1,{left:300}); t.to( "#div1",2,{width:300,onComplete:function(){ getCurrentLabel(); }} ); t.add( "state2" ) t.to( "#div1",3,{height:300,onComplete:function(){ getCurrentLabel(); }} ); t.add( "state3" ) alert( t.totalDuration() ) alert( t.getLabelTime( "state3" ) ) alert( t.currentLabel() ) getCurrentLabel(); function getCurrentLabel(){ //alert( t.currentLabel() ) alert( t.getLabelTime( t.currentLabel() ) ) } }) </script> </head> <body> <div id="div1"></div> </body> </html> 7、getLabelAfter():获取下一个状态 参数说明:1. 时间数字返回值是状态的字符串,如果没有下一个状态返回null getLabelBefore():获取上一个状态参数说明:1. 时间数字 返回值是状态的字符串,如果没有上一个状态返回null <!DOCTYPE html> <html lang="zh-cn"> <head> <meta http-equiv="Content-Type" content="text/html; charset=utf-8" /> <title></title> <style> #div1{ width: 100px; height: 100px; background: red; position: absolute; left: 0; top:50px; } </style> <script type="text/javascript" src="./js/jquery-1.8.3.js"></script> <script type="text/javascript" src="./js/TweenMax.js"></script> <script> $(function(){ var t = new TimelineMax(); t.add( "state1" ); t.to( "#div1",4,{left:300}); t.to( "#div1",5,{width:300,onComplete:function(){ getCurrentLabel(); }} ); t.add( "state2" ) t.to( "#div1",6,{height:300,onComplete:function(){ getCurrentLabel(); }} ); t.add( "state3" ) //alert( t.totalDuration() ) //alert( t.getLabelTime( "state3" ) ) //alert( t.currentLabel() ) getCurrentLabel(); function getCurrentLabel(){ //获取当前的时间 var currentTime = t.getLabelTime( t.currentLabel() ); //获取到上一个状态 var beforeLabel = t.getLabelBefore( currentTime ); //获取到下一个状态 var afterLabel = t.getLabelAfter( currentTime ); var str = "<p>上一个状态:"+ beforeLabel +"</p><p>当前状态:"+ t.currentLabel() +"</p><p>下一个状态:"+ afterLabel +"</p>"; $("#label").html( str ); } }) </script> </head> <body> <div id="label"></div> <div id="div1"></div> </body> </html> 原文发布时间:2018年06月18日 作者:冰雪为融 本文来源:CSDN如需转载请联系原作者

优秀的个人博客,低调大师

《Jenkins权威指南》笔记

1、Jenkins的启动参数: java -jar jenkins.war --httpPort=8081 java -jar jenkins.war --httpPort=8081 --ajp13Port=8010 远程构建触发: Jenkins +svn Jenkins +git 远程触发构建 MAVEN ANT shell Windows shell 系统变量:BUILD_NUMBER BUILD_ID JOB_NAME BUILD_TAG JAVA_HOME WORKSPACE HUDSON_URL JOB_URL BUILD_URL ANT调用环境变量 MAVEN调用环境变量 Jenkins +JUnit 归档构建产物 归档的构建产物的地址: Jenkins +JUnit Jenkins +Cobertura ANT集成Cobertura Jenkins +JMeter Jenkins +审计JobConfigHistory 电子邮件通知 Jenkins+钉钉 Jenkins +Checkstyle Jenkins +Violations Jenkins +Coverage Complexity Scatter Plot Jenkins +Sonar Jenkins +部署 Jenkins +Disk Usage磁盘空间插件 Jenkins +Thin Backup备份

优秀的个人博客,低调大师

python面向对象笔记

一、封装(属性/私有方法/公有方法/静态方法/构造函数...) # 定义一个类 class Animal: # 私有成员(用_开头的约定为私有成员 - 注:仅仅是君子协定) _age = 0 # 构造函数 def __init__(self, name): # 建议所有私有成员在这里初始化(不管是已定义的,还是"动态"添加的) self.name = name # 动态添加的私有成员 self._age = 1 # 已经定义好的私有成员 # 静态方法 @staticmethod def eat(): print("Animal can eat food") # 公有方法 def to_string(self): return "name:" + self.name # 私有方法(用_开头的约定为私有方法 - 注:仅仅是君子协定) def _some_method(self): return "this is a private method of :" + self.name # setter示例 def set_age(self, age): if age < 0 or age > 100: print("age is invalid!") self._age = age # getter示例 def get_age(self): return self._age def run(self): print(self._some_method()) print("I am running") def test(self): print("test1") # 注:这样会覆盖上面的test(self版本) def test(self, hello): print("test2:" + hello) animal = Animal("A new animal") print(animal.to_string()) # 方法调用 animal.eat() # 静态方法调用1(不推荐) Animal.eat() # 静态方法调用2 print("animal._age=" + str(animal.get_age())) animal.set_age(10) # 调用setter print(animal.get_age()) # 调用getter,输出10 animal.run() # 公有方法里调用私有方法 animal._age = 30 # 直接修改私有成员(不推荐) animal._age2 = 40 # 注意:这里实际上给实例animal"动态"添加了一个_age2属性 print(animal.get_age()) # 这里输出的仍然是10 print("_age2:" + str(animal._age2)) # 这里输出的动态添加的_age2属性值 print(animal.test("hi")) #print(animal.test()) # 这里会报错,因为test(self,hello)这个版本要求hello参数有值 print(animal._some_method()) # 直接调用私有方法(不推荐) 输出: name:A new animal Animal can eat food Animal can eat food animal._age=1 10 this is a private method of :A new animal I am running 30 _age2:40 test2:hi None this is a private method of :A new animal 几个要点: 1、约定大于配置:比如构造函数约定为__init__;私有方法/成员约定为"_"开头(注:只是君子协定,硬要调用的话,外部是可以直接调用的);实例方法约定第1个参数为self 2、重载的处理,不象java里要定义多个方法签名,python里就一个版本,但是通过可变参数来实现(后面还要细讲) 3、动态语言,实例在运行过程中,可随时动态添加属性 另外注意:不要轻易使用__(二个连续的下划线)做为方法或变量的前缀或后缀,"__XXX__"在python里通常有特定含义,如果使用"__"开头的变量或写法,可能会遇到各种奇葩问题。 二、重载 传统的OOP语言,比如java,重载只能是定义多个不同方法签名的method,来实现重载,但是python可以做得更简单,用参数默认值就可以变相实现。 # 定义一个类 class Calculator: # 加法 def add(self, a=0, b=0, c=0, d=0): print("args:", a, b, c, d) return int(a) + int(b) + int(c) + int(d) cal = Calculator() print(cal.add(1, 2)) print(cal.add(1, 2, 3)) print(cal.add(1, "2", 3, "4")) print("\n") cal = Calculator #注意这里,如果漏了(),结果会大不同 print(cal.add(1, 2)) 输出: args: 1 2 0 0 3 args: 1 2 3 0 6 args: 1 2 3 4 10 args: 2 0 0 0 2 注意:16行,如果漏了(),cal = Calculator,实际上只是cal只是相当于类Calculator的别名,这样调用add(1,2)时,类似于静态方法调用,1会认为是第一个参数self,所以输出就成了2. 如果不确定参数个数,还可以这么做: # 定义一个类 class Calculator: # 约定:*参数,表示参数个数不限定 def add(self, *args): result = 0 for arg in args: result += int(arg) return result cal = Calculator() print(cal.add(1, 2, 3)) print(cal.add("1", 2, "3")) 输出: 6 6 三、继承 3.1 基本示例 class Fruit: def __init__(self, name): print("Fruit constructor...") self.name = name def to_string(self): print("Fruit to_string...") return "name:" + self.name # 抽象方法 def get_color(self): print("Fruit get_color...") raise NotImplementedError class RedApple(Fruit): def __init__(self, name): print("Apple constructor...") # 调用父类的构造函数 Fruit.__init__(self, name) def get_color(self): return self.name + " is red" fruit = Fruit("unknown") print(fruit.to_string()) # print(fruit.get_color()) # 报错,因为没实现 print("\n") redApple = RedApple("red apple") print(redApple.get_color()) print(redApple.to_string()) print("\n") print("1、redApple is instance of RedApple ? ", isinstance(redApple, RedApple)) print("2、redApple is instance of Fruit ? ", isinstance(redApple, Fruit)) print("3、fruit is instance of Fruit ? ", isinstance(fruit, Fruit)) print("4、fruit is instance of RedApple ? ", isinstance(fruit, RedApple)) print("5、RedApple is subclass of Fruit ? ", issubclass(RedApple, Fruit)) print("6、Fruit is subclass of Fruit ? ", issubclass(Fruit, Fruit)) print("7、Fruit is subclass of RedApple ? ", issubclass(Fruit, RedApple)) 输出: Fruit constructor... Fruit to_string... name:unknown Apple constructor... Fruit constructor... red apple is red Fruit to_string... name:red apple 1、redApple is instance of RedApple ? True 2、redApple is instance of Fruit ? True 3、fruit is instance of Fruit ? True 4、fruit is instance of RedApple ? False 5、RedApple is subclass of Fruit ? True 6、Fruit is subclass of Fruit ? True 7、Fruit is subclass of RedApple ? False 注:抽象方法是通过抛出未实现的异常来实现的。如果想类似java定义抽象类,把__init__方法抛出未实现异常就行。 3.2 多继承 python支持多继承,这点与java有很大区别 class P1: def a(self): print("P1-a") def b(self): print("P1-b") def x(self): print("P1-x") class P2: def a(self): print("P2-a") def b(self): print("P2-b") def y(self): print("P2-y") # 多继承示例 class S1(P1, P2): def a(self): print("S1-a") class S2(P2, P1): def a(self): print("S2-a") s1 = S1() s1.a() s1.b() # P1-b s1.x() s1.y() print("\n") s2 = S2() s2.a() s2.b() # P2-b s2.x() s2.y() print("\n") print("s1 isinstance of P1:", isinstance(s1, P1)) print("s1 isinstance of P2:", isinstance(s1, P2)) print("s1 isinstance of S1:", isinstance(s1, S1)) print("s1 isinstance of S2:", isinstance(s1, S2)) 输出: S1-a P1-b P1-x P2-y S2-a P2-b P1-x P2-y s1 isinstance of P1: True s1 isinstance of P2: True s1 isinstance of S1: True s1 isinstance of S2: False 注意多承继的顺序,如果“爸爸们”之间有重名方法,将会按照继承顺序,谁在前面,就调用谁的。eg:def S(A,B) 子类S继承自A,B,如果A,B中都有方法x,调用S.x时,因为A排在B的前面,所以调用到的就是A.x方法。从上面的输出就可以得到印证。 3.3 接口、abc模块、属性 3.1中抽象类/方法是通过抛出异常来实现的,有点粗暴,下面介绍一种更优雅的方法,python内置的abc模块 from abc import * # 接口示例 class IRun(ABC): # 抽象方法 @abstractmethod def run(self): pass class Animal(ABC): # 抽象属性 @property @abstractmethod def name(self): pass class Dog(Animal, IRun): def __init__(self, name): self._name = name; # 属性的getter @property def name(self): return self._name # 属性的setter (注:每个property都会生成一个对应的@xxx.setter) @name.setter def name(self, value): self._name = value # 接口的方法实现 def run(self): print(self.name + " is running") dog1 = Dog("a") dog1.run() dog2 = Dog("b") dog2.run() print(isinstance(dog1, IRun)) print(id(dog1), id(dog2), id(dog1) == id(dog2)) # 判断2个实例是否相等 输出: a is running b is running True 4314753736 4314753792 False 最后送一波福利:https://github.com/faif/python-patterns这是python实现的所有设计模式,对oop感兴趣的推荐研究。 作者: 菩提树下的杨过 出处: http://yjmyzz.cnblogs.com 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

Java开发环境笔记

在配置环境变量中 设置Java_home: 一是为了方便引用,比如,jdk安装在c:\jdk16.0目录里,则设置java_home为该目录路径,那么以后要使用这个路径的时候,只需输入%java_home%即可,避免每次引用都输入很长的路径串; 二则是归一原则,当jdk路径改变的时候,仅需要更改java_home的变量值即可,否则,就要更改任何用绝对路径引用jdk目录的文档,要是万一没有改全,某个程序找不到jdk,后果是可想而知的系统崩溃 三则是第三方软件会引用约定好的java_home变量 path 变量 path 变量使得我们能够在系统中的任何地方运行java应用程序,比如 javac、java、javah 等等,这就要找到我们安装 JDK 的目录, 假设我们的JDK安装在 C:\jdk1.6.0 目录下,那么在 C:\jdk1.6.0\bin 目录下就是我们常用的 java 应用程序,我们就需要把 C:\jdk1.6.0\bin 这个目录加到 path 环境变量里面。 classpath 变量 classpath 环境变量,是当我们在开发java程序时需要引用别人写好的类时,要让 java 解释器知道到哪里去找这个类。通常,sun 为我们提供了一些额外的丰富的类包,一个是 dt.jar,一个是 tools.jar,这两个 jar 包都位于 C:\jdk1.6.0\lib 目录下,所以通常我们都会把这两个 jar 包加到我们的 classpath 环境变量中 set classpath=.;C:\jdk1.6.0\lib\tools.jar;C:\jdk1.6.0\lib\dt.jar。 注意在完成配置环境变量后测试JDK是否安装成功时键入命令:java -version JDK和JRE的区别 JRE(Java Runtime Enviroment)是Java的运行环境。面向Java程序的使用者,而不是开发者。如果你仅下载并安装了JRE,那么你的系统只能运行Java程序。JRE是运行Java程序所必须环境的集合,包含JVM标准实现及 Java核心类库。它包括Java虚拟机、Java平台核心类和支持文件。它不包含开发工具(编译器、调试器等)。 JDK(Java Development Kit)又称J2SDK(Java2 Software Development Kit),是Java开发工具包,它提供了Java的开发环境(提供了编译器javac等工具,用于将java文件编译为class文件)和运行环境(提 供了JVM和Runtime辅助包,用于解析class文件使其得到运行)。如果你下载并安装了JDK,那么你不仅可以开发Java程序,也同时拥有了运行Java程序的平台。JDK是整个Java的核心,包括了Java运行环境(JRE),一堆Java工具tools.jar和Java标准类库 (rt.jar)。 网名:浩秦; 邮箱:root#landv.pw; 只要我能控制一個國家的貨幣發行,我不在乎誰制定法律。金錢一旦作響,壞話隨之戛然而止。

优秀的个人博客,低调大师

菜鸟随笔记录

在本地进行编程练习,html在调用.php文件时死活无法工作,使用浏览器检查功能,查看network,发现.php文件被挂起。不知道到底哪出问题的情况下,关闭phpstorm,重启,即OK。2.MYSQL更新数据字段,令其自动加1,PHP: $conn=mysqli_connect("localhost","root","");if(!$conn){ die("error!"); }mysqli_query($conn,"set names utf8");$sql="UPDATE sylj SET count=count+1 WHERE h_id='$q'"; //$q是变量,必须在'‘中mysqli_select_db($conn,'mydb');$retval=mysqli_query($conn,$sql);if(!$retval){ die('error2!'); }

优秀的个人博客,低调大师

Python基础学习笔记

---------2018.1.24------------ round是向上取整,引用方式为round(number[,ndigits]) 而floor是向下取整,floor函数通过import math导入,引用方式为math.floor(number) str函数,它会把值转换成合理形式的字符串,函数原型为str(object)//字符串要用双引 号引起来,数字不需要 repr函数,它会创建一个字符串.以合法的Python表达式的形式来表示值,函数原型为repr (object) 如果你希望打印一个包含数字的句子,加上``(反引号)可以很方便的输出 input()与raw_input()区别 input()会假设用户输入的是合法的python表达式,例如字符串一定要用引号引起来 而raw_input()会把所有的输入当作原始数据将其放入字符串中 如果你需要写一个非常长的字符串,需要跨越多行,可以使用三个引号(单引号和双引号均 可)代替. 如果一行中最后一个字符是反斜杠\,那么换行符本身就"转义"了,也就是被忽略了. 原始字符串r'x'或者r"x",几乎可以输出任何字符,唯一不行的就是原始字符串最后的一个 字符不能是反斜杠,要输出反斜杠\,只有对原反斜杠\进行转义,形式为'\\' pow(x,y[,z]) 返回x的y次幂(所得结果对z取模) ---------2018.2.6------------ 利用切片操作,实现一个trim()函数,去除字符串首尾的空格,注意不要调用str的strip()方法 1 # -*- coding: utf-8 -*- 2 def trim(s): 3 if s[:1] != ' ' and s[-1:] != ' ': 4 return s 5 elif s[:1] == ' ': 6 return trim(s[1:]) 7 else: 8 return trim(s[:-1]) 9 # 测试: 10 if trim('hello ') != 'hello': 11 print('测试失败!') 12 elif trim(' hello') != 'hello': 13 print('测试失败!') 14 elif trim(' hello ') != 'hello': 15 print('测试失败!') 16 elif trim(' hello world ') != 'hello world': 17 print('测试失败!') 18 elif trim('') != '': 19 print('测试失败!') 20 elif trim(' ') != '': 21 print('测试失败!') 22 else: 23 print('测试成功!') 汉诺塔的移动可以用递归函数非常简单地实现。 请编写move(n, a, b, c)函数,它接收参数n,表示3个柱子A、B、C中第1个柱子A的盘子数量,然后打印出把所有盘子从A借助B移动到C的方法,例如: 1 def move(n,a,b,c): 2 if(n==1): 3 print(a,'-->',c) 4 else: 5 move(n-1, a, c, b) 6 move(1, a, b, c) 7 move(n-1, b, a, c) 8 move(3, 'A' , 'B', 'C') 请使用迭代查找一个list中最小和最大值,并返回一个tuple: 1 # -*- coding: utf-8 -*- 2 def findMinAndMax(L): 3 length=len(L) 4 if(length==0): 5 return (None,None) 6 elif(length==1): 7 return (L[0],L[0]) 8 else: 9 minn=L[0] 10 maxn=L[0] 11 for x in L: 12 if(x>=maxn): 13 maxn=x 14 if(x<=minn): 15 minn=x 16 return (minn,maxn) 17 # 测试 18 if findMinAndMax([]) != (None, None): 19 print('测试失败!') 20 elif findMinAndMax([7]) != (7, 7): 21 print('测试失败!') 22 elif findMinAndMax([7, 1]) != (1, 7): 23 print('测试失败!') 24 elif findMinAndMax([7, 1, 3, 9, 5]) != (1, 9): 25 print('测试失败!') 26 else: 27 print('测试成功!') 杨辉三角定义如下: 1 / \ 1 1 / \ / \ 1 2 1 / \ / \ / \ 1 3 3 1 / \ / \ / \ / \ 1 4 6 4 1 / \ / \ / \ / \ / \ 1 5 10 10 5 1 把每一行看做一个list,试写一个generator,不断输出下一行的list: 1 # -*- coding: utf-8 -*- 2 def triangles(): 3 a = [1] 4 while True: 5 yield a 6 a = [sum(i) for i in zip([0] + a, a + [0])] 7 8 # 期待输出: 9 # [1] 10 # [1, 1] 11 # [1, 2, 1] 12 # [1, 3, 3, 1] 13 # [1, 4, 6, 4, 1] 14 # [1, 5, 10, 10, 5, 1] 15 # [1, 6, 15, 20, 15, 6, 1] 16 # [1, 7, 21, 35, 35, 21, 7, 1] 17 # [1, 8, 28, 56, 70, 56, 28, 8, 1] 18 # [1, 9, 36, 84, 126, 126, 84, 36, 9, 1] 19 n = 0 20 results = [] 21 for t in triangles(): 22 print(t) 23 results.append(t) 24 n = n + 1 25 if n == 10: 26 break 27 if results == [ 28 [1], 29 [1, 1], 30 [1, 2, 1], 31 [1, 3, 3, 1], 32 [1, 4, 6, 4, 1], 33 [1, 5, 10, 10, 5, 1], 34 [1, 6, 15, 20, 15, 6, 1], 35 [1, 7, 21, 35, 35, 21, 7, 1], 36 [1, 8, 28, 56, 70, 56, 28, 8, 1], 37 [1, 9, 36, 84, 126, 126, 84, 36, 9, 1] 38 ]: 39 print('测试通过!') 40 else: 41 print('测试失败!') 1 # -*- coding: utf-8 -*- 2 L1 = ['Hello', 'World', 18, 'Apple', None] 3 L2 = [s.lower() for s in L1 if isinstance(s,str)==True] 4 # 测试: 5 print(L2) 6 if L2 == ['hello', 'world', 'apple']: 7 print('测试通过!') 8 else: 9 print('测试失败!') split翻译为分裂。 split()就是将一个字符串分裂成多个字符串组成的列表。 split()当不带参数时以空格进行分割,当代参数时,以该参数进行分割。 //---当不带参数时 example: st0= ' song huan gong ' print(st0.split()) 结果为: ['song', 'huan', 'gong'] 结论:当不带参数时,默认是以空格作为参数,不管空格在哪,或者有几个 全部被镐掉了! //---当带参数时 这种情况就不能按照上面的方式去理解了 example: st0= 'iisongiiihuaniiiigongi' print(st0.split('i')) 结果为: ['', '', 'song', '', '', 'huan', '', '', '', 'gong', ''] 分析: 这个结果可能就有点出乎意料了并不是想象中的['song', 'huan', 'gong'] 而是多了很多空字符串元素'',这个怎么理解呢? 我的理解方式是,当带参数时,我们得把字符串想象成一块五花肉,我们要做 一件奇葩的事情,就是将肥肉丢到垃圾桶,把瘦肉留下。 比如'iisongiiihuaniiiigongi'这串五花肉,'i'就是要丢掉的肥肉,每次还只能切 'i'这么多。 切的时候是从左到右,一刀下去肥肉'i'丢掉,刀刃左边的部分拿走作为list的一个元素, 刀刃右边的就是剩下的,那么继续切剩下的部分,直到切完。 'iisongiiihuaniiiigongi'这块肉比较特殊: 其一、他的开始和结尾都有i,而且i还不止一个!这样按照上述的方法就会切出 空气,就是列表中我们看到的'', 空字符串元素。 如'iisongiiihuaniiiigongi',当第一刀下去的时候,第一个i被丢到了垃圾桶, 而刀刃的左边什么都没有,所以列表的第一个元素就是'',空字符串元素。 一刀下去之后,就剩下'isongiiihuaniiiigongi'。 所以第二刀下去之后,又得到一个空字符串元素,目前“肉”就剩下'songiiihuaniiiigongi'。 第三刀又切掉一个i,那么刀刃左边的就是song,所以第三个元素就是'song'。 直到切到最后,整坨肉就只剩下一个i了,使用最后一刀下去i被切掉了,刀刃的左边此时也 什么都没有了,所以最后一个元素任然是空字符串。 一个超级好的例子: 1 >>> str="hello boy<[www.doiido.com]>byebye" 2 >>> str.split("[")[1].split("]")[0] 3 'www.doiido.com' 4 >>> str.split("[")[1].split("]")[0].split(".") 5 ['www', 'doiido', 'com'] 利用map和reduce编写一个str2float函数,把字符串'123.456'转换成浮点数123.456: 1 # -*- coding: utf-8 -*- 2 from functools import reduce 3 DIGITS = {'0': 0, '1': 1, '2': 2, '3': 3, '4': 4, '5': 5, '6': 6, '7': 7, '8': 8, '9': 9} 4 def char2num(s): 5 return DIGITS[s] 6 def str2float(s): 7 s=s.split('.') 8 if len(s[0])==0: 9 s[0]='0' 10 return reduce(lambda x,y:x*10+y,map(char2num,s[0]))+reduce(lambda x,y:x*10+y,map(char2num,s[1]))*pow(0.1,len(s[1])) 11 print('str2float(\'123.456\') =', str2float('123.456')) 12 if abs(str2float('123.456') - 123.456) < 0.00001: 13 print('测试成功!') 14 else: 15 print('测试失败!') Python提供的sum()函数可以接受一个list并求和,请编写一个prod()函数,可以接受一个list并利用reduce()求积: 1 # -*- coding: utf-8 -*- 2 from functools import reduce 3 def prod(L): 4 return reduce(lambda x,y:x*y,L) 5 print('3 * 5 * 7 * 9 =', prod([3, 5, 7, 9])) 6 if prod([3, 5, 7, 9]) == 945: 7 print('测试成功!') 8 else: 9 print('测试失败!') 利用map()函数,把用户输入的不规范的英文名字,变为首字母大写,其他小写的规范名字。输入:['adam', 'LISA', 'barT'],输出:['Adam', 'Lisa', 'Bart']: 1 # -*- coding: utf-8 -*- 2 def normalize(name): 3 name=name[0].upper()+name[1:].lower() 4 return name 5 # 测试: 6 L1 = ['adam', 'LISA', 'barT'] 7 L2 = list(map(normalize, L1)) 8 print(L2) 回数是指从左向右读和从右向左读都是一样的数,例如12321,909。请利用filter()筛选出回数: 1 # -*- coding: utf-8 -*- 2 def is_palindrome(n): 3 nn = str(n) #转成字符串 4 return nn == nn[::-1] #反转字符串并对比原字符串返回true/false 5 # 测试: 6 output = filter(is_palindrome, range(1, 1000)) 7 print('1~1000:', list(output)) 8 if list(filter(is_palindrome, range(1, 200))) == [1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44, 55, 66, 77, 88, 99, 101, 111, 121, 131, 141, 151, 161, 171, 181, 191]: 9 print('测试成功!') 10 else: 11 print('测试失败!') ---------2018.2.7------------ 请把下面的Student对象的gender字段对外隐藏起来,用get_gender()和set_gender()代替,并检查参数有效性: 1 # -*- coding: utf-8 -*- 2 class Student(object): 3 def __init__(self, name, gender): 4 self.name = name 5 self.gender = gender 6 def get_gender(self): 7 return self.gender 8 def set_gender(self,gender): 9 if gender=='male' or gender=='female': 10 self.gender=gender 11 else: 12 raise ValueError('gender error') 13 # 测试: 14 bart = Student('Bart', 'male') 15 if bart.get_gender() != 'male': 16 print('测试失败!') 17 else: 18 bart.set_gender('female') 19 if bart.get_gender() != 'female': 20 print('测试失败!') 21 else: 22 print('测试成功!') 2018/3/5 ubuntu16.04自带python的环境,不用进行python环境安装,在安装好环境的虚拟机中,提供了py2,py3,django_py2,tornado_py2,spider_py2,django_py3的虚拟环境 mysql安装sudo apt-get install mysql-serversudo apt-get install libmysqlclient-dev注意安装server端的时候会提示输入密码,记住这个密码。然后通过命令登入数据库 redis安装sudo apt-get install redis-server通过redis-cli登入mongoDB安装详情请参考 http://blog.csdn.net/zgf19930504/article/details/52045600postgresql安装sudo apt-get install postgresqlsudo apt-get install libpq-develasticsearch安装(django项目使用)sudo apt-get install elasticsearch其它依赖包sudo apt-get install python-dev 3.django环境安装我们将虚拟环境所需的包全部放在install.txt,以下是django_py3项目所需环境:django==1.7.4jsonfieldPillow==2.8.2celeryamqp==1.4.9anyjson==0.3.3billiard==3.3.0.23celery==3.1.23decorator==4.0.10Django==1.7.8django-haystack==2.5.0django-redis-sessions==0.5.6ipdb==0.8.1ipython-genutils==0.1.0jsonfield==1.0.3kombu==3.0.35psycopg2==2.6.2pytz==2016.6.1redis==2.10.5setuptools==25.1.0wheel==0.29.0执行pip3 install -r instal.txt命令即可 4.tornado环境安装在tornado_py2虚拟环境中安装:ipython==4.2.0ipython-genutils==0.1.0pingpp==2.0.11pycrypto==2.6.1qiniu==7.0.7redis==2.10.5requests==2.10.0tornado==4.3MySQL-python==1.2.5SQLAlchemy==1.0.14 5.spider环境安装在spider_py2虚拟环境中安装:attrs==16.0.0backports-abc==0.4backports.ssl-match-hostname==3.5.0.1BeautifulSoup==3.2.1beautifulsoup4==4.4.1boto==2.38.0certifi==2016.2.28cffi==1.7.0chardet==2.3.0CherryPy==3.5.0click==6.6cryptography==1.4cssselect==0.9.2cssutils==1.0Cython==0.24decorator==4.0.6Django==1.8.7dnspython==1.12.0easydict==1.6enum34==1.1.6feedparser==5.1.3greenlet==0.4.10html5lib==0.999idna==2.1ipaddress==1.0.16ipython==2.4.1jieba==0.38jsonpath==0.54lxml==3.5.0Markdown==2.6.6mechanize==0.2.5motor==0.2motorengine==0.9.0mysqlclient==1.3.7ndg-httpsclient==0.4.0netifaces==0.10.4nltk==3.2.1parsel==1.0.2pbr==1.9.1pexpect==4.0.1Pillow==3.3.0pip==8.1.2pkg-resources==0.0.0poster==0.8.1ptyprocess==0.5pyasn1==0.1.9pyasn1-modules==0.0.8pybloomfilter==1.0pybloomfiltermmap==0.3.12pycparser==2.14pycrypto==2.6.1PyDispatcher==2.0.5Pygments==2.1pymongo==2.7pyOpenSSL==16.0.0python-dateutil==2.4.2pytz==2014.10PyYAML==3.11queuelib==1.4.2redis==2.10.5repoze.lru==0.6requests==2.10.0Routes==2.2rq==0.6.0Scrapy==1.1.0scrapy-redis==0.6.3scrapyd==1.1.0scrapyd-client==1.0.1selenium==2.53.6service-identity==16.0.0setuptools==25.1.0simplegeneric==0.8.1singledispatch==3.4.0.3six==1.10.0sqlparse==0.1.18stevedore==1.13.0tornado==4.3Twisted==16.2.0urllib3==1.13.1w3lib==1.14.2WebOb==1.5.1wheel==0.29.0zope.interface==4.2.0 编译C语言代码(基于Vim编辑器) vi 1.ci插入代码 上下左右还是可以使用HJKL或者up down left right(建议使用HJKL)写完保存退出ESC+:xgcc 1.c编译 会生成a.out文件运行a.out文件命令:./a.out python3支持中文编码,python2不支持中文编码要解决python2不支持中文编码的操作为:# -*- coding=utf-8 -*- 特别注意:python2中input的意思是把交互式输入的东西当成代码去执行,而python3中默认当作字符串去输入而如果要让python2中输入的东西当作字符串,我们需要用到raw_input() 比如a=input("请输入你的名字:")请输入你的名字:laowangpython2中会报错,python3则不会请输入你的名字:1+2print(a)python2中打印结果为3 python3中打印结果为'1+2'而python2中要实现打印字符串,用raw_input函数a=raw_input("请输入你的名字:")请输入你的名字:1+2print(a)'1+2' 由于在python3中默认input类型为字符串类型,如果我们需要获取int类型,我们需要设置一个变量去存储字符串类型例如age_num=int(age) 变量名不能使用关键字 import keyword keyword.kwlist显示当前版本的所有关键字 print("%d%s%f"%(a,b,c)) 不等于在python2和python3中通用写法是!=但是在python2中还有一种写法是<>,这个意思也是表示不等于 vi编辑代码的时候,如果之前有定义的变量,敲完该变量的一部分,再敲上Ctrl+n自动补全 if not (条件):print(xxx) 意思是不在条件范围内if not (x>0 and x<50):print("hello") 逻辑运算符:and 且or 或not 非 if 条件1: print(a)elif 条件2: print(aa)......else: print(aaa) while 条件: a=b+c print(c)打印不换行:print("xxx(打印信息)",end="")打印换行:print("") 复合赋值运算符:+=-=*=/=%=**=//=而不能使用j++之类的,这是错误的语法,只能写成j+=1 在进行复合赋值运算时,=后面的数字不管进行什么运算,切记加上小括号 举个例子:a=2a*=3+2答案是10,计算方式是a=a*(3+2)=2*5=10,而并不是a=2*3+2=8 import randomrandom.randint(0,2)意思是导入一个random的库,random.randint(0,2)意思是随机生成0-2中的整数 切片:name[2:6]取的是从第二个位置开始(下标从0开始),到小于第六个位置为止(第五个位置) name[2:]取的是从第二个位置开始(下标从0开始),取到最后一个 name[2:-1:2]取的是从第二个位置开始(下标从0开始),取到最后一个的前面一个,步长为2,就是每两个位置取一个 切片:[起始位置:终止位置:步长](针对字符串而言) 起始位置取大于等于号,终止位置取小于号 步长可以为负数 步长为负数时是倒着取值,反向,相当于取逆序数 find函数,意思是找到我们需要的字符串的首字符的下标,找不到输出-1 str="hello world"str.find("world")>>6 str.find("Hello")>>-1 index函数 和find查找函数一样 找到了返回 只不过find没找到返回-1 index没有找到直接返回异常 rindex 返回子字符串 str 在字符串中最后出现的位置 如果没有匹配的字符串会报异常 rfind 返回字符串最后一次出现的位置,如果没有匹配项则返回-1 count 用于统计字符串里某个字符出现的次数。可选参数为在字符串搜索的开始与结束位置。 replace 把字符串中的 old(旧字符串) 替换成 new(新字符串),如果指定第三个参数max,则替换不超过 max 次。 split 通过指定分隔符对字符串进行切片,如果参数num 有指定值,则仅分隔 num 个子字符串str.split(str="", num=string.count(str)).str -- 分隔符,默认为所有的空字符,包括空格、换行(\n)、制表符(\t)等num -- 分割次数 str = "Line1-abcdef \nLine2-abc \nLine4-abcd";print str.split( );>>['Line1-abcdef', 'Line2-abc', 'Line4-abcd'] capitalize 将字符串的第一个字母变成大写,其他字母变小写。对于 8 位字节编码需要根据本地环境。 s = ' a, B' # a 前面有空格s.capitalize()>>' a, b' title 所有单词都是以大写开始,其余字母均为小写str.title() startswith 用于检查字符串是否是以指定子字符串开头,如果是则返回 True,否则返回 False。如果参数 beg 和 end 指定值,则在指定范围内检查。 endswith 用于判断字符串是否以指定后缀结尾,如果以指定后缀结尾返回True,否则返回False。可选参数"start"与"end"为检索字符串的开始与结束位置。 lower 转换字符串中所有大写字符为小写str.lower() upper 将字符串中的小写字母转为大写字母str.upper() rjust 返回一个原字符串右对齐,并使用空格填充至长度 width 的新字符串。如果指定的长度小于字符串的长度则返回原字符串。 ljust 返回一个原字符串左对齐,并使用空格填充至指定长度的新字符串。如果指定的长度小于原字符串的长度则返回原字符串。 center 返回一个原字符串居中,并使用空格填充至长度 width 的新字符串。默认填充字符为空格。 lstrip 用于截掉字符串左边的空格或指定字符 rstrip 删除 string 字符串末尾的指定字符(默认为空格) strip 用于移除字符串头尾指定的字符(默认为空格) partition 用来根据指定的分隔符将字符串进行分割。 rpartition 从后往前查找,返回包含字符串中分隔符之前、分隔符、分隔符之后的子字符串的tuple;如果没找到分隔符,返回字符串和两个空字符串 splitlines 字符串以换行符为分隔符拆分,去掉换行符;如果keepends为True,保留换行符 isalpha 检测字符串是否只由字母组成 isdigit 检测字符串是否只由数字组成 join 用于将序列中的元素以指定的字符连接生成一个新的字符串 str = "-";seq = ("a", "b", "c"); # 字符串序列print str.join( seq );>>a-b-c append 用于在列表末尾添加新的对象 如果添加的对象是列表 则会整体添加list.append(obj) ps:a=[1,2]b=[3,4]a.extend(b)>>[1,2,3,4]a.append(b)>>[1,2,[3,4]] insert 用于将指定对象插入列表的指定位置 list.insert(index, obj) extend 用于在列表末尾一次性追加另一个序列中的多个值(用新列表扩展原来的列表) list.extend(seq) pop 用于移除列表中的一个元素(默认最后一个元素),并且返回该元素的值 删除最后一个list.pop(obj=list[-1]) remove 用于移除列表中某个值的第一个匹配项 根据内容来删除 list.remove(obj) del xxx[下标] 根据下标来删除 in 操作符用于判断键是否存在于列表/字典中,如果键在列表/字典里返回true,否则返回false not in 如果在指定的序列中没有找到值返回 True,否则返回 False。 字典通过键来查找 info={键1:值1,键2:值2,......} 添加 xxx[新的key] = value 删除 del xxx[key] 修改 xxx[已存在的key] = new_value 查询 xxxx.get(key) for...else结构: 如果for循环里面有break,不触发else如果for循环里面没有break 一定会触发else append 注意点:a=[1,2]b=[3,4] a=a.append(b)进行这一步操作后,a的值为None了 原因是进行a.append(b)操作后,b的值已经添加到a里面去了 结果已经发生变化了 但是我们单独敲a.append(b)这句话时,并没有任何输出 这就说明a.append(b)这步操作的值为空 a.append(b)整体结果为没有 没有输出就没有结果 反而你把这个传入a a的值只能保存为空 即为None 在python2中 keys 以列表返回一个字典所有的键 ps:dict.keys() values 以列表返回字典中的所有值 ps:dict.values() items 以列表返回可遍历的(键, 值) 元组数组 ps:dict.items() 而python3中 会返回一个生成器 一个对象 内容是列表的形式 example: 在python2中:info={"name":"laowang","age":18}info.keys()>>['name','age'] 而在python3中info={"name":"laowang","age":18}info.keys()>>dict_keys(['name','age']) 拆包 举个例子就知道了:下面是元组拆包a=(11,22)c,d=ac>>11d>>22 在items中取值时,两种取值方式 一种是用数组下标 一种是元组拆包 举个例子:info={"name":"laowang","age":18}for temp in info.items(): print("key=%s,value=%s"%(temp[0],temp[1])) info={"name":"laowang","age":18}for A,B in info.items(): print("key=%s,value=%s"%(A,B)) 以上两种方式得出的结果相同 元组:(小括号) 字典:很多信息描述一个物体(大括号)列表:存储不同物体的相同信息(中括号) 元组类型的数据不能修改里面的值,相当于一个只读文件而列表可以修改值 函数:def 函数名: ... 一个函数想要返回多个数值,可以将其打包成元组或者列表 return a,b,c 相当于封装成元组返回 写代码规范:写函数时,先写结构,再去考虑里面内容 代码能够重复使用 全局变量与局部变量注意点: 1.如果全局变量中定义了某个量 如果还想在函数中对这个变量进行修改的话 在函数中使用global对全局变量进行一个声明那么这个函数中的变量就不是定义一个局部变量 而是对全局变量进行修改 2.全局变量定义得放在函数调用之前 #注释会被忽略文档字符串(doctoring)"""XXX"""可以被调用(不影响程序的执行) def main 完成对整个程序的控制 main函数需要定义 main()调用主函数 python代码一般格式:# -*-coding=utf-8-*-import xxxdef xxx(aa): ...xxx(aa) 列表 字典的注意事项: 如果列表 字典当作全局变量 可以不需要在函数中定义global,加了也没事 但是单纯的变量在函数中一定需要加上global 缺省参数:在函数中传入默认值 在调用函数时可以不传入那个变量值 那个参数称为缺省参数 example:def test(a,b=22): result = a+b print("result=%d"%result)test(11)test(22,33)test(44) >>33>>55>>66 而像test(11,b=22)b=22为命名参数 不定长参数 如果我们需要调用一个传入任意个参数的函数 怎么办呢 我们这时候采用传入*args 函数的形参 告诉python解释器 传入的实参个数如果大于形参真正的个数 剩下的统统扔给args比如我们有10个苹果要分给三个人 有个人是你的亲属 需要你照顾他 每个人发完一个后 剩余的都给需要照顾的人 输出的结果为元组 example:def sum(a,b,*args): print(a) print(b) print(args) sum(1,2,3,4,5,6,7,8)>>1>>2>>(3,4,5,6,7,8) 对于上面这个例子 如果传入的实参只有2个 也不会错 args的值为空 输出的时候会输出一个()(空的元组) **kwargs以字典的形式保存 输出结果为字典形式 多余参数不带变量名的 统统给args 多余参数带变量名的 统统给kwargs def sum(a,b,*args,**kwargs): print(a) print(b) print(args) print(kwargs) sum(1,2,3,4,5,6,task=88,done=78) 12(3, 4, 5, 6){'task': 88, 'done': 78} 拆包: 就是在实参上加上*/** 把一个列表/字典拆成一个一个值 元组/列表拆成一个一个元素 字典拆成 key value 这个过程就是拆包 用法:如下例子 def sum(a,b,*args,**kwargs): print(a) print(b) print(args) print(kwargs) A=(44,55,66)/[44,55,66] B={"name":"laowang","age":18} sum(11,22,*A,**B) 在实参上写了*/** 意思是拆包 >>1122(44, 55, 66){'name': 'laowang', 'age': 18} id 用于获取对象的内存地址id([object]) a=1 意思并不是说定义了一个变量 而是贴了个标签,这个标签是内存地址 b=a 这个意思也是把a的内存地址给b 所以id查看会发现a,b的内存地址相同 而C语言不是 C语言是定义变量 只是值相等 地址不同 只要a的值改变了 b的值也会改变 python有自动回收垃圾机制 数字是不可变类型 字符串也是不可变类型 元组也是个不可变类型 举个例子a="hello"a[0]>>'h'a[0]='H'报错。。。 说明字符串不允许修改 列表和字典属于可变类型 在定义时不允许当key用 infors.sort(key=lambda x:x['name']) 匿名函数 lambda eval 用来执行一个字符串表达式,并返回表达式的值 eval(expression[, globals[, locals]]) 交换两个数 a=a+bb=a-ba=a-b 任何语言都适用 a,b=b,a python独特写法 两数交换 列表加上列表 等于 列表的合并 误区: python里面不是值赋值,而是引用赋值 例子: num+=num与num=num+num的区别 由于python里面时引用赋值 假设num=100传入一个求解两个数的和的函数 num+=num 传入的实参num指向100这个值 所以做修改时直接修改的是num本身的值 修改的是全局变量 而num = num + num传入参数时 num定义的是临时变量 此时num指向的是100+100=200 文件的读入 f = oepn("test.py","r") 意味着通过open打开文件 用f进行操作文件的读写 r 文件必须存在w 文件如果不存在 就创建新文件a 打开一个文件 从文件的末尾写 rbwbab有b结尾说明是二进制文件 文本文件与二进制文件区别 r+w+a++表示你可以读写文件 rb+wb+ab+ open默认以读入的方式打开 所以可以不写"r" seek 用于移动文件读取指针到指定位置 fileObject.seek(offset[, whence]) f.seek(2,0) 0表示文件的开头 2表示跳过开头两个位置开始读 如果我已经读完了一个文件 想要重新读取该文件 我们应该用f.seek(0,0)拉回来 让该文件还能调用f.read()重新读取 f.tell() 返回文件的当前位置,即文件指针当前位置 fileObject.tell(offset[, whence]) open 支持相对路径和绝对路径 面向过程 考虑要面面俱到 强调的是过程而面向对象则不需要 找个有这样能力的人去做 强调的是对象 形象的解释对象 看的见摸得着 实实在在的东西 类是模型 一个概念 类由三部分组成 类的名称:类名 类的属性:一组数据 类的方法:允许对进行操作的方法(行为) 比如: 类名:Tank属性:重量 速度 材料方法:开炮 移动 转弯 在类中定义方法的时候参数位置要写上self 执行 Cat() 在内存中申请了空间 返回对象的引用 而执行 tom = Cat() tom是创建的对象的引用 指向那个对象 添加属性 tom.name="xxx" 给tom添加属性name tom.age=xx 给tom添加属性age 例子: 类Cat tom=Cat() tom.调用方法 tom.添加属性 class Cat: #属性 #方法 def eat(self): print("猫在吃鱼....") def drink(self): print("猫正在喝kele.....") def introduce(self): #print("%s的年龄是:%d"%(tom.name, tom.age)) print("%s的年龄是:%d"%(self.name, self.age)) #创建一个对象tom = Cat() #调用tom指向的对象中的 方法tom.eat()tom.drink() #给tom指向的对象添加2个属性tom.name = "汤姆"tom.age = 40 #获取属性的第1种方式#print("%s的年龄是:%d"%(tom.name, tom.age)) tom.introduce()#相当于 tom.introduce(tom) lanmao = Cat()lanmao.name = "蓝猫"lanmao.age = 10lanmao.introduce() self的作用:你通过哪个对象去调用方法 self就指向哪个对象 tom.introduce() 相当于tom.introduce(tom) 而如果class中函数的形参不写入self 直接调用tom.introduce() 结果会显示多传入了一个参数 这个就是原因所在 还有 不一定要传入形参的时候传self a b c等任何数都行 只是我们约定俗成 用self 魔法方法1:__init__ 方法:初始化对象def __init__(self): pass 初始化对象 创建对象的过程:1.创建一个对象2.python会自动的调用__init__方法3.返回创建的对象的引用给tom __init__也称为魔法方法 class Cat: """定义了一个Cat类""" #初始化对象 def __init__(self, new_name, new_age): self.name = new_name self.age = new_age #方法 def eat(self): print("猫在吃鱼....") def drink(self): print("猫正在喝kele.....") def introduce(self): print("%s的年龄是:%d"%(self.name, self.age)) #创建一个对象tom = Cat("汤姆", 40)tom.eat()tom.drink()#tom.name = "汤姆"#tom.age = 40tom.introduce() lanmao = Cat("蓝猫", 10)#lanmao.name = "蓝猫"#lanmao.age = 10lanmao.introduce() 1.创建对象name = "汤姆"age = 40 2.调用__init__方法3.返回这个对象的引用 1.创建对象name = "蓝猫"age = 102.调用__init__方法3.返回这个对象的引用 魔法方法2:__str__ 用来获取对象描述信息 def __self__(self): return xxx print(tom) 打印出xxx(调用tom的信息) class Cat: """定义了一个Cat类""" #初始化对象 def __init__(self, new_name, new_age): self.name = new_name self.age = new_age def __str__(self): return "%s的年龄是:%d"%(self.name, self.age) #方法 def eat(self): print("猫在吃鱼....") def drink(self): print("猫正在喝kele.....") def introduce(self): print("%s的年龄是:%d"%(self.name, self.age)) #创建一个对象tom = Cat("汤姆", 40) lanmao = Cat("蓝猫", 10) print(tom)print(lanmao) 打印结果为:汤姆的年龄是40蓝猫的年龄是10 通过全局变量 通过属性 来进行数据的共享 把函数的功能封装起来 def __test(self): pass 这种方式是方法私有化 del不是真正删除了 而是删除了引用 def __del__(self): pass python解释器调用 class Dog: def __del__(self): print("-----英雄over------") dog1 = Dog()dog2 = dog1 del dog1#不会调用 __del__方法,因为这个对象 还有其他的变量指向它,即 引用计算不是0del dog2#此时会调用__del__方法,因为没有变量指向它了print("====================") #如果在程序结束时,有些对象还存在,那么python解释器会自动调用它们的__del__方法来完成清理工作 测量一个对象引用的计数方式: 使用sys模块中的getrefcount函数 import sysclass T: pass t = T() sys.getrefcount(t)>>2 tt = tsys.getrefcount(tt)>>3 del ttsys.getrefcount(t)>>2 父类/基类 继承 子类/派生类 我们定义了一个Animal类 父类/基类 下面有个Dog Cat的子类 Dog下面定义了一个wangcai的方法 tom的方法 wangcai只能使用Dog Animal类中的方法tom只能使用Cat Animal类中的方法 不允许出现tom使用Dog中的方法或者是wangcai使用Cat中的方法 重写 在子类中重写父类的方法 调用的时候只会调用子类的方法 super().bark() super调用被重写的父类的方法 私有方法 私有的属性并不会被继承 如果调用的是继承的父类中的共有方法 可以在这个公有方法中访问父类中的私有属性和私有方法 但是如果在子类中实现了一个公有方法 那么这个方法是不能够调用继承的父类中的私有方法 class Base(object): pass class Base(object): def test(self): print("----Base") class A(Base): def test(self): print("-----A") class B(Base): def test(self): print("-----B") class C(A,B): pass #def test(self): # print("-----C") c = C()c.test() print(C.__mro__) 类名.__mro__决定调用一个方法的时候 搜索的顺序 如果在某个类中找到了方法 那么就停止搜索 定义的时候对象不确定 调用的时候确定对象 这个方法叫多态 python既支持面向过程 也支持面向对象 python面向对象的三个基本要素是 封装 继承 多态 一个特殊的属性 能够知道这个对象的class 类在程序里面也是一个对象 称为类对象 由类创建出的对象为实例对象 实例对象的属性为实例属性 实例属性和对象有关系 类对象中的属性为类属性 类属性和类有关系 类属性是共享的 实例属性:和具体的某个实例对象有关系并且 一个实例对象和另外一个实例对象是不共享属性的 类属性:类属性所属于类对象并且多个实例对象之间共享同一个 类属性 class Tool(object): #类属性 num = 0 #方法 def __init__(self, new_name): #实例属性 self.name = new_name #对类属性+=1 Tool.num += 1 tool1 = Tool("铁锹")tool2 = Tool("工兵铲")tool3 = Tool("水桶") print(Tool.num) 实例方法 类方法 静态方法 class Game(object): #类属性 num = 0 #实例方法 def __init__(self): #实例属性 self.name = "laowang" #类方法 @classmethod def add_num(cls): cls.num = 100 #静态方法 @staticmethod def print_menu(): print("----------------------") print(" 穿越火线V11.1") print(" 1. 开始游戏") print(" 2. 结束游戏") print("----------------------") game = Game()#Game.add_num()#可以通过类的名字调用类方法game.add_num()#还可以通过这个类创建出来的对象 去调用这个类方法print(Game.num) #Game.print_menu()#通过类 去调用静态方法game.print_menu()#通过实例对象 去调用静态方法 @classmethod 装饰器 固定写法 通过一个类进行分离解耦 在父类中不去实现 在子类中实现 这就是工厂方法模式 def __new__(cls): pass 当你继承一些不可变的class时(比如int, str, tuple), 提供给你一个自定义这些类的实例化过程的途径 class Dog(object): def __init__(self): print("----init方法-----") def __del__(self): print("----del方法-----") def __str__(self): print("----str方法-----") return "对象的描述信息" def __new__(cls):#cls此时是Dog指向的那个类对象 #print(id(cls)) print("----new方法-----") return object.__new__(cls) #print(id(Dog)) xtq = Dog() 1.创建一个对象2.调用__init__方法3.返回对象的引用 而__new__方法就是重写父类的new方法 1.调用__new__方法来创建对象,然后找了个变量来接受__new__返回值,这个返回值表示 创建出来的对象的引用 2.__init__(刚刚创建出来的对象的引用) 初始化 3.返回对象的引用 而构造方法是既创建对象 又初始化 和__init__方法不等价 __new__只负责创建对象 __init__只负责初始化 class Dog(object): __instance = None def __new__(cls): if cls.__instance == None: cls.__instance = object.__new__(cls) return cls.__instance else: #return 上一次创建的对象的引用 return cls.__instance a = Dog()print(id(a))b = Dog()print(id(b)) class Dog(object): __instance = None __init_flag = False def __new__(cls, name): if cls.__instance == None: cls.__instance = object.__new__(cls) return cls.__instance else: #return 上一次创建的对象的引用 return cls.__instance def __init__(self, name): if Dog.__init_flag == False: self.name = name Dog.__init_flag = True a = Dog("旺财")print(id(a))print(a.name) b = Dog("哮天犬")print(id(b))print(b.name) 异常处理: try: except 出现异常的名字: try:print(num)except NameError:print(111) Exception 如果用了Exception,那么意味着只要上面的except没有捕获到异常 这个except一定会捕获到 Exception 不管产生什么异常 都会捕获到 就不需要去写许多异常了 异常方面很多 as 预处理方案 会给出产生该异常的原因 #coding=utf-8 try: num = input("xxx:") int(num) #11/0 #open("xxx.txt") #print(num) print("-----1----") except (NameError,FileNotFoundError): print("如果捕获到异常后做的 处理....")except Exception as ret: print("如果用了Exception,那么意味着只要上面的except没有捕获到异常,这个except一定会捕获到") print(ret)else: print("没有异常才会执行的功能")finally: print("------finally-----") print("-----2----") Ctrl + C也是一个异常 自定义异常类 raise引发一个自定义的异常 log日志 会记录发生的异常 *.py文件就是模块 .pyc 字节码的后缀 翻译后的python代码 from 模块名 import 功能名1,功能名2,.....从模块中导入功能1,功能2,等等 from 模块名 import * 从模块中导入所有功能 这种方式缺陷:如果导入的模块的功能名相同 后面导入的会覆盖前面导入的 import msgmsg.text1() 通过模块名.功能名调用 import time as tt 导入time模块 给它取个名字 叫tttt.sleep(3) 不取和模块名相同的名字 import xxx class ClassName(object): def __init__(self,arg): pass def xxx(): pass def main(): pass if __name == '__main__': main() __all__ = ["功能名1","功能名2",...../或者类名也行] 定义的作用:放上将来你想要用的功能/类名,如果没放进去 调用import仍不能用 把模块有关联的放在一个文件夹中 在python2中调用文件夹名会直接失败在python3中调用会成功,但是调用不能成功 解决办法是: 在该文件夹下加入空文件__init__.py python2会把该文件夹整体当成一个包 然后编辑__init__.py 加入__all__ = ["功能名1","功能名2",...../或者类名也行] 再通过from 模块名 import *通用写法是:from . import 模块名 这样就可以调用包中那些模块功能了 #如果导入这个模块的方式是 from 模块名 import * ,那么仅仅会导入__all__的列表中包含的名字 setup.py from distutils.core import setup setup(name="dongGe", version="1.0", description="dongGe's module", author="dongGe", py_modules=['TestMsg.sendmsg', 'TestMsg.recvmsg']) 模块的发布过程:1.创建文件setup.py 传入模块.功能2.python3 setup.py build3.python3 setup.py dist4.生成压缩包,然后可以发布到github.com上 系统安装包sudo python3 setup.py install python2中range(10)返回值是一个列表[0,...,9]而在python3中返回值是range(0,10) range(0,10)在python2中返回是一个列表[0,...,9]而在python3中返回值是range(0,10) range有风险 如果将来你需要一个很大的值 因为需要占用很大的空间 所以不给你 如果python3中想要返回值是一个列表 使用a = [i for i in range(1,18)] 这样可以返回一个列表 在python2中这种写法也适合 (参数1,参数2,参数3,.....) for 参数1 in range(第1个数) for 参数2 in range(第2个数) 。。。。。。。 set 字典 list 列表 while True:1.检测事件,如果有时间就控制相应的图片移动2.把所有的图片重新画一遍 1/60s --> 动画效果 列表循环删除的时候不能删除循环的那个列表 我们可以申请一个新的列表去存 您可以考虑给博主来个小小的打赏以资鼓励,您的肯定将是我最大的动力。thx. 微信打赏 支付宝打赏 作 者: Angel_Kitty 出 处:http://www.cnblogs.com/ECJTUACM-873284962/ 关于作者:潜心机器学习以及信息安全的综合研究。如有问题或建议,请多多赐教! 版权声明:本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文链接。 特此声明:所有评论和私信都会在第一时间回复。也欢迎园子的大大们指正错误,共同进步。或者直接私信我 声援博主:如果您觉得文章对您有帮助,可以点击右下角【推荐】推荐一下该博文。您的鼓励是作者坚持原创和持续写作的最大动力!


优秀的个人博客,低调大师

Ruby学习笔记-Array

由于工作需要,最近在学习Ruby,现在主要在看两本书《Ruby on Rail程序设计技术详解》和《Ruby of book》。毕竟是要在工作中运用,而且时间还有限,所以我在看书和做例子的同时也简单记录下了一些基本知识点,方便用的时候查找。有兴趣的朋友欢迎一起交流学习: l数组 1.创建数组: 和其它很多编程语言一样,很容易创建一个数组,但要注意的是Ruby是一种弱类型的脚本语言,数组中各元素的类型可以互不相同,而且数组的长度可变: arr = [“one”,”two”,”three”] OR arr = Array.new#an empty array arr = Array.new(5)#[nil, nil, nil, nil, nil] arr = Array.new(5,”hello”)#[”hello”, ”hello”, ”hello”, ”hello”, ”hello”] 当创建一个数组时,如果其元素为string类型且使用单引号,而你又不想老输入单引号,那么我们可以使用下面的方法来创建(使用%W来创建用双引号括起来的字符串): arr = %w( this is an array of strings)#使用空格作为元素的分隔符 2.通过索引存取数组的值: 在Ruby中,数组索引可以是正整数(从前到后,从0开始)也可以是负整数(从后到前,从-1开始)还可以是范围(Range): arr = ['h','e','l','l','o',' ','w','o','r','l','d'] print arr[0,5] puts print arr[0..4] puts print arr[0...4] puts print arr[-5,5] --------Results-------- hello hello hell world Note:arr[-5,5]:前一个整数-5表示开始的索引,后面一个整数5表示数量 3..复制数组: 当使用”=”将一个数组变量赋值给另一个数组变量时,这两个数组变量引用的仍然是同一个数组,修改其中一个数组的值,另一个也会修改。我们可以使用Clone方法复制一个新数组: arr = [‘one’,’two’,’three’,] arr1= arr#arr和arr1引用的还是同一个数组,修改一个另一个也会修改 arr2=arr.clone#arr2是arr的一个新版本,修改arr2不影响arr 4..比较数组大小: 当使用<=>来比较两个数组a1和a2时,有三种情况: 1.a1小于a2,返回-1 2.a1等于a2,返回0 3.a1大于a2,返回1 那么,数组是如何比大小的呢? 当两个数组进行比较时,会把两个数组相同索引(从0开始)上的值拿来比较,如[0,10,20]<=> [0,20,20],则会返回-1,因为当索引为1时,10<20; 另外,如果比较的两个数组的元素是字符串,那么就比较它们的ASCII;如果一个数组比另一个长且其它元素都相同,那么数组长的‘大’。 然而,如果一个短数组里面的一个元素比另一个长数组里面的同位置的元素大,则认为短数组‘大’。 arr1=[1,2,3,4,5] arr2=[1,2,3,4,5] arr3=[1,2,3,4] arr4=[1,2,3,5] arr5=[1000,2000,3000] arr6=[1,2] arr7=[2,1] arr8=["hello", "world"] arr9=["Hello", "World"] p(arr1<=>arr2)#0 p(arr3<=>arr1)#-1 p(arr4<=>arr3)#1 p(arr5<=>arr4)#1 p(arr7<=>arr6)#1 p(arr8<=>arr7)#nil p(arr9<=>arr8)#-1 5.数组排序: Sort方法使用比较操作符<=>来比较一个数组中邻近的元素的大小,但是这个不能比较一个数组中包含有nil的值的情况; arr.sort{|a,b| a.to_s <=> b.to_s} 说明:在这arr是一个数组对象,a和b代表相邻的两个元素。本方法使用了to_s方法把nil转换为一个空字符串,这样就可以对含有nil的数组进行排序了。此外,这个数组本身的值不会发生任何变在。 6.添加和删除数组元素: 向数组添加元素: unshift:向数组头部添加数组元素 push:向数组头部尾数组元素 << :向数组尾部添加一个数组元素 向数组删除元素: shift:从头部删除数组元素,并返回被删除的元素 pop:从尾删除数组元素,并返回被删除的元素 本文转自贺满博客园博客,原文链接:http://www.cnblogs.com/puresoul/archive/2011/10/20/2218690.html,如需转载请自行联系原作者。

优秀的个人博客,低调大师

node.js笔记

第一章 用户在浏览器中输入 www.taobao.com 直到看到页面之间发生了什么?(浏览器的加载、解析、渲染过程)① 操作系统(windows)访问网络上DNS服务器,把域名转换为IP地址 DNS [www.taobao.com 60.28.242.250]② 浏览器向Web服务器发起HTTP请求③ web服务器接收并解析请求消息,查找指定资源,可能访问数据库,构建并返回http响应消息④ 浏览器接收并解析响应消息,发送请求获取嵌入在HTML中的资源(如图片、CSS、JS、视频、音频等)⑤ 浏览器(缓存)接收到解析内容,并解析和渲染响应内容 解析html构建DOM树→构建渲染树(render tree)→布局(layout)→绘制(painting)rendering树 布局(layout): 根据渲染树将节点树的每一个节点布局在屏幕上的正确位置创建渲染树后,下一步就是布局(Layout),也叫回流(reflow,relayout): 这个过程就是通过渲染树中渲染对象的信息,计算出每一个渲染对象的位置和尺寸,将其安置在浏览器窗口的正确位置,而有时会在文档布局完成后对DOM进行修改,这时候可能需要重新进行布局,也可称其为回流,本质上还是一个布局的过程,每一个渲染对象都有一个布局或者回流方法,实现其布局或回流在渲染树布局完成后,再次操作文档,改变文档的内容或结构,或者元素定位时,会触发回流,即需要重新布局$("div").css("margin-left","10px");$("div").css("margin-left","100px");此时并没有效果,因为对margin-left的修改并没有触发回流,元素margin-left值的改变被缓存,可以在中间强制触发回流$("div").css("margin-left","10px");$("div").css("margin");$("div").css("margin-left","100px"); 绘制(painting): 也叫重绘,遍历渲染树绘制所有节点,为每一个节点适用对应的样式通常,当改变元素的视觉样式,如background-color, visibility, margin, padding或字体颜色时会触发全局或局部重绘 静态网页和动态网页静态网页: 网页内容任何人在任何时间访问都是不变的:HTML/CSS/JS/Flash/音频/视频...动态网页: 网页内容任何人在任何时间访问可能都是不同的:JSP/PHP/NodeJS...① JSP = HTML+JAVA 功能强大可靠,适合大型企业级项目② PHP = HTML+PHP 简单易用,适合互联网项目③ ASP.NET = HTML+C# 易用,适合windows平台,但价格昂贵④ NodeJS = HTML+"JS" 性能好,适合服务器IO密集(如微博)型项目,不适合CPU密集(如天气预报)型项目_Nodejs概述Nodejs不是JS,而是一个软件开发平台(安装在服务器端),只不过使用的语言是JS,它的竞争对手是PHP/JSP/ASP.NET,历史上第一次有一种语言可以通吃前后端前端JS和Node.js区别:前端JS: 运行于客户端浏览器中,存在兼容性问题;数据类型: 值类型+引用类型(ES+DOM+BOM+自定义)Node.js: 运行于服务器端(V8引擎),不存在兼容性问题;数据类型: 值类型+引用类型(ES+扩展对象+自定义)官网: www.nodejs.org版本: 0.12(16年初) → 4.x(16年中) → 6.x(16年底)LTS: Long Term Support 长期稳定支持版本Current: 最新版本(不太稳定) 安装nodejs① 区别32 windows/64 windows: 计算机 → 右键 → 系统类型 32位安装: node-v6.10.2.x86.msi 64位安装: node-v6.10.2.x64.msi② windows系统下,双击安装文件 建议1: 安装目录不要c:\ 建议2: 安装目录不要中文,不要有空格③检测是否安装成功: 开始 → 运行 → cmd →node -v,显示:v6.10.2 即安装成功 Node.js的两种运行模式① 交互模式(REPL: Read Evaluate Print Loop)一般用于临时测试,输入一行代码执行一行注意: 交互模式自带输出功能,不必写console.log(...),但是可以在程序中 写 用来查看 node 回车,进入交互模式 .exit 退出交互模式② 脚本模式,正式项目中使用的方式把要执行的所有语句编写的一个文本文件中(后缀名为.js或不写),一次性提交给node解释器执行node 完整路径名/x.js 回车 //在cmd.exe下 按住Shift+右键 → 在此处打开命令窗口 → 输入相对路径名 回车提示: 只要安装完Node.js,重启一下WebStorm,WebStorm可以自动发现node.exe解释器程序 Run → Run 文件名 → 运行程序 新建的项目要修改默认的文件编码方式为 UTF-8_如何自学一门新语言 ——— Node.js① 了解背景 ——— 百度百科Node.js② 搭建开发环境,编写HelloWorld,下载并安装node-v6.10.2-x64.msi,使用(包含)V8引擎 交互模式、脚本模式③ 数据类型 ——— 重点面试题前端JS中的数据类型:① 基本/原生/原始/值类型: string、number、boolean、null、undefined② 引用/对象类型ES对象类型: String/Number/Boolean/Date/RegExp/Object/Function/Error/Array/Window/MathBOM对象类型: window、document、screen、history、location、navigator、event...DOM对象类型: Node、Element、Attr...用户自定义对象类型: { }后端Node.js中的数据类型:① 基本/原生/原始/值类型: string、number、boolean、null、undefined② 引用/对象类型ES对象类型: String/Number/Boolean/Date/RegExp/Object/Function/Error/Array/Window/MathNode.js官方与第三方对象: 目前有几百个... www.npmjs.com没有DOM和BOM用户自定义对象类型: { } ④ 变量和常量: var age = 20; const PI = 3.14;⑤ 运算符: 算术运算符 比较运算符 逻辑运算符 位运算符 三目运算符 赋值运算符 特殊运算符: instanceof typeof⑥ 逻辑结构: 循环结构: while do...while for( ; ; ) for(...in ...) for(...of ...) 选择结构: if...else... switch...case...⑦ 通用小程序:九九乘法表、100以内的质数、数组排序...⑧ 函数和对象⑨ 常用的组件、第三方工具、框架⑩ 实际小项目_Node.js中的特有概念 ———模块(Module)Modal: 模态框,登录时的遮罩层Model: CSS框模型,定义元素框处理元素内容,内边距以及外边距的方式Module:一个Web项目功能可以分为很多不同的"模块",如商品管理模块、用户管理模块、支付模块、促销模块、商家管理模块...Node.js按照功能的不同,可以把函数、对象分别保存到不同的文件、目录下,这些文件/目录在Node.js中就称为"Module"模块Node.js中每个模块都是一个独立的构造函数,解释器会为每个模块(.js)文件添加如下代码:(function(exports, require, module, __filename, __dirname){ size(); //自己编写的文件内容} ) //exports: 空对象{ } 用于声明向外部导出自己的成员 //require: 函数fn 用于导入其它的模块,创建指定模块对象 new //module: 代表当前模块 //__filename: 当前文件的绝对路径名 //__dirname: 当前文件所属目录的绝对路径名(后面加'..',表示上一级) 面试题: Node.js的模块中exports和module.exports对象的区别是什么?相同点: 二者都可以用于向外界导出自己内部的成员不同点: module 变量指代当前模块对象,真正导出的是module.exports Node.js 底层有代码: exports = module.exports module.exports可以向外导出对象或成员,exports只能向外导出成员所以: 若只是给exports对象添加新的成员,则等价于给module.exports添加新成员 但是若修改了exports的指向,则不会产生实质作用 每个模块都可以使用自己的require()函数引入另一个模块,底层本质就是创建了指定模块的一个对象实例引用模块:var obj=require('./要引入的模块文件名'); // ./:当前目录下,后缀名可不写,返回值是个对象使用: obj.成员名; 或 obj.成员名(); //变量不加(),函数加(),原函数若无形参则无法传参 每个模块可以使用exports对象向外导出/公开一些自己内部的成员供其它的模块使用要公开的成员:exports.成员名 = 成员值; //成员名: 调用时使用的名称;成员值: 内部成员名;函数也不加()Node.js中模块的分类① Node.js官方提供的原生模块 ——— 安装在解释器内部: var 变量名 = require('模块名'); global、querystring、url、fs、http、Buffer...② 第三方编写的模块: mysql、oracle、express...③ 用户自定义的模块: 文件模块和目录模块 Node.js预定义模块 ——— Global该模块提供的可以直接使用,而无需 require('global') exports: 用于向外部导出当前模块内部的成员 module: 用于指代当前模块 require: 用于引入其他模块 __filename: 返回当前模块的文件全名(绝对路径) __dirname: 返回当前模块所处目录的全名(绝对路径) console: 指代控制台对象,注意该对象与Chrome中console不同 console.log/dir/time/timeEnd/assert ... //console.log与Chrome中的console.log类似 timer模块(全局API,无需调用require('timers')),用于在某个未来时间段调用调度函数Node.js中的计时器函数实现了与Web浏览器提供的计时器类似的API,但使用了不同的内部实现,是基于Node.js事件循环构建的启动定时器:默认情况下,当使用setTimeout()或setInterval()预定一个定时器时,只要定时器处于活动状态,Node.js事件循环就会继续运行。这些函数返回的Timeout对象都导出了可用于控制这个默认行为的timeout.ref()和timeout.unref()函数定时器都会返回一个用于清除定时器的变量立即定时器(I/O事件的回调之后立即执行) setImmediate(callback[, ...args]) //callback: 在事件循环的当前回合结束时调用的函数 //arg: 当调用callback时要传入的可选参数周期性定时器(等待delay毫秒之后重复执行callback) setInterval(callback,delay[, ...args]) //当delay大于2147483647或小于1时,delay被设为1一次性定时器(预定在delay毫秒后执行的单次callback) setTimeout(callback,delay[, ...args])取消定时器: clearImmediate(immediate) clearInterval(timeout) clearTimeout(timeout) 第二章* 自定义模块的两种形式① 文件模块:创建一个js文件,如m3.js,导出需要公开的数据。其它模块可以require('./m3')模块② 目录模块 方式1: 创建一个目录,假设名为m4,其中创建名必须为index.js文件,导出需要公开的数据。其它模块可以require('./m4')模块 m4/index.js require("./m4"); 方式2: 创建一个目录,假设名为m5,其中创建名package.json文件,其中声明main属性指定默认执行的启动js文件,如'./5.js',其中导出需要公开的数据。其它模块可以require('./m5')模块 m5/package.json "main":"./1.js" 1.js 方式3: 创建一个目录,必须名为node_modules,在其中再创建目录模块,假设名为m6,在其中创建文件,必须名为package.json,其中声明main属性指定默认执行的启动js文件名,如'./6.js',其中导出需要公开的数据其它模块在node_modules的同级目录可以require('m6')模块 //只有这1种不加 ./ (若加会报错) node_modules/m6/package.json "main":"./6.js" 6.js_NPM包管理器Node Package Manager: Nodejs的第三方模块/包管理器,用于下载、删除、更新、维护包依赖关系的工具npm工具默认到www.npmjs.org网站下载所需的第三方模块/包标准语法:(在cmd.exe下),在哪里打开命令窗口,就自动下载到哪里下载一个新的软件包:npm install 包名,比如: npm i mysql删除指定的软件包: npm uninstall 包名更多的 npm 命令参数可以使用: npm -h 进行查看_① Node.js官方提供的原生模块 ——— querystring: 查找字符串querystring模块用于处理HTTP请求 URL中查询字符串const qs = require("querystring"); 加载querystring模块var obj = qs.parse(str); 把任意查询字符串转换为JS对象var str = qs.stringify(obj); 把JS对象转换为查询字符串JSON.stringify(result); 将js数据转换为JSON字符串 ② Node.js官方提供的原生模块 ——— urlurl模块用于解析一个HTTP请求地址,获取其中各个部分const url = require("url"); 加载url模块var obj = url.parse(str); 把一个URL字符串解析为一个对象var obj = url.parse(str,true);把URL字符串解析为一个对象,并把其中的查询字符串也解析为对象 ③ Node.js官方提供的原生模块 ——— Buffer 重点Buffer: 缓冲区,用于暂存以后要用到的数据(可能是数字、字符串、二进制图片/音视频等)缓存是CPU的一部分,它存在于CPU中,CPU存取的速度可达1G/秒,而内存最多几十M,缓存是用来解决CPU与内存的速度差异问题的。内存中被CPU访问最频繁的数据和指令被复制入CPU中的缓存,这样CPU只需要到缓存中去取数据就可以了,而缓存的速度要比内存快的多Buffer模块是全局模块,可以直接使用,无需加载var buf1 = Buffer.alloc( 1024*n ); //创建一个指定大小的缓冲区(最大2M),1024:字节byte,简写为bvar buf2 = Buffer.from( [1,3,5] ); //创建一个缓冲区,用来存放数字数组var buf3 = Buffer.from( 'abcdefg' ); //创建一个缓冲区,用来存放字符串var str = buf3.toString(); //把一个缓冲区中的数据(buf)转换为字符串 ④ Node.js官方提供的原生模块 ——— fs 重点fs模块提供了对文件系统中的文件/目录进行增删改查、读写的功能同步: NodeJS解析器 与 磁盘: 一个工作时,另一个等待异步: NodeJS解释器 与 磁盘: 可以同时工作const fs=require("fs"); //加载fs模块var data = fs.readFileSync("./文件路径"); //同步(Synchronize)读取文件中的内容fs.writeFileSync("./文件路径",str/buf); //同步向文件中写入内容(同时删除已有内容) //写入的文件如 ./public/2.log不必先创建,nodejs发现如果没有此文件,会先创建再写入fs.appendFileSync("./文件路径",str/buf); //同步向文件中追加写入str/buf内容(不删除已有内容) fs.readFile("./文件路径",function(err,data){...} ); //异步读取文件中的内容,data: 返回的内容fs.writeFile("./文件路径",str/buf,function(err){...} );//异步向文件中写入内容(删除已有内容)fs.appendFile("./文件路径",str/buf,function(err){...} ); //异步向文件中追加写入str/buf内容 (不删除已有内容)if(err) throw err; //抛出错误,用于出错时的提示注意: 在项目中,文件读写可以使用同步或异步,但推荐使用异步方法: 可以最大限度的发挥Nodejs的优势_⑤ Node.js官方提供的原生模块 ——— http 重点HTTP模块可用于编写基于HTTP协议的客户端程序(即浏览器),也可以编写基于HTTP协议的服务器端程序(即Web服务器)用http模块编写一个Web服务器: 接收客户端的HTTP请求消息 解析客户端请求消息 读取客户端请求的文件 向客户端发送HTTP响应消息,主体就是客户端请求的文件 http=require("http"); //加载http模块 var server = http.createServer(); //创建http服务器server.listen(8080); //让http服务器监听端口,当客户端发起此端口请求时,连接服务器 //范围: 1-65535,1023以下是互联网公共程序使用,最好不用)server.on('request',function(req,res){ //绑定请求事件requestres.setHeader("Content-Type","text/html;charset=utf-8") 设置响应主体格式(绑定事件后)req 请求对象request(客户端请求信息),解析请求消息 req.method 客户端请求方式 req.httpVersion 客户端请求版本 req.url: 客户端请求程序地址 var path=url.parse(req.url).pathname 客户端请求路径pathname(对象格式) var objUrl=url.parse(req.url,true): //.pathname: 如: '/login.html',带后缀,?之前的字符 //.path: 如: '/login.html?uname=tim&uid=10' //.query: 发送的字符串,如: { uname: 'tim', uid: '10' url.parse(str,true);时才是对象,否则为字符串 //.search: 如: '?uname=tim&uid=10' res 响应对象response(服务器输出信息),向客户端输出响应消息 res.statusCode=200 设置响应状态码为200 (默认200,可以省略) res.write("html标签") 输出响应主体(也可输出data数据) res.end(data); 输出数据后结束(也可换成html标签)} ) 若想用ajax,需要将data放在函数中,函数名要与ajax的jsonpCallback的值一致一个端口只能启动一个服务器,否则会报错'rn': 换行回车,用于追加输出数据加载模块放在最上面,否则可能会出错用户请求先经过服务器,再连接数据库查看端口状态是否驱动: netstat -an/ano //在cmd.exe下 第三章* 使用Node.js访问MySQL服务器为了精简Node.js解释器,官方没有提供任何访问数据库的相关模块,必须使用npm工具下载第三方模块在www.npmjs.org上搜索关键字mysql,可以得到很多相关的模块,每个模块都有使用说明使用npm工具下载mysql模块: npm i mysql //在cmd.exe下mysql 模块的使用步骤:① 创建与服务器数据库的连接:const mysql = require('mysql');var conn = mysql.createConnection({ host:"127.0.0.1", //服务器主机IP地址 user:"root", //mysql用户名 password:"", //mysql密码 database:"jd" //mysql数据库名}); ② 创建SQL语句,发送给服务器数据库执行:$sql="insert into jd_user values(null,?,?)"; //用 ? 占位符预先输入数据 //代替字符串/日期要加的引号,常规入侵手段失效conn.query($sql,["tom","123"],function(err,result){});③ 关闭连接: conn.end();_为了提升数据库操作性能,nodejs提供了完善功能的连接池(应用完后归还连接)工作机制:在系统启动时自动创建多个连接,保存在内存中,当应用需要连接时,租用一个连接,应用完成后归还连接Nodejs使用连接池操作 mysql 的使用步骤:① 创建数据库连接池:const mysql = require('mysql');var pool = mysql.createPool({ host:"127.0.0.1", //服务器主机IP地址 user:"root", //mysql用户名 password:"", //mysql密码 database:"jd", //mysql数据库名 connectionLimit:10 //指定系统启动时最小连接池数量,默认为10}); ② 从连接池获取其中一个连接:pool.getConnection((err,conn)=>{ if(err){ throw err }; varsql="insert into jd_user values(null,?,?)"; //var sql=... <=> $sql=... conn.query(sql,['tom',obj.p],(err,result)=>{//result是对象组成的数组(查询)/对象(添加) (日期至少要写年月日) //result.length==0判断是否成功 if(err){ throw err }; elseif(result.affectedRows>0){ //添加记录影响的行数>0,表示操作成功,result表示返回结果 console.log("添加成功:"+result.insertId); //添加记录后,自增的Id值 conn.release(); //③释放连接,回到连接池。不必conn.end(),但要先res.end(),输出结束 若不释放,服务器数据库运行速度会越来越慢 } })}); 第四章* NodeJS 框架 Express使用官方提供的http模块可以创建一个web服务器应用,但是此模块非常底层,要处理各种情形,比较繁琐。推荐使用http模块进一步封装简化的模块: express (第三方模块)第三方模块,是基于nodejs的http模块而编写的高层模块,简化了web服务端应用的开发,express是一个请求处理工具,用于接收客户端请求消息,返回响应消息可以到 npmjs.org 上下载该模块: npm i express该模块自己的官网: http://expressjs.com该模块的中文镜像网站: http://www.expressjs.com.cn使用方法:(框架里包含简单的404页面)① 在自己的模块中引入express模块:const http = require("http"); //加载http模块const express = require("express"); //加载express模块② 使用http模块创建一个web服务器对象,让express() 处理请求var app = express(); //创建express对象var server = http.createServer(app); //创建web服务器server.listen(8080); //绑定监听端口 请求方法:① 在浏览器地址栏输入127.0.0.1:8080/请求路径 ② a/img/script/link的href/src属性="/请求路径" ③ ajax的url设置为"/请求路径" ④ ajax的url设置为"http://127.0.0.1:8080/请求路径"(不同域需要跨域,必须加http)app.get('/请求路径',处理函数(req,res)=>{ //路由: 处理get请求,根路径: "/" 不加.点 //express中的req和res继承http模块中的req、res,但功能上有很大增强 res.send(...); //res.send()是express提供的简化版,自动识别发送的格式 //res.send() 相当于 res.setHeader()+res.write()+res.end() res.sendFile(__dirname+"/public/index.html"); //__dirname: 当前文件所属目录的绝对路径名 //res.sendFile() 相当于 fs.readFile()+res.setHeader()+res.write()+res.end() //路径: 相对路径(以当前程序路径为准)/绝对路径(以磁盘路径为准) res.json(result); //将 js数据(可以是数组/对象等) 转化为JSON字符串,输出给客户端 //res.json() 相当于JSON.stringify(result)+res.setHeader()+res.write()+res.end()});发送JSON格式数据的好处: 程序灵活,适用于各种不同的环境(ajax/ios/安卓/...)不同的请求方式,请求路径可以相同,但应避免相同express路由: 路由(Route) = Method(请求方式)+Path(url地址)+fn(处理函数)_如何使用express 4.0处理静态资源(jpg/html/css/js...)文件官方提供了函数(中间件,Middleware): app.use(express.static('public目录'));(不加 / )若客户请求了/public目录某个指定资源("style.css"),它可以直接向客户端返回,不会再调用后续路由若请求的是public下的子文件夹中的文件,则请求url改为: "login.html"app.get("/",(req,res)=>{res.redirect("login.html");}) //自动跳转到指定页面开发时,公共资源与以前相同,开发好后,把文件整体放在public下即可(使用ajax时要用服务器) express是一个自身功能极简,完全是由路由和中间件构成的web开发框架: 从本质上说,一个express应用就是调用各种中间件函数中间件是一个函数,它可以访问请求对象(request),响应对象(response)中间件工作于请求和响应之间,与路由混合使用中间件的功能包括:① 执行任何代码② 修改请求和响应对象③ 终结请求—响应循环④ 调用堆栈中的下一个中间件标准语法app.use(url,(req,res,next)=>{ //中间件要执行的代码 next(); //调用下一个中间件或者路由});_① 引入各种模块② 用http模块创建服务器对象(var server = http.createServer(app))③ 创建数据库连接池(var pool = mysql.createPool)④ 判断请求(request): app.get/app.post...⑤ 从连接池获取连接(pool.getConnection),并执行相应的操作(操作mysql数据库(conn.query))⑥ 发送数据res.send(),并释放连接conn.release() 客户端JS与服务器的NodeJS整合在一个项目中① 客户端请求静态HTML页面② 服务器返回客户端请求静态资源 app.use(express.static("url"))③ 客户端加载完成,AJAX异步请求动态数据④ 服务器返回动态数据(一般数据都是JSON格式)⑤ 客户端异步动态数据,解析出来,挂载到DOM树上_GET: 表示客户端想获得指定的资源 发起方式:浏览器地址栏输入URL、超链接、标签href /src、js跳转、表单GET、AJAX-GETPOST: 表示客户端想添加/上传指定数据给服务器,相关数据在请求主体中 发起方式:表单-POST提交、AJAX-POSTPUT: 表示客户端想"放置/更新"服务器上指定资源,相关数据在请求主体中DELETE: 表示客户端想删除服务器上指定资源PUT和POST语义区别:所有请求方法中只有二个有请求主体,都可以向服务器传送数据PUT: 一般情况表示更新,多次请求也只能产生一条影响POST:一般情况表示添加,每次POST请求都在服务器上产生一条数据记录GET /user 表示客户端想获取所有用户数据GET /user?pno=2&psize=10 表示客户端想分页获取数据请求字符串: /user?uid=10&loc=bjapp.get("/user",(req,res)=>{ req.query.uid; //express为每一个req对象添加 query(查询) 属性 req.query.loc;});GET /user/pno/2/psize/10 表示客户端想分页获取数据请求字符串: /user/jsj/60 //请求时不用加:app.get("/user/:type/:id",(req,res)=>{ req.params.type; //express为每个req对象添加 params(参数) 属性 req.params.id;});GET /user/10 表示客户端想获取编号为10数据POST /user uname=tom&age=10 表示客户端想添加一条记录app.post(url,(req,res)=>{ req.on("data",(data)=>{ //为req对象绑定事件,接收请求主体的数据 var obj = qs.parse(data.toString());//把收到的数据(buf)转为字符串 //再把任意字符串转换为JS对象 //POST请求会把数据统一转换为Buffer数据发送给服务器 })});PUT /user uname=james&uid=1 表示客户端想更新一条记录app.put(url,(req,res)=>{ req.on("data",(data)=>{ //为req对象绑定事件,接收请求主体的数据 var obj = qs.parse(data.toString()); })});DELETE /user 表示客户端想删除服务器所有用户数据app.delete(url,(req,res)=>{});DELETE /user?uid=9 表示客户端想删除服务器编号为9用户DELETE /user/9 表示客户端想删除服务器编号为9用户 _ 发送json过程中,php与nodejs 的区别php与nodejs都是服务器端技术,发送json字符串php一个对象: echo '{"uname":"tom","code":1}';一个数组: echo json_encode($rows); nodejs(express)一个对象: res.json({code:1,bid:10});一个数组: res.json(result); AJAX 接收一个对象$.ajax({ url:"/book", success:function(data){ console.log(data.bid); }});AJAX 接收一个数组$.ajax({ url:"/book", success:function(data){ for(var i=0;i var o = data[i]; }}});

优秀的个人博客,低调大师

hive 使用技巧笔记

来源: http://michael-roshen.iteye.com/blog/2115268 例子: INSERT OVERWRITE TABLE prices_collected_${hiveconf:wid_version} select pc.collect_id as product_id , regexp_extract(pc.price,'(\\d*\\.?\\d+)',1) as price , pc.region, '' as location_area_code, '' as city_code, from_unixtime(unix_timestamp() , 'yyyy-MM-dd hh:mm:ss') as created_at, from_unixtime(unix_timestamp() , 'yyyy-MM-dd hh:mm:ss') as updated_at from products_compared_${hiveconf:wid_version} as pc 1.根据hive执行的参数来动态的设置表名称prices_collected_${hiveconf:wid_version} hive -hiveconf wid_version='4' 则可以通过${hiveconft:wid_version}来接收参数,生成prices_collected_4这张表 2. 使用正则表达式获取需要的信息,如:获取一段字符串中的数字 regexp_extract(pc.price,'(\\d*\\.?\\d+)',1) as price 注意hive中需要使用双斜杠来处理正则表达式 3. 获取系统时间 from_unixtime(unix_timestamp() , 'yyyy-MM-dd hh:mm:ss') as created_a 使用from_unixtime(unix_timestamp() , 'yyyy-MM-dd hh:mm:ss')获取系统时间,格式可以根据需要调整 4. 多个表进行join的时候,可能会报错 使用set hive.auto.convert.join=false;解决 5. 创建表 create table if not exists brands ( name string, created_at string, updated_at string ) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t' ESCAPED BY '\\' STORED AS TEXTFILE; 以文本方式进行存储,"\\"进行转义,"\t"作为换行符 6.到处hive中的某个表中的数据到本地,执行hive命令如下: hive -hiveconf local_path=/home/hive/hive_data/products_24_1 -hiveconf hive_table=products_24_1 -hiveconf columnstr=' name , created_at, updated_at, "released" as status ' -f /home/hive/export_hive_table_to_local.sql 需要执行的参数依次是 1.导出到本地的位置local_path 2.导出hive中的哪个表hive_table 3. 导出products_24_1 表中的哪些字段 colunmstr 4. 根据上面的参数,在本地创建products_24_1 表,使用-f来指定调用的文件 /home/hive/export_hive_table_to_local.sql 文件内容如下: insert overwrite local directory '${hiveconf:local_path}' ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t' ESCAPED BY '\\' STORED AS TEXTFILE select ${hiveconf:columnstr} from ${hiveconf:hive_table}; 7.将本地文件导入到psql数据库中, hive对pg的支持不好,不能用sqoop来进行数据的导入,可以先将hive中的数据读到本地,在使用python脚本来进行文件的写入 Python代码 definsert_to_pg(conn,table_name,file_path,insert_columns=None): conn=psycopg2.connect(conn) cursor=conn.cursor() ifos.path.isfile(file_path): datafile=ReadFileProgress(file_path) cursor.copy_from(file=datafile,table=table_name,sep='\t',null='\\N',size=81920,columns=insert_columns) datafile.close() Python代码 #!/usr/bin/python ##_*_coding:utf-8_*_ importos,sys importpsycopg2 classReadFileProgress: def__init__(self,filename): self.datafile=open(filename) self.totalRecords=0 self.totalBytes=os.stat(filename).st_size self.readBytes=0 self.datafile.readline() i=0 fori,linenumerate(self.datafile): pass self.totalRecords=i+1 sys.stderr.write("Numberofrecords:%d\n"%(self.totalRecords)) self.datafile.seek(0) self.datafile.readline() self.perc5=self.totalBytes/20.0 self.perc5count=0 self.lastPerc5=0 sys.stderr.write("Writingrecords:0%") defcountBytes(self,size=0): self.readBytes+=size if(self.readBytes-self.lastPerc5>=self.perc5): self.lastPerc5=self.readBytes if(int(self.readBytes/self.perc5)==5): sys.stderr.write("25%") elif(int(self.readBytes/self.perc5)==10): sys.stderr.write("50%") elif(int(self.readBytes/self.perc5)==15): sys.stderr.write("75%") else: sys.stderr.write(".") sys.stderr.flush() defreadline(self,size=None): countBytes(size) returnself.datafile.readline(size) defread(self,size=None): self.countBytes(size) returnself.datafile.read(size) defclose(self): sys.stderr.write("100%\n") self.datafile.close() 8. 从pg上导出指定表 Python代码 defdo_export(conn,table_name,file_path,columns=None): conn=psycopg2.connect(conn) cursor=conn.cursor() cursor.copy_to(file=file(file_path,'w'),table=table_name,sep='\t',null='\\N',columns=columns) cursor.close() conn.commit() sys.stdout.write("Transactionfinishedsuccessfully.\n") 9. 则select语句中也可以通过hiveconf来传递参数,执行hive命令 hive -hiveconf name='hello hive' INSERT OVERWRITE TABLE companies select '${hiveconf:name}' as name from companies_old 本文转自 SimplePoint 51CTO博客,原文链接:http://blog.51cto.com/2226894115/1898261,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册