首页 文章 精选 留言 我的

精选列表

搜索[价值断层],共10000篇文章
优秀的个人博客,低调大师

多引擎集成挖掘湖上数据价值

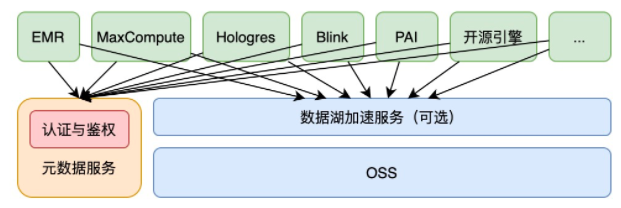
数据湖已经逐步走到了精细化的管理,这意味着原始的计算引擎直接读写存储的方式应当逐步演变为使用标准方式读写数据湖存储。然而“标准方式”实际上并无业界标准,与具体的计算引擎深度绑定,因此,支持计算引擎的丰富程度也就成了衡量数据湖的一个准则。 阿里云数据湖构建服务支持丰富的计算引擎对接,包括但不限于阿里云产品 E-MapReduce(EMR)、MaxCompute(开发中)、Blink(开发中)、Hologres(开发中)、PAI(开发中),以及开源系的 Hive、Spark、Presto 等等。 数据湖的对接主要体现在元数据与存储引擎两个方面。元数据为所有用户所共享,提供统一的元数据访问接口。各个引擎使用定制化的元数据访问客户端来访问元数据。元数据服务为各个用户提供租户隔离保证和认证鉴权服务。在数据存储方面,用户使用自己的 OSS 存储存储数据,各个引擎需要具备访问 OSS 的功能,这对于阿里云服务和大部分支持 HDFS 存储的引擎都不是什么问题。在 OSS 存储上层,数据湖构建服务还提供了可选的数据湖加速服务。而使用该服务也非常简单,只需要在引擎侧将对 OSS 的访问路径替换为加速服务提供的路径即可。 多引擎支持 EMR 使用 EMR 访问数据湖构建服务最为简单。在用户创建 EMR 集群的时候,可以直接选择使用数据湖构建服务的元数据服务作为元数据库,EMR 服务与数据湖构建服务在认证鉴权方面深度打通,只要获得用户的授权,EMR 基于数据湖元数据的使用体验和用本地元数据库体验几乎完全一致。因为在 EMR 集群创建阶段已经自动安装了数据构建服务的相关SDK,同时EMR上的开源计算引擎 Spark、Hive 和 Presto 都完成了对数据湖构建服务的兼容支持,所以用户通过 EMR 引擎可获得数据湖分析的最佳体验。 即便用户在创建集群的时候没有选择使用数据湖元数据服务,也可以在后期通过配置将元数据转移到数据湖元数据服务。在数据存储方面,由于数据湖构建在用户 OSS 之上,因此不存在跨服务认证问题。而 EMR 天然内置了 OSS 的访问支持,并提供了 JindoFS 的增强功能,使得 EMR 用户访问数据湖数据将获得比原生 OSS 访问更佳的性能提升(JindoFS 是构建在 OSS 之上的,专门为大数据使用场景深度定制的文件系统,在元数据操作、数据缓存等方面有独到的优势。更多相关文章请参考文末链接。)。对于那些已经在使用 EMR 的用户,数据湖构建服务提供了一键迁移工具,方便用户将元数据从本地元数据库转移到数据湖元数据服务。对于数据部分,用户可以选择将数据继续存储在本地 HDFS 系统,或者迁移至 OSS。 值得一提的是 EMR 提供了免 AK 访问数据湖构建服务的功能。用户不需要提供 AK 即可访问元数据服务以及 OSS 上的数据,前提是数据湖构建服务获得了用户的授权。该功能的实现基于 EMR 的 MetaService 功能,在用户授权的前提下,MetaService 为本机请求提供 Assume Role 的 AK 信息,从而让调用者以用户身份访问目标服务。免 AK 访问功能最小化了用户机密信息丢失的风险。 阿里云服务 MaxCompute、实时计算、Hologres、PAI 等阿里云服务,通过数据湖构建服务在底层打通数据,在一定程度上达到通过使用一份数据满足多种不同场景的计算需求。例如,MaxCompute 可以直接读取数据湖构建服务的数据内容,配合 DataWorks 给用户良好的数仓使用体验;实时计算服务可以将数据实时注入数据湖,从而实现基于数据湖的流批一体计算;而 Hologres 则可以应对对性能要求较高的场景,既能够对于数据湖内温冷数据做加速分析,也能够配合 Hologres 的内置存储处理温热数据,从而构建数据从产生到归档一整个生命周期的一站式分析方案;PAI 则可以将数据湖作为数据来源,也可以将其他引擎计算的离线特征存储到数据湖做模型构建之用等等。 开源引擎 对于直接使用开源产品的用户,数据湖构建服务也提供了一些方法让这些服务能够快速对接数据湖,不过这可能需要用户基于开源代码打个 patch,以便在开源代码中插件化地嵌入数据湖元数据的访问。对于数据访问,由 EMR 团队贡献 Hadoop 社区的 OSSFileSystem 可以完成对用户 OSS 存储的访问,因此只要引擎支持读写 HDFS,就可以读写 OSS。对于元数据和 OSS 的访问控制,则统一使用阿里云 RAM 方式,体验上保证一致。 特殊格式支持 除了计算引擎本身,某些引擎还可以读写特定的表格式,如近两年兴起的 Delta Lake、Hudi、Iceberg 等等。数据湖构建服务不局限用户使用哪一种存储格式,但是由于这些表格式有自己的元数据,因此在引擎对接方面仍然需要做一些额外的工作。以 Delta Lake 为例,其元数据存储在 OSS 之上,而元数据服务中也会存一份元数据,这样便引出了两个问题:一是引擎应该读取哪份元数据,二是如果有必要存两份元数据的话,元数据的一致性如何保证。对于第一个问题,如果是开源组件,我们应当遵循开源默认的做法,通常是让引擎去读取 OSS 中的元数据。对于元数据服务中的元数据也非常有必要保存,这可以服务于页面显示,并且可以省去 OSS 元数据解析的巨大性能损耗。对于第二个问题,数据湖构建服务开发了一个 hook 工具,每当 Delta Lake 有事务提交时,便会自动触发 hook,将 OSS 中的元数据同步到元数据服务中。除此之外,Delta Lake 元数据的设计最大程度的保证了一份元数据同时支持 Spark、Hive、Presto 等多个引擎,用户不必像开源产品那样为不同引擎维护不同的元数据。 如图所示,元数据服务中的元数据(Delta Table)为 OSS 中 Delta 表元数据(Delta Log)的映像,并通过 commit hook(3)保持同步;Delta Tabe 为页面展示,以及 Hive、Spark 引擎读取必要信息(如 table path、InputFormat/OutputFormat 等)所用(1);当引擎获得必要信息后读取 table path 下 Delta 表的元数据,完成元数据解析和数据读取工作(2);当引擎完成数据操作并提交事务后,Delta Log 通过 commit hook 同步至 Delta Table(3),完成一个循环。 未来工作 数据湖构建服务的多引擎支持在诸多方面尚在快速发展之中。未来我们将围绕以下几点继续开展工作: 阿里云服务对接:从解决方案角度完善阿里云产品对接,给用户更平滑的体验; 开源引擎支持:更多的开源引擎支持,如 Impala、Flink 等; 功能丰富:如完善统计信息支持,支持事务接口等; 性能提升:做到超越本地元数据与本地 HDFS 存储的性能。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册