首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10000篇文章
优秀的个人博客,低调大师

Java入门之异常处理

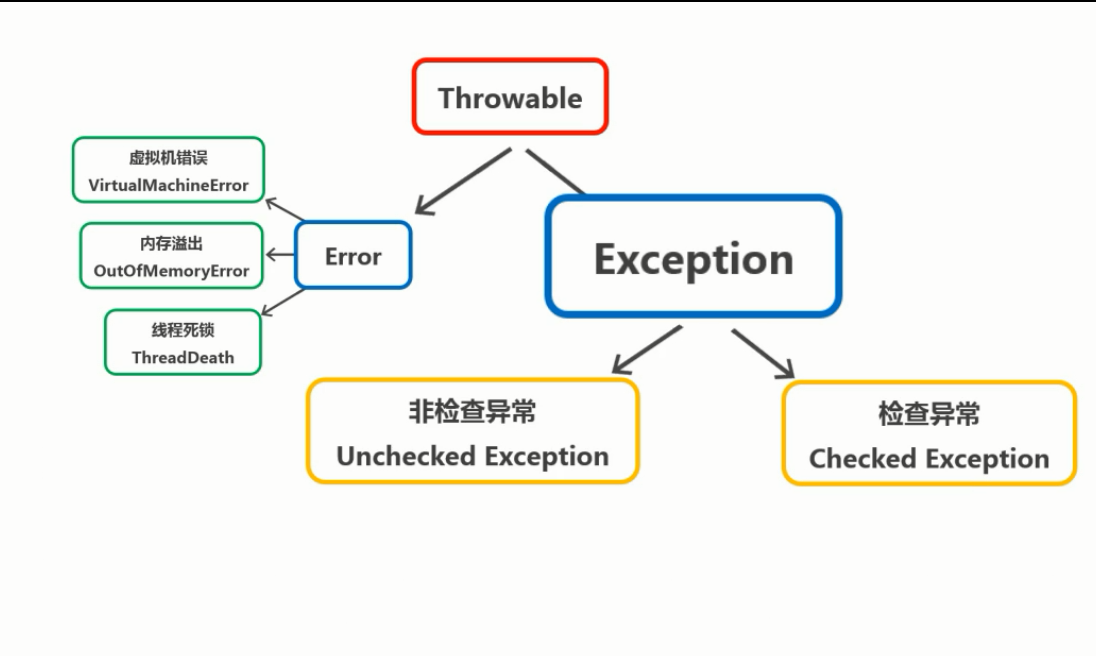
异常处理 如何处理异常 1. try-catch-finally 2. throw 3. throws 4. 自定义异常 5. 异常链 根类:Throwable 两个子类:Error、Exception image.png 上图中非检查异常,表示的是编译器不要求强制处理的异常,包括: image.png 检查异常:在程序编码阶段就被要求必须进行异常处理,否则编译无法通过。 image.png Java中异常通过五个关键字来实现: try catch finally throw throws image.png try-catch-finally public class TryDemo { public static void main(String[] args){ int a = 10; int b = 0; try { int c = a/b; }catch (ArithmeticException e){ System.out.println("出错了"); }finally { System.out.println("一定会执行"); } } } 使用多重catch结构处理异常 public class TryDemo { public static void main(String[] args){ int a = 10; int b = 0; try { int c = a/b; }catch (ArithmeticException e){ System.out.println("出错了"); }catch (Exception e){ System.out.println("33333"); } finally { System.out.println("一定会执行"); } } } Exception 父类异要放在最后一个catch块中。 注意:如果在finally块中和catch块中都有return语句,最终只会执行finally中的return,不会执行catch块中的return。在代码编写中不建议把return放到finally块中。 使用throws声明异常类型 public class TryDemo { public static void main(String[] args){ try { int result = test(); }catch (ArithmeticException e){ System.out.println(e); }catch (InputMismatchException e){ System.out.println(e); } } public static int test() throws ArithmeticException, InputMismatchException{ System.out.println("d"); } } 使用throw抛出异常对象 throw抛出的只能是可抛出类Throwable或者其子类的实例对象。 当方法当中包含throw抛出对象的语句时,常规的处理方法有两种: 方法一: public void method(){ try{ throw new 异常类型(); }catch(异常类型 e){ //处理异常 } } 方法二:谁调用了当前的方法谁就来处理异常 public void method() throws 异常类型{ throw new 异常类型(); } 自定义异常类 使用Java内置的异常类可以描述在编程时出现的大部分异常情况。 也可以通过自定义异常描述特定业务产生的异常类型。 所谓自定义异常,就是定义一个类去继承Throwable类或它的子类。 异常链 有时候我们在捕获一个异常后再抛出另一个异常。 异常链:将异常发生的原因一个传一个串起来,即把底层的异常信息传给上层 ,这样逐层抛出。

优秀的个人博客,低调大师

Python打包系统简单入门

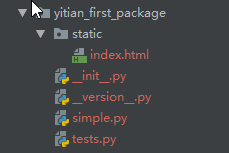
最近把pyenv、pipenv这种都研究了一下,然后我发现一个严重的问题:就是我虽然看了半天这些工具,但是我对Python自己的打包系统却完全没有了解。所以这篇文章就来研究一下Python自带的打包系统。 pip 先来详细介绍一下pip的用法,平时基本上我们用pip的时候也就是一个pip install。其实pip也有很多特性,在此先介绍一下常用的一些特性。此部分参考了pip文档,想了解更多的话可以看原文。 安装 最常用的命令就是安装了,除此以外还可以指定版本号: $ pip install SomePackage # 不指定版本号,安装最新版 $ pip install SomePackage==1.0.4 # 指定版本号 $ pip install 'SomePackage>=1.0.4' # 指定最小版本号 $ pip install -r requirements.txt # 从需求文件安装 $ pip install -e . # 从本地项目setup.py安装 使用代理服务器 当从官方的PyPI源安装比较慢的时候,可以考虑使用代理服务器,指定代理服务器的方法有三种: 使用--proxy参数在命令行指定,代理格式为[user:passwd@]proxy.server:port。 在配置文件中指定。 设置http_proxy, https_proxy 和no_proxy环境变量。 使用需求文件(requirements.txt) 在需要很多pip包的项目中,用pip一个个安装包不是一个好办法,这时候可以考虑使用需求文件。 如果要生成需求文件,用下面的命令。这会将当前Python环境中的所有包的当前版本状态保存下来,将来安装的时候会精确还原到冻结的那个状态。 pip freeze > requirements.txt 要从需求文件中安装,则是用下面的命令: pip install -r requirements.txt 官方文档还给出了一个带注释的实例需求文件: # ####### example-requirements.txt ####### # ###### 没有版本标识符的包,会安装最新版 ###### nose nose-cov beautifulsoup4 # ###### 带版本标识符的包 ###### # 版本标识符的资料 https://www.python.org/dev/peps/pep-0440/#version-specifiers docopt == 0.6.1 # Version Matching. Must be version 0.6.1 keyring >= 4.1.1 # Minimum version 4.1.1 coverage != 3.5 # Version Exclusion. Anything except version 3.5 Mopidy-Dirble ~= 1.1 # Compatible release. Same as >= 1.1, == 1.* # ###### 还可以指定其他的需求文件 ###### -r other-requirements.txt # # ###### 还可以指定本地货网络上的特定包 ###### ./downloads/numpy-1.9.2-cp34-none-win32.whl http://wxpython.org/Phoenix/snapshot-builds/wxPython_Phoenix-3.0.3.dev1820+49a8884-cp34-none-win_amd64.whl # ###### Additional Requirements without Version Specifiers ###### # 和第一部分一样,这里这些部分没有顺序需求,可以随意改变位置 rejected green # 版本标识符用来指定包的版本,有以下几个例子: SomeProject SomeProject == 1.3 SomeProject >=1.2,<.2.0 SomeProject[foo, bar] SomeProject~=1.4.2 从6.0版本开始,pip也支持环境标记(也就是分号后面跟Python版本或者系统类型): SomeProject ==5.4 ; python_version < '2.7' SomeProject; sys_platform == 'win32' 卸载 卸载某个包使用下面的命令: $ pip uninstall SomePackage 列出包 要列出所有已安装的包: $ pip list docutils (0.9.1) Jinja2 (2.6) Pygments (1.5) Sphinx (1.1.2) 要列出过时的包: $ pip list --outdated docutils (Current: 0.9.1 Latest: 0.10) Sphinx (Current: 1.1.2 Latest: 1.1.3) 要列出某个已安装的包的详细信息: $ pip show sphinx --- Name: Sphinx Version: 1.1.3 Location: /my/env/lib/pythonx.x/site-packages Requires: Pygments, Jinja2, docutils 搜索 要搜索一个包,用下面的命令,搜索结果可能有很多: $ pip search "query" 更新 要更新一个包,使用-U或者--upgrade参数: pip install -U <pkg> 如果想更新所有的包,很遗憾,pip并没有提供该功能,我在StackOverFlow上找到一个看起来比较简单的解决办法,就是在Python解释器中执行下面的代码: import pkg_resources from subprocess import call packages = [dist.project_name for dist in pkg_resources.working_set] call("pip install --upgrade " + ' '.join(packages), shell=True) 以上就是pip的一些简单用法,详情可参考官方文档。 打包项目 下面就进入本文的正题,Python的打包系统上。基本上我们不需要完全了解打包系统,只要学会简单的几个点就可以打包自己的类库了。打包需要distutils、setuptools、wheel等类库,不过基本上我们只需要写好其中最重要的setup.py,就可以完成打包工作了。distutils是官方的类库,在当年有很广泛的使用,不过到了现在很难用。distutuils类库的核心就是setup函数,我们需要将项目的各种信息作为参数传递给setup函数,然后就可以用相关命令创建项目分发包了。关于distutils的用法,可以参考官方文档。 当然现在项目基本都不用distutils了,有更好用的第三方替代品,那就是setuptools,它可以算作是distutils的加强版,功能更加强大、使用更加简单,这就是这里要介绍的。其实从文档就可以看出来,distutils毕竟时间比较早,有些接口设计的不太合理甚至有些反人类,setuptools的文档就简单多了。 准备项目 为了做演示,首先需要准备一个项目,一个项目应该包括README和LICENSE等文件,README文件是Markdown格式的文本文件,用于描述项目自身;LICENSE文件是授权文件,列出项目使用者应该遵循的各种条款。下图是我的项目结构。 项目结构 此外还可能存在几个文件: setup.cfg。对应的配置文件,一般情况下可以不要。 MANIFEST.in。清单文件,当项目中需要一些没办法自动包括到源代码分发包的文件时,可能需要用到它。 具体文件内容就不列出了。需要注意my_package/__init__.py文件中应该有如下一行标识包名: name = 'yitian_first_package' 编写setup.py文件 用setuptools来编写setup.py文件是一件非常简单的事情,而且有很多例子可供参考,我挑选了Kenneth Reitz(requests、pipenv等类库的作者)写的例子,做了一些修改并翻译了一些注释: #!/usr/bin/env python # -*- coding: utf-8 -*- # 注意 如果要使用上传功能,需要安装twine包: # $ pip install twine import io import os import sys from shutil import rmtree from setuptools import find_packages, setup, Command # 包的元信息 NAME = 'yitian_first_package' DESCRIPTION = '项目的简短描述,不超过200字符' URL = 'https://github.com/techstay/python-study' EMAIL = 'lovery521@gmail.com' AUTHOR = '易天' REQUIRES_PYTHON = '>=3.6.0' VERSION = '0.1.0' KEYWORDS = 'sample setuptools development' # 项目依赖,也就是必须安装的包 REQUIRED = [ 'requests-html' ] # 项目的可选依赖,可以不用安装 EXTRAS = { # 'fancy feature': ['django'], } # 剩下部分不用怎么管 :) # ------------------------------------------------ # 除了授权和授权文件标识符! # 如果你改了License, 记得也相应修改Trove Classifier! here = os.path.abspath(os.path.dirname(__file__)) # 导入README文件作为项目长描述. # 注意 这需要README文件存在! try: with io.open(os.path.join(here, 'README.md'), encoding='utf-8') as f: long_description = '\n' + f.read() except FileNotFoundError: long_description = DESCRIPTION # 当前面没指定版本号的时候,将包的 __version__.py 模块加载进来 about = {} if not VERSION: with open(os.path.join(here, NAME, '__version__.py')) as f: exec(f.read(), about) else: about['__version__'] = VERSION class UploadCommand(Command): """上传功能支持""" description = 'Build and publish the package.' user_options = [] @staticmethod def status(s): """Prints things in bold.""" print('\033[1m{0}\033[0m'.format(s)) def initialize_options(self): pass def finalize_options(self): pass def run(self): try: self.status('Removing previous builds…') rmtree(os.path.join(here, 'dist')) except OSError: pass self.status('Building Source and Wheel (universal) distribution…') os.system('{0} setup.py sdist bdist_wheel --universal'.format(sys.executable)) self.status('Uploading the package to PyPI via Twine…') os.system('twine upload dist/*') self.status('Pushing git tags…') os.system('git tag v{0}'.format(about['__version__'])) os.system('git push --tags') sys.exit() # 神奇的操作,一个函数完事 setup( name=NAME, version=about['__version__'], description=DESCRIPTION, long_description=long_description, long_description_content_type='text/markdown', author=AUTHOR, author_email=EMAIL, python_requires=REQUIRES_PYTHON, url=URL, keywords=KEYWORDS, # 项目中要包括和要排除的文件,setuptools可以自动搜索__init__.py文件来找到包 packages=find_packages(exclude=('tests',)), # 如果项目中包含任何不在包中的单文件模块,需要添加py_modules让setuptools能找到它们: # py_modules=['yitian_first_package'], # entry_points={ # 'console_scripts': ['mycli=mymodule:cli'], # }, install_requires=REQUIRED, extras_require=EXTRAS, # 老旧的distutils需要手动添加项目中需要的非代码文件,setuptools可以用下面参数自动添加(仅限包目录下) include_package_data=True, # 如果是包的子目录下,则需要手动添加 package_data={ 'yitian_first_package': ['static/*.html'] }, license='MIT', classifiers=[ # Trove classifiers # Full list: https://pypi.python.org/pypi?%3Aaction=list_classifiers 'License :: OSI Approved :: MIT License', 'Programming Language :: Python', 'Programming Language :: Python :: 3', 'Programming Language :: Python :: 3.7', 'Programming Language :: Python :: Implementation :: CPython', 'Programming Language :: Python :: Implementation :: PyPy' ], # $ setup.py publish support. cmdclass={ 'upload': UploadCommand, }, ) 下面再讲一些在注释里没法详细解释的东西,官方文档的内容更丰富,有需要的可以查看。示例文件中其实还有几个setup参数没写全,这里再补充一下。 project_urls project_urls参数可以列出一些相关项目的URL。 project_urls={ 'Documentation': 'https://packaging.python.org/tutorials/distributing-packages/', 'Funding': 'https://donate.pypi.org', 'Say Thanks!': 'http://saythanks.io/to/example', 'Source': 'https://github.com/pypa/sampleproject/', 'Tracker': 'https://github.com/pypa/sampleproject/issues', }, python_requires参数格式就是pip中指定包版本的标识符,,指定我们项目支持的Python版本,这里再补充几个例子。 # 大版本号大于等于3 python_requires='>=3', # 版本号大于等于3.3,但是不能超过4 python_requires='~=3.3', # 支持2.6 2.7以及所有以3.3开头的Python 3版本 python_requires='>=2.6, !=3.0.*, !=3.1.*, !=3.2.*, <4', package_data和data_file package_data和data_file参数用于指定数据文件,也就是在项目中使用到的非代码文件,一般情况下通过设置include_package_data=True自动搜索就够用了,如果需要细粒度的控制,就要使用它们了,详情见setuptools 文档 - Including Data Files。 package_data指定包括在包中的数据文件,也就是“包数据文件”,这些文件会复制到包的相应目录。 package_data={ 'package_name': ['package_data.dat'], }, data_files指定放在包外的数据文件,这些文件会被复制到项目根目录下指定的相对目录中。 data_files=[('my_data', ['data/data_file'])], entry_points entry_points参数指定一些入口点,可以看做是项目提供的一些额外功能,其中最常见的就是console_scripts,用于注册脚本接口。setuptools提供的工具链可以在安装项目分发包的时候将这些接口转化为真正的可执行脚本,更多信息参考setuptools文档 - Automatic Script Creation。 entry_points={ 'console_scripts': [ 'sample=sample:main', ], }, 版本号 下面是开发、A测、B测、发布候选、最终发布等情况的版本号实例。 1.2.0.dev1 # Development release 1.2.0a1 # Alpha Release 1.2.0b1 # Beta Release 1.2.0rc1 # Release Candidate 1.2.0 # Final Release 1.2.0.post1 # Post Release 15.10 # Date based release 23 # Serial release 开发模式 setup.py文件写完之后,项目就算是可打包状态了。当然也可以继续在项目上进行工作,这时候一般希望项目既可以作为包来安装,又希望项目是可以编辑的,这时候就可以进入开发模式。这种情况下需要用下面的命令来安装包,-e选项全称是--editable,也就是可编辑的意思;.表示当前目录,也就是setup.py存在的那个目录: pip install -e . 该命令会安装install_requires中指定的所有包,以及console_scripts部分指定的脚本。依赖项会作为普通包来安装,而项目本身会以可编辑状态来安装。特别的,如果只希望安装项目本身而不安装所有依赖包,用下面的命令: pip install -e . --no-deps 如果有需要的话,还可以安装VCS或者本地目录中保存的包来替代官方索引中的包。详情请查看文档。 打包项目 终于到了观看成果的时候了,项目可以被打包成各种类型的可分发包,这里只介绍几种最常用的。 源码分发包(sdist) 这是最低等级的一种,基本上就是复制源代码,不过因此在安装的时候有一个必须的构建(可能包括编译)过程来生成各种元信息,哪怕项目是纯的Python项目。用下面的命令来生成: python setup.py sdist Wheels(轮子) 在编程界各种第三方包不是被形象地称作轮子吗(著名梗:不要重复造轮子),这里就是这个意思。轮子是一种二进制分发包,是现在最推荐的分发包格式,轮子又可以分为好几种轮子。当然,在构建轮子之前,还需要安装wheel包来提供支持。 pip install wheel 通用轮子。也就是项目中只存在Python代码,同时兼容Python 2和Python 3的轮子,用下面的命令生成。 python setup.py bdist_wheel --universal 当然也可以在setup.cfg配置文件中指定: [bdist_wheel] universal=1 纯Python轮子。和通用轮子差不多,不过只支持Python 2或者Python 3. python setup.py bdist_wheel 平台轮子。这种轮子中不仅有Python代码,一般还包括但不限于C代码写成的扩展等,因此它们只支持特定平台。 python setup.py bdist_wheel 运行以上命令之后,会在dist文件夹中生成打包好的可发布包。 发布项目 项目打包完毕,生成可可分发包之后,最后一步就是发布项目了。几乎所有的项目都被发布到了Python Package Index(简称PyPI)上了,当然如果有需求的话还可以搭建自己的私人索引,不过这就是另一个话题了。 很有意思的是,Python官方还提供了一个测试索引,它是一个和PyPI完全一样的测试网站,定期清理,可以让我们方便的练习上传项目,同时不用担心会污染官方仓库。使用方法很简单,先注册一个账户。 上传项目需要用到另一个类库twine: pip install twine 然后用下面的命令将包上传到测试索引中,该命令会提示输入刚才注册用的用户名和密码: twine upload --repository-url https://test.pypi.org/legacy/ dist/* 稍等片刻,上传应该就完成了。然后就可以在测试索引中找到我的项目了。当然由于测试索引会定期清理的缘故,可能过段时间项目和我的账户就都不存在了。 上传完成 全部流程都熟悉之后,就可以在官方索引上注册账号,并将项目上传上去,这样一来,全世界的开发者都能用到你的项目了!
优秀的个人博客,低调大师

Source Map入门教程

部署前端之前,开发者通常会对代码进行打包压缩,这样可以减少代码大小,从而有效提高访问速度。然而,压缩代码的报错信息是很难Debug的,因为它的行号和列号已经失真。这时就需要Source Map来还原真实的出错位置了。 为啥变换代码? 前端代码越来越复杂的情况下,开发者通常会使用webpack、UglifyJS2等工具对代码进行打包变换,这样可以减少代码大小,有效提高访问速度。关于变换代码的原因,这里不妨引用一下大神阮一峰的JavaScript Source Map 详解: 压缩,减小体积。比如jQuery 1.9的源码,压缩前是252KB,压缩后是32KB。 多个文件合并,减少HTTP请求数。 其他语言编译成JavaScript。最常见的例子就是CoffeeScript。 如何变换代码? 下面是一个简单的“hello World”程序hello.js function sayHello() { var name = "Fundebug"; var greeting = "Hello, " + Name; console.log(greeting); } sayHello(); 使用UglifyJS2对源代码进行压缩变换: uglifyjs hello.js \ -m toplevel=true \ -c unused=true,collapse_vars=true \ -o hello.min.js 压缩后的代码hello.min.js function o(){var o="Hello, "+Name;console.log(o)}o(); 为啥需要Source Map? 使用Firefox执行hello.js的报错信息是这样: ReferenceError: Name is not defined sayHello file:///Users/fundebug/sourcemap-tutorial/hello.js:4:9 <匿名> file:///Users/fundebug/sourcemap-tutorial/hello.js:8:1 而hello.min.js的报错信息是这样: ReferenceError: Name is not defined o file:///Users/fundebug/sourcemap-tutorial/hello.min.js:1:18 <匿名> file:///Users/fundebug/sourcemap-tutorial/hello.min.js:1:59 对比压缩前后的出错信息,我们会发现,错误行号和列号已经失真,且函数名也经过了变换。而对于真实的前端项目,开发者会将数十个源文件压缩为一个文件,这时,错误的列号可能多达数千,且出错的真实文件名也是很难确定的,这样的话,压缩代码的报错信息是很难Debug的。 而Source Map则可以用于还原真实的出错位置,帮助开发者更快的Debug。 什么是Source Map? 使用UglifyJS2时指定source-map选项即可生成Source Map: uglifyjs hello.js \ -m toplevel=true \ -c unused=true,collapse_vars=true \ --source-map hello.min.js.map \ --source-map-include-sources \ --source-map-root \ -o hello.min.js 各种主流前端任务管理工具,打包工具都支持生成Source Map,具体可以查看生成Source Map - Fundebug文档。 生成的hello.min.js多了sourceMappingURL,表示Source Map文件的位置。 function o(){var o="Hello, "+Name;console.log(o)}o(); //# sourceMappingURL=hello.min.js.map 生成的Source Map为hello.min.js.map: { "version": 3, "sources": ["hello.js"], "names": ["sayHello", "greeting", "Name", "console", "log"], "mappings": "AAAA,QAASA,KAEL,GACIC,GAAW,UAAYC,IAC3BC,SAAQC,IAAIH,GAGhBD", "file": "hello.min.js", "sourceRoot": "", "sourcesContent": ["function sayHello()\n{\n var name = \"Fundebug\";\n var greeting = \"Hello, \" + Name;\n console.log(greeting);\n}\n\nsayHello();\n"] } 由hello.min.js.map可知,Source Map是一个JSON文件,而它包含了代码转换前后的位置信息。也就是说,给定一个转换之后的压缩代码的位置,就可以通过Source Map获取转换之前的代码位置,反过来也一样。Source Map各个属性的含义如下: version:Source Map的版本号。 sources:转换前的文件列表。 names:转换前的所有变量名和属性名。 mappings:记录位置信息的字符串,经过编码。 file:(可选)转换后的文件名。 sourceRoot:(可选)转换前的文件所在的目录。如果与转换前的文件在同一目录,该项为空。 sourcesContent:(可选)转换前的文件内容列表,与sources列表依次对应。 Source Map真正神奇之处在于mappings属性,它记录了位置是如何对应的。JavaScript Source Map 详解已经有很好的解释,这里不再赘述。 怎样使用Source Map? 主流浏览器均支持Source Map功能,不过Chrome与Firefox需要一些简单的配置,具体步骤请参考How to enable source maps。下面以MacBook上的Chrome浏览器为例,介绍一下配置方法: 1. 开启开发者工具 使用快捷键option + command + i;或者在菜单栏选择视图->开发者->开发者工具 2. 打开设置 使用快捷键fn + F1;或者点击右上角的三个点的图标,选择Settings 3. 开启Source Map 在Sources中,选中Enable JavaScript source maps 为了测试,我写了一个简单的HTML文件hello.min.html <head> <script type="text/javascript" src="hello.min.js"></script> </head> 使用Chrome打开hello.min.html,在控制台看到的错误如下: Uncaught ReferenceError: Name is not defined at o (hello.min.js:1) at hello.min.js:1 报错的文件仍然为hello.min.js,需要刷新一下Source Map才有作用: Uncaught ReferenceError: Name is not defined at o (hello.js:4) at hello.js:8 注意,Chrome的报错信息没有列号,因此4为错误的行号。Chrome不仅可以通过Source Map还原真实的出错位置,还可以根据Source Map的sourcesContent还原出错的源代码。点击出错位置,即可跳转到源码,这样Debug将非常方便。 参考链接 JavaScript Source Map 详解 Source Map Revision 3 Proposal How to enable source maps 关于Fundebug Fundebug专注于JavaScript、微信小程序、微信小游戏、支付宝小程序、React Native、Node.js和Java实时BUG监控。 自从2016年双十一正式上线,Fundebug累计处理了6亿+错误事件,得到了Google、360、金山软件等众多知名用户的认可。欢迎免费试用! 版权声明 转载时请注明作者Fundebug以及本文地址:https://blog.fundebug.com/2017/03/13/sourcemap-tutorial/

优秀的个人博客,低调大师

python-面向对象入门

一、面向对象介绍 介绍面向对象之前,先来回顾一下以前学的面向过程的编程思想 面向过程编程: 核心是过程二字,过程指的是解决问题的步骤,即先干什么,再干什么后干什么,基于该思想编程就好比是在设计一条流水线,是一种机械化的思维方式 优点:复杂的问题流程化,进而简单化 缺点:可扩展性差 现在轮到面向对象的编程思想了! 面向对象编程,核心是对象二字,对象是特征与技能的结合体,基于该思想编写程序(脑子里始终想的是对象二字),就好比创造一个世界,在上帝眼里任何存在的事物都是对象,任何不存在的事物都可以造出来,是一种上帝式的思维方式 优点:可扩展性强 缺点:编程的复杂度要高于面向过程 二、类 对象是特征与技能的结合体,而类则是一系列对象相同的特征与技能的结合体 强调: 1.对象是具体存在的事物,而类则是一个抽象概念 2.站在不同的角度总结出的类与对象是不同的 在现实世界中,先有一个个具体存在的对象,然后随着人类文明的发展才总结出类的概念 在程序中,先定义类,后调用类来产生对象 类体中最常见的就是变量和函数的定义,但类体中可以存在任意的python代码。 定义类: class语句创建一个新的类的定义,后面跟着冒号“:” class Student: #相同的特征 school = 'superschool' #相同的技能 def choose_course(self): print('choosing course') 类体代码会在类定义阶段立即执行,会产生一个类名称空间,用来将类体代码都丢进去。 查看类的名称空间: print(Student.__dict__) 修改,添加,删除 Student.school = 'SUPPER' Student.country = 'China'del Student.country 总结类: 1.类本质上就是一个名称空间,或者说是一个用来存放变量和函数的容器 2.类的用途之一就是当做名称空间从其内部取出名字来使用 3.类的用途之二就是调用类来产生对象 对象: 调用类的过程称之为类的实例化,调用类的返回值称之为类的一个对象/实例 stu1 = Student() 为对象定制自己独有的特性: stu1.name='李铁蛋' stu1.age=18 stu1.sex='male' stu2.name='赵钢弹' stu2.age=38 stu2.sex='female' 大家也注意到了,这里存在了冗余代码,我们来优化一下 def init(obj,name,age,sex): obj.name = name obj.age = age obj.sex = sex 产生的对象通过每次调用函数能够更简便,还有没有更好的方法呢?答案肯定是有的 class Student: #相同的特征 school = 'oldboy' # stu1,'李铁蛋',18,'male' def __init__(obj, name, age, sex): obj.name = name #stu1.name='李铁蛋' obj.age = age #stu1.age=18 obj.sex = sex #stu1.sex='male' #相同的技能 def choose_course(self): print('choosing course') 调用类会先产生一个空对象stul,然后返回,触发类中的__init__的执行,将对象连同调用类括号里指定的参数一同传入 stu1=Student('李铁蛋',18,'male') #__init__(stu1,'李铁蛋',18,'male') stu2=Student('赵钢弹',38,'female') #__init__(stu2,'赵弹',38,'female') 总结__init__的功能:是在实例化时就为对象初始自己独有的属性,要注意的是不能有返回值,默认返回None 属性查找: 1.先从对象自己的名称空间中找,没有则去所属的类中找 2.类中定义的变量是所有对象共享的,对象可以用来用,类也可以来使用,类一旦改变自己的数据属性的值,所有对象都能感知到。 绑定方法: 类中定义的函数是是类的函数属性,类可以用,类调用就是一个普通函数,但其实类中定义的函数是给对象用的,而且是绑定给对象用的 1.类的函数:该传几个参数就传几个 2.绑定方法,指向类的函数:特殊之处是绑定给谁就由谁来调用,谁来调用就会当做第一个参数自动传入。 三、一切皆对象 在python3中统一了类与类型的概念 class Foo: pass print(Foo) obj=Foo() print(type(obj)) print(int) age=10 #age=int(10) print(type(age)) l1=[1,2,3] #l1=list([1,2,3]) # print(type(l1)) # l1.append(4) # print(l1) l1.append(4) # list.append(l1,4) print(l1) l1.append就相当于调用了list类中的append函数 面向对象后期继续补充,七夕刚好new个对象!焚膏油以继晷,恒兀兀以穷年。

优秀的个人博客,低调大师

zookeeper入门与Doubbo(一)

1.zookeeper的特性 一致性:数据一致性,数据按照顺序分批入库 原子性:事务要么成功,要么失败,不会局部化 单一视图:客户端连接集群中任一zk节点,数据都是一致的 可靠性:每次对zk的操作状态都会保存在服务器端 实时性:客户端可以读取到zk服务端的最新数据 2.JDK的安装 第一步:卸载自带的openjdk: rpm -qa | grep java rpm -e --nodeps java-XXXXXX 第二步:解压 第三步:配置环境变量 [root@localhost opt]# vim /etc/profile [root@localhost opt]# source /etc/profile 3.zookeeper的安装 zookeeper的目录结构: 配置文件: 运行zookeeper:在zookeeper下的bin下运行 4.zookeeper的数据类型 ①树型结构、 ②目录结构 5.zookeeper基本数据类型的操作 主要包括客户端连接,查看znode连接,关闭客户端连接(ctrl+c退出) 6.zookeeper的作用

优秀的个人博客,低调大师

python-函数入门(二)

一、函数对象 什么是函数? 函数是第一类对象,指的是函数名指向的值(函数)可以被当做数据去使用 1.函数的特性 1.函数可以被引用,即函数可以把值赋值给一个变量 def foo(): print('from foo') foo() func=foo #引用,赋值 func() print(foo) print(func) 2.函数可以当做参数传给另一个函数 def hi(): return "hi yasoob!" def doSomethingBeforeHi(func): print("I am doing some boring work before executing hi()") print(func()) doSomethingBeforeHi(hi) 3.可以当做一个函数的返回值 def func(): # func=函数的内地址 print('from func') # print(func) age=10 def bar(x): return x res=bar(age) print(res) res=bar(func) print(res) 4.可以当做容器类型的元素 容器对象(list、dict、set等)中可以存放任何对象,包括整数、字符串,函数也可以作存放到容器对象中 def func(): # func=函数的内地址 print('from func') age=10 l=[age,func,func()] print(l) 二、函数嵌套 函数的嵌套又分为两大类 1.函数的嵌套调用:在调用一个函数的过程中,其内部代码又调用了其他函数 def max2(x,y): if x > y: return x else: return y def max4(a,b,c,d): res1=max2(a,b) res2=max2(res1,c) res3=max2(res2,d) return res3 print(max4(1,2,3,4)) 2.函数的嵌套定义:一个函数内部又定义了另外一个函数 # from math import pi # # print(pi) # # def circle(radius,action=0): # """ # 圆形相关运算 # :param radius: 半径 # :param action: 0代表求面积,1代表求周长 # :return: 面积或者周长 # """ # def area(radius): # return pi * (radius ** 2) # # def perimiter(radius): # return 2 * pi * radius # # if action == 0: # res=area(radius) # elif action == 1: # res=perimiter(radius) # # return res # # print(circle(10,0)) # print(circle(10,1)) 三、名称空间与作用域 1.什么是名称空间: 名称空间就是用来存放名字与内存地址绑定关系的地方(内存空间),但凡要查找值一定要通过名字,访问名字必须去查找名称空间 2.名称空间的三大类 内置名称空间:存放的是python解释器自带的名字 例如:len()、man()等 全局名称空间:存放的是文件级别的名字(不是函数内,不是内置的) x、y、z、b、foo都是全局 m不是 x=1 y=2 if x=1: z=3 while Ture: b=4 def foo(): m=3 局部名称空间:在函数内部定义的 生命周期: 内置名称空间:在解释器启动时生效,关闭时则失效 全局名称空间:在解释器解释执行python文件时生效,文件执行完毕后则失效 局部名称空间:只在调用函数时临时产生该函数的局部名称空间 加载顺序:内置===》全局===》局部 查找名字的顺序: 基于当前所在位置往上查找,假设当前站在局部,查找顺序:局部==》全局==》内置 假设当前站在全局,查找顺序:全局=》内置 注:名字的查找顺序,在函数定义阶段就已经被固定死了(即在检测语法时就已经确定了名字的查找顺序),与函数调 用位置无关,无论在任何地方调用函数,都必须回到当初定义函数的位置去确定名字的查找关系 # x=111 # def outer(): # def inner(): # print('from inner',x) # x访问的时全局名称空间中x # return inner # # f=outer() # # print(f) # # x=222 # f() 3.作用域 作用域指的是作用的范围,分为两种,全局作用域和局部作用域 1.全局作用域:包含的是内置名称空间与全局名称空间中的名字 特点:全局有效,全局存活 2.局部作用域:包含的是局部名称空间中的名字 特点:局部有效,临时存活 补:global 和 nonlocal #global:在局部声明一个名字是来自于全局作用域的,可以用来在局部修改全局的不可变类型 # x=1 # def foo(): # global x # x=2 # # foo() # print(x) #nonlocal:声明一个名字是来自于当前层外一层作用域的,可以用来在局部修改外层函数的不可变类型 # x=0 # def f1(): # x=111 # def f2(): # nonlocal x # x=222 # f2() # print(x) # # f1() # print(x) 四、闭包函数 1.什么是闭包函数? 指的是定义一个函数内部的函数,该内部函数包含对外层函数作用域名字的引用 需要结合函数对象的概念将闭包函数返回到全局作用域去使用,从而打破函数的层级限制。 def outter(): x=111 def inner(): print(x) return inner f=outter() #f=outter内的inner # x=22222 # f() def func(): x=3333 f() func() 2.为何要用闭包函数? 闭包函数提供了一种为函数体传值的解决方案 3.如何使用闭包函数 为函数传值的方式有两种,参数和闭包(目前所学) # 为函数体传值的方式一:参数 # def func(x,y): # print(x+y) # # func(1,2) # 为函数体传值的方式二:闭包 # def outter(x,y): # # x=1 # # y=2 # def func(): # print(x+y) # return func # # f=outter(1,2) # f() 闭包的概念有的晦涩难以理解,期待接下里的学习! 焚膏油以继晷,恒兀兀以穷年。

优秀的个人博客,低调大师

Java入门之继承(下)

Object类 Object类是所有类的父类 一个类没有使用extends关键字明确标识继承关系,则默认继承Object类 (包括数组) Java中的每个类都可以使用Object中定义的方法 可以在Java官方文档中查找Object类中的自带的方法 Object类官方文档 final关键字 final关键字修饰的类 , 表示该类不允许有子类,也就是说不允许被继承 final关键字修饰的方法, 不能修饰构造方法 该方法不允许被子类重写 可以正常被子类继承使用 final关键字修饰方法内部的变量(局部变量), 只要在具体被使用之前进行赋值即可 一旦赋值不允许被修改 final关键字修饰类当中成员属性时,只有在三个特定的位置可以对final修饰的成员属性进行赋值, 定义时直接初始化 构造方法中 构造代码块中 final关键字修饰引用类型的变量, 初始化之后不能再指向另一个对象,但对象的内容是可以改变的 可配合static使用 表示静态的不允许被修改的信息 /* * final eat()修饰方法 */ public final void eat(){ } public class Animal{ public final int age = 18; //final 修饰变量 并 赋值 } 注解 从JDK1.5版本引入的一个特性 可以声明在包、类、属性、方法、局部变量、方法参数等,的前面,用来对这些元素进行说明、解释。 注解可以按照两种不同的类别来进行区分: 按照运行机制来分 源码注解 :注解只在源码中存在,编译成.class文件注解就不存在了(例:@Override) 编译时注解 :注解在源码和.class文件中都存在 运行时注解 :在运行阶段还起作用,甚至会影响运行逻辑的注解(例:Spring注解:@Autowired) 按照来源区分 来自JDK的注解 :例:@Override 来自第三方的注解 :例:Spring注解:@Autowired 我们自己定义的注解 :自己编写的注解 @Override public void eat(){ // @Override 用来标识此方法是重写父类的一个方法 System.out.println(); }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册