首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10000篇文章
优秀的个人博客,低调大师

Docker入门-Dockerfile的使用

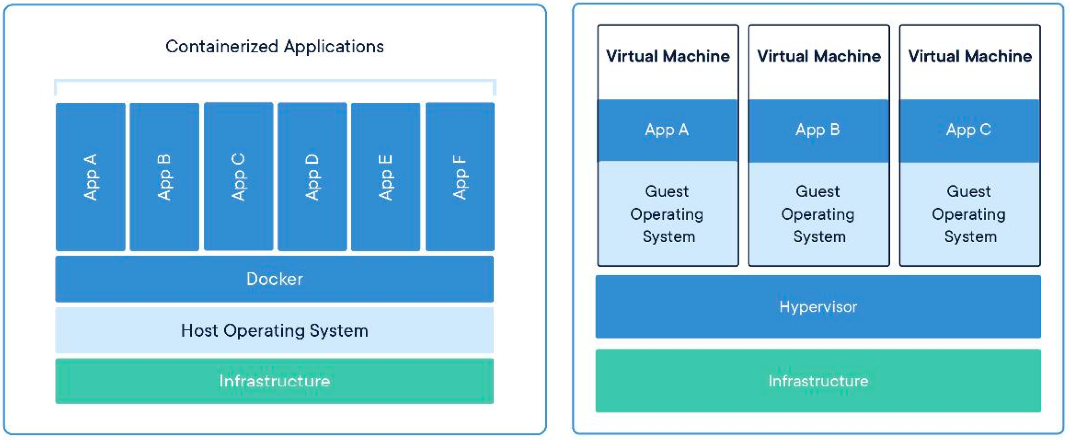
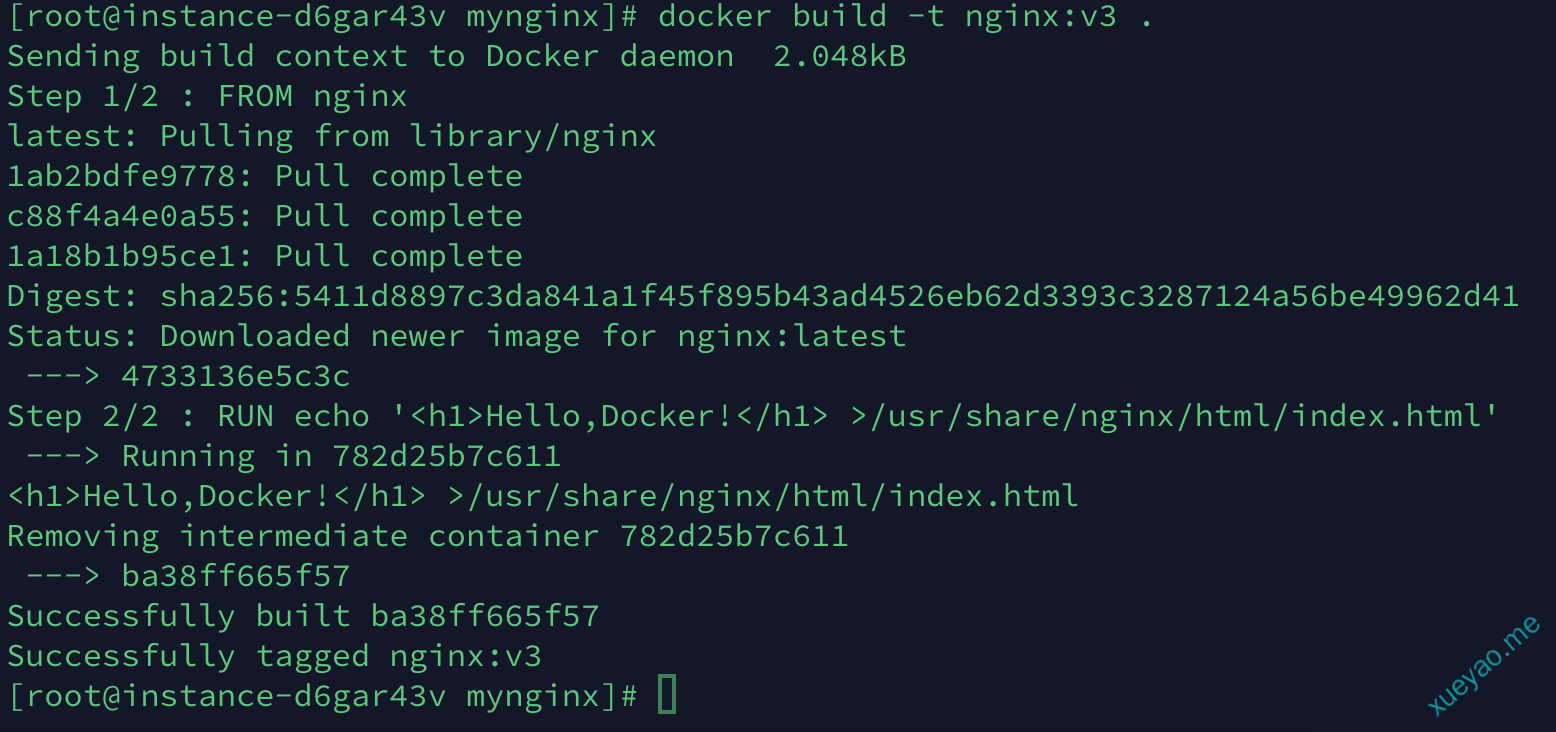
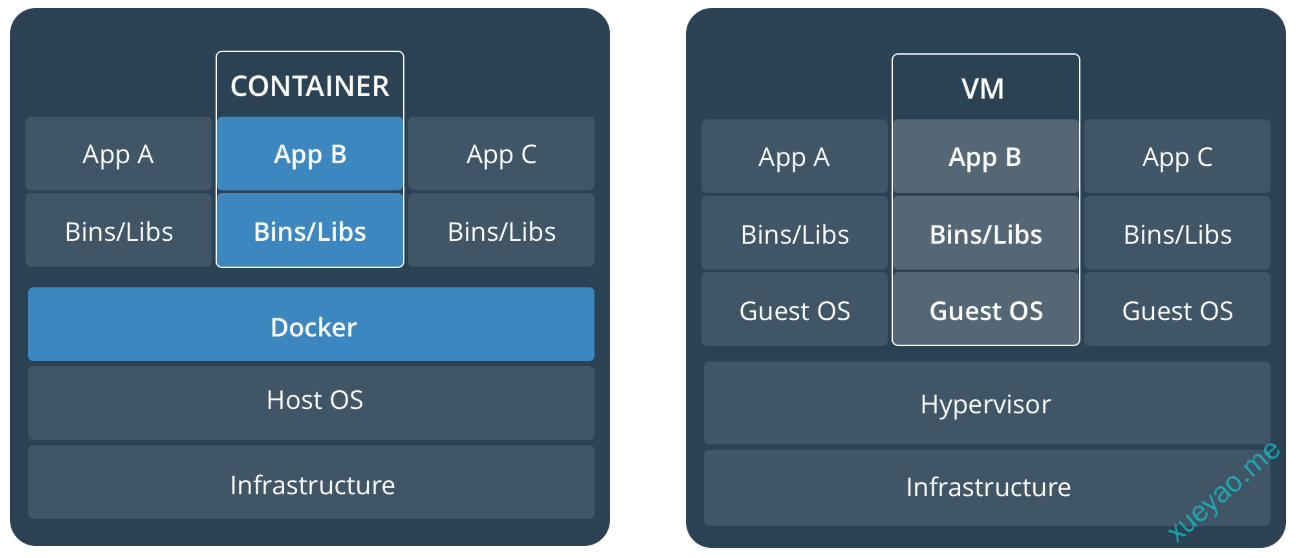
使用Dockerfile定制镜像 镜像的定制实际上就是定制每一层所添加的配置、文件。我们可以把每一层修改、安装、构建、操作的命令都写入一个脚本,这个脚本就是Dockerfile。 Dockerfile是一个文本文件,其内包含了一条条的指令,每一条指令构建一层,因此每一条指令的内容,就是描述该层应当如何构建。 接下来我们以官方nginx镜像为例,使用Dockerfile来定制。 在一个空白目录中,建立一个文本文件,并命名为Dockerfile: mkdir mynginx cd mynginx touch Dockerfile 其内容为: FROM nginx RUN echo '<h1> Hello,Docker!</h1>' >/usr/share/nginx/html/index.html 这个Dockerfile很简单,一共就两行。涉及到了两条指令,FROM和RUN。 FROM指定基础镜像 所谓定制镜像,一定是以一个镜像为基础,在其上进行定制。基础镜像是必须指定的,而FROM就是指定基础镜像,因此一个Dockerfile中FROM是必备的指令,并且必须是第一条指令。在Docker Hub上有非常多的高质量的官方镜像,有可以直接拿来使用的服务类的镜像,如nginx、redis、mysql、tomcat等;可以在其中寻找一个最符合我们最终目标的镜像为基础镜像进行定制。 如果没有找到对应服务的镜像,官方镜像中还提供了一些更为基础的操作系统镜像,如ubuntu、debian、centos、alpine等,这些操作系统的软件库为我们提供了更广阔的扩展空间。 除了选择现有镜像为基础镜像外,Docker还存在一个特殊的镜像,名为scratch。这个镜像是虚拟的概念,并不实际存在,它表示一个空白的镜像。 FROM scratch ... 如果你以scratch为基础镜像的话,意味着你不以任何镜像为基础,接下来所写的指令将作为镜像第一层开始存在。 对于Linux下静态编译的程序来说,并不需要有操作系统提供运行时支持,所需的一切库都已经在可执行文件里了,因此直接FROM scratch会让镜像体积更加小巧。使用Go语言开发的应用很多会使用这种方式来制作镜像,这也是为什么有人认为Go是特别适应容器微服务架构的语言的原因之一。 RUN执行命令 RUN指令是用来执行命令行命令的。由于命令行的强大能力,RUN指令在定制镜像时是最常用的指令之一。其格式有两种: shell格式:RUN <命令> RUN echo '<h1>Hello,Docker~</h1>' > /usr/share/nginx/html/index.html exec格式: RUN ["可执行文件",“参数1”,“参数2”] RUN tar -xzf redis.tar.gz -C /usr/src/redis --strip-components=1 RUN make -C /usr/src/redis RUN make -C /usr/src/redis install 上面我们利用Dockerfile定制了nginx镜像,现在我们明白了这个Dockerfile的内容,接下来我们来构建这个镜像。 在Dockerfile文件所在目录执行: docker build -t nginx:v3 . 从命令的输出结果中,我们可以清晰的看到镜像的构建过程。在Step2中,RUN指令启动了一个容器782d25b7c611,执行了所要示的命令,并最后提交了这一层ba38ff665f57,随后删除了所用到的这个容器782d25b7c611。 启动构建的Nginx docker run --name nginx-test -p 8081:80 -d nginx:v3 如图所示 Dockerfile指令详解 COPY复制文件 格式: COPY <源路径>...<目标路径> COPY ["<源路径1>",..."<目标路径>"] COPY指令将从构建上下文目录中<源路径>的文件/目录复制到新的一层的镜像内的<目标路径>位置。比如: COPY package.json /usr/src/app/ <源路径>可以是多个,甚至可以是通配符,如: COPY hom* /mydir/ COPY hom?.txt /mydir/ ADD更高级的复制文件 ADD指令和COPY的格式和性质基本一致。但是在COPY基础上增加了一些功能。比如<源路径>可以是一个URL,这种情况下,Docker引擎会试图去下载这个链接的文件放到<目标路径>去。 在Docker官方的Dockerfile最佳实践文档中要求,尽可能的使用COPY,因此COPY的语义很明确,就是复制文件而已,而ADD则包含了更复杂的功能,其行为也不一定很清晰。最适合使用ADD的场合,就是所提及的需要自动解压缩的场合。 因此在COPY和ADD指令中选择的时候,可以遵循这样的原则,所有的文件复制均使用COPY指令,仅在需要自动解压缩的场合使用ADD。 CMD容器启动命令 CMD指令的格式和RUN相似,也是两种格式: shell格式:CMD <命令> exec格式:CMD ["可执行文件",“参数1”,“参数2”] 参数列表格式:CMD [“参数1”,“参数2”...]。在指定了ENTRYPOINT指令后,用CMD指定具体参数。 Docker不是虚拟机,容器就是进程。既然是进程,那么在启动容器的时候,需要指定所运行的程序及参数。CMD指令就是用于指定默认的容器主进程启动命令的。 ENTRYPOINT入口点 ENTRYPOINT的目的和CMD一样,都是在指定容器启动程序及参数。ENTRYPOINT在运行也可以替代,不过比CMD要略显繁琐,需要通过docker run的参数 --entrypoint来指定。 当指定了ENTRYPOINT后,CMD的含义就发生了改变,不再是直接的运行其命令,而是将CMD的内容作为参数传给ENTRYPOINT指令,换句话说实际执行时,将变为: <ENTRYPOINT>"<CMD>" ENV设置环境变量 格式有两种: ENV ENV ==... 这个指令很简单,就是设置环境变量而已,无论是后面的其它指令,如RUN,还是运行时的应用,都可以直接使用这里定义的环境变量。 ENV VERSION=1.0 DEBUG=on NAME="Happy Feet" $VERSION #使用环境变量 下列指令可以支持环境变量展开:ADD、COPY、ENV、EXPOSE、LABEL、USER、WORKDIR、VOLUME、STOPSIGNAL、ONBUILD。 ARG构建参数 格式: ARG <参数名>[=<默认值>]构建参数和ENV的效果一样,都是设置环境变量。所不同的是,ARG所设置的构建环境的环境变量,在将来容器运行时是不会存在这些环境变量的。但是不要因此就使用ARG保存密码之类的信息,因此docker history还是可以看到所有值的。 Dockerfile中的ARG指令是定义参数名称,以及定义其默认值。该默认值可以在构建命令docker build中用 --build-arg <参数名>=<值>来覆盖。 VOLUME定义匿名卷 格式为: VOLUME ["<路径1>","[路径2]"...] VOLUME <路径> 容器运行时应该尽量保持容器存储层不发生写操作,对于数据库需要保存动态数据的应用,其数据库文件应该保存于卷(volume)中,为了防止运行时用户忘记将动态文件所保存目录挂载为卷,在Dockerfile中,我们可以事先指定某些目录挂载为匿名卷,这样在运行时如果用户不指定挂载,其应用也可以正常运行,不会向容器存储层写入大量数据 VOLUME /data 这里的/data目录就会在运行时自动挂载为匿名卷,任何向/data中写入的信息都不会记录进容器存储层,从而保证了容器存储层的无状态化。当然,运行时可以覆盖这个挂载设置。 比如: docker run -d -v mydata:/data xxxx 在这行命令中,就使用了mydata这个命名卷挂载到了/data这个位置,替代了Dockerfile中定义的匿名卷的挂载配置。 EXPOSE声明端口 格式为EXPOSE <端口1>[<端口2>...]。 EXPOSE指令是声明运行时容器提供服务端口,这只是一个声明,在运行时并不会因为这个声明应该就会开启这个端口的服务。 在Dockerfile中写入这样的声明有两个好处: 是帮助镜像使用者理解这个镜像服务的守护端口,以方便配置映射; 在运行是使随机端口映射时,也就是docker run -P时,会自动随机映射EXPOSE端口。 WORKDIR指定工作目录 格式为WORKDIR <工作目录路径> 使用WORKDIR指令可以来指定工作目录(或者称为当前目录),以后各层的当前目录就被改为指定的目录,如该目录不存在,WORKDIR会帮你建立目录。 之前提到一些初学者常犯的错误是把Dockerfile等同于Shell脚本来书写,这种错误的理解还可能会导致出现下面这样的错误: RUN cd /app RUN echo "hello">world.txt 如果将这个Dockerfile进行构建镜像运行后,会发现找不到 /app/world.txt文件。 原因 在Shell中,连续两行是同一个进程执行环境,因此前一个命令修改的内存状态,会直接影响后一个命令。 而在Dockerfile中,这两行RUN命令的执行环境根本不同,是两个完全不同的容器。这就是对Dockerfile构建分层存储的概念不了解导致的错误。 每一个RUN都是启动一个容器、执行命令、然后提交存储层文件变量。第一层RUN cd /app的执行仅仅是当前进程的工作目录变量,一个内存上的变化而已,其结果不会造成任何文件变更。而到第二层的时候,启动的是一个全新的容器,跟第一层的容器更完全没关系,自然不可能继承前一层构建过程中的内存变化。 因此如果需要改变以后各层的工作目录的位置,那么应该使用WORKIDR指令。 USER指定当前用户 格式:USER <用户名> USER指令和WORKDIR相似,都是改变环境状态并影响以后的层。WORKDIR是改变工作目录,USER则是改变之后层的执行RUN,CMD以及ENTRYPOINT这类命令的身份。 当前,和WORKDIR一样,USER只是帮助你切换到指定用户而已,这个用户必须是事先建立好的,否则无法切换。 RUN groupadd -r redis && useradd -r -g redis redis USER redis RUN ["redis-server"] HEALTHCHECK健康检查 格式: HEALTHCHECK [选项] CMD <命令>:设置检查容器健康状况的命令 HEALTHCHECK NONE:如果基础镜像有健康检查指令,可以屏蔽掉其健康检查指令 HEALTHCHECK指令是告诉Docker应该如何进行判断容器的状态是否正常,这是Docker1.12引入的新指令。通过该指令指定一行命令,用这行命令来判断容器主进程的服务状态是否还正常,从而比较真实的反应容器实际状态。 一个镜像指令HEALTHCHECK指令后,用其启动容器,初始状态会为starting,在执行健康检查成功后变为healthy,如果连续一定次数失败,则会变为unhealthy。 HEALTHCHECK支持下列选项: --interval=<间隔>:两次健康检查的间隔,默认为30秒; --timeout=<时长>:健康检查命令运行超时时间,如果超过这个时间,本次健康检查就被视为失败,默认30秒; --retries=<次数>:当连续失败指定次数后,则将容器状态视为unhealthy,默认3次。 为了帮助排障,健康检查命令的输出(包括stdout以及stderr)都会被存储于健康状态里,可以用docker inspect来查看。 ONBUILD为他人做嫁衣裳 格式: ONBUILD <其它指令>ONBUILD是一个特殊的指令,它后面跟的是其它指令,比如RUN,COPY等,而这些指令,在当前镜像构建时并不会被执行。只有当以前镜像为基础镜像,去构建下一级镜像的时候才会被执行。 Dockerfile中的其它指令都是为了定制当前镜像而准备的,唯有ONBUILD是为了帮助别人定制自己而准备的。 其他制作镜像方式 docker save和docker load Docker还提供了docker load和docker save命令,用以将镜像保存为一个tar文件,然后传输到另一个位置上,再加载进来。这是在没有Docker Registry时的做法,现在已经不推荐,镜像迁移应该直接使用Docker Registry,无论是直接使用Docker Hub还是使用内网私有Registry都可以。 例如:保存nginx镜像 docker save nginx|gzip > nginx-latest.tar.gz 然后我们将nginx-latest.tar.gz文件复制到了另一个机器上,再次加载镜像: docker load -i nginx-latest.tar.gz
优秀的个人博客,低调大师

【Kafka】《Kafka权威指南》入门

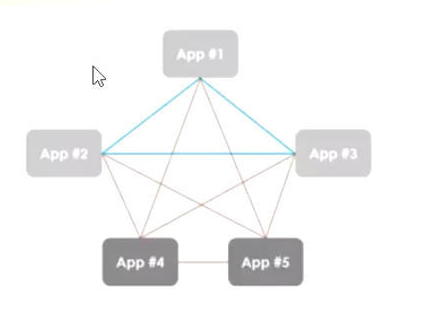
发布与订阅消息系统 在正式讨论Apache Kafka (以下简称Kafka)之前,先来了解发布与订阅消息系统的概念, 并认识这个系统的重要性。数据(消息)的发送者(发布者)不会直接把消息发送给接收 者,这是发布与订阅消息系统的一个特点。发布者以某种方式对消息进行分类,接收者 (订阅者)订阅它们,以便接收特定类型的消息。发布与订阅系统一般会有一个 broker,也就是发布消息的中心点。 发布与订阅消息系统的大部分应用场景都是从一个简单的消息队列或一个进程间通信开始的。比如电商系统中,包含会员模块、订单模块、商品模块、推荐模块、配送物流模块等,多个模块(子系统)间涉及消息的传递。 最早的应用解决方案就是采用(子系统间)直连的方式,使得很多子系统交错复杂。这种点对点的连接方式,形成网状的连接,弊端很多,不一一赘述。 后来,为了解决子系统间直连交错的问题,出现了队列系统。下图所示的架构包含了 3 个独立的发布与订阅系统。 这种方式比直接使用点对点的连接要好得多,但这里有太多重复的地方。你的公司因此要为数据队列维护多个系统,每个系统又有各自的缺陷和不足。而且,接下来可能会有更多的场景需要用到消息系统。 此时,你真正需要的是一个单一的集中式系统,它可以用来发布通用类型的数据,其规模可以随着公司业务的增长而增长。这时Kafka登场了。 Kafka登场 Kafka就是为了解决上述问题而设计的一款基于发布与订阅的消息系统。它一般被称为 “分布式提交日志”或者“分布式流平台”。文件系统或数据库提交日志用来提供所有事务 的持久记录 , 通过重放这些日志可以重建系统的状态。同样地, Kafka 的数据是按照 一定顺序持久化保存的,可以按需读取 。 此外, Kafka 的数据分布在整个系统里,具备数据故障保护和性能伸缩能力。 消息和批次 Kafka的数据单元被称为消息。如果你在使用 Kafka之前已经有数据库使用经验,那么可 以把消息看成是数据库里的一个“数据行”或一条“记录”。消息由字节数组组成,所以 对于 Kafka来说,消息里的数据没有特别的格式或含义。消息可以有一个可选的元数据, 也就是键(key)。键也是一个字节数组,与消息一样,对于 Kafka来说也没有特殊的含义。 当消息以一种可控的方式写入不同的分区时,会用到键。最简单的例子就是为键生成一个一致 性散列值,然后使用散列值对主题分区数进行取模,为消息选取分区 。这样可 以保证具有 相同键的消息总是被写到相同的分区上。 为了提高效率,消息被分批次写入 Kafka。 批次就是一组消息,这些消息属于同一个主题 和分区。如果每一个消息都单独穿行于网络,会导致大量的网络开销,把消息分成批次传 输可以减少网络开销。不过,这要在时间延迟和吞吐量之间作出权衡;批次越大,单位时间内处理的消息就越多,单个消息的传输时间就越长。批次数据会被压缩,这样可以提升 数据的传输和存储能力,但要做更多的计算处理。 主题(topic)和分区(partition) Kafka 的悄息通过 主题进行分类。主题就好比数据库的表,或者文件系统里的文件夹。主题可以被分为若干个分区 , 一个分区就是一个提交日志。消息以追加的方式写入分区,然后以先入先出的顺序读取。要注意,由于一个主题一般包含几个分区,因此无法在整个主题范围内保证消息的顺序,但可以保证消息在单个分区内的顺序。下图 所示的主题有 4 个分区,消息被迫加写入每个分区的尾部。 Kaflca通过分区来实现数据冗余和伸缩性。分区可以分布在不同的服务器上,也就是说, 一个主题可以横跨多个服务器,以此来提供比 单个服务器更强大的性能。 我们通常会使用流这个词来描绘Kafka这类系统对数据。很多时候,人们把一个主题的数据看成一个流,不管它有多少个分区。流是一组从生产者移动到消费者的数据。当我们讨 论流式处理时,一般都是这样描述消息的。 Kaflca Streams、 Apache Samza 和 Storm 这些框 架以实时的方式处理消息,也就是所谓的流式处理。我们可以将流式处理与离线处理进行比较,比如 Hadoop 就是被设计用于在稍后某个时刻处理大量的数据。 生产者和消费者 Kafka 的客户端就是 Kafka 系统的用户,它们被分为两种基本类型 : 生产者和消费者。除此之外,还有其他高级客户端 API——用于数据集成的 Kaflca Connect API 和用于流式处理 的 Kaflca Streams。这些高级客户端 API 使用生产者和消费者作为内部组件,提供了高级的 功能。 生产者创建消息。在其他发布与订阅系统中,生产者可能被称为发布者或写入者。一般情 况下,一个消息会被发布到一个特定的主题(topic)上。生产者在默认情况下把消息均衡地分布到主题的所有分区上,而并不关心特定消息会被写到哪个分区。不过,在某些情况下,生产者会把消息直接写到指定的分区。这通常是通过消息键和分区器来实现的,分区器为键生 成一个散列值,并将其映射到指定的分区上。这样可以保证包含同一个键的消息会被写到 同一个分区上。生产者也可以使用自定义的分区器,根据不同的业务规则将消息映射到分 区。下一章将详细介绍生产者。 消费者读取消息。在其他发布与订阅系统中,消费者可能被称为订阅者或读者 。 消费者订阅一个或多个主题,并按照消息生成的顺序读取它们。消费者通过检查消息的偏移盘来区 分已经读取过的消息。 偏移量是另一种元数据,它是一个不断递增的整数值,在创建消息 时, Kafka 会把它添加到消息里。在给定的分区里,每个悄息的偏移量都是唯 一 的。消费 者把每个分区最后读取的悄息偏移量保存在 Zookeeper或 Kafka上,如果悄费者关闭或重 启,它的读取状态不会丢失。 消费者是消费者群组的一部分,也就是说,会有一个或多个消费者共同读取一个主题。 群组保证每个分区只能被一个消费者使用 。下图所示的群组中,有 3 个消费者同时读取一 个主题。其中的两个消费者各自读取一个分区,另外一个消费者读取其他两个分区。消费 者与分区之间的映射通常被称为悄费者对分区的所有权关系 。 通过这种方式,消费者可以消费包含大量消息的主题。而且,如果一个消费者失效,群组 里的其他消费者可以接管失效悄费者的工作。第 4章将详细介绍消费者和悄费者群组。 broker和集群 一个独立的 Kafka服务器被称为 broker。 broker接收来自 生产者的消息,为消息设置偏移 量,并提交消息到磁盘保存。 broker 为消费者提供服务,对读取分区的请求作出响应,返 回已经提交到磁盘上的消息。根据特定的硬件及其性能特征,单个 broker可以轻松处理数 千个分区以及每秒百万级的消息量。 Broker可以看作是消息中间件处理节点,一个Kafka节点就是一个broker,一个或者多个Broker可以组成一个Kafka集群。 broker是集群的组成部分。每个集群都有一个 broker 同时充当了集群控制器的角色(自动 从集群的活跃成员中选举出来)。控制器负责管理工作,包括将分区分配给 broker和监控 broker. 在集群中, 一个分区从属于一个 broker, i亥 broker被称为分区的首领。一个分区 可以分配给多个 broker,这个时候会发生分区复制(见下图)。这种复制机制为分区提供 了消息冗余,如果有一个 broker失效,其他 broker可以接管领导权。不过,相关的消费者 和生产者都要重新连接到新的首领。 保留消息(在一定期限内)是 Kafka的一个重要特性。 Kafka broker默认的消息保留策略 是这样的:要么保留一段时间(比如 7天),要么保留到消息达到一定大小的字节数(比 如 1GB)。当消息数量达到这些上限时,旧消息就会过期井被删除,所以在任何时刻, 可 用消息的总量都不会超过配置参数所指定的大小。主题可以配置自己的保留策略,可以将 悄息保留到不再使用它们为止。例如,用于跟踪用户活动的数据可能需要保留几天,而应 用程序的度量指标可能只需要保留几个小时。可以通过配置把主题当作 紧凑型日志, 只有 最后一个带有特定键的消息会被保留下来。这种情况对于变更日志类型的数据来说比较适 用,因为人们只关心最后时刻发生的那个变更。 为什么选择 Kafka 多个生产者 Kafka 可以无缝地支持多个生产者,不管客户端在使用单个 主题还是多个主题。所以它很 适合用来从多个前端系统收集数据,并以统一的格式对外提供数据。例如, 一个包含了 多 个微服务的网站,可以为页面视图创建一个单独的主题,所有服务都以相同的消息格式向 该主题写入数据。消费者应用程序会获得统一的页面视图,而无需协调来自不同生产者的 数据流。 多个消费者 除了支持多个生产者外, Kafka也支持多个消费者从一个单独的消息流上读取数据,而且 消费者之间直不影响。这与其他队列系统不同,其他队列系统的消息一旦被一个客户端读 取,其他客户端就无法再读取它。另外,多个消费者可以组成一个群组,它们共享一个消息流,并保证整个群组对每个给定的消息只处理一次。 基于磁盘的数据存储 Kafka不仅支持多个消费者,还允许消费者非实时地读取消息,这要归功于 Kafka的数据 保留特性。?肖息被提交到磁盘,根据设置的保留规则进行保存。每个主题可以设置单独的 保留规则,以便满足不同消费者的需求,各个主题可以保留不同数量的消息。消费者可能 会因为处理速度慢或突发的流量高峰导致无陆及时读取消息,而持久化数据可以保证数据 不会丢失。?肖费者可以在进行应用程序维护时离线一小段时间,而无需担心消息丢失或堵 塞在生产者端。 消费者可以被关闭,但消息会继续保留在 Kafka里。消费者可以从上次中 断的地方继续处理消息。 伸缩性 为了能够轻松处理大量数据, Kafka 从一开始就被设计成一个具有灵活伸缩性的系统。用 户在开发阶段可以先使用单个 broker,再扩展到包含 3 个 broker 的小型开发集群,然后随 着数据盐不断增长,部署到生产环境的集群可能包含上百个 broker。对在线集群进行扩展 丝毫不影响整体系统的可用性。也就是说, 一个包含多个 broker的集群,即使个别 broker 失效,仍然可以持续地为客户提供服务。要提高集群的容错能力,需要配置较高的复制系 数。 高性能 上面提到的所有特性,让 Kafka成为了一个高性能的发布与订阅消息系统。通过横向扩展 生产者、消费者和 broker, Kafka可以轻松处理巨大的消息流。在处理大量数据的同时, 它还能保证亚秒级的消息延迟。

优秀的个人博客,低调大师

Docker-Dockerfile入门 - 2

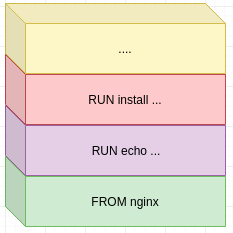
之前我们学会了一个简单的镜像是如何使用Dockerfile来构建出来的,步骤已经列出来了,没有说明白的就是上次的Dockerfile的内容,如下 FROM nginx RUN echo "<h1>Welcome Docker !</h1>" > /usr/share/nginx/html/index.html 如果你了解一点Linux命令,那echo就知道是用来做什么的,那剩下的陌生的就剩下FROM & RUN了 指定基础镜像: FROM 这个命令是一个Dockerfile的基础,它用来指定一个基础的镜像,来作为我们搭建的基础镜像,之后的所有命令和构建都是在此基础镜像上进行构建 有一个特殊的,如下,表示一个空白镜像,就是不以任何镜像为基础镜像,适用于不需要运行时系统支持的操作 FROM scratch 因为是用来指定基础的,所以必须指定,并且必须是第一条命令 执行命令行: RUN 首先这个命令有两种书写格式,一种就是前面说的RUN <Linux命令>,还有一种如下 RUN ["执行文件","参数1","参数2"] 每一个RUN命令都是在原有的基础镜像上新建一层,如下图 下面是一个Dockerfile,它并不是一个可执行的Dockerfile,但是请仔细观察 FROM nginx RUN apt-get update RUN apt-get install git RUN wget "https://xxx.tar" RUN ... 如上是有问题的,并不是用法问题,而是思想问题,RUN了四次也就是在原有的nginx镜像上新建了四层,而我们的目的只是想构建好现在这个基础镜像,以便更方便的使用它,所以我们上面的操作就应该是在一层构建完成的,所以我们应该只是用一个RUN来把环境搭建好,如下 FROM nginx RUN mysoft='git' \ && apt-get update \ && apt-get install $mysoft \ && wget "https://xxx.tar" && <cache clean> 相信你看完上面,就明白我要说什么了,其中刚开始的mysoft是我们定义的变量,而$mysoft就是引用其值,后面的<cache clean>是一些其他的推荐操作,比如更新系统下载下来的软件包清理掉 我们使用RUN就要有这样的思想,我们是在定义每一层是如何构建的,保证无关的东西在本层删除掉 记住并不是上一层不能更改或者触碰到下一层的相关文件,如果知道清理下一层什么文件这是可以清理的,比如这样 FROM centos:latest RUN echo "first" > /hello RUN echo "second" >> /hello RUN rm -f /hello 如上/hello在三次构建的时候都会被影响,而如果第二层不知道第一层有这个hello文件,那么他就修改不了了(意思有点不合适,记住把本层的副作用降到最低这一准则)

优秀的个人博客,低调大师

Docker-Dockerfile入门 - 1

之前说的commit操作会带来各种不好的结果,那么解决办法就是使用Dockerfile来解决这个问题 commit操作不会记录每层的构建过程,而Dockerfile则是记录了每层是如何构建的,那么我们可以通过观察Dockerfile的内容来知道镜像是如何的构建的,达到了镜像透明的目的,并且我们还可以自由的删除Dockerfile中的不需要的构建步骤,来解决镜像臃肿的问题 Dockerfile就是一个文本文件,里面是一条条命令,来指导Docker如何构建我们需要的镜像,比如我们来构建一个index页面为:“welcome Docker”的nginx服务镜像 我们需要先删除之前的nginx:v1,当然不删除也可以,无关紧要 [qidai@qidai-pc docker-file]$ docker images REPOSITORY TAG IMAGE ID CREATED SIZE nginx v1 ca9ac899159e 4 hours ago 109MB nginx latest 881bd08c0b08 4 days ago 109MB ubuntu latest 47b19964fb50 4 weeks ago 88.1MB centos latest 1e1148e4cc2c 3 months ago 202MB [qidai@qidai-pc docker-file]$ docker rmi -f nginx:v1 Untagged: nginx:v1 [qidai@qidai-pc docker-file]$ docker images REPOSITORY TAG IMAGE ID CREATED SIZE <none> <none> ca9ac899159e 4 hours ago 109MB #注意 nginx latest 881bd08c0b08 4 days ago 109MB ubuntu latest 47b19964fb50 4 weeks ago 88.1MB centos latest 1e1148e4cc2c 3 months ago 202MB [qidai@qidai-pc docker-file]$ docker rmi ca9ac899159e #告诉你有容器正在依赖这个镜像在跑着,所以删不掉 Error response from daemon: conflict: unable to delete ca9ac899159e (cannot be forced) - image is being used by running container 1c494ae39be7 [qidai@qidai-pc docker-file]$ docker ps #确实在跑 CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 1c494ae39be7 ca9ac899159e "nginx -g 'daemon of…" 4 hours ago Up 4 hours 0.0.0.0:80->80/tcp recursing_zhukovsky [qidai@qidai-pc docker-file]$ docker stop recursing_zhukovsky recursing_zhukovsky [qidai@qidai-pc docker-file]$ docker rmi ca9ac899159e #停止在删除 Deleted: sha256:ca9ac899159eefe41cf30771cc2f4e23db967d6e2f3d0725226495296b69cb76 Deleted: sha256:c521a0a996057d1e77e13f5badbe3ef8a50b15863dffd7bd71311538ba506472 [qidai@qidai-pc docker-file]$ docker images #删除完成了 REPOSITORY TAG IMAGE ID CREATED SIZE nginx latest 881bd08c0b08 4 days ago 109MB ubuntu latest 47b19964fb50 4 weeks ago 88.1MB centos latest 1e1148e4cc2c 3 months ago 202MB 我们从上面可以看到出现了<none>这样的名字,他之前是有名字和标签的,但这样的镜像基本没有存在价值了,所以可以直接删除,对于只显示这些镜像的过滤条件就是dangling=true,造成这种镜像问题的原因除了上面的这种情况,还会有其他情况会造成,以后遇到了再说吧,不过需要知道的是这种镜像叫做虚悬镜像 好了到这之后,我们使用Dockerfile创建一个index为“welcome Docker”的nginx服务镜像,内容如下 [qidai@qidai-pc docker-file]$ mkdir nginx-index [qidai@qidai-pc docker-file]$ nano nginx-index/Dockerfile [qidai@qidai-pc docker-file]$ cd nginx-index [qidai@qidai-pc nginx-index]$ docker build -t qidai/nginx:welcome . Sending build context to Docker daemon 2.048kB Step 1/2 : FROM nginx ---> 881bd08c0b08 Step 2/2 : RUN echo "<h1>Welcome Docker !</h1>" > /usr/share/nginx/html/index.html ---> Running in 5532922d8639 Removing intermediate container 5532922d8639 ---> 04bf915d6d0d Successfully built 04bf915d6d0d Successfully tagged qidai/nginx:welcome [qidai@qidai-pc nginx-index]$ docker images REPOSITORY TAG IMAGE ID CREATED SIZE qidai/nginx welcome 04bf915d6d0d 11 seconds ago 109MB nginx latest 881bd08c0b08 4 days ago 109MB -t:是指定修建的新镜像的name:tag .:就是Docker当前的context,必须要给出的 Dockerfile内容是这样的 FROM nginx RUN echo "<h1>Welcome Docker !</h1>" > /usr/share/nginx/html/index.html 上面是在Dockerfile所在目录下运行的命令可以成功,如果要指定Dockerfile的目录应该是这样的 [qidai@qidai-pc docker-file]$ docker build -t qidai/nginx:Welcome -f nginx-index/Dockerfile . 到这你就更能了解最后那个.是什么作用了,.代表当前目录,就是Docker会基于当前目录,去寻找-f参数的路径 修建完后,我们来运行一下看看是否成功了 [qidai@qidai-pc docker-file]$ docker run --rm -d -p 80:80 qidai/nginx:Welcome [sudo] qidai 的密码: 83112aeaa80b223d1491ed61a9bed615a606c7545ee34e95ba1724470a85a97a [qidai@qidai-pc docker-file]$ docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 83112aeaa80b qidai/nginx:Welcome "nginx -g 'daemon of…" 4 seconds ago Up 3 seconds 0.0.0.0:80->80/tcp silly_lehmann 访问: localhost 好了到这Dockerfile的初步使用我们就知道了,但是还没有说里面的具体的编写语法,我们下一结来说

优秀的个人博客,低调大师

Python 网络爬虫入门详解

什么是网络爬虫 网络爬虫又称网络蜘蛛,是指按照某种规则在网络上爬取所需内容的脚本程序。众所周知,每个网页通常包含其他网页的入口,网络爬虫则通过一个网址依次进入其他网址获取所需内容。 优先申明:我们使用的python编译环境为PyCharm 一、首先一个网络爬虫的组成结构: 爬虫调度程序(程序的入口,用于启动整个程序) url管理器(用于管理未爬取得url及已经爬取过的url) 网页下载器(用于下载网页内容用于分析) 网页解析器(用于解析下载的网页,获取新的url和所需内容) 网页输出器(用于把获取到的内容以文件的形式输出) 二、编写网络爬虫 (1)准备所需库 我们需要准备一款名为BeautifulSoup(网页解析)的开源库,用于对下载的网页进行解析,我们是用的是PyCharm编译环境所以可以直接下载该开源库。 在学习中有迷茫不知如何学习的朋友小编推荐一个学Python的学习q u n 227 -435- 450可以来了解一起进步一起学习!免费分享视频资料 步骤如下: 选择File->Settings 打开Project:PythonProject下的Project interpreter 点击加号添加新的库 输入bs4选择bs4点击Install Packge进行下载 (2)编写爬虫调度程序 这里的bike_spider是项目名称引入的四个类分别对应下面的四段代码url管理器,url下载器,url解析器,url输出器。 (3)编写url管理器 我们把已经爬取过的url和未爬取的url分开存放以便我们不会重复爬取某些已经爬取过的网页。 (4)编写网页下载器 通过网络请求来下载页面 (5)编写网页解析器 对网页进行解析时我们需要知道我们要查询的内容都有哪些特征,我们可以打开一个网页点击右键审查元素来了解我们所查内容的共同之处。 (6)编写网页输出器 输出的格式有很多种,我们选择以html的形式输出,这样我们可以的到一个html页面。 写在末尾 注意:网页经常发生变化,我们需要根据网页的变化动态修改我们的代码来获得我们所需要的内容。 这只是一个简单的网络爬虫,如果需要完善其功能我们需要考虑更多问题。

优秀的个人博客,低调大师

Java入门—字符串

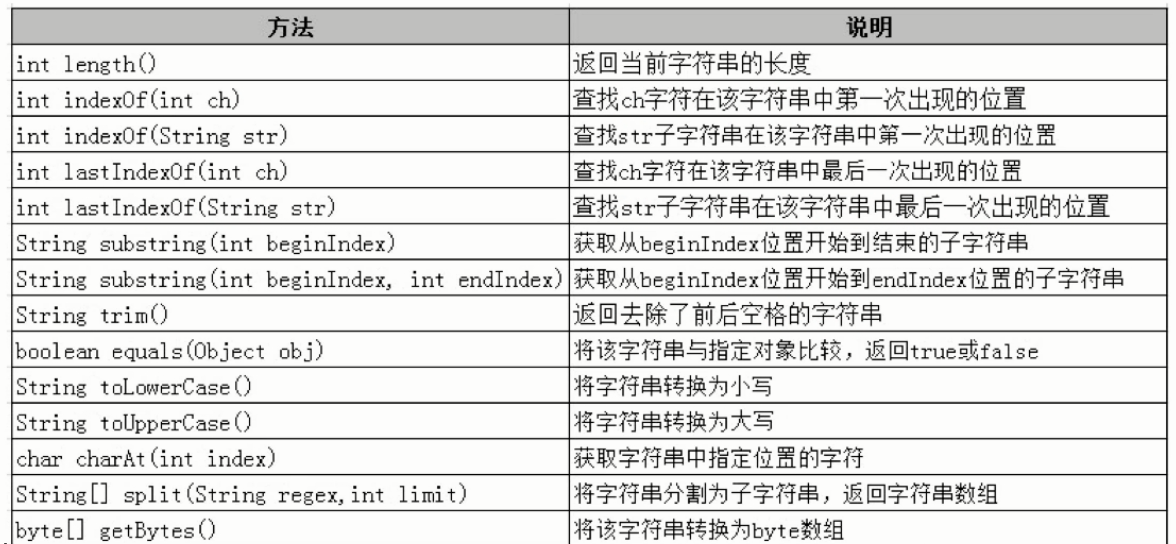
String的常用方法 image.png 以上是我们平时常用的方法,建议自己手动测试练习加以记忆,其他方法可以查阅文档。 将字符串转换为byte数组 示例代码: String name = "java 编程 基础"; byte[] b = name.getBytes(); for(int e: b){ System.out.print(e+" "); } 输出结果: 106 97 118 97 32 -25 -68 -106 -25 -88 -117 32 -27 -97 -70 -25 -95 -128 在utf-8编码中,一个汉字是用三个字节去表示,所以上边输出为三个连续负数。 image.png 每个字节为8位,最大值是不能超过127的,而汉字转换为字节后是超过127的,之后就会发生溢出,以负数的方式显示。 将byte数组转为字符串: String e = new String(b); System.out.println(e); new String()方法可以传入编码方式,(gbk utf-8) byte数组和字符串互转时,编码要相同。 ==和equals方法的区别 String a = "allen"; String b = "allen"; String c = new String("allen"); System.out.println(a==b); System.out.println(a==c); System.out.println(a.equals(b)); System.out.println(a.equals(c)); 对于==, 如果作用于基本数据类型的变量,则直接比较其存储的 “值”是否相等; 如果作用于引用类型的变量,则比较的是所指向的对象的地址 对于equals :注意:equals方法不能作用于基本数据类型的变量如果没有对equals方法进行重写,则比较的是引用类型的变量所指向的对象的地址;诸如String、Date等类对equals方法进行了重写的话,比较的是所指向的对象的内容。 来源于慕课网.png 字符串的不可变性 String对象被创建后,是不可变的。 所谓的修改是创建了新的对象。原变量指向了新的对象。 字符串处理类StringBuilder 区别:StringBuilder 是可变的。 当频繁操作字符串时,建议使用 StringBuilder ,如果使用String,会产生很多中间变量,会在常量池产生很多废弃的数据。 StringBuilder 和 StringBuffer 二者基本相似,StringBuffer是线程安全的(相对来说速度慢),StringBuilder非线程安全,但是性能高。 四种构造方法: image.png 如果文章对你有帮助记得点个赞~ 关注作者后续更新不错过~

优秀的个人博客,低调大师

java8学习:入门

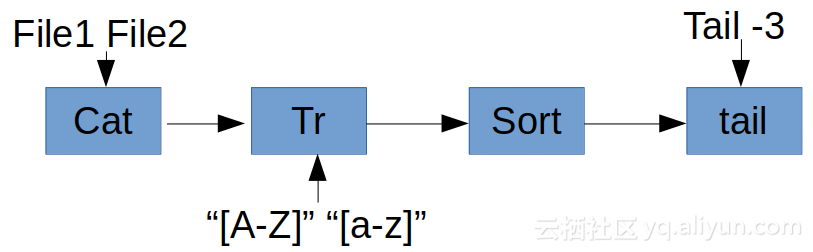
内容来自《 java8实战 》,本篇文章内容均为非盈利,旨为方便自己查询、总结备份、开源分享。如有侵权请告知,马上删除。书籍购买地址:java8实战 sync的使用成本:多核CPU的每个处理器内核都有独立的告诉缓存,加锁需要这些告诉缓存同步运行,然而这有需要在内核间进行较慢的缓存一致性协议通信 流处理 流是一系列数据项,一次只生成一项。程序可以从输入流中一个个读取数据项,然后以 相同的方式将数据项写入输出流 拿Linux的管道命令来演示流过程 如上熟悉linux都清楚cat file1 file2会创建两个文件的输出流,如果加上>那么就会生成一个合并了File1和file2的新文件,cat产生的数据流会通过管道传送给tr进行内容过滤,符合条件的又会传入下一个sort方法进行排序,最后sort排序完成的结果集交给tail -3取三行,至此流算是结束了。这些的流处理行为是高效的,因为cat的数据读一条就会传给tr过滤,tr后传入sort,sort就能在cat或tr完成前先处理几行 基于上面的思想,java8引入了Stream,这样的好处是并行能力得到了极大的提升,并且站在了更高的抽象角度去编程,因为原来的编程习惯的java只能利用一个cpu,除非自己去写thread,并且thread是容易出错的 用行为参数化把代码传递给方法 java8可以通过api传递代码。 对上面的解释就是:看到上面的图的sort函数,可能它默认的只能升序或者降序排序,但是如果我们需要定制排序的话,也就只能对sort进行重新定义,那么就比如下面(java代码演示) @Test public void test() throws Exception { List<Integer> ints = Arrays.asList(1,3,4,5,1,5,7,7,8); ints.sort(new Comparator<Integer>() { @Override public int compare(Integer o1, Integer o2) { return o1.compareTo(o2); //升序 } }); System.out.println(ints); ints.sort(new Comparator<Integer>() { @Override public int compare(Integer o1, Integer o2) { return - o1.compareTo(o2); //降序 } }); System.out.println(ints); } 如上的代码,其实是只有renturn...是有用的,这句代码关乎到排序规则,但是其他的代码都是无用的。那么这时候就会想,只需要写一遍匿名内部类,排序逻辑根据自己需要传入不就行了。这个思想就是:通过api传递代码 并行与共享的可变数据 并发和并行的概念 并发是两个任务可以在重叠的时间段内启动,运行和完成。并行是任务在同一时间运行,例如,在多核处理器上。 并发是独立执行过程的组合,而并行是同时执行(可能相关的)计算。 并发是一次处理很多事情,并行是同时做很多事情。 应用程序可以是并发的,但不是并行的,这意味着它可以同时处理多个任务,但是没有两个任务在同一时刻执行。 应用程序可以是并行的,但不是并发的,这意味着它同时处理多核CPU中的任务的多个子任务。 一个应用程序可以即不是并行的,也不是并发的,这意味着它一次一个地处理所有任务。 应用程序可以即是并行的也是并发的,这意味着它同时在多核CPU中同时处理多个任务。 那么在以往的线程编程中,实现并行的前提就是各个副本可以独立工作,如果在多个副本出现了共享的变量或对象,这就行不通了,因为如果出现同时修改共享变量怎么办 java8的流实现比线程更容易,尽量保持流处理过程中,不访问共享的可变变量,这种函数就被称为纯函数,无副作用函数或无状态函数。但是依旧可以使用sync来实现一个可变数据,但是这样就与并行的概念相悖 函数 方法引用 编写一个目录下查询出所有隐藏文件 @Test public void test() throws Exception { File[] files = new File(".").listFiles(new FileFilter() { @Override public boolean accept(File pathname) { return pathname.isHidden(); } }); for (File file : files) { System.out.println(file); } } 如上啰里啰嗦的只是判断 pathname.isHidden(),java8引入之前只能这么写,但是现在可以这样 @Test public void test() throws Exception { File[] files = new File(".").listFiles((File::isHidden)); for (File file : files) { System.out.println("file = " + file); } } 上面是将isHidden方法做为值传入listFIles方法,与用对象引用传递对象相似,在java8里写下File::isHidden的时候,就创建了一个方法引用,然后可以传递这个引用了 lambda匿名函数 比如代码(int x ) -> x+1,代码的意思就是你传入一个2,那么他会返回3,也可以像上面定义一个方法add1,然后class::add1,但是对于简短逻辑明确的代码来说这样更简洁,如果匿名函数有很多行代码,不能一眼看出这个匿名函数是干嘛的,那么就应该把匿名函数抽出来一个方法使用 实例 bean代码 @AllArgsConstructor @NoArgsConstructor @Data public class Apple { private String color; private Integer weight; } java8之前:苹果根据条件过滤:找出绿色苹果 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); for (Apple apple : apples) { if ("green".equals(apple.getColor())){ System.out.println(apple); } } } java8之前:苹果根据条件过滤:找出1000克以上的大苹果 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); for (Apple apple : apples) { if (1000 < apple.getWeight()){ //其他代码与上面都是一直的,无奈的是只能复制黏贴改条件,复制黏贴是为限的,因为如果有一天需要改一个地方,如果忘记了另一处复制的代码,那么就会出错 System.out.println(apple); } } } java8之后 改变Apple类 @AllArgsConstructor @NoArgsConstructor @Data public class Apple { private String color; private Integer weight; public static boolean filterWeight(Apple apple){ return 1000 < apple.getWeight(); } public static boolean filterColor(Apple apple){ return "green".equals(apple.getColor()); } } 增加接口 public interface FindApple<T> { boolean find(T t); } 编写方法测试 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); filterApple(apples,Apple::filterColor); //java8之后:苹果根据条件过滤:找出绿色苹果 filterApple(apples,Apple::filterWeight); //java8之后:苹果根据条件过滤:找出1000克以上的大苹果 } static void filterApple(List<Apple> apples,FindApple<Apple> f){ for (Apple apple : apples) { if (f.find(apple)){ System.out.println(apple); } } } 自己实现方法引用确实有点复杂,首先要为需要过滤的类增加自实现的static方法,然后编写带有测试方法的结果,之后就是编写方法,此方法是可以接收需要测试类内static方法的。 如上方法filterApple中的f.find(apple),都是可以看出来这是在使用接口中的测试方法,但是这个方法没有实现自己的逻辑,所以到这它是不能按照要求过滤apple的,然后在上面junit测试方法中,传入的Apple::filterColor其实就是为接口中的测试方法添加逻辑,使其能按照我们的要求过滤apple 从传递方法到lambda 如上自己实现方法引用那真是脸上心里全都是mmp,为了实现方法引用,我们增加类Apple的方法,增加了接口等,如果java8要真是这样,那么宁可不用,不过java8是解决了这个问题的,他引入了lambda表达式,这时候上面的写法就可以写为 将增加的接口删掉~ 将在Apple内增加的方法删掉~ 编写代码 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); filterApple(apples,(apple -> "green".equals(apple.getColor()))); filterApple(apples,(apple -> (apple.getWeight() > 1000))); } static void filterApple(List<Apple> apples, Predicate<Apple> f){ for (Apple apple : apples) { if (f.test(apple)){ System.out.println(apple); } } } 这时候看到的变化是从原来的FindApple接口改变为了Predicate接口,其实这个接口的定义跟刚才的FIndApple接口内定义是一样一样的,如下 @FunctionalInterface public interface Predicate<T> { boolean test(T t); .... .... } 最大的变化就是我们并没有使用方法引用,而是直接以更直观的方法来过滤apple 流 日常写代码的时候,在java8之前如果要遍历Map中找出map对应key的特定value值,如果更加复杂的类型就需要嵌套循环并且编写出来的代码是一大坨的 void test() throws Exception {Map maps = new HashMap<>();for (Map.Entry integerStringEntry : maps.entrySet()) { if (integerStringEntry.getKey() > 1000) { if (integerStringEntry.getValue().equals("value")){ System.out.println("integerStringEntry = " + integerStringEntry); } } } } Stream api就类似SQL一样的过滤操作,如上的代码可以写为下面这样的 void test() throws Exception {Map maps = new HashMap<>();maps.entrySet().stream() .filter(entry -> entry.getKey() > 1000) .filter(entry -> entry.getValue().equals("value")) .forEach(System.out::println); } Stream 解决了经典的java程序只能利用一个cpu的问题,可以使程序并行执行,如图 - 在两个cpu上筛选数据,分割数据到两个cpu上,如1 - 按条件过滤数据,如2 - 一个cpu会将结果汇总起来,如3 Stream顺序处理 maps.entrySet().stream().... Stream的并行处理 maps.entrySet().parallelStream().... 默认方法 如上已经看到了,在java8中使用集合类都会有stream方法,那么在java8之前是没有这个方法,如果把java7升级到java8,那么多的这个stream方法不就的需要实现吗,那么不就不能向后兼容了吗? 如上的问题全是由接口内的默认方法实现的 默认方法的定义是由default开始的,比如 public interface MyFunction { default boolean test(String str) { return str.equals(".."); } } public class UU implements MyFunction{ public static void main(String[] args) { UU uu = new UU(); System.out.println(uu.test("..")); } } 如上UU类中根本不要实现接口中的test方法就可以使用,当然也可以覆盖实现 public class UU implements MyFunction{ @Override public boolean test(String str) { return "ll".equals(str); } public static void main(String[] args) { UU uu = new UU(); System.out.println(uu.test("..")); } } 这时候实现的逻辑就是子类重写之后的了 我们都知道接口是可以多重实现的,那么如果IA和IB中方法名重复了咋办 public interface MyFunction1 { default boolean test(String str) { return str.equals(".."); } } public interface MyFunction2 { default boolean test(String str) { return str.equals("ll"); } } public class UU implements MyFunction1,MyFunction2{ //exception public static void main(String[] args) { UU uu = new UU(); System.out.println(uu.test("..")); } } 如上当两个接口中的方法名重复了,那么就会出错,解决办法就是重写重复的方法即可,当然方法重载是没有问题的 这就是为什么在更新为java8之后,之前的代码还是可以使用的原因,java8 在Collection接口中加入了stream默认实现了 default Stream<E> stream() { return StreamSupport.stream(spliterator(), false); }

优秀的个人博客,低调大师

Java入门之包装类

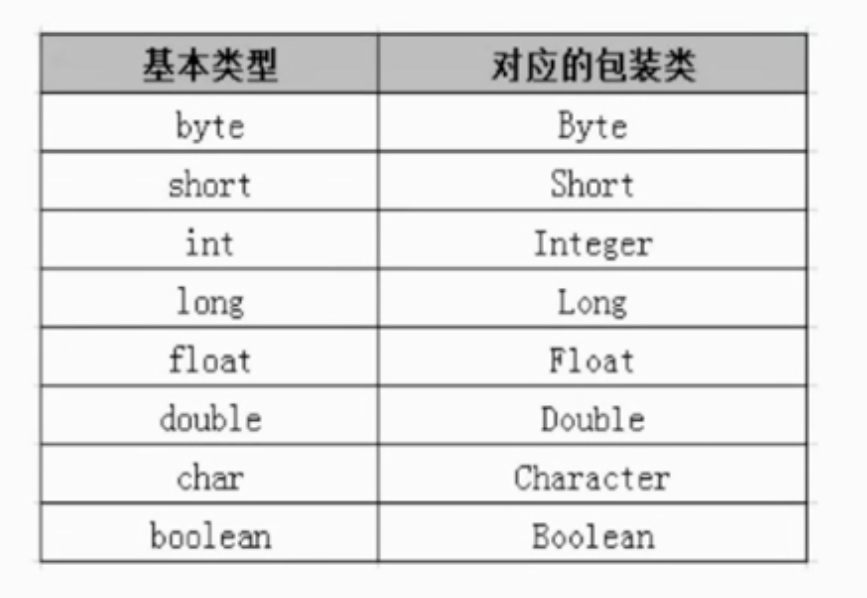
包装类用途 Java中有些异类(8种基本数据类型)它们不能像对象一样进行属性和方法的调用以及进行相互之间的对象化处理,包装类的存在就是为了解决这些异类产生的问题,让它们能像对象一样进行交互。 包装类与基本数据类型之间的关系 image.png 包装类的常用方法 Java中所有包装类都是存放在java.lang这个包中。 以Integer为例,介绍它常用的属性和方法 public final class Integer(){ } 所有的包装类都是用final修饰,不允许被继承,无子类。 image.png 基本数据类型和包装类的转换 装箱 : 基本数据类型转换为包装类 拆箱:包装类转换为基本数据类型 自动装箱(拆箱): int a = 1; Integer b = a; 手动装箱(拆箱): int a = 1; Integer b = new Integer(a); //拆箱 int c = b.intValue(); 基本数据类型和字符串之间转换 通过包装类完成基本数据类型和字符串之间转换。 public class Demo { public static void main(String[] args){ int a = 3; String name = Integer.toString(a); System.out.println(name); //1. int b = Integer.parseInt(name); //2.包装类的valueOf方法先将字符串转为包装类,再通过自动拆箱完成基本数据类型的转换 int d = Integer.valueOf(name); } } 补充知识 包装类对象的初始值 首先看下基本数据类型的初始值: image.png (注:上图中\u是unicode编码) 跟这些基本数据类型对应的包装类,它们的初始值是多少? 包装类的初始值为null。 包装类对象间比较 看代码: public class WrapperTest { public static void main(String[] args) { // TODO Auto-generated method stub Integer one=new Integer(100); Integer two=new Integer(100); System.out.println("one==two的结果:"+(one==two));//1 Integer three=100;//自动装箱 //Integer three=Integer.valueOf(100); //等号两端比较的是值 System.out.println("three==100的结果:"+(three==100));//2 自动拆箱 //执行这个语句时 编译器实际上执行的是这个:Integer four=Integer.valueOf(100); Integer four=100; System.out.println("three==four的结果:"+(three==four));//3 Integer five=200; System.out.println("five==200的结果:"+(five==200));//4 Integer six=200; System.out.println("five==six的结果:"+(five==six));//5 Double d1=Double.valueOf(100); System.out.println("d1==100的结果:"+(d1==100)); Double d2=Double.valueOf(100); System.out.println("d1==d2的结果:"+(d1==d2)); } } 上边代码这个部分:Integer.valueOf(100),为了执行的效率,在这个方法执行的过程中,java内存提供了一个类似于常量数组的缓存区(对象池),如果传入这个方法的参数是大于-128小于127这个范围,会去缓存区查找是否存在,如果有,直接产生,如果没有,实例化新的产生。这也就解释了为什么three==four打印出的值是ture。而five==six的结果是false。 八种基本数据类型中,除了float和double,其他的都是应用对象常量池这个概念的。 后续持续更新ing...

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册