首页 文章 精选 留言 我的

精选列表

搜索[团队协作工具],共10000篇文章
优秀的个人博客,低调大师

Kafka核心逻辑介绍 | 京东云技术团队

1、概念 Kafka是最初由Linkedin公司开发,是一个分布式、支持分区的(partition)、多副本的(replica)分布式消息系统(kafka2.8.0版本之后接触了对zk的依赖,使用自己的kRaft做集群管理,新增内部主体@metadata存储元数据信息),它的最大的特性就是可以实时的处理大量数据以满足各种需求场景:比如基于hadoop的批处理系统、低延迟的实时系统、storm/Spark流式处理引擎,web/nginx日志、访问日志,消息服务等等,用scala语言编写,Linkedin于2010年贡献给了Apache基金会并成为顶级开源 项目。 类似产品还有 JBoss、MQ(ActiveMQ、RabbitMQ-erlang、RocketMQ-支持事务型消息) 2、kafka的特性 高吞吐量、低延迟:kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒。(RecordAccumulate) 可扩展性:kafka集群支持热扩展 持久性、可靠性:消息被持久化到本地磁盘,并且支持数据备份防止数据丢失 容错性:允许集群中节点失败(若副本数量为n,则允许n-1个节点失败) 高并发:支持数千个客户端同时读写 3、为什么要使用kafka ① 异步处理 ② 服务解耦 ③ 流量控制 4、kafka原理解析 消息是kafka的基本单位,消息是一串字节构成的。主要是key、value,key根据一定的策略,将消息体路由到不同的partition分区中。 kafka消息全部持久化到磁盘,其使用日志文件的方式来保存。Partition 以文件的形式存储在文件系统中 命名规则:<topic_name>-<partition_id> Producer:消息⽣产者,向 Kafka Broker 发消息的客户端。 Consumer:消息消费者,从 Kafka Broker 取消息的客户端。Kafka支持持久化,生产者退出后,未消费的消息仍可被消费。 Consumer Group:消费者组(CG),消费者组内每个消费者负责消费不同分区的数据,提⾼消费能⼒。⼀个分区只能由组内⼀个消费者消费,消费者组之间互不影响。所有的消费者都属于某个消费者组,即消费者组是逻辑上的⼀个订阅者。 Broker:⼀台 Kafka 机器就是⼀个 Broker。⼀个集群(kafka cluster)由多个 Broker 组成。⼀个 Broker 可以容纳多个 Topic。 Controller:由zookeeper选举其中一个Broker产生。它的主要作用是在 Apache ZooKeeper 的帮助下管理和协调整个 Kafka 集群。Broker都在ZooKeeper的Controller节点上注册一个Watcher,当controller发生故障的时候,注册在其上的Watcher会被触发,竞选成为新的controller Topic:可以理解为⼀个队列,Topic 将消息分类,⽣产者和消费者⾯向的是同⼀个 Topic。 Partition:为了实现扩展性,提⾼并发能⼒,⼀个⾮常⼤的 Topic 可以分布到多个 Broker上,⼀个 Topic 可以分为多个 Partition,同⼀个topic在不同的分区的数据是不重复的,每个 Partition 是⼀个有序的队列,其表现形式就是⼀个⼀个的⽂件夹。不同Partition可以部署在同一台机器上,但不建议这么做。 Replication:每⼀个分区都有多个副本,副本的作⽤是做备胎。当主分区(Leader)故障的时候会选择⼀个备胎(Follower)上位,成为Leader。在kafka中默认副本的最⼤数量是10个,且副本的数量不能⼤于Broker的数量,follower和leader绝对是在不同的机器,同⼀机器对同⼀个分区也只可能存放⼀个副本(包括⾃⼰)。 Message:每⼀条发送的消息主体。 Leader:每个分区多个副本的“主”副本,⽣产者发送数据的对象,以及消费者消费数据的对象,都是 Leader。 Follower:每个分区多个副本的“从”副本,使用发布订阅模式主动拉取Leader的数据(与redis不同),实时从 Leader 中同步数据,保持和 Leader 数据的同步。Leader 发⽣故障时,某个 Follower 还会成为新的 Leader。 Offset:消费者消费的位置信息,监控数据消费到什么位置,当消费者挂掉再重新恢复的时候,可以从消费位置继续消费。 ZooKeeper:Kafka 集群能够正常⼯作,需要依赖于 ZooKeeper,ZooKeeper 帮助 Kafka存储和管理集群信息。 High Level API 和Low Level API :高水平API,kafka本身定义的行为,屏蔽细节管理,使用方便;低水平API细节需要自己处理,较为灵活但是复杂。 kafka的高吞吐量 1,数据批量发送 kafka消息从producer发送出去时并不是一条一条发送的,而是先发送到一个消息批次(RecordAccumulate)中,然后由sender线程异步的将消息批次中的消息发到broker。这也是kafka吞吐量高的主要原因之一 消息发送 ---> 放入队列 ---> 申请内存 ---> 消费消息 之所以用到CopyOnWriteMap (采用写时复制),读不需要加锁,适用于读多写少的情况。而kafka只有当某个topic+partition下的第一条消息进行写入时才会写入数据,大部分情况都是读,符合读多写少的情况。 kafka的高可用 每个partition分区至少有一个副本,各个副本同步leader副本,一主多从的模式。 AR:分区中的所有 Replica 统称为 AR ISR:所有与 Leader 副本保持一定程度同步的Replica(包括 Leader 副本在内)组成 ISR OSR:与 Leader 副本同步滞后过多的 Replica 组成了 OSR 有效的分区副本是一个ISR集合,ISR集合保存的是有效的副本集合,如果发现某一个副本同步非常慢,则可以自动剔除。leader副本和fllower副本同步的时候会有延迟,但是只要未超过阈值都是可以接受的 ISR集合的存在只要是解决分区leader和follwer 同步复制和异步复制带来的问题 持同步不是指与Leader数据保持完全一致,只需在replica.lag.time.max.ms时间内与Leader保持有效连接 Follower周期性地向Leader发送FetchRequest请求,发送时间间隔配置在replica.fetch.wait.max.ms中,默认值为500ms 极端情况下,如果ISR集合内的所有节点都down了,有两种情况: 1,等待ISR集合中的某一个节点恢复并担任leader 2,选择所有节点(包含ISR之外的) 第一个恢复的担当leader 那么目前kafka的策略是第二点,这样会有一个问题就是ISR集合之外的节点可能数据不全,会和有效ISR集合内节点的数据有出入,造成数据不准确,但是保持了可用性 ACK机制 ① 0:生产者无需等待服务端的任何确认,消息被添加到生产者套接字缓冲区后就视为已发送,因此acks=0不能保证服务端已收到消息 ② 1:只要 Partition Leader 接收到消息而且写入本地磁盘了,就认为成功了,不管它其他的 Follower 有没有同步过去这条消息了 ③ all:Leader将等待ISR中的所有副本确认后再做出应答,因此只要ISR中任何一个副本还存活着,这条应答过的消息就不会丢失 2,磁盘的顺序读写 3,数据压缩传输 4,topic划分多个partition分区,提高并发能力 kafka高性能 普通文件读取: 磁盘文件 --①-> 内核缓冲区 --②-> 用户缓存区 --③-> 内核socket缓存区 --④-> 网卡接口 ---> 消费者 零拷贝技术 磁盘文件 --①-> 内核缓冲区 --②(transferTo)-> 网卡接口 ---> 消费者 划重点: 零拷贝并不是不需要拷贝,而是减少拷贝的次数。 DMA DMA技术使得 数据文件在各个层之间的传输,则可以直接绕过CPU。 linux系统中,零拷贝依赖于底层的sendfile() 方法实现,java中,FileChannel.transfeTo方法的底层实现了sendfile方法。 kafka消费方式 推拉结合:生产者push,消费组pull ① enable.auto.commit 是否自动提交自己的offset值;默认值时true ② auto.commit.interval.ms 自动提交时长间隔;默认值时5000 ms ③ consumer.commitSync(); offset提交命令; at most onece:最多消费一次,存在数据丢失的情况 at least once:最少消费一次,保证数据不丢,存在重复消费 (kafka默认消费方式) exactly once:精确一次,无论何种情况下,消息只会消费一次 (依赖于外部存储系统协调) 最多一次、最少一次的主要区别:是消费消息再记录offset还是先记录offset再消费消息。 5、kafka消息丢失问题 场景: 消费端从leader副本poll了一批消息消费之后,leader副本挂机了,之后从ISR选举出的副本中的消息可能是比leader少了的。如果此时consumer处理完这批数据提交offset,消费端会丢失这部分新产生而在kafka中实实在在保存着的数据。 解决方式: HW(high Watermark)高水位 它标识了一个特定的消息偏移量(offset),消费者只能拉取到这个 offset 之前的消息。 分区 ISR 集合中的每个副本都会维护自身的 LEO(Log End Offset):俗称日志末端位移,而 ISR 集合中最小的 LEO 即为分区的 HW,对消费者而言只能消费 HW 之前的消息。 附 1.kafka的消费组如果需要增加组员,最多增加到和partition数量一致,否则超过的组员只会占用资源而没有作用 2.Raft协议是啥? 比较流行的分布式协议算法(leader选举、日志复制) 3.分区设置:一天一亿消息大致分为8个分区资源可满足。 参考: https://www.jianshu.com/p/6cbe28a44543 作者:京东零售张继 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

带你走进灵动岛 | 京东云技术团队

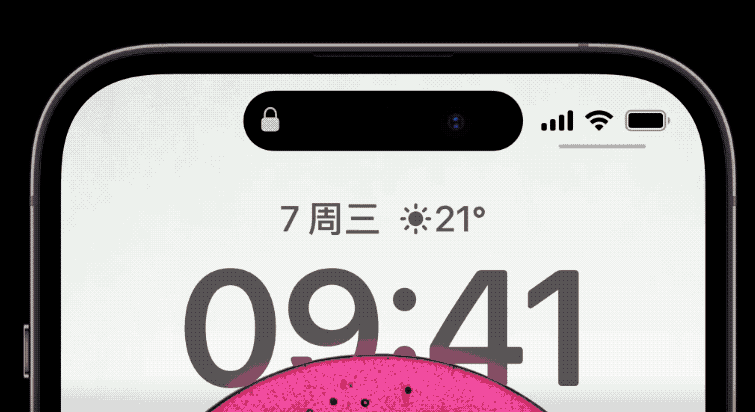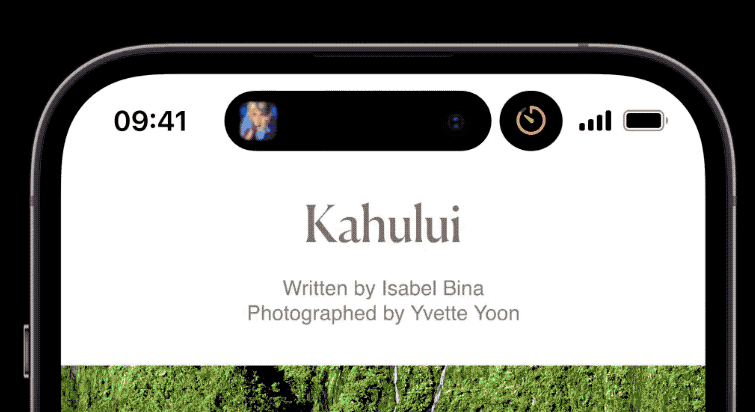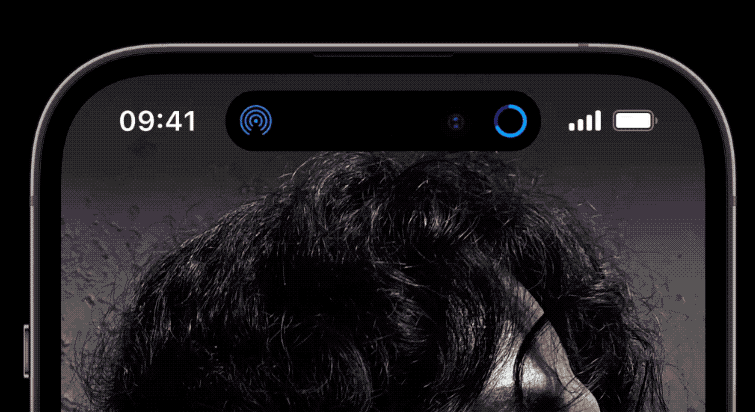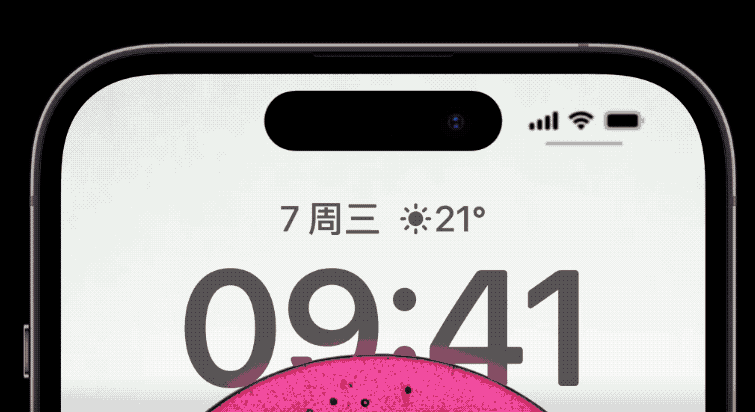
前言 iOS最近几年新特性 iOS14 视频画中画 AppLibrary 桌面小组件 照片隐私加强 应用限免 智能折叠 全新siri悬浮显示 iOS15 FaceTime支持屏幕共享 信息和新增拟我表情 推出专注模式 通知重新设计,图标变得更大 地图公共交通路线置顶,增加时间显示 识别图片上文字信息 支持照片信息和照片上的文字进行搜索 iOS16 iOS 16 锁定界面 锁定界面小组件 锁屏界面的实时活动 iPhone锁定全屏幕音乐播放器 电池百分比出来啦 视频实况文本 快速查询Wi-Fi密码 iOS17 设置您的待机屏幕 优先考虑交互式小部件 定制您的联系海报 创建您自己的贴纸 设置新的 Safari 配置文件 开启反追踪 分享您的 iCloud 钥匙串密码 一、简介 实时活动(Live Activity),是iOS16新增的扩展组件功能,可以在灵动岛和锁定屏幕上显示应用程序的实时数据。用于追踪事件和任务进度实时活动的开始和结束都是离散的,具体画面场景如下:苹果 苹果在 iPhone 14 Pro 及 iPhone 14 Pro MAX 上推出了灵动岛。灵动岛将 iPhone 前置镜头和软件通知结合在一起的全新设计,用出色的交互设计掩盖硬件的缺陷,是一次交互玩法的革新。灵动岛可以通过点按、长按、轻扫来进行交互,最多支持两个应用同时“登岛”。 灵动岛全称 Dynamic Island,作为 iOS 中实时活动(Live Activities)功能的一部分,用来展示需要实时更新的消息。例如外卖配送信息,地图实时导航信息等。灵动岛有 3 种展现形式。 1.1 展现形式 1.1.1 紧凑(Compact) 当系统只有 1 个实时活动的内容时,灵动岛默认使用紧凑模式。紧凑模式下UI由头部(Leading side)和尾部(Trailing side)组成,如图所示。用户可以点击灵动岛打开 App 查看实时活动的内容 1.1.2 最小化(Minimal) 当系统有多个实时活动的内容时,灵动岛自动切换使用最小化模式。最小化模式下由附着的头部(Leading(attached))和分割开的尾部(Trailing(detached))组成,如图所示。和紧凑模式一样,最小化模式也支持用户点击打开 App。 1.1.3扩展(Expanded) 当用户在紧凑或最小化模式轻扫或长按灵动岛时,灵动岛可以切换成扩展模式。用于向用户展示更多信息。扩展模式的 UI 设计尽量保持和紧凑模式一致,用户从紧凑模式切换到扩展模式会有一个平滑的体验。 当我们向 App Store 提交了适配灵动岛的 App 版本时,以上 3 种模式都需要适配。 二、场景限制 2.1样式限制 1、实时活动针对锁定屏幕和灵动岛提供了不同的视图。锁定屏幕可以出现在所有支持 iOS 16 的设备上。而灵动岛在支持设备上,使用以下视图显示实时活动:紧凑前视图、紧凑尾视图、最小视图和扩展视图。 2、当用户触摸灵动岛,且灵动岛中有紧凑或最小视图,同时实时活动更新时,会出现扩展视图。在不支持灵动岛的设备上,扩展视图显示为实时活动更新的横幅。 3、为确保系统可以在每个位置显示 App 的实时活动,开发者必须支持所有视图。 建议:同场景多卡片由于样式趋同且折叠,不建议同时创建多卡片 灵动岛页面需要实现的部分有4个: a、不支持灵动岛的机型 或 锁屏时的 显示 b、紧凑级展示(即左右贴合灵动岛的展示) c、多Live activity时的展示(即极小视图,左贴合,右分离) d、扩展视图(长按灵动岛时触发) 备注:还有一个App同时存在的实时活动面板最多只能创建5个,这也是一个场景约束条件。Error requesting delivery Live Activity The operation couldn’t be completed. Maximum number of activities for target already exists 2.2 时间限制 实时活动最多可以保持八小时的活动状态,除非其应用程序或人员在此限制之前结束活动。超过八小时限制后,系统自动结束直播活动,并立即将其移出动态岛。但是,实时活动会保留在锁定屏幕上,直到有人将其删除,或者在系统将其删除之前最多再保留四个小时(以先到者为准)。因此,实时活动在锁定屏幕上保留最多 12 小时。 官方表述:https://developer.apple.com/documentation/activitykit/displaying-live-data-with-live-activities A Live Activity can be active for up to eight hours unless your app or a person ends it before this limit. After the 8-hour limit, the system automatically ends it. When a Live Activity ends, the system immediately removes it from the Dynamic Island. However, the Live Activity remains on the Lock Screen until a person removes it or for up to four additional hours before the system removes it — whichever comes first. As a result, a Live Activity remains on the Lock Screen for a maximum of twelve hours. 2.3 数据更新 每个实时活动运行在自己的沙盒中,与小组件不同的是,它无法访问网络或接收位置更新。若要更新实时活动的动态数据,少量(不能超过4KB)数据可通过远程推送通知发送,或通过ActivityKit 框架后台活动刷新数据。 ActivityKit 更新和 ActivityKit 推送通知的更新动态数据大小不能超过 4 KB。 2.4 网络限制 a、卡片本身禁止定位以及网络请求,数据刷新依赖本地刷新,实施活动推送刷新,同2)所述; b、Live Activity内部禁用网络图片,传统的服务端传图片URL的方式无法满足实际使用,但是希望传入订单图片来个性化地表达并且区分不同订单。 iOS 16 beta版创建时可以通过将图片转为Data格式传入卡片,但是iOS16.1该方案仅限传入4KB左右的图片(API限制),因此暂时不考虑非本地图片方案,采用内置图片方式实现。 2.5 埋点限制 **场景情况:**由于默认情况点击是回主程序,而并不是固定页面,因此有必要自定义widgetUrl(如用于回到订单页面),也可以通过Link实现分区域的跳转,Link和widgetUrl共存时,点击Link区域会响应Link,因此两者同时使用即可。 无法在widget内部直接添加埋点,并且灵动岛收起时,仅支持添加同一个widgetUrl,对于收起状态添加Link并没有响应。 **埋点方式:**因为点击直接跳转到主App,因此考虑将埋点参数加入URL参数即可,主App解析时埋点。但是无法记录包括用户查看、用户关闭(关闭卡片 继续发送推送也没有报错 因此无法判断)等行为的埋点。 对于灵动岛的区分,实际测试发现,在展开模式下,可以加入Link并且可以正常响应,这与官方文档中的描述一致。 三、适配 3.1 UI适配 1、尺寸: 目前只有 iPhone 14 Pro 及 iPhone 14 Pro MAX 具有灵动岛功能。在两种机型上,灵动岛的圆角半径都为 44Points,这个数值和前置深感摄像头的半径是一样的。按照前述的 3 种模式,灵动岛的具体参数如下表格所示(表格涉及的数值表示Points)。 机型 屏幕尺寸 紧凑模式(头部) 紧凑模式(尾部) 最小化模式 展开模式 iPhone 14 Pro 393*852 52.33*36.67 52.33*36.67 36.67*36.67 371*(84-160) iPhone 14 Pro Max 430*932 62.33*36.67 62.33*36.67 36.67*36.67 408*(84-160) 2、颜色 开发者无法更改灵动岛的背景颜色,只能更改文字颜色、素材颜色、灵动岛边框颜色等。UI 适配需要考虑系统的深色模式,必要情况可以使用两套 UI。 3.2开发适配 3.2.1开发框架简介 苹果在 iOS 16.1 正式对外开放了灵动岛适配框架ActivityKit,第三方 App 可以使用这些ActivityKit完成灵动岛适配工作。注意ActivityKit的 API 目前仅适用于 iPhone。灵动岛使用WidgetKit和SwiftUI完成 UI 开发工作,ActivityKit在其中扮演创建Activity,请求数据,更新数据,结束Activity的角色。 3.2.2权限管理 灵动岛作为实时活动的一部分,需要实时活动权限才能正常展示。和通知权限,相机权限等类似,实时活动权限需要 App 3.2.3 生命周期 Request Update Observe avtivity state End import ActivityKit struct AdventureAttributes: ActivityAttributes { //不可变 let hero: EmojiRanger /// The associated type that describes the dynamic content of a Live Activity. /// /// The dynamic data of a Live Activity that's encoded by `ContentState` can't exceed 4KB. struct ContentState: Codable & Hashable { let currentHealthLevel: Double let eventDescription: String } } let adventure = AdventureAttributes(hero: hero) let initialState = AdventureAttributes.ContentState( currentHealthLevel: hero.healthLevel, eventDescription: "Adventure has begun!" ) let content = ActivityContent(state: initialState, staleDate: nil, relevanceScore: 0.0) let activity = try Activity.request( attributes: adventure, content: content, pushType: nil ) let heroName = activity.attributes.hero.name let contentState = AdventureAttributes.ContentState( currentHealthLevel: hero.healthLevel, eventDescription: "\(heroName) has taken a critical hit!" ) var alertConfig = AlertConfiguration( title: "\(heroName) has taken a critical hit!", body: "Open the app and use a potion to heal \(heroName)", sound: .default ) activity.update( ActivityContent<AdventureAttributes.ContentState>( state: contentState, staleDate: nil ), alertConfiguration: alertConfig ) // Observe activity state asynchronously func observeActivity(activity: Activity<AdventureAttributes>) { Task { for await activityState in activity.activityStateUpdates { if activityState == .dismissed { self.cleanUpDismissedActivity() } } } } // Observe activity state synchronously let activityState = activity.activityState if activityState == .dismissed { self.cleanUpDismissedActivity() } let hero = activity.attributes.hero let finalContent = AdventureAttributes.ContentState( currentHealthLevel: hero.healthLevel, eventDescription: "Adventure over! \(hero.name) has defeated the boss! Congrats!" ) let dismissalPolicy: ActivityUIDismissalPolicy = .default activity.end( ActivityContent(state: finalContent, staleDate: nil), dismissalPolicy: dismissalPolicy) } 3.2.4UI import WidgetKit import SwiftUI @main struct EmojiRangersWidgetBundle: WidgetBundle { var body: some Widget { EmojiRangerWidget() LeaderboardWidget() AdventureActivityConfiguration() } } struct AdventureActivityConfiguration: Widget { var body: some WidgetConfiguration { ActivityConfiguration(for: AdventureAttributes.self) { context in // ... // Create the view that appears on the Lock Screen and as a // banner on the Home Screen of devices that don't support the // Dynamic Island. } dynamicIsland: { context in // Create the views that appear in the Dynamic Island. DynamicIsland { // Create the expanded view. // Leading region // Expanded region // Bottom region } compactLeading: { // Create the compact leading view. // ... } compactTrailing: { // Create the compact trailing view. // ... } minimal: { // Create the minimal view. // ... } } } } 四、远程通知更新数据 实时活动也支持远程推送更新,根据文档以下9点要求实现(avtivity远程推送每小时有通知预算(数量未明确),超出后系统将关闭通知) 1、确保启动activity时[request(attributes:contentState:pushType:)传入pushType参数(.token); 2、获取启动后的activity的推送令牌pushToken,传给服务端用来推送更新activity;(实时活动的pushToken不是消息通知的token,这个是独立出来的) 3、服务端推送的更新内容字段需要和ActivityAttributes的ContentState中定义的动态数据字段对应; 4、设置推送的报头apns-push-type的值为liveactivity; 5、设置推送的报头apns-topic的值为.push-type.liveactivity; 6、正确的推送对应的内容和状态; 7、使用pushTokenUpdates监听pushToken变化,如有变化,就令牌失效,需要将新的令牌传给服务器; 8、当Activity结束时,服务器端的pushToken将失效; { "aps": { "timestamp": 1685952000, "event": "update", "content-state": { "currentHealthLevel": 0.0, "eventDescription": "Power Panda has been knocked down!" }, "alert": { "title": "Power Panda is knocked down!", "body": "Use a potion to heal Power Panda!", "sound": "default" } } } 注意: 1、不用为推送提供声音 , 如果推送延迟,在activity结束后收到时将被忽略,avtivity每小时有通知预算(数量未明确),超出后系统将关闭通知; 2、实时活动的pushToken不是消息通知的token,这个token上报到JDPush服务,需要单独管理和归类。 备注: 灵动岛的实时信息要有明确的开始和结束时间点 当一个实时信息持续超过 8 小时,系统会从灵动岛移除这个 App 的信息 当一个实时活动结束时,灵动岛上的展示信息也会立即被系统移除 避免在灵动岛上显示广告,毕竟引起用户反感可以被直接关闭 App 要能够响应灵动岛的点击信息,跳转到 App 中的正确子页面,而不是停留在 App 的首页 运用场景 1、需在屏幕驻留的文字、图像为主的信息:如地图导航、airdrop 传输情况等; 2、后台进行的音频类:如接电话、放音乐、录音、倒计时等; 3、即时交互反馈:如充电、静音、人脸识别等。超过这三类信息后,桌面可能会变得杂乱无章 参考文章 ActivityKit官方文档 https://developer.apple.com/videos/play/wwdc2023/10194 https://developer.apple.com/videos/play/wwdc2023/10184 https://www.jianshu.com/p/f410eba6c392 https://www.bilibili.com/read/cv18549307/ 作者:京东零售李艳敏 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

IPSec VPN原理介绍 | 京东物流技术团队

背景: 什么是VPN?他是干什么用的?有什么优势?解决我们什么问题? 1 VPN的概念 VPN定义 Virtual Private Network,中文名虚拟专用网络,意思是在公用网络上仿真建立一条点到点的专用网络,进行加密通讯,解决远程访问(个人和分支机构到总部)的问题。 要理解VPN,我们需要先弄了解一个概念——隧道协议,其实质是用一种协议来传输另一种协议,其基本功能是封装和加密。我们给大家列举几个隧道协议:GRE、IPSec、SSL/TLS、VPN(WebVPN)、PPTP、L2TP。 VPN解决的问题 VPN是企业分支机构、末端网络以及个人通告公共网络访问内部私网的一个解决方案。公网上存在的问题既是VPN需要面对和解决的问题。 广域网存在的隐患: 网上传输的数据有被窃听的风险; 网上传输的数据有被篡改的风险; 通信双方可能被冒充; VPN如何保护网络实体间的通信: 通过加密技术防止数据被窃听——数据的私密性; 通过哈希技术防止数据被篡改——数据的完整性; 通过认证机制确认身份,防止数据被截获、重传——数据的源认知; 通过增加序列号机制,防止数据的重放攻击——防重放攻击; VPN的优势 VPN作为一项成熟的技术,广泛应用于组织总部和分支机构之间的组网互联,其利用组织已有的互联网出口,虚拟出一条“专线”,将组织的分支机构和总部连接起来,组成一个大的局域网。 相比于传统专线,vpn具有安全、成本低、可靠、构建灵活等特点。 VPN的框架 VPN的两种框架: site-to-site VPN,也叫LAN-to-LAN。 remote-access VPN,即拨号VPN,一般通过软件进行拨号。 2 IPSec VPN 2.1 引入IPSec IP Security,IP层安全。工作在网络层,针对IP包提供如下功能:私密性、完整性、源认证和防重放攻击。 IPSec是一个开放的标准,与具体的算法没有关联。很多个RFC共同定义IPSec。 2.2 IPSec私密性保护 IPSec通过加密技术实现数据的私密性,加密就是把数据的明文格式通过具体的算法变成无法理解的密文格式。 加密算法的发展: 古典加密算法(算法都是保密不公开的,古典加密算法就是在研究各种算法) 现代加密算法:现代加密学的所有算法都是公开的,但是现代加密算法加入了一个key,主要在研究key,现代加密算法都是通过异或运算与数据难题在设计 现代加密算法分类: 对称加密学:加密解密使用相同的key,典型的对称算法:DES,3DES,AES 非对称加密学:又叫公共密钥系统,每种算法存在2个key:public key和private key。两个key都可以用来加密数据,但是解密必须非对称,公钥加密私钥解密,私钥加密公钥解密。典型的公共密钥算法有RSA(DSA)和DH。 对称加密算法的缺陷: 密钥的分发问题; key的数量与参与者的数量呈正比,密钥管理困难 对称加密算法的优点: 算法快,不需要消耗很多资源; 明文密文几乎等长,不需要浪费网络带宽 非对称加密算法缺点: 算法需要很长时间进行加解密,不可能通告非对称算法实现传输数据的加密; 算法冗长,密文远远大于明文; 非对称加密算法的优点: 非常安全,不可能被破解,非对称算法都是基于现有的属性南通设计的; 可用来支撑数字签名; 现有安全模型的操作规范: 实体间交换公钥 发送方通过公钥加密对称算法的key,得出密文,这个密文只有私钥持有者可以解密 接收方通过私钥解密密文,得到对称算法的key 通过这个key运行对称算法 2.3 IPSec的数据完整性保护 数据完整性指发送方到接收方的整个过程数据没有发生任何变化。IPSec通过哈希技术实现完整性校验,哈希是数据的指纹算法。 哈希的特征: 不可逆(哈希的结果不可能反推明文) 等长(不同的哈希算法,对不同大小的数据,得到哈希结果总是相同的) 雪崩(微小的变化会引起完全不一样的结果) 开销少 介绍两种哈希算法: MD5:哈希结果128bit; SHA:哈希结果256bit; 2.4 IPSec的数据源认证 源认证是用来对数据发送方进行合法性校验的方法。IPSec提供两种方式实现源认证: HMAC:在MD5的算法中,加入一个变量key,只有key相同才能导致MD5结果相同,通过这种方式可实现数据的源认证。IGP的认证中,都是HMAC; 数字签名:指发送方通过自己的私钥对数据的指纹进行加密,得出加密后的哈希,这个东西就是数据签名,数字签名只能使用发送方的公钥进行解密,这样发送方无法抵赖(最严谨的源认证)。 注意:在整个安全模型中,如果使用到私钥在进行加密,肯定是出现了数字签名 2.5 IPSec框架 前面提到,IPSec不是一个特定协议,而是一组操作流程,有多个组件构成: 封装协议(AH,ESP) 加密算法(RSA,DH,DES,3DES,AES) 认证协议(MD5,SHA) ESP封装为数据提供了如下功能:私密性、完整性、源认证和防重放攻击。 概念介绍:SA:Security Association,安全关联是指一组用来保护信息的策略和密钥。安全关联的概念是IPSec的基础。所有AH和ESP的实现都必须支持安全关联。 安全关联的两种模式:transport mode和tunnel mode。通过两种设备的位置,可以判断当前网络模式应该使用哪种封装模式: 通讯点设备:真正的数据发起和接收设备。 加密点设备:IPSec实施设备,可以是路由器、防火墙等。 transport mode:通讯点即为加密点,可以试试传输模式,有两种场景会使用:GRE over IPSec、内网设备间部署IPSec tunnel mode:通讯点不等于加密点一定使用隧道模式。因为通讯点位于网络内部,发出的数据包是私网地址,不可全局路由,所以必须实施新的IP头封装,让数据包全局可路由。 3 IPSec工作流程步骤 3.1 整体工作流程 流量触发IPSec; IKE阶段1,在VPN设备间协商IKE的安全策略,建立一个安全的channel——控制层面; IKE阶段2,在VPN设备间通过安全的channel去协商IPSec的策略,用来保护数据;——数据层面; 通过对感兴趣流设施安全保护,来转发数据; 隧道终结。 VPN设备对感兴趣流量的匹配:设备接口下存在一个map,用来定义感兴趣流的,如果数据撞上map则需要应用IPSec保护,否则bypass 概念穿插: IKE:internet KEY Exchange,因特网密钥交换,目前使用IKEv1版本,包括如下内容: ISAKMP:因特网安全管理和密钥管理协议,端口号500; OAKLEY:用来定义IKE的密钥交换方式,当前的定义是使用DH实现。 SKEME:用来定义IKE职场的加密算法。 IKE的两种模式:main mode(主模式)和积极模式(用于拨号vpn) IKE主模式操作过程: IKE协商——构建控制层面; IPSec协商——协商数据层面; 两个阶段需要进行9个包交换,第一个阶段6个包,3次交换,第二个阶段3个包,两次交换。 3.2 IKE阶段1 主要功能介绍: 协商IKE策略(第1,2两个包)——第一次交换; 交换DH组(第3,4两个包)——第二次交换; 验证peer的合法性(第5,6两个包)——第三次交换。 第一次交换:VPN device把本地所有的IKE policy打包,发起ike的proposal IPSec设备会进行策略比较,总是从policy-id小的开始match,如果存在可以match的policy则提议被通过,如果所有的policy无法match,则IKE协商失败,进入第二次交换。 因为加密算法没统一,没有加密key,所以第一次交换过程肯定是明文交换。 第二次交换:交换的是DH组信息,在这个交换过程中,设备不可能把本地的psk进行发送(psk严格本地保留),只是用来交互几个DH的公开值。 因为key还没协商,所有依然是明文交换。 在第二次交换后,VPN设备通过cookie+psk可以推导出三个密钥: SKEIDa:用来通过1,2个包协商出来的加密算法保护5,6包 SKEIDe:用来通过1,2个包交换出来的哈希算法对5,6包进行认证 SKEIDd:这个密钥是在第二个阶段用来衍生IPSec的key,如果这个密钥被攻破,所有IPSec就没有意义 第三次交换:第三次交换的主要功能是用来做peer的身份验证。 第三次交换是在建立了安全的channel下交换的,第五第六个包是加密的,也是被认证的。 在psk的验证中,其实vpn设备只是通过5,6包的源IP地址进行校验。psk的关键作用只是参与DH算法,用来做key衍生,如果psk不同key不同,协商失败。 IKE第一阶段协商结果,即产生IKE SA,也叫isakmp sa 3.2 IKE阶段2 本阶段涉及3个包,两次交换,也叫做快速模式。 快速模式下的所有包都是通过SKEIDa进行加密,SKEIDe进行认证,所有读取报文都是加密的数据。 此过程交换并匹配IPSec的安全参数(转换集),VPN设备把本地的所有转换集打包发送,match的时候与IKE的1,2包交换是相同的,同时只要转换集匹配则通过DH的第三个key-SKEIDd进行IPSec加密算法密钥的推导。 IKE第二阶段协商结果是IPSec sa。 SA的三要素: SPI(安全参数索引),用来描述一个SA,用于IPSec快速匹配,告诉对端通过这个SPI对应的SA对该数据进行解密,让加解密更加高效,占用4byte;对于一个对应的感兴趣流,一端的outbound SPI肯定是对端的inbound SPI(因为数据保护使用的是对称算法,必须保证加解密key相同) 安全协议标识:标识该SA是AH安全关联或ESP安全关联。 IP目的地址:只允许使用单一地址,表示SA的目的地址。 4 扩展话题 SA的切换探讨: SA的主要内容就是对称密钥的key与哈希算法的key,当一个SA使用的越频繁,就代表key越需要更新,SA的切换必须做到不丢包。 IKE在可以超时前就会重新推算新的SA,防止切换瞬间带来的丢包。 所有的IPSec SA都是通过IKE的SKEIDd在推算,如果这个SKEIDd被曝光,会导致所有的IPSec SA全部可推算 PFS(完美向前保护): 因为默认的IPsec key间存在互相推导关系,导致不够安全,PFS强制每一次重新计算SA需要重新通过DH推导SKEIDd。 RRI(反向路由注入): 如果策略1能够成功的协商SA,则往本地路由表注入一条远端通讯点的静态路由 DPD(dead peer detection): 如果对端失效,本端无法检测,导致数据层面转发黑洞,解决方案是必须让本端可以检测到对端失效,同时删除与对端的SA,重新寻找peer去建立SA DMVPN和NHRP(可自行了解) 作者:京东物流 陈旭辉 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

浅谈幂等设计 | 京东云技术团队

1 幂等性 一句话,幂等就是一个执行操作,无论执行多少次,产生的效果和返回的结果都是一样的。 2 为什么要实现幂等性? 如今随着互联网技术快速发展,业务越来越复杂,系统的高并发和关键数据的场景越来越多。 在分布式系统中,机器宕机和消息丢失也是需要重点关注的问题,其中的一个典型就是幂等性问题。 想想看,一个对外暴露的接口会面领很多次请求,如果不能保证幂等性会带来什么样的后果? 微信进行一次扣款操作,应该只扣用户一次钱,当遇到网络故障或系统bug,如果没有实现幂等性扣多了你会不会直接“C语言”投诉? 当然,有些接口是天然保证幂等性的,比如查询操作、删除操作。有些对数据的修改是一个常量,无其他操作,也是具有幂等性的。修改操作可能幂等可能不幂等。 SELECT col1 FROM tab1 WHERE col2 = 2UPDATE tab1 SET col1 = 1 WHERE col2 = 2UPDATE tab1 SET col1 = col1 + 1 WHERE col2 = 2 这三个sql只有第三个不是幂等的。 POST请求天生就不是一个幂等操作,每次调用都会在系统中产生新的资源,想要幂等就必须在业务中实现。 需要避免的是,幂等性和并发安全不是一回事。当同一笔订单即使你不停的提交支付,如果扣了不止一次钱,就说明该操作不幂等。 而有多笔订单同时进行支付,最后扣除的金额不是这么多笔金额的总和,说明该操作有并发安全问题。这是两个维度的问题,应该分开讨论解决。 3 如何实现幂等性? (1)数据库防重 利用数据表唯一索引的特性,当并发时新增报错时,再查询一次,数据已经存在,就避免了脏数据的新增。但注意,不要将uuid作为索引字段,其大小和类型对于索引而言都会导致速度非常慢。 常见的场景,比如博客/微博系统点赞,一个用户对一个微博点赞,就把用户id与该博文id绑定,后续该用户再对该博文点赞就无法插入。再比如金融账户,可以通过在账户表中增加唯一索引来存储用户id,即使重复操作一个用户也只能拥有一个账户。 (2)token令牌机制 token机制是适用范围最广泛的一种幂等设计。虽然实现方式有很多种,但核心思想就是每次操作都生成一个唯一token凭证,服务器通过这个唯一凭证确保同样的操作不会被执行多次。 具体可以分为两个阶段,获取token和使用token。每次接口请求前先获取一个token,然后在下次请求时在请求的header体中加上这个token,后端进行校验,如果验证通过则删除token,下次请求再次判断token。如果在redis缓存的帮助下,流程图如下: (3)分布式锁 数据库防重表可以通过分布式锁代替,相比去重表,将放并发做到了缓存中,效率更高。局限性都是同一时间只能完成一次请求。 比如某些业务处理流程很长,要求不能并发执行,可以在流程执行之前根据某个标志(用户ID+后缀等)获取分布式锁,其他流程执行时获取锁就会失败,也就是同一时间该流程只能有一个能执行成功,执行完成后,释放分布式锁。 4 幂等的优缺点 优点: 业务需要 缺点: (1)客户端处理逻辑得以简化,但服务端控制幂等逻辑变得更加复杂; (2)把并发执行变成改为串行执行,降低了执行效率。 5 扩展 分布式自增ID可以借鉴Snowflake算法,优点是高性能、低延迟、按时间有序;缺点是需要独立的开发和部署。 其结构如下: 最高位是符号位,始终为0,不可用。 41位的时间序列,精确到毫秒级,41位的长度可以使用 (1L << 41) / (1000L * 60 * 60 * 24 * 365) = 69年。时间位还有一个很重要的作用是可以根据时间进行排序。注意,41位时间截不是存储当前时间的时间截,而是存储时间截的差值(当前时间截 - 开始时间截) 后得到的值,这里的的开始时间截,一般是我们的id生成器开始使用的时间,由我们程序来指定的。 10位的机器标识,10位的长度最多支持部署1024个节点。 12位的计数序列号,序列号即一系列的自增id,可以支持同一节点同一毫秒生成多个ID序号,12位的计数序列号支持每个节点每毫秒产生4096个ID序号。 加起来刚好64位,为一个Long型。这个算法很简洁,但依旧是一个很好的ID生成策略。 参考文献: [1] 分布式系统互斥性与幂等性问题的分析与解决 https://zhuanlan.zhihu.com/p/22820761 [2] 高并发下接口幂等性解决方案 https://blog.csdn.net/u011635492/article/details/81058153 [3] 幂等性问题和解决方法 https://blog.csdn.net/qq_32020035/article/details/105448889 [4] 雪花算法 https://www.cnblogs.com/grasp/p/12309726.html [5] 聊聊开发中幂等问题 https://segmentfault.com/a/1190000018808510 作者:京东零售 李泽阳 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

浅析Java - SPI机制 | 京东云技术团队

SPI是什么 SPI全称Service Provider Interface,是Java提供的一套用来被第三方实现或者扩展的API,它可以用来启用框架扩展和替换组件。 整体机制如下图 Java SPI 实际上是“基于接口的编程+策略模式+配置文件”组合实现的动态加载机制。 使用场景 适用于:调用者根据实际使用需要,启用、扩展、或者替换框架的实现策略 比较常见的例子: 数据库驱动加载接口实现类的加载,JDBC加载不同类型数据库的驱动 日志门面接口实现类加载,SLF4J加载不同提供商的日志实现类 Spring中大量使用了SPI,比如:对servlet3.0规范对ServletContainerInitializer的实现、自动类型转换Type Conversion SPI(Converter SPI、Formatter SPI)等 Dubbo中也大量使用SPI的方式实现框架的扩展, 不过它对Java提供的原生SPI做了封装,允许用户扩展实现Filter接口 使用介绍 要使用Java SPI,需要遵循如下约定: 当服务提供者提供了接口的一种具体实现后,在jar包的META-INF/services目录下创建一个以“接口全限定名”为命名的文件,内容为实现类的全限定名; 接口实现类所在的jar包放在主程序的classpath中; 主程序通过java.util.ServiceLoder动态装载实现模块,它通过扫描META-INF/services目录下的配置文件找到实现类的全限定名,把类加载到JVM; SPI的实现类必须携带一个不带参数的构造方法; 总结 优点:使用Java SPI机制的优势是实现解耦,使得第三方服务模块的装配控制的逻辑与调用者的业务代码分离,而不是耦合在一起。应用程序可以根据实际业务情况启用框架扩展或替换框架组件。 缺点: 虽然ServiceLoader也算是使用的延迟加载,但是基本只能通过遍历全部获取,也就是接口的实现类全部加载并实例化一遍。如果你并不想用某些实现类,它也被加载并实例化了,这就造成了浪费。获取某个实现类的方式不够灵活,只能通过Iterator形式获取,不能根据某个参数来获取对应的实现类。 多个并发多线程使用ServiceLoader类的实例是不安全的。 作者:京东零售 曹志飞 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

Elasticsearch Mapping类型修改 | 京东云技术团队

背景 通常数据库进行分库分表后,目前比较常规的作法,是通过将数据异构到Elasticsearch来提供分页列表查询服务;在创建Elasticsearch索引时,基本都是会参考目前的业务需求、关系数据库中的类型以及对数据的相关规划来定义相关字段mapping的类型. 在Elasticsearch的mapping中的列(或则叫属性),有几个比较重要的参数(更多参数参考官方文档) 列类型:type 指定了该列的数据类型,常用的有text,keyword,date,long,double,boolean以及object和nested,不同的类型也有对应的不同查询方式,创建之后是不能修改的; 是否可索引:index 该index选项控制字段值是否被索引。它接受trueorfalse,并且默认为true. 未索引的字段不可查询,当然也不能做为排序字段。 但是在实际的开发过程中,又会有需求对现有的mapping的type进行修改(类似对MySQL数据表的字段进行DDL操作)的诉求。比如商品上的价格price字段,按原来的业务分析,只需要提供数据返回即可,在创建索引时类型定义了keyword了,并且index设置成了false,这时我们需要根据价格的范围查询或则进行排序操作,就希望对mapping进行调整,将类型修改成数字类型,索引也需要加上;今天针对Elasticsearch的Mapping类型进行修改,讨论几个可行的方案 方案1:运用reindex 遇到问题第一时间,我们应该是查询官方文档是否有相关的操作说明,在官方文档中,确实还能找到对已有mapping更新的相关apiput-mapping,通过这个文档,很快可以找到文档中对修改已有mapping的列的方式(参考官方文档),同时也提到的通过reindex的方式来修改已有类型的方式; 除了支持的mapping parameters外,您不能更改现有字段的映射或字段类型。更改现有字段可能会使已编制索引的数据无效。如果您需要更改字段的映射,请使用正确的映射创建一个新索引并将您的数据重新索引reindex到该索引中。 如原来索引的mapping如下 PUT /users { "mappings" : { "properties": { "user_id": { "type": "long" } } } } //加一了两条数据 POST /users/_doc?refresh=wait_for { "user_id" : 12345 } POST /users/_doc?refresh=wait_for { "user_id" : 12346 } 这时想修改user_id的类型为keyword,我们直接是修改不了的。 //尝试直接修改type,行不通,会报错 PUT /users/_mapping { "properties": { "user_id": { "type": "keyword" } } } //报错信息 { "error": { "root_cause": [ { "type": "illegal_argument_exception", "reason": "mapper [user_id] of different type, current_type [long], merged_type [keyword]" } ], "type": "illegal_argument_exception", "reason": "mapper [user_id] of different type, current_type [long], merged_type [keyword]" }, "status": 400 } 按官方文档说的reindex重新索引可按以下步骤操作 操作步骤 第一步:创建新的索引new_users将user_id的类型定义成keyword PUT /new_users { "mappings" : { "properties": { "user_id": { "type": "keyword" } } } } 第二步:将原user索引标记为只读 控制我们的应用系统,数据停写不再向老索引中写数据,并且最好对老索引进行只读操作设置,保证在reindex的过程中,不要生产新数据,导致新老索数据不一致; //设置索引为读写的 PUT /users/_settings { "settings": { "index.blocks.write": true } } 第三步:将原user索引中的数据迁移到new_users中 POST /_reindex { "source": { "index": "users" }, "dest": { "index": "new_users" } } reindex还有很多的参数可以配置,包括从远程的一个集群迁移数据都是可以的,详细可参考:Reindex API 如果新的索引的mapping的定义与原索引的定义有差异的,会按新索引定义的dynamic规则进行数据的迁移,具体的,可以参考:dynamic 该dynamic设置控制是否可以动态添加新字段。它接受三种设置: 值 说明 true 新检测到的字段被添加到映射中。(默认); 新增的数据类型的规则,可以参考:dynamic-mapping false 忽略新检测到的字段。这些字段不会被编入索引,因此将无法搜索,但仍会出现在_source返回的命中字段中。这些字段不会添加到映射中,必须明确添加新字段。 strict 如果检测到新字段,则会抛出异常并拒绝文档。必须将新字段显式添加到映射中。 同时将原user索引标记为可读写 //设置索引为可读写 PUT /users/_settings { "settings": { "index.blocks.write": false } } 第四步:切换到使用新的mapping 可以将应用系统中的配置改成新索引 也可以通过索引的别名的方式为新索引增加原来老索引的别名来操作,为索引增加别名参考文档:Add index alias API,在增加别名前,需要删除原来的老索引; //为索引增加别名 基本格式 PUT /<index>/_alias/<alias> POST /<index>/_alias/<alias> //为new_users索引增加别名users PUT /new_users/_alias/users //没有删除老索引前,是增加不了别名的,需要先删除老别名 { "error": { "root_cause": [ { "type": "invalid_alias_name_exception", "reason": "Invalid alias name [users], an index exists with the same name as the alias", "index_uuid": "8Rbq_32BTHC4CoO_CqWdXA", "index": "users" } ], "type": "invalid_alias_name_exception", "reason": "Invalid alias name [users], an index exists with the same name as the alias", "index_uuid": "8Rbq_32BTHC4CoO_CqWdXA", "index": "users" }, "status": 400 } 方案优劣分析 【优点】操作简单,官方方案 该方案,不需要对原索引做操作,在线即可进行,并且操作步骤也简单;也是官方文档提供的方案。 【缺点】数据量大迁移耗时长 当数据最大时,这个数据迁移会比较耗时 结论 当数据量小时,并且希望mapping比较规整好看,该方案是比较推荐的。当数据量大时,可能该方案在数据迁移过程中会比较耗时,需要评估是否可行; 方案2:运用multi-fields 为不同的目的以不同的方式索引同一个字段通常很有用。这就是multi-fields的目的。例如,一个string字段可以映射为text用于全文搜索的字段,也可以映射keyword为用于排序或聚合的字段; 在这个方案中,应用的是mapping参数fields来对同一个列,定义多种数据类型;详细[【官方文档】multi-fields] (https://www.elastic.co/guide/en/elasticsearch/reference/7.5/multi-fields.html) 操作步骤 第一步:为列增加fields属性 还是以上面的users这个索引为例,我们还是想将user_id的类型定义成keyword; PUT /users/_mapping { "properties":{ "user_id":{ "type":"long", "fields":{ "raw":{ "type":"keyword" } } } } } 操作完成后,在users的user_id列下,就会多出一个raw的子属性;在我们正常写数据user_id时,会自动生成这两个索引,一个是long类型的user_id,以及keyword类型的user_id.raw(注意这里有个点,跟子对象访问方式一样); 在put mapping时,type参数必需给,并且需要跟原来的类型一致,fields中新定义的子属性可以多个; 【可选】第二步:历史数据更新 针对历史数据需要处理,可以借助_update_by_query来更新数据,只需要将原来的索引再写一次,即可将新加的字段写入数据。 POST /users/_update_by_query { "query":{ "exists":{ "field":"user_id" } }, "script":{ "source":"ctx._source.user_id=ctx._source.user_id ", "lang":"painless" } } // query 部分为需要更新数据过滤条件,可根据业务规则写 // script 更数据的逻辑,这个基本可以不改 方案优劣分析 【优点】不影响原索引,同一列可以定义多种类型 通过这方式不会影响原来的索引数据,可以不用修改现在的应用程序的读写方式,对应用程序一切按原来逻辑执行,对应用方无感知,非常优化。只需要有使用新类型的场景使用即可,可以说影响是最小的; 同时只是做了一个定义,执行速度是非常快的,对Elasticsearch服务基本不会有太大影响;并且对于同一个列可以定义多个类型,比如商品名称,在多国多语言环境下可以根据不同语言定义多个列,对应使用不同的分词器; 【缺点】老数据不会自动创建子索引,多出额外的存储 老数据不会自动创建索引,因为需要多出新的索引来,会增加额外的存储; 结论 1、需要对多一列创建多个索引类型时,是一个非常推荐的方案; 2、对于新索引,只有新业务使用,对老数据没有诉求的,也非常推荐该方案; 方案3:运用copy_to copy_to是将多个字段的值,合并到一个字段中,便于搜索。但是也可以实现一个字段存在多个类型的需求。详细参考【官方文档】copy_to 操作步骤 还是用上面的users这个索引为例,为user_id创建一个copy列:user_id_raw类型定义成keyword PUT /users/_mapping { "properties":{ "user_id_raw":{ "type":"keyword", "copy_to":"user_id" } } } 这个方案与方案2:multi-fields基本是一样的,只是创建列的方式不同,优缺点都一样; 参考资料 [1]【官方文档】Mapping parameters [2]【官方文档】Mapping Field datatypes [3] [【官方文档】multi-fields] (https://www.elastic.co/guide/en/elasticsearch/reference/7.5/multi-fields.html) [4]Elasticsearch Rename Index [5]elasticSearch7.x—mapping中的fields属性||copy_to配置(同一个字段两种类型) [6]《Elasticsearch:权威指南》Mapping -- Mapping parameters -- fields(multi-fields) 作者:京东零售 周德东 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

商品推荐系统浅析 | 京东云技术团队

一、综述 本文主要做推荐系统浅析,主要介绍推荐系统的定义,推荐系统的基础框架,简单介绍设计推荐的相关方法以及架构。适用于部分对推荐系统感兴趣的同学以及有相关基础的同学,本人水平有限,欢迎大家指正。 二、商品推荐系统 2.1 推荐系统的定义 推荐系统本质上还是解决信息过载的问题,帮助用户找到他们感兴趣的物品,深度挖掘用户潜在的兴趣。 2.2 推荐架构 其实推荐系统的核心流程只有召回、排序、重排。 请求流程 当一个用户打开一个页面,这个时候前端会携带用户信息(pin或者uuid等)去请求后台接口(通过color间接调用),当后台收到请求后一般会先根据用户标识进行分流获取相关策略配置(ab策略),这些策略去决定接下来会调用召回模块、排序模块以及重排模块的哪个接口。一般召回模块分多路召回,每路召回负责召回多个商品,排序和重排负责调整这些商品的顺序。最后挑选出合适的商品并进行价格、图片等相关信息补充展现给用户。用户会根据自己是否感兴趣选择点击或者不点击,这些涉及用户的行为会通过日志上报到数据平台,为之后效果分析和利用用户行为推荐商品奠定基础。 其实有些问题想说一说: 为什么要采取召回、排序、重排这种漏斗分层架构? (1)从性能方面 终极:从百万级的商品库筛选出用户感兴趣的个位数级别的商品。 复杂的排序模型线上推断耗时严重,需要严格控制进入排序模型的商品数量。需要进行拆解 (2)从目标方面 召回模块:召回模块的任务是快速从大量的物品中筛选出一部分候选物品,目的是不要漏掉用户可能会喜欢的物品。召回模块通常采用多路召回,使用一些简化的特征或模型。 排序模块:排序模块的任务是精准排序,根据用户的历史行为、兴趣、偏好等信息,对召回模块筛选出的候选物品进行排序。排序模块通常使用一些复杂的模型。 重排模块:重排模块的任务是对排序模块的结果进行二次排序或调整,以进一步提高推荐的准确性和个性化程度。重排模块通常使用一些简单而有效的算法。 什么是ab实验? 参考论文:Overlapping Experiment Infrastructure: More, Better, Faster Experimentation(google2010) 只有在线实验才能真正评估模型优劣,ab实验可以快速验证实验的效果,快速迭代模型。减少上线新功能的风险。 ab算法:Hash(uuid+实验id+创建时间戳)%100 特性:分流+正交 2.3召回 召回层的存在仅仅是为用户从广阔的商品池子中初筛出一批还不错的商品。为了平衡计算速度与召回率(正样本占全部正样本的比例)指标之间的矛盾,采用多路召回策略,每路召回策略只考虑其中的单一特征或策略。 2.3.1多路召回的优劣 多路召回:采用不同的策略、特征或者简单模型分别召回一部分候选集,然后把候选集混合在一起供排序使用。召回率高,速度快,多路召回相互补充。 多路召回中每路召回的截断个数K是个超参数,需要人工调参,成本高;召回通路存在重合问题,冗余。 是否存在一种召回可以替代多路召回,向量召回应用而生,就目前而言,仍然是以向量召回为主,其他召回为辅的架构。 2.3.2召回分类 主要分为非个性化召回,个性化召回两大类。非个性化召回主要是进行热点推送,推荐领域马太效应严重,20%的商品贡献80%的点击。个性化召回主要是发掘用户感兴趣的商品,着重处理每个用户的差异点,提高商品的多样性,保持用户的粘性。 非个性化召回 (1) 热门召回 近7天高点击、高点赞、高销量商品召回 (2)新品召回 最新上架的商品召回 个性化召回 (1)标签召回、地域召回 标签召回:用户感兴趣的品类、品牌、店铺召回等 地域召回:根据用户的地域召回地域内的优质商品。 (2)cf召回 协同过滤算法是基于用户行为数据挖掘用户的行为偏好,从而根据用户的行为偏好为其推荐物品,其根据的是用户和物品的行为矩阵(共现矩阵)。用户行为一般包括浏览、点赞、加购、点击、关注、分享等等。 协同过滤分为三大类:基于用户的协同过滤(UCF)和基于物品的协同过滤(ICF)和基于模型的协同过滤(隐语义模型)。是否为用户推荐某个物品,首先要把用户和物品进行关联,而进行关联的点是另一个物品还是另一个用户,决定了这属于哪个类型的协同过滤。而基于隐语义模型是根据用户行为数据进行自动聚类挖掘用户的潜在兴趣特征。从而通过潜在兴趣特征对用户和物品进行关联。 基于物品的协同过滤(ICF):判断是否为用户推荐某个物品,首先根据用户历史行为记录的物品和这个物品的相似关系来推断用户对这个物品的兴趣度,从而判断我们是否推荐这个物品。整个协同过滤过程主要分为以下几步:计算物品之间的相似度,计算用户对物品的兴趣度,排序截取结果。 商品相似度计算: 衡量相似度主要有以下几种方式:夹角余弦距离,杰卡德公式。由于用户或物品的表示方式的多样性,使得这些相似度的计算非常灵活。我们可以利用用户和物品的行为矩阵来去计算相似度,也可以根据用户行为、物品属性和上下文关系构造用户和物品的向量表示去计算相似性。 夹角余弦距离公式: cos⁡θ=(x1*x2+y1*y2)/(√(x12+y12 )*√(x22+y22 )) 杰卡德公式J(A,B)=(|A⋂B|)/(|A⋃B|) 商品a 商品b 商品c 商品d 用户A 1 0 0 1 用户B 0 1 1 0 用户C 1 0 1 1 用户D 1 1 0 0 夹角余弦距离公式计算商品a和b的相似度: Wab=(1*0+0*1+1*0+1*1)/(√(1^2+0^2+1^2+1^2 )*√(0^2+1^2+0^2+1^2 ))=1/√6 spark实现ICF:https://zhuanlan.zhihu.com/p/413159725 问题:冷启动问题,长尾效应。 (3)向量召回 向量化召回:通过学习用户与物品低维向量化表征,将召回建模成向量空间内的近邻搜索问题,有效提升了召回的泛化能力与多样性,是推荐引擎的核心召回通道。 向量:万物皆可向量化,Embedding就是用一个低维稠密的向量表示一个对象(词语或者商品),主要作用是将稀疏向量转换成稠密向量(降维的效果),这里的表示蕴含着一定的深意,使其能够表达出对象的一部分特征,同时向量之间的距离反映对象之间的相似性。 向量召回步骤:离线训练生成向量,在线向量检索。 1.离线训练生成向量 word2vec:词向量的鼻祖,由三层神经网络:输入层,隐藏层,输出层,隐藏层没有激活函数,输出层用了softmax计算概率。 目标函数 网络结构: 总的来说:输入是词语的序列,经过模型训练可以得到每个词语对应的向量。应用在推荐领域就是输入是用户的点击序列,经过模型训练得到每个商品的向量。 优劣:简单高效,但是只考虑了行为序列,没有考虑其他特征。 双塔模型: 网络结构:分别称为User塔和物品塔;其中User塔接收用户侧特征作为输入比如用户id、性别、年龄、感兴趣的三级品类、用户点击序列、用户地址等;Item塔接受商品侧特征,比如商品id、类目id、价格、近三天订单量等。数据训练:(正样本数据,1)(负样本,0)正样本:点击的商品,负样本:全局随机商品样本(或者同批次其他用户点击样本) 优劣:高效,完美契合召回特性,在线请求得到用户向量,检索召回item向量,泛化性高;用户塔和item塔割裂,只在最后做了交互。 2.在线向量检索 向量检索:是一种基于向量空间模型(Vector Space Model)的信息检索方法,用于在大规模文本集合中快速查找与查询向量最相似的文档向量。在信息检索、推荐系统、文本分类中得到广泛应用。 向量检索的过程是计算向量之间的相似度,最后返回相似度较高的TopK向量返回,而向量相似度计算有多种方式。计算向量相似性得方式有欧式距离、内积、余弦距离。归一化后,内积与余弦相似度计算公式等价。 向量检索的本质是近似近邻搜索(ANNS),尽可能减小查询向量的搜索范围,从而提高查询速度。 目前在工业界被大规模用到的向量检索算法基本可以分为以下3类: 局部敏感性哈希(LSH) 基于图(HNSW) 基于乘积量化 简单介绍LSH LSH算法的核心思想是:将原始数据空间中的两个相邻数据点通过相同的映射或投影变换后,这两个数据点在新的数据空间中仍然相邻的概率很大,而不相邻的数据点被映射到同一个桶的概率很小。 相比于暴力搜索遍历数据集中的所有点,而使用哈希,我们首先找到查询样本落入在哪个桶中,如果空间的划分是在我们想要的相似性度量下进行分割的,则查询样本的最近邻将极有可能落在查询样本的桶中,如此我们只需要在当前的桶中遍历比较,而不用在所有的数据集中进行遍历。当哈希函数数目H取得太大,查询样本与其对应的最近邻落入同一个桶中的可能性会变得很微弱,针对这个问题,我们可以重复这个过程L次(每一次都是不同得哈希函数),从而增加最近邻的召回率。 案例:基于word2vec实现向量召回 2.4排序 推荐系统的掌上明珠 排序阶段分为粗排和精排,粗排一般出现在在召回结果的数据量级比较大的时候。 进化历程 简单介绍Wide&Deep 背景:手动特征组合实现记忆性效果不错但是特征工程太耗费人力,并且未曾出现的特征组合无法记忆,不能进行泛化。 目的:使模型同时兼顾泛化和记忆能力(有效的利用历史信息并具有强大的表达能力)​ (1)记忆能力 模型直接学习并利用历史数据中物品或者特征共现频率的能力,记忆历史数据的分布特点,简单模型容易发现数据中对结果影响较大的特征或者组合特征,调整其权重实现对强特征的记忆 (2)泛化能力 模型传递特征的相关性,以及发掘稀疏或者从未出现过的稀有特征和最终标签相关性的能力,即使是非常稀疏的特征向量输入也能得到稳定平滑的推荐概率。提高泛化性的例子:矩阵分解,神经网络 兼顾记忆和泛化能力 (结果的准确性和扩展性) wide部分专注模型记忆,快速处理大量历史行为特征,deep部分专注模型泛化,探索新世界,模型传递特征的相关性,发掘稀疏甚至从外出现过的稀有特征与最终标签的相关性的能力,具有强大的表达能力。最终将wide部分和deep部分结合起来,形成统一的模型。 wide部分就是基础的线性模型,表示为y=W^T X+b X特征部分包括基础特征和交叉特征。交叉特征在wide部分很重要,可以捕捉到特征间的交互,起到添加非线性的作用。 deep部分为embeding层+三层神经网络(relu),前馈公式 联合训练 优劣:为推荐/广告/搜索排序算法之后的发展奠定了重要基础,从传统算法跨越到深度学习算法,里程碑意义。兼顾记忆和泛化能力但是Wide侧仍需要手工组合特征。 参考论文:Wide & Deep Learning for Recommender Systems 2.5 重排 定义:对精排后的结果顺序进行微调,一方面实现全局最优、一方面满足业务诉求提升用户体验。比如打散策略,强插策略,提高曝光,敏感过滤 MMR算法 实现商品多样性问题​ 目的:在推荐结果准确性的同时保证推荐结果的多样性,为了平衡推荐结果的多样性和相关性​ 算法原理,如公式​ D:商品集合,Q:用户,S:已被选中的商品集合, R\S:R中未被选中的商品集合​ def MMR(itemScoreDict, similarityMatrix, lambdaConstant=0.5, topN=20): #s 排序后列表 r 候选项 s, r = [], list(itemScoreDict.keys()) while len(r) > 0: score = 0 selectOne = None # 遍历所有剩余项 for i in r: firstPart = itemScoreDict[i] # 计算候选项与"已选项目"集合的最大相似度 secondPart = 0 for j in s: sim2 = similarityMatrix[i][j] if sim2 > second_part: secondPart = sim2 equationScore = lambdaConstant * (firstPart - (1 - lambdaConstant) * secondPart) if equationScore > score: score = equationScore selectOne = i if selectOne == None: selectOne = i # 添加新的候选项到结果集r,同时从s中删除 r.remove(selectOne) s.append(selectOne) return (s, s[:topN])[topN > len(s)] 意义是选择一个与用户最相关的同时跟已选择物品最不相关的物品。时间复杂度O(n2) 可以通过限制选择的个数进行降低时间复杂度​ 工程实现:需要用户和物品的相关性和物品之间的相似性作为输入,用户和物品的相关性可以用排序模型的结果作为代替,物品之间的相似性可以通过协同过滤等算法得到商品向量,计算余弦距离。也可以简单得是否同一三级类目、同一店铺等表征​ 三、总结 就简单唠叨这么多啦,主要想让大家了解一下推荐系统,向大家介绍一下整个推荐架构,以及整个推荐都有哪些模块。由于本人水平有限,每个模块也没有讲的特别细,希望之后能在工作中继续学习这个领域,深挖细节,产出更好的东西呈现给大家。感谢!!! 作者:京东零售 闫先东 来源:京东云开发者社区

优秀的个人博客,低调大师

并发编程-CompletableFuture解析 | 京东物流技术团队

1、CompletableFuture介绍 CompletableFuture对象是JDK1.8版本新引入的类,这个类实现了两个接口,一个是Future接口,一个是CompletionStage接口。 CompletionStage接口是JDK1.8版本提供的接口,用于异步执行中的阶段处理,CompletionStage定义了一组接口用于在一个阶段执行结束之后,要么继续执行下一个阶段,要么对结果进行转换产生新的结果等,一般来说要执行下一个阶段都需要上一个阶段正常完成,这个类也提供了对异常结果的处理接口 2、CompletableFuture的API 2.1 提交任务 在CompletableFuture中提交任务有以下几种方式: public static CompletableFuture<Void> runAsync(Runnable runnable) public static CompletableFuture<Void> runAsync(Runnable runnable, Executor executor) public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier) public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier, Executor executor) 这四个方法都是用来提交任务的,不同的是supplyAsync提交的任务有返回值,runAsync提交的任务没有返回值。两个接口都有一个重载的方法,第二个入参为指定的线程池,如果不指定,则默认使用ForkJoinPool.commonPool()线程池。在使用的过程中尽量根据不同的业务来指定不同的线程池,方便对不同线程池进行监控,同时避免业务共用线程池相互影响。 2.2 结果转换 2.2.1 thenApply public <U> CompletableFuture<U> thenApply(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn, Executor executor) thenApply这一组函数入参是Function,意思是将上一个CompletableFuture执行结果作为入参,再次进行转换或者计算,重新返回一个新的值。 2.2.2 handle public <U> CompletableFuture<U> handle(BiFunction<? super T, Throwable, ? extends U> fn) public <U> CompletableFuture<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn) public <U> CompletableFuture<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn, Executor executor) handle这一组函数入参是BiFunction,该函数式接口有两个入参一个返回值,意思是处理上一个CompletableFuture的处理结果,同时如果有异常,需要手动处理异常。 2.2.3 thenRun public CompletableFuture<Void> thenRun(Runnable action) public CompletableFuture<Void> thenRunAsync(Runnable action) public CompletableFuture<Void> thenRunAsync(Runnable action, Executor executor) thenRun这一组函数入参是Runnable函数式接口,该接口无需入参和出参,这一组函数是在上一个CompletableFuture任务执行完成后,在执行另外一个接口,不需要上一个任务的结果,也不需要返回值,只需要在上一个任务执行完成后执行即可。 2.2.4 thenAccept public CompletableFuture<Void> thenAccept(Consumer<? super T> action) public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action) public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action, Executor executor) thenAccept这一组函数的入参是Consumer,该函数式接口有一个入参,没有返回值,所以这一组接口的意思是处理上一个CompletableFuture的处理结果,但是不返回结果。 2.2.5 thenAcceptBoth public <U> CompletableFuture<Void> thenAcceptBoth(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action) public <U> CompletableFuture<Void> thenAcceptBothAsync(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action) public <U> CompletableFuture<Void> thenAcceptBothAsync(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action, Executor executor) thenAcceptBoth这一组函数入参包括CompletionStage以及BiConsumer,CompletionStage是JDK1.8新增的接口,在JDK中只有一个实现类:CompletableFuture,所以第一个入参就是CompletableFuture,这一组函数是用来接受两个CompletableFuture的返回值,并将其组合到一起。BiConsumer这个函数式接口有两个入参,并且没有返回值,BiConsumer的第一个入参就是调用方CompletableFuture的执行结果,第二个入参就是thenAcceptBoth接口入参的CompletableFuture的执行结果。所以这一组函数意思是将两个CompletableFuture执行结果合并到一起。 2.2.6 thenCombine public <U,V> CompletableFuture<V> thenCombine(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn, Executor executor) thenCombine这一组函数和thenAcceptBoth类似,入参都包含一个CompletionStage,也就是CompletableFuture对象,意思也是组合两个CompletableFuture的执行结果,不同的是thenCombine的第二个入参为BiFunction,该函数式接口有两个入参,同时有一个返回值。所以与thenAcceptBoth不同的是,thenCombine将两个任务结果合并后会返回一个全新的值作为出参。 2.2.7 thenCompose public <U> CompletableFuture<U> thenCompose(Function<? super T, ? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T, ? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T, ? extends CompletionStage<U>> fn, Executor executor) thenCompose这一组函数意思是将调用方的执行结果作为Function函数的入参,同时返回一个新的CompletableFuture对象。 2.3 回调方法 public CompletableFuture<T> whenComplete(BiConsumer<? super T, ? super Throwable> action) public CompletableFuture<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action) public CompletableFuture<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action, Executor executor) whenComplete方法意思是当上一个CompletableFuture对象任务执行完成后执行该方法。BiConsumer函数式接口有两个入参没有返回值,这两个入参第一个是CompletableFuture任务的执行结果,第二个是异常信息。表示处理上一个任务的结果,如果有异常,则需要手动处理异常,与handle方法的区别在于,handle方法的BiFunction是有返回值的,而BiConsumer是没有返回值的。 以上方法都有一个带有Async的方法,带有Async的方法表示是异步执行的,会将该任务放到线程池中执行,同时该方法会有一个重载的方法,最后一个参数为Executor,表示异步执行可以指定线程池执行。为了方便进行控制,最好在使用CompletableFuture时手动指定我们的线程池。 2.4 异常处理 public CompletableFuture<T> exceptionally(Function<Throwable, ? extends T> fn) exceptionally是用来处理异常的,当任务抛出异常后,可以通过exceptionally来进行处理,也可以选择使用handle来进行处理,不过两者有些不同,hand是用来处理上一个任务的结果,如果有异常情况,就处理异常。而exceptionally可以放在CompletableFuture处理的最后,作为兜底逻辑来处理未知异常。 2.5 获取结果 public static CompletableFuture<Void> allOf(CompletableFuture<?>... cfs) public static CompletableFuture<Object> anyOf(CompletableFuture<?>... cfs) allOf是需要入参中所有的CompletableFuture任务执行完成,才会进行下一步; anyOf是入参中任何一个CompletableFuture任务执行完成都可以执行下一步。 public T get() throws InterruptedException, ExecutionException public T get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException public T getNow(T valueIfAbsent) public T join() get方法一个是不带超时时间的,一个是带有超时时间的。 getNow方法则是立即返回结果,如果还没有结果,则返回默认值,也就是该方法的入参。 join方法是不带超时时间的等待任务完成。 3、CompletableFuture原理 join方法同样表示获取结果,但是join与get方法有什么区别呢。 public T join() { Object r; return reportJoin((r = result) == null ? waitingGet(false) : r); } public T get() throws InterruptedException, ExecutionException { Object r; return reportGet((r = result) == null ? waitingGet(true) : r); } public T get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { Object r; long nanos = unit.toNanos(timeout); return reportGet((r = result) == null ? timedGet(nanos) : r); } public T getNow(T valueIfAbsent) { Object r; return ((r = result) == null) ? valueIfAbsent : reportJoin(r); } 以上是CompletableFuture类中两个方法的代码,可以看到两个方法几乎一样。区别在于reportJoin/reportGet,waitingGet方法是一致的,只不过参数不一样,我们在看下reportGet与reportJoin方法。 private static <T> T reportGet(Object r) throws InterruptedException, ExecutionException { if (r == null) // by convention below, null means interrupted throw new InterruptedException(); if (r instanceof AltResult) { Throwable x, cause; if ((x = ((AltResult)r).ex) == null) return null; if (x instanceof CancellationException) throw (CancellationException)x; if ((x instanceof CompletionException) && (cause = x.getCause()) != null) x = cause; throw new ExecutionException(x); } @SuppressWarnings("unchecked") T t = (T) r; return t; } private static <T> T reportJoin(Object r) { if (r instanceof AltResult) { Throwable x; if ((x = ((AltResult)r).ex) == null) return null; if (x instanceof CancellationException) throw (CancellationException)x; if (x instanceof CompletionException) throw (CompletionException)x; throw new CompletionException(x); } @SuppressWarnings("unchecked") T t = (T) r; return t; } 可以看到这两个方法很相近,reportGet方法判断了r对象是否为空,并抛出了中断异常,而reportJoin方法没有判断,同时reportJoin抛出的都是运行时异常,所以join方法也是无需手动捕获异常的。 我们在看下waitingGet方法 private Object waitingGet(boolean interruptible) { Signaller q = null; boolean queued = false; int spins = -1; Object r; while ((r = result) == null) { if (spins < 0) spins = SPINS; else if (spins > 0) { if (ThreadLocalRandom.nextSecondarySeed() >= 0) --spins; } else if (q == null) q = new Signaller(interruptible, 0L, 0L); else if (!queued) queued = tryPushStack(q); else if (interruptible && q.interruptControl < 0) { q.thread = null; cleanStack(); return null; } else if (q.thread != null && result == null) { try { ForkJoinPool.managedBlock(q); } catch (InterruptedException ie) { q.interruptControl = -1; } } } if (q != null) { q.thread = null; if (q.interruptControl < 0) { if (interruptible) r = null; // report interruption else Thread.currentThread().interrupt(); } } postComplete(); return r; } 该waitingGet方法是通过while的方式循环判断是否任务已经完成并产生结果,如果结果为空,则会一直在这里循环,这里需要注意的是在这里初始化了一下spins=-1,当第一次进入while循环的时候,spins是-1,这时会将spins赋值为一个常量,该常量为SPINS。 private static final int SPINS = (Runtime.getRuntime().availableProcessors() > 1 ? 1 << 8 : 0); 这里判断可用CPU数是否大于1,如果大于1,则该常量为 1<< 8,也就是256,否则该常量为0。 第二次进入while循环的时候,spins是256大于0,这里做了减一的操作,下次进入while循环,如果还没有结果,依然是大于0继续做减一的操作,此处用来做短时间的自旋等待结果,只有当spins等于0,后续会进入正常流程判断。 我们在看下timedGet方法的源码 private Object timedGet(long nanos) throws TimeoutException { if (Thread.interrupted()) return null; if (nanos <= 0L) throw new TimeoutException(); long d = System.nanoTime() + nanos; Signaller q = new Signaller(true, nanos, d == 0L ? 1L : d); // avoid 0 boolean queued = false; Object r; // We intentionally don't spin here (as waitingGet does) because // the call to nanoTime() above acts much like a spin. while ((r = result) == null) { if (!queued) queued = tryPushStack(q); else if (q.interruptControl < 0 || q.nanos <= 0L) { q.thread = null; cleanStack(); if (q.interruptControl < 0) return null; throw new TimeoutException(); } else if (q.thread != null && result == null) { try { ForkJoinPool.managedBlock(q); } catch (InterruptedException ie) { q.interruptControl = -1; } } } if (q.interruptControl < 0) r = null; q.thread = null; postComplete(); return r; } timedGet方法依然是通过while循环的方式来判断是否已经完成,timedGet方法入参为一个纳秒值,并通过该值计算出一个deadline截止时间,当while循环还未获取到任务结果且已经达到截止时间,则抛出一个TimeoutException异常。 4、CompletableFuture实现多线程任务 这里我们通过CompletableFuture来实现一个多线程处理异步任务的例子。 这里我们创建10个任务提交到我们指定的线程池中执行,并等待这10个任务全部执行完毕。 每个任务的执行流程为第一次先执行加法,第二次执行乘法,如果发生异常则返回默认值,当10个任务执行完成后依次打印每个任务的结果。 public void demo() throws InterruptedException, ExecutionException, TimeoutException { // 1、自定义线程池 ExecutorService executorService = new ThreadPoolExecutor(5, 10, 60L, TimeUnit.SECONDS, new LinkedBlockingQueue<>(100)); // 2、集合保存future对象 List<CompletableFuture<Integer>> futures = new ArrayList<>(10); for (int i = 0; i < 10; i++) { int finalI = i; CompletableFuture<Integer> future = CompletableFuture // 提交任务到指定线程池 .supplyAsync(() -> this.addValue(finalI), executorService) // 第一个任务执行结果在此处进行处理 .thenApplyAsync(k -> this.plusValue(finalI, k), executorService) // 任务执行异常时处理异常并返回默认值 .exceptionally(e -> this.defaultValue(finalI, e)); // future对象添加到集合中 futures.add(future); } // 3、等待所有任务执行完成,此处最好加超时时间 CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).get(5, TimeUnit.MINUTES); for (CompletableFuture<Integer> future : futures) { Integer num = future.get(); System.out.println("任务执行结果为:" + num); } System.out.println("任务全部执行完成!"); } private Integer addValue(Integer index) { System.out.println("第" + index + "个任务第一次执行"); if (index == 3) { int value = index / 0; } return index + 3; } private Integer plusValue(Integer index, Integer num) { System.out.println("第" + index + "个任务第二次执行,上次执行结果:" + num); return num * 10; } private Integer defaultValue(Integer index, Throwable e) { System.out.println("第" + index + "个任务执行异常!" + e.getMessage()); e.printStackTrace(); return 10; } 作者:京东物流 丁冬 来源:京东云开发者社区 自猿其说Tech

优秀的个人博客,低调大师

并发编程-FutureTask解析 | 京东物流技术团队

1、FutureTask对象介绍 Future对象大家都不陌生,是JDK1.5提供的接口,是用来以阻塞的方式获取线程异步执行完的结果。 在Java中想要通过线程执行一个任务,离不开Runnable与Callable这两个接口。 Runnable与Callable的区别在于,Runnable接口只有一个run方法,该方法用来执行逻辑,但是并没有返回值;而Callable的call方法,同样用来执行业务逻辑,但是是有一个返回值的。 Callable执行任务过程中可以通过FutureTask获得任务的执行状态,并且可以在执行完成后通过Future.get()方式获取执行结果。 Future是一个接口,而FutureTask就是Future的实现类。并且FutureTask实现了 RunnableFuture(Runnable + Future),说明我们可以创建一个FutureTask并直接把它放到线程池执行,然后获取FutureTask的执行结果。 2、FutureTask源码解析 2.1 主要方法和属性 那么FutureTask是如何通过阻塞的方式来获取到异步线程执行的结果的呢?我们看下FutureTask中的属性。 // FutureTask的状态及其常量 private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; // callable对象,执行完后置空 private Callable<V> callable; // 要返回的结果或要引发的异常来自 get() 方法 private Object outcome; // non-volatile, protected by state reads/writes // 执行Callable的线程 private volatile Thread runner; // 等待线程的一个链表结构 private volatile WaitNode waiters; FutureTask中几个比较重要的方法。 // 取消任务的执行 boolean cancel(boolean mayInterruptIfRunning); // 返回任务是否已经被取消 boolean isCancelled(); // 返回任务是否已经完成,任务状态不为NEW即为完成 boolean isDone(); // 通过get方法获取任务的执行结果 V get() throws InterruptedException, ExecutionException; // 通过get方法获取任务的执行结果,带有超时,如果超过给定时间则抛出异常 V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException; 2.2 FutureTask执行 当我们在线程池中执行一个Callable方法时,其实是将Callable任务封装成一个RunnableFuture对象去执行,同时将这个RunnableFuture对象返回,这样我们就拿到了FutureTask的引用,可以随时获取到任务执行的状态,并且可以在任务执行完成后通过该对象获取执行结果。 以下为ThreadPoolExecutor线程池提交一个callable方法的源码。 public <T> Future<T> submit(Callable<T> task) { if (task == null) throw new NullPointerException(); RunnableFuture<T> ftask = newTaskFor(task); execute(ftask); return ftask; } protected <T> RunnableFuture<T> newTaskFor(Callable<T> callable) { return new FutureTask<T>(callable); } 2.3 run方法介绍 RunnableFuture其实也是一个可以执行的runnable,我们看下他的run方法。其主要流程就是执行call方法,正常执行完毕后将result结果赋值到outcome属性上。 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { // 将callable赋值到本地变量 Callable<V> c = callable; // 判断callable不为空并且FutureTask的状态必须为新创建 if (c != null && state == NEW) { V result; boolean ran; try { // 执行call方法(用户自己实现的call逻辑),并获取到result结果 result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; // 如果执行过程出现异常,则将异常对象赋值到outcome上 setException(ex); } // 如果正常执行完毕,则将result赋值到outcome属性上 if (ran) set(result); } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } 以下逻辑为正常执行完成后赋值的逻辑。 // 如果任务没有被取消,将future执行完的返回值赋值给result结果 // FutureTask任务的执行状态是通过CAS的方式进行赋值的,并且由此可知,COMPLETING其实是一个瞬时状态 // 当将线程执行结果赋值给outcome后,状态会修改为对应的NORMAL,即正常结束 protected void set(V v) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // final state finishCompletion(); } } 以下为执行异常时赋值逻辑,直接将Throwable对象赋值到outcome属性上。 protected void setException(Throwable t) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = t; UNSAFE.putOrderedInt(this, stateOffset, EXCEPTIONAL); // final state finishCompletion(); } } 无论是正常执行还是异常执行,最终都会调用一个finishCompletion方法,用来做工作的收尾工作。 2.4 get方法介绍 Future的get方法有两个重载的方法,一个是get()获取结果,一个是get(long, TimeUnit)带有超时时间的获取结果,我们看下FutureTask中的这两个方法是如何实现的。 // 不带有超时时间,一直阻塞直到获取结果 public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) // 等待结果完成,带有超时的get方法也是调用的awaitDone方法 s = awaitDone(false, 0L); // 返回结果 return report(s); } // 带有超时时间的获取结果,如果超过时间还没有获取到结果则抛出异常 public V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { if (unit == null) throw new NullPointerException(); int s = state; // 如果任务未中断,调用awaitDone方法等待任务结果 if (s <= COMPLETING && (s = awaitDone(true, unit.toNanos(timeout))) <= COMPLETING) throw new TimeoutException(); // 返回结果 return report(s); } 我们主要看下awaitDone方法的执行逻辑。此方法会通过for循环的方式一直阻塞等待任务执行完成。如果带有超时时间,则超过截止时间后会直接返回。 // timed:是否需要超时获取 // nanos:超时时间单位纳秒 private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; // 此方法会一直for循环判断任务状态是否已经完成,是Future.get阻塞的原因 for (;;) { if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } int s = state; // 任务状态大于COMPLETING,则表明任务结束,直接返回 if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet // Thread.yield() 方法,使当前线程由执行状态,变成为就绪状态,让出cpu时间,在下一个线程执行时候,此线程有可能被执行,也有可能没有被执行。 // COMPLETING状态为瞬时状态,任务执行完成,要么是正常结束,要么异常结束,后续会被置为NORMAL或者EXCEPTIONAL Thread.yield(); else if (q == null) // 每调用一次get方法,都会创建一个WaitNode等待节点 q = new WaitNode(); else if (!queued) // 将该等待节点添加到链表结构waiters中,q.next = waiters 即在waiters的头部插入 queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q); // 如果方法带有超时判断,则判断当前时间是否已经超过了截止时间,如果超过了及截止日期,则退出循环直接返回当前状态,此时任务状态一定是NEW else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) { removeWaiter(q); return state; } LockSupport.parkNanos(this, nanos); } else LockSupport.park(this); } } 我们在看下report方法,在调用get方法时是如何返回结果的。 这里首先获取outcome的值,并判断任务是否已经执行完成,如果执行完成,则将outcome对象强转成泛型指定的类型;如果任务被取消了,则抛出一个CancellationException异常;如果都不是,则说明任务在执行过程中发生了异常,此时任务状态位EXCEPTIONAL,此时的outcome即为Throwable对象,所以将outcome强转为Throwable并抛出异常。 由此可以知道,我们将一个FutureTask任务submit到线程池中执行的时候,如果发生了异常,是会在调用get方法的时候抛出的。 private V report(int s) throws ExecutionException { Object x = outcome; if (s == NORMAL) return (V)x; if (s >= CANCELLED) throw new CancellationException(); throw new ExecutionException((Throwable)x); } 2.5 cancel方法介绍 cancel方法用于取消正在运行的任务,如果任务取消成功,则返回TRUE,如果取消失败则返回FALSE。 // mayInterruptIfRunning:允许中断正在运行的任务 public boolean cancel(boolean mayInterruptIfRunning) { // mayInterruptIfRunning如果为true则将状态置为INTERRUPTING,如果未false则将状态置为CANCELLED if (!(state == NEW && UNSAFE.compareAndSwapInt(this, stateOffset, NEW, mayInterruptIfRunning ? INTERRUPTING : CANCELLED))) return false; // 如果状态修改成功后,判断是否允许中断线程,如果允许,则调用Thread的interrupt方法中断 try { // in case call to interrupt throws exception if (mayInterruptIfRunning) { try { Thread t = runner; if (t != null) t.interrupt(); } finally { // final state UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); } } } finally { // 取消后的收尾工作 finishCompletion(); } return true; } 2.6 isDone/isCancelled方法介绍 isDone方法用于判断FutureTask是否已经完成;isCancelled方法用来判断FutureTask是否已经取消,这两个方法都是通过状态位来判断的。 public boolean isCancelled() { return state >= CANCELLED; } public boolean isDone() { return state != NEW; } 2.7 finishCompletion方法介绍 我们看下finishCompletion方法都做了哪些工作。 // 删除所有等待线程并发出信号,最后执行done方法 private void finishCompletion() { // assert state > COMPLETING; for (WaitNode q; (q = waiters) != null;) { if (UNSAFE.compareAndSwapObject(this, waitersOffset, q, null)) { for (;;) { Thread t = q.thread; if (t != null) { q.thread = null; LockSupport.unpark(t); } WaitNode next = q.next; if (next == null) break; q.next = null; // unlink to help gc q = next; } break; } } done(); callable = null; // to reduce footprint } 我们看到done方法是一个受保护的空方法,此处没有任何逻辑,由其子类去根据自己的业务去实现相应的逻辑。例如:java.util.concurrent.ExecutorCompletionService.QueueingFuture。 protected void done() { } 3、总结 通过源码解读可以了解到Future的原理: 第一步:主线程将任务封装成一个Callable对象,通过submit方法提交到线程池去执行。 第二步:线程池执行任务的run方法,主线程则可以继续执行其他逻辑。 第三步:线程池中方法执行完成后将结果赋值到outcome属性上,并修改任务状态。 第四步:主线程在需要拿到异步任务结果的时候,主动调用fugure.get()方法来获取结果。 第五步:如果异步线程在执行过程中发生异常,则会在调用future.get()方法的时候抛出来。 以上就是对于FutureTask的分析,我们可以了解FutureTask任务执行的方式以及Future.get已阻塞的方式获取线程执行的结果原理,并且从代码中可以了解FutureTask的任务执行状态以及状态的变化过程。 作者:京东物流 丁冬 来源:京东云开发者社区 自猿其说Tech
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册