首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

JVM运行数据区深度解析

运行数据区 字节码只是一个二进制文件存放在那里。要想在jvm里跑起来,先得有个运行的内存环境。 也就是我们所说的jvm运行时数据区。 1)运行时数据区的位置 运行时数据区是jvm中最为重要的部分,执行引擎频繁操作的就是它。类的初始化,以及后面我们讲的对象空间的分配、垃圾的回收都是在这块区域发生的。 2)区域划分 根据《Java虚拟机规范》中的规定,在运行时数据区将内存细分为几个部分 线程私有的:Java虚拟机栈(Java Virtual Machine Stack)、程序计数器(Program Counter Register)、本地方法栈(Native Method Stacks) 大家共享的:方法区(Method Area)、Java堆区(Java Heap) 接下来我们分块详细来解读,每一块是做什么的,如果溢出了会发生什么事情 1.1 程序计数器 1.1.1 概述 程序计数器(Program Counter Register) 每个线程一个。是一块较小的内存空间,它表示当前线程执行的字节码指令的地址。 字节码解释器工作时,通过改变这个计数器的值来选取下一条需要执行的字节码指令,所以整个程序无论是分支、循环、跳转、异常处理、线程恢复等基础功能都需要依赖这个计数器来完成。 由于线程是多条并行执行的,互相之间执行到哪条指令是不一样的,所以每条线程都需要有一个独立的程序计数器,各条线程之间计数器互不影响,独立存储,我们称这类内存区域为“线程私有”的内存。 如果是native方法,这里为空 1.1.2 溢出异常 没有! 在虚拟机规范中,没有对这块区域设定内存溢出规范,也是唯一一个不会溢出的区域 1.1.3 案例 因为它不会溢出,所以我们没有办法给它造一个,但是从class类上可以找到痕迹。 回顾上面javap的反汇编,其中code所对应的编号就可以理解为计数器中所记录的执行编号。 1.2 虚拟机栈 1.2.1 概述 也是线程私有的!生命周期与线程相同。 它描述的是Java方法执行的当前线程的内存模型,每个方法被执行的时候,Java虚拟机都会同步创建一个栈帧,用于存储局部变量表、操作数栈、动态连接、方法出口等信息。每一个方法被调用直至执行完毕的过程,就对应着一个栈帧在虚拟机栈中从入栈到出栈的过程。 1.2.2 溢出异常 1)栈深度超出设定 如果是创建的栈的深度大于虚拟机允许的深度,抛出 Exception in thread "main" java.lang.StackOverflowError 2)内存申请不足 如果栈允许内存扩展,但是内存申请不够的时候,抛出 OutOfMemoryError 注意!这一点和具体的虚拟机有关,hotspot虚拟机并不支持栈空间扩展,所以单线程环境下,一个线程创建时,分配给它固定大小的一个栈,在这个固定栈空间上不会出现再去扩容申请内存的情况,也就不会遇到申请不到一说,只会因为深度问题超出固定空间造成上面的StackOverflowError 如果换成多线程,毫无节制的创建线程,还是有可能造成OutOfMemoryError。但是这个和Xss栈空间大小无关。是因为线程个数太多,栈的个数太多,导致系统分配给jvm进程的物理内存被吃光。 这时候虚拟机会附带相关的提示: Exception in thread "main" java.lang.OutOfMemoryError: unable to create native thread ps: 每个线程默认分配1M空间(64位linux,hotspot环境) 疑问:是不是改小Xss的值就可以得到栈空间溢出呢? 答:根据上面的分析,hotspot下不可以,还是会抛出StackOverflowError,无非深度更小了。 1.2.3 案例一:进出栈顺序 1)代码 package com.itheima.jvm.demo; /** * 程序模拟进栈、出栈过程 * 先进后出 */ public class StackInAndOut { /** * 定义方法一 */ public static void A() { System.out.println("进入方法A"); } /** * 定义方法二;调用方法一 */ public static void B() { A(); System.out.println("进入方法B"); } public static void main(String[] args) { B(); System.out.println("进入Main方法"); } } 2)运行结果: 进入方法A 进入方法B 进入Main方法 3)栈结构: main方法---->B方法---->A方法 1.2.4 案例二:栈深度溢出 1)代码 这个容易实现,方法嵌套自己就可以: package com.itheima.jvm.demo; /** * 通过一个程序模拟线程请求的栈深度大于虚拟机所允许的栈深度; * 抛出StackOverflowError */ public class StackOverFlow { /** * 定义方法,循环嵌套自己 */ public static void B() { B(); System.out.println("进入方法B"); } public static void main(String[] args) { B(); System.out.println("进入Main方法"); } } 2)运行结果: Exception in thread "main" java.lang.StackOverflowError at com.itheima.jvm.demo.StackOverFlow.B(StackOverFlow.java:12) at com.itheima.jvm.demo.StackOverFlow.B(StackOverFlow.java:12) at com.itheima.jvm.demo.StackOverFlow.B(StackOverFlow.java:12) at com.itheima.jvm.demo.StackOverFlow.B(StackOverFlow.java:12) at com.itheima.jvm.demo.StackOverFlow.B(StackOverFlow.java:12) 3)栈结构: 1.2.5 案例三:栈内存溢出 一直不停的创建线程就可以堆满栈 但是!这个很危险,到32系统的winxp上勇敢的小伙伴可以试一试,机器卡死不负责! package com.itheima.jvm.demo; /* * 栈内存溢出,注意!很危险,谨慎执行 * 执行时可能会卡死系统。直到内存耗尽 * */ public class StackOutOfMem { public static void main(String[] args) { while (true) { new Thread(() -> { while(true); }).start(); } } } 1.3 本地方法栈 1.3.1 概述 本地方法栈的功能和特点类似于虚拟机栈,均具有线程隔离的特点 不同的是,本地方法栈服务的对象是JVM执行的native方法,而虚拟机栈服务的是JVM执行的java方法 虚拟机规范里对这块所用的语言、数据结构、没有强制规定,虚拟机可以自由实现它 甚至,hotspot把它和虚拟机栈合并成了1个 1.3.2 溢出异常 和虚拟机栈一样,也是两个: 如果是创建的栈的深度大于虚拟机允许的深度,抛出 StackOverFlowError 内存申请不够的时候,抛出 OutOfMemoryError 1.4 堆 1.4.1 概述 与上面的3个不同,堆是所有线程共享的!所谓的线程安全不安全也是出自这里。 在虚拟机启动时创建。此内存区域的唯一目的就是存放对象实例,Java世界里“几乎”所有的对象实例都在这里分配内存。 需要注意的是,《Java虚拟机规范》并没有对堆进行细致的划分,所以对于堆的讲解要基于具体的虚拟机,我们以使用最多的HotSpot虚拟机为例。 Java堆是垃圾收集器管理的内存区域,因此它也被称作“GC堆”,这就是我们做JVM调优的重点区域部分。 1.4.2 jdk1.7 jvm的内存模型在1.7和1.8有较大的区别,虽然1.7目前使用的较少了,但是我们也是需要对1.7的内存模型有所了解,所以接下里,我们将先学习1.7再学习1.8的内存模型。 Young 年轻区(代) Young区被划分为三部分,Eden区和两个大小严格相同的Survivor区 其中,Survivor区间中,某一时刻只有其中一个是被使用的,另外一个留做垃圾收集时复制对象用 在Eden区间变满的时候, GC就会将存活的对象移到空闲的Survivor区间中,根据JVM的策略,在经过几次垃圾收集后,任然存活于Survivor的对象将被移动到下面的Tenured区间。 Tenured 年老区 Tenured区主要保存生命周期长的对象,一般是一些老的对象,当一些对象在Young复制转移一定的次数以后,对象就会被转移到Tenured区,一般如果系统中用了application级别的缓存,缓存中的对象往往会被转移到这一区间。 Perm 永久区 hotspot 1.6 才有这货,现在已经成为历史 Perm代主要保存class,method,filed对象,这部份的空间一般不会溢出,除非一次性加载了很多的类,不过在涉及到热部署的应用服务器的时候,有时候会遇到java.lang.OutOfMemoryError : PermGen space 的错误,造成这个错误的很大原因就有可能是每次都重新部署,但是重新部署后,类的class没有被卸载掉,这样就造成了大量的class对象保存在了perm中,这种情况下,一般重新启动应用服务器可以解决问题。另外一种可能是创建了大批量的jsp文件,造成类信息超出perm的上限而溢出。这种重启也解决不了。只能调大空间。 Virtual区: jvm参数可以设置一个范围,最大内存和初始内存的差值,就是Virtual区。 1.4.3 jdk1.8 由上图可以看出,jdk1.8的内存模型是由2部分组成,年轻代 + 年老代。永久代被干掉,换成了Metaspace(元数据空间) 年轻代:Eden + 2*Survivor (不变) 年老代:OldGen (不变) 元空间:原来的perm区 (重点!) 需要特别说明的是:Metaspace所占用的内存空间不是在虚拟机内部,而是在本地内存空间中,这也是与1.7的永久代最大的区别所在。 1.4.4 溢出异常 内存不足时,抛出 java.lang.OutOfMemoryError: Java heap space 1.4.5 案例:堆溢出 1)代码 分配大量对象,超出jvm规定的堆范围即可 package com.itheima.jvm.demo; import java.util.ArrayList; import java.util.List; /** * 堆溢出 * -Xms20m -Xmx20m */ public class HeapOOM { Byte[] bytes = new Byte[1024*1024]; public static void main(String[] args) { List list = new ArrayList(); int i = 0; while (true) { System.out.println(++i); list.add(new HeapOOM()); } } } 2)启动 注意启动时,指定一下堆的大小: 2)输出 1 2 3 4 5 Exception in thread "main" java.lang.OutOfMemoryError: Java heap space at com.itheima.jvm.demo.HeapOOM.<init>(HeapOOM.java:7) at com.itheima.jvm.demo.HeapOOM.main(HeapOOM.java:13) 1.5 方法区 1.5.1 概述 同样,线程共享的。 它主要用来存储类的信息、类里定义的常量、静态变量、编译器编译后的代码缓存。 注意!方法区在虚拟机规范里这是一个逻辑概念,它具体放在那个区域里没有严格的规定。 所以,hotspot 1.7 将它放在了堆的永久代里,1.8+单独开辟了一块叫metaspace来存放一部分内容(不是全部!定义的类对象在堆里) 具体方法区主要存什么东西呢?粗略的分,可以划分为两类: 类信息:主要指类相关的版本、字段、方法、接口描述、引用等 运行时常量池:编译阶段生成的常量与符号引用、运行时加入的动态变量 (常量池里的类变量,如对象或字符串,比较特殊,1.6和1.8位置不同,下面会讲到) 小提示: 这里经常会跟上面堆里的永久代混为一谈,实际上这是两码事 永久代是hotspot在1.7及之前才有的设计,1.8+,以及其他虚拟机并不存在这个东西。 可以说,永久代是1.7的hotspot偷懒的结果,他在堆里划分了一块来实现方法区的功能,叫永久代。因为这样可以借助堆的垃圾回收来管理方法区的内存,而不用单独为方法区再去编写内存管理程序。懒惰! 同时代的其他虚拟机,如J9,Jrockit等,没有这个概念。后来hotspot认识到,永久代来做这件事不是一个好主意。1.7已经从永久代拿走了一部分数据,直到1.8+彻底去掉了永久代,方法区大部分被移到了metaspace(再强调一下,不是全部!) 结论: 方法区是一定存在的,这是虚拟机规定的,但是是个逻辑概念,在哪里虚拟机自己去决定 而永久代不一定存在(hotspot 1.7 才有),已成为历史 1.5.2 溢出异常 1.6:OutOfMemoryError: PermGen space 1.8:OutOfMemoryError: Metaspace 1.5.3 案例:1.6方法区溢出 1)原理 在1.6里,字符串常量是运行时常量池的一部分,也就是归属于方法区,放在了永久代里。 所以1.6环境下,让方法区溢出,只需要可劲造往字符串常量池中造字符串即可,这里用到一个方法: /* 如果字符串常量池里有这个字符串,直接返回引用,不再额外添加 如果没有,加进去,返回新创建的引用 */ String.intern() 2)代码 /** * 方法区溢出,注意限制一下永久代的大小 * 编译的时候注意pom里的版本,要设置1.6,否则启动会有问题 * jdk1.6 : -XX:PermSize=6M -XX:MaxPermSize=6M */ public class ConstantOOM { public static void main(String[] args) { ConstantOOM oom = new ConstantOOM(); Set<String> stringSet = new HashSet(); int i = 0; while (true) { System.out.println(++i); stringSet.add(String.valueOf(i).intern()); } } } 3)创建启动环境 4)异常信息: ... 19118 19119 19120 Exception in thread "main" java.lang.OutOfMemoryError: PermGen space at java.lang.String.intern(Native Method) at com.itheima.jvm.demo.ConstantOOM.main(ConstantOOM.java:19) 1.5.4 案例:1.8方法区溢出 1)到了1.8,情况发生了变化 可以测试一下,1.8下无论指定下面的哪个参数,常量池运行都不会溢出,会一直打印下去 -XX:PermSize=6M -XX:MaxPermSize=6M -XX:MetaspaceSize=10M -XX:MaxMetaspaceSize=10M 2)配置运行环境 3)控制台信息 不会抛出异常,只要你jvm堆内存够,理论上可以一直打下去 4)为什么呢? 永久代我们加了限制,结果没意义,因为1.8里已经没有这货了 元空间也加了限制,同样没意义,那说明字符串常量池它不在元空间里! 那么,它在哪里呢? jdk1.8以后,字符串常量池被移到了堆空间,和其他对象一样,接受堆的控制。 其他的运行时的类信息、基本数据类型等在元空间。 我们可以验证一下,对上面的运行时参数再加一个堆上限限制: -Xms10m -Xmx10m 运行环境如下: 运行没多久,你会得到以下异常: …… 84014 84015 84016 84017 84018 84019 Exception in thread "main" java.lang.OutOfMemoryError: GC overhead limit exceeded at java.lang.Integer.toString(Integer.java:403) at java.lang.String.valueOf(String.java:3099) at com.itheima.jvm.demo.ConstantOOM.main(ConstantOOM.java:18) 说明:1.8里,字符串inter()被放在了堆里,受最大堆空间的限制。 5)那如何才能让元空间溢出呢? 既然字符串常量池不在这里,那就换其他的。类的基本信息总在元空间吧?我们来试一下 cglib是一个apache下的字节码库,它可以在运行时生成大量的对象,我们while循环同时限制metaspace试试: 附:https://gitee.com/mirrors/cglib (想深入了解这个工具的猛击左边,这里不做过多讨论) package com.itheima.jvm.demo; import net.sf.cglib.proxy.Enhancer; import net.sf.cglib.proxy.MethodInterceptor; import net.sf.cglib.proxy.MethodProxy; import java.lang.reflect.Method; /** * jdk8方法区溢出 * -XX:MetaspaceSize=10M -XX:MaxMetaspaceSize=10M */ public class ConstantOOM8 { public static void main(final String[] args) { while (true) { Enhancer enhancer = new Enhancer(); enhancer.setSuperclass(OOM.class); enhancer.setUseCache(false); enhancer.setCallback(new MethodInterceptor() { @Override public Object intercept(Object o, Method method, Object[] objects, MethodProxy methodProxy) throws Throwable { return methodProxy.invokeSuper(objects,args); } }); enhancer.create(); } } static class OOM{ } } 6)运行设置 7)运行结果 Caused by: java.lang.OutOfMemoryError: Metaspace at java.lang.ClassLoader.defineClass1(Native Method) at java.lang.ClassLoader.defineClass(ClassLoader.java:763) 结论: jdk8引入元空间来存储方法区后,内存溢出的风险比历史版本小多了,但是在类超出控制的时候,依然会打爆方法区 1.6 一个案例 为便于大家理解和记忆,下面我们用一个案例,把上面各个区串通起来。 假设有个Bootstrap的类,执行main方法。在jvm里,它从class文件到跑起来,大致经过如下步骤: 首先JVM会先将这个Bootstrap.class 信息加载到内存中的方法区 接着,主线程开辟一块内存空间,准备好程序计数器pc,虚拟机栈、本地方法栈 然后,JVM会在Heap堆上为Bootstrap.class 创建一个Bootstrap.class 的类实例 JVM开始执行main方法,这时在虚拟机栈里为main方法创建一个栈帧 main方法在执行的过程之中,调用了greeting方法,则JVM会为greeting方法再创建一个栈帧,推到虚拟机栈顶,在main的上面,每次只有一个栈帧处于活动状态,当前为greeting 当greeting方法运行完成后,则greeting方法出栈,当前活动帧指向main,方法继续往下运行 1.7 归纳总结 1)独享/共享的角度: 独享:程序计数器、虚拟机栈、本地方法栈 共享:堆、方法区 2)error的角度: 程序计数器:不会溢出,比较特殊,其他都会 两个栈:可能会发生两种溢出,一是深度超了,报StackOverflowError,空间不足:OutOfMemoryError 堆:只会在空间不足时,报OutOfMemoryError,会提示heapSpace 方法区:空间不足时,报OutOfMemoryError,提示不同,1.6是permspace,1.8是元空间,和它在什么地方有关 3)归属: 计数器、虚拟机栈、本地方法栈:线程创建必须申请配套,真正的物理空间 堆:真正的物理空间,但是内部结构的划分有变动,1.6有永久代,1.8被干掉 方法区:最没归属感的一块,原因就是它是一个逻辑概念。1.6被放在了堆的永久代,1.8被拆分,一部分在元空间,一部分(方法区的运行时常量池里面的类对象,包括字符串常量,被设计放在了堆里) 直接内存:这块实际上不属于运行时数据区的一部分,而是直接操作物理内存。在nio操作里DirectByteBuffer类可以对native操作,避免流在堆内外的拷贝。我们下一步的调优不会涉及到它,了解即可。 本文由传智教育博学谷教研团队发布。 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。 转载请注明出处!

优秀的个人博客,低调大师

Go 原生插件使用问题全解析

文|丁飞(花名:路德) 蚂蚁集团高级工程师 深耕于 SOFAMesh 产品的商业化落地 主要方向为基于服务网格技术的系统架构升级方案设计与落地 本文 4394 字 阅读10 分钟 |前言| MOSN 作为蚂蚁集团在 ServiceMesh 解决方案中的数据面组件,从设计之初就考虑到了第三方的扩展开发需求。目前,MOSN 支持通过 gRPC、WASM、以及 Go 原生插件三种机制对其进行扩展。 我在主导设计和落地基于 Go 原生插件机制的扩展能力时遇到了很多问题,鉴于这方面的相关资料很少,因而就有了这个想法来做一个非常粗浅的总结,希望能对大家有所帮助。 注:本文只说问题和解决方案,不读代码,文章最后会给出核心源码的 checklist。 PART. 1--文章技术背景 一、运行时 通常而言,在计算机编程语言领域,“运行时”的概念和一些需要使用到 VM 的语言相关。程序的运行由两个部分组成:目标代码和“虚拟机”。比如最为典型的 JAVA,即 Java Class + JRE。 对于一些看似不需要“虚拟机”的编程语言,就不太会有“运行时”的概念,程序的运行只需要一个部分,即目标代码。但事实上,即使是 C/C++,也有“运行时”,即它所运行平台的 OS/Lib。 Go 也是一样,因为运行 Go 程序不需要前置部署类似于 JRE 的“运行时”,所以它看起来似乎跟“虚拟机”或者“运行时”没啥关系。但事实上,Go 语言的“运行时”被编译器编译成了二进制目标代码的一部分。 图 1-1. Java 程序、runtime 和 OS 关系 图 1-2. C/C++ 程序、runtime 和 OS 关系 图 1-3. Go 程序、runtime 和 OS 关系 二、Go 原生插件机制 作为一个看起来更贴近 C/C++ 技术栈的 Go 语言来说,支持类似动态链接库的扩展一直是社区中较为强烈的诉求。 如图 1-5,Go 在标准库中专门提供了一个plugin包,作为插件的语言级编程界面,src/plugin包的本质是使用 cgo 机制调用 unix 的标准接口:dlopen()和dlsym() 。因此,它给 C/C++ 背景的程序员一种“这题我会”的错觉。 图 1-4. C/C++ 程序加载动态链接库 图 1-5. Go 程序加载动态链接库 PART. 2--典型问题解决 很遗憾,与 C/C++ 技术栈相比,Go 的插件的产出物虽然也是一个动态链接库文件,但它对于插件的开发、使用有一系列很复杂的内置约束。更令人头大的是,Go 语言不但没有对这些约束进行系统性的介绍,甚至写了一些比较差的设计和实现,导致插件相关问题的排错非常反人类。 本章节重点跟大家一起看下,在开发、使用 Go 插件,主要是编译、加载插件的时候,最常见、但必须定位到 Go 标准库 (主要包括编译器、链接器、打包器和运行时部分) 源码才能完全弄明白的几个问题,及对应的解决方法。 简而言之,Go 的主程序在加载 plugin 时,会在“runtime”里对两者进行一堆约束检查,包括但不限于: -go version 一致 - go path 一致 - go dependency 的交集一致 代码一致 path 一致 - go build 某些 flag 一致 一、不一致的标准库版本 主程序加载插件时报错: plugin was built with a different version of package runtime/internal/sys 从这个报错的文本可以得知,具体有问题的库是runtime/internal/sys,很显然这是一个 go 的内置标准库。看到这里,你可能会有很大的疑惑:我明明用的是同一个本地环境编译主程序和插件,为什么报标准库不是一个版本? 答案是,Go 的 error 日志描述不准确。而这个报错出现的根本原因可以归结为:主程序和插件的某些关键编译 flag 不一致,跟“版本”没啥关系。 比如,你使用下面的命令编译插件: GO111MODULE=on go build --buildmode=plugin -mod readonly -o ./codec.so ./codec.go 但是你使用 goland 的 debug 模式调试主程序,此时,goland 会帮你把 go build 命令按下面的例子组装好: 注意,goland 组装的编译命令里包含关键的 -gcflags all=-N -l参数,但是插件编译的命令里没有。此时,你在尝试拉起插件时就会得到一个有关runtime/internal/sys的报错。 图 2-1. 编译 flag 不一致导致的加载失败 解决这一类标准库版本不一致问题的方案比较简单:尽可能对齐主程序和插件编译的 flag。事实上,有一些 flag 是不影响插件加载的,你可以在具体的实践中慢慢摸索。 二、不一致的第三方库版本 如果使用 vendor 来管理 Go 的依赖库,那么当解决上一节的问题之后,你 100% 会立即遇到以下这个报错: plugin was built with a different version of package xxxxxxxx 其中,xxxxxxxx指的是某一个具体的三方库,比如github.com/stretchr/testify。这个报错有几个非常典型的原因,如果没有相关的排查经验,其中几个可能会烧掉开发人员不少时间。 Case 1. 版本不一致 如报错所示,似乎原因很明确,即主程序和插件所共同依赖的某个第三方库版本不一致,报错中会明确告诉你哪一个库有问题。此时,你可以对比排查主程序和插件的go.mod文件,分别找到问题库的版本,看看他们是否一致。如果这时候你发现主程和插件确实有commitid或tag的不一致问题,那解决的方法也很简单:对齐它们。 但是在很多场景下,你只会用到三方库的一部分:如一个 package,或者只是引了某些 interface。这一部分的代码在不同的版本里可能根本就没有变更,但其他没用到的代码的变更,同样会导致整个三方库版本的变更,进而导致你成为那个“版本不一致”的无辜受害者。 而且,此时你可能立即会遇到另一个问题:以谁为基准对齐?主程序?还是插件? 从常理上来说,以主程序为基线进行对齐是一个比较好的策略,毕竟插件是新添加的“附属品”,且主程序与插件通常是“一对多”的关系。但是,如果插件的三方库依赖因为任何原因就是不能和主程序对齐怎么办?在尝试了很久以后,我暂时没有找到一个完美解决这个问题的办法。 如果版本无法对齐,就只能从根本上放弃走插件这条路。 Go 语言的这种对三方库的、几乎无脑的强一致性约束,从一方面来说,避免了运行时因为版本不一致带来的潜在问题;从另一方面来说,这种刻意不给程序员灵活度的设计,对插件化、定制化、扩展化开发非常的不友好。 图 2-2. 共同依赖的三方库版本不一致导致的加载失败 Case 2. 版本号一致,代码不一致 当你按照 case 1 的思路排查go.mod文件,但是惊讶的发现报错的库版本是一致的时候,事情就会变得复杂起来。你可能会拿出世界上最先进的文本查验工具,并花掉一个上午去diff三方库的commitid,但它们就是一模一样,似乎陷入了薛定谔的版本。 出现这个问题可能的一个不是原因的原因是:有人直接修改了 vendor 目录下的代码,Go 插件机制会对代码内容的一致性进行校验。 这真的是一个非常令人头大,并难以排查的原因。除了修改代码的那个人,和已经在其他 case 中被“坑”过的那些人,没人会知道这件事情。如果修改的 vendor 代码出现在主程序里,你就几乎没有任何靠谱的办法让它们正常工作起来。 不要直接在 vendor 里改代码!!! 不要直接在 vendor 里改代码!!! 不要直接在 vendor 里改代码!!! 回馈开源社区,或者 fork-replace!!! 好消息是,你不需要解决这个问题。因为即使解决了,也还会有更大的问题等着你。 图 2-3. 共同依赖的三方库代码被就地修改导致的加载失败 Case 3. 路径不一致 当按照 case 1 和 case 2 的思路都把问题排查、解决完,但它还是报different version of package的时候,可能你就会开始对 Go 的插件机制失去耐心了:版本真的“一毛一样”,代码真的一行没动,为什么还报不同版本??? 原因是:插件机制会校验依赖库源码的「路径」,因此不能使用 vendor 管理依赖。 举个例子:你的主程序源码放在/path/to/main目录下,因此,你的某个三方库依赖的目录应该是:/path/to/main/vendor/some/thrid/part/lib; 同理,你的插件源码放在/path/to/plugin目录下,因此,同一个三方库依赖的目录应该是:/path/to/plugin/vendor/some/thrid/part/lib。 这些「文件路径」数据会被打包到二进制可执行文件里并用于校验,当主程序加载插件时,Go 的“运行时”“聪明的”通过「文件路径」的差异认定它和插件用的不是同一份代码,然后报了个different version of package。 图 2-4. 使用 vendor 机制管理第三方库导致的加载失败 同样的问题也可能会出现在使用不同机器/用户,分别编译主程序、插件的场景下:用户名不同,go 代码的路径应该也会不一样。 解决这类问题的方法很暴力直接:删掉主程序和插件的 vendor 目录,或者使用-mod=readonly编译 flag。 到这里,如果你是使用同一台机器进行主程序和插件的编译,那么常见的问题应该都基本解决了,插件机制理应能够正常工作。另一方面,由于不再使用 vendor 管理依赖,因此 case 2 的问题也会在这里被强制解决:要么提 PR 给社区,要么 fork-replace。 图 2-5. 成功加载 三、不一致的 Go 版本 fatal error: runtime: no plugin module data 除了上面的那些问题以外,还有一个在多机器分别编译主程/插件场景下的常见报错。这个报错的一个可能原因是 Go 版本不一致,对齐它们即可。(如果从机器层面就是不能对齐怎么办?……) 图 2-6. Go 版本不一致导致的加载失败 PART. 3--统一解决方案 从第二 Part 中,我们看了一些既很难排查,也不是很好处理的问题。除此之外,其实还有一些问题没有被重点介绍进来。作为一个编程语言官方支持的扩展机制,做的如此用户不友好确实出人意料。 由于「专有云 MOSN」重点依赖 Go 的插件机制做定开,因此必须拿出一个系统化的方案把这些问题统统解决掉。在尝试直接修改 Go 源码无果以后 (吐槽:Go 插件机制源码写的令人略感遗憾) ,我们重点从“产品层”及外围基础设施入手开展了相关工作: - 统一编译环境: 提供一个标准的 docker image 用来编译主程序和插件,规避任何 go 版本、gopath 路径、用户名等不一致所带来的问题; 预制go/pkg/mod,尽可能减少因为没有使用 vendor 模式导致每次编译都要重新下载依赖的问题。 - 统一 Makefile: 提供一套主程序和插件的编译 Makefile,规避任何因为 go build 命令带来的问题。 - 统一插件开发脚手架: 由脚手架,而不是开发者拉齐插件与主程序的依赖版本。并由脚手架解决其他相关问题。 - 流水线化: 将编译部署流水线化,进一步避免出现错误。 图 3-1. 统一解决方案 PART. 4--关键源码位置 如果真的想从根本上搞清楚插件校验的机制,那这里为你提供一些快速进入源码阅读状态的入口。我使用的 Go 源码为 1.15.2 版本。相关 Go 源码位置: - compiler:go/src/cmd/compile/* - linker:go/src/cmd/link/internal/ld/* - pkgloader:go/src/cmd/go/internal/load/* - runtime:go/src/runtime/* 一、go build 到底在做啥 你可以在go build命令里添加-x参数,以显式的打印出 Go 程序编译、链接、打包的全流程,例如: go build -x -buildmode=plugin -o ../calc_plugin.so calc_plugin.go 二、目标代码生成 go/src/cmd/compile/internal/gc/obj.go:55:注意第 67 和第 72 行,这里是两个入口; go/src/cmd/compile/internal/gc/iexport.go:244:注意 280 行,这里会记录 path 相关数据。 三、库哈希生成算法 go/src/cmd/link/internal/ld/lib.go:967:注意第 995-1025 行,这里计算 pkg 的 hash。 四、库哈希校验 go/src/runtime/symtab.go:392:关键数据结构; go/src/runtime/plugin.go:52:链接期 hash 与运行时 hash 值校验点; go/src/cmd/link/internal/ld/symtab.go:621:链接期 hash 赋值点; go/src/cmd/link/internal/ld/symtab.go:521:运行时 hash 赋值点。 PART. 5--总结 可以看到,即使 Go 的原生插件机制有各种各样令人头痛的问题,SOFAStack 团队依旧秉持“开源、开放、可扩展”的初衷,通过各种手段解决问题,并最终将此能力做到生产可用。 目前,专有云 MOSN 的协议编解码器和 logger 的定制化开发已经实现全面的插件化。接下来,我们将持续对 MOSN 架构进行升级,目标对包括路由逻辑、LB 逻辑、注册中心/配置中心对接等在内的多方面能力进行插件化支持。 了解更多…… MOSNStar 一下✨: https://github.com/mosn/mosn 和我们一起共建吧🧸 本周推荐阅读 MOSN 构建 Subset 优化思路分享 MOSN 文档使用指南 MOSN 1.0 发布,开启新架构演进 MOSN Contributor 采访|开源可以是做力所能及的事 欢迎关注:

优秀的个人博客,低调大师

EventBridge 事件总线及 EDA 架构解析

作者:肯梦 作为 Gartner 定义的 10 大战略技术趋势之一,事件驱动架构(EDA)逐渐成为主流技术架构。根据 Gartner 的预估,在新型数字化商业的解决方案中,将有 60%使用 EDA,在商业组织参与的技术栈中,EDA 有一半的占比。 当下比较成功的企业已然认识到,要想最大限度提升运营效率和客户体验,务必要将业务和技术两方面的举措紧密结合起来。运营事件或业务形势的变化是时下众多企业关注的焦点,这些变化能够为企业领导者带来切实有用的信息,而架构设计的主旨恰恰是从客户联系人、交易、运营等方面的信息中获取洞见,两者相辅相成。传统技术历来对企业从事件中获取洞见的速度有着诸多限制,比如用于记录、收集和处理此类事件的批处理 ETL(提取、转换、加载)等。基于以上背景,阿里云 EventBridge 应运而生。 EventBridge 是事件驱动的具体落地产品,也是 EDA 的最佳实践方式。 事件驱动(EDA)是什么 早在 2018 年,Gartner 评估报告将 Event-Driven Model 列为 10 大战略技术趋势之一,事件驱动架构(EDA)将成为未来微服务的主流。该报告同时做出了以下断言: • 到 2022 年,事件通知的软件模型将成为超过 60% 的新型数字化商业的解决方案; • 到 2022 年,超过 50% 的商业组织将参与到事件驱动的数字化商业服务的生态系统当中。 很喜欢 George Santayana 在《 The Life of Reason》说的一句话 Those who fail to learn History are doomed to repeat it.(不懂历史的人注定会重蹈覆辙)。我们以史为鉴,来看看为什么会架构会演进到事件驱动。 上图是关于架构演进时间轴线。架构本身没有优劣之分,它本身就是一组技术决策,决定后续项目的所有功能开发(框架,编码规范,文档,流程….),所以这里不谈选型好坏,只谈为什么会引入某些框架,这个框架解决了软件开发中的什么问题。 • 单体架构: 在单节点服务中,单体应用的所有模块都封装在单个进程运行,通信通过相同堆栈调用完成。这种模式下非常容易导致结构和关系不明确,难以对系统进行更改和重构。就像一个不透明的,粘稠的,脆弱的,僵硬的 Big Ball of Mud! • 分层架构: 在经典的分层架构中,层以相当谨慎的方式使用。即一个层只能知道它下方层的数据。在随后的实际应用中,更多的方式是一个层可以访问它下面的任何层。分层架构解决了单体架构的的逻辑分离问题,每一层都可以被等效替换,是用层区分也更加标准化,同时一个层可以被几个不同/更高级别的层使用。当然,层也有比较明显的缺点,层不能封装掉一切,比如添加到 UI 的某个字段,可能也需要添加到 DB,而且额外多余的层会严重损害系统性能。 • MVC 架构: MVC 架构产生的原因其实很简单,随着业务系统的复杂性增加,之前所谓“全栈工程师”已经不适用大部分场景。为了降低前端和后台的集成复杂性,故而开始推广 MVC 架构。其中,Model 代表业务逻辑;View 代表视图层,比如前端 UI 的某个小组件;Controller 提供 View 和 Model 的协调,比如将用户某项操作转为业务逻辑等。此外还有很多扩展架构,譬如 Model-View-Presenter,Model-View-Presenter-ViewModel,Resource-Method-Representation,Action-Domain-Responder 就不在细说了,感兴趣的同学可以 wiki 搜索下。 • EBI 架构: 即 Entity,Boundary(接口),Interactor (控制)。EBI 架构将系统边界视为完整连接,而不仅仅是视图,控制器或接口。EBI 的实体代表持有数据并结束相关行为的实际实体,很类似阿里云的 POP API。EBI 主要还是后端概念,它是与 MVC 相辅相成的。 • 洋葱架构: 洋葱架构是一种低耦合,高内聚的架构模型。所有的应用程序围绕独立的对象模型构建,内层定义接口,外层实现接口,耦合方向向中心内聚,所有代码都可以独立与基础设施进行编译和运行。 • SOA 架构: SOA 是 Service Orientated Architure 的缩写,即面向服务架构。表示每一个功能都是通过一个独立的服务来提供,服务定义了明确的可调用接口,服务之间的编排调用可完成一个完整的业务。其实这个架构也是目前架构中最成熟的,日常使用最多的架构模式。 在介绍完之前全部的架构趋势后,在回过头看看什么是 EDA 架构。 EDA 事件驱动架构( Event-Driven Architecture ) 是一种系统架构模型,它的核心能力在于能够发现系统“事件”或重要的业务时刻(例如交易节点、站点访问等)并实时或接近实时地对相应的事件采取必要行动。这种模式取代了传统的“ request/response ”模型,在这种传统架构中,服务必须等待回复才能进入下一个任务。事件驱动架构的流程是由事件提供运行的。 上图其实很好的解释了 EDA 架构的模型,但是其实还不够明确,所以这里我们和单体架构一起对比看看他们之间差异。 在如上对比图中,我们其实可以较为清楚看到它与传统架构的区别。在一般传统架构中,创建订单操作发生后,一系列的操作其实都是通过一个系统完成的。而事件驱动的概念则是将全部操作都转换为 “事件” 概念,下游通过捕获某个 “事件” 来决定调用什么系统完成什么样的操作。 我们回过头来看“事件”,刚刚介绍中比较的重要部分其实是将操作转换为某类事件进行分发。那这的事件我们怎么定义呢? 简单来看,其实事件就是状态的显著变化,当用户采取特定行动时触发。以 4S 店售卖汽车为例: • 当客户购买汽车并且其状态从 For Sale 变为 Sold 是一个事件; • 成功交易后,从帐户中扣除金额是一个事件; • 单击预订试驾后,从将预约信息添加到指定用户就是一个事件; 每个事件都可能触发一个或多个选项作为响应。 事件其实云原生 CNCF 基金会在 2018 年托管了开源 CloudEvents 项目,该项目旨在用统一和规范的格式来描述事件,来加强不同的服务、平台以及系统之间的互操作性。在该项目定义下,通用的事件规范是这样的: 事件主要由 Json 体构成,通过不同字段描述发生的事件。 总结来看,事件驱动其实是将比较重要的业务时刻封装成“事件”,并通过某个 EventBus 将事件路由给下游系统。 了解了 EDA 架构的整个处理过程,但是还没解决这个所谓的“EventBus”到底是什么? 如上图就是 EventBus 的核心逻辑架构,它由 Event Producer 和 Event Consumer 两端组成,通过 Bus 解耦中间环节,是不是非常像某个传统的 MQ 架构?别着急,在接下来的落地实践部分会讲解这个架构的复杂部分。 EDA 架构的落地实践思考 在开始介绍落地实践时,我们先来看一个经典的 EDA 架构模型: 这是一个非常经典 EDA 订单架构,该架构主要使用了 EventBridge 和 FC 函数计算(如果不太熟悉 FaaS 的同学可以把 FC 节点当作 ECS 或 Kubernetes 的某个 POD 节点),通过事件驱动各个业务进行协作。 所以这块的中心节点(EventBridge)其实有三个比较重要的能力: For Event Capturing(事件收集):具备采集事件的能力; For Routing(事件路由):通过事件内容将事件路由分发至于下游的能力; For Event Processing(事件过滤/替换):对事件进行脱敏或初步过滤&筛选的能力。 通常情况下,要实现这三个能力是比较困难的,比如:Event Capturing 可能需要熟悉 Dell Boomi, Snaplogic, MuleSoft, Dataflow, Apache Apex 等,Routing 部分可能通过 RocketMQ、RabbitMQ、ActiveMQ、Apache Kafka,Event Processing 需要了解 Apache Storm, Apache Flink 。所以之前讲的逻辑架构其实非常理想,要想实现完成的 EDA 事件驱动还需要包括这些核心能力。 其实,从刚刚的架构中我们也能窥探到一些信息,EDA 架构其实看起来没有那么简单,那它有何优劣呢? 下面简单罗列下 EDA 架构在实践中的优势: 松耦合: 事件驱动架构是高度松耦合且高度分布式的架构模型,事件的创建者(来源)只知道发生的事件,并不知道事件的处理方式,也关心有多少相关方订阅该事件; 异步执行: EDA 架构是异步场景下最适合的执行工具,我们可以将需要事件保留在队列中,直到状态正常后执行; 可扩展性: 事件驱动架构可以通过路由&过滤能力快速划分服务,提供更便捷的扩展与路由分发; 敏捷性: 事件驱动架构可以通过将事件分发至任何地方,提供更敏捷高效的部署方案。 当然,劣势也很明显: 架构复杂: 事件驱动架构复杂,路由节点多,系统结成复杂,功能要求多; 路由分发难: 事件路由分发难,灵活的事件路由需要依赖强大的实时计算能力,对整体分发系统要求较高; 无法追踪: 事件追踪是整个 EDA 架构的保证,EDA 架构中往往很难追踪到事件处理状态,需要大量的定制化开发; 可靠性差: 事件驱动由于需要多系统集成,可靠性通常较差,且交付无法保障。 如何解决 EDA 场景下的困境 针对 EDA 场景面临的这些问题,阿里云推出了 EventBridge,一款无服务器事件总线服务,其使命是作为云事件的枢纽,以标准化的 CloudEvents 1.0 协议连接云产品和应用、应用和应用,提供中心化的事件治理和驱动能力,帮助用户轻松构建松耦合、分布式的事件驱动架构;另外,在阿里云之外的云市场上有海量垂直领域的 SaaS 服务,EventBridge 将以出色的跨产品、跨组织以及跨云的集成与被集成能力,助力客户打造一个完整的、事件驱动的、高效可控的上云体验。 阿里云对 EventBridge 做了定义,核心价值包括: • 统一事件枢纽:统一事件界面,定义事件标准,打破云产品事件孤岛; • 事件驱动引擎:海量事件源,毫秒级触发能力,加速 EDA/Serverless 架构升级; • 开放与集成:提供丰富的跨产品、跨平台连接能力,促进云产品、应用程序、SaaS 服务相互集成。 下面从架构层面和功能层面对 EventBridge 进行介绍: 架构层面 针对架构复杂问题,EventBridge 提供业内通用的 Source ,Buses,Rules,Targets 模块管理能力,同时支持 EventBus 和 EventStream 两种模式,大幅度降低事件驱动架构难度。 1)事件总线模型经典 EDA( 事件驱动)场景的 N:N 模型,提供多事件路由,事件匹配,事件转换等核心能力,帮助开发者快速搭建事件驱动架构。 2)事件流模型标准 Streaming(1:1) 流式处理场景,无总线概念,用于端到端的数据转储,数据同步及数据处理等,帮助轻松构建云上端到端的数据管道服务。 功能层面 在功能层面,EventBridge 的核心亮点应用包括: 1)事件规则驱动 针对基于事件的路由分发,EventBridge 通过事件规则驱动,支持 8 大事件模式,4 重转换器,满足路由分发的全部诉求。 2)事件追踪 针对事件无法追踪,独家提供事件追踪能力,事件分析/查询能力。为用户完善的全链路事件查询分析能力。 3)DLQ/重试机制、事件全流程触发 针对可靠性差,支持 DLQ/重试机制,与事件全流程触发,大幅度保证由于用户下游系统导致的事件故障与延迟。 4)Schema 注册中心 针对事件管理复杂,支持 Schema 注册中心,支持事件信息的解释、预览和上下游代码生成能力,帮助用户低代码完成事件的收发处理。解决跨部门信息沟通困难,业务代码冗余等一系列事件管理问题。 5)同时,基于以上功能 EventBridge 支持对接 85 种以上的阿里云产品,847 种事件类型。 更多产品功能介绍,可访问 EventBridge 官网 https://www.aliyun.com/product/aliware/eventbridge 阿里云 EventBridge 更多场景介绍 经典 EDA 事件驱动 事件总线(EventBridge)最重要的能力是通过连接应用程序、云服务和 Serverless 服务来构建 EDA(Event-driven Architectures) 事件驱动架构,驱动应用与应用,应用与云的连接。 流式 ETL 场景 EventBridge 另一个核心能力是为流式的数据管道的责任,提供基础的过滤和转换的能力,在不同的数据仓库之间、数据处理程序之间、数据分析和处理系统之间进行数据同步/跨地域备份等场景,连接不同的系统与不同服务。 统一事件通知服务 EventBridge 提供丰富的云产品事件源与事件的全生命周期管理工具,您可以通过总线直接监听云产品产生的数据,并上报至监控,通知等下游服务。 重磅推荐 本篇是对 EventBridge 事件总线及 EDA 架构进行了整体介绍,若您意犹未尽,想要了解更多场景应用,可关注「阿里云 EventBridge 系列公开课」,完整课程现已重磅推出!本次系列直播课共包含有 5 个 Topic ,带您一起深入了解阿里云 EventBridge 事件总线的核心功能及应用。 后期系列课具体安排如下,有兴趣的小伙伴不要错过哦~ 点击此处,即可观看本篇文章对应的公开课视频~ 发布云原生技术最新资讯、汇集云原生技术最全内容,定期举办云原生活动、直播,阿里产品及用户最佳实践发布。与你并肩探索云原生技术点滴,分享你需要的云原生内容。 关注【阿里巴巴云原生】公众号,获取更多云原生实时资讯!

优秀的个人博客,低调大师

Vue3核心Typescript类解析

与使用JavaScript不同的是,用Typescript写Vue程序要需要了解Vue的相关类型。Vue核心的类型,大部分写在@vue/runtime-core包中。 Component Vue页面是由一个个组件组成的,组件在Vue中的类是Component,继承了ComponentOptions、FunctionalComponent和ComponentPublicInstanceConstructor。 其中,ComponentOptions继承了ComponentOptionsBase,就是是我们经常写的声明式的包含data、methods等属性的选项组件: FunctionalComponent是函数式组件,ComponentPublicInstanceConstructor是实例构造器(构造函数)。 ComponentOptions继承了ComponentCustomOptions,这个接口在Vue源码中是空的,我们可以借助它了自定义Vue组件选项中的属性,比如源码中的例子: declare module '@vue/runtime-core' { interface ComponentCustomOptions { beforeRouteUpdate?( to: Route, from: Route, next: () => void ): void } } 我们在定义组件时使用的defineComponent函数用于帮助我们进行组件选项的类型声明,它接受ComponentOptionsWithoutProps,ComponentOptionsWithArrayProps或ComponentOptionsWithObjectProps作为选项参数。它们都继承了ComponentOptionsBase,但具有不同的声明props的形式。这个函数也可以接受setup函数。 defineComponent函数返回DefineComponent类对象,它是ComponentOptionsBase和ComponentPublicInstanceConstructor的交集类对象: type DefineComponent = ComponentPublicInstanceConstructor & ComponentOptionsBase && CreateAppFunction 在V3中,一个页面的启动通常是从createApp开始的,它的类型声明是这样的: export type CreateAppFunction<HostElement> = ( rootComponent: Component, rootProps?: Data | null ) => App<HostElement> 它接受一个Component和属性作为参数,返回一个App。 App App实例是一个Vue的顶层对象,通过它可以设置共享属性、设置插件、注册组件、设置编译选项、设置错误处理函数等。 https://v3.cn.vuejs.org/api/application-api.html 通过mount方法可以将根组件挂载到文档中,并返回一个ComponentPublicInstance对象。 ComponentPublicInstance ComponentPublicInstance是组件实例,包含$el,'$emit``$props等属性。Vue以Component为模板,创建了ComponentPublicInstance`。 它的类型定义为: type ComponentPublicInstance< P = {}, // props type extracted from props option B = {}, // raw bindings returned from setup() D = {}, // return from data() C extends ComputedOptions = {}, M extends MethodOptions = {}, E extends EmitsOptions = {}, PublicProps = P, Defaults = {}, MakeDefaultsOptional extends boolean = false, Options = ComponentOptionsBase<any, any, any, any, any, any, any, any, any> > = { $: ComponentInternalInstance $data: D $props: MakeDefaultsOptional extends true ? Partial<Defaults> & Omit<P & PublicProps, keyof Defaults> : P & PublicProps $attrs: Data $refs: Data $slots: Slots $root: ComponentPublicInstance | null $parent: ComponentPublicInstance | null $emit: EmitFn<E> $el: any $options: Options & MergedComponentOptionsOverride $forceUpdate: () => void $nextTick: typeof nextTick $watch( source: string | Function, cb: Function, options?: WatchOptions ): WatchStopHandle } & P & ShallowUnwrapRef<B> & UnwrapNestedRefs<D> & ExtractComputedReturns<C> & M & ComponentCustomProperties 其中$options就是我们在写组件时的ComponentOptionsBase类对象(如果有的话,对于函数式组件则包含一个renderer方法)和MergedComponentOptionsOverride(钩子函数)交集类。 P、ShallowUnwrapRef、UnwrapNestedRefs、ExtractComputedReturns、M帮助我们可以用this[...]的方式读取组件实例的数据属性和方法。 ComponentCustomProperties在源码中是一个空接口,我们可以通过它来自定义组件实例上的属性。示例: import { Router } from 'vue-router' declare module '@vue/runtime-core' { interface ComponentCustomProperties { $router: Router } } $属性是ComponentInternalInstance类对象,表示组件的内部示例,包含了一些为高级应用提供的属性,包括VNode。

优秀的个人博客,低调大师

HarmonyOS “跨设备迁移”原理解析

## 什么是HarmonyOS“跨设备迁移”? HarmonyOS“跨设备迁移”是指将承载业务的Page在同一用户的不同设备间迁移,以便支持用户业务无缝切换的诉求。“跨设备迁移”实现了业务跨设备流转功能,打破业务受限单设备的壁垒。 典型应用场景举例: ![1.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/165a8a819d700049d4d927d746b3b7717d9f6e.png?x-oss-process=image/resize,w_679,h_380) ![1.jpg](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/96586db69814b6ddd5982927388eb5530bc2ac.jpg?x-oss-process=image/resize,w_1080,h_695) 设备A完成邮件编写并选择附件,流转到另一设备 ![2.jpg](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/c3ff87277bc77f11de94174201f2025fe1255a.jpg?x-oss-process=image/resize,w_1080,h_895) 设备B弹出邮件界面,可继续完成邮件编写 ## HarmonyOS“跨设备迁移”的技术原理 HarmonyOS“跨设备迁移”需要用到一项关键技术——“**分布式任务调度**”。 ### **分布式任务调度** “跨设备迁移”依赖HarmonyOS系统中**分布式任务调度**的“**业务迁移能力**”。 ![3.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/83293f5757fd4cb89177937c2b2733db66002e.png?x-oss-process=image/resize,w_639,h_505) “分布式任务调度”基于**分布式软总线**、**分布式数据管理**、**分布式****Profile****和分布式安全认证**这四项技术特性,构建统一的分布式服务管理(发现、同步、注册、调用)机制,支持对跨设备的应用进行远程启动、远程调用、远程连接以及迁移等操作。 ![4.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/d59e681715852e5a32e370b9389523d662a5f4.png?x-oss-process=image/resize,w_650,h_390) ● 分布式软总线实现了近场设备间统一的分布式通信能力管理,提供不区分链路的设备发现、连接、组网和传输能力。开发者可无需关注设备间组网方式与底层协议,集中精力实现业务逻辑功能。 ● 分布式数据管理中的数据同步能力可实现组网内的设备信息共享实时同步,如设备上下线、设备信息列表等,方便多设备信息实时同步。 ● 分布式Profile实现多设备Profile的统一查询、订阅能力,拉通多设备之间的管理。 ● 分布式安全认证提供应用完整性保护、应用权限管理、设备认证、密钥管理等服务,为业务提供安全保障基础。 分布式任务调度基于以上技术特性基座,构建统一的分布式服务管理机制,完成了分布式组网内设备中的系统服务信息同步及管理,包括服务注册、服务发现、服务同步和服务调度。 在业务发起“跨设备迁移”请求时,分布式调度系统根据调度决策机制选择目标设备,并获取对应设备的系统服务信息,在系统服务成功调度后,向目标设备发起远程启动、远程调用、远程连接和远程迁移,由对应设备的分布式任务调度系统完成本地化的任务执行。 ## HarmonyOS“跨设备迁移”的具体实现流程 HarmonyOS“跨设备迁移”依赖“Ability”实现,这里我们简单介绍一下“Ability”。 ### Ability Ability是应用所具备能力的抽象,HarmonyOS支持应用以Ability为单位进行部署。业务“跨设备迁移”的基础粒度也是Ability,具体实现是在不同设备间同一应用的同名Ability之间进行迁移。 **●** **Ability概述** https://developer.harmonyos.com/cn/docs/documentation/doc-guides/ability-ability-overview-0000000000029852 HarmonyOS的应用由一个或多个FA(Feature Ability)或PA(Particle Ability)组成。 ![5.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/51a560a73ebbad9c4636973f1021fc067216df.png?x-oss-process=image/resize,w_1080,h_331) **●** **FA有UI界面,提供与用户交互的能力** FA仅支持Page Ability,一个Page实例可以包含一组相关页面,每个页面用一个AbilitySlice实例表示。 ![6.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/86c183677b03e9f65d2867d3d275ca55975a42.png?x-oss-process=image/resize,w_177,h_218) **●** **Page Ability基本概念** https://developer.harmonyos.com/cn/docs/documentation/doc-guides/ability-page-concept-0000000000033573 **●** **PA无UI界面,提供后台运行任务的能力以及统一的数据访问抽象** PA支持Service Ability和Data Ability: Service Ability:用于提供后台运行任务的能力。 Data Ability:用于对外部提供统一的数据访问抽象。 Ability的生命周期主要用于Page实例的状态机管理,系统管理或用户操作等行为均会引起Page实例在其生命周期的不同状态之间进行转换。Ability Class提供的回调机制能够让Page及时感知外界变化,从而正确地应对状态变化。 **●** **Page Ability生命周期** https://developer.harmonyos.com/cn/docs/documentation/doc-guides/ability-page-lifecycle-0000000000029840 “跨设备迁移”的处理依赖Ability的生命周期管理来完成Page的状态切换,同时Page在生命周期回调中处理数据的保存与恢复。具体流程如下图所示: ![7.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/2231e9c74f2e99bbf5a0247e061d60761f04a6.png?x-oss-process=image/resize,w_942,h_706) **●** **onStart()** 当系统首次创建Page实例时触发。应用须重写该方法,并在此初始化配置为展示AbilitySlice。Page在此后进入INACTIVE状态,用户不可交互。 **• onActive()** 当Page从INACTIVE状态切换到前台时触发。Page在此之后进入ACTIVE状态,该状态下,应用与用户处于可交互的状态。 **• onInactive()** 当Page即将进入不可交互状态时会被触发,Page在此之后进入INACTIVE状态,应用与用户不可交互。 **• onBackground()** 当Page不再对用户可见时触发。Page在此之后进入BACKGROUND状态。 **• onForeground()** 当Page从BACKGROUND状态重新回到前台时触发。Page在此之后回到INACTIVE状态。 **• onStop()** 当系统将要销毁Page时触发。 ### 迁移流程 **围绕Ability的生命周期,我们来看看业务“跨设备迁移”的具体流程。** 业务“跨设备迁移”的本质即通过分布式组网把一个设备的“Ability运行状态”迁移到另外一台设备上。 程序中“跨设备迁移”通过调用Page Ability的迁移接口ContinueAbility,将设备A的业务无缝迁移到指定设备B中。其中,支持迁移的Page以及此Page所包含的所有AbilitySlice必须实现IAbilityContinuation接口。具体接口代码如下: ``` public interface IAbilityContinuation { //是否可迁移 boolean onStartContinuation(); //保存数据 boolean onSaveData(IntentParams var1); //恢复数据 boolean onRestoreData(IntentParams var1); //迁移完成 void onCompleteContinuation(int var1); default void onRemoteTerminated() { throw new RuntimeException("Stub!"); } } ``` ![8.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/8697baf141a1fa4208a4119465dc3e426ea70e.png?x-oss-process=image/resize,w_965,h_543) 图8 业务“跨设备迁移”流程 **“跨设备迁移”关键步骤:** ![QQ截图20210608110009.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/95202d640a7fa399475571ea7953217eeac621.png?x-oss-process=image/resize,w_703,h_283) **“跨设备迁移”数据流转过程:** ![QQ截图20210608105826.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/9446c8b631cf94e02607185470ec737ed2119d.png?x-oss-process=image/resize,w_711,h_414) [想了解更多关于鸿蒙的内容,请访问:](https://harmonyos.51cto.com/#bkwz) [51CTO和华为官方战略合作共建的鸿蒙技术社区](https://harmonyos.51cto.com/#bkwz) https://harmonyos.51cto.com/#bkwz

优秀的个人博客,低调大师

源码深度解析 Handler 机制及应用

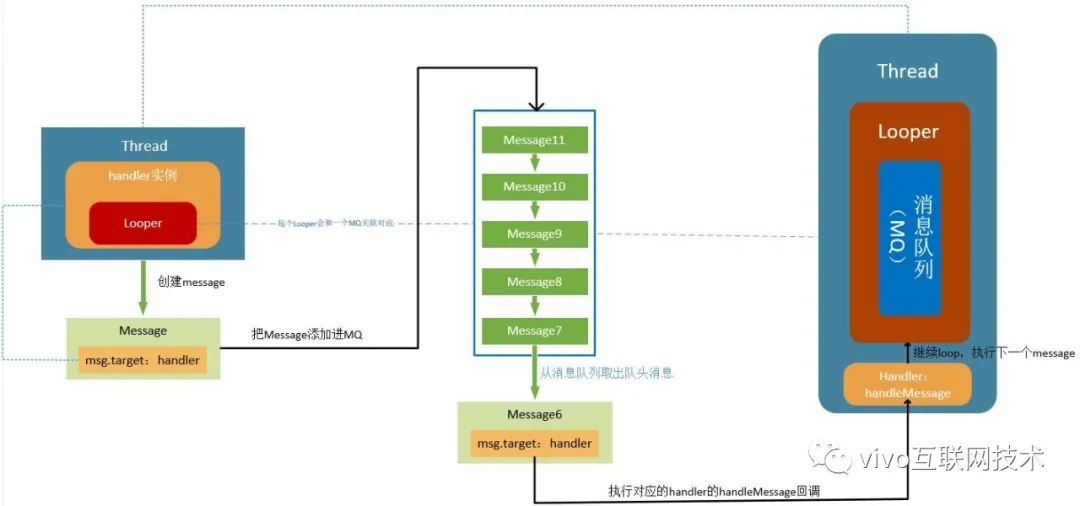
本文以源码分析+实际应用的形式,详细讲解了 Handler 机制的原理,以及在开发中的使用场景和要注意的地方。 一、基本原理回顾 在 Android 开发中,Handler及相关衍生类的应用经常用到,Android的运行也是建立在这套机制上的,所以了解其中的原理细节,以及其中的坑对于每位开发者来说都是非常有必要的。Handler机制的五个组成部分:Handler、Thread(ThreadLocal)、Looper、MessageQueue、Message。 1、Thread(ThreadLocal) Handler机制用到的跟Thread相关的,而根本原因是Handler必须和对应的Looper绑定,而Looper的创建和保存是跟Thread一一对应的,也就是说每个线程都可以创建唯一一个且互不相关的Looper,这是通过ThreadLocal来实现的,也就是说是用ThreadLocal对象来存储Looper对象的,从而达到线程隔离的目的。 static final ThreadLocal<Looper> sThreadLocal = new ThreadLocal<Looper>(); private static void prepare(boolean quitAllowed) { if (sThreadLocal.get() != null) { throw new RuntimeException("Only one Looper may be created per thread"); } sThreadLocal.set(new Looper(quitAllowed)); } 2、Handler Handler() Handler(Callback callback) Handler(Looper looper) Handler(Looper looper, Callback callback) Handler(boolean async) Handler(Callback callback, boolean async) Handler(Looper looper, Callback callback, boolean async) 2.1 创建Handler大体上有两种方式: 一种是不传Looper 这种就需要在创建Handler前,预先调用Looper.prepare来创建当前线程的默认Looper,否则会报错。 一种是传入指定的Looper 这种就是Handler和指定的Looper进行绑定,也就是说Handler其实是可以跟任意线程进行绑定的,不局限于在创建Handler所在的线程里。 2.2 async参数 这里Handler有个async参数,通过这个参数表明通过这个Handler发送的消息全都是异步消息,因为在把消息压入队列的时候,会把这个标志设置到message里.这个标志是全局的,也就是说通过构造Handler函数传入的async参数,就确定了通过这个Handler发送的消息都是异步消息,默认是false,即都是同步消息。至于这个异步消息有什么特殊的用途,我们在后面讲了屏障消息后,再联系起来讲。 private boolean enqueueMessage(MessageQueue queue, Message msg, long uptimeMillis) { msg.target = this; if (mAsynchronous) { msg.setAsynchronous(true); } return queue.enqueueMessage(msg, uptimeMillis); } 2.3 callback参数 这个回调参数是消息被分发之后的一种回调,最终是在msg调用Handler的dispatchMessage时,根据实际情况进行回调: public void dispatchMessage(Message msg) { if (msg.callback != null) { handleCallback(msg); } else { if (mCallback != null) { if (mCallback.handleMessage(msg)) { return; } } handleMessage(msg); } } 3、Looper 用于为线程运行消息循环的类。默认线程没有与它们相关联的Looper;所以要在运行循环的线程中调用prepare(),然后调用loop()让它循环处理消息,直到循环停止。 private static void prepare(boolean quitAllowed) { if (sThreadLocal.get() != null) { throw new RuntimeException("Only one Looper may be created per thread"); } sThreadLocal.set(new Looper(quitAllowed)); } public static void loop() { ... for (;;) { ... } ... } class LooperThread extends Thread { public Handler mHandler; public void run() { Looper.prepare(); mHandler = new Handler() { public void handleMessage(Message msg) { Message msg=Message.obtain(); } }; Looper.loop(); } } 既然在使用Looper前,必须调用prepare创建Looper,为什么我们平常在主线程里没有看到调用prepare呢?这是因为Android主线程创建的时候,在ActivityThread的入口main方法里就已经默认创建了Looper。 public static void main(String[] args) { ... Looper.prepareMainLooper(); ... Looper.loop(); ... } 我们再来回顾一下Looper相关类的之间的联系: 4、MessageQueue 和 Message MessageQueue是一个消息队列,Handler将Message发送到消息队列中,消息队列会按照一定的规则取出要执行的Message。Message并不是直接加到MessageQueue的,而是通过Handler对象和Looper关联到一起。 MessageQueue里的message是按时间排序的,越早加入队列的消息放在队列头部,优先执行,这个时间就是sendMessage的时候传过来的,默认是用的当前系统从启动到现在的非休眠的时间SystemClock.uptimeMillis()。 sendMessageAtFrontOfQueue 这个方法传入的时间是0,也就是说调用这个方法的message肯定会放到对消息队列头部,但是这个方法不要轻易用,容易引发问题。 存到MessageQueue里的消息可能有三种:同步消息,异步消息,屏障消息。 4.1 同步消息 我们默认用的都是同步消息,即前面讲Handler里的构造函数参数的async参数默认是false,同步消息在MessageQueue里的存和取完全就是按照时间排的,也就是通过msg.when来排的。 4.2 异步消息 异步消息就是在创建Handler如果传入的async是true或者发送来的Message通过msg.setAsynchronous(true);后的消息就是异步消息,异步消息的功能要配合下面要讲的屏障消息才有效,否则和同步消息是一样的处理。 private boolean enqueueMessage(MessageQueue queue, Message msg, long uptimeMillis) { msg.target = this; // 这个mAsynchronous就是在创建Handler的时候传入async参数 if (mAsynchronous) { msg.setAsynchronous(true); } return queue.enqueueMessage(msg, uptimeMillis); } 4.3 Barrier(屏障)消息 屏障(Barrier) 是一种特殊的Message,它最大的特征就是target为null(只有屏障的target可以为null,如果我们自己设置Message的target为null的话会报异常),并且arg1属性被用作屏障的标识符来区别不同的屏障。屏障的作用是用于拦截队列中同步消息,放行异步消息。 那么屏障消息是怎么被添加和删除的呢?我们可以看到在MessageQueue里有添加和删除屏障消息的方法: private int postSyncBarrier(long when) { // Enqueue a new sync barrier token. // We don't need to wake the queue because the purpose of a barrier is to stall it. synchronized (this) { final int token = mNextBarrierToken++; final Message msg = Message.obtain(); msg.markInUse(); msg.when = when; msg.arg1 = token; Message prev = null; Message p = mMessages; if (when != 0) { // 这里是说如果p指向的消息时间戳比屏障消息小,说明这个消息比屏障消息先进入队列, // 那么这个消息不应该受到屏障消息的影响(屏障消息只影响比它后加入消息队列的消息),找到第一个比屏障消息晚进入的消息指针 while (p != null && p.when <= when) { prev = p; p = p.next; } } // 上面找到第一个比屏障消息晚进入的消息指针之后,把屏障消息插入到消息队列中,也就是屏障消息指向第一个比它晚进入的消息p, // 上一个比它早进入消息队列的prev指向屏障消息,这样就完成了插入。 if (prev != null) { // invariant: p == prev.next msg.next = p; prev.next = msg; } else { // 如果prev是null,说明上面没有经过移动,也就是屏障消息就是在消息队列的头部了。 msg.next = p; mMessages = msg; } return token; } } public void removeSyncBarrier(int token) { // Remove a sync barrier token from the queue. // If the queue is no longer stalled by a barrier then wake it. synchronized (this) { Message prev = null; Message p = mMessages; // 前面在插入屏障消息后会生成一个token,这个token就是用来删除该屏障消息用的。 // 所以这里通过判断target和token来找到该屏障消息,从而进行删除操作 // 找到屏障消息的指针p while (p != null && (p.target != null || p.arg1 != token)) { prev = p; p = p.next; } if (p == null) { throw new IllegalStateException("The specified message queue synchronization " + " barrier token has not been posted or has already been removed."); } final boolean needWake; // 上面找到屏障消息的指针p后,把前一个消息指向屏障消息的后一个消息,这样就把屏障消息移除了 if (prev != null) { prev.next = p.next; needWake = false; } else { mMessages = p.next; needWake = mMessages == null || mMessages.target != null; } p.recycleUnchecked(); // If the loop is quitting then it is already awake. // We can assume mPtr != 0 when mQuitting is false. if (needWake && !mQuitting) { nativeWake(mPtr); } } } 4.4 屏障消息的作用 说完了屏障消息的插入和删除,那么屏障消息在哪里起作用的?它跟前面提到的异步消息又有什么关联呢?我们可以看到MessageQueue的next方法里有这么一段: // 这里就是判断当前消息是否是屏障消息,判断依据就是msg.target==null, 如果存在屏障消息,那么在它之后进来的消息中, // 只把异步消息放行继续执行,同步消息阻塞,直到屏障消息被remove掉。 if (msg != null && msg.target == null) { // Stalled by a barrier. Find the next asynchronous message in the queue. do { prevMsg = msg; msg = msg.next; // 这里的isAsynchronous方法就是前面设置进msg的async参数,通过它判断如果是异步消息,则跳出循环,把该异步消息返回 // 否则是同步消息,把同步消息阻塞。 } while (msg != null && !msg.isAsynchronous()); } 4.5 屏障消息的实际应用 屏障消息的作用是把在它之后入队的同步消息阻塞,但是异步消息还是正常按顺序取出执行,那么它的实际用途是什么呢?我们看到ViewRootImpl.scheduleTraversals()用到了屏障消息和异步消息。 TraversalRunnable的run(),在这个run()中会执行doTraversal(),最终会触发View的绘制流程:measure(),layout(),draw()。为了让绘制流程尽快被执行,用到了同步屏障技术。 void scheduleTraversals() { if (!mTraversalScheduled) { mTraversalScheduled = true; // 这里先将主线程的MessageQueue设置了个消息屏障 mTraversalBarrier = mHandler.getLooper().getQueue().postSyncBarrier(); // 这里发送了个异步消息mTraversalRunnable,这个mTraversalRunnable最终会执行doTraversal(),也就是会触发View的绘制流程 // 也就是说通过设置屏障消息,会把主线程的同步消息先阻塞,优先执行View绘制这个异步消息进行界面绘制。 // 这很好理解,界面绘制的任务肯定要优先,否则就会出现界面卡顿。 mChoreographer.postCallback( Choreographer.CALLBACK_TRAVERSAL, mTraversalRunnable, null); if (!mUnbufferedInputDispatch) { scheduleConsumeBatchedInput(); } notifyRendererOfFramePending(); pokeDrawLockIfNeeded(); } } private void postCallbackDelayedInternal(int callbackType, Object action, Object token, long delayMillis) { if (DEBUG_FRAMES) { Log.d(TAG, "PostCallback: type=" + callbackType + ", action=" + action + ", token=" + token + ", delayMillis=" + delayMillis); } synchronized (mLock) { final long now = SystemClock.uptimeMillis(); final long dueTime = now + delayMillis; mCallbackQueues[callbackType].addCallbackLocked(dueTime, action, token); if (dueTime <= now) { scheduleFrameLocked(now); } else { Message msg = mHandler.obtainMessage(MSG_DO_SCHEDULE_CALLBACK, action); msg.arg1 = callbackType; // 设置该消息是异步消息 msg.setAsynchronous(true); mHandler.sendMessageAtTime(msg, dueTime); } } } 4.6我们能用屏障消息做什么? 那么除了系统中使用到了屏障消息,我们在开发中有什么场景能派上用场吗? 运用屏障消息可以阻塞同步消息的特性,我们可以用来实现UI界面初始化和数据加载同时进行。 我们一般在Activity创建的时候,为了减少空指针异常的发生,都会在onCreate先setContent,然后findView初始化控件,然后再执行网络数据加载的异步请求,待网络数据加载完成后,再刷新各个控件的界面。 试想一下,怎么利用屏障消息的特性来达到界面初始化和异步网络数据的加载同时进行,而不影响界面渲染?先来看一个时序图: 我们通过下面伪代码进一步加深理解: // 在上一个页面里异步加载下一个页面的数据 // 网络请求返回的数据 Data netWorkData; // 创建屏障消息会生成一个token,这个token用来删除屏障消息,很重要。 int barrierToken; // 创建异步线程加载网络数据 HandlerThread thread = new HandlerThread("preLoad"){ @Override protected void onLooperPrepared() { Handler mThreadHandler = new Handler(thread.getLooper()); // 1、把请求网络耗时消息推入消息队列 mHandler.post(new Runnable() { @Override public void run() { // 异步耗时操作:网络请求数据,赋值给netWorkData netWorkData = xxx; } }); // 2、然后给异步线程的队列发一个屏障消息推入消息队列 barrierToken = thread.getLooper().getQueue().postSyncBarrier(); // 3、然后给异步线程的消息队列发一个刷新UI界面的同步消息 // 这个消息在屏障消息被remove前得不到执行的。 mHandler.post(new Runnable() { @Override public void run() { // 回调主线程, 把netWorkData赋给监听方法,刷新界面 } }); } }; thread.start(); // 当前界面初始化界面 protected void onCreate(Bundle savedInstanceState) { setContentView(view); // 各种findview操作完成 Button btn = findViewById(R.id.xxx); ... // 4、待控件初始化完成,把异步线程设置的屏障消息remove掉,这样异步线程请求数据完成后,3、处的刷新UI界面的同步消息就有机会执行,就可以安全得刷新界面了。 thread.getLooper().getQueue().removeSyncBarrier(barrierToken); } 但是,MessageQueue源码里我们我们看到,屏障消息的创建和删除都是隐藏方法(@hide),我们没法直接调用,只能用反射来调用,所以在实际使用中还得综合验证。 4.7 IdleHandler及应用 IdleHandler,字面意思就是空闲的处理器(就是说我是在消息队列空闲的时候才会执行的,如果消息队列里有其他非IdleHandler消息在执行,则我先不执行),它其实就是一个接口,我们就认为它是空闲消息吧,只不过它不是存在MessageQueue里,而是以数组的形式保存的。 public static interface IdleHandler { /** * Called when the message queue has run out of messages and will now * wait for more. Return true to keep your idle handler active, false * to have it removed. This may be called if there are still messages * pending in the queue, but they are all scheduled to be dispatched * after the current time. */ boolean queueIdle(); } 我们看到MessageQueue有添加和删除IdleHandler的方法,IdleHandler被保存在一个ArrayList里: private final ArrayList<IdleHandler> mIdleHandlers = new ArrayList<IdleHandler>(); ... public void addIdleHandler(@NonNull IdleHandler handler) { if (handler == null) { throw new NullPointerException("Can't add a null IdleHandler"); } synchronized (this) { mIdleHandlers.add(handler); } } public void removeIdleHandler(@NonNull IdleHandler handler) { synchronized (this) { mIdleHandlers.remove(handler); } } 那么,它是怎么实现在消息队列空闲的间隙得到执行的呢?还是看next()方法。 // If first time idle, then get the number of idlers to run. // Idle handles only run if the queue is empty or if the first message // in the queue (possibly a barrier) is due to be handled in the future. // pendingIdleHandlerCount < 0是说for循环只执行第一次 // mMessages == null || now < mMessages.when) 是说当前消息队列没有消息或者要执行的消息晚于当前时间 // 说明现在消息队列处于空闲。 if (pendingIdleHandlerCount < 0 && (mMessages == null || now < mMessages.when)) { pendingIdleHandlerCount = mIdleHandlers.size(); } if (pendingIdleHandlerCount <= 0) { // No idle handlers to run. Loop and wait some more. mBlocked = true; continue; } 在上面这段代码判定当前消息队列处于空闲后,就会拿到空闲消息的大小,下面这段代码就是把把空闲消息执行一遍。 // Run the idle handlers. // We only ever reach this code block during the first iteration. for (int i = 0; i < pendingIdleHandlerCount; i++) { final IdleHandler idler = mPendingIdleHandlers[i]; mPendingIdleHandlers[i] = null; // release the reference to the handler boolean keep = false; try { // 如果queueIdle返回true,则该空闲消息不会被自动删除,在下次执行next的时候,如果还出现队列空闲,会再次执行。 // 如果返回false,则该空闲消息会在执行完后,被自动删除掉。 keep = idler.queueIdle(); } catch (Throwable t) { Log.wtf(TAG, "IdleHandler threw exception", t); } if (!keep) { synchronized (this) { mIdleHandlers.remove(idler); } } } // Reset the idle handler count to 0 so we do not run them again. // 这里把空闲消息标志置为0,而不置为-1,就是说本次已经处理完,防止for循环反复执行,影响其他消息的执行 pendingIdleHandlerCount = 0; // While calling an idle handler, a new message could have been delivered // so go back and look again for a pending message without waiting. nextPollTimeoutMillis = 0; 总结一下: 如果本次循环拿到的消息为空,或者这个消息是一个延时的消息而且还没到指定的触发时间,那么,就认定当前的队列为空闲状态。 接着就会遍历mPendingIdleHandlers数组(这个数组里面的元素每次都会到mIdleHandlers中去拿)来调用每一个IdleHandler实例的queueIdle方法, 如果这个方法返回false的话,那么这个实例就会从mIdleHandlers中移除,也就是当下次队列空闲的时候,不会继续回调它的queueIdle方法了。 处理完IdleHandler后会将nextPollTimeoutMillis设置为0,也就是不阻塞消息队列,当然要注意这里执行的代码同样不能太耗时,因为它是同步执行的,如果太耗时肯定会影响后面的message执行。 IdleHandler的原理大概就是上面讲的那样,那么能力决定用处,从本质上讲就是趁着消息队列空闲的时候干点事情,具体做什么,是在IdleHandler的queueIdle()方法里。那么IdleHandler在系统源码里使用场景是怎样的?我们可以看到它在主线程生命周期处理中使用比较多,比如在ActivityThread里有个 就有一个名叫GcIdler的内部类,实现的就是IdleHandler接口,它的作用就是在主线程空闲的时候对内存进行强制GC。 final class GcIdler implements MessageQueue.IdleHandler { @Override public final boolean queueIdle() { doGcIfNeeded(); return false; } } // 这里的意思就是说判断距离上次GC的时间是否超过5秒,超过则执行后台强制GC void doGcIfNeeded() { mGcIdlerScheduled = false; final long now = SystemClock.uptimeMillis(); //Slog.i(TAG, "**** WE MIGHT WANT TO GC: then=" + Binder.getLastGcTime() // + "m now=" + now); if ((BinderInternal.getLastGcTime()+MIN_TIME_BETWEEN_GCS) < now) { //Slog.i(TAG, "**** WE DO, WE DO WANT TO GC!"); BinderInternal.forceGc("bg"); } } 我们看看它是在哪里添加到消息队列的: // 这个方法是在mH的handleMessage方法里调的,也就是说也是通过AMS(ActivityManagerService)把消息发送到主线程消息队列 void scheduleGcIdler() { if (!mGcIdlerScheduled) { mGcIdlerScheduled = true; Looper.myQueue().addIdleHandler(mGcIdler); } mH.removeMessages(H.GC_WHEN_IDLE); } 还有就是在ActivityThread的performLaunchActivity方法执行时,最终会执行到Instrumentation.callActivityOnCreate方法,在这个方法里,也有用到IdleHandler做一些额外的事情。 public void callActivityOnCreate(Activity activity, Bundle icicle) { prePerformCreate(activity); activity.performCreate(icicle); postPerformCreate(activity); } private void prePerformCreate(Activity activity) { if (mWaitingActivities != null) { synchronized (mSync) { final int N = mWaitingActivities.size(); for (int i=0; i<N; i++) { final ActivityWaiter aw = mWaitingActivities.get(i); final Intent intent = aw.intent; if (intent.filterEquals(activity.getIntent())) { aw.activity = activity; mMessageQueue.addIdleHandler(new ActivityGoing(aw)); } } } } } 除此之外,在一些第三方库中都有使用IdleHandler,比如LeakCanary,Glide中有使用到。 那么对于我们来说,IdleHandler可以有些什么使用场景呢?根据它最核心的原理,在消息队列空闲的时候做点事情,那么对于主线程来讲,我们有很多的一些代码不是必须要跟随生命周期方法同步执行的,就可以用IdleHandler,减少主线程的耗时,也就减少应用或者Activity的启动时间。例如:一些第三方库的初始化,埋点尤其是延时埋点上报等,都可以用IdleHandler添加到消息队列里。 ==好了,提个问题:前面我们说了在主线程创建的main函数里创建了Handler和Looper,回顾了上面的Handler机制的原理,我们都知道一般线程执行完就会退出,由系统回收资源,那Android UI线程也是基于Handler Looper机制的,那么为什么UI线程可以一直常驻?不会被阻塞呢?== 因为Looper在执行loop方法里,是一个for循环,也就是说线程永远不会执行完退出,所以打开APP可以一直显示,Activity的生命周期就是通过消息队列把消息一个一个取出来执行的,然后因为MessageQueue的休眠唤醒机制,当消息队列里没有消息时,消息队列会进入休眠,并释放CPU资源,当又有新消息进入队列时,会唤醒队列,把消息取出来执行。 二、Handler应用之HandlerThread HandlerThread本质上是一个Thread,所不同的是,它充分利用了Handler机制,通过在内部创建Looper循环,外部通过Handler把异步任务推送给消息队列,从而达到不用重复创建多个Thread,即能将多个异步任务排队进行异步执行,它的原理很简单: @Override public void run() { mTid = Process.myTid(); Looper.prepare(); synchronized (this) { mLooper = Looper.myLooper(); notifyAll(); } Process.setThreadPriority(mPriority); onLooperPrepared(); Looper.loop(); mTid = -1; } 在线程的run方法里创建了looper循环,这样这个线程不主动quit的话,不会销毁,有消息则执行消息,没有消息根据MessageQueue休眠机制,会释放CPU资源,进入休眠。 使用HandlerThread时,我们注意到,在创建Handler时,是要传入线程的Looper进行绑定的,所以必须先执行HandlerThread的start方法,因为执行start方法,才会执行HandlerThread的run方法,才会创建线程的Looper,创建Handler传入的Looper才不会是null。 所以我们一般使用是这样的: 创建HandlerThread后,调用start,然后再创建Handler; 从run方法里我们看到有个onLooperPrepared()方法,可以实现这个方法,在这个方法里创建Handler,这样就不受start位置的限制了,原理就是以为run方法是在调用start方法后才会执行。 那么怎么回收一个HandlerThread呢?我们看到HandlerThread里有个quit方法,这个方法最终会调用到MessageQueue的quit方法,从而结束消息分发,最终终止一个HandlerThread线程。 public boolean quit() { Looper looper = getLooper(); if (looper != null) { looper.quit(); return true; } return false; } 三、Handler应用之IntentService IntentService其实是Service和HandlerThread的结合体,我们可以看到在onCreate里创建了个HandlerThread并创建了个Handler和该HandlerThread绑定,然后在onStat方法里以消息的形式发送给HandlerThread执行 @Override public void onCreate() { // TODO: It would be nice to have an option to hold a partial wakelock // during processing, and to have a static startService(Context, Intent) // method that would launch the service & hand off a wakelock. super.onCreate(); // 创建HandlerThread HandlerThread thread = new HandlerThread("IntentService[" + mName + "]"); thread.start(); // 创建Handler和HandlerThread绑定 mServiceLooper = thread.getLooper(); mServiceHandler = new ServiceHandler(mServiceLooper); } @Override public void onStart(@Nullable Intent intent, int startId) { Message msg = mServiceHandler.obtainMessage(); msg.arg1 = startId; msg.obj = intent; // 想HandlerThread的消息队列发送消息 mServiceHandler.sendMessage(msg); } 最终在handleMessage里执行 private final class ServiceHandler extends Handler { public ServiceHandler(Looper looper) { super(looper); } @Override public void handleMessage(Message msg) { onHandleIntent((Intent)msg.obj); stopSelf(msg.arg1); } } 所以我们使用IntentService都必须实现onHandleIntent这个抽象方法,在这个抽象方法里做具体的业务操作。 我们都知道IntentService在执行完异步任务后,会自动销毁,这是怎么实现的? public ServiceHandler(Looper looper) { super(looper); } @Override public void handleMessage(Message msg) { onHandleIntent((Intent)msg.obj); // 答案在这里:在这里会停止Service stopSelf(msg.arg1); } } // 然后在onDestory里会终止掉消息循环,从而达到销毁异步线程的目的: @Override public void onDestroy() { mServiceLooper.quit(); } 四、Handler.post和View.post 我们先来看个大家平常经常使用的案例:获取View的宽高。 @Override protected void onCreate(Bundle savedInstanceState) { // 位置1 Log.i("view_w_&_h", "onCreate " + mView.getWidth() + " " + mView.getHeight()); mView.post(new Runnable() { @Override public void run() { // 位置2 Log.i("view_w_&_h", "onCreate postRun " + mView.getWidth() + " " + mView.getHeight()); } }); new Handler(Looper.getMainLooper()).post(new Runnable() { @Override public void run() { // 位置3 Log.i("view_w_&_h", "onCreate Handler " + mView.getWidth() + " " + mView.getHeight()); } }); } @Override protected void onResume() { super.onResume(); // 位置4 Log.i("view_w_&_h", "onResume " + mView.getWidth() + " " + mView.getHeight()); new Handler(Looper.getMainLooper()).post(new Runnable() { @Override public void run() { // 位置5 Log.i("view_w_&_h", "onResume Handler " + mView.getWidth() + " " + mView.getHeight()); } }); } 这几个位置,哪些能获取到mView的宽高? 我们都知道在View被attach到window之前,是获取不到View的宽高的,因为这个时候View还没有被Measure、layout、draw,所以在onCreate或者onResume直接调用View的宽高方法,都是0,Handler.post在onCreate里也是获取不到,但是在onResume里能获取到,而View.post无论放在onCreate或者onResume里,都能获取到View的宽高,为什么? 我们先看个简版的View的绘制流程: 我们都知道View的最终绘制是在performTraversals()方法里,包括measure、layout、draw,从上面的图往上追溯,我们知道,View的绘制是在ActivityThread的handleResumeActivity方法里,这个方法相信大家不会陌生,这个方法就是会回调Activity的onResume方法的顶级方法。 final void handleResumeActivity(IBinder token, boolean clearHide, boolean isForward, boolean reallyResume, int seq, String reason) { ... // 这里追溯进去,最终会调用Activity的onStart方法和onResume方法 r = performResumeActivity(token, clearHide, reason); ... // 调用WindowManager的addView方法,这里就是最终执行View绘制的地方 wm.addView(decor, l); ... } 从上面的代码片段执行顺序来看,Activity的onStart和onResume被执行的时候,其实界面还没有开始进行绘制(wm.addView(decor, l)还没执行到),这里就可以解释为什么用Handler.post在onCreate里拿不到宽高。因为Handler机制,它是把消息推送到主线程的消息队列里去,在onCreate里把消息推到消息队列时,onResume的消息都还没入队,也就没有执行,所以拿不到。那为什么onResume里能拿到呢?因为消息队列的机制,Handler.post推送的消息,必须得等上一个消息执行完才能得到执行,所以它必须得等handleResumeActivity执行完,而handleResumeActivity执行完成后,View已经绘制完成了,当然就能拿到宽高了。 好了,现在解释第二个疑问,为什么View.post在onCreate里能拿到View的宽高呢?我们先看下View.post方法: public boolean post(Runnable action) { final AttachInfo attachInfo = mAttachInfo; // attachInfo不为null,说明View已经被attach到window,也就是完成了绘制,所以直接把消息推送到主线程的消息队列执行。 if (attachInfo != null) { return attachInfo.mHandler.post(action); } // Postpone the runnable until we know on which thread it needs to run. // Assume that the runnable will be successfully placed after attach. // 关键就在这里,走到这里,说明attachInfo为null,也就是现在View还没attach到window,所以把消息临时保存到RunQueue里 getRunQueue().post(action); return true; } 上面我们可以看到,如果attachInfo为null,则Runnable会临时存储起来,保存到RunQueue里,并没有立即执行,那么保存到RunQueue是什么时候被执行的呢? 我们看到HandlerActionQueue有个executeActions方法,这个方法就是用来执行保存其中的Runnable的: public void executeActions(Handler handler) { synchronized (this) { final HandlerAction[] actions = mActions; for (int i = 0, count = mCount; i < count; i++) { final HandlerAction handlerAction = actions[i]; handler.postDelayed(handlerAction.action, handlerAction.delay); } mActions = null; mCount = 0; } } 那么这个方法是在什么时机调用的呢?接着往下看:在View的dispatchAttachedToWindow方法里,我们看到调用了RunQueue的executeActions,执行保存在RunQueue里的runnable。 void dispatchAttachedToWindow(AttachInfo info, int visibility) { ... // Transfer all pending runnables. if (mRunQueue != null) { mRunQueue.executeActions(info.mHandler); mRunQueue = null; } onAttachedToWindow(); ... } 那么dispatchAttachedToWindow又是在什么时候被调用呢?在ViewRootImpl的performTraversals方法里,我们看到dispatchAttachedToWindow被执行。host就是DecorView。 private void performTraversals() { ... host.dispatchAttachedToWindow(mAttachInfo, 0); ... performMeasure(); ... performLayout(); ... performDraw(); } 从前面的View绘制的UML时序图,我们知道,performTraversals是在ActivityThread的handleResumeActivity被调用的。 总结一下: 系统在执行ActivityThread的handleResumeActivity的方法里,最终会调到ViewRootImpl的performTraversals()方法,performTraversals()方法调用host的dispatchAttachedToWindow()方法,host就是DecorView也就是View,接着在View的dispatchAttachedToWindow()方法中调用mRunQueue.executeActions()方法,这个方法内部会遍历HandlerAction数组,利用Handler来post之前存放的Runnable。 这里就可以解释为什么View.post在onCreate里同样可以得到View的宽高,是因为View.post发出的消息,它被执行的时机是在View被绘制之后。 ==可能有同学要问了:dispatchAttachedToWindow 方法是在 performMeasure 方法之前调用的,既然在调用的时候还没有执行performMeasure来进行测量,那么为什么在执行完dispatchAttachedToWindow方法后就可以获取到宽高呢?== 还是回到Handler机制最基本的原理,消息是以队列的形式存在消息队列里,然后依次等待Loop执行的,而performTraversals的执行它本身就是在一个Runnable消息里,所以performTraversals在执行的时候,其他消息得等performTraversals执行完了才能得到执行,也就是说mRunQueue.executeActions()的消息必须得等performTraversals彻底执行完才能得到执行,所以View.post(runnable)中的runnable执行是要在performTraversals方法执行完之后的,并非一调用dispatchAttachedToWindow就会执行。 前面还遗留了一个问题:View.post方法里的mAttachInfo是在什么时候赋值的呢? public ViewRootImpl(Context context, Display display) { ... mAttachInfo = new View.AttachInfo(mWindowSession, mWindow, display, this, mHandler, this, context); ... } 我们看到它是在ViewRootImpl的构造函数里被赋值的,那么ViewRootImpl是什么时候被创建的呢?顺着往上找,我们看到,它是在WindowManagerGlobal的add方法里被创建的。 public void addView(View view, ViewGroup.LayoutParams params, Display display, Window parentWindow) { ... ViewRootImpl root; ... root = new ViewRootImpl(view.getContext(), display); ... } 前面也讲了WindowManagerGlobal的addView方法是在ActivityThread的handleResumeActivity()方法里被执行的,所以问题就解开了,为什么View.post方法里会先判断mAttachInfo是否为空,不为空,说明View.post的调用时机是在onResume之后,也就是View绘制完成之后,这个时候直接推入主线程消息队列执行就可以。而如果mAttachInfo为空,说明View还没绘制完,先暂存起来,待绘制完后再依次推入主线程执行。 要注意的是View.post方法是有坑的,android版本 < 24,也就是7.0以下的系统。 // 7.0以下系统 public boolean post(Runnable action) { final AttachInfo attachInfo = mAttachInfo; if (attachInfo != null) { return attachInfo.mHandler.post(action); } // Assume that post will succeed later // 注意此处,不同于我7.0及以上系统, ViewRootImpl.getRunQueue().post(action); return true; } 而我们看一下 ViewRootImpl 的RunQueue是怎么实现的: static final ThreadLocal<RunQueue> sRunQueues = new ThreadLocal<RunQueue>(); static RunQueue getRunQueue() { RunQueue rq = sRunQueues.get(); if (rq != null) { return rq; } rq = new RunQueue(); sRunQueues.set(rq); return rq; } 结合前面讲的ThreadLocal特性,它是跟线程相关的,也就是说保存其中的变量只在本线程内可见,其他线程获取不到。 好了,假设有这种场景,我们子线程里用View.post一个消息,从上面的代码看,它会保存子线程的ThreadLocal里,但是在执行RunQueue的时候,又是在主线程里去找runnable调用,因为ThreadLocal线程隔离,主线程永远也找不到这个消息,这个消息也就没法得到执行了。 而7.0及以上没有这个问题,是因为在post方法里把runnable保存在主线程里:getRunQueue().post(action)。 总结一下: 上面这个问题的前提有两个:View被绘制前,且在子线程里调用View.post。如果View.post是在View被绘制之后,也就是mAttachInfo非空,那么会立即推入主线程调用,也就不存在因线程隔离找不到runnable的问题。 作者:He Ying

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册