首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

物联网数据库 IoTDB 解析

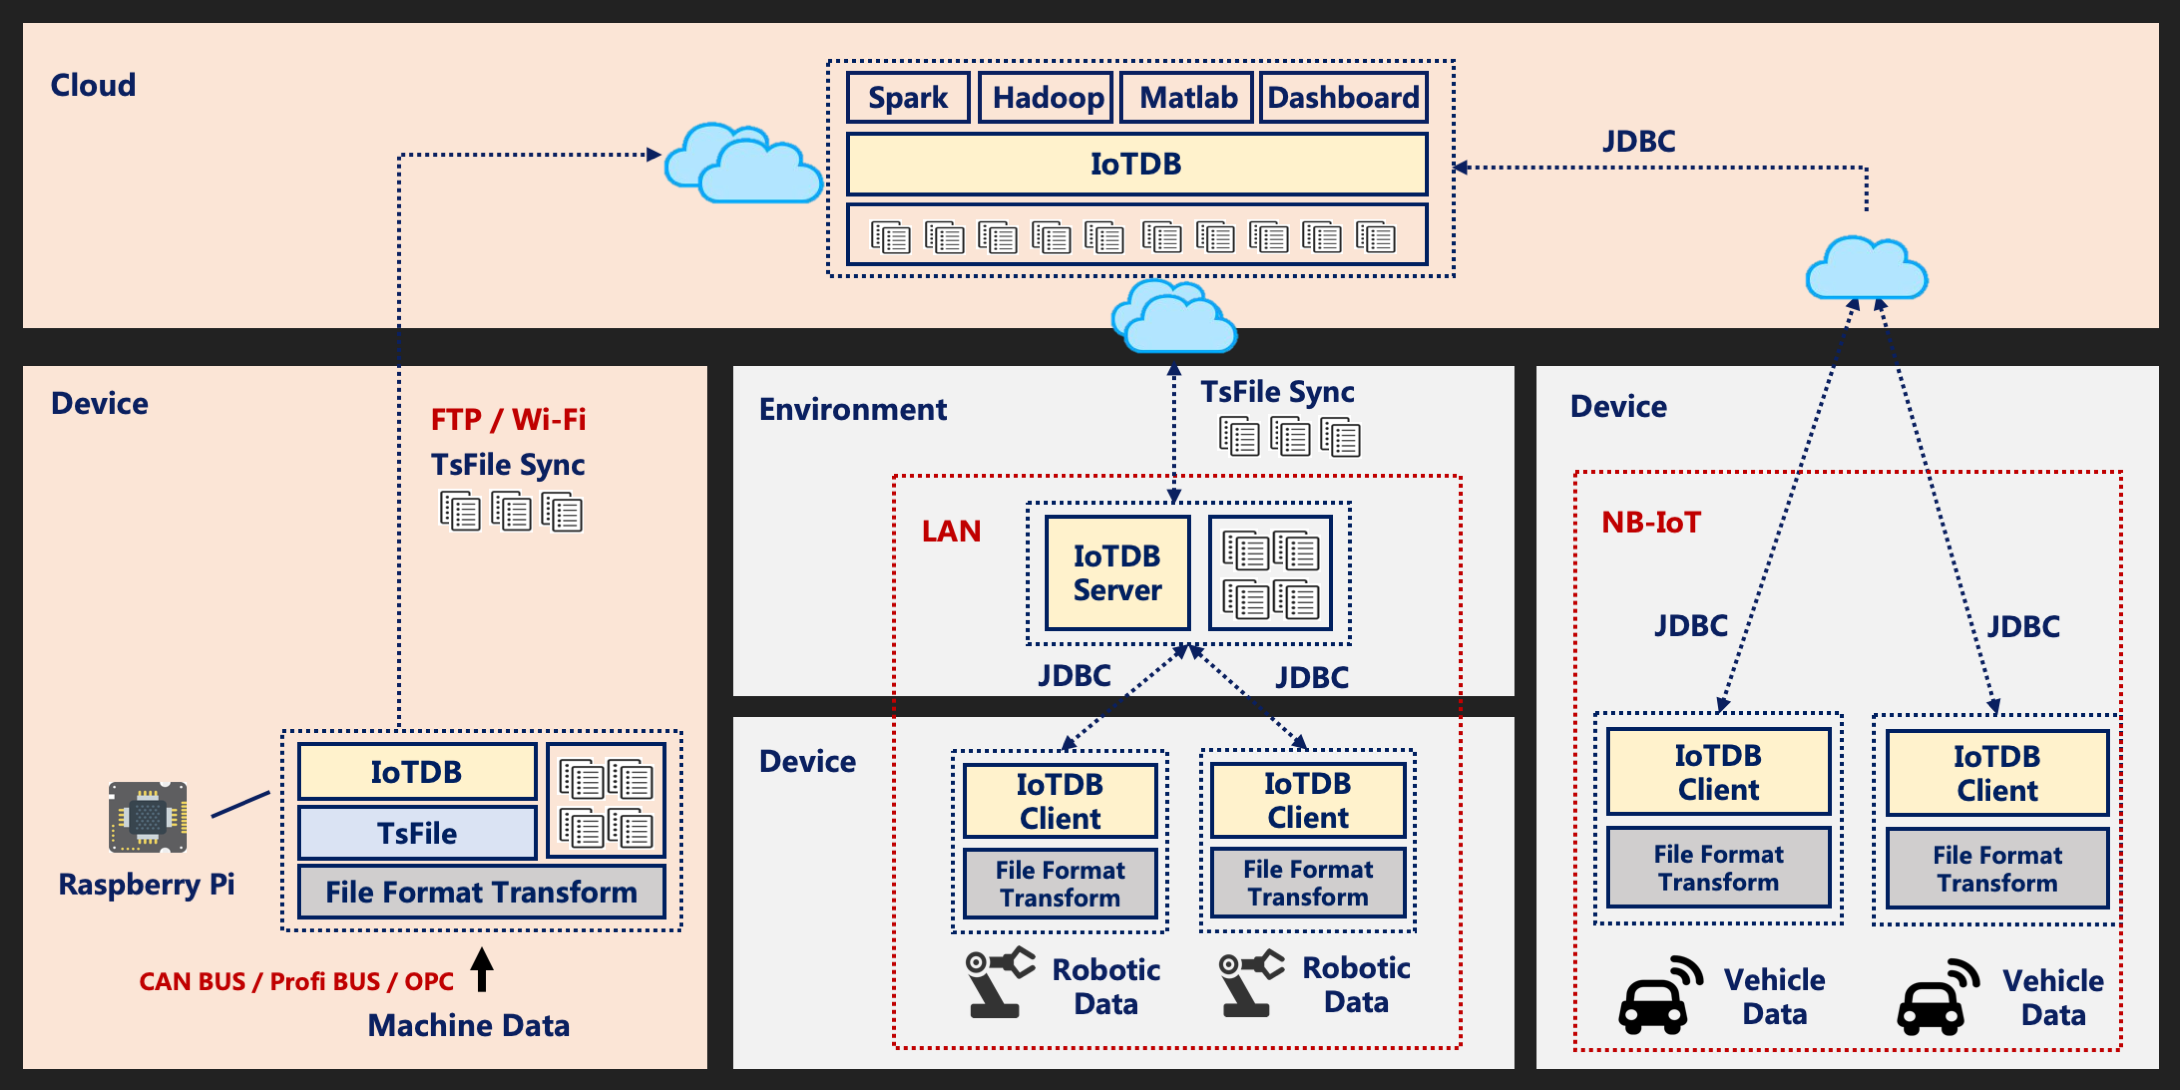
Apache IoTDB 是专为物联网时序数据打造的数据库,提供数据采集、存储、分析的功能。IoTDB 提供端云一体化的解决方案,在云端,提供高性能的数据读写以及丰富的查询能力,针对物联网场景定制高效的目录组织结构,并与 Apache Hadoop、Spark、Flink 等大数据系统无缝打通;在边缘端,提供轻量化的 TsFile 管理能力,端上的数据写到本地 TsFile,并提供一定的基础查询能力,同时支持将 TsFile 数据同步到云端。 TsFile TsFile 是为物联网设备时序数据存储定制的文件格式,整体以树状目录结构组织,一个 TsFile 里可存储多个设备的数据,每个设备包含多个 measurment(指标)。如下图,TsFile 里包含两个设备数据,标识分别为 d1、d2;每个设备包含 s1、s2、s3 三个监测指标

优秀的个人博客,低调大师

深入并发锁,解析Synchronized锁升级

这篇文章分为六个部分,不同特性的锁分类,并发锁的不同设计,Synchronized中的锁升级,ReentrantLock和ReadWriteLock的应用,帮助你梳理 Java 并发锁及相关的操作。 一、锁有哪些分类 一般我们提到的锁有以下这些: 乐观锁/悲观锁 公平锁/非公平锁 可重入锁 独享锁/共享锁 互斥锁/读写锁 分段锁 偏向锁/轻量级锁/重量级锁 自旋锁 上面是很多锁的名词,这些分类并不是全是指锁的状态,有的指锁的特性,有的指锁的设计,下面分别说明。 1、乐观锁 VS 悲观锁 乐观锁与悲观锁是一种广义上的概念,体现了看待线程同步的不同角度,在Java和数据库中都有此概念对应的实际应用。 (1)乐观锁 顾名思义,就是很乐观,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。 乐观锁适用于多读的应用类型,乐观锁在Java中是通过使用无锁编程来实现,最常采用的是CAS算法,Java原子类中的递增操作就通过CAS自旋实现的。 CAS全称 Compare And Swap(比较与交换),是一种无锁算法。在不使用锁(没有线程被阻塞)的情况下实现多线程之间的变量同步。java.util.concurrent包中的原子类就是通过CAS来实现了乐观锁。 简单来说,CAS算法有3个三个操作数: 需要读写的内存值 V。 进行比较的值 A。 要写入的新值 B。 当且仅当预期值A和内存值V相同时,将内存值V修改为B,否则返回V。这是一种乐观锁的思路,它相信在它修改之前,没有其它线程去修改它;而Synchronized是一种悲观锁,它认为在它修改之前,一定会有其它线程去修改它,悲观锁效率很低。 (2)悲观锁 总是假设最坏的情况,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会阻塞直到它拿到锁。 传统的MySQL关系型数据库里边就用到了很多这种锁机制,比如行锁,表锁等,读锁,写锁等,都是在做操作之前先上锁。 悲观锁适合写操作多的场景,先加锁可以保证写操作时数据正确。 乐观锁适合读操作多的场景,不加锁的特点能够使其读操作的性能大幅提升。 2、公平锁 VS 非公平锁 (1)公平锁 就是很公平,在并发环境中,每个线程在获取锁时会先查看此锁维护的等待队列,如果为空,或者当前线程是等待队列的第一个,就占有锁,否则就会加入到等待队列中,以后会按照FIFO的规则从队列中取到自己。 公平锁的优点是等待锁的线程不会饿死。缺点是整体吞吐效率相对非公平锁要低,等待队列中除第一个线程以外的所有线程都会阻塞,CPU唤醒阻塞线程的开销比非公平锁大。 (2)非公平锁 上来就直接尝试占有锁,如果尝试失败,就再采用类似公平锁那种方式。 非公平锁的优点是可以减少唤起线程的开销,整体的吞吐效率高,因为线程有几率不阻塞直接获得锁,CPU不必唤醒所有线程。缺点是处于等待队列中的线程可能会饿死,或者等很久才会获得锁。 (3)典型应用 java jdk并发包中的ReentrantLock可以指定构造函数的boolean类型来创建公平锁和非公平锁(默认),比如:公平锁可以使用new ReentrantLock(true)实现。 3、独享锁 VS 共享锁 (1)独享锁 是指该锁一次只能被一个线程所持有。 (2)共享锁 是指该锁可被多个线程所持有。 对于Java ReentrantLock而言,其是独享锁。但是对于Lock的另一个实现类ReadWriteLock,其读锁是共享锁,其写锁是独享锁。 读锁的共享锁可保证并发读是非常高效的,读写,写读 ,写写的过程是互斥的。 独享锁与共享锁也是通过AQS来实现的,通过实现不同的方法,来实现独享或者共享。 (3)AQS 抽象队列同步器(AbstractQueuedSynchronizer,简称AQS)是用来构建锁或者其他同步组件的基础框架,它使用一个整型的volatile变量(命名为state)来维护同步状态,通过内置的FIFO队列来完成资源获取线程的排队工作。 concurrent包的实现结构如上图所示,AQS、非阻塞数据结构和原子变量类等基础类都是基于volatile变量的读/写和CAS实现,而像Lock、同步器、阻塞队列、Executor和并发容器等高层类又是基于基础类实现。 4、互斥锁 VS 读写锁 相交进程之间的关系主要有两种,同步与互斥。所谓互斥,是指散布在不同进程之间的若干程序片断,当某个进程运行其中一个程序片段时,其它进程就不能运行它们之中的任一程序片段,只能等到该进程运行完这个程序片段后才可以运行。所谓同步,是指散布在不同进程之间的若干程序片断,它们的运行必须严格按照规定的某种先后次序来运行,这种先后次序依赖于要完成的特定的任务。 显然,同步是一种更为复杂的互斥,而互斥是一种特殊的同步。也就是说互斥是两个线程之间不可以同时运行,他们会相互排斥,必须等待一个线程运行完毕,另一个才能运行,而同步也是不能同时运行,但他是必须要安照某种次序来运行相应的线程(也是一种互斥)! 总结:互斥:是指某一资源同时只允许一个访问者对其进行访问,具有唯一性和排它性。但互斥无法限制访问者对资源的访问顺序,即访问是无序的。 同步:是指在互斥的基础上(大多数情况),通过其它机制实现访问者对资源的有序访问。在大多数情况下,同步已经实现了互斥,特别是所有写入资源的情况必定是互斥的。少数情况是指可以允许多个访问者同时访问资源。 (1)互斥锁 在访问共享资源之前对进行加锁操作,在访问完成之后进行解锁操作。 加锁后,任何其他试图再次加锁的线程会被阻塞,直到当前进程解锁。 如果解锁时有一个以上的线程阻塞,那么所有该锁上的线程都被编程就绪状态, 第一个变为就绪状态的线程又执行加锁操作,那么其他的线程又会进入等待。 在这种方式下,只有一个线程能够访问被互斥锁保护的资源 (2)读写锁 这个时候读写锁就应运而生了,读写锁是一种通用技术,并不是Java特有的。 读写锁特点: 多个读者可以同时进行读 写者必须互斥(只允许一个写者写,也不能读者写者同时进行) 写者优先于读者(一旦有写者,则后续读者必须等待,唤醒时优先考虑写者) 互斥锁特点: 一次只能一个线程拥有互斥锁,其他线程只有等待 (3)Linux的读写锁 Linux内核也支持读写锁。 互斥锁 pthread_mutex_init() pthread_mutex_lock() pthread_mutex_unlock() 读写锁 pthread_rwlock_init() pthread_rwlock_rdlock() pthread_rwlock_wrlock() pthread_rwlock_unlock() 条件变量 pthread_cond_init() pthread_cond_wait() pthread_cond_signal() 5、自旋锁 自旋锁(spinlock):是指当一个线程在获取锁的时候,如果锁已经被其它线程获取,那么该线程将循环等待,然后不断的判断锁是否能够被成功获取,直到获取到锁才会退出循环。 在Java中,自旋锁是指尝试获取锁的线程不会立即阻塞,而是采用循环的方式去尝试获取锁,这样的好处是减少线程上下文切换的消耗,缺点是循环会消耗CPU。典型的自旋锁实现的例子,可以参考自旋锁的实现 它是为实现保护共享资源而提出一种锁机制。其实,自旋锁与互斥锁比较类似,它们都是为了解决对某项资源的互斥使用。无论是互斥锁,还是自旋锁,在任何时刻,最多只能有一个保持者,也就说,在任何时刻最多只能有一个执行单元获得锁。但是两者在调度机制上略有不同。对于互斥锁,如果资源已经被占用,资源申请者只能进入睡眠状态。 但是自旋锁不会引起调用者睡眠,如果自旋锁已经被别的执行单元保持,调用者就一直循环在那里看是否该自旋锁的保持者已经释放了锁,”自旋”一词就是因此而得名。 (1)Java如何实现自旋锁? 下面是个简单的例子: public class SpinLock { private AtomicReference<Thread> cas = new AtomicReference<Thread>(); public void lock() { Thread current = Thread.currentThread(); // 利用CAS while (!cas.compareAndSet(null, current)) { // DO nothing } } public void unlock() { Thread current = Thread.currentThread(); cas.compareAndSet(current, null); } } lock()方法利用的CAS,当第一个线程A获取锁的时候,能够成功获取到,不会进入while循环,如果此时线程A没有释放锁,另一个线程B又来获取锁,此时由于不满足CAS,所以就会进入while循环,不断判断是否满足CAS,直到A线程调用unlock方法释放了该锁。 (2)自旋锁存在的问题 如果某个线程持有锁的时间过长,就会导致其它等待获取锁的线程进入循环等待,消耗CPU。使用不当会造成CPU使用率极高。 上面Java实现的自旋锁不是公平的,即无法满足等待时间最长的线程优先获取锁。不公平的锁就会存在“线程饥饿”问题。 (3)自旋锁的优点 自旋锁不会使线程状态发生切换,一直处于用户态,即线程一直都是active的;不会使线程进入阻塞状态,减少了不必要的上下文切换,执行速度快 非自旋锁在获取不到锁的时候会进入阻塞状态,从而进入内核态,当获取到锁的时候需要从内核态恢复,需要线程上下文切换。 (线程被阻塞后便进入内核(Linux)调度状态,这个会导致系统在用户态与内核态之间来回切换,严重影响锁的性能) 二、并发锁的不同设计方式 根据所锁的设计方式和应用,有分段锁,读写锁等。 1、分段锁技术,并发锁的一种设计方案 分段锁其实是一种锁的设计,并不是具体的一种锁,对于ConcurrentHashMap而言,其并发的实现就是通过分段锁的形式来实现高效的并发操作。 以ConcurrentHashMap来说一下分段锁的含义以及设计思想,ConcurrentHashMap中的分段锁称为Segment,它即类似于HashMap(JDK7与JDK8中HashMap的实现)的结构,即内部拥有一个Entry数组,数组中的每个元素又是一个链表;同时又是一个ReentrantLock(Segment继承了ReentrantLock)。 当需要put元素的时候,并不是对整个hashmap进行加锁,而是先通过hashcode来知道他要放在那一个分段中,然后对这个分段进行加锁,所以当多线程put的时候,只要不是放在一个分段中,就实现了真正的并行的插入。 但是,在统计size的时候,可就是获取hashmap全局信息的时候,就需要获取所有的分段锁才能统计。 分段锁的设计目的是细化锁的粒度,当操作不需要更新整个数组的时候,就仅仅针对数组中的一项进行加锁操作。 2、锁消除和锁膨胀(粗化) 锁消除,如无必要,不要使用锁。Java 虚拟机也可以根据逃逸分析判断出加锁的代码是否线程安全,如果确认线程安全虚拟机会进行锁消除提高效率。 锁粗化。如果一段代码需要使用多个锁,建议使用一把范围更大的锁来提高执行效率。Java 虚拟机也会进行优化,如果发现同一个对象锁有一系列的加锁解锁操作,虚拟机会进行锁粗化来降低锁的耗时。 3、轮询锁与定时锁 轮询锁是通过线程不断尝试获取锁来实现的,可以避免发生死锁,可以更好地处理错误场景。Java 中可以通过调用锁的 tryLock 方法来进行轮询。tryLock 方法还提供了一种支持定时的实现,可以通过参数指定获取锁的等待时间。如果可以立即获取锁那就立即返回,否则等待一段时间后返回。 4、读写锁 读写锁 ReadWriteLock 可以优雅地实现对资源的访问控制,具体实现为 ReentrantReadWriteLock。读写锁提供了读锁和写锁两把锁,在读数据时使用读锁,在写数据时使用写锁。 读写锁允许有多个读操作同时进行,但只允许有一个写操作执行。如果写锁没有加锁,则读锁不会阻塞,否则需要等待写入完成。 ReadWriteLock lock = new ReentrantReadWriteLock(); Lock readLock = lock.readLock(); Lock writeLock = lock.writeLock(); 三、synchronized中的锁 synchronized 代码块是由一对儿 monitorenter/monitorexit 指令实现的,Monitor 对象是同步的基本实现单元。 在 Java 6 之前,Monitor 的实现完全是依靠操作系统内部的互斥锁,因为需要进行用户态到内核态的切换,所以同步操作是一个无差别的重量级操作。现代的(Oracle)JDK 中,JVM 对此进行了大刀阔斧地改进,提供了三种不同的 Monitor 实现,也就是常说的三种不同的锁:偏斜锁(Biased Locking)、轻量级锁和重量级锁,大大改进了其性能。 1、synchronized中锁的状态 锁的状态是通过对象监视器在对象头中的字段来表明的。四种状态会随着竞争的情况逐渐升级,而且是不可逆的过程,即不可降级。这四种状态都不是Java语言中的锁,而是Jvm为了提高锁的获取与释放效率而做的优化(使用synchronized时)。 无锁状态 偏向锁状态 轻量级锁状态 重量级锁状态 2、偏向锁、轻量级锁、重量级锁 这三种锁是指锁的状态,并且是针对Synchronized。在Java 5通过引入锁升级的机制来实现高效Synchronized。这三种锁的状态是通过对象监视器在对象头中的字段来表明的。 偏向锁是指一段同步代码一直被一个线程所访问,那么该线程会自动获取锁。降低获取锁的代价。轻量级锁是指当锁是偏向锁的时候,被另一个线程所访问,偏向锁就会升级为轻量级锁,其他线程会通过自旋的形式尝试获取锁,不会阻塞,提高性能。 重量级锁是指当锁为轻量级锁的时候,另一个线程虽然是自旋,但自旋不会一直持续下去,当自旋一定次数的时候,还没有获取到锁,就会进入阻塞,该锁膨胀为重量级锁。重量级锁会让其他申请的线程进入阻塞,性能降低。 3、synchronized的锁升级 所谓锁的升级、降级,就是 JVM 优化 synchronized 运行的机制,当 JVM 检测到不同的竞争状况时,会自动切换到适合的锁实现,这种切换就是锁的升级、降级。 当没有竞争出现时,默认会使用偏斜锁。JVM 会利用 CAS 操作(compare and swap),在对象头上的 Mark Word 部分设置线程 ID,以表示这个对象偏向于当前线程,所以并不涉及真正的互斥锁。这样做的假设是基于在很多应用场景中,大部分对象生命周期中最多会被一个线程锁定,使用偏斜锁可以降低无竞争开销。 如果有另外的线程试图锁定某个已经被偏斜过的对象,JVM 就需要撤销(revoke)偏斜锁,并切换到轻量级锁实现。轻量级锁依赖 CAS 操作 Mark Word 来试图获取锁,如果重试成功,就使用普通的轻量级锁;否则,进一步升级为重量级锁。 四、看下ReentrantLock ReentrantLock,一个可重入的互斥锁,它具有与使用synchronized方法和语句所访问的隐式监视器锁相同的一些基本行为和语义,但功能更强大。 1、基本用法 public class LockTest { private Lock lock = new ReentrantLock(); public void testMethod() { lock.lock(); for (int i = 0; i < 5; i++) { System.out.println("ThreadName=" + Thread.currentThread().getName() + (" " + (i + 1))); } lock.unlock(); } } 2、Condition应用 synchronized与wait()和nitofy()/notifyAll()方法相结合可以实现等待/通知模型,ReentrantLock同样可以,但是需要借助Condition,且Condition有更好的灵活性,具体体现在: 一个Lock里面可以创建多个Condition实例,实现多路通知 notify()方法进行通知时,被通知的线程时Java虚拟机随机选择的,但是ReentrantLock结合Condition可以实现有选择性地通知,这是非常重要的 3、Condition类和Object类 Condition类的awiat方法和Object类的wait方法等效 Condition类的signal方法和Object类的notify方法等效 Condition类的signalAll方法和Object类的notifyAll方法等效 五、再看下ReadWriteLock 在并发场景中用于解决线程安全的问题,我们几乎会高频率的使用到独占式锁,通常使用java提供的关键字synchronized(关于synchronized可以看这篇文章)或者concurrents包中实现了Lock接口的ReentrantLock。 它们都是独占式获取锁,也就是在同一时刻只有一个线程能够获取锁。而在一些业务场景中,大部分只是读数据,写数据很少,如果仅仅是读数据的话并不会影响数据正确性(出现脏读),而如果在这种业务场景下,依然使用独占锁的话,很显然这将是出现性能瓶颈的地方。 针对这种读多写少的情况,java还提供了另外一个实现Lock接口的ReentrantReadWriteLock(读写锁)。读写所允许同一时刻被多个读线程访问,但是在写线程访问时,所有的读线程和其他的写线程都会被阻塞。 1、ReadWriteLock接口 ReadWriteLock,顾明思义,读写锁在读的时候,上读锁,在写的时候,上写锁,这样就很巧妙的解决synchronized的一个性能问题:读与读之间互斥。 ReadWriteLock也是一个接口,原型如下: public interface ReadWriteLock { Lock readLock(); Lock writeLock(); } 该接口只有两个方法,读锁和写锁。 也就是说,我们在写文件的时候,可以将读和写分开,分成2个锁来分配给线程,从而可以做到读和读互不影响,读和写互斥,写和写互斥,提高读写文件的效率。 2、ReentrantReadWriteLock应用 下面的实例参考《Java并发编程的艺术》,使用读写锁实现一个缓存。 import java.util.HashMap; import java.util.Map; import java.util.concurrent.locks.Lock; import java.util.concurrent.locks.ReentrantReadWriteLock; public class Cache { static Map<String,Object> map = new HashMap<String, Object>(); static ReentrantReadWriteLock readWriteLock = new ReentrantReadWriteLock(); static Lock readLock = readWriteLock.readLock(); static Lock writeLock = readWriteLock.writeLock(); public static final Object getByKey(String key){ readLock.lock(); try{ return map.get(key); }finally{ readLock.unlock(); } } public static final Object getMap(){ readLock.lock(); try{ return map; }finally{ readLock.unlock(); } } public static final Object put(String key,Object value){ writeLock.lock(); try{ return map.put(key, value); }finally{ writeLock.unlock(); } } public static final Object remove(String key){ writeLock.lock(); try{ return map.remove(key); }finally{ writeLock.unlock(); } } public static final void clear(){ writeLock.lock(); try{ map.clear(); }finally{ writeLock.unlock(); } } public static void main(String[] args) { List<Thread> threadList = new ArrayList<Thread>(); for(int i =0;i<6;i++){ Thread thread = new PutThread(); threadList.add(thread); } for(Thread thread : threadList){ thread.start(); } put("ji","ji"); System.out.println(getMap()); } private static class PutThread extends Thread{ public void run(){ put(Thread.currentThread().getName(),Thread.currentThread().getName()); } } } 3、读写锁的锁降级 读写锁支持锁降级,遵循按照获取写锁,获取读锁再释放写锁的次序,写锁能够降级成为读锁,不支持锁升级,关于锁降级下面的示例代码摘自ReentrantWriteReadLock源码中: void processCachedData() { rwl.readLock().lock(); if (!cacheValid) { // Must release read lock before acquiring write lock rwl.readLock().unlock(); rwl.writeLock().lock(); try { // Recheck state because another thread might have // acquired write lock and changed state before we did. if (!cacheValid) { data = ... cacheValid = true; } // Downgrade by acquiring read lock before releasing write lock rwl.readLock().lock(); } finally { rwl.writeLock().unlock(); // Unlock write, still hold read } } try { use(data); } finally { rwl.readLock().unlock(); } } }

优秀的个人博客,低调大师

Prometheus-operator 介绍和配置解析

随着云原生概念盛行,对于容器、服务、节点以及集群的监控变得越来越重要。Prometheus 作为 Kubernetes 监控的事实标准,有着强大的功能和良好的生态。但是它不支持分布式,不支持数据导入、导出,不支持通过 API 修改监控目标和报警规则,所以在使用它时,通常需要写脚本和代码来简化操作。Prometheus Operator 为监控 Kubernetes service、deployment 和 Prometheus 实例的管理提供了简单的定义,简化在 Kubernetes 上部署、管理和运行 Prometheus 和 Alertmanager 集群。 功能 Prometheus Operator (后面都简称 Operater) 提供如下功能: 创建/销毁:在 Kubernetes namespace 中更加容易地启动一个 Prometheues 实例,一个特定应用程序或者团队可以更容易使用 Operator。 便捷配置:通过 Kubernetes 资源配置 Prometheus 的基本信息,比如版本、存储、副本集等。 通过标签标记目标服务: 基于常见的 Kubernetes label 查询自动生成监控目标配置;不需要学习 Prometheus 特定的配置语言。 先决条件 对于版本高于 0.18.0 的 Prometheus Operator 要求 Kubernetes 集群版本高于 1.8.0。如果你才开始使用 Prometheus Operator,推荐你使用最新版。 如果你使用的旧版本的 Kubernetes 和 Prometheus Operator 还在运行,推荐先升级 Kubernetes,再升级 Prometheus Operator。 安装与卸载 快速安装 使用 helm 安装 Prometheus Operator。使用 helm 安装后,会在 Kubernetes 集群中创建、配置和管理 Prometheus 集群,chart 中包含多种组件: prometheus-operator prometheus alertmanager node-exporter kube-state-metrics grafana 收集 Kubernetes 内部组件指标的监控服务 kube-apiserver kube-scheduler kube-controller-manager etcd kube-dns/coredns kube-proxy 安装一个版本名为 my-release 的 chart: helm install --name my-release stable/prometheus-operator 这会在集群中安装一个默认配置的 prometheus-operator。这份配置文件列出了安装过程中可以配置的选项。 默认会安装 Prometheus Operator, Alertmanager, Grafana。并且会抓取集群的基本信息。 卸载 卸载 my-release 部署: helm delete my-release 这个命令会删除与这个 chart 相关的所有 Kubernetes 组件。 这个 chart 创建的 CRDs 不会被默认删除,需要手动删除: kubectl delete crd prometheuses.monitoring.coreos.com kubectl delete crd prometheusrules.monitoring.coreos.com kubectl delete crd servicemonitors.monitoring.coreos.com kubectl delete crd podmonitors.monitoring.coreos.com kubectl delete crd alertmanagers.monitoring.coreos.com 架构 Prometheus Operator 架构图如下: 上面架构图中,各组件以不同的方式运行在 Kubernetes 集群中: Operator: 根据自定义资源(Custom Resource Definition / CRDs)来部署和管理 Prometheus Server,同时监控这些自定义资源事件的变化来做相应的处理,是整个系统的控制中心。 Prometheus:声明 Prometheus deployment 期望的状态,Operator 确保这个 deployment 运行时一直与定义保持一致。 Prometheus Server: Operator 根据自定义资源 Prometheus 类型中定义的内容而部署的 Prometheus Server 集群,这些自定义资源可以看作是用来管理 Prometheus Server 集群的 StatefulSets 资源。 ServiceMonitor:声明指定监控的服务,描述了一组被 Prometheus 监控的目标列表。该资源通过 Labels 来选取对应的 Service Endpoint,让 Prometheus Server 通过选取的 Service 来获取 Metrics 信息。 Service:简单的说就是 Prometheus 监控的对象。 Alertmanager:定义 AlertManager deployment 期望的状态,Operator 确保这个 deployment 运行时一直与定义保持一致。 自定义资源 Prometheus Operater 定义了如下的四类自定义资源: Prometheus ServiceMonitor Alertmanager PrometheusRule Prometheus Prometheus 自定义资源(CRD)声明了在 Kubernetes 集群中运行的 Prometheus 的期望设置。包含了副本数量,持久化存储,以及 Prometheus 实例发送警告到的 Alertmanagers等配置选项。 每一个 Prometheus 资源,Operator 都会在相同 namespace 下部署成一个正确配置的 StatefulSet,Prometheus 的 Pod 都会挂载一个名为 <prometheus-name> 的 Secret,里面包含了 Prometheus 的配置。Operator 根据包含的 ServiceMonitor 生成配置,并且更新含有配置的 Secret。无论是对 ServiceMonitors 或者 Prometheus 的修改,都会持续不断的被按照前面的步骤更新。 一个样例配置如下: kind: Prometheus metadata: # 略 spec: alerting: alertmanagers: - name: prometheus-prometheus-oper-alertmanager # 定义该 Prometheus 对接的 Alertmanager 集群的名字, 在 default 这个 namespace 中 namespace: default pathPrefix: / port: web baseImage: quay.io/prometheus/prometheus replicas: 2 # 定义该 Proemtheus “集群”有两个副本,说是集群,其实 Prometheus 自身不带集群功能,这里只是起两个完全一样的 Prometheus 来避免单点故障 ruleSelector: # 定义这个 Prometheus 需要使用带有 prometheus=k8s 且 role=alert-rules 标签的 PrometheusRule matchLabels: prometheus: k8s role: alert-rules serviceMonitorNamespaceSelector: {} # 定义这些 Prometheus 在哪些 namespace 里寻找 ServiceMonitor serviceMonitorSelector: # 定义这个 Prometheus 需要使用带有 k8s-app=node-exporter 标签的 ServiceMonitor,不声明则会全部选中 matchLabels: k8s-app: node-exporter version: v2.10.0 Prometheus 配置 ServiceMonitor ServiceMonitor 自定义资源(CRD)能够声明如何监控一组动态服务的定义。它使用标签选择定义一组需要被监控的服务。这样就允许组织引入如何暴露 metrics 的规定,只要符合这些规定新服务就会被发现列入监控,而不需要重新配置系统。 要想使用 Prometheus Operator 监控 Kubernetes 集群中的应用,Endpoints 对象必须存在。Endpoints 对象本质是一个 IP 地址列表。通常,Endpoints 对象由 Service 构建。Service 对象通过对象选择器发现 Pod 并将它们添加到 Endpoints 对象中。 一个 Service 可以公开一个或多个服务端口,通常情况下,这些端口由指向一个 Pod 的多个 Endpoints 支持。这也反映在各自的 Endpoints 对象中。 Prometheus Operator 引入 ServiceMonitor 对象,它发现 Endpoints 对象并配置 Prometheus 去监控这些 Pods。 ServiceMonitorSpec 的 endpoints 部分用于配置需要收集 metrics 的 Endpoints 的端口和其他参数。在一些用例中会直接监控不在服务 endpoints 中的 pods 的端口。因此,在 endpoints 部分指定 endpoint 时,请严格使用,不要混淆。 注意:endpoints(小写)是 ServiceMonitor CRD 中的一个字段,而 Endpoints(大写)是 Kubernetes 资源类型。 ServiceMonitor 和发现的目标可能来自任何 namespace。这对于跨 namespace 的监控十分重要,比如 meta-monitoring。使用 PrometheusSpec 下 ServiceMonitorNamespaceSelector, 通过各自 Prometheus server 限制 ServiceMonitors 作用 namespece。使用 ServiceMonitorSpec 下的 namespaceSelector 可以现在允许发现 Endpoints 对象的命名空间。要发现所有命名空间下的目标,namespaceSelector 必须为空。 spec: namespaceSelector: any: true 一个样例配置如下: kind: ServiceMonitor metadata: labels: k8s-app: node-exporter # 这个 ServiceMonitor 对象带有 k8s-app=node-exporter 标签,因此会被 Prometheus 选中 name: node-exporter namespace: default spec: selector: matchLabels: # 定义需要监控的 Endpoints,带有 app=node-exporter 且 k8s-app=node-exporter标签的 Endpoints 会被选中 app: node-exporter k8s-app: node-exporter endpoints: - bearerTokenFile: /var/run/secrets/kubernetes.io/serviceaccount/token interval: 30s # 定义这些 Endpoints 需要每 30 秒抓取一次 targetPort: 9100 # 定义这些 Endpoints 的指标端口为 9100 scheme: https jobLabel: k8s-app ServiceMonitor 配置 Alertmanager Alertmanager 自定义资源(CRD)声明在 Kubernetes 集群中运行的 Alertmanager 的期望设置。它也提供了配置副本集和持久化存储的选项。 每一个 Alertmanager 资源,Operator 都会在相同 namespace 下部署成一个正确配置的 StatefulSet。Alertmanager pods 配置挂载一个名为 <alertmanager-name> 的 Secret, 使用 alertmanager.yaml key 对作为配置文件。 当有两个或更多配置的副本时,Operator 可以高可用性模式运行Alertmanager实例。 一个样例配置如下: kind: Alertmanager # 一个 Alertmanager 对象 metadata: name: prometheus-prometheus-oper-alertmanager spec: baseImage: quay.io/prometheus/alertmanager replicas: 3 # 定义该 Alertmanager 集群的节点数为 3 version: v0.17.0 Alertmanager 配置 PrometheusRule PrometheusRule CRD 声明一个或多个 Prometheus 实例需要的 Prometheus rule。 Alerts 和 recording rules 可以保存并应用为 yaml 文件,可以被动态加载而不需要重启。 一个样例配置如下: kind: PrometheusRule metadata: labels: # 定义该 PrometheusRule 的 label, 显然它会被 Prometheus 选中 prometheus: k8s role: alert-rules name: prometheus-k8s-rules spec: groups: - name: k8s.rules rules: # 定义了一组规则,其中只有一条报警规则,用来报警 kubelet 是不是挂了 - alert: KubeletDown annotations: message: Kubelet has disappeared from Prometheus target discovery. expr: | absent(up{job="kubelet"} == 1) for: 15m labels: severity: critical PrometheusRule 配置 它们之间的关系如下图: Prometheus Operator 的优点 Prometheus Operator 中所有的 API 对象都是 CRD 中定义好的 Schema,API Server会校验。当开发者使用 ConfigMap 保存配置没有任何校验,配置文件写错时,自表现为功能不可用,问题排查复杂。在 Prometheus Operator 中,所有在 Prometheus 对象、ServiceMonitor 对象、PrometheusRule 对象中的配置都是有 Schema 校验的,校验失败 apply 直接出错,这就大大降低了配置异常的风险。 Prometheus Operator 借助 K8S 将 Prometheus 服务平台化。有了 Prometheus 和 AlertManager 这样的 API 对象,非常简单、快速的可以在 K8S 集群中创建和管理 Prometheus 服务和 AlertManager 服务,以应对不同业务部门,不同领域的监控需求。 ServiceMonitor 和 PrometheusRule 解决了 Prometheus 配置难维护问题,开发者不再需要去专门学习 Prometheus 的配置文件,不再需要通过 CI 和 k8s ConfigMap 等手段把配置文件更新到 Pod 内再触发 webhook 热更新,只需要修改这两个对象资源就可以了。 关于Choerodon猪齿鱼 Choerodon猪齿鱼是一个开源多云技术平台,是基于开源技术Kubernetes,Istio,knative,Gitlab,Spring Cloud来实现本地和云端环境的集成,实现企业多云/混合云应用环境的一致性。平台通过提供精益敏捷、持续交付、容器环境、微服务、DevOps等能力来帮助组织团队来完成软件的生命周期管理,从而更快、更频繁地交付更稳定的软件。 Choerodon猪齿鱼已开通官方微信交流群,欢迎大家添加Choerodon猪齿鱼微信(ID:choerodon-c7n)入群 大家也可以通过以下社区途径了解猪齿鱼的最新动态、产品特性,以及参与社区贡献: 官网:http://choerodon.io 论坛:http://forum.choerodon.io Github:https://github.com/choerodon 码云:https://gitee.com/choerodon

优秀的个人博客,低调大师

解析-hadoop五大节点

1.NameNode(管理节点)Namenode 管理着文件系统的命令空间(Namespace)。它维护着文件系统树以及文件树中所有的文件和文件夹的元数据(metadata),元数据包括编辑日志(edits)和镜像文件。管理这些信息的文件有两个,分别是Namespace 镜像文件(fsimage)和编辑日志文件,编辑日志主要是记录对hdfs进行的修改。镜像文件主要是记录hdfs的文件树形结构。这些信息被Cache在RAM中,当然,这两个文件也会被持久化存储在本地硬盘。Namenode记录着每个文件中各个块所在的数据节点的位置信息,但是他并不持久化存储这些信息,因为这些信息会在系统启动时从数据节点重建。2.DataNode(工作节点) Datanode是文件系统的工作节点,他们根据客户端或者是namenode的调度存储和检索数据,并且定期向namenode发送他们所存储的块(block)的列表。没有namenode,文件系统是无法使用的。事实上,如果运行namenode服务的服务器坏掉,文件系统上的所有文件将会丢失。因为我们不知道如何根据DataNode的块进行重建文件。所有对NameNode进行容错冗余机制是非常重要的。 集群中的从节点服务器都运行一个DataNode后台程序,这个后台程序负责把HDFS数据块读写到本地的文件系统。当需要通过客户端读/写某个数据时,先由NameNode告诉客户端去哪个DataNode进行具体的读/写操作,然后客户端直接与这个DataNode服务器上的后台程序进行通信,并且对相关的数据块进行读/写操作。3.secondary NameNode(相当于MySQL数据库中主从复制的从节点) Secondary NameNode是一个用来监控HDFS状态的辅助后台程序。和NameNode一样,每个集群都有一个Secondary NameNode,并且部署在一个单独的服务器上。Secondary NameNode不同于NameNode,它不接受或者记录任何实时的数据变化,但是,它会与NameNode进行通信,以便定期地保存HDFS元数据的快照。由于NameNode是单点的,通过Secondary NameNode的快照功能,可以将NameNode的宕机时间和数据损失降低到最小。同时,如果NameNode发生问题,Secondary NameNode可以及时地作为备用NameNode使用。4.ResourceManager ResourceManage 即资源管理,在YARN中,ResourceManager负责集群中所有资源的统一管理和分配,它接收来自各个节点(NodeManager)的资源汇报信息,并把这些信息按照一定的策略分配给各个应用程序(实际上是ApplicationManager)。 RM包括Scheduler(定时调度器)和ApplicationManager(应用管理器)Schedular负责向应用程序分配资源,它不做监控以及应用程序的状态跟踪,并且不保证会重启应用程序本身或者硬件出错而执行失败的应用程序。ApplicationManager负责接受新的任务,协调并提供在ApplicationMaster容器失败时的重启功能.每个应用程序的AM负责项Scheduler申请资源,以及跟踪这些资源的使用情况和资源调度的监控。5.Nodemanager NM是ResourceManager在slave机器上的代理,负责容器管理,并监控它们的资源使用情况,以及向ResourceManager/Scheduler提供资源使用报告。

优秀的个人博客,低调大师

Apache Flink Time & Window 深度解析

作者:邱从贤 1、 Window & Time 介绍 Apache Flink(以下简称 Flink) 是一个天然支持无限流数据处理的分布式计算框架,在 Flink 中 Window 可以将无限流切分成有限流,是处理有限流的核心组件,现在 Flink 中 Window 可以是时间驱动的(Time Window),也可以是数据驱动的(Count Window)。 下面的代码是在 Flink 中使用 Window 的两个示例 2、 Window API 使用 从第一部分我们已经知道 Window 的一些基本概念,以及相关 API,下面我们以一个实际例子来看看怎么使用 Window 相关的 API。 代码来自 flink-examples 上面的例子中我们首先会对每条数据进行时间抽取,然后进行 keyby,接着依次调用 window(),ev

优秀的个人博客,低调大师

QLExpress代码解读,运行原理解析

本文针对上图的功能详细图,进行逐个的简单介绍:代码入口、代码的主要逻辑和算法。 调用代码实例 //本文以helloworld案例,开启了两个打印日志的参数,实际使用通常不建议打开。 boolean printParseLog = true;//语法分析日志开关 boolean printExecuteLog = true;//每一条指令执行开关 ExpressRunner runner = new ExpressRunner(false, printParseLog); IExpressContext<String, Object> context = new DefaultContext<String, Object>(); String script = "sum=0;for(i=0;i<10;i=i

优秀的个人博客,低调大师

Java并发编程之CountDownLatch源码解析

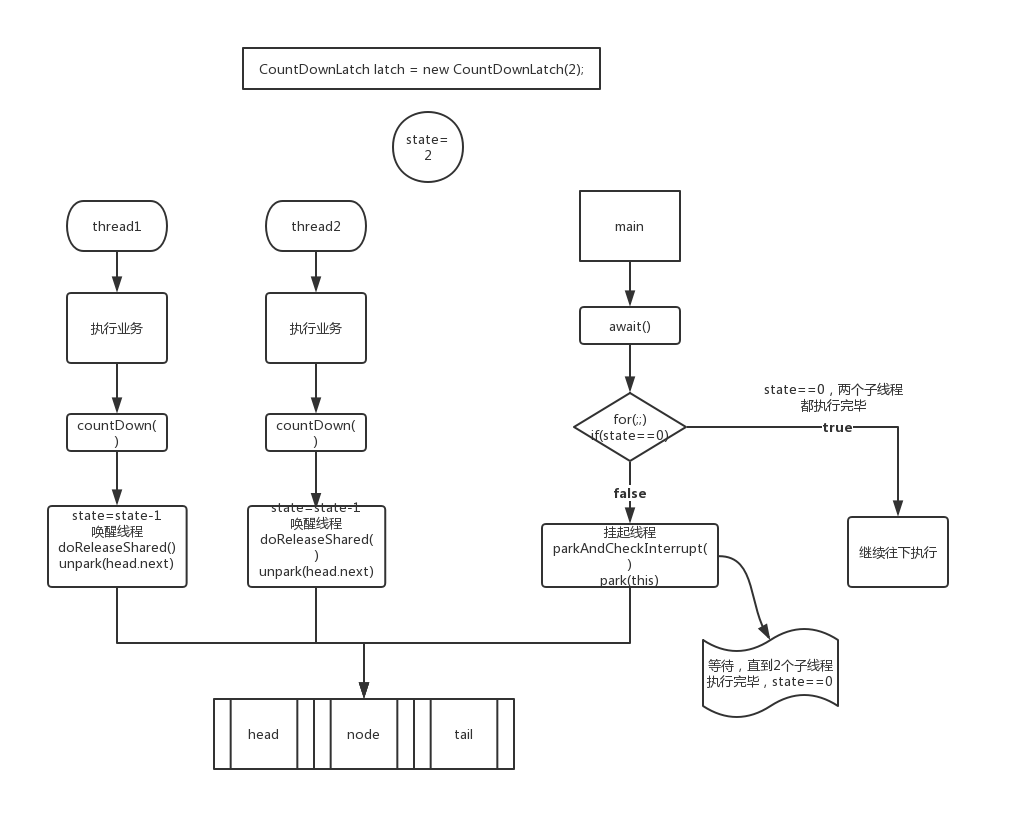
一、导语 最近在学习并发编程原理,所以准备整理一下自己学到的知识,先写一篇CountDownLatch的源码分析,之后希望可以慢慢写完整个并发编程。 二、什么是CountDownLatch CountDownLatch是java的JUC并发包里的一个工具类,可以理解为一个倒计时器,主要是用来控制多个线程之间的通信。 比如有一个主线程A,它要等待其他4个子线程执行完毕之后才能执行,此时就可以利用CountDownLatch来实现这种功能了。 三、简单使用 public static void main(String[] args){ System.out.println("主线程和他的两个小兄弟约好去吃火锅"); System.out.println("主线程进入了饭店"); System.out.println("主线程想要开始动筷子吃饭"); //new一个计数器,初始值为2,当计数器为0时,主线程开始执行 CountDownLatch latch = new CountDownLatch(2); new Thread(){ public void run() { try { System.out.println("子线程1——小兄弟A 正在到饭店的路上"); Thread.sleep(3000); System.out.println("子线程1——小兄弟A 到饭店了"); //一个小兄弟到了,计数器-1 latch.countDown(); } catch (InterruptedException e) { e.printStackTrace(); } }; }.start(); new Thread(){ public void run() { try { System.out.println("子线程2——小兄弟B 正在到饭店的路上"); Thread.sleep(3000); System.out.println("子线程2——小兄弟B 到饭店了"); //另一个小兄弟到了,计数器-1 latch.countDown(); } catch (InterruptedException e) { e.printStackTrace(); } }; }.start(); //主线程等待,直到其他两个小兄弟也进入饭店(计数器==0),主线程才能吃饭 latch.await(); System.out.println("主线程终于可以开始吃饭了~"); } 四、源码分析 核心代码: CountDownLatch latch = new CountDownLatch(1); latch.await(); latch.countDown(); 其中构造函数的参数是计数器的值; await()方法是用来阻塞线程,直到计数器的值为0 countDown()方法是执行计数器-1操作 1、首先来看构造函数的代码 public CountDownLatch(int count) { if (count < 0) throw new IllegalArgumentException("count < 0"); this.sync = new Sync(count); } 这段代码很简单,首先if判断传入的count是否<0,如果小于0直接抛异常。 然后new一个类Sync,这个Sync是什么呢?我们一起来看下 private static final class Sync extends AbstractQueuedSynchronizer { private static final long serialVersionUID = 4982264981922014374L; Sync(int count) { setState(count); } int getCount() { return getState(); } //尝试获取共享锁 protected int tryAcquireShared(int acquires) { return (getState() == 0) ? 1 : -1; } //尝试释放共享锁 protected boolean tryReleaseShared(int releases) { // Decrement count; signal when transition to zero for (;;) { int c = getState(); if (c == 0) return false; int nextc = c-1; if (compareAndSetState(c, nextc)) return nextc == 0; } } } 可以看到Sync是一个内部类,继承了AQS,AQS是一个同步器,之后我们会详细讲。 其中有几个核心点: 变量 state是父类AQS里面的变量,在这里的语义是计数器的值 getState()方法也是父类AQS里的方法,很简单,就是获取state的值 tryAcquireShared和tryReleaseShared也是父类AQS里面的方法,在这里CountDownLatch对他们进行了重写,先有个印象,之后详讲。 2、了解了CountDownLatch的构造函数之后,我们再来看它的核心代码,首先是await()。 public void await() throws InterruptedException { sync.acquireSharedInterruptibly(1); } 可以看到,其实是通过内部类Sync调用了父类AQS的acquireSharedInterruptibly()方法。 public final void acquireSharedInterruptibly(int arg) throws InterruptedException { //判断线程是否是中断状态 if (Thread.interrupted()) throw new InterruptedException(); //尝试获取state的值 if (tryAcquireShared(arg) < 0)//step1 doAcquireSharedInterruptibly(arg);//step2 } tryAcquireShared(arg)这个方法就是我们刚才在Sync内看到的重写父类AQS的方法,意思就是判断是否getState() == 0,如果state为0,返回1,则step1处不进入if体内acquireSharedInterruptibly(int arg)方法执行完毕。若state!=0,则返回-1,进入if体内step2处。 下面我们来看acquireSharedInterruptibly(int arg)方法: private void doAcquireSharedInterruptibly(int arg) throws InterruptedException { //step1、把当前线程封装为共享类型的Node,加入队列尾部 final Node node = addWaiter(Node.SHARED); boolean failed = true; try { for (;;) { //step2、获取当前node的前一个元素 final Node p = node.predecessor(); //step3、如果前一个元素是队首 if (p == head) { //step4、再次调用tryAcquireShared()方法,判断state的值是否为0 int r = tryAcquireShared(arg); //step5、如果state的值==0 if (r >= 0) { //step6、设置当前node为队首,并尝试释放共享锁 setHeadAndPropagate(node, r); p.next = null; // help GC failed = false; return; } } //step7、是否可以安心挂起当前线程,是就挂起;并且判断当前线程是否中断 if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) throw new InterruptedException(); } } finally { //step8、如果出现异常,failed没有更新为false,则把当前node从队列中取消 if (failed) cancelAcquire(node); } } 按照代码中的注释,我们可以大概了解该方法的内容,下面我们来仔细看下其中调用的一些方法是干什么的。 1、首先看addWaiter() //step1 private Node addWaiter(Node mode) { //把当前线程封装为node Node node = new Node(Thread.currentThread(), mode); // Try the fast path of enq; backup to full enq on failure //获取当前队列的队尾tail,并赋值给pred Node pred = tail; //如果pred!=null,即当前队尾不为null if (pred != null) { //把当前队尾tail,变成当前node的前继节点 node.prev = pred; //cas更新当前node为新的队尾 if (compareAndSetTail(pred, node)) { pred.next = node; return node; } } //如果队尾为空,走enq方法 enq(node);//step1.1 return node; } ----------------------------------------------------------------- //step1.1 private Node enq(final Node node) { for (;;) { Node t = tail; //如果队尾tail为null,初始化队列 if (t == null) { // Must initialize //cas设置一个新的空node为队首 if (compareAndSetHead(new Node())) tail = head; } else { //cas把当前node设置为新队尾,把前队尾设置成当前node的前继节点 node.prev = t; if (compareAndSetTail(t, node)) { t.next = node; return t; } } } } 2、接下来我们在来看setHeadAndPropagate()方法,看其内部实现 //step6 private void setHeadAndPropagate(Node node, int propagate) { //获取队首head Node h = head; // Record old head for check below //设置当前node为队首,并取消node所关联的线程 setHead(node); // if (propagate > 0 || h == null || h.waitStatus < 0 || (h = head) == null || h.waitStatus < 0) { Node s = node.next; //如果当前node的后继节点为null或者是shared类型的 if (s == null || s.isShared()) //释放锁,唤醒下一个线程 doReleaseShared();//step6.1 } } -------------------------------------------------------------------- //step6.1 private void doReleaseShared() { for (;;) { //找到头节点 Node h = head; if (h != null && h != tail) { //获取头节点状态 int ws = h.waitStatus; if (ws == Node.SIGNAL) { if (!compareAndSetWaitStatus(h, Node.SIGNAL, 0)) continue; // loop to recheck cases //唤醒head节点的next节点 unparkSuccessor(h); } else if (ws == 0 && !compareAndSetWaitStatus(h, 0, Node.PROPAGATE)) continue; // loop on failed CAS } if (h == head) // loop if head changed break; } } 3、接下来我们来看countDown()方法。 public void countDown() { sync.releaseShared(1); } 可以看到调用的是父类AQS的releaseShared 方法 public final boolean releaseShared(int arg) { //state-1 if (tryReleaseShared(arg)) {//step1 //唤醒等待线程,内部调用的是LockSupport.unpark方法 doReleaseShared();//step2 return true; } return false; } ------------------------------------------------------------------ //step1 protected boolean tryReleaseShared(int releases) { // Decrement count; signal when transition to zero for (;;) { //获取当前state的值 int c = getState(); if (c == 0) return false; int nextc = c-1; //cas操作来进行原子减1 if (compareAndSetState(c, nextc)) return nextc == 0; } } 五、总结 CountDownLatch主要是通过计数器state来控制是否可以执行其他操作,如果不能就通过LockSupport.park()方法挂起线程,直到其他线程执行完毕后唤醒它。 下面我们通过一个简单的图来帮助我们理解一下: PS:本人也是还在学习的路上,理解的也不是特别透彻,如有错误,愿倾听教诲。^_^
优秀的个人博客,低调大师

HttpServletRequest 接收并解析获取JSON数据

最近在弄Security权限时遇到attemptAuthentication接口接收登录参数的时候只能用request,但是现在很多项目都是已经使用前后端分离的开发模式了 像以往我们在Controller的时候处理json数据转换只需要标注@RequestBody注解即可. 有问题就要解决,打开debug找了一下request的字段内容,并没有发现我所需要的Json数据,一时比较辣手,最后不得不面向Google编程了. 以下是工具类 public class GetRequestJsonUtils { public static JSONObject getRequestJsonObject(HttpServletRequest request) throws IOException { String json = getRequestJsonString(request); return JSONObject.parseObject(json); } /*** * 获取 request 中 json 字符串的内容 * * @param request * @return : <code>byte[]</code> * @throws IOException */ public static String getRequestJsonString(HttpServletRequest request) throws IOException { String submitMehtod = request.getMethod(); // GET if (submitMehtod.equals("GET")) { return new String(request.getQueryString().getBytes("iso-8859-1"),"utf-8").replaceAll("%22", "\""); // POST } else { return getRequestPostStr(request); } } /** * 描述:获取 post 请求的 byte[] 数组 * <pre> * 举例: * </pre> * @param request * @return * @throws IOException */ public static byte[] getRequestPostBytes(HttpServletRequest request) throws IOException { int contentLength = request.getContentLength(); if(contentLength<0){ return null; } byte buffer[] = new byte[contentLength]; for (int i = 0; i < contentLength;) { int readlen = request.getInputStream().read(buffer, i, contentLength - i); if (readlen == -1) { break; } i += readlen; } return buffer; } /** * 描述:获取 post 请求内容 * <pre> * 举例: * </pre> * @param request * @return * @throws IOException */ public static String getRequestPostStr(HttpServletRequest request) throws IOException { byte buffer[] = getRequestPostBytes(request); String charEncoding = request.getCharacterEncoding(); if (charEncoding == null) { charEncoding = "UTF-8"; } return new String(buffer, charEncoding); } } 最后我们只需要把request传入GetRequestJsonUtils返回一个JSONObject 对象. JSONObject json = GetRequestJsonUtils.getRequestJsonObject(request); String username = json.getString(usernameParameter); String password = json.getString(passwordParameter); 原文地址:https://blog.csdn.net/tengdazhang770960436/article/details/50149061

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册