首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

解析$nextTick魔力,为啥大家都爱它?

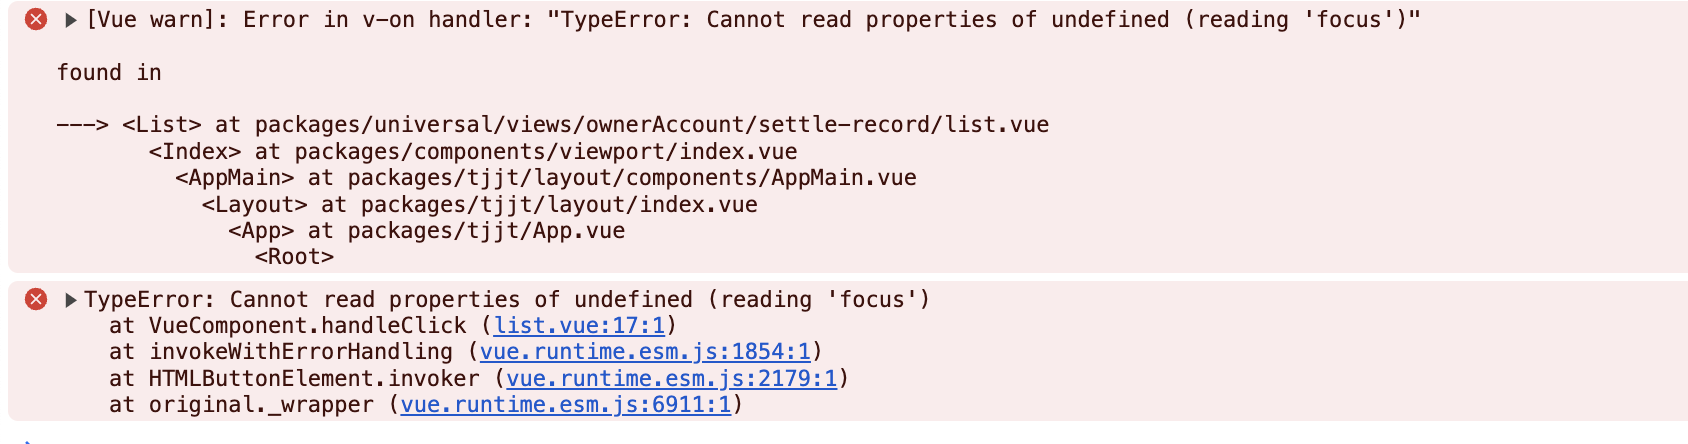
1.为什么需要使用$nextTick? 首先我们来看看官方对于$nextTick的定义: 在下次 DOM 更新循环结束之后执行延迟回调。在修改数据之后立即使用这个方法,获取更新后的 DOM。 由于vue的试图渲染是异步的,生命周期的created()钩子函数进行的DOM操作一定要放在Vue.nextTick()的回调函数中,原因是在created()钩子函数执行的时候DOM其实并未进行渲染,而此时进行DOM操作是徒劳的,所以一定要将DOM操作的js代码放到Vue.nextTick()的回调函数中。除了在created()钩子函数中使用之外咱们还会遇到很多种需要使用到Vue.nextTick()的场景,如下所示: 咱们日常生活中常常会遇上上述场景,当我们点击按钮更新数据时候,如下示例: <template> <div> <input type="text" v-if = "isShow" ref="input"/> <button @click="handleClick">点击显示输入框,并且获取输入框焦点</button> </div> </template> <script> export default { data() { return { isShow: false } }, methods : { handleClick () { this.isShow = true this.$refs.input.focus() //控制栏会报错,因为还没有这个dom } } } </script> 点击控制栏显示效果:控制栏报错,提示没有获取到dom元素;   所以现在Vue.nextTick()派上了用场,Vue.nextTick() 方法的作用正是等待上一次事件循环执行完毕,并在下一次事件循环开始时再执行回调函数。这样可以保证回调函数中的 DOM 操作已经被 Vue.js 进行过更新,从而避免了一些潜在的问题,如下代码所示: <template> <div> <input type="text" v-if = "isShow" ref="input"/> <button @click="handleClick">点击显示输入框,并且获取输入框焦点</button> </div> </template> <script> export default { data() { return { isShow: false } }, methods : { handleClick () { this.isShow = true this.$nextTick(()=>{ this.$refs.input.focus() }) } } } </script> 加上this.$nextTick后就能够使得输入框获取到焦点; 总而言之Vue.nextTick()就是下次 DOM 更新渲染后执行延迟回调函数。在日常开发中,我们在修改数据之后使用这个方法,就可以获取更新后的 DOM的同时进行在对DOM进行相对应操作的 js代码; 2.$nextTick如何实现的? JS是单线程执行的,所有的同步任务都是在主线程上执行的,形成了一个执行栈,从上到下依次执行,异步代码会放在任务队列里面。 • 同步任务 在主线程里执行,当浏览器第一遍过滤html文件的时候可以执行完;(在当前作用域直接执行的所有内容,包括执行的方法、new出来的对象) • 异步任务 耗费时间较长或者性能较差的,浏览器执行到这些的时候会将其丢到异步任务队列中,不会立即执行 同时异步任务分为宏任务(如setTimeout、setInterval、postMessage、setImmediate等)和微任务(Promise、process.nextTick等),浏览器执行这两种任务的优先级不同;会优先执行微任务队列的代码,微任务队列清空之后再执行宏任务的队列,这样循环往复; JS自上向下进行代码的编译执行,遇到同步代码压入JS执行栈执行后出栈,遇到异步代码放入任务队列,当JS执行栈清空,去执行异步队列中的回调函数,先去执行微任务队列,当微任务队列清空后,去检测执行宏任务队列中的回调函数,直至所有栈和队列清空 整体流程如下图所示:    接下来让我们看看nextTick的源码~ vue将nextTick的源码放在了vue/core/util/next-tick.js中。如下图所示:   我们把这个文件拆成三个部分来看: 1.nextTick定义函数 我们将nextTick函数单独拿出来,callbacks是一个回调队列,其实调用nextTick就是往这个数组里面传执行任务,callbacks新增回调函数之后执行timerFunc函数,pending是用来限制同一个事件循环内只能执行一次的pending锁; const callbacks = [] // 回调队列 let pending = false // export function nextTick (cb?: Function, ctx?: Object) { let _resolve callbacks.push(() => { // cb 回调函数会经统一处理压入 callbacks 数组 if (cb) { try { cb.call(ctx) } catch (e) { handleError(e, ctx, 'nextTick') } } else if (_resolve) { _resolve(ctx) } }) // 执行异步延迟函数 timerFunc if (!pending) { pending = true timerFunc() } // $flow-disable-line // 当 nextTick 没有传入函数参数的时候,返回一个 Promise 化的调用 if (!cb && typeof Promise !== 'undefined') { return new Promise(resolve => { _resolve = resolve }) } } 2.timerFunc函数 做了四个判断,先后尝试当前环境是否能够使用原生的Promise.then、MutationObserver和setImmediate,不断的降级处理,如果以上三个都不支持,则最后就会直接使用setTimeOut,主要操作就是将flushCallbacks中的函数放入微任务或者宏任务,等待下一个事件循环开始执行;宏任务耗费的时间是大于微任务的,所以在浏览器支持的情况下,优先使用微任务。如果浏览器不支持微任务,使用宏任务;但是,各种宏任务之间也有效率的不同,需要根据浏览器的支持情况,使用不同的宏任务; export let isUsingMicroTask = false let timerFunc if (typeof Promise !== 'undefined' && isNative(Promise)) { //是否支持Promise const p = Promise.resolve() timerFunc = () => { p.then(flushCallbacks) if (isIOS) setTimeout(noop) } isUsingMicroTask = true } else if (!isIE && typeof MutationObserver !== 'undefined' && ( isNative(MutationObserver) || MutationObserver.toString() === '[object MutationObserverConstructor]' )) { //是否支持MutationObserver let counter = 1 const observer = new MutationObserver(flushCallbacks) const textNode = document.createTextNode(String(counter)) observer.observe(textNode, { characterData: true }) timerFunc = () => { counter = (counter + 1) % 2 textNode.data = String(counter) } isUsingMicroTask = true } else if (typeof setImmediate !== 'undefined' && isNative(setImmediate)) { timerFunc = () => { //是否支持setImmediate setImmediate(flushCallbacks) } } else { // Fallback to setTimeout. timerFunc = () => { //上面都不行,直接使用setTimeout setTimeout(flushCallbacks, 0) } } 3.flushCallbacks函数 flushCallbacks函数只有几行,也很好理解,将pending锁置为false,同时将callbacks数组复制一份之后再将callbacks置为空,接下来将复制出来的callbacks数组的每个函数依次进行执行,简单来说它的主要作用就是用来执行callbacks中的回调函数; function flushCallbacks () { pending = false const copies = callbacks.slice(0) callbacks.length = 0 for (let i = 0; i < copies.length; i++) { copies[i]() } } 值得注意的是,$nextTick 并不是一个真正意义上的微任务microtask,而是利用了事件循环机制来实现异步更新。因此,它的执行时机相对于微任务可能会有所延迟,但仍能保证在 DOM 更新后尽快执行回调函数。 总的来说,nextTick就是 1.将传入的回调函数放入callbacks数组等待执行,定义pending判断锁保证一个事件循环中只能调用一次timerFunc函数; 2.根据环境判断使用异步方式,调用timerFunc函数调用flushCallbacks函数依次执行callbacks中的回调函数; 3.个人小结 nextTick可避免数据更新后导致DOM的数据不一致的问题,提供了更稳定的异步更新机制,解决了created钩子函数DOM未渲染会造成的异步数据渲染问题,但如果过多的使用nextTick会导致事件循环中任务数量和回调函数增多,有可能出现可怕的回调地狱,导致性能下降,同时过度依赖nextTick也会降低代码的可读性,所以大家还是"按需加载"的好~  作者:京东保险 卓雅倩 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

ES的索引结构与算法解析

作者:京东物流 李洪吉 提到ES,大多数爱好者想到的都是搜索引擎,但是明确一点,ES不等同于搜索引擎。不管是谷歌、百度、必应、搜狗为代表的自然语言处理(NLP)、爬虫、网页处理、大数据处理的全文搜索引擎,还是有明确搜索目的的搜索行为,如各大电商网站、OA、站内搜索、视频网站的垂直搜索引擎,他们或多或少都使用到了ES。 ​作为搜索引擎的一部分,ES自然具有速度快、结果准确、结果丰富等特点,那么ES是如何达到“搜索引擎”级别的查询效率呢?首先是索引,其次是压缩算法,接下来我们就一起了解下ES的索引结构和压缩算法 1 结构 1.1 Mysql Mysql下的data目录存放的文件就是mysql相关数据,mysql文件夹对应的就是数据库mysql。 其中表columns_priv对应了3个文件:columns_priv.frm、columns_priv.MYD、columns_priv.MYI。 .frm:表结构;.MYD:myisam存储引擎原数据;.MYI:myisam存储引擎索引;.ibd:innodb存储引擎数据 1.2 Elasticsearch cfe为索引文,cfs 为数据文件,cfe文件保存Lucene各文件在.cfs文件的位置信息 cfs、cfe 在segment还很小的时候,将segment的所有文件都存在在cfs中,在cfs逐渐变大时,大小超过shard的10%,则会拆分为其他文件,如tim、dvd、fdt等文件 1.3 存储结构 倒排索引结构分为倒排表、词项字典、词项索引 倒排表包含某个词项的所有id的数据存储了在.doc文件中 词项字典包含了index field的所有经过处理之后的词项数据,最终存储在.tim文件中 1.4 结构对比 我们以某商城的手机为例,左侧为es倒排索引结构,右侧为原始数据。左侧图示只是为了展示倒排索引结构,并不是说es中倒排表就是简单的数组 以上面结构对比示例图为例,假如共有10亿条数据需要存储在ES中(上图右),分词后存储的倒排表(上图左)大概包含分词term以及对应的id数组等,在10亿条数据中,分词“小米”相关的数据有100万条,也就是说分词“小米”对应的数组Posting List长度是100万 id是int类型的有序主键,分词“小米”在数组Posting List中100万int类型数字总长度=100万✖每个int占4字节=400万Byte≈4MB。1个分词占4MB空间,假如10亿条数据有500万个分词,总空间=4MB✖500万=2千万MB,磁盘空间直接爆炸 2 算法 分词对应的数组Posting List实际就是一个个有序数组,而有序数值数组是比较容易进行压缩处理的,而且一般来说压缩效益也不错,如果能对其进行压缩是能够大大节约空间资源的 ES中倒排索引的压缩算法主要有FOR算法(Frame Of Reference)和RBM算法(RoaringBitMap) 2.1 FOR FOR算法的核心思想是用减法来削减数值大小,从而达到降低空间存储。 假设V(n)表示数组中第n个字段的值,那么经过FOR算法压缩的数值V(n)=V(n)-V(n-1)。也就是说存储的是后一位减去前一位的差值。存储是也不再按照int来计算了,而是看这个数组的最大值需要占用多少bit来计算 我们按照差值计算的方式来保存数据,初始值为1,2与1的差值为1,3与2的差值为1……最终我们就将原始Posting List数据转化为100万个1,每个1我们可以用1bit来记录,总空间=1bit✖100万=100万bit,相比原有400万Byte=3200bit,空间压缩了32倍 在实际生产中,不可能出现一个term的Posting List是这种差值均为1的情况,所以我们以通用示例举例。假如原数据为[73,300,302,332,343,372],数组中6个数字占据总空间为24字节。按照差值方式记录,数组转化为[73,227,2,30,11,29],最大数字为227,大于2的7次方128,小于2的8次方256,所以每个数字可以使用8bit即1Byte来保存,占据总空间为1Byte*6 + 1Byte=7Byte 在此基础上,我们将差值数组按照密集度划分为[73,227]和[2,30,11,29],其中[73,227]中最大值227介于2的7次方和2的8次方之间,所以用8bit=1Byte作为切割分段,[2,30,11,29]中最大数30介于2的4次方和2的5次方之间,所以用5bit作为切割分段。 数组[73,227]占据总空间为8bit✖2个=16bit=2Byte 数组[2,30,11,29]占据总空间为5bit✖4个=20bit=3Byte 为什么20bit=3Byte呢?因为8bit=1Byte,小于8bit也会占据1个字节空间,所以17bit到24bit均为3Byte 所以,最终占据总空间=1+2+1+3=7Byte 疑问一:既然原数组[73,300,302,332,343,372]要按照密集度拆分为[73,227]和[2,30,11,29]两个数组,那为什么不继续往下拆分,直接拆分到每个数字是一个数组,这样使用bit记录时占据总空间会更少? 答:如果继续拆分数组,空间确实会使用更少,但是,之前我们提到搜索引擎速度快的方式有两种:高效的压缩算法和快速的编码解码速度,单个数字存储确实压缩了空间,但是我们无法再通过解码的方式将源数据还原 疑问二:为什么源数据使用差值记录占据6Byte,拆分数组后占据7Byte,拆分后占据空间不变,有时候甚至会变大,为什么? 答:数据量小的情况下确实会出现该情况,因为我们需要拆分数组并记录拆分数组的长度(如上面示例中的8bit和5bit),在原数据存储空间基础上还要存储拆分长度,所以数据量小的情况下会出现比直接存储占据空间大的情况。但是不管是搜索引擎还是Elasticsearch更多处理的是海量数据,数据量越多,差值数组拆分的方式节省空间越明显 2.2 RBM 我们已经了解了FOR压缩算法,算法核心是将PostingList按照差值密集度转化成两个差值数组。在这里我们要考虑一种情况就是:在大数据中,10亿条数据分词500万个,如果分词“小米”所在PostList比较分散且差值很大,此时使用FOR算法效果就会大打折扣。所以稀疏的数组,不适合使用FOR算法 在这里我们以[1000,62101,131385,132052,191173,196658]为例,如果按照FOR算法,转化成的差值数组为[1000,61101,69284,667,59121,5485]密集度很低。我们采用RBM算法 源数据PostingList是由int类型组成的数组,int类型=4Byte=32bit,最大值=2的32次方-1=4294967295≈43亿。当数据较大且稀疏时,我们将32bit拆分为16bit和16bit,16bit最大值=65535,前16bit存放商,后16bit存放余数,所以商和余数都不会超过65535.我们将源数组的值除以65536,得到的商和余数分别存放在前16bit和后16bit。 以数字196658为例,转化为2进制,前16位=3,后16位=50 得到的结果以K-V存放。Key最大值为16bit,所以以short[]数组存放,Value以Container存放。 由于源数组为有序数组,所以按照高低16位转化后,商和余数都是从小到大排列 通过看Container源码,我们可以看到Container有3种:ArrayContainer、BitmapContainer、RunContainer。 ArrayContainer本质为集合,所以随着数组中数量越多,占用空间越多,呈正向增长。 当数组种数量为4096时,占据总空间=4096个✖16bit(即2Byte)➗1024=8KB 当数组种数量为65536时,占据总空间=65536个✖16bit(即2Byte)➗1024=128KB BitmapContainer位图,核心就是将原有存储数值转化成该数值在哪个位置上存在 由于余数最大值为65535,所以我们需要65536位位图,数值是多少,在位图上对应的位置就是多少。数值等于4096,则位图上4096位值为1;数值等于65535,则位图上65535位值为1。每个位置上的数都占用8KB空间(8KB=65536bit) RunContainer用法相对狭隘,这种类型是Lucene 5之后新增的类型,主要应用在连续数字的存储商,比如倒排表中存储的数组为 [1,2,3…100W] 这样的连续数组,如果使用RunContainer,只需存储开头和结尾两个数字:1和100W,即占用8个字节。这种存储方式的优缺点都很明显,它严重收到数字连续性的影响,连续的数字越多,它存储的效率就越高 如果数组是如下形式 [1,2,3,4,5,100,101,102,999,1000,1001] 就会被拆分为三段:[1,5],[100,102],[999,1001] 至于每次存储采用什么容器,需要进行一下判定,比如ArrayContainer,当存储的元素少于4096个时,他会比BitmapContainer占用更少空间,而当大于4096个元素时,采用ArrayContainer所需要的空间就会大于8kb,那么采用BitmapContainer就会占用更少空间 3 总结 ES在处理海量数据时通过其独到的结构和压缩算法,将索引效率尽可能的提升。虽然在实际业务处理中我们极少遇到海量数据处理的情况,但是通过了解ES的原理,能够帮我们开阔下视野,了解数字之美,算法之美。
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册